

取引におけるニューラルネットワーク:インテリジェントな予測パイプライン(最終回)
 3
 4

はじめに
Time-MoEフレームワークは、時系列データを扱うためのまったく新しいアプローチを提供します。 従来のモデルとは異なり、時点単位のトークン化によって各ティックやローソク足の情報を完全に保持します。さらに、SwiGLU埋め込みによって、これらの基本単位となるトークンの表現を拡張し、滑らかなトレンドの動きからボラティリティの急激な変動まで捉えられるようにします。
著者らの中心的なアイデアは、Decoder-Only Transformer内にスパースな混合エキスパート(MoE)を導入することです。各トークンに対して最も適切なエキスパートモデルを動的に選択します。さらに、常に利用される共有エキスパートを組み合わせることで、適応性と拡張性に優れたアーキテクチャを実現します。 複数の予測Headによる出力が、この構成をさらに完成させます。これにより、次のティックから週単位のトレンドまで、異なる予測期間に対する予測を同時に生成できます。
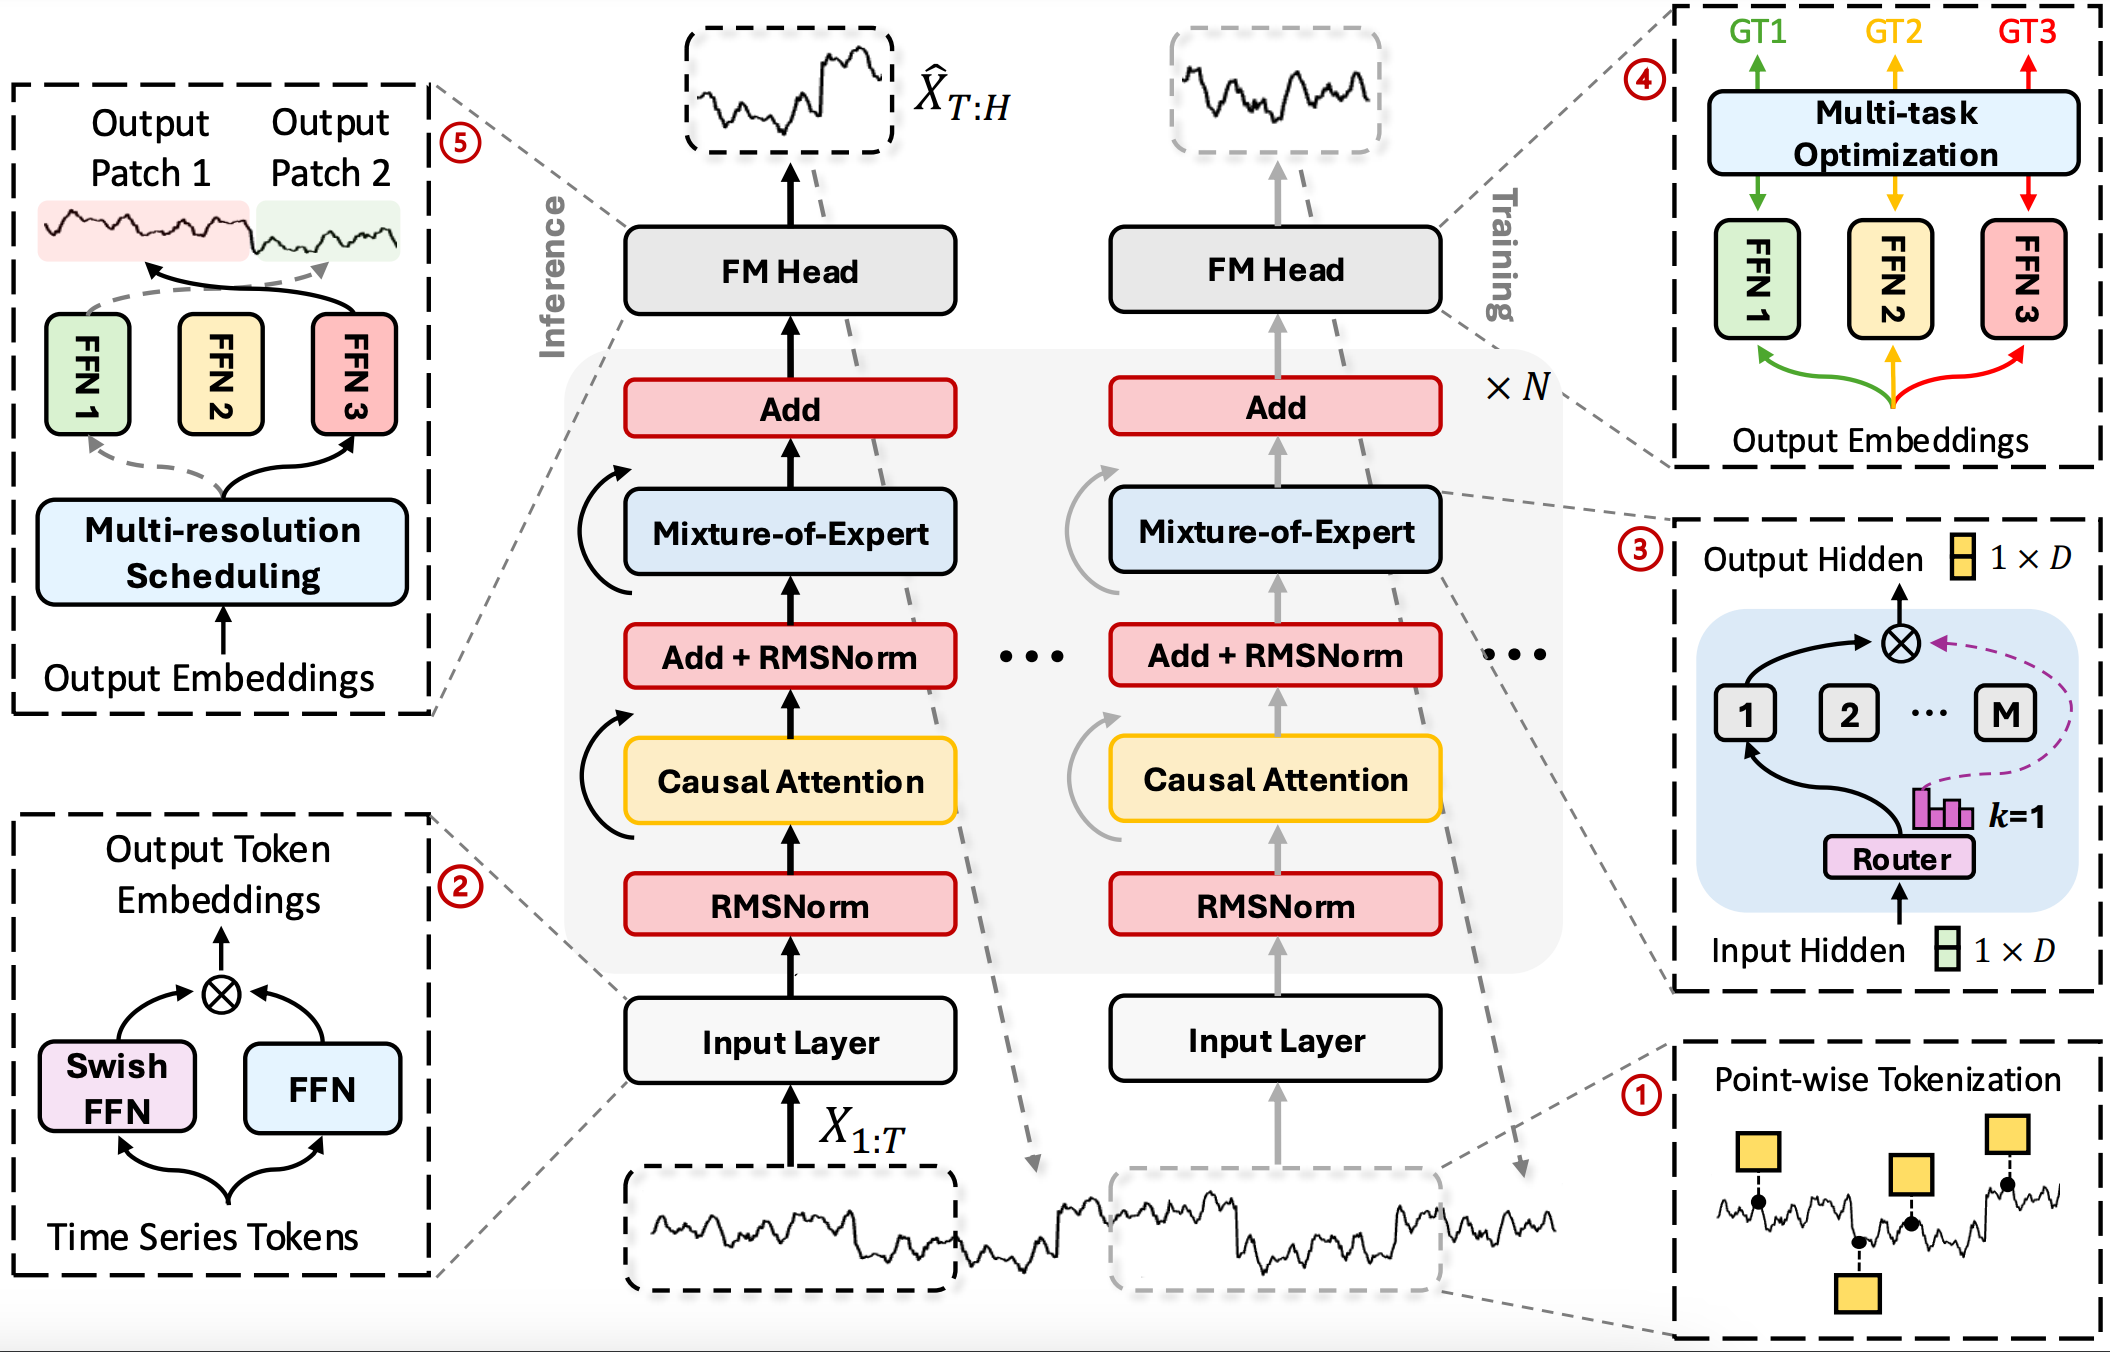
Time-MoEフレームワークを扱った最初の記事では、原論文「Time-MoE: Billion-Scale Time Series Foundation Models with Mixture of Experts」で提案された抽象的なアイデアを、実際に動作するMQL5コードに落とし込む方法を順を追って解説しました。 具体的には、2つの射影を組み合わせて生データを隠れベクトルに変換するCNeuronSwiGLUOCLモジュールを作成しました。
第2回では、MoEの仕組みに焦点を当て、これをCNeuronTimeMoESparseExpertsという単一のモジュールとして実装しました。このモジュールでは、個別のデータ処理経路と共有のデータ処理経路に加え、Top-Kルーターと共有エキスパート用のシグモイドゲートを組み合わせています。
今回は、これらすべての要素を統合して完全なモデルを構築し、その学習環境を設定します。 最後に、学習済みモデルを実際の過去データを使って検証します。
Attentionモジュール
モデル全体のアーキテクチャを構築する前に、小さな変更を1つ加える必要があります。これは小規模ながら、非常に重要な変更です。具体的には、Transformerアーキテクチャにおける標準のFeedForwardブロックを、先ほど作成したスパースMoEモジュールに置き換えます。 ここで改めて確認しておくと、Time-MoEは、Decoder-Onlyアーキテクチャに基づいており、Cross-Attentionが重要な役割を果たします。これにより、Decoderはコンテキスト層からの情報を考慮できるようになります。
この実装では、既存のCross-AttentionコンポーネントであるCNeuronCrossDMHAttentionを基底クラスとして使用します。このクラスには、必要なメカニズムがすべて備わっています。 私たちがおこなう作業は、FeedForwardブロックをCNeuronTimeMoESparseExpertsの呼び出しに置き換えるだけです。 新しいCNeuronTimeMoEAttentionオブジェクトの構造は以下の通りです。
class CNeuronTimeMoEAttention   :  public CNeuronCrossDMHAttention
  {
protected:
   //---
   virtual bool      feedForward(CNeuronBaseOCL *NeuronOCL) override;
   virtual bool      feedForward(CNeuronBaseOCL *NeuronOCL, CBufferFloat *SecondInput) override
                            { return        feedForward(NeuronOCL); }
   virtual bool      calcInputGradients(CNeuronBaseOCL *prevLayer) override;
   virtual bool      calcInputGradients(CNeuronBaseOCL *NeuronOCL, CBufferFloat *SecondInput,
                     CBufferFloat *SecondGradient, ENUM_ACTIVATION SecondActivation = None) override
                            { return        calcInputGradients(NeuronOCL); }
   virtual bool      updateInputWeights(CNeuronBaseOCL *NeuronOCL) override;
   virtual bool      updateInputWeights(CNeuronBaseOCL *NeuronOCL, CBufferFloat *SecondInput) override
                            { return        updateInputWeights(NeuronOCL); }

public:
                     CNeuronTimeMoEAttention(void)  {};
                    ~CNeuronTimeMoEAttention(void)  {};
   //---
   virtual bool      Init(uint numOutputs, uint myIndex, COpenCLMy *open_cl,
                          uint window, uint window_key, uint units_count,
                          uint window_cross, uint units_cross,
                          uint heads, uint layers,
                          uint experts, uint experts_dimension, uint topK,
                          ENUM_OPTIMIZATION optimization_type, uint batch);
   //---
   virtual int       Type(void) override   const   {  return defNeuronTimeMoEAttention; }
  };
CNeuronCrossDMHAttentionオブジェクトは、内部アーキテクチャを動的に構成する設計に基づいている点に注目してください。 つまり、このモジュールの主要な構成要素はクラス構造にハードコーディングされているわけではなく、初期化時に必要な数だけその都度動的に生成されるということです。 このクラス構造には、これらのオブジェクトへのポインタを格納するための動的配列のみが含まれており、これにより、コードベース全体を変更することなく、必要に応じて内部のレイアウトを文字通り再構成することが可能になります。Initメソッド内のロジックを調整するだけで十分です。
その他のメソッドは、親クラスからそのまま継承するか、あるいはごくわずかな変更を加えるだけで済みます。 このアプローチにより、最大限の柔軟性と再利用性が実現します。初期化パラメータを変更するだけで、モジュールの新しいバリエーションを簡単に作成できます。 まさにそのため、今回は初期化メソッドに注目します。Attentionモジュールの内部構造がここで構築され、MoEブロックもその中に組み込まれるからです。
bool CNeuronTimeMoEAttention::Init(uint numOutputs, uint myIndex, COpenCLMy *open_cl,
                                   uint window, uint window_key, uint units_count,
                                   uint window_cross, uint units_cross, uint heads,
                                   uint layers, uint experts, uint experts_dimension,
                                   uint topK, ENUM_OPTIMIZATION optimization_type, uint batch)
  {
   if(!CNeuronBaseOCL::Init(numOutputs, myIndex, open_cl, window * units_count,
                                                     optimization_type, batch))
      return false;
メソッド本体では、まず基底ニューラル層の同名メソッドを呼び出します。 これにより、モジュールの骨格が作成されます。 そして、ここからが興味深いところです。 内部層配列cLayersを準備し、OpenCLインターフェースに関連付けます。
cLayers.Clear();
cLayers.SetOpenCL(OpenCL);
CNeuronRelativeSelfAttention *attention = NULL;
CNeuronRelativeCrossAttention *cross = NULL;
CNeuronTimeMoESparseExperts *MoE = NULL;
bool use_self = units_count > 0;
int layer = 0;
続いて、必要なローカル変数を設定します。 これで準備段階は終了です。
次に、指定された内部層の数(layers)に従ってループ処理をおこない、1本の処理チェーンを段階的に構築していきます。 メインの情報ストリームに複数のトークンが含まれている場合は、まずSelf-Attentionモジュールを作成して初期化し、cLayersに追加します。 これにより、Decoderは外部のコンテキスト情報に切り替える前に、それまでに生成したトークンに注意を向けることができます。
for(uint i = 0; i < layers; i++)
  {
   if(use_self)
     {
      attention = new CNeuronRelativeSelfAttention();
      if(!attention ||
         !attention.Init(0, layer, OpenCL, window, window_key, units_count, heads,
                                                          optimization, iBatch) ||
         !cLayers.Add(attention)
        )
        {
         delete attention;
         return false;
        }
      layer++;
     }
次に、前の層からの情報とコンテキストを統合するCross-Attentionモジュールを作成します。 ウィンドウのパラメータとAttention Headの数を、その場で渡して初期化します。 このモジュールは直ちに動作可能な状態となり、Query、Key、Valueの計算をおこなえるようになります。 ループ内では、これらのオブジェクトへのポインタをそれぞれの層配列に格納します。これは、個々の部品をつなぎ合わせて、1本の処理チェーンを組み立てていくようなものです。
cross = new CNeuronRelativeCrossAttention();
if(!cross ||
   !cross.Init(0, layer, OpenCL, window, window_key, units_count, heads,
                     window_cross, units_cross, optimization, iBatch) ||
   !cLayers.Add(cross)
  )
  {
   delete cross;
   return false;
  }
layer++;
しかし、ここでの最大のポイントは、Cross-Attentionの直後にあります。ここで、CNeuronTimeMoESparseExpertsのインスタンスを生成します。 この部分でMoEブロックを設定します。エキスパートの数、それぞれの射影のサイズ(つまり、各エキスパートが処理する特徴量の数)、そして各処理パスで有効化するエキスパートの数を決定するtopKパラメータを指定します。 もちろん、OpenCLコンテキストとの接続も忘れてはいけません。
 MoE = new CNeuronTimeMoESparseExperts();
 if(!MoE ||
    !MoE.Init(0, layer, OpenCL, window, experts_dimension, units_count, 1,
                                   experts, topK, optimization, iBatch) ||
    !cLayers.Add(MoE)
   )
   {
    delete MoE;
    return false;
   }
 layer++;
}
すべての層に対する初期化ループが完了したら、最後の層の結果バッファを、このオブジェクトの外部インターフェースに接続します。
   SetOutput(MoE.getOutput(), true);
   SetGradient(MoE.getGradient(), true);
//---
   return true;
  }
このように、Initメソッドは、空のコンテナを、3種類の層が厳密な順序で配置された、いわば生命体のような構造へと変化させます。しかも、基盤となるアテンション機構には一切変更を加えていません。 すべての動的な構成は、新しい要素を追加し、パラメータを設定するだけで実現されています。これは、保守に必要な作業を最小限に抑えられる、柔軟なアーキテクチャの典型例です。
ただし、ここで1つ問題があります。 Cross-Attentionモジュールは、メインストリームとコンテキストストリームという2つの情報ストリームを必要とします。 しかし、Time-MoEフレームワークには情報ストリームが1つしかありません。 この問題は、基盤となる仕組みには最小限の変更を加えるだけで解決できます。 具体的には、順伝播と逆伝播のメソッドをオーバーライドし、1つの情報ストリームを入力として受け取り、それを2つの方向に振り分けるようにします。
bool CNeuronTimeMoEAttention::feedForward(CNeuronBaseOCL *NeuronOCL)
  {
   if(!NeuronOCL)
      return false;
   return CNeuronCrossDMHAttention::feedForward(NeuronOCL, NeuronOCL.getOutput());
  }
一見すると、この処理によってCross-AttentionモジュールがSelf-Attentionモジュールに変わったように見えるかもしれません。 しかし、ここでの狙いは、最新の時点に属するトークンだけをメインの情報ストリームに渡すことです。 これは、メインの情報ストリームで分析する要素数を減らすことで実現します。 一方、コンテキスト情報ストリームには情報全体を渡します。これにより、メインの情報ストリーム内のトークンは、過去の情報をすべて含むコンテキストによって、その表現を豊かにすることができます。 この仕組みによって、Decoder-OnlyのTime-MoEアーキテクチャが持つ利点はすべて維持されます。各新規トークンは、自身が担当する限定的な部分空間についてエキスパートから助言を受けると同時に、これまでに蓄積された市場の動き全体を活用できるのです。
このクラスの完全なコードとすべてのメソッドは、添付ファイルに含まれています。
モデルアーキテクチャ
必要なコンポーネントがすべて実装できたので、いよいよ学習可能なモデルの全体アーキテクチャを構築していきます。 これまでの開発と同様に、今回のプロジェクトも、強化学習のタスクで有効性が実証されているActor–Director–Criticフレームワークを基盤としています。 このフレームワークに、これまで開発してきたTime-MoE関連の機能を統合し、入力データから意味的に豊かな表現を生成するモデルの一部であるEnvironment State Encoderに組み込みます。
ただし、この段階で重要な点があります。 今回使用する全体のパイプラインでは、モデルの出力は1つだけです。それは、Actor、Director、Criticのすべてのコンポーネントで共有される汎用的な特徴ベクトルです。 一方、著者らが提案するTime-MoEアーキテクチャには、それぞれ異なる予測ホライズンを扱う複数の予測Headが含まれています。 このため、両者の間に潜在的な不整合が生じます。 すべての出力を1つのバッファにまとめてしまうと、学習が複雑になり、各出力の解釈も難しくなります。
そこで、すべてを1つの構造にまとめるのではなく、 Encoderと予測Headを明確に分離する設計を採用しました。 Encoder (Time-MoE)は、汎用的な特徴抽出機構として機能し、すべての予測Headで共有される単一のコンポーネントとなります。 その後、予測期間ごとに独立したモデルを作成します。それぞれのモデルはEncoderの出力を入力として受け取り、担当するタスクに応じた予測を生成します。
このアプローチには、明確な利点があります。情報を抽出するための学習可能なユニットを1つに保ちながら、予測をおこなう段階では独立性と柔軟性を確保できます。 各予測Headは、それぞれ異なる時間スケールを担当するため、対応する市場変動の特性に適応できます。 その結果、アーキテクチャのモジュール性と拡張性を維持しながら、時間的なコンテキストの構造にも柔軟に対応できるようになります。
フレームワーク全体の基本的な構成が決まったところで、次に学習可能なモデルのアーキテクチャを設計していきます。各サブシステムは共通の原則に従って構築されます。 これにより、構造が明確になり、トレーディングコアの要件に合わせてモデルを柔軟に拡張できるようになります。
初期化処理はすべてCreateDescriptionsメソッドでおこないます。このメソッドでは、まずEncoderから始めて、層を1つずつ組み立てながら各モデルのアーキテクチャを構築します。
bool CreateDescriptions(CArrayObj *&encoder,
                        CArrayObj *&forecast1,
                        CArrayObj *&forecast2,
                        CArrayObj *&forecast3,
                        CArrayObj *&actor,
                        CArrayObj *&director,
                        CArrayObj *&critic
                       )
  {
//---
   CLayerDescription *descr;
//---
   if(!encoder)
     {
      encoder = new CArrayObj();
      if(!encoder)
         return false;
     }
   if(!forecast1)
     {
      forecast1 = new CArrayObj();
      if(!forecast1)
         return false;
     }
   if(!forecast2)
     {
      forecast2 = new CArrayObj();
      if(!forecast2)
         return false;
     }
   if(!forecast3)
     {
      forecast3 = new CArrayObj();
      if(!forecast3)
         return false;
     }
   if(!actor)
     {
      actor = new CArrayObj();
      if(!actor)
         return false;
     }
   if(!director)
     {
      director = new CArrayObj();
      if(!director)
         return false;
     }
   if(!critic)
     {
      critic = new CArrayObj();
      if(!critic)
         return false;
     }
生の市場履歴データはEncoderに入力されます。 最初の層は単純な基盤オブジェクトで、基本的にはデータを取得するためのインターフェースとして機能します。 次に、ノイズを付加したバッチ正規化層を配置します。この層は、入力値の分布を安定させるとともに、データ拡張の役割も果たし、モデルの過学習を防ぐのに役立ちます。
//--- Encoder
   encoder.Clear();
//--- Input layer
   if(!(descr = new CLayerDescription()))
      return false;
   descr.type = defNeuronBaseOCL;
   uint prev_count = descr.count = (HistoryBars * BarDescr);
   descr.activation = None;
   descr.optimization = ADAM;
   if(!encoder.Add(descr))
     {
      delete descr;
      return false;
     }
//--- layer 1
   if(!(descr = new CLayerDescription()))
      return false;
   descr.type = defNeuronBatchNormWithNoise;
   descr.count = prev_count;
   descr.batch = BatchSize;
   descr.activation = None;
   descr.optimization = ADAM;
   if(!encoder.Add(descr))
     {
      delete descr;
      return false;
     }
次に、ConcatDiff層を使用します。この層では、各ローソク足を構成要素に分解して差分値のチャネルを追加し、より複雑な処理に対応できるようにデータ構造を整えます。
//--- layer 2
   if(!(descr = new CLayerDescription()))
      return false;
   descr.type = defNeuronConcatDiff;
   prev_count = descr.count = HistoryBars;
   descr.layers = BarDescr;
   descr.step = 1;
   descr.batch = BatchSize;
   descr.optimization = ADAM;
   descr.activation = None;
   if(!encoder.Add(descr))
     {
      delete descr;
      return false;
     }
その後、データはMamba4CastEmbeddingモジュールに入力されます。 ここでは、複数の時間スケールに対応するタグを同時に付加することで、入力シーケンスの表現を拡張します。 この仕組みにより、入力信号を複数の周波数成分から捉えた表現を得ることができます。 この層は、固定長の潜在ウィンドウ(NSkills)を出力します。その後、データは転置層を通過し、テンソルの次元が変更されます。これにより、後続の処理で各チャネルを独立した単変量シーケンスとして扱える形式になります。
//--- layer 3
   if(!(descr = new CLayerDescription()))
      return false;
   descr.type = defMamba4CastEmbeding;
   prev_count = descr.count = HistoryBars;
   descr.window = 2 * BarDescr;
   uint prev_out = descr.window_out = NSkills;
     {
      uint temp[] = {PeriodSeconds(PERIOD_H1), PeriodSeconds(PERIOD_D1)};
      if(ArrayCopy(descr.windows, temp) < (int)temp.Size())
         return false;
     }
   descr.batch = BatchSize;
   descr.optimization = ADAM;
   descr.activation = None;
   if(!encoder.Add(descr))
     {
      delete descr;
      return false;
     }
//--- layer 4
   if(!(descr = new CLayerDescription()))
      return false;
   descr.type = defNeuronTransposeOCL;
   descr.count = prev_count;
   prev_count = descr.window = prev_out;
   descr.batch = BatchSize;
   descr.optimization = ADAM;
   descr.activation = None;
   if(!encoder.Add(descr))
     {
      delete descr;
      return false;
     }
   prev_out = descr.count;
次に、SwiGLU埋め込み層が続きます。 この層は特徴量の次元数を増やし、状態を抽象的に表現するための初期的な基盤を形成します。
//--- layer 5
   if(!(descr = new CLayerDescription()))
      return false;
   descr.type = defNeuronSwiGLUOCL;
   descr.count = Segments;
   descr.window = (prev_out + Segments - 1) / Segments;
   descr.variables = prev_count;
   prev_out = descr.window_out = EmbeddingSize;
   descr.batch = BatchSize;
   descr.optimization = ADAM;
   descr.activation = None;
   if(!encoder.Add(descr))
     {
      delete descr;
      return false;
     }
   prev_count = descr.count;
   uint prev_var = descr.variables;
次に、TransposeRCDOCL転置層をを適用し、時間ステップと分析対象チャネルの次元を並べ替えます。 この操作は、作成したAttentionモジュールを正しく機能させるうえで非常に重要です。 この処理によって、分析対象となるすべての変数について、最新の時間ステップに対応するトークンがバッファの先頭に集められます。
//--- layer 6
   if(!(descr = new CLayerDescription()))
      return false;
   descr.type = defNeuronTransposeRCDOCL;
   descr.count = prev_var;
   descr.window = prev_count;
   descr.step = prev_out;
   descr.batch = BatchSize;
   descr.optimization = ADAM;
   descr.activation = None;
   if(!encoder.Add(descr))
     {
      delete descr;
      return false;
     }
//--- layer 7
   if(!(descr = new CLayerDescription()))
      return false;
   descr.type = defNeuronBatchNormOCL;
   descr.count = prev_count * prev_out * prev_var;
   descr.batch = BatchSize;
   descr.activation = None;
   descr.optimization = ADAM;
   if(!encoder.Add(descr))
     {
      delete descr;
      return false;
     }
その後にバッチ正規化層を配置します。この層は、データをAttentionモジュールに渡す前に、その分布を安定させます。
そして、いよいよ中核となるモジュールTimeMoEAttention」に到達します。 これは、多数のエキスパートを備えたMulti-Head Attentionモジュールです。各エキスパートは、それぞれ時間情報の異なる側面に着目します。 入力として受け取るのは、現在の状態を表すコンパクトなトークンと、過去の全履歴から抽出されたコンテキストです。この仕組みによって、トークンはデータから意味を抽出します。 入力の次元数とエキスパートの数(NExperts)はパラメータによって指定されます。また、各HeadはTop-K方式でエキスパートを選択し、コンパクトでありながら豊かな表現力を持つ潜在表現を形成します。 この層はEncoderの最後に位置し、以降のすべての予測モデルおよび意思決定モデルがアクセスする出力空間を定義します。
//--- layer 8
   if(!(descr = new CLayerDescription()))
      return false;
   descr.type = defNeuronTimeMoEAttention;
   descr.window_out = EmbeddingSize / 4;
     {
      uint temp[] = {prev_out, prev_out, 8, TopK};               //Window Main, Window Cross, Experts dimension, TopK
      if(ArrayCopy(descr.windows, temp) < ArraySize(temp))
         return false;
     }
     {
      uint temp[] = {prev_var, prev_var * prev_count, NExperts}; //Units Main, Units Cross, Experts
      if(ArrayCopy(descr.units, temp) < ArraySize(temp))
         return false;
     }
   descr.layers = 6;
   descr.step = 4;                                                // Attention heads
   descr.batch = BatchSize;
   descr.activation = None;
   descr.optimization = ADAM;
   if(!encoder.Add(descr))
     {
      delete descr;
      return false;
     }
Encoderの出力では、すべてのモデルからアクセスできる共有の潜在配列が形成されます。 最初の予測モデルであるforecast1は、この配列をそのまま受け取ります。 まず、基盤入力層がテンソルを受け取ります。 続いて、シンプルな畳み込み処理をおこない、分析対象となる各チャネルについて、指定された予測期間の予測を生成します。 この場合、予測するのは次の1つの値のみです。
//---
   CLayerDescription *latent = descr;
//--- Forecast 1
   forecast1.Clear();
//--- Input layer
   if(!(descr = new CLayerDescription()))
      return false;
   descr.type = defNeuronBaseOCL;
   descr.count = int(latent.windows[0] * latent.units[0]);
   descr.activation = None;
   descr.optimization = ADAM;
   if(!forecast1.Add(descr))
     {
      delete descr;
      return false;
     }
//--- layer 1
   if(!(descr = new CLayerDescription()))
      return false;
   descr.type = defNeuronConvOCL;
   descr.count = latent.units[0];
   descr.window = latent.windows[0];
   descr.step = descr.window;
   descr.layers = 1;
   descr.window_out = 1;
   descr.batch = BatchSize;
   descr.optimization = ADAM;
   descr.activation = TANH;
   if(!forecast1.Add(descr))
     {
      delete descr;
      return false;
     }
ここでは、重要な技術的詳細に注意する必要があります。 Environment State Encoderによるデータの前処理では、元の特徴量空間が意図的に拡張されていました。 この拡張は、高次の特徴量を抽出し、より表現力の高い潜在表現を形成するために必要なものです。 しかし、この変換によって、予測値と、学習フェーズで使用する実際のデータとの間に次元数の不一致が生じます。
予測結果と実際の値を正しく対応させるには、予測値を元の特徴量空間のスケールと構造に戻す必要があります。 ここでは、単純な全結合層を使用し、データの次元数を指定されたBarDescrの値まで削減することで、この処理を実現します。
//--- layer 2
   if(!(descr = new CLayerDescription()))
      return false;
   descr.type = defNeuronBaseOCL;
   descr.count = BarDescr;
   descr.activation = TANH;
   descr.optimization = ADAM;
   if(!forecast1.Add(descr))
     {
      delete descr;
      return false;
     }
ここで、もう1つ個別に取り上げておくべき点があります。それは、正規化によって失われた元のデータ分布を復元することです。 以前は、この目的のためにRevIN逆正規化層を使用していました。この層は、Encoder内の対応する層から正規化パラメータを自動的に取得します。 しかし、今回の実装ではアーキテクチャ上の制約が生じています。正規化層がEnvironment-State Encoderの内部に残っており、予測モデルから直接アクセスできないのです。 つまり、ここではRevINは機能しません。バッチ統計量にアクセスできないためです。
一見すると、解決策は逆説的に思えるかもしれません。再びバッチ正規化層を使用するのですが、今度は正規化のためではなく、元のスケールを復元するために使用します。 冗談のように聞こえるかもしれませんが、実際には十分に有効な手法です。
重要なのは、BatchNormのアーキテクチャには、学習可能な2つの出力パラメータ、スケーリング係数(scale)とオフセット(bias)があるという点です。 これらは従来、学習の安定化と高速化に使用されますが、今回は異なる役割を担います。予測値を元のデータ分布に近づける逆変換を学習するのです。 つまり、正規化統計量を保存する代わりに、モデル自身にデータの逆正規化の方法を学習させ、実際の環境に適応させます。
このアプローチには、ある種の優れた合理性があります。モデル構造をコンパクトに保ち、状態バッファを不必要に複雑化することを避けられます。さらに重要なのは、計算グラフを壊すことなく、現在の逆伝播のロジックとの完全な互換性を維持できる点です。
//--- layer 3
   if(!(descr = new CLayerDescription()))
      return false;
   descr.type = defNeuronBatchNorm;
   descr.count = BarDescr;
   descr.batch = BatchSize;
   descr.activation = None;
   descr.optimization = ADAM;
   if(!forecast1.Add(descr))
     {
      delete descr;
      return false;
     }
すべては最大限の効率を実現するように設計されています。ウィンドウは固定、層は1つ、長さも固定です。
2番目と3番目の予測モデル(forecast2、forecast3)は、最初のモデルと同じ入力データを使用します。 アーキテクチャもほぼ完全に同じですが、予測ウィンドウがより長くなっている点が異なります。 予測用畳み込み層のパラメータは最初のHeadからコピーされますが、フィルタ数は、必要な予測期間に対応する数まで拡張されます。
//--- Forecast 2
   forecast2.Clear();
//--- Input layer
   if(!forecast2.Add(forecast1.At(0)))
      return false;
//--- layer 1
   if(!(descr = new CLayerDescription()))
      return false;
   if(!descr.Copy(forecast1.At(1)))
     {
      delete descr;
      return false;
     }
   prev_out = descr.window_out = NForecast / 2;
   if(!forecast2.Add(descr))
     {
      delete descr;
      return false;
     }
   prev_count = descr.count;
予測ブロックのアーキテクチャに関して、もう1つ技術的に重要な点があります。 畳み込み層の出力では、モデルは個々の単変量時系列に対する予測値を生成します。それぞれの時系列は、特定の指標または特徴量の局所的な動きを反映しています。 そのため、予測の構造は空間的には疎ですが、豊富な情報を含んでいます。
ここで問題となるのは、これらの予測をどのように集約し、元のデータと比較可能な形式に変換するかという点です。 原理的には、従来型の全結合層を使用することもできます。情報を集約する能力は十分にあるからです。 しかし、予測期間が長くなるにつれて(それに伴い、出力シーケンスも長くなるにつれて)、この実装は効率が低下します。 パラメータ数が急激に増加し、局所的な時間依存関係も失われ始めます。
これを避けるため、まずテンソルを転置し、時間ステップが独立したチャネルとなるように軸を並べ替えます。 これにより、次の畳み込み層を各時間スライスに個別に適用できるようになります。 つまり、シーケンス全体を1つのまとまりとして処理するのではなく、それぞれの時点を、その時点固有の特徴量を通してモデルに分析させるのです。 この操作には2つの利点があります。出力表現の次元数を削減してボトルネックとして機能すると同時に、各時間ステップ間の時間的な一貫性を維持できることです。
//--- layer 2
   if(!(descr = new CLayerDescription()))
      return false;
   descr.type = defNeuronTransposeOCL;
   descr.window = prev_out;
   descr.count = prev_count;
   descr.batch = BatchSize;
   descr.optimization = ADAM;
   descr.activation = None;
   if(!forecast2.Add(descr))
     {
      delete descr;
      return false;
     }
//--- layer 3
   if(!(descr = new CLayerDescription()))
      return false;
   descr.type = defNeuronConvOCL;
   descr.window = prev_count;
   descr.step = prev_count;
   prev_count = descr.count = prev_out;
   descr.layers = 1;
   prev_out = descr.window_out = BarDescr;
   descr.batch = BatchSize;
   descr.optimization = ADAM;
   descr.activation = TANH;
   if(!forecast2.Add(descr))
     {
      delete descr;
      return false;
     }
このようにして、予測の詳細な構造を損なうことなく、効率的な集約メカニズムを実現しています。 これは、多数の特徴量を含むデータでモデルを学習させる場合や、マルチグラフ特徴量を使用する場合に特に有効です。このようなケースでは、各時間スライスが、単なる一般的なパターンに集約できない固有の情報を持っているためです。
最後に、バッチ正規化をおこない、元のデータ分布を復元して処理を完了します。
//--- layer 4
   if(!(descr = new CLayerDescription()))
      return false;
   descr.type = defNeuronBatchNormOCL;
   descr.count = prev_count * prev_out;
   descr.activation = None;
   if(!forecast2.Add(descr))
     {
      delete descr;
      return false;
     }
このモデルは、より長い予測期間を対象とする予測モデルとして機能します。同じ特徴量を使用し、より長期の予測に活用します。
3番目の予測モデルについては、そのアーキテクチャは2番目のモデルと同一です。 唯一の違いは予測期間がさらに延長されていることで、より先の未来まで予測できるようになっています。 それ以外は、同じ畳み込み層と転置層を使用し、次元数の整合や正規化についても同じロジックに従います。 したがって、同じ説明の繰り返しで議論が煩雑になるのを避けるため、ここでは詳細な説明を省略し、意思決定モデルに焦点を当てます。
次に登場するのは、戦略の実行を担うActorモデルです。 このモデルは、現在の口座状態を表す記述子を入力として受け取ります。 得られたデータには、標準的な正規化処理が適用されます。
//--- Actor
   actor.Clear();
//--- Input layer
   if(!(descr = new CLayerDescription()))
      return false;
   descr.type = defNeuronBaseOCL;
   descr.count = AccountDescr;
   descr.activation = None;
   descr.optimization = ADAM;
   if(!actor.Add(descr))
     {
      delete descr;
      return false;
     }
//--- layer 1
   if(!(descr = new CLayerDescription()))
      return false;
   descr.type = defNeuronBatchNormOCL;
   descr.count = AccountDescr;
   descr.batch = BatchSize;
   descr.activation = None;
   descr.optimization = ADAM;
   if(!actor.Add(descr))
     {
      delete descr;
      return false;
     }
次に、これらのデータはCrossDMHAttention機構に入力されます。 これはCross-Attention機構であり、メインストリームには現在の口座情報を、コンテキストにはEncoderから得られた潜在特徴量を使用します。 このアプローチにより、モデルのAttention機構は、ユーザーの現在の状況を考慮しながら、マーケット状態から最も関連性の高い特徴量を特定できます。 このブロックの内部には3層のAttention層が積み重ねられており、各層はいくつかのAttentionHeadを使用します。
//--- layer 2
   if(!(descr = new CLayerDescription()))
      return false;
   descr.type = defNeuronCrossDMHAttention;
     {
      uint temp[] = {AccountDescr,         // Inputs window
                    latent.windows[0]     // Cross window
                   };
      if(ArrayCopy(descr.windows, temp) < (int)temp.Size())
         return false;
     }
     {
      uint temp[] = {1,                 // Inputs units
                    latent.units[0]    // Cross units
                   };
      if(ArrayCopy(descr.units, temp) < (int)temp.Size())
         return false;
     }
   descr.step = 4;                  // Heads
   descr.window_out = 32;
   descr.batch = 1e4;
   descr.layers = 3;
   descr.activation = None;
   descr.optimization = ADAM;
   if(!actor.Add(descr))
     {
      delete descr;
      return false;
     }
Attention機構の後には、3層の全結合層が続きます。これらの層によって、得られたデータは行動確率(NActions)に変換されます。 この出力が、取引判断を生成する際に使用されます。
//--- layer 3
   if(!(descr = new CLayerDescription()))
      return false;
   descr.type = defNeuronBaseOCL;
   descr.count = LatentCount;
   descr.batch = BatchSize;
   descr.activation = TANH;
   descr.optimization = ADAM;
   if(!actor.Add(descr))
     {
      delete descr;
      return false;
     }
//--- layer 4
   if(!(descr = new CLayerDescription()))
      return false;
   descr.type = defNeuronBaseOCL;
   descr.count = LatentCount;
   descr.activation = SoftPlus;
   descr.batch = BatchSize;
   descr.optimization = ADAM;
   if(!actor.Add(descr))
     {
      delete descr;
      return false;
     }
//--- layer 5
   if(!(descr = new CLayerDescription()))
      return false;
   descr.type = defNeuronBaseOCL;
   prev_count = descr.count = NActions;
   descr.activation = SIGMOID;
   descr.batch = BatchSize;
   descr.optimization = ADAM;
   if(!actor.Add(descr))
     {
      delete descr;
      return false;
     }
このように、アーキテクチャ全体は、過去データの前処理から、Transformer機構やMulti-Head Attention、そして予測と意思決定に至るまで、順序立てて論理的かつモジュール的に構成されています。 このアプローチにより、透明性、信頼性、そして十分な柔軟性が確保されます。これは、アーキテクチャの分断が許されない実際の取引アプリケーションにおいて、特に重要な点です。 すべての要素が共通の潜在空間を基盤としており、各モデルは全体としての一貫性を損なうことなく、それぞれ固有のコンテキスト内で動作します。
CriticモデルとDirectorモデルのアーキテクチャは、Actorモデルと同様の構造になっています。 唯一の違いは、入力が口座の状態ではなく、Actor自身が生成した行動ベクトルであるという点です。 出力は、これらの行動に対する数値的な評価です。Criticの場合はvalue関数であり、Directorの場合は二値分類(良い行動/悪い行動)によって得られるシグナル勾配となります。 内部構造は、同じ正規化ブロック、Cross-Attention機構、および出力層のカスケードで構成されています。 すでに説明した内容の繰り返しで本文が煩雑になるのを避けるため、ここでは詳細な説明を省略します。 すべてのコンポーネントの完全なアーキテクチャは、添付ファイルに含まれています。
モデルの学習
次の作業は、モデルの学習です。 ここで、重要な課題の1つに直面します。 元のTime-MoEフレームワークの開発者たちは、膨大というよりも、途方もない規模のデータセットであるTime-300Bを使用してニューラルネットワークを学習させました。 このデータセットには、経済、エネルギー、輸送、医療など、9つの異なる分野から3000億を超える時系列データポイントが含まれています。 この膨大なデータ量によって、モデルは優れた汎化能力を獲得できます。しかし同時に、ローカル環境や半自動化された学習環境では確保できないほどのリソースが必要になります。
自宅でこのようなデータセットを再現するのは現実的ではありません。 一方、流入するデータだけを使ったオンライン学習に限定すると、安定したパターンを学習する能力を本質的に欠いたシステムになってしまいます。 これは、市場のボラティリティが高く、観測期間が限られている状況では特に顕著です。
そこで、私たちは折衷案を採用しました。事前に静的な学習データセットを収集する段階を省略する一方で、内部状態バッファにデータを段階的に蓄積して利用することで、学習プロセスの制御を維持する方法です。 ここでは、以前にTimeFoundモデルで検証したメカニズムを採用しました。このメカニズムは十分な効果が確認されていたため、今回は予測モデルだけでなく、意思決定モデルの学習にも再利用することにしました。
このメカニズムの基本は、エージェントを疑似実データで学習させることです。 実際の価格履歴は取引ターミナルから取得し、シミュレーション環境で行動を評価します。 一連の処理はEA「…\Experts\TimeMoE\Study.mq5」のTrainメソッド内に実装されています。 ここで、過去データの段階的な処理が始まり、学習バッチの形成、取引口座のコンテキストの収集、そして逆伝播によるモデルの逐次学習がおこなわれます。
最初の段階では、このメソッドが学習対象となる時間範囲を決定します。具体的には、学習に使用する過去データの開始インデックスと終了インデックスを計算します。
void Train(void)
  {
   int start = iBarShift(Symb.Name(), TimeFrame, Start);
   int end = iBarShift(Symb.Name(), TimeFrame, End);
   int bars = CopyRates(Symb.Name(), TimeFrame, 0, start, Rates);
次に、相場データが読み込まれ、主要なテクニカル指標が初期化されます。 それぞれの指標について、計算の準備が完了しているかどうかが確認されます。計算がまだ完了していない場合は、短い待機時間を挟みながら処理を待ちます。 これは、バッファを確実に初期化するために必要な処理です。そうしなければ、その後の処理をおこなっても意味がありません。
   if(!RSI.BufferResize(bars) || !CCI.BufferResize(bars) ||
      !ATR.BufferResize(bars) || !MACD.BufferResize(bars))
     {
      PrintFormat("%s -> %d", __FUNCTION__, __LINE__);
      ExpertRemove();
      return;
     }
//---
   int count = -1;
   bool calculated = false;
   do
     {
      count++;
      calculated = (RSI.BarsCalculated() >= bars &&
                    CCI.BarsCalculated() >= bars &&
                    ATR.BarsCalculated() >= bars &&
                    MACD.BarsCalculated() >= bars
                   );
      Sleep(100);
      count++;
     }
   while(!calculated && count < 100);
   if(!calculated)
     {
      PrintFormat("%s -> %d The training data has not been loaded", __FUNCTION__, __LINE__);
      ExpertRemove();
      return;
     }
   RSI.Refresh();
   CCI.Refresh();
   ATR.Refresh();
   MACD.Refresh();
//---
   if(!ArraySetAsSeries(Rates, true))
     {
      PrintFormat("%s -> %d", __FUNCTION__, __LINE__);
      ExpertRemove();
      return;
     }
   bars -= end + HistoryBars + NForecast;
   if(bars < 0)
     {
      PrintFormat("%s -> %d", __FUNCTION__, __LINE__);
      ExpertRemove();
      return;
     }
インジケーターの準備が整うと、学習用パターンの収集が始まります。 各反復で、有効なバーの範囲内からランダムに位置を選択する学習ループを設定します。 この位置が、次の学習シナリオの起点となります。 選択された位置に基づいて、次の3つの重要なベクトルが生成されます。
- bState:インジケータと価格パラメータをテンソルとして表現し、市場の状態を記述します。
- bTime:時間的なコンテキストを表します。
- Result:その後の価格変動に基づく、目標予測値を格納します。
   vector<float> result, target, neg_target;
   bool Stop = false;
//---
   uint ticks = GetTickCount();
//---
   for(int iter = 0; (iter < Iterations && !IsStopped() && !Stop); iter ++)
     {
      int posit = (int)((MathRand() * MathRand() / MathPow(32767, 2)) * bars);
      if(!CreateBuffers(posit + end, GetPointer(bState), GetPointer(bTime), Result))
        {
         PrintFormat("%s -> %d", __FUNCTION__, __LINE__);
         ExpertRemove();
         return;
        }
市場の状態に加えて、擬似口座状態も生成されます。これは、その時点におけるトレーダーの取引状況をシミュレーションしたものです。 これは、SampleAccount関数内でおこなわれ、残高、有効証拠金、ポジションサイズ、累積損益、リスクリワード比(テイクプロフィットまでのリスクとストップロスまでのリスクの比率)、さらに潜在的な季節性パターンをモデル化する正弦波信号の要素を含む特徴ベクトルを生成します。
const vector<float> account = SampleAccount(GetPointer(bState), datetime(bTime[0]));
if(!bAccount.AssignArray(account))
  {
   PrintFormat("%s -> %d", __FUNCTION__, __LINE__);
   ExpertRemove();
   return;
  }
このベクトルはActorへの入力として渡され、現在の状況に対する理解を深めます。つまり、エージェントは市場の状況だけでなく、自身の取引ポジションも考慮して意思決定をおこないます。
入力データの準備が完了すると、モデルは順伝播を実行します。Encoderが市場の状態をエンコードした後、3つのForecast[i]ブロックが、それぞれ異なる時間軸に対する予測を生成します。
//--- Feed Forward
if(!cEncoder.feedForward((CBufferFloat*)GetPointer(bState), 1, false, (CBufferFloat*)GetPointer(bTime)))
  {
   PrintFormat("%s -> %d", __FUNCTION__, __LINE__);
   Stop = true;
   break;
  }
for(uint f = 0; f < caForecast.Size(); f++)
   if(!caForecast[f].feedForward(GetPointer(cEncoder), -1, (CBufferFloat*)NULL))
     {
      PrintFormat("%s -> %d - Forecast %d", __FUNCTION__, __LINE__, f);
      Stop = true;
      break;
     }
同時に、Actorは取引判断を生成し、その判断は直ちに、独立した2つのモデルであるCriticとDirectorによって評価されます。 一方は従来のValueベースのアプローチに基づいて判断を分析し、もう一方は二値分類器として判断を評価します。これにより、適切な行動と明らかに誤った行動を区別し、明確なフィードバックを提供します。
if(!cActor.feedForward(GetPointer(bAccount), 1, false, GetPointer(cEncoder), LatentLayer))
  {
   PrintFormat("%s -> %d", __FUNCTION__, __LINE__);
   Stop = true;
   break;
  }
if(!cCritic.feedForward(GetPointer(cActor), -1, GetPointer(cEncoder), LatentLayer))
  {
   PrintFormat("%s -> %d", __FUNCTION__, __LINE__);
   Stop = true;
   break;
  }
if(!cDirector.feedForward(GetPointer(cActor), -1, GetPointer(cEncoder), LatentLayer))
  {
   PrintFormat("%s -> %d", __FUNCTION__, __LINE__);
   Stop = true;
   break;
  }
次に、逆伝播メソッドを呼び出して、モデルパラメータの最適化に進みます。 事前に準備した将来の環境状態を表すテンソルを用いて、予測モデルを学習させます。
//--- Study
for(uint f = 0; f < caForecast.Size(); f++)
   if(!caForecast[f].backProp(Result, (CBufferFloat*)NULL) ||
      !cEncoder.backPropGradient((CBufferFloat*)NULL))
     {
      PrintFormat("%s -> %d - Forecast %d", __FUNCTION__, __LINE__, f);
      Stop = true;
      break;
     }
CheckAction関数を使用して、行動の客観的な評価を取得します。 この関数は仮想ポジションのオープンをシミュレーションし、実際の過去データに基づく割引係数を考慮して、期待利益を計算します。 これらのデータに基づいて報酬が生成され、モデルにフィードバックされます。そして、この報酬を基に、Actor、Critic、Directorのすべてのコンポーネントのパラメータが再計算されます。
cActor.getResults(Action);
double equity = bAccount[2] * bAccount[0] * EtalonBalance / (1 + bAccount[1]);
double reward = CheckAction(Action, Result, equity);
Result.Clear();
if(!Result.Add(float(reward)))
  {
   PrintFormat("%s -> %d", __FUNCTION__, __LINE__);
   Stop = true;
   break;
  }
if(!cCritic.backProp(Result, GetPointer(cEncoder), LatentLayer) ||
   !cActor.backPropGradient(GetPointer(cEncoder), LatentLayer, -1, true))
  {
   PrintFormat("%s -> %d", __FUNCTION__, __LINE__);
   Stop = true;
   break;
  }
if(!Result.Update(0, float(reward > 0)))
  {
   PrintFormat("%s -> %d", __FUNCTION__, __LINE__);
   Stop = true;
   break;
  }
if(!cDirector.backProp(Result, GetPointer(cEncoder), LatentLayer) ||
   !cActor.backPropGradient(GetPointer(cEncoder), LatentLayer, -1, true))
  {
   PrintFormat("%s -> %d", __FUNCTION__, __LINE__);
   Stop = true;
   break;
  }
勾配の補正は、1回の更新処理で迅速におこなわれます。 誤差がネットワークにフィードバックされ、学習信号に従って重みが更新されます。 これにより、モデルは有用なパターンを徐々に蓄積し、新しいサンプルに基づいて自身の動作を調整できるようになります。つまり、誤りを回避し、有効なアクションを強化することを学習していきます。
学習プロセスをリアルタイムで視覚的に監視できるように、メソッドは定期的に、予測誤差やCriticの正解率といった主要な学習パラメータをチャート上のコメント欄に表示します。
 if(GetTickCount() - ticks > 500)
   {
    double percent = double(iter) * 100.0 / (Iterations);
    string str = "";
    for(uint f = 0; f < caForecast.Size(); f++)
       str += StringFormat("%-12s%d %6.2f%% -> Error %15.8f\n", "Forecast", f, percent,
                                                caForecast[f].getRecentAverageError());
    str += StringFormat("%-12s %6.2f%% -> Error %15.8f\n", "Critic", percent,
                                                      cCritic.getRecentAverageError());
    str += StringFormat("%-12s %6.2f%% -> Error %15.8f\n", "Director", percent,
                                                    cDirector.getRecentAverageError());
    Comment(str);
    ticks = GetTickCount();
   }
}
指定された反復数が完了すると、メソッドは学習結果をターミナルログに出力し、ExpertRemoveを使用してプログラムを正常に終します。
   Comment("");
//---
   for(uint f = 0; f < caForecast.Size(); f++)
      PrintFormat("%s -> %d -> %-15s%d %10.7f", __FUNCTION__, __LINE__, "Forecast", f,
                                               caForecast[f].getRecentAverageError());
   PrintFormat("%s -> %d -> %-15s %10.7f", __FUNCTION__, __LINE__, "Critic",
                                                     cCritic.getRecentAverageError());
   PrintFormat("%s -> %d -> %-15s %10.7f", __FUNCTION__, __LINE__, "Director",
                                                   cDirector.getRecentAverageError());
   ExpertRemove();
//---
  }
このように、1回の学習実行は、それぞれが過去の一定区間を再現する小規模なシミュレーションの連続で構成されます。各シミュレーションでは、市場の状態から取引結果に至るまでが再現されます。 エージェントは、成功と失敗の両方を含む直接的な経験を通じて学習し、さまざまな市場環境に徐々に適応していきます。そして、バランスの取れた評価システムと的を絞った補正によって、自身の戦略を改善していきます。
メインの学習フェーズが終了すると、モデルはオンライン学習モードによるファインチューニングに移行します。 この段階では、組み込みの MetaTrader 5ストラテジーテスターを使用します。これにより、シミュレーションを完全に制御しながら、実際の市場にできるだけ近い条件下でアルゴリズムを実行できます。 このアプローチによって、モデルの性能を評価するだけでなく、現在の市場環境に合わせて動作を適応させ、現在のボラティリティや値動きの特性に応じてパラメータを徐々に調整することも可能になります。
オンライン学習の仕組みは、以前の記事で使用したプログラムを変更せずに引き継ぐ形で実装されています。 モデルは新しいデータから学習を続け、その都度、自身のアクションを調整します。これは、市場レジームが頻繁に変化する場合に特に重要です。
テスト
モデルの学習プロセスは、2つの段階に分けて実施しました。 このアプローチにより、一貫性と信頼性を保ちながら、着実にシステムを構築することができました。
最初の段階は、オフライン学習です。 EURUSD通貨ペアの1分足(M1)の過去15年分の履歴データを使用しました。 これにより、モデルに多様な市場状況を大量に学習させることができました。 Encoderは、規則性を認識し、重要なパターンを特定するとともに、市場の状態を情報量の豊富なコンパクトな特徴ベクトルにエンコードすることを学習しました。 このベクトルは、エージェントがおこなうすべての意思決定の基盤となります。 学習中、ActorはCriticとDirectorからの信号を受け取りながら、行動戦略を学習します。
次に、オンラインでのファインチューニングをおこないます。 これはMetaTrader 5ストラテジーテスター上で実行します。 ここでは、モデルはローソク足を1本ずつ処理し、市場ノイズやランダムな変動、不安定性を含む、より現実的なモードで過去のデータと相互作用します。 これにより、実際の市場の動きに合わせてエージェントの動作を適応させ、実市場に近い条件下で戦略を調整することができます。
学習完了後、新しいデータである2025年1月の相場データを使用してモデルをテストしました。 すべての設定は事前に固定し、テスト中も変更していません。 これにより、客観的かつ透明性の高い評価が可能になります。 テストの結果を以下に示します。
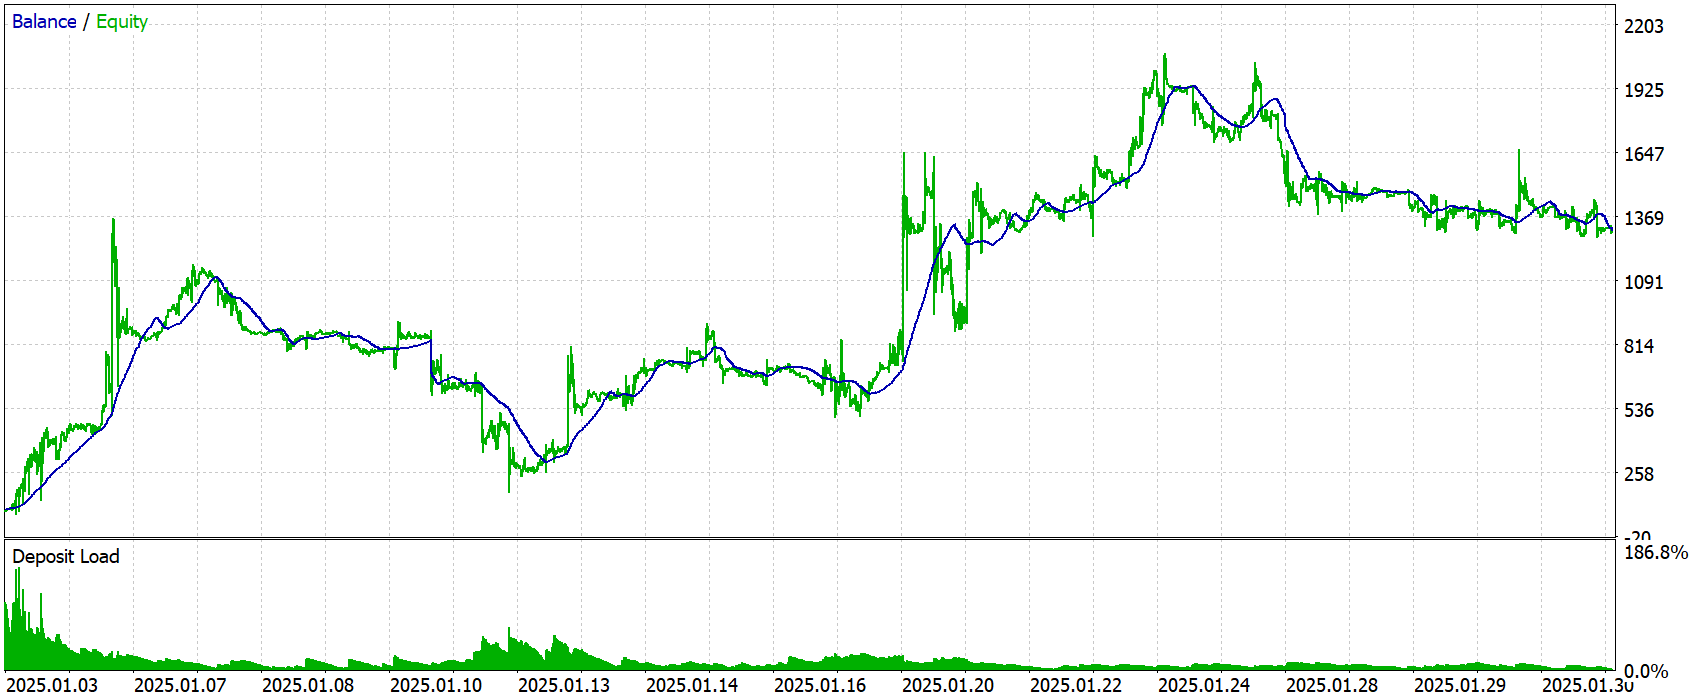
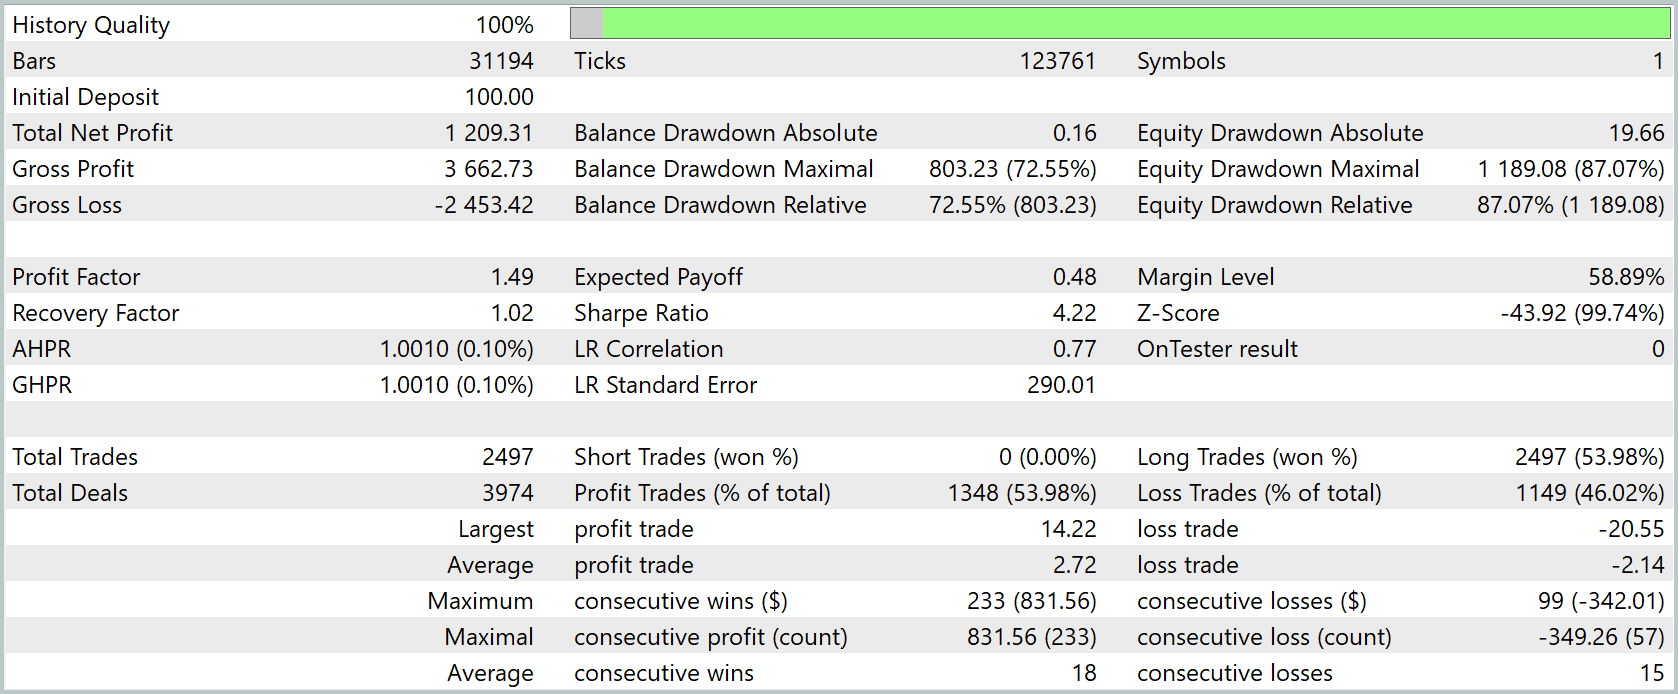
テスト結果は一概に評価できるものではなく、慎重に解釈する必要があります。 一方では、累積リターンは従来から重要な評価指標です。初期証拠金100ドルで開始したシステムは、期間終了時に1,209ドルの純利益を達成しました。 これは初期資金の約12倍に相当します。 残高曲線を見ると、月半ばまでは着実に増加し、その後は1,350~1,400ドルの水準で比較的安定しています。
しかし、極めて大きなドローダウンがすぐに目に留まります。 残高ベースの最大ドローダウンは72%を超え、有効証拠金ベースでは87%を超えました。 これは、最も厳しい取引局面において、システムが資金の大部分を失ったことを意味します。 その後に回復したとしても、この結果は、非常に高リスクな行動方針であることを示しています。
プロフィットファクターは1.49でした。これを許容可能な水準と考える人も多いでしょう。しかし、このような大きなドローダウンを考慮すると、将来発生し得る損失期間を補うには不十分と考えられます。 リカバリーファクター(純利益を最大ドローダウンで割った値)はほぼ1であり、損失からの回復が非常に遅いことを示しています。
取引統計を見ると、この1か月間に約2,500回の取引がおこなわれ、そのうち53.98%が利益を上げています。 平均利益は平均損失をわずかに上回る程度です。
全体として、これらの結果は、モデルが利益につながるシグナルを識別し、口座資金を増加させる能力を備えている一方で、その代償として非常に大きなドローダウンや長期間にわたる連続損失を伴うことを示しています。 実際の取引にこの戦略を使用するには、資金の大幅なドローダウンを抑制するための追加的な保護策が必要です。
結論
本稿では、学術論文で提唱されたTime-MoEフレームワークの主要なアイデアを段階的に実際のMQL5とOpenCLのコードに落とし込みました。 SwiGLUによる埋め込みを実装し、スパースな混合エキスパート(MoE)を構築して、Cross-Attention機構に統合しました。 また、Actor–Director–Criticアーキテクチャ内に、完全な学習パイプラインを構築しました。 明確なモジュール構造により、すべてのコンポーネントを相互に連携させながら、設定や拡張も容易におこなえるようにしました。
15年分のデータを用いた第1段階のオフライン学習により、Encoderは市場の豊かな潜在表現を形成し、ActorはCriticとDirectorの監督のもとで基本的な戦略を習得しました。 第2段階では、MetaTrader 5ストラテジーテスター上でオンラインファインチューニングをおこない、現代の市場の動向やノイズをパラメータに反映させることで、モデルを取引に対応できる状態にしました。
2025年1月の相場データを用いたテストでは、エージェントが安定した利益を生み出す能力を持つ一方で、大きなドローダウンを伴うことが明らかになりました。 この結果は、リスク管理のさらなる最適化と、取引条件の微調整が必要であることを示しています。
リンク
本記事で使用したプログラム
| # | 名前 | 種類 | 説明 |
|---|---|---|---|
| 1 | Study.mq5 | EA | モデルのオフライン学習用EA |
| 2 | StudyOnline.mq5 | EA | モデルのオンライン学習用EA |
| 3 | Test.mq5 | EA | モデルテスト用EA |
| 4 | Trajectory.mqh | クラスライブラリ | システム状態とモデルアーキテクチャを記述するための構造体 |
| 5 | NeuroNet.mqh | クラスライブラリ | ニューラルネットワークを作成するためのクラスライブラリ |
| 6 | NeuroNet.cl | ライブラリ | OpenCLプログラム用コードライブラリ |
MetaQuotes Ltdによってロシア語から翻訳されました。
元の記事: https://www.mql5.com/ru/articles/18548
警告: これらの資料についてのすべての権利はMetaQuotes Ltd.が保有しています。これらの資料の全部または一部の複製や再プリントは禁じられています。
この記事はサイトのユーザーによって執筆されたものであり、著者の個人的な見解を反映しています。MetaQuotes Ltdは、提示された情報の正確性や、記載されているソリューション、戦略、または推奨事項の使用によって生じたいかなる結果についても責任を負いません。


コードを共有していただきありがとうございます。以前からあなたの記事を拝読させていただいています。どれもごく最近の学術論文に基づいて書かれているようです。 しかし、コンパイルしようとすると、どれも構文エラーが多すぎてうまくいきません。エラーの多くは「NeuroNet.cl」に起因しているようですが、私の理解が正しければ、これは「NeuroNet.mqh」のOpenCL計算の中核となる部分ですよね。 あなたの環境では、すべてのコードがすでにコンパイルできていることは間違いないと思います。したがって、この問題は私の側のMQLのバージョンに起因しているのではないかと推測しています。あなたの環境とは異なる可能性があります。その点について、少し詳しく教えていただけませんか?よろしくお願いします!
[T]取引はロングポジションのみ[。]
個人的には、S&P 500指数のように、上昇局面が比較的安定している銘柄には、ロング専用アルゴリズムの方が適していると思います。
もちろん、EURUSDはあくまでこの記事で説明されている概念や仕組みを実証するための例に過ぎないので……