

交易中的神经网络:以分解替代模型规模扩张(SSCNN)
 55
 0

引言
时间序列预测始终是数据分析、机器学习与统计学的基础研究方向之一。它的重要性再怎么强调都不为过:从金融、气象,到城市基建与通信领域 —— 凡是涉及动态演化、需要可预测性的场景,时间序列都发挥着关键作用。然而面对开放、动态变化的复杂系统,ARIMA、指数平滑这类经典单变量模型越来越显得力不从心。
深度学习方法问世之后,局面发生了巨大转变。Transformer架构的提出带来一次尤为重大的突破:该架构不仅能够捕捉序列中复杂的成对依赖关系,还可以提取序列的多层表征。正是这些特性,让 Transformer 成为现代预测领域的核心技术之一,树立了模型精度的新标准。
在大语言模型(LLMs)飞速发展的大背景下,神经网络扩容几乎成了主流趋势。如今绝大多数顶尖模型都拥有数百万参数;预训练大语言模型的参数量更是达到数十亿级别。人们原本以为,规模扩张会带来预测效果的大幅提升。但事与愿违,精度提升幅度相当有限:以均方误差(MSE)、平均绝对误差(MAE)衡量,精度增益不超过 30%,而参数量相比简单线性模型却膨胀了数百甚至上千倍。此外,自 PatchTST 模型之后,相关研究的进展大幅放缓;后续模型仅能带来微小、边际性的性能提升。
这些现象让学界开始反思该领域的发展方向。很明显,单纯扩大模型规模并不能保证模型效果优异。在此背景下,另一条技术路线 —— 在不损失预测能力的前提下减少参数量,变得越来越有研究价值。
不过,在提出新方案之前,我们先要弄清楚:为什么现有模型在参数量削减之后效果会变差。当下大多数主流架构都会使用分块(patching)操作,也就是沿着时间或空间维度,把数据切分成片段。搭配注意力机制使用时,该方法确实可以捕捉复杂依赖关系。但它也存在弊端。分块操作会破坏时间(或空间)标识,打断观测样本之间的关联,导致模型本应捕捉的数据结构信息丢失。
为了部分弥补这种信息损失,研究人员会额外引入身份编码与位置编码,从而扩充隐特征空间。而需要保留的标识信息越多,特征空间维度就越高,随之而来的就是参数量上涨。最终,模型规模呈指数级增长。这又进一步放大过拟合风险 —— 尤其当训练数据有限时,而这正是时间序列任务的常态。
如果我们想要构建既有效又精简的模型,就必须重新思考范式:与其在隐空间里重建数据结构,不如从一开始就保留并利用数据本身蕴含的规律。近期研究表明,特征分解能够在不依赖超大模型的前提下显著提升预测精度。但该方法同样存在局限。首先,该方法在长期预测任务中的适用范围有限,尤其是在数据存在复杂时空关联时。除此之外还有理论层面的疑问:分解为什么有效、它的工作原理是什么,相比分块好在哪里?
论文《精简还是能力?分解同时兼顾二者:长期时间序列预测》的作者针对上述问题提出了全新方案 ——SSCNN 架构(基于选择性结构化分量的神经网络)。该模型兼顾预测精度、模型精简性与理论严谨性。和以往方案不同,SSCNN 首次从效率与模型精简性两个角度,对 “特征分解优于分块” 给出形式化论证。并且基础分解流程之上新增选择机制:模型可以在单个时间步粒度识别重要关联,大幅提升结构化分量的重构精度,最终改善整体预测效果。
框架作者在基准任务上完成的测试结果表明:SSCNN 的预测效果持续优于现有方法;99% 的场景下,它所需参数量少于 PatchTST或iTransformer。更亮眼的是,在长期预测任务中,SSCNN 的参数量甚至比极致轻量化的 DLinear 模型还要少 87%。
SSCNN 代表一次技术进步:它不靠堆砌算力,而是依靠对数据结构的合理利用与精细的工程设计。这套方案说明,高质量预测的关键不在于模型体量,而在于对数据规律的理解。
SSCNN 算法
多元时间序列预测问题中,给定历史观测序列X = {x1, …, xN} ∈ RN*Tin,其中 N 代表变量数量,Tin是输入序列长度;任务是预测未来长度为Tout区间内的值,记为X̂ ∈ RN*Tout。输入数据会经过预处理,用于预测尚未发生的未来值。预测过程中会生成一系列中间表征,用来刻画数据内在动态规律。
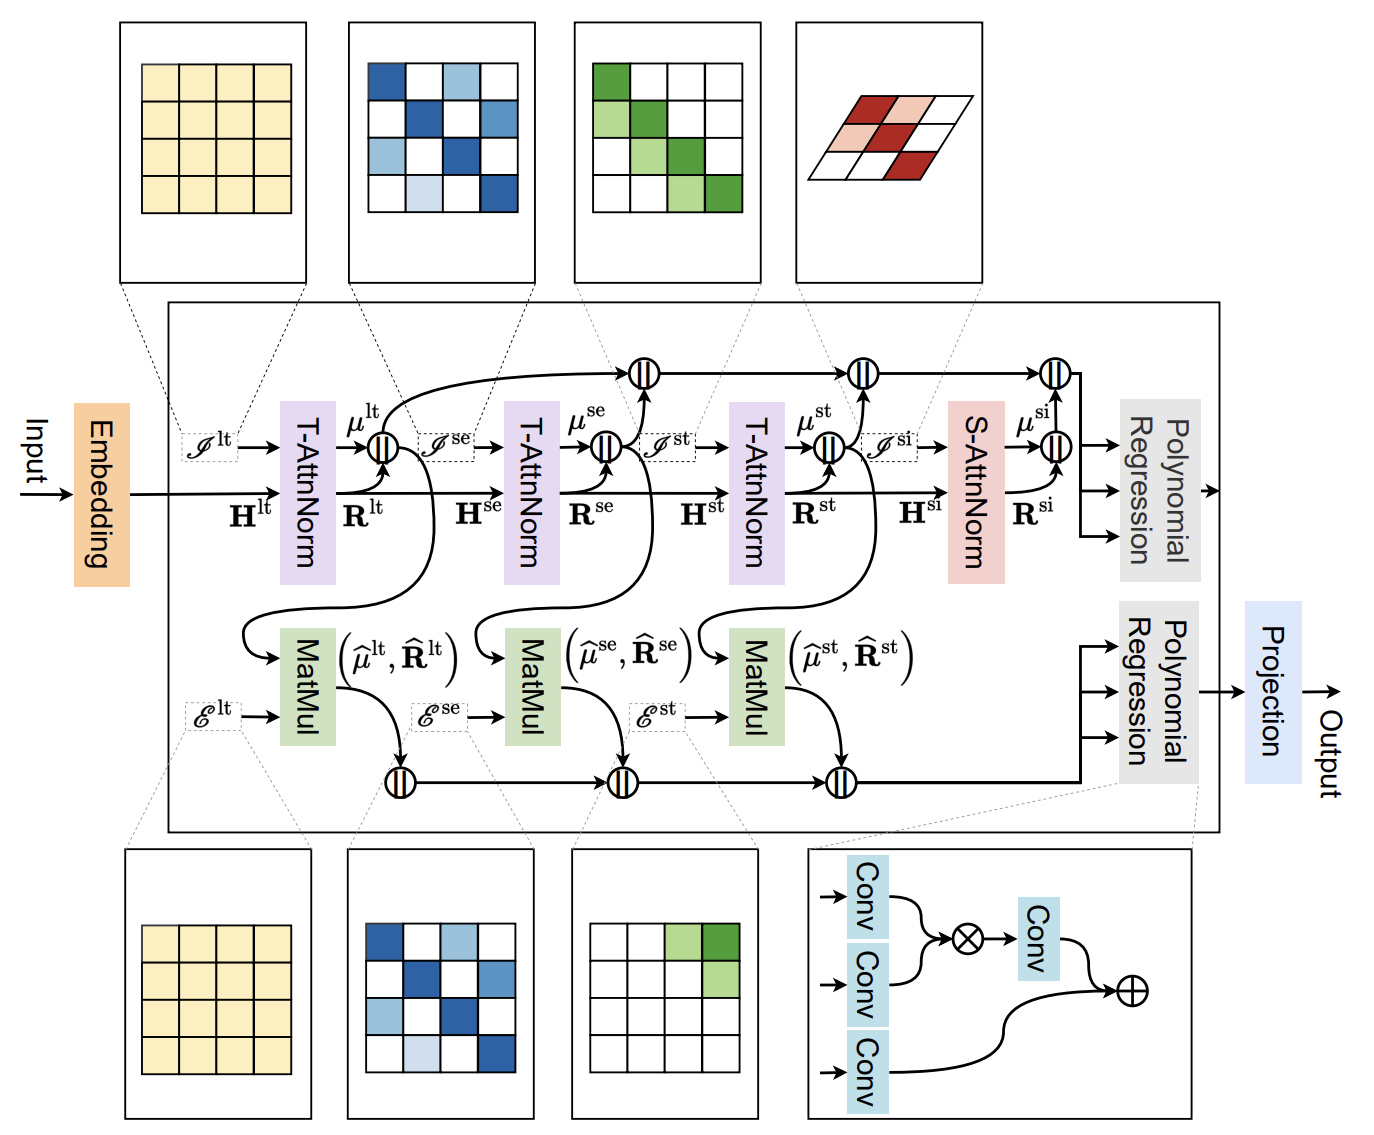
SSCNN 架构分为两个功能独立的分支。上方分支负责推理:提取时间序列里的结构化分量以及对应的残差。下方分支则专注外推,也就是预测这些分量随时间的演化方式。
提取得到的各分量与残差会拼接为一条宽向量,送入多项式回归层。该层能够捕捉元素间复杂关联,同时保留数据的结构标签信息。
SSCNN 框架作者提出一种全新归一化机制:基于时间注意力的 T-AttnNorm。借助该机制,可以逐步拆解出时间序列的核心分量:长期分量、季节分量、短期分量。对每一个变量,都会沿着时间轴单独提取上述分量。与此同时会生成注意力图(选择图),用来刻画目标分量的动态特征。
提取完某一分量后,模型会把该分量从序列总表征中分离出来,得到残差信号;残差包含了被提取分量之外的其余信息。于是,从原始时间序列表征H ∈ RN*Tin*d,拆分出两路信息:结构化分量µ ∈ RN*Tin*d和残差R ∈ RN*Tin*d。选择图I ∈ RN*Tin*Tin控制每一个分量的生成过程。
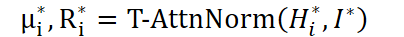
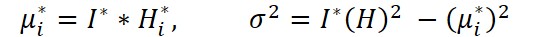
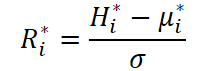
为保证归一化正确,矩阵 I* 的各行会做归一化处理,使得每一行元素之和等于 1。长期、季节、短期分量三者之间的区别,本质就在于这个矩阵的构造方式。
需要重点注意:上一步得到的残差,会作为下一个模块的输入。举例来说,想要分离季节分量,就使用剔除长期分量之后剩下的残差作为输入。
当所有结构化分量、残差信号都完成分解后,两路数据会通过矩阵 E* ∈ RN*Tin*Tout 定义的线性映射,外推到未来预测区间。和注意力图 I* 一样,矩阵 E* 同样按行归一化。
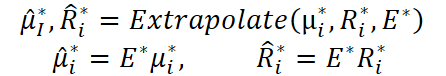
最终我们得到预测分量 ̂µ* 和 R̂* ∈ RN*Tout*d。
模型的长期分量,用于识别并刻画时间序列里持续存在的趋势。为尽可能客观地估计长期分量,框架作者会对多个周期的数据取平均。这种方式可以削弱季节性波动与短期扰动带来的影响 —— 这类扰动只具备局部效应,容易扭曲整体趋势。
长期分量的提取与外推依靠简单的常值矩阵实现:矩阵内每个元素取值均为1/Tin。这代表历史上每一个时间点,对长期趋势的贡献均等。也就是说,序列中不存在优先级更高的片段;模型依赖全局平均的走势特征。
框架作者刻意不在长期分量处理流程中加入注意力机制。大量实验表明,在他们使用的数据集上,加入注意力并不能提升预测精度。当一个分量的数据分布随时间发生显著变化时,注意力机制确实有用,可以降低估计偏差。但长期分量在整个输入区间内,分布保持稳定。因此在这个场景下使用注意力并不划算,只会徒增模型复杂度,无法带来实际收益。
模型的季节分量,用来描述按固定周期重复出现的规律性波动。季节分量提取的前提假设是周期长度稳定,这能简化季节模式识别流程。这里定义c为一个周期的长度。τin代表输入序列包含的完整周期数量(τin • c ≤ Tin);τout代表覆盖输出序列至少需要的周期数量(τout • c ≥ Tout)。为方便后续计算,我们假定输入长度Tin是周期c的整数倍。
为得到无偏、准确的季节分量估计,SSCNN 作者引入可训练参数矩阵Wse ∈ Rτin*τin,矩阵中每一个元素刻画一对周期之间的关联。该矩阵使用 SoftMax 按行归一化。在计算当前周期权重时,模型会纳入所有历史周期的贡献,从而同时捕捉局部与全局周期模式。
模型会构建一张特殊的选择图,相当于滤波器:只提取不同周期里相位相同的数据点。简单讲,只会对比每个月的同一天,或是每周的周一这类同相位样本,具体由周期尺度决定。实现方式是只选取索引差值为周期c整数倍的元素;样本属于哪一个周期,则依靠整数除法判定。
进入外推阶段,也就是预测未来时刻的季节分量时,沿用相似逻辑。引入矩阵Ŵse ∈ Rτout*τin,刻画输出周期与输入周期之间的关联。该矩阵同样经过归一化,生成外推用的选择图,保证已经识别出来的季节模式能够合理、连贯地延伸至未来。
这套设计可以让模型精准捕捉重复出现的数据结构,并以此作为预测锚点,保障季节预测具备高鲁棒性与精度。
短期分量用于捕捉落在趋势、季节模式之外的局部异常与短期效应。和趋势分量不同,短期分量依靠一个有限观测窗口δ,这个窗口决定回溯时间的深度。这类数据的有效时间很短,相关性会随滞后阶数(观测点之间的间隔)变化。
正因如此,短期分量的提取依靠参数向量 wst ∈ Rδ,窗口内不同样本被赋予不同权重。权重经过 SoftMax 归一化,在保证模型数值稳定的同时,放大重要观测样本的影响。注意力只会聚焦在时间序列最近的样本上,重点贴合预测时点附近的变化。
短期分量的预测方式,取决于预测的时间跨度。如果只预测后面少数几步,近期样本之间的相关性依然有效,会使用基于参数矩阵wst ∈ Rδ*δ的回归模型。而当预测区间拉得很远时,不确定性不断累积,预测可靠性下降。这时模型会采用补零(zero-padding)策略,主动舍弃多余参数,避免过拟合。
因此短期分量模块保持轻量化、高灵活度,精准捕捉局部波动,不会引入冗余计算与权重。这种自适应能力对不稳定、噪声较多的数据尤其重要 —— 这类场景里短期动态对预测判断至关重要。
空间分量用来刻画前面三类时序结构(长期、季节、短期分量)无法解释的序列特征。换言之,它反映了时间上不规则、但在空间维度上保持一致的特征,会在多条序列上同步显现。
空间分量依靠基于空间注意力的特殊归一化机制 S-AttnNorm 提取。时序归一化沿着时间轴运算,而该机制是逐帧、沿着空间维度处理。也就是说,在每一个时间步,模型同时分析全部时间序列的走势,提取它们的共同特征。
计算逻辑与时序归一化相近:对每一帧数据,计算均值(质心)、标准差以及残差分量。区别在于,这里的向量化操作和时间轴正交 —— 每个时间步都看作一个空间截面。
模型借助相关分析识别多条序列之间的关联,尤其是剔除主要时序结构(趋势、季节性、短期动态)之后仍然留存的关联。每一条时间序列被表示为 Tin × d 的矩阵,再做向量化。由此构建相似度矩阵Isi ∈ RN×N,刻画两两序列之间的条件相关性。即便序列的响应关系随时间不稳定,模型依旧可以识别出对外界因素反应相近的序列分组。
时序分量、空间分量全部分解完成后,模型进入聚合与解读阶段:把提取到的各个分量融合为统一表征,用于最终预测。该阶段由多项式回归层实现,它是架构的核心模块,能够建模分量之间线性与非线性交互关系。
SSCNN 框架作者在实现时大幅拓展了该模块能力:除了加法(求和)关联,还支持乘法依赖关系,可以建模分量之间更复杂的相互作用,包含二阶效应。
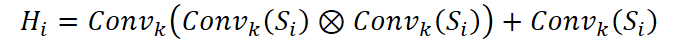
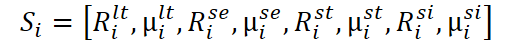
向量 Si 是前面所有分量以及对应残差的拼接结果。
这种结构让该层不仅可以对提取特征求和,还能捕捉分量之间的相互依赖与联合效应,这点在高维、互相耦合的时间序列场景中尤为关键。
处理结果Hi是融合全部关键模式后的综合表征。该表征送入下一层,开启新一轮长期分量模块Hlt i 的计算,由此形成架构闭环,保证预测动态连贯。该设计提升了模型表达能力,让模型更好适配真实市场数据 —— 在真实行情里,简单叠加各个分量往往不足以刻画规律。
下面是作者绘制的 SSCNN 框架可视化图。
在MQL5中的实现
深入理解 SSCNN 框架理论基础之后,我们进入本文实践部分。这里我们会详细讲解如何依托 MQL5 环境,实现这套方案。借此巩固前面的理论概念,并展示它在真实金融市场中的落地效果。
阅读理论部分时,你或许已经察觉到本文介绍的 SSCNN 框架,和之前讨论的 SCNN 在理念上高度相似。二者名字相近也并非巧合。两种方法都基于同一个核心思路:把时间序列拆分为独立分量,从而对数据做更精细、结构化的分析。
但二者最核心的区别,在于分量识别以及后续外推的实现思路。SCNN 使用相对传统的分解与预测手段;SSCNN 引入创新的自适应机制,例如选择性结构化分解、专用注意力图,显著提升预测精度与计算效率。
即便如此,使用固定常值矩阵提取长期分量,本质就是经典归一化 —— 在整个时间区间上做平均。这简化了开发工作,可以直接复用成熟可靠的方案,不用从零设计新逻辑。
但处理更复杂的分量,也就是季节分量和短期分量时,情况就不一样了。这部分需要更多开发工作量与精细调参。想要正确提取季节、短期分量,必须依靠自适应机制,捕捉时间序列的周期性、变异性和局部特征。其中包括构造专用注意力图、对周期之间的关联做参数化建模、刻画局部相关性。
接下来进入实现的核心环节:编写、解析 OpenCL 前向传播内核。计算底层在这里完成真正的数据处理,实现核心归一化与注意力运算;模型想要保证高精度与稳定性,离不开这些基础算子。
这个过渡是合理且必要的。我们已经知道,有序、分步拆解时间序列的长期、季节、短期分量十分重要。但想要高效、可扩展地落地这套逻辑,需要适合大规模数据并行运算的工具。OpenCL 正是这样的工具,可以灵活、高性能地调用现代 GPU 与 CPU 算力。
我们先编写 AttentNorm 内核,它是核心工作模块,负责执行注意力运算与输入数据归一化。它的任务是接收原始时序数据,用预计算好的注意力矩阵做加权,计算局部均值与标准差,接着做标准化,输出归一化后的数据。
内核参数包括待分析数据指针、注意力权重、均值与标准差数组,以及归一化结果缓存。除此之外还会传入常量:单条序列总元素数量、待处理分段长度。
__kernel void AttentNorm(__global const float* inputs,
                         __global const float* attention,
                         __global float* means,
                         __global float* stdevs,
                         __global float* outputs,
                         const int total_inputs,
                         const int segment_size
                        )
  {
   const size_t s = get_global_id(0);
   const size_t i = get_local_id(1);
   const size_t v = get_global_id(2);
   const size_t total_segments = get_global_size(0);
   const size_t total_local = get_local_size(1);
   const size_t variables = get_global_size(2);
接下来,在内核中,我们获取三维维度下当前工作项的索引。变量s代表全局分段索引,i 代表块内局部索引,v代表变量或通道的全局索引。依靠这些索引,每个线程可以精准确定自己负责处理哪一部分数据。同时程序还会获取分段总数、局部块大小以及变量数量,以此保障任务可以合理分配。
在设备高速内存中声明一个名为Temp的局部数组,用来临时存放中间计算结果。随后计算偏移量 —— 该偏移量对应当前线程、变量以及分段在源数据数组中的位置。
   __local float Temp[LOCAL_ARRAY_SIZE];
   const int shift = v * total_inputs + s * segment_size + i;
计算开始时,先初始化变量,用于保存均值、标准差以及一个会逐步累加的临时值。接着开启循环,每个局部线程按指定步长依次处理分段内的元素,以此保证并行计算、负载均匀分布。同时会做越界检查,避免出现内存访问错误。
   float mean = 0, stdev = 0;
   float val = 0;
   for(uint l = 0; l < segment_size; l += total_local)
     {
      if((l + i) >= segment_size ||
         (s * segment_size + l + i) >= total_inputs)
         break;
      float val_l = IsNaNOrInf(inputs[shift + l], 0);
      if(l == 0)
         val = val_l;
      float att = IsNaNOrInf(attention[v * segment_size + l + i], 0);
      mean += val_l * att;
      stdev += val_l * val_l * att;
     }
循环的每一轮迭代中,程序结合偏移量从源数组读取数值,并调用防护函数,将非数值、无穷这类无效值替换为 0。第一轮迭代时,会把当前数值存入单独变量,供后续使用。同理,从注意力权重数组读取对应的权重,并同样校验其有效性。
之后累加加权值之和,用于计算均值;同时累加数值加权平方和,为后续方差计算做准备。循环结束后,局部求和函数在块内所有局部线程上执行归约操作:把所有局部部分和合并为一个总和,保证统计量计算准确。为保证线程同步,这里使用屏障指令,确保所有线程都完成计算后,才继续往下执行。
   mean = LocalSum(mean, 1, Temp);
   BarrierLoc;
   stdev = LocalSum(stdev, 1, Temp);
//---
   stdev -= mean * mean;
   stdev = IsNaNOrInf(sqrt(stdev), 1);
   if(stdev <= 0)
      stdev = 1;
下一步计算方差:用平方和减去均值的平方,再开平方根得到标准差。需要重点注意:如果标准差为 0、负数或是无效值,就将其置为 1,防止后续归一化过程报错。
完成上述步骤后,由其中一个局部线程把算出的均值和标准差写入对应的输出数组,保存每个分段、每个变量的统计结果。
   if(i == 0)
     {
      int shift_ms = v * total_segments + s;
      means[shift_ms] = mean;
      stdevs[shift_ms] = stdev;
     }
随后开启另一段循环,正式执行数据归一化:每个输入值减去均值,再除以标准差,并且强制校验结果是否合法。归一化后的数值存入输出缓冲区,等待后续处理。
   for(uint l = 0; l < segment_size; l += total_local)
     {
      if((l + i) >= segment_size ||
         (s * segment_size + l + i) >= total_inputs)
         break;
      if(l > 0)
         val = inputs[shift + l];
      outputs[shift + l] = IsNaNOrInf((val - mean) / stdev, 0);
     }
  }
该内核可以在线程之间高效分配计算负载,在纳入注意力权重的前提下精准计算统计量,并完成数据归一化。这在时序预测与时序分析任务中尤为关键。借助局部内存与线程同步机制,程序兼顾高性能与计算稳定性。
除此之外,我们还需要理解这个内核算法背后一条核心假设:局部工作组的大小,等于待分析分段的长度。这不只是形式上相等,更是一条基础约束,能够简化计算逻辑,提升GPU上代码的执行效率。
当满足该条件时,用来按工作组步长遍历分段的循环实际上只需要执行一次。也就是说,每个线程恰好处理分段内的一个元素,不需要反复遍历。这种方案大幅降低内层循环复杂度,简化逻辑,最重要的是减少对全局内存的访问次数。
程序不会反复从全局缓冲区读取数据,而是在第一次读取时就把分段数值存入局部变量,之后直接从寄存器读取。性能完全不在一个量级:寄存器或者局部内存的访问速度比全局内存高出一个数量级,尤其是需要实时处理成百上千个并行分段的时候。
由此可见,合理设置工作组大小与分段长度之间的比例,已经不只是一项配置参数,而是主动的优化手段。它可以充分释放硬件加速潜力,降低额外开销,提升整套时序处理系统的效率。
尽管这套方案简洁高效,但在真实场景下,我们不能只依赖理想情况。硬件的性能上限往往不会完全符合我们的预期。不同 GPU 平台架构、可用内存、局部工作组尺寸上限、甚至驱动特性都各不相同。这就意味着,工作组尺寸和分段长度严格相等只是理想目标,而不是总能实现的条件。
这也是代码里保留循环结构的原因:用来适配不同场景,保证通用性。虽然在最优条件下循环只会跑一轮,但当硬件不支持创建指定大小的局部工作组时,循环就必不可少。它相当于一层安全兜底:如果分段长度超过硬件支持的最大工作组尺寸,循环就可以分块处理分段,保证任何场景下计算都正确。
这种效率与灵活性之间的取舍,可以在条件允许时维持高性能,同时保证在性能较弱的设备上也能正常运行。计算任务和现实世界一样,最好随时准备 B 方案,尤其是在适配兼容性有限的硬件时。
前面介绍的是前向传播流程:每个元素依据自身所在分段的均值和标准差完成归一化。接下来我们进入更微妙、同时也至关重要的部分 —— 反向传播算法。仅仅简单回传误差是不够的。我们必须意识到,每一个输出梯度都会影响输入分段里全部元素,因为均值和方差是基于整段数据统一计算得到的。这对具体实现提出了特殊要求。
为方便理解,我们来看归一化值对输入求导的表达式。
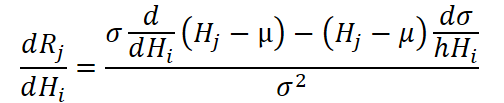
该式包含两项:一项直接和输入值的导数相关,另一项和标准差的导数相关,而标准差本身又依赖分段内所有数值。也就是说,想要算出单个元素的梯度,就不能忽略其余所有元素带来的贡献。
从数学形式上可以这样理解:每一个输出梯度都要反向映射到整个分段,而不是仅仅回传到对应的单个输入单元。所以,为了准确求出某个输入元素对应的梯度,必须遍历该分段所有输出梯度,累加每一项的贡献,同时考虑:当这个输入值发生变化时,均值和标准差会如何改变。
会出现一种特殊情况:当前输出元素索引,和我们正在求梯度的输入元素索引相同。这时梯度的传导不只是通过统计量的变化,还会直接来自该数值归一化本身的导数。而如果索引不一致,就只剩下间接影响,全部由均值和方差的变化决定。
落实到代码实现上:针对每一个输入元素,我们都需要遍历分段全部输出梯度,累加各自带来的影响。这会让内核结构变得更复杂,但可以严格贴合数学公式。这点对于神经网络模型能否正确、高效训练至关重要。
我们来看AttentNormGrad内核算法,它就是反向传播的核心。在这里,程序会计算输入数据以及注意力权重对应的梯度,计算过程会考虑归一化输出依赖整个分段所有数值这一特性。
__kernel void AttentNormGrad(__global const float* inputs,
                             __global float* inputs_gr,
                             __global const float* attention,
                             __global float* attention_gr,
                             __global const float* means,
                             __global const float* stdevs,
                             __global const float* means_gr,
                             __global const float* outputs_gr,
                             const int total_inputs,
                             const int segment_size
                            )
  {
   const size_t i = get_global_id(0);              // main
   const size_t loc = get_local_id(1);             // local to sum
   const size_t v = get_global_id(2);              // variable
   const size_t total_main = get_global_size(0);   // total
   const size_t total_loc = get_local_size(1);     // local dimension
   const size_t variables = get_global_size(2);    // total variables
在内核的起始位置,索引定义如下:
- i — 当前元素的全局 ID,
- loc — 工作组内的局部索引,
- v — 当前正在处理的变量索引。
   __local float Temp[LOCAL_ARRAY_SIZE];
//--- Input gradients
     {
      const int s = i / segment_size;
      const int shift_in = v * total_inputs + i;
      const int shift_ms = v * segment_size + s;
      float grad = 0;
      if(loc == 0 && i < total_inputs)
        {
         Temp[0] = IsNaNOrInf(inputs[shift_in], 0);
         Temp[1] = IsNaNOrInf(means[shift_ms], 0);
         Temp[2] = IsNaNOrInf(stdevs[shift_ms], 1);
         Temp[3] = IsNaNOrInf(means_gr[shift_ms], 0);
         Temp[4] = IsNaNOrInf(attention[(v - s) * segment_size + i], 0);
        }
      BarrierLoc;
随后进入内核第一部分:计算输入数据inputs对应的梯度。这里先确定元素i 所属的分段,计算所需内存偏移量;如果是局部工作组内的第一个线程(loc == 0),就把需要的数据加载进局部缓冲区:输入值本身、均值、标准差、均值梯度以及对应的注意力权重。之后设置同步屏障,保证所有线程等待数据加载完成,再安全读取数据。
接下来进入最核心的计算环节。我们遍历整个分段,分析每一个归一化输出,对目标输入元素梯度的贡献。过程中重点判断位置是否匹配:也就是该元素是否就是我们正在求导的目标元素(same标记)。如果匹配,则直接计算它的贡献;如果不匹配,则仅通过分段统计量的变化产生间接贡献。计算时会同时考虑数值与均值的偏差,以及该偏差对标准差带来的影响。所有贡献都会被累加至变量grad中。同时还要纳入跨信息流累加得到的均值梯度。
      if(i < total_inputs)
        {
         float x = Temp[0];
         float mean = Temp[1];
         float stdev = Temp[2];
         float mean_gr = Temp[3];
         float att = Temp[4];
         for(int l = 0; l < segment_size; l += total_loc)
           {
            if((l + loc) >= segment_size ||
               (i * segment_size + loc + l) >= total_inputs)
               break;
            float out_gr = IsNaNOrInf(outputs_gr[v * total_inputs + s * segment_size + loc + l], 0);
            bool same = (i - s * segment_size) == (loc + l);
            float xl = x;
            if(!same)
               xl = IsNaNOrInf(inputs[v * total_inputs + s * segment_size + loc + l], 0);
            float dy = ((int)same - att) * (1 / stdev - (xl - mean) * att * x / pow(stdev, 3.0f));
            float dmean = (same ? IsNaNOrInf(mean_gr * att, 0) : 0);
            grad += IsNaNOrInf(dy * out_gr + dmean, 0);
           }
        }
      grad = LocalSum(grad, 1, Temp);
      if(loc == 0 && i < total_inputs)
         inputs_gr[shift_in] = grad;
      BarrierLoc;
     }
累加得到的结果会在局部完成归约求和,并写入inputs_gr缓冲区。
输入数据梯度计算完毕后,进入第二部分:计算注意力权重对应的梯度。这一部分逻辑和前面是对称的:计算框架不变,但侧重点发生转移。此时,对每一个i(分段内元素),遍历全部输入数据,分析注意力权重发生变化时输出如何改变。整体结构保持一致:计算局部梯度、位置匹配判断、考虑均值与标准差变化带来的贡献。同样执行局部归约求和,最后将结果保存到attention_gr。
//--- Attention gradient
     {
      float grad = 0;
      int shift_att = v * segment_size + i;
      if(i < segment_size)
        {
         float att = IsNaNOrInf(attention[shift_att], 0);
         for(int l = 0; l < total_inputs; l += total_loc)
           {
            if((l + loc) >= total_inputs)
               break;
            int shift_out = (l + loc) + v * total_inputs;
            int s = (l + loc) / segment_size;
            int shift_in = v * total_inputs + s * segment_size + i;
            float x = IsNaNOrInf(inputs[shift_in], 0);
            float out_gr = IsNaNOrInf(outputs_gr[shift_out], 0);
            float mean = means[v * segment_size + s];
            float stdev = stdevs[v * segment_size + s];
            float mean_gr = means_gr[v * segment_size + s];
            bool same = (i - s * segment_size) == (loc + l);
            float xl = x;
            if(!same)
               xl = IsNaNOrInf(inputs[shift_out], 0);
            float dy = -x / stdev - (xl - mean) * x * x * (1 - 2 * att) / (2 * pow(stdev, 3.0f));
            float dmean = IsNaNOrInf(mean_gr * x, 0);
            grad += IsNaNOrInf(dy * out_gr + dmean, 0);
           }
        }
      grad = LocalSum(grad, 1, Temp);
      if(loc == 0 && i < segment_size)
         attention_gr[shift_att] = grad;
     }
  }
这个内核按照前面推导得到的梯度公式实现。整套代码不只是一堆指令的集合,而是一套精心组织的计算体系。每个线程都会仔细评估:单个输入或者注意力权重发生变化时,整组输出会如何变化。其中包含基于局部缓冲区的优化、精准的线程同步,以及边界条件的稳妥处理。这正是成熟工程方案该有的样子 —— 严谨、经过精细调校,同时能够适配硬件能力与数值求导的特性。
我们已经详细讲解了SSCNN 框架核心组件之一:带注意力机制的归一化模块在 OpenCL 程序中的实现。理论就此转化成可运行算法,该算法能够识别每个元素的权重,并以高阶工程所需的精度,把这种影响分配到整个数据结构中。我们看到,调优局部内存与全局内存之间的交互至关重要,适配硬件架构特性意义重大;也理解了为什么哪怕是形式上简单的归一化操作,在并行环境下也会变成一个完整复杂的计算任务。
但我们的探索还没有结束。归一化只是构成整个 SSCNN 框架的多组件机制中的一环。我们将在下一篇文章继续展开。最精彩的部分才刚刚开始。
结论
本文探讨了SSCNN 框架的理论内容,重点介绍时序结构分解、基于注意力归一化提取分量的思路。该框架作者提出了一套论证充分的架构,可以用较低的计算开销处理高维时序数据。
在本文的实践章节,我们详细研究了框架核心组件之一 ——T-AttnNorm 层的实现。重点分析前向传播、反向传播的细节,以及全局内存、局部内存之间的交互逻辑。文中梳理了算法在特殊场景下的行为特点,并给出适配 OpenCL 架构的实操说明。
我们为完整实现 SSCNN 技术栈及后续训练奠定了基础,印证了精确梯度收集与导数计算的重要性。下一篇文章,我们将继续这个主题。
参考
本文使用的程序
| # | 名称 | 类型 | 说明 |
|---|---|---|---|
| 1 | Study.mq5 | EA | 用于离线模型训练的EA |
| 2 | StudyOnline.mq5 | EA | 用于在线模型训练的EA |
| 3 | Test.mq5 | EA | 模型测试EA |
| 4 | Trajectory.mqh | 类库 | 用于描述系统状态与模型架构的结构体 |
| 5 | NeuroNet.mqh | 类库 | 用于搭建神经网络的类库 |
| 6 | NeuroNet.cl | 库文件 | OpenCL程序的代码库文件 |
本文由MetaQuotes Ltd译自俄文
原文地址: https://www.mql5.com/ru/articles/19069
注意: MetaQuotes Ltd.将保留所有关于这些材料的权利。全部或部分复制或者转载这些材料将被禁止。
本文由网站的一位用户撰写,反映了他们的个人观点。MetaQuotes Ltd 不对所提供信息的准确性负责,也不对因使用所述解决方案、策略或建议而产生的任何后果负责。

 基于平均K线(Heikin Ashi)搭建专业交易系统(第一部分):自定义指标开发
 神经网络在交易中的应用:一种端到端多变量时间序列预测模型(结论)
 从基础到中级:FileSave 和 FileLoad
 价格行为分析工具包开发(第三十八部分):基于Tick环形缓冲区的VWAP与短窗口失衡引擎
