

Neuronale Netze im Handel: Zerlegen statt Skalieren (SSCNN)
 17
 0

Einleitung
Die Zeitreihenprognose gehört nach wie vor zu den grundlegenden Bereichen der Datenanalyse, des maschinellen Lernens und der Statistik. Ihre Bedeutung kann gar nicht hoch genug eingeschätzt werden: Von der Finanzwelt über die Meteorologie bis hin zur städtischen Infrastruktur und Telekommunikation – überall dort, wo Dynamik und Vorhersagbarkeit eine Rolle spielen, sind Zeitreihen von entscheidender Bedeutung. Allerdings erweisen sich klassische univariate Modelle wie ARIMA oder exponentielle Glättungsverfahren angesichts der Komplexität offener und sich dynamisch verändernder Systeme zunehmend als unzureichend.
Mit dem Aufkommen von Deep-Learning-Methoden begann sich die Situation grundlegend zu ändern. Ein besonders bedeutender Durchbruch gelang nach der Einführung der Transformer-Architektur, die nicht nur komplexe paarweise Abhängigkeiten in Sequenzen erkennen, sondern auch deren mehrstufige Darstellungen extrahieren kann. Gerade diese Eigenschaften haben Transformer zu einer der Schlüsseltechnologien der modernen Prognose gemacht und einen neuen Maßstab für die Modellgenauigkeit gesetzt.
Vor dem Hintergrund der rasanten Entwicklung großer Sprachmodelle (LLMs) hat sich die Skalierung neuronaler Netze im Wesentlichen zum vorherrschenden Trend entwickelt. Heutzutage verfügen die allermeisten Modelle auf dem neuesten Stand der Technik über Millionen von Parametern, und bei vortrainierten LLMs beläuft sich diese Zahl sogar auf Milliarden. Man könnte meinen, dass eine solche Expansion zu einer deutlichen Ergebnisverbesserung hätte führen müssen. Entgegen den Erwartungen fielen die Verbesserungen jedoch eher bescheiden aus: Der Genauigkeitsgewinn (gemessen an MSE und MAE) liegt nicht über 30 %, während die Anzahl der Parameter im Vergleich zu einfachen linearen Modellen um das Hundert- oder Tausendfache zunimmt. Zudem haben sich die Fortschritte seit der Einführung des PatchTST-Modells drastisch verlangsamt – nachfolgende Modelle zeigen nur noch schrittweise, geringfügige Verbesserungen.
Diese Beobachtungen werfen Fragen zur Entwicklungsrichtung des Fachgebiets auf. Es liegt auf der Hand, dass die Größe eines Modells allein noch keine Garantie für hohe Qualität ist. Vor diesem Hintergrund gewinnt der gegenteilige Ansatz – die Reduzierung der Anzahl der Parameter ohne Einbußen bei der Vorhersagekraft – zunehmend an Bedeutung.
Bevor jedoch eine alternative Lösung vorgeschlagen wird, ist es wichtig zu verstehen, warum die derzeitigen Methoden bei einer Verringerung der Parameteranzahl nur eine schlechte Leistung erbringen. Die meisten modernen Architekturen nutzen das sogenannte Patching – die Aufteilung von Daten in Fragmente entlang zeitlicher oder räumlicher Dimensionen. In Verbindung mit dem Aufmerksamkeitsmechanismus ermöglicht dieser Ansatz tatsächlich die Erfassung komplexer Abhängigkeiten. Das hat jedoch auch eine Kehrseite. Patching beeinträchtigt zeitliche (oder räumliche) Kennzeichnungen, unterbricht die Verbindungen zwischen den Beobachtungen und lässt somit genau jene Struktur verschwinden, die das Modell eigentlich erfassen soll.
Um diese Verluste teilweise auszugleichen, führen die Forscher eine zusätzliche Kodierung von Identitäten und zeitlichen Positionen ein und erweitern dadurch den latenten Merkmalsraum. Je mehr dieser Identitäten jedoch erhalten bleiben müssen, desto höher ist die Dimensionalität des Raums – und damit auch die Anzahl der Parameter. Infolgedessen wächst die Modellgröße exponentiell. Dies wiederum erhöht das Risiko einer Überanpassung – insbesondere, wenn nur eine begrenzte Menge an Trainingsdaten zur Verfügung steht, was für Zeitreihenaufgaben typisch ist.
Wenn das Ziel darin besteht, ein Modell zu entwickeln, das nicht nur effektiv, sondern auch parametersparsam ist, müssen wir das Paradigma selbst überdenken: Anstatt die Struktur im latenten Raum zu rekonstruieren, ist es besser, die Regelmäßigkeiten in den Daten von Anfang an zu bewahren und zu nutzen. Jüngste Studien zeigen, dass sich die Genauigkeit durch Merkmalszerlegung erheblich verbessern lässt, ohne dass dafür große Modelle erforderlich sind. Dieser Ansatz hat jedoch auch seine Grenzen. Vor allem ist er für langfristige Prognoseaufgaben nur von begrenztem Nutzen, insbesondere wenn die Daten komplexe räumlich-zeitliche Zusammenhänge aufweisen. Darüber hinaus gibt es dabei auch einen analytischen Aspekt: Warum und wie funktioniert die Zerlegung, und inwiefern ist sie besser als Patching?
Als Reaktion auf diese Probleme haben die Autoren des Artikels „Parsimony or Capability? Decomposition Delivers Both in Long-term Time Series Forecasting“ einen neuen Ansatz vor – die Architektur SSCNN (Selective Structured Components-based Neural Network). Dieses Modell vereint Genauigkeit, Parametersparsamkeit und analytische Stringenz. Im Gegensatz zu früheren Lösungen bietet SSCNN erstmals eine formale Analyse der Vorteile der Merkmalszerlegung gegenüber dem Patching und begründet diese sowohl unter dem Gesichtspunkt der Effizienz als auch der Kompaktheit. Darüber hinaus wird die grundlegende Zerlegung hier durch einen Selektionsmechanismus ergänzt: Das Modell ist in der Lage, wichtige Zusammenhänge auf der Ebene einzelner Zeitschritte zu identifizieren, was die Genauigkeit bei der Rekonstruktion struktureller Komponenten und damit auch die Gesamtgenauigkeit der Prognose erheblich verbessert.
Die Ergebnisse der von den Autoren des Frameworks durchgeführten Tests von SSCNN anhand von Benchmark-Aufgaben zeigen, dass das Modell hinsichtlich der Prognosequalität durchweg besser abschneidet als bestehende Methoden und dabei in 99 % der Fälle weniger Parameter benötigt als die Modelle PatchTST oder iTransformer. Noch bemerkenswerter ist, dass SSCNN bei der Lösung von Langfristprognosen 87 % weniger Parameter verwendet als selbst das ultrakompakte DLinear-Modell.
SSCNN stellt einen Fortschritt dar – nicht durch eine Steigerung der Rechenleistung, sondern durch die durchdachte Nutzung der Datenstruktur und eine präzise technische Umsetzung. Diese Lösung legt nahe, dass der Weg zu einer qualitativ hochwertigen Prognose nicht in der Quantität, sondern im Verständnis liegt.
Der SSCNN-Algorithmus
Bei der Prognose multivariater Zeitreihen sind historische Beobachtungen X = {x1, …, xN} ∈ RN*Tin gegeben, wobei N die Anzahl der Variablen und Tin die Länge der zu analysierenden Sequenz ist. Die Aufgabe besteht darin, Werte für ein zukünftiges Intervall der Länge Tout zu prognostizieren, die als X̂ ∈ RN*Tout bezeichnet werden. Die Eingabedaten werden vorverarbeitet, um zukünftige, noch unbekannte Werte vorherzusagen. Im Verlauf des Prognoseprozesses entsteht eine Abfolge von Zwischenrepräsentationen, die die interne Dynamik der Daten widerspiegeln.
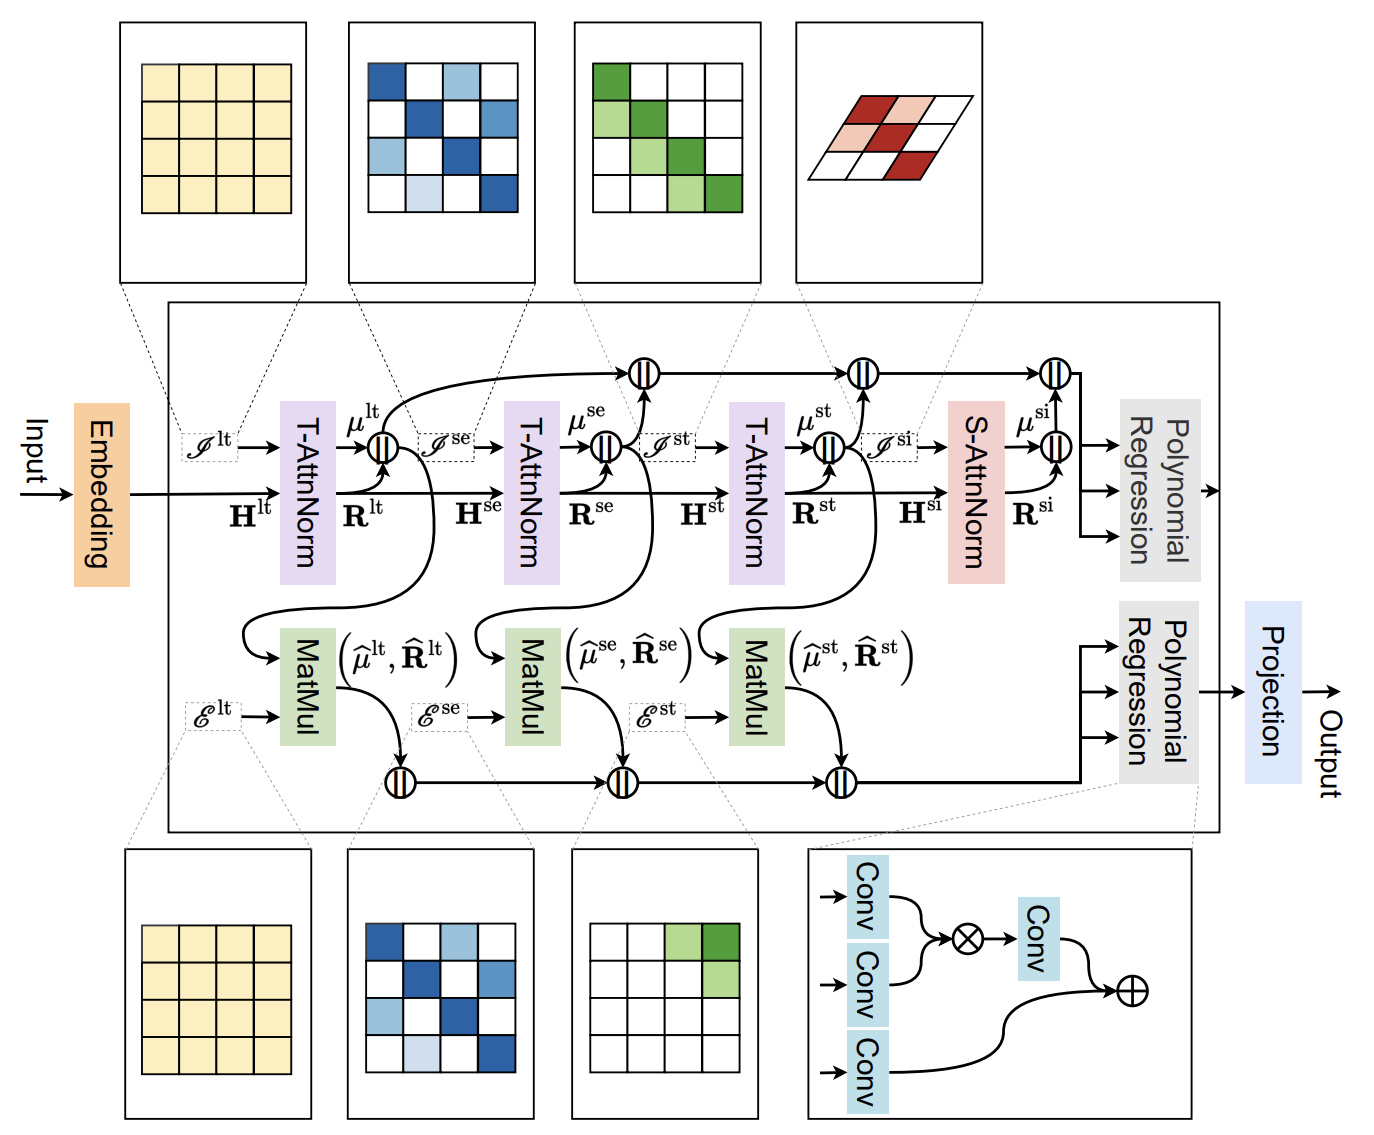
Die SSCNN-Architektur gliedert sich in zwei funktional unterschiedliche Zweige. Der obere Zweig ist für den Inferenzprozess zuständig: Er extrahiert die strukturellen Komponenten der Zeitreihe zusammen mit den entsprechenden Residuen. Der untere Zweig konzentriert sich wiederum auf die Extrapolation – das heißt darauf, vorherzusagen, wie sich diese Komponenten im Laufe der Zeit entwickeln könnten.
Die resultierenden Komponenten und Residuen werden zu einem einzigen, breiten Vektor zusammengeführt, der anschließend an die Polynomregressionsschicht weitergeleitet wird. Diese Schicht ermöglicht es, komplexe Beziehungen zwischen Elementen zu erkennen und gleichzeitig die strukturelle Kennzeichnung der Daten beizubehalten.
Die Autoren des SSCNN-Frameworks stellen einen neuen Normalisierungsmechanismus namens T-AttnNorm vor, der auf zeitlicher Aufmerksamkeit basiert. Damit lassen sich die Hauptkomponenten einer Zeitreihe Schritt für Schritt identifizieren: die Langzeitkomponente, die saisonale Komponente und die Kurzzeitkomponente. Jedes dieser Elemente wird für jede Variable entlang der Zeitachse einzeln extrahiert. Gleichzeitig wird eine Aufmerksamkeitsmatrix (Selektionsmatrix) erstellt, die die Dynamik der betreffenden Komponente widerspiegelt.
Nach der Extraktion der Komponente trennt das Modell diese von der Gesamtdarstellung der Reihe, wodurch ein Residualsignal entsteht, das die Informationen enthält, die nicht in der Struktur des extrahierten Elements enthalten sind. Aus der ursprünglichen Darstellung der Zeitreihe H ∈ RN*Tin*d ergeben sich somit zwei Datenströme: die strukturelle Komponente µ ∈ RN*Tin*d und das Residuum R ∈ RN*Tin*d. Die Selektionsmatrix I ∈ RN*Tin*Tin steuert die Bildung jeder Komponente.
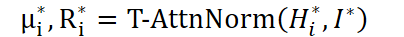
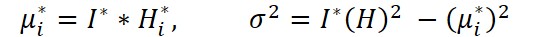
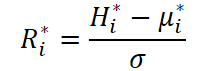
Um eine korrekte Normalisierung zu gewährleisten, werden die Zeilen der Matrix I* so normalisiert, dass die Summe jeder Zeile 1 ergibt. Der Unterschied zwischen der Langzeitkomponente, der saisonalen Komponente und der Kurzzeitkomponente liegt genau in der Art und Weise, wie diese Matrix aufgebaut ist.
Es ist wichtig zu beachten, dass das auf einer Stufe erhaltene Residuum dem Eingang des nächsten Blocks zugeführt wird. Um beispielsweise die saisonale Komponente zu isolieren, wird das Residuum, das nach dem Entfernen der Langzeitkomponente verbleibt, als Eingabe verwendet.
Nachdem jede Strukturkomponente und das Residualsignal zerlegt wurden, werden beide Datenströme mithilfe einer linearen Abbildung, die durch die Matrix E* ∈ RN*Tin*Tout definiert ist, auf den zukünftigen Zeithorizont extrapoliert. Wie die Aufmerksamkeitsmatrix I* ist auch die Matrix E* zeilenweise normalisiert.
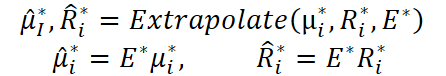
Als Ergebnis erhalten wir die vorhergesagten Komponenten ̂µ* und R̂* ∈ RN*Tout*d.
Die Langzeitkomponente des Modells dient dazu, anhaltende Trends in Zeitreihen zu erkennen und zu beschreiben. Um eine möglichst objektive Bewertung dieser Komponente zu erhalten, mitteln die Autoren des Frameworks die über mehrere saisonale Zyklen erfassten Werte. Dieser Ansatz minimiert die Auswirkungen saisonaler und kurzfristiger Schwankungen, die nur lokal zum Tragen kommen und den Gesamttrend verzerren können.
Die Mechanismen zur Isolierung und Extrapolation der Langzeitkomponente werden mithilfe einfacher Matrizen umgesetzt, deren Einträge alle gleich sind: Jede Zelle dieser Matrizen hat den Wert 1/Tin. Das bedeutet, dass jeder Zeitpunkt in der Vergangenheit gleichermaßen zum langfristigen Gesamtbild beiträgt. Somit wird keinem einzelnen Segment der Reihe Vorrang eingeräumt – im Gegenteil, das Modell stützt sich auf das globale, gemittelte Verhalten.
Die Autoren des Frameworks haben den Aufmerksamkeitsmechanismus (attention) bewusst aus der Verarbeitung der Langzeitkomponente ausgeschlossen. Die Erfahrung hat gezeigt, dass dies bei den betrachteten Datensätzen nicht zu einer Verbesserung der Prognosegenauigkeit führt. Aufmerksamkeit kann durchaus nützlich sein, wenn sich die Verteilung einer Komponente im Laufe der Zeit erheblich verändert – in solchen Fällen hilft sie, die Verzerrung der Schätzung zu verringern. Im Falle der Langzeitkomponente bleibt diese Verteilung jedoch über den gesamten Eingabezeitraum hinweg stabil. Daher ist der Einsatz von Aufmerksamkeit in diesem Zusammenhang nicht gerechtfertigt und führt lediglich zu unnötiger Komplexität, ohne einen praktischen Nutzen zu bieten.
Die saisonale Komponente des Modells dient dazu, regelmäßige Schwankungen zu beschreiben, die mit einer bestimmten Periodizität wiederkehren. Die Extraktion dieser Komponente basiert auf der Annahme einer stabilen Zykluslänge, was die Erkennung saisonaler Muster vereinfacht. Hier wird c als Bezeichnung für die Länge eines Zyklus eingeführt. Dabei bezeichnet τin die Anzahl der vollständigen Zyklen, die in der zu analysierenden Sequenz enthalten sind (τin • c ≤ Tin), während τout die Mindestanzahl an Zyklen angibt, die erforderlich sind, um die Ausgabesequenz abzudecken (τout • c ≥ Tout). Um die nachfolgenden Berechnungen zu vereinfachen, nehmen wir an, dass die Eingabelänge Tin ein Vielfaches von c ist.
Um eine genaue und unverzerrte Schätzung der saisonalen Komponente zu erhalten, führen die Autoren des SSCNN-Frameworks eine trainierbare Parametermatrix Wse ∈ Rτin*τin ein, wobei jeder Eintrag die Beziehung zwischen zwei Zyklen widerspiegelt. Diese Matrix wird mithilfe von SoftMax zeilenweise normalisiert. Bei der Berechnung der Gewichte für den aktuellen Zyklus werden somit die Beiträge aller vorangegangenen Zyklen berücksichtigt, wodurch sowohl lokale als auch globale Muster erfasst werden können.
Das Modell erstellt eine spezielle Selektionsmatrix – eine Art Filter –, mit der es ausschließlich jene Werte extrahieren kann, die identischen Phasen in verschiedenen Zyklen entsprechen. Mit anderen Worten: Je nach Zeitskala des Zyklus werden beispielsweise nur die ersten Tage jedes Monats oder nur die Montage jeder Woche verglichen. Dies wird erreicht, indem nur Elemente berücksichtigt werden, deren Indexdifferenz ein Vielfaches von c ist, während die Zugehörigkeit zu einem bestimmten Zyklus mittels ganzzahliger Division bestimmt wird.
Bei der Extrapolation – also bei der Prognose der saisonalen Komponente für zukünftige Zeitpunkte – wird eine ähnliche Logik angewendet. Es wird eine Matrix Ŵse ∈ Rτout*τin eingeführt, die die Beziehungen zwischen den Zyklen in der Ausgangs- und der Eingangssequenz widerspiegelt. Auch diese Matrix wird normalisiert und erzeugt eine Selektionsmatrix für die Extrapolation, wodurch eine logische und konsistente Fortsetzung der bereits identifizierten saisonalen Muster in die Zukunft gewährleistet wird.
Diese Vorgehensweise ermöglicht es dem Modell, wiederkehrende Datenstrukturen genau zu berücksichtigen und sie als Anker für Vorhersagen zu nutzen, wodurch eine hohe Robustheit und Genauigkeit bei saisonalen Vorhersagen gewährleistet wird.
Die Kurzzeitkomponente dient dazu, lokale Anomalien und kurzfristige Effekte zu identifizieren, die nicht durch saisonale und langfristige Muster erfasst werden. Im Gegensatz zum Trend wird sie auf der Grundlage eines begrenzten Beobachtungsfensters δ gebildet, das die Tiefe des zeitlichen Rückblicks bestimmt. Solche Daten sind nur kurzfristig relevant und weisen je nach Zeitverzögerung – also dem Abstand zwischen den Beobachtungszeitpunkten – unterschiedlich starke Korrelationen auf.
Genau aus diesem Grund basiert die Extraktion der Kurzzeitkomponente auf dem Parametervektor wst ∈ Rδ, wodurch die Werte innerhalb eines bestimmten Fensters unterschiedlich gewichtet werden können. Diese Gewichte werden einer SoftMax-Normalisierung unterzogen, die dazu beiträgt, die wichtigsten Beobachtungen hervorzuheben und zugleich die numerische Stabilität des Modells zu bewahren. Somit richtet sich die Aufmerksamkeit ausschließlich auf die jüngsten Werte der Zeitreihe und damit auf die Veränderungen, die dem Prognosezeitraum zeitlich am nächsten liegen.
Bei der Prognose der Kurzzeitkomponente hängt der Ansatz davon ab, wie weit der Zeithorizont in die Zukunft reicht. Wenn die Vorhersage die nächsten wenigen Schritte umfasst, bleiben die Korrelationen mit den jüngsten Werten erhalten, und es wird ein Regressionsmodell verwendet, das auf der Parametermatrix wst ∈ Rδ*δ basiert. Je weiter das Modell jedoch in die Zukunft blickt, desto mehr Unsicherheiten häufen sich an, wodurch die Zuverlässigkeit der Vorhersagen abnimmt. In solchen Fällen nutzt das Modell das Verfahren „Auffüllen mit Nullen“ und verwirft dabei bewusst redundante Parameter, die zu einer Überanpassung führen könnten.
Somit bleibt die Kurzzeitkomponente kompakt und flexibel und erfasst lokale Schwankungen präzise, ohne das Modell durch unnötige Berechnungen und Gewichte zu verkomplizieren. Diese Anpassungsfähigkeit ist besonders wichtig im Umgang mit instabilen oder verrauschten Daten, bei denen kurzfristige Dynamiken eine entscheidende Rolle bei der Entscheidungsfindung spielen.
Die räumliche Komponente umfasst jene Aspekte von Zeitreihen, die sich nicht anhand der zuvor identifizierten langfristigen, saisonalen und kurzfristigen zeitlichen Strukturen beschreiben lassen. Mit anderen Worten: Sie spiegelt Merkmale wider, die zeitlich unregelmäßig, räumlich jedoch konsistent sind und sich über mehrere Reihen hinweg gleichzeitig auf ähnliche Weise manifestieren.
Diese Komponente wird mithilfe eines speziellen Normalisierungsmechanismus extrahiert, der auf räumlicher Aufmerksamkeit basiert – S-AttnNorm. Im Gegensatz zur zeitlichen Normalisierung, die entlang der Zeitachse angewendet wird, erfolgt die Verarbeitung hier für jeden Zeitschritt entlang der räumlichen Dimension. Mit anderen Worten: Bei jedem Zeitschritt analysiert das Modell das Verhalten aller Zeitreihen gleichzeitig und ermittelt dabei ihre gemeinsamen Merkmale.
Die Berechnungen sind ähnlich wie bei der zeitlichen Normalisierung aufgebaut: Für jeden Zeitschritt werden der Mittelwert (Schwerpunkt), die Standardabweichung und das Residuum berechnet. Hier erfolgt die Vektorisierung jedoch orthogonal zur Zeitachse – jeder Zeitschritt wird als Querschnitt im Raum betrachtet.
Die Korrelationsanalyse dient dazu, Zusammenhänge zwischen Zeitreihen zu ermitteln, insbesondere solche, die auch nach dem Herausfiltern der wichtigsten zeitlichen Strukturen (Trend, Saisonalität und kurzfristige Dynamik) bestehen bleiben. Jede Zeitreihe wird als Tin × d-Matrix dargestellt, die anschließend vektorisiert wird. Auf diese Weise können wir eine Ähnlichkeitsmatrix Isi ∈ RN×N erstellen, die die bedingte Korrelation zwischen Paaren von Reihen widerspiegelt. Somit ist das Modell in der Lage, Gruppen von Zeitreihen zu identifizieren, die ähnlich auf externe Faktoren reagieren, obwohl diese Reaktionen zeitlich instabil sind.
Nach Abschluss der Zerlegung in zeitliche und räumliche Komponenten geht das Modell zur Aggregations- und Interpretationsphase über, in der die extrahierten Komponenten zu einer einheitlichen Darstellung für die endgültige Prognose zusammengefasst werden. Diese Stufe wird mithilfe einer Polynomregressionsschicht umgesetzt – einer Schlüsselkomponente der Architektur, die sowohl lineare als auch nichtlineare Wechselwirkungen zwischen den Komponenten ermöglicht.
Bei der Umsetzung haben die Autoren des SSCNN-Frameworks die Funktionalität des Moduls erheblich erweitert: Additive (summierende) Beziehungen werden durch multiplikative Abhängigkeiten ergänzt, wodurch sich komplexere Beziehungsformen zwischen Komponenten, einschließlich Effekten zweiter Ordnung, modellieren lassen.
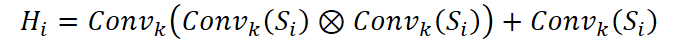
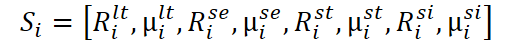
Der Vektor Si stellt die Verkettung aller zuvor ermittelten Komponenten und der dazugehörigen Residuen dar.
Diese Struktur ermöglicht es der Schicht, nicht nur die extrahierten Merkmale zu summieren, sondern auch ihre wechselseitigen Abhängigkeiten zu erkennen und ihre kombinierten Effekte zu erfassen, was insbesondere im Zusammenhang mit hochdimensionalen, miteinander in Beziehung stehenden Zeitreihen von Bedeutung ist.
Das Verarbeitungsergebnis Hi ist eine verallgemeinerte Darstellung, die bereits alle wesentlichen Muster berücksichtigt. Diese Darstellung wird an die nächste Ebene des Modells weitergeleitet; dort beginnt eine neue Iteration des Langzeitblocks Hlt i, wodurch der architektonische Zyklus geschlossen und eine kohärente Prognosedynamik gewährleistet wird. Dieser Ansatz erhöht die Ausdrucksstärke des Modells und verbessert seine Fähigkeit, präzise an reale Marktdaten angepasst zu werden, bei denen sich das bloße Addieren der Komponenten oft als unzureichend erweist.
Nachstehend ist eine vom Autor erstellte Darstellung des SSCNN-Frameworks abgebildet.
Implementierung in MQL5
Nachdem wir uns eingehend mit den theoretischen Grundlagen des SSCNN-Frameworks befasst haben, wenden wir uns nun dem praktischen Teil des Artikels zu. An dieser Stelle werden wir eine Implementierung der vorgeschlagenen Methoden unter Nutzung der Möglichkeiten der MQL5-Umgebung im Detail untersuchen. Auf diese Weise können wir diese konzeptionellen Ideen konkretisieren und ihre effektive Anwendung unter realen Finanzmarktbedingungen demonstrieren.
Beim Durcharbeiten des theoretischen Teils ist Ihnen vielleicht bereits die auffällige konzeptionelle Ähnlichkeit zwischen dem hier vorgestellten SSCNN-Framework und dem zuvor besprochenen SCNN-Ansatz aufgefallen. Diese Ähnlichkeit spiegelt sich sogar in den Namen der Frameworks wider, was kein Zufall ist. Beide Methoden basieren auf dem Ansatz, eine Zeitreihe in einzelne Komponenten zu zerlegen, was eine differenziertere und strukturiertere Analyse der Daten ermöglicht.
Der entscheidende Unterschied liegt jedoch im Vorgehen bei der Identifizierung und anschließenden Extrapolation dieser Komponenten. Während SCNN eher traditionelle Zerlegungs- und Prognosemethoden verwendet, nutzt SSCNN innovative adaptive Mechanismen wie die selektive strukturierte Zerlegung und spezielle Aufmerksamkeitsmatrizen, die die Prognosegenauigkeit und -effizienz erheblich verbessern.
Allerdings läuft die Extraktion der Langzeitkomponente mithilfe einer Matrix, die mit identischen festen Werten gefüllt ist, im Wesentlichen auf eine klassische Normalisierung hinaus – nämlich die Mittelwertbildung über das gesamte Zeitintervall. Dies vereinfacht die Aufgabe und ermöglicht es, bewährte, vorgefertigte Lösungen zu nutzen, ohne etwas Neues erfinden zu müssen.
Gleichzeitig sieht die Situation anders aus, wenn es darum geht, komplexere Komponenten zu identifizieren – nämlich die saisonale Komponente und die Kurzzeitkomponente. Dies wird erheblich mehr Aufwand und Feinabstimmung erfordern. Um diese korrekt zu extrahieren, sind adaptive Mechanismen erforderlich, die die Periodizität, die Variabilität und die lokalen Eigenschaften der Zeitreihe erfassen können. Dazu gehören die Erstellung spezieller Aufmerksamkeitsmatrizen, die Parametrisierung der Beziehungen zwischen den Perioden und die Berücksichtigung lokaler Korrelationen.
Kommen wir nun zum Kernstück der Implementierung – dem Schreiben und Analysieren des Kernels für den Vorwärtsdurchlauf in OpenCL. Genau hier, auf der unteren Ebene der Rechenarchitektur, beginnt die eigentliche Datenverarbeitung, die die grundlegenden Normalisierungs- und Aufmerksamkeitsoperationen bereitstellt, ohne die die hohe Genauigkeit und Stabilität des Modells nicht möglich wären.
Dieser Übergang ist logisch und notwendig. Wir wissen bereits, wie wichtig es ist, die Langzeitkomponente, die saisonale Komponente und die Kurzzeitkomponente einer Zeitreihe sorgfältig und konsequent zu isolieren. Um diese Konzepte jedoch effizient und skalierbar umzusetzen, benötigen wir ein leistungsfähiges Werkzeug für die parallele Verarbeitung großer Datensätze. OpenCL ist genau ein solches Werkzeug, das einen flexiblen und leistungsstarken Zugriff auf die Ressourcen moderner GPUs und CPUs ermöglicht.
Zunächst erstellen wir den AttentNorm-Kernel, das zentrale Arbeitsmodul, das für die Anwendung von Aufmerksamkeitsmechanismen und die Normalisierung der Eingabedaten zuständig ist. Seine Aufgabe besteht darin, rohe Zeitreihendaten zu übernehmen, diese anhand einer vorab berechneten Aufmerksamkeitsmatrix zu gewichten, lokale Mittelwerte und Standardabweichungen zu berechnen und anschließend eine Standardisierung durchzuführen, um die Daten in eine normalisierte Form zu bringen.
Die Kernel-Parameter umfassen Zeiger auf die zu analysierenden Daten, Aufmerksamkeitsgewichte, Arrays für Mittelwerte und Standardabweichungen sowie einen Puffer zur Speicherung der normalisierten Ergebnisse. Zudem werden Konstanten übergeben: die Gesamtanzahl der Elemente in jeder Folge und die Größe des zu verarbeitenden Segments.
__kernel void AttentNorm(__global const float* inputs,
                         __global const float* attention,
                         __global float* means,
                         __global float* stdevs,
                         __global float* outputs,
                         const int total_inputs,
                         const int segment_size
                        )
  {
   const size_t s = get_global_id(0);
   const size_t i = get_local_id(1);
   const size_t v = get_global_id(2);
   const size_t total_segments = get_global_size(0);
   const size_t total_local = get_local_size(1);
   const size_t variables = get_global_size(2);
Anschließend ermitteln wir innerhalb des Kernels die Indizes der aktuellen Work-Items in drei Dimensionen. Die Variable s bezieht sich auf den globalen Segmentindex, i auf den lokalen Index innerhalb des Blocks und v auf den globalen Index der Variablen oder des Kanals. Anhand dieser Werte weiß jeder Thread genau, für welchen Datenabschnitt er zuständig ist. Die Gesamtzahl der Segmente, die lokale Blockgröße und die Anzahl der Variablen werden ebenfalls ermittelt, um eine angemessene Verteilung der Arbeit zu gewährleisten.
Im schnellen Speicher des Geräts wird ein lokales Array namens Temp deklariert, um Zwischenergebnisse vorübergehend zu speichern. Anschließend wird der Offset berechnet – der Index im Quelldaten-Array, der dem aktuellen Thread, der aktuellen Variablen und dem aktuellen Segment entspricht.
   __local float Temp[LOCAL_ARRAY_SIZE];
   const int shift = v * total_inputs + s * segment_size + i;
Zu Beginn der Berechnungen werden Variablen initialisiert, um den Mittelwert, die Standardabweichung und einen temporären Wert zu speichern, der nach und nach akkumuliert wird. Anschließend wird eine Schleife gestartet, in der jeder lokale Thread die Segmentelemente nacheinander mit einer festgelegten Schrittweite verarbeitet, wodurch Parallelität und eine gleichmäßige Verteilung der Berechnungen gewährleistet werden. Gleichzeitig wird geprüft, ob die Bereichsgrenzen eingehalten werden, um Speicherzugriffsfehler zu verhindern.
   float mean = 0, stdev = 0;
   float val = 0;
   for(uint l = 0; l < segment_size; l += total_local)
     {
      if((l + i) >= segment_size ||
         (s * segment_size + l + i) >= total_inputs)
         break;
      float val_l = IsNaNOrInf(inputs[shift + l], 0);
      if(l == 0)
         val = val_l;
      float att = IsNaNOrInf(attention[v * segment_size + l + i], 0);
      mean += val_l * att;
      stdev += val_l * val_l * att;
     }
Bei jeder Iteration der Schleife wird unter Berücksichtigung des Offsets ein Wert aus dem Quellarray abgerufen; zur Absicherung gegen ungültige Daten wird eine Funktion angewendet, die nicht-numerische oder unendliche Werte durch Null ersetzt. Bei der ersten Iteration wird der aktuelle Wert in einer separaten Variablen gespeichert, um ihn später wiederverwenden zu können. Ebenso wird das entsprechende Gewicht aus dem Array der Aufmerksamkeitsgewichte abgerufen, und auch dessen Gültigkeit wird überprüft.
Anschließend wird die Summe der gewichteten Werte gebildet, um den Mittelwert zu berechnen, ebenso wie die Summe der gewichteten Quadrate der Werte für die anschließende Berechnung der Varianz. Nachdem die Schleife abgeschlossen ist, führt die lokale Summierungsfunktion eine Reduktion über alle lokalen Threads innerhalb des Blocks durch: Alle Teilsummen werden zu einer einzigen Gesamtsumme zusammengefasst, wodurch eine genaue Berechnung der Statistiken gewährleistet wird. Um eine korrekte Synchronisation der Threads zu gewährleisten, wird eine Synchronisationsbarriere eingesetzt, die sicherstellt, dass alle Threads ihre Berechnungen abgeschlossen haben, bevor die Ausführung fortgesetzt wird.
   mean = LocalSum(mean, 1, Temp);
   BarrierLoc;
   stdev = LocalSum(stdev, 1, Temp);
//---
   stdev -= mean * mean;
   stdev = IsNaNOrInf(sqrt(stdev), 1);
   if(stdev <= 0)
      stdev = 1;
Der nächste Schritt besteht darin, die Varianz zu berechnen, indem man das Quadrat des Mittelwerts von der Summe der Quadrate abzieht, und anschließend die Quadratwurzel zu ziehen, um die Standardabweichung zu erhalten. Es ist wichtig zu beachten, dass die Standardabweichung, falls sie null, negativ oder ungültig ist, durch eins ersetzt wird, um Fehler bei der anschließenden Normalisierung zu vermeiden.
Anschließend schreibt eines der Work-Items der lokalen Work-Group den berechneten Mittelwert und die Standardabweichung in die entsprechenden Ausgabe-Arrays und stellt so sicher, dass die Ergebnisse für jedes Segment und jede Variable gespeichert werden.
   if(i == 0)
     {
      int shift_ms = v * total_segments + s;
      means[shift_ms] = mean;
      stdevs[shift_ms] = stdev;
     }
Anschließend wird eine weitere Schleife gestartet, in der die Datennormalisierung selbst stattfindet: Von jedem Eingabewert wird der Mittelwert abgezogen, und das Ergebnis wird durch die Standardabweichung geteilt, wobei zwingend überprüft wird, ob das Ergebnis gültig ist. Die normalisierten Werte werden im Ausgabepuffer gespeichert und stehen so für die weitere Verarbeitung bereit.
   for(uint l = 0; l < segment_size; l += total_local)
     {
      if((l + i) >= segment_size ||
         (s * segment_size + l + i) >= total_inputs)
         break;
      if(l > 0)
         val = inputs[shift + l];
      outputs[shift + l] = IsNaNOrInf((val - mean) / stdev, 0);
     }
  }
Dieser Kernel verteilt die Arbeitslast effizient auf die Work-Items, gewährleistet eine genaue Berechnung der Statistiken unter Berücksichtigung der Aufmerksamkeitsgewichte und normalisiert die Daten korrekt, was insbesondere bei der Arbeit mit Zeitreihen im Rahmen von Prognose- und Analyseaufgaben von großer Bedeutung ist. Die Nutzung von lokalem Speicher und Synchronisation gewährleistet hohe Leistung und numerische Stabilität.
Darüber hinaus ist es wichtig, auf eine der zentralen Annahmen hinzuweisen, die dem Algorithmus dieses Kernels zugrunde liegen. Konkret wird davon ausgegangen, dass die Größe der lokalen Work-Group der Größe des zu analysierenden Segments entspricht. Dies ist nicht nur eine formale Gleichheit, sondern eine grundlegende Voraussetzung, die die Rechenlogik vereinfacht und die Effizienz der Codeausführung auf der GPU verbessert.
Ist diese Bedingung erfüllt, werden die Schleifen, die das Segment mit einer Schrittweite gleich der Größe der lokalen Work-Group durchlaufen sollen, praktisch auf eine einzige Iteration reduziert. Das bedeutet, dass jedes Work-Item genau ein Element seines Segments verarbeitet, ohne wiederholte Durchläufe durchzuführen. Dieser Ansatz reduziert die Komplexität interner Schleifen drastisch, vereinfacht die Logik und minimiert vor allem die Anzahl der Zugriffe auf den globalen Speicher.
Anstatt immer wieder Daten aus dem globalen Puffer auszulesen, wird jeder Segmentwert bei der ersten Gelegenheit in einer lokalen Variablen gespeichert und anschließend über ein Register abgerufen. Und das ist eine ganz andere Leistungsstufe: Der Zugriff auf ein Register oder den lokalen Speicher ist um eine Größenordnung schneller als der Zugriff auf den globalen Speicher, insbesondere wenn Hunderte oder Tausende paralleler Segmente in Echtzeit verarbeitet werden müssen.
Somit wird ein richtig gewähltes Verhältnis zwischen der Größe der Work-Group und der Segmentgröße nicht nur zu einem Konfigurationselement, sondern zu einem aktiven Optimierungsfaktor. Dadurch lässt sich das Potenzial der Hardwarebeschleunigung voll ausschöpfen, was den Overhead reduziert und die Effizienz des gesamten Systems zur Verarbeitung von Zeitreihen verbessert.
Trotz der Eleganz und Wirksamkeit des beschriebenen Ansatzes kann man sich unter realen Bedingungen jedoch nicht ausschließlich auf ideale Szenarien verlassen. Leider entsprechen die technischen Möglichkeiten der Hardware nicht immer unseren Vorstellungen. GPU-Plattformen unterscheiden sich hinsichtlich ihrer Architektur, des verfügbaren Speichers, der Größenbeschränkungen für lokale Work-Groups und sogar hinsichtlich treiberspezifischer Funktionen. All dies bedeutet, dass eine strikte Übereinstimmung zwischen der Größe der Work-Group und der Segmentlänge eher wünschenswert als garantiert ist.
Genau aus diesem Grund behalten wir die Schleife im Code bei – als Element der Anpassungsfähigkeit und Vielseitigkeit. Obwohl die Schleife im optimalen Fall nur einmal durchlaufen wird, bleibt sie für Situationen erforderlich, in denen die Hardware es nicht zulässt, eine lokale Work-Group der erforderlichen Größe festzulegen. Das ist eine Art Sicherheitsvorkehrung: Sollte das Segment mehr Elemente enthalten, als die verfügbare lokale Work-Group Work-Items umfasst, verarbeitet die Schleife es ordnungsgemäß in Teilen und gewährleistet so unter allen Umständen korrekte Berechnungen.
Dieser Kompromiss zwischen Effizienz und Flexibilität ermöglicht es, die Leistung, wo immer möglich, aufrechtzuerhalten und gleichzeitig einen einwandfreien Betrieb auch auf weniger leistungsstarken Geräten zu gewährleisten. In der Welt der Rechenaufgaben lohnt es sich, genau wie im Leben, immer einen Plan „B“ parat zu haben – insbesondere bei der Arbeit mit Hardware, die keine Kompromisse zulässt.
Nachdem wir den Vorwärtsdurchlauf beschrieben haben, bei dem jedes Element anhand des Mittelwerts und der Standardabweichung seines Segments normalisiert wird, wenden wir uns nun einem subtileren und zugleich äußerst wichtigen Teil zu – dem Algorithmus für den Rückwärtsdurchlauf. Es reicht hier nicht aus, Fehler einfach weiterzugeben. Es ist wichtig zu berücksichtigen, dass jedes Element des Ausgabegradienten alle Elemente des Eingabesegments beeinflusst, da sowohl der Mittelwert als auch die Varianz jeweils über den gesamten Datensatz berechnet werden. Dies bringt bestimmte implementierungsspezifische Anforderungen mit sich.
Um dies zu verdeutlichen, wollen wir uns kurz den Ausdruck ansehen, der die Ableitung des normalisierten Werts nach der Eingabe beschreibt.
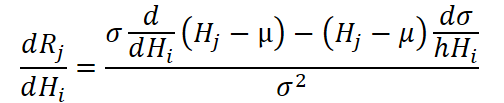
Er enthält zwei Terme: Der eine hängt direkt von der Ableitung nach dem Eingabewert ab, der andere von der Ableitung nach der Standardabweichung, die wiederum von allen Werten im Segment abhängt. Das bedeutet, dass es unmöglich ist, den Gradienten für ein einzelnes Element zu berechnen, ohne die Beiträge aller anderen Elemente zu berücksichtigen.
Formal drückt sich dies darin aus, dass jeder Ausgabegradient auf das gesamte Segment zurückprojiziert werden muss, nicht nur auf die eigene Eingabe-„Zelle“. Um den Gradienten bezüglich eines bestimmten Eingabeelements korrekt zu berechnen, ist es daher notwendig, alle Ausgabeelemente des Segments zu durchlaufen und deren Beiträge zu summieren, wobei zu berücksichtigen ist, wie sich der Mittelwert und die Standardabweichung ändern würden, wenn diese Eingabe variiert würde.
Ein Sonderfall tritt auf, wenn der Index des aktuellen Ausgabeelements mit dem Index des Eingabeelements übereinstimmt, für das wir den Gradienten berechnen. In diesem Fall breitet sich der Effekt nicht nur durch Änderungen in den statistischen Werten aus, sondern auch direkt – über die Ableitung der Normalisierung des Wertes selbst. Wenn sich die Indizes jedoch unterscheiden, bleibt nur ein indirekter Effekt bestehen, der vollständig durch Veränderungen der Mittelwerte und der Varianz bestimmt wird.
In der Implementierung bedeutet dies, dass wir für jedes Eingabeelement alle Ausgabegradienten des Segments durchlaufen und ihre jeweiligen Beiträge summieren müssen. Dieser Ansatz macht die Kernelstruktur zwar komplexer, gewährleistet jedoch eine exakte Übereinstimmung mit der mathematischen Formulierung. Dies ist besonders wichtig, wenn wir möchten, dass das neuronale Netzwerkmodell korrekt und effizient trainiert wird.
Wenn wir uns nun dem Algorithmus des Kernels AttentNormGrad zuwenden, befinden wir uns im Kern des Backpropagation-Algorithmus. An dieser Stelle werden die Gradienten bezüglich der Eingabedaten und der Aufmerksamkeitsgewichte berechnet, wobei berücksichtigt wird, wie die normalisierte Ausgabe von der Gesamtheit der Segmentwerte abhängt.
__kernel void AttentNormGrad(__global const float* inputs,
                             __global float* inputs_gr,
                             __global const float* attention,
                             __global float* attention_gr,
                             __global const float* means,
                             __global const float* stdevs,
                             __global const float* means_gr,
                             __global const float* outputs_gr,
                             const int total_inputs,
                             const int segment_size
                            )
  {
   const size_t i = get_global_id(0);              // main
   const size_t loc = get_local_id(1);             // local to sum
   const size_t v = get_global_id(2);              // variable
   const size_t total_main = get_global_size(0);   // total
   const size_t total_loc = get_local_size(1);     // local dimension
   const size_t variables = get_global_size(2);    // total variables
Zu Beginn des Kernels werden die Indizes wie folgt definiert:
- i — die globale ID des aktuellen Elements,
- loc – ein lokaler Index innerhalb der Work-Group,
- v — der Index der Variablen, mit der wir arbeiten.
   __local float Temp[LOCAL_ARRAY_SIZE];
//--- Input gradients
     {
      const int s = i / segment_size;
      const int shift_in = v * total_inputs + i;
      const int shift_ms = v * segment_size + s;
      float grad = 0;
      if(loc == 0 && i < total_inputs)
        {
         Temp[0] = IsNaNOrInf(inputs[shift_in], 0);
         Temp[1] = IsNaNOrInf(means[shift_ms], 0);
         Temp[2] = IsNaNOrInf(stdevs[shift_ms], 1);
         Temp[3] = IsNaNOrInf(means_gr[shift_ms], 0);
         Temp[4] = IsNaNOrInf(attention[(v - s) * segment_size + i], 0);
        }
      BarrierLoc;
Als Nächstes folgt der erste Teil des Kernels – die Berechnung der Gradienten bezüglich der Eingabedaten inputs. Hier ermitteln wir, zu welchem Segment das Element i gehört, berechnen die erforderlichen Speicher-Offsets und laden – sofern wir uns im ersten Work-Item innerhalb der lokalen Work-Group befinden (loc == 0) – die erforderlichen Werte in den lokalen Puffer: den Eingabewert selbst, den Mittelwert, die Standardabweichung, den Gradienten des Mittelwerts und das entsprechende Aufmerksamkeitsgewicht. Als Nächstes folgt eine Synchronisationsbarriere, um sicherzustellen, dass alle Work-Items warten, bis die Daten geladen sind, und dann sicher damit arbeiten können.
Jetzt beginnt die wichtigste Arbeit. Wir gehen das gesamte Segment durch und analysieren den Beitrag jedes normalisierten Ausgangswerts zum Gradienten des uns interessierenden Eingabewerts. Dabei wird besonders darauf geachtet, ob die Positionen übereinstimmen – das heißt, ob es sich um dasselbe Element handelt, bezüglich dessen wir den Gradienten berechnen (same). Ist dies der Fall, wird sein Beitrag direkt berechnet; andernfalls nur indirekt, über Veränderungen in den Segmentstatistiken. Dazu berücksichtigt die Berechnung sowohl die Abweichung des Wertes vom Mittelwert als auch den Einfluss des Wertes auf die Standardabweichung. All dies wird sorgfältig in der Variablen grad akkumuliert. Wir berücksichtigen zudem den Gradienten bezüglich des Mittelwerts, der über andere Informationsströme hinweg akkumuliert wurde.
      if(i < total_inputs)
        {
         float x = Temp[0];
         float mean = Temp[1];
         float stdev = Temp[2];
         float mean_gr = Temp[3];
         float att = Temp[4];
         for(int l = 0; l < segment_size; l += total_loc)
           {
            if((l + loc) >= segment_size ||
               (i * segment_size + loc + l) >= total_inputs)
               break;
            float out_gr = IsNaNOrInf(outputs_gr[v * total_inputs + s * segment_size + loc + l], 0);
            bool same = (i - s * segment_size) == (loc + l);
            float xl = x;
            if(!same)
               xl = IsNaNOrInf(inputs[v * total_inputs + s * segment_size + loc + l], 0);
            float dy = ((int)same - att) * (1 / stdev - (xl - mean) * att * x / pow(stdev, 3.0f));
            float dmean = (same ? IsNaNOrInf(mean_gr * att, 0) : 0);
            grad += IsNaNOrInf(dy * out_gr + dmean, 0);
           }
        }
      grad = LocalSum(grad, 1, Temp);
      if(loc == 0 && i < total_inputs)
         inputs_gr[shift_in] = grad;
      BarrierLoc;
     }
Die resultierenden Werte werden lokal summiert und in den Puffer inputs_gr geschrieben.
Sobald die Gradienten bezüglich der Eingabedaten berechnet sind, gehen wir zum zweiten Teil über – der Berechnung der Gradienten bezüglich der Aufmerksamkeitsgewichte. Hier ist alles spiegelbildlich: Die Logik ist dieselbe, aber der Schwerpunkt verlagert sich. Nun durchlaufen wir für jedes i (Segmentelement) alle Eingabedaten und beobachten, wie sich die Ausgabe ändert, wenn sich das Aufmerksamkeitsgewicht ändert. Der Aufbau bleibt derselbe: Berechnung des lokalen Gradienten, Überprüfung der Übereinstimmungsbedingungen und Berücksichtigung des Beitrags durch Änderungen der Standardabweichung und des Mittelwerts. Und noch einmal – eine sorgfältige lokale Summierung und Speicherung des Ergebnisses in attention_gr.
//--- Attention gradient
     {
      float grad = 0;
      int shift_att = v * segment_size + i;
      if(i < segment_size)
        {
         float att = IsNaNOrInf(attention[shift_att], 0);
         for(int l = 0; l < total_inputs; l += total_loc)
           {
            if((l + loc) >= total_inputs)
               break;
            int shift_out = (l + loc) + v * total_inputs;
            int s = (l + loc) / segment_size;
            int shift_in = v * total_inputs + s * segment_size + i;
            float x = IsNaNOrInf(inputs[shift_in], 0);
            float out_gr = IsNaNOrInf(outputs_gr[shift_out], 0);
            float mean = means[v * segment_size + s];
            float stdev = stdevs[v * segment_size + s];
            float mean_gr = means_gr[v * segment_size + s];
            bool same = (i - s * segment_size) == (loc + l);
            float xl = x;
            if(!same)
               xl = IsNaNOrInf(inputs[shift_out], 0);
            float dy = -x / stdev - (xl - mean) * x * x * (1 - 2 * att) / (2 * pow(stdev, 3.0f));
            float dmean = IsNaNOrInf(mean_gr * x, 0);
            grad += IsNaNOrInf(dy * out_gr + dmean, 0);
           }
        }
      grad = LocalSum(grad, 1, Temp);
      if(loc == 0 && i < segment_size)
         attention_gr[shift_att] = grad;
     }
  }
Unser Kernel implementiert den Gradientenausdruck gemäß der zuvor abgeleiteten Formel. Der gesamte Code ist nicht nur eine Reihe von Befehlen, sondern ein sorgfältig strukturiertes System. Jeder Thread wertet sorgfältig aus, wie sich eine Änderung jedes einzelnen Eingabewerts oder Aufmerksamkeitsgewichts auf die Ausgaben der gesamten Gruppe auswirkt. Dazu gehören die Optimierung durch lokale Puffer, präzise Synchronisation und der sorgfältige Umgang mit Randbedingungen. Genau so sieht eine echte ingenieurtechnische Lösung aus – präzise und gut abgestimmt, dabei aber an die Leistungsfähigkeit der Hardware und die Besonderheiten der numerischen Differentiation anpassbar.
Wir haben die Implementierung einer Schlüsselkomponente des SSCNN-Frameworks – des Normalisierungsmoduls mit Aufmerksamkeit – innerhalb des OpenCL-Programms eingehend untersucht. Vor unseren Augen verwandelte sich die Theorie in einen funktionierenden Algorithmus, der das Gewicht jedes einzelnen Elements berücksichtigen und diesen Einfluss mit einer Präzision über die gesamte Datenstruktur verteilen konnte, die höchsten ingenieurtechnischen Ansprüchen genügt. Wir haben gesehen, wie wichtig es ist, das Zusammenspiel zwischen lokalem und globalem Speicher fein abzustimmen, wie entscheidend es ist, die Besonderheiten der Hardwarearchitektur zu berücksichtigen, und warum selbst eine formal einfache Normalisierungsoperation in einer parallelen Umgebung zu einer vollwertigen Rechenaufgabe wird.
Unsere Reise ist jedoch noch nicht zu Ende. Die Normalisierung ist nur ein Aspekt des aus mehreren Komponenten bestehenden Mechanismus, auf dem das gesamte SSCNN-Framework basiert. Im nächsten Artikel werden wir unsere Arbeit fortsetzen. Der interessanteste Teil fängt gerade erst an.
Fazit
In diesem Artikel haben wir die theoretischen Aspekte des SSCNN-Frameworks untersucht, wobei wir einen besonderen Schwerpunkt auf das Konzept der strukturellen Zerlegung einer Zeitreihe und die Extraktion von Komponenten mittels aufmerksamkeitsbasierter Normalisierung gelegt haben. Die Autoren des Frameworks schlugen eine fundierte Architektur vor, die hochdimensionale Zeitreihen mit minimalem Rechenaufwand verarbeiten kann.
Im praktischen Teil dieses Artikels haben wir die Implementierung einer der Schlüsselkomponenten des Frameworks – der T-AttnNorm-Schicht – eingehend untersucht. Besonderes Augenmerk wurde auf die Besonderheiten der Vorwärts- und Rückwärtsdurchläufe sowie auf die Interaktion mit dem globalen und lokalen Speicher gelegt. Es wurden Feinheiten im Verhalten des Algorithmus in Sonderfällen identifiziert und praktische Hinweise zu seiner Anpassung an die OpenCL-Architektur gegeben.
Wir haben die Grundlagen für die Implementierung des gesamten SSCNN-Stacks geschaffen und eine Basis für dessen Trainierbarkeit gelegt. Dabei haben wir die Bedeutung einer präzisen Erfassung der Gradienten und Berechnung der Ableitungen bestätigt. Im nächsten Artikel werden wir unsere Reise fortsetzen.
Literaturverzeichnis
- Parsimony or Capability? Decomposition Delivers Both in Long-term Time Series Forecasting
- Weitere Artikel in dieser Reihe
In diesem Artikel verwendete Programme
| # | Name | Typ | Beschreibung |
|---|---|---|---|
| 1 | Study.mq5 | Expert Advisor | Expert Advisor für das Offline-Modelltraining |
| 2 | StudyOnline.mq5 | Expert Advisor | Expert Advisor für Online-Modelltraining |
| 3 | Test.mq5 | Expert Advisor | Expert Advisor für Modelltests |
| 4 | Trajectory.mqh | Klassenbibliothek | Struktur zur Beschreibung des Systemzustands und der Modellarchitektur |
| 5 | NeuroNet.mqh | Klassenbibliothek | Klassenbibliothek zum Erstellen eines neuronalen Netzes |
| 6 | NeuroNet.cl | Bibliothek | Codebibliothek für ein OpenCL-Programm |
Übersetzt aus dem Russischen von MetaQuotes Ltd.
Originalartikel: https://www.mql5.com/ru/articles/19069
Warnung: Alle Rechte sind von MetaQuotes Ltd. vorbehalten. Kopieren oder Vervielfältigen untersagt.
Dieser Artikel wurde von einem Nutzer der Website verfasst und gibt dessen persönliche Meinung wieder. MetaQuotes Ltd übernimmt keine Verantwortung für die Richtigkeit der dargestellten Informationen oder für Folgen, die sich aus der Anwendung der beschriebenen Lösungen, Strategien oder Empfehlungen ergeben.
 Neuronale Netze im Handel: Eine intelligente Prognosepipeline (Fazit)
 Neuronale Netze im Trading: Heterogenitätsbasiertes Lernen von Metaparametern (HimNet)
 Neuronale Netze im Handel: Zerlegen statt Skalieren – Entwicklung von Modulen
 Marktsimulation: Positionsanzeige (VII)

- Freie Handelsapplikationen
- Über 8.000 Signale zum Kopieren
- Wirtschaftsnachrichten für die Lage an den Finanzmärkte
Sie stimmen der Website-Richtlinie und den Nutzungsbedingungen zu.