

Neuronale Netze im Trading: Ein Ende-zu-Ende-Modell für multivariate Zeitreihenprognose (Kernkomponenten)
 36
 1

Einleitung
Im vorherigen Artikel haben wir uns eingehend mit dem GinAR-Framework befasst – einer modernen Architektur für die Arbeit mit Zeitreihen, die die Vorteile von Graph Neural Networks mit der Fähigkeit verbindet, mit asynchronen, unvollständigen und heterogenen Daten zu trainieren. Der Kerngedanke dieses Ansatzes besteht darin, eine Zeitreihe nicht als einfache Abfolge von Beobachtungswerten zu interpretieren, sondern als Graphstruktur, in der einzelne Variablen oder Zeitpunkte durch beliebige, erlernbare Interdependenzen miteinander verbunden werden können. Dieser Ansatz ist besonders relevant für Probleme der Finanzmodellierung, bei denen die Daten oft unregelmäßig sind, fehlende Werte enthalten und komplexe latente Beziehungen aufweisen.
GinAR wurde als vielseitiges Werkzeug zur Lösung solcher Probleme vorgeschlagen. Sein modularer Aufbau umfasst mehrere Schlüsselkomponenten:
- der Interpolation Attention-Mechanismus, der es ermöglicht, fehlende Werte durch die Aggregation von Informationen aus beobachteten Variablen zu rekonstruieren;
- Graphschichten mit individuellen trainierbaren Gewichten;
- adaptive Normalisierungsfunktionen, die das Modell robust gegenüber Ausreißern und Skaleninstabilität machen.
Der Interpolation Attention-Mechanismus spielt eine zentrale Rolle in der Architektur – es handelt sich dabei nicht um einen klassischen Self-Attention-Kernel, sondern um ein vollwertiges adaptives Modul, das sowohl globale Abhängigkeiten zwischen Variablen als auch den lokalen Kontext von Beobachtungen berücksichtigen kann. In der Praxis bedeutet dies, dass das Modell beispielsweise in der Lage ist, den Wert eines Finanzindikators zu prognostizieren – selbst wenn dessen jüngste Messwerte nicht vorliegen –, indem es die Struktur benachbarter Indikatoren und das allgemeine Marktbild heranzieht. Dieser Ansatz ist unter realen Bedingungen von entscheidender Bedeutung, da Daten dort häufig mit Verzögerungen, in unregelmäßigen Abständen oder mit erheblichen Lücken eintreffen.
Ein wesentliches Merkmal von GinAR ist die Fähigkeit, den Graphen während des Trainings dynamisch umzustrukturieren. Im Gegensatz zu den meisten graphbasierten Modellen, bei denen die Struktur von vornherein feststeht, entsteht sie hier erst während des Trainingsprozesses. Dadurch lassen sich Veränderungen der Marktbedingungen, der Korrelationen und der latenten Faktoren berücksichtigen. Das Modell ermittelt eigenständig, welche Variablen miteinander verbunden werden sollten, welche Verbindungen abgeschwächt werden sollten und welche Variablen als entscheidend für den aktuellen Kontext identifiziert werden sollten. Dadurch entsteht eine flexible Architektur, die sich an Marktregime und Marktdynamiken anpassen kann.
Nachstehend ist die vom Autor erstellte Darstellung des GinAR-Frameworks abgebildet.
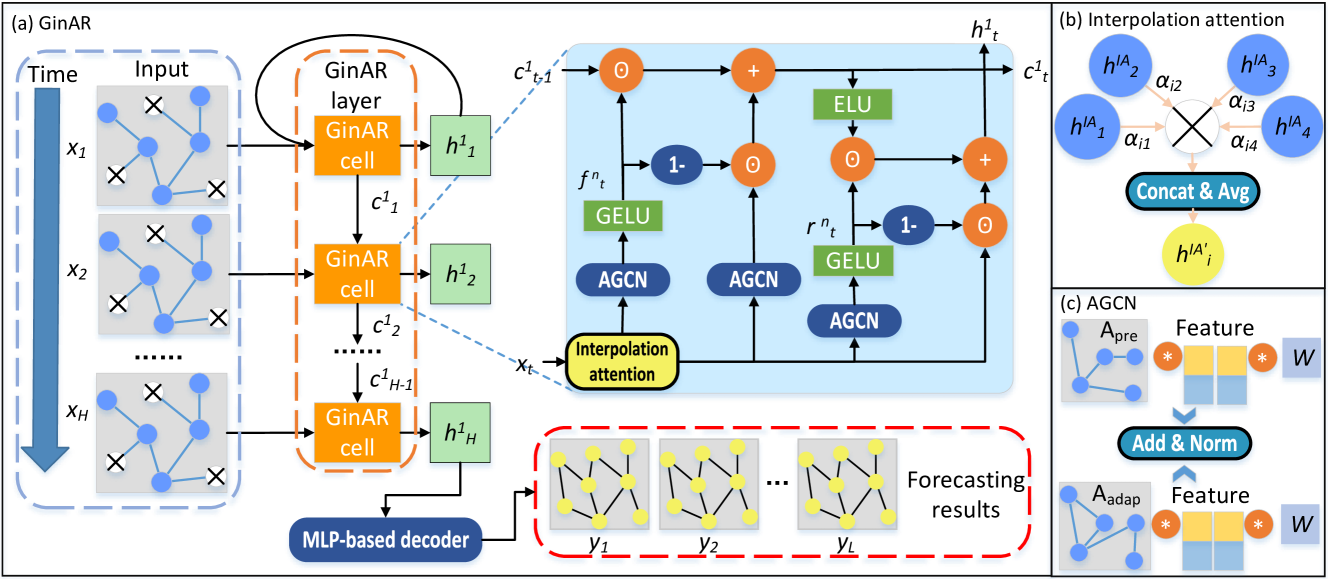
Im praktischen Teil des vorherigen Artikels haben wir umfangreiche Vorarbeiten geleistet und damit die Grundlage für Berechnungen innerhalb des OpenCL-Programms geschaffen. Alle wichtigen Funktionen wurden implementiert – von lokalen Reduktionen und der Berechnung von SoftMax bis hin zu den Vorwärts- und Rückwärtsdurchläufen im Interpolation Attention-Modul. Besonderes Augenmerk wurde auf den korrekten Umgang mit lokalem Speicher, die Thread-Synchronisierung und die numerische Stabilität gelegt, die bei der Arbeit mit unvollständigen Zeitreihen in einer parallelen Rechenumgebung von besonderer Bedeutung sind.
Diese Vorbereitung ebnet den Weg für den nächsten Schritt – die Integration des Modellkerns in das Hauptprogramm. Hier wird der Algorithmus zum Leben erweckt: Daten werden aus der Handelsumgebung eingespeist, mithilfe von OpenCL-Geräten verarbeitet, durch das Modell geleitet und als Prognosen und Handelsentscheidungen ausgegeben. Diese Verbindung zwischen der übergeordneten Logik und den hardwarenahen, beschleunigten Berechnungen ist ein wesentlicher Bestandteil unserer gesamten Implementierung der GinAR-Architektur.
Interpolation Attention
Heute steht uns viel praktische Arbeit im Zusammenhang mit der Implementierung der Schlüsselkomponenten des GinAR-Frameworks bevor. Wir werden uns also nicht allzu lange mit der Theorie aufhalten – kommen wir gleich zur Sache.
Der erste Schritt besteht darin, ein Schlüsselmodul, Interpolation Attention, zu erstellen, das wir als eigenständige Klasse CNeuronInterpolationAttention implementieren werden. Diese Klasse erbt vom Basisobjekt für neuronale Schichten in unserer Bibliothek, CNeuronBaseOCL, und implementiert die gesamte erforderliche Logik für die effiziente Nutzung der zuvor vorbereiteten OpenCL-Kernel über den gesamten Zyklus von Vorwärts- und Rückwärtsdurchlauf hinweg.
class CNeuronInterpolationAttention :  public CNeuronBaseOCL
  {
protected:
   //---
   uint                 iCount;
   uint                 iDimension;
   //---
   CParams              cW;
   CParams              cA;
   CParams              cGL;
   //---
   CNeuronBaseOCL       cH;
   CNeuronBaseOCL       cAdj;
   CNeuronBaseOCL       cAttention;
   //---
   virtual bool      InterpolationAttention(CNeuronBaseOCL *NeuronOCL);
   virtual bool      InterpolationAttentionGrad(CNeuronBaseOCL *NeuronOCL);
   virtual bool      feedForward(CNeuronBaseOCL *NeuronOCL) override;
   virtual bool      updateInputWeights(CNeuronBaseOCL *NeuronOCL) override;
   virtual bool      calcInputGradients(CNeuronBaseOCL *NeuronOCL) override;

public:
                     CNeuronInterpolationAttention(void) { activation = None; }
                    ~CNeuronInterpolationAttention(void) {};
   //---
   virtual bool      Init(uint numOutputs, uint myIndex, COpenCLMy *open_cl,
                          uint units_count, uint dimension,
                          ENUM_OPTIMIZATION optimization_type, uint batch);
   //---
   virtual bool      Save(const int file_handle) override;
   virtual bool      Load(const int file_handle) override;
   //---
   virtual int       Type(void) override const {  return defNeuronInterpolationAttention; }
   virtual void      TrainMode(bool flag) override;
   virtual void      SetOpenCL(COpenCLMy *obj);
   //---
   virtual bool      WeightsUpdate(CNeuronBaseOCL *source, float tau);
   virtual void      SetActivationFunction(ENUM_ACTIVATION value) override {};
  };
Die Klasse enthält eine Reihe interner Variablen: iCount und iDimension definieren die Anzahl der Elemente im Quelldatentensor, während die Objekte cW, cA und cGL die Parameter der trainierbaren Matrizen darstellen. Es werden eigene Objekte definiert, um Zwischenergebnisse für verborgene Repräsentationen, den Adjazenzgraphen und die Attention-Gewichte zu speichern.
Die zentrale Rechenlogik ist in den Methoden InterpolationAttention und InterpolationAttentionGrad gekapselt, die jeweils für den Vorwärts- und den Rückwärtsdurchlauf des Modells zuständig sind. Diese Methoden übernehmen die Vorbereitung und das Einreihen der entsprechenden OpenCL-Kernel zur Ausführung, die wir im Rahmen der praktischen Arbeit im vorherigen Artikel erstellt haben. Diese Methoden basieren auf einem Algorithmus, den wir bereits kennen, daher werden wir in diesem Artikel nicht näher darauf eingehen. Der vollständige Code für diese Methoden ist im Anhang zum Selbststudium enthalten.
Alle internen Objekte der Klasse CNeuronInterpolationAttention werden als eingebettete Klassenmitglieder deklariert, was die Verwaltung des Lebenszyklus der Instanz vereinfacht. Aus diesem Grund können der Konstruktor und der Destruktor der Klasse leer bleiben – sie erfordern keine explizite Initialisierung oder Freigabe von Ressourcen. Die gesamte erforderliche Konfiguration, einschließlich der Initialisierung der klasseneigenen Member und der von der übergeordneten Klasse geerbten Komponenten, wird zentral in der Methode Init durchgeführt. Dies sorgt für eine übersichtliche und vorhersehbare Initialisierungsstruktur, wodurch Code-Duplikation vermieden und die Zuverlässigkeit verbessert wird, wenn das Modul in verschiedenen Modellkonfigurationen wiederverwendet wird.
bool CNeuronInterpolationAttention::Init(uint numOutputs, uint myIndex, COpenCLMy *open_cl,
                                         uint units_count, uint dimension,
                                         ENUM_OPTIMIZATION optimization_type, uint batch)
  {
   if(!CNeuronBaseOCL::Init(numOutputs, myIndex, open_cl, units_count * dimension,
                                                        optimization_type, batch))
      return false;
Im Methodenkörper rufen wir zunächst die gleichnamige Methode der übergeordneten Klasse, CNeuronBaseOCL, auf. In diesem Fall wird die Schichtgröße unter Berücksichtigung der Merkmalsdimension des Eingangssignals neu berechnet.
Anschließend werden die zentralen Parameter des Modells – die Anzahl der Variablen und die Repräsentationsdimensionalität – für die Berechnungen und die interne Pufferverwaltung gespeichert. Diese Parameter legen die Größen aller anderen Vektoren und Matrizen fest, die während des Vorwärts- und Rückwärtsdurchlaufs verwendet werden.
iCount = units_count;
iDimension = dimension;
Der folgende Codeblock initialisiert die Parameter und Zwischentensoren, die im Interpolation Attention-Mechanismus verwendet werden. Zunächst werden die trainierbaren Gewichte cW erstellt; sie stellen eine individuelle Interaktionsmatrix zwischen den Variablen dar. Dies ist eine quadratische dimension × dimension-Matrix.
int index = 0;
if(!cW.Init(0, index, OpenCL, iDimension * iDimension, optimization, iBatch))
   return false;
Als Nächstes werden die cA-Parameter initialisiert, die für die Attention-Aggregation zwischen Knoten zuständig sind.
index++;
if(!cA.Init(0, index, OpenCL, 2 * iDimension, optimization, iBatch))
   return false;
index++;
if(!cGL.Init(0, index, OpenCL, iDimension * iDimension, optimization, iBatch))
   return false;
Anschließend wird das cGL-Objekt erstellt, das die latenten Vektoren der Variablen darstellt. Es hat ebenfalls die Abmessungen Dimension × Dimension.
Nachdem alle trainierbaren Parameter initialisiert wurden, beginnt die Konfiguration der Hilfsobjekte, die für die Speicherung der Zwischenergebnisse zuständig sind. Der cH-Puffer stellt eine Matrix linearer Transformationen des Eingangssignals dar, die durch Multiplikation des Eingangssignals mit den Gewichten erhalten wird. Seine Abmessungen betragen units_count × dimension.
index++;
if(!cH.Init(0, index, OpenCL, iCount * iDimension, optimization, iBatch))
   return false;
Als Nächstes folgt das cAdj-Objekt, in dem die angepassten Korrelationswerte zwischen den Variablen gespeichert sind.
   index++;
   if(!cAdj.Init(0, index, OpenCL, iDimension * iDimension, optimization, iBatch))
      return false;
   index++;
   if(!cAttention.Init(0, index, OpenCL, iDimension * iDimension, optimization, iBatch))
      return false;
//---
   return true;
  }
Schließlich ist cAttention ein Tensor der endgültigen Attention-Werte, die nach der Normalisierung mittels SoftMax erhalten wurden.
Nach jeder Initialisierung wird überprüft, ob diese erfolgreich war. Tritt in einer beliebigen Phase ein Fehler auf, gibt die Methode sofort false zurück und bietet so einen zuverlässigen Schutz vor Konfigurationsfehlern.
Wenn alle Objekte erfolgreich konfiguriert und im Speicher des OpenCL-Geräts abgelegt wurden, wird die Methode abgeschlossen und gibt true zurück. Das bedeutet, dass die Schicht vollständig einsatzbereit ist und als Teil des Modells verwendet werden kann.
Sobald die Objektinitialisierung abgeschlossen ist, fahren wir mit der Einrichtung des Vorwärtsdurchlaufs fort, den wir in der Methode feedForward implementieren. Ihre Aufgabe besteht darin, alle Eingabedaten ordnungsgemäß vorzubereiten und die Hauptberechnung mithilfe des zuvor entwickelten OpenCL-Kernels auszuführen. Der Algorithmus ist relativ kompakt, umfasst jedoch mehrere zentrale Phasen, von denen jede eine wichtige Rolle im Gesamtbetrieb der Schicht spielt.
bool CNeuronInterpolationAttention::feedForward(CNeuronBaseOCL *NeuronOCL)
  {
   if(bTrain)
     {
      if(!cW.FeedForward())
         return false;
      if(!cA.FeedForward())
         return false;
      if(!cGL.FeedForward())
         return false;
     }
   if(!InterpolationAttention(NeuronOCL))
      return false;
//---
   return true;
  }
Zunächst prüft die Methode, ob das Flag bTrain gesetzt ist, was darauf hinweist, dass sich die Schicht im Trainingsmodus befindet. Dies ist entscheidend, da in diesem Fall für die trainierbaren Parameter des Modells zunächst deren eigene FeedForward-Methoden aufgerufen werden müssen. Dieser Aufruf ist erforderlich, um deren Werte zu aktualisieren und ihre Einbindung in den aktuellen Berechnungszyklus sicherzustellen. Alle drei Aufrufe beinhalten eine Erfolgsprüfung, und schon beim geringsten Fehler bricht die Methode die Ausführung sofort ab und gibt false zurück. Dadurch wird verhindert, dass nicht initialisierte oder ungültige Parameter in nachfolgende Berechnungen weitergereicht werden.
Sobald alle vorbereitenden Schritte abgeschlossen sind, wird die Hauptmethode InterpolationAttention aufgerufen. Diese Funktion löst den Start des OpenCL-Kernels aus, der für die Berechnung der Attention, die Aggregation von Werten und die Erzeugung der Ausgaberepräsentation der Schicht zuständig ist.
Die Methode beendet ihre Ausführung, indem sie das boolesche Ergebnis der Operationen an den Aufrufer zurückgibt.
Die Methode calcInputGradients ist äußerst knapp implementiert, da die gesamte Logik der Backpropagation bereits in den entsprechenden OpenCL-Kernel ausgelagert wurde. Hier rufen wir lediglich die Wrapper-Funktion InterpolationAttentionGrad auf, die dafür zuständig ist, den Kernel zu starten und die erforderlichen Puffer zu übergeben. Anschließend geben wir das boolesche Ergebnis der Operationen an den Aufrufer zurück.
bool CNeuronInterpolationAttention::calcInputGradients(CNeuronBaseOCL *NeuronOCL)
  {
   if(!InterpolationAttentionGrad(NeuronOCL))
      return false;
//---
   return true;
  }
Diese Implementierung bewahrt die allgemeine Betriebsstruktur neuronaler Schichten vollständig, sodass dieses Modul ohne Änderungen an der Trainingslogik zusammen mit anderen Schichttypen verwendet werden kann. Dies unterstreicht die architektonische Flexibilität des Systems und macht die Integration neuer Lösungen so einfach und sicher wie möglich.
Die Aktualisierung der trainierbaren Parameter im Modul ist so kompakt und logisch wie möglich implementiert. Alle in den Berechnungen verwendeten Gewichte sind interne Objekte der Klasse (cW, cA, cGL), von denen jedes seinen eigenen Aktualisierungsalgorithmus kapselt. Die Methode updateInputWeights ruft lediglich die entsprechenden Funktionen dieser Objekte auf und gewährleistet so Modularität und eine übersichtliche Architektur.
bool CNeuronInterpolationAttention::updateInputWeights(CNeuronBaseOCL *NeuronOCL)
  {
   if(!cW.UpdateInputWeights())
      return false;
   if(!cA.UpdateInputWeights())
      return false;
   if(!cGL.UpdateInputWeights() ||
      !Normilize(cGL.getWeightsParams(), 2 * iDimension))
      return false;
//---
   return true;
  }
Besonderes Augenmerk gilt dem cGL-Tensor, der nach seiner Aktualisierung zusätzlich mithilfe der Funktion Normilize normalisiert wird. Dies ist notwendig, da cGL die Gewichte der korrelationsbasierten Verbindungen zwischen Variablen enthält und sich die Stabilität dieser Koeffizienten direkt auf die Stabilität des gesamten Attention-Moduls auswirkt. Die Normalisierung trägt dazu bei, Ausreißer abzumildern und die Interpretierbarkeit der Gewichte zu erhalten. Somit schließt diese Methode den Trainingszyklus vollständig ab, ohne dass zusätzliche Eingriffe oder Konfigurationen erforderlich sind.
Der vollständige Quellcode für die Klasse CNeuronInterpolationAttention sowie die Implementierung aller zugehörigen Methoden sind im Anhang zu finden. Wir haben bewusst darauf verzichtet, diesen Artikel mit technischen Details zu überfrachten, um den Text lebendig zu halten; wir empfehlen jedoch, den Quellcode durchzusehen, um die Logik des Moduls und dessen Einbindung in das gesamte GinAR-Framework vollständig zu verstehen.
AGCN
Der nächste logische Schritt bei der Entwicklung des GinAR-Frameworks ist die Implementierung des Mechanismus der adaptiven Graphkonvolution (AGCN). Dies ist eine zentrale Komponente des Frameworks, die es ermöglicht, komplexe Beziehungen zwischen Zeitreihen zu berücksichtigen, die als Knoten in einem Graphen dargestellt werden. Im Gegensatz zu herkömmlichen Ansätzen, bei denen die Graphstruktur im Voraus festgelegt wird und während des gesamten Trainings unverändert bleibt, ermöglicht die adaptive Konvolution dem Modell, die Topologie der Verbindungen auf Grundlage des aktuellen Datenzustands selbstständig auszubilden und anzupassen. Diese Flexibilität ist bei der Arbeit mit dynamischen Finanzzeitreihen von entscheidender Bedeutung, da deren Struktur ständigen Schwankungen, latenten Beziehungen und externen Störungen unterliegt.
Um diese Idee umzusetzen, wurde ein eigenständiges Modul in Form der Klasse CNeuronAGCN entwickelt. Diese Klasse erbt von der vollverbundenen Basisschicht CNeuronBaseOCL und kapselt die gesamte Logik, die für die Durchführung einer adaptiven Konvolution mithilfe von OpenCL-Beschleunigung erforderlich ist. Die interne Struktur ist so ausgelegt, dass in jeder Verarbeitungsphase – einschließlich Merkmalsextraktion, Bildung der Verbindungsmatrix, Normalisierung, Aggregation und Training der Graphgewichte – maximale Recheneffizienz und Genauigkeit gewährleistet sind.
Eine Besonderheit dieses Moduls besteht darin, dass es bei der Informationsverarbeitung nicht auf eine feste Adjazenzmatrix zurückgreift, sondern sie in Echtzeit berechnet. Zu diesem Zweck durchlaufen die Eingabedaten eine Abfolge von Transformationen, wodurch für jeden Knoten eine latente Repräsentation entsteht. Diese Repräsentationen werden verwendet, um die Ähnlichkeit zwischen Knoten zu berechnen, auf deren Grundlage die Matrix der adaptiven Verbindungen erstellt wird. Auf diese Weise betrachtet das Modell im Wesentlichen jede Zeitreihe und entscheidet selbstständig, mit welchen anderen Zeitreihen es sie verknüpft – und wie stark. Das Ergebnis ist ein flexibler Attention-Mechanismus, bei dem jeder Knoten in der Lage ist, sein Verhalten kontextabhängig anzupassen.
Die Struktur der neuen Klasse ist unten dargestellt.
class CNeuronAGCN    :  public CNeuronBaseOCL
  {
protected:
   CParams              cEa;
   CNeuronSwiGLUOCL     cWx;
   CNeuronSwiGLUOCL     cWe;
   CNeuronBaseOCL       cWconcat_ex;
   CNeuronConvOCL       cEn;
   CNeuronTransposeOCL  cEnT;
   CNeuronBaseOCL       cEnEnT;
   CNeuronSoftMaxOCL    cAadapt;
   CNeuronBaseOCL       cAadaptX;
   CNeuronBaseOCL       cApreX;
   CNeuronSwiGLUOCL     cWadapt;
   CNeuronSwiGLUOCL     cWpre;
   //---
   virtual bool      feedForward(CNeuronBaseOCL *NeuronOCL) override { return false; }
   virtual bool      feedForward(CNeuronBaseOCL *NeuronOCL, CBufferFloat *SecondInput) override;
   virtual bool      updateInputWeights(CNeuronBaseOCL *NeuronOCL) override { return false; }
   virtual bool      updateInputWeights(CNeuronBaseOCL *NeuronOCL, CBufferFloat *second) override;
   virtual bool      calcInputGradients(CNeuronBaseOCL *NeuronOCL) override { return false; }
   virtual bool      calcInputGradients(CNeuronBaseOCL *NeuronOCL,
                                        CBufferFloat *SecondInput,
                                        CBufferFloat *SecondGradient,
                                        ENUM_ACTIVATION SecondActivation = None) override;

public:
                     CNeuronAGCN(void) {activation = None;}
                    ~CNeuronAGCN(void) {};
   //---
   virtual bool      Init(uint numOutputs, uint myIndex, COpenCLMy *open_cl,
                          uint units_count, uint dimension,
                          ENUM_OPTIMIZATION optimization_type, uint batch);
   //---
   virtual bool      Save(const int file_handle) override;
   virtual bool      Load(const int file_handle) override;
   //---
   virtual int       Type(void) override const  {  return defNeuronAGCN; }
   virtual void      TrainMode(bool flag) override;
   virtual void      SetOpenCL(COpenCLMy *obj);
   //---
   virtual bool      WeightsUpdate(CNeuronBaseOCL *source, float tau);
   //---
   virtual uint      GetWindow(void) const      { return cWx.GetWindow(); }
   virtual uint      GetUnits(void) const       { return cWx.GetUnits(); }
   virtual void      SetActivationFunction(ENUM_ACTIVATION value) override {};
  };
Die gesamte Rechenkette ist in einem einzigen Objekt organisiert, umfasst jedoch zahlreiche Hilfsschichten und Operationen. Die Logik ist in einzelne Schritte unterteilt, die wir im Zuge der Implementierung der Klassenmethoden näher betrachten werden. Die Ausgabemerkmale lassen sich als Ergebnis einer koordinierten Filterung über einen angepassten Graphen interpretieren, bei der sowohl Inhaltsinformationen als auch topologische Beziehungen zwischen den Zeitreihen berücksichtigt werden.
Wie bei der vorherigen Schicht wurden alle internen Komponenten der Klasse CNeuronAGCN statisch deklariert. Dieser Ansatz ermöglicht es uns, den Konstruktor und den Destruktor der Klasse leer zu lassen und die gesamte Initialisierungslogik in einer einzigen Methode zu bündeln: Init. Dies gewährleistet eine kompakte Implementierung und erleichtert zudem die Verwaltung des Lebenszyklus von Objekten innerhalb der Schicht.
bool CNeuronAGCN::Init(uint numOutputs, uint myIndex, COpenCLMy *open_cl,
                       uint units_count, uint dimension,
                       ENUM_OPTIMIZATION optimization_type, uint batch)
  {
   if(!CNeuronBaseOCL::Init(numOutputs, myIndex, open_cl,
                            units_count * dimension, optimization_type, batch))
      return false;
Die Initialisierung beginnt mit einem Aufruf der gleichnamigen Methode in der übergeordneten Klasse, in der die Erstkonfiguration der Schnittstellen und der allgemeinen Schichtparameter erfolgt. Anschließend werden alle wesentlichen Komponenten der adaptiven Graphkonvolution Schritt für Schritt konfiguriert.
Im ersten Schritt wird ein cEa-Objekt erstellt, das zur Kodierung zusätzlicher Informationen über die Datenstruktur verwendet wird.
//---
   int index = 0;
   if(!cEa.Init(0, index, OpenCL, Neurons(), optimization, iBatch))
      return false;
   cEa.SetActivationFunction(None);
Als Nächstes werden zwei wichtige Schichten – cWx und cWe – initialisiert; sie sind dafür zuständig, Merkmale aus den Eingabedaten und der zuvor gelernten Struktur der Zeitreihen zu extrahieren. Beide Schichten werden mithilfe des SwiGLU-Mechanismus implementiert und parallel trainiert.
index++;
if(!cWx.Init(0, index, OpenCL, dimension, dimension, dimension, units_count,
                                                   1, optimization, iBatch))
   return false;
index++;
if(!cWe.Init(0, index, OpenCL, dimension, dimension, dimension, units_count,
                                                   1, optimization, iBatch))
   return false;
Darauf folgt der cWconcat_ex-Puffer, der Repräsentationen im latenten Raum zusammenführt.
index++;
if(!cWconcat_ex.Init(0, index, OpenCL, 2 * Neurons(), optimization, iBatch))
   return false;
cWconcat_ex.SetActivationFunction(None);
Das nächste Element im Initialisierungsprozess ist die cEn-Schicht, die eine lineare Transformation der kombinierten Merkmale durchführt. Ergänzt wird sie durch das cEnT-Transpositionsmodul, das die Daten für die Bildung einer vorläufigen Attention-Matrix aufbereitet.
index++;
if(!cEn.Init(0, index, OpenCL, 2 * dimension, 2 * dimension, dimension, units_count,
                                                           1, optimization, iBatch))
   return false;
cEn.SetActivationFunction(None);
index++;
if(!cEnT.Init(0, index, OpenCL, units_count, dimension, optimization, iBatch))
   return false;
index++;
if(!cEnEnT.Init(0, index, OpenCL, units_count * units_count, optimization, iBatch))
   return false;
cEnEnT.SetActivationFunction(GELU);
Nach dem Transponierungsschritt werden die aufbereiteten Daten an die Matrixmultiplikation weitergeleitet, wo eine Skalarproduktoperation zwischen der ursprünglichen Repräsentation und ihrer transponierten Version durchgeführt wird. Das Ergebnis ist eine symmetrische Beziehungsmatrix, die im cEnEnT-Objekt gespeichert wird. In diesem Block werden die resultierenden Werte durch die GELU-Funktion geleitet; diese Funktion ermöglicht es, negative Korrelationen sanft zu unterdrücken, ohne sie vollständig zu beseitigen, und zugleich ihren Beitrag zur endgültigen Repräsentation zu verringern.
Dieser Ansatz hilft dabei, die wichtigsten Muster und latenten Beziehungen zwischen den Knoten des Graphen zu identifizieren, was bei der Bildung einer adaptiven Attention-Matrix von entscheidender Bedeutung ist. Letztendlich ist das Modell dank dieser Operation in der Lage, tiefere strukturelle Muster innerhalb des Graphen zu erfassen und die Interaktionen zwischen den Knoten korrekt zu gewichten.
Als Nächstes folgt ein entscheidender Schritt – die Normalisierung der ermittelten Werte. Hierfür wird die SoftMax-Funktion verwendet, die innerhalb des cAadapt-Objekts angewendet wird. Durch diesen Vorgang werden die rohen Gewichtungskoeffizienten in eine Wahrscheinlichkeitsverteilung umgewandelt, in der jeder Kante zwischen den Knoten des Graphen ein bestimmter Bedeutungsgrad zugewiesen wird. Auf diese Weise werden schwache und verrauschte Abhängigkeiten unterdrückt, während starke und aussagekräftige Abhängigkeiten verstärkt werden. Das Ergebnis ist eine vollständig ausgebildete adaptive Attention-Matrix, die die individuellen Interaktionsmuster zwischen den Komponenten des Eingangssignals widerspiegelt.
index++;
if(!cAadapt.Init(0, index, OpenCL, units_count * units_count, optimization, iBatch))
   return false;
cAadapt.SetHeads(units_count);
Der nächste logische Schritt besteht darin, die adaptiven Gewichte auf die Eingabedaten anzuwenden. Dieser Schritt erfolgt durch Gewichtung der Eingabemerkmale mit den entsprechenden Attention-Koeffizienten. Das Ergebnis wird im cAadaptX-Puffer gespeichert, der eine aktualisierte, kontextangereicherte Repräsentation des Eingangssignals darstellt. Im Wesentlichen handelt es sich hierbei um eine neu gewichtete Projektion der ursprünglichen Eingabedaten, bei der die identifizierten Beziehungen zwischen den einzelnen Knoten im Graphen berücksichtigt werden.
index++;
if(!cAadaptX.Init(0, index, OpenCL, Neurons(), optimization, iBatch))
   return false;
cAadaptX.SetActivationFunction(None);
index++;
if(!cApreX.Init(0, index, OpenCL, Neurons(), optimization, iBatch))
   return false;
cApreX.SetActivationFunction(None);
Ein weiterer Verarbeitungsschritt besteht darin, die Eingabedaten an eine vordefinierte Graphstruktur anzupassen. Dieser Schritt dient dazu, den Einfluss bekannter, a-priori-Beziehungen zwischen Knoten zu verstärken, die außerhalb des zu trainierenden Modells abgeleitet wurden – beispielsweise auf der Grundlage grundlegender Zusammenhänge, der Topologie oder von Expertenregeln. Der Mechanismus ist hier ähnlich wie beim vorherigen: Auf den ursprünglichen Tensor werden Gewichte angewendet, jedoch nicht aus der adaptiven Attention-Matrix; stattdessen stammen sie aus einer externen Koeffizientenmatrix. Das Ergebnis wird im cApreX-Puffer gespeichert. Somit erhält das Modell gleichzeitig zwei unabhängige Informationskanäle – einen, der auf automatischem Lernen und identifizierten Mustern basiert, und einen, der auf strukturellen A-priori-Informationen beruht. Durch ihre Kombination lässt sich ein besseres Gleichgewicht zwischen der Flexibilität und der Robustheit des Modells erreichen.
Schließlich werden im letzten Schritt des Initialisierungsprozesses zwei Konvolutionsschichten erstellt: cWadapt und cWpre. Beide nutzen die SwiGLU-Architektur und fungieren als Filter, die die Merkmale an die Struktur der generierten Verbindungsmatrix anpassen.
   index++;
   if(!cWadapt.Init(0, index, OpenCL, dimension, dimension, dimension, units_count,
                                                          1, optimization, iBatch))
      return false;
   cWadapt.SetActivationFunction(None);
   index++;
   if(!cWpre.Init(0, index, OpenCL, dimension, dimension, dimension, units_count, 1,
                                                              optimization, iBatch))
      return false;
   cWpre.SetActivationFunction(None);
   SetActivationFunction(None);
//---
   return true;
  }
Sobald alle diese Schritte abgeschlossen sind, deaktivieren wir die Aktivierungsfunktion der Schicht explizit, da die Nichtlinearitäten innerhalb der internen Blöcke angewendet werden und es nicht notwendig ist, sie am Ausgang erneut anzuwenden.
Somit ist die gesamte Init-Methode eine sorgfältig strukturierte Abfolge von Schritten, in deren Verlauf alle Elemente der adaptiven Konvolution erstellt und konfiguriert werden. Jede Komponente ist für einen bestimmten Teil der Berechnungen zuständig und fügt sich in die Gesamtarchitektur der Schicht ein und bildet so die Grundlage für den weiteren Betrieb des Modells.
Die nächste Phase unserer Arbeit ist die feedForward-Methode, die den gesamten Vorwärtsdurchlauf der adaptiven Graphkonvolution implementiert und dabei sowohl trainierbare als auch extern vorgegebene strukturelle Verbindungen berücksichtigt. Der Algorithmus ist recht komplex, daher wollen wir ihn Schritt für Schritt betrachten und uns dabei auf die semantische Logik der einzelnen Blöcke konzentrieren.
bool CNeuronAGCN::feedForward(CNeuronBaseOCL *NeuronOCL, CBufferFloat *SecondInput)
  {
   if(!SecondInput || SecondInput.Total() < cAadapt.Neurons())
      return false;
Bevor der Algorithmus ausgeführt wird, erfolgt eine obligatorische Prüfung, um die Gültigkeit der Eingabedaten sicherzustellen: Fehlt die Matrix der vordefinierten Korrelationskoeffizienten, SecondInput, oder reicht ihre Größe für die Durchführung von Matrixoperationen nicht aus, wird die Ausführung sofort abgebrochen.
Befindet sich das Modell im Trainingsmodus, wird anschließend die Schleife zur Parametervorbereitung für den Zweig gestartet, der für den adaptiven Kontext der Knoten zuständig ist. Zunächst wird ein Vorwärtsdurchlauf durch das cEa-Objekt durchgeführt, das die trainierbaren Parameter zur Berechnung von Kanten-Embeddings enthält. Das Ergebnis wird an cWe übergeben, wo die Matrix der externen Interaktionsgewichte gebildet wird, wobei die Gewichte den Kontext der Verbindungen zwischen den Knoten im aktuellen Trainingsschritt widerspiegeln.
if(bTrain)
  {
   if(!cEa.FeedForward())
      return false;
   if(!cWe.FeedForward(cEa.AsObject()))
      return false;
  }
Gleichzeitig wird der Hauptzweig aktiviert, also der Zweig, der mit der primären Merkmalssequenz arbeitet. In diesem Zweig führt cWx den Vorwärtsdurchlauf aus, wodurch eine Repräsentation des aktuellen Zustands der Knoten gebildet wird.
if(!cWx.FeedForward(NeuronOCL))
   return false;
if(!Concat(cWx.getOutput(), cWe.getOutput(), cWconcat_ex.getOutput(),
             cWx.GetWindowOut(), cWe.GetWindowOut(), cWx.GetUnits()))
   return false;
Anschließend werden die beiden Ausgabevektoren (cWx und cWe) über einzelne Sequenzelemente hinweg verkettet, wodurch das Modell bei nachfolgenden Operationen strukturelle und kontextbezogene Informationen berücksichtigen kann. Die resultierende Ausgabe wird in cEn verwendet, das eine lineare Konvolution durchführt, die die Dimensionalität reduziert und aussagekräftige Merkmale hervorhebt.
if(!cEn.FeedForward(cWconcat_ex.AsObject()))
   return false;
if(!cEnT.FeedForward(cEn.AsObject()))
   return false;
if(!MatMul(cEn.getOutput(), cEnT.getOutput(), cEnEnT.getOutput(),
             cEnT.GetCount(), cEnT.GetWindow(), cEnT.GetCount()))
   return false;
if(cEnEnT.Activation() != None)
   if(!Activation(cEnEnT.getOutput(), cEnEnT.getOutput(), cEnEnT.Activation()))
      return false;
Als Nächstes erfolgt eine entscheidende Operation: die Transposition der resultierenden Matrix und ihre Multiplikation mit der ursprünglichen Matrix, wodurch im cEnEnT-Objekt eine symmetrische Korrelationsmatrix konstruiert werden kann. Wird auf dieses Objekt eine Aktivierungsfunktion (in unserem Fall GELU) angewendet, wird diese aufgerufen, wodurch die Auswirkungen von Rauschen und negativen Korrelationen gemildert werden.
Die resultierende Matrix wird anschließend an das cAadapt-Objekt übergeben, wo der SoftMax-Mechanismus innerhalb einer Multi-Head-Attention-Struktur angewendet wird. Dieser normalisiert die Gewichte zeilenweise und gibt eine an die aktuelle Datenstruktur angepasste Attention-Matrix zurück. Um die diagonalen Verbindungen zu stärken, wird die Funktion IdentSum aufgerufen; sie addiert eine Identitätsmatrix zum Ergebnis, wodurch die Robustheit des Graphen gegenüber spärlichen Eingaben gewährleistet wird.
if(!cAadapt.FeedForward(cEnEnT.AsObject()))
   return false;
if(!IdentSum(cAadapt.getOutput(), cAadapt.getOutput(), cAadapt.Heads()))
   return false;
Das Modell berechnet dann zwei parallele Matrixmultiplikations-Streams. Der erste Stream arbeitet mit den externen Daten SecondInput, indem er sie mit den aktuellen Ausgaben der neuronalen Schicht multipliziert; das Ergebnis wird im cApreX-Puffer gespeichert. Der zweite Stream verfährt analog mit der cAadapt-Attention-Matrix und den aktuellen Ausgaben und speichert das Ergebnis in cAadaptX.
if(!MatMul(SecondInput, NeuronOCL.getOutput(), cApreX.getOutput(),
           cWpre.GetUnits(), cWpre.GetUnits(), cWpre.GetWindow()))
   return false;
if(!MatMul(cAadapt.getOutput(), NeuronOCL.getOutput(), cAadaptX.getOutput(),
           cWadapt.GetUnits(), cWadapt.GetUnits(), cWadapt.GetWindow()))
   return false;
Der letzte Schritt besteht darin, beide Streams durch die trainierbaren Konvolutionsblöcke cWpre und cWadapt zu leiten. Dadurch kann das Modell die resultierenden Daten unter Berücksichtigung lokaler Merkmale verfeinern.
   if(!cWpre.FeedForward(cApreX.AsObject()))
      return false;
   if(!cWadapt.FeedForward(cAadaptX.AsObject()))
      return false;
   if(!SumAndNormilize(cWadapt.getOutput(), cWpre.getOutput(), Output, cWadapt.GetWindowOut(), true))
      return false;
//---
   return true;
  }
Anschließend wird die Funktion SumAndNormilize aufgerufen; sie führt beide Datenströme zusammen und bringt das Ergebnis am Schichtausgang in die erforderliche Form.
Somit setzt die Methode gleich mehrere leistungsstarke Mechanismen um: adaptive Attention, Merkmalsextraktion, strukturelle Integration und konvolutionsbasierte Transformation. All dies macht das Modul zu einem vollwertigen Graphverarbeitungsblock, der sowohl interne Abhängigkeiten zwischen Knoten als auch externe strukturelle Einschränkungen berücksichtigen kann.
Sobald der Vorwärtsdurchlauf in der adaptiven Graphkonvolution (AGCN) abgeschlossen ist, beginnt eine der entscheidendsten Phasen: die Propagierung der Fehlergradienten vom Schichtausgang zu ihren trainierbaren Komponenten. Im Rahmen dieses Prozesses wird Backpropagation durchgeführt, wodurch sich der Beitrag jedes einzelnen Objekts zum Endergebnis genau bestimmen und die Parameter zur Minimierung des Fehlers anpassen lassen. Der gesamte Algorithmus ist in der Methode calcInputGradients implementiert.
bool CNeuronAGCN::calcInputGradients(CNeuronBaseOCL *NeuronOCL,
                                     CBufferFloat *SecondInput,
                                     CBufferFloat *SecondGradient,
                                     ENUM_ACTIVATION SecondActivation = -1)
  {
   if(!NeuronOCL || !SecondInput || !SecondGradient ||
      SecondInput.Total() < cAadapt.Neurons() ||
      SecondGradient.Total() < cAadapt.Neurons())
      return false;
Im ersten Schritt wird eine standardmäßige Validierungsprüfung der Eingabedaten durchgeführt: Sind die übergebenen Zeiger nicht initialisiert oder sind die Eingabepuffer nicht groß genug, um Matrixoperationen durchzuführen, wird die Ausführung der Methode abgebrochen. Als Nächstes beginnt die eigentliche Fehlerverteilung.
Die Backpropagation im AGCN-Block beginnt ganz am Ende – genauer gesagt am Schichtausgang, wo das Endergebnis bereits gebildet wurde. In unserem Fall handelt es sich dabei um die Summe der Ausgabewerte zweier Schlüsselkomponenten: cWadapt und cWpre. Zur Erinnerung: Es sind genau diese Komponenten, die zur Bildung der endgültigen Repräsentation beitragen, die sowohl die Attention als auch die statische Struktur des Graphen generalisiert.
Da die Blockausgabe eine einfache Summe zweier Tensoren ist, muss der von der nachfolgenden Schicht empfangene Fehlergradient gleichermaßen an beide Module weitergeleitet werden – ohne zusätzliche Gewichtungskoeffizienten. Bevor wir jedoch damit beginnen, die Gradienten über die internen Verbindungen der einzelnen Module zu berechnen, müssen wir diese Gradienten anpassen, um die im Vorwärtsdurchlauf verwendeten Aktivierungsfunktionen zu berücksichtigen. Dazu wird die Methode DeActivation aufgerufen – im Wesentlichen multipliziert sie den erhaltenen Gradienten mit der Ableitung der Aktivierungsfunktion, die auf die Ausgänge von cWadapt und cWpre angewendet wird. Dies ist ein entscheidender Schritt; ohne ihn wäre die Backpropagation durch nichtlineare Transformationen fehlerhaft.
if(!DeActivation(cWadapt.getOutput(), cWadapt.getGradient(), Gradient, cWadapt.Activation()))
   return false;
if(!DeActivation(cWpre.getOutput(), cWpre.getGradient(), Gradient, cWpre.Activation()))
   return false;
Anschließend wird der Fehler an deren Eingänge weitergegeben: Die Methoden CalcHiddenGradients werden für die Objekte cAadaptX und cApreX aufgerufen, über die die Datenströme liefen, die jeweils mithilfe der Matrizen adaptiver und vordefinierter Verbindungen zwischen den Knoten gebildet wurden.
if(!cApreX.CalcHiddenGradients(cWpre.AsObject()))
   return false;
if(!cAadaptX.CalcHiddenGradients(cWadapt.AsObject()))
   return false;
Anschließend wird mithilfe von MatMulGrad die Backpropagation durch die Multiplikationsoperation durchgeführt: Dabei wird der Beitrag jeder Komponente zum Gesamtfehler berechnet. Wird eine Aktivierungsfunktion verwendet, wird deren Rücktransformation mithilfe von DeActivation durchgeführt, wodurch der tatsächliche Fehler wieder in seinen Zustand vor der Normalisierung zurückversetzt werden kann.
   if(!MatMulGrad(SecondInput, SecondGradient,
                  NeuronOCL.getOutput(), NeuronOCL.getGradient(),
                  cApreX.getGradient(), cWpre.GetUnits(),
                  cWpre.GetUnits(), cWpre.GetWindow()))
      return false;
   if(SecondActivation != None)
      if(!DeActivation(SecondInput, SecondGradient,
                       SecondGradient, SecondActivation))
         return false;
//---
   if(!MatMulGrad(cAadapt.getOutput(), cAadapt.getGradient(),
                  NeuronOCL.getOutput(), PrevOutput,
                  cAadaptX.getGradient(),  cWadapt.GetUnits(),
                  cWadapt.GetUnits(), cWadapt.GetWindow()))
      return false;
   if(!SumAndNormilize(NeuronOCL.getGradient(), PrevOutput,
                       PrevOutput, cWx.GetWindow(), false))
      return false;
   if(NeuronOCL.Activation() != None)
      if(!DeActivation(NeuronOCL.getOutput(), PrevOutput,
                       PrevOutput, NeuronOCL.Activation()))
         return false;
Bitte beachten Sie, dass bei beiden während des Vorwärtsdurchlaufs durchgeführten Matrixmultiplikationen die Eingabedaten aus dem Hauptinformationsstrom verwendet wurden. Daher müssen wir den Fehlergradienten entlang beider Zweige akkumulieren. Wir verwenden den temporären Puffer PrevOutput, um die Werte zu akkumulieren. Wenn NeuronOCL eine Aktivierungsfunktion verwendet, wird deren Ableitung angewendet, um den Gradienten unter Berücksichtigung der Nichtlinearität korrekt neu zu berechnen.
Der nächste wichtige Schritt ist die Backpropagation durch die cEnEnT-Korrelationsmatrix, die zuvor während des Vorwärtsdurchlaufs ermittelt wurde. Zunächst werden die verborgenen Gradienten berechnet; anschließend wird, sofern die GELU-Funktion verwendet wurde, der Gradient unter Berücksichtigung der Ableitung der Aktivierungsfunktion zurückpropagiert.
if(!cEnEnT.CalcHiddenGradients(cAadapt.AsObject()))
   return false;
if(cEnEnT.Activation() != None)
   if(!DeActivation(cEnEnT.getOutput(), cEnEnT.getGradient(),
                    cEnEnT.getGradient(), cEnEnT.Activation()))
      return false;
Anschließend wird MatMulGrad aufgerufen, wodurch die Rückwärtspropagierung der Gradienten durch die Operation der Multiplikation der Merkmale mit ihrer transponierten Kopie umgesetzt wird.
if(!MatMulGrad(cEn.getOutput(), cEn.getPrevOutput(),
               cEnT.getOutput(), cEnT.getGradient(),
               cEnEnT.getGradient(), cEnT.GetCount(),
               cEnT.GetWindow(), cEnT.GetCount()))
   return false;
Zudem werden die transponierten Fehler an die cEn-Schicht weitergeleitet, wo sie mit zuvor ermittelten Werten summiert werden und eine Deaktivierung erfolgt, sofern eine Aktivierungsfunktion verwendet wurde.
if(!cEn.CalcHiddenGradients(cEnT.AsObject()))
   return false;
if(!SumAndNormilize(cEn.getGradient(), cEn.getPrevOutput(),
                    cEn.getGradient(), cEnT.GetWindow(), false))
   return false;
if(cEn.Activation() != None)
   if(!DeActivation(cEn.getOutput(), cEn.getGradient(),
                    cEn.getGradient(), cEn.Activation()))
      return false;
Unmittelbar danach werden die Gradienten an cWconcat_ex übergeben, wo der umgekehrte Vorgang der Trennung der Merkmale beginnt (zur Erinnerung: Diese wurden während des Vorwärtsdurchlaufs kombiniert).
if(!cWconcat_ex.CalcHiddenGradients(cEn.AsObject()))
   return false;
if(!DeConcat(cWx.getGradient(), cWe.getGradient(), cWconcat_ex.getGradient(),
             cWx.GetWindowOut(), cWe.GetWindowOut(), cWx.GetUnits()))
   return false;
if(cWx.Activation() != None)
   if(!DeActivation(cWx.getOutput(), cWx.getGradient(),
                    cWx.getGradient(), cWx.Activation()))
      return false;
if(cWe.Activation() != None)
   if(!DeActivation(cWe.getOutput(), cWe.getGradient(),
                    cWe.getGradient(), cWe.Activation()))
      return false;
Die Funktion DeConcat teilt die Gradienten korrekt in zwei Teile auf – einen für cWx und einen für cWe. In jedem dieser Module wird DeActivation separat aufgerufen, wodurch der korrigierte Gradient ermittelt wird. Als Nächstes verläuft die Backpropagation durch das Netzwerk: zunächst über `cWx` zur Eingabedatenebene, dann zu cEa über cWe.
   if(!NeuronOCL.CalcHiddenGradients(cWx.AsObject()))
      return false;
   if(!SumAndNormilize(NeuronOCL.getGradient(), PrevOutput,
                       NeuronOCL.getGradient(), cWx.GetWindow(), false))
      return false;
   if(!cEa.CalcHiddenGradients(cWe.AsObject()))
      return false;
//---
   return true;
  }
Beachten Sie, dass wir den Fehlergradienten bereits an die Eingabedatenebene des Hauptzweigs weitergegeben haben; daher summieren wir die resultierenden Werte mit den zuvor akkumulierten Werten.
Besonders hervorzuheben ist, dass die Methode eine strikte Abfolge aller Schritte umsetzt. Dies ist notwendig, da der Fehler streng in umgekehrter Reihenfolge des Vorwärtsdurchlaufs rückwärts propagiert werden muss. Bei jedem Schritt werden die Auswirkungen von Konvolutionen, Normalisierungen, Aktivierungen und Transpositionen sorgfältig kompensiert. Erst am Ende, nachdem die Gradienten vollständig berechnet wurden, ist das Modell bereit, seine Gewichte zu aktualisieren, wodurch die Genauigkeit in jeder Phase des Trainings gewährleistet bleibt.
Die Methode zur Aktualisierung der Parameter ist äußerst einfach, aber dennoch elegant und zuverlässig umgesetzt. Hier gibt es keine komplexen Bedingungen oder zusätzlichen Berechnungen – letztlich geht es nur darum, die Steuerung sorgfältig an interne Objekte zu übergeben, die die trainierbaren Gewichte direkt enthalten. Jedes von ihnen implementiert seinen eigenen Aktualisierungsmechanismus auf der Grundlage der akkumulierten Gradienten und des gewählten Optimierungsschemas.
bool CNeuronAGCN::updateInputWeights(CNeuronBaseOCL *NeuronOCL, CBufferFloat *second)
  {
   if(!cEa.UpdateInputWeights())
      return false;
   if(!cWe.UpdateInputWeights(cEa.AsObject()))
      return false;
   if(!cWx.UpdateInputWeights(NeuronOCL))
      return false;
   if(!cEn.UpdateInputWeights(cWconcat_ex.AsObject()))
      return false;
   if(!cWpre.UpdateInputWeights(cApreX.AsObject()))
      return false;
   if(!cWadapt.UpdateInputWeights(cAadaptX.AsObject()))
      return false;
//---
   return true;
  }
Jede Methode wird mit dem entsprechenden Eingabeobjekt aufgerufen, das während des Vorwärtsdurchlaufs ermittelt wurde, wodurch die rechnerische Korrektheit innerhalb der Graphtopologie gewährleistet bleibt.
Dieser Ansatz sorgt dafür, dass die Codestruktur nicht nur gut lesbar, sondern auch leicht skalierbar ist.
Zur besseren Orientierung des Lesers und zur Gewährleistung vollständiger technischer Transparenz ist der gesamte Quellcode dieser Klasse, einschließlich der Definitionen aller Methoden, im Anhang enthalten.
GinAR-Zelle
Nun kommen wir zur letzten Phase – der Erstellung einer vollwertigen GinAR-Rechenzelle, die alle zuvor besprochenen Komponenten in einer einzigen, zusammenhängenden Struktur vereint. Genau hier, in der Klasse CNeuronGinARCell, laufen die Mechanismen der Interpolation Attention, der adaptiven Graphkonvolution und der Speichersteuerungselemente zusammen und bilden eine flexible und zugleich streng strukturierte Architektur.
class CNeuronGinARCell  :  public CNeuronBaseOCL
  {
protected:
   CNeuronInterpolationAttention cX_IA;
   CNeuronAGCN                   cX_AGCN;
   CNeuronAGCN                   cForgetGate;
   CNeuronAGCN                   cResetGate;
   CNeuronBaseOCL                cContext;
   CBufferFloat                  bTemp;
   //---
   virtual bool      feedForward(CNeuronBaseOCL *NeuronOCL) override { return false; }
   virtual bool      feedForward(CNeuronBaseOCL *NeuronOCL, CBufferFloat *SecondInput) override;
   virtual bool      updateInputWeights(CNeuronBaseOCL *NeuronOCL) override { return false; }
   virtual bool      updateInputWeights(CNeuronBaseOCL *NeuronOCL, CBufferFloat *second) override;
   virtual bool      calcInputGradients(CNeuronBaseOCL *NeuronOCL) override { return false; }
   virtual bool      calcInputGradients(CNeuronBaseOCL *NeuronOCL,
                                        CBufferFloat *SecondInput,
                                        CBufferFloat *SecondGradient,
                                        ENUM_ACTIVATION SecondActivation = None) override;

public:
                     CNeuronGinARCell(void) { activation = None;}
                    ~CNeuronGinARCell(void) {};
   //---
   virtual bool      Init(uint numOutputs, uint myIndex, COpenCLMy *open_cl,
                          uint units_count, uint dimension,
                          ENUM_OPTIMIZATION optimization_type, uint batch);
   //---
   virtual bool      Save(const int file_handle) override;
   virtual bool      Load(const int file_handle) override;
   //---
   virtual int       Type(void) override const  {  return defNeuronGinARCell; }
   virtual void      TrainMode(bool flag) override;
   virtual void      SetOpenCL(COpenCLMy *obj);
   //---
   virtual bool      WeightsUpdate(CNeuronBaseOCL *source, float tau);
   virtual void      SetActivationFunction(ENUM_ACTIVATION value) override {};
  };
Aus der oben dargestellten Struktur des neuen Objekts geht klar hervor, dass CNeuronGinARCell die Basisschnittstelle von CNeuronBaseOCL. erbt. Dies gewährleistet die Kompatibilität mit den anderen Schichten und Modulen des Frameworks. Im Gegensatz zu einfachen Blöcken vereint dieser jedoch mehrere funktionale Komponenten:
- cX_IA – ein Block für Interpolation Attention, der für die Glättung und Anpassung der Eingabe-Zeitreihe zuständig ist;
- cX_AGCN – das zentrale Modul für adaptive Graphkonvolution, das eine verallgemeinerte Repräsentation der Eingabemerkmale bildet und dabei deren Beziehungen berücksichtigt;
- cForgetGate und cResetGate sind zwei weitere graphbasierte Teilsysteme, die Forget- und Reset-Mechanismen implementieren, ähnlich denen in GRU-Zellen;
- cContext – ein interner Puffer, der den akkumulierten Zustand des verborgenen Speichers speichert;
- bTemp – ein temporärer Puffer, der bei Zwischenberechnungen verwendet wird.
Die Klasse implementiert den standardmäßigen Ausführungszyklus einer neuronalen Schicht. Die Init-Methode initialisiert Schritt für Schritt alle Komponenten von CNeuronGinARCell. Hier werden die wichtigsten Parameter des Modells festgelegt: die Anzahl der Ausgaben, die Dimensionalität des Merkmalsraums, die Art der Optimierung und die Batch-Größe.
bool CNeuronGinARCell::Init(uint numOutputs, uint myIndex, COpenCLMy *open_cl,
                            uint units_count, uint dimension,
                            ENUM_OPTIMIZATION optimization_type, uint batch)
  {
   if(!CNeuronBaseOCL::Init(numOutputs, myIndex, open_cl,
                            units_count * dimension, optimization_type, batch))
      return false;
Anschließend werden die internen Blöcke der Zelle nacheinander initialisiert. Zunächst wird cX_IA initialisiert, das für Interpolation Attention zuständig ist.
int index = 0;
if(!cX_IA.Init(0, index, OpenCL, units_count, dimension, optimization, iBatch))
   return false;
Als Nächstes wird das Hauptmodul für die Graphkonvolution, cX_AGCN, initialisiert, gefolgt von den Steuer-Gates cForgetGate und cResetGate. Jedem wird ein eigener, eindeutiger Index zugewiesen.
index++;
if(!cX_AGCN.Init(0, index, OpenCL, units_count, dimension, optimization, iBatch))
   return false;
index++;
if(!cForgetGate.Init(0, index, OpenCL, units_count, dimension, optimization, iBatch))
   return false;
index++;
if(!cResetGate.Init(0, index, OpenCL, units_count, dimension, optimization, iBatch))
   return false;
In einem separaten Schritt wird das Modul cContext initialisiert, das als Akkumulator für den internen Zustand dient. Dessen Ausgabe wird explizit mit Nullen gefüllt, um zufälliges Rauschen beim Start zu vermeiden, und die Aktivierungsfunktion wird deaktiviert, sodass es als reiner Speicherpuffer verwendet werden kann.
   index++;
   if(!cContext.Init(0, index, OpenCL, units_count * dimension, optimization, iBatch))
      return false;
   if(!cContext.getPrevOutput().Fill(0))
      return false;
   cContext.SetActivationFunction(None);
   bTemp.BufferFree();
   if(!bTemp.BufferInit(units_count * units_count, 0) ||
      !bTemp.BufferCreate(OpenCL))
      return false;
//---
   return true;
  }
Abschließend wird ein temporärer Puffer bTemp angelegt, um Zwischenoperationen durchzuführen. Die Puffergröße wird quadratisch gewählt: units_count * units_count. In diesem Fall wird der Puffer, falls er bereits angelegt wurde, zunächst freigegeben, wodurch ein korrekter Betrieb gewährleistet und Ressourcen geschont werden.
Nachdem alle Operationen abgeschlossen sind, gibt die Methode dem Aufrufer ein boolesches Ergebnis zurück.
Der in der Methode feedForward implementierte Algorithmus für den Vorwärtsdurchlauf setzt die zentrale Funktionslogik von CNeuronGinARCell um und kombiniert dabei Attention-Mechanismen, Graphkonvolutionen sowie die Speicherverwaltung über das Forget-Gate und das Reset-Gate.
bool CNeuronGinARCell::feedForward(CNeuronBaseOCL *NeuronOCL, CBufferFloat *SecondInput)
  {
   if(!cX_IA.FeedForward(NeuronOCL))
      return false;
In der ersten Stufe wird das Modul cX_IA aktiviert, das eine Interpolationstransformation der Quelldaten aus NeuronOCL durchführt. Die daraus resultierende Repräsentation dient als Grundlage für drei parallel laufende Blöcke – das Hauptmodul für Graphkonvolution cX_AGCN sowie die Module cForgetGate und cResetGate, die für die Erzeugung von Steuermasken zuständig sind.
if(!cX_AGCN.FeedForward(cX_IA.AsObject(), SecondInput))
   return false;
if(!cForgetGate.FeedForward(cX_IA.AsObject(), SecondInput))
   return false;
if(!cResetGate.FeedForward(cX_IA.AsObject(), SecondInput))
   return false;
if(!Activation(cForgetGate.getOutput(), cForgetGate.getOutput(), GELU))
   return false;
if(!Activation(cResetGate.getOutput(), cResetGate.getOutput(), GELU))
   return false;
Jeder dieser drei Blöcke akzeptiert zudem eine zweite Eingabe, SecondInput, die graphbezogene oder strukturelle Informationen enthält – eine Adjazenzmatrix oder Daten zu benachbarten Knoten. Nach dem Durchlaufen der Schichten werden die Ausgaben der Gates cForgetGate und cResetGate durch die GELU-Aktivierungsfunktion geleitet, wodurch glattere und flexiblere Masken erzeugt werden können, die die Auswirkungen abrupter Übergänge und negativer Werte verringern.
Als Nächstes wird der interne Kontext aktualisiert. An dieser Stelle sei angemerkt, dass während des Vorwärtsdurchlaufs die für die Operationen des Rückwärtsdurchlaufs benötigten Kontextwerte sofort überschrieben werden. Um dies zu verhindern, verwenden wir einen Pufferwechsel: Wir rufen die Methode SwapOutputs auf, die die Pufferzeiger Output und PrevOutput vertauscht.
//--- Context
   if(!cContext.SwapOutputs())
      return false;
   if(!GateElementMult(cContext.getPrevOutput(), cX_AGCN.getOutput(),
                       cForgetGate.getOutput(), cContext.getOutput()))
      return false;
Anschließend wird ein neuer Kontextvektor gebildet, indem der vorherige Zustand von cContext und die Ergebnisse von cX_AGCN elementweise multipliziert und dabei mit der Forget-Maske cForgetGate gewichtet werden. Dadurch lässt sich flexibel steuern, welche Speicherelemente beibehalten und welche auf Null gesetzt werden sollen.
Der neue Kontextvektor durchläuft eine ELU-Aktivierungsfunktion, die auf die Verarbeitung negativer Werte ausgelegt ist, was die Gradientenstabilität verbessert.
//--- Output
   if(!Activation(cContext.getOutput(), cContext.getPrevOutput(), ELU))
      return false;
   if(!GateElementMult(cContext.getPrevOutput(), cX_IA.getOutput(), cResetGate.getOutput(), Output))
      return false;
//---
   return true;
  }
Schließlich wird die endgültige Ausgabe des Blocks im Puffer Output durch elementweise Multiplikation des aktualisierten Kontexts, des Ergebnistensors cX_IA und der Maske cResetGate gebildet. In diesem Schritt werden der Langzeitspeicher, der aktuelle Eingabezustand und die Reset-Maske kombiniert, die dafür zuständig ist, relevante Merkmale an die Ausgabe weiterzuleiten.
Tritt während der Ausführung des Vorgangs zu irgendeinem Zeitpunkt ein Fehler oder eine Störung auf, gibt die Methode false zurück. Wenn alle Vorgänge erfolgreich abgeschlossen wurden, gibt die Funktion true zurück und bestätigt damit, dass die Daten die gesamte Zellstruktur korrekt durchlaufen haben.
Der Algorithmus zur Backpropagation ist nicht so einfach, wie es auf den ersten Blick erscheinen mag. Die Hauptkomplexität liegt darin, Gradienten aus mehreren Quellen sorgfältig zu summieren und zu normalisieren, da die Eingabedaten aus beiden Zweigen an mehreren Stellen gleichzeitig verwendet werden: im Hauptstrom (cX_AGCN) und in Hilfspfaden über die Steuer-Gates cForgetGate und cResetGate. Daher erzeugt jede dieser Komponenten ihren eigenen Beitrag zum endgültigen Gradienten, und alle Beiträge müssen korrekt kombiniert werden.
bool CNeuronGinARCell::calcInputGradients(CNeuronBaseOCL *NeuronOCL,
                                          CBufferFloat *SecondInput,
                                          CBufferFloat *SecondGradient,
                                          ENUM_ACTIVATION SecondActivation = -1)
  {
   if(!NeuronOCL || !SecondInput || !SecondGradient)
      return false;
//--- Output
   if(!GateElementMultGrad(cContext.getPrevOutput(), cContext.getGradient(),
                           cX_IA.getOutput(), cX_IA.getPrevOutput(),
                           cResetGate.getOutput(), cResetGate.getGradient(),
                           Gradient, ELU, cX_IA.Activation(), GELU))
      return false;
Zunächst wird der Gradient der endgültigen Ausgabe der Zelle auf den Kontext cContext, das Ergebnis der Interpolation Attention cX_IA und das Reset-Gate cResetGate verteilt. Dabei werden alle Ableitungen in Bezug auf die entsprechenden Aktivierungsfunktionen berücksichtigt.
Anschließend wird der Gradient des internen Speicherzustands cContext rekonstruiert. Da er aus dem Produkt der Ausgabe des Haupt-Konvolutionsmoduls cX_AGCN mit der cForgetGate-Maske gebildet wird, wird eine ähnliche Operation der Backpropagation verwendet. Hier kommen andere Aktivierungsfunktionen und andere Gradienten zum Einsatz, und das Ergebnis wird im cContext-Objekt akkumuliert.
//--- Context
   if(!GateElementMultGrad(cContext.getOutput(), cContext.getPrevOutput(),
                           cX_AGCN.getOutput(), cX_AGCN.getGradient(),
                           cForgetGate.getOutput(), cForgetGate.getGradient(),
                           cContext.getGradient(), None,
                           cX_AGCN.Activation(), GELU))
      return false;
Als Nächstes folgt einer der kritischsten Schritte – die Rückführung der Gradienten an das cX_IA-Modul für Interpolation Attention. Da es als gemeinsamer Vorgänger der drei Zweige diente, sind drei unabhängige Aufrufe von CalcHiddenGradients erforderlich, jeweils einer für jeden Pfad: den Hauptzweig (cX_AGCN), das Forget-Gate (cForgetGate) und das Reset-Gate (cResetGate).
//--- Gradient to Interpolation Attention
   if(!cX_IA.CalcHiddenGradients(cX_AGCN.AsObject(), SecondInput,
                                 SecondGradient, SecondActivation) ||
      !SumAndNormilize(cX_IA.getGradient(), cX_IA.getPrevOutput(),
                       cX_IA.getPrevOutput(), cForgetGate.GetWindow(), false, 0, 0, 0, 1))
      return false;
   if(!cX_IA.CalcHiddenGradients(cForgetGate.AsObject(), SecondInput,
                                 GetPointer(bTemp), SecondActivation) ||
      !SumAndNormilize(cX_IA.getGradient(), cX_IA.getPrevOutput(),
                       cX_IA.getPrevOutput(), cForgetGate.GetWindow(), false, 0, 0, 0, 1) ||
      !SumAndNormilize(SecondGradient, GetPointer(bTemp),
                       SecondGradient, cForgetGate.GetUnits(), false, 0, 0, 0, 1))
      return false;
   if(!cX_IA.CalcHiddenGradients(cResetGate.AsObject(), SecondInput,
                                 GetPointer(bTemp), SecondActivation) ||
      !SumAndNormilize(cX_IA.getGradient(), cX_IA.getPrevOutput(),
                       cX_IA.getPrevOutput(), cForgetGate.GetWindow(), false, 0, 0, 0, 1) ||
      !SumAndNormilize(SecondGradient, GetPointer(bTemp), SecondGradient,
                       cForgetGate.GetUnits(), false, 0, 0, 0, 1))
      return false;
Nach jedem Aufruf wird das Ergebnis im Puffer bTemp summiert und sorgfältig in SecondGradient zurückgeschrieben, wodurch sichergestellt wird, dass alle Beiträge in einem einzigen Ausgabestrom akkumuliert werden.
Abschließend wird für das NeuronOCL-Quelldatenobjekt, das mit cX_IA verknüpft ist, die Berechnung des verborgenen Gradienten aufgerufen. Damit ist die Kette der Backpropagation abgeschlossen, und es wird sichergestellt, dass alle Informationen darüber, wie sich Änderungen an den Eingabedaten auf die Ausgabe auswirken, korrekt bis zum Anfang des Modells zurückpropagiert werden.
//---
   if(!NeuronOCL.CalcHiddenGradients(cX_IA.AsObject()))
      return false;
//---
   return true;
  }
Somit implementiert das Verfahren einen sequenziellen und gewichteten Mechanismus zur Aggregation und Propagierung von Gradienten in alle Richtungen. Dadurch wird ein korrektes Training einer komplexen, mehrkomponentigen Struktur wie GinAR gewährleistet, bei der jede Ausgabe gleichzeitig mehrere Rechenzweige beeinflusst.
Der vollständige Code für diese Klasse und alle ihre Methoden ist im Anhang zum Selbststudium enthalten. Bei Bedarf können Sie die Berechnungskette, die Struktur der Abhängigkeiten zwischen den Komponenten und die Logik der Datenübertragung in jeder Phase – vom Vorwärtsdurchlauf über die Backpropagation bis hin zu den Gewichtsaktualisierungen – problemlos nachvollziehen.
Wir haben umfangreiche Arbeit geleistet – Schritt für Schritt haben wir die Architektur, die Methoden und die interne Logik der zentralen Komponenten analysiert und damit eine solide Grundlage für die nächsten Schritte geschaffen. Ich schlage vor, wir machen eine kurze Pause, kommen erst einmal zu Atem und lassen unsere Gedanken zur Ruhe kommen. Im nächsten Artikel werden wir diese Diskussion zu ihrem logischen Abschluss bringen: Wir werden von der Theorie zur Praxis übergehen und die tatsächliche Wirksamkeit der umgesetzten Lösungen anhand von Marktdaten bewerten.
Fazit
In diesem Artikel haben wir eine eingehende Analyse der Architektur der zentralen Komponenten des GinAR-Frameworks durchgeführt. Wir haben den Initialisierungsprozess der Komponenten Schritt für Schritt untersucht, die Implementierung des Vorwärtsdurchlaufs erörtert und einen detaillierten Einblick in die Algorithmen zur Backpropagation gegeben. Besonderes Augenmerk wurde darauf gelegt, wie Attention-Module, Graphkonvolutionen und Steuer-Gates zusammenwirken, wodurch eine flexible und ausdrucksstarke Struktur geschaffen werden konnte.
Diese Modularität vereinfacht nicht nur die Skalierung, sondern ebnet auch den Weg für die Integration komplexerer Steuerblöcke – sei es im Kontext von Reinforcement Learning oder für Prognoseaufgaben mit Abhängigkeiten zwischen Variablen.
Literaturverzeichnis
- GinAR: An End-To-End Multivariate Time Series Forecasting Model Suitable for Variable Missing
- Weitere Artikel dieser Reihe
In diesem Artikel verwendete Programme
| # | Name | Typ | Beschreibung |
|---|---|---|---|
| 1 | Study.mq5 | Expert Advisor | Expert Advisor für das Offline-Modelltraining |
| 2 | StudyOnline.mq5 | Expert Advisor | Expert Advisor für Online-Modelltraining |
| 3 | Test.mq5 | Expert Advisor | Expert Advisor für Modelltests |
| 4 | Trajectory.mqh | Klassenbibliothek | Struktur zur Beschreibung des Systemzustands und der Modellarchitektur |
| 5 | NeuroNet.mqh | Klassenbibliothek | Klassenbibliothek zum Erstellen eines neuronalen Netzes |
| 6 | NeuroNet.cl | Bibliothek | Codebibliothek für das OpenCL-Programm |
Übersetzt aus dem Russischen von MetaQuotes Ltd.
Originalartikel: https://www.mql5.com/ru/articles/18892
Warnung: Alle Rechte sind von MetaQuotes Ltd. vorbehalten. Kopieren oder Vervielfältigen untersagt.
Dieser Artikel wurde von einem Nutzer der Website verfasst und gibt dessen persönliche Meinung wieder. MetaQuotes Ltd übernimmt keine Verantwortung für die Richtigkeit der dargestellten Informationen oder für Folgen, die sich aus der Anwendung der beschriebenen Lösungen, Strategien oder Empfehlungen ergeben.

 Neuronale Netze im Handel: Ein End-to-End-Modell zur multivariaten Zeitreihenprognose (Fazit)
 Neuronale Netze im Trading: Ein Ende-zu-Ende-Modell für die multivariate Zeitreihenprognose (GinAR)
 Vom Anfänger zum Fortgeschrittenen: Objekte (I)
 Neuronale Netze im Handel: Probabilistische Zeitreihenprognose (Fazit)

- Freie Handelsapplikationen
- Über 8.000 Signale zum Kopieren
- Wirtschaftsnachrichten für die Lage an den Finanzmärkte
Sie stimmen der Website-Richtlinie und den Nutzungsbedingungen zu.
Ein sehr interessanter Artikel und eine wertvolle Fortsetzung der GinAR-Implementierungsreihe. Die Architektur hat unser Interesse geweckt, da wir derzeit ein umfassenderes, mehrstufiges Forschungsframework für maschinelles Lernen im Bereich des algorithmischen Handels entwickeln und einer der Bereiche, mit denen wir uns intensiv beschäftigen, die Frage ist, ob eine assetübergreifende Modellierung Informationen liefern kann, die von herkömmlichen, auf einzelne Wertpapiere bezogenen Modellen nicht erfasst werden.
Unser Rahmenwerk ist bewusst in unabhängige Schichten unterteilt: Erfassung von Marktdaten, Feature-Engineering, Erstellung historischer Datensätze, Modellforschung, Validierung, Generierung von Handelskandidaten und Ausführung. Maschinelles Lernen wird eher als Evidenzschicht betrachtet denn als Quelle direkter Handelsentscheidungen. Ein Modell darf daher nachgelagerte Handelsentscheidungen nicht allein deshalb beeinflussen, weil es innerhalb der Stichprobe gute Ergebnisse liefert; es muss zunächst einen stabilen, inkrementellen Mehrwert außerhalb der Stichprobe nachweisen.
Derzeit arbeiten wir mit einem Multi-Asset-Universum, das Devisen, Gold, US-Indizes, Aktien und Energieinstrumente umfasst. Historische Daten werden über eine „Bronze → Silber → Gold“-Pipeline verarbeitet, wobei strenge Kontrollen zu bestimmten Zeitpunkten erfolgen. Informationen, die zum Zeitpunkt der Entscheidung verfügbar sind, werden von zukünftigen Informationen getrennt gehalten, die für Labels und die Ergebnisanalyse verwendet werden.
Unser aktueller „Gold“-Trainingsdatensatz enthält 142 Quellmerkmale pro Beobachtung, bestehend aus 129 numerischen und 13 kategorialen Merkmalen. Der Merkmalssatz umfasst Volatilität, Trend, Momentum, Marktstruktur, Break-Verhalten, Preisaktionskontext, Liquiditätsbedingungen, Sitzungsstatus und andere deterministische Marktdeskriptoren.
Vor dem Testen von GinAR hatten wir bereits eine Modellfamilie der zweiten Generation unter Verwendung von logistischer Regression, XGBoost, LightGBM und CatBoost aufgebaut. Diese Modelle wurden mittels chronologischer Walk-Forward-Validierung, Schwellenwert-Screening, Bootstrap-Stabilitätsanalyse, Kalibrierungsprüfungen, Regime-Analyse und einer unberührten Holdout-Phase evaluiert.
Zehn Instrumente erreichten unsere „Deep Validation PASS“-Kandidatenphase:
GBPUSD, USDCHF, US500, US30, USDCAD, EURUSD, USDJPY, EURGBP, USTEC und XAUUSD.
Diese bildeten das anfängliche Forschungsuniversum für unser GinAR-Experiment.
Was GinAR für uns besonders interessant machte, ist, dass es etwas einführt, das sich grundlegend von unseren bestehenden Modellen unterscheidet. Unsere aktuellen GEN2-Modelle sind größtenteils symbolbezogene Klassifikatoren, während GinAR die Möglichkeit bietet, dynamische, assetübergreifende Beziehungen und latente Darstellungen über mehrere Instrumente hinweg gleichzeitig zu erlernen.
Dies ist auf den Finanzmärkten besonders relevant, da Finanzinstrumente nicht unabhängig voneinander sind. Die Beziehungen zwischen Währungen, Gold, Aktienindizes und anderen Vermögenswerten ändern sich je nach Marktumfeld, Volatilität und Handelsstruktur. Zudem gibt es in einem Multi-Asset-Handelsuniversum naturgemäß Zeiträume, in denen nicht alle Instrumente gleichzeitig über gültige Kurse oder aktive Handelssitzungen verfügen.
Aus diesem Grund haben wir einen völlig separaten GinAR-Forschungszweig eingerichtet, der über keine Handelsbefugnis verfügt und keine Auswirkungen auf unser bestehendes Ausführungssystem hat.
Das Ziel bestand nicht darin, die in diesem Artikel beschriebene Implementierung Zeile für Zeile nachzubilden oder unsere bestehenden Modelle sofort zu ersetzen. Stattdessen wollten wir eine enger gefasste Forschungsfrage beantworten:
Kann ein assetübergreifendes Graphmodell im GinAR-Stil zusätzliche Out-of-Sample-Informationen liefern, die über unsere bestehenden GEN2-Modelle auf Symbolbasis hinausgehen?
Unsere Implementierung war daher ein „Clean-Room“-Forschungsmodell im Stil von GinAR, das auf den wichtigsten architektonischen Ideen basierte:
Für das erste Experiment verwendeten wir den gemeinsamen numerischen Teil des Gold-Feature-Kontrakts, wodurch das Modell 129 numerische Merkmale pro Knoten erhielt.
Als Ziel wurde in diesem Experiment ein 240-minütiges WHIPSAW-Klassifizierungsproblem verwendet.
Die Integrität der Labels erwies sich als wichtiges methodisches Problem. Unsere historischen Labels enthalten:
WHIPSAW
NO_WHIPSAW
AMBIGUOUS_FIRST_MOVE
und in einigen Fällen INCOMPLETE.
„AMBIGUOUS_FIRST_MOVE“ tritt auf, wenn beide Barrieren für den ersten Zug innerhalb desselben M1-Balkens berührt werden, was bedeutet, dass die tatsächliche Reihenfolge innerhalb des Balkens anhand der verfügbaren Quelldaten nicht bestimmt werden kann.
Wir haben daher explizit Folgendes verwendet:
AMBIGUOUS_DO_NOT_GUESS
.
Der binäre Zielkontrakt lautete:
WHIPSAW = 1
NO_WHIPSAW = 0
während AMBIGUOUS_FIRST_MOVE und INCOMPLETE aus den binären Verlust- und Bewertungsmetriken ausgeschlossen wurden, anstatt zwangsweise einer der beiden Klassen zugeordnet zu werden.
Dieser Punkt war für uns wichtig, da die Umwandlung mehrdeutiger Ergebnisse in eine der beiden Klassen künstliches Label-Rauschen verursachen würde.
Außerdem hielten wir strenge Maßnahmen gegen das „Anti-Look-Ahead“ ein.
Das Validierungsprotokoll lautete:
180 Tage Training
30 Tage Validierung
60-tägiger Walk-Forward-Schritt
240-minütige Bereinigung/Lücke
60-tägiger abschließender, unberührter Holdout
Der abschließende Holdout-Satz blieb während des anfänglichen GinAR-Experiments versiegelt.
Wir haben bewusst auf eine zufällige Aufteilung in Trainings- und Testdaten verzichtet.
Ein weiterer wichtiger Punkt betrifft fehlende Variablen. Die „Interpolation Attention“ von GinAR ist potenziell sehr nützlich für eine Handelsumgebung mit mehreren Vermögenswerten, in der Instrumente aufgrund unterschiedlicher Handelssitzungen vorübergehend nicht verfügbar sein können.
Wir haben das Modell jedoch nicht zur Generierung historischer Beobachtungen verwendet.
Fehlende Quellbeobachtungen blieben in den ursprünglichen Datensätzen unberücksichtigt und wurden explizit durch Masken dargestellt. Interne Interpolation wurde nur als Teil der neuronalen Darstellung verwendet. Es wurden keine rekonstruierten Werte in unsere Gold-Datensätze zurückgeschrieben.
Anschließend trainierten wir das GinAR-Forschungsmodell über 6 chronologische Walk-Forward-Folds hinweg.
Die Anzahl der gültigen Zielbeobachtungen war groß und über die Folds hinweg relativ stabil. Die daraus resultierende OOF-Auswertung lieferte etwa 114.558 Out-of-Fold-Vorhersagen.
Die PR-AUC-Werte über die sechs Folds waren:
Fold 1: 0,6894
Fold 2: 0,6910
Fold 3: 0,6833
Fold 4: 0,6866
Fold 5: 0,6584
Faltung 6: 0,6999
Die meisten Folds waren relativ stabil, obwohl Fold 5 deutlich schwächer ausfiel. Wir halten diesen Zeitraum für besonders interessant im Hinblick auf eine spätere Regime- und Graphstrukturanalyse.
Der nächste Schritt war der Teil, den wir als am wichtigsten erachteten: ein direkter Vergleich mit unseren bestehenden GEN2-Champion-Modellen.
Wir haben die GinAR-OOF-Vorhersagen mit den entsprechenden GEN2-Vorhersagen am gleichen Schnittpunkt aus Symbol und Zeitstempel abgeglichen.
Der Vergleich umfasste 90.122 abgeglichene Beobachtungen außerhalb des Folds.
Das Ergebnis lautete:
Delta PR-AUC: -0,0161
Delta LogLoss: +0,0059
Da ein höherer PR-AUC-Wert und ein niedrigerer LogLoss-Wert wünschenswert sind, sprach das aktuelle Ergebnis eindeutig für die bestehenden GEN2-Modelle.
Mit anderen Worten: In unserem ersten Experiment konnte GinAR als eigenständiger WHIPSAW-Klassifikator unsere bestehende Modellfamilie aus logistischer Regression, XGBoost, LightGBM und CatBoost nicht übertreffen.
Wir haben GinAR daher nicht als Ersatz für GEN2 empfohlen.
Ich glaube jedoch nicht, dass dieses Ergebnis GinAR für Finanzanwendungen uninteressant macht.
Tatsächlich könnte das Experiment darauf hindeuten, dass der wertvollste Teil der Architektur nicht unbedingt der abschließende eigenständige Klassifikator ist.
GinAR erzeugt eine assetübergreifende latente Darstellung, über die unsere unabhängigen, symbolbezogenen Modelle von Natur aus nicht verfügen.
Aus diesem Grund behalten wir GinAR als Forschungs-Encoder bei und ändern die nächste Forschungsfrage von:
„Kann GinAR GEN2 ersetzen?“
in:
„Kann GinAR GEN2 um assetübergreifende Informationen ergänzen?“
Unser nächstes geplantes Experiment lautet daher:
GEN2-Baseline
versus
GEN2 + GinAR-anlageklassenübergreifende Einbettungen
unter Verwendung von „fold-safe Stacking“, Wahrscheinlichkeits-Diskrepanz-Analyse, Regime-Analyse, Graph-Stabilitäts-Analyse und Ablationsversuchen.
Unser besonderes Interesse gilt der Untersuchung von Fällen, in denen der GEN2-Champion falsch liegt, während GinAR richtig liegt, und umgekehrt. Sollten sich diese Fehlermengen ausreichend unterscheiden, könnte die GinAR-Darstellung trotz ihres niedrigeren eigenständigen PR-AUC-Werts dennoch als zusätzliche Merkmalsschicht nützlich sein.
Außerdem planen wir zu untersuchen, ob die gelernte Adjazenzmatrix über die Zeit stabil bleibt oder ob sich die Beziehungen zwischen den Instrumenten über verschiedene Volatilitäts- und Marktregime hinweg wesentlich verändern.
Hier könnten graphbasierte Modelle unserer Ansicht nach in Handelssystemen besonders nützlich werden.
Beispielsweise die Relevanz von Beziehungen wie:
Gold ↔ USD,
Devisen ↔ US-Indizes,
USDCAD ↔ Energie,
oder USTEC ↔ große Technologiewerte
nicht unbedingt davon auszugehen, dass sie über die Zeit hinweg konstant bleibt.
Ein Modell, das in der Lage ist, diese Zusammenhänge dynamisch zu erlernen, kann wertvolle Einblicke liefern, selbst wenn sein direkter Klassifikationskopf für sich genommen nicht der stärkste Prädiktor ist.
Eine methodische Erkenntnis aus unserem Experiment ist ebenfalls erwähnenswert: Es ist sehr leicht, eine neue neuronale Architektur allein anhand des Trainingsverlusts oder eines einzigen Backtests zu beurteilen. Unsere Ergebnisse veränderten die Interpretation des Modells, sobald wir es mit einem bestehenden Benchmark anhand derselben „Out-of-Fold“-Beobachtungen verglichen.
Für uns ist diese Art des Vergleichs unerlässlich.
Ein neues Modell sollte nicht allein deshalb als nützlich angesehen werden, weil es eine vernünftige Metrik liefert. Es muss entweder Folgendes nachweisen:
Zu diesem Zeitpunkt lautet unsere Schlussfolgerung daher:
GinAR ist derzeit kein besserer eigenständiger Klassifikator als unsere GEN2-Modelle, bleibt jedoch ein vielversprechender Kandidat als Schicht zur anlageklassenübergreifenden Darstellung und Merkmalsgenerierung.
Wir haben den endgültigen, unberührten Holdout-Datensatz bewusst bis zur Festlegung der nächsten Forschungsphase unter Verschluss gehalten, um zu vermeiden, dass der Holdout-Datensatz wiederholt für Entscheidungen zur Modellentwicklung herangezogen wird.
Ich wäre sehr daran interessiert, die kommenden Experimente des Autors mit realen Marktdaten zu sehen, insbesondere:
Vielen Dank für die Veröffentlichung dieser Serie. Sie stellt eine der interessanteren Ansätze dar, die wir bisher bei der Anwendung multivariater, graphbasierter Lernverfahren auf finanzielle Zeitreihen kennengelernt haben.
Auch wenn unser erster unabhängiger Vergleich keinen eigenständigen Vorteil gegenüber GEN2 zeigte, eröffnete das Experiment für uns eine neue und potenziell nützlichere Forschungsrichtung: die Nutzung von GinAR als anlageklassenübergreifende Intelligenzebene statt lediglich als weiteren Klassifikator.
Ich freue mich auf den nächsten Artikel und wäre sehr daran interessiert, unsere Ergebnisse mit den Marktdaten-Ergebnissen des Autors zu vergleichen.