

Redes neurais em trading: Modelo multidimensional de ponta a ponta para previsão de séries temporais (Componentes principais)
 443
 1

Introdução
No artigo anterior, analisamos detalhadamente o framework GinAR, uma arquitetura moderna para trabalhar com séries temporais, que combina as vantagens das redes neurais baseadas em grafos com a possibilidade de treinamento em dados assíncronos, incompletos e heterogêneos. A ideia central da abordagem é interpretar a série temporal não como uma sequência plana de observações, mas como uma estrutura em grafo, na qual variáveis individuais ou pontos temporais podem estar ligados entre si por interdependências arbitrárias e treináveis. Essa perspectiva é especialmente relevante para tarefas de modelagem financeira, em que os dados costumam ser irregulares, conter lacunas e apresentar relações latentes complexas.
O GinAR foi proposto como uma ferramenta universal para resolver esse tipo de problema. Sua estrutura modular inclui vários componentes-chave:
- mecanismo Interpolation Attention, que permite reconstruir valores ausentes por meio da agregação de informações das variáveis observadas;
- camadas em grafo com pesos treináveis individuais;
- funções adaptativas de normalização, que garantem a robustez do modelo a outliers e à instabilidade de escala.
O mecanismo Interpolation Attention ocupa um lugar central na arquitetura; não se trata de um núcleo clássico de Self-Attention, mas de um módulo adaptativo completo, capaz de levar em conta tanto as dependências globais entre as variáveis quanto o contexto local das observações. Na prática, isso significa que o modelo é capaz, por exemplo, de prever o valor de um indicador financeiro mesmo quando suas últimas medições estão ausentes, utilizando a estrutura dos indicadores vizinhos e o quadro geral do mercado. Essa abordagem é fundamental em condições reais, nas quais os dados frequentemente chegam com atraso, de forma irregular ou com grandes lacunas.
Uma característica do GinAR é a capacidade de reconfigurar dinamicamente a estrutura em grafo durante o treinamento. Ao contrário da maioria dos modelos baseados em grafos, em que a estrutura é fixada antecipadamente, aqui ela é formada durante o processo de treinamento. Isso permite levar em conta mudanças nas condições de mercado, nas correlações e nos fatores ocultos. O modelo decide de forma autônoma quais variáveis devem ser conectadas entre si, quais devem ter essa conexão enfraquecida e quais devem ser destacadas como centrais para o contexto atual. Assim, obtém-se uma arquitetura flexível, capaz de se adaptar aos regimes de mercado e à sua dinâmica.
A visualização autoral do framework GinAR é apresentada a seguir.
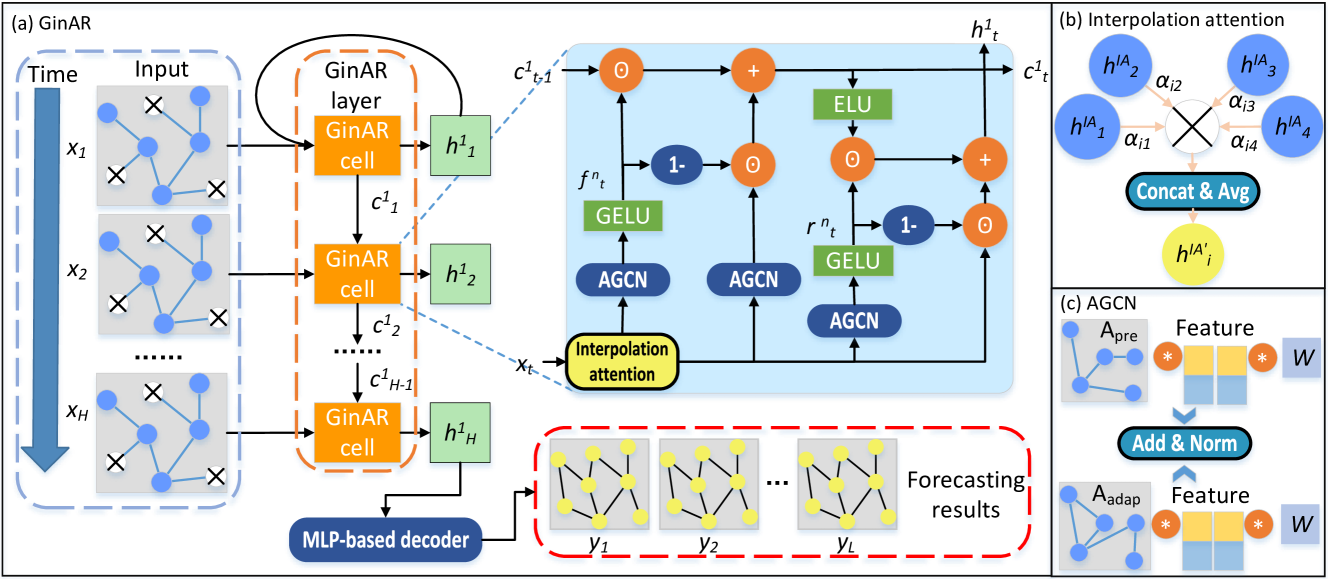
Na parte prática do artigo anterior, realizamos um volume significativo de trabalho, estabelecendo a base para os cálculos no código OpenCL. Foram implementadas todas as funções-chave, desde reduções locais e cálculo de SoftMax até a propagação para frente e a propagação reversa no módulo Interpolation Attention. Foi dada atenção especial ao processamento correto da memória local, à sincronização das threads e à estabilidade numérica, algo especialmente importante ao trabalhar com séries temporais incompletas em condições de computação paralela.
Essa preparação nos abre o caminho para a próxima etapa, a integração do núcleo do modelo ao programa principal. É aqui que o algoritmo começará a ganhar vida: os dados virão do ambiente de trading, serão processados com dispositivos OpenCL, passarão pelo modelo e retornarão na forma de previsões e decisões de trading. Essa ponte entre a lógica de alto nível e os cálculos acelerados de baixo nível é uma parte fundamental de toda a nossa implementação da arquitetura GinAR.
Interpolation Attention
Hoje teremos de realizar um grande volume de trabalho prático relacionado à implementação dos principais componentes do framework GinAR. Por isso, não vamos nos alongar na teoria e passaremos direto ao que interessa.
O primeiro passo será a criação do módulo mais importante, o Interpolation Attention, que implementaremos na forma de uma classe separada, CNeuronInterpolationAttention. Essa classe herda do objeto base das camadas neurais em nossa biblioteca CNeuronBaseOCL e implementa toda a lógica necessária, permitindo usar com eficiência os kernels OpenCL preparados anteriormente em todo o ciclo de propagação para frente e propagação reversa.
class CNeuronInterpolationAttention :  public CNeuronBaseOCL
  {
protected:
   //---
   uint                 iCount;
   uint                 iDimension;
   //---
   CParams              cW;
   CParams              cA;
   CParams              cGL;
   //---
   CNeuronBaseOCL       cH;
   CNeuronBaseOCL       cAdj;
   CNeuronBaseOCL       cAttention;
   //---
   virtual bool      InterpolationAttention(CNeuronBaseOCL *NeuronOCL);
   virtual bool      InterpolationAttentionGrad(CNeuronBaseOCL *NeuronOCL);
   virtual bool      feedForward(CNeuronBaseOCL *NeuronOCL) override;
   virtual bool      updateInputWeights(CNeuronBaseOCL *NeuronOCL) override;
   virtual bool      calcInputGradients(CNeuronBaseOCL *NeuronOCL) override;

public:
                     CNeuronInterpolationAttention(void) { activation = None; }
                    ~CNeuronInterpolationAttention(void) {};
   //---
   virtual bool      Init(uint numOutputs, uint myIndex, COpenCLMy *open_cl,
                          uint units_count, uint dimension,
                          ENUM_OPTIMIZATION optimization_type, uint batch);
   //---
   virtual bool      Save(const int file_handle) override;
   virtual bool      Load(const int file_handle) override;
   //---
   virtual int       Type(void) override const {  return defNeuronInterpolationAttention; }
   virtual void      TrainMode(bool flag) override;
   virtual void      SetOpenCL(COpenCLMy *obj);
   //---
   virtual bool      WeightsUpdate(CNeuronBaseOCL *source, float tau);
   virtual void      SetActivationFunction(ENUM_ACTIVATION value) override {};
  };
A classe contém um conjunto de variáveis internas, entre as quais iCount e iDimension são responsáveis pela quantidade de elementos no tensor dos dados de entrada, enquanto os objetos cW, cA e cGL representam os parâmetros das matrizes treináveis. Também são definidos separadamente objetos intermediários para armazenar resultados intermediários das representações ocultas, do grafo de adjacência e dos pesos de atenção.
A lógica computacional principal está encapsulada nos métodos InterpolationAttention e InterpolationAttentionGrad, responsáveis, respectivamente, pela propagação para frente e pela propagação reversa do modelo. Neles, é realizado o processo de preparação e de enfileiramento da execução dos kernels correspondentes do programa OpenCL, que criamos no trabalho prático do artigo anterior. Como eles utilizam um algoritmo que já nos é familiar, não vamos nos deter neles no âmbito deste artigo. O código completo desses métodos é apresentado em anexo para estudo independente.
Todos os objetos internos da classe CNeuronInterpolationAttention são declarados como estáticos, o que simplifica a gestão do ciclo de vida da instância. Graças a isso, é possível deixar o construtor e o destrutor da classe vazios, pois eles não exigem inicialização explícita nem liberação de recursos. Toda a configuração necessária, incluindo a inicialização dos próprios membros e dos componentes herdados da classe pai, é realizada de forma centralizada no método Init. Isso garante uma estrutura de inicialização limpa e previsível, evitando duplicação de código e aumentando a confiabilidade na reutilização do módulo em diferentes configurações do modelo.
bool CNeuronInterpolationAttention::Init(uint numOutputs, uint myIndex, COpenCLMy *open_cl,
                                         uint units_count, uint dimension,
                                         ENUM_OPTIMIZATION optimization_type, uint batch)
  {
   if(!CNeuronBaseOCL::Init(numOutputs, myIndex, open_cl, units_count * dimension,
                                                        optimization_type, batch))
      return false;
No corpo do método, primeiro chamamos o método homônimo da classe pai CNeuronBaseOCL. Nesse processo, o tamanho da camada é recalculado levando em conta a dimensão espacial do sinal de entrada.
Em seguida, são armazenados os principais parâmetros do modelo, a quantidade de variáveis e a dimensionalidade da representação, para uso nos cálculos e na gestão dos buffers internos. Esses parâmetros determinam o tamanho de todos os demais vetores e matrizes que serão usados ao longo da propagação para frente e da propagação reversa.
iCount = units_count;
iDimension = dimension;
O bloco de código seguinte corresponde à inicialização dos parâmetros e dos tensores intermediários envolvidos no mecanismo Interpolation Attention. Primeiro, são criados os pesos treináveis cW, que representam uma matriz individual de interação entre as variáveis. Trata-se de uma matriz quadrada dimension × dimension.
int index = 0;
if(!cW.Init(0, index, OpenCL, iDimension * iDimension, optimization, iBatch))
   return false;
Em seguida, são inicializados os parâmetros cA, responsáveis pela agregação da atenção entre os nós.
index++;
if(!cA.Init(0, index, OpenCL, 2 * iDimension, optimization, iBatch))
   return false;
index++;
if(!cGL.Init(0, index, OpenCL, iDimension * iDimension, optimization, iBatch))
   return false;
Em seguida, é criado o objeto cGL, que representa os vetores latentes das variáveis. Ele também tem dimensão dimension × dimension.
Após a inicialização de todos os parâmetros treináveis, começa a configuração dos objetos auxiliares responsáveis pelo armazenamento dos resultados intermediários. O buffer cH representa a matriz de transformações lineares do sinal de entrada, obtida pela multiplicação da entrada pelos pesos. Sua dimensão é units_count × dimension.
index++;
if(!cH.Init(0, index, OpenCL, iCount * iDimension, optimization, iBatch))
   return false;
Na sequência, temos o objeto cAdj, no qual são armazenados os valores da correlação ajustada entre as variáveis.
   index++;
   if(!cAdj.Init(0, index, OpenCL, iDimension * iDimension, optimization, iBatch))
      return false;
   index++;
   if(!cAttention.Init(0, index, OpenCL, iDimension * iDimension, optimization, iBatch))
      return false;
//---
   return true;
  }
E, por fim, cAttention é o tensor dos valores finais de atenção, obtidos após a normalização via SoftMax.
Cada inicialização é acompanhada de uma verificação de sucesso. Em caso de falha em qualquer etapa, o método retorna imediatamente false, garantindo proteção confiável contra erros de configuração.
Se todos os objetos forem configurados com sucesso e alocados na memória do dispositivo OpenCL, o método conclui sua execução retornando true. Isso significa que a camada está totalmente pronta para ser executada e pode ser usada como parte do modelo.
Depois de concluir o trabalho de inicialização do objeto, passamos à implementação do processo de propagação para frente, que realizaremos no método feedForward. Sua tarefa é preparar corretamente todos os dados de entrada e iniciar o cálculo principal com o uso do kernel OpenCL desenvolvido anteriormente. O algoritmo é bastante compacto, mas inclui várias etapas-chave, cada uma desempenhando uma função importante no esquema geral de funcionamento da camada.
bool CNeuronInterpolationAttention::feedForward(CNeuronBaseOCL *NeuronOCL)
  {
   if(bTrain)
     {
      if(!cW.FeedForward())
         return false;
      if(!cA.FeedForward())
         return false;
      if(!cGL.FeedForward())
         return false;
     }
   if(!InterpolationAttention(NeuronOCL))
      return false;
//---
   return true;
  }
Antes de tudo, o método verifica se a flag bTrain está ativa, indicando que a camada está no modo de treinamento. Isso é fundamental, pois, nesse caso, os parâmetros treináveis do modelo precisam antes passar por seus próprios métodos FeedForward. Essa chamada é necessária para atualizar seus valores e garantir sua participação no ciclo computacional atual. As três chamadas são acompanhadas de verificação de sucesso e, diante da menor falha, o método interrompe imediatamente a execução, retornando false. Isso permite evitar a situação em que parâmetros não inicializados ou incorretos sigam para os cálculos posteriores.
Após a conclusão de todas as etapas preparatórias, é feita a chamada ao método principal InterpolationAttention. É ele que inicializa a execução do kernel OpenCL responsável pelo cálculo da atenção, pela agregação dos valores e pela formação da representação de saída da camada.
O método conclui seu trabalho retornando ao programa chamador o resultado lógico da execução das operações.
O método calcInputGradients é implementado de forma extremamente concisa, pois toda a lógica de retropropagação do erro já foi transferida para o kernel OpenCL correspondente. Aqui, simplesmente chamamos a função wrapper InterpolationAttentionGrad, responsável por executar o kernel e transmitir os buffers necessários. E retornamos ao programa chamador o resultado lógico da execução das operações.
bool CNeuronInterpolationAttention::calcInputGradients(CNeuronBaseOCL *NeuronOCL)
  {
   if(!InterpolationAttentionGrad(NeuronOCL))
      return false;
//---
   return true;
  }
Essa implementação preserva integralmente a estrutura geral de funcionamento das camadas neurais, permitindo usar esse módulo em igualdade de condições com outros tipos de camadas, sem qualquer alteração na lógica de treinamento. Isso destaca a flexibilidade arquitetural do sistema e torna a integração de novas soluções o mais simples e segura possível.
A atualização dos parâmetros treináveis no módulo foi implementada de forma extremamente compacta e lógica. Todos os pesos envolvidos nos cálculos são objetos internos da classe (cW, cA, cGL), cada um dos quais encapsula seu próprio algoritmo de atualização. O método updateInputWeights apenas chama para eles as funções correspondentes, garantindo modularidade e limpeza arquitetural.
bool CNeuronInterpolationAttention::updateInputWeights(CNeuronBaseOCL *NeuronOCL)
  {
   if(!cW.UpdateInputWeights())
      return false;
   if(!cA.UpdateInputWeights())
      return false;
   if(!cGL.UpdateInputWeights() ||
      !Normilize(cGL.getWeightsParams(), 2 * iDimension))
      return false;
//---
   return true;
  }
Foi dada atenção especial ao tensor cGL, que, após a atualização, passa adicionalmente por normalização com a ajuda da função Normilize. Isso é necessário porque cGL contém os pesos das relações de correlação entre as variáveis, e a estabilidade desses coeficientes afeta diretamente a robustez de todo o módulo de atenção. A normalização permite suavizar possíveis outliers e preservar a interpretabilidade dos pesos. Assim, esse método conclui integralmente o ciclo de treinamento, sem exigir intervenções ou ajustes adicionais.
O código completo da classe CNeuronInterpolationAttention, assim como a implementação de todos os seus métodos, pode ser consultado no anexo. Deliberadamente, não sobrecarregamos o artigo com detalhes técnicos, para preservar a fluidez da exposição, mas recomendamos o estudo do código-fonte para a compreensão completa da lógica de funcionamento do módulo e de sua integração ao framework GinAR como um todo.
AGCN
O próximo passo lógico na construção do framework GinAR é a implementação do mecanismo de convolução adaptativa em grafo (AGCN). Esse é um elemento central do framework, que permite levar em conta relações complexas entre séries temporais representadas como nós do grafo. Ao contrário das abordagens tradicionais, nas quais a estrutura do grafo é definida previamente e permanece inalterada ao longo do treinamento, a convolução adaptativa permite que o modelo forme e modifique por conta própria a topologia das conexões em função do estado atual dos dados. Essa flexibilidade é crucial ao trabalhar com séries temporais financeiras dinâmicas, cuja estrutura está sujeita a flutuações constantes, inter-relações ocultas e perturbações externas.
Para implementar essa ideia, foi desenvolvido um módulo separado, apresentado na forma da classe CNeuronAGCN. Essa classe herda da camada base totalmente conectada CNeuronBaseOCL e serve para encapsular toda a lógica necessária à execução da convolução adaptativa com uso de aceleração via OpenCL. Sua estrutura interna foi organizada de modo que, em cada etapa do processamento, sejam garantidas a máxima eficiência e a precisão dos cálculos, incluindo extração de características, formação da matriz de conexões, normalização, agregação e treinamento dos pesos do grafo.
A particularidade desse módulo está no fato de que, durante o processamento das informações, ele não se apoia em uma matriz de adjacência fixa, mas a calcula em tempo real. Para isso, os dados de entrada passam por uma sequência de transformações, como resultado da qual é formada uma representação latente de cada nó. Essas representações são usadas para calcular a similaridade entre os nós, com base na qual é construída a matriz de conexões adaptativas. Assim, o modelo, por assim dizer, observa cada série temporal e decide por conta própria com quais outras séries vale a pena conectá-la, e com que intensidade. No fim, obtemos um mecanismo de atenção flexível, em que cada nó é capaz de adaptar seu comportamento em função do contexto.
A estrutura da nova classe é apresentada a seguir.
class CNeuronAGCN    :  public CNeuronBaseOCL
  {
protected:
   CParams              cEa;
   CNeuronSwiGLUOCL     cWx;
   CNeuronSwiGLUOCL     cWe;
   CNeuronBaseOCL       cWconcat_ex;
   CNeuronConvOCL       cEn;
   CNeuronTransposeOCL  cEnT;
   CNeuronBaseOCL       cEnEnT;
   CNeuronSoftMaxOCL    cAadapt;
   CNeuronBaseOCL       cAadaptX;
   CNeuronBaseOCL       cApreX;
   CNeuronSwiGLUOCL     cWadapt;
   CNeuronSwiGLUOCL     cWpre;
   //---
   virtual bool      feedForward(CNeuronBaseOCL *NeuronOCL) override { return false; }
   virtual bool      feedForward(CNeuronBaseOCL *NeuronOCL, CBufferFloat *SecondInput) override;
   virtual bool      updateInputWeights(CNeuronBaseOCL *NeuronOCL) override { return false; }
   virtual bool      updateInputWeights(CNeuronBaseOCL *NeuronOCL, CBufferFloat *second) override;
   virtual bool      calcInputGradients(CNeuronBaseOCL *NeuronOCL) override { return false; }
   virtual bool      calcInputGradients(CNeuronBaseOCL *NeuronOCL,
                                        CBufferFloat *SecondInput,
                                        CBufferFloat *SecondGradient,
                                        ENUM_ACTIVATION SecondActivation = None) override;

public:
                     CNeuronAGCN(void) {activation = None;}
                    ~CNeuronAGCN(void) {};
   //---
   virtual bool      Init(uint numOutputs, uint myIndex, COpenCLMy *open_cl,
                          uint units_count, uint dimension,
                          ENUM_OPTIMIZATION optimization_type, uint batch);
   //---
   virtual bool      Save(const int file_handle) override;
   virtual bool      Load(const int file_handle) override;
   //---
   virtual int       Type(void) override const  {  return defNeuronAGCN; }
   virtual void      TrainMode(bool flag) override;
   virtual void      SetOpenCL(COpenCLMy *obj);
   //---
   virtual bool      WeightsUpdate(CNeuronBaseOCL *source, float tau);
   //---
   virtual uint      GetWindow(void) const      { return cWx.GetWindow(); }
   virtual uint      GetUnits(void) const       { return cWx.GetUnits(); }
   virtual void      SetActivationFunction(ENUM_ACTIVATION value) override {};
  };
Toda a cadeia computacional está concentrada dentro de um único objeto, mas inclui várias camadas auxiliares e operações. A lógica é dividida em etapas, com as quais vamos nos familiarizar durante a implementação dos métodos da classe. As características obtidas na saída podem ser interpretadas como o resultado de uma filtragem coordenada sobre um grafo adaptado, levando em conta a informação semântica e as relações topológicas entre as séries temporais.
Assim como no caso da camada anterior, todos os componentes internos da classe CNeuronAGCN foram declarados como estáticos. Essa abordagem nos permite deixar vazios o construtor e o destrutor da classe, concentrando toda a lógica de inicialização em um único método, Init. Isso garante uma implementação compacta e também facilita o controle do ciclo de vida dos objetos dentro da camada.
bool CNeuronAGCN::Init(uint numOutputs, uint myIndex, COpenCLMy *open_cl,
                       uint units_count, uint dimension,
                       ENUM_OPTIMIZATION optimization_type, uint batch)
  {
   if(!CNeuronBaseOCL::Init(numOutputs, myIndex, open_cl,
                            units_count * dimension, optimization_type, batch))
      return false;
A inicialização começa com a chamada ao método homônimo da classe pai, no qual é realizada a configuração inicial das interfaces e dos parâmetros gerais da camada. Em seguida, todos os componentes-chave da convolução adaptativa são configurados passo a passo.
Na primeira etapa, é criado o objeto cEa, que será usado para codificar informações adicionais sobre a estrutura dos dados.
//---
   int index = 0;
   if(!cEa.Init(0, index, OpenCL, Neurons(), optimization, iBatch))
      return false;
   cEa.SetActivationFunction(None);
Em seguida, são inicializadas duas camadas importantes, cWx e cWe, responsáveis pela extração de características dos dados de entrada e da estrutura da série temporal aprendida anteriormente. Ambas as camadas são implementadas com base no mecanismo SwiGLU e treinadas em paralelo.
index++;
if(!cWx.Init(0, index, OpenCL, dimension, dimension, dimension, units_count,
                                                   1, optimization, iBatch))
   return false;
index++;
if(!cWe.Init(0, index, OpenCL, dimension, dimension, dimension, units_count,
                                                   1, optimization, iBatch))
   return false;
Depois delas, vem o buffer cWconcat_ex, que garante a concatenação das representações no espaço latente.
index++;
if(!cWconcat_ex.Init(0, index, OpenCL, 2 * Neurons(), optimization, iBatch))
   return false;
cWconcat_ex.SetActivationFunction(None);
O próximo elemento da inicialização é a camada cEn, que realiza a transformação linear das características concatenadas. Ela é complementada pelo módulo de transposição cEnT, que prepara os dados para a formação da matriz preliminar de atenção.
index++;
if(!cEn.Init(0, index, OpenCL, 2 * dimension, 2 * dimension, dimension, units_count,
                                                           1, optimization, iBatch))
   return false;
cEn.SetActivationFunction(None);
index++;
if(!cEnT.Init(0, index, OpenCL, units_count, dimension, optimization, iBatch))
   return false;
index++;
if(!cEnEnT.Init(0, index, OpenCL, units_count * units_count, optimization, iBatch))
   return false;
cEnEnT.SetActivationFunction(GELU);
Após a etapa de transposição, os dados preparados são enviados para a operação de multiplicação matricial, na qual é realizado o produto escalar da representação original com sua versão transposta. Como resultado, forma-se uma matriz simétrica de inter-relações, que é armazenada no objeto cEnEnT. É justamente nesse bloco que os valores obtidos passam pela ativação com a função GELU, que permite atenuar suavemente as correlações negativas, sem zerá-las por completo, mas reduzindo ao mesmo tempo sua contribuição para a representação final.
Essa abordagem favorece a identificação dos padrões mais significativos e das relações latentes entre os nós do grafo, algo crucial para a formação da matriz adaptativa de atenção. Em última análise, graças a essa operação, o modelo passa a ser capaz de captar regularidades estruturais mais profundas dentro do grafo e ponderar corretamente as interações entre os nós.
Em seguida, vem a etapa-chave: a normalização dos valores obtidos. Para isso, é usada a função SoftMax, aplicada dentro do objeto cAadapt. Essa operação transforma os coeficientes de peso brutos em uma distribuição de probabilidade, na qual cada conexão entre os nós do grafo recebe um determinado grau de relevância. Assim, dependências fracas e ruidosas são atenuadas, enquanto as fortes e informativas são reforçadas. Como resultado, obtém-se uma matriz adaptativa de atenção completa, que reflete os padrões individuais de interação entre os componentes do sinal de entrada.
index++;
if(!cAadapt.Init(0, index, OpenCL, units_count * units_count, optimization, iBatch))
   return false;
cAadapt.SetHeads(units_count);
A próxima operação lógica é a aplicação dos pesos adaptativos aos dados de entrada. Essa etapa é implementada por meio da ponderação das características de entrada pelos coeficientes de atenção correspondentes. O resultado é armazenado no buffer cAadaptX, que já representa uma versão atualizada e enriquecida pelo contexto do sinal de entrada. Em essência, trata-se de uma projeção renormalizada da informação original, levando em conta as inter-relações identificadas entre os diferentes nós do grafo.
index++;
if(!cAadaptX.Init(0, index, OpenCL, Neurons(), optimization, iBatch))
   return false;
cAadaptX.SetActivationFunction(None);
index++;
if(!cApreX.Init(0, index, OpenCL, Neurons(), optimization, iBatch))
   return false;
cApreX.SetActivationFunction(None);
Uma etapa adicional de processamento é a adaptação dos dados de entrada levando em conta a estrutura do grafo definida previamente. Esse passo tem como objetivo reforçar a influência de conexões conhecidas, a priori, entre os nós, obtidas fora do escopo do modelo de treinamento, por exemplo, com base em relações fundamentais, topologia ou regras de especialistas. O mecanismo aqui é análogo ao anterior: pesos são aplicados ao tensor de entrada, mas agora não a partir da matriz adaptativa de atenção, e sim de uma matriz externa de coeficientes. O resultado é armazenado no buffer cApreX. Assim, o modelo passa a dispor imediatamente de dois canais independentes de informação: um baseado no autoaprendizado e nos padrões identificados, e outro baseado em informação estrutural a priori. A combinação de ambos permite alcançar um equilíbrio maior entre flexibilidade e robustez do modelo.
Por fim, na parte final da inicialização, são criadas duas camadas de convolução: cWadapt e cWpre. Ambas usam a arquitetura SwiGLU, atuando como filtros que adaptam as características à estrutura da matriz de conexões formada.
   index++;
   if(!cWadapt.Init(0, index, OpenCL, dimension, dimension, dimension, units_count,
                                                          1, optimization, iBatch))
      return false;
   cWadapt.SetActivationFunction(None);
   index++;
   if(!cWpre.Init(0, index, OpenCL, dimension, dimension, dimension, units_count, 1,
                                                              optimization, iBatch))
      return false;
   cWpre.SetActivationFunction(None);
   SetActivationFunction(None);
//---
   return true;
  }
Após a conclusão de todas essas etapas, desativamos explicitamente a função de ativação da camada, já que as não linearidades são aplicadas dentro dos blocos internos e não há necessidade de duplicá-las na saída.
Assim, todo o método Init representa uma sequência de etapas cuidadosamente estruturada, ao longo da qual são criados e configurados todos os elementos da convolução adaptativa. Cada componente é responsável por uma parte específica dos cálculos e se encaixa na arquitetura geral da camada, criando a base para o funcionamento posterior do modelo.
A etapa seguinte do nosso trabalho é o método feedForward, que implementa o ciclo completo de propagação para frente da convolução adaptativa em grafo, levando em conta tanto as conexões estruturais treináveis quanto as definidas externamente. O algoritmo é bastante denso, por isso vamos analisá-lo por etapas, com ênfase na lógica funcional de cada bloco.
bool CNeuronAGCN::feedForward(CNeuronBaseOCL *NeuronOCL, CBufferFloat *SecondInput)
  {
   if(!SecondInput || SecondInput.Total() < cAadapt.Neurons())
      return false;
Antes do início da execução do algoritmo, é feita uma verificação obrigatória da correção dos dados de entrada: se a matriz de coeficientes de correlação predefinidos SecondInput estiver ausente, ou se seu tamanho for insuficiente para a execução das operações matriciais, a execução será interrompida imediatamente.
Em seguida, se o modelo estiver em modo de treinamento, é iniciado o ciclo de preparação dos parâmetros para o ramo responsável pelo contexto adaptativo dos nós. Primeiro, é executada a propagação para frente do objeto cEa, que contém os parâmetros treináveis para o cálculo dos embeddings das arestas. O resultado obtido é transferido para cWe, onde ocorre a formação da matriz de pesos da interação externa, refletindo o contexto das conexões entre os nós na etapa atual do treinamento.
if(bTrain)
  {
   if(!cEa.FeedForward())
      return false;
   if(!cWe.FeedForward(cEa.AsObject()))
      return false;
  }
Paralelamente, é ativado o ramo principal, aquele que trabalha com a sequência principal de características. Nele, é chamado o método de propagação para frente de cWx, formando a representação do estado atual dos nós.
if(!cWx.FeedForward(NeuronOCL))
   return false;
if(!Concat(cWx.getOutput(), cWe.getOutput(), cWconcat_ex.getOutput(),
             cWx.GetWindowOut(), cWe.GetWindowOut(), cWx.GetUnits()))
   return false;
Depois disso, ambos os vetores de saída, cWx e cWe, são concatenados ao longo dos elementos individuais da sequência, permitindo que o modelo leve em conta a informação estrutural e contextual nas operações subsequentes. O resultado obtido é usado em cEn, que implementa uma convolução linear, reduzindo a dimensionalidade e reforçando as características relevantes.
if(!cEn.FeedForward(cWconcat_ex.AsObject()))
   return false;
if(!cEnT.FeedForward(cEn.AsObject()))
   return false;
if(!MatMul(cEn.getOutput(), cEnT.getOutput(), cEnEnT.getOutput(),
             cEnT.GetCount(), cEnT.GetWindow(), cEnT.GetCount()))
   return false;
if(cEnEnT.Activation() != None)
   if(!Activation(cEnEnT.getOutput(), cEnEnT.getOutput(), cEnEnT.Activation()))
      return false;
Na sequência, ocorre a operação-chave: a transposição da matriz obtida e sua multiplicação pela matriz original, o que permite formar uma matriz de correlação simétrica no objeto cEnEnT. Se uma função de ativação tiver sido aplicada a esse objeto, no nosso caso, GELU, ela é chamada para suavizar a influência de ruídos e correlações negativas.
Depois disso, a matriz obtida é transferida para o objeto cAadapt, onde é aplicado o mecanismo SoftMax com o uso de uma estrutura de atenção multi-head. Ele normaliza os pesos por linha e retorna a matriz de atenção adaptada à estrutura atual dos dados. Para reforçar as conexões diagonais, é chamada a função IdentSum, que adiciona uma matriz identidade unitária ao resultado, garantindo a robustez do grafo diante de entradas esparsas.
if(!cAadapt.FeedForward(cEnEnT.AsObject()))
   return false;
if(!IdentSum(cAadapt.getOutput(), cAadapt.getOutput(), cAadapt.Heads()))
   return false;
Em seguida, o modelo calcula dois fluxos paralelos de multiplicação de matrizes. O primeiro fluxo trabalha com os dados externos SecondInput, multiplicando-os pelas saídas atuais da camada neural; o resultado é armazenado no buffer cApreX. O segundo fluxo trabalha de forma análoga com a matriz de atenção cAadapt e as saídas atuais, armazenando o resultado em cAadaptX.
if(!MatMul(SecondInput, NeuronOCL.getOutput(), cApreX.getOutput(),
           cWpre.GetUnits(), cWpre.GetUnits(), cWpre.GetWindow()))
   return false;
if(!MatMul(cAadapt.getOutput(), NeuronOCL.getOutput(), cAadaptX.getOutput(),
           cWadapt.GetUnits(), cWadapt.GetUnits(), cWadapt.GetWindow()))
   return false;
A etapa final é a passagem de ambos os fluxos pelos blocos convolucionais treináveis cWpre e cWadapt. Isso permite que o modelo refine os dados obtidos do ponto de vista das características locais.
   if(!cWpre.FeedForward(cApreX.AsObject()))
      return false;
   if(!cWadapt.FeedForward(cAadaptX.AsObject()))
      return false;
   if(!SumAndNormilize(cWadapt.getOutput(), cWpre.getOutput(), Output, cWadapt.GetWindowOut(), true))
      return false;
//---
   return true;
  }
Depois disso, é chamada a função SumAndNormilize, que combina ambos os fluxos e ajusta o resultado ao formato exigido na saída da camada.
Assim, o método implementa de uma só vez vários mecanismos poderosos: atenção adaptativa, extração de características, integração estrutural e transformação convolucional. Tudo isso transforma o módulo em um bloco completo de processamento em grafo, capaz de levar em conta tanto as dependências internas entre os nós quanto as restrições externas da estrutura.
Após a conclusão da propagação para frente na convolução adaptativa em grafo (AGCN), começa uma das etapas mais críticas, a propagação dos gradientes de erro da saída da camada para seus componentes treináveis. No âmbito desse processo, é implementada a propagação reversa (backpropagation), que permite determinar com precisão a contribuição de cada objeto para o resultado final e ajustar os parâmetros, minimizando o erro. Todo o algoritmo é organizado dentro do método calcInputGradients.
bool CNeuronAGCN::calcInputGradients(CNeuronBaseOCL *NeuronOCL,
                                     CBufferFloat *SecondInput,
                                     CBufferFloat *SecondGradient,
                                     ENUM_ACTIVATION SecondActivation = -1)
  {
   if(!NeuronOCL || !SecondInput || !SecondGradient ||
      SecondInput.Total() < cAadapt.Neurons() ||
      SecondGradient.Total() < cAadapt.Neurons())
      return false;
Na primeira etapa, é realizada a verificação padrão da validade dos dados de entrada: se os ponteiros recebidos não estiverem inicializados, ou se o tamanho dos buffers de entrada for insuficiente para a execução das operações matriciais, a execução do método é interrompida. Em seguida, começa a distribuição efetiva dos erros.
A propagação reversa no bloco AGCN começa pelo fim, isto é, pela saída da camada, onde o resultado final já foi formado. No nosso caso, trata-se da soma das saídas de dois componentes-chave: cWadapt e cWpre. São eles que, vale lembrar, participam da construção da representação final, que generaliza tanto a atenção quanto a estrutura estática do grafo.
Como a saída do bloco é uma soma simples de dois tensores, o gradiente de erro recebido da camada seguinte também precisa ser repassado em igual medida a ambos os módulos, sem quaisquer coeficientes de ponderação adicionais. No entanto, antes de iniciar o cálculo dos gradientes nas conexões internas de cada um dos módulos, somos obrigados a corrigir esse gradiente levando em conta as funções de ativação aplicadas na propagação para frente. Para isso, é chamado o método DeActivation — em essência, ele multiplica o gradiente recebido pela derivada da função de ativação aplicada à saída de cWadapt e cWpre. Esse é um passo fundamental, sem o qual a propagação reversa através das transformações não lineares será incorreta.
if(!DeActivation(cWadapt.getOutput(), cWadapt.getGradient(), Gradient, cWadapt.Activation()))
   return false;
if(!DeActivation(cWpre.getOutput(), cWpre.getGradient(), Gradient, cWpre.Activation()))
   return false;
Depois disso, o erro é distribuído por suas entradas: são chamados os métodos CalcHiddenGradients para os objetos cAadaptX e cApreX, pelos quais passaram os fluxos formados levando em conta, respectivamente, as matrizes de conexões adaptativas e predefinidas entre os nós.
if(!cApreX.CalcHiddenGradients(cWpre.AsObject()))
   return false;
if(!cAadaptX.CalcHiddenGradients(cWadapt.AsObject()))
   return false;
Em seguida, com a ajuda de MatMulGrad, é realizada a propagação reversa através da operação de multiplicação: calcula-se a contribuição de cada parte para o erro final. Em caso de uso de função de ativação, sua transformação reversa é realizada com a ajuda de DeActivation, o que permite recuperar o erro real antes de sua normalização.
   if(!MatMulGrad(SecondInput, SecondGradient,
                  NeuronOCL.getOutput(), NeuronOCL.getGradient(),
                  cApreX.getGradient(), cWpre.GetUnits(),
                  cWpre.GetUnits(), cWpre.GetWindow()))
      return false;
   if(SecondActivation != None)
      if(!DeActivation(SecondInput, SecondGradient,
                       SecondGradient, SecondActivation))
         return false;
//---
   if(!MatMulGrad(cAadapt.getOutput(), cAadapt.getGradient(),
                  NeuronOCL.getOutput(), PrevOutput,
                  cAadaptX.getGradient(),  cWadapt.GetUnits(),
                  cWadapt.GetUnits(), cWadapt.GetWindow()))
      return false;
   if(!SumAndNormilize(NeuronOCL.getGradient(), PrevOutput,
                       PrevOutput, cWx.GetWindow(), false))
      return false;
   if(NeuronOCL.Activation() != None)
      if(!DeActivation(NeuronOCL.getOutput(), PrevOutput,
                       PrevOutput, NeuronOCL.Activation()))
         return false;
Observe que, em ambas as operações de multiplicação matricial na propagação para frente, foram usados os dados originais da via principal de informação. Portanto, teremos de reunir o gradiente de erro de ambas as vias. Para acumular os valores, usamos o buffer temporário PrevOutput. Se NeuronOCL utilizar alguma função de ativação, sua derivada será aplicada para o recálculo correto do gradiente, levando em conta a não linearidade.
A etapa-chave seguinte é a propagação reversa através da matriz de correlação cEnEnT, obtida anteriormente na etapa de propagação para frente. Primeiro, é feito o cálculo dos gradientes ocultos; em seguida, realiza-se a desativação na saída, caso a função GELU tenha sido usada.
if(!cEnEnT.CalcHiddenGradients(cAadapt.AsObject()))
   return false;
if(cEnEnT.Activation() != None)
   if(!DeActivation(cEnEnT.getOutput(), cEnEnT.getGradient(),
                    cEnEnT.getGradient(), cEnEnT.Activation()))
      return false;
Depois disso, é chamada MatMulGrad, que implementa a propagação reversa do gradiente através da operação de multiplicação das características por sua cópia transposta.
if(!MatMulGrad(cEn.getOutput(), cEn.getPrevOutput(),
               cEnT.getOutput(), cEnT.getGradient(),
               cEnEnT.getGradient(), cEnT.GetCount(),
               cEnT.GetWindow(), cEnT.GetCount()))
   return false;
Além disso, os erros transpostos são transmitidos à camada cEn, onde são somados aos valores obtidos anteriormente e é realizada a desativação, caso uma função de ativação tenha sido usada.
if(!cEn.CalcHiddenGradients(cEnT.AsObject()))
   return false;
if(!SumAndNormilize(cEn.getGradient(), cEn.getPrevOutput(),
                    cEn.getGradient(), cEnT.GetWindow(), false))
   return false;
if(cEn.Activation() != None)
   if(!DeActivation(cEn.getOutput(), cEn.getGradient(),
                    cEn.getGradient(), cEn.Activation()))
      return false;
Logo em seguida, os gradientes chegam a cWconcat_ex, onde começa o procedimento reverso de separação das características, lembrando que, na propagação para frente, elas haviam sido concatenadas.
if(!cWconcat_ex.CalcHiddenGradients(cEn.AsObject()))
   return false;
if(!DeConcat(cWx.getGradient(), cWe.getGradient(), cWconcat_ex.getGradient(),
             cWx.GetWindowOut(), cWe.GetWindowOut(), cWx.GetUnits()))
   return false;
if(cWx.Activation() != None)
   if(!DeActivation(cWx.getOutput(), cWx.getGradient(),
                    cWx.getGradient(), cWx.Activation()))
      return false;
if(cWe.Activation() != None)
   if(!DeActivation(cWe.getOutput(), cWe.getGradient(),
                    cWe.getGradient(), cWe.Activation()))
      return false;
A função DeConcat separa corretamente os gradientes em duas partes, para cWx e cWe. Em cada um desses módulos, DeActivation é chamada separadamente, restaurando o gradiente puro. Em seguida, ocorre a propagação reversa pela rede: primeiro até o nível dos dados de entrada por meio de `cWx`, depois até cEa por meio de cWe.
   if(!NeuronOCL.CalcHiddenGradients(cWx.AsObject()))
      return false;
   if(!SumAndNormilize(NeuronOCL.getGradient(), PrevOutput,
                       NeuronOCL.getGradient(), cWx.GetWindow(), false))
      return false;
   if(!cEa.CalcHiddenGradients(cWe.AsObject()))
      return false;
//---
   return true;
  }
Observe que já havíamos transmitido o gradiente de erro ao nível dos dados de entrada da via principal, por isso os valores obtidos agora são somados aos que já haviam sido acumulados.
Vale dar atenção especial ao fato de que o método implementa uma sequência rigorosa de todas as etapas. Isso é necessário porque o erro deve ser retropropagado exatamente na ordem inversa daquela em que ocorreu a propagação para frente. Cada etapa compensa cuidadosamente o efeito das convoluções, normalizações, ativações e transposições. Somente ao final, depois do cálculo completo dos gradientes, o modelo está pronto para a atualização dos pesos, preservando a precisão em cada etapa do treinamento.
O método de atualização dos parâmetros foi implementado de forma extremamente direta, mas ao mesmo tempo elegante e confiável. Aqui não há condições complexas nem cálculos adicionais; tudo se resume a uma transferência cuidadosa de controle para os objetos internos, que contêm diretamente os pesos treináveis. Cada um deles implementa seu próprio mecanismo de atualização com base nos gradientes acumulados e no esquema de otimização selecionado.
bool CNeuronAGCN::updateInputWeights(CNeuronBaseOCL *NeuronOCL, CBufferFloat *second)
  {
   if(!cEa.UpdateInputWeights())
      return false;
   if(!cWe.UpdateInputWeights(cEa.AsObject()))
      return false;
   if(!cWx.UpdateInputWeights(NeuronOCL))
      return false;
   if(!cEn.UpdateInputWeights(cWconcat_ex.AsObject()))
      return false;
   if(!cWpre.UpdateInputWeights(cApreX.AsObject()))
      return false;
   if(!cWadapt.UpdateInputWeights(cAadaptX.AsObject()))
      return false;
//---
   return true;
  }
Cada método é chamado com a passagem do objeto de entrada necessário, obtido ao longo da propagação para frente, o que permite preservar a correção dos cálculos nas condições da topologia em grafo.
Essa abordagem torna a estrutura do código não apenas legível, mas também facilmente escalável.
Para conveniência do leitor e para garantir total transparência técnica, todo o código-fonte desta classe, incluindo as definições de todos os métodos, é apresentado no anexo.
Célula GinAR
Avançamos para a etapa final, a criação de uma célula computacional GinAR completa, na qual todos os componentes analisados anteriormente são reunidos em uma única estrutura coerente. É justamente aqui, na classe CNeuronGinARCell, que convergem os mecanismos de Interpolation Attention, da convolução adaptativa em grafo e dos elementos de controle da memória, formando uma arquitetura flexível, mas ao mesmo tempo rigidamente estruturada.
class CNeuronGinARCell  :  public CNeuronBaseOCL
  {
protected:
   CNeuronInterpolationAttention cX_IA;
   CNeuronAGCN                   cX_AGNC;
   CNeuronAGCN                   cForgetGate;
   CNeuronAGCN                   cResetGate;
   CNeuronBaseOCL                cContext;
   CBufferFloat                  bTemp;
   //---
   virtual bool      feedForward(CNeuronBaseOCL *NeuronOCL) override { return false; }
   virtual bool      feedForward(CNeuronBaseOCL *NeuronOCL, CBufferFloat *SecondInput) override;
   virtual bool      updateInputWeights(CNeuronBaseOCL *NeuronOCL) override { return false; }
   virtual bool      updateInputWeights(CNeuronBaseOCL *NeuronOCL, CBufferFloat *second) override;
   virtual bool      calcInputGradients(CNeuronBaseOCL *NeuronOCL) override { return false; }
   virtual bool      calcInputGradients(CNeuronBaseOCL *NeuronOCL,
                                        CBufferFloat *SecondInput,
                                        CBufferFloat *SecondGradient,
                                        ENUM_ACTIVATION SecondActivation = None) override;

public:
                     CNeuronGinARCell(void) { activation = None;}
                    ~CNeuronGinARCell(void) {};
   //---
   virtual bool      Init(uint numOutputs, uint myIndex, COpenCLMy *open_cl,
                          uint units_count, uint dimension,
                          ENUM_OPTIMIZATION optimization_type, uint batch);
   //---
   virtual bool      Save(const int file_handle) override;
   virtual bool      Load(const int file_handle) override;
   //---
   virtual int       Type(void) override const  {  return defNeuronGinARCell; }
   virtual void      TrainMode(bool flag) override;
   virtual void      SetOpenCL(COpenCLMy *obj);
   //---
   virtual bool      WeightsUpdate(CNeuronBaseOCL *source, float tau);
   virtual void      SetActivationFunction(ENUM_ACTIVATION value) override {};
  };
Na estrutura do novo objeto apresentada acima, vê-se que CNeuronGinARCell herda a interface base de CNeuronBaseOCL. Isso garante compatibilidade com as demais camadas e módulos do framework. No entanto, ao contrário de blocos simples, aqui estão reunidos vários componentes funcionais ao mesmo tempo:
- cX_IA, o bloco de Interpolation Attention, responsável pela suavização e correção das séries temporais de entrada;
- cX_AGNC, o módulo principal de convolução adaptativa em grafo, que forma uma representação generalizada das características de entrada levando em conta suas conexões;
- cForgetGate e cResetGate, dois subsistemas gráficos adicionais que implementam os mecanismos de esquecimento e reset, por analogia às células GRU;
- cContext, o buffer interno que armazena o estado acumulado da memória oculta;
- bTemp, o buffer temporário usado em cálculos intermediários.
A classe implementa o ciclo padrão de funcionamento de uma camada neural. O método Init realiza a inicialização gradual de todos os componentes da célula CNeuronGinARCell. Aqui são definidos os principais parâmetros do modelo: quantidade de saídas, dimensionalidade do espaço de características, tipo de otimização e tamanho do batch.
bool CNeuronGinARCell::Init(uint numOutputs, uint myIndex, COpenCLMy *open_cl,
                            uint units_count, uint dimension,
                            ENUM_OPTIMIZATION optimization_type, uint batch)
  {
   if(!CNeuronBaseOCL::Init(numOutputs, myIndex, open_cl,
                            units_count * dimension, optimization_type, batch))
      return false;
Em seguida, os blocos internos da célula são inicializados em sequência. Primeiro, cX_IA, responsável pelo Interpolation Attention.
int index = 0;
if(!cX_IA.Init(0, index, OpenCL, units_count, dimension, optimization, iBatch))
   return false;
Depois, é inicializado o módulo principal de convolução em grafo cX_AGNC, seguido pelos gates de controle cForgetGate e cResetGate. Cada um deles recebe seu próprio índice exclusivo.
index++;
if(!cX_AGNC.Init(0, index, OpenCL, units_count, dimension, optimization, iBatch))
   return false;
index++;
if(!cForgetGate.Init(0, index, OpenCL, units_count, dimension, optimization, iBatch))
   return false;
index++;
if(!cResetGate.Init(0, index, OpenCL, units_count, dimension, optimization, iBatch))
   return false;
Em seguida, é inicializado separadamente o módulo cContext, que desempenha o papel de acumulador do estado interno. Sua saída é explicitamente preenchida com zeros para evitar ruído aleatório no início, e a função de ativação é desativada, permitindo usá-lo como memória pura.
   index++;
   if(!cContext.Init(0, index, OpenCL, units_count * dimension, optimization, iBatch))
      return false;
   if(!cContext.getPrevOutput().Fill(0))
      return false;
   cContext.SetActivationFunction(None);
   bTemp.BufferFree();
   if(!bTemp.BufferInit(units_count * units_count, 0) ||
      !bTemp.BufferCreate(OpenCL))
      return false;
//---
   return true;
  }
Na etapa final, é criado o buffer temporário bTemp, necessário para executar operações intermediárias. O tamanho do buffer é escolhido quadraticamente, units_count × units_count. Ao mesmo tempo, se o buffer já tiver sido criado anteriormente, ele será liberado antes disso, o que garante funcionamento correto e economia de recursos.
Depois de concluir todas as operações, o módulo encerra seu trabalho, retornando previamente ao programa chamador o resultado lógico correspondente.
O algoritmo de propagação para frente no método feedForward implementa a lógica central de funcionamento da célula CNeuronGinARCell, combinando mecanismos de atenção, convoluções em grafo e controle de memória por meio dos gates de esquecimento e reset.
bool CNeuronGinARCell::feedForward(CNeuronBaseOCL *NeuronOCL, CBufferFloat *SecondInput)
  {
   if(!cX_IA.FeedForward(NeuronOCL))
      return false;
Na primeira etapa, é ativado o módulo cX_IA, que realiza a transformação por interpolação dos dados de entrada NeuronOCL. A representação obtida é usada como base para três blocos paralelos: o módulo principal de convolução em grafo cX_AGNC, assim como os módulos cForgetGate e cResetGate, que são responsáveis pela formação das máscaras de controle.
if(!cX_AGNC.FeedForward(cX_IA.AsObject(), SecondInput))
   return false;
if(!cForgetGate.FeedForward(cX_IA.AsObject(), SecondInput))
   return false;
if(!cResetGate.FeedForward(cX_IA.AsObject(), SecondInput))
   return false;
if(!Activation(cForgetGate.getOutput(), cForgetGate.getOutput(), GELU))
   return false;
if(!Activation(cResetGate.getOutput(), cResetGate.getOutput(), GELU))
   return false;
Cada um desses três blocos também recebe adicionalmente a segunda entrada SecondInput, que contém informação em grafo ou estrutural, isto é, a matriz de adjacência ou dados sobre os nós vizinhos. Depois de passar pelas camadas, as saídas dos gates cForgetGate e cResetGate são ativadas pela função GELU, o que permite criar máscaras mais suaves e flexíveis, reduzindo a influência de transições bruscas e de valores negativos.
Em seguida, o contexto interno é atualizado. Aqui vale observar que, durante a propagação para frente, os valores do contexto necessários para as operações de propagação reversa são imediatamente sobrescritos. Para evitar isso, usamos um carrossel de buffers: chamamos o método SwapOutputs, que troca os ponteiros dos buffers Output e PrevOutput.
//--- Context
   if(!cContext.SwapOutputs())
      return false;
   if(!GateElementMult(cContext.getPrevOutput(), cX_AGNC.getOutput(),
                       cForgetGate.getOutput(), cContext.getOutput()))
      return false;
Na sequência, é formado um novo vetor de contexto, por meio da multiplicação elemento a elemento entre o estado anterior de cContext e os resultados de cX_AGNC, ponderados pela máscara de esquecimento cForgetGate. Isso permite controlar com flexibilidade quais elementos da memória devem ser preservados e quais devem ser zerados.
O novo vetor de contexto passa pela função de ativação ELU, adaptada para trabalhar com valores negativos, o que aumenta a estabilidade dos gradientes.
//--- Output
   if(!Activation(cContext.getOutput(), cContext.getPrevOutput(), ELU))
      return false;
   if(!GateElementMult(cContext.getPrevOutput(), cX_IA.getOutput(), cResetGate.getOutput(), Output))
      return false;
//---
   return true;
  }
Por fim, a saída final do bloco no buffer Output é formada pela multiplicação elemento a elemento entre o contexto atualizado, o tensor de resultados cX_IA e a máscara cResetGate. Essa etapa combina a memória de longo prazo, o estado atual de entrada e a máscara de reset, responsável por transmitir à saída as características relevantes.
Se em qualquer etapa ocorrer um erro ou falha na execução da operação, o método retorna false. Se todas as operações forem concluídas com sucesso, retorna true, confirmando a passagem correta dos dados por toda a estrutura da célula.
O algoritmo de propagação reversa do erro não é tão simples quanto pode parecer à primeira vista. Sua principal complexidade está na necessidade de somar e normalizar cuidadosamente os gradientes provenientes de várias fontes, pois os dados de entrada de ambas as vias são usados simultaneamente em vários pontos: no fluxo principal (cX_AGNC) e nos caminhos auxiliares através dos gates de controle cForgetGate e cResetGate. Por isso, cada um desses consumidores gera sua própria contribuição para o gradiente final, e todas elas precisam ser combinadas corretamente.
bool CNeuronGinARCell::calcInputGradients(CNeuronBaseOCL *NeuronOCL,
                                          CBufferFloat *SecondInput,
                                          CBufferFloat *SecondGradient,
                                          ENUM_ACTIVATION SecondActivation = -1)
  {
   if(!NeuronOCL || !SecondInput || !SecondGradient)
      return false;
//--- Output
   if(!GateElementMultGrad(cContext.getPrevOutput(), cContext.getGradient(),
                           cX_IA.getOutput(), cX_IA.getPrevOutput(),
                           cResetGate.getOutput(), cResetGate.getGradient(),
                           Gradient, ELU, cX_IA.Activation(), GELU))
      return false;
Primeiramente, o gradiente da saída final da célula é distribuído entre o contexto cContext, o resultado do Interpolation Attention cX_IA e o gate de reset cResetGate. Nesse processo, são levadas em conta todas as derivadas das funções de ativação correspondentes.
Em seguida, é restaurado o gradiente do estado interno de memória cContext. Como ele é formado a partir dos resultados da multiplicação entre a saída do módulo convolucional principal cX_AGNC e a máscara cForgetGate, é usada uma operação análoga de propagação reversa. Aqui já entram em jogo outras funções de ativação e outros gradientes, e o resultado é acumulado no objeto cContext.
//--- Context
   if(!GateElementMultGrad(cContext.getOutput(), cContext.getPrevOutput(),
                           cX_AGNC.getOutput(), cX_AGNC.getGradient(),
                           cForgetGate.getOutput(), cForgetGate.getGradient(),
                           cContext.getGradient(), None,
                           cX_AGNC.Activation(), GELU))
      return false;
Depois, chega um dos momentos mais críticos, a transmissão dos gradientes de volta ao módulo de Interpolation Attention cX_IA. Ele foi o predecessor comum de três ramos, por isso é necessário realizar três chamadas independentes de CalcHiddenGradients, uma para cada caminho: o principal (cX_AGNC), o gate de esquecimento (cForgetGate) e o gate de reset (cResetGate).
//--- Gradient to Interposition Attention
   if(!cX_IA.CalcHiddenGradients(cX_AGNC.AsObject(), SecondInput,
                                 SecondGradient, SecondActivation) ||
      !SumAndNormilize(cX_IA.getGradient(), cX_IA.getPrevOutput(),
                       cX_IA.getPrevOutput(), cForgetGate.GetWindow(), false, 0, 0, 0, 1))
      return false;
   if(!cX_IA.CalcHiddenGradients(cForgetGate.AsObject(), SecondInput,
                                 GetPointer(bTemp), SecondActivation) ||
      !SumAndNormilize(cX_IA.getGradient(), cX_IA.getPrevOutput(),
                       cX_IA.getPrevOutput(), cForgetGate.GetWindow(), false, 0, 0, 0, 1) ||
      !SumAndNormilize(SecondGradient, GetPointer(bTemp),
                       SecondGradient, cForgetGate.GetUnits(), false, 0, 0, 0, 1))
      return false;
   if(!cX_IA.CalcHiddenGradients(cResetGate.AsObject(), SecondInput,
                                 GetPointer(bTemp), SecondActivation) ||
      !SumAndNormilize(cX_IA.getGradient(), cX_IA.getPrevOutput(),
                       cX_IA.getPrevOutput(), cForgetGate.GetWindow(), false, 0, 0, 0, 1) ||
      !SumAndNormilize(SecondGradient, GetPointer(bTemp), SecondGradient,
                       cForgetGate.GetUnits(), false, 0, 0, 0, 1))
      return false;
Após cada chamada, o resultado é somado no buffer bTemp e cuidadosamente devolvido a SecondGradient, garantindo o acúmulo de todas as contribuições em um único fluxo de saída.
Por fim, é chamado o cálculo do gradiente oculto no objeto dos dados de entrada NeuronOCL, associado a cX_IA. Isso conclui a cadeia de propagação do erro e garante que toda a informação sobre como a alteração dos dados de entrada influencia a saída seja cuidadosamente levada de volta ao início do modelo.
//---
   if(!NeuronOCL.CalcHiddenGradients(cX_IA.AsObject()))
      return false;
//---
   return true;
  }
Assim, o método implementa um mecanismo sequencial e equilibrado de agregação e transmissão de gradientes em todas as direções. Isso assegura o treinamento correto de uma estrutura complexa e multicomponente como o GinAR, na qual cada saída afeta simultaneamente vários ramos de cálculo.
O código completo desta classe e de todos os seus métodos é apresentado no anexo para estudo independente. Quando necessário, você poderá acompanhar facilmente a cadeia de cálculos, a estrutura de dependências entre os componentes e a lógica de transmissão dos dados em todas as etapas, da propagação para frente à propagação reversa do erro e à atualização dos pesos.
Ficou para trás um volume impressionante de trabalho. Passo a passo, analisamos a arquitetura, os métodos e a lógica interna dos principais componentes, estabelecendo uma base sólida para os próximos passos. Proponho fazer uma pequena pausa, respirar e deixar as ideias assentarem. Já no próximo artigo, levaremos o que foi iniciado à sua conclusão lógica: passaremos da teoria à prática e avaliaremos a eficiência real das soluções implementadas com dados de mercado.
Considerações finais
Neste artigo, realizamos uma análise aprofundada da arquitetura dos principais componentes do framework GinAR. Examinamos em etapas o processo de inicialização dos componentes, a implementação da propagação para frente e também detalhamos os algoritmos de retropropagação do erro. Foi dada atenção especial ao mecanismo de interação entre os módulos de atenção, as convoluções em grafo e os gates de controle, o que permitiu criar uma estrutura flexível e expressiva.
Essa modularidade não apenas simplifica a escalabilidade, mas também abre caminho para a integração de blocos de controle mais complexos, seja no contexto do aprendizado por reforço, seja em tarefas de previsão com dependências variáveis.
Links
- GinAR: An End-To-End Multivariate Time Series Forecasting Model Suitable for Variable Missing
- Outros artigos da série
Programas utilizados no artigo
| # | Nome | Tipo | Descrição |
|---|---|---|---|
| 1 | Study.mq5 | Expert Advisor | EA de treinamento offline dos modelos |
| 2 | StudyOnline.mq5 | Expert Advisor | EA de treinamento online dos modelos |
| 3 | Test.mq5 | Expert Advisor | Expert Advisor para testar o modelo |
| 4 | Trajectory.mqh | Biblioteca de classe | Estrutura de descrição do estado do sistema e da arquitetura dos modelos |
| 5 | NeuroNet.mqh | Biblioteca de classe | Biblioteca de classes para criação de redes neurais |
| 6 | NeuroNet.cl | Biblioteca | Biblioteca de código de programas OpenCL |
Traduzido do russo pela MetaQuotes Ltd.
Artigo original: https://www.mql5.com/ru/articles/18892
Aviso: Todos os direitos sobre esses materiais pertencem à MetaQuotes Ltd. É proibida a reimpressão total ou parcial.
Esse artigo foi escrito por um usuário do site e reflete seu ponto de vista pessoal. A MetaQuotes Ltd. não se responsabiliza pela precisão das informações apresentadas nem pelas possíveis consequências decorrentes do uso das soluções, estratégias ou recomendações descritas.
 Técnicas do MQL5 Wizard que você deve conhecer (Parte 56): Fractais de Bill Williams
 Processos gaussianos em machine learning (Parte 1): modelo de classificação em MQL5
 Redes neurais em trading: Modelo multidimensional de ponta a ponta para previsão de séries temporais (Conclusão)
 Redes neurais em trading: modelo multivariado de ponta a ponta para previsão de séries temporais (GinAR)

- Aplicativos de negociação gratuitos
- 8 000+ sinais para cópia
- Notícias econômicas para análise dos mercados financeiros
Você concorda com a política do site e com os termos de uso
Artigo muito interessante e uma continuação valiosa da série sobre a implementação do GinAR. A arquitetura chamou nossa atenção porque, atualmente, estamos desenvolvendo uma estrutura de pesquisa mais ampla de aprendizado de máquina em múltiplas etapas para negociação algorítmica, e uma das áreas que estamos investigando ativamente é se a modelagem entre ativos pode agregar informações que não são captadas pelos modelos tradicionais por símbolo.
Nossa estrutura é intencionalmente dividida em camadas independentes: coleta de dados de mercado, engenharia de características, construção de conjuntos de dados históricos, pesquisa de modelos, validação, geração de candidatos e execução. O aprendizado de máquina é tratado como uma camada de evidência, e não como uma fonte de autoridade direta para negociação. Portanto, um modelo não pode influenciar decisões de negociação posteriores simplesmente por apresentar bom desempenho na amostra; ele deve primeiro demonstrar valor incremental estável fora da amostra.
Atualmente, trabalhamos com um universo multiativos que abrange câmbio, ouro, índices dos EUA, ações e instrumentos de energia. Os dados históricos são processados por meio de um fluxo de trabalho Bronze → Prata → Ouro, com controles rigorosos em momentos específicos. As informações disponíveis no momento da decisão são mantidas separadas das informações futuras utilizadas para rotulagem e análise de resultados.
Nosso contrato de treinamento Gold atual contém 142 características de origem por observação, consistindo em 129 características numéricas e 13 categóricas. O conjunto de características inclui volatilidade, tendência, momentum, estrutura de mercado, comportamento de quebra, contexto de ação de preço, condições de liquidez, estado da sessão e outros descritores determinísticos do mercado.
Antes de testar o GinAR, já havíamos construído uma família de modelos de segunda geração utilizando Regressão Logística, XGBoost, LightGBM e CatBoost. Esses modelos foram avaliados por meio de validação cronológica walk-forward, triagem por limiar, análise de estabilidade por bootstrap, verificações de calibração, análise de regime e uma fase de holdout não alterada.
Dez instrumentos alcançaram nosso estágio de candidatos aprovados na Validação Profunda:
GBPUSD, USDCHF, US500, US30, USDCAD, EURUSD, USDJPY, EURGBP, USTEC e XAUUSD.
Esses passaram a constituir o universo inicial de pesquisa para nosso experimento com o GinAR.
O que tornou o GinAR especialmente interessante para nós é que ele introduz algo fundamentalmente diferente de nossos modelos existentes. Nossos modelos GEN2 atuais são, em grande parte, classificadores por símbolo, enquanto o GinAR oferece a possibilidade de aprender relações dinâmicas entre ativos e representações latentes em vários instrumentos simultaneamente.
Isso é particularmente relevante nos mercados financeiros, pois os instrumentos não são independentes. As relações entre moedas, ouro, índices de ações e outros ativos mudam de acordo com o regime de mercado, a volatilidade e a estrutura do pregão. Além disso, um universo de negociação com múltiplos ativos naturalmente contém períodos em que nem todos os instrumentos têm cotações válidas ou pregões ativos ao mesmo tempo.
Por esse motivo, criamos um Ramo de Pesquisa GinAR totalmente separado, sem autoridade de negociação e sem efeito sobre nosso sistema de execução existente.
O objetivo não era reproduzir a implementação deste artigo linha por linha, nem substituir imediatamente nossos modelos existentes. Em vez disso, queríamos responder a uma questão de pesquisa mais específica:
Um modelo de grafo entre ativos no estilo GinAR pode fornecer informações adicionais fora da amostra, além dos nossos modelos GEN2 por símbolo já existentes?
Nossa implementação foi, portanto, um modelo de pesquisa “clean-room” inspirado no GinAR, baseado nas principais ideias arquitetônicas:
Para o primeiro experimento, utilizamos a parte numérica comum do contrato de características Gold, fornecendo ao modelo 129 características numéricas por nó.
O alvo utilizado neste experimento foi um problema de classificação WHIPSAW de 240 minutos.
A integridade dos rótulos revelou-se uma questão metodológica importante. Nossos rótulos históricos contêm:
WHIPSAW
NO_WHIPSAW
AMBIGUOUS_FIRST_MOVE
e, em alguns casos, INCOMPLETE.
AMBIGUOUS_FIRST_MOVE ocorre quando ambas as barreiras de primeiro movimento são atingidas dentro da mesma barra M1, o que significa que a ordem real dentro da barra não pode ser determinada a partir dos dados de origem disponíveis.
Portanto, utilizamos uma especificação explícita:
AMBIGUOUS_DO_NOT_GUESS
.
O contrato-alvo binário ficou assim:
WHIPSAW = 1
NO_WHIPSAW = 0
enquanto AMBIGUOUS_FIRST_MOVE e INCOMPLETE foram excluídos das métricas binárias de perda e avaliação, em vez de serem forçados a pertencer a uma das duas classes.
Esse ponto foi importante para nós porque converter resultados ambíguos em uma das duas classes introduziria ruído artificial nos rótulos.
Também mantivemos controles rigorosos contra a antecipação.
O protocolo de validação foi:
180 dias de treinamento
30 dias de validação
Etapa de avanço de 60 dias
240 minutos de purga/lacuna
período de retenção final intocado de 60 dias
O conjunto de teste final permaneceu isolado durante o experimento inicial do GinAR.
Evitamos deliberadamente a divisão aleatória entre treinamento e teste.
Outro ponto importante diz respeito às variáveis ausentes. A “Interpolation Attention” do GinAR é potencialmente muito útil para um ambiente de negociação com múltiplos ativos, no qual os instrumentos podem ficar temporariamente indisponíveis devido a diferentes sessões de negociação.
No entanto, não utilizamos o modelo para gerar observações históricas.
As observações de origem ausentes permaneceram ausentes nos conjuntos de dados originais e foram representadas explicitamente por máscaras. A interpolação interna foi utilizada apenas como parte da representação neural. Nenhum valor reconstruído foi gravado de volta em nossos conjuntos de dados Gold.
Em seguida, treinamos o modelo de pesquisa do GinAR em seis dobras cronológicas do método walk-forward.
O número de observações-alvo válidas foi grande e relativamente estável entre as dobras. A avaliação OOF resultante produziu aproximadamente 114.558 previsões fora da dobra.
Os valores de PR-AUC nas seis dobras foram:
Passo 1: 0,6894
Passo 2: 0,6910
Passo 3: 0,6833
Passo 4: 0,6866
Fold 5: 0,6584
Dobradura 6: 0,6999
A maioria das dobras se mostrou razoavelmente estável, embora a Dobra 5 tenha sido visivelmente mais fraca. Consideramos esse período especialmente interessante para uma análise posterior do regime e da estrutura do gráfico.
O próximo passo foi a parte que consideramos mais importante: uma comparação direta com nossos modelos GEN2 de referência já existentes.
Alinhamos as previsões do GinAR OOF com as previsões correspondentes do GEN2 na mesma interseção de símbolo/marca de tempo.
A comparação incluiu 90.122 observações fora de dobra correspondentes.
O resultado foi:
Delta PR-AUC: -0,0161
Delta LogLoss: +0,0059
Como um PR-AUC mais alto e um LogLoss mais baixo são preferíveis, o resultado atual favoreceu claramente os modelos GEN2 existentes.
Em outras palavras, em nosso primeiro experimento, o GinAR não superou nossa família de modelos existente de Regressão Logística / XGBoost / LightGBM / CatBoost como um classificador WHIPSAW independente.
Portanto, não promovemos o GinAR como substituto do GEN2.
No entanto, não acho que esse resultado torne o GinAR desinteressante para aplicações financeiras.
Na verdade, o experimento pode sugerir que a parte mais valiosa da arquitetura não é necessariamente o classificador autônomo final.
O GinAR cria uma representação latente entre ativos que nossos modelos independentes por símbolo não possuem naturalmente.
Por esse motivo, estamos mantendo o GinAR como um codificador de pesquisa e alterando a próxima questão de pesquisa de:
“O GinAR pode substituir o GEN2?”
para:
“O GinAR pode fornecer informações complementares entre ativos para o GEN2?”
Nosso próximo experimento planejado é, portanto:
linha de base do GEN2
versus
GEN2 + GinAR com representações entre ativos
utilizando empilhamento fold-safe, análise de discordância de probabilidade, análise de regime, análise de estabilidade de grafos e testes de ablação.
Estamos particularmente interessados em examinar casos em que o modelo GEN2 líder esteja errado enquanto o GinAR estiver correto, e vice-versa. Se esses conjuntos de erros forem suficientemente diferentes, a representação do GinAR ainda poderá ser útil como uma camada adicional de características, mesmo que seu PR-AUC isolado seja menor.
Também planejamos examinar se a matriz de adjacência aprendida permanece estável ao longo do tempo ou se as relações entre os instrumentos mudam significativamente em diferentes regimes de volatilidade e de mercado.
É nesse ponto que acreditamos que os modelos baseados em grafos possam se tornar particularmente úteis em sistemas de negociação.
Por exemplo, a relevância de relações como:
Ouro ↔ USD,
Câmbio ↔ índices dos EUA,
USDCAD ↔ energia,
ou USTEC ↔ grandes ações do setor de tecnologia
não deve necessariamente ser considerada constante ao longo do tempo.
Um modelo capaz de aprender essas relações dinamicamente pode oferecer um contexto valioso, mesmo que seu módulo de classificação direta não seja o melhor preditor isolado.
Também vale a pena mencionar uma lição metodológica de nosso experimento: é muito fácil julgar uma nova arquitetura neural com base apenas na perda de treinamento ou em um único backtest. Nossos resultados mudaram a interpretação do modelo assim que o comparamos com um benchmark existente nas mesmas observações fora do conjunto de treinamento.
Para nós, esse tipo de comparação é essencial.
Um novo modelo não deve ser considerado útil simplesmente porque produz uma métrica razoável. Ele deve demonstrar:
Nesta fase, nossa conclusão é, portanto:
O GinAR não é, atualmente, um classificador autônomo melhor do que nossos modelos GEN2, mas continua sendo um candidato promissor como camada de representação e geração de características entre ativos.
Mantivemos deliberadamente o conjunto de teste final intacto e isolado até que esta próxima etapa da pesquisa seja definida, a fim de evitar o uso repetido do conjunto de teste para decisões de desenvolvimento de modelos.
Eu teria muito interesse em ver os próximos experimentos do autor com dados reais de mercado, particularmente:
Agradecemos pela publicação desta série. É uma das direções mais interessantes que encontramos para a aplicação do aprendizado multivariável baseado em grafos a séries temporais financeiras.
Embora nossa primeira comparação independente não tenha mostrado uma vantagem isolada em relação ao GEN2, o experimento abriu uma direção de pesquisa nova e potencialmente mais útil para nós: usar o GinAR como uma camada de inteligência entre ativos, em vez de simplesmente mais um classificador.
Estou ansioso pelo próximo artigo e teria muito interesse em comparar nossas descobertas com os resultados do autor baseados em dados de mercado.