

取引におけるニューラルネットワーク:確率的時系列予測(Encoder)
 24
 0

はじめに
不確実性の高い状況下での時系列モデリングに特化して設計された先進的なアーキテクチャ、K²VAEフレームワークについて、引き続き解説していきます。 このモデルは、潜在空間における線形ダイナミクス(クープマン作用素による)、適応的な誤差フィルタリング(KalmanNetを使用)、および確率的モデリング(変分オートエンコーダに基づく)という3つの主要な概念を組み合わせたものです。 このアプローチにより、データに含まれるパターンと、それらのパターンに対する信頼度の両方を同時に考慮することができます。
K²VAEの最大の特徴は、単に将来の値を予測するのではなく、システムの将来の状態を表す確率分布を推定する点にあります。 最も可能性の高いシナリオを単一の予測値として出力する従来型のモデルとは異なり、このアプローチでは、将来起こり得るさまざまな結果を分布として表現します。 さらに、その分布の広がりは、現在の状態に対するモデルの信頼度に応じて変化します。 この特性により、K²VAEは、リスクや不確実性の考慮が重要となる分野、たとえば金融予測、物流、技術システムの管理などにおいて、特に有用なフレームワークとなります。
このような柔軟性と適応性がどのように実現されているのかを理解するために、まずはモデル全体のアーキテクチャを見ていきましょう。 K²VAEアーキテクチャは、大きく分けてPatching、Encoder、Decoderという3つの主要なコンポーネントで構成されています。それぞれが独自の役割を担いながら、相互に連携して動作します。
- Patchingは、入力データをパッチ化し、潜在表現へ写像します。
- Encoderは、観測された時系列Xから隠れ状態Zを抽出します。 標準的なVAEモデルとは異なり、K²VAEでは、以下の要素を組み合わせた複雑なアーキテクチャを採用しています。
- KoopmanNet:クープマン作用素に相当する学習可能なモデルであり、潜在特徴量の時間発展を線形システムとして表現し、その推移を予測します。
- Attentionモジュール:再構成された値と実際の観測値との差を分析し、モデルの予測と実際のデータとの乖離が生じるタイミングを捉えます。
- KalmanNet:カルマンフィルタの考え方をニューラルネットワークと組み合わせたモデルです。Attentionモジュールから得られる制御信号に基づいて、不確実性を表す共分散行列を推定します。
- VAE機構:KalmanNetとKoopmanNetから得られるパラメータに基づき、将来のトークンを確率的にサンプリングします。
- Decoderは、潜在変数を観測可能な変数へと変換し、時系列の予測値を再構成します。 また、モデルの確率的な性質を維持するため、Decoderにも学習可能なニューラルネットワーク構造が採用されています。このネットワークは、出力分布の平均と分散の2つの出力を持ちます。 これにより、条件付き分布P(Y|Z)をモデル化し、予測に伴う不確実性を考慮できます。
著者によるK²VAEフレームワークの構成図を以下に示します。
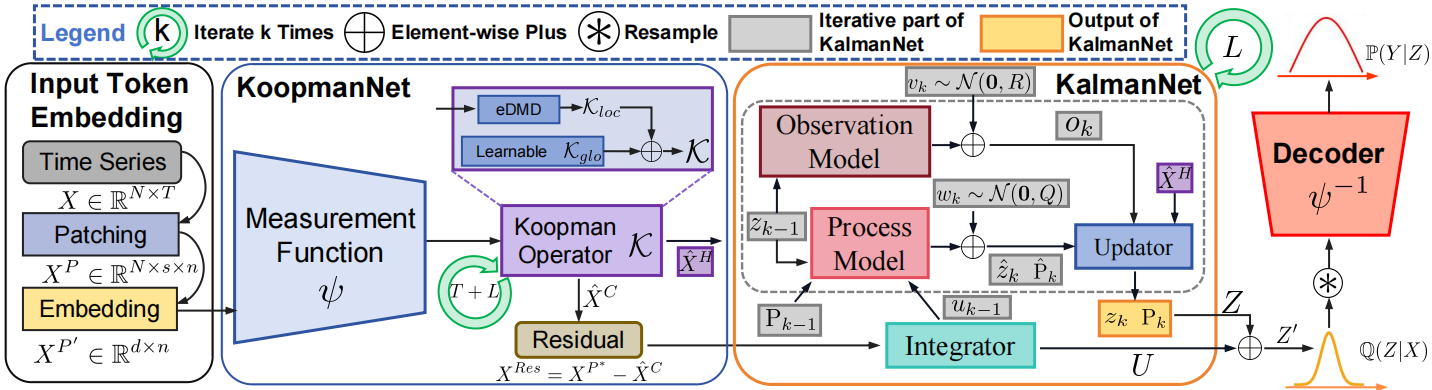
前回の記事では、モデル構築の基盤となる部分に焦点を当てました。基本的なインフラストラクチャを実装するとともに、学習可能な行列を再利用できる仕組みを導入し、堅牢性と拡張性を備えたアーキテクチャの土台を整えました。 また、パラメータ生成のための汎用クラスを作成し、標準的な誤差逆伝播法によってパラメータを更新する仕組みを検証・調整しました。さらに、今後のコンポーネントの追加や機能拡張に対応できる構造を設計しました。 これにより、より高度なモジュールを実装するための基盤が整いました。
次の論理的なステップはEncoderの開発です。Encoderは、元の時系列データを、線形解析や確率的モデリングに適した潜在表現へと変換する重要な役割を担います。 この処理は、単純に複数の層を積み重ねるだけで実現されるものではありません。各構成要素が連携して機能するよう、慎重に設計されたアーキテクチャによって実現されます。
設計アプローチに関する考察
MQL5言語を用いてEncoderを実際に実装する前に、そのアーキテクチャと設計思想を詳しく見ていきましょう。 これにより、今後の実装作業を適切に進められるだけでなく、各モジュールがモデル全体の挙動にどのように寄与するのかも理解できるようになります。
K²VAEフレームワークのEncoderは、モジュール型の設計に基づいて構築されており、相互に連携する4つのコンポーネントで構成されています。それぞれのコンポーネントは、時系列データの処理過程において、明確に定義された役割を担います。
処理チェーンの最初の要素はKoopmanNetです。これはクープマン作用素をニューラルネットワークによって実現するものであり、主な役割は時系列の線形ダイナミクスを近似することです。 隠れ状態を入力として受け取り、ある潜在空間における線形変換によってシステムの挙動を表現できると仮定し、次の状態を予測します。 しかし、実世界の時系列が厳密な線形軌道に従うことはほとんどありません。そのため、KoopmanNetの潜在空間への射影だけでは、信頼性の高いモデリングを実現するには不十分です。 モデルがトレンドを再現するだけでなく、自らの予測精度も評価できるようにするため、フレームワークの著者らは独創的な仕組みを提案しました。
KoopmanNetは、次の状態を予測するだけでなく、すでに発生した遷移を再構成するようにも学習されます。つまり、時系列の過去の値をもとに、それまでの軌跡を遡って再構成するのです。 したがって、モデルは単に未来へ向かって予測を進めるだけではなく、過去を振り返り、現在のパラメータが過去の観測結果とどの程度整合しているかを検証します。 このような双方向の推論により、予測されたダイナミクスとシステムの実際の状態との差を算出できるようになります。
まさにこの偏差、すなわちKoopmanNetによって計算された遷移と実際の過去の値との差が、線形近似の精度を評価するための基礎となります。 これにより、モデルは自己診断能力を獲得し、基盤となる線形構造を維持しながら、変化や不安定性に動的に適応できるようになります。
K²VAEフレームワークのオリジナル実装では、KoopmanNetモジュールは、2つの独立した小規模な全結合モデル(MLP)で構成されています。それぞれが、潜在空間における遷移の異なる側面をモデル化します。一方は大域的依存関係を、もう一方は局所的依存関係を担当します。 このアプローチは理論的には十分に合理的ですが、実際には制約が強く、柔軟性に欠ける可能性があります。特に、市場データの変動が激しい場合には、その問題が顕著になることが考えられます。
そこで、この記事では、より汎用性と柔軟性に優れたスパース混合エキスパートブロック、CNeuronTimeMoESparseExpertsを導入することで、KoopmanNetを強化することを提案します。 これは、TimeMoEフレームワークに属するモジュールであり、混合エキスパート(MoE)の原理を実装しています。すなわち、複数の専門化されたサブモデル(エキスパート)が並列に動作し、制御機構が入力のコンテキストに応じて最適なエキスパートを選択する仕組みです。
スパース混合エキスパートブロックは、単なる技術的な実装要素ではありません。金融時系列に含まれる局所的パターンと大域的パターンを分離するための、論理的な基盤でもあります。 このブロックでは、2種類のエキスパートが動作します。 1つ目は、専門化されたローカルエキスパートのグループです。それぞれが短期的な遷移や、コンテキストに依存するパターンの特定を担当します。 これらのエキスパートは、限られた時間区間における市場の動きを分析し、現在のボラティリティやミクロトレンドに適応します。
2つ目は、大域的エキスパートです。 これはCNeuronTimeMoESparseExperts構造に組み込まれており、一般化された線形クープマン作用素として機能します。 その目的は、学習ウィンドウ全体を通じて持続するパターンを特定し、時系列における安定した長期的なダイナミクスを捉えることです。 これにより、モデルは、詳細なローカル分析と広い視野に立った全体的な分析という、2つの視点からデータを捉えられるようになります。
このアーキテクチャにより、KoopmanNetは次の状態を予測するだけでなく、現在の状態に至るまでの遷移を遡ることで、それ以前の軌跡を再構成することもできます。 再構成された遷移を実際の値と比較することで、システムは自らの近似精度を評価できるようになります。
KoopmanNetがダイナミクスの再構成を完了し、次のステップを予測すると、続いてAttentionモジュールが機能します。その役割は、実際の値とモデルによる予測値を単純に比較することではなく、両者の間に生じた偏差そのものを分析することです。 2つのデータ系列を比較する従来のクロスアテンション機構とは異なり、このアプローチでは、誤差テンソルそのものに焦点を当て、その内部に繰り返し現れる構造やパターンを特定します。
K²VAEフレームワークの著者らは、こうした偏差を単なる副産物ではなく、独立した情報源として捉えることを提案しています。 その基本的な考え方は、誤差そのものに有用な信号が含まれているというものです。つまり、誤差は、KoopmanNetがシステムの挙動をどの程度うまく記述できているか、また、線形モデルでは捉えきれていないダイナミクスの局所的な特徴がどこにあるかを示しています。 Attentionによって、これらの誤差から制御信号のテンソルを抽出できます。これは、次の段階で予測を調整するための一種の指針として機能します。
したがって、このモデルは予測値と実際の結果を単に比較するだけでなく、自らの弱点を意味のある形で解釈することを学習します。 このアプローチこそが、K²VAEの高い適応性と高度な情報処理能力を支える基盤であり、変化が激しく不安定な環境でも効果的に動作することを可能にします。
今回提案する実装では、実際の運用で検証され、これまでに時系列解析への適用実績もあるSelf-Attentionモジュールを利用できます。 これにより、開発プロセスを大幅に効率化できるだけでなく、フレームワークの他のコンポーネントとの互換性も確保できます。 このモジュールは、繰り返し現れるパターンや、異なる時間区間における偏差間の局所的依存関係を検出することで、誤差の構造に潜む規則性を特定します。
ここで重要なのは、この文脈におけるSelf-Attentionは、標準的なTransformerで一般的に行われるように元の入力系列を処理するためのものではない、という点です。ここでは、KoopmanNetによるダイナミクスの再構成時に生じる再構成誤差を分析するために使用します。 つまり、モデルの注目対象をデータそのものから、自らの処理結果へと移すことで、システムが自身の挙動を客観的に評価し、誤差から有用な情報を抽出できるようにします。
ただし、このアプローチを実装する際には、興味深い問題が生じます。 分析対象となる過去の履歴の長さと、制御信号を生成する対象となる予測期間の長さは、必ずしも一致しません。 フレームワークのオリジナル版では、この問題を線形射影によって解決しています。これは、制御ベクトルを必要な予測期間に合わせて変換する、簡潔な仕組みです。
今回の実装では、状況がやや単純になります。 モデルは次のトークンを1つだけ生成するように設計されているため、制御信号の系列を生成する必要はなく、単一のベクトルだけで十分です。 もちろん、同じ線形射影を利用することもできます。 しかし、ここでは別のアプローチを提案します。それは、過去の偏差の連鎖全体を考慮しながら、最後のトークンに対応する誤差に注目する方法です。
このアプローチによって、新たな可能性が開かれます。 誤差を独立した量として扱うのではなく、過去から蓄積された予測の不正確さと関連付けて分析します。 これにより、Attention機構は、過去のダイナミクスのどの区間が現在の誤差に最も大きな影響を与えたのかを特定できます。 その結果、単に現在の誤差に反応するだけでなく、システムの過去の状態に反映された誤差の原因まで考慮する制御ベクトルが得られます。
この方法には、明確な利点がいくつかあります。
- 対象を絞ったAttention:軌跡全体に計算資源を分散させるのではなく、最後のステップの誤差に焦点を当てる。
- 計算負荷の軽減:将来の各ステップに対して長いベクトルを生成する必要がない。
- 解釈性の向上:制御信号が明確な意味を持ち、可視化による分析や診断に適したものになる。
最終的に、Encoderに柔軟な内部制御機構が組み込まれます。これにより、モデルは自身の弱点に適応し、KalmanNetとVAEを通じて、次のステップに対する確率分布をより適切に形成できるようになります。 このアプローチは、アーキテクチャの堅牢性を高めるだけでなく、その挙動の透明性も向上させます。これは、市場の不確実性が高い状況で運用する際に、特に重要な特性です。
Encoderの次の構成要素は、KalmanNetです。このモジュールは、適応型の共分散行列生成器として機能します。 その役割は、単に情報を次の段階へ伝達することではなく、KoopmanNetから得られた線形予測の信頼度を積極的に評価することです。 Attentionブロックから送られる制御信号は、前段のモデルの信頼性を示す指標として機能します。 偏差が小さく、安定している場合、KalmanNetは予測に対する信頼度が高いと判断し、それに応じて共分散を縮小します。これは、時系列のその後の挙動が、高い確率で予測されたシナリオに従うという仮定に基づいています。 一方、誤差に大きな不均衡や構造的な変化が見られる場合、モデルは共分散行列を拡大し、より多様な確率的結果を許容します。
このように、KalmanNetは実質的に信頼度の指標として機能します。データ内の変動や不安定性に敏感に反応する、一種のバロメーターといえます。 単に信号を伝達するのではなく、その信号を解釈し、捉えにくい微細な変動を、後続の処理で利用できる数学的な形式へと変換します。
Encoderの動作は、変分サンプリングブロック(VAE)によって完了します。 ここで、将来状態を表す最終的な潜在表現が形成されます。 ただし、サンプリングは無作為におこなわれるわけではありません。それまでの各段階で得られた情報に基づいて実行されます。 予測されるダイナミクスの基準となる平均値はKoopmanNetから取得し、ばらつきの程度はKalmanNetが生成する共分散行列によって決定します。 その結果、点予測ではなく、時系列の線形構造と市場の確率的な性質の両方を考慮した確率モデルが得られます。
このアプローチには、明確な戦略的優位性があります。 モデルは不確実性の高い状況でも柔軟性を維持し、単一の展開シナリオに固執することなく、状況に応じて予測に対する信頼度を調整することができます。 そのため、このフレームワークは、将来の状態を予測すること自体よりも、リスクや信頼度の評価に基づいて動的に意思決定することが重要な用途に適しています。
今回の実装では、不確実性の程度や潜在的なリスクを表現するために、単一の予測値だけに頼ることはしません。 その代わりに、時系列が次のステップでどのように推移し得るかについて、指定された数のシナリオをサンプリングします。 それぞれのシナリオは、KoopmanNetとKalmanNetによって形成された共通の分布に基づいて生成される、個別の軌跡です。 この方法により、平均的な推定値を得るだけでなく、起こり得る結果の幅広い範囲を捉え、モデルが将来の動きをどの程度安定して予測できているかを評価できます。
KoopmanNet、Attentionブロック、KalmanNet、そしてVAEが連携することで、複雑でありながらも論理的な構造が形成されます。それぞれのコンポーネントが固有の役割を果たしながら、信頼性と適応性を備えた将来の状態の表現を構築します。
オブジェクト構造
K²VAEのEncoderにおけるアーキテクチャの設計原則や各コンポーネントの連携の仕組みについて詳しく解説してきました。ここからは、実際の実装について見ていきましょう。 モジュール性、柔軟性、コードの可読性を確保するため、主要な要素をCNeuronK2VAEEncoderクラスの単一のオブジェクトに集約しました。このクラスは、CNeuronBaseOCLを継承し、その基本機能を利用します。
このオブジェクトには、Encoderの一連の処理を実行するために必要な機能がすべて組み込まれています。具体的には、KoopmanNetによる時系列のダイナミクスの分析、KalmanNetによる将来状態の共分散構造の構築、そしてVAEの仕組みを利用した確率的な予測のサンプリングまでを担います。 また、クープマンネットワーク、Attentionブロック、カルマンフィルタといった専用コンポーネントに加え、変換処理、線形演算、行列計算をおこなうための各種の層も備えています。
以下に、CNeuronK2VAEEncoderクラスの構造を示します。各コンポーネントは、観測された系列をエンコードする一連の処理の中で、それぞれ固有の役割を果たします。 この実装により、モデルのあらゆる階層において、処理を段階的に分析し、デバッグすることが可能になります。さらに、さまざまなアーキテクチャ構成や解析の深さに対応できる、拡張性の高い設計となっています。
class CNeuronK2VAEEncoder   :  public CNeuronBaseOCL
  {
protected:
   //--- Koopman
   CNeuronTimeMoESparseExperts   cKoopman;
   CNeuronBaseOCL                cKoopmanPred;
   CNeuronBaseOCL                cKoopmanRest;
   //---
   CNeuronTimeMoEAttention       cAuxiliaryNet;
   //--- Kalman Filter
   CParams              cB;      // Control input matrix B
   CParams              cF;      // State transition matrix F
   CParams              cH;      // Observation matrix H
   CParams              cQ;      // Learnable covariance matrices Q
   CParams              cR;      // Learnable covariance matrices R
   CNeuronBaseOCL       cP;      // Covariance matrices P
   //---
   CNeuronTransposeOCL  cFT;
   CNeuronTransposeOCL  cHT;
   CNeuronTransposeOCL  cQT;
   CNeuronTransposeOCL  cRT;
   CNeuronTransposeOCL  cPT;
   //---
   CNeuronBaseOCL       cQ_QT;
   CNeuronBaseOCL       cR_RT;
   CNeuronBaseOCL       cXPred;
   CNeuronBaseOCL       cF_P;
   CNeuronBaseOCL       cPPred;
   //---
   CNeuronBaseOCL       cP_HT;
   CNeuronBaseOCL       cH_P_HT;
   matrix<double>       mS, mSGrad;
   CNeuronBaseOCL       cSInv;
   CNeuronBaseOCL       cK;
   CNeuronTransposeOCL  cKT;
   CNeuronBaseOCL       cYPred;
   CNeuronBaseOCL       cDeltY;
   CNeuronBaseOCL       cX;
   CNeuronBaseOCL       cK_H;
   CNeuronBaseOCL       cIdifK_H;
   CNeuronTransposeOCL  cIdifK_HT;
   matrix<double>       mP;
   matrix<double>       mPGrad;
   matrix<double>       mNoise;
   matrix<double>       mGrad;
   //---
   virtual bool      feedForward(CNeuronBaseOCL *NeuronOCL) override;
   virtual bool      updateInputWeights(CNeuronBaseOCL *NeuronOCL) override;
   virtual bool      calcInputGradients(CNeuronBaseOCL *NeuronOCL) override;

public:
                     CNeuronK2VAEEncoder(void) {};
                    ~CNeuronK2VAEEncoder(void) {};
   //---
   virtual bool      Init(uint numOutputs, uint myIndex, COpenCLMy *open_cl,
                          uint window, uint window_key, uint units_cross,
                          uint heads, uint layers, uint scenarios,
                          uint experts, uint experts_dimension, uint topK,
                          ENUM_OPTIMIZATION optimization_type, uint batch);
   //---
   virtual bool      Save(const int file_handle) override;
   virtual bool      Load(const int file_handle) override;
   //---
   virtual int       Type(void)        const                      {  return defNeuronK2VAEEncoder; }
   virtual void      TrainMode(bool flag) override;
   virtual void      SetOpenCL(COpenCLMy *obj);
   //---
   virtual bool      WeightsUpdate(CNeuronBaseOCL *source, float tau);
  };
ここで示す新しいクラスの構造では、Encoderアーキテクチャ全体の設計思想を反映する主要コンポーネントに特に注目する必要があります。 KoopmanNetとして、強力なCNeuronTimeMoESparseExpertsモジュールを採用しています。このモジュールは、スパース混合エキスパートによる局所的な柔軟性と、大域的予測器による安定性を兼ね備えています。 この構成により、時系列における短期的なダイナミクスと持続的なダイナミクスの両方を効果的にモデル化できます。
AttentionモジュールにはCNeuronTimeMoEAttentionを採用し、再構成誤差の構造を分析します。 偏差に現れるパターンを特定し、KoopmanNetの予測に対する信頼度を評価するための制御特徴量を生成します。
実装において特に重要なのが、カルマンフィルタのブロックです。 ここでは、学習可能な行列B、F、H、Q、Rが定義されており、それぞれがCParamsクラスの独立したインスタンスとして表現されています。 この方法により、フィルタのパラメータを一元管理できるだけでなく、学習中にそれらを完全に適応させることも可能になります。
これらのコンポーネントに加え、クラス構造には、KalmanNetの段階的な処理ロジックを正しく実装し、Encoder 内のすべてのテンソル演算を効率的に管理するための補助オブジェクトも多数含まれています。 これらの補助オブジェクトの機能については、クラスの各メソッドを実装する際に、さらに詳しく説明します。
CNeuronK2VAEEncoderクラスでは、使用するすべてのコンポーネントを静的に宣言する構成を採用しています。 これにより、オブジェクトのライフサイクルが簡素化され、メモリの確保や解放を手動で行う必要がなくなります。 そのため、クラスのコンストラクタとデストラクタは空のままにでき、不要な処理によってコードが複雑になるのを避けられます。
KoopmanNet の設定、Attentionパラメータ、カルマンフィルタのパラメータなど、アーキテクチャに関する設定はすべてInitメソッドでおこないます。 このメソッドでオブジェクトの具体的な構成が決まります。具体的には、Attentionのパラメータを設定し、制御特徴量の次元を指定するとともに、エキスパート数、入力ウィンドウの深さ、その他の重要なモデル特性を設定します。
bool CNeuronK2VAEEncoder::Init(uint numOutputs, uint myIndex, COpenCLMy * open_cl,
                               uint window, uint window_key, uint units_cross,
                               uint heads, uint layers, uint scenarios,
                               uint experts, uint experts_dimension, uint topK,
                               ENUM_OPTIMIZATION optimization_type, uint batch)
  {
   if(!CNeuronBaseOCL::Init(numOutputs, myIndex, open_cl, window * scenarios, optimization_type, batch))
      return false;
最初の段階では、基底クラスの同名の関数に処理を委譲します。 これにより、入力パラメータの基本的な検証に必要な既存の仕組みを利用できるほか、継承されたインターフェースや共通コンポーネントを初期化できます。 このアプローチにより、すべてのニューラルネットワーク層で初期化手順が統一され、アーキテクチャの保守や拡張が容易になります。
メモリ構成については、特に注意が必要です。 今回の実装では、K²VAEのEncoderは単一のベクトルではなく、サンプリングによって生成された複数の将来シナリオを返します。そのため、結果を格納するバッファのサイズも、それに応じて設定する必要があります。
次に、KoopmanNetブロックの初期化に進みます。今回の実装では、このブロックをCNeuronTimeMoESparseExpertsモジュールで構成しています。 モデルの数と各モデルの次元数を指定し、スパース混合エキスパートモジュールを初期化します。 このコンポーネントは、クープマン作用素の振る舞いを模倣することで、時系列から局所的なパターンと大域的なパターンの両方を抽出する役割を担います。
//--- Koopman
   int index = 0;
   if(!cKoopman.Init(0, index, OpenCL, window, 2 * window, units_cross, 1, experts, topK, optimization, iBatch))
      return false;
   index++;
   if(!cKoopmanPred.Init(0, index, OpenCL, window, optimization, iBatch))
      return false;
   index++;
   if(!cKoopmanRest.Init(0, index, OpenCL, window * (units_cross - 1), optimization, iBatch))
      return false;
次に、2つのヘルパーオブジェクト、cKoopmanPred と cKoopmanRest を初期化します。 前者はKoopmanNetが算出した予測値の格納に使用し、後者は時系列ですでに観測された状態を再構成するために使用します。
続いて、Attentionモジュールを初期化します。今回の実装では、このモジュールをcAuxiliaryNetオブジェクトで表現しています。
index++;
if(!cAuxiliaryNet.Init(0, index, OpenCL, window, window_key, 1, window, units_cross - 1,
                                                   heads, layers, optimization, iBatch))
   return false;
しかし、新しいクラスの内部アーキテクチャにおいて重要な部分を占めるのが、カルマンフィルタの処理構成です。ここに計算の大部分と、Initメソッドに実装されたロジックの大半が集約されています。
最初の段階では、フィルタの学習可能なパラメータを表す正方行列を順番に初期化します。すなわち状態遷移行列 F、制御入力行列 B、観測行列 Hに加え、モデル誤差の共分散行列Q と観測誤差の共分散行列Rを初期化します。
//--- Kalman Filter
   index++;
   if(!cB.Init(0, index, OpenCL, window * window, optimization, iBatch) ||
      !cB.Identity(window, window))
      return false;
   index++;
   if(!cF.Init(0, index, OpenCL, window * window, optimization, iBatch) ||
      !cF.Identity(window, window))
      return false;
   index++;
   if(!cH.Init(0, index, OpenCL, window * window, optimization, iBatch) ||
      !cH.Identity(window, window))
      return false;
   index++;
   if(!cQ.Init(0, index, OpenCL, window * window, optimization, iBatch) ||
      !cQ.Identity(window, window))
      return false;
   index++;
   if(!cR.Init(0, index, OpenCL, window * window, optimization, iBatch) ||
      !cR.Identity(window, window))
      return false;
   index++;
   if(!cP.Init(0, index, OpenCL, window * window, optimization, iBatch) ||
      !cP.getOutput().Fill(matrix<float>::Identity(window, window)))
      return false;
各行列の初期化時には、それぞれの次元を指定します。 次に、学習初期の反復処理においてカルマンフィルタの数値的な安定性を確保するため、これらの行列をすべて対角行列として初期化します。 この初期化により、共分散行列が正定値となるようにし、予測の補正処理で行列Sを逆行列に変換する際に生じる計算の不安定性を防ぎます。
対角行列による初期化は、学習初期の安定性を高めるだけでなく、潜在状態のさまざまな成分に対してモデルが均等に感度を持つようにします。これは、支配的なトレンドによって、弱くても重要なシグナルが埋もれてしまう時系列を扱ううえで、特に重要です。
次に、対応する行列の転置を担当するオブジェクトを準備します。 一見すると技術的な細部に思えますが、アルゴリズム全体を正しく動作させるうえで重要な工程です。 これは、カルマンフィルタの計算中に、行列F、H、Q、R、Pそのものだけでなく、それらの転置行列も繰り返し参照する必要があるためです。 そのため、対応する転置用オブジェクトをあらかじめ確保し、初期化しておきます。
index++;
if(!cFT.Init(0, index, OpenCL, window, window, optimization, iBatch))
   return false;
index++;
if(!cHT.Init(0, index, OpenCL, window, window, optimization, iBatch))
   return false;
index++;
if(!cQT.Init(0, index, OpenCL, window, window, optimization, iBatch))
   return false;
index++;
if(!cRT.Init(0, index, OpenCL, window, window, optimization, iBatch))
   return false;
index++;
if(!cPT.Init(0, index, OpenCL, window, window, optimization, iBatch))
   return false;
これにより、転置行列をバッファリングする仕組みが実現され、計算速度が大幅に向上するとともに、フィルタリングアルゴリズムの主要部分のコード構造も簡潔になります。 さらに、各フィルタ要素を全体の処理フローに影響を与えることなく個別に扱えるため、アーキテクチャのモジュール性も高まります。
ノイズの共分散行列であるQ(プロセスノイズの共分散行列)とR(観測ノイズの共分散行列)には、特に注意を払う必要があります。 カルマンフィルタのアルゴリズムが正しく機能するには、これらの行列が2つの重要な性質を満たしていなければなりません。主対角線に関して対称であること、そして正定値であることです。 これらの条件を満たさない場合、フィルタリングが不安定になったり、逆行列を計算する際に虚数値が生じたり、状態推定が完全に破綻したりする可能性があります。
学習中もこれらの性質を維持するため、実績があり広く用いられている手法を採用します。具体的には、行列QとRを、それぞれ元の行列とその転置行列の積として表現します。 この表現により、元の行列が特異行列でない限り、得られる行列は自動的に対称かつ正定値になります。 これにより、対角成分を手動で監視したり、正則化を導入したりする必要がなくなります。
index++;
if(!cQ_QT.Init(0, index, OpenCL, window * window, optimization, iBatch))
   return false;
index++;
if(!cR_RT.Init(0, index, OpenCL, window * window, optimization, iBatch))
   return false;
Encoderの設定では、次に、中間計算の結果を格納するオブジェクトを初期化します。 これらのオブジェクトは、各計算が直前の処理結果に基づいておこなわれるカルマンフィルタのアルゴリズムを段階的に実装するうえで、重要な役割を果たします。 また、誤差勾配を正しく伝播させるため、逆伝播処理でもこれらの値を使用します。
まず、補正処理を適用する前のシステムの予測状態を格納するcXPredオブジェクトを初期化します。
index++;
if(!cXPred.Init(0, index, OpenCL, window, optimization, iBatch))
   return false;
index++;
if(!cF_P.Init(0, index, OpenCL, window * window, optimization, iBatch))
   return false;
index++;
if(!cPPred.Init(0, index, OpenCL, window * window, optimization, iBatch))
   return false;
次に、cF_PとcPPredの各オブジェクトを初期化します。これらはそれぞれ、状態遷移行列と共分散行列の積、および予測共分散行列を格納します。 これらのデータは、予測の信頼性を評価する後続の処理で必要となります。
続いて、cP_HTブロックとcH_P_HTの各ブロックを順番に設定します。これらは、観測予測誤差の共分散行列であるS行列を計算する際に、中間値を算出します。
   index++;
   if(!cP_HT.Init(0, index, OpenCL, window * window, optimization, iBatch))
      return false;
   index++;
   if(!cH_P_HT.Init(0, index, OpenCL, window * window, optimization, iBatch))
      return false;
//---
   mS = mSGrad = matrix<double>::Zeros(window, window);
同時に、行列mSおよびmSGradが作成され、初期化されます。これらは、学習中に共分散値そのものと、それに対応する勾配を格納するために使用されます。
cSInvオブジェクトは、カルマンゲインcKの計算に必要なS行列の逆行列を格納するためのものです。また、このゲインには、それ自体の転置であるcKTも用意されています。
   index++;
   if(!cSInv.Init(0, index, OpenCL, window * window, optimization, iBatch))
      return false;
   index++;
   if(!cK.Init(0, index, OpenCL, window * window, optimization, iBatch))
      return false;
   index++;
   if(!cKT.Init(0, index, OpenCL, window, window, optimization, iBatch))
      return false;
//---
   index++;
   if(!cYPred.Init(0, index, OpenCL, window, optimization, iBatch))
      return false;
//---
   index++;
   if(!cDeltY.Init(0, index, OpenCL, window, optimization, iBatch))
      return false;
次に、観測値を予測するcYPredブロックと、予測値と実際の観測値との差を表すcDeltYブロックを初期化します。
特に重要なのが、カルマンフィルタによる補正を適用した後の最終的な状態を格納するcXオブジェクトです。
   index++;
   if(!cX.Init(0, index, OpenCL, window, optimization, iBatch))
      return false;
//---
   index++;
   if(!cK_H.Init(0, index, OpenCL, window * window, optimization, iBatch))
      return false;
//---
   index++;
   if(!cIdifK_H.Init(0, index, OpenCL, window * window, optimization, iBatch))
      return false;
//---
   index++;
   if(!cIdifK_HT.Init(0, index, OpenCL, window, window, optimization, iBatch))
      return false;
続いて、誤差逆伝播を正しくおこない、共分散推定値を更新するために必要な数学的変換の結果を記録するcK_H、cIdifK_H、cIdifK_HTを初期化します。
最後に、行列mPとmPGrad、および補助配列mNoiseとmGradを初期化します。これらは、サンプリング段階でノイズを生成するため、またモデルの学習中に勾配を計算するために使用します。
   mP = mPGrad = mS;
   mNoise = mGrad = matrix<double>::Zeros(scenarios, window);
//---
   return true;
  }
このように、この段階では、K²VAEのEncoder内でカルマンフィルタを安定かつ正確に動作させるための、包括的な計算基盤が構築されます。 すべての内部コンポーネントの初期化が正常に完了すると、初期化メソッドは処理結果を示す真偽値を呼び出し元のプログラムに返し、処理を終了します。
順伝播の構成
各種データを格納するオブジェクトの初期化を終え、順伝播メソッドfeedForwardの説明に移ることで、K²VAEのEncoderにおける計算ロジックの核心に踏み込んでいきます。 ここで、これまでに準備したすべてのコンポーネントが統合され、ひとつのシステムとして機能します。 よく調整された機構のように、全体の構造が連携して動作し、入力された観測値を内部表現へと変換します。
順伝播処理は、モデルの重要な構成要素であるクープマンブロックから始まります。このブロックは、学習中にシステムの線形ダイナミクスを学習します。 推論時の順伝播処理では、解析対象の系列と、学習済みの変化の線形構造に基づいて、一連の再構成結果と単一の予測状態を生成します。 したがって、その出力は2つの重要な要素から構成されます。ひとつは、直近の観測値と、学習済みの線形パターンのみに基づく将来状態の予測です。もうひとつは、過去の状態系列全体を再構成したもので、履歴データの解析対象となる期間の始点までさかのぼります。
bool CNeuronK2VAEEncoder::feedForward(CNeuronBaseOCL * NeuronOCL)
  {
//--- Koopman
   if(!cKoopman.FeedForward(NeuronOCL))
      return false;
//--- Pred / Rest
   if(!DeConcat(cKoopmanPred.getOutput(), cKoopmanRest.getPrevOutput(), cKoopman.getOutput(),
                cKoopman.GetWindow(), cKoopman.Neurons() - cKoopman.GetWindow(), 1))
      return false;
   if(!Different(NeuronOCL.getOutput(), cKoopmanRest.getPrevOutput(),
                 cKoopmanRest.getOutput(), cKoopman.GetWindow()))
      return false;
このように処理を分離することは、特に重要です。予測値はカルマンフィルタのブロックで使用される一方、残差系列(実際のデータと再構成値との差分)はAttentionモジュールに渡されます。Attentionモジュールは、線形モデルでは捉えきれないダイナミクスの特徴を分析します。
//--- Rest Attention
   if(!cAuxiliaryNet.FeedForward(cKoopmanRest.AsObject()))
      return false;
次に、モデルが学習モードで動作している場合、カルマンフィルタの学習可能なコンポーネントをすべて有効化します。 これには、状態遷移行列、制御入力行列、観測行列、およびモデル誤差と観測誤差の共分散行列が含まれます。
//--- Kalman Filter
   if(bTrain)
     {
      if(!cB.FeedForward())
         return false;
      if(!cF.FeedForward())
         return false;
      if(!cH.FeedForward())
         return false;
      if(!cQ.FeedForward())
         return false;
      if(!cR.FeedForward())
         return false;
      if(!cFT.FeedForward(cF.AsObject()))
         return false;
      if(!cHT.FeedForward(cH.AsObject()))
         return false;
      if(!cQT.FeedForward(cQ.AsObject()))
         return false;
      if(!cRT.FeedForward(cR.AsObject()))
         return false;
フィルタが正しく動作するためには、行列QとRが正定値である必要があるため、まず、それぞれの行列に自身の転置行列を乗じて安定化させます。
 if(!MatMul(cQ.getOutput(), cQT.getOutput(), cQ_QT.getOutput(),
            cQT.GetCount(), cQT.GetWindow(), cQT.GetCount(), 1, true))
    return false;
 if(!MatMul(cR.getOutput(), cRT.getOutput(), cR_RT.getOutput(),
            cRT.GetCount(), cRT.GetWindow(), cRT.GetCount(), 1, true))
    return false;
}
すべてのパラメータの準備が整うと、予測段階に入ります。 まず、入力データとAttentionモジュールの出力という2つの情報を組み合わせ、次のステップの状態を予測します。 これらのベクトルを学習可能なパラメータ行列FとBでそれぞれ射影し、その結果を加算します。 こうして、中間状態XPredが生成されます。
//--- Prediction step
   if(!MatMul(NeuronOCL.getOutput(), cFT.getOutput(), cXPred.getGradient(),
              1, cFT.GetWindow(), cFT.GetCount(), 1, true))
      return false;
   if(!MatMul(cAuxiliaryNet.getOutput(), cB.getOutput(), cXPred.getPrevOutput(),
              1, cFT.GetWindow(), cFT.GetCount(), 1, true))
      return false;
   if(!SumAndNormilize(cXPred.getGradient(), cXPred.getPrevOutput(), cXPred.getOutput(),
                       cFT.GetCount(), false, 0, 0, 0, 1))
      return false;
次に、状態誤差の予測共分散を計算します。 そのために、状態遷移行列と現在の共分散行列を順に乗算し、さらにモデルノイズの共分散行列Qを加算します。これにより、予測共分散*P_predが生成されます。
if(!MatMul(cF.getOutput(), cP.getOutput(), cF_P.getOutput(),
           cFT.GetCount(), cFT.GetWindow(), cP.Neurons() / cFT.GetWindow(), 1, true))
   return false;
if(!MatMul(cF_P.getOutput(), cFT.getOutput(), cPPred.getOutput(),
           cFT.GetCount(), cFT.GetWindow(), cFT.GetCount(), 1, true))
   return false;
if(!SumAndNormilize(cPPred.getOutput(), cQ_QT.getOutput(), cPPred.getOutput(),
                    cHT.GetWindow(), false, 0, 0, 0, 1))
   return false;
この段階では、カルマンフィルタの大きな特長である予測値の補正処理を開始します。 まず、観測誤差の共分散を計算し、観測値の分散と予測値の分散を合算した行列Sを構成します。
//--- Update step
   if(!MatMul(cPPred.getOutput(), cHT.getOutput(), cP_HT.getOutput(),
              cPPred.Neurons() / cHT.GetWindow(), cHT.GetWindow(), cHT.GetCount(), 1, true))
      return false;
   if(!MatMul(cH.getOutput(), cP_HT.getOutput(), cH_P_HT.getOutput(),
              cHT.GetCount(), cHT.GetWindow(), cHT.GetCount(), 1, true))
      return false;
   if(!SumAndNormilize(cH_P_HT.getOutput(), cR_RT.getOutput(), cR_RT.getPrevOutput(),
                       cRT.GetWindow(), false, 0, 0, 0, 1))
      return false;
状態補正における重み係数として機能するカルマンゲインKを計算するには、行列Sの逆行列を使用します。 行列の逆行列を求めるアルゴリズムを一から実装することはせず、 MQL5に備わっている既存の行列演算機能を利用することにしました。 必要に応じて、行列を安定化し、対角化したうえで再構成することで、特異行列になることを防ぎます。
if(cR_RT.getPrevOutput().GetData(mSGrad) <= 0)
   return false;
mS = mSGrad.Inv();
if(mS.Rows() == 0)
  {
   mSGrad = mSGrad + mSGrad.Transpose();
   vector<double> eigvals;
   matrix<double> eigvecs;
   if(!mSGrad.Eig(eigvecs, eigvals))
      return false;
   if(eigvals.Size() > 0)
     {
      if(!eigvals.Clip(1e-6, DBL_MAX))
         return false;
      mSGrad = matrix<double>::Zeros(eigvals.Size(), eigvals.Size());
      mSGrad.Diag(eigvals);
      mSGrad = eigvecs.MatMul(mSGrad.MatMul(eigvecs.Transpose()));
      mSGrad = mSGrad + mSGrad.Transpose();
      mS = mSGrad.Inv();
     }
   if(mS.Rows() == 0)
     {
      mSGrad.Identity();
      mS = mSGrad;
     }
  }
cSInv.getOutput().Fill(mS);
if(!MatMul(cP_HT.getOutput(), cSInv.getOutput(), cK.getOutput(),
           cHT.GetCount(), (int)mS.Rows(), (int)mS.Cols(), 1, true))
   return false;
観測更新段階では、モデルは実際の観測値ではなく、KoopmanNetから得られた別の予測値に基づいて、先に予測した状態を補正します。 まず、予測状態XPredに観測行列Hの転置行列を乗じて、観測値の期待値を計算します。 この値(YPred)は、モデルの予測に誤差がないと仮定した場合に得られる観測値を表します。
//--- Measurement update
   if(!MatMul(cXPred.getOutput(), cHT.getOutput(), cYPred.getOutput(),
              1, cHT.GetWindow(), cHT.GetCount(), 1, true))
      return false;
   if(!Different(cKoopmanPred.getOutput(), cYPred.getOutput(), cDeltY.getOutput(),
                 1, 0, 0, 0, 1))
      return false;
   if(!MatMul(cDeltY.getOutput(), cK.getOutput(), cX.getPrevOutput(), 1,
              cDeltY.Neurons(), cX.Neurons(), 1, true))
      return false;
   if(!SumAndNormilize(cX.getPrevOutput(), cXPred.getOutput(), cX.getOutput(), 1, false, 0, 0, 0, 1))
      return false;
2つのモデルの予測値の差を誤差として扱います。 この誤差にカルマンゲインKを乗じることで補正ベクトルを求め、初期予測値XPredに加算し、補正後の状態Xを得ます。
同時に、状態の共分散行列Pを、数値誤差の蓄積を防ぎ、対称性を維持するのに役立つ、Joseph安定化形式によって更新します。
//--- Joseph stabilized form for P
   if(!MatMul(cK.getOutput(), cH.getOutput(), cK_H.getOutput(), cKT.GetCount(),
              cKT.GetWindow(), cHT.GetWindow(), 1, true))
      return false;
   if(!IdentDifferent(cK_H.getOutput(), cIdifK_H.getOutput(), cHT.GetWindow(), 0, 0, 1))
      return false;
   if(!cIdifK_HT.FeedForward(cIdifK_H.AsObject()))
      return false;
   if(!cKT.FeedForward(cK.AsObject()))
      return false;
   if(!MatMul(cIdifK_H.getOutput(), cPPred.getOutput(), cIdifK_H.getPrevOutput(),
              cIdifK_HT.GetCount(), cIdifK_HT.GetWindow(), cIdifK_HT.GetWindow(), 1, true))
      return false;
   if(!MatMul(cIdifK_H.getPrevOutput(), cIdifK_HT.getOutput(), cP.getPrevOutput(),
              cIdifK_HT.GetCount(), cIdifK_HT.GetWindow(), cIdifK_HT.GetCount(), 1, true))
      return false;
   if(!MatMul(cK.getOutput(), cR_RT.getOutput(), cK.getPrevOutput(),
              cKT.GetCount(), cRT.GetCount(), cRT.GetCount(), 1, true))
      return false;
   if(!MatMul(cK.getPrevOutput(), cKT.getOutput(), cKT.getPrevOutput(),
              cKT.GetCount(), cKT.GetWindow(), cKT.GetCount(), 1, true))
      return false;
   if(!SumAndNormilize(cP.getPrevOutput(), cKT.getPrevOutput(), cP.getOutput(), cPT.GetWindow(), false, 0, 0, 0, 1))
      return false;
   if(!cPT.FeedForward(cP.AsObject()))
      return false;
   if(!SumAndNormilize(cP.getOutput(), cPT.getOutput(), cP.getOutput(), 1, false, 0, 0, 0, 0.5f))
      return false;
すべての計算が完了したら、最後に出力ベクトルを生成します。 そのために、得られた逆共分散行列P⁻¹に基づいてサンプリングをおこないます。 ランダムノイズをPによってスケーリングし、その結果を状態ベクトルXに加算することで、最終的な表現を生成します。
   if(!SumAndNormilize(cX.getOutput(), cAuxiliaryNet.getOutput(), cX.getOutput(), 1, false, 0, 0, 0, 1))
      return false;
//--- Sample Output
   if(!cP.getOutput().GetData(mPGrad))
      return false;
   if(mPGrad.HasNan() > 0)
     {
      mPGrad.Identity();
      if(!cP.getOutput().Fill(mPGrad))
         return false;
     }
   mP = mPGrad.Inv();
   if(mP.Rows() == 0)
     {
      mPGrad = mPGrad + mPGrad.Transpose();
      vector<double> eigvals;
      matrix<double> eigvecs;
      if(!mPGrad.Eig(eigvecs, eigvals))
         return false;
      if(eigvals.Size() > 0)
        {
         if(!eigvals.Clip(1e-6, DBL_MAX))
            return false;
         mPGrad = matrix<double>::Zeros(eigvals.Size(), eigvals.Size());
         mPGrad.Diag(eigvals);
         mPGrad = eigvecs.MatMul(mPGrad.MatMul(eigvecs.Transpose()));
         mPGrad = mPGrad + mPGrad.Transpose();
         mP = mPGrad.Inv();
        }
      if(mP.Rows() == 0)
        {
         mPGrad.Identity();
         if(!cP.getOutput().Fill(mPGrad))
            return false;
         mP = mPGrad.Inv();
        }
     }
   mNoise.Random(-1, 1);
   matrix<double> temp = mNoise.MatMul(mP);
   if(!PrevOutput.Fill(temp))
      return false;
   if(!SumVecMatrix(cX.getOutput(), PrevOutput, Output, (int)mNoise.Cols(), 0, 0, 0, 1))
      return false;
//---
   return true;
  }
結果テンソルを生成する最終段階では、単一のシナリオを構築するだけではない点を強調しておく必要があります。 モデルはその代わりに、さまざまな軌道の集合を生成します。それぞれの軌道は、共分散行列Pによって記述される多変量分布から得られる実現値です。 これは単なる数学的な技巧ではなく、モデル自身の予測に対する信頼度を反映したものです。
このアプローチこそが、市場が不安定な状況や信頼できる情報が不足している状況において、モデルを特に有用なものにしています。モデルは、将来起こり得る単一のシナリオを予測するだけでなく、学習によって得られた知見に基づいて、起こり得る軌道の全体像を描き出すことができます。 これにより、feedForwardの出力は、解の確率的な分布へと変わります。 その一つひとつが、事態がどのように展開し得るかについて、異なる側面を表しています。
誤差勾配分布の特徴
モデルがさまざまな軌道を生成すると、順伝播処理が終了し、同じく重要な段階である誤差勾配の逆伝播が始まります。 この処理は、calcInputGradientsメソッドで実装しています。このメソッドの主な役割は、モデルの出力層から入力データへと勾配を伝え、関連するすべての構成要素を通じて誤差を正しく伝播させることです。
アルゴリズムは、線形モデルの予測平均値と共分散行列Pの間で勾配を分配することから始まります。
bool CNeuronK2VAEEncoder::calcInputGradients(CNeuronBaseOCL *NeuronOCL)
  {
   if(!NeuronOCL)
      return false;
//--- From Output
   if(!SumVecMatrixGrad(cX.getGradient(), PrevOutput, Gradient, (int)mNoise.Cols(), 0, 0, 0, 1))
      return false;
   if(!PrevOutput.GetData(mGrad))
      return false;
   mPGrad = mNoise.Transpose().MatMul(mGrad);
   mP = mP.Transpose();
   mP = (mP * (-1)).MatMul(mPGrad.MatMul(mP));
誤差勾配もJoseph安定化形式を通じて伝播させます。
//--- Joseph stabilized form for P
   if(!cPT.getGradient().Fill(mP))
      return false;
   if(!cP.CalcHiddenGradients(cPT.AsObject()))
      return false;
   if(!SumAndNormilize(cP.getGradient(), cPT.getGradient(), cP.getGradient(), 1, false, 0, 0, 0, 0.5f))
      return false;
//---
   if(!MatMulGrad(cK.getPrevOutput(), cKT.getPrevOutput(),
                  cKT.getOutput(), cKT.getGradient(),
                  cP.getGradient(), cKT.GetCount(),
                  cKT.GetWindow(), cKT.GetCount(), 1, true))
      return false;
   if(!MatMulGrad(cK.getOutput(), cK.getPrevOutput(),
                  cR_RT.getOutput(), cR_RT.getGradient(),
                  cKT.getPrevOutput(), cKT.GetCount(),
                  cRT.GetCount(), cRT.GetCount(), 1, true))
      return false;
   if(!MatMulGrad(cIdifK_H.getPrevOutput(), cIdifK_HT.getPrevOutput(),
                  cIdifK_HT.getOutput(), cIdifK_HT.getGradient(),
                  cP.getGradient(), cIdifK_HT.GetCount(),
                  cIdifK_HT.GetWindow(), cIdifK_HT.GetCount(), 1, true))
      return false;
   if(!MatMulGrad(cIdifK_H.getOutput(), cIdifK_H.getPrevOutput(),
                  cPPred.getOutput(), cPPred.getGradient(),
                  cIdifK_HT.getPrevOutput(), cIdifK_HT.GetCount(),
                  cIdifK_HT.GetWindow(), cIdifK_HT.GetWindow(), 1, true))
      return false;
//---
   if(!cK.CalcHiddenGradients(cKT.AsObject()))
      return false;
   if(!SumAndNormilize(cK.getGradient(), cK.getPrevOutput(), cK.getGradient(), 1, false, 0, 0, 0, 1))
      return false;
得られた行列は次の処理へと渡され、カルマンフィルタブロックにおける勾配の伝播経路の起点となります。 まず、観測更新モジュールを通じて処理を進めます。
//--- Measurement update
   if(!cIdifK_H.CalcHiddenGradients(cIdifK_HT.AsObject()))
      return false;
   if(!SumAndNormilize(cIdifK_H.getGradient(), cIdifK_H.getPrevOutput(), cIdifK_H.getGradient(),
                                                                          1, false, 0, 0, 0, 1))
      return false;
   if(!IdentDifferentGrad(cK_H.getGradient(), cIdifK_H.getGradient(), cHT.GetWindow(), 0, 0, 1))
      return false;
   if(!MatMulGrad(cK.getOutput(), cK.getPrevOutput(),
                  cH.getOutput(), cH.getGradient(),
                  cK_H.getGradient(), cKT.GetCount(),
                  cKT.GetWindow(), cHT.GetWindow(), 1, true))
      return false;
//---
   if(!MatMulGrad(cDeltY.getOutput(), cDeltY.getGradient(),
                  cK.getOutput(), cK.getPrevOutput(),
                  cX.getGradient(), 1,
                  cDeltY.Neurons(), cX.Neurons(), 1, true))
      return false;
   if(!SumAndNormilize(cK.getGradient(), cK.getPrevOutput(), cK.getGradient(), 1, false, 0, 0, 0, 1))
      return false;
   if(!DifferentGrad(cKoopmanPred.getGradient(), cYPred.getGradient(), cDeltY.getGradient(),
                     1, 0, 0, 0, 1))
      return false;
   if(!MatMulGrad(cXPred.getOutput(), cXPred.getGradient(),
                  cHT.getOutput(), cHT.getGradient(),
                  cYPred.getGradient(),
                  1, cHT.GetWindow(), cHT.GetCount(), 1, true))
      return false;
   if(!SumAndNormilize(cXPred.getGradient(), cX.getGradient(), cXPred.getGradient(), 1, false, 0, 0, 0, 1))
      return false;
次に、補正ブロックでは、予測行列と誤差行列を通じて勾配を伝播させます。 これらの処理を通じて、出力から隠れ空間に至る勾配の流れを丁寧に構築します。最も重要なのは、変数間の構造的な関係を考慮している点です。
//--- Update step
   if(!MatMulGrad(cP_HT.getOutput(), cP_HT.getGradient(),
                  cSInv.getOutput(), cSInv.getGradient(),
                  cK.getGradient(), cHT.GetCount(),
                  (int)mS.Rows(), (int)mS.Cols(), 1, true))
      return false;
   if(cSInv.getGradient().GetData(mSGrad) <= 0)
      return false;
   mS = mS.Transpose();
   mS = (mS * (-1)).MatMul(mSGrad.MatMul(mS));
   if(cH_P_HT.getGradient().Fill(mS) <= 0)
      return false;
   if(!MatMulGrad(cH.getOutput(), cH.getPrevOutput(),
                  cP_HT.getOutput(), cP_HT.getPrevOutput(),
                  cH_P_HT.getGradient(), cHT.GetCount(),
                  cHT.GetWindow(), cHT.GetCount(), 1, true))
      return false;
   if(!SumAndNormilize(cH_P_HT.getGradient(), cR_RT.getGradient(),
                       cR_RT.getGradient(), int(mS.Cols()), false, 0, 0, 0, 1))
      return false;
   if(!SumAndNormilize(cH.getGradient(), cH.getPrevOutput(),
                       cH.getPrevOutput(), 1, false, 0, 0, 0, 1))
      return false;
   if(!SumAndNormilize(cP_HT.getGradient(), cP_HT.getPrevOutput(),
                       cP_HT.getGradient(), 1, false, 0, 0, 0, 1))
      return false;
   if(!MatMulGrad(cPPred.getOutput(), cPPred.getPrevOutput(),
                  cHT.getOutput(), cHT.getPrevOutput(),
                  cP_HT.getGradient(), cPPred.Neurons() / cHT.GetWindow(),
                  cHT.GetWindow(), cHT.GetCount(), 1, true))
      return false;
   if(!SumAndNormilize(cPPred.getGradient(), cPPred.getPrevOutput(),
                       cQ_QT.getGradient(), int(cQT.GetWindow()), false, 0, 0, 0, 1))
      return false;
   if(!SumAndNormilize(cHT.getGradient(), cHT.getPrevOutput(), cHT.getGradient(), 1, false, 0, 0, 0, 1))
      return false;
続いて、予測ブロック、すなわち予測ステップを処理します。
//--- Prediction step
   if(!MatMulGrad(cF_P.getOutput(), cF_P.getGradient(),
                  cFT.getOutput(), cFT.getGradient(),
                  cQ_QT.getGradient(), cFT.GetCount(),
                  cFT.GetWindow(), cFT.GetCount(), 1, true))
      return false;
   if(!MatMulGrad(cF.getOutput(), cF.getPrevOutput(),
                  cP.getOutput(), cP.getGradient(),
                  cF_P.getGradient(),
                  cFT.GetCount(), cFT.GetWindow(), cP.Neurons() / cFT.GetWindow(), 1, true))
      return false;
   if(!MatMulGrad(cAuxiliaryNet.getOutput(), cAuxiliaryNet.getGradient(),
                  cB.getOutput(), cB.getGradient(),
                  cXPred.getGradient(), 1,
                  cFT.GetWindow(), cFT.GetCount(), 1, true))
      return false;
   if(!MatMulGrad(NeuronOCL.getOutput(), NeuronOCL.getGradient(),
                  cFT.getOutput(), cFT.getPrevOutput(),
                  cXPred.getGradient(), 1,
                  cFT.GetWindow(), cFT.GetCount(), 1, true))
      return false;
   if(!SumAndNormilize(cFT.getGradient(), cFT.getPrevOutput(),
                       cFT.getGradient(), 1, false, 0, 0, 0, 1))
      return false;
//---
   if(!MatMulGrad(cR.getOutput(), cR.getPrevOutput(),
                  cRT.getOutput(), cRT.getGradient(),
                  cR_RT.getGradient(), cRT.GetCount(),
                  cRT.GetWindow(), cRT.GetCount(), 1, false))
      return false;
   if(!MatMulGrad(cQ.getOutput(), cQ.getPrevOutput(),
                  cQT.getOutput(), cQT.getGradient(),
                  cQ_QT.getGradient(), cQT.GetCount(),
                  cQT.GetWindow(), cQT.GetCount(), 1, false))
      return false;
   if(!cR.CalcHiddenGradients((CObject*)cRT.AsObject()))
      return false;
   if(!SumAndNormilize(cR.getGradient(), cR.getPrevOutput(),
                       cR.getGradient(), cRT.GetWindow(), false, 0, 0, 0, 0.01f))
      return false;
   if(!cQ.CalcHiddenGradients(cQT.AsObject()))
      return false;
   if(!SumAndNormilize(cQ.getGradient(), cQ.getPrevOutput(),
                       cQ.getGradient(), cQT.GetWindow(), false, 0, 0, 0, 0.01f))
      return false;
   if(!cH.CalcHiddenGradients(cHT.AsObject()))
      return false;
   if(!SumAndNormilize(cH.getGradient(), cH.getPrevOutput(),
                       cH.getGradient(), cHT.GetWindow(), false, 0, 0, 0, 0.01f))
      return false;
   if(!cF.CalcHiddenGradients(cFT.AsObject()))
      return false;
   if(!SumAndNormilize(cF.getGradient(), cF.getPrevOutput(),
                       cF.getGradient(), cFT.GetWindow(), false, 0, 0, 0, 0.01f))
      return false;
最後のブロックでは、クープマン空間における表現とAttentionモジュールを扱います。 ここでは、予測部分と再構成部分(KoopmanPred、KoopmanRest)へ勾配を伝播させます。
//--- Rest Attention
   if(!cKoopmanRest.CalcHiddenGradients(cAuxiliaryNet.AsObject()))
      return false;
//--- Pred / Rest
   if(!NeuronOCL.getPrevOutput().Fill(0))
      return false;
   if(!DifferentGrad(NeuronOCL.getPrevOutput(), cKoopmanRest.getPrevOutput(),
                     cKoopmanRest.getGradient(), cKoopman.GetWindow()))
      return false;
   if(!SumAndNormilize(NeuronOCL.getGradient(), NeuronOCL.getPrevOutput(),
                       NeuronOCL.getPrevOutput(), 1, false, 0, 0, 0, 1))
      return false;
   if(NeuronOCL.Activation() != None)
     {
      if(!DeActivation(NeuronOCL.getOutput(), NeuronOCL.getPrevOutput(),
                       NeuronOCL.getPrevOutput(), NeuronOCL.Activation()))
         return false;
     }
   if(!Concat(cKoopmanPred.getGradient(), cKoopmanRest.getPrevOutput(), cKoopman.getGradient(),
              cKoopman.GetWindow(), cKoopman.Neurons() - cKoopman.GetWindow(), 1))
      return false;
後者については、その差分に対する勾配を計算し、その後、両方の部分を統合して単一のクープマン構造を形成します。
最終段階では、勾配を元のデータのレベルまで伝播させます。
//--- Koopman
   if(!NeuronOCL.CalcHiddenGradients(cKoopman.AsObject()))
      return false;
   if(!SumAndNormilize(NeuronOCL.getGradient(), NeuronOCL.getPrevOutput(),
                       NeuronOCL.getGradient(), 1, false, 0, 0, 0, 1))
      return false;
//---
   return true;
  }
したがって、このメソッドは、確率的潜在成分、状態フィルタリング、予測、補正、クープマン空間における変換という、モデルのすべての主要な構成要素を網羅しながら、逆伝播の経路全体を段階的にたどります。 これにより、モデルのパラメータが適切に調整され、時系列データから効果的に学習できるようになります。
CNeuronK2VAEEncoderオブジェクトとそのすべてのメソッドの完全なソースコードは、添付ファイルに含まれています。
本日は、かなりの量の詳細な作業を終えました。記事もすでに非常に長くなっています。 ここで少し休憩を取り、内容を十分に消化してから、改めて新鮮な視点で見直すことをお勧めします。 次の記事では、今回始めた作業を完結させるため、残された項目を詳しく検討し、実際の過去データを用いて実装した手法を検証します。 これにより、理論への理解を深めるとともに、実用面での有効性も評価できます。
結論
本記事では、KoopmanNetとカルマンフィルタの機能を時系列解析のための単一システムに統合したK²VAEフレームワークにおけるEncoderのアーキテクチャと実装の主要な段階について詳しく解説しました。 このアプローチでは、従来の線形予測と、観測データに基づく柔軟で適応的な補正を組み合わせることで、金融データの複雑なダイナミクスを効果的にモデル化できます。 今回取り上げたフレームワークは、実績のある手法を最新のニューラルネットワーク技術とシームレスに統合できることを示しており、金融市場の分析と予測に新たな可能性をもたらします。
次の記事では、実際の過去データを用いてモデルを実践的に検証し、実際の取引環境における有効性と可能性を客観的に評価していきます。
参考文献
- K²VAE: A Koopman-Kalman Enhanced Variational Autoencoder for Probabilistic Time Series Forecasting
- 本連載の他の記事
本記事で使用したプログラム
| # | 名前 | 種類 | 説明 |
|---|---|---|---|
| 1 | Study.mq5 | EA | モデルのオフライン学習用EA |
| 2 | StudyOnline.mq5 | EA | モデルのオンライン学習用EA |
| 3 | Test.mq5 | EA | モデルテスト用EA |
| 4 | Trajectory.mqh | クラスライブラリ | システム状態とモデルアーキテクチャを記述するための構造体 |
| 5 | NeuroNet.mqh | クラスライブラリ | ニューラルネットワークを構築するためのクラスライブラリ |
| 6 | NeuroNet.cl | ライブラリ | OpenCLプログラム用のコードライブラリ |
MetaQuotes Ltdによってロシア語から翻訳されました。
元の記事: https://www.mql5.com/ru/articles/18766
警告: これらの資料についてのすべての権利はMetaQuotes Ltd.が保有しています。これらの資料の全部または一部の複製や再プリントは禁じられています。
この記事はサイトのユーザーによって執筆されたものであり、著者の個人的な見解を反映しています。MetaQuotes Ltdは、提示された情報の正確性や、記載されているソリューション、戦略、または推奨事項の使用によって生じたいかなる結果についても責任を負いません。

 取引におけるニューラルネットワーク:確率的時系列予測(最終回)
 取引におけるニューラルネットワーク:確率的時系列予測(K2VAE)
 取引におけるニューラルネットワーク:多変量時系列予測のためのエンドツーエンドモデル(GinAR)
 取引におけるニューラルネットワーク:適応的周期セグメンテーション(最終回)

- 無料取引アプリ
- 8千を超えるシグナルをコピー
- 金融ニュースで金融マーケットを探索