

取引におけるニューラルネットワーク:確率的時系列予測(K2VAE)
 19
 0

はじめに
近年、時系列分析は大きなブレークスルーを遂げました。 異常検出、分類、欠損値の補完は、以前よりも正確かつ迅速におこなわれるようになりました。 しかし、金融市場においては、確率的予測がはるかに重要です。それは単に資産価格を予測することではなく、起こりうるシナリオの範囲を評価することです。 こうした評価は、トレーダーやアナリストが柔軟な戦略を策定し、リスクを管理し、十分な情報に基づいて意思決定をおこなううえで役立ちます。
従来のモデルは、短期予測をおこなううえで非常に優れています。 しかし、もう少し先まで予測しようとすると、誤差が蓄積し始め、ボラティリティによって不正確さが増幅され、計算コストが急増します。 これは特に金融市場に当てはまります。企業の決算発表であれ、地政学的な予期せぬ出来事であれ、あらゆるイベントが非線形性をもたらし、状況のルールを変えてしまうためです。
この種の問題を解決するためのアプローチの1つとして、論文「K²VAE: A Koopman-Kalman Enhanced Variational AutoEncoder for Probabilistic Time Series Forecasting」では、2つの基本的な考え方に基づく新しいフレームワークが提案されました。第一に、クープマン理論は非線形プロセスを線形形式に変換します。 株価チャートを特別なレンズ越しに見ることで、複雑な動きが直線として見えるようになる様子を想像してみてください。このアプローチによって、ダイナミクスを理解しやすくなります。 第二に、従来のカルマンフィルタは、新たなデータを注意深く処理し、新しい情報が得られるたびに予測を調整します。その情報には、決算発表、金利の変動、予期せぬイベントなどが含まれます。
論文の著者らは、これら2つの考え方をK²VAEフレームワークに統合しました。これは、変分オートエンコーダ(Variational AutoEncoder, VAE)に基づく軽量かつ高速なシステムです。 まず、KoopmanNetが過去の価格データや指標に線形構造を課します。 次に、カルマンフィルタの手法に基づくKalmanNetが、起こりうる値動きの推定値とその不確実性を段階的に精緻化します。 このアーキテクチャにより、高い精度と安定性を維持しながら、短期と長期の両方の予測が可能になります。
K²VAEフレームワークの主な利点は次のとおりです。
- モデルの透明性: 線形コンポーネントによって、トレーダーが解釈可能なシグナルが得られ、ブラックボックスではありません。
- 予測の柔軟性: 通貨ペア、指数、コモディティなど、さまざまな資産についてのシナリオを迅速に生成できます。
- リスク管理: 信頼区間を適応的に調整することで、大きな損失のリスクを適時に低減できます。
その結果、K²VAEは短期予測と長期予測の両方に対応する汎用的なソリューションとなります。単一のシナリオにとどまらず、起こりうる市場変動の全範囲を即座に評価できるため、ポートフォリオ管理の有効性と自動取引戦略の信頼性が大幅に向上します。 つまり、点予測だけでなく、潜在的なリスクと機会を含む全体像を把握できるのです。
K²VAEアルゴリズム
金融市場のダイナミクスを分析する際、価格変動、ボラティリティの急上昇、ニュース報道の影響など、一見するとカオスのように見える現象にしばしば遭遇します。クープマン理論は、こうした現象を内側から捉える視点を提供します。つまり、非線形性を直接制御しようとするのではなく、システムを特殊な観測可能空間へと変換するのです。 ここでは、各状態ベクトル xₖ(たとえば、複数の気配値や経済指標の集合など)が、関数ψによって観測量へと変換され、その時間発展が線形作用素𝒦によって記述されます。 簡単に言えば、複雑な価格チャートを線形化し、直線に沿って表現できるようにすることで、時系列の根底にあるダイナミクスを分析・予測しやすくします。 このアプローチにより、長期的なトレンドと短期的なノイズを区別しやすくなります。
しかし、線形表現を用いても、不確実性がなくなるわけではありません。価格は刻々と変動し、新たな経済指標が発表され、中央銀行は金利を調整します。 ここで活躍するのがカルマンフィルタです。 このアルゴリズムは、シンプルながら強力な「予測–補正」の原理に基づいて動作します。まず、システムの現在の状態を予測し、その予測に対する信頼度を共分散行列Pₖによって推定します。次に、実際の観測値(価格、取引高、マクロ経済指標など)を受け取ると、カルマンゲインKₖを計算します。 これを用いて、実際の状況を反映するよう初期予測を調整し、不確実性の推定値を更新します。 トレーダーにとって、これは新たなデータを用いてモデルの状態をオンラインで更新することに相当します。企業レポート、流動性の変化、突発的な地政学的イベントなどが予測に即座に反映され、実際の市場の動きに対するモデルの遅れが最小限に抑えられます。
システムの線形ロールアウトと適応的なフィルタリングを組み合わせることで、確率的予測のための堅牢な基盤が得られます。 しかし、予測を単一のシナリオに限定しないために、VAEの力を活用します。VAEは、この問題を条件付き生成の問題へと変換します。入力は履歴データX(N個の資産について、直近T個の観測値)であり、出力は将来値の単一ベクトルではなく、考えられる軌道の分布Yです。 重要なのは潜在変数Zです。これは、相関、サイクル、予期せぬショックなど、隠れた市場要因を表します。 最適化には、対数尤度の下限が用いられます。 第1の項は生成の品質が低い場合にモデルへペナルティを課し、第2の項は潜在分布が事前の期待から大きく離れ、極端な領域へと逸脱した場合にペナルティを課します。
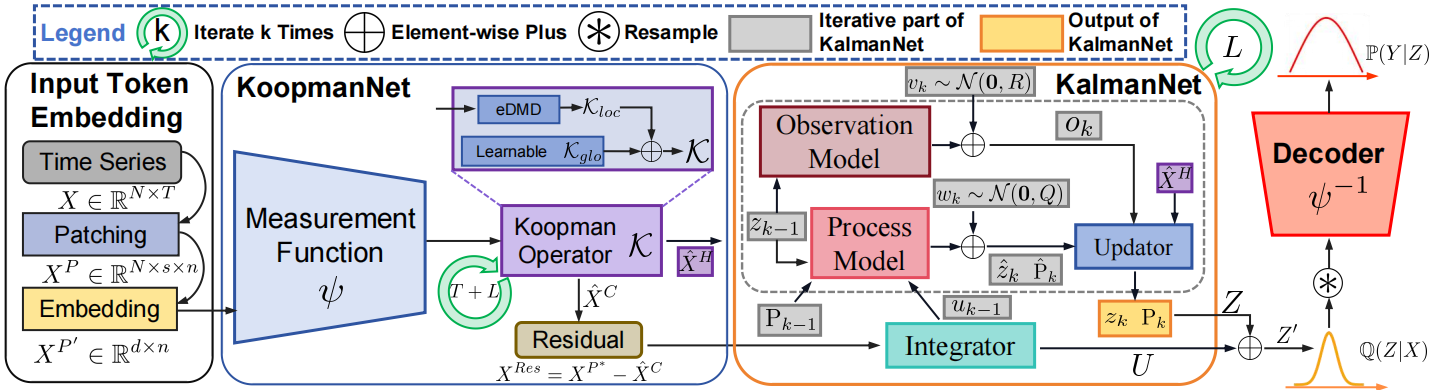
K²VAEフレームワークでは、これら3つの構成要素(KoopmanNet、KalmanNet、VAE)は単に共存するのではなく、互いをシームレスに補完します。 全体として、K²VAEアーキテクチャは明確な多段階パイプラインに従っており、各コンポーネントが、分析対象のデータを解釈可能な力学モデルへと変換する過程の一段階を担います。
まず、Input Token Embedding(入力トークン埋め込み)モジュールが元の時系列をトークン、すなわち価格履歴や流動性指標の小さな断片に分割します。 この手法は、アナリストが価格チャートを主要なサポートラインやレジスタンスラインを含む区間に分割する方法に似ています。これにより、データにより明確な意味を持たせます。
次に、KoopmanNetがこれらのトークンを、いわゆる観測可能空間へ写像します。 この空間では、資産間の相関や短期的なボラティリティの急上昇といった時系列の複雑な非線形挙動が、単純な線形成分へと分解されます。 学習を通じて、最初のトークンから作用素を繰り返し適用することで、システムの発展をモデル化する線形クープマン作用素を特定します。 もちろん、システムを完全に線形化できる理想的な観測可能空間は存在しません。そのため、予測にはバイアスが残ります。
続いて、KalmanNetが登場します。 カルマンフィルタと同様に、線形予測を受け取り、新たな観測値を用いて状態を更新し、多次元状態の共分散を精緻化します。これにより、明確な意味を持つ変分事後分布Q(Z|X)が形成されます。 これは金融分野において極めて重要です。基準となる価格軌道を構築するだけでなく、突然のギャップから、重大なニュースに反応した相場の反転まで、その軌道から起こりうる逸脱の範囲も即座に評価できるからです。
最後に、Decoderが観測可能写像の逆変換(ψ⁻¹)をおこない、潜在空間から得られたサンプルを、なじみのある時系列形式へと戻します。 また、予測対象期間にわたる最終分布P(Y|Z,X)のモデル化も担います。 こうして、すぐに利用できる将来の価格シナリオが得られます。それは単一のシナリオではなく、それぞれが独自のリスク評価と信頼度推定を伴う、複数の確率的な軌道です。
最終的に、K²VAEは生の金融データを、適応的な不確実性の精緻化と、起こりうる市場変動の全範囲を生成する機能を備えた、一貫性のある線形力学モデルへと変換します。 これは、ポートフォリオ計画、リスク評価、信頼性の高いアルゴリズム取引戦略の構築に役立つ強力なツールです。
時系列をパッチに分割することは、単なる技術的な工夫ではありません。 金融分析においては、個々のティック相場から5分足や30分足のローソク足へ移行することに似ています。これにより、トレンドやボラティリティの重要な急変をすぐに把握できるようになります。 K²VAEフレームワークのデータ前処理も同様の考え方に基づいていますが、各チャネルを個別に処理する従来のチャネル独立型アーキテクチャの枠を超えています。 その代わりに、フレームワークの開発者らは、さまざまな資産の価格、取引高、テクニカル指標など、すべての変数を1つのパッチにまとめています。これにより、モデルはそれらの間の相互作用を自然に考慮できるようになります。
まず、コンテキスト時系列X(N個の変数についてT時点分のデータを含む行列)を、長さsの等長で重複しない区間に分割します。 各パッチには、N個すべての指標についてs時点分のデータが同時に含まれており、その期間における市場状況のスナップショットを提供します。 次に、各断片を次元N·sのベクトルに平坦化し、線形射影に通すことで、情報を次元dのコンパクトな埋め込み表現へと圧縮します。 この処理により、モデルは各パッチの内部構造を学習するだけでなく、変数間の重要な組み合わせも自動的に特定できるようになります。たとえば、テクノロジーセクターの銘柄と半導体銘柄の相関や、異なる市場セグメント間で同期して発生する取引高の急増などです。
ばらばらのチャネルから多次元トークンへの、このほとんど爆発的ともいえる移行には、いくつもの利点があります。 第一に、ボラティリティや価格トレンドが複数の資産に同時に影響するとき、モデルはこうしたクラスター状の現象を即座に検出できます。 第二に、単一のパッチ内に含まれる局所的なノイズやランダムな揺らぎが平滑化され、誤ったシグナルが大幅に減少します。 第三に、より多くの変数をまとめて扱うことで、各トークン内の隠れたサイクルや長期的なパターンが明確になります。従来の手法では、チャネルを個別に処理するために見落とされたり、歪められたりしていた可能性のあるパターンです。
したがって、K²VAEが入力として受け取るのは、個々の特徴量の集合ではなく、各長さsの区間について、市場環境を包括的に捉えた分析可能なスナップショットです。 これが、後続の処理段階の出発点となります。
実際の金融時系列では、非線形性が複数の形で同時に現れます。価格サイクルの位相が互いにずれたり、重要なレポートの発表によって統計的特性が変化したり、突発的なニュースによって既存のパターンが崩れたりします。 こうした複雑さを制御するため、K²VAEフレームワークの著者らは、いわば「クープマンレンズ」を通してデータを捉えます。つまり、カオス的な振動の領域にあるトークンを、その時間発展が単純な線形過程となる空間へ写像するのです。
具体的には、 まず各パッチX′ᴾの平滑化された埋め込みベクトルを、小規模ながら強力なMLPに通します。このMLPは観測可能関数ψとして機能します。 簡単に言えば、価格と指標の間にある複雑な相互関係を凝縮し、根底にあるダイナミクスをより明確に捉えられる新たなベクトルxᴾᵢ*へと変換します。
こうしたベクトルをすべて集めると、行列X*ᴾが得られます。その各行は、単一のパッチを線形的に解釈可能な形で射影したものです。 しかし、行列を得るだけでは十分ではありません。 システムが段階ごとにどのように発展するかを理解するために、eDMD(拡張動的モード分解)法を用います。これにより、X*ᴾから前後の状態のペアを取り出し、それらの間の差を最小化する作用素 𝒦locを計算します。 この作用素は、𝒦locをX*ᴾの第1列に適用すると第2列を可能な限り正確に再現し、同じ処理を時系列の末尾まで続けられるように学習されます。 この手法によって、局所的な状態遷移の規則を段階的に導き出すことができます。
局所レベルから大域レベルへと進むため、2つ目の学習可能なコンポーネント𝒦gloを追加します。 これらを組み合わせると、完全なクープマン作用素 𝒦 = 𝒦loc + 𝒦gloが得られます。 これにより、過去のパッチを再構成できるだけでなく、最初の射影x₁ᴾ*に𝒦ⁿ、𝒦ⁿ⁺¹などを適用することで、将来の状態も高い信頼度で予測できるようになります。 この場合、観測可能空間におけるm = L/s個のパッチは、元の時系列におけるLステップにそれぞれ対応します。
その結果、株価、取引高、テクニカル指標の間にある複雑な相互作用でさえも線形化されます。K²VAEは、数分先から数か月先まで、さまざまな予測期間について迅速かつ正確に予測を生成できます。 同時に、モデルの透明性も保たれます。局所的な状態遷移の規則とグローバルなトレンドの両方を把握できるうえ、線形構造によって、トレーダーやリスク管理担当者は特定のシナリオが生じる要因を理解できます。
KoopmanNetが主要なトレンドを線形化し、コンテキスト系列を再構成した後も、残差誤差がわずかに残ります。これは、パッチの実際の射影と線形近似との差です。 K²VAEフレームワークの著者らは、こうした残差を無視しません。むしろ、それらを1つの残差情報ストリームにまとめ、線形モデルがどこで、どの程度、実際の挙動を捉えきれなかったのかを明らかにします。
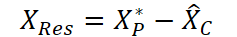
この行列ベースの残差記録は、突発的なギャップ、急激な取引高のスパイク、クープマン作用素にまだ反映されていないニュースショックなど、さまざまな予期せぬ現象を捉えます。
次に、軽量なTransformerインテグレータが、助言者の役割を担います。蓄積された非線形性をすべて分析し、それを一連の制御入力U = [u₁, …, uₘ]に変換します。 各ベクトルuₖは、ステップkにおいて予測をどの方向へ調整すべきかを示すシグナルとして機能します。 Transformerは異なる時点間の関係を考慮できるため、モデルは誤差情報を再配分し、最も効果的な方法で誤差を補正することを学習します。
制御入力が得られたら、古典的なプロセスモデルを構築します。
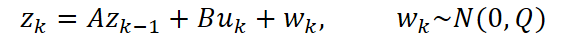
ここで、Aは基本的な段階ごとの状態遷移を、Bは制御入力の影響を表します。また、wₖは予測不可能な市場要因を反映するランダムノイズを加えます。 モデルが可能な限り正確な状態から予測を開始できるよう、初期状態z₀には直近の実測パッチを用います。
次に、観測モデルを通して、得られた予測を検証します。

ここで、Hは内部状態を予測形式へ写像し、vₖはモデルの線形部分に内在する不正確さを反映する測定ノイズを加えます。 予測対象期間について、KoopmanNetが以前に生成した予測を主要な観測値として扱います。
従来の「予測–補正」サイクルにより、KalmanNetは線形予測と誤差情報のバランスを動的に調整できます。 まず、予備的な予測状態ẑₖと、モデルの信頼度を定量化する共分散行列P̂ₖを求めます。
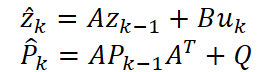
次に、その予測を観測値と比較してカルマンゲインKₖを算出します。 その後、状態と共分散を補正します。
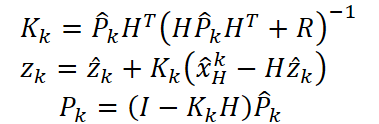
このように、モデルは予測を精緻化するだけでなく、各段階で市場の状態をどの程度捉えられているか、また、どの部分について追加の確認が必要なのかを明確に示します。
蓄積された誤差情報を失わないよう、フレームワークの著者らは、スキップ接続を介して最終状態を制御入力に結び付けています。
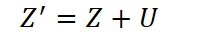
これにより、KoopmanNetとKalmanNetが市場の細かな特徴を十分に学習するまで、モデルは利用可能な情報をすべて活用できます。 学習が進むにつれて、Uの大きさはゼロに近づきます。これは、線形ダイナミクスが次第に自律的になることを意味します。
その結果、K²VAEフレームワークは、単なる価格予測ではなく、価格そのものと、それに対する信頼度という2つの関連する推定値を生成します。 トレーダーやリスク管理担当者にとって、これは非常に価値の高い2つの要素からなるシグナルです。予測は取引計画の立案に役立ち、共分散はどこで慎重になるべきか、どこでリスクを取る価値があるかを示します。 このアプローチにより、アルゴリズム取引は、点予測を盲目的に追い求めるものから、十分に検討されたリスク管理戦略へと変わります。
最後に、確率的予測を生成する最終段階に進みます。 この時点で、すでに2つの重要な結果が得られています。すなわち、調整後の潜在状態Z′と、予測の各段階における信頼度を表す共分散行列Pです。 これらを組み合わせることで、将来シナリオのランダムサンプルを抽出するための変分分布が定義されます。
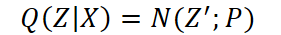
ランダムサンプリングを通じて勾配を伝播させるため、フレームワークの著者らは、よく知られた再パラメータ化トリックを用います。 ZをN(Z′, P) から直接サンプリングする代わりに、標準正規ノイズ ϵ∈N(0,1)を生成し、次のように構成します。
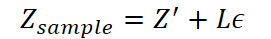
ここで、Lは分解 P = LLᵀ から得られる下三角行列です。 この方法では処理全体が微分可能になるため、損失関数からKalmanNetとKoopmanNetの両方のパラメータへ、勾配を伝播させることができます。
次に、K²VAEの著者らは、Decoderを用いて、得られた潜在ベクトル Zsample をなじみのある時系列形式へと戻します。このDecoderは、元のKoopman-Encoder ψに対応する2つの対称的なMLPで構成されます。 最初のMLP(ψ⁻¹μと表記)は平均ベクトルμを予測し、2番目のMLP(ψ⁻¹σ)は標準偏差ベクトルσを予測します。
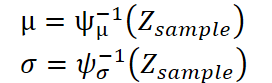
その結果、生成された各サンプルから、将来値のベクトルと、そのばらつきの推定値が得られます。つまり、最も可能性の高い軌道だけでなく、信頼区間の境界もすぐに把握できます。
逆変換の品質をさらに高めるため、フレームワークの著者らは、再構成された系列X̂Cもψ⁻¹μに入力します。
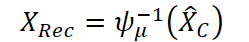
これによりXRecを求め、再構成誤差LRecの計算に使用します。 この処理によって、観測可能関数ψは真に線形なシステムを構築するよう促され、Decoderはデータを価格や指標の元の空間へ正確に写像できるようになります。
最後に、すべての要素を統合し、予測分布を決定します。
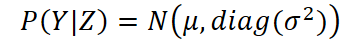
各サンプルについて、Decoderはベクトルμとベクトルσを出力します。これらを用いて、中央値、信頼区間、極端なシナリオを含む、完全な確率的予測を構築します。
実際には、これによりトレーダーやリスク管理担当者は、起こりうる市場変動の全体像をすぐに把握できます。そこには、狭いレンジ内での穏やかな推移から、ボラティリティの高まりを伴う激しい急騰まで、さまざまなシナリオが含まれます。 再パラメータ化と、すべてのコンポーネント(KoopmanNet、KalmanNet、Decoder)の同期学習により、K²VAEは滑らかで微分可能な処理パイプラインを実現します。その各反復において、平均予測の精度だけでなく、リスク推定の信頼性も向上します。
K²VAEの学習の中核には、相互に補完し合う2つの損失関数があります。これらが組み合わさることで、モデルを自己改善させる強力な仕組みが形成されます。 1つ目は、古典的なELBO (Evidence Lower Bound)目的関数です。ここでモデルは、生成された軌道Yが期待される分布に従うようにすることと、潜在空間Zが事前の仮定から大きく逸脱しないようにすることを同時に目指します。
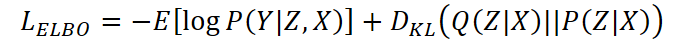
第1項は、将来シナリオの生成品質が低い場合に課されるペナルティです。潜在変数Zのサンプルから、DecoderがYの分布を再現する性能が低いほど、ペナルティは大きくなります。 第2項は、変分事後分布 Q(Z|X) と、単純な標準正規事前分布P(Z|X)=N(0,I) との間のKLダイバージェンスです。 これにより、潜在空間が妥当な範囲を超えて逸脱することを防ぎ、観測可能空間の線形システムが安定する状態へと、潜在空間を滑らかに収束させます。
しかし、ELBOだけでは、観測可能空間が実際に線形に振る舞うことまでは保証されません。 そこで登場するのが、もう1つの重要な要素である再構成誤差です。
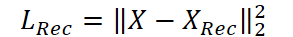
フレームワークの著者らは、元の系列Xと、その再構成系列 XRec を比較します。XRecは、再構成されたクープマン出力系列をDecoderに通して得られるものです。 モデルがデータを元の空間へ正確に写像できるほど、観測可能層における線形ダイナミクスも、より正確かつ明瞭に構築されます。 この損失関数は、モデルの基盤を支える補強材のように働き、観測可能関数ψが線形性から逸脱するのを防ぎます。
最終的に、全体の学習目的関数は、この2つの項を足し合わせたものとなります。
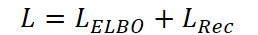
ELBOは、適切なデータ生成と、整った潜在空間の形成を担います。一方、再構成誤差は、線形近似の厳密さと逆変換の品質を確保します。 この2つを組み合わせることで、K²VAEは妥当な市場シナリオの生成を学習するだけでなく、理解しやすく解釈可能な線形力学構造を形成するよう促されます。その構造は、ボラティリティの急上昇や予期せぬ市場の急変にも耐えられるものです。 これにより、トレーダーやリスク管理担当者は、単なる予測にとどまらない、包括的で透明性が高く、信頼できる意思決定ツールを得られます。
以下に、K²VAEフレームワークの著者らによる構成図を示します。
MQL5による実装
ここまで、KoopmanNetのダイナミクスの線形化から、KalmanNetによる適応的な不確実性の精緻化、そして最終段のVAEDecoderに至るまで、K²VAEフレームワークの主要な構成要素を詳しく検討してきました。いよいよ、理論を実践に移す段階です。 実践編では、ソースデータの準備やパッチの生成から、モデルパラメータの学習、最終結果の生成に至るまで、これらの各モジュールをMQL5環境内で直接実装する方法を体系的に解説します。 この実践ガイドを通じて、提案されたアーキテクチャの柔軟性と透明性を損なうことなく、K²VAEを自身のアルゴリズム取引戦略に段階的に実装できるようになります。
お気づきかもしれませんが、K²VAEの中核は、いくつかの重要な行列、すなわちクープマン作用素、KalmanNetの遷移行列と制御行列、そしてEncoderとDecoderの重み射影を中心に構成されています。 また、標準的なニューラルネットワークで一般的な畳み込み → 活性化 → 畳み込みという階層構造とは異なり、ここでは同じパラメータがパイプラインの複数の段階で同時に使用されます。 この考え方をそのまま実装しようとすると、各ステップに個別のMLP層を宣言する必要があり、その結果、重みが重複してしまいます。これは実行速度を低下させ、コードを複雑にするだけでなく、単一の線形作用素という概念も損なってしまいます。
したがって、共有パラメータという概念を維持しながら、それらを既存の学習メカニズムに統合できる別の方法を見つける必要があります。 ここで、標準的なニューラルネットワーク層の階層構造の外側に学習可能な行列を配置する必要があった際、ほかのプロジェクトでもすでに使用してきた、昔ながらの実績ある手法を思い出す価値があります。
その方法は、学習可能な行列を2層のMLP(多層パーセプトロン)として実装することです。 第1層は単一の固定値である1.0を出力し、第2層はその値を必要なパラメータ行列全体へと展開します。 この巧妙な設計により、標準的な構造の外側にあるパラメータに対しても、標準的な誤差逆伝播と重み更新の仕組みを利用できます。
言い換えれば、ここでは入力データを処理するのではなく、単にパラメータ行列を生成することを目的とした疑似層を作成しています。 一見すると計算上は役に立たないように見えますが、このレイヤーを通じて勾配が伝播し、第2層が学習されます。そして、これによって行列A、B、K、H、あるいは、たとえばψを得ることができます。
このアプローチの利点は、ニューラルネットワークの一般的な学習フレームワークとの互換性を維持できることです。 独立した最適化メカニズムを構築したり、重みを手動で更新したりする必要はありません。 すべてが標準的な仕組みに従って動作します。すなわち、順伝播 → 誤差 → 勾配伝播 → パラメータ更新です。
このように、クープマン作用素やKalmanNetの共分散行列といった特殊な要素であっても、学習機能を完全にサポートした状態でアーキテクチャに組み込むことができます。
問題で必要となるパラメータ化された行列が1つだけであれば、単一のオブジェクト内に小規模なMLPを実装する方法で十分です。 内部層をいくつか追加し、入力に定数を与えるだけで、出力として目的の行列を得ることができ、それを計算に利用できます。 シンプルで分かりやすく、追加のアーキテクチャも必要ありません。
しかし、KoopmanNetやKalmanNetのアルゴリズムでは事情が異なります。ここでは、このような行列が数多く必要になります。 それぞれを個別に実装すると、アーキテクチャが煩雑になり、コードの可読性が損なわれるおそれがあります。
そこで、より汎用性と拡張性に優れた解決策を採用しました。学習可能な行列を生成するロジックを、CParamsと呼ぶ独立したクラスに移したのです。 このクラスは、重みの初期化、保存、更新に関するすべての処理を担い、必要なタイミングで目的の行列を返します。 これにより、次のことが可能になります。
- パラメータを一元管理する
- 新しい行列を追加する際に、アーキテクチャを容易に拡張する
- 統一された生成インターフェースを使用する
- デバッグと可視化を簡素化する
新しいオブジェクトの構造を以下に示します。このクラスには、あらゆるニューラルネットワークアーキテクチャに統合できる、最小限でありながら機能的に完結したフレームワークが実装されています。
class CParams  :  public   CNeuronBaseOCL
  {
protected:
   CNeuronBaseOCL    cOne;
   //---
   virtual bool      feedForward(CNeuronBaseOCL *NeuronOCL) override
                        { return FeedForward(); }
   virtual bool      updateInputWeights(CNeuronBaseOCL *NeuronOCL) override
                        { return UpdateInputWeights(); }
   virtual bool      calcInputGradients(CNeuronBaseOCL *NeuronOCL) override  { return true; }
   virtual bool      calcHiddenGradients(CNeuronBaseOCL *NeuronOCL) override { return true; }

public:
                     CParams(void) {};
                    ~CParams(void) {};
   //---
   virtual bool      Init(uint numOutputs, uint myIndex, COpenCLMy *open_cl, uint numNeurons,
                          ENUM_OPTIMIZATION optimization_type, uint batch) override;
   virtual bool      Identity(const int rows, const int cols);
   //---
   virtual bool      FeedForward(void);
   virtual bool      UpdateInputWeights(void);
   //---
   virtual bool      Save(const int file_handle) override;
   virtual bool      Load(const int file_handle) override;
   //---
   virtual int       Type(void) override const  {  return defParams; }
   virtual void      SetOpenCL(COpenCLMy *obj) override;
   //---
   virtual bool      WeightsUpdate(CNeuronBaseOCL *source, float tau) override;
  };
この実装の重要な特徴は、1で埋められたダミー入力cOneを使用し、これを学習可能な層に渡すことです。 これにより、出力として生成される行列が、必要なパラメータを保持する唯一のオブジェクトとなり、そのまま直接利用できるようになります。
内部的には、CParamsは基底ニューラル層CNeuronBaseOCLを継承しているため、フレームワークのほかの部分と完全な互換性を備えています。 中核となる動作ロジックは、FeedForwardメソッドとUpdateInputWeightsメソッドに実装されており、入力としてcOneを使用して、同名の継承メソッドを呼び出します。
このオブジェクトは、Initメソッドを呼び出して初期化します。このメソッドによって必要なインターフェースが作成され、各コンポーネント間の接続が設定されます。
bool CParams::Init(uint numOutputs, uint myIndex, COpenCLMy *open_cl, uint numNeurons,
                                      ENUM_OPTIMIZATION optimization_type, uint batch)
  {
   if(!CNeuronBaseOCL::Init(numOutputs, myIndex, open_cl, numNeurons, optimization_type, batch))
      return false;
   if(!cOne.Init(numNeurons, 0, OpenCL, 1, optimization, iBatch))
      return false;
   cOne.SetActivationFunction(None);
   if(!cOne.getOutput().Fill(1))
      return false;
//---
   return true;
  }
慎重に実装することで、OpenCLコンテキスト内で順伝播と逆伝播、パラメータの最適化、バッファの管理をサポートするために必要な複雑な処理をすべて隠蔽できます。その結果、ユーザーは行列の形状と用途を宣言的に指定するだけで済みます。
最終的に得られるのは、複雑な計算グラフにも適した、汎用性、拡張性、再利用性に優れた学習可能パラメータのブロックです。 言い換えれば、OpenCLをサポートするMQL5環境内で、PyTorchのnn.Parameterに相当する柔軟な仕組みを実現できます。
ここで、重要な点を1つ指摘しておきます。CParamsオブジェクトの順伝播処理(FeedForward)は、学習時にのみ実行されます。 これは理にかなっています。重み行列をモデルの誤差に応じて適応させ、誤差逆伝播に基づいて調整する必要があるのは、まさにこのタイミングだからです。
bool CParams::FeedForward(void)
  {
   if(!bTrain)
      return true;
//---
   return CNeuronBaseOCL::feedForward(cOne.AsObject());
  }
ただし、本番モード、すなわち学習済みモデルを予測や意思決定に使用する場合には、行列を再計算する必要はありません。 学習によって生成された行列は静的パラメータとなり、それ以降は変化しないため、追加の演算は不要です。特に、リソースを大量に消費するOpenCLカーネルの呼び出しも必要ありません。
したがって、本番モードに切り替える際には、パラメータを固定し順伝播を無効化することで、システムを不要な計算から解放できます。 これにより、計算リソースへの負荷が軽減され、モデルの動作が高速化し、安定性も向上します。
このアプローチは、計算フェーズの分離の典型例です。学習とデプロイメントを、ロジックと処理負荷の両面で明確に区別します。 これにより、アーキテクチャの理解と変更が容易になるだけでなく、運用時の挙動も予測しやすくなります。これは、リアルタイムシステムにおいて特に重要です。
CParamsオブジェクトと、そのすべてのメソッドの完全なコードは、添付ファイルに含まれています。
ここまで、私たちは膨大な作業を進めてきました。K²VAEフレームワークの理論的基礎を探り、主要なモジュールを詳しく検討し、さらに、モデルのアーキテクチャに欠かせない、パラメータ化された行列を生成する汎用オブジェクトであるCParamsの実装まで行いました。 ここからは、さらに大きな課題に取り組みます。フレームワーク全体を通じて明確かつ一貫したロジックを確立し、あらゆる細部が、円滑に機能する仕組みの不可欠な要素となるようにすることです。
とはいえ、ここで急ぐ必要はありません。 このようなシステムを構築するには、冷静な思考、細やかな注意、そして新鮮な視点が必要です。 だからこそ、次の記事までは少し休憩を取り、新たな活力とインスピレーションを得てから、再び取り組むことにします。
結論
本記事では、線形ダイナミクス、変分推論、適応フィルタリングの利点を組み合わせた、強力で有望なフレームワークであるK²VAEを取り上げました。 その最大の強みは、潜在空間における観測可能空間において複雑な非線形プロセスを線形近似しながら、ノイズや系統的な偏差に対する頑健性を維持できることです。 これにより、単なるモデルにとどまらず、高い解釈性、柔軟性、精度を備えたツールが実現します。これは、時系列分析や市場ダイナミクスの予測において、特に重要な特性です。
私たちは、K²VAEフレームワークの基盤となる複雑なアイデアを解き明かし始めたばかりです。 本記事では、理論的基礎から、パラメータ行列や、標準的なニューラルネットワークのアーキテクチャの外側ですべての重みを管理する汎用CParamsクラスといった主要コンポーネントの実装に至るまで、最初の一歩を踏み出しました。 これは、モデル全体のロジックを構築するための重要な準備ステップとなりました。
しかし、まだ多くの作業が残されています。 個別の要素を、単一の一貫したシステムへと統合する必要があります。具体的には、フィルタリング機構を実装し、潜在空間における確率的ダイナミクスを構成し、Encoder、Integrator、KalmanNet、Decoderから成るアーキテクチャを一つにまとめなければなりません。 これは決して簡単な作業ではありませんが、こうした取り組みこそが、モデルを真に知的な意思決定システムへと進化させるのです。
ここで作業を締めくくるわけではありません。今回は、これから進む道筋を示したにすぎません。 主要な展開はまだこれからです。 次のパートでも新たな活力をもって取り組みを続けられるよう、ここで少し休憩を取ることにしましょう。
参考文献
- K²VAE: A Koopman-Kalman Enhanced Variational AutoEncoder for Probabilistic Time Series Forecasting
- 本連載の他の記事
本記事で使用したプログラム
| # | 名前 | 種類 | 説明 |
|---|---|---|---|
| 1 | Study.mq5 | EA | モデルのオフライン学習用EA |
| 2 | StudyOnline.mq5 | EA | モデルのオンライン学習用EA |
| 3 | Test.mq5 | EA | モデルテスト用EA |
| 4 | Trajectory.mqh | クラスライブラリ | システム状態とモデルアーキテクチャを記述するための構造体 |
| 5 | NeuroNet.mqh | クラスライブラリ | ニューラルネットワークを作成するためのクラスライブラリ |
| 6 | NeuroNet.cl | ライブラリ | OpenCLプログラム用のコードライブラリ |
MetaQuotes Ltdによってロシア語から翻訳されました。
元の記事: https://www.mql5.com/ru/articles/18734
警告: これらの資料についてのすべての権利はMetaQuotes Ltd.が保有しています。これらの資料の全部または一部の複製や再プリントは禁じられています。
この記事はサイトのユーザーによって執筆されたものであり、著者の個人的な見解を反映しています。MetaQuotes Ltdは、提示された情報の正確性や、記載されているソリューション、戦略、または推奨事項の使用によって生じたいかなる結果についても責任を負いません。


 取引におけるニューラルネットワーク:適応的周期セグメンテーション(最終回)
 エラー 146 (「トレードコンテキスト ビジー」) と、その対処方法
 取引におけるニューラルネットワーク:適応的周期セグメンテーション(LightGTS)

- 無料取引アプリ
- 8千を超えるシグナルをコピー
- 金融ニュースで金融マーケットを探索