

取引におけるニューラルネットワーク:インテリジェントな予測パイプライン(Time-MoE)
 12
 0

はじめに
時系列予測は、現代のアルゴリズム取引を支える重要なタスクの一つです。 モデルの予測精度は、取引戦略の成否を左右するだけでなく、絶えず変化する市場環境に適応できるかどうかにも影響します。 従来のモデルの多くは特定のタスク向けに設計されており、市場環境がわずかに変化しただけでも、その頑健性が損なわれることがありました。 近年では、いわゆる基盤モデルが急速に発展しています。 その一例が、論文「Time-MoE: Billion-Scale Time Series Foundation Models with Mixture of Experts」で発表されたモデルです。
Time-MoEは、時系列データ向けに特化して設計された、次世代のDecoder-Only型Transformerです。 スパース学習、モジュール性、マルチスケール予測という原則に基づいています。 開発者らは、計算効率を損なうことなく、大規模モデルのスケーラビリティと柔軟性を時系列予測の分野にも拡張できることを示しています。 提示されたモデルアーキテクチャは、解析対象の系列長や予測期間を任意に設定できるよう設計されています。 また、データストリームをリアルタイムで処理することも可能です。
このアーキテクチャの最初の構成要素は、時系列の点単位トークン化(Point-Wise Tokenization)です。 ウィンドウ単位で処理する方式や、データを集約する方式とは異なり、各時点を個別のトークンに変換します。 この特徴は、わずか1ティックの変化でも市場の状況が変わり得る高頻度取引において、有用となる可能性があります。 MQL5環境では、バーやティックに加え、ボラティリティ、出来高、独自の取引戦略から得られるシグナルなどの派生指標を用いてトークンを構成できます。
トークン化されたデータは、次にSwiGLUを用いた埋め込み層に入力されます。SwiGLUは、Swishとゲート付き線形ユニットを組み合わせたものです。 これにより、分析対象の情報を、より滑らかで頑健な表現へと変換できます。この特性は、市場ノイズが多い場合や、トレンドが不安定な場合に特に有用です。
このモデルの中核を成すのは、N個のブロックを積み重ねた構造です。各ブロックは、Causal Multi-Head Self-Attention(因果的マルチヘッド自己注意)とスパースなエキスパート混合(Sparse MoE)を組み合わせています。 注意機構は過去のデータのみに向けられるため、時間的な順序が厳密に保たれます。つまり、モデルが未来のデータを参照することはなく、実際の市場環境にも適用できます。MoEは、モデルのスケーラビリティを高めます。すべてのパラメータを活性化するのではなく、各トークンに対して、特定の処理に特化したサブモデル(エキスパート)のうち、限られた数だけを選択して使用します。 急激な値動きへの対応を得意とするエキスパートもあれば、保ち合い局面やレンジ相場の分析に特化したエキスパートもあります。 どのエキスパートにトークンを振り分けるかは、適応的なルーティング機構によって決定されます。
しかし、このモデルの特徴はデータ処理だけにとどまりません。 Time-MoEの主要な特徴の一つが、マルチスケール予測(Multiscale Forecasting)です。 学習時には、異なる予測期間について同時に予測するようモデルを訓練します。 これを実現するのが、並列に配置された出力モジュール(ヘッド)です。各ヘッドは、それぞれ固有の教師ラベル(短期・中期・長期)に対して学習されます。 このアーキテクチャにより、市場の微細な動きと、より広範な市場の動向を同時に捉えることができます。 また、市場の状況に応じて、これらの予測を使い分けることも可能です。
推論時には、動的な予測ヘッド選択(Dynamic Head Scheduling)が機能します。 ボラティリティ、トレンドの強さ、あるいはモデルの予測信頼度に応じて、使用する予測モジュールが選択されます。 このような適応的なアプローチは、市場の状況が瞬時に変化し得る取引環境において、Time-MoEの大きな利点となります。
Time-MoEは、大規模な時系列データセットを用いた学習に最適化されている点も重要です。 開発者らは、9つの分野から集められた3,000億件を超える時系列データポイントを含む、「Time-300B」という公開データセットを用いてモデルを学習させました。 これにより、高い汎用性、データ分布の変化に対する頑健性、そして未学習のタスクへの汎化能力を実現しています。 また、Time-MoEは最大24億個のパラメータを持つ規模まで拡張できますが、推論時にはその一部のみを活性化します。そのため、高い性能と計算資源の効率的な利用を両立できます。
Time-MoEアルゴリズム
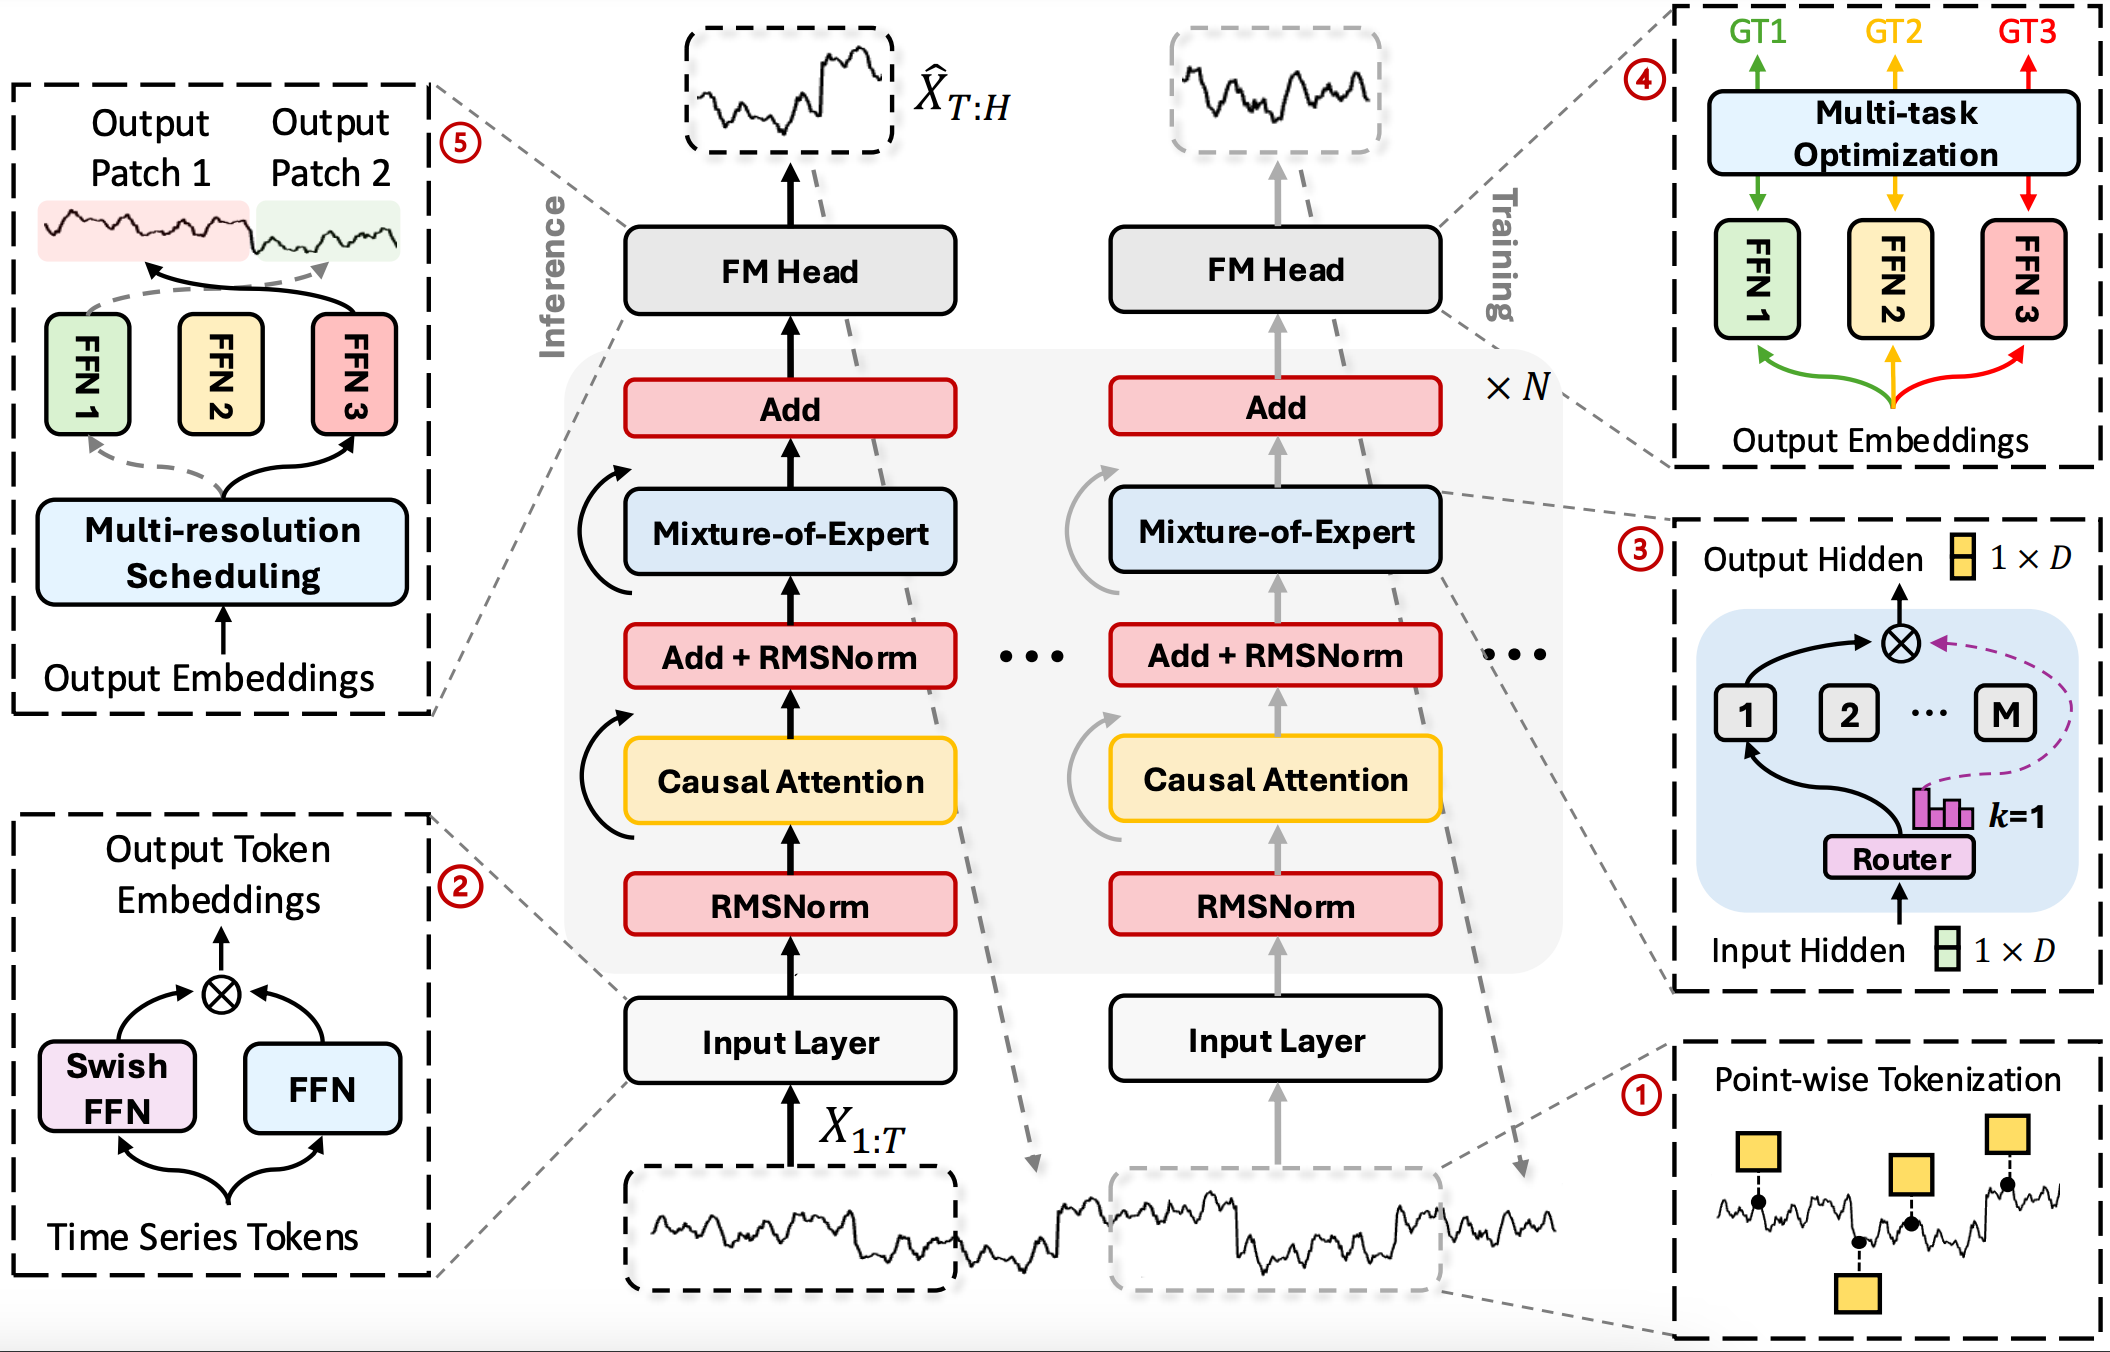
Time-MoEは、計算リソースへの負荷を抑えながら、分析対象の環境におけるさまざまな状況に適応できる、統一的かつスケーラブルな時系列予測モデルを構築するという考え方に基づいています。 このフレームワークのアルゴリズムは、点単位のトークン化(Point-Wise Tokenization)から始まります。この処理では、時系列の各時点に含まれる重要な特徴を捉えます。 このアプローチにより、集約処理によって細かな情報が失われるのを防ぎます。
生トークンを情報量の多い潜在空間に変換するには、SwiGLU埋め込みを使用します。
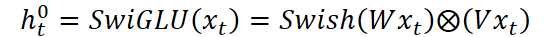
ここで、行列WおよびVはモデルの学習を通じて最適化されます。 要素ごとの乗算 ⨂ によって重要な特徴が強調され、Swish関数とゲート付き線形ユニット(Gated Linear Unit: GLU)の仕組みを組み合わせることで、複雑な非線形依存関係を表現できる、より表現力の高い埋め込みが生成されます。
埋め込み処理を終えたトークンは、N個の同一構造のTransformerブロックを積み重ねたネットワークに入力されます。 各ブロックは、以下の処理で構成されます。
- 正規化と因果的注意:入力ベクトルh_{t,l-1}はまず正規化され、その後、将来の値へのアクセスを防ぐマスクを用いたマルチヘッド自己注意によって解析されます。 各トークンは、それまでの履歴全体を振り返って参照できますが、未来を覗くことはできません。つまり、現在の判断は過去の情報のみに基づいておこなわれます。
- 2回目の正規化をおこなうことで、まれな異常値に対する過剰な反応を抑えます。
- スパースなエキスパート混合層。 ここでは、各履歴ウィンドウをエキスパートのグループ、すなわちエキスパート混合に振り分けられます。 適応型ルーターは、N個のエキスパートのうち、どのK個を活性化するかを決定します。 共有エキスパートが1つ設けられており、シグモイド関数に基づく重み付けを通じて、常に処理に参加します。これは、N個のエキスパートに加えられるN+1番目のエキスパートに相当します。 選択されたエキスパートは、それぞれ独立して入力データを処理し、予測結果を返します。 ブロックの最終出力は、これらの処理結果と入力信号を加算することで得られます。
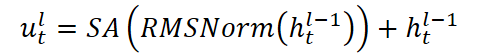
ここで、SAはH個のヘッドを持つSelf-Attentionを表します。各ヘッドは、時点tより前のt−1個の位置を分析します。 この仕組みにより、時間的な因果関係を保ちながら、過去の履歴に含まれる重要な出来事を追跡できます。
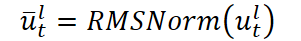
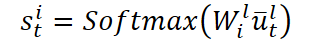
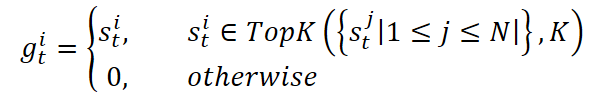
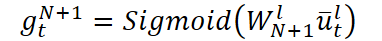
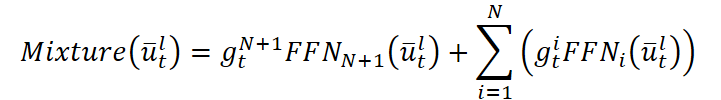
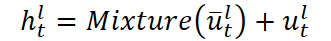
この構造によって、状況に応じた専門的な処理を動的に選択できます。ボラティリティが高い局面では、急激な値動きを認識するように訓練されたエキスパートにトークンが振り分けられます。一方、市場が比較的落ち着いている局面では、トレンドやレンジ相場への対応に適したエキスパートが選択されます。Top-K方式によって、活性化するサブネットワークの数を制限し、パラメータの大部分を非活性の状態に保つことができます。 これにより、推論時の計算量を一定の範囲に抑えながら、モデルを数十億パラメータ規模まで拡張できます。
トークンxTがN個の層すべてを通過すると、市場の履歴とそこに含まれるパターンを反映したコンテキストベクトル hT,Lが得られます。 多解像度予測では、単層のFFNを用いて、予測ホライズンp1、…、pPに対するP個の予測を生成します。
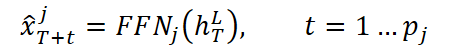
このアーキテクチャにより、共通の内部表現を維持しながら、異なる期間に対する予測を同時に生成できます。
学習時には、モデルは複数の予測期間を同時に予測するように訓練されます。その対象は、分単位の短期的な変動から、数日・数週間にわたって展開する長期的なトレンドまで多岐にわたります。 各予測の学習には、Huber損失が使用されます。この損失関数は、二次関数的な誤差評価の滑らかさと、一次関数的な誤差評価の頑健性を組み合わせたものです。 誤差が小さい場合、Huber損失は古典的なMSEと同様に振る舞い、小さな偏差に緩やかにペナルティを課します。一方、誤差が大きい場合には徐々にL1損失へ移行し、まれな外れ値の影響を軽減するとともに、勾配爆発を防ぎます。 その後、モデルはすべての予測ヘッドの損失を集約します。
このアプローチにより、モデルは、あらゆる予測レベルで一貫性を保ちながら、短期的な突発的変動を捉えると同時に、長期的なトレンドを追跡できるようになります。
一方、スパースなエキスパート(MoE)を採用すると、負荷が一部のエキスパートに集中し、ほかのエキスパートがほとんど利用されないという問題が生じる可能性があります。 この偏りを軽減するため、負荷の不均衡を評価する補助的な正則化項が導入されています。 最終的な学習目的関数は、主損失と補助損失の合計です。
このようにして、きめ細かなトークン化から、エキスパート間の動的なルーティング、マルチレベルの予測、負荷の均衡を考慮した学習までを一貫して連携させるパイプラインが構築されます。
以下に、Time-MoEフレームワークの著者らによる構成図を示します。
MQL5での実装
ここまで、Time-MoEフレームワークの理論と主要な仕組みについて詳しく見てきました。ここからは実装の段階に進み、理論をコードとして形にしていきます。 ただし、システム全体を一度に実装するのではなく、まずは全体を論理的なブロックに分割します。 情報の流れに沿って、MQL5を用いてフレームワークを段階的に実装していきます。 このように段階を踏んで実践的に進めることで、各モジュールのテストやデバッグが容易になるだけでなく、それらを組み合わせて、実際の市場環境でも高い性能と効率を発揮できる、応答性に優れた完全なTime-MoE実装を構築できるようになります。
Time-MoEの著者らが提案した当初の設計思想では、すべての入力データを点単位トークン化(point-wise tokenization)モジュールに通します。この処理は、既存の畳み込み層を利用することで効率的に実装できます。 具体的には、各バーまたはティックのデータを短い1次元畳み込みフィルタに入力します。その畳み込みの出力は、複数の特徴量を持つアトミックトークンとなります。 この手法には、2つの重要な利点があります。1つ目は、集約処理による情報損失を伴わず、各時点の情報を保持できることです。2つ目は、畳み込みによって局所的なパターンを直接検出できることです。
次に、データをSwiGLUモジュールに渡します。このモジュールについて、次に詳しく見ていきます。
SwiGLU埋め込み
トークンの生成後、それらを第2段階であるSwiGLU埋め込みモジュールに入力し、生の特徴量を、豊かな表現力を持つ隠れ空間のベクトルへと変換します。 SwiGLU層では、次の2つの経路で変換を行います。
- まず、トークンを線形射影に通し、滑らかでソフトな活性化関数であるSwishを適用します。
- 次に、別の線形射影をおこない、選択的に情報を通過させるゲート付き線形ユニット(GLU)を適用します。
最後に、2つの出力を要素ごとの乗算によって結合します。
Swishは埋め込み表現を滑らかにし、モデルが微細なシグナルを捉えられるようにします。一方、GLUはベクトルの各成分を選択的に開閉することで、特に重要なパターンを際立たせます。
今回の実装では、SwiGLU層をCNeuronSwiGLUOCLクラスとして実装します。 このクラスは、基底となるニューラルネットワーク層のクラスを継承します。クラス内部には、対象のベクトルに対して2つの異なる射影をおこない、それぞれの信号を出力する2つの個別の畳み込み層を作成します。 新しいオブジェクトの構造を以下に示します。
class CNeuronSwiGLUOCL  :  public   CNeuronBaseOCL
  {
protected:
   CNeuronConvOCL    caProjections[2];
   //---
   virtual bool      feedForward(CNeuronBaseOCL *NeuronOCL)          override;
   virtual bool      updateInputWeights(CNeuronBaseOCL *NeuronOCL)   override;
   virtual bool      calcInputGradients(CNeuronBaseOCL *NeuronOCL)   override;

public:
                     CNeuronSwiGLUOCL(void) {};
                    ~CNeuronSwiGLUOCL(void) {};
   //---
   virtual bool      Init(uint numOutputs, uint myIndex, COpenCLMy *open_cl, uint window,
                          uint step, uint window_out, uint units_count, uint variables,
                          ENUM_OPTIMIZATION optimization_type, uint batch);
   //---
   virtual int       Type(void) override const {   return defNeuronSwiGLUOCL; }
   //--- methods for working with files
   virtual bool      Save(int const file_handle)   override;
   virtual bool      Load(int const file_handle)   override;
   //---
   virtual void      SetOpenCL(COpenCLMy *obj)     override;
   //---
   virtual bool      WeightsUpdate(CNeuronBaseOCL *source, float tau) override;
  };
この新しいクラスの内部オブジェクトはすべて静的に宣言されているため、 コンストラクタとデストラクタは空のままです。 各射影や畳み込みパラメータの初期化、さらにOpenCLコンテキストとの接続は、Initメソッドでおこないます。 このメソッドの引数には、畳み込みウィンドウのサイズ、ストライド、フィルタ数、およびOpenCLコンテキストへのポインタを指定します。 これにより、層を使用する前に、必要な設定をすべて完了できます。
bool CNeuronSwiGLUOCL::Init(uint numOutputs, uint myIndex, COpenCLMy *open_cl,
                            uint window, uint step, uint window_out, uint units_count,
                            uint variables, ENUM_OPTIMIZATION optimization_type, uint batch)
  {
   if(CNeuronBaseOCL::Init(numOutputs, myIndex, open_cl, units_count * window_out * variables,
                                                                    optimization_type, batch))
      return false;
   SetActivationFunction(None);
このメソッドでは、基本的な初期化処理を親クラスに任せます。親クラスには、基本的な検証や共通インターフェースの設定がすでに実装されています。 そのため、親クラスの同名メソッドを呼び出すだけで、これらの処理を実行できます。 これにより、低レベルの処理を重複して記述する必要がなくなり、実行環境の信頼性も確保できます。
ここでは、すべての非線形変換を内部オブジェクトでおこなうため、層のインターフェースでは活性化関数を明示的に無効化します。
基盤となる設定が完了したら、次に層の詳細な設定に進みます。 ここで重要なのは、2つの内部畳み込み層が、どちらも同じサイズのベクトルを出力するように設計されている点です。これは不可欠です。 結局のところ、要素ごとの乗算を正しくおこなうには、両者の次元が一致している必要があります。 両者の違いは、その後に適用する活性化関数だけです。
そのため、準備段階では、ループを使ってこれらの層を初期化し、各層に同じ畳み込みカーネルのサイズ、フィルタ数、ストライドを自動的に設定します。 これにより、コードの重複を避けるとともに、両方の射影の次元が常に一致するようにしています。
for(uint i = 0; i < caProjections.Size(); i++)
  {
   if(!caProjections[i].Init(0, i, OpenCL, window, step, window_out, units_count,
                                                variables, optimization, iBatch))
      return false;
  }
次元数と基本パラメータの確認が完了したら、各層に異なる活性化関数を設定します。これにより、最終的な埋め込み表現に、滑らかな特徴と選択性の高い特徴の両方を反映させます。 このアプローチにより、コードの保守が容易になり、SwiGLU層内での役割の明確な分離が確保されます。
   caProjections[0].SetActivationFunction(GELU);
   caProjections[1].SetActivationFunction(None);
//---
   return true;
  }
これで、演算の結果をブール値として呼び出し元プログラムに返すことで、SwiGLU層の初期化メソッドを完成させることができます。
層の設定がすべて完了したら、いよいよ処理を実行し、解析対象のデータを2つの畳み込み射影に通します。 まずは、feedForwardメソッドで実装する順伝播アルゴリズムを構築していきましょう。
bool CNeuronSwiGLUOCL::feedForward(CNeuronBaseOCL *NeuronOCL)
  {
   for(uint i = 0; i < caProjections.Size(); i++)
      if(!caProjections[i].FeedForward(NeuronOCL))
         return false;
いつものように、このメソッドのパラメータとして、入力データオブジェクトへのポインタを受け取ります。 これを、2つのデータ射影層のそれぞれに渡します。 この処理はループ内で実行します。 オブジェクトの配列を宣言することで、この処理が可能になります。
両層が同じ次元のテンソルを生成するため、次元の不一致を気にすることなく、要素ごとに直接乗算できます。 その結果、単一の出力テンソルが得られます。各値は、Swish射影とGLU射影それぞれの「意見」を掛け合わせた値です。 データへのポインタを層の配列に沿って順次渡すこの手法により、コードを簡潔に保つことができます。また、配列の長さを変更するだけで、層内の「声」の数を容易に増減できます。
   if(!ElementMult(caProjections[0].getOutput(), caProjections[1].getOutput(), Output))
      return false;
//---
   return true;
  }
得られた結果を層の出力バッファに格納し、呼び出し元のプログラムにブール値を返して、このメソッドを終了します。
SwiGLU層での順伝播が完了したら、次は誤差がどこへ伝わったのかを一つずつ追跡し、逆伝播を準備します。 基本的な考え方は、出力側から入力データへ向かって勾配を分配し、その過程で2つの畳み込み射影器のそれぞれを慎重に通過させることです。 この処理は、calcInputGradientsメソッドで実装します。
bool CNeuronSwiGLUOCL::calcInputGradients(CNeuronBaseOCL *NeuronOCL)
  {
   if(!NeuronOCL)
      return false;
メソッド本体では、 順伝播時に使用したものと同じ入力データオブジェクトへのポインタを取得します。 ただし今回は、最終結果に対する入力データの影響度に応じて、誤差勾配をその入力データに戻す必要があります。 データを正しく渡すには、有効なオブジェクトが必要です。 そのため、後続の処理に進む前に、受け取ったポインタが有効かどうかを確認します。
この層の外部インターフェースには、現在の予測値と目標値との差分がすでに渡されています。 次に、ベクトルの次元が一致しているため、誤差のうち各内部フィルタに起因する部分を容易に切り分けることができます。
if(!ElementMultGrad(caProjections[0].getOutput(), caProjections[0].getGradient(),
                    caProjections[1].getOutput(), caProjections[1].getGradient(),
                    Gradient, caProjections[0].Activation(), caProjections[1].Activation()
                   ))
   return false;
これらの2つのストリームを、それぞれ対応する畳み込みニューロンに送ります。 両層が独自の勾配バッファを保持しているため、それぞれの層には、入力データと同じ次元を持つベクトルが渡されます。
その後、各内部畳み込みオブジェクトは、それぞれが担当する誤差の一部を独立してさらに伝播させます。 しかし今回は、ループ内で入力データオブジェクトに値を書き込むことはできません。 後続の処理によってデータが上書きされ、それまでに保存した値が失われてしまうためです。 一方、ここではすべての情報の流れから得られる値を集約する必要があります。 そこで、まず最初の射影層から誤差勾配を伝播させます。
if(!NeuronOCL.calcHiddenGradients(caProjections[0].AsObject()))
   return false;
次に、入力データオブジェクトの誤差勾配バッファへのポインタをローカル変数に格納します。 そのバッファの代わりに、同じサイズの別の空きデータバッファを割り当てます。
   CBufferFloat *temp = NeuronOCL.getGradient();
   if(!NeuronOCL.SetGradient(NeuronOCL.getPrevOutput(), false) ||
      !NeuronOCL.calcHiddenGradients(caProjections[1].AsObject()) ||
      !SumAndNormilize(temp, NeuronOCL.getGradient(), temp, 1, false, 0, 0, 0, 1) ||
      !NeuronOCL.SetGradient(temp, false)
     )
      return false;
//---
   return true;
  }
これで、2つ目の情報フローにも安全にデータを渡せるようになります。 次に、2つの射影層から得られた値を合算します。 この方法により、異なる情報フローから生じた誤差のあらゆる成分を保持し、正しく集約できます。その結果、後続の最適化ステップで、正確かつ安定した重みの更新が可能になります。
最後に、データバッファへのポインタを元の状態に戻し、処理結果をブール値として呼び出し元のプログラムに返して、メソッドを終了します。
通常どおり、逆伝播アルゴリズムは2つの論理的な段階に分かれています。 第1段階である誤差勾配の分配については、すでに詳しく説明しました。 これは、マルチブランチの情報フローが持つ特性をすべて考慮しながら、層の出力から入力データへ誤差を正しく伝播させるための重要なステップです。
第2段階は、全体の誤差を低減することを目的としたパラメータ最適化です。この段階は本記事の対象範囲外とします。 重要ではないからではなく、その実装が各畳み込みオブジェクトの内部に厳密にカプセル化されているためです。 これには重要な利点があります。クラスのインターフェースに不要な詳細を詰め込むことなく、アーキテクチャの明快さとモジュール性を維持できるのです。
重みの更新に必要な処理は、すべて各射影層の内部にすでに実装されています。 したがって、最適化サイクル全体を完了するには、各内部オブジェクトの対応するメソッドを順番に呼び出すだけです。 この方法により、メインクラスをコンパクトに保ちながら、パラメータ更新のロジックの信頼性を確保できます。また、そのロジックは個別にテスト済みです。
CNeuronSwiGLUOCLクラスの完全なソースコードと、順伝播関数や逆伝播関数を含むすべてのメソッドは、添付ファイルに収録されています。コードを参照することで、内部の動作メカニズムをより深く理解できます。
これで、SwiGLU埋め込みコンポーネントの実装が完了しました。次はいよいよ、Time-MoEフレームワークの中核となる、改良版Transformerブロックの実装へと進みます。 このステップは、モデル開発の新たな段階の始まりを意味します。シーケンス全体に対する高次の理解が形成されるのは、まさにTransformerブロック内だからです。モデルはここで、長期的な依存関係を特定し、文脈を分析し、将来の事象がどのように推移するかを予測することを学習します。
変換された時系列データをSwiGLUブロックからTransformerモジュールへ渡すことは、単なるデータの受け渡しではありません。本質的には、知識の受け渡しです。 局所的なパターンに関する情報を圧縮して豊富に保持した埋め込みが、ここからの詳細な分析の基盤となります。 しかし、Time-MoEのTransformerアーキテクチャは、従来の実装とは大きく異なります。 まず目を引くのは、各層でアテンション機構の直後に通常配置される、おなじみのFeedForwardブロックが存在しないことです。
標準的なモジュールの代わりに、著者らは、いわゆるスパースなエキスパート混合(Sparse Mixture of Experts、略してMoE)を採用しています。 このアーキテクチャ上の選択は、モデルに適応的な柔軟性をもたらすだけでなく、学習をより意味のある、文脈に応じたものにします。 MoEの基本的な考え方は、単一の汎用層を、専門性の高い複数のサブモジュール(エキスパート)に分割し、それぞれが特定の種類の入力データを処理するように学習させることです。 この方法では、入力シーケンス内の各トークンが、その特徴を処理するのに最適なエキスパートだけを利用し、その他のエキスパートは待機状態に置かれます。
エキスパートを適応的に選択する仕組みは、ルーターと呼ばれる独立したサブモジュールによって実現されます。ルーターは、トークンの初期表現に基づいて、どのエキスパートを処理に参加させるかを決定します。 原論文では、重要な点としてスパースルーティングが採用されていることが強調されています。つまり、各トークンをすべてのエキスパートに一斉に割り当てるのではなく、候補となるエキスパートのうち、ごく一部だけに割り当てます。たとえば、10個のエキスパートのうち2個だけを使用します。 これにより計算コストを大幅に削減できるため、リソースに過度な負荷をかけることなく、大規模なMoEを利用できるようになります。
このアプローチには、モデルにとって多くの利点があります。 第一に、モデルはタスクをエキスパート間で分担する方法を学習します。たとえば、短期的な価格変動に適応するエキスパートもあれば、トレンドの動きやボラティリティに適応するエキスパートもあります。 第二に、モデルは知識を一般化する能力を獲得します。エキスパートごとに異なる経験を積むため、従来の単一層のアーキテクチャでは難しい、より複雑な相互作用をモデル化できるようになります。
このように、Time-MoE Transformerにおけるスパースなエキスパート混合の採用は、フレームワークの中核的な革新といえます。 これは単なるアーキテクチャ上の実験ではなく、時系列データの処理方法そのものを根本から見直す試みです。
では、こうしたアーキテクチャ上のアイデアを、実際にどのように実装すればよいのでしょうか。 私たちは理論を論じるだけでなく、実際に動作するシステムを一歩ずつ構築しています。 これまでの研究を振り返ると、DUETフレームワークの開発において、すでにエキスパート混合(MoE)の概念を取り上げました。 当時は、ルーティングやエキスパートの判断を集約する仕組みへの理解を深めるため、非常にシンプルなプロトタイプを開発しました。 しかし、その実装を真の意味でスパースと呼ぶのは難しいでしょう。 実際には、選択メカニズムを模倣したものにすぎず、すべてのエキスパートが同時に出力を計算した後、それぞれの結果に対応するマスクを掛けていたのです。
数学的な観点から見れば、最終結果は妥当に見えました。マスクによって不要なエキスパートの出力をゼロにし、制御可能な重ね合わせを形成できたからです。 しかし、計算効率という観点では、率直に言って不十分でした。 どのエキスパートも、その出力が実際に使われるかどうかにかかわらず、依然としてすべての計算を実行していたためです。 その結果、エキスパートの数に比例して計算量が線形に増加し、MoEアーキテクチャの大きな利点の一つである、コストを指数関数的に増大させずに規模を拡大できるという特長が損なわれていました。
もちろん、この方法でも、エキスパートの数や各エキスパートの規模が小さく、性能要件もそれほど厳しくないモデルであれば許容できます。 しかし、実際の運用環境では事情が異なります。例えば、深く幅の広いTransformerで、1層おきにMoEを使用し、エキスパートの数が数十に達するような場合、この方法は現実的ではありません。計算負荷がすぐに許容範囲を超えてしまうためです。 特に、金融市場でのアルゴリズム取引など、モデルをリアルタイムで動作させたい場合には、大きな問題となります。
さらに、エキスパートの数が増えるにつれて、ルーティング処理自体も複雑になります。 すべてのエキスパートを一度に動作させ続ければ、GPUメモリの使用量が増大し、OpenCLでの性能低下も避けられません。 だからこそ、ここでは真のスパース性という理念を貫くことが重要です。ネットワークのうち、実際に動作させるのは必要な部分だけに限定し、まさにその時点で必要な部分だけを活性化させるのです。 この方法は、リソースを節約するだけでなく、モデルの適応性を高め、ノイズに対する頑健性も向上させます。
今回の実装では、形式的なマスキングだけで済ませるのではなく、さらに一歩進み、Time-MoEフレームワークの理念に沿った真にスパースなアルゴリズムを構築することにしました。 取り組むべき課題がアーキテクチャの複数の階層にまたがる大きなものであることは明らかです。 重要なのは、単に新しいモジュールをプログラムすることではありません。ルーティング、活性化、集約、パラメータ最適化が、原アルゴリズムの意図どおりに連携して動作する、一貫したシステムを構築することです。 そこで、ここでいったん短い休憩を挟みたいと思います。
私たちは大きな一歩を踏み出しました。独自のSwiGLU埋め込みを実装し、情報フローを確立し、エキスパート混合を統合するためのアーキテクチャ上の基盤を整えました。 これは、モデルをさらに発展させるための確かな土台です。 ただし、内容が散漫になったり、情報を詰め込みすぎたりしないよう、スパースなMoEの構築については別の記事で扱うのが適切でしょう。 そうすることで、細部まで十分に検討できるだけでなく、コードとロジックが断片化するのも防げます。
こうして、今回はここを自然な区切りとして締めくくります。次の記事では、スパースなMoEを実装に組み込んだ状態で、引き続き開発を進めていきましょう。
結論
本記事では、論文「Time-MoE: Billion-Scale Time Series Foundation Models with Mixture of Experts」の著者らが提案した先進的なフレームワーク、Time-MoEのアーキテクチャについて解説しました。このモデルは、Transformerアプローチの利点と、スパースなエキスパート混合(Sparse Mixture of Experts)の考え方を効果的に組み合わせ、計算処理を適応的に振り分けることで、予測精度の向上を実現します。 Time-MoEの主な利点の一つは、時系列データにおける短期的な依存関係と長期的な依存関係の両方を効果的に捉えられることです。 また、SwiGLUモジュールを導入することで、モデルの柔軟性が高まります。
実践パートでは、MQL5を用いて提案アプローチに対する独自の解釈に基づく実装を開始し、理論的概念を段階的に実際のコードへと落とし込んでいきました。 現段階の一環として、要素ごとの乗算をおこなう2つの畳み込み射影に基づくSwiGLU埋め込みブロックを実装しました。 順伝播と逆伝播、適切な勾配分配、および畳み込み層内での情報処理に焦点を当てました。
こうして土台が築かれ、次の段階へ進む準備が整いました。 次の部分では、真にスパースなMoEブロックを構築することに焦点を当てます。これには、より複雑なルーティングとエキスパート管理ロジックが必要となります。 このコンポーネントは、Time-MoEアーキテクチャの中核となるものであり、その実装には綿密な計画と革新的なエンジニアリング上の解決策の両方が必要となります。
リンク
本記事で使用したプログラム
| # | 名前 | 種類 | 説明 |
|---|---|---|---|
| 1 | Research.mq5 | EA | サンプル収集用EA |
| 2 | ResearchRealORL.mq5 | EA | サンプル収集用EA(Real-ORL手法) |
| 3 | Study.mq5 | EA | モデルのオフライン学習用EA |
| 4 | StudyOnline.mq5 | EA | モデルのオンライン学習用EA |
| 5 | Test.mq5 | EA | モデルテスト用EA |
| 6 | Trajectory.mqh | クラスライブラリ | システム状態とモデルアーキテクチャを記述するための構造体 |
| 7 | NeuroNet.mqh | クラスライブラリ | ニューラルネットワークを作成するためのクラスライブラリ |
| 8 | NeuroNet.cl | ライブラリ | OpenCLプログラム用のコードライブラリ |
MetaQuotes Ltdによってロシア語から翻訳されました。
元の記事: https://www.mql5.com/ru/articles/18499
警告: これらの資料についてのすべての権利はMetaQuotes Ltd.が保有しています。これらの資料の全部または一部の複製や再プリントは禁じられています。
この記事はサイトのユーザーによって執筆されたものであり、著者の個人的な見解を反映しています。MetaQuotes Ltdは、提示された情報の正確性や、記載されているソリューション、戦略、または推奨事項の使用によって生じたいかなる結果についても責任を負いません。

 初級から中級まで:オブジェクトイベント(II)
 取引におけるニューラルネットワーク:クロスドメイン時系列予測フレームワーク(最終回)
 エラー 146 (「トレードコンテキスト ビジー」) と、その対処方法
 取引におけるニューラルネットワーク:クロスドメイン時系列予測フレームワーク「TimeFound」

- 無料取引アプリ
- 8千を超えるシグナルをコピー
- 金融ニュースで金融マーケットを探索