

取引におけるニューラルネットワーク:高精度分類のための効果的な特徴抽出(オブジェクトの実装)
 26
 0

はじめに
前回の記事では、時系列分類のための基盤モデルであるMantisフレームワークの理論的な側面を取り上げました。Mantisは、回帰アルゴリズムに伴う計算上の複雑さを回避しながら、高い精度を維持することを目指したモデルです。 解析対象となる時系列の生データを、明確な信頼度を伴うシグナルへと変換することで、分析の質を新たな段階へと引き上げます。
従来の予測モデルを考えてみましょう。一般的なモデルは予測誤差を最小化するように学習しますが、ボラティリティが急激に高まると、十分に対応できないことがあります。 こうしたアルゴリズムは、市場の変化に合わせて挙動が漂流しやすく、 適応も容易ではありません。 また、過学習を起こしやすく、予測の信頼性を透明性の高い形で示すことも困難です。 必要なのは、単に将来の価格を予測することだけではありません。 価格が通常のパターンに沿って動いているのか、それとも異常な動きを示しているのかをリアルタイムで識別する、市場レジームの認識が求められます。 ここで登場するのがMantisです。このモデルは、回帰による予測そのものよりも、時系列に現れるパターンの理解に重点を置いて学習されます。
Mantisの基盤となっているのは、Vision Transformer (ViT)に着想を得た「時系列のトークン化」という考え方です。 数万に及ぶティックや秒単位のデータを一つずつ処理するのではなく、時系列をあらかじめ定められた数のパッチに分割します。 これにより、長さの異なる時系列であっても、同じ数のステップで処理できるようになり、データの規模に応じてアーキテクチャを変更する必要がなくなります。 そこで、ハイブリッドなアテンションの妙が発揮されます。このモデルは、一方では、畳み込みとプーリングによって局所的な変化を細かく捉えます。もう一方では、グローバルアテンションによって長期的な傾向を把握します。 この2つの視点を組み合わせることで、モデルは微細な価格変動を捉えつつ、市場全体の動きの方向性も把握できるようになります。
このモデルの重要な秘訣が、対照事前学習です。 同じ価格履歴の一部分から、わずかに変化を加えた2つのデータを作成する場面を想像してください。Mantisは、これらのデータから得られる埋め込み表現を、表現空間内で互いに近づけるように学習します。光の異なる帯が1本の光線にまとまるようなイメージです。一方、まったく異なるデータから得られた表現は、互いに遠ざけます。電子と陽電子のような関係です。 このような対照学習によって、モデルはパターンを安定して認識できるようになります。これは、振幅の変化、わずかな時間的なずれ、通常とは異なるノイズなどが含まれるデータを扱う際に、特に有効です。
学習プロセスの最後には、温度スケーリングによる出力確率の較正をおこないます。 トレーダーにとって重要なのは、単に「反転するか、しないか」という判定だけではありません。その判定がどの程度確からしいのかも重要です。Mantisは、単なる抽象的なスコアではなく、適切に較正された確率を出力できます。 経験上、モデルが「反転確率80%」と予測したシグナルが100件あれば、そのうち約80件で実際に反転が起こることが期待されます。
Mantisの真価は、複数のチャネルから得られる情報を入力したときに、さらに明らかになります。 リズムを刻むように変動するRSI、取引量、移動平均線、通貨ペア間の相関関係などが組み合わさることで、市場の複雑な状況を多角的に捉えられるようになります。 これらのシグナルを単純に連結すると、パラメータ数が爆発的に増加してしまいます。一方、それぞれを独立して処理すれば、チャネル間の相互依存関係を十分に捉えられません。 Mantisでは、この問題に対処するため、チャネル間の相互作用を効率的に圧縮する軽量なアダプターを使用します。これにより、指標間の関係の強さなど、重要な情報を保持しながら、計算に必要なメモリを抑えられます。 結果として、トレーダーがモデルの設定に費やす時間も削減できます。
Mantisの仕組みをより深く理解するために、処理の流れを順に見ていきましょう。 最初の段階は初期畳み込みです。dチャネルからなる時系列データを、出力チャネル数256の畳み込み層に入力し、密な表現を生成します。 次に、得られたテンソルを等しい長さに分割し、チャネル方向の平均プーリングを適用することで、各区間の局所的な情報を表す32個のトークンに変換します。
これと並行して、差分ストリームを構築します。入力データの一次差分を計算することで、短期的な変化や局所的な動態を捉えやすくします。 得られた差分データにも、同じパッチ化処理を適用します。
3番目と4番目のストリームは、統計情報を扱うストリームです。それぞれ、同じ32個の時間窓について入力データの平均値と標準偏差を計算します。これにより、データの水準と変動の大きさに関する全体的な特徴を捉えます。
こうして得られた4つのストリームは、それぞれ独立した線形射影層を通過し、特徴量の次元が統一されます。その後、各ストリームの特徴量を連結し、さらに射影することで、指定された次元数を持つグローバルトークンを生成します。
次に、分析対象の時系列を表すトークン列に、クラストークンと正弦波位置エンコーディングを追加します。これにより、モデルがトークンの順序に関する情報を保持できるようにします。 その後、トークン列をTransformerに入力します。Transformerは6層で構成され、8ヘッドのマルチヘッドアテンション、正規化層、GELU活性化関数を用いた2層のフィードフォワードネットワーク(FFN)、および学習時に適用するドロップアウト(Dropout、確率0.1)を備えています。
モデルの学習は、2段階に分けて行われます。 初めに対照学習段階を実施します。10種類の公開データセットを統合したコーパスを使用し、700万件を超える時系列データを対象に、バッチサイズ2,048、100エポックの条件で学習します。計算環境には、NVIDIA Tesla V100 GPUを4基使用します。 いわば、モデルに幅広い時系列パターンを学習させるための集中的なトレーニング期間です。 第2段階では、分類ヘッドを追加して、対象タスクに合わせた学習をおこないます。また、温度スケーリングによって、モデルの予測確率を較正します。 この2段階のアプローチにより、ニューラルネットワークでは珍しい、高い精度と信頼性の高い解釈可能性の両立が可能になります。
最後に、柔軟性について見ていきましょう。 さまざまな規模のタスクに対応し、計算予算やデータ構造に応じてモデルを調整するため、Mantisフレームワークの著者らは、次のような複数のアダプターを提案しています。
- PCAおよび切り捨て特異値分解:線形次元削減のための、古典的で実績のある手法です。
- ランダム射影:特徴量ベクトルの次元を削減するための、高速かつシンプルでありながら強力な手法です。
- 分散ベースセレクター:分散に基づいて、最も情報量の多いチャネルのみを選択します。
- 微分可能な線形結合器(LComb):メインモデルと並行して学習され、特定のタスクに適応する学習可能なアダプターです。
これらのアダプターにより、速度と精度のバランスを取りながら、計算リソースを節約し、チャネル間の重要な関係性が失われるのを防ぐことができます。
最終的に、Mantisは単なるモデルではなく、時系列データを詳細に分析するための包括的なエンジニアリングスイートです。 その強みは、大仰な主張にあるのではなく、綿密な実行にあります。すなわち、すべてのパッチへの細心の注意、局所的なコンテキストと大域的なコンテキストの慎重な統合、厳密な較正、そして慎重に設計されたチャネル圧縮です。 こうした分析手法と人工知能の組み合わせにより、当て推量に頼るのではなく、統計や実証済みのアルゴリズムの原理に基づいて、自信を持って判断できるようになります。 スピードと精度が何よりも重要な時代において、Mantisは、綱渡りのような市場環境でバランスを保つためのツールとなります。
以下に、Mantisフレームワークの著者による構成図を示します。
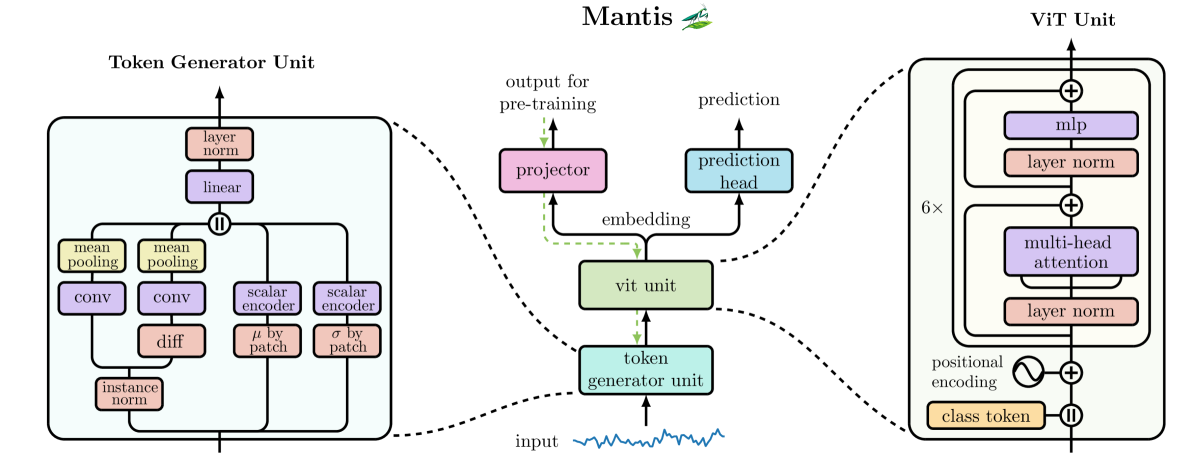
前回の記事の実践編では、時系列データを処理するための基本モジュールであるCNeuronConcatDiffを実装しました。 このモジュールは、一次差分を計算するアルゴリズムと、異なる情報ストリームから得られたテンソルを連結する仕組みを組み合わせたものです。 これは、Mantisフレームワークの中核部分を実際に実装する出発点となりました。
今回は、このアーキテクチャの構築をさらに進め、ニューラルネットワークモデルを構成する次の重要な要素に取り組みます。 前回の記事の設計段階では、データストリームに時間エンコーディングを導入する必要があることを確認しました。 これは、計算効率や実行性能を損なうことなく、解釈可能性を高めるとともに、入力データの位置構造を考慮するためです。 もちろん、車輪を再発明するつもりはありません。幸い、すでに実績のあるCMamba4CastEmbeddingというオブジェクトがあります。 これは、Mamba4Castフレームワークの開発過程で実装したもので、今回のタスクにも適しています。
次に取り組むべきなのは、時系列データのパッチ化です。 この段階で、モデルは入力シーケンスの長さへの依存を解消し、データの規模にかかわらず、固定数のパッチを扱えるようになります。 これは、分類器のアーキテクチャにおいて、誇張ではなく最も重要なモジュールの一つです。後続のすべての処理が安定して動作するかどうかは、このモジュールの実装に左右されるためです。 そこで、今回の作業はここから始めます。入力情報のストリームを、コンパクトで情報量の多いパッチに分割する仕組みを、一つずつ構築していきましょう。
セグメンテーションオブジェクト
オリジナルのMantisフレームワークの著者らは、時系列のセグメンテーションという課題に、意外性がありながらも洗練されたアプローチを採用しました。 単に時系列を等しい長さの区間に分割するのではなく、まず畳み込み演算によってデータを変換する方法を提案したのです。 さらに、単に畳み込みを適用するのではなく、1次元の時系列をマルチチャネルテンソルに変換するために、この演算を利用しました。 一見すると、このアイデアは不要に思えるかもしれません。しかし、実際には大きな利点があります。小さなウィンドウを用いて畳み込みをおこなうことで、モデルは信号の局所的な変動を検出し、全体的なトレンドの陰に隠れて見落とされがちな、市場の動きの重要なニュアンスを捉えられるようになります。
この変換によって、マルチチャネルテンソルが得られます。各チャネルは、元の時系列を異なる視点から捉えた個別の射影、言い換えれば、信号の「ミニ表現」に相当します。 このテンソルを、次に固定数のパッチへ均等に分割します。 これらのパッチが、以降の処理でモデルが扱う基本単位となります。 そして、次の段階では、各セグメント内の情報を集約します。
Mantisの著者らは、平均プーリングと呼ばれる、古典的なチャネルごとの平均化処理を採用しました。 この方法はシンプルで直感的であり、セグメントを平滑化して良好な表現を生成します。 最大値のみを保持する最大プーリングとは異なり、平均プーリングでは、時系列の各要素が最終的なトークンの生成に寄与します。 これは、各パッチがデータの比較的広い範囲をカバーする場合に特に有効です。そのような場合、ピークや谷だけでなく、利用可能なすべての情報を考慮する必要があります。 このように生成されたトークンは、元データの時間的な構造をコンパクトかつ情報豊かに表現し、Transformerによる後続の分析に適したものとなります。
しかし、実際には、平均プーリングは「おとなしくなりすぎる」ことがあります。情報だけでなく、信号構造における異常や急激な変化までも平均化してしまうためです。 基盤モデルとしては、シンプルさと高速性、汎用性を維持できるため、これは許容できる妥協といえるでしょう。 しかし、私たちはさらに一歩踏み込むことにしました。 今回の実装では、標準的な平均プーリングを、チャネルごとの畳み込みと、それに続く最大プーリングを組み合わせた処理に置き換えました。
では、これによって実際にどのような効果が得られるのでしょうか。 まず、畳み込み演算によって各チャネル内の特徴量を抽出し、初期段階のフィルタリングをおこなうとともに、局所的な変化を強調します。 続いて、最大プーリングによって、抽出された特徴量のうち、最も顕著なものを取り出します。 このアプローチにより、モデルは時系列の動態に対して、より鋭敏に反応できるようになります。 すべての値を平均化するのではなく、重要な特徴を捉えることで、急激な値動きにも、より迅速かつ正確に反応できるようになります。 この特性は、高頻度取引やボラティリティの高い資産を扱う場合に、特に重要となります。
このようにパッチ化手法を改良することで、私たちの分類器は、それぞれの時系列の形状や構造に適応できるようになります。 もはや単にデータを区間に分割するだけでなく、特徴の分析、抽出、フィルタリング、評価までをおこないます。 このようなシステムにおいて、個々のパッチは単なる信号の断片ではありません。信号の文脈と形状の両方を保持した、情報豊かなトークンとなります。
提案するアルゴリズムは、CNeuronMantisPatchingクラスに実装されています。 これは、時系列を構造化されたパッチに分割し、後続の処理に適した高次の表現を生成する専用モジュールです。 ここから、データの真の理解が始まります。単純な1次元のデータストリームから局所的なパターンを抽出し、それらを高密度なベクトル表現へと変換するのです。
CNeuronMantisPatchingクラスは、多段階の計算パイプラインとして構成されています。 クラス内部には複数のオブジェクトが配置されており、それぞれが特定の処理に特化した役割を担います。 クラスの構造を以下に示します。
class CNeuronMantisPatching   :  public CNeuronTransposeOCL
  {
protected:
   CNeuronTransposeOCL     cToVarSeq;
   CNeuronConvOCL          cProjecting;
   CNeuronTransposeVRCOCL  cToVarProjSeq;
   CNeuronConvOCL          cPatchingProj;
   CNeuronProofOCL         cProof;
   //---
   virtual bool      feedForward(CNeuronBaseOCL *NeuronOCL) override;
   virtual bool      updateInputWeights(CNeuronBaseOCL *NeuronOCL)  override;
   virtual bool      calcInputGradients(CNeuronBaseOCL *NeuronOCL)  override;

public:
                     CNeuronMantisPatching(void) {};
                    ~CNeuronMantisPatching(void) {};
   //---
   virtual bool      Init(uint numOutputs, uint myIndex, COpenCLMy *open_cl,
                          uint count, uint patchs, uint variables,
                          uint embedding_size, uint patch_filters,
                          ENUM_OPTIMIZATION optimization_type, uint batch);
   //---
   virtual bool      Save(int const file_handle) override;
   virtual bool      Load(int const file_handle) override;
   //---
   virtual int       Type(void)  override const {  return defNeuronMantisPatching; }
   //---
   virtual void      SetOpenCL(COpenCLMy *obj) override;
   virtual bool      WeightsUpdate(CNeuronBaseOCL *source, float tau) override;
  };
すべての内部オブジェクトは静的に宣言されているため、クラスのコンストラクタとデストラクタは空のままにできます。 これらのオブジェクトの初期化と設定はInitメソッドでおこないます。このメソッドのパラメータには一連の定数が指定されており、これによって生成するオブジェクトのアーキテクチャを一意に決定できます。
bool CNeuronMantisPatching::Init(uint numOutputs, uint myIndex, COpenCLMy *open_cl,
                                 uint count, uint patchs, uint variables,
                                 uint embedding_size, uint patch_filters,
                                 ENUM_OPTIMIZATION optimization_type, uint batch)
  {
   if(!CNeuronTransposeOCL::Init(numOutputs, myIndex, open_cl, variables * embedding_size,
                                                        patchs, optimization_type, batch))
      return false;
CNeuronMantisPatchingオブジェクトへの入力として、マルチチャネル時系列の値を格納した行列を想定しています。 各列は個別のチャネルを表し、各チャネルには時間の経過に沿った数値データが並びます。 つまり、ここで扱うのは次元[T × C]の行列であり、ここでTは時間ステップ数、Cはチャネル数(変数の数)を表します。
モジュール内で各チャネルを独立して処理するために、データの転置オブジェクトを使用します。 これは、チャネル軸と時間軸に沿った処理をそれぞれ独立しておこなうために必要です。軸を明示的に入れ替えなければ、このように処理を分離することは困難です。 また、CNeuronMantisPatchingクラス自体はCNeuronTransposeOCLを継承しています。そのため、すべての変換処理が完了した後、親クラスのメソッドを使用して逆転置を行い、出力テンソルを所定の形式に戻すことができます。
初期化メソッドでは、まず親クラスであるCNeuronTransposeOCLの同名メソッドを呼び出します。 このメソッドは基本構造を準備し、各パラメータの初期化をおこないます。 この処理は、継承された各種機能を正常に動作させるために必要です。
親クラスの初期化が正常に完了すると、内部コンポーネントの設定に進みます。 最初に設定するのは、cToVarSeqオブジェクトです。これは行列を転置するレイヤーであり、各チャネルの時系列に個別にアクセスできるようにします。 このオブジェクトの役割は、入力データを変換し、各チャネルを独立した時系列として扱えるようにすることです。これにより、後続の局所畳み込み処理を適用できるようになります。
   int index = 0;
   if(!cToVarSeq.Init(0, index, OpenCL, count, variables, optimization, iBatch))
      return false;
次に、局所エンコーディングをおこなうcProjectingオブジェクトを初期化します。 これは、固定幅3、ストライド1のウィンドウを用いて時系列の各チャネルを走査する畳み込み層であり、「注意深い観察者」として機能します。 その役割は、短期的な局所パターンを特定し、それらを固定次元のembedding_size空間で表現することです。
   index++;
   if(!cProjecting.Init(0, index, OpenCL, 3, 1, embedding_size, count - 2, variables,
                                                               optimization, iBatch))
      return false;
   cProjecting.SetActivationFunction(SoftPlus);
処理はあくまでもチャネル単位で厳密に行われる点を強調しておくことが重要です。各チャネルは独立して分析されるため、モデルはそれぞれの信号の特性に適応できます。 さらに、各チャネルにはそれぞれ固有の畳み込みフィルターセットが用意されており、これによって処理に非常に高い柔軟性と精度がもたらされます。
この演算の結果、次元が[C * T' * D]のテンソルが得られます。ここで、
- Cはチャネル(特徴量)の数
- T'はウィンドウサイズ3の畳み込み後の時間軸の長さ
- Dはエンコーディング後の新しい表現の次元
このテンソルは、元のデータを局所的に圧縮し、部分的に構造化した形式であり、以降のセグメンテーションと集約の基盤となります。 これにより、各特徴量における短期的なダイナミクスを凝縮したスナップショットが得られます。このような情報は、従来の時系列分析手法では、煩雑で計算リソースを大量に消費する変換をおこなわなければ、ほとんど捉えることができません。
次はセグメンテーションの段階です。 ここで、ひとつ注意すべき点があります。 この文脈におけるセグメンテーションとは、時間軸に沿ってデータを分割し、シーケンスを固定長のセグメントに分ける処理を指します。 しかし、前のステップで得られた畳み込みの結果はテンソルとして表現されており、時間軸は第2次元に位置しています。 その後の処理を容易にし、後続の層のアーキテクチャに合わせるために、軸の順序を入れ替える必要があります。
そこで、3次元テンソルの転置オブジェクトを使用して軸の順序を入れ替え、時間方向のセグメンテーションに適した次元配置にします。 その結果、構造が[C * D * T']のテンソルが得られます。
   index++;
   if(!cToVarProjSeq.Init(0, index, OpenCL, variables, count-2, embedding_size, optimization, iBatch))
      return false;
このデータ表現は、扱いやすく、論理的なものです。これにより、時間方向のシーケンスを直接扱い、等しい長さのセグメントに分割して、それぞれを独立した意味的セグメントとして扱うことができます。 これは、個々の点の分析からパターンの分析へと移行するという、当初の意図に沿ったものです。
テンソルは、この新しい形式で次の段階へ進み、そこでセグメンテーションと情報集約の主要な処理がおこなわれます。 主な目的は、時系列を固定数のセグメントに分割し、それぞれのセグメントから情報量の多い表現を抽出することです。 しかし、最初に与えられるのは必要なセグメント数(patchs)だけなので、まず1つのセグメントのサイズ、つまり各パッチに含まれるタイムステップ数を計算する必要があります。
次に、セグメンテーションをおこなう畳み込み層cPatchingProjを初期化します。 この層では、計算したパッチサイズと同じ幅のウィンドウを使用し、同じサイズのストライドで時間軸に沿ってスライドさせることで、重なりのないセグメントを作成します。
   index++;
   int patch_size = (int(count + patchs) - 3) / int(patchs);
   if(!cPatchingProj.Init(0, index, OpenCL, patch_size, patch_size, patch_filters,
                        patchs, variables * embedding_size, optimization, iBatch))
      return false;
   cPatchingProj.SetActivationFunction(SoftPlus);
ここで重要なのは、単純な平均プーリングとは異なり、複数のフィルター(patch_filters)を用いた本格的な畳み込み演算を使用している点です。 これにより、モデルはセグメント内の情報を単に平均化するのではなく、特徴的な局所パターンに反応しながら、各セグメントから最も関連性の高い特徴量を抽出できます。
テンソルがcPatchingProj層を通過すると、形状[C × D × P × F]の4次元テンソルが得られます。ここで、
- Pはセグメント(パッチ)の数
- Fは各パッチに適用されるフィルターの数
このテンソルには、すべてのフィルターにわたる、各チャネルの各セグメントの拡張された表現が含まれています。 ただし、後続の処理では、このデータを集約する必要があります。 ここで、最後の次元、すなわちフィルター軸Fに沿って、最大プーリングを適用します。 この演算では、各次元で最も顕著な値を選択することで、冗長なフィルターや活性化の弱いフィルターを除外できます。 これにより、テンソルの次元は[C × D × P]となります。
   index++;
   if(!cProof.Init(0, index, OpenCL, patch_filters, patch_filters,
            patchs*variables*embedding_size, optimization, iBatch))
      return false;
//---
   return true;
  }
最終的なデータ変換は、先ほど初期化した親クラスを使用しておこなわれます。 したがって、このメソッドは、各演算の結果を表すブール値を呼び出し元のプログラムに返して終了します。
CNeuronMantisPatchingアーキテクチャは、高度なモジュール性を備えるように設計されています。 各内部層はチャネルを独立して処理するため、このアーキテクチャは非常に高い拡張性を備えています。 分析対象のチャネル数にかかわらず、各チャネルは独立したデータストリームとして扱われるため、処理ロジックは変わりません。
さらに、この独立した構造により、計算を効率的に並列化することができます。 使用されるすべてのニューラルレイヤーは OpenCLで実装されているため、利用可能なGPUやその他の互換性のある計算デバイスを自動的に活用します。 これにより、それぞれが個別のチャネルを処理する数百のスレッドを、実行時間への目立った影響なしに同時に実行できます。
初期化メソッドの構造を分析する際に、CNeuronMantisPatchingクラスの主要なロジックと、内部コンポーネント間の相互作用について詳しく説明しました。 このメソッドでは、マルチチャネル時系列を処理するための主要な段階が、初期の転置からセグメンテーション、情報の集約に至るまで、順次構築されます。
この記事に不要な詳細を詰め込みすぎないよう、順方向パス(feedForward)と逆方向パス(calcInputGradients、updateInputWeights)の説明は意図的に省略しました。 これらの処理では、構築されたパイプラインのアーキテクチャに従って、内部オブジェクトの同名メソッドが順次呼び出されます。
このクラスの完全なソースコードは、すべてのヘルパーメソッドの実装を含め、添付ファイルに収録されています。 読者は必要に応じてコードを確認し、技術的な詳細をさらに深く掘り下げることができます。
アテンションモジュール
Mantisフレームワークの基本的なロジックに従い、前処理済みの時系列シーケンスがTransformerモジュールに入力されます。このシーケンスは、個々のチャネルのパッチから構成されたトークンの形式になっています。 ここで、時間情報とチャネル間情報の最終的な処理がおこなわれます。具体的には、トークン列に特別なクラストークンが追加され、位置エンコーディングが組み込まれます。
クラストークンは、一種の情報集約器として機能します。 マルチヘッド自己アテンション(Self-Attention)機構の6層を通過する過程で、シーケンス全体の構造情報を集約します。 対応する出力ベクトルは、分析対象の時系列のクラス識別子として解釈されます。これは、市場局面の認識、インジケーターの状態分類、将来の値動きのタイプの予測など、タスクの種類を問いません。
私たちの実装では、この段階にいくつかの変更を加えました。 まず、位置エンコーディングを除外しました。 その理由は、Mamba4Castアーキテクチャから取り入れた組み込みの時間エンコーディングによって、シーケンスの時間構造がすでにトークン自体に明示的にエンコードされているためです。 このアプローチでは、従来のTransformerで一般的な正弦波位置ベクトルや学習可能な位置ベクトルを使用することなく、各チャネル内の要素の絶対位置と相対位置をエンコードできます。
この変更には、2つの利点があります。 第一に、入力シーケンスのずれや歪みに対するモデルの感度が低下します。 第二に、固定された位置コードと、データ内にすでに存在する実際の時間的コンテキストとの間の矛盾を解消できます。 実際の市場時系列に適用した場合、これによりモデルの頑健性が向上し、Transformerが入力信号の内容に集中できるようになります。
さらに、原論文でのMantisの実装では、Transformerの出力としてクラストークンのみが使用されます。これは、シーケンス全体に関する一般化された情報を蓄積するための特別なベクトルです。 このトークンは入力シーケンスの先頭に付加され、Transformerのすべての層を通過した後、出力から抽出されます。
一方、私たちの実装では、別の方法を採用しました。 従来のように、シーケンスの先頭にクラストークンを挿入してから抽出するのではなく、クロスアテンションモジュール(Cross-Attention)を使用します。 この構成の特徴は、クラストークンをメインクエリ(query)として与え、ソースシーケンスのトークンをコンテキスト(keysおよびvalues)として与える点にあります。 この構成により、クラストークンはシーケンス内の最も重要な要素に集中し、ノイズを最小限に抑えながら、関連性の高い結び付きを強化できます。
さらに、各チャネルを独立して分析する、独立チャネル型のクロスアテンションも適用しました。 これにより、アテンションに対する各チャネルの寄与を個別に評価できます。 このアプローチは、マルチモーダル信号や異種の信号を分析する際に特に有用です。特定のチャネルが他のチャネルを支配するのを防ぎ、時系列全体の構造を客観的に集約して捉えることができるためです。
このように、クロスアテンションブロックが生成する最終的な集約ベクトルには、時間構造全体を一般化し、バランスよく表現した情報がすでに含まれており、後続の分類や予測に利用できます。
技術的には、これらの処理はすべて、CNeuronSoftMaxOCLを継承するCNeuronMantisAttentionUnitクラスに実装されています。 つまり、出力から、分析対象のシーケンスが特定のクラスに属する確率が直ちに得られます。 新しいオブジェクトの構造を以下に示します。
class CNeuronMantisAttentionUnit :  public CNeuronSoftMaxOCL
  {
protected:
   CNeuronBaseOCL                cClassToken[2];
   CNeuronMVCrossAttentionMLKV   cAttention;
   //---
   virtual bool      feedForward(CNeuronBaseOCL *NeuronOCL) override;
   virtual bool      updateInputWeights(CNeuronBaseOCL *NeuronOCL)  override;
   virtual bool      calcInputGradients(CNeuronBaseOCL *NeuronOCL)  override;

public:
                     CNeuronMantisAttentionUnit(void) {};
                    ~CNeuronMantisAttentionUnit(void) {};
   //---
   virtual bool      Init(uint numOutputs, uint myIndex, COpenCLMy *open_cl,
                          uint token_size, uint window, uint window_key, uint heads,
                          uint units_count, uint layers, uint variables,
                          ENUM_OPTIMIZATION optimization_type, uint batch);
   //---
   virtual bool      Save(int const file_handle) override;
   virtual bool      Load(int const file_handle) override;
   //---
   virtual int       Type(void)  override const {  return defNeuronMantisAttentionUnit; }
   //---
   virtual void      SetOpenCL(COpenCLMy *obj) override;
   virtual bool      WeightsUpdate(CNeuronBaseOCL *source, float tau) override;
  };
新しいクラスの内部には、2つの主要なコンポーネントがあります。
- cClassToken[2]は、学習可能なクラストークンを生成するための2層のMLP
- cAttentionは、多層クロスアテンションオブジェクト本体
すべての内部オブジェクトは静的に宣言されているため、クラスのコンストラクタとデストラクタは空のままにできます。 いつものように、内部オブジェクトはInitメソッド内で初期化されます。
bool CNeuronMantisAttentionUnit::Init(uint numOutputs, uint myIndex, COpenCLMy *open_cl,
                                      uint token_size, uint window, uint window_key,
                                      uint heads, uint units_count, uint layers, uint variables,
                                      ENUM_OPTIMIZATION optimization_type, uint batch)
  {
   if(!CNeuronSoftMaxOCL::Init(numOutputs, myIndex, open_cl, token_size, optimization_type, batch))
      return false;
ここでは、まず同名の親クラスのメソッドを呼び出します。このメソッドでは、ご存じのとおり、継承されたオブジェクトとインターフェイスの初期化がすでに処理されています。 親クラスのメソッドが正常に完了したら、内部オブジェクトの初期化に進みます。 最初に、学習可能なクラストークンを生成するためのMLPを初期化します。 第1層は常に値が固定された単一の要素を持ち、第2層では学習可能なパラメータを使用して、必要なサイズのクラストークンを生成します。
   int index = 0;
   if(!cClassToken[0].Init(token_size, index, OpenCL, 1, optimization, iBatch))
      return false;
   if(!cClassToken[0].getOutput().Fill(1))
      return false;
   index++;
   if(!cClassToken[1].Init(0, index, OpenCL, token_size, optimization, iBatch))
      return false;
   cClassToken[1].SetActivationFunction(SIGMOID);
指定した値の範囲内でトークンの各要素を得るため、最終層にはシグモイド活性化関数を使用します。
次に、クロスアテンションブロックを初期化します。 初期化メソッドのパラメータを通じて、すべての設定データをユーザーから受け取ります。
   index++;
   if(!cAttention.Init(0, index, OpenCL, token_size, window_key, heads * variables, window,
                       heads, 1, units_count, layers, 1, 1, variables, optimization, iBatch))
      return false;
//---
   return true;
  }
そして、処理結果のブール値を呼び出し元のプログラムに返して、メソッドを終了します。
feedForwardメソッドも同様に簡潔です。 メソッドのパラメータとして、分析対象のシーケンスのコンテキストオブジェクトへのポインタを受け取り、まずその有効性を確認します。
bool CNeuronMantisAttentionUnit::feedForward(CNeuronBaseOCL *NeuronOCL)
  {
   if(!NeuronOCL)
      return false;
次に、クラストークンを生成する必要があります。 ただし、この処理はモデルの学習中にのみ実行されます。 モデルのパラメータは動作中には変化しないため、クラストークンも固定されたままです。 また、反復のたびに再生成する必要はありません。
//---
   if(bTrain)
     {
      if(!cClassToken[1].FeedForward(cClassToken[0].AsObject()))
         return false;
     }
生成したクラストークンを、分析対象のシーケンスのコンテキストとともにアテンションブロックに入力します。
   if(!cAttention.FeedForward(cClassToken[1].AsObject(), NeuronOCL.getOutput()))
      return false;
アテンションブロックの出力、すなわち情報が付加されたクラストークンを、親クラスであるCNeuronSoftMaxOCLの入力に渡します。 この処理によって、予測値が確率的な解釈に変換されます。 その結果、各クラスに対する確率分布が得られます。
   if(!CNeuronSoftMaxOCL::feedForward(cAttention.AsObject()))
      return false;
//---
   return true;
  }
最後に、逆伝播のメソッド(calcInputGradients および updateInputWeights)では、ネストされた各コンポーネントの対応する関数を順番に呼び出す処理が実装されていることを述べておきます。 CNeuronMantisAttentionUnitモジュールにおける学習と重み更新のプロセスを十分に理解するために、読者はそれらの実装を自分で確認できます。 このクラスとすべてのメソッドの完全なコードは、添付ファイルに記載されています。
本日予定していた作業はすべて完了しました。 次回の記事では、モデルのアーキテクチャを検討し、実際の過去データを用いて、実装したソリューションの有効性を評価します。
結論
最初のデータ準備から始まり、一次差分の計算、特徴量の連結、CMamba4CastEmbeddingに基づく時間エンコーディングを経て、複雑なパッチ処理、さらにクラストークンを用いたクロスアテンションによる高度な集約まで、一連の処理を実装しました。 この処理チェーンの各段階では、転置や局所畳み込みから、最大プーリング、マルチヘッドアテンションに至るまで、時間的ダイナミクスを可能な限り完全に捉えながら、OpenCLによる並列処理を重視して計算リソースを最適化できるよう、慎重に設計されています。
その結果、基盤となるロジックを変更することなく、チャネル数、パッチサイズ、埋め込みの深さ、アテンションヘッド数を容易に調整できるモジュール型アーキテクチャが実現しました。 これにより、高頻度取引から長期トレンドの分析まで、幅広い金融シナリオにモデルを迅速に適応させることが可能になります。
次回は、ここまでに説明したコンポーネントに基づく学習可能なモデル全体の構成図を示し、過去のデータを用いた実験結果を紹介します。
参考文献
- Mantis: Lightweight Calibrated Foundation Model for User-Friendly Time Series Classification
- 本連載の他の記事
本記事で使用したプログラム
| # | 名前 | 種類 | 説明 |
|---|---|---|---|
| 1 | Research.mq5 | EA | サンプル収集用EA |
| 2 | ResearchRealORL.mq5 | EA | サンプル収集用EA(Real-ORL手法) |
| 3 | StudyContrast.mq5 | EA | 対照学習エンコーダー学習用EA |
| 4 | Study.mq5 | EA | モデルのオフライン学習用EA |
| 5 | StudyOnline.mq5 | EA | モデルのオンライン学習用EA |
| 6 | Test.mq5 | EA | モデルテスト用EA |
| 7 | Trajectory.mqh | クラスライブラリ | システム状態とモデルアーキテクチャを記述するための構造体 |
| 8 | NeuroNet.mqh | クラスライブラリ | ニューラルネットワークを作成するためのクラスライブラリ |
| 9 | NeuroNet.cl | ライブラリ | OpenCLプログラムコードのライブラリ |
MetaQuotes Ltdによってロシア語から翻訳されました。
元の記事: https://www.mql5.com/ru/articles/18307
警告: これらの資料についてのすべての権利はMetaQuotes Ltd.が保有しています。これらの資料の全部または一部の複製や再プリントは禁じられています。
この記事はサイトのユーザーによって執筆されたものであり、著者の個人的な見解を反映しています。MetaQuotes Ltdは、提示された情報の正確性や、記載されているソリューション、戦略、または推奨事項の使用によって生じたいかなる結果についても責任を負いません。
 取引におけるニューラルネットワーク:クロスドメイン時系列予測フレームワーク「TimeFound」
 初級から中級まで:オブジェクト(II)
 エラー 146 (「トレードコンテキスト ビジー」) と、その対処方法
 市場シミュレーション(第22回):SQL入門(V)

- 無料取引アプリ
- 8千を超えるシグナルをコピー
- 金融ニュースで金融マーケットを探索