

Neuronale Netze im Handel: Eine intelligente Prognosepipeline (Fazit)
 21
 4

Einleitung
Das Time-MoE-Framework bietet einen völlig neuen Ansatz für die Arbeit mit Zeitreihen. Im Gegensatz zu herkömmlichen Modellen bewahrt es dank punktbasierter Tokenisierung die vollständigen Informationen zu jedem Tick oder jeder Kerze und reichert diese atomaren Token anschließend mithilfe der SwiGLU-Einbettung an, die sowohl sanfte Trendbewegungen als auch starke Volatilitätssprünge erfassen kann.
Die Kernidee der Autoren besteht darin, innerhalb des Decoder-only-Transformers ein sparse Mixture-of-Experts-Modell zu verwenden, bei dem für jedes Token dynamisch die relevantesten Experten ausgewählt werden; zusammen mit einem stets vorhandenen, gemeinsam genutzten Experten, bilden sie eine wirklich adaptive und skalierbare Architektur. Die Ausgaben mehrerer Prognoseköpfe runden das Bild ab und ermöglichen es, Prognosen für verschiedene Horizonte gleichzeitig zu erstellen – vom nächsten Tick bis zum wöchentlichen Trend.
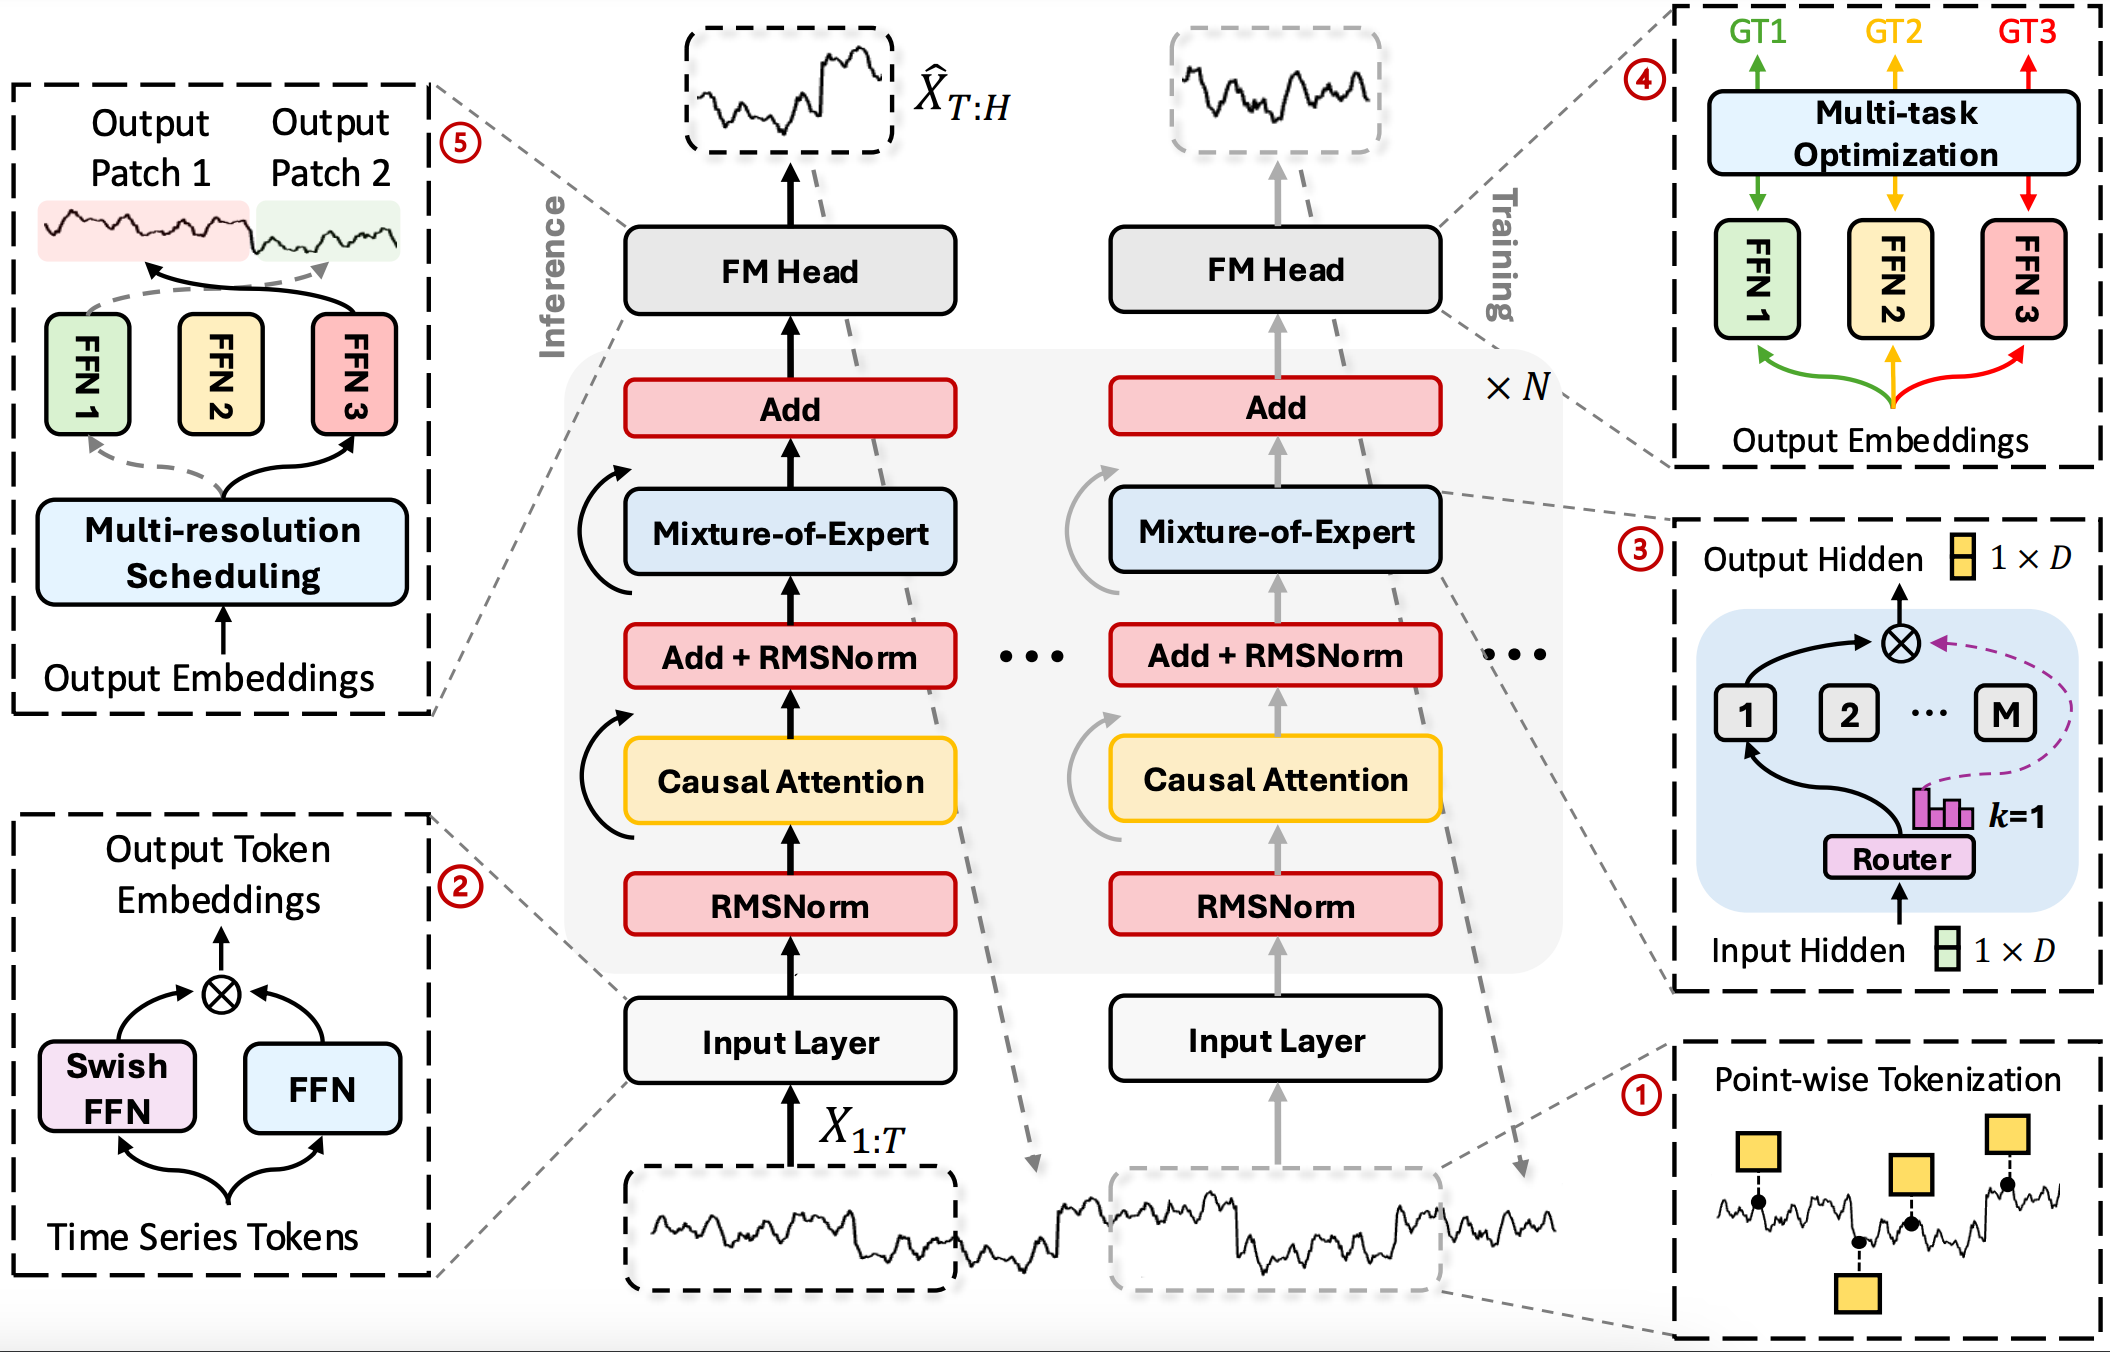
Im ersten Artikel zum Time-MoE-Framework haben wir Schritt für Schritt erläutert, wie sich die abstrakten Ideen aus der Originalarbeit „Time-MoE: Billion-Scale Time Series Foundation Models with Mixture of Experts“ in funktionierenden MQL5-Code umsetzen lassen. Wir haben das Modul CNeuronSwiGLUOCL entwickelt, das Rohdaten durch die Kombination zweier Projektionen in verborgene Vektoren umwandelt.
Im zweiten Teil haben wir uns auf den Mechanismus des sparse Mixture-of-Experts-Modells konzentriert und diesen als einzelnes Modul, CNeuronTimeMoESparseExperts, implementiert, in dem wir individuelle und gemeinsame Datenverarbeitungspfade, einen Top-K-Router und ein Sigmoid-Gate für den gemeinsam genutzten Experten kombiniert haben.
Nun ist es an der Zeit, all diese Elemente zu einem vollständigen Modell zusammenzufügen und dessen Training einzurichten. Abschließend werden wir das trainierte Modell anhand echter historischer Daten testen.
Attention-Modul
Bevor wir mit dem Aufbau der vollständigen Modellarchitektur beginnen, müssen wir eine kleine, aber äußerst wichtige Anpassung vornehmen: Wir müssen den standardmäßigen Feedforward-Block in der Transformer-Architektur durch das von uns erstellte Modul für ein sparse Mixture-of-Experts-Modell ersetzen. Zur Erinnerung: Time-MoE basiert auf einer reinen Decoder-Architektur, in der Cross-Attention eine zentrale Rolle spielt, wodurch der Decoder Informationen aus der Kontextschicht berücksichtigen kann.
Dazu wählen wir die vorgefertigte Cross-Attention-Komponente CNeuronCrossDMHAttention als Basisklasse aus; sie stellt alle erforderlichen Mechanismen bereit. Unsere Aufgabe besteht lediglich darin, den Feedforward-Block durch einen Aufruf von CNeuronTimeMoESparseExperts zu ersetzen. Die Struktur des neuen Objekts CNeuronTimeMoEAttention ist unten dargestellt.
class CNeuronTimeMoEAttention   :  public CNeuronCrossDMHAttention
  {
protected:
   //---
   virtual bool      feedForward(CNeuronBaseOCL *NeuronOCL) override;
   virtual bool      feedForward(CNeuronBaseOCL *NeuronOCL, CBufferFloat *SecondInput) override
                            { return        feedForward(NeuronOCL); }
   virtual bool      calcInputGradients(CNeuronBaseOCL *prevLayer) override;
   virtual bool      calcInputGradients(CNeuronBaseOCL *NeuronOCL, CBufferFloat *SecondInput,
                     CBufferFloat *SecondGradient, ENUM_ACTIVATION SecondActivation = None) override
                            { return        calcInputGradients(NeuronOCL); }
   virtual bool      updateInputWeights(CNeuronBaseOCL *NeuronOCL) override;
   virtual bool      updateInputWeights(CNeuronBaseOCL *NeuronOCL, CBufferFloat *SecondInput) override
                            { return        updateInputWeights(NeuronOCL); }

public:
                     CNeuronTimeMoEAttention(void)  {};
                    ~CNeuronTimeMoEAttention(void)  {};
   //---
   virtual bool      Init(uint numOutputs, uint myIndex, COpenCLMy *open_cl,
                          uint window, uint window_key, uint units_count,
                          uint window_cross, uint units_cross,
                          uint heads, uint layers,
                          uint experts, uint experts_dimension, uint topK,
                          ENUM_OPTIMIZATION optimization_type, uint batch);
   //---
   virtual int       Type(void) override   const   {  return defNeuronTimeMoEAttention; }
  };
Es ist anzumerken, dass das CNeuronCrossDMHAttention-Objekt auf dem Prinzip einer dynamischen internen Architektur basiert. Das bedeutet, dass die Schlüsselkomponenten des Moduls nicht fest in der Klassenstruktur verankert sind, sondern bei der Initialisierung dynamisch in der erforderlichen Anzahl erstellt werden. Die Klassenstruktur enthält lediglich ein dynamisches Array zum Speichern von Zeigern auf diese Objekte, wodurch es möglich ist, die interne Struktur bei Bedarf buchstäblich neu zu gestalten, ohne den gesamten Code ändern zu müssen: Es reicht aus, die Logik in der Init-Methode anzupassen.
Die übrigen Methoden werden einfach von der übergeordneten Klasse geerbt oder erfordern nur geringfügige Änderungen. Dieser Ansatz bietet ein Höchstmaß an Flexibilität und Wiederverwendbarkeit, sodass sich neue Varianten des Moduls ganz einfach durch Ändern der Initialisierungsparameter erstellen lassen. Genau aus diesem Grund konzentrieren wir uns voll und ganz auf die Initialisierungsmethode – hier entsteht die interne Struktur unseres Aufmerksamkeitsmoduls, einschließlich des MoE-Blocks.
bool CNeuronTimeMoEAttention::Init(uint numOutputs, uint myIndex, COpenCLMy *open_cl,
                                   uint window, uint window_key, uint units_count,
                                   uint window_cross, uint units_cross, uint heads,
                                   uint layers, uint experts, uint experts_dimension,
                                   uint topK, ENUM_OPTIMIZATION optimization_type, uint batch)
  {
   if(!CNeuronBaseOCL::Init(numOutputs, myIndex, open_cl, window * units_count,
                                                     optimization_type, batch))
      return false;
Im Methodenkörper rufen wir zunächst die gleichnamige Methode der neuronalen Basisschicht auf. Auf diese Weise können wir das Grundgerüst des Moduls erstellen. Und hier wird es erst richtig spannend. Wir bereiten das Array cLayers für die internen Schichten vor und binden es an unsere OpenCL-Schnittstelle.
cLayers.Clear();
cLayers.SetOpenCL(OpenCL);
CNeuronRelativeSelfAttention *attention = NULL;
CNeuronRelativeCrossAttention *cross = NULL;
CNeuronTimeMoESparseExperts *MoE = NULL;
bool use_self = units_count > 0;
int layer = 0;
Und gleich zu Beginn definieren wir die erforderlichen lokalen Variablen. Damit ist die Vorbereitungsphase abgeschlossen.
Anschließend durchlaufen wir die angegebene Anzahl interner Schichten (layers) in einer Schleife und bauen dabei schrittweise eine einzige Kette auf. Befindet sich mehr als ein Token im Hauptinformationsstrom, erstellen und initialisieren wir zunächst das Self-Attention-Modul und fügen es zu cLayers hinzu. Dadurch kann der Decoder seine Aufmerksamkeit zunächst auf die bereits generierten Tokens richten, bevor er auf externe Kontextquellen zurückgreift.
for(uint i = 0; i < layers; i++)
  {
   if(use_self)
     {
      attention = new CNeuronRelativeSelfAttention();
      if(!attention ||
         !attention.Init(0, layer, OpenCL, window, window_key, units_count, heads,
                                                          optimization, iBatch) ||
         !cLayers.Add(attention)
        )
        {
         delete attention;
         return false;
        }
      layer++;
     }
Als Nächstes erstellen wir einfach ein Cross-Attention-Modul, das Informationen aus der vorherigen Schicht mit dem Kontext kombiniert. Dabei übergeben wir ihm direkt die Fensterparameter und die Anzahl der Attention-Köpfe. Es ist sofort einsatzbereit und kann Abfragen, Schlüssel und Werte berechnen. Innerhalb der Schleife wird im Schichtenarray ein Zeiger auf jedes dieser Objekte gespeichert, als würden wir aus einzelnen Gliedern eine einzige Verarbeitungskette zusammensetzen.
cross = new CNeuronRelativeCrossAttention();
if(!cross ||
   !cross.Init(0, layer, OpenCL, window, window_key, units_count, heads,
                     window_cross, units_cross, optimization, iBatch) ||
   !cLayers.Add(cross)
  )
  {
   delete cross;
   return false;
  }
layer++;
Das eigentliche Highlight folgt jedoch direkt nach Cross-Attention: Wir erstellen eine Instanz von CNeuronTimeMoESparseExperts. Hier konfigurieren wir unseren MoE-Block: Wir legen die Anzahl der Experten, die Größe ihrer Projektionen (also die Anzahl der Merkmale, die jeder Experte verarbeitet) sowie den Parameter topK fest, der bestimmt, wie viele Experten in jedem Durchlauf aktiviert werden. Und natürlich dürfen wir die Verbindung zum OpenCL-Kontext nicht vergessen.
 MoE = new CNeuronTimeMoESparseExperts();
 if(!MoE ||
    !MoE.Init(0, layer, OpenCL, window, experts_dimension, units_count, 1,
                                   experts, topK, optimization, iBatch) ||
    !cLayers.Add(MoE)
   )
   {
    delete MoE;
    return false;
   }
 layer++;
}
Sobald die Initialisierungsschleife für alle Schichten abgeschlossen ist, verbinden wir die Ergebnispuffer der letzten Schicht mit den externen Schnittstellen des Objekts.
   SetOutput(MoE.getOutput(), true);
   SetGradient(MoE.getGradient(), true);
//---
   return true;
  }
Im Ergebnis verwandelt die Init-Methode einen leeren Container in einen lebendigen Organismus aus drei Schichttypen, die in einer festen Reihenfolge angeordnet sind, ohne dabei die zugrunde liegenden Aufmerksamkeitsmechanismen auch nur ein einziges Mal zu verändern. Die gesamte Dynamik entsteht ausschließlich durch das Hinzufügen neuer Elemente und deren parametrische Konfiguration – ein klassisches Beispiel für eine flexible Architektur, die nur minimalen Wartungsaufwand erfordert.
Aber es gibt einen Haken. Das Cross-Attention-Modul benötigt zwei Informationsströme: den Hauptstrom und den Kontextstrom. Im Time-MoE-Framework gibt es jedoch nur einen. Dieses Problem wird mit minimalen Eingriffen in die Kernmechanismen gelöst. Wir überschreiben einfach die Methoden für den Vorwärts- und Rückwärtsdurchlauf, die einen einzelnen Informationsstrom als Eingabe entgegennehmen und ihn in zwei Richtungen weiterleiten.
bool CNeuronTimeMoEAttention::feedForward(CNeuronBaseOCL *NeuronOCL)
  {
   if(!NeuronOCL)
      return false;
   return CNeuronCrossDMHAttention::feedForward(NeuronOCL, NeuronOCL.getOutput());
  }
Auf den ersten Blick verwandelt diese Operation das Cross-Attention-Modul in ein Self-Attention-Modul. Unsere Idee ist es jedoch, nur die Token aus dem letzten Zeitschritt durch den Hauptinformationsstrom weiterzuleiten. Dies wird dadurch erreicht, dass die Anzahl der im Hauptinformationsstrom analysierten Elemente reduziert wird. Über den Kontextinformationsstrom leiten wir sämtliche Informationen weiter, sodass die Token im Hauptinformationsstrom mit dem gesamten historischen Kontext angereichert werden können. Dadurch bleiben alle Vorteile der Decoder-only-Architektur von Time-MoE erhalten: Jedes neue Token holt sich Rat von den Experten zu seinem eng begrenzten Unterraum und stützt sich gleichzeitig auf die gesamte bisher erfasste Marktdynamik.
Der vollständige Code für diese Klasse und alle ihre Methoden ist im Anhang enthalten.
Modellarchitektur
Nachdem nun alle erforderlichen Komponenten implementiert wurden, machen wir uns endlich daran, die vollständige Architektur der trainierbaren Modelle aufzubauen. Wie bereits in früheren Arbeiten basiert das Projekt weiterhin auf dem Actor–Director–Critic-Framework, das sich bei Aufgaben des bestärkenden Lernens bewährt hat. Innerhalb dieses Frameworks integrieren wir alle unsere Entwicklungen im Zusammenhang mit Time-MoE in den Encoder für den Umgebungszustand – den Teil des Modells, der für die Erzeugung einer semantisch reichhaltigen Repräsentation der Eingabedaten zuständig ist.
An dieser Stelle ergibt sich jedoch ein wichtiger Punkt. Die von uns verwendete Gesamtpipeline verfügt nur über eine einzige Modellausgabe – einen universellen Merkmalsvektor, der von allen Komponenten verwendet wird: Actor, Director und Critic. Gleichzeitig umfasst die Time-MoE-Architektur der Autoren mehrere Prognoseköpfe, die jeweils mit einem unterschiedlichen Planungshorizont arbeiten. Dies führt zu einem potenziellen Konflikt. Die Zusammenführung aller Ausgaben in einem einzigen Puffer erschwert das Training und beeinträchtigt die Interpretierbarkeit.
Wir haben beschlossen, nicht alles in einer einzigen Struktur zusammenzufassen. Stattdessen wurde eine klare logische Trennung zwischen dem Encoder und den Prognoseköpfen vorgenommen. Der Encoder (Time-MoE) fungiert als universeller Mechanismus zur Merkmalsextraktion – er ist eine einzige, von allen Prognoseköpfen gemeinsam genutzte Komponente. Anschließend wird für jeden Planungshorizont ein eigenes Modell erstellt, das die Ausgaben des Encoders als Eingabe erhält und eine Prognose für seine jeweilige Aufgabe erzeugt.
Dieser Ansatz bietet konkrete Vorteile: Wir behalten eine einzige trainierbare Einheit für die Informationsgewinnung bei und gewährleisten gleichzeitig Unabhängigkeit und Flexibilität auf der Prognoseebene. Jeder Prognosekopf ist für seine eigene Zeitskala verantwortlich und kann sich dadurch an die entsprechende Charakteristik der Marktschwankungen anpassen. Dadurch bleibt die Architektur modular und skalierbar und lässt sich gleichzeitig sehr gut an die Struktur des zeitlichen Kontexts anpassen.
Nachdem wir die allgemeine Logik des Rahmenwerks festgelegt haben, wenden wir uns der Gestaltung der Architektur der trainierbaren Modelle zu, wobei jedes Teilsystem nach einem einheitlichen Prinzip aufgebaut ist. Dies sorgt für strukturelle Übersichtlichkeit und ermöglicht eine flexible Skalierung des Modells entsprechend den Anforderungen der Handelslogik.
Die gesamte Initialisierung erfolgt in der Methode CreateDescriptions, die die Architekturen Schicht für Schicht aufbaut, beginnend mit dem Encoder.
bool CreateDescriptions(CArrayObj *&encoder,
                        CArrayObj *&forecast1,
                        CArrayObj *&forecast2,
                        CArrayObj *&forecast3,
                        CArrayObj *&actor,
                        CArrayObj *&director,
                        CArrayObj *&critic
                       )
  {
//---
   CLayerDescription *descr;
//---
   if(!encoder)
     {
      encoder = new CArrayObj();
      if(!encoder)
         return false;
     }
   if(!forecast1)
     {
      forecast1 = new CArrayObj();
      if(!forecast1)
         return false;
     }
   if(!forecast2)
     {
      forecast2 = new CArrayObj();
      if(!forecast2)
         return false;
     }
   if(!forecast3)
     {
      forecast3 = new CArrayObj();
      if(!forecast3)
         return false;
     }
   if(!actor)
     {
      actor = new CArrayObj();
      if(!actor)
         return false;
     }
   if(!director)
     {
      director = new CArrayObj();
      if(!director)
         return false;
     }
   if(!critic)
     {
      critic = new CArrayObj();
      if(!critic)
         return false;
     }
Die historischen Markt-Rohdaten werden in den Encoder eingespeist. Die erste Schicht ist lediglich ein Basisobjekt, das im Wesentlichen als Schnittstelle zum Abrufen von Daten dient. Als Nächstes folgt eine Schicht zur Batch-Normalisierung mit hinzugefügtem Rauschen, die die Verteilung der Eingabewerte stabilisiert, für eine gewisse Datenaugmentation sorgt und hilft, eine Überanpassung des Modells zu verhindern.
//--- Encoder
   encoder.Clear();
//--- Input layer
   if(!(descr = new CLayerDescription()))
      return false;
   descr.type = defNeuronBaseOCL;
   uint prev_count = descr.count = (HistoryBars * BarDescr);
   descr.activation = None;
   descr.optimization = ADAM;
   if(!encoder.Add(descr))
     {
      delete descr;
      return false;
     }
//--- layer 1
   if(!(descr = new CLayerDescription()))
      return false;
   descr.type = defNeuronBatchNormWithNoise;
   descr.count = prev_count;
   descr.batch = BatchSize;
   descr.activation = None;
   descr.optimization = ADAM;
   if(!encoder.Add(descr))
     {
      delete descr;
      return false;
     }
Anschließend kommt eine ConcatDiff-Schicht zum Einsatz, die Kanäle mit Differenzwerten hinzufügt, indem sie jeden Balken in seine Bestandteile zerlegt und die Datenstruktur für eine komplexere Verarbeitung vorbereitet.
//--- layer 2
   if(!(descr = new CLayerDescription()))
      return false;
   descr.type = defNeuronConcatDiff;
   prev_count = descr.count = HistoryBars;
   descr.layers = BarDescr;
   descr.step = 1;
   descr.batch = BatchSize;
   descr.optimization = ADAM;
   descr.activation = None;
   if(!encoder.Add(descr))
     {
      delete descr;
      return false;
     }
Anschließend werden die Daten in das Modul „Mamba4CastEmbedding“ geleitet. An dieser Stelle wird die Eingabesequenz gleichzeitig mit Merkmalen mehrerer Zeitskalen angereichert. Dieser Mechanismus ermöglicht es, eine Mehrfrequenzdarstellung des Eingangssignals zu erhalten. Diese Schicht gibt ein latentes Fenster fester Länge (NSkills) aus, das anschließend eine Transpositionsschicht durchläuft. Diese bringt die Tensordimensionen in eine Form, die für die anschließende Verarbeitung unabhängiger univariater Sequenzen der einzelnen Kanäle geeignet ist.
//--- layer 3
   if(!(descr = new CLayerDescription()))
      return false;
   descr.type = defMamba4CastEmbeding;
   prev_count = descr.count = HistoryBars;
   descr.window = 2 * BarDescr;
   uint prev_out = descr.window_out = NSkills;
     {
      uint temp[] = {PeriodSeconds(PERIOD_H1), PeriodSeconds(PERIOD_D1)};
      if(ArrayCopy(descr.windows, temp) < (int)temp.Size())
         return false;
     }
   descr.batch = BatchSize;
   descr.optimization = ADAM;
   descr.activation = None;
   if(!encoder.Add(descr))
     {
      delete descr;
      return false;
     }
//--- layer 4
   if(!(descr = new CLayerDescription()))
      return false;
   descr.type = defNeuronTransposeOCL;
   descr.count = prev_count;
   prev_count = descr.window = prev_out;
   descr.batch = BatchSize;
   descr.optimization = ADAM;
   descr.activation = None;
   if(!encoder.Add(descr))
     {
      delete descr;
      return false;
     }
   prev_out = descr.count;
Als Nächstes folgt eine SwiGLU-Einbettungsschicht. Sie erhöht die Merkmalstiefe und bildet die erste Grundlage für eine abstrakte Repräsentation des Zustands.
//--- layer 5
   if(!(descr = new CLayerDescription()))
      return false;
   descr.type = defNeuronSwiGLUOCL;
   descr.count = Segments;
   descr.window = (prev_out + Segments - 1) / Segments;
   descr.variables = prev_count;
   prev_out = descr.window_out = EmbeddingSize;
   descr.batch = BatchSize;
   descr.optimization = ADAM;
   descr.activation = None;
   if(!encoder.Add(descr))
     {
      delete descr;
      return false;
     }
   prev_count = descr.count;
   uint prev_var = descr.variables;
Anschließend wird die Transpositionsschicht TransposeRCDOCL angewendet, wodurch die Dimensionen der Zeitschritte und der analysierten Kanäle neu angeordnet werden können. Dieser Vorgang ist entscheidend für die korrekte Funktion des von uns erstellten Attention-Moduls. Gerade dank dieses Vorgangs werden die Token des jüngsten Zeitschritts für alle analysierten Variablen am Anfang des Puffers gesammelt.
//--- layer 6
   if(!(descr = new CLayerDescription()))
      return false;
   descr.type = defNeuronTransposeRCDOCL;
   descr.count = prev_var;
   descr.window = prev_count;
   descr.step = prev_out;
   descr.batch = BatchSize;
   descr.optimization = ADAM;
   descr.activation = None;
   if(!encoder.Add(descr))
     {
      delete descr;
      return false;
     }
//--- layer 7
   if(!(descr = new CLayerDescription()))
      return false;
   descr.type = defNeuronBatchNormOCL;
   descr.count = prev_count * prev_out * prev_var;
   descr.batch = BatchSize;
   descr.activation = None;
   descr.optimization = ADAM;
   if(!encoder.Add(descr))
     {
      delete descr;
      return false;
     }
Darauf folgt eine Batch-Normalisierungsschicht, die die Datenverteilung stabilisiert, bevor die Daten an das Attention-Modul weitergeleitet werden.
Und nun sind wir beim zentralen Modul angelangt – TimeMoEAttention. Hierbei handelt es sich um ein Multi-Head-Attention-Modul mit zahlreichen Experten, von denen sich jeder auf einen eigenen Aspekt der zeitlichen Informationen konzentriert. Als Eingabe erhält es kompakte Token, die den aktuellen Zustand und den aus der gesamten Historie gewonnenen Kontext repräsentieren – auf diese Weise extrahieren die Token die Bedeutung aus den Daten. Die Eingabedimensionen und die Anzahl der Experten (NExperts) werden über Parameter festgelegt, und jeder Attention-Kopf wählt die Top-K-Experten aus, wodurch eine kompakte und dennoch aussagekräftige latente Repräsentation entsteht. Diese Schicht ist die letzte im Encoder und definiert den Ausgaberaum, auf den anschließend alle Prognose- und Entscheidungsmodelle zugreifen.
//--- layer 8
   if(!(descr = new CLayerDescription()))
      return false;
   descr.type = defNeuronTimeMoEAttention;
   descr.window_out = EmbeddingSize / 4;
     {
      uint temp[] = {prev_out, prev_out, 8, TopK};               //Window Main, Window Cross, Experts dimension, TopK
      if(ArrayCopy(descr.windows, temp) < ArraySize(temp))
         return false;
     }
     {
      uint temp[] = {prev_var, prev_var * prev_count, NExperts}; //Units Main, Units Cross, Experts
      if(ArrayCopy(descr.units, temp) < ArraySize(temp))
         return false;
     }
   descr.layers = 6;
   descr.step = 4;                                                // Attention heads
   descr.batch = BatchSize;
   descr.activation = None;
   descr.optimization = ADAM;
   if(!encoder.Add(descr))
     {
      delete descr;
      return false;
     }
Am Encoder-Ausgang wird ein gemeinsames latentes Array gebildet, auf das alle Modelle zugreifen können. Das erste Prognosemodell, forecast1, übernimmt dieses Array unverändert. Die Basis-Eingabeschicht nimmt den Tensor entgegen. Darauf folgt eine einfache Verarbeitung mittels Faltung, die für jeden analysierten Kanal eine Prognose für den festgelegten Planungshorizont erstellt. In diesem Fall wird nur der nächste Wert prognostiziert.
//---
   CLayerDescription *latent = descr;
//--- Forecast 1
   forecast1.Clear();
//--- Input layer
   if(!(descr = new CLayerDescription()))
      return false;
   descr.type = defNeuronBaseOCL;
   descr.count = int(latent.windows[0] * latent.units[0]);
   descr.activation = None;
   descr.optimization = ADAM;
   if(!forecast1.Add(descr))
     {
      delete descr;
      return false;
     }
//--- layer 1
   if(!(descr = new CLayerDescription()))
      return false;
   descr.type = defNeuronConvOCL;
   descr.count = latent.units[0];
   descr.window = latent.windows[0];
   descr.step = descr.window;
   descr.layers = 1;
   descr.window_out = 1;
   descr.batch = BatchSize;
   descr.optimization = ADAM;
   descr.activation = TANH;
   if(!forecast1.Add(descr))
     {
      delete descr;
      return false;
     }
An dieser Stelle lohnt es sich, einem wichtigen technischen Detail besondere Aufmerksamkeit zu schenken. Bei der vom Encoder für den Umgebungszustand durchgeführten Datenvorverarbeitung wurde der ursprüngliche Merkmalsraum bewusst erweitert. Diese Erweiterung ist notwendig, um Merkmale auf hoher Abstraktionsebene zu extrahieren und eine aussagekräftigere latente Repräsentation zu bilden. Diese Transformation führt jedoch dazu, dass die Dimensionalität der vorhergesagten Werte nicht mit der Dimensionalität der tatsächlichen Daten übereinstimmt, die wir während der Trainingsphase verwenden.
Um sicherzustellen, dass die Prognoseergebnisse korrekt auf die tatsächlichen Werte abgestimmt sind, müssen die Prognosen wieder auf den Maßstab und die Struktur des ursprünglichen Raums abgebildet werden. In diesem Fall wird dies durch eine einfache vollständig verbundene Schicht erreicht, die die Dimensionalität der Daten auf den angegebenen Wert BarDescr reduziert.
//--- layer 2
   if(!(descr = new CLayerDescription()))
      return false;
   descr.type = defNeuronBaseOCL;
   descr.count = BarDescr;
   descr.activation = TANH;
   descr.optimization = ADAM;
   if(!forecast1.Add(descr))
     {
      delete descr;
      return false;
     }
Der zweite Punkt, auf den gesondert eingegangen werden sollte, ist die Wiederherstellung der ursprünglichen Datenverteilung, die bei der Normalisierung verloren gegangen ist. Bisher haben wir zu diesem Zweck die RevIN-Schicht zur inversen Normalisierung verwendet, die die Normalisierungsparameter automatisch aus der entsprechenden Schicht im Encoder extrahiert. In der aktuellen Implementierung ist jedoch eine architektonische Einschränkung aufgetreten: Die Normalisierungsschicht befindet sich weiterhin innerhalb des Encoders für den Umgebungszustand und ist von den Prognosemodellen nicht direkt zugänglich. Mit anderen Worten: RevIN funktioniert hier schlichtweg nicht – es besteht kein Zugriff auf die Batch-Statistiken.
Auf den ersten Blick mag die Lösung paradox erscheinen: Wir verwenden erneut eine Batch-Normalisierungsschicht – allerdings nicht zur Normalisierung, sondern zur Wiederherstellung der ursprünglichen Skalierung. Ja, ja, das klingt zwar wie ein Wortspiel, aber in der Praxis ist es eine durchaus sinnvolle Methode.
Der Punkt ist, dass die BatchNorm-Architektur über zwei Ausgabeparameter verfügt: Skalierung (scale) und Bias (bias), die trainierbar sein können. Obwohl sie traditionell zur Stabilisierung und Beschleunigung des Trainings eingesetzt werden, übernehmen sie in unserem Fall eine andere Rolle – nämlich das Erlernen der inversen Transformation, die die Prognosewerte näher an die ursprüngliche Verteilung heranführt. Anstatt also Normalisierungsstatistiken zu speichern, lassen wir das Modell selbst lernen, wie es die Daten denormalisieren und sich dabei an reale Bedingungen anpassen kann.
Dieser Ansatz hat eine gewisse Eleganz: Er hält die Modellstruktur kompakt, vermeidet eine unnötige Verkomplizierung des Zustandspuffers und unterbricht – was besonders wichtig ist – den Berechnungsgraphen nicht, wodurch die vollständige Kompatibilität mit der aktuellen Backpropagation-Logik gewährleistet bleibt.
//--- layer 3
   if(!(descr = new CLayerDescription()))
      return false;
   descr.type = defNeuronBatchNorm;
   descr.count = BarDescr;
   descr.batch = BatchSize;
   descr.activation = None;
   descr.optimization = ADAM;
   if(!forecast1.Add(descr))
     {
      delete descr;
      return false;
     }
Alles ist auf maximale Effizienz ausgelegt: ein konstantes Fenster, eine einzige Schicht und eine feste Länge.
Das zweite und das dritte Prognosemodell (forecast2, forecast3) verwenden dieselben Eingabedaten wie das erste. Sie bilden dessen Architektur fast vollständig nach, unterscheiden sich jedoch durch ein längeres Prognosefenster. Die Parameter der Prognose-Faltungsschicht werden vom ersten Prognosekopf übernommen, die Anzahl der Filter wird jedoch entsprechend dem erforderlichen Planungshorizont erhöht.
//--- Forecast 2
   forecast2.Clear();
//--- Input layer
   if(!forecast2.Add(forecast1.At(0)))
      return false;
//--- layer 1
   if(!(descr = new CLayerDescription()))
      return false;
   if(!descr.Copy(forecast1.At(1)))
     {
      delete descr;
      return false;
     }
   prev_out = descr.window_out = NForecast / 2;
   if(!forecast2.Add(descr))
     {
      delete descr;
      return false;
     }
   prev_count = descr.count;
Ein weiterer technisch wichtiger Punkt betrifft die Architektur des Prognoseblocks. Am Ausgang der Faltungsschicht generiert das Modell Prognosewerte für einzelne univariate Zeitreihen, von denen jede die lokale Dynamik eines bestimmten Indikators oder Merkmals widerspiegelt. Dadurch ist die Prognosestruktur räumlich dünn besetzt, aber informationsreich.
Dies wirft die Frage auf: Wie lassen sich diese Prognosen aggregieren und in eine Form umwandeln, die mit den Quelldaten vergleichbar ist? Grundsätzlich könnte man eine klassische, vollständig verbundene Schicht verwenden – diese ist durchaus in der Lage, Informationen zu aggregieren. Mit zunehmendem Planungshorizont (und damit zunehmender Länge der Ausgabesequenz) verliert diese Implementierung jedoch an Effizienz. Die Anzahl der Parameter steigt explosionsartig an, und lokale zeitliche Abhängigkeiten gehen allmählich verloren.
Um dies zu vermeiden, transponieren wir zunächst den Tensor und ordnen die Achsen so neu an, dass die Zeitschritte zu unabhängigen Kanälen werden. Dadurch kann die nächste Faltungsschicht separat auf jeden Zeitschnitt angewendet werden. Mit anderen Worten: Anstatt die gesamte Sequenz als ein einziges Ganzes zu verarbeiten, lassen wir das Modell jeden Zeitpunkt anhand seiner eigenen Merkmale analysieren. Dieser Vorgang bietet einen doppelten Vorteil: Er reduziert die Dimensionalität der Ausgabedarstellung (und wirkt dadurch als Engpass) und bewahrt gleichzeitig die zeitliche Kohärenz zwischen den einzelnen Schritten.
//--- layer 2
   if(!(descr = new CLayerDescription()))
      return false;
   descr.type = defNeuronTransposeOCL;
   descr.window = prev_out;
   descr.count = prev_count;
   descr.batch = BatchSize;
   descr.optimization = ADAM;
   descr.activation = None;
   if(!forecast2.Add(descr))
     {
      delete descr;
      return false;
     }
//--- layer 3
   if(!(descr = new CLayerDescription()))
      return false;
   descr.type = defNeuronConvOCL;
   descr.window = prev_count;
   descr.step = prev_count;
   prev_count = descr.count = prev_out;
   descr.layers = 1;
   prev_out = descr.window_out = BarDescr;
   descr.batch = BatchSize;
   descr.optimization = ADAM;
   descr.activation = TANH;
   if(!forecast2.Add(descr))
     {
      delete descr;
      return false;
     }
Auf diese Weise wird ein effektiver Aggregationsmechanismus implementiert, ohne dass die detaillierte Struktur der Prognose verloren geht. Dies ist besonders wertvoll beim Trainieren von Modellen anhand von Daten mit hoher Multiplizität sowie bei der Verwendung von Multi-Graph-Merkmalen, bei denen jeder Zeitschnitt spezifische Informationen enthält, die sich nicht auf ein allgemeines Muster reduzieren lassen.
Der Prozess endet mit einem abschließenden Schritt der Batch-Normalisierung, durch den die ursprüngliche Datenverteilung wiederhergestellt wird.
//--- layer 4
   if(!(descr = new CLayerDescription()))
      return false;
   descr.type = defNeuronBatchNormOCL;
   descr.count = prev_count * prev_out;
   descr.activation = None;
   if(!forecast2.Add(descr))
     {
      delete descr;
      return false;
     }
Das Modell dient als Prognosemodell mit längerem Prognosehorizont, das zwar dieselben Merkmale nutzt, diese jedoch über einen längeren Prognosehorizont auswertet.
Was das dritte Prognosemodell betrifft, so entspricht dessen Architektur genau der des zweiten Modells. Der einzige Unterschied besteht in dem erweiterten Planungshorizont, der es uns ermöglicht, weiter in die Zukunft zu blicken. Ansonsten verwendet es dieselben Faltungs- und Transpositionsschichten sowie dieselbe Logik für die Dimensionsanpassung und Normalisierung. Um die Diskussion nicht mit Wiederholungen zu überfrachten, verzichten wir daher auf eine detaillierte Beschreibung und konzentrieren uns stattdessen auf Entscheidungsmodelle.
Als Nächstes folgt das Actor-Modell, das die Strategie ausführt. Als Eingabe erhält es Deskriptoren des aktuellen Kontozustands. Die daraus resultierenden Daten werden einer Standardnormalisierung unterzogen.
//--- Actor
   actor.Clear();
//--- Input layer
   if(!(descr = new CLayerDescription()))
      return false;
   descr.type = defNeuronBaseOCL;
   descr.count = AccountDescr;
   descr.activation = None;
   descr.optimization = ADAM;
   if(!actor.Add(descr))
     {
      delete descr;
      return false;
     }
//--- layer 1
   if(!(descr = new CLayerDescription()))
      return false;
   descr.type = defNeuronBatchNormOCL;
   descr.count = AccountDescr;
   descr.batch = BatchSize;
   descr.activation = None;
   descr.optimization = ADAM;
   if(!actor.Add(descr))
     {
      delete descr;
      return false;
     }
Anschließend werden sie in den CrossDMHAttention-Mechanismus eingespeist. Hierbei handelt es sich um einen Cross-Attention-Mechanismus, bei dem der Hauptstrom aus aktuellen Kontoinformationen und der Kontext aus latenten Merkmalen des Encoders besteht. Dieser Ansatz ermöglicht es dem Aufmerksamkeitsmechanismus des Modells, unter Berücksichtigung der aktuellen Situation des Nutzers die relevantesten Merkmale aus der Marktlage zu identifizieren. Innerhalb des Blocks befindet sich ein Stapel aus drei Attention-Schichten, von denen jede mehrere Attention-Köpfe verwendet.
//--- layer 2
   if(!(descr = new CLayerDescription()))
      return false;
   descr.type = defNeuronCrossDMHAttention;
     {
      uint temp[] = {AccountDescr,         // Inputs window
                    latent.windows[0]     // Cross window
                   };
      if(ArrayCopy(descr.windows, temp) < (int)temp.Size())
         return false;
     }
     {
      uint temp[] = {1,                 // Inputs units
                    latent.units[0]    // Cross units
                   };
      if(ArrayCopy(descr.units, temp) < (int)temp.Size())
         return false;
     }
   descr.step = 4;                  // Heads
   descr.window_out = 32;
   descr.batch = 1e4;
   descr.layers = 3;
   descr.activation = None;
   descr.optimization = ADAM;
   if(!actor.Add(descr))
     {
      delete descr;
      return false;
     }
Auf den Aufmerksamkeitsmechanismus folgt eine Kette aus drei vollständig verbundenen Schichten, die die resultierenden Daten in Aktionswahrscheinlichkeiten (NActions) umwandelt. Diese Ausgabe wird verwendet, um Handelsentscheidungen zu treffen.
//--- layer 3
   if(!(descr = new CLayerDescription()))
      return false;
   descr.type = defNeuronBaseOCL;
   descr.count = LatentCount;
   descr.batch = BatchSize;
   descr.activation = TANH;
   descr.optimization = ADAM;
   if(!actor.Add(descr))
     {
      delete descr;
      return false;
     }
//--- layer 4
   if(!(descr = new CLayerDescription()))
      return false;
   descr.type = defNeuronBaseOCL;
   descr.count = LatentCount;
   descr.activation = SoftPlus;
   descr.batch = BatchSize;
   descr.optimization = ADAM;
   if(!actor.Add(descr))
     {
      delete descr;
      return false;
     }
//--- layer 5
   if(!(descr = new CLayerDescription()))
      return false;
   descr.type = defNeuronBaseOCL;
   prev_count = descr.count = NActions;
   descr.activation = SIGMOID;
   descr.batch = BatchSize;
   descr.optimization = ADAM;
   if(!actor.Add(descr))
     {
      delete descr;
      return false;
     }
Somit ist die gesamte Architektur sequenziell, logisch und modular aufgebaut: von der Vorverarbeitung historischer Daten über Transformer-Mechanismen und Multi-Head-Attention bis hin zur Prognose und Entscheidungsfindung. Dieser Ansatz gewährleistet Transparenz, Zuverlässigkeit und ausreichende Flexibilität – was insbesondere für reale Handelsanwendungen von Bedeutung ist, bei denen die Architektur keine Fragmentierung zulässt. Alles ist in einem gemeinsamen latenten Raum verankert, und jedes Modell arbeitet in seinem eigenen Kontext, ohne dass dabei die globale Konsistenz verloren geht.
Die Architekturen der Modelle von Critic- und Director sind ähnlich aufgebaut wie die des Actor. Der einzige Unterschied besteht darin, dass die Eingabe nicht der Kontozustand ist, sondern ein vom Actor selbst generierter Aktionsvektor. Das Ergebnis ist eine numerische Bewertung dieser Aktionen: Für den Critic ist dies die Wertfunktion, während es für den Director ein Signalgradient aus einer binären Klassifikation (gute/schlechte Aktion) liefert. Die interne Struktur besteht aus denselben Normalisierungsblöcken, dem Cross-Attention-Mechanismus und einer Kaskade von Ausgabeschichten. Um den Text nicht mit wiederholten, bereits behandelten Details zu überfrachten, werden wir nicht näher darauf eingehen. Die vollständige Architektur aller Komponenten ist im Anhang enthalten.
Modelltraining
Der nächste Schritt unserer Arbeit ist das Trainieren der Modelle. Hier erwartet uns eine der zentralen Herausforderungen. Die Autoren des ursprünglichen Time-MoE-Frameworks trainierten ihre neuronalen Netze anhand des riesigen, wenn nicht gar kolossalen Time-300B-Datensatzes. Dieser Datensatz umfasst mehr als 300 Milliarden Zeitpunkte aus neun verschiedenen Bereichen, darunter Wirtschaft, Energie, Verkehr, Gesundheitswesen und weitere. Diese Datenmenge verleiht dem Modell eine beeindruckende Generalisierungsfähigkeit – erfordert jedoch auch Ressourcen, die in einer lokalen oder halbautomatischen Trainingsumgebung nicht zur Verfügung stehen.
Es wäre unrealistisch, einen solchen Datensatz zu Hause nachzubilden. Wenn wir uns jedoch ausschließlich auf das Online-Training anhand eingehender Daten beschränken, schaffen wir ein System, das von Natur aus nicht in der Lage ist, stabile Muster zu lernen. Dies gilt insbesondere unter Bedingungen hoher Marktvolatilität und eines begrenzten Beobachtungszeitraums.
Daher haben wir uns für eine Kompromisslösung entschieden: Wir verzichten auf die vorbereitende Phase der Erfassung eines statischen Trainingsdatensatzes, behalten aber durch das schrittweise Befüllen und Nutzen interner Zustandspuffer die Kontrolle über den Trainingsprozess. Hier stützten wir uns auf einen Mechanismus, der zuvor im Modell TimeFound getestet worden war – er erwies sich als wirksam genug, um wiederverwendet zu werden, diesmal jedoch nicht nur für das Training des Prognosemodells, sondern auch für das Training von Entscheidungsmodellen.
Der Mechanismus besteht im Wesentlichen darin, den Agenten anhand von pseudorealen Daten zu trainieren. Hier werden die tatsächlichen historischen Kursdaten aus dem Handelsterminal abgerufen, während die Handelsaktionen durch eine simulierte Umgebung bewertet werden. Der gesamte Prozess ist in der Train-Methode des Expert Advisors „…\Experts\TimeMoE\Study.mq5“ implementiert. An dieser Stelle beginnen die schrittweise Verarbeitung der historischen Daten, die Bildung von Trainingsbatches, die Erfassung des Handelskontokontexts und das sequenzielle Training des Modells mittels Backpropagation.
In der ersten Phase legt die Methode die Grenzen des Trainingszeitraums fest: Es werden der Start- und der Endindex des historischen Intervalls berechnet, auf dessen Grundlage das Training durchgeführt wird.
void Train(void)
  {
   int start = iBarShift(Symb.Name(), TimeFrame, Start);
   int end = iBarShift(Symb.Name(), TimeFrame, End);
   int bars = CopyRates(Symb.Name(), TimeFrame, 0, start, Rates);
Anschließend werden die Kursdaten geladen und die wichtigsten technischen Indikatoren initialisiert. Jeder Indikator wird auf seine Bereitschaft überprüft – sind die Berechnungen noch nicht abgeschlossen, wartet das System und legt kurze Pausen ein. Dies ist für eine stabile Initialisierung des Puffers erforderlich; andernfalls wäre die anschließende Verarbeitung schlichtweg sinnlos.
   if(!RSI.BufferResize(bars) || !CCI.BufferResize(bars) ||
      !ATR.BufferResize(bars) || !MACD.BufferResize(bars))
     {
      PrintFormat("%s -> %d", __FUNCTION__, __LINE__);
      ExpertRemove();
      return;
     }
//---
   int count = -1;
   bool calculated = false;
   do
     {
      count++;
      calculated = (RSI.BarsCalculated() >= bars &&
                    CCI.BarsCalculated() >= bars &&
                    ATR.BarsCalculated() >= bars &&
                    MACD.BarsCalculated() >= bars
                   );
      Sleep(100);
      count++;
     }
   while(!calculated && count < 100);
   if(!calculated)
     {
      PrintFormat("%s -> %d The training data has not been loaded", __FUNCTION__, __LINE__);
      ExpertRemove();
      return;
     }
   RSI.Refresh();
   CCI.Refresh();
   ATR.Refresh();
   MACD.Refresh();
//---
   if(!ArraySetAsSeries(Rates, true))
     {
      PrintFormat("%s -> %d", __FUNCTION__, __LINE__);
      ExpertRemove();
      return;
     }
   bars -= end + HistoryBars + NForecast;
   if(bars < 0)
     {
      PrintFormat("%s -> %d", __FUNCTION__, __LINE__);
      ExpertRemove();
      return;
     }
Sobald die Indikatoren bereitstehen, beginnt der Prozess der Erfassung von Mustern für das Training. Wir richten eine Trainingsschleife ein, in der bei jeder Iteration eine zufällige Position innerhalb des gültigen Bereichs der Balken ausgewählt wird. Dies ist der Einstiegspunkt für das nächste Trainingsszenario. Ausgehend von dieser Position werden drei zentrale Vektoren gebildet:
- bState – beschreibt den Marktzustand als Tensor aus Indikatoren und Preisparametern;
- bTime – spiegelt den zeitlichen Kontext wider;
- Result – enthält eine Zielprognose auf der Grundlage der zukünftigen Preisentwicklung.
   vector<float> result, target, neg_target;
   bool Stop = false;
//---
   uint ticks = GetTickCount();
//---
   for(int iter = 0; (iter < Iterations && !IsStopped() && !Stop); iter ++)
     {
      int posit = (int)((MathRand() * MathRand() / MathPow(32767, 2)) * bars);
      if(!CreateBuffers(posit + end, GetPointer(bState), GetPointer(bTime), Result))
        {
         PrintFormat("%s -> %d", __FUNCTION__, __LINE__);
         ExpertRemove();
         return;
        }
Zusätzlich zum Marktzustand wird ein Pseudo-Kontozustand generiert – eine Simulation des Handelskontexts des Händlers in dieser Phase. Dies geschieht in der Funktion SampleAccount, die einen Merkmalsvektor erstellt, der den Kontostand, die Equity, die Positionsgröße, den kumulierten Gewinn, die Verhältnisse von Risiko zu Take-Profit und von Risiko zu Stop-Loss sowie sinusförmige Signale enthält, die verborgene saisonale Muster modellieren.
const vector<float> account = SampleAccount(GetPointer(bState), datetime(bTime[0]));
if(!bAccount.AssignArray(account))
  {
   PrintFormat("%s -> %d", __FUNCTION__, __LINE__);
   ExpertRemove();
   return;
  }
Dieser Vektor wird dem Actor als Eingabe zugeführt und erweitert dessen Verständnis der aktuellen Situation: Der Agent trifft Entscheidungen nicht nur auf der Grundlage des Marktes, sondern auch im Kontext seiner Handelsposition.
Sobald die Eingabedaten aufbereitet sind, führt das Modell seinen Vorwärtsdurchlauf durch: Der Encoder kodiert die Marktdaten, woraufhin drei Forecast[i]-Blöcke Prognosen für verschiedene Zeithorizonte erstellen.
//--- Feed Forward
if(!cEncoder.feedForward((CBufferFloat*)GetPointer(bState), 1, false, (CBufferFloat*)GetPointer(bTime)))
  {
   PrintFormat("%s -> %d", __FUNCTION__, __LINE__);
   Stop = true;
   break;
  }
for(uint f = 0; f < caForecast.Size(); f++)
   if(!caForecast[f].feedForward(GetPointer(cEncoder), -1, (CBufferFloat*)NULL))
     {
      PrintFormat("%s -> %d - Forecast %d", __FUNCTION__, __LINE__, f);
      Stop = true;
      break;
     }
Gleichzeitig trifft der Actor eine Handelsentscheidung, die sofort von zwei unabhängigen Modellen – dem Critic und dem Director – bewertet wird. Das eine Modell analysiert die Entscheidung aus der Perspektive des klassischen wertbasierten Ansatzes, während das andere als binärer Klassifikator eine deutliche Rückmeldung liefert und gute Handlungen von eindeutig fehlerhaften unterscheidet.
if(!cActor.feedForward(GetPointer(bAccount), 1, false, GetPointer(cEncoder), LatentLayer))
  {
   PrintFormat("%s -> %d", __FUNCTION__, __LINE__);
   Stop = true;
   break;
  }
if(!cCritic.feedForward(GetPointer(cActor), -1, GetPointer(cEncoder), LatentLayer))
  {
   PrintFormat("%s -> %d", __FUNCTION__, __LINE__);
   Stop = true;
   break;
  }
if(!cDirector.feedForward(GetPointer(cActor), -1, GetPointer(cEncoder), LatentLayer))
  {
   PrintFormat("%s -> %d", __FUNCTION__, __LINE__);
   Stop = true;
   break;
  }
Als Nächstes optimieren wir die Modellparameter, indem wir die Methode für den Rückwärtsdurchlauf aufrufen. Zum Trainieren der Prognosemodelle wird ein im Voraus erstellter Tensor mit nachfolgenden Umgebungszuständen verwendet.
//--- Study
for(uint f = 0; f < caForecast.Size(); f++)
   if(!caForecast[f].backProp(Result, (CBufferFloat*)NULL) ||
      !cEncoder.backPropGradient((CBufferFloat*)NULL))
     {
      PrintFormat("%s -> %d - Forecast %d", __FUNCTION__, __LINE__, f);
      Stop = true;
      break;
     }
Die Funktion CheckAction dient dazu, eine objektive Bewertung einer Aktion zu erhalten. Sie simuliert die Eröffnung einer virtuellen Position und berechnet den erwarteten Gewinn unter Berücksichtigung eines auf tatsächlichen historischen Daten basierenden Diskontierungsfaktors. Auf der Grundlage dieser Daten wird eine Belohnung generiert, die in das Modell zurückgeführt wird und als Grundlage für die Neuberechnung der Parameter aller Komponenten dient – von Actor, Critic und Director.
cActor.getResults(Action);
double equity = bAccount[2] * bAccount[0] * EtalonBalance / (1 + bAccount[1]);
double reward = CheckAction(Action, Result, equity);
Result.Clear();
if(!Result.Add(float(reward)))
  {
   PrintFormat("%s -> %d", __FUNCTION__, __LINE__);
   Stop = true;
   break;
  }
if(!cCritic.backProp(Result, GetPointer(cEncoder), LatentLayer) ||
   !cActor.backPropGradient(GetPointer(cEncoder), LatentLayer, -1, true))
  {
   PrintFormat("%s -> %d", __FUNCTION__, __LINE__);
   Stop = true;
   break;
  }
if(!Result.Update(0, float(reward > 0)))
  {
   PrintFormat("%s -> %d", __FUNCTION__, __LINE__);
   Stop = true;
   break;
  }
if(!cDirector.backProp(Result, GetPointer(cEncoder), LatentLayer) ||
   !cActor.backPropGradient(GetPointer(cEncoder), LatentLayer, -1, true))
  {
   PrintFormat("%s -> %d", __FUNCTION__, __LINE__);
   Stop = true;
   break;
  }
Die Gradientenkorrektur erfolgt schnell und in einem einzigen Aktualisierungsschritt. Die Fehler werden in das Netzwerk zurückgeführt, und die Gewichte werden entsprechend dem Trainingssignal aktualisiert. Dadurch kann das Modell nach und nach nützliche Muster erlernen und sein Verhalten anhand neuer Beispiele anpassen, wobei es lernt, Fehler zu vermeiden und nützliche Handlungen zu verstärken.
Um eine visuelle Echtzeitüberwachung des Prozesses zu ermöglichen, zeigt die Methode regelmäßig wichtige Trainingsparameter in den Chart-Kommentaren an: Prognosefehler und Genauigkeit des Critic.
 if(GetTickCount() - ticks > 500)
   {
    double percent = double(iter) * 100.0 / (Iterations);
    string str = "";
    for(uint f = 0; f < caForecast.Size(); f++)
       str += StringFormat("%-12s%d %6.2f%% -> Error %15.8f\n", "Forecast", f, percent,
                                                caForecast[f].getRecentAverageError());
    str += StringFormat("%-12s %6.2f%% -> Error %15.8f\n", "Critic", percent,
                                                      cCritic.getRecentAverageError());
    str += StringFormat("%-12s %6.2f%% -> Error %15.8f\n", "Director", percent,
                                                    cDirector.getRecentAverageError());
    Comment(str);
    ticks = GetTickCount();
   }
}
Nach Abschluss der festgelegten Anzahl von Iterationen gibt die Methode die Trainingsergebnisse in das Terminal-Protokoll aus und beendet das Programm sauber mithilfe von ExpertRemove.
   Comment("");
//---
   for(uint f = 0; f < caForecast.Size(); f++)
      PrintFormat("%s -> %d -> %-15s%d %10.7f", __FUNCTION__, __LINE__, "Forecast", f,
                                               caForecast[f].getRecentAverageError());
   PrintFormat("%s -> %d -> %-15s %10.7f", __FUNCTION__, __LINE__, "Critic",
                                                     cCritic.getRecentAverageError());
   PrintFormat("%s -> %d -> %-15s %10.7f", __FUNCTION__, __LINE__, "Director",
                                                   cDirector.getRecentAverageError());
   ExpertRemove();
//---
  }
Somit besteht jeder Trainingslauf aus einer Reihe kleiner Simulationen, von denen jede einen Abschnitt der Historie nachbildet: von der Marktlage bis zum Handelsergebnis. Der Agent lernt aus direkten Erfahrungen, aus Fehlern und erfolgreichen Handlungen, passt sich nach und nach an verschiedene Marktbedingungen an und verbessert seine eigene Strategie durch ein ausgewogenes Bewertungssystem und gezielte Korrekturen.
Nach der Haupttrainingsphase folgt die Feinabstimmung des Modells, die im Online-Lernmodus durchgeführt wird. Hierfür kommt der integrierte Strategietester von MetaTrader 5 zum Einsatz, der es ermöglicht, den Algorithmus unter Bedingungen auszuführen, die den realen Marktbedingungen so nahe wie möglich kommen, während die Simulation gleichzeitig vollständig kontrollierbar bleibt. Dieser Ansatz ermöglicht es nicht nur, die Qualität des Modells zu bewerten, sondern auch sein Verhalten an das aktuelle Marktumfeld anzupassen, indem seine Parameter schrittweise auf die aktuelle Volatilität und die Art der Kursbewegungen abgestimmt werden.
Der Online-Lernmechanismus wird auf der Grundlage des aus früheren Arbeiten übernommenen Programms ohne jegliche Änderungen implementiert. Das Modell lernt kontinuierlich aus neuen Daten und passt seine Handlungen in Echtzeit an, was besonders wichtig ist, wenn sich die Marktregime häufig ändern.
Tests
Der Modelltrainingsprozess wurde in zwei Phasen unterteilt. Dieser Ansatz ermöglichte es, das System konsistent, zuverlässig und ohne Zeitdruck aufzubauen.
Zunächst erfolgt das Offline-Training. Wir haben historische Daten aus 15 Jahren für das Währungspaar EURUSD im M1-Zeitrahmen herangezogen. Dadurch stand dem Modell eine große Menge unterschiedlicher Marktsituationen zur Verfügung. Der Encoder lernte, Regelmäßigkeiten zu erkennen, aussagekräftige Muster zu identifizieren und die Marktlage in einen kompakten, informationsreichen Merkmalsvektor zu kodieren. Dieser Vektor dient als Grundlage für alle Entscheidungen, die der Agent trifft. Während des Trainings lernt der Actor eine Verhaltensstrategie, indem er Signale vom Critic und vom Director erhält.
Anschließend folgt die Online-Feinabstimmung. Sie wird im Strategietester von MetaTrader 5 ausgeführt. Hier interagiert das Modell auf realistische Weise mit historischen Daten: Kerze für Kerze, mit Marktrauschen, zufälligen Schwankungen und Instabilität. Dies trägt dazu bei, das Verhalten des Agenten auf die Dynamik des realen Marktes abzustimmen und seine Strategie unter nahezu realen Bedingungen anzupassen.
Nach dem Training wurde das Modell anhand neuer Daten getestet – Kursnotierungen für Januar 2025. Alle Einstellungen wurden im Voraus festgelegt und blieben unverändert. Dadurch wird sichergestellt, dass die Bewertung objektiv und transparent erfolgt. Die Testergebnisse sind unten aufgeführt.
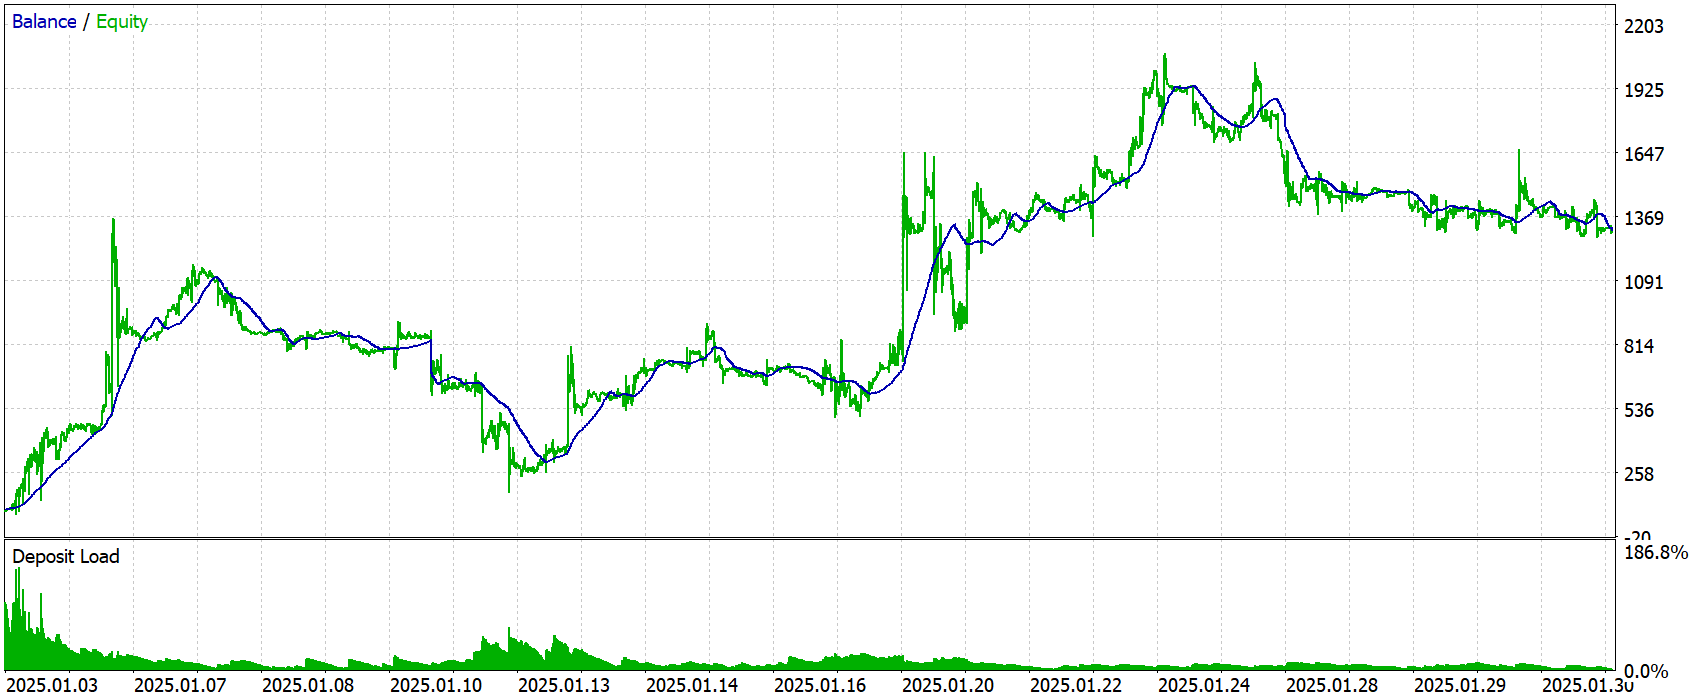
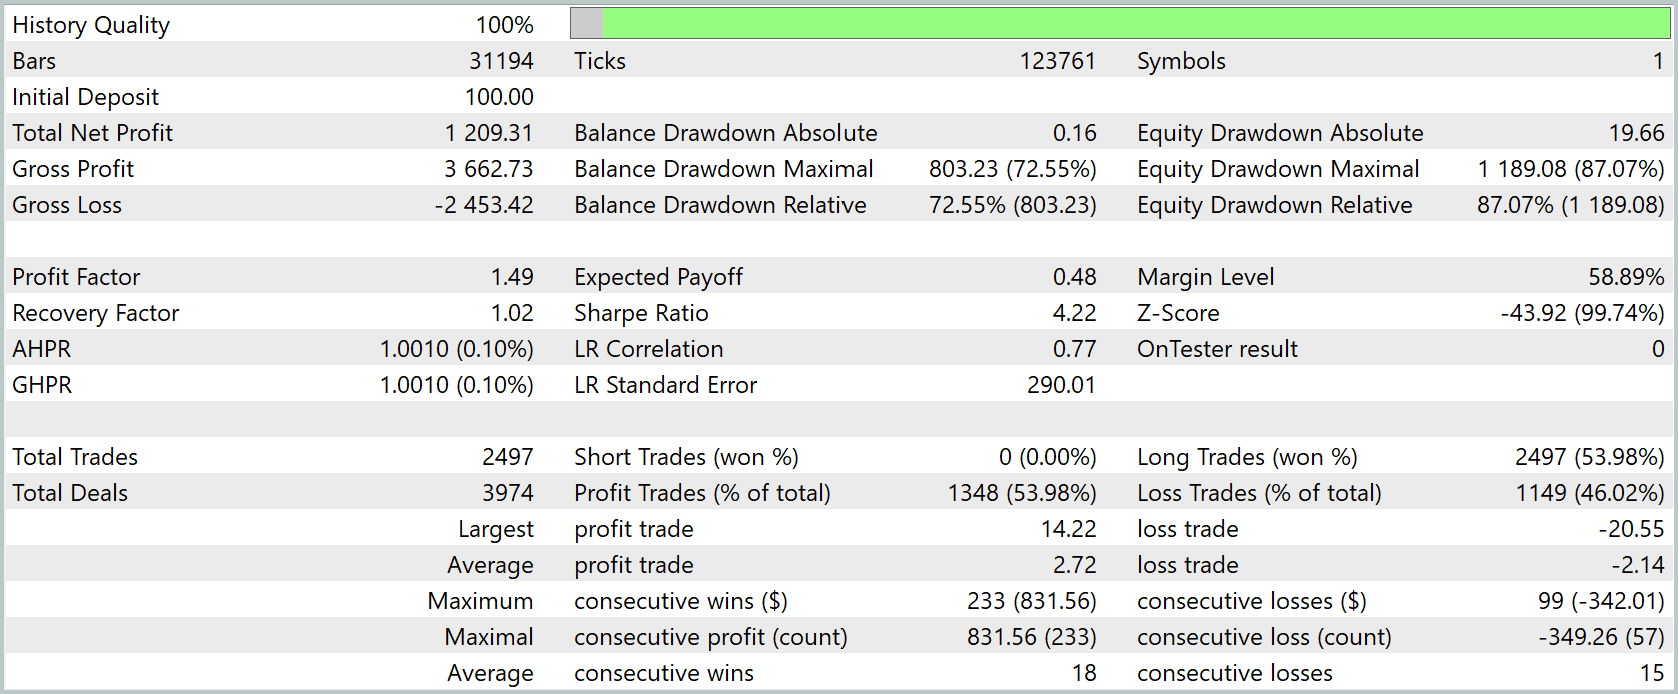
Die Testergebnisse fallen gemischt aus und sollten mit Vorsicht interpretiert werden. Einerseits ist die kumulierte Rendite traditionell von Bedeutung: Bei einer Anfangseinlage von 100 Dollar schloss das System den Zeitraum mit einem Nettogewinn von 1.209 Dollar ab. Das ist das Zwölffache des Anfangskapitals. Das Kontostandsdiagramm zeigt ein stetiges Wachstum bis zur Monatsmitte, gefolgt von einer relativen Stabilisierung auf einem Niveau von 1.350–1.400 US-Dollar.
Der extreme Drawdown fällt jedoch sofort ins Auge. Der maximale Drawdown des Kontostands lag bei über 72 %, während der Drawdown der Equity über 87 % betrug. Das bedeutet, dass das System in den schwierigsten Handelsphasen den Großteil seines Kapitals verloren hat. Dies kennzeichnet die Verhaltensstrategie trotz der anschließenden Erholung als hochriskant.
Der Profitfaktor lag bei 1,49 – viele halten dies für ein akzeptables Niveau, doch angesichts solcher Drawdowns ist es unwahrscheinlich, dass damit mögliche Verlustphasen ausgeglichen werden können. Der Erholungsfaktor (das Verhältnis von Nettogewinn zu maximalem Drawdown) liegt bei fast 1, was auf eine sehr langsame Erholung von Verlusten hindeutet.
Aus den Handelsstatistiken geht hervor, dass im Laufe des Monats fast 2.500 Trades ausgeführt wurden, von denen 53,98 % gewinnbringend waren. Der durchschnittliche Gewinn liegt nur geringfügig über dem durchschnittlichen Verlust.
Insgesamt zeigen diese Ergebnisse, dass das Modell zwar in der Lage ist, profitable Signale zu identifizieren und ein Wachstum des Kontostands zu erzielen, dies jedoch auf Kosten sehr tiefer Drawdowns und langer Serien von Verlustgeschäften geschieht. Im praktischen Handel erfordert diese Strategie zusätzliche Absicherungsmaßnahmen, um das Risiko eines tiefen Drawdowns des Kapitals zu verringern.
Fazit
In dieser Arbeit haben wir die Kernideen des Time-MoE-Frameworks aus der wissenschaftlichen Veröffentlichung aufgegriffen und sie Schritt für Schritt in konkreten Code in MQL5 und OpenCL umgesetzt. Wir haben die SwiGLU-Einbettung implementiert, ein sparse Mixture-of-Experts-Modell aufgebaut und dieses in den Cross-Attention-Mechanismus integriert. Wir haben eine vollständige Trainingspipeline innerhalb der Actor–Director–Critic-Architektur eingerichtet. Dank einer klaren modularen Struktur waren alle Komponenten miteinander vernetzt und ließen sich dennoch einfach konfigurieren und erweitern.
In der ersten Phase des Offline-Trainings anhand von Daten aus fünfzehn Jahren konnte der Encoder eine umfassende latente Repräsentation des Marktes bilden, und der Actor konnte unter der Aufsicht des Critic und des Director eine grundlegende Strategie erlernen. In der zweiten Phase der Online-Feinabstimmung im Strategietester von MetaTrader 5 wurde das Modell für den Handel vorbereitet, indem die Dynamik und das Rauschen des aktuellen Marktes in seinen Parametern abgebildet wurden.
Tests anhand von Kursdaten vom Januar 2025 haben gezeigt, dass der Agent zwar in der Lage ist, stetige Gewinne zu erzielen, dies jedoch mit tiefen Drawdowns einhergeht. Dies macht deutlich, dass das Risikomanagement weiter optimiert und die Handelskriterien genauer abgestimmt werden müssen.
Links
- Time-MoE: Foundation Models für Zeitreihen im Milliardenmaßstab mit Mixture-of-Experts
- Weitere Artikel in dieser Reihe
In diesem Artikel verwendete Software
| # | Name | Typ | Beschreibung |
|---|---|---|---|
| 1 | Study.mq5 | Expert Advisor | Expert Advisor für das Offline-Modelltraining |
| 2 | StudyOnline.mq5 | Expert Advisor | Expert Advisor für Online-Modelltraining |
| 3 | Test.mq5 | Expert Advisor | Expert Advisor für Modelltests |
| 4 | Trajectory.mqh | Klassenbibliothek | Struktur zur Beschreibung des Systemzustands und der Modellarchitektur |
| 5 | NeuroNet.mqh | Klassenbibliothek | Klassenbibliothek zum Erstellen neuronaler Netze |
| 6 | NeuroNet.cl | Bibliothek | Codebibliothek für das OpenCL-Programm |
Übersetzt aus dem Russischen von MetaQuotes Ltd.
Originalartikel: https://www.mql5.com/ru/articles/18548
Warnung: Alle Rechte sind von MetaQuotes Ltd. vorbehalten. Kopieren oder Vervielfältigen untersagt.
Dieser Artikel wurde von einem Nutzer der Website verfasst und gibt dessen persönliche Meinung wieder. MetaQuotes Ltd übernimmt keine Verantwortung für die Richtigkeit der dargestellten Informationen oder für Folgen, die sich aus der Anwendung der beschriebenen Lösungen, Strategien oder Empfehlungen ergeben.
 Neuronale Netze im Handel: Zerlegen statt Skalieren – Entwicklung von Modulen
 Neuronale Netze im Handel: Zerlegen statt Skalieren (SSCNN)
 Eine alternative Log-datei mit der Verwendung der HTML und CSS
 Neuronale Netze im Trading: Heterogenitätsbasiertes Lernen von Metaparametern (HimNet)

- Freie Handelsapplikationen
- Über 8.000 Signale zum Kopieren
- Wirtschaftsnachrichten für die Lage an den Finanzmärkte
Sie stimmen der Website-Richtlinie und den Nutzungsbedingungen zu.
Vielen Dank, dass Sie Ihre Codes zur Verfügung stellen. Ich verfolge Ihre Artikel schon seit einiger Zeit. Sie scheinen alle auf ganz aktuellen wissenschaftlichen Veröffentlichungen zu basieren. Ich habe jedoch Probleme beim Kompilieren, da bei allen zu viele Syntaxfehler auftreten. Viele der Fehler stammen aus der Datei „NeuroNet.cl“, die, wenn ich mich nicht irre, den Kern der OpenCL-Berechnungen für „NeuroNet.mqh“ bildet. Ich bin mir sicher, dass alle Codes auf Ihrer Seite bereits kompiliert sind. Daher nehme ich an, dass die Probleme auf die MQL-Version auf meiner Seite zurückzuführen sind, die sich möglicherweise von Ihrer unterscheidet. Könnten Sie uns dazu ein paar Details geben? Vielen Dank!
[D]ie Trades erfolgen ausschließlich auf der Long-Seite[.]
Meiner Meinung nach eignet sich ein reiner Long-Algorithmus wahrscheinlich besser für einen Index wie den S&P 500, der eine konstantere Aufwärtsbewegung aufweist.
Natürlich dient der EUR/USD lediglich als Beispiel für die im Artikel beschriebenen Konzepte und deren Funktionsweise, also…