

Neuronale Netze im Handel: Adaptive periodische Segmentierung (LightGTS)
 21
 0

Einleitung
Die Zeitreihenprognose ist seit Langem ein wichtiges Instrument in vielen Bereichen – von Energie und Verkehr bis hin zu Gesundheitswesen und Bildung. Doch gerade im Finanzwesen – wo der Wert jeder Sekunde in Geld ausgedrückt werden kann – kommt der Genauigkeit einer Prognose entscheidende Bedeutung zu. Hier gibt es keinen Spielraum für Fehler: Schon der kleinste Fehltritt im Modell – und die Strategie rutscht in die roten Zahlen.
Herkömmliche Ansätze, ob sie nun auf Statistik oder Deep Learning basieren, beruhen in der Regel auf dem Prinzip „eine Aufgabe, ein Modell“. Solche Lösungen funktionieren in kontrollierten oder eng abgegrenzten Szenarien gut, doch in der Praxis verhalten sich Finanzmärkte unvorhersehbar: Veränderungen bei Volatilität, Skalen, Zyklen und Regimen stellen die Wirksamkeit starr auf bestimmte Aufgaben ausgerichteter Modelle infrage.
Vor diesem Hintergrund entstehen derzeit sogenannte Time Series Foundation Models (TSFM) also grundlegende vortrainierte Modelle für Zeitreihen. Sie werden anhand umfangreicher, vielfältiger Datensätze trainiert, um Vielseitigkeit und Skalierbarkeit zu erreichen. Die Realität sieht jedoch so aus, dass solche Modelle enorme Rechenressourcen erfordern und der Gewinn an Genauigkeit die Kosten nicht immer rechtfertigt. Es gibt zig Millionen Parameter, doch in der Praxis geht die Vielseitigkeit oft in den Details unter.
Was Zeitreihen so einzigartig macht, ist ihr Rhythmus. Anders als bei Text, wo ein Token einem Wort entspricht, sind hier Skala und Periodizität wichtig. Manche Daten fallen einmal pro Stunde an, andere hingegen alle 15 Minuten. Einige weisen tägliche oder wöchentliche Saisonalität auf, während andere vierteljährliche oder jährliche Saisonalität zeigen. All dies wirkt sich auf die sogenannte interne Periode aus – ein wiederkehrendes Muster in den Daten, das für verlässliche Prognosen entscheidend ist. Zudem ändert sich bei einer Änderung der Skala auch die Zykluslänge – und wenn das Modell damit nicht umgehen kann, nimmt seine Generalisierungsfähigkeit stark ab.
Das Problem ist, dass die meisten bestehenden Modelle eine feste Tokenisierung verwenden. Sie unterteilen die Daten einfach in gleich lange Segmente, ohne dabei die Skala oder die Struktur der Perioden zu berücksichtigen. Infolgedessen sind einige Token mit Daten überladen, während andere fast leer sind. Informationen werden verwischt, und wiederkehrende Muster werden gestört. Dies macht sich insbesondere dann bemerkbar, wenn ein Modell, das auf einer bestimmten Skala trainiert wurde, auf Daten mit einer anderen Skala angewendet wird – die Genauigkeit der Prognosen sinkt, die Anzahl der Parameter muss erhöht werden, und infolgedessen steigen der Zeitaufwand und die Kosten für das Training.
Die Autoren des Artikels „LightGTS: A Lightweight General Time Series Forecasting Model“ beschlossen, nicht auf Brute-Force-Methoden zu setzen, sondern einen sinnvollen Ansatz zu verfolgen – nämlich die natürlichen Eigenschaften von Zeitreihen zu nutzen: Skaleninvarianz und Periodizität. Das Ergebnis ihrer Arbeit war das LightGTS-Framework – eine schlanke, effiziente Lösung, die speziell für reale Anwendungen der Zeitreihenprognose zugeschnitten ist. Der Kerngedanke besteht nicht darin, gegen Skalen anzukämpfen, sondern sich an sie anzupassen.
Anstelle einer starren Aufteilung in identische Fragmente wurde vorgeschlagen, eine periodische Tokenisierung zu verwenden. Das Modell unterteilt die Daten adaptiv in Segmente, deren Länge einem vollständigen Zyklus entspricht. Dadurch kann es vollständige Muster unabhängig von der Skala erfassen – sei es auf einem Tageschart oder einem Ein-Minuten-Chart. Die Semantik innerhalb eines Tokens bleibt unverändert, was bedeutet, dass die Merkmalsrepräsentation stabil und auf andere Aufgaben übertragbar wird.
Das Framework nutzt für die Prognose die parallele Dekodierung: Das letzte Token aus dem Encoder dient als Ausgangspunkt, und alle zukünftigen Werte werden auf dieser Grundlage auf einmal generiert. Dies spart nicht nur Zeit und verringert die Fehlerhäufung (im Gegensatz zu schrittweisen autoregressiven Ansätzen), sondern ermöglicht auch eine bessere Nutzung der Struktur der Zeitreihe selbst. Das letzte Token fasst den Kern des historischen Kontexts zusammen und ist direkt mit der Zukunft verknüpft, wodurch die Prognosen logisch und strukturell fundiert sind.
Zudem haben sich die Autoren des LightGTS-Frameworks von der festen Merkmalsprojektion verabschiedet. Stattdessen wird eine flexible Schicht verwendet, die sich an unterschiedliche Zykluslängen und mehrere Datenquellen anpassen kann. Dies ist insbesondere bei Finanzanwendungen von Bedeutung, bei denen stündliche Aktienkursdaten und tägliche makroökonomische Daten innerhalb eines einzigen Portfolios nebeneinander bestehen können.
Die Ergebnisse sprechen für sich. Das LightGTS-Modell bietet eine Genauigkeit, die mit den branchenweit besten Lösungen vergleichbar ist, und kommt dabei mit weniger als 5 Millionen Parametern aus. Das sind 10- bis 100-mal weniger Parameter als bei anderen TSFM-Modellen. Das bedeutet weniger Trainingszeit, geringere Infrastrukturkosten und eine größere Chance, das Modell in einem realen Handelssystem oder einer Analyseplattform einzusetzen.
Der LightGTS-Algorithmus
Stellen Sie sich ein typisches Prognoseproblem auf den Finanzmärkten vor. Wir haben eine multivariate Zeitreihe – zum Beispiel Kursdaten, Handelsvolumina, Indikatoren und andere Marktsignale. Bezeichnen wir sie als Xt = {xi,t-L:t}i=1,C, wobei jedes xi Beobachtungen für einen einzelnen Kanal über die letzten L Zeitschritte darstellt. Die Anzahl solcher Kanäle, C, kann beliebig sein – von einem bis zu Dutzenden. Dies ist unser Fenster in die Vergangenheit, ein gleitendes Fenster über die analysierte Historie.
Unser Ziel ist es, F Schritte in die Zukunft zu blicken und die Werte Ŷt = {ŷi,t:t+F}i=1,C zu prognostizieren. Um die Genauigkeit während des Trainings zu bewerten, verfügen wir außerdem über die tatsächlichen Daten: Yt = {yi,t:t+F}i=1,C. All dies fügt sich in das klassische Prognose-Framework ein.
Nun zum interessantesten Teil. Das Modell wird in zwei Phasen trainiert. Zunächst erfolgt ein groß angelegtes Vortraining anhand heterogener Zeitreihen aus verschiedenen Quellen. Dazu können historische Daten von Aktien, Währungen, Wirtschaftsindikatoren, Wetterdaten und allem anderen gehören, was eine zeitliche Struktur aufweist. Als Nächstes folgt das Fine-Tuning des Modells für eine bestimmte Aufgabe.
Ein interessanter Aspekt: Das Modell muss möglicherweise gar nicht feinabgestimmt werden – es könnte ausreichen, das Modell ohne weiteres Fine-Tuning direkt auf einem Testdatensatz einzusetzen bzw. zu evaluieren, vorausgesetzt, es wurde ursprünglich so trainiert, dass es ausreichend universell einsetzbar ist. Dies ist insbesondere im Zusammenhang mit dem algorithmischen Handel von Bedeutung: Es ist nicht immer möglich, das Modell für jedes einzelne Instrument feinabzustimmen, insbesondere nicht in Echtzeit.
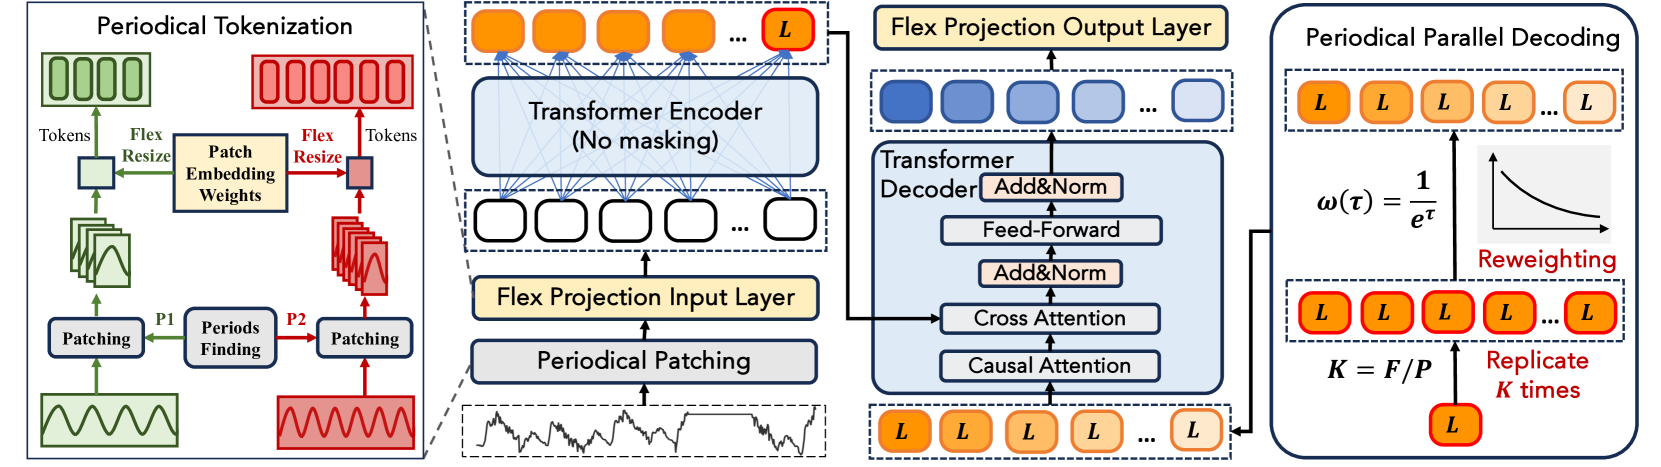
Was macht das LightGTS-Modell so einzigartig? Alles beginnt mit der periodischen Tokenisierung – einer Art intelligentem Maßband, das sich an den Rhythmus der Zeitreihe selbst anpasst. Die Autoren des Frameworks schlagen vor, die Zeitreihe in periodische Patches zu unterteilen – Datensegmente, die einem einzelnen vollständigen Zyklus entsprechen (etwa einem Tages- oder Wochenzyklus). Dieser Vorgang wird als adaptives periodisches Patching bezeichnet. Es berücksichtigt die Skala und Struktur der Zeitreihe und bildet Segmente, die genau zu wiederkehrenden Mustern des Marktverhaltens passen.
Um die Methode zu beschreiben, betrachten wir einen einfachen Fall – eine eindimensionale Zeitreihe. In der Praxis lässt sich das problemlos auf multivariate Daten übertragen: Jeder Kanal wird einfach separat verarbeitet, ohne dass dabei die Struktur verloren geht.
Stellen wir uns vor, wir arbeiten mit einem Satz von Zeitreihen aus verschiedenen Quellen – Finanzanlagen, Märkten und Zeitrahmen. Jede Reihe hat ihren eigenen inneren Rhythmus – die sogenannte natürliche Periode. Dies könnte beispielsweise ein täglicher Handelszyklus, wöchentliche Volatilität oder ein saisonaler Trend sein. Um effektiv mit solchen Zeitreihen arbeiten zu können, muss zunächst die Länge dieser Periode bestimmt werden – das heißt, wie viele Zeitpunkte in den analysierten Daten einen vollständigen Zyklus bilden.
Wenn Sie über Vorabinformationen zur Datenfrequenz verfügen (beispielsweise, ob die Daten stündlich oder minütlich eingehen), lässt sich die Zykluslänge leicht bestimmen: Bei einer täglichen Periode mit stündlichen Daten wären dies beispielsweise 24 Datenpunkte. Wenn jedoch keine Frequenzinformationen vorliegen, kommt die Spektralanalyse – einschließlich der schnellen Fourier-Transformation (FFT) – zu Hilfe und hilft dabei, die dominanten Frequenzen in der Reihe zu identifizieren. Gerade diese Frequenzen spiegeln wiederkehrende Muster wider – Zyklen, die für die Prognose der Marktdynamik so wichtig sind.
Sobald die Zykluslänge – nennen wir sie P – bestimmt wurde, wird die gesamte Zeitreihe sauber in aufeinanderfolgende, nicht überlappende Fragmente aufgeteilt, die genau eine Periode lang sind. Jedes dieser Segmente, auch Patch genannt, enthält P Punkte und deckt einen vollständigen Zyklus ab. Die Anzahl solcher Patches ergibt sich einfach aus L geteilt durch P, nach unten abgerundet, wobei L die Länge der ursprünglichen Reihe ist.
Auf den ersten Blick scheint dieser Schritt einfach zu sein, doch in Wirklichkeit eröffnet er dem Modell den Zugang zu einer völlig neuen Ebene semantischer Struktur. Unterschiedliche Zeitrahmen, Frequenzen und Quellen werden nun in einem einzigen, periodensynchronisierten Raum interpretiert. Dadurch wird das durch Unterschiede in der Datenskala verursachte Rauschen reduziert und das Modell kann lernen, Muster zu erkennen, die sich tatsächlich von Zyklus zu Zyklus wiederholen – anstatt sich lediglich an lokale Volatilität anzupassen.
Gerade diese Methode zur Aufteilung der Zeitreihe ermöglicht es, das Modell anhand heterogener Datenquellen zu trainieren. Trotz der unterschiedlichen Frequenzen werden sie alle in eine vergleichbare Form umgewandelt, in der die Periode die maßgebliche Informationseinheit ist. Das bedeutet, dass das Modell wiederkehrende Marktsignale erkennen und verallgemeinern kann, was für zuverlässige Prognosen unter realen Handelsbedingungen von entscheidender Bedeutung ist.
Sobald die Zeitreihe in zyklische Patches aufgeteilt wurde, von denen jeder einen vollständigen Zyklus der Zeitreihe abdeckt, ist es wichtig, diese Patches korrekt in eine Vektordarstellung abzubilden. Hier kommt die Projektionsschicht ins Spiel, aber genau wie im echten Leben steckt der Teufel im Detail.
Eine naive Lösung wäre die Verwendung einer festen Projektionsmatrix, die jeden Patch in ein Token umwandelt. Das Problem? Verschiedene Arten von Finanzdaten weisen unterschiedliche Zykluslängen auf: Ein Tageszyklus bei Minutenkerzen umfasst 1.440 Punkte, während ein Wochenzyklus bei Stundenkerzen nur 120 Punkte umfasst. Infolgedessen variieren die Eingabe-Patches in ihrer Größe, und eine feste Matrix kann damit einfach nicht umgehen: Entweder werden die Daten abgeschnitten, oder alles muss auf eine einheitliche Größe angepasst werden. Eine einfache Interpolation ist sicherlich hilfreich – man kann die Daten einfach strecken oder stauchen. Aber es gibt einen Haken: Solche Operationen verzerren die Bedeutung. Am Ende haben wir zwar schön ausgerichtete, aber leere Tokens, die für das Modell kaum Aussagekraft haben.
Um solche Verzerrungen zu vermeiden, wird eine flexible Projektionsschicht (Flex Projection Layer) eingeführt. Ihre Aufgabe besteht nicht lediglich darin, den Patch auf eine feste Dimensionalität zu komprimieren, sondern dies so zu tun, dass die Semantik der Daten erhalten bleibt. Mit anderen Worten: Die aus einem Patch der Länge 96 abgeleiteten Tokens sollten denen entsprechen, die sich aus einem Patch der Länge 144 ergeben würden, vorausgesetzt, beide spiegeln denselben Marktzyklus wider.
Wie funktioniert das technisch gesehen? Angenommen, wir haben Projektionsgewichte θ, die für einen Patch der Länge P trainiert wurden. Wir möchten sie an einen neuen Patch der Länge P′ anpassen, und zwar so, dass das Produkt aus den Daten und den Gewichten (und damit die Tokens) so nah wie möglich am ursprünglichen Produkt bleibt. Eine einfache Interpolation funktioniert hier nicht – sie ist viel zu grob. Daher wird eine lineare Transformation mit Gewichtsanpassung über eine Pseudoinverse Matrix verwendet – ein aus numerischen Methoden und der Regressionsanalyse bekanntes Verfahren.
Dieser Mechanismus wird als Flex-Resize bezeichnet und löst ein Optimierungsproblem: Es gilt, neue Gewichte θ′ zu finden, die – bei Anwendung auf neue Patches – ein Ergebnis liefern, das dem Original so nahe wie möglich kommt – mathematisch ausgedrückt, gemessen an der Frobenius-Norm. Hier wird ein Koeffizient δ eingeführt – er berücksichtigt den Unterschied in den Varianzen zwischen dem ursprünglichen Patch und dem interpolierten Patch, was dazu beiträgt, die statistische Stabilität der Projektionen zu gewährleisten. Die endgültige Formel für Flex-Resize sieht zwar recht komplex aus, ist aber im Grunde genommen eine clevere Methode, um die Gewichtsmatrix flexibel und anpassungsfähig zu gestalten.
Die Implementierung der Flex Projection Layer verwendet zwei Parametermatrizen – eine für die Eingabe und eine für die Ausgabe –, die jeweils auf eine Referenz-Patch-Größe (beispielsweise 96) ausgelegt sind. Während des Forward Pass des Modells werden diese Matrizen mithilfe derselben δ⁻¹(A)+-Transformation an die erforderliche Länge des aktuellen Patches angepasst. Anschließend lassen sich die Patches problemlos in den latenten Raum des Modells projizieren – die Tokens stehen anschließend zur Verfügung und bewahren die vollständige Struktur des ursprünglichen Marktzyklus bei.
Unabhängig davon, ob das Modell anhand von Tageskerzen einen Wochentrend analysiert oder kurzfristige Strategien auf Minutencharts verfolgt, arbeitet es also stets mit Daten, die in einheitlicher und konsistenter Form dargestellt sind. Dadurch wird der Konflikt zwischen verschiedenen Skalen gelöst und die effektive Nutzung vortrainierter Gewichte ermöglicht, ohne von Grund auf neu trainieren zu müssen. Und an den Finanzmärkten, wo Daten aus verschiedenen Quellen und mit unterschiedlichen Frequenzen anfallen, ist eine solche Flexibilität kein Luxus, sondern eine Notwendigkeit.
Die Architektur des LightGTS-Frameworks nutzt, ähnlich wie der klassische Transformer, einen Encoder und einen Decoder, die jeweils Multi-Head-Attention-Module und vollverbundene Schichten (Feed-Forward-Netzwerke) enthalten. Hier gibt es jedoch ein wichtiges Detail: Die Attention-Module nutzen Rotary Positional Encoding (RoPE), also eine rotierende Positionskodierung, wodurch sie nicht nur die absoluten, sondern auch die relativen Positionen der Tokens berücksichtigen können. Dies gilt insbesondere für Zeitreihen, bei denen nicht nur die Reihenfolge, sondern auch der Abstand zwischen den Punkten eine Rolle spielt.
Nachdem die periodischen Patches mithilfe von Flex Projection in Tokens umgewandelt wurden, wird eine Token-Sequenz 𝐗ₑ = {𝐱ₑ₁, 𝐱ₑ₂, …, 𝐱ₑₙ} gebildet, wobei jedes 𝐱ₑᵢ eine Vektorrepräsentation des mit i indizierten Patches ist. Bei der Verarbeitung dieser Sequenz fügt der Encoder mithilfe von RoPE eine Positionsstruktur hinzu: Die Tokens merken sich nicht nur ihre eigene Position, sondern berücksichtigen auch die relativen Versätze zueinander.
Konkret werden für jedes Token die Query-Vektoren (Query) und Key-Vektoren (Key) mithilfe der trainierbaren Matrizen 𝐖Q und 𝐖K berechnet. Anschließend wird auf das Vektorpaar (𝐱ₑᵢ, 𝐱ₑⱼ), das die Positionen i und j repräsentiert, eine Rotationsmatrix 𝐑i−j angewendet; sie kodiert die Differenz zwischen ihren Positionen exakt. Das sich daraus ergebende Ähnlichkeitsmaß zwischen den Tokens i und j wird anhand der folgenden Formel berechnet:
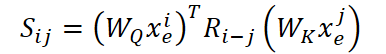
Je höher dieser Wert ist, desto mehr Attention weist Token i Token j zu. Alle diese Werte werden mithilfe der SoftMax-Funktion normalisiert und zur Berechnung einer gewichteten Summe von Value-Vektoren verwendet, die über eine weitere trainierbare Matrix 𝐖V ermittelt werden.
Genau diese Attention bestimmt ganz unmittelbar für jedes Token, auf welche seiner Nachbarn es blicken soll und wie intensiv. Nach der Attention wird jedes Token zusätzlich von einem vollständig vernetzten Block – einem Feed-Forward-Netzwerk – weiterverarbeitet, der verborgene Merkmale extrahiert und die Repräsentation anreichert.
Daher ist die Ausgabe des Encoders ein latenter Raum, in dem jeder Vektor 𝐞ⱼ nicht nur lokale Informationen über den Patch enthält, sondern auch Kontextinformationen aus allen anderen Tokens, wobei deren relative Positionen in der Zeitreihe berücksichtigt werden. Dieser Mechanismus ermöglicht es dem Modell, die Struktur, den Rhythmus und die wiederkehrenden Muster in den Daten zu erfassen, was für finanzielle Zeitreihen von entscheidender Bedeutung ist, bei denen nicht so sehr der einzelne Datenpunkt zählt, sondern vielmehr sein Kontext.
Wie bereits erwähnt, hilft periodisches Patching dabei, wiederkehrende Zyklen aus Zeitreihen zu extrahieren. Um diese Informationen bei der Erstellung einer Prognose optimal zu nutzen, wendet das Modell jedoch einen neuen Ansatz an – die periodische parallele Dekodierung. Im Gegensatz zum klassischen autoregressiven Ansatz, bei dem Prognosen Schritt für Schritt erstellt werden, nutzt diese Methode eine nicht-autoregressive Strategie, die es ermöglicht, den gesamten zukünftigen Zeithorizont auf einmal zu verarbeiten.
Die Kernidee ist einfach und zugleich elegant: Das letzte Token 𝐞ₙ aus dem latenten Ausgaberaum des Encoders enthält komprimierte Informationen über die gesamte vorangehende Sequenz, einschließlich ihrer internen Periodizität. Daher nehmen wir genau dieses Token, klonen es K-mal (wobei K = F/P ist – also die Anzahl der zu prognostizierenden Zyklen) und erhalten die Matrix 𝐇, die als Eingabe für den Decoder dient.
Es ist jedoch zu beachten, dass der Einfluss des letzten Tokens auf die Prognose mit zunehmender zeitlicher Entfernung abnimmt. Daher wird die Gewichtungsfunktion ω(j) = 1/eʲ auf jeden geklonten Vektor 𝐡ⱼ angewendet, wodurch dessen Beitrag exponentiell reduziert wird, je größer der Abstand zum aktuellen Zeitpunkt wird. Die daraus entstehenden gewichteten Tokens ω(j)·𝐡ⱼ werden gleichzeitig in den Decoder eingespeist, was den Kern der parallelen Architektur des Decoders ausmacht.
Der Decoder gibt eine Matrix 𝐙 aus – Prognose-Tokens, die zukünftigen Zyklen entsprechen. Um diese Tokens wieder in reguläre Werte der Zeitreihe umzuwandeln, nutzt das Modell die inverse Projektion über den bereits bekannten Flex-Resize-Mechanismus, dieses Mal angewendet auf die Decoder-Parameter θd.
Somit generiert das Modell den gesamten Prognosehorizont 𝐘̂ auf einmal, ohne die für schrittweise Prognosen typischen Fehlerakkumulationen und Verzögerungen. Dies beschleunigt nicht nur die Berechnungen, sondern bewahrt auch die Periodizität besser, da sie bereits in der Tokenisierungsphase angelegt wurde und nun durch die gesamte Architektur getragen wird – vom Encoder bis zur finalen Ausgabe.
Hinter den Kulissen läuft LightGTS wie ein Uhrwerk: rhythmisch, präzise und ohne unnötigen Overhead. Dank periodischer Tokenisierung und paralleler Dekodierung umgeht das Modell die klassischen Fallstricke schwerfälliger Architekturen und mangelnder Übertragbarkeit.
Entsprechend der gängigen Praxis bei Zeitreihenprognosen verwenden die Autoren des LightGTS-Frameworks den klassischen mittleren quadratischen Fehler (MSE) als Verlustfunktion. Er misst die Abweichung zwischen Prognosewerten und tatsächlich beobachteten Daten und dient als objektives Kriterium für die Prognosequalität.
Nachstehend ist die von den Autoren erstellte Darstellung des LightGTS-Frameworks abgebildet.
Implementierung mit MQL5
Nach einer ausführlichen Betrachtung der theoretischen Aspekte des LightGTS-Frameworks wenden wir uns nun dem praktischen Teil unseres Artikels zu. In diesem Abschnitt stellen wir unseren eigenen Ansatz zur Implementierung der Schlüsselkomponenten des Modells mithilfe von MQL5 vor – unter Berücksichtigung der Eigenschaften finanzieller Zeitreihen und der Einschränkungen der Plattform.
Beginnen wir mit einem der grundlegendsten – und zugleich interessantesten – Elemente: dem adaptiven periodischen Patching. Mit diesem Mechanismus beginnt der Prozess der Umwandlung einer Zeitreihe in eine Struktur, die für die Verarbeitung durch einen Transformer geeignet ist. Hier stehen wir vor mehreren nicht trivialen Herausforderungen.
Eine davon – dynamische Änderungen der Patchgröße – wird bereits von den Autoren des ursprünglichen Frameworks erwähnt. Die Arbeit schlägt eine elegante Methode zur Lösung dieses Problems vor, die auf der linearen Interpolation von Gewichten basiert. In der Praxis löst dies jedoch nur einen Teil des Problems.
Denn wenn sich die Patchgröße ändert, ändert sich auch die Anzahl der Patches – dynamisch und unvorhersehbar. Dies führt zu einer zusätzlichen Komplexitätsebene in der Architektur des Modells, insbesondere bei der Implementierung in einer streng typisierten Sprache wie MQL5. Herkömmliche Schleifen und Arrays erfordern in allen Phasen eine präzise Größenkontrolle. Das bedeutet, dass nicht nur die Dimensionalität der Eingabedaten angepasst werden muss, sondern auch ein Mechanismus entwickelt werden muss, um die Zeitreihe adaptiv in eine variable Anzahl von Patches aufzuteilen – unter Wahrung ihrer Periodizität und Konsistenz mit historischen Beobachtungen.
Leider lassen die von uns verwendeten architektonischen Lösungen keine dynamische Dimensionalität für Eingabe- oder Ausgabetensoren zur Laufzeit zu. Daher benötigen wir einen anderen, pragmatischeren Ansatz, der feste Puffergrößen vorsieht und es uns dennoch ermöglicht, mit einer variablen Anzahl von Tokens zu arbeiten.
Eine mögliche Option besteht darin, einen überdimensionierten Puffer anzulegen, der so ausgelegt ist, dass er die maximal mögliche Anzahl von Tokens aufnehmen kann. Ist die tatsächliche Anzahl der Tokens geringer, werden die zusätzlichen Zellen auf Null gesetzt. Dieser Ansatz bietet zwar ein gewisses Maß an Flexibilität bei der Arbeit mit unterschiedlichen Patch-Anzahlen; diese Flexibilität geht jedoch auf Kosten eines unnötigen Speicherverbrauchs, von dem ein erheblicher Teil ungenutzt bleibt.
Darüber hinaus darf eine wesentliche Schwäche der Transformer-Architektur nicht übersehen werden: die quadratische Komplexität der Attention in Abhängigkeit von der Sequenzlänge. Je mehr Tokens wir einspeisen, desto mehr Zeit und Ressourcen werden für die Verarbeitung der Attention-Blöcke selbst benötigt. Mit anderen Worten: Eine übermäßige Anzahl von Tokens ist nicht nur speicherineffizient, sondern beeinträchtigt auch direkt die Rechenleistung des Modells, insbesondere unter Echtzeitbedingungen oder bei der Verarbeitung von Arrays hochfrequenter Marktdaten.
Daher besteht Bedarf an einem alternativen, flexibleren Ansatz. In diesem Zusammenhang ist das von den Autoren vorgeschlagene Konzept des LightGTS-Frameworks mit nicht überlappenden periodischen Patches erwähnenswert; nach diesem Konzept entspricht jedes Segment der Zeitreihe einem einzelnen vollständigen Zyklus. Das ist durchaus logisch: Eine Zeitreihe enthält oft unterschiedliche periodische Komponenten, und die separate Analyse jeder Periode ermöglicht es uns, semantisch saubere Merkmale zu extrahieren.
Wir schlagen jedoch vor, das Problem aus einer anderen Perspektive zu betrachten. Was wäre, wenn wir die strenge Vorgabe aufgeben würden, dass sich Patches nicht überlappen dürfen? Stattdessen können wir die gewünschte Anzahl von Ausgabe-Patches festlegen und die Überlappungslänge zwischen benachbarten Fenstern in Abhängigkeit von der Periodizität der Eingabesequenz anpassen.
Dieser Ansatz bietet eine Reihe von Vorteilen. Erstens gewährleistet er eine konstante Anzahl von Patches, unabhängig von der Periodizität der analysierten Zeitreihe. Das ist bei der Entwicklung einer festen Architektur äußerst praktisch. Zweitens ermöglicht eine flexible Überlappung eine vollständige Erfassung der zyklischen Datenstruktur, ohne dass diese abgeschnitten wird oder Informationen zwischen den Fenstergrenzen verloren gehen. Schließlich ermöglicht dies eine feiner abgestufte Steuerung der Auflösung der semantischen Repräsentation, ohne die Kompaktheit des Ausgabetensors zu beeinträchtigen.
Einfach ausgedrückt schlagen wir vor, die strenge Regel „ein Patch – ein Zyklus“ durch eine kontrollierte Repräsentationsdichte zu ersetzen, wobei die Gesamtmenge der Ausgabeinformationen erhalten bleibt und die Robustheit des Modells gegenüber Änderungen der Länge der Eingabe-Zeitreihe erhöht wird.
Ich denke, das Konzept ist klar. Jetzt ist der perfekte Zeitpunkt, um zur praktischen Umsetzung überzugehen. Der erste Schritt besteht darin, die Periodizität der zu analysierenden Zeitreihe zu bestimmen. Dazu werden wir eine klassische, bewährte Methode verwenden, die auf der schnellen Fourier-Transformation (FFT) basiert.
Der Kern dieses Ansatzes ist einfach: Wir untersuchen das Amplitudenspektrum der Frequenzkomponenten der Zeitreihe und ermitteln die Frequenz mit der höchsten Energie. Diese Frequenz entspricht in der Regel dem dominanten Zyklus in den Daten. Die Periode wiederum wird als Kehrwert der ermittelten Frequenz berechnet.
Warum entscheiden wir uns gerade für die FFT? Erstens handelt es sich um einen schnellen und effizienten Algorithmus, selbst bei der Verarbeitung großer Datenmengen. Zweitens ermöglicht es die Identifizierung verborgener periodischer Abhängigkeiten, die visuell möglicherweise nicht zu erkennen sind. Schließlich besteht einer der Vorteile der FFT darin, dass sie es uns ermöglicht, auch dann zu arbeiten, wenn uns A-priori-Informationen über die Frequenzeigenschaften einer Zeitreihe fehlen – was bei realen Handelsdaten häufig der Fall ist.
Und natürlich ist ein weiterer Vorteil die Verfügbarkeit einer vorgefertigten FFT-Implementierung in unserer Bibliothek. Ich möchte Sie daran erinnern, dass wir sie im Rahmen unserer Arbeit mit dem FITS-Framework verwendet haben.
Die FFT-Implementierung in unserer Bibliothek liefert den Real- und den Imaginärteil des Spektrums, was genau der klassischen Darstellung des Ergebnisses der schnellen Fourier-Transformation entspricht. Diese Information allein beantwortet jedoch nicht die Frage, welche Frequenz das Signal dominiert und die Struktur der Schwingungen bestimmt.
Um eine Überlastung der CPU zu vermeiden und die Parallelisierungseffizienz aufrechtzuerhalten, implementieren wir einen Kernel, der die dominante Frequenz für jede einzelne Sequenz direkt im OpenCL-Kontext ermittelt. Jedes Work-Item erhält sein eigenes Spektrum, berechnet die Energie aller Frequenzkomponenten und wählt die Komponente mit der höchsten Amplitude aus. Es ist, als würde man einer komplexen Melodie lauschen und sofort den zugrunde liegenden Rhythmus erkennen, der ihr ihre Struktur verleiht. Dieser Ansatz ist besonders wichtig bei der Arbeit mit multivariaten Zeitreihen, bei denen jede Variable ihre eigene charakteristische Frequenz aufweisen kann.
Wir implementieren den Algorithmus im OpenCL-Kernel MainFreq, der mit Arrays reeller und imaginärer Spektralkomponenten arbeitet. Er gibt ein Array zurück, das die Indizes der hervorstechendsten Frequenzen für jede Sequenz enthält.
__kernel void MainFreq(__global const float* freq_r,
                       __global const float* freq_im,
                       __global float *main_freq,
                       int dimension
                      )
  {
   if(dimension <= 0)
      return;
//---
   size_t n = get_global_id(0);
   const int shift = n * dimension;
Im Kernel-Rumpf identifizieren wir zunächst jedes Work-Item in einem eindimensionalen Aufgabenraum. Der daraus resultierende Index gibt die eindeutige Nummer der jeweiligen analysierten Sequenz an. Anhand dieses Index ermitteln wir sofort den Versatz in den Spektrum-Arrays, sodass jedes Work-Item nur seine eigene Sequenz verarbeitet.
Als Nächstes initialisieren wir die Variablen, um die maximale Amplitude (Energie) und den dazugehörigen Index zu speichern.
float max_f = 0;
float max_id = 0;
float energy;
Damit sind die Vorbereitungen abgeschlossen, und als Nächstes richten wir eine Schleife über das Spektrum ein, beginnend mit der ersten Harmonischen.
for(int i = 1; i < dimension; i++)
  {
   float2 freq = (float2)(freq_r[shift + i], freq_im[shift + i]);
   energy = ComplexAbs(freq);
   if(max_f < energy)
     {
      max_f = energy;
      max_id = i + 1;
     }
  }
Wir überspringen bewusst die Nullfrequenz (die DC-Komponente) – sie trägt keine Informationen über die Periodizität, sondern spiegelt den Gleichanteil des Signals wider.
Bei jeder Iteration bilden wir eine komplexe Zahl aus dem Real- und dem Imaginärteil. Der Betrag dieser Zahl gibt die Stärke der entsprechenden Frequenz an. Wenn die ermittelte Energie das aktuelle Maximum überschreitet, aktualisieren wir die Werte.
Nachdem wir schließlich das gesamte Spektrum durchlaufen haben, schreiben wir das Ergebnis in den globalen Datenpuffer.
 main_freq[n] = max_id;
}
Der Algorithmus funktioniert wie ein erfahrener Dirigent, der jedes Instrument im Orchester genau im Blick behält und ermittelt, welches davon die Hauptstimme spielt. Wir ermitteln nicht nur die Frequenz – wir berechnen auch die ausgeprägteste Periode des Signals, die anschließend verwendet wird, um im Modell adaptiv Patches zu konstruieren. Und da jede Zeitreihe (in einem multimodalen Umfeld) unabhängig verarbeitet wird, erhalten wir letztendlich ein skalierbares, flexibles und vollständig autonomes System zur Bestimmung der lokalen Periodizität.
Hervorzuheben ist zudem, dass der vorgeschlagene Algorithmus vollständig deterministisch ist, keine trainierbaren Parameter enthält und keine Trainingskosten verursacht. Es stützt sich ausschließlich auf die physikalischen Eigenschaften des Spektrums: Die Amplitude der Frequenzkomponenten wird direkt geschätzt, ohne dass dabei statistische Verfahren, Regressionen oder adaptive Gewichte zum Einsatz kommen. Dadurch ist die Methode transparent, zuverlässig und besonders praktisch in der Phase der Datenvorverarbeitung – wenn es entscheidend ist, Verzerrungen durch Unter- oder Überanpassung zu vermeiden. Mit anderen Worten: Dieser Ansatz stützt sich auf reine, unverzerrte Mathematik und nicht auf probabilistische Annahmen, was bei der Analyse volatiler Marktzeitreihen besonders wichtig ist.
Der nächste Schritt unserer Arbeit wird die eigentliche Implementierung des adaptiven Patching-Algorithmus mit einer sich dynamisch ändernden Segmentgröße sein. Wie Sie sich jedoch vorstellen können, lässt sich das nicht mit wenigen Worten erklären. Die Umsetzung erfordert die Berücksichtigung einer Vielzahl technischer Details, und dieser Artikel ist ohnehin schon ziemlich lang. Ganz in der Tradition spannender Fernsehserien empfehlen wir daher, eine kurze Pause einzulegen und unsere Erörterung darüber, wie die vorgeschlagenen Ansätze umgesetzt werden können, im nächsten Artikel fortzusetzen.
In jenem Artikel werden wir Schritt für Schritt erläutern, wie man einen Mechanismus zur dynamischen Generierung von Patches implementiert, der variable Zykluslängen berücksichtigt und gleichzeitig eine konstante Anzahl von Ausgabe-Tokens gewährleistet. Wir werden die möglichen Kompromisse zwischen architektonischer Flexibilität und Recheneffizienz untersuchen.
Fazit
In diesem Artikel haben wir die theoretischen Grundlagen des LightGTS-Frameworks eingehend untersucht und dabei den Schwerpunkt auf dessen Schlüsselkomponenten gelegt: periodisches Patching, flexible Tokenprojektion und den parallelen Dekodierungsmechanismus. Wir haben untersucht, wie die Architektur mit multivariaten Zeitreihen umgeht und sich an unterschiedliche Perioden anpasst, ohne dass das Modell neu trainiert werden muss. Besonderes Augenmerk wurde auf die technischen Aspekte der Berechnung der dominanten Frequenz mithilfe der schnellen Fourier-Transformation gelegt.
Wir haben außerdem die praktischen Einschränkungen im Zusammenhang mit der dynamischen Speicherzuweisung und einer variablen Anzahl von Tokens erörtert und alternative Lösungen vorgeschlagen, die auf überlappenden Patches und einem Ausgabevektor fester Länge basieren. Dieser Ansatz verbessert nicht nur die Kompatibilität mit der Transformer-Architektur, sondern ermöglicht auch eine effizientere Nutzung der Ressourcen, wodurch übermäßiger Speicherverbrauch und Leistungseinbußen vermieden werden.
Das hier vorgestellte Material bildet eine solide Grundlage für die anschließende Umsetzung der Vollversion des adaptiven Patching-Verfahrens und deren Integration in die Prognosearchitektur. Im nächsten Artikel werden wir diesen Weg fortsetzen und uns dabei auf konkrete Implementierungen der adaptiven Zeitreihensegmentierung sowie auf die Integration der daraus resultierenden Tokens in ein trainierbares Modell konzentrieren.
Literaturverzeichnis
In diesem Artikel verwendete Programme
| # | Name | Typ | Beschreibung |
|---|---|---|---|
| 1 | Study.mq5 | Expert Advisor | Expert Advisor für das Offline-Modelltraining |
| 2 | StudyOnline.mq5 | Expert Advisor | Expert Advisor für Online-Modelltraining |
| 3 | Test.mq5 | Expert Advisor | Expert Advisor zum Testen des Modells |
| 4 | Trajectory.mqh | Klassenbibliothek | Struktur zur Beschreibung des Systemzustands und der Modellarchitektur |
| 5 | NeuroNet.mqh | Klassenbibliothek | Klassenbibliothek zum Erstellen neuronaler Netze |
| 6 | NeuroNet.cl | Bibliothek | Codebibliothek für ein OpenCL-Programm |
Übersetzt aus dem Russischen von MetaQuotes Ltd.
Originalartikel: https://www.mql5.com/ru/articles/18596
Warnung: Alle Rechte sind von MetaQuotes Ltd. vorbehalten. Kopieren oder Vervielfältigen untersagt.
Dieser Artikel wurde von einem Nutzer der Website verfasst und gibt dessen persönliche Meinung wieder. MetaQuotes Ltd übernimmt keine Verantwortung für die Richtigkeit der dargestellten Informationen oder für Folgen, die sich aus der Anwendung der beschriebenen Lösungen, Strategien oder Empfehlungen ergeben.

 Neuronale Netze im Trading: Eine intelligente Prognosepipeline (Sparse Mixture of Experts)
 Neuronale Netze im Trading: Adaptive periodische Segmentierung (Token-Generierung)
 Neuronale Netze im Trading: Adaptive periodische Segmentierung (Fazit)
 Von den Grundlagen bis zur Mittelstufe: Navigation durch die Sandbox

- Freie Handelsapplikationen
- Über 8.000 Signale zum Kopieren
- Wirtschaftsnachrichten für die Lage an den Finanzmärkte
Sie stimmen der Website-Richtlinie und den Nutzungsbedingungen zu.