

Neuronale Netze im Trading: Zerlegung strukturierter Komponenten (SCNN)
 17
 0

Einleitung
Die Prognose multivariater Zeitreihen ist ein grundlegendes Problem im maschinellen Lernen. Aus dieser Perspektive lässt sich eine Vielzahl anwendungsbezogener Probleme untersuchen: von der Abschätzung der Nachfrage und der Prognose des Verkehrsaufkommens bis hin zur Analyse des Verhaltens von Marktteilnehmern sowie von Kursbewegungen. Dies gilt insbesondere für den Finanzsektor – schließlich lässt sich praktisch jeder Vermögenswert, sei es eine Aktie, eine Währung oder ein Rohstoff, durch eine komplexe multivariate Zeitreihe mit einer Vielzahl miteinander verknüpfter Faktoren darstellen: Volumina, Kurse, Indikatoren, makroökonomische Daten, Verhaltenssignale und so weiter.
Die größte Herausforderung bei der Erstellung solcher Prognosen besteht darin, raumzeitliche Muster zu erkennen. Räumliche Aspekte spiegeln sich in den Merkmalen des externen Umfelds wider: Unterschiede hinsichtlich der Liquidität, der Handelssitzungen und der regionalen Aktivität. Zeitliche Muster hingegen hängen mit den Rhythmen der Märkte selbst zusammen – mit Handelszyklen, nachrichtengetriebenen Ausschlägen und der Periodizität der Veröffentlichung makroökonomischer Daten. In der Praxis sind Finanzzeitreihen alles andere als stationär. Sie unterliegen plötzlichen Veränderungen, Verteilungsverschiebungen und komplexen Übergängen zwischen verschiedenen Phasen – Trends, Seitwärtsbewegungen, Panik und Euphorie. Zudem sind Autokorrelationsstrukturen unbeständig: Was heute funktioniert, hat morgen möglicherweise keine Prognosekraft mehr.
Moderne, auf neuronalen Netzen basierende Methoden wie Transformer, rekurrente neuronale Netze und Faltungsarchitekturen erfordern keine Stationaritätsannahme und haben sich bei kurzfristigen Prognoseaufgaben als wirksam erwiesen. Unter realen Marktbedingungen sind sie meist nur gegenüber bekannten Mustern robust. Bei plötzlichen Veränderungen – sei es ein Liquiditätszusammenbruch oder eine Veränderung der Verhaltensmuster der Marktteilnehmer – sinkt ihre Genauigkeit jedoch drastisch. Zudem bleiben solche Modelle im Wesentlichen „Black Boxes“ mit hohem Rechenaufwand und eingeschränkter Interpretierbarkeit.
In diesem Zusammenhang findet der Ansatz der Zerlegung von Zeitreihen – also deren Aufschlüsselung in Trend, Saisonalität und residuale Schwankungen – zunehmend Beachtung. Dieser Ansatz vereinfacht die Problemstruktur, verbessert die Anpassungsfähigkeit des Modells und vermittelt ein klareres Verständnis der Grundlage der Prognose. Selbst einfache lineare Modelle, die auf einer Zerlegung basieren, übertreffen komplexe neuronale Netze in manchen Fällen hinsichtlich Genauigkeit und Stabilität.
Man sollte jedoch bedenken, dass auch diese Methoden ihre Grenzen haben. Viele von ihnen konzentrieren sich ausschließlich auf langfristige und saisonale Komponenten und lassen dabei kurzfristige oder volatile Segmente außer Acht, in denen doch gerade die wichtigsten Marktsignale zu finden sind. Zudem erschwert die getrennte Verarbeitung verschiedener Komponenten ohne Informationsaustausch zwischen ihnen die Erfassung übergeordneter und nichtlinearer Wechselwirkungen. Die Verwendung statischer Parameter erweist sich jedoch angesichts der dynamischen Autokorrelation als unwirksam, da sich die optimalen Einstellungen des Modells flexibel an die aktuellen Marktbedingungen anpassen müssen.
Um diese Herausforderungen zu bewältigen, wurde in dem Artikel „Disentangling Structured Components: Towards Adaptive, Interpretable and Scalable Time Series Forecasting“ eine neue Architektur vorgestellt – das Structured Component Neural Network (SCNN). Es handelt sich um das erste neuronale Netzwerk dieser Art, das vollständig auf der strukturellen Zerlegung von Zeitreihen basiert. Der Grundgedanke hinter SCNN besteht darin, Daten strategisch in mehrere heterogene Komponenten zu zerlegen: nicht nur langfristige Trends und saisonale Schwankungen, sondern auch sich schnell verändernde, volatile Segmente. Jede Gruppe wird von einem eigenen Teilnetzwerk verarbeitet, das auf ihre jeweilige Dynamik abgestimmt ist. Dank dieses Ansatzes reagiert das Modell besser auf Veränderungen der Marktbedingungen, und seine Funktionsweise wird verständlicher und transparenter.
Ein wesentliches Unterscheidungsmerkmal von SCNN besteht darin, dass die Zerlegungs- und Rekonstruktionsprozesse in die Struktur des neuronalen Netzes selbst integriert sind, statt auf die Eingabe- und Ausgabestufen beschränkt zu bleiben. Diese Architektur ermöglicht nicht nur eine tiefgehende Zerlegung der Daten, sondern auch die Identifizierung komplexer Wechselwirkungen zwischen Komponenten, einschließlich Querverbindungen und latenter Abhängigkeiten. Darüber hinaus ist jedes Netzwerkmodul als Architektur mit zwei Zweigen aufgebaut: Ein Zweig passt die Modellparameter dynamisch an die aktuellen Marktbedingungen an, während der andere diese Parameter zur Verarbeitung verborgener Merkmale nutzt. Im Wesentlichen konfiguriert sich das Modell zur Laufzeit neu und passt sich dabei an die aktuelle Autokorrelationsstruktur an.
Um die Robustheit und die Generalisierungsfähigkeit von SCNN weiter zu verbessern, haben die Autoren des Frameworks einen speziellen strukturellen Regularisierungsmechanismus integriert. Dadurch kann sich das Modell auf jene Komponenten der Zeitreihe konzentrieren, die weniger anfällig für Rauschen und Verzerrungen sind. Selbst in einem instabilen Marktumfeld, in dem manche Muster schnell an Bedeutung verlieren, während andere plötzlich auftauchen, weist SCNN daher eine hohe Genauigkeit und Zuverlässigkeit auf.
Dies wird durch die Ergebnisse umfangreicher experimenteller Tests bestätigt, die von den Autoren des Frameworks an drei unabhängigen Datensätzen durchgeführt wurden. SCNN schnitt durchweg besser ab als konkurrierende Methoden, insbesondere bei starken Verteilungsverschiebungen und Anomalien in den Daten. Besonders wichtig ist, dass all dies mit einem vertretbaren Rechenaufwand erreicht wird, wodurch sich das Modell sowohl für lokale Berechnungen als auch für die Integration in Handelssysteme eignet.
Der SCNN-Algorithmus
In ihrer Arbeit gehen die Autoren des SCNN-Frameworks davon aus, dass eine Zeitreihe stufenweise entsteht – von zufälligen Störungen bis hin zu komplexen Marktstrukturen.
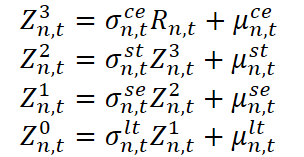
Dabei ist Z⁰n,t der ursprüngliche Wert der beobachteten Zeitreihe (beispielsweise der Kurs oder das Handelsvolumen), und Zⁱn,t für i = 1, 2, 3 sind Zwischenrepräsentationen auf verschiedenen Ebenen der Struktur. Rn,t ist die Residualkomponente, die Rauschen oder unerwartete Ausreißer enthält. Jede Stufe umfasst sowohl einen multiplikativen Koeffizienten σ, der den Skalierungseffekt widerspiegelt, als auch eine additive Verschiebung µ, die absoluten Anpassungen entspricht.
Um ein intuitives Verständnis dieser Struktur zu erlangen, ziehen wir eine Analogie zur Analyse von Marktdaten heran. Werfen wir einen Blick auf die Kursentwicklung eines Vermögenswerts. Die langfristige Komponente spiegelt grundlegende Veränderungen wider. Dies könnte auf die Auswirkungen der Zinssätze oder auf strukturelle Veränderungen in der Wirtschaft zurückzuführen sein. Die saisonale Komponente besteht aus wiederkehrenden Mustern, die mit Quartalsberichten, Steuerzeiträumen oder dem Verhalten wichtiger Marktakteure zusammenhängen. Die kurzfristige Komponente erfasst lokale Schwankungen, die beispielsweise durch Nachrichtenveröffentlichungen, eine erhöhte Handelsaktivität oder vorübergehende Liquiditätsengpässe verursacht werden. Die ko-evolvierende Schicht modelliert synchrone Marktereignisse – beispielsweise, wenn mehrere Aktien aus demselben Sektor gleichzeitig auf eine gemeinsame makroökonomische Nachricht reagieren. Die Residualkomponente besteht aus weißem Rauschen oder Ausreißern, die beispielsweise durch vereinzelte Großaufträge oder Notierungsfehler verursacht werden.
Man muss sich bewusst machen, dass unter realen Marktbedingungen die Grenzen zwischen diesen Ebenen recht fließend sind. So kann beispielsweise ein starker Anstieg des Handelsvolumens einer bestimmten Aktie zunächst als Ausreißer wahrgenommen werden, doch wenn er anhält, wird er zu einem kurzfristigen Trend. Wenn er wochenlang anhält, wird er schließlich Teil der langfristigen Struktur. Diese Entwicklung der Muster erfordert, dass Modelle flexibel sind und sich an die sich verändernde Struktur der Daten anpassen können.
In diesem Rahmen hat jede Komponente sowohl einen multiplikativen als auch einen additiven Effekt. Der multiplikative Effekt ermöglicht es uns, proportionale Veränderungen zu modellieren. Der additive Effekt spiegelt hingegen konstante Verschiebungen wider, wie beispielsweise die anhaltenden Auswirkungen von Unternehmensdividenden oder saisonalen Gebühren, die nicht vom aktuellen Preisniveau abhängen. Gerade die Kombination dieser beiden Arten von Effekten ermöglicht es, Marktdaten so realistisch wie möglich zu modellieren. Schließlich ist in manchen Fällen die relative Veränderung der entscheidende Faktor, während es in anderen Fällen der absolute Wert ist.
Die langfristige Komponente dient dazu, stabile strukturelle Muster in der Zeitreihe zu identifizieren, wie beispielsweise ein stetiges Wachstum der Handelsvolumina oder eine Zunahme der Marktaktivität vor dem Hintergrund eines wirtschaftlichen Aufschwungs. Mit Muster meinen wir nicht einfach eine chronologische Abfolge, sondern vielmehr die Form der Verteilung aggregierter Daten – ohne Bezug auf bestimmte Zeitpunkte. Somit wird die langfristige Struktur durch das statistische Profil der Daten bestimmt, die über einen längeren Zeitraum erhoben wurden, der mehrere saisonale Zyklen umfasst.
Das Prinzip ist einfach: Durch die Kombination von Beobachtungen aus verschiedenen saisonalen Zyklen lassen sich kurzfristige Schwankungen ausgleichen und eine klarere, weniger verrauschte Schätzung anhaltender Trends gewinnen. Dieser Ansatz hilft dabei, eine Überanpassung an vorübergehende Anomalien – wie beispielsweise einmalige Volumenspitzen oder kurzfristige Korrekturen – zu vermeiden, und ermöglicht es uns, uns auf die grundlegende Marktdynamik zu konzentrieren.
Zur Umsetzung dieses Ansatzes wird ein gleitendes Fenster der Länge ∆ verwendet, das es ermöglicht, Beobachtungen bei jedem Zeitschritt dynamisch auszuwählen. Anschließend werden zwei wichtige statistische Parameter berechnet: der Mittelwert (oder das Zentrum der Verteilung) und die Standardabweichung (die das Ausmaß der Schwankungen charakterisiert). Beide Parameter werden gemeinsam verwendet, um eine Darstellung der langfristigen Komponente zu bilden. Anschließend wird jedes neu analysierte Segment normalisiert – der langfristige Mittelwert wird von diesem Segment abgezogen, und das Ergebnis wird durch die Standardabweichung geteilt. Dadurch werden alle Segmente auf eine einheitliche Skala gebracht, langfristige Offsets beseitigt und die Daten für die nächste Stufe der Zerlegung vorbereitet.
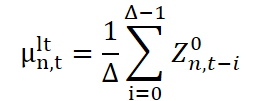
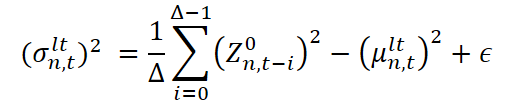
Dabei sind μˡᵗn,t und σˡᵗn,t jeweils der langfristige Mittelwert und die Skala (Standardabweichung), die aus den Daten im Fenster ∆ ermittelt wurden. Hierbei ist Z¹n,t der normalisierte Wert, aus dem die langfristige Komponente entfernt wurde; dieser Wert wird an die nächste Verarbeitungsstufe weitergeleitet, in der die Saisonalität identifiziert wird.
Diese Phase lässt sich als auf ein gemeinsames Niveau gebrachte Marktdarstellung verstehen, in der persistente strukturelle Trends bereits berücksichtigt sind. Dies ist insbesondere bei der Finanzprognose von Bedeutung, wo kurzfristige Strategien (wie beispielsweise Intraday-Strategien) Daten erfordern, aus denen langfristige Verschiebungen herausgefiltert wurden, um lokale Chancen ohne Verzerrung durch globale Trends zu erkennen.
Die saisonale Komponente dient dazu, wiederkehrende zyklische Muster in einer Zeitreihe zu identifizieren. Im Zusammenhang mit den Finanzmärkten können solche Muster beispielsweise Intraday-Spitzen bei der Handelsaktivität umfassen: morgendliche Anstiege, eine Flaute um die Mittagszeit und eine Zunahme am Abend vor Handelsschluss. Dazu könnten wöchentliche Muster gehören – wie beispielsweise eine geringere Volatilität an Freitagen oder höhere Handelsvolumina an Montagen – sowie vierteljährliche und jährliche saisonale Effekte im Zusammenhang mit Ergebnisberichten oder der Veröffentlichung makroökonomischer Daten.
Es wird davon ausgegangen, dass die Dauer des saisonalen Zyklus im Laufe der Zeit konstant bleibt – dies ist eine vereinfachte, aber praktikable Annahme. Für Szenarien mit variablen Zykluslängen schlagen die Autoren des Frameworks jedoch vor, eine automatische Saisonalitätsschätzung mithilfe der FFT (Fast Fourier Transform) zu integrieren.
Technisch gesehen ist die Extraktion der saisonalen Komponente ähnlich wie die langfristige Normalisierung aufgebaut, allerdings mit einem wichtigen Unterschied: Es wird ein dilatiertes Fenster verwendet, dessen Schrittweite der Zykluslänge entspricht. Sei τ die Fenstergröße und m der Dilatationsfaktor (der tatsächlich der Zykluslänge entspricht). Dadurch können die Daten in Intervallen abgetastet werden, die der saisonalen Struktur entsprechen.
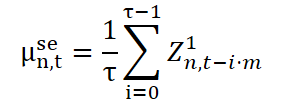
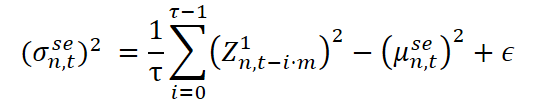
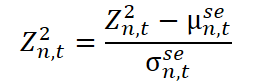
Dabei bezeichnet Z²n,t die normalisierten, saisonalitätsbereinigten Daten, die an die nächste Verarbeitungsstufe weitergeleitet werden.
Die kurzfristige Komponente dient dazu, lokale und unregelmäßige Abweichungen zu erfassen, die sich weder durch langfristige Trends noch durch saisonale Muster erklären lassen. An den Finanzmärkten können solche Effekte durch eine plötzliche Reaktion auf eine Nachrichtenmeldung, technische Störungen, spekulative Liquiditätsschübe oder eine abrupte Veränderung der Marktstimmung in Zeiten hoher Volatilität ausgelöst werden. Dies ist eine Art Marktpuls, der die Empfindlichkeit des Marktes gegenüber externen Reizen über sehr kurze Zeitintervalle hinweg widerspiegelt.
Im Gegensatz zur langfristigen Normalisierung wird hier ein kleines Glättungsfenster verwendet, um ein Verwischen kurzfristiger Schwankungen zu vermeiden. Sei δ die Länge dieses Fensters. Auf dieser Grundlage werden die üblichen statistischen Kennzahlen – Lage und Skala der Stichprobe – berechnet; anschließend werden die Daten normalisiert.
Der daraus resultierende Wert Z³n,t ist eine Zwischenrepräsentation, die gefiltert wurde, um kurzfristige Schwankungen zu entfernen, und anschließend an die letzte Stufe der Normalisierung weitergeleitet wird.
Diese Komponente hat jedoch ihre Grenzen. Erstens kann sie nicht sofort auf plötzliche, drastische Veränderungen reagieren – das Modell weist Trägheit auf. Zweitens kann eine Veränderung, die nur zwei oder drei Zeitschritte andauert, unbemerkt bleiben, insbesondere bei hoher Varianz. Dies lässt sich mit einer Marktsituation vergleichen, in der kurzfristige Schwankungen einer einzelnen Aktie vom System als Ganzes ignoriert werden können, wenn ihr Ausmaß im aggregierten Rauschen untergeht.
Um diesen Effekt auszugleichen und die Empfindlichkeit des Modells gegenüber kurzfristigen Signalen zu erhöhen, kommen in SCNN ko-evolvierende Zeitreihen zum Einsatz. Mit anderen Worten: Wird bei einem Instrument eine Abweichung festgestellt, prüft das Modell, ob bei anderen Vermögenswerten – wie Derivaten, Indizes oder Handelsvolumina – synchrone Signale vorliegen. Somit wird die kurzfristige Komponente nicht nur reaktiv, sondern auch kontextsensitiv – was insbesondere im Hochfrequenz- und algorithmischen Handel von Bedeutung ist.
Die ko-evolvierende Komponente spielt in der Gesamtstruktur des Modells eine besondere Rolle. Im Gegensatz zu den vorangegangenen drei Komponenten, die das Verhalten jeder Zeitreihe isoliert analysieren, stützt sich dieser Teil des Modells auf räumliche Korrelationen und ermöglicht es, Veränderungen zu erfassen, die zeitgleich in mehreren Zeitreihen auftreten. Wenn zwei oder mehr Zeitreihen zu denselben Zeitpunkten eine ähnliche Dynamik aufweisen, deutet dies stark auf das Vorhandensein eines gemeinsamen generativen Prozesses hin. In diesem Fall können wir diesen Prozess schätzen, indem wir die relevanten Beobachtungen aggregieren.
Um diesen Ansatz umzusetzen, muss jedoch eine zentrale Herausforderung bewältigt werden: die genaue Bestimmung der Zeitreihen, die an diesem gemeinsamen Prozess beteiligt sind. Im Grunde geht es darum, die Korrelation zwischen Zeitreihen zu messen. Hier gibt es zwei mögliche Ansätze: Entweder legt man die Korrelationsmatrix im Voraus auf der Grundlage von Expertenwissen fest, oder man erlernt sie direkt aus den Daten. Die Autoren des Frameworks entschieden sich für den zweiten Ansatz – einen, der flexibler und universeller einsetzbar ist, insbesondere wenn keine Vorabinformationen über die Datenstruktur vorliegen.
Für jedes Zeitreihenpaar n und n' wird ein individueller Attention-Koeffizient berechnet, der anschließend mithilfe der SoftMax-Funktion normalisiert wird. Dadurch wird sichergestellt, dass die Summe der Gewichte für jede Zeitreihe gleich eins ist.
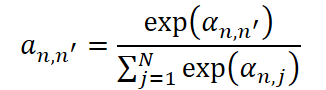
Anhand dieser Gewichte berechnen wir die Parameter der ko-evolvierenden Komponente. Zunächst wird der Mittelwert berechnet, der die lokale Zentrierung widerspiegelt und dabei die Wechselbeziehungen berücksichtigt.
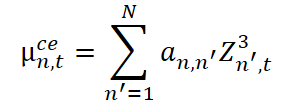
Anschließend wird die Skala (Standardabweichung) unter Hinzunahme der stabilisierenden Konstante ϵ geschätzt.
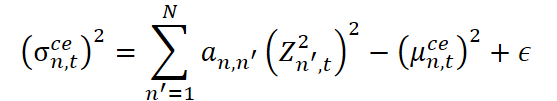
Auf dieser Grundlage wird ein normalisiertes Residuum gebildet.
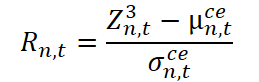
Dieses Residuum Rn,t stellt den Teil des Signals dar, der sich nicht durch eine der zuvor identifizierten Komponenten erklären lässt. Es spiegelt verbleibende Unsicherheit, strukturelles Rauschen oder individuelle Abweichungen einer bestimmten Zeitreihe von der Gesamtdynamik wider, die sich nicht formalisieren lassen.
Bei der Arbeit mit einer großen Anzahl von Zeitreihen lässt sich die Skalierbarkeit des Modells weiter verbessern. Zu diesem Zweck wird vorgeschlagen, ein Lernmodul für die Adjazenzmatrix einzusetzen, das eine flexible Anpassung der Attention-Architektur sowie eine Optimierung der Berechnungen ermöglicht.
In der letzten Phase werden alle Zwischenrepräsentationen zu einem einzigen Merkmalsvektor zusammengefasst.
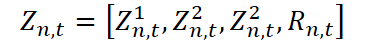
Gleichzeitig wird ein Hilfsvektor mit Normalisierungsparametern erzeugt.
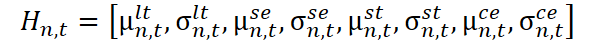
Eine Zeitreihe ist also nicht mehr bloß eine Menge von Werten, die über die Zeit aufgezeichnet wurden. Sie wird in eine Mehrkomponentendarstellung umgewandelt, in der jede Komponente eine bestimmte Art von Dynamik erfasst: einen strukturellen Trend, wiederkehrende saisonale Schwankungen, lokale kurzfristige Fluktuationen oder kollektive synchrone Veränderungen. Dadurch lassen sich Daten genauer analysieren, interpretierbare Modelle erstellen und robuste Prognosealgorithmen entwickeln.
Da jede Komponente ihre eigene Dynamik mit unterschiedlichem Grad an Prognostizierbarkeit aufweist, ergibt sich zwangsläufig die Notwendigkeit, ihr Verhalten separat zu modellieren. Dies ist insbesondere für die kurzfristige Prognose von Bedeutung, wenn langfristige und saisonale Komponenten in der Regel stabil bleiben und relativ regelmäßigen Mustern folgen. Unter solchen Bedingungen lassen sie sich weiterhin direkt extrapolieren, ohne dass zusätzliche Parameter oder komplexe Modelle eingeführt werden müssen.
Für die langfristige Komponente wird daher der einfachste Ansatz gewählt: Es wird davon ausgegangen, dass ihre Werte über den gesamten Prognosehorizont hinweg konstant bleiben. Mit anderen Worten: Wenn die aktuellen Schätzwerte der Parameter dieser Komponente bekannt sind, schreiben wir sie einfach in die Zukunft fort.
Die saisonale Komponente hingegen beruht auf Periodizität und erfordert einen etwas differenzierteren Ansatz. Da die Zyklizität erhalten bleibt, verwenden wir Parameterwerte aus früheren Zeitpunkten wieder, die sich in derselben Phase des Zyklus befinden wie der zu prognostizierende Zeitpunkt. Mit anderen Worten: Die Werte der saisonalen Komponente zum Zeitpunkt t+i werden dem Zeitpunkt t-m+i entnommen, wobei m die Zykluslänge ist.
Diese Methode bewahrt den saisonalen Rhythmus und ermöglicht es, das Verhalten der Komponente mit hoher Genauigkeit zu extrapolieren, ohne das Modell zusätzlich zu belasten.
Im Gegensatz zu den langfristigen und saisonalen Komponenten weisen die kurzfristige Komponente, ko-evolvierende Abhängigkeiten und Residualdarstellungen eine wesentlich größere Stochastizität auf. Ihre Dynamik ist deutlich unregelmäßiger, was die Anwendung fester Heuristiken oder streng definierter Extrapolationsregeln unmöglich macht. Aus diesem Grund wenden die Autoren des Rahmenwerks für jede dieser drei Komponenten ein auf Autoregression basierendes parametrisiertes Modell an; dadurch können sie deren komplexe und unvorhersehbare Schwankungen berücksichtigen.
Für jeden Zeitpunkt i innerhalb des Prognosehorizonts werden die Werte der entsprechenden Komponenten auf der Grundlage der δ vorhergehenden Werte mithilfe eines linearen Modells mit trainierbaren Gewichten berechnet. Das Extrapolationsverfahren ist für die kurzfristige, die ko-evolvierende und die Residualkomponente identisch und lässt sich wie folgt ausdrücken:
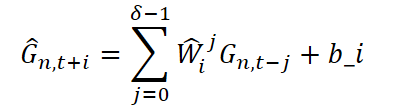
wobei G ∈ {Zˡn,t+i, μstn,t+i, σstn,t+i, μcen,t+i, σcen,t+i} die extrapolierten Parameter bezeichnet, die den verschiedenen Komponenten entsprechen; Ŵji ∈ Rdz · dz sind trainierbare Gewichtsmatrizen, die den Beitrag vergangener Werte widerspiegeln; bi ist der Bias-Term (bias), der ebenfalls trainierbar ist.
Nach der Extrapolation werden alle Komponenten zu zwei Vektoren zusammengefasst:
- Ĥn, t+i — eine Menge statistischer Parameter;
- Źn, t+i — eine Menge normalisierter Darstellungen.
Um die Wechselwirkung zwischen diesen beiden Merkmalsmengen zu modellieren, wird eine paarweise Multiplikation (ein elementweises Produkt) auf zwei lineare Projektionen angewendet, die jeweils mithilfe einer trainierbaren Parametermatrix gebildet werden.
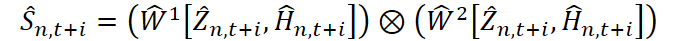
Auf diese Weise entsteht die endgültige Prognoserepräsentation, in der alle statistisch signifikanten Aspekte des untersuchten Prozesses zusammengeführt werden.
Implementierung mit MQL5
Nach einer eingehenden Untersuchung der theoretischen Grundlagen des SCNN-Frameworks wenden wir uns nun dessen praktischer Umsetzung zu. In diesem Abschnitt erläutern wir, wie sich die Kernideen des Modells mithilfe von MQL5 praktisch umsetzen lassen. Dabei zeigen wir, wie man eine Zeitreihe in ihre strukturellen Komponenten zerlegt und wie man den prädiktiven Teil des Modells aufbaut, ohne dabei dessen Interpretierbarkeit und Modularität zu beeinträchtigen. Dieser Ansatz ebnet den Weg für die Entwicklung intuitiver, flexibler und anpassungsfähiger Handelsstrategien auf der Grundlage komplexer neuronaler Netzwerkarchitekturen.
In der ersten Phase der Umsetzung des SCNN-Frameworks werden wir uns auf die Entwicklung des Kernblocks konzentrieren: einen Algorithmus zur Extraktion statistischer Kenngrößen und zur Normalisierung der Eingabedaten innerhalb fester Zeitintervalle. Dieser Schritt spielt eine entscheidende Rolle bei der Zerlegung der Zeitreihe, da hier die langfristige und die kurzfristige Komponente gebildet werden, auf denen später die gesamte nachfolgende Prognose basiert.
Der Algorithmus ist als OpenCL-Kernel namens PeriodNorm implementiert, der für die Berechnung statistischer Kenngrößen und die Normalisierung der Daten innerhalb gleitender Fenster der Zeitreihe zuständig ist. Die Umsetzung basiert auf dem Konzept der parallelen Verarbeitung, bei dem die Daten für alle Variablen und Zeitfenster gleichzeitig verarbeitet werden.
__kernel void PeriodNorm(__global const float* inputs,
                         __global float2* mean_stdevs,
                         __global float* outputs,
                         const int total_inputs
                        )
  {
   const size_t i = get_global_id(0);
   const size_t p = get_local_id(1);
   const size_t v = get_global_id(2);
   const size_t windows = get_global_size(0);
   const size_t period = get_local_size(1);
   const size_t variable = get_global_size(2);
Die Funktion übernimmt ein Array von Eingabewerten, inputs, sowie Arrays zur Speicherung der normalisierten Werte, outputs, und der berechneten statistischen Parameter (Mittelwerte und Standardabweichungen), mean_stdevs. Außerdem wird der Parameter total_inputs übergeben; er legt die Länge der Zeitreihe pro Variable fest.
Die Work-Items sind in drei Dimensionen organisiert: Die erste Koordinate entspricht der Fensternummer (Zeitabschnitt), die zweite der Position innerhalb des Fensters und die dritte dem Variablenindex. Somit ist jedes Work-Item für ein bestimmtes Zeitreihenelement innerhalb eines bestimmten Fensters und für eine bestimmte Variable zuständig.
Zunächst werden die Indizes berechnet, die für einen korrekten Zugriff auf die Daten im Speicher erforderlich sind. Die Variable shift_i gibt die Position des aktuellen Elements relativ zum Anfang der Zeitreihe an; shift_v gibt den Offset für die jeweilige Variable an und shift_ms die Position im Statistik-Array.
   __local float Temp[LOCAL_ARRAY_SIZE];
   const int shift_i = i * period + p;
   const int shift_v = v * total_inputs;
   const int shift_ms = v * windows + i;
Anschließend wird der Wert der Zeitreihe aus dem Quellarray abgerufen, wobei auf ungültige Werte geprüft wird: Wenn NaN oder unendliche Werte auftreten, werden sie durch null ersetzt.
//---
   float val = 0;
   if((shift_i) < total_inputs)
      val = IsNaNOrInf(inputs[shift_v + shift_i], 0);
Der nächste Schritt besteht darin, den Mittelwert innerhalb des aktuellen Fensters zu berechnen. Hierfür wird die Hilfsfunktion LocalSum verwendet; sie summiert die Elementwerte über alle Work-Items in der lokalen Gruppe hinweg, was die Leistung erheblich verbessert.
   float mean = IsNaNOrInf(LocalSum(val, 1, Temp) / period, 0);
   val -= mean;
   BarrierLoc;
Der berechnete Mittelwert wird dann von der aktuellen Beobachtung abgezogen, und die Standardabweichung wird auf dieser Grundlage als Quadratwurzel der mittleren quadratischen Abweichungen berechnet. Alle Schritte enthalten integrierte numerische Stabilitätsprüfungen, um eine Division durch Null und die Akkumulation von Fehlern zu verhindern.
   float stdev = LocalSum(val * val, 1, Temp) / period;
   stdev = IsNaNOrInf(sqrt(stdev), 1);
Die Ergebnisse werden in zwei Formen gespeichert: Erstens werden die statistischen Werte für jedes Fenster und jede Variable in das Array mean_stdevs geschrieben, und zweitens werden die normalisierten Werte im Array outputs zurückgegeben.
   mean_stdevs[shift_ms] = (float2)(mean, stdev);
   if((shift_i) < total_inputs)
      outputs[shift_v + shift_i] = IsNaNOrInf(val / stdev, 0);
  }
Die Normalisierung erfolgt anhand der klassischen Formel der z-Score-Normalisierung, wobei die laufend berechnete Standardabweichung als Norm verwendet wird.
Der Kernel ist so konzipiert, dass er sich problemlos skalieren lässt: Sie können die Fenstergröße, die Anzahl der Variablen oder die Länge der Zeitreihe ändern, ohne die Logik anzupassen. Insbesondere mit zunehmender Fensterlänge reagiert die Normalisierung empfindlich auf langfristige Trends und kann zur Extraktion des Trends genutzt werden. Umgekehrt ermöglicht eine Reduzierung der Fenstergröße eine genauere Erkennung kurzfristiger Abweichungen und Anomalien.
Um ein Modell mit einem vollständigen Trainingszyklus zu implementieren, der Backpropagation umfasst, müssen wir sicherstellen, dass Gradienten von den Ausgängen der neuronalen Netzwerkarchitektur zu deren Eingängen weitergeleitet werden können. Obwohl der PeriodNorm-Kernel keine trainierbaren Parameter enthält (alle Berechnungen sind rein statistischer Natur und basieren auf den eingegebenen Zeitreihendaten), müssen Gradienten berechnet werden, wenn die Normalisierung als Teil des Berechnungsgraphen durchgeführt wird. Daher fügen wir der Architektur einen zweiten Kernel, PeriodNormGrad, hinzu.
__kernel void PeriodNormGrad(__global const float* inputs,
                             __global float* inputs_gr,
                             __global const float2* mean_stdevs,
                             __global const float2* mean_stdevs_gr,
                             __global const float* outputs,
                             __global const float* outputs_gr,
                             const int total_inputs
                            )
  {
   const size_t i = get_global_id(0);
   const size_t p = get_local_id(1);
   const size_t v = get_global_id(2);
   const size_t windows = get_global_size(0);
   const size_t period = get_local_size(1);
   const size_t variable = get_global_size(2);
Im Gegensatz zu klassischen Blöcken mit trainierbaren Parametern ist der im PeriodNormGrad-Kernel implementierte Algorithmus so konzipiert, dass er den Fehler korrekt rückwärts durch eine Schicht propagiert, die selbst weder Neuronen noch Gewichte enthält. Zunächst wird innerhalb des Kernels für jede Variable ein elementweiser Zugriff auf jedes Zeitfenster der Zeitreihe eingerichtet. Die Indizes werden auf dieselbe Weise berechnet wie im Vorwärtsdurchlauf:
- i — Fensternummer,
- p — Position innerhalb des Fensters,
- v — Variablennummer.
Nachdem wir die Koordinaten auf diese Weise ermittelt haben, extrahieren wir alle erforderlichen Daten: den Eingabewert (inp), dessen normalisierte Version (out), den Fehlergradienten bezüglich des normalisierten Werts (out_gr) sowie den vorab berechneten Mittelwert und die Standardabweichung für das Fenster (mean_stdev) und die Gradienten bezüglich dieser Werte (mean_stdev_gr), die ebenfalls ermittelt werden können, wenn die Werte wiederholt verwendet werden. Insbesondere geht das SCNN-Framework davon aus, dass sie zur Datenextrapolation verwendet werden. Alle Werte werden auf ihre Gültigkeit überprüft – NaN-Werte und Unendlichkeiten werden herausgefiltert, um die Berechnungen nicht zu verfälschen.
   __local float Temp[LOCAL_ARRAY_SIZE];
   const int shift_i = i * period + p;
   const int shift_v = v * total_inputs;
   const int shift_ms = v * windows + i;
//---
   float inp = 0;
   float inp_gr = 0;
   float out = 0;
   float out_gr = 0;
   const float2 mean_stdev = means_stdevs[shift_ms];
   const float2 mean_stdev_gr = means_stdevs_gr[shift_ms];
   if((shift_i) < total_inputs)
     {
      inp = IsNaNOrInf(inputs[shift_v + shift_i], 0);
      out = IsNaNOrInf(outputs[shift_v + shift_i], 0);
      out_gr = IsNaNOrInf(outputs_gr[shift_v + shift_i], 0);
     }
Nun zum interessantesten Teil. Um zu verstehen, wie stark jeder einzelne Eingabewert den endgültigen Fehler des Modells beeinflusst hat, müssen wir berechnen, wie sich der Fehler verändern würde, wenn dieser Wert geringfügig geändert würde. In der Statistik erfolgt die Normalisierung durch Subtraktion des Mittelwerts und Division durch die Standardabweichung. Das bedeutet, dass sich jede Änderung der Eingabe sowohl auf den Zähler (die Abweichung vom Mittelwert) als auch auf den Nenner (den Grad der Streuung innerhalb des Fensters) auswirkt. Daher müssen wir die Gradienten in Bezug auf beide Parameter berechnen – den Mittelwert und die Standardabweichung.
   float mean_gr = LocalSum(out_gr, 1, Temp) / period + IsNaNOrInf(mean_stdev.x, 0);
   BarrierLoc;
   float stdev_gr = out * LocalSum(IsNaNOrInf(out * out_gr, 0), 1, Temp) / period +
                                                        IsNaNOrInf(mean_stdev.y, 0);
Dazu bilden wir zunächst die Summe aller Gradienten auf der Ebene des Schichtausgangs, out_gr, über das aktuelle Fenster und mitteln sie – dies ist der Beitrag zum Gradienten in Bezug auf den Mittelwert (mean_gr). Beachten Sie, dass wir den Gradienten hier nicht einfach direkt weitergeben: Vielmehr berücksichtigen wir, wie sich eine Änderung des Mittelwerts auf die normalisierten Werte im gesamten Fenster auswirkt.
Als Nächstes ist die Berechnung des Gradienten in Bezug auf die Standardabweichung (stdev_gr) etwas komplizierter: Hier multiplizieren wir den um den Mittelwert bereinigten Wert mit seinem Fehlergradienten und mitteln anschließend das Ergebnis, wodurch wir die Sensitivität des Fehlers gegenüber der Streuung der Daten erhalten.
Da uns nun beide Gradienten vorliegen, können wir mit der Berechnung des Hauptergebnisses fortfahren – des Gradienten in Bezug auf die Eingabe selbst. Wir kombinieren den Gradienten aus out_gr mit den Ableitungen in Bezug auf den Mittelwert und die Standardabweichung. Die endgültige Formel berücksichtigt die Beiträge ausgewogen und bildet den Beitrag jedes Eingabewerts zum Gesamtfehler des Modells, wobei seine Position innerhalb des Fensters und sein Einfluss auf die gesamten statistischen Kenngrößen berücksichtigt werden.
   inp_gr = (out_gr - mean_gr - stdev_gr) / IsNaNOrInf(mean_stdev.y, 1);
//---
   if((shift_i) < total_inputs)
      inpurs_gr[shift_v + shift_i] = IsNaNOrInf(inp_gr, 0);
  }
Abschließend wird der resultierende Wert wie üblich wieder in das Array der Eingabegradienten (inputs_gr) geschrieben. Alle Operationen berücksichtigen die Array-Grenzen: Liegt der aktuelle Index außerhalb dieser Grenzen, werden keine Operationen ausgeführt.
Somit ist PeriodNormGrad nicht nur eine formale Implementierung von Gradienten, sondern eine wichtige funktionale Brücke zwischen klassischer Statistik und modernen Methoden des Modelltrainings. Dadurch können statistische Operationen zu vollwertigen Bestandteilen des Berechnungsgraphen werden und am Training teilnehmen, indem sie Fehlerinformationen korrekt dorthin zurückleiten, wo sie entstanden sind.
Im Hauptprogramm werden wir eine spezialisierte Klasse, CNeuronPeriodNorm, erstellen, die dazu dient, die Logik für die Arbeit mit OpenCL-Kernels zur Periodennormalisierung sowohl für den Vorwärts- als auch für den Rückwärtsdurchlauf zu kapseln. Sie erbt von der Basisklasse CNeuronBaseOCL, was darauf hinweist, dass sie zur Komponentenhierarchie des Berechnungsmodells gehört. Die Struktur des neuen Objekts ist unten dargestellt.
class CNeuronPeriodNorm :  public CNeuronBaseOCL
  {
protected:
   uint                    iPeriod;
   uint                    iVariables;
   uint                    iCount;
   CNeuronBaseOCL          cMeanSTDevs;
   //---
   virtual bool      feedForward(CNeuronBaseOCL *NeuronOCL) override;
   virtual bool      updateInputWeights(CNeuronBaseOCL *NeuronOCL) override { return true; }
   virtual bool      calcInputGradients(CNeuronBaseOCL *NeuronOCL) override;

public:
                     CNeuronPeriodNorm(void) : iPeriod(-1), iVariables(1) {};
                    ~CNeuronPeriodNorm(void) {};
   //---
   virtual bool      Init(uint numOutputs, uint myIndex, COpenCLMy *open_cl,
                          uint units_count, uint period, uint variables,
                          ENUM_OPTIMIZATION optimization_type, uint batch);
   //---
   virtual bool      Save(const int file_handle) override;
   virtual bool      Load(const int file_handle) override;
   //---
   virtual int       Type(void) override const  {  return defNeuronPeriodNorm; }
   virtual void      SetOpenCL(COpenCLMy *obj) override;
//---
   CNeuronBaseOCL*   GetMeanSTDevs(void) { return cMeanSTDevs.AsObject(); }
   virtual uint      GetPeriod(void) const { return iPeriod; }
   virtual uint      GetVariables(void) const { return iVariables; }
   virtual uint      GetUnits(void) const { return iCount; }
  };
Die internen Felder der Klasse spiegeln wichtige Konfigurationsparameter wider. Insbesondere gibt die Variable iPeriod die Länge des Zeitfensters an, innerhalb dessen die statistische Verarbeitung – die Berechnung des Mittelwerts und der Standardabweichung – durchgeführt wird. Der Parameter iVariables gibt die Anzahl der zu verarbeitenden Variablen (oder Merkmale) an, und iCount gibt die Anzahl der unabhängigen Fenster für jede einzelne Sequenz an.
Darüber hinaus enthält die Klasse das Objekt cMeanSTDevs, das als Zwischenpuffer zum Speichern der während des Vorwärtsdurchlaufs berechneten Mittelwerte und Standardabweichungen dient. Dieser Puffer ist auch an der Backpropagation beteiligt, wie sie im PeriodNormGrad-Kernel implementiert ist.
Die Methode Init fungiert als Initialisierungskonstruktor: Sie nimmt alle Parameter als Eingabe entgegen, bereitet damit die internen Strukturen vor und bindet das Objekt an die erforderlichen OpenCL-Ressourcen.
Die Methoden für den Vorwärts- und Rückwärtsdurchlauf dienen im Wesentlichen als Hilfsfunktionen. Ihre Aufgabe besteht nicht darin, die Daten manuell neu zu berechnen, sondern alles vorzubereiten, was erforderlich ist, um die entsprechenden OpenCL-Kernel korrekt zur Ausführung in die Warteschlange einzureihen.
Beachten Sie die Funktion GetMeanSTDevs – sie ermöglicht den Zugriff auf einen Puffer mit berechneten statistischen Kenngrößen, die von anderen Komponenten des Modells genutzt werden können, beispielsweise zur Visualisierung oder zur weiteren Verarbeitung.
Somit ist die Klasse CNeuronPeriodNorm eine vollständig eigenständige und flexible Komponente, die nicht nur eine Normalisierung durchführt, sondern auch die korrekte Integration in die Struktur eines Berechnungsmodells mit Trainingsunterstützung gewährleistet. Alles ist streng nach den Prinzipien von Frameworks für neuronale Netze implementiert, wobei die klare Logik beibehalten wird, die für Systeme mit manueller Berechnungssteuerung wie MQL5 + OpenCL charakteristisch ist.
Der vollständige Code für diese Klasse, einschließlich ihrer Methoden, ist im Anhang zum Selbststudium enthalten.
Heute haben wir umfangreiche und produktive Arbeit geleistet. Der Stoff ist ziemlich komplex und erfordert etwas Zeit, ihn zu verarbeiten. Jetzt ist der perfekte Zeitpunkt, um eine kurze Pause einzulegen, durchzuatmen – und dann im nächsten Artikel mit neuer Energie unsere Arbeit fortzusetzen.
Fazit
In diesem Artikel haben wir die theoretischen Aspekte des SCNN-Frameworks untersucht, das einen originellen und konzeptionell fundierten Ansatz zur Zerlegung von Zeitreihen in interpretierbare Komponenten bietet: langfristige, saisonale, kurzfristige und Residualkomponenten. Diese Struktur verbessert nicht nur die Prognosegenauigkeit, sondern erhöht auch die Transparenz des Modells erheblich, wodurch dessen Verhalten besser vorhersehbar und an sich ändernde Marktbedingungen anpassbar wird.
Besonderes Augenmerk wird auf die Unterschiede in der Dynamik der einzelnen Komponenten gelegt, was den Einsatz spezieller Interpolationsmethoden erforderlich macht: Für die langfristigen und saisonalen Komponenten werden einfache Wiederholungsmuster verwendet, während kurzfristige und Residualschwankungen mithilfe trainierbarer autoregressiver Strukturen modelliert werden.
Im praktischen Teil dieses Artikels haben wir damit begonnen, unsere eigene Interpretation der vorgeschlagenen Ansätze umzusetzen, und eines der Grundelemente des Modells entwickelt – einen Algorithmus zur Normalisierung periodischer Segmente einer Zeitreihe. Wir haben die Einzelheiten der Durchführung von Berechnungen auf der OpenCL-Seite untersucht, einschließlich des Vorwärts- und Rückwärtsdurchlaufs, was es uns anschließend ermöglichen wird, diesen Mechanismus in eine trainierbare neuronale Netzwerkarchitektur zu integrieren. Dieser Schritt war ein wichtiger Meilenstein bei der praktischen Anpassung des Frameworks für Handelsaufgaben in der MQL5-Umgebung.
Im nächsten Artikel werden wir diese Implementierung weiterentwickeln, indem wir neue Modellkomponenten hinzufügen und schrittweise auf ein vollwertiges System zur Analyse und Prognose von Zeitreihen auf Basis des SCNN-Frameworks hinarbeiten.
Links
- Disentangling Structured Components: Towards Adaptive, Interpretable and Scalable Time Series Forecasting
- Weitere Artikel dieser Reihe
In diesem Artikel verwendete Programme
| # | Name | Typ | Beschreibung |
|---|---|---|---|
| 1 | Study.mq5 | Expert Advisor | Expert Advisor für das Offline-Modelltraining |
| 2 | StudyOnline.mq5 | Expert Advisor | Expert Advisor für Online-Modelltraining |
| 3 | Test.mq5 | Expert Advisor | Expert Advisor für Modelltests |
| 4 | Trajectory.mqh | Klassenbibliothek | Struktur zur Beschreibung des Systemzustands und der Modellarchitektur |
| 5 | NeuroNet.mqh | Klassenbibliothek | Klassenbibliothek zum Erstellen eines neuronalen Netzes |
| 6 | NeuroNet.cl | Bibliothek | Codebibliothek für ein OpenCL-Programm |
Übersetzt aus dem Russischen von MetaQuotes Ltd.
Originalartikel: https://www.mql5.com/ru/articles/18950
Warnung: Alle Rechte sind von MetaQuotes Ltd. vorbehalten. Kopieren oder Vervielfältigen untersagt.
Dieser Artikel wurde von einem Nutzer der Website verfasst und gibt dessen persönliche Meinung wieder. MetaQuotes Ltd übernimmt keine Verantwortung für die Richtigkeit der dargestellten Informationen oder für Folgen, die sich aus der Anwendung der beschriebenen Lösungen, Strategien oder Empfehlungen ergeben.

 Neuronale Netze im Trading: Zerlegung strukturierter Komponenten (Encoder)
 Marktsimulation: Erste Schritte mit SQL in MQL5 (V)
 Neuronale Netze im Trading: Zerlegung strukturierter Komponenten (Fazit)
 Marktsimulation: Erste Schritte mit SQL in MQL5 (I)

- Freie Handelsapplikationen
- Über 8.000 Signale zum Kopieren
- Wirtschaftsnachrichten für die Lage an den Finanzmärkte
Sie stimmen der Website-Richtlinie und den Nutzungsbedingungen zu.