

Neuronale Netze im Handel: Ein End-to-End-Modell zur multivariaten Zeitreihenprognose (Fazit)
 37
 8

Einleitung
In den vorangegangenen Artikeln haben wir uns von einer Einführung in die theoretischen Aspekte bis zur praktischen Umsetzung der vorgeschlagenen Ansätze vorgearbeitet und dabei schrittweise die Architektur und Logik von GinAR vorgestellt – einem neuartigen neuronalen Netzwerk-Framework, das speziell für die Analyse und Prognose von Zeitreihen bei struktureller Unsicherheit und stark verrauschten Daten. GinAR basiert auf einer mehrschichtigen, aus mehreren Komponenten bestehenden Architektur und kombiniert erfolgreich Attention-Mechanismen, Graphtransformationen und rekurrente Dynamiken. Dadurch erlangt das Modell die Fähigkeit, die Struktur der Daten nicht nur zu erfassen, sondern sich auch in Echtzeit daran anzupassen.
Nun sind wir beim entscheidenden – und vielleicht auch interessantesten – Teil angelangt: der Bewertung des GinAR-Frameworks unter realen Marktbedingungen. Wir haben nun die Phasen der architektonischen Konzeption, der Implementierung der Schlüsselkomponenten sowie der Entwicklung der Algorithmen für den Vorwärts- und Rückwärtsdurchlauf abgeschlossen. Alle Komponenten des Systems wurden sorgfältig entwickelt, getestet und an die spezifischen Eigenschaften finanzieller Zeitreihen angepasst. Nun ist es an der Zeit, alle Komponenten zusammenzuführen und sie, wie man so schön sagt, auf Herz und Nieren zu prüfen – um zu sehen, wie effektiv GinAR praktische Analyse- und Prognoseaufgaben bewältigt.
Mit diesem Artikel schließen wir nicht nur die Entwicklung ab, sondern markieren auch den Höhepunkt eines Konzepts, dessen Umsetzung mit erheblichem Aufwand verbunden war. Der Schwerpunkt wird auf dem Training und Testen des Modells unter Bedingungen liegen, die einem realen Einsatz nahekommen.
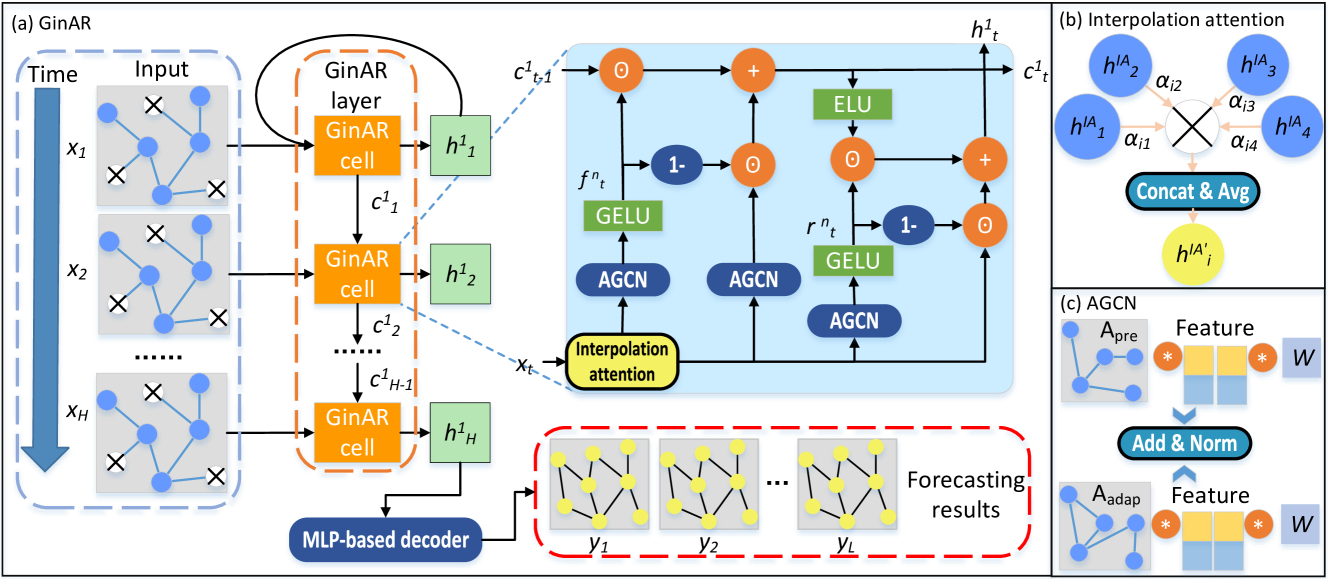
Bevor wir zur Bewertung übergehen, wollen wir kurz noch einmal einen Blick darauf werfen, wie das GinAR-Framework selbst aufgebaut ist. Im Kern steht eine speziell entwickelte Zelle, GinARCell, die mehrere Schlüsselkomponenten vereint:
- Interpolation Attention (IA) ist ein kontextbezogener Attention-Mechanismus, der den Eingabestrom vorverarbeitet und das Modell auf relevante Elemente fokussiert. Es handelt sich um eine Art vorgeschalteten Filter, der es ermöglicht, wichtige Muster zu erkennen und fehlende Elemente vor der eigentlichen Transformation zu rekonstruieren.
- AGCN-Blöcke (Adaptive Graph Convolution Network) bestehen aus drei Modulen, von denen eines für die Hauptverarbeitung zuständig ist (cX_AGNC), während die beiden anderen die Steuersignale verarbeiten (ForgetGate und ResetGate). Ihre Aufgabe besteht darin, strukturelle und topologische Informationen zu extrahieren sowie den Datenfluss auf der Grundlage zeitlicher und struktureller Abhängigkeiten zu modellieren.
- Der kontextbezogene Block (Context) dient als Speicher für zeitliche Zustände, der ein tiefes Gedächtnis und Kontinuität im Verarbeitungsablauf gewährleistet. Sein Zustand wird nach einem gewichteten Schema aktualisiert, das auf der Interaktion mit Steuer-Gates (Gates) basiert.
- Ein dualer Steuermechanismus – ForgetGate und ResetGate – funktioniert nach den Prinzipien der Filterung und des Überschreibens des Kontexts. Sie sind als eigenständige AGCN-Zellen implementiert, was eine flexible Steuerung des internen Zustands des Modells ermöglicht.
Die Ausgabe der Zelle wird auf der Grundlage der ELU-Aktivierung und kontextbezogener Attention-Multiplikatoren gebildet, was einen sanften und zugleich sensiblen Übergang zwischen den Zeitintervallen gewährleistet.
Diese Kombination macht GinAR wirklich einzigartig. Im Gegensatz zu klassischen rekurrenten neuronalen Netzen speichert es nicht nur die Vergangenheit – es kann sie auch strukturieren. Im Gegensatz zu herkömmlichen GCN-Modellen arbeitet es nicht mit einer festen Topologie, sondern lernt die Topologie während des Betriebs. Schließlich bewahrt GinAR – im Gegensatz zu allgemeinen Transformer-Modellen – Lokalität und dynamische Anpassung, zwei Merkmale, die für die Analyse finanzieller Zeitreihen von entscheidender Bedeutung sind.
Nachstehend ist eine vom Autor erstellte Darstellung des GinAR-Frameworks abgebildet.
Dieser Artikel bildet nicht nur den Abschluss des technischen Teils, sondern dient auch als Beleg für die Ausgereiftheit des gesamten Entwurfs. Wir werden sehen, wie sich das Framework in der Praxis bewährt, welche Engpässe auftreten und welche Genauigkeit und Robustheit das Modell bei neuen Daten erreicht. Und vor allem werden wir prüfen, ob es dem Trader tatsächlich den entscheidenden Vorteil verschafft, der all diese architektonische Komplexität rechtfertigt.
GinAR-Block
Die GinAR-Architektur ist hierarchisch aufgebaut. Sie besteht aus mehreren aufeinanderfolgenden GinAR-Schichten und endet mit einem Decoder, der auf einem mehrschichtigen Perzeptron (MLP) basiert. Jede GinAR-Schicht enthält wiederum eine Reihe von GinARCell-Zellen, die die zeitliche Sequenz Schritt für Schritt verarbeiten, ähnlich wie die Einzelbilder eines Films eine zusammenhängende Szene bilden.
Am Ausgang jeder Schicht wird nur der endgültige verborgene Zustand der letzten Zelle beibehalten. Diese Zustände werden zu einem einzigen abschließenden Tensor, hⁿₐₗₗ, zusammengefasst, der eine komprimierte und maximal aussagekräftige Darstellung der gesamten zu analysierenden Sequenz enthält. Dieser Tensor wird in den MLP-Decoder eingespeist, der aus zwei vollverbundenen Schichten besteht, zwischen denen eine ReLU-Aktivierungsfunktion liegt.
Besondere Aufmerksamkeit verdient ein wichtiger architektonischer Aspekt im Zusammenhang mit der Organisation des Datenflusses in der mehrschichtigen Struktur von GinAR. An sich ist die sequenzielle Anwendung mehrerer Schichten – bei der jede nachfolgende Schicht die Ausgabe der vorherigen als Eingabe erhält – eine völlig gängige Vorgehensweise und fügt sich gut in die Logik des linearen Modells ein.
Das ursprüngliche GinAR-Modell verwendet jedoch ein komplexeres Schema: Nach der sequenziellen Verarbeitung durch mehrere Schichten ist das Ergebnis nicht einfach die Ausgabe der letzten Schicht, sondern eine kombinierte Darstellung, die durch Konkatenation der Ausgaben aller Schichten gewonnen wird. Dieser Ansatz ermöglicht es dem Decoder, das gesamte Spektrum der auf verschiedenen Abstraktionsebenen generierten internen Merkmale zu nutzen, was das Modell zweifellos verbessert. Allerdings stört dies auch die lineare Datenübertragungsstruktur, die unseren Implementierungen zugrunde liegt, und erfordert zusätzliche Logik, um Daten aus verschiedenen Schichten zu sammeln und zusammenzuführen.
Das von uns verwendete High-Level-Objekt zur Modellerstellung unterstützte ursprünglich keine Operationen zum Zusammenführen der Ausgaben mehrerer Schichten zu einem einzigen Tensor, wodurch es unmöglich ist, diesen Teil der ursprünglichen GinAR-Architektur direkt zu implementieren. Um diese Einschränkung zu umgehen, haben wir einen speziellen GinAR-Block entwickelt, der die sequenzielle Verarbeitung der Eingabedaten mithilfe einer Reihe von CNeuronGinARCell-Zellen steuert und anschließend die Ergebnisse aller Zellen zu einem einzigen Tensor zusammenfasst. Dieser finale Tensor wird an den Decoder übergeben, wodurch ein wesentliches Merkmal des ursprünglichen Modells nachgebildet wird – nämlich die Integration von Merkmalen, die auf verschiedenen Abstraktionsebenen gewonnen wurden.
Wenn wir uns nun der Untersuchung der Architektur des GinAR-Blocks zuwenden, sollte ein wichtiger Unterschied zum ursprünglichen Modell hervorgehoben werden. Zusätzlich zur Grundstruktur haben wir eine lernbare Matrix mit vordefinierten Beziehungen zwischen den Komponenten der analysierten Daten hinzugefügt. Sie basiert auf einem adaptiven Lernmechanismus, der dem Mechanismus ähnelt, der in den Matrizen struktureller Abhängigkeiten innerhalb jeder GinARCell-Zelle verwendet wird. Der wesentliche Unterschied liegt jedoch im Anwendungsbereich. Während adaptive Matrizen in jeder Zelle separat gebildet werden und lokale Muster widerspiegeln, ist die von uns eingeführte Matrix globaler Natur und wird von allen Zellen innerhalb eines einzelnen GinAR-Blocks gemeinsam genutzt. Dadurch lassen sich stabile, wiederkehrende Korrelationen zwischen Variablen über die gesamte Analyse hinweg erfassen, was die strukturelle Konsistenz des Modells stärkt.
Um den GinAR-Block in unserer Architektur zu implementieren, haben wir eine spezielle Klasse namens CNeuronGinAR erstellt, die von CNeuronSwiGLUOCL abgeleitet ist. Diese Hierarchie ermöglicht es uns, die Kompatibilität mit dem restlichen Modell zu gewährleisten und die Vorteile des zugrunde liegenden Aktivierungsdesigns zusammen mit der flexiblen SwiGLU-Nichtlinearität zu nutzen. Die zentralen Funktionselemente und die Ablauflogik wurden jedoch erheblich erweitert und neu definiert. Die Struktur des neuen Objekts ist unten dargestellt.
class CNeuronGinAR   :  public CNeuronSwiGLUOCL
  {
protected:
   CParams              cEa;
   CNeuronSwiGLUOCL     cWx;
   CNeuronSwiGLUOCL     cWe;
   CNeuronBaseOCL       cWconcat_ex;
   CNeuronConvOCL       cEn;
   CNeuronTransposeOCL  cEnT;
   CNeuronBaseOCL       cEnEnT;
   CNeuronSoftMaxOCL    cApre;
   CNeuronGinARCell     caCells[4];
   CNeuronBaseOCL       cConcat;
   //---
   virtual bool      feedForward(CNeuronBaseOCL *NeuronOCL) override;
   virtual bool      updateInputWeights(CNeuronBaseOCL *NeuronOCL) override;
   virtual bool      calcInputGradients(CNeuronBaseOCL *NeuronOCL) override;

public:
                     CNeuronGinAR(void) {};
                    ~CNeuronGinAR(void) {};
   //---
   virtual bool      Init(uint numOutputs, uint myIndex, COpenCLMy *open_cl,
                          uint units_count, uint dimension,
                          ENUM_OPTIMIZATION optimization_type, uint batch);
   //---
   virtual bool      Save(const int file_handle) override;
   virtual bool      Load(const int file_handle) override;
   //---
   virtual int       Type(void) override const  {  return defNeuronGinAR; }
   virtual void      TrainMode(bool flag) override;
   virtual void      SetOpenCL(COpenCLMy *obj);
   //---
   virtual bool      WeightsUpdate(CNeuronBaseOCL *source, float tau);
   //---
   virtual bool      Clear(void) override;
  };
Die Klasse CNeuronGinAR ist ein vollwertiger Baustein des GinAR-Frameworks, der in der MQL5-Umgebung mithilfe von OpenCL implementiert wurde. Er wurde entwickelt, um Zeitreihen zu verarbeiten und komplexe Muster auf der Grundlage einer Hierarchie linearer Beziehungen zu extrahieren. Die Klasse vereint mehrere Schlüsselkomponenten, die für die Erzeugung und Interpretation der globalen Matrix struktureller Abhängigkeiten zuständig sind, sowie ein Array von CNeuronGinARCell-Zellen, die die sequenzielle Verarbeitung der Eingabedaten übernehmen. Ihre Ergebnisse werden anschließend per Konkatenation zusammengeführt, um eine finale Darstellung der analysierten Sequenz zu bilden.
Die Klassenstruktur basiert auf den Prinzipien der Modularität und Wiederverwendbarkeit. Alle internen Elemente werden statisch deklariert. Das bedeutet, dass die Verwaltung ihres Lebenszyklus (Erstellung, Zerstörung und Speicherbereinigung) automatisch erfolgt, ohne dass ein explizites Eingreifen seitens des Konstruktors oder Destruktors erforderlich ist.
Die Methode Init dient zur Konfiguration aller internen Komponenten; sie fungiert als zentraler Einstiegspunkt für den Initialisierungsprozess. Sie nimmt Parameter entgegen, die die Architektur des Objekts und die Art der Parameteroptimierung definieren.
bool CNeuronGinAR::Init(uint numOutputs, uint myIndex, COpenCLMy *open_cl,
                        uint units_count, uint dimension,
                        ENUM_OPTIMIZATION optimization_type, uint batch)
  {
   if(!CNeuronSwiGLUOCL::Init(numOutputs, myIndex, open_cl, caCells.Size()*dimension,
                              caCells.Size()*dimension, dimension, units_count, 1,
                              optimization_type, batch))
      return false;
Zunächst wird die gleichnamige Methode der übergeordneten Klasse CNeuronSwiGLUOCL aufgerufen; in unserer Implementierung bildet sie aggregierte Darstellungen der von den GinARCell-Zellen erzeugten Ergebnisse. Anschließend werden die neu deklarierten Komponenten, die Teil der Architektur des Blocks sind, nacheinander initialisiert.
Die erste ist die lernbare Matrix globaler struktureller Abhängigkeiten zwischen den Zeitreihenvariablen.
int index = 0;
if(!cEa.Init(0, index, OpenCL, Neurons(), optimization, iBatch))
   return false;
cEa.SetActivationFunction(None);
Im Gegensatz zum ursprünglichen Ansatz, bei dem eine vordefinierte Kovarianzmatrix auf der Grundlage von Vorwissen oder einer vorläufigen Analyse der Struktur der zu prognostizierenden Sequenz erstellt wird, verwendet unsere Implementierung eine lernbare Matrix struktureller Abhängigkeiten, die allen GinARCell-Zellen innerhalb eines einzelnen Blocks gemeinsam ist. Dieser Ansatz macht eine manuelle Feinabstimmung oder externe Datenanalyse überflüssig und ermöglicht eine flexiblere, adaptive Anpassung der Beziehungen zwischen den Variablen während der Trainingsphase.
Als Nächstes initialisieren wir die linearen Transformationsschichten cWx und cWe. Ihr Zweck besteht darin, die Eingabedaten und die Kovarianzmatrix auf eine gemeinsame Dimensionalität abzubilden, bevor sie zu einem einzigen Tensor cWconcat_ex kombiniert werden.
   index++;
   if(!cWx.Init(0, index, OpenCL, dimension, dimension, dimension, units_count, 1,
                                                            optimization, iBatch))
      return false;
   index++;
   if(!cWe.Init(0, index, OpenCL, dimension, dimension, dimension, units_count, 1,
                                                            optimization, iBatch))
      return false;
   if(!cWconcat_ex.Init(0, index, OpenCL, 2 * Neurons(), optimization, iBatch))
      return false;
   cWconcat_ex.SetActivationFunction(None);
Die Faltungsschicht cEn ist darauf ausgelegt, eine tiefgehende Durchmischung von Merkmalen und deren Abhängigkeiten durchzuführen.
   index++;
   if(!cEn.Init(0, index, OpenCL, 2 * dimension, 2 * dimension, dimension, units_count,
                                                              1, optimization, iBatch))
      return false;
   cEn.SetActivationFunction(None);
   index++;
   if(!cEnT.Init(0, index, OpenCL, units_count, dimension, optimization, iBatch))
      return false;
   index++;
   if(!cEnEnT.Init(0, index, OpenCL, units_count * units_count, optimization, iBatch))
      return false;
   cEnEnT.SetActivationFunction(GELU);
Zunächst transponieren wir die erhaltenen Daten und multiplizieren dann die ursprüngliche Darstellung mit ihrer Transponierten, um eine symmetrische Matrix der Interdependenzen zwischen den Variablen, cEnEnT, zu erhalten. Die GELU-Funktion wird zur Aktivierung verwendet und hebt signifikante Zusammenhänge hervor.
Anschließend normalisieren wir die Abhängigkeitsmatrix mithilfe der SoftMax-Funktion und wandeln die Daten so in eine Wahrscheinlichkeitsverteilung um.
   index++;
   if(!cApre.Init(0, index, OpenCL, units_count * units_count, optimization, iBatch))
      return false;
   cApre.SetHeads(units_count);
Der nächste Schritt besteht darin, ein Array von CNeuronGinARCell-Zellen zu initialisieren, von denen jede für die Verarbeitung der zu analysierenden Sequenz auf ihrer eigenen Ebene in der Hierarchie zuständig ist. Trotz ihrer logischen Unabhängigkeit weisen alle Zellen eine identische Architektur auf, was den Initialisierungsprozess vereinfacht – eine einzige, gut strukturierte Schleife reicht aus.
   for(uint i = 0; i < caCells.Size(); i++)
     {
      index++;
      if(!caCells[i].Init(0, index, OpenCL, units_count, dimension, optimization, iBatch))
         return false;
     }
   index++;
   if(!cConcat.Init(0, index, OpenCL, GetWindow()*units_count, optimization, iBatch))
      return false;
//---
   return true;
  }
Die Ergebnisse aus den Zellen werden im cConcat-Objekt zusammengefasst. Nachdem alle internen Komponenten erfolgreich initialisiert wurden, geben wir das boolesche Ergebnis der Operationen an das aufrufende Programm zurück.
Es ist wichtig zu beachten, dass die Methode Init den Lebenszyklus der aufgeführten Objekte nicht verwaltet. Seine Aufgabe besteht darin, die Parameter präzise zu konfigurieren und die Schichtarchitektur einzurichten, um anschließend die Kontrolle an den Ausführungszyklus des Modells zu übergeben. Dieser Ansatz gewährleistet hohe Stabilität, vorhersehbares Verhalten und eine effiziente Speichernutzung.
Sobald die Initialisierungsphase abgeschlossen ist, sind alle Komponenten des CNeuronGinAR-Blocks für den Betrieb während des Vorwärtsdurchlaufs bereit. Hier zeigt sich die Wechselwirkung zwischen den strukturellen Modulen, den verborgenen Zuständen der Zellen und der lernbaren Matrix von Abhängigkeiten. Die Methode feedForward ist für die Ausführung des gesamten Verarbeitungszyklus der Eingabesequenz zuständig, einschließlich der Erstellung der Matrix struktureller Abhängigkeiten und der Generierung des endgültigen Ausgabetensors, der an die nächste Schicht der neuronalen Architektur weitergeleitet wird.
bool CNeuronGinAR::feedForward(CNeuronBaseOCL *NeuronOCL)
  {
//--- Calculate Apre
   if(bTrain)
     {
      if(!cEa.FeedForward())
         return false;
      if(!cWe.FeedForward(cEa.AsObject()))
         return false;
     }
Der erste Schritt besteht darin, die lernbare Abhängigkeitsmatrix zu erstellen. Befindet sich das Modell im Trainingsmodus (bTrain == true), wird zunächst der Tensor der globalen strukturellen Abhängigkeiten aktiviert; anschließend wird dessen Ausgabe durch eine lineare Projektionsschicht verarbeitet.
Parallel dazu wird auch der Hauptinformationsfluss der Eingabedaten verarbeitet, während er die lineare Projektionsschicht cWx durchläuft.
//---
   if(!cWx.FeedForward(NeuronOCL))
      return false;
   if(!Concat(cWx.getOutput(), cWe.getOutput(), cWconcat_ex.getOutput(),
              cWx.GetWindowOut(), cWe.GetWindowOut(), cWx.GetUnits()))
      return false;
Anschließend werden die Ergebnisse beider Zweige mithilfe der Concat-Operation zu einem einzigen Tensor zusammengefasst, und das Ergebnis wird in die cEn-Faltungsschicht eingespeist.
   if(!cEn.FeedForward(cWconcat_ex.AsObject()))
      return false;
   if(!cEnT.FeedForward(cEn.AsObject()))
      return false;
   if(!MatMul(cEn.getOutput(), cEnT.getOutput(), cEnEnT.getOutput(), cEnT.GetCount(),
                                                  cEnT.GetWindow(), cEnT.GetCount()))
      return false;
   if(cEnEnT.Activation() != None)
      if(!Activation(cEnEnT.getOutput(), cEnEnT.getOutput(), cEnEnT.Activation()))
         return false;
Der resultierende Tensor wird anschließend transponiert (cEnT), woraufhin der ursprüngliche Tensor mit seiner transponierten Version multipliziert wird. In dieser Phase wird praktisch eine Kovarianzmatrix gebildet, und bei Bedarf wird mithilfe der angegebenen Aktivierungsfunktion eine Nichtlinearität hinzugefügt.
Die endgültige Kovarianzmatrix wird in der cApre-Schicht erstellt, wo die Daten mithilfe der SoftMax-Funktion in eine probabilistische Darstellung umgewandelt werden.
if(!cApre.FeedForward(cEnEnT.AsObject()))
   return false;
if(!IdentSum(cApre.getOutput(), cApre.getOutput(), cApre.Heads()))
   return false;
Um Stabilität und ein Mindestmaß an Selbstverbindung zu gewährleisten, wird diese Matrix durch eine Einheitsmatrix ergänzt. Mit anderen Worten: Jede Variable erhält nicht nur Informationen über ihre Beziehungen zu den anderen, sondern behält auch eine grundlegende Selbstreferenz bei. Das Ergebnis ist eine ausgewogene Struktur von Attention-Gewichten, die sowohl globale Abhängigkeiten als auch die lokale Bedeutung jedes einzelnen Elements berücksichtigen kann. Diese abschließende Matrix wird dann an den Eingang jeder GinARCell-Zelle weitergeleitet und dient als universeller Mechanismus zur selektiven Signalverstärkung.
Anschließend beginnt die eigentliche Verarbeitung der Eingabesequenz mithilfe des Zellenarrays. Die zu analysierenden Daten, die von einem externen Programm stammen, werden in den Eingang der ersten Zelle eingespeist. Jede nachfolgende Zelle analysiert die Ergebnisse der vorherigen und erhöht so den Detaillierungsgrad der latenten Darstellung. Auf diese Weise entsteht eine Abfolge verborgener Darstellungen, die den hierarchischen Charakter der Zeitreihenanalyse widerspiegelt.
//--- GimAR Cells
   CNeuronBaseOCL *temp = NeuronOCL;
   for(uint i = 0; i < caCells.Size(); i++)
     {
      if(!caCells[i].FeedForward(temp, cApre.getOutput()))
         return false;
      temp = caCells[i].AsObject();
     }
//---
   if(!Concat(caCells[0].getOutput(), caCells[1].getOutput(), caCells[2].getOutput(),
              caCells[3].getOutput(), cConcat.getOutput(), GetWindow() / 4,
              GetWindow() / 4, GetWindow() / 4, GetWindow() / 4, GetUnits()))
      return false;
//---
   return CNeuronSwiGLUOCL::feedForward(cConcat.AsObject());
  }
Der letzte Schritt des Verfahrens besteht darin, die Ausgaben aller Zellen zu einem einzigen gemeinsamen Tensor (cConcat) zusammenzuführen, der anschließend als Eingabe an die gleichnamige Methode der übergeordneten Klasse CNeuronSwiGLUOCL zur weiteren Verarbeitung übergeben wird. Diese Struktur gewährleistet einen koordinierten und effizienten Informationsfluss durch den GinAR-Block und bringt das Verhalten des Systems trotz der architektonischen Einschränkungen des verwendeten Frameworks so nah wie möglich an die ursprüngliche Architektur heran.
Nach Abschluss des Vorwärtsdurchlaufs und der Berechnung der Blockergebnisse gehen wir zur zweiten zentralen Phase über: der Propagation des Fehlergradienten (Backpropagation). Hier beginnt das eigentliche Reverse Engineering der Prognose: Der Fehler aus dem Decoder wird an jedes Element der Architektur zurückgeführt, um die Gewichte präzise anzupassen und das Modell zu optimieren.
Die Methode calcInputGradients ist dafür zuständig, einen vollständigen Rückwärtsdurchlauf durch die gesamte Blockarchitektur durchzuführen, beginnend bei der Ausgabe und endend bei den Eingabedaten. Da die Struktur des Blocks komplex ist und sowohl sequenzielle Operationen als auch Tensor-Verzweigungs- und -Zusammenführungsoperationen umfasst, erfordert der Rückwärtsdurchlauf eine schrittweise und streng koordinierte Ausführung.
bool CNeuronGinAR::calcInputGradients(CNeuronBaseOCL *NeuronOCL)
  {
   if(!NeuronOCL)
      return false;
//---
   if(!CNeuronSwiGLUOCL::calcInputGradients(cConcat.AsObject()))
      return false;
   if(!DeConcat(caCells[0].getPrevOutput(), caCells[1].getPrevOutput(),
                caCells[2].getPrevOutput(), caCells[3].getGradient(),
                cConcat.getGradient(), GetWindow() / 4,
                GetWindow() / 4, GetWindow() / 4,
                GetWindow() / 4, GetUnits()))
      return false;
Die Methode beginnt mit dem Aufruf der gleichnamigen Methode in der übergeordneten Klasse CNeuronSwiGLUOCL, die den Gradienten an den konkatenierten Tensor der Ausgaben der internen Zellen weiterleitet: cConcat. Da dieser Tensor während des Vorwärtsdurchlaufs durch die Konkatenation der Ausgaben von vier GinAR-Zellen gebildet wurde, muss der Gradient nun korrekt auf die vier Informationsströme zurückverteilt werden. Mit der Methode DeConcat leiten wir den Fehlergradienten entsprechend dem Einfluss der jeweiligen Zelle auf das Endergebnis an jede Zelle weiter.
Ein wichtiger Aspekt hinsichtlich der Logik der Propagation des Fehlergradienten innerhalb des GinAR-Blocks verdient besondere Hervorhebung. Trotz der scheinbaren Symmetrie der Zellen sind ihre funktionalen Rollen während des Lernprozesses nicht identisch.
Erstens dient nur die letzte Zelle ausschließlich dazu, durch Konkatenation den finalen Ergebnis-Tensor des Blocks zu bilden. Alle vorhergehenden Zellen erfüllen einen doppelten Zweck: Ihre Ausgaben gehen nicht nur in die Konkatenation ein, sondern dienen auch als Eingabedaten für die nächste GinARCell in der Hierarchie. Das bedeutet, dass der Fehlergradient aus zwei Quellen in jede solche Zelle einfließen muss. Daher erfassen wir bei der Berechnung des Gradienten für die ersten drei Zellen den Gradienten entlang der beiden Pfade, in denen die Daten verwendet werden, und summieren ihn korrekt. Dadurch werden die Kontinuität des Fehlerflusses und eine präzise Rückmeldung auf jeder Hierarchieebene gewährleistet.
//--- GimAR Cells
   cApre.getGradient().Fill(0);
   for(uint i = caCells.Size() - 1; i > 0; i--)
      if(!caCells[i - 1].CalcHiddenGradients(caCells[i].AsObject(), cApre.getOutput(),
                                             cApre.getPrevOutput(),
                                             (ENUM_ACTIVATION)cApre.Activation()) ||
         !SumAndNormilize(caCells[i - 1].getGradient(), caCells[i - 1].getPrevOutput(),
                          caCells[i - 1].getGradient(), cWx.GetWindow(), false, 0, 0, 0, 1) ||
         !SumAndNormilize(cApre.getGradient(), cApre.getPrevOutput(),
                          cApre.getGradient(), GetUnits(), false, 0, 0, 0, 1))
         return false;
   if(!NeuronOCL.CalcHiddenGradients(caCells[0].AsObject(), cApre.getOutput(),
                                     cApre.getPrevOutput(), (ENUM_ACTIVATION)cApre.Activation()) ||
      !SumAndNormilize(cApre.getGradient(), cApre.getPrevOutput(),
                       cApre.getGradient(), GetUnits(), false, 0, 0, 0, 1))
      return false;
Zweitens ergibt sich eine noch differenziertere Situation bei der Berechnung des Gradienten für die globale Kovarianzmatrix, die durch das cApre-Objekt dargestellt wird. Diese Matrix wurde gleichzeitig an alle vier GinARCell-Instanzen übergeben. Folglich muss ihr Gradient während des Rückwärtsdurchlaufs Informationen aus vier unabhängigen Richtungen akkumulieren – aus jeder Zelle. Dazu müssen alle eingehenden Gradienten nacheinander addiert werden, wobei eine konsistente Form und Skalierung beibehalten werden müssen. Fehler in diesem Bereich können zu abrupten Sprüngen bei den Gewichten und damit zu instabilem Training führen.
Anschließend beginnt die Backpropagation durch den Block zur Bildung der Abhängigkeitsmatrix. Zunächst wird der Gradient für cEnEnT berechnet; anschließend werden die Werte anhand der Ableitung der entsprechenden Aktivierungsfunktion angepasst.
//---
   if(!cEnEnT.CalcHiddenGradients(cApre.AsObject()))
      return false;
   if(cEnEnT.Activation() != None)
      if(!DeActivation(cEnEnT.getOutput(), cEnEnT.getGradient(),
                       cEnEnT.getGradient(), cEnEnT.Activation()))
         return false;
   if(!MatMulGrad(cEn.getOutput(), cEn.getPrevOutput(),
                  cEnT.getOutput(), cEnT.getGradient(),
                  cEnEnT.getGradient(), cEnT.GetCount(),
                  cEnT.GetWindow(), cEnT.GetCount()))
      return false;
   if(!cEn.CalcHiddenGradients(cEnT.AsObject()))
      return false;
   if(!SumAndNormilize(cEn.getGradient(), cEn.getPrevOutput(),
                       cEn.getGradient(), cEnT.GetWindow(), false, 0, 0, 0, 1))
      return false;
   if(cEn.Activation() != None)
      if(!DeActivation(cEn.getOutput(), cEn.getGradient(),
                       cEn.getGradient(), cEn.Activation()))
         return false;
Anschließend wird der Gradient für die Matrixmultiplikationsoperation MatMulGrad berechnet, wodurch der Fehler zwischen der Faltungsschicht cEn und ihrer transponierten Kopie cEnT verteilt wird. Gleichzeitig propagieren wir den Fehlergradienten der transponierten Darstellung zurück bis zur Faltungsschicht und summieren die aus den beiden Informationsflüssen erhaltenen Werte. Dieser Ansatz ermöglicht es, eine vollständig differenzierbare Darstellung der symmetrischen Kovarianzmatrix zu konstruieren, wodurch die Genauigkeit und Integrität der Propagation des Fehlergradienten auch innerhalb einer komplexen Topologie gewahrt bleibt.
Wir propagieren die erhaltenen Werte bis auf die Ebene des Tensors cWconcat_ex.
if(!cWconcat_ex.CalcHiddenGradients(cEn.AsObject()))
   return false;
if(!DeConcat(cWx.getGradient(), cWe.getGradient(), cWconcat_ex.getGradient(),
             cWx.GetWindowOut(), cWe.GetWindowOut(), cWx.GetUnits()))
   return false;
Die Ausgabe von cWconcat_ex wurde aus den Ergebnissen von cWx und cWe gebildet. Nun werden die Gradienten wieder aufgeteilt und gegebenenfalls durch die Ableitung der Aktivierungsfunktion zurückpropagiert. Anschließend wird ein Rückwärtsdurchlauf von cWx zum Quelldatenobjekt NeuronOCL initiiert.
Wir sollten hier jedoch bedenken, dass der Fehlergradient aus der ersten Zelle bereits an die Quelldatenebene weitergegeben worden war. Daher werden wir einen Trick anwenden, bei dem Zeiger auf Datenpuffer ersetzt werden; anschließend werden die aus den beiden Informationsflüssen erhaltenen Werte summiert.
   if(cWx.Activation() != None)
      if(!DeActivation(cWx.getOutput(), cWx.getGradient(),
                       cWx.getGradient(), cWx.Activation()))
         return false;
   if(cWe.Activation() != None)
      if(!DeActivation(cWe.getOutput(), cWe.getGradient(),
                       cWe.getGradient(), cWe.Activation()))
         return false;
   CBufferFloat* temp = NeuronOCL.getGradient();
   if(!NeuronOCL.SetGradient(NeuronOCL.getPrevOutput(), false))
      return false;
   if(!NeuronOCL.CalcHiddenGradients(cWx.AsObject()))
      return false;
   if(!SumAndNormilize(NeuronOCL.getGradient(), temp,
                       NeuronOCL.getGradient(), cWx.GetWindow(), false, 0, 0, 0, 1))
      return false;
   if(!NeuronOCL.SetGradient(temp, false))
      return false;
Die Methode endet damit, dass der Fehlergradient an die Ebene der Matrix globaler Abhängigkeiten cEa übergeben wird.
   if(!cEa.CalcHiddenGradients(cWe.AsObject()))
      return false;
//---
   return true;
  }
Nachdem alle Iterationen erfolgreich abgeschlossen wurden, geben wir das boolesche Ergebnis der Methode an das aufrufende Programm zurück.
Somit gewährleistet die Methode calcInputGradients eine korrekte Gradientenpropagation über die gesamte Struktur des GinAR-Blocks hinweg. Die Architektur des Rückwärtsdurchlaufs spiegelt exakt die Struktur des Vorwärtsdurchlaufs wider, was insbesondere bei der Verwendung komplexer Attention-Mechanismen und verschachtelter Komponenten von Bedeutung ist.
Der vollständige Code für diese Klasse und alle ihre Methoden ist im Anhang enthalten und steht zum eigenständigen Studium zur Verfügung.
Modellarchitektur
Nachdem wir nun alle Komponenten erstellt haben, die für den Aufbau des GinAR-Frameworks erforderlich sind, gehen wir zur nächsten Phase über: der Beschreibung der Architektur der trainierbaren Modelle. Hier geht die Architektur weit über einfache Zeitreihenprognosen hinaus: Unser Ziel ist es, einen vollwertigen Handelsagenten zu entwickeln, in dem das GinAR-Framework als Encoder für den Umgebungszustand fungiert.
Jede Komponente des Modells ist für eine bestimmte Funktion zuständig. Der Encoder ist dafür zuständig, Informationen aus historischen Daten zu extrahieren und zusammenzufassen. Die Prognosemodule, die in drei parallele Modelle unterteilt sind, erstellen Prognosen für unterschiedliche Zeithorizonte. Als Nächstes folgen die Blöcke Actor und Critic, die der Reinforcement Learning-Architektur entsprechen: Ersterer generiert Handelsaktionen, während Letzterer die erwartete Performance des Modellverhaltens im aktuellen Marktzustand bewertet.
Die Methode CreateDescriptions dient zur Beschreibung der Architektur; sie generiert Konfigurationen für alle Module. Im ersten Schritt initialisiert die Methode Container für jedes Modell: den Encoder, die Prognosemodule, den Actor und den Critic. Diese Container sind als Arrays von Objekten implementiert, nämlich als Beschreibungen neuronaler Schichten.
bool CreateDescriptions(CArrayObj *&encoder,
                        CArrayObj *&forecast1,
                        CArrayObj *&forecast2,
                        CArrayObj *&forecast3,
                        CArrayObj *&actor,
                        CArrayObj *&critic
                       )
  {
//---
   CLayerDescription *descr;
//---
   if(!encoder)
     {
      encoder = new CArrayObj();
      if(!encoder)
         return false;
     }
   if(!forecast1)
     {
      forecast1 = new CArrayObj();
      if(!forecast1)
         return false;
     }
   if(!forecast2)
     {
      forecast2 = new CArrayObj();
      if(!forecast2)
         return false;
     }
   if(!forecast3)
     {
      forecast3 = new CArrayObj();
      if(!forecast3)
         return false;
     }
   if(!actor)
     {
      actor = new CArrayObj();
      if(!actor)
         return false;
     }
   if(!critic)
     {
      critic = new CArrayObj();
      if(!critic)
         return false;
     }
Nach der Initialisierung nimmt die Modellstruktur Gestalt an. Der Encoder beginnt mit einer einfachen, vollverbundenen Schicht, die lediglich die historischen Eingabedaten des Modells empfängt.
//--- Encoder
   encoder.Clear();
//--- Input layer
   if(!(descr = new CLayerDescription()))
      return false;
   descr.type = defNeuronBaseOCL;
   uint prev_count = descr.count = (HistoryBars * BarDescr);
   descr.activation = None;
   descr.optimization = ADAM;
   if(!encoder.Add(descr))
     {
      delete descr;
      return false;
     }
//--- layer 1
   if(!(descr = new CLayerDescription()))
      return false;
   descr.type = defNeuronBatchNormWithNoise;
   descr.count = prev_count;
   descr.batch = BatchSize;
   descr.activation = None;
   descr.optimization = ADAM;
   if(!encoder.Add(descr))
     {
      delete descr;
      return false;
     }
Als Nächstes folgt eine Batch-Normalisierungsschicht mit hinzugefügtem Rauschen, deren Zweck darin besteht, die Verteilung der Rohdaten zu stabilisieren und erweitert durch das Hinzufügen von Rauschen die Repräsentationen, um die Robustheit des Modells gegenüber Overfitting zu verbessern.
Anschließend werden Kanäle mit Differenzmerkmalen zwischen benachbarten Balken hinzugefügt. Dadurch kann das System nicht nur absolute Werte erfassen, sondern auch die Richtung und das Ausmaß von Veränderungen. Dies ist insbesondere unter Bedingungen eines hochfrequenten und unregelmäßigen Marktverhaltens von Bedeutung.
//--- layer 2
   if(!(descr = new CLayerDescription()))
      return false;
   descr.type = defNeuronConcatDiff;
   prev_count = descr.count = HistoryBars;
   descr.layers = BarDescr;
   descr.step = 1;
   descr.batch = BatchSize;
   descr.optimization = ADAM;
   descr.activation = None;
   if(!encoder.Add(descr))
     {
      delete descr;
      return false;
     }
Die nächste Schicht reichert die Repräsentationen mit harmonischen Zeitmerkmalen an.
//--- layer 3
   if(!(descr = new CLayerDescription()))
      return false;
   descr.type = defMamba4CastEmbeding;
   prev_count = descr.count = HistoryBars;
   descr.window = 2 * BarDescr;
   uint prev_out = descr.window_out = NSkills;
     {
      uint temp[] = {PeriodSeconds(PERIOD_H1), PeriodSeconds(PERIOD_D1)};
      if(ArrayCopy(descr.windows, temp) < (int)temp.Size())
         return false;
     }
   descr.batch = BatchSize;
   descr.optimization = ADAM;
   descr.activation = None;
   if(!encoder.Add(descr))
     {
      delete descr;
      return false;
     }
Die vorverarbeiteten Daten durchlaufen anschließend eine Transpositionsschicht, die die Darstellungsachsen verändert: Zeitliche Sequenzen werden in räumliche Merkmale umgewandelt und einem Faltungsfilter zugeführt. Eine Faltungsschicht mit tanh-Aktivierung identifiziert zentrale Muster und strukturelle Abhängigkeiten in den Embeddings und erzeugt so eine komprimierte, konzentrierte Darstellung verborgener Marktregularitäten.
//--- layer 4
   if(!(descr = new CLayerDescription()))
      return false;
   descr.type = defNeuronTransposeOCL;
   descr.count = prev_count;
   prev_count = descr.window = prev_out;
   descr.batch = BatchSize;
   descr.optimization = ADAM;
   descr.activation = None;
   if(!encoder.Add(descr))
     {
      delete descr;
      return false;
     }
   prev_out = descr.count;
//--- layer 5
   if(!(descr = new CLayerDescription()))
      return false;
   descr.type = defNeuronConvOCL;
   descr.count = prev_count;
   descr.window = prev_out;
   descr.variables = 1;
   prev_out = descr.window_out = EmbeddingSize;
   descr.batch = BatchSize;
   descr.optimization = ADAM;
   descr.activation = TANH;
   if(!encoder.Add(descr))
     {
      delete descr;
      return false;
     }
Den Abschluss des Encoders bildet die Schicht, die das GinAR-Framework implementiert. Hier werden alle zuvor gewonnenen Merkmale kombiniert und mithilfe einer Hierarchie von GinAR-Zellen interpretiert. Sie arbeiten synchron und nutzen dabei eine gemeinsame, lernbare Kovarianzmatrix, um verborgene strukturelle Abhängigkeiten in den Daten zu modellieren. Diese Schicht leitet Informationen nicht lediglich weiter – sie bildet eine aktive Darstellung des Marktzustands, die bereits als geeignet für den Einsatz bei Handelsentscheidungen angesehen werden kann.
//--- layer 6
   if(!(descr = new CLayerDescription()))
      return false;
   descr.type = defNeuronGinAR;
   descr.count = prev_count;
   descr.window = prev_out;
   descr.batch = BatchSize;
   descr.optimization = ADAM;
   descr.activation = None;
   if(!encoder.Add(descr))
     {
      delete descr;
      return false;
     }
Somit werden die Ansätze des GinAR-Frameworks konsistent, logisch und ohne unnötige Komplexität in die Modellarchitektur integriert. Der vom Encoder erzeugte finale verborgene Zustand ist eine übergeordnete Beschreibung der Marktsituation, die sich sowohl für Prognosen als auch für die Generierung von Handelsentscheidungen eignet.
Zum Trainieren des Encoders für den Umgebungszustand wird eine Strategie der durchgängigen Propagation des Fehlergradienten von mehreren unabhängigen Teilsystemen gleichzeitig verwendet. In erster Linie handelt es sich hierbei um drei Prognosemodelle, die jeweils auf die Prognose der Fortsetzung der Zeitreihe über ihren eigenen Planungshorizont spezialisiert sind. Diese Module analysieren denselben vom Encoder generierten verborgenen Zustand, interpretieren ihn jedoch je nach vorgegebenem Planungshorizont unterschiedlich. Dies ermöglicht ein mehrskaliges Verständnis der aktuellen Marktsituation.
Zudem wird der Actor hinzugefügt – eine Komponente, die für die Generierung einer Handelsentscheidung zuständig ist. Er stützt sich auf dieselbe komprimierte Darstellung des Umgebungszustands und interpretiert diese als Handlungsleitfaden. Somit steht der Encoder gleichzeitig aus vier Richtungen unter Druck: Seine Ausgabe muss sowohl für Prognosen aussagekräftig als auch für die praktische Anwendung unter Marktunsicherheit geeignet sein.
Es ist wichtig zu betonen, dass die Architektur all dieser Modelle vollständig aus der früheren Arbeit übernommen wurde. Daher werden wir in dieser Studie nicht näher auf ihre detaillierte Beschreibung eingehen. Der Fokus liegt ausschließlich auf dem neuen Teil – der Integration des GinAR-Frameworks in das trainierbare System.
Der vollständige Code für alle Komponenten, einschließlich der Schichtkonfigurationen, ist im Anhang enthalten.
Training
Nachdem wir den Aufbau aller Komponenten und die Konfiguration der Architektur der trainierbaren Modelle abgeschlossen haben, gehen wir nun zur letzten und vielleicht kritischsten Phase über – dem Modelltraining. In unserem System verfolgen wir einen kombinierten Ansatz, der die Stärken sowohl der Offline- als auch der Online-Trainingsmodi vereint. Dies gewährleistet nicht nur ein robustes initiales Training des Modells, sondern ermöglicht es auch, sein Verhalten an spezifische Handelsbedingungen anzupassen, darunter Veränderungen der Marktphase, des Volatilitätsniveaus und der Häufigkeit von Handelssignalen.
Wie in früheren Studien erfolgt der Trainingsprozess in zwei Phasen. Die erste Phase ist das Offline-Training. Hier werden die Modelle anhand historischer Daten trainiert. Zudem verfolgen wir einen Ansatz, bei dem keine Trainingsstichprobe im Voraus gesammelt werden muss. Stattdessen bilden wir den Umgebungszustand direkt aus den historischen Daten des Terminals und simulieren gleichzeitig den Kontozustand. Dieser Ansatz bietet ein hohes Maß an Flexibilität und ermöglicht die Verwendung beliebiger historischer Zeiträume, ohne dass eine manuelle Aufbereitung der Datensätze erforderlich ist.
Die zweite Phase ist die Online-Feinabstimmung. Sie wird im Strategietester des MetaTrader 5 unter Bedingungen durchgeführt, die dem Live-Trading so nahe wie möglich kommen. Das Modell setzt das Training fort, während es auf neue, zuvor ungesehene Marktszenarien stößt, und passt sich in Echtzeit daran an. Diese Phase ermöglicht es, die während des Offline-Trainings angesammelten verbleibenden Diskrepanzen aufzulösen und das System auf den vollständig autonomen Betrieb auf einem Live-Konto vorzubereiten.
Es ist wichtig zu beachten, dass das zweistufige Training in unserer Forschung kein neues Konzept ist. Auch in unseren früheren Arbeiten haben wir diese Strategie erfolgreich angewendet. Im aktuellen Projekt wurden jedoch während der Offline-Trainingsphase grundlegend wichtige Änderungen vorgenommen, die sowohl durch theoretische Überlegungen als auch durch praktische Erfahrungen aus der Implementierung früherer Modelle motiviert waren.
Ihnen ist wahrscheinlich aufgefallen, dass in der aktuellen Architektur eine Komponente namens Director fehlt. Erinnern wir uns daran, dass in mehreren neueren Arbeiten der Director als zusätzliches Bewertungsmodell eingesetzt wurde, das parallel zum Critic arbeitete. Seine Hauptfunktion bestand in der binären Klassifizierung der Aktionen des Agenten als profitabel oder verlustbringend. Diese starre Form des Feedbacks erwies sich in den frühen Trainingsphasen als wirksam und trug dazu bei, die anfängliche Anpassung der Policy zu beschleunigen.
Dennoch haben wir in der aktuellen Umsetzung einen anderen Ansatz gewählt. Wir haben uns daher entschlossen, zwei Trainingsansätze – Reinforcement Learning und überwachtes Lernen – direkt in der Offline-Trainingsphase zu kombinieren. Diese Lösung erwies sich sowohl hinsichtlich der Qualität als auch der Ausrichtung des Feedbacks als eleganter und effektiver.
Der Kern der Änderung ist folgender: Parallel zur Bewertung der aktuellen Aktionen des Agenten, die vom Critic vorgenommen wird, stellen wir dem Actor Referenzaktionen zur Verfügung, die aus einer Analyse zukünftiger Kursbewegungen abgeleitet werden. Da wir während der Offline-Trainingsphase Zugriff auf das gesamte Zeitreihensegment haben, einschließlich der nachfolgenden Kursbewegungen, können wir eine sogenannte nahezu perfekte Aktionstrajektorie berechnen. Diese nachträglich generierten Aktionen geben nicht nur einfach die Richtung an – sie werden zu einer Art Referenzpunkt, auf den die Actor-Policy hinarbeitet.
Daher implementieren wir einen Mechanismus, bei dem der Agent sowohl aus seinen eigenen Fehlern als auch aus Beispielen vorab berechneter gewinnbringender Strategien lernt. Dadurch lässt sich von der harten binären Rückmeldung des Director abkommen, ohne dass deren Trainingseffekt verloren geht. Im Gegenteil: Die Qualität des Leitsignals verbessert sich, und der Prozess der Entwicklung einer profitablen Policy wird besser beherrschbar und robuster.
Der vorgeschlagene Ansatz wird in der Methode Train des Expert Advisors implementiert, der sich unter „…\MQL5\Experts\GinAR\Study.mq5“ befindet. Der Algorithmus dieser Methode bildet die zentrale Phase des Offline-Trainings und kombiniert Reinforcement Learning mit überwachtem Lernen. Er basiert auf der sequenziellen Simulation von Marktsituationen anhand historischer Daten und auf dem Training einer Handelsstrategie durch die Analyse sowohl aktueller Zustände als auch idealisierter Trajektorien von Handelsentscheidungen.
Alles beginnt mit der Aufbereitung eines Trainingsdatensatzes: Aus den historischen Kursdaten wird ein benutzerdefinierter Bereich ausgewählt, und für jedes Zeitintervall werden die zu analysierenden technischen Indikatoren berechnet. In diesem Schritt stellen wir sicher, dass alle Indikatoren berechnet wurden und einsatzbereit sind; andernfalls wird der Vorgang unterbrochen.
void Train(void)
  {
   int start = iBarShift(Symb.Name(), TimeFrame, Start);
   int end = iBarShift(Symb.Name(), TimeFrame, End);
   int bars = CopyRates(Symb.Name(), TimeFrame, 0, start, Rates);
//---
   if(!RSI.BufferResize(bars) || !CCI.BufferResize(bars) ||
      !ATR.BufferResize(bars) || !MACD.BufferResize(bars))
     {
      PrintFormat("%s -> %d", __FUNCTION__, __LINE__);
      ExpertRemove();
      return;
     }
//---
   int count = -1;
   bool calculated = false;
   do
     {
      count++;
      calculated = (RSI.BarsCalculated() >= bars &&
                    CCI.BarsCalculated() >= bars &&
                    ATR.BarsCalculated() >= bars &&
                    MACD.BarsCalculated() >= bars
                   );
      Sleep(100);
      count++;
     }
   while(!calculated && count < 100);
   if(!calculated)
     {
      PrintFormat("%s -> %d The training data has not been loaded", __FUNCTION__, __LINE__);
      ExpertRemove();
      return;
     }
   RSI.Refresh();
   CCI.Refresh();
   ATR.Refresh();
   MACD.Refresh();
//---
   if(!ArraySetAsSeries(Rates, true))
     {
      PrintFormat("%s -> %d", __FUNCTION__, __LINE__);
      ExpertRemove();
      return;
     }
   bars -= end + HistoryBars + NForecast;
   if(bars < 0)
     {
      PrintFormat("%s -> %d", __FUNCTION__, __LINE__);
      ExpertRemove();
      return;
     }
Puffer werden angelegt, um Eingabezustände, Zeitstempel und Zielwerte zu speichern.
Als Nächstes beginnt die Haupttrainingsschleife. Das Training ist als eine Reihe von Epochen organisiert – vollständige Durchläufe über die ausgewählte Historie. Innerhalb jeder Epoche werden die Marktsituationen nacheinander simuliert.
//---
   vector<float> result, target, neg_target;
   bool Stop = false;
//---
   uint ticks = GetTickCount();
//---
   for(int epoch = 0; (epoch < Epochs && !IsStopped() && !Stop); epoch ++)
     {
      if(!cEncoder.Clear())
        {
         PrintFormat("%s -> %d", __FUNCTION__, __LINE__);
         ExpertRemove();
         return;
        }
      for(int posit = start - HistoryBars - NForecast - 1; posit >= end; posit--)
        {
         if(!CreateBuffers(posit, GetPointer(bState), GetPointer(bTime), Result))
           {
            PrintFormat("%s -> %d", __FUNCTION__, __LINE__);
            ExpertRemove();
            return;
           }
         const vector<float> account = SampleAccount(GetPointer(bState), datetime(bTime[0]));
         const vector<float> target_action = OraculAction(account, Result);
         if(!bAccount.AssignArray(account))
           {
            PrintFormat("%s -> %d", __FUNCTION__, __LINE__);
            ExpertRemove();
            return;
           }
Bei jedem Schritt wird der aktuelle Marktzustand als numerischer Vektor gebildet, und die entsprechende Zeitachse wird bestimmt. Diese Daten werden in den Encoder eingespeist, der den Zustand in eine kompakte verborgene Darstellung umwandelt – eine Art Quintessenz des Marktbildes.
//--- Feed Forward
if(!cEncoder.feedForward((CBufferFloat*)GetPointer(bState), 1, false,
                                   (CBufferFloat*)GetPointer(bTime)))
  {
   PrintFormat("%s -> %d", __FUNCTION__, __LINE__);
   Stop = true;
   break;
 }
Der daraus resultierende latente Vektor wird gleichzeitig auf drei Arten verwendet. Einerseits wird er in drei Prognosemodelle eingespeist, von denen jedes für seinen eigenen Planungshorizont zuständig ist: kurzfristig, mittelfristig und langfristig. Diese Modelle liefern Prognosen für die kommenden Zeiträume.
for(uint f = 0; f < caForecast.Size(); f++)
   if(!caForecast[f].feedForward(GetPointer(cEncoder), -1, (CBufferFloat*)NULL))
     {
      PrintFormat("%s -> %d - Forecast %d", __FUNCTION__, __LINE__, f);
      Stop = true;
      break;
     }
Andererseits wird dieselbe verborgene Darstellung an den Actor weitergeleitet, der für die Handelsentscheidung zuständig ist. Auf der Grundlage des Marktzustands und des aktuellen Kontozustands generiert er einen Aktionstensor.
if(!cActor.feedForward(GetPointer(bAccount), 1, false, GetPointer(cEncoder), LatentLayer))
  {
   PrintFormat("%s -> %d", __FUNCTION__, __LINE__);
   Stop = true;
   break;
  }
Die getroffene Entscheidung wird vom Critic bewertet, der ermittelt, wie sinnvoll sie unter den gegebenen Bedingungen ist.
if(!cCritic.feedForward(GetPointer(cActor), -1, GetPointer(cEncoder), LatentLayer))
  {
   PrintFormat("%s -> %d", __FUNCTION__, __LINE__);
   Stop = true;
   break;
  }
Nach der Durchführung eines Vorwärtsdurchlaufs müssen wir den Modellen Feedback geben. Zunächst werden die Parameter der Prognosemodelle angepasst.
//--- Study
for(uint f = 0; f < caForecast.Size(); f++)
   if(!caForecast[f].backProp(Result, (CBufferFloat*)NULL) ||
     !cEncoder.backPropGradient((CBufferFloat*)NULL))
     {
     PrintFormat("%s -> %d - Forecast %d", __FUNCTION__, __LINE__, f);
      Stop = true;
      break;
     }
Die Bewertung der Aktionen des Actor basiert auf der Berechnung der Belohnung: der auf den Referenz-Kontostand normierten Veränderung der Equity. Bei einem Verlust wird die Strafe verdoppelt, um das Feedback strenger und aussagekräftiger zu gestalten. Wir übergeben die daraus resultierende Belohnung an den Critic. Anschließend leiten wir den Fehlergradienten von dort aus rückwärts an den Actor und den Encoder weiter.
//---
cActor.getResults(Action);
double equity = bAccount[2] * bAccount[0] * EtalonBalance / (1 + bAccount[1]);
double reward = CheckAction(Action, equity, posit - NForecast + 1) / EtalonBalance;
if(reward < 0)
   reward *= 2;
Result.Clear();
if(!Result.Add(float(reward)))
  {
   PrintFormat("%s -> %d", __FUNCTION__, __LINE__);
   Stop = true;
   break;
  }
if(!cCritic.backProp(Result, GetPointer(cEncoder), LatentLayer) ||
  !cActor.backPropGradient(GetPointer(cEncoder), LatentLayer, -1, false) ||
  !cEncoder.backPropGradient((CBufferFloat*)NULL, NULL, LatentLayer, true))
 {
   PrintFormat("%s -> %d", __FUNCTION__, __LINE__);
   Stop = true;
  break;
  }
So erfolgt das initiale Training: auf Grundlage der tatsächlichen Reaktion des Marktes auf die ausgewählte Aktion.
Doch damit ist der Prozess noch nicht abgeschlossen. An dieser Stelle kommt der zweite Teil des Ansatzes ins Spiel – das überwachte Lernen. Anstatt sich ausschließlich auf die tatsächliche Reaktion des Marktes zu stützen, nutzt das System Informationen, die im realen Handel nicht verfügbar sind: Wissen über die Zukunft. Für jeden Zustand wird eine nahezu perfekte Referenztrajektorie berechnet – also die Aktion, die gemessen an der anschließenden Kursentwicklung zum besten Ergebnis geführt hätte. Diese Aktion wird an den Actor übergeben, der sie mit seiner eigenen Policy vergleicht. Auf diese Weise trainieren wir die Strategie nicht nur durch Versuch und Irrtum, sondern geben ihr auch einen klaren Maßstab vor, den sie anstreben soll. Dieses zweischichtige Schema (tatsächliche und idealisierte Steuerung) beschleunigt das Lernen und sorgt für ein stabileres und rationaleres Verhalten des Modells.
//--- Oracul
if(!Action.AssignArray(target_action))
  {
   PrintFormat("%s -> %d", __FUNCTION__, __LINE__);
   Stop = true;
   break;
  }
reward = CheckAction(Action, equity, posit - NForecast + 1) / EtalonBalance;
if(!cActor.backProp(Action, GetPointer(cEncoder), LatentLayer) ||
   !cEncoder.backPropGradient((CBufferFloat*)NULL, NULL, LatentLayer, true))
  {
   PrintFormat("%s -> %d", __FUNCTION__, __LINE__);
   Stop = true;
   break;
  }
Der Einsatz einer Referenzaktion beschränkt sich nicht auf das Training des Actor. Außerdem leiten wir diese Aktion an den Eingang des Critic weiter, der – anders als im ersten Durchlauf – ein Verhalten bewertet, von dem bekannt ist, dass es korrekt ist. Nach dem Vorwärtsdurchlauf wird der Fehler anhand dieser idealisierten Aktion per Backpropagation zum Encoder propagiert. Dadurch kann der Critic die Struktur der Belohnungsfunktion genauer erfassen, zusätzliche Informationen über jene Bereiche des Zustandsraums gewinnen, in denen das Agenten-Verhalten besonders präzise sein muss, und dadurch seine Effektivität beim anschließenden Training des Actor verbessern.
if(!cCritic.feedForward(Action, 1, false, GetPointer(cEncoder), LatentLayer))
  {
   PrintFormat("%s -> %d", __FUNCTION__, __LINE__);
   Stop = true;
   break;
  }
if(!Result.Update(0, float(reward)))
  {
   PrintFormat("%s -> %d", __FUNCTION__, __LINE__);
   Stop = true;
   break;
  }
if(!cCritic.backProp(Result, GetPointer(cEncoder), LatentLayer) ||
   !cEncoder.backPropGradient((CBufferFloat*)NULL, NULL, LatentLayer, true))
  {
   PrintFormat("%s -> %d", __FUNCTION__, __LINE__);
   Stop = true;
   break;
  }
//---
Damit ist der gesamte Trainingszyklus für einen einzelnen Zustand abgeschlossen. Zudem verläuft das Lernen gleichzeitig entlang zweier Trajektorien: über das tatsächliche Verhalten und über das Referenzverhalten. Diese Dual-Loop-Struktur ermöglicht nicht nur, den Fehler schneller zu reduzieren, sondern trägt auch dazu bei, interne Repräsentationen zu bilden, die gegenüber Marktrauschen und lokalen Schwankungen robust sind.
Während des gesamten Vorgangs wird im Terminal in festgelegten Zeitabständen ein visueller Bericht aktualisiert. Auf dem Bildschirm werden die durchschnittlichen Fehler aller Modelle angezeigt. Anhand dieser Daten kann der Entwickler den Trainingsfortschritt in Echtzeit überwachen, die Stabilität des Prozesses beurteilen und potenzielle Fehler oder Anomalien erkennen.
    if(GetTickCount() - ticks > 500)
      {
       double percent = (epoch + 1.0 - double(posit - end) /
                        (start - end - HistoryBars - NForecast))
                        / Epochs * 100.0;
       string str = "";
       for(uint f = 0; f < caForecast.Size(); f++)
          str += StringFormat("%-12s%d %6.2f%% -> Error %15.8f\n", "Forecast", f,
                                 percent, caForecast[f].getRecentAverageError());
       str += StringFormat("%-12s %6.2f%% -> Error %15.8f\n", "Actor", percent,
                                                 cActor.getRecentAverageError());
       str += StringFormat("%-12s %6.2f%% -> Error %15.8f\n", "Critic", percent,
                                                cCritic.getRecentAverageError());
       Comment(str);
       ticks = GetTickCount();
      }
   }
}
Sobald das Training über alle Epochen hinweg abgeschlossen ist, fasst der Algorithmus die Ergebnisse zusammen und zeigt den durchschnittlichen Fehler für jedes Modell an. Danach beendet sich der Expert Advisor.
   Comment("");
//---
   for(uint f = 0; f < caForecast.Size(); f++)
      PrintFormat("%s -> %d -> %-15s%d %10.7f", __FUNCTION__, __LINE__, "Forecast", f,
                                               caForecast[f].getRecentAverageError());
   PrintFormat("%s -> %d -> %-15s %10.7f", __FUNCTION__, __LINE__, "Actor",
                                                      cActor.getRecentAverageError());
   PrintFormat("%s -> %d -> %-15s %10.7f", __FUNCTION__, __LINE__,
                                            "Critic",cCritic.getRecentAverageError());
   ExpertRemove();
//---
  }
Letztlich zeigt die Train-Methode, wie das Training einer Handelsstrategie strukturiert werden kann, indem sowohl auf tatsächliche Ergebnisse von Aktionen als auch auf ideale Referenzen zurückgegriffen wird, die aus der Zukunft abgeleitet werden. Diese Architektur ermöglicht nicht nur eine Anpassung an historische Daten, sondern auch eine gezielte Ausrichtung auf potenzielle Gewinne.
Der vollständige Code für diesen Expert Advisor sowie für alle Programme, die bei der Erstellung dieses Artikels verwendet wurden, ist im Anhang enthalten.
Testen
Wie bereits erwähnt, war der gesamte Modelltrainingsprozess in zwei aufeinanderfolgende Phasen unterteilt. In der ersten Phase haben wir ein Offline-Training auf historischen Daten für das Währungspaar EURUSD im H1-Zeitrahmen für das gesamte Jahr 2024 durchgeführt. Dieser Zeitraum umfasst eine breite Palette von Marktszenarien – von anhaltenden Seitwärtsbewegungen bis hin zu raschen Trendbewegungen und von trägen, ruhigen Phasen bis hin zu explosionsartigen Volatilitätssprüngen. Diese Vielfalt ermöglichte es dem Modell, sowohl mit typischen als auch mit atypischen Situationen konfrontiert zu werden, was für Zuverlässigkeit und Vielseitigkeit von entscheidender Bedeutung ist.
Während des Trainings lernte der Encoder, wiederkehrende Muster in Marktinformationen zu erkennen und diese in eine kompakte, aber dennoch merkmalsreiche Darstellung zu komprimieren. Dieser interne Marktzustand bildete die Grundlage, auf der der Actor unter Nutzung des Feedbacks des Critic eine robuste Strategie entwickelte, die unter verschiedenen Bedingungen effektiv agieren konnte. Zudem wurden dem Modell während der Offline-Trainingsphase sogenannte nahezu perfekte Trajektorien zur Verfügung gestellt – Referenzaktionen, die auf Grundlage der Kenntnis zukünftiger Kursbewegungen generiert wurden. Diese Hinweise lenkten nicht nur die Policy in Richtung höherer Gewinne, sondern boten auch einen verlässlichen Bezugspunkt für die Strategieentwicklung, insbesondere in den frühen Phasen des Trainings, als die eigene Erfahrung des Modells noch begrenzt war.
Nach Abschluss des Offline-Trainings gingen wir zur zweiten Phase über – der Online-Feinabstimmung unter Bedingungen, die denen des Live-Marktes nahekommen. Das Training wurde im Strategietester des MetaTrader 5 durchgeführt, wo das Modell den Markt im Streaming-Modus Schritt für Schritt und Kerze für Kerze analysierte. Dadurch konnten wir nicht nur die Robustheit des Modells gegenüber Rauschen, Marktverzerrungen und zufälligen Schwankungen testen, sondern dies wurde auch zu einem wichtigen Instrument für die Anpassung: Das Modell prägte sich die Informationen nicht einfach nur ein, sondern lernte tatsächlich, unter realen, unvorhersehbaren Bedingungen zu operieren. Dieser Ansatz erhöhte die Robustheit des Modells deutlich, reduzierte Overfitting und verbesserte seine Generalisierungsfähigkeit.
Der letzte Schritt bestand darin, das Modell anhand völlig neuer Daten zu testen – nämlich anhand von Marktkursen für den Zeitraum von Januar bis März 2025. Alle während des Trainings verwendeten Parameter und internen Einstellungen blieben unverändert. Somit ermöglichen die erzielten Ergebnisse eine objektive Bewertung nicht nur der Genauigkeit, sondern auch der praktischen Zuverlässigkeit des vorgeschlagenen Ansatzes.
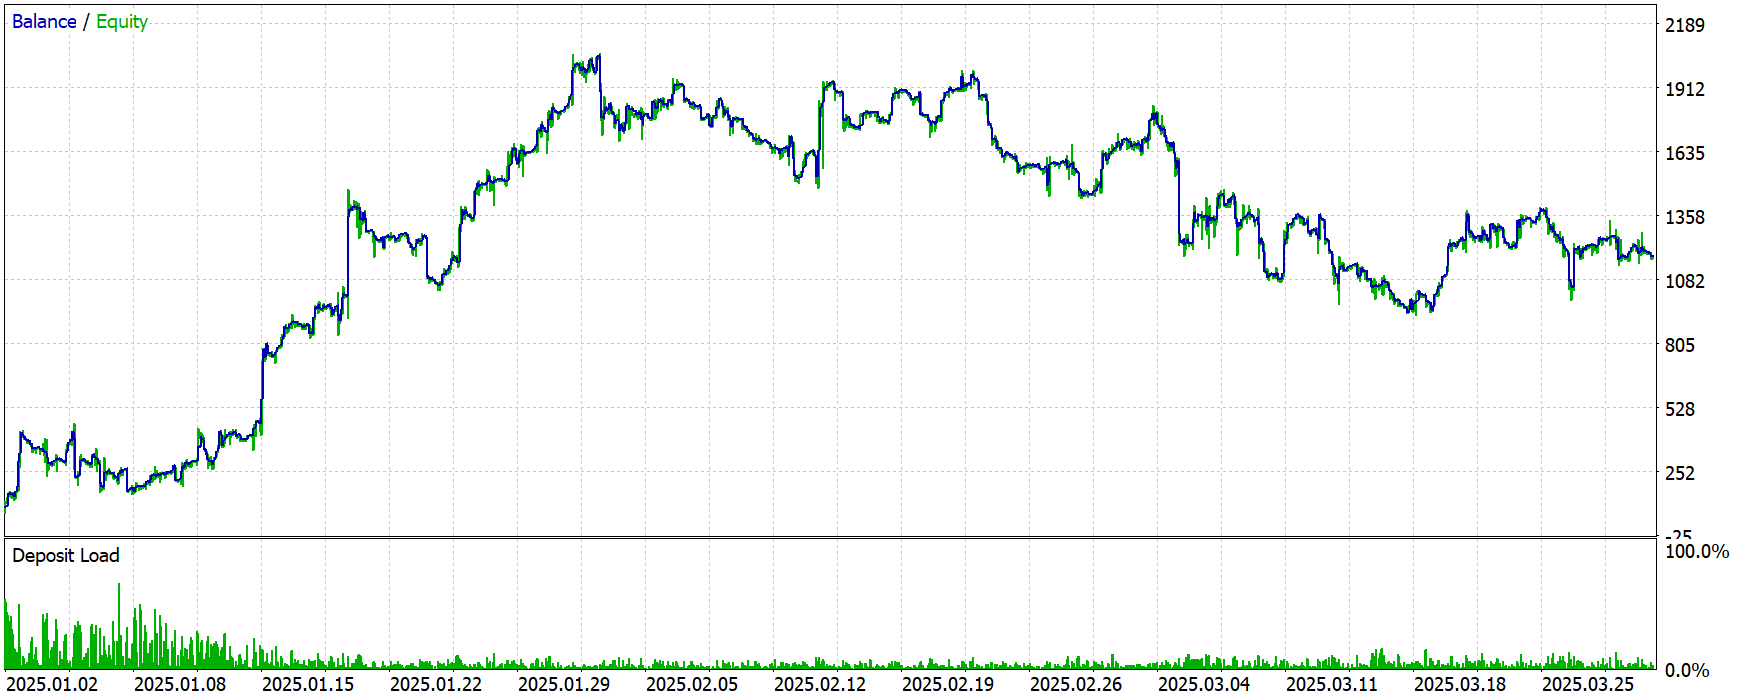
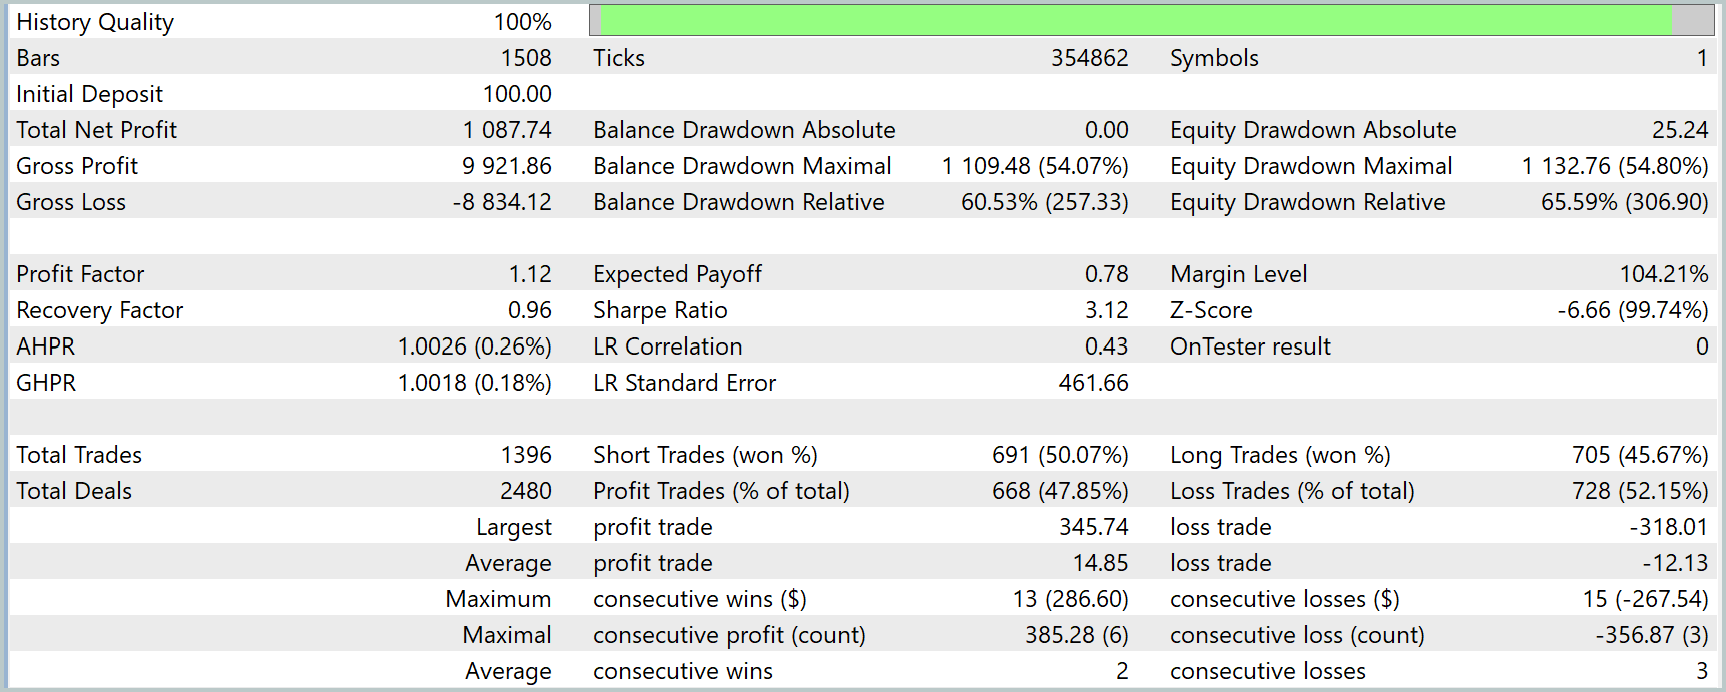
Die Ergebnisse der Modelltests liefern ein objektives Bild der tatsächlichen Effektivität und Robustheit des Modells außerhalb der Trainingsstichprobe. Die Anfangseinlage von 100 Dollar stieg auf 1.087,74 Dollar an, was einer mehr als zehnfachen Kapitalvervielfachung entspricht – ein Ergebnis, das auf den ersten Blick beeindruckend wirkt. Bei genauerer Betrachtung zeigt sich jedoch ein deutliches Muster: Das Modell schneidet zu Beginn des Testzeitraums sehr gut ab, doch je weiter es sich zeitlich von der Trainingsstichprobe entfernt, desto stärker lässt seine Leistung nach.
Das Kontostandsdiagramm veranschaulicht diesen Effekt deutlich. Im ersten Drittel des Zeitraums ist ein rasantes Wachstum zu beobachten, das einer referenznahen Trajektorie mit minimalen Drawdowns und stetigen Gewinnen folgt. Ab Mitte Februar und insbesondere im März flacht die Kurve jedoch ab und zeigt sogar Anzeichen einer Verschlechterung: Die Schwankungen nehmen zu, die Verlustserien werden länger, und das Tempo des Gewinnzuwachses geht spürbar zurück.
Dieser Effekt wird auch durch numerische Kennzahlen bestätigt. Der Recovery Factor (Recovery Factor) liegt unter 1 (0,96), was auf ein nicht ideales Verhältnis zwischen Gewinn und Drawdown-Tiefe hindeutet. Der relative Drawdown bezogen auf die Equity erreicht 65,59 % – ein recht hohes Risikoniveau, insbesondere wenn man bedenkt, dass der absolute Drawdown zu Beginn des Tests nahezu bei null lag. Der Profit-Factor (Profit Factor) beträgt 1,12 – der minimal akzeptable Wert für eine Strategie, die auf eine konsistente Performance abzielt. Auch das Verhältnis zwischen profitablen und unprofitablen Trades ist zuungunsten des Modells verzerrt: Profitable Trades machen weniger als 48 % aus.
Dieses Verhalten lässt sich logisch durch die begrenzte Größe der Trainingsstichprobe erklären. Das Modell wurde ausschließlich mit Daten aus dem Jahr 2024 trainiert, und obwohl diese Daten verschiedene Marktphasen abdeckten, bleibt der Markt ein dynamisches und volatiles System. Je weiter sich das Modell vom bekannten Zeitraum entfernt, desto häufiger stößt es auf Situationen, die ihm unbekannt sind. Ohne zusätzliche Trainingsepisoden wird das Verhalten des Modells zunehmend weniger relevant, insbesondere unter neuen, volatilen Bedingungen.
Eine naheliegende Möglichkeit, dieses Problem zu lösen, besteht darin, die Trainingsstichprobe zu erweitern. Durch die Einbeziehung von Daten aus früheren Jahren – beispielsweise aus dem Jahr 2020 oder sogar aus dem Jahr 2015 – könnte das Modell ein wesentlich breiteres Spektrum an Marktszenarien abdecken. Dies könnte nicht nur die Generalisierungsfähigkeit verbessern, sondern auch zu einem besseren Verständnis seltener, aber äußerst wichtiger Muster im Preisverhalten beitragen. Eine weitere Möglichkeit wäre inkrementelles Online-Lernen, bei dem die Gewichte des Modells periodisch aktualisiert werden, sobald neue Daten eintreffen; so bliebe das Modell ohne vollständiges erneutes Training auf dem neuesten Stand.
Fazit
Im Rahmen unserer Arbeit haben wir die praktische Anwendbarkeit des GinAR-Frameworks unter realen Marktbedingungen demonstriert. Vom Entwurf der Architektur über das phasenweise Training bis hin zu den abschließenden Tests bestätigte der gesamte Prozess die Tragfähigkeit des vorgeschlagenen Ansatzes.
Trotz der starken Leistung zu Beginn des Testzeitraums offenbarte die anschließende Entwicklung die inhärenten Grenzen des Modells, die aus der begrenzten Trainingsstichprobe resultierten. Dies unterstreicht ein grundlegendes Prinzip beim Arbeiten mit Zeitreihen: Die Robustheit einer Strategie hängt unmittelbar von ihrer Fähigkeit ab, Wissen über den Trainingskontext hinaus zu generalisieren.
Die erzielten Ergebnisse bilden eine solide Grundlage für weitere Forschung und Verfeinerung. Insbesondere besteht eine naheliegende Richtung für die Weiterentwicklung darin, den Umfang der Trainingsdaten zu erweitern und einen Mechanismus für kontinuierliches Lernen zu implementieren. All dies eröffnet Möglichkeiten für die Entwicklung tatsächlich adaptiver und intelligenter Handelssysteme, die unter schwierigen Marktbedingungen nicht nur bestehen können, sondern auch dauerhaft Gewinne erzielen.
Literaturverzeichnis
- GinAR: An End-To-End Multivariate Time Series Forecasting Model Suitable for Variable Missing
- Weitere Artikel dieser Reihe
In diesem Artikel verwendete Programme
| # | Name | Typ | Beschreibung |
|---|---|---|---|
| 1 | Study.mq5 | Expert Advisor | Expert Advisor für das Offline-Modelltraining |
| 2 | StudyOnline.mq5 | Expert Advisor | Expert Advisor für Online-Modelltraining |
| 3 | Test.mq5 | Expert Advisor | Expert Advisor für Modelltests |
| 4 | Trajectory.mqh | Klassenbibliothek | Struktur zur Beschreibung des Systemzustands und der Modellarchitekturen |
| 5 | NeuroNet.mqh | Klassenbibliothek | Klassenbibliothek zum Erstellen eines neuronalen Netzes |
| 6 | NeuroNet.cl | Bibliothek | Codebibliothek für das OpenCL-Programm |
Übersetzt aus dem Russischen von MetaQuotes Ltd.
Originalartikel: https://www.mql5.com/ru/articles/18914
Warnung: Alle Rechte sind von MetaQuotes Ltd. vorbehalten. Kopieren oder Vervielfältigen untersagt.
Dieser Artikel wurde von einem Nutzer der Website verfasst und gibt dessen persönliche Meinung wieder. MetaQuotes Ltd übernimmt keine Verantwortung für die Richtigkeit der dargestellten Informationen oder für Folgen, die sich aus der Anwendung der beschriebenen Lösungen, Strategien oder Empfehlungen ergeben.

 Die Übertragung der Trading-Signale in einem universalen Expert Advisor.
 Neuronale Netze im Trading: Ein Ende-zu-Ende-Modell für multivariate Zeitreihenprognose (Kernkomponenten)
 Eine alternative Log-datei mit der Verwendung der HTML und CSS
 Neuronale Netze im Trading: Ein Ende-zu-Ende-Modell für die multivariate Zeitreihenprognose (GinAR)

- Freie Handelsapplikationen
- Über 8.000 Signale zum Kopieren
- Wirtschaftsnachrichten für die Lage an den Finanzmärkte
Sie stimmen der Website-Richtlinie und den Nutzungsbedingungen zu.
Außerdem treten dieselben Probleme im Modul „NeuroNet.mqh“ auf
Die korrigierte Bibliothek im Artikel „Neuralnetze im Trading: Zerlegung statt Skalierung – Erstellung von Modulen“ – Artikel zu MQL5
Korrigierte Bibliothek im Artikel „Neuralnetze im Trading: Zerlegung statt Skalierung – Aufbau von Modulen“ – Artikel zu MQL5