

Neuronale Netze im Trading: Eine intelligente Prognose-Pipeline (Time-MoE)
 45
 0

Einleitung
Die Prognose von Zeitreihen gehört nach wie vor zu den Kernaufgaben, auf denen der moderne algorithmische Handel basiert. Die Genauigkeit des Modells entscheidet nicht nur über den Erfolg einer Handelsstrategie, sondern auch über deren Fähigkeit, sich an die ständigen Veränderungen des Marktes anzupassen. Die meisten Modelle wurden für eine bestimmte Aufgabe entwickelt und verloren bei der geringsten Veränderung des Marktumfelds ihre Robustheit. In letzter Zeit haben sich sogenannte Foundation-Modelle rasant weiterentwickelt. Ein solches Modell wurde in dem Artikel „Time-MoE: Billion-Scale Time Series Foundation-Modelle with Mixture of Experts“.
Time-MoE ist ein Transformer mit reiner Decoder-Architektur der nächsten Generation, der speziell für Zeitreihendaten entwickelt wurde. Es basiert auf den Prinzipien des Sparse Learning, der Modularität und der Prognose auf mehreren Skalen. Die Autoren des Frameworks zeigen auf, wie sich die Skalierbarkeit und Flexibilität großer Modelle auf den Bereich der Zeitreihen ausweiten lässt, ohne dabei an Recheneffizienz einzubüßen. Die von ihnen vorgestellte Modellarchitektur unterstützt beliebige Längen der analysierten Sequenzen und Prognosehorizonte. Gleichzeitig kann das Modell Datenströme in Echtzeit verarbeiten.
Die erste Komponente der Architektur ist die punktweise Tokenisierung der Zeitreihe (Point-Wise Tokenization). Im Gegensatz zu fensterbasierten oder aggregierten Ansätzen wird hier jeder Zeitschritt in ein eigenständiges Token umgewandelt. Diese Funktion kann beim Hochfrequenzhandel nützlich sein, wo schon ein einziger Tick das Marktbild verändern kann. In der MQL5-Umgebung können Tokens aus Bars, Ticks und abgeleiteten Indikatoren gebildet werden, darunter Volatilität, Volumen und Signale aus benutzerdefinierten Strategien.
Nach der Tokenisierung werden die Daten durch eine Einbettungsschicht mit SwiGLU-Aktivierung geleitet, einer Mischung aus Swish und einer Gated Linear Unit. Es ermöglicht eine glattere und robustere Darstellung der analysierten Informationen, was insbesondere bei Marktrauschen und instabilen Trends von Nutzen ist.
Das Herzstück des Modells bildet ein Stapel aus N sich wiederholenden Blöcken, von denen jeder eine kausale Multi-Head-Self-Attention (Causal Multi-Head Self-Attention) mit einer spärlichen Expertenmischung (Sparse MoE) kombiniert. Der Fokus liegt ausschließlich auf der Vergangenheit, was eine korrekte Chronologie gewährleistet: Das Modell hat keinen Zugriff auf zukünftige Daten und ist daher unter realen Marktbedingungen anwendbar. MoE sorgt für Skalierbarkeit der Architektur: Anstatt alle Modellparameter zu aktivieren, wird für jedes Token eine begrenzte Anzahl spezialisierter Teilmodelle (Experten) ausgewählt. Manche lernen, besser mit impulsiven Kursbewegungen umzugehen, während andere sich auf Konsolidierungsphasen oder Seitwärtsmärkte spezialisieren. Der adaptive Mechanismus legt fest, wie die Tokens weitergeleitet werden.
Das Modell beschränkt sich jedoch nicht auf die Datenverarbeitung. Eines der Hauptmerkmale von TIME-MOE ist die mehrskalige Vorhersage (Multiscale Forecasting). Während des Trainings hat das Modell die Aufgabe, gleichzeitig Vorhersagen für verschiedene Prognosehorizonte zu treffen. Dies wird durch parallele Ausgabemodule (Köpfe) umgesetzt, von denen jedes auf sein eigenes Ziellabel trainiert wird: kurzfristig, mittelfristig oder langfristig. Diese Architektur ermöglicht es, sowohl die Mikrodynamik des Marktes als auch übergreifendere Muster des Marktverhaltens gleichzeitig zu erfassen. Das Modell ist in der Lage, je nach Marktkontext flexibel zwischen diesen Zeitskalen zu gewichten bzw. umzuschalten.
Bei der Inferenz kommt die dynamische Auswahl der Prognoseköpfe (Dynamic Head Scheduling) zum Einsatz. Je nach Volatilität, Trendstärke oder dem Konfidenzwert des Modells werden unterschiedliche Prognosemodule aktiviert. Dieser adaptive Ansatz macht Time-MoE besonders wertvoll im Handel, wo sich das Marktverhalten von einem Moment auf den anderen ändern kann.
Es ist wichtig zu beachten, dass Time-MoE für das Training mit umfangreichen Zeitreihendatensätzen optimiert ist. Die Autoren des Frameworks haben das Modell mit Time-300B trainiert – dem größten öffentlich zugänglichen Datensatz, der mehr als 300 Milliarden Zeitreihendatenpunkte aus neun Bereichen enthält. Dadurch konnten eine hohe Modellvielseitigkeit, Robustheit gegenüber Verteilungsverschiebungen und die Fähigkeit zur Generalisierung auf unbekannte Aufgaben erreicht werden. Gleichzeitig lässt sich Time-MoE auf 2,4 Milliarden Parameter skalieren, wobei bei der Inferenz nur ein Teil davon aktiviert wird, wodurch das Modell sowohl leistungsstark als auch ressourceneffizient ist.
Der Time-MoE-Algorithmus
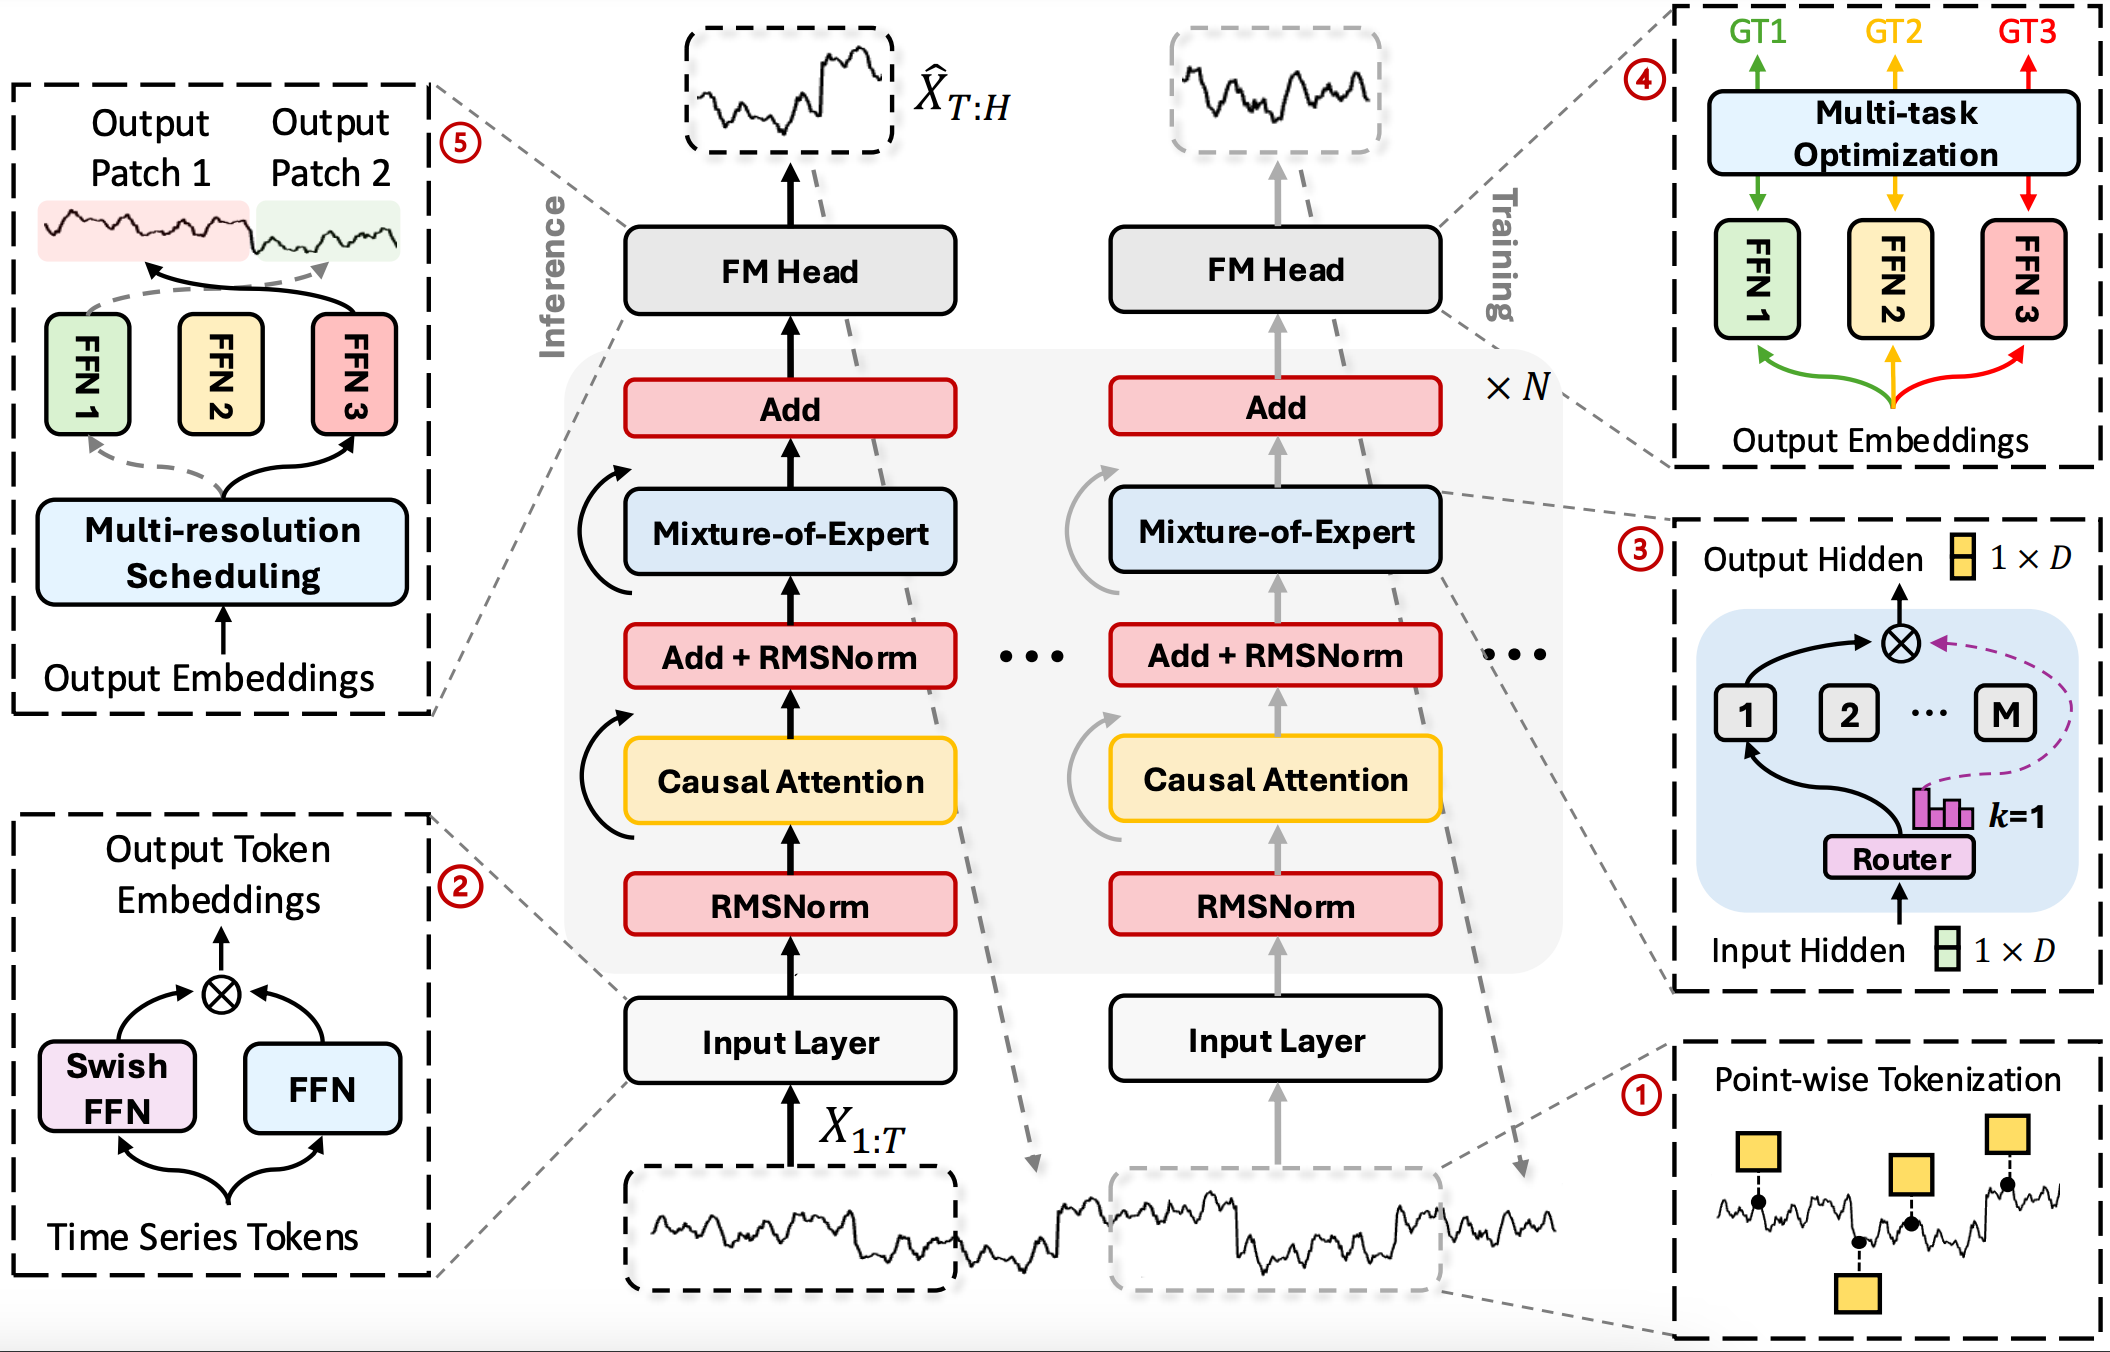
Time-MoE basiert auf der Idee, ein einheitliches, skalierbares Modell für Zeitreihenprognosen zu entwickeln, das sich an alle Bedingungen in der analysierten Umgebung anpassen kann und gleichzeitig die Belastung der Rechenressourcen beherrschbar hält. Der Algorithmus des Frameworks beginnt mit einer punktweisen Tokenisierung (Point-Wise Tokenization), bei der alle wichtigen Merkmale jedes Schritts in der Zeitreihe erfasst werden. Dieser Ansatz stellt sicher, dass bei der Aggregation kein Detail verloren geht.
Die Umwandlung von Roh-Tokens in einen informativen latenten Raum erfolgt mithilfe einer SwiGLU- Einbettung.
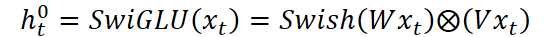
wobei die Matrizen W und V gemeinsam mit dem Modell trainiert werden. Die elementweise Multiplikation ⨂ verstärkt signifikante Merkmale, und die Kombination aus der Swish-Funktion und dem Gating-Mechanismus (Gated Linear Unit) erzeugt aussagekräftigere Einbettungen, die komplexe nicht lineare Abhängigkeiten kodieren können.
Nach der Einbettung werden die Token in einen Stapel aus N identischen Transformer-Blöcken eingespeist. Jeder Block besteht aus drei Phasen:
- Normalisierung und kausale Aufmerksamkeit: Die Eingabevektoren $h_{t,l-1} $ werden zunächst normalisiert und anschließend mittels Multi-Head-Self-Attention analysiert, wobei eine Maske den Zugriff auf zukünftige Werte verhindert. Das Token wendet den Kopf zurück und blickt auf die gesamte bisherige Geschichte zurück, kann aber gleichzeitig nicht in die Zukunft blicken, als ob es einer strengen Regel folgen würde: Aktuelle Entscheidungen basieren ausschließlich auf vergangenen Erfahrungen.
- Eine zweite Normalisierung hilft dabei, Überreaktionen auf seltene Anomalien zu vermeiden.
- Eine Sparse-MoE-Schicht. Hier leiten wir jedes historische Zeitfenster an eine Gruppe von Experten weiter – eine „Mixture-of-Experts“. Der adaptive Router entscheidet, welche K von N Experten aktiviert werden sollen. Der gemeinsame (N+1)-te Experte wird stets über eine sigmoide Gewichtungsfunktion einbezogen. Aktive Experten verarbeiten die Daten unabhängig voneinander und liefern ihre Ausgaben. Das Endsignal des Blocks wird mit dem Eingangssignal summiert.
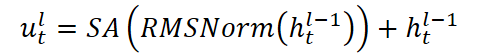
wobei SA für Self-Attention mit H Köpfen steht, von denen jeder die vorherigen t-1 Positionen analysiert. Dank dieses Ansatzes kann das Modell wichtige Ereignisse in der Historie erfassen und dabei kausale Zusammenhänge bewahren.
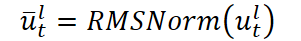
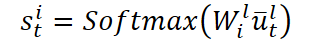
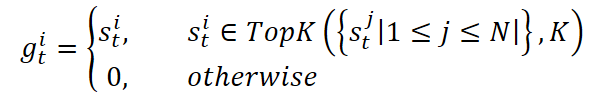
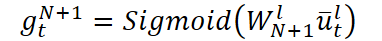
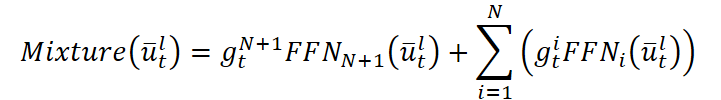
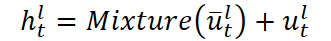
Diese Struktur ermöglicht eine dynamische Auswahl der Spezialisierung: In Phasen hoher Volatilität werden die Token an Experten weitergeleitet, die darauf trainiert sind, impulsive Bewegungen zu erkennen, während sie in ruhigeren Phasen an diejenigen weitergeleitet werden, die besser für den Umgang mit Trends oder Seitwärtsbewegungen geeignet sind. Die Top-K-Expertenauswahl ermöglicht es, die Anzahl der aktiven Teilnetzwerke zu begrenzen, während der Großteil der Parameter inaktiv bleibt. Dadurch lässt sich das Modell auf Milliarden von Parametern skalieren, während das Inferenzbudget konstant bleibt.
Wenn das Token xT alle N Schichten durchläuft, erhalten wir einen Kontextvektor hT,L, der die gesamte Marktgeschichte und deren Muster enthält. Bei der Multi-Resolution-Prognose werden daraus mithilfe einschichtiger FFNs P Prognosen für die Prognosehorizonte p1 …, pP generiert.
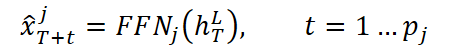
Diese Architektur ermöglicht es, Prognosen für verschiedene Zeiträume gleichzeitig zu erstellen und dabei eine einheitliche verborgene Darstellung beizubehalten.
Während des Trainings steht das Modell vor der Aufgabe, mehrere Prognosehorizonte gleichzeitig vorherzusagen: von kurzfristigen Schwankungen im Minutentakt bis hin zu längerfristigen Trends, die sich über Tage und Wochen hinweg entwickeln. Für jede Prognose verwenden die Autoren des Rahmenwerks den Huber-Verlust, der die Glattheit der quadratischen Komponente mit der Robustheit des linearen Teils verbindet. Bei kleinen Fehlern verhält sich der Huber-Verlust ähnlich wie der klassische MSE und bestraft kleine Abweichungen nur geringfügig, während er bei großen Fehlern allmählich in den L1-Verlust übergeht, wodurch die Auswirkungen seltener Ausreißer gemindert und eine Gradientenexplosion verhindert werden. Das Modell aggregiert anschließend die Verluste über alle Prognose-Heads hinweg.
Dank dieses Ansatzes lernt das Modell, kurzfristige impulsartige Bewegungen zu erfassen und gleichzeitig langfristige Trends zu verfolgen, wobei die Kohärenz der Prognosen auf allen Schichten gewahrt bleibt.
Der Einsatz von „Sparse Experts“ (MoE) birgt jedoch das Risiko einer ungleichmäßigen Arbeitslastverteilung: Einige Experten könnten überlastet werden, während andere untätig bleiben. Um diesen Effekt abzuschwächen, wurde ein zusätzlicher Regularisierungsterm hinzugefügt, um das Ungleichgewicht zu messen. Das endgültige Trainingsziel setzt sich aus den Haupt- und Nebenkomponenten zusammen.
Das Endergebnis ist eine einheitliche, koordinierte Pipeline: von der feinkörnigen Tokenisierung über die dynamische Zuweisung an Experten bis hin zu mehrstufigen Prognosen und einem ausgewogenen Training.
Nachstehend ist die von den Autoren erstellte Darstellung des Time-MoE-Rahmenwerks abgebildet.
Implementierung in MQL5
Nachdem wir uns nun ausführlich mit der Theorie und den wichtigsten Aspekten des Time-MoE-Frameworks befasst haben, ist es an der Zeit, zum praktischen Teil unserer Arbeit überzugehen und die Theorie in Code umzusetzen. Anstatt jedoch zu versuchen, das Ganze auf einmal anzugehen, werden wir das gesamte System in logische Blöcke unterteilen. Wir werden dem Informationsfluss folgen und das Framework Schritt für Schritt mit MQL5 umsetzen. Dieser schrittweise, praxisorientierte Ansatz wird nicht nur das Testen und Debuggen der einzelnen Module erleichtern, sondern es uns auch ermöglichen, diese zu einer voll funktionsfähigen, reaktionsschnellen Time-MoE-Implementierung zusammenzufügen, die für einen leistungsstarken und effizienten Betrieb unter realen Marktbedingungen bereit ist.
Gemäß dem ursprünglichen Konzept, das von den Autoren von Time-MoE vorgeschlagen wurde, durchlaufen alle Eingabedaten das Modul zur punktweisen Tokenisierung, das mithilfe einer bestehenden Faltungsschicht effizient implementiert werden kann. Im Wesentlichen wird jede Bar oder jeder Tick in einen kurzen 1D-Faltungsfilter eingespeist, und das Ergebnis der Faltung ist nichts anderes als ein atomares Token mit einer Reihe von Merkmalen. Diese Technik bietet uns zwei wichtige Vorteile: Erstens bleiben Informationen über jeden Zeitpunkt bzw. jede einzelne Zeitposition erhalten, ohne dass es zu den bei einer Aggregation üblichen Verlusten kommt; zweitens werden lokale Muster durch die Faltung sofort erkannt.
Anschließend werden die Daten an die SwiGLU-Einbettung weitergeleitet, mit der wir uns als Nächstes befassen werden.
SwiGLU-Einbettung
Nachdem die Tokens generiert wurden, werden sie an die zweite Stufe weitergeleitet – das SwiGLU-Einbettungsmodul, das die Rohmerkmale in aussagekräftige Vektoren im verborgenen Raum umwandelt. Die SwiGLU-Schicht führt eine doppelte Transformation durch:
- Zunächst durchläuft das Token eine lineare Projektion und die sanfte, glatte Swish-Funktion;
- dann durch eine weitere Projektion und eine selektive Gated Linear Unit (GLU).
Am Ausgang werden die beiden Ergebnisse durch elementweise Multiplikation kombiniert.
Swish glättet die Einbettung, sodass das Modell subtile Signale erfassen kann, während GLU einzelne Vektorkomponenten öffnet oder schließt und so die wirklich wichtigen Muster hervorhebt.
In unserer Implementierung wird die SwiGLU-Schicht durch die Klasse CNeuronSwiGLUOCL dargestellt, die vom Basisobjekt für neuronale Schichten abgeleitet ist. In dieser Klasse werden wir zwei spezielle Faltungsschichten erstellen, die eine duale Projektion des analysierten Vektors durchführen und zwei Versionen des Signals ausgeben. Die Struktur des neuen Objekts ist unten dargestellt.
class CNeuronSwiGLUOCL  :  public   CNeuronBaseOCL
  {
protected:
   CNeuronConvOCL    caProjections[2];
   //---
   virtual bool      feedForward(CNeuronBaseOCL *NeuronOCL)          override;
   virtual bool      updateInputWeights(CNeuronBaseOCL *NeuronOCL)   override;
   virtual bool      calcInputGradients(CNeuronBaseOCL *NeuronOCL)   override;

public:
                     CNeuronSwiGLUOCL(void) {};
                    ~CNeuronSwiGLUOCL(void) {};
   //---
   virtual bool      Init(uint numOutputs, uint myIndex, COpenCLMy *open_cl, uint window,
                          uint step, uint window_out, uint units_count, uint variables,
                          ENUM_OPTIMIZATION optimization_type, uint batch);
   //---
   virtual int       Type(void) override const {   return defNeuronSwiGLUOCL; }
   //--- methods for working with files
   virtual bool      Save(int const file_handle)   override;
   virtual bool      Load(int const file_handle)   override;
   //---
   virtual void      SetOpenCL(COpenCLMy *obj)     override;
   //---
   virtual bool      WeightsUpdate(CNeuronBaseOCL *source, float tau) override;
  };
Alle internen Objekte unserer neuen Klasse werden statisch deklariert. Daher bleiben der Konstruktor und der Destruktor leer. Die Initialisierung aller Projektionen, Faltungsparameter und der Verbindung zum OpenCL-Kontext erfolgt über die Methode Init. In den Parametern dieser Funktion gibt der Benutzer die Größe des Faltungsfensters, den Schritt, die Anzahl der Filter sowie einen Zeiger auf den OpenCL-Kontext an. All dies ermöglicht es, die Schicht vor der Verwendung vollständig zu konfigurieren.
bool CNeuronSwiGLUOCL::Init(uint numOutputs, uint myIndex, COpenCLMy *open_cl,
                            uint window, uint step, uint window_out, uint units_count,
                            uint variables, ENUM_OPTIMIZATION optimization_type, uint batch)
  {
   if(CNeuronBaseOCL::Init(numOutputs, myIndex, open_cl, units_count * window_out * variables,
                                                                    optimization_type, batch))
      return false;
   SetActivationFunction(None);
Innerhalb der Methode übergeben wir die gesamte grundlegende Initialisierung nach oben – auf die Schicht der übergeordneten Klasse, wo die grundlegende Validierung und die allgemeine Schnittstelleneinrichtung bereits implementiert sind. Rufen Sie dazu einfach die gleichnamige Methode in der übergeordneten Klasse auf. Dadurch können wir Doppelungen bei Low-Level-Operationen vermeiden und uns auf die Zuverlässigkeit der Ausführungsumgebung verlassen.
Hier deaktivieren wir die Aktivierungsfunktion unserer Schicht explizit auf Ebene der Schnittstelle, da alle Nichtlinearitäten durch interne Objekte implementiert werden.
Sobald die Details zur Infrastruktur geklärt sind, machen wir uns daran, unsere Schicht zu optimieren. An dieser Stelle ist es wichtig zu beachten, dass beide internen Faltungsschichten so ausgelegt sind, dass sie Vektoren gleicher Größe erzeugen – dies ist von entscheidender Bedeutung. Schließlich können wir die Elemente nur dann korrekt Element für Element multiplizieren, wenn die Dimensionen übereinstimmen. Der einzige Unterschied zwischen ihnen besteht in der anschließenden Verwendung unterschiedlicher Aktivierungsfunktionen.
Daher initialisieren wir diese Schichten während der Vorbereitungsphase in einer Schleife und weisen jeder Schicht automatisch dieselbe Konfiguration des Faltungsfensters, dieselbe Anzahl an Filtern und denselben Schritt zu. Dadurch wird eine Code-Duplizierung vermieden und sichergestellt, dass beide Projektionen stets dimensional konsistent bleiben.
for(uint i = 0; i < caProjections.Size(); i++)
  {
   if(!caProjections[i].Init(0, i, OpenCL, window, step, window_out, units_count,
                                                variables, optimization, iBatch))
      return false;
  }
Sobald die Dimensionen und grundlegenden Parameter überprüft wurden, konfigurieren wir für jede Schicht eine eigene Aktivierungsfunktion, sodass die resultierenden Einbettungen eine Kombination aus glatten und selektiven Merkmalen aufweisen. Dieser Ansatz vereinfacht die Code-Wartung und gewährleistet eine klare Rollentrennung innerhalb der SwiGLU -Schicht.
   caProjections[0].SetActivationFunction(GELU);
   caProjections[1].SetActivationFunction(None);
//---
   return true;
  }
Nun können wir die Initialisierungsmethode der SwiGLU-Schicht vervollständigen, indem wir das boolesche Ergebnis der Operationen an das aufrufende Programm zurückgeben.
Sobald alle Layer-Einstellungen vorgenommen sind, ist es an der Zeit , die Engine zu starten und die zu analysierenden Daten durch unsere beiden Faltungs-Projektionen zu leiten. Beginnen wir mit der Entwicklung des Algorithmus für den Vorwärtsdurchlauf, der in der Methode feedForward implementiert ist.
bool CNeuronSwiGLUOCL::feedForward(CNeuronBaseOCL *NeuronOCL)
  {
   for(uint i = 0; i < caProjections.Size(); i++)
      if(!caProjections[i].FeedForward(NeuronOCL))
         return false;
Wie üblich erhalten wir in den Parametern dieser Methode einen Zeiger auf das Eingabedatenobjekt. Genau das müssen wir an unsere beiden Datenprojektionsschichten übergeben. Wir führen diesen Vorgang in einer Schleife aus. Die Deklaration eines Arrays aus Objekten bietet uns diese Möglichkeit.
Gerade weil beide Schichten Tensoren mit denselben Dimensionen erzeugen, können wir sie direkt Element für Element multiplizieren, ohne uns Gedanken über nicht übereinstimmende Dimensionen machen zu müssen. Das Ergebnis ist ein einzelner Ausgabetensor, bei dem jeder Wert das Produkt der Meinungen der Swish- und GLU-Projektionen ist. Diese Technik, bei der ein Zeiger auf die Daten zyklisch durch das Array der Schichten weitergereicht wird, sorgt für einen kompakten Code und ermöglicht es, die Anzahl der „Stimmen“ innerhalb einer Schicht einfach durch Ändern der Länge des Arrays anzupassen.
   if(!ElementMult(caProjections[0].getOutput(), caProjections[1].getOutput(), Output))
      return false;
//---
   return true;
  }
Wir speichern die erhaltenen Ergebnisse im Ausgabepuffer der Schicht und beenden die Methode, indem wir ein boolesches Ergebnis an das aufrufende Programm zurückgeben.
Sobald der Vorwärtsdurchlauf durch die SwiGLU-Schicht abgeschlossen ist, ist es an der Zeit , nachzuvollziehen, wohin jeder Fehler geflossen ist – und den Rückwärtsdurchlauf einzurichten. Die Idee besteht darin, den Gradienten von der Ausgabeschicht zurück auf die Eingabedaten zu verteilen und ihn dabei sorgfältig durch unsere beiden konvolutionalen Projektoren zu leiten. Dieser Prozess wird in der Methode calcInputGradients implementiert.
bool CNeuronSwiGLUOCL::calcInputGradients(CNeuronBaseOCL *NeuronOCL)
  {
   if(!NeuronOCL)
      return false;
Im Methodenkörper erhalten wir einen Zeiger auf das Eingabedatenobjekt. Genau denselben, den wir beim Vorwärtsdurchlauf verwendet haben. Nur müssen wir dieses Mal den Fehlergradienten proportional zum Einfluss der Eingabedaten auf das Endergebnis an ihn zurückgeben. Natürlich ist ein gültiges Objekt erforderlich, damit die Daten korrekt übergeben werden können. Daher prüfen wir, bevor wir mit weiteren Operationen fortfahren, ob der erhaltene Zeiger gültig ist.
In den externen Schnittstellen unserer Schicht ist bereits die Differenz zwischen der aktuellen Prognose und dem Zielwert enthalten. Da die Vektordimensionen übereinstimmen, können wir als Nächstes problemlos den Teil des Fehlers isolieren, der auf den jeweiligen internen Filter zurückzuführen ist.
if(!ElementMultGrad(caProjections[0].getOutput(), caProjections[0].getGradient(),
                    caProjections[1].getOutput(), caProjections[1].getGradient(),
                    Gradient, caProjections[0].Activation(), caProjections[1].Activation()
                   ))
   return false;
Wir leiten diese beiden Datenströme an die entsprechenden Faltungsneuronen weiter. Da beide Schichten ihre eigenen Gradientenpuffer verwalten, erhält jede von ihnen einen eigenen Vektor mit denselben Dimensionen wie die Eingabedaten.
Danach leitet jedes interne Faltungsobjekt seinen Anteil am Fehler eigenständig weiter. Dieses Mal können wir jedoch keine Werte an das Eingabedatenobjekt innerhalb der Schleife übergeben. Das Problem ist, dass jeder nachfolgende Vorgang die Daten überschreibt und dabei die zuvor gespeicherten Daten löscht. Wir hingegen müssen die Werte aus allen Informationsströmen zusammenfassen. Daher leiten wir zunächst die Fehlergradienten aus der ersten Projektionsschicht weiter.
if(!NeuronOCL.calcHiddenGradients(caProjections[0].AsObject()))
   return false;
Anschließend speichern wir einen Zeiger auf den Fehlergradientenpuffer des Eingabedatenobjekts in einer lokalen Variablen. An seine Stelle tritt ein weiterer freier Datenpuffer derselben Größe.
   CBufferFloat *temp = NeuronOCL.getGradient();
   if(!NeuronOCL.SetGradient(NeuronOCL.getPrevOutput(), false) ||
      !NeuronOCL.calcHiddenGradients(caProjections[1].AsObject()) ||
      !SumAndNormilize(temp, NeuronOCL.getGradient(), temp, 1, false, 0, 0, 0, 1) ||
      !NeuronOCL.SetGradient(temp, false)
     )
      return false;
//---
   return true;
  }
Und nun können wir die Daten problemlos über den zweiten Informationsfluss weiterleiten. Anschließend addieren wir die Werte, die aus den beiden Projektionsschichten gewonnen wurden. Dieser Ansatz stellt sicher, dass jeder Fehler aus den verschiedenen Informationsströmen erhalten bleibt und korrekt aggregiert wird, wodurch wir im anschließenden Optimierungsschritt eine genaue und stabile Aktualisierung der Gewichte erhalten.
Abschließend setzen wir die Zeiger auf die Datenpuffer wieder in ihren ursprünglichen Zustand zurück und beenden die Methode, indem wir das boolesche Ergebnis der Operationen an das aufrufende Programm zurückgeben.
Wie üblich ist der Backward-Pass-Algorithmus in zwei logische Phasen unterteilt. Wir haben die erste Stufe – die Verteilung des Fehlergradienten – bereits ausführlich besprochen. Dies ist ein entscheidender Schritt, der es ermöglicht, den Fehler korrekt vom Ausgang der Schicht an die Eingabedaten weiterzugeben und dabei alle Merkmale des verzweigten Informationsflusses zu berücksichtigen.
Die zweite Phase – die Parameteroptimierung, die auf die Verringerung des Gesamtfehlers abzielt – würde den Rahmen dieses Artikels sprengen. Nicht, weil es unwichtig ist, sondern weil seine Implementierung streng in jedem der Faltungsobjekte gekapselt ist. Dies verschafft uns einen wichtigen Vorteil: Die Schnittstelle unserer Klasse wird nicht mit unnötigen Details überfrachtet, sondern bewahrt stattdessen die architektonische Reinheit und Modularität.
Alle erforderlichen Schritte zur Aktualisierung der Gewichte wurden bereits in den einzelnen Projektions-Schichten umgesetzt. Um den gesamten Optimierungszyklus abzuschließen, müssen wir daher lediglich die entsprechenden Methoden aller internen Objekte nacheinander aufrufen. Dank dieses Ansatzes bleibt die Hauptklasse kompakt, und die Logik zur Aktualisierung der Parameter ist zuverlässig und wurde isoliert getestet.
Der vollständige Quellcode für die Klasse CNeuronSwiGLUOCL und alle ihre Methoden, einschließlich der Funktionen für den Vorwärts- und Rückwärtsdurchlauf, ist im Anhang enthalten und kann eingesehen werden, um ein tieferes Verständnis aller internen Funktionsmechanismen zu erlangen.
Wir haben die Implementierung der SwiGLU-Einbettungskomponente abgeschlossen und können nun zuversichtlich zur nächsten Phase übergehen – der Implementierung des Kernteils des Time-MoE-Frameworks: des modifizierten Transformer-Blocks. Dieser Schritt läutet ein neues Kapitel in der Modellentwicklung ein, da im Transformer-Block ein umfassendes Verständnis der Sequenz entsteht: Das Modell lernt, langfristige Abhängigkeiten zu erkennen, den Kontext zu analysieren und die wahrscheinliche Dynamik zukünftiger Ereignisse vorherzusagen.
Die Weitergabe der transformierten Zeitreihe vom SwiGLU-Block an das Transformer-Modul ist nicht einfach nur eine Datenübertragung, sondern im Wesentlichen eine Wissensübertragung. Einbettungen, die komprimiert und reich an Informationen über lokale Muster sind, bilden nun die Grundlage für eine eingehende Analyse. Die Transformer-Architektur in Time-MoE unterscheidet sich jedoch erheblich von der klassischen Implementierung. Was als Erstes auffällt, ist das Fehlen des bekannten FeedForward-Blocks, der normalerweise in jeder Schicht unmittelbar auf den Aufmerksamkeitsmechanismus folgt.
Anstelle des Standardmoduls schlugen die Autoren vor, eine sogenannte spärlich aktivierte Mischung von Experten (Sparse Mixture of Experts, kurz MoE) zu verwenden. Diese architektonische Entscheidung verleiht dem Modell nicht nur adaptive Flexibilität, sondern sorgt auch dafür, dass sein Training aussagekräftiger und kontextabhängiger wird. Der Kerngedanke von MoE besteht darin, eine einzige universelle Schicht in eine Reihe hochspezialisierter Untermodule (Experten) aufzuteilen, von denen jedes darauf trainiert ist, eine bestimmte Art von Eingabedaten zu verarbeiten. Dieser Ansatz ermöglicht es, dass jedes Token in der Eingabesequenz nur jene Experten zurate zieht, die für die Verarbeitung seiner spezifischen Merkmale am besten geeignet sind, während die anderen im Standby-Modus verbleiben.
Der adaptive Mechanismus zur Expertenauswahl wird mithilfe eines Routers implementiert – eines separaten Submoduls, das anhand der anfänglichen Darstellung des Tokens bestimmt, welche Experten einbezogen werden. Der Originalartikel hebt einen wichtigen Punkt hervor: Er nutzt das Sparse Routing, bei dem jedes Token nicht an alle Experten gleichzeitig weitergeleitet wird, sondern nur an einige wenige (zum Beispiel zwei von zehn möglichen Experten). Dadurch werden die Rechenkosten erheblich gesenkt, sodass MoE auch in großem Maßstab eingesetzt werden kann, ohne die Ressourcen kritisch zu belasten.
Dieser Ansatz bietet dem Modell zahlreiche Vorteile. Zunächst lernt es, Aufgaben auf Experten zu verteilen: Einige passen sich kurzfristigen Kursschwankungen an, während andere auf Trendbewegungen oder Volatilität reagieren. Zweitens erhält das Modell die Fähigkeit, Wissen zu verallgemeinern: Da verschiedene Experten unterschiedliche Erfahrungen sammeln, kann es komplexere Interaktionen abbilden als eine herkömmliche einstufige Architektur.
Somit kann der Einsatz von Sparse Mixture of Experts im Time-MoE-Transformer als zentrale Innovation des Frameworks angesehen werden. Dies ist nicht nur ein architektonisches Experiment – es ist ein grundlegendes Umdenken hinsichtlich des Ansatzes zur Verarbeitung von Zeitreihen.
Das führt uns zu der Frage: Wie können wir diese architektonischen Ideen in die Praxis umsetzen? Schließlich betreiben wir nicht nur Theorie – wir bauen Schritt für Schritt ein funktionierendes System auf. Wenn wir auf die bisherigen Phasen unserer Forschung zurückblicken, sind wir im Zusammenhang mit der Entwicklung des Frameworks von DUET bereits auf das Konzept der Mischung von Experten (MoE) gestoßen. Damals haben wir einen sehr einfachen Prototyp entwickelt, der uns dabei half, besser zu verstehen, wie Routing und die Zusammenführung von Expertenentscheidungen funktionieren. Allerdings wäre es schwierig, diese Implementierung als wirklich spärlich zu bezeichnen. Vielmehr handelte es sich um eine Nachahmung des Auswahlmechanismus: Alle Experten berechneten ihre Ergebnisse gleichzeitig, und anschließend wurden diese Ergebnisse einfach mit den entsprechenden Masken multipliziert.
Aus mathematischer Sicht erschien das Endergebnis plausibel: Die Masken ermöglichten es, die Ausgänge nicht benötigter Experten auf Null zu setzen und so eine steuerbare Überlagerung zu bilden. Was jedoch die Recheneffizienz angeht, blieben wir, offen gesagt, hinter den Erwartungen zurück. Schließlich hat in diesem Fall jeder Experte dennoch sein gesamtes Arbeitspensum erledigt, unabhängig davon, ob sein Ergebnis verwendet werden würde oder nicht. Somit stieg die Rechenkomplexität linear mit der Anzahl der Experten, was einen der wesentlichen Vorteile der MoE-Architektur zunichte machte – nämlich ihre Fähigkeit, ohne exponentiellen Kostenanstieg skaliert zu werden.
Dieser Ansatz ist natürlich für kleine Modelle akzeptabel, bei denen die Anzahl der Experten und deren Dimensionen beherrschbar sind und die Leistungsanforderungen nicht allzu hoch sind. In der Praxis jedoch – beispielsweise bei der Arbeit mit tiefen und breiten Transformern, bei denen MoE in jeder zweiten Schicht zum Einsatz kommt und die Anzahl der Experten bis in den zweistelligen Bereich reichen kann – ist eine solche Lösung schlichtweg nicht mehr realisierbar. Die Rechenlast überschreitet schnell ein vertretbares Maß, insbesondere wenn wir das Modell in Echtzeit einsetzen wollen – beispielsweise für den algorithmischen Handel an den Finanzmärkten.
Zudem wird der Routing-Prozess selbst mit steigender Anzahl von Experten immer komplexer. Wenn wir sie weiterhin alle gleichzeitig nutzen, werden wir unweigerlich auf Probleme mit der GPU-Speicherauslastung und Leistungseinbußen bei OpenCL stoßen. Und genau hier kommt es besonders darauf an, sich an die Philosophie der echten Sparsity zu halten: Nur ein kleiner Teil des Netzwerks soll aktiv sein – aber genau der Teil, der hier und jetzt benötigt wird. Dieser Ansatz schont nicht nur Ressourcen, sondern macht das Modell selbst auch anpassungsfähiger und widerstandsfähiger gegenüber Rauschen.
In der aktuellen Implementierung haben wir uns entschieden, uns nicht auf eine rein formale Maskierung zu beschränken, sondern noch einen Schritt weiterzugehen – und einen wirklich spärlichen Algorithmus zu entwickeln, der der Philosophie des Time-MoE-Frameworks entspricht. Es besteht kein Zweifel daran, dass wir vor einer umfangreichen Aufgabe stehen, die sich über mehrere Schichten der Architektur erstreckt. Der Schlüssel liegt hier nicht einfach darin, ein weiteres Modul zu programmieren, sondern ein logisches System aufzubauen, in dem Routing, Aktivierung, Aggregation und Parameteroptimierung harmonisch zusammenwirken – genau so, wie es im ursprünglichen Algorithmus vorgesehen war. Deshalb schlage ich vor, dass wir an dieser Stelle eine kurze Pause einlegen.
Wir haben einen großen Schritt vorwärts gemacht: Wir haben unsere eigene SwiGLU-Einbettung implementiert, den Informationsfluss festgelegt und die architektonischen Grundlagen für die Integration der Mischung von Experten geschaffen. Dies ist bereits eine solide Grundlage, auf der wir die nächste Stufe des Modells aufbauen können. Um jedoch nicht den Fokus zu verlieren und den Stoff nicht zu überfrachten, wäre es sinnvoll, der Erstellung eines spärlich aktivierten MoE einen eigenen Artikel zu widmen. Auf diese Weise können wir nicht nur alle Details so gründlich wie möglich prüfen, sondern auch eine Fragmentierung des Codes und der Logik vermeiden.
An diesem natürlichen Haltepunkt wollen wir den aktuellen Teil abschließen und laden Sie ein, unsere Reise im nächsten Artikel fortzusetzen – mit einem bereits integrierten, spärlich aktivierten MoE.
Fazit
In diesem Artikel haben wir uns mit der Time-MoE-Architektur befasst – einem fortschrittlichen Framework, das von den Autoren des Artikels „3Time-MoE: Billion-Scale Time Series Foundation Models with Mixture of Experts“ vorgeschlagen wurde. Dieses Modell verbindet erfolgreich die Vorteile des Transformer-Ansatzes mit dem Konzept einer spärlichen Mischung von Experten (Sparse Mixture of Experts) und ermöglicht so eine verbesserte Prognosequalität durch adaptives Routing der Berechnung. Einer der Hauptvorteile von Time-MoE ist seine Fähigkeit, sowohl kurzfristige als auch langfristige Abhängigkeiten in Zeitreihen effektiv zu verarbeiten. Durch die Einführung von SwiGLU-Modulen wird das Modell flexibler.
Im praktischen Teil begannen wir damit, unsere eigene Vision der vorgeschlagenen Ansätze mithilfe von MQL5 umzusetzen, und setzten dabei theoretische Konzepte Schritt für Schritt in konkreten Code um. Im Rahmen der aktuellen Phase wurde ein SwiGLU-Einbettungsblock implementiert, der auf zwei konvolutionellen Projektionen mit elementweiser Multiplikation basiert. Wir haben uns auf den Vorwärtsdurchlauf und den Rückwärtsdurchlauf, die korrekte Gradientenverteilung sowie die Informationsverarbeitung innerhalb der konvolutionellen Schichten konzentriert.
Damit ist der Grundstein gelegt, und wir sind bereit, weiterzumachen. Im nächsten Teil werden wir uns auf die Erstellung eines wirklich spärlich aktivierten MoE-Blocks konzentrieren, was ein komplexeres Routing und eine komplexere Expertenverwaltungslogik erfordert. Diese Komponente wird eine zentrale Rolle in der Time-MoE-Architektur spielen, und ihre Umsetzung erfordert sowohl eine sorgfältige Planung als auch innovative technische Lösungen.
Links
- Time-MoE: Billion-Scale Time Series Foundation Models with Mixture of Experts
- Weitere Artikel dieser Reihe
In diesem Artikel verwendete Programme
| # | Name | Typ | Beschreibung |
|---|---|---|---|
| 1 | Research.mq5 | Expert Advisor | Beispielsammlung für Expert Advisors |
| 2 | ResearchRealORL.mq5 | Expert Advisor | Beispielsammlung von Expert Advisors unter Verwendung der Real-ORL -Methode |
| 3 | Study.mq5 | Expert Advisor | Expert Advisor für das Offline-Modelltraining |
| 4 | StudyOnline.mq5 | Expert Advisor | Expert Advisor für Online-Modelltraining |
| 5 | Test.mq5 | Expert Advisor | Expert Advisor zum Testen des Modells |
| 6 | Trajectory.mqh | Klassenbibliothek | Struktur zur Beschreibung des Systemzustands und der Modellarchitektur |
| 7 | NeuroNet.mqh | Klassenbibliothek | Eine Klassenbibliothek zum Erstellen neuronaler Netze |
| 8 | NeuroNet.cl | Bibliothek | Codebibliothek für ein OpenCL-Programm |
Übersetzt aus dem Russischen von MetaQuotes Ltd.
Originalartikel: https://www.mql5.com/ru/articles/18499
Warnung: Alle Rechte sind von MetaQuotes Ltd. vorbehalten. Kopieren oder Vervielfältigen untersagt.
Dieser Artikel wurde von einem Nutzer der Website verfasst und gibt dessen persönliche Meinung wieder. MetaQuotes Ltd übernimmt keine Verantwortung für die Richtigkeit der dargestellten Informationen oder für Folgen, die sich aus der Anwendung der beschriebenen Lösungen, Strategien oder Empfehlungen ergeben.
 Die Übertragung der Trading-Signale in einem universalen Expert Advisor.
 Von der Grundstufe bis zur Mittelstufe: Direkter Dateizugriff (I)
 Eine alternative Log-datei mit der Verwendung der HTML und CSS
 Neuronale Netze im Trading: Effektive Merkmalsextraktion zur präzisen Klassifizierung (letzter Teil)

- Freie Handelsapplikationen
- Über 8.000 Signale zum Kopieren
- Wirtschaftsnachrichten für die Lage an den Finanzmärkte
Sie stimmen der Website-Richtlinie und den Nutzungsbedingungen zu.