

Neuronale Netze im Trading: Zerlegung strukturierter Komponenten (Encoder)
 19
 0

Einleitung
Wir setzen unsere Arbeit an der Umsetzung unserer eigenen Interpretation der von den Autoren des SCNN-Frameworks vorgestellten Ansätze fort. Zur Erinnerung: SCNN (Structured Component Neural Network) verfolgt einen konzeptionell anderen Ansatz: Anstatt zu versuchen, die gesamte Zeitreihe mit einem einzigen universellen Mechanismus zu modellieren, wird sie in fünf zentrale Komponenten unterteilt – die langfristige Komponente, die saisonale Komponente, die kurzfristige Komponente, die gekoppelte Komponente und die Residualkomponente. Jede dieser Komponenten wird separat modelliert und extrapoliert, was uns nicht nur Flexibilität verschafft, sondern es uns auch ermöglicht, in jeder Phase ein interpretierbares Ergebnis zu erhalten.
Der Hauptvorteil dieser Architektur ist die Transparenz. Im Gegensatz zu herkömmlichen „Blackbox-Modellen“ ermöglicht SCNN Analysten und Tradern, genau zu erkennen, welcher Teil des Modells für einen bestimmten Abschnitt der Prognose verantwortlich ist und wie zuversichtlich das Modell unter den aktuellen Bedingungen ist. Dies ist besonders wichtig bei der Arbeit mit Finanzdaten, bei der das Vertrauen in das Modell durch Erklärbarkeit und Kontrollierbarkeit untermauert werden muss. Darüber hinaus ermöglicht ein maßgeschneiderter Ansatz zur Extrapolation der einzelnen Komponenten den Einsatz sowohl statistischer Heuristiken (für langfristige und saisonale Muster) als auch trainierbarer neuronaler Netzmodule (zur Modellierung kurzfristiger Anomalien oder Wechselwirkungen zwischen Assets).
Das Framework berücksichtigt zudem komplexe zeitliche Abhängigkeiten, darunter Autokorrelationen, die in vereinfachten Modellen häufig außer Acht gelassen werden. Dies ist insbesondere für Aufgaben im Zusammenhang mit dem Intraday-Handel oder Prognosen beim Übergang zwischen Handelssitzungen von Bedeutung. SCNN ermöglicht eine dynamische Anpassung an Veränderungen der statistischen Eigenschaften in Echtzeit und hilft zudem dabei, anomale Punkte zu identifizieren, an denen die Prognose möglicherweise unzuverlässig ist.
Nachfolgend ist die vom Autor erstellte Visualisierung des SCNN-Frameworks dargestellt.
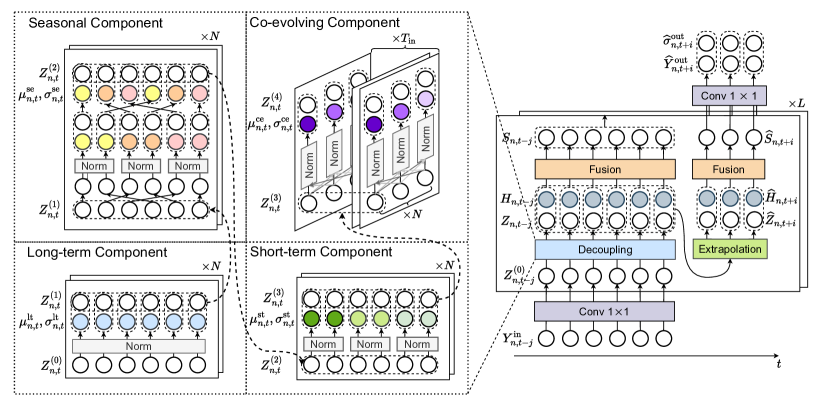
Im praktischen Teil unserer vorherigen Arbeit haben wir das Objekt CNeuronPeriodNorm entwickelt, das dazu dient, periodische Komponenten aus einer Zeitreihe zu extrahieren. Diese Komponente war der erste Schritt zur Implementierung des SCNN-Frameworks in der MQL5-Umgebung und wird zur Extraktion der langfristigen und kurzfristigen Komponenten verwendet. Der Einsatz von OpenCL-Kernels ermöglicht eine effiziente parallele Datenverarbeitung und unterstützt den Backpropagation-Mechanismus, wodurch sich dieses Modul für den Einsatz in trainierbaren neuronalen Netzwerkarchitekturen eignet.
Später werden wir zeigen, dass sich CNeuronPeriodNorm durch einige einfache Datentransformationen auch so anpassen lässt, dass die saisonale Komponente extrahiert wird, wodurch es noch vielseitiger wird. Heute werden wir den nächsten Schritt gehen: Wir werden mit der Entwicklung eines Objekts beginnen, das für die Extraktion der gekoppelten Komponente zuständig ist, die miteinander verknüpfte Änderungen mehrerer Variablen in einer Zeitreihe widerspiegelt. Dieses Modul wird eine Schlüsselrolle bei der Modellierung synchronisierter Oszillationen und anomaler gemeinsamer Bewegungen spielen, was insbesondere im Zusammenhang mit der multivariaten Marktanalyse von Bedeutung ist.
Extraktion der gekoppelten Komponente
Unsere praktischen Erfahrungen zeigen, dass eine zeitliche Analyse allein für die korrekte Umsetzung des Modells nicht ausreicht. Es ist außerdem wichtig, räumliche Abhängigkeiten zu berücksichtigen – also die Beziehungen zwischen verschiedenen Variablen zu einem bestimmten Zeitpunkt. Genau das leistet der Mechanismus zur Extraktion der gekoppelten Komponente: Er hilft dabei, gleichgerichtete oder entgegengesetzte Bewegungen zwischen den Signalen einzelner Komponentensequenzen in der analysierten multimodalen Zeitreihe zu erkennen. Eine solche Koevolution kann entweder stabil sein oder sich dynamisch verändern und erfordert daher einen adaptiven Ansatz zur Normalisierung.
Im SCNN-Framework wird dieses Problem durch die Implementierung einer räumlich gewichteten Normalisierung unter Verwendung eines Attention-Mechanismus gelöst. Wir wenden uns nun dem nächsten Umsetzungsschritt zu, in dem wir unsere eigene Interpretation des vorgeschlagenen Algorithmus vorstellen werden, wobei wir uns an den praktischen Anforderungen der Finanzmodellierung orientieren. Wie üblich lagern wir den Großteil der Berechnungen – einschließlich der gewichteten Mittelwertbildung und der adaptiven Standardisierung – an den OpenCL-Kontext aus. Dies beschleunigt nicht nur die Verarbeitung, sondern gewährleistet auch Flexibilität bei der Konfiguration der Architektur.
Zu diesem Zweck werden wir einen neuen Kernel namens AdaptSpatialNorm erstellen. Der Kernel-Algorithmus implementiert eine adaptive Normalisierung der Eingabedaten, wobei die Attention-Gewichte zwischen den Variablen berücksichtigt werden und so eine genauere und sensiblere Verarbeitung räumlicher Beziehungen gewährleistet wird. Die Idee besteht darin, für jeden Zeitpunkt den Mittelwert und die Standardabweichung zu berechnen, gewichtet mit der Attention-Maske. Dadurch ist es möglich, nicht einfach nur einen Durchschnitt über alle Variablen zu bilden, sondern deren relative Bedeutung zu berücksichtigen – also den Einfluss jeder einzelnen Variablen auf einen bestimmten Punkt innerhalb eines räumlich-zeitlichen Kontexts.
__kernel void AdaptSpatialNorm(__global const float* inputs,
                               __global const float* attention,
                               __global float2* mean_stdevs,
                               __global float* outputs
                              )
  {
   const size_t i = get_global_id(0);
   const size_t a = get_local_id(1);
   const size_t v = get_global_id(2);
   const size_t total_inputs = get_global_size(0);
   const size_t total_local = get_local_size(1);
   const size_t variables = get_global_size(2);
Im Kernel werden die Berechnungen in drei Dimensionen organisiert: Zeit, Variablen und lokale Work-Items. Jedes Work-Item ist für die Verarbeitung eines bestimmten Werts zuständig – einer einzelnen Variablen zu einem bestimmten Zeitpunkt. Zunächst wird ein Index-Offset ermittelt, der es jedem Work-Item ermöglicht, korrekt auf die benötigten Speicherbereiche zuzugreifen.
   __local float Temp[LOCAL_ARRAY_SIZE];
   const int shift_v = v * total_inputs;
   const int shift_out = shift_v + i;
Dann beginnt der Hauptteil der Arbeit, in dem für alle Variablen die Werte aus dem Eingabe-Array und die entsprechenden Attention-Gewichte abgerufen werden. Jeder Wert wird mit seinem Gewicht multipliziert; anschließend erfolgt eine lokale Summierung – zunächst zur Berechnung des Mittelwerts, dann zur Ermittlung der Varianz.
   float mean = 0, stdev = 0;
   for(uint l = 0; l < variables; l += total_local)
     {
      const int shift_at = v * variables + (a + l);
      float val = IsNaNOrInf(inputs[(a + l) * total_inputs + i], 0);
      float att = IsNaNOrInf(attention[shift_at], 0);
      mean += LocalSum(val * att, 1, Temp);
      BarrierLoc;
      stdev += LocalSum(val * val * att, 1, Temp);
      BarrierLoc;
     }
Um eine korrekte parallele Berechnung über alle Work-Items hinweg zu gewährleisten, wird eine Synchronisationsbarriere verwendet, die dazu beiträgt, Zugriffskonflikte bei der Arbeit mit gemeinsam genutztem Speicher zu vermeiden.
An dieser Stelle lohnt es sich, den technischen Aspekten der Organisation von Berechnungen besondere Aufmerksamkeit zu widmen. Um Summierungsoperationen mit Werten aus verschiedenen Work-Items korrekt durchzuführen, werden innerhalb von OpenCL sogenannte Work-Groups angelegt. Work-Items innerhalb dieser Gruppen können Daten über den lokalen Speicher austauschen, der im Gegensatz zum globalen Speicher deutlich schneller ist und die effiziente Implementierung kollektiver Operationen wie Reduktion oder Summierung ermöglicht.
Diese Architektur unterliegt jedoch einer inhärenten Einschränkung: Die Größe der Work-Group darf einen bestimmten, durch die Grafikkarte oder ein anderes Rechengerät vorgegebenen Hardware-Grenzwert nicht überschreiten. In der Praxis bedeutet dies, dass die Anzahl der Work-Items, die Variablen in einer einzelnen Work-Group gleichzeitig verarbeiten, begrenzt ist und nicht immer der Dimensionalität des zu verarbeitenden Eingabe-Arrays entspricht.
Um diese Einschränkung zu umgehen, wurde im Kernel-Rumpf eine spezielle Schleife implementiert, die es ermöglicht, alle Variablen schrittweise zu durchlaufen, selbst wenn ihre Anzahl die Größe der Work-Group deutlich übersteigt. Der gesamte Merkmalsraum wird in Blöcke unterteilt, stückweise verarbeitet, und die Werte werden nacheinander aggregiert. Dieser Ansatz gewährleistet eine hohe Recheneffizienz und stellt sicher, dass alle mathematischen Operationen korrekt ausgeführt werden, unabhängig von der Anzahl der im Modell enthaltenen Variablen.
Diese Technik sorgt dafür, dass die Implementierung bei der Skalierung robust bleibt und vielseitig genug ist, um auf einer Vielzahl von Geräten mit unterschiedlichen Spezifikationen ausgeführt zu werden, während sie zugleich das Modell selbst flexibler und portabler macht.
Sobald alle Werte verarbeitet wurden, übernimmt in jeder lokalen Work-Group jeweils nur ein Work-Item die Aufgabe der abschließenden Normalisierung. Dieses berechnet die Varianz, indem es das Quadrat des Mittelwerts von der Summe der Quadrate der Werte abzieht; anschließend zieht es die Quadratwurzel, um die Standardabweichung zu erhalten. Um eine Division durch Null zu verhindern, gibt es eine Sicherheitsvorkehrung: Ist die Varianz zu klein, wird sie durch 1 ersetzt.
   if(a == 0)
     {
      stdev -= mean * mean;
      stdev = IsNaNOrInf(sqrt(stdev), 1);
      if(stdev <= 0)
         stdev = 1;
      mean_stdevs[shift_out] = (float2)(mean, stdev);
      outputs[shift_out] = IsNaNOrInf((inputs[shift_out] - mean) / stdev, 0);
     }
  }
Anschließend wird der normalisierte Eingabewert berechnet und in das Ausgabe-Array geschrieben. Gleichzeitig werden der berechnete Mittelwert und die berechnete Standardabweichung gespeichert – sie werden später noch nützlich sein.
Die implementierte Logik kombiniert die Aggregation von Informationen über die räumliche Verteilung der Daten mit einer auf dieser Verteilung basierenden Normalisierung. Dadurch kann das Modell sensibel auf verborgene Zusammenhänge zwischen Variablen reagieren und somit die Dynamik komplexer Zeitreihenprozesse genauer erfassen – was insbesondere bei Finanzprognosen von großer Bedeutung ist.
Um das Modell vollständig zu trainieren, muss nicht nur ein Vorwärtsdurchlauf durchgeführt werden, bei dem normalisierte Werte berechnet werden, sondern auch ein korrekter Rückwärtsdurchlauf, der sicherstellt, dass die Fehlergradienten zurück zu den Eingabedaten und Parametern weitergeleitet werden. Im Zusammenhang mit unserem AdaptSpatialNorm-Kernel für die räumlich gewichtete Normalisierung besteht der nächste logische Schritt darin, den Backpropagation-Kernel AdaptSpatialNormGrad zu implementieren, der für die Verteilung der Fehlergradienten auf die Eingabedaten und die Attention-Gewichte zuständig ist.
__kernel void AdaptSpatialNormGrad(__global const float* inputs,
                                   __global float* inputs_gr,
                                   __global const float* attention,
                                   __global float* attention_gr,
                                   __global const float2* mean_stdevs,
                                   __global const float2* mean_stdevs_gr,
                                   __global const float* outputs_gr,
                                   const uint total_inputs
                                  )
  {
   const size_t i = get_global_id(0);              // main
   const size_t loc = get_local_id(1);             // local to sum
   const size_t v = get_global_id(2);              // variable
   const size_t total_main = get_global_size(0);   // total
   const size_t total_loc = get_local_size(1);     // local dimension
   const size_t variables = get_global_size(2);    // total variables
//---
   __local float Temp[LOCAL_ARRAY_SIZE];
Der Algorithmus basiert auf der Verteilung der Rechenlast auf verschiedene Work-Items, wobei jedes Work-Item eine bestimmte Kombination von Indizes verarbeitet, die einem Zeitabschnitt und einer Variablen entspricht. Der lokale Speicher dient zur Speicherung von Zwischenwerten, was die Summierung und Aggregation von Daten innerhalb von Work-Groups beschleunigt.
Zunächst werden die Gradienten in Bezug auf die Eingabedaten berechnet. Für jedes Element des Eingabe-Arrays werden die entsprechenden Attention-Parameter und Ausgabegradienten abgerufen. Anschließend wird der Gradient berechnet, wobei die partiellen Ableitungen in Bezug auf die Normalisierungsparameter (Mittelwert und Standardabweichung) berücksichtigt werden, die ebenfalls bei der Backpropagation eine Rolle spielen. Alle Teilsummen werden akkumuliert, und das Ergebnis wird anschließend im Eingabegradienten-Array gespeichert.
//--- Input gradient
     {
      if(i < total_inputs)
        {
         float grad = 0;
         int shift_in = v * total_inputs + i;
         float x = IsNaNOrInf(inputs[shift_in], 0);
         for(int l = 0; l < variables; l += total_loc)
           {
            if((l + loc) >= variables)
               break;
            int shift_out = i + (l + loc) * total_inputs;
            float att = IsNaNOrInf(attention[(l + loc) * variables + v], 0);
            float out_gr = IsNaNOrInf(outputs_gr[shift_out], 0);
            float2 ms = mean_stdevs[shift_out];
            float2 ms_gr = mean_stdevs_gr[shift_out];
            float dy = (1 - att) * (1 / ms.y - (x - ms.x) * att * x / pow(ms.y, 3.0f));
            float dmean = IsNaNOrInf(ms_gr.x * att, 0);
            float dstd = IsNaNOrInf(ms_gr.y * x * (att - att * att) / ms.y, 0);
            grad += IsNaNOrInf(dy * out_gr + dmean + dstd, 0);
           }
         grad = LocalSum(grad, 1, Temp);
         if(loc == 0)
            inputs_gr[shift_in] = grad;
        }
      BarrierLoc;
     }
Mit Blick auf das Folgende ist ein wichtiges Detail zu beachten: Die von uns gespeicherten Normalisierungsparameter (Mittelwert und Standardabweichung) sind keine Nebenprodukte der Berechnungen. Im Gegenteil, sie sind aktiv an den nachfolgenden Operationen des SCNN-Frameworks beteiligt und bilden eine Art Hilfszweig der Datenverarbeitung. Daher muss der Fehlergradient, der für diese Parameter in späteren Phasen des Vorwärtsdurchlaufs akkumuliert wurde, ebenfalls bis auf die Ebene der Eingabedaten zurückpropagiert werden.
Das bedeutet, dass wir uns während des Rückwärtsdurchlaufs nicht auf den Hauptinformationsfluss beschränken – wir berücksichtigen auch den Beitrag, der mit den Ableitungen in Bezug auf die gespeicherten Normalisierungsstatistiken verbunden ist, und addieren ihn zum endgültigen Eingabegradienten. Dieser Ansatz gewährleistet die Integrität des Berechnungsgraphen und ermöglicht es dem Modell, alle Parameter, die das Ergebnis beeinflussen, effektiv anzupassen – einschließlich derer, die über Normalisierungsmechanismen indirekt mit der Eingabe zusammenhängen.
Anschließend werden die Gradienten in Bezug auf die Attention-Parameter berechnet. Für jedes Element der Attention-Gewichte durchläuft der Algorithmus alle entsprechenden Zeitpunkte und nutzt dabei die Werte aus den Eingabedaten sowie die bereits berechneten Ausgabegradienten. Die Berechnungen berücksichtigen zudem den Einfluss von Attention auf die Normalisierung über den Mittelwert und die Standardabweichung. Die Endwerte werden mithilfe des lokalen Speichers akkumuliert und im entsprechenden Attention-Gradienten-Array gespeichert.
//--- Attention gradient
     {
      if(i < variables)
        {
         float grad = 0;
         int shift_att = v * variables + i;
         float att = IsNaNOrInf(attention[shift_att], 0);
         for(int l = 0; l < total_inputs; l += total_loc)
           {
            if((l + loc) >= total_inputs)
               break;
            int shift_out = (l + loc) + v * total_inputs;
            int shift_in = (l + loc) + i * total_inputs;
            float x = IsNaNOrInf(inputs[shift_in], 0);
            float out_gr = IsNaNOrInf(outputs_gr[shift_out], 0);
            float2 ms = mean_stdevs[shift_out];
            float2 ms_gr = mean_stdevs_gr[shift_out];
            float dy = -x / ms.y - (x - ms.x) * x * x * (1 - 2 * att) / (2 * pow(ms.y, 3.0f));
            float dmean = IsNaNOrInf(ms_gr.x * x, 0);
            float dstd = IsNaNOrInf(ms_gr.y * x * x * (1 - 2 * att) / (2 * ms.y), 0);
            grad += IsNaNOrInf(dy * out_gr + dmean + dstd, 0);
           }
         grad = LocalSum(grad, 1, Temp);
         if(loc == 0)
            attention_gr[shift_att] = grad;
        }
     }
  }
Es ist wichtig zu beachten, dass die Implementierung die Möglichkeit ungültiger numerischer Werte wie NaN oder Unendlichkeit berücksichtigt und verhindert, dass diese sich weiter fortpflanzen, was die Robustheit des Algorithmus verbessert.
Dieser Gesamtansatz mit schleifenbasierter Datenverarbeitung und der Nutzung des lokalen Speichers gewährleistet Skalierbarkeit und Effizienz und ermöglicht die Verarbeitung großer Mengen von Variablen und Zeitschritten, selbst wenn deren Umfang die Dimensionen der Work-Group übersteigt.
Somit ermöglicht der AdaptSpatialNormGrad-Kernel eine genaue und effiziente Berechnung von Gradienten für wichtige Normalisierungsparameter unter Berücksichtigung räumlicher Attention-Gewichte, wodurch dieser Mechanismus in komplexe Modelle integriert werden kann, die mittels Backpropagation trainiert werden.
Um den oben beschriebenen Algorithmus zur räumlich gewichteten Normalisierung in die Gesamtarchitektur zu integrieren, wird im Hauptprogramm ein spezialisiertes CNeuronAdaptSpatialNorm-Objekt erstellt. Diese Klasse erbt die Basis-Schnittstellen von CNeuronBaseOCL, wodurch sie sich nahtlos in die Hierarchie der neuronalen Komponenten einbinden lässt. Der Hauptzweck des Objekts besteht darin, die Berechnungen sowohl für den Vorwärts- als auch für den Rückwärtsdurchlauf ordnungsgemäß zu organisieren sowie alle mit dem Attention-Mechanismus verbundenen Hilfskomponenten korrekt zu verarbeiten.
Die Struktur der neuen Klasse ist unten dargestellt.
class CNeuronAdaptSpatialNorm :  public CNeuronBaseOCL
  {
protected:
   uint                    iVariables;
   uint                    iCount;
   //---
   CParams                 cEn;
   CNeuronTransposeOCL     cEnT;
   CNeuronBaseOCL          cEnEnT;
   CNeuronSoftMaxOCL       cAttan;
   CNeuronBaseOCL          cMeanSTDevs;
   //---
   virtual bool      AdaptSpatialNorm(CNeuronBaseOCL *NeuronOCL);
   virtual bool      AdaptSpatialNormGrad(CNeuronBaseOCL *NeuronOCL);
   //---
   virtual bool      feedForward(CNeuronBaseOCL *NeuronOCL) override;
   virtual bool      updateInputWeights(CNeuronBaseOCL *NeuronOCL) override;
   virtual bool      calcInputGradients(CNeuronBaseOCL *NeuronOCL) override;

public:
                     CNeuronAdaptSpatialNorm(void) : iCount(0), iVariables(1) {};
                    ~CNeuronAdaptSpatialNorm(void) {};
   //---
   virtual bool      Init(uint numOutputs, uint myIndex, COpenCLMy *open_cl,
                          uint units_count, uint variables,
                          ENUM_OPTIMIZATION optimization_type, uint batch);
   //---
   virtual bool      Save(const int file_handle) override;
   virtual bool      Load(const int file_handle) override;
   //---
   virtual int       Type(void) override const  {  return defNeuronAdaptSpatialNorm; }
   virtual void      SetOpenCL(COpenCLMy *obj) override;
   //---
   CNeuronBaseOCL*   GetMeanSTDevs(void) { return cMeanSTDevs.AsObject(); }
   virtual uint      GetVariables(void) const { return iVariables; }
   virtual uint      GetUnits(void) const { return iCount; }
   //---
   virtual bool      WeightsUpdate(CNeuronBaseOCL *source, float tau);
  };
Innerhalb der Klasse sehen wir eine Reihe geschützter Mitglieder, von denen jedes eine wichtige Rolle für die Funktionsweise der Komponente spielt. Die Variablen iVariables und iCount geben die Dimensionen des Eingabedaten-Tensors an und legen die räumlichen Grenzen der Verarbeitung fest. Die internen Objekte cEn, cEnT, cEnEnT und cAttan bilden und trainieren nacheinander die Attention-Matrix. Die Komponente cMeanSTDevs vervollständigt diese Kette, indem sie die Normalisierungsparameter speichert und aktualisiert, die zur Skalierung der Eingabedaten auf Grundlage der berechneten Attention-Gewichte verwendet werden.
Alle internen Objekte werden statisch deklariert, was die Speicherverwaltung und die Initialisierung erheblich vereinfacht. Dadurch wird die Lösung zuverlässiger und ihr Verhalten berechenbarer: Es ist nicht erforderlich, Ressourcen manuell zu allokieren oder freizugeben. Der Konstruktor und der Destruktor der Klasse bleiben leer, da die Objekte bereits vorhanden sind, wenn eine Instanz der Klasse erstellt wird, und automatisch zerstört werden, wenn der Lebenszyklus der Instanz endet.
Alle internen Komponenten der Klasse werden zentral in der Init-Methode initialisiert. Diese Methode nimmt zentrale Parameter als Eingabe entgegen, anhand derer sich die Architektur des zu erstellenden Objekts eindeutig bestimmen lässt, einschließlich der Dimension der Eingabedaten. Der gesamte Prozess verläuft schrittweise und logisch und steht in einem klaren Zusammenhang mit der internen Struktur des Modells.
bool CNeuronAdaptSpatialNorm::Init(uint numOutputs, uint myIndex, COpenCLMy *open_cl,
                                   uint units_count, uint variables,
                                   ENUM_OPTIMIZATION optimization_type, uint batch)
  {
   if(!CNeuronBaseOCL::Init(numOutputs, myIndex, open_cl, units_count * variables, optimization_type, batch))
      return false;
In der ersten Phase wird die gleichnamige Methode der übergeordneten Klasse CNeuronBaseOCL aufgerufen, die die Ersteinrichtung des neuronalen Knotens durchführt. Die Größe des Ergebnispuffers ergibt sich aus dem Produkt der Anzahl der Variablen und der Länge der Sequenz. Wenn die Initialisierung auf Basisebene erfolgreich verläuft, werden die Parameter des Eingabedaten-Tensors festgelegt und in den lokalen Variablen iVariables und iCount gespeichert.
   iVariables = variables;
   iCount = units_count;
//---
   uint dimension = (iVariables + 1) / 2;
   uint index = 0;
   if(!cEn.Init(0, index, OpenCL, iVariables * dimension, optimization, iBatch))
      return false;
   cEn.SetActivationFunction(None);
Anschließend werden die internen Komponenten, die für die Bildung der Attention-Matrix zuständig sind, nacheinander konfiguriert. Zunächst wird das Objekt cEn initialisiert. Es handelt sich um einen Tensor aus trainierbaren Parametern. Seine Dimensionalität ist definiert als das Produkt aus der Anzahl der Variablen und der Hälfte dieser Anzahl. Diese Dimensionsreduktion ermöglicht es, die aussagekräftigsten Merkmale für die weitere Verarbeitung zu identifizieren. Die Aktivierungsfunktion wird hier explizit deaktiviert, da in dieser Phase eine rein lineare Transformation erforderlich ist, ohne das Ausgabesignal zu verzerren.
Anschließend wird das Transpositionsobjekt cEnT initialisiert, wodurch eine transponierte Kopie des Tensors mit trainierbaren Parametern erstellt werden kann.
   index++;
   if(!cEnT.Init(0, index, OpenCL, iVariables, dimension, optimization, iBatch))
      return false;
   cEnT.SetActivationFunction(None);
   index++;
   if(!cEnEnT.Init(0, index, OpenCL, iVariables * iVariables, optimization, iBatch))
      return false;
   cEnEnT.SetActivationFunction(None);
Das Objekt cEnEnT spielt eine zentrale Rolle beim Aufbau des Attention-Mechanismus innerhalb des SCNN-Frameworks. Es dient dazu, die Ergebnisse der Matrixmultiplikation des Tensors der trainierbaren Parameter mit seiner transponierten Kopie zu speichern. Diese Operation bildet eine symmetrische Matrix, die die Wechselbeziehungen und die Stärke der Korrelation zwischen den Variablen innerhalb eines einzelnen Zeitschritts widerspiegelt. Die daraus resultierende Struktur ermöglicht es, explizit zu ermitteln, welche der analysierten Merkmale den größten Einfluss aufeinander haben.
Das cAttan-Objekt vervollständigt den Aufbau des Attention-Mechanismus. Es nimmt eine Korrelationsmatrix als Eingabe entgegen und wendet darauf eine SoftMax-Normalisierung an, wodurch die Attention auf die Variablen verteilt wird. Die Anzahl der Attention-Heads entspricht der Anzahl der Zeilen in der Korrelationsmatrix, was eine flexible Anpassung an die Datenstruktur ermöglicht.
   index++;
   if(!cAttan.Init(0, index, OpenCL, iVariables * iVariables, optimization, iBatch))
      return false;
   cAttan.SetHeads(iVariables);
Schließlich wird das cMeanSTDevs-Objekt so konfiguriert, dass es Wertepaare speichert: den Mittelwert und die Standardabweichung, die mithilfe der räumlich gewichteten Normalisierung berechnet wurden. Die Dimensionalität dieses Objekts entspricht dem Doppelten der Anzahl der Ausgangsneuronen, da für jedes Element der Ergebnisse zwei Parameter gespeichert werden müssen.
   index++;
   if(!cMeanSTDevs.Init(0, index, OpenCL, 2 * Neurons(), optimization, iBatch))
      return false;
   cMeanSTDevs.SetActivationFunction(None);
//---
   return true;
  }
Somit erstellt und konfiguriert die Init-Methode alle Komponenten, die für das ordnungsgemäße Funktionieren des Mechanismus der räumlich gewichteten Normalisierung innerhalb von SCNN erforderlich sind. Die Codestruktur spiegelt die Stringenz und Modularität der Architektur wider, in der jeder Block einen klar definierten Zweck hat und in einer festgelegten Reihenfolge mit den anderen interagiert.
Nachdem alle internen Komponenten erfolgreich initialisiert wurden, fahren wir mit der Erstellung des Vorwärtsdurchlauf-Mechanismus fort, der in der feedForward-Methode implementiert ist. Damit beginnt eine entscheidende Phase im Ablauf der Schicht, in der die Attention-Matrix gebildet und eine räumlich gewichtete Normalisierung der Eingabedaten durchgeführt wird.
bool CNeuronAdaptSpatialNorm::feedForward(CNeuronBaseOCL *NeuronOCL)
  {
   if(bTrain)
     {
      if(!cEn.FeedForward())
         return false;
      if(!cEnT.FeedForward(cEn.AsObject()))
         return false;
      if(!MatMul(cEn.getOutput(), cEnT.getOutput(), cEnEnT.getOutput(),
                 iVariables, cEnT.GetWindow(), iVariables, 1, false))
         return false;
      if(!cAttan.FeedForward(cEnEnT.AsObject()))
         return false;
     }
//---
   return AdaptSpatialNorm(NeuronOCL);
  }
An dieser Stelle sollte ein wichtiger architektonischer Aspekt hervorgehoben werden: Die Attention-Parameter werden ausschließlich während des Trainings gebildet. Dies geschieht bewusst, da die Attention-Matrix selbst eine statische Komponente des Modells ist – sie passt sich während des Betriebs nicht an bestimmte Eingabedaten an. Mit anderen Worten: Wir trainieren universelle Gewichte, die stabile Beziehungen zwischen den Variablen innerhalb der Zeitreihe widerspiegeln. Dieser Ansatz gewährleistet ein stabiles Modellverhalten bei neuen Daten, und die Attention-Berechnung kann während der Inferenz übersprungen werden, was den Rechenvorgang erheblich beschleunigt, ohne die Normalisierungsqualität zu beeinträchtigen.
In der Sequenz des Vorwärtsdurchlaufs wird als Nächstes die AdaptSpatialNorm-Methode aufgerufen, die als Wrapper für den gleichnamigen Kernel dient. Dies ist der Schritt, bei dem die Steuerung an den OpenCL-Kontext übergeben wird, in dem die eigentlichen Berechnungen stattfinden: die Normalisierung der Eingabedaten auf der Grundlage der Attention-Gewichte.
Es lohnt sich, ein paar Worte darüber zu verlieren, wie die Wrapper-Methode für den OpenCL-Kernel aufgebaut ist. Obwohl die allgemeine Logik des Algorithmus unverändert blieb, wurden strukturelle Verbesserungen an der Implementierung vorgenommen, um die Lesbarkeit und Zuverlässigkeit des Codes zu erhöhen. Dies betrifft in erster Linie die Art und Weise, wie Aufrufe von OpenCL-Funktionen geschrieben werden.
Ersetzungsmakros wurden eingeführt, um das Setzen von Kernel-Argumenten und das Starten des Kernels zu vereinfachen und zu standardisieren. Das Makro setBuffer kapselt beispielsweise einen Aufruf von OpenCL.SetArgumentBuffer mit automatischer Fehlerbehandlung und Debug-Ausgabe, einschließlich des Kernel-Namens, des Fehlercodes und der Zeile, in der der Fehler aufgetreten ist. Das Makro setArgument funktioniert beim Festlegen skalarer Werte auf ähnliche Weise.
#define setBuffer(kernel, id, buffer)  if(!OpenCL.SetArgumentBuffer(kernel, id, buffer)) { \
                                          printf("Error of set parameter kernel %s: %d; line %d",
                                                 OpenCL.GetKernelName(kernel), GetLastError(), __LINE__); \
                                          return false; }
#define setArgument(kernel, id, value) if(!OpenCL.SetArgument(kernel, id, value)) { \
                                          printf("Error of set parameter kernel %s: %d; line %d",
                                                 OpenCL.GetKernelName(kernel), GetLastError(), __LINE__); \
                                          return false; }
Der Kernel wird mithilfe der Makros kernelExecute und kernelExecuteLoc gestartet, die den gesamten technischen Boilerplate-Code zur Initialisierung des Work-Item-Grids verbergen und im Fehlerfall automatisch eine detaillierte Textbeschreibung des Fehlers anzeigen, die dem Namen der aufgerufenen Funktion zugeordnet ist.
#define kernelExecute(kernel,offset,global)  if(!OpenCL.Execute(kernel, global.Size(), offset, global)) { \
                                                string error; \
                                                CLGetInfoString(OpenCL.GetContext(), CL_ERROR_DESCRIPTION, error); \
                                                printf("Error of execution kernel %s %s: %s", __FUNCSIG__,
                                                        OpenCL.GetKernelName(kernel), error); \
                                                return false; }
#define kernelExecuteLoc(kernel,offset,global,local)  if(!OpenCL.Execute(kernel, global.Size(), offset,
                                                                         global, local)) {  string error; \
                                                         CLGetInfoString(OpenCL.GetContext(), CL_ERROR_DESCRIPTION,
                                                                                                          error); \
                                                         printf("Error of execution kernel %s %s: %s", __FUNCSIG__,
                                                                 OpenCL.GetKernelName(kernel), error); \
                                                         return false; }
Dank dieser Struktur wird der Code der Methode kompakter, logisch übersichtlicher und lässt sich leichter skalieren, wenn neue Kernel oder Parameter hinzugefügt werden.
Darüber hinaus müssen, wie bereits in der Beschreibung der Kernel erwähnt, vor deren Ausführung die technischen Einschränkungen des Rechengeräts berücksichtigt werden – insbesondere die maximale Größe der Work-Group, die von der OpenCL-Plattform unterstützt wird. Diese Parameter variieren je nach Grafikkartenmodell und können die korrekte Ausführung des Codes erheblich beeinflussen.
Im Rumpf der Methode AdaptSpatialNorm wird dies durch einen Aufruf von CLGetDeviceInfo umgesetzt, mit dem die zulässige Work-Group-Größe für jede Dimension abgefragt wird. Die Rückgabewerte werden in der Struktur union sizes gespeichert, sodass bequem als Array von Ganzzahlen darauf zugegriffen werden kann, ohne sich um die Einzelheiten der internen Datendarstellung kümmern zu müssen.
bool CNeuronAdaptSpatialNorm::AdaptSpatialNorm(CNeuronBaseOCL *NeuronOCL)
  {
   if(!OpenCL || !NeuronOCL)
      return false;
   uint global_work_offset[3] = { 0 };
   union sizes
     {
      long data[3];
      uchar cdata[24];
     } max_workgroup_size;
   uint size = 0;
   if(!CLGetDeviceInfo(OpenCL.GetContext(), CL_DEVICE_MAX_WORK_ITEM_SIZES, max_workgroup_size.cdata, size))
      return false;
Nachdem wir diese Parameter ermittelt haben, bilden wir das Array global_work_size, das das gesamte Rechengitter definiert. Zudem begrenzen wir für die zweite Dimension, die die Breite der lokalen Work-Group bestimmt, den Wert explizit auf das Minimum aus der Anzahl der Variablen (iVariables) und der vom Gerät zugelassenen maximalen Größe. Dadurch wird sichergestellt, dass die im Kernel implementierte Schleife auch bei großen Datenmengen korrekt ausgeführt wird.
   uint global_work_size[] = { iCount, MathMin(iVariables, uint(max_workgroup_size.data[1])), iVariables};
   uint local_work_size[] = { 1, global_work_size[1], 1};
//---
   uint kernel = def_k_AdaptSpatialNorm;
   setBuffer(kernel, def_k_asn_inputs, NeuronOCL.getOutputIndex())
   setBuffer(kernel, def_k_asn_mean_stdevs, cMeanSTDevs.getOutputIndex())
   setBuffer(kernel, def_k_asn_attention, cAttan.getOutputIndex())
   setBuffer(kernel, def_k_asn_outputs, getOutputIndex())
   kernelExecuteLoc(kernel, global_work_offset, global_work_size, local_work_size)
//---
   return true;
  }
Gleichzeitig wird das Array local_work_size angelegt, wobei die Anzahl der Work-Items entlang der zweiten Dimension explizit festgelegt wird. Dieser Ansatz ermöglicht eine effiziente Nutzung des lokalen Speichers bei der Verarbeitung von Merkmalsvektoren.
Anschließend setzen wir die Kernel-Argumentpuffer nacheinander mithilfe der zuvor definierten setBuffer-Makros, wodurch eine konsistente und sichere Initialisierung der Parameter gewährleistet wird. Der Prozess endet mit dem Makro kernelExecuteLoc, das den AdaptSpatialNorm-Kernel startet und dabei alle zuvor festgelegten Einschränkungen sowie die Struktur des Rechengitters berücksichtigt.
Auf diese Weise implementieren wir nicht nur einen Wrapper für den Aufruf des Kernels, sondern auch einen flexiblen Mechanismus zur Anpassung des Algorithmus an die spezifischen technischen Möglichkeiten der Zielhardware, wodurch Kompatibilität und ein stabiler Betrieb auf einer breiten Palette von Geräten gewährleistet werden.
Der nächste wichtige Schritt ist die Verteilung des Fehlergradienten, die in der Methode calcInputGradients implementiert ist. An dieser Stelle breitet sich das Signal rückwärts durch die internen Objekte aus. Die kumulierten Fehler werden schrittweise transformiert und zurück zu den trainierbaren Parametern der Eingabeebene propagiert. Dieser Teil des Algorithmus ist besonders wichtig, da er es ermöglicht, die Gewichte auf der Grundlage aktueller Informationen über die Abweichung zwischen den vorhergesagten und den tatsächlichen Werten anzupassen.
bool CNeuronAdaptSpatialNorm::calcInputGradients(CNeuronBaseOCL *NeuronOCL)
  {
   if(!AdaptSpatialNormGrad(NeuronOCL))
      return false;
Der Prozess beginnt mit dem Aufruf der Methode AdaptSpatialNormGrad, die – genau wie ihr Pendant im Vorwärtsdurchlauf – ein Wrapper für den entsprechenden OpenCL-Kernel ist. Sie ist dafür zuständig, den Gradienten von den Ausgängen des Normalisierungsblocks nach unten zu den Eingabedaten und den trainierbaren Parametern der Attention-Matrix zu propagieren.
Die Implementierung der Methode AdaptSpatialNormGrad folgt fast vollständig der Struktur, die zuvor zum Einreihen des Vorwärtsdurchlauf-Kernels verwendet wurde. Außerdem definieren wir die globalen und lokalen Work-Sizes, richten die Puffer mithilfe von Makros ein und übergeben die Parameter in der richtigen Reihenfolge an den Kernel. Hier gibt es jedoch einen wichtigen Unterschied, der sich aus dem Wesen der Backpropagation des Fehlers ergibt.
Während beim Vorwärtsdurchlauf jedes Element unabhängig verarbeitet wurde, ändert sich die Situation bei der Berechnung der Gradienten: Für jedes Element auf der Ebene der Eingabedaten muss der Gradientenbeitrag aller univariaten Sequenzen über Attention-Gewichte aggregiert werden. Dies erfordert den gleichzeitigen Zugriff auf viele verschiedene Komponenten des Ausgabetensors, was ein komplexeres Summierungsschema zur Folge hat.
Auch bei den Attention-Gewichten ist ein besonderer Ansatz erforderlich. Hier ist es notwendig, den Gradienten sorgfältig über die Zeitdimension zu integrieren – das heißt, Informationen über alle Positionen in der Sequenz zu sammeln, an denen das entsprechende Gewicht angewendet wurde. Da es sich hierbei um einen relativ ressourcenintensiven Vorgang handelt, insbesondere bei großen Eingabetensoren, wird der Größe der Work-Group besondere Aufmerksamkeit geschenkt.
Für eine korrekte und effiziente Problemkonfiguration wird die Größe der Work-Group daher als Maximum über die Achsen gewählt, entlang derer Gradienten aggregiert werden müssen, wobei zugleich der maximal zulässige Wert berücksichtigt wird, den ein bestimmtes OpenCL-Gerät unterstützt. Dieser Ansatz gewährleistet nicht nur die Einhaltung der technischen Anforderungen, sondern optimiert auch die Leistung, indem unnötige Überläufe und Konflikte beim Speicherzugriff vermieden werden.
Nachdem die Berechnungen auf der OpenCL-Seite abgeschlossen sind, wird die Methode in einem vertrauteren Stil fortgesetzt. Wir leiten den Fehlergradienten schrittweise nach unten durch die Objekte weiter, aus denen sich die Attention-Matrix zusammensetzt.
   if(!cEnEnT.CalcHiddenGradients(cAttan.AsObject()))
      return false;
   if(!MatMulGrad(cEn.getOutput(), cEn.getPrevOutput(),
                  cEnT.getOutput(), cEnT.getGradient(),
                  cEnEnT.getGradient(), iVariables,
                  cEnT.GetWindow(), iVariables, 1, false))
      return false;
   if(!cEn.CalcHiddenGradients(cEnT.AsObject()) ||
      !SumAndNormilize(cEn.getGradient(), cEn.getPrevOutput(), cEn.getGradient(),
                       cEnT.GetWindow(), false, 0, 0, 0, 1))
      return false;
   if(cEn.Activation() != None)
      if(!DeActivation(cEn.getOutput(), cEn.getGradient(), cEn.getGradient(), cEn.Activation()))
         return false;
//---
   return true;
  }
Somit ist die gesamte Methode calcInputGradients eine klar strukturierte Abfolge von Schritten, die sicherstellt, dass der Fehler konsistent und korrekt rückwärts durch das Netzwerk propagiert wird.
Die Methode zur Parameteroptimierung ist hier so knapp wie möglich implementiert, verfolgt dabei jedoch ein sehr klares Ziel. Im Wesentlichen läuft die gesamte Aufgabe darauf hinaus, die Steuerung an ein einziges internes Objekt, cEn, zu übergeben, das die trainierbaren Attention-Parameter enthält. Dieses Objekt bildet den Kern des parametrischen Blocks, auf dem die Korrelationsmatrix aufbaut. Sie allein ist für den trainierbaren Teil des Moduls vollständig verantwortlich.
bool CNeuronAdaptSpatialNorm::updateInputWeights(CNeuronBaseOCL *NeuronOCL)
  {
   return cEn.UpdateInputWeights();
  }
Der vollständige Code der Klasse CNeuronAdaptSpatialNorm sowie all ihrer Methoden ist im Anhang zum weiteren Studium enthalten.
SCNN-Encoder
Nachdem wir die Objekte erstellt haben, die für die Extraktion einzelner Komponenten der Zeitreihe zuständig sind, besteht der nächste logische Schritt darin, diese in eine einzige, zusammenhängende Struktur zu integrieren: den SCNN-Encoder. In dieser Phase werden die vorgefertigten Blöcke in einer klar definierten Reihenfolge zusammengesetzt, die eine zuverlässige, stabile und dennoch flexible Verarbeitung der zu analysierenden Daten gewährleistet.
Das Hauptmerkmal des SCNN-Encoders ist seine modulare Architektur. Er basiert auf vier parallelen Zweigen, von denen jeder für einen eigenen Analysemaßstab zuständig ist. Ein Zweig erfasst langfristige Trends, ein anderer saisonale Muster, ein dritter kurzfristige Schwankungen, und der vierte normalisiert die Daten adaptiv, wodurch die Beziehungen zwischen den einzelnen Merkmalen hervorgehoben werden.
Alle diese Algorithmen sind sorgfältig in dem spezialisierten Objekt CNeuronSCNNEncoder implementiert. Seine Struktur verkörpert die beschriebene Logik und bildet die Grundlage für die Erstellung einer verallgemeinerten Repräsentation der Sequenz – komprimiert, aussagekräftig und für nachfolgende Prognosen geeignet.
class CNeuronSCNNEncoder   :  public CNeuronTransposeOCL
  {
protected:
   CNeuronPeriodNorm       cLongNorm;
   CNeuronTransposeVRCOCL  cSeasonTransp;
   CNeuronPeriodNorm       cSeasonNorm;
   CNeuronTransposeVRCOCL  cUnSeasonTransp;
   CNeuronPeriodNorm       cShortNorm;
   CNeuronAdaptSpatialNorm cAdaptSpatNorm;
   CNeuronBaseOCL          cConcatenated;
   CNeuronSwiGLUOCL        cProjection;
   CNeuronTransposeOCL     cTranspose;
   CNeuronConvOCL          caFusion[2];
   CNeuronBaseOCL          cFusionOut;
   //---
   virtual bool      feedForward(CNeuronBaseOCL *NeuronOCL) override;
   virtual bool      updateInputWeights(CNeuronBaseOCL *NeuronOCL)  override;
   virtual bool      calcInputGradients(CNeuronBaseOCL *NeuronOCL)  override;

public:
                     CNeuronSCNNEncoder(void) {};
                    ~CNeuronSCNNEncoder(void) {};
   //---
   virtual bool      Init(uint numOutputs, uint myIndex, COpenCLMy *open_cl,
                          uint units_count, uint variables, uint forecast,
                          uint season_period, uint short_period,
                          ENUM_OPTIMIZATION optimization_type, uint batch);
   //---
   virtual bool      Save(const int file_handle) override;
   virtual bool      Load(const int file_handle) override;
   //---
   virtual int       Type(void) override const  {  return defNeuronGinAR; }
   virtual void      TrainMode(bool flag) override;
   virtual void      SetOpenCL(COpenCLMy *obj);
   //---
   virtual bool      WeightsUpdate(CNeuronBaseOCL *source, float tau);
  };
Die Struktur der neuen Klasse umfasst eine Reihe interner Objekte, von denen jedes eine genau definierte Funktion innerhalb des Encoders erfüllt. Wir werden etwas später mehr über ihre Aufgaben erfahren, wenn wir uns mit der Logik des Algorithmus befassen. An dieser Stelle sei auf ein wichtiges architektonisches Detail hingewiesen: Alle diese Komponenten werden statisch deklariert. Das bedeutet, dass für sie im Voraus Speicherplatz zugewiesen wird und ihr Lebenszyklus genau dem Lebenszyklus des CNeuronSCNNEncoder-Objekts selbst entspricht. Durch diesen Ansatz entfällt die Notwendigkeit zusätzlicher Verarbeitung – der Konstruktor und der Destruktor der Klasse bleiben leer.
Die Initialisierung aller deklarierten und vererbten internen Objekte erfolgt in der Init-Methode, deren Parameter alle Konstanten liefern, die die Architektur des Objekts definieren.
bool CNeuronSCNNEncoder::Init(uint numOutputs, uint myIndex, COpenCLMy *open_cl,
                              uint units_count, uint variables, uint forecast,
                              uint season_period, uint short_period,
                              ENUM_OPTIMIZATION optimization_type, uint batch)
  {
   if(!CNeuronTransposeOCL::Init(numOutputs, myIndex, open_cl, units_count + forecast, variables,
                                                                       optimization_type, batch))
      return false;
   SetActivationFunction(None);
Alles beginnt mit einem Aufruf der gleichnamigen Basismethode in der übergeordneten Klasse, in der die zentralen Parameter der Architektur festgelegt werden. Nach erfolgreicher Initialisierung wird eine neutrale Aktivierungsfunktion aktiviert, wodurch verhindert wird, dass in dieser Phase nichtlineare Verzerrungen eingeführt werden.
Anschließend werden nacheinander Module erstellt, die für die Vorverarbeitung der Zeitreihe zuständig sind. Zunächst wird der Normalisierungsblock für die langfristige Komponente initialisiert.
   uint index = 0;
   if(!cLongNorm.Init(0, index, OpenCL, 1, units_count, variables, optimization, iBatch))
      return false;
   cLongNorm.SetActivationFunction(None);
Der nächste wichtige Schritt besteht darin, die saisonale Komponente zu isolieren. In dem von den Autoren des SCNN-Frameworks vorgeschlagenen ursprünglichen Konzept wird dieser Schritt als Normalisierung der Daten mit einer Schrittweite interpretiert, die der saisonalen Periode entspricht. Auf den ersten Blick könnte es so aussehen, als wäre dafür eine Art Spezialmodul erforderlich. Wir sind das Problem jedoch rationaler angegangen, ganz im Sinne der klassischen Prinzipien des Systems Engineering.
Wir haben ein universelles Normalisierungsobjekt entwickelt, das für die Verarbeitung von Daten über festgelegte Zeiträume ausgelegt ist. Für sich genommen enthält es keine Informationen über die saisonale Struktur; diese Struktur wird sichtbar, sobald wir die Darstellung des analysierten Arrays ändern. Durch einfaches Transponieren der Abfolge der Zeitschritte anhand der Länge der saisonalen Periode werden die Daten automatisch in Sequenzen mit dem erforderlichen Intervall gruppiert. Diese neu gebildeten Sequenzen eignen sich hervorragend für das Format, das unser Modul zur Periodennormalisierung erwartet.
Auf diese Weise erhalten wir mit minimalem Aufwand einen leistungsstarken Mechanismus zur Extraktion der saisonalen Komponente, ohne zusätzliche Änderungen an der Struktur des normalisierenden Objekts selbst vornehmen zu müssen. Man muss lediglich die Eingabedaten korrekt neu organisieren, und ab dann übernimmt ein bewährter und gut abgestimmter Algorithmus.
   index++;
   if(!cSeasonTransp.Init(0, index, OpenCL, variables, units_count / season_period, season_period,
                                                                            optimization, iBatch))
      return false;
   cSeasonTransp.SetActivationFunction(None);
   index++;
   if(!cSeasonNorm.Init(0, index, OpenCL, cSeasonTransp.GetCount(), season_period, variables,
                                                                       optimization, iBatch))
      return false;
   cSeasonNorm.SetActivationFunction(None);
   index++;
   if(!cUnSeasonTransp.Init(0, index, OpenCL, variables, season_period, cSeasonTransp.GetCount(),
                                                                           optimization, iBatch))
      return false;
   index++;
Nachdem wir die saisonale Komponente isoliert haben, bringen wir die Daten durch eine Rücktransposition wieder in ihre ursprüngliche Darstellung und aktivieren den Block für die kurzfristige Normalisierung.
   if(!cShortNorm.Init(0, index, OpenCL, units_count / short_period, short_period, variables, optimization, iBatch))
      return false;
   cSeasonNorm.SetActivationFunction(None);
   index++;
   if(!cAdaptSpatNorm.Init(0, index, OpenCL, units_count, variables, optimization, iBatch))
      return false;
   cAdaptSpatNorm.SetActivationFunction(None);
Als Nächstes folgt die adaptive räumliche Normalisierung, bei der die Beziehungen zwischen den Variablen in der Eingabesequenz berücksichtigt werden.
Sobald die Daten aus verschiedenen Quellen aufbereitet wurden, wird ein Zusammenführungsmodul erstellt, um die Ausgaben aller Normalisierungsblöcke in einer einzigen Merkmalsmatrix zusammenzuführen. Die Größe dieses Moduls wird dynamisch berechnet, wobei sowohl die Hauptausgänge als auch die mit jedem Normalisierungsblock verbundenen statistischen Kennwerte berücksichtigt werden.
   index++;
   uint concatSize = units_count * variables;                                         //inputs
   concatSize += cLongNorm.Neurons() + cLongNorm.GetMeanSTDevs().Neurons();           // long term
   concatSize += cSeasonNorm.Neurons() + cSeasonNorm.GetMeanSTDevs().Neurons();       // seasons
   concatSize += cShortNorm.Neurons() + cShortNorm.GetMeanSTDevs().Neurons();         // short term
   concatSize += cAdaptSpatNorm.Neurons() + cAdaptSpatNorm.GetMeanSTDevs().Neurons(); // spatial
   if(!cConcatenated.Init(0, index, OpenCL, concatSize, optimization, iBatch))
      return false;
   cConcatenated.SetActivationFunction(None);
Die nächste logische Komponente ist der Projektionsblock, der eine effektive Komprimierung und Umstrukturierung des mehrdimensionalen Merkmalsraums ermöglicht.
   index++;
   if(!cProjection.Init(0, index, OpenCL, concatSize / variables, concatSize / variables,
                             units_count + forecast, 1, variables, optimization, iBatch))
      return false;
Die Ausgabe wird an ein Transpositionsmodul weitergeleitet, das die Daten je nach den Anforderungen der nachfolgenden Verarbeitung zwischen Zeit- und Merkmalsdarstellungen umwandelt.
   index++;
   if(!cTranspose.Init(0, index, OpenCL, variables, units_count + forecast, optimization, iBatch))
      return false;
   index++;
   if(!caFusion[0].Init(0, index, OpenCL, variables, variables, variables, units_count + forecast,
                                                                            optimization, iBatch))
      return false;
   caFusion[0].SetActivationFunction(TANH);
   index++;
   if(!caFusion[1].Init(0, index, OpenCL, variables, variables, variables, units_count + forecast,
                                                                            optimization, iBatch))
      return false;
   caFusion[1].SetActivationFunction(SIGMOID);
   index++;
   if(!cFusionOut.Init(0, index, OpenCL, caFusion[0].Neurons(), optimization, iBatch))
      return false;
//---
   return true;
  }
Die letzte Stufe besteht aus zwei parallelen Faltungsschichten, die unterschiedliche Signalfilterungsmechanismen umsetzen. Eine davon nutzt die hyperbolische Tangensfunktion, wodurch die Ausgabe eine sanfte Sättigung erhält, während die andere eine Sigmoid-Funktion verwendet, die eine logistische Begrenzung der Werte bewirkt. Ihre Ergebnisse laufen im abschließenden Faltungsmodul zusammen, wodurch der Aufbau der Architektur vervollständigt wird.
Wir haben viel Arbeit investiert, und der Artikel ist deutlich länger geworden. Nun folgt eine Untersuchung des nichttrivialen Algorithmus für den Vorwärts- und Rückwärtsdurchlauf unseres Encoders – ein Schritt, der besondere Aufmerksamkeit und Konzentration erfordert. Daher ist es sinnvoll, eine kurze Pause einzulegen, um sich Zeit zu nehmen, den bereits behandelten Stoff zu verinnerlichen und darüber nachzudenken. Im nächsten Artikel werden wir unsere Arbeit fortsetzen, sie zu einem logischen Abschluss bringen und die Wirksamkeit der umgesetzten Lösungen anhand realer historischer Daten bewerten.
Fazit
In diesem Artikel haben wir uns eingehend mit dem nächsten Schritt bei der Implementierung des SCNN-Frameworks befasst – der Erstellung und Integration des Objekts für adaptive räumliche Normalisierung sowie der Zusammenführung der Hauptkomponenten zu einem einzigen Encoder. Wir haben aufgezeigt, wie eine gut konzipierte Architektur und der Einsatz moderner OpenCL-Computing-Technologien es ermöglichen, strukturelle Komponenten in Zeitreihen effektiv zu identifizieren und eine qualitativ hochwertige Datenaufbereitung für weitere Prognosen zu gewährleisten.
Im nächsten Artikel werden wir unsere Untersuchungen fortsetzen und uns dabei auf das Testen und Bewerten der Leistungsfähigkeit des SCNN-Frameworks anhand realer Daten konzentrieren. Auf diese Weise können wir die praktische Bedeutung der implementierten Methoden und ihre Wirksamkeit bei Finanzprognoseaufgaben einschätzen.
Links
- Entflechtung strukturierter Komponenten: Auf dem Weg zu adaptiven, interpretierbaren und skalierbaren Zeitreihenprognosen
- Weitere Artikel dieser Reihe
In diesem Artikel verwendete Software
| # | Name | Typ | Beschreibung |
|---|---|---|---|
| 1 | Study.mq5 | Expert Advisor | Expert Advisor für das Offline-Modelltraining |
| 2 | StudyOnline.mq5 | Expert Advisor | Expert Advisor für Online-Modelltraining |
| 3 | Test.mq5 | Expert Advisor | Expert Advisor für Modelltests |
| 4 | Trajectory.mqh | Klassenbibliothek | Struktur zur Beschreibung des Systemzustands und der Modellarchitektur |
| 5 | NeuroNet.mqh | Klassenbibliothek | Klassenbibliothek zum Erstellen neuronaler Netze |
| 6 | NeuroNet.cl | Bibliothek | Codebibliothek für ein OpenCL-Programm |
Übersetzt aus dem Russischen von MetaQuotes Ltd.
Originalartikel: https://www.mql5.com/ru/articles/18982
Warnung: Alle Rechte sind von MetaQuotes Ltd. vorbehalten. Kopieren oder Vervielfältigen untersagt.
Dieser Artikel wurde von einem Nutzer der Website verfasst und gibt dessen persönliche Meinung wieder. MetaQuotes Ltd übernimmt keine Verantwortung für die Richtigkeit der dargestellten Informationen oder für Folgen, die sich aus der Anwendung der beschriebenen Lösungen, Strategien oder Empfehlungen ergeben.

 Neuronale Netze im Trading: Zerlegung strukturierter Komponenten (Fazit)
 Neuronale Netze im Trading: Zerlegung strukturierter Komponenten (SCNN)
 Neuronale Netze im Trading: Zerlegen statt Skalieren (Fazit)
 Marktsimulation: Erste Schritte mit SQL in MQL5 (V)

- Freie Handelsapplikationen
- Über 8.000 Signale zum Kopieren
- Wirtschaftsnachrichten für die Lage an den Finanzmärkte
Sie stimmen der Website-Richtlinie und den Nutzungsbedingungen zu.