

Neuronale Netze im Trading: Ein Ende-zu-Ende-Modell für die multivariate Zeitreihenprognose (GinAR)
 34
 0

Einleitung
Die multivariate Zeitreihenprognose (MTSF) ist zu einem festen Bestandteil der Analyse in verschiedenen Branchen geworden – vom Verkehrswesen über die Umweltwissenschaften bis hin zu den Finanzmärkten. In unserem Fachgebiet bedeutet dies die Fähigkeit, das Verhalten mehrerer miteinander verknüpfter Finanzinstrumente (Aktien, Indizes, Währungen) auf der Grundlage ihrer historischen Dynamik vorherzusagen. Diese Modelle ermöglichen es, fundiertere Anlageentscheidungen zu treffen, Risiken zu steuern und verborgene Zusammenhänge zwischen Assets aufzudecken.
Formal lässt sich eine multivariate Zeitreihe (MTS) als raumzeitlicher Graph darstellen, in dem jede Variable (sei es ein Wechselkurs, ein Handelsvolumen oder eine Rendite) im Zeitverlauf beobachtet und über verborgene Abhängigkeiten mit anderen Variablen verknüpft ist. Diese Abhängigkeiten lassen sich in zwei Hauptkategorien einteilen: zeitliche (Ursache-Wirkungs-Beziehungen zwischen Ereignissen) und räumliche (Wechselbeziehungen zwischen Assets oder Marktsektoren).
Für eine effektive MTS-Prognose ist es entscheidend, diese raumzeitlichen Abhängigkeiten erkennen und nutzen zu können. Dies ist besonders kritisch in Zeiten hoher Volatilität und Marktschocks, in denen sich traditionelle Modelle einfach nicht schnell genug anpassen können. Hier kommen Graph Neural Networks ins Spiel. Diese Modelle vereinen die Vorteile von Graph-Convolutional Networks und rekurrenten Modellen und ermöglichen so genauere Prognosen auf der Grundlage komplexer Beziehungen zwischen Variablen.
In der Praxis ist die Sache jedoch nicht ganz so einfach. Finanzdaten sind oft unvollständig. Einige Kennzahlen sind nicht verfügbar oder werden nur für einen Teil des Zeitraums erfasst. Fehlende Werte können verschiedene Ursachen haben: Störungen bei der Datenübermittlung, Änderungen bei den Berechnungsmethoden der Indikatoren oder technische Fehler seitens der Broker. Und wenn Daten zu wichtigen Assets fehlen, sinkt die Prognosegenauigkeit drastisch. In solchen Fällen verlieren Graph-Modelle in der Regel ihre Fähigkeit, Abhängigkeiten angemessen zu bewerten, was zu einer lawinenartigen Anhäufung von Fehlern und einem Rückgang der Prognosequalität führt.
Einige Versuche, dieses Problem zu umgehen, basieren darauf, nicht verfügbare Variablen einfach auszuschließen. Das ist jedoch kurzsichtig – fehlende Daten zu einem zentralen Asset können die gesamte logische Struktur des Modells untergraben und zu falschen Schlussfolgerungen führen. Anspruchsvollere Ansätze nutzen Methoden zur Imputation fehlender Werte (Imputation) und kombinieren dabei den zeitlichen Kontext mit festen räumlichen Beziehungen, wie beispielsweise Korrelationen oder Netzwerkstrukturen zwischen Assets. Solche Methoden versagen jedoch häufig, wenn ein hoher Anteil an fehlenden Daten vorliegt oder wenn keine verlässlichen Zusammenhänge zwischen den beobachteten und den fehlenden Variablen bestehen. Und wieder häufen sich die Fehler, und die Prognose wird unzuverlässig.
Was sollen wir also tun? Die Lösung besteht darin, Modelle zu entwickeln, die in der Lage sind, Informationen über verfügbare Variablen zu nutzen, um fehlende Daten direkt während des Prognoseprozesses zu imputieren, ohne das Training in separate Phasen „Imputation → Prognose“ zu unterteilen. Genau so funktioniert das neue Graph Interpolation Attention Recursive Network (GinAR)-Framework, wie es im Artikel „GinAR: An End-to-End Multivariate Time Series Forecasting Model Suitable for Variable Missing“ vorgestellt wird. Hierbei handelt es sich um eine neue End-to-End-Architektur, die darauf ausgelegt ist, fehlende Variablen in multivariaten Zeitreihen zu verarbeiten.
GinAR basiert auf einem einfachen rekurrenten Netzwerk (SRU), das zwei Schlüsselkomponenten umfasst:
- Interpolation Attention (IA) ist ein Mechanismus, der fehlende Variablen durch die Anwendung von Attention-Algorithmen auf die verfügbaren Daten rekonstruiert. Dadurch lassen sich Fehler vermeiden, die entstehen, wenn das Modell aus Nullwerten und Ausreißern lernt.
- Adaptive Graph Convolution (AGCN) ist eine adaptive Graph-Convolution, die die Struktur der Beziehungen zwischen Variablen nach der Imputation neu aufbaut, sodass sowohl direkte als auch indirekte Korrelationen zwischen Assets berücksichtigt werden können.
Auf diese Weise prognostiziert und verfeinert GinAR das Abhängigkeitsmodell gleichzeitig und verhindert so, dass sich Fehler vervielfachen. Und besonders wichtig ist, dass es sogar unter extremen Bedingungen funktioniert. In Tests mit realen Daten, die von den Autoren des Frameworks durchgeführt wurden, behielt das Modell auch dann eine hohe Genauigkeit bei, wenn bis zu 90 % der Variablen nicht verfügbar waren. Stellen Sie sich eine Situation vor, in der Sie nur Daten für einige wenige Assets in Ihrem Portfolio haben, während die übrigen keine Daten liefern – GinAR erstellt dennoch eine Prognose für das gesamte System.
Kurz gesagt, die wichtigsten Beiträge von GinAR sind:
- Dies ist das erste für MTSF mit fehlenden Variablen entwickelte Modell, das ohne einen vorgelagerten Imputationsschritt funktioniert.
- Die neue Architektur (IA + AGCN) ersetzt die vollständig verbundenen Schichten in SRU und minimiert so Verzerrungen bei den Abhängigkeiten.
- Den im Artikel der Autoren vorgestellten Versuchsergebnissen zufolge schnitt GinAR bei fünf verschiedenen Datensätzen besser ab als elf andere Modelle und zeigte selbst bei kritisch hohen Anteilen fehlender Daten eine robuste Leistung.
Für die Finanzmärkte bedeutet dies nur eines: Selbst wenn einige Daten fehlen, ist es möglich, systematische und genaue Prognosen zu erstellen. Das bedeutet, dass adaptive Strategien, Stresstests und Risikomanagement zuverlässig umgesetzt werden können, ohne dass man sich auf ideale Eingabedaten verlassen muss. Schließlich ist der Markt in der Realität niemals perfekt – und GinAR wurde genau dafür entwickelt, unter solchen Bedingungen eingesetzt zu werden.
GinAR-Algorithmus
Die Architektur des GinAR-Frameworks folgt dem klassischen Encoder → Decoder-Schema. Ein Stapel von GinAR-Schichten wird als Encoder verwendet, während der Decoder mithilfe eines mehrschichtigen Perzeptrons (MLP) implementiert wird. Ein wesentlicher Bestandteil des Systems ist die GinAR-Zelle – ein Modul, das auf dem Prinzip der rekursiven Modellierung basiert. Wenn unvollständige Daten eingegeben werden – also Zeitreihen mit fehlenden Variablen –, ist das Modell in der Lage, zukünftige Werte für alle Variablen gleichzeitig zu prognostizieren, selbst für diejenigen, für die keine vollständigen historischen Daten vorliegen.
Bei der Konzeption der internen Logik von GinAR schlugen die Autoren des Frameworks vor, alle vollständig verbundenen Schichten in der klassischen rekursiven Struktur von SRU durch zwei spezialisierte Komponenten zu ersetzen: IA (Interpolation Attention) und AGCN (Adaptive Graph Convolution Network).
Die erste Komponente imputiert fehlende Variablen mithilfe von Informationen aus verfügbaren Nachbarn. Dies ist insbesondere im Zusammenhang mit den Finanzmärkten von Bedeutung: Fehlen Daten zu wichtigen Assets – und sei es auch nur teilweise –, kann das Modell erheblich an Genauigkeit einbüßen. Der IA-Mechanismus verhindert dies, indem er auf der Grundlage der verfügbaren Daten aussagekräftige Repräsentationen der fehlenden Zeitreihen rekonstruiert und die Auswirkungen von Rauschen minimiert.
Die zweite Komponente, AGCN, verzichtet auf feste Abhängigkeitsgraphen, wie beispielsweise vordefinierte Beziehungen zwischen Assets, Indizes und Sektoren, und lernt stattdessen während des Trainings direkt eine adaptive Graphstruktur. Dadurch lassen sich räumliche Beziehungen zwischen Variablen flexibel erfassen, selbst wenn sie sich im Laufe der Zeit ändern oder nicht auf den ersten Blick erkennbar sind.
Der Encoder von GinAR wird mithilfe eines rekursiven Schemas implementiert, bei dem in jedem Zeitschritt die aktuellen Merkmale und der interne Zustand aus dem vorherigen Schritt als Eingaben zugeführt werden. Die GinAR-Zelle verarbeitet sie, aktualisiert den Zustand und erzeugt eine verborgene Repräsentation des aktuellen Zeitschritts. Dieser Ansatz ermöglicht es, fehlende Daten zu imputieren, den Abhängigkeitsgraphen zu rekonstruieren und dynamische Muster zu extrahieren – und das alles innerhalb eines einzigen Moduls. Dank Residual-Verbindungen (Skip Connections) kann das Modell tief sein, ohne dass die Trainingsstabilität darunter leidet. Dies ist besonders wichtig bei der Prognose komplexer Marktsignale, bei denen sowohl kurzfristige Schwankungen als auch langfristige Trends eine wichtige Rolle spielen.
Der nächste Schritt ist die Prognose. Dazu müssen die resultierenden latenten Repräsentationen korrekt aggregiert werden. Einerseits enthält jeder endgültige verborgene Zustand einer GinAR-Zelle vollständige Informationen über die zeitliche Struktur der Eingabedaten – dies ist auf den rekursiven Charakter des Modells zurückzuführen. Andererseits spiegelt jede verborgene Repräsentation dank ihrer mehrschichtigen Struktur und der vorhandenen Skip Connections unterschiedliche Abstraktionsebenen wider: von Mikrobewegungen bis hin zu globalen Korrelationen. Daher werden die Merkmale aller Schichten zu einem einzigen Tensor zusammengefasst und in den Decoder eingespeist. Der Decoder ist ein mehrschichtiges Perzeptron, das mithilfe der Strategie der direkten Mehrschrittprognose (Direct Multi-Step Forecasting, DMSF) trainiert wurde – einem Ansatz zur direkten Mehrschrittprognose. Dieser Ansatz ermöglicht es, den gesamten Zielhorizont auf einmal zu prognostizieren (zum Beispiel Kursbewegungen in den nächsten 5–10 Bars), ohne auf eine iterative Schritt-für-Schritt-Prognose zurückgreifen zu müssen, die zur Anhäufung von Fehlern neigt.
Infolgedessen bietet GinAR eine robuste Architektur, die in der Lage ist, Prognoseaufgaben bei fehlenden Daten, dynamischen Beziehungen und hohen Korrelationen zwischen Zeitreihen effektiv zu bewältigen. Das Modell vereint die Imputation fehlender Daten, das Erlernen der Graphstruktur und Prognosen – alles in einer einzigen End-to-End-Lösung, die sich an die Unsicherheiten des realen Marktes anpassen kann.
Der Interpolation Attention-Mechanismus (IA) dient dazu, Repräsentationen von Variablen zu rekonstruieren, für die historische Daten vollständig fehlen. Für jede fehlende Variable muss die Menge der beobachteten Variablen festgelegt werden, auf der die Rekonstruktion basiert, sowie die entsprechenden Einflussgewichte für diese Variablen. Dieser Prozess besteht aus zwei wesentlichen Schritten: Zunächst werden Zuordnungen zwischen den fehlenden und den verfügbaren Variablen hergestellt, und anschließend wird ein Attention-Mechanismus angewendet, um Informationen zu aggregieren und eine Rekonstruktion durchzuführen.
In der ersten Phase wird eine Zuordnungsmatrix zwischen den Variablen erstellt. Es werden eine Identitätsmatrix IN ∈ Rᴺ*ᴺ sowie zwei Einbettungsmatrizen der Variablen initialisiert: EIA1 ∈ Rᴺ*ᵈ und EIA2 ∈ Rᵈ*ᴺ. Diese Einbettungen werden gemeinsam mit dem Modell erlernt. Die Korrelationsmatrix zwischen den Variablen wird anhand der folgenden Formel berechnet:
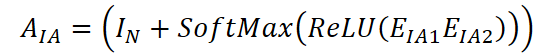
Das Element (i, j) der Matrix AIA ∈ Rᴺ*ᴺ spiegelt den Grad der Beziehung zwischen den Variablen i und j wider. Ist der Wert positiv, bedeutet dies, dass die beobachtete Variable j zur Imputation der fehlenden Variable i herangezogen werden kann. Somit können wir für jede fehlende Variable i eine Menge zugehöriger beobachteter Variablen N(i) ⊆ {1,…,N} bestimmen.
Nachdem die Zuordnungen ermittelt wurden, werden die Repräsentationen der fehlenden Variablen mithilfe von Attention-Mechanismen rekonstruiert. Zu diesem Zweck werden die Attention-Koeffizienten aij berechnet, die die Bedeutung der beobachteten Variablen j bei der Rekonstruktion der Variablen i widerspiegeln:
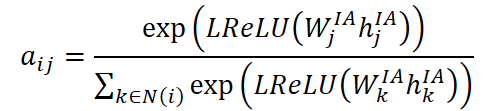
wobei hᴵᴬj die aktuelle verborgene Repräsentation der Variablen j ist und Wᴵᴬj die trainierbare Gewichtsmatrix ist. Die Aktivierung erfolgt über die LReLU-Funktion, die dazu beiträgt, zu verhindern, dass Gradienten bei schwachen Aktivierungen auf null gesetzt werden.
Die daraus resultierenden Koeffizienten werden verwendet, um Informationen aus den beobachteten Variablen zu aggregieren. Die Repräsentation der fehlenden Variablen i wird anhand der folgenden Formel rekonstruiert:
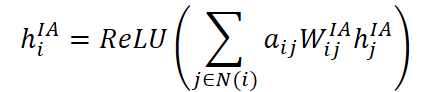
wobei Wᴵᴬij eine separate trainierbare Gewichtsmatrix für jedes Paar von Variablen i und j ist und die abschließende Aggregation mittels ReLU normalisiert wird, um die Robustheit gegenüber Ausreißern zu verbessern.
Dieser Vorgang wird für alle fehlenden Variablen wiederholt, bis die Repräsentationen für alle M fehlenden Komponenten rekonstruiert wurden. Daraus ergibt sich ein neuer Tensor XᴵᴬM ∈ Rᴺ*ᴴ*ᶜ′, in dem alle Variablen, einschließlich der zuvor fehlenden, vollständige verborgene Repräsentationen aufweisen. Es ist zu beachten, dass die Schritte 2 und 3 in der Praxis mithilfe von Matrixmultiplikation und parallelen Berechnungen umgesetzt werden, um die Rekonstruktion der Repräsentationen effizienter zu gestalten.
Somit ermöglicht der Interpolation Attention-Mechanismus, Daten in multivariaten Zeitreihen mit fehlenden Variablen flexibel zu imputieren, ohne dass die Struktur der Beziehungen zwischen den Variablen im Voraus starr festgelegt werden muss. Dies ist besonders wichtig für Finanzprognoseaufgaben, bei denen die Korrelationsstrukturen zwischen Assets volatil sein können und historische Daten möglicherweise unvollständig oder verrauscht sind.
Bei Problemen der multivariaten Zeitreihenprognose wird häufig eine vordefinierte Graphstruktur verwendet, um räumliche Abhängigkeiten zwischen Variablen abzubilden. Zu diesem Zweck wird die Adjazenzmatrix A definiert, die es dem Modell ermöglicht, die zugrunde liegenden Beziehungen zu erfassen. Bei einem erheblichen Umfang fehlender Daten – insbesondere wenn für eine Reihe von Variablen keine vollständigen Informationen vorliegen – kann eine solche vordefinierte Graphstruktur jedoch unzureichend sein. Um diese Einschränkung zu überwinden, haben die Autoren des Frameworks Adaptive Graph Convolution eingeführt, die eine vordefinierte Struktur mit einem aus den Daten generierten Graphen kombiniert.
Die Grundlage für die vordefinierte Graphstruktur bilden entweder Entfernungsangaben (beispielsweise bei Verkehrsnetzen) oder der Pearson-Korrelationskoeffizient zwischen Variablen, sofern die Daten keine Informationen zur Topologie enthalten. In diesem Fall wird die Adjazenzmatrix für die Graphkonvolution wie folgt berechnet:
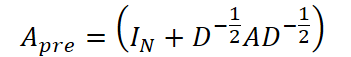
wobei IN ∈ Rᴺ*ᴺ die Einheitsmatrix ist, D die Gradmatrix der Graphknoten ist und A die ursprüngliche Adjazenzmatrix ist. Diese Normalisierung trägt dazu bei, die Gewichtsskala während des Trainings zu stabilisieren.
Wenn jedoch einige Variablen fehlen oder ihre Zusammenhänge unbekannt sind, müssen räumliche Abhängigkeiten dynamisch ermittelt werden. Zu diesem Zweck wird ein adaptiver Graph konstruiert und aus den Daten gelernt. Dieser Prozess beginnt mit der Initialisierung einer Identitätsmatrix IN ∈ Rᴺ*ᴺ und der zufälligen Initialisierung der Variablen-Einbettungen EA ∈ Rᴺ*ᵈ. Diese Einbettungen werden während des Modelltrainings aktualisiert.
Nach der Imputation der Variablen mithilfe des IA-Mechanismus erhalten wir den Tensor der verborgenen Repräsentationen XᴵᴬM ∈ Rᴺ*ᴴ*ᶜ′. Anschließend wird eine aktualisierte Repräsentation der Variablen, En ∈ Rᴺ*ᵈ, berechnet, wobei sowohl Einbettungen als auch zeitliche Repräsentationen kombiniert werden:
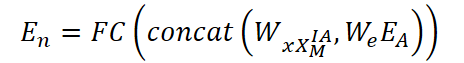
wobei Wx und We die trainierbaren Gewichtsmatrizen für zeitliche Merkmale bzw. Einbettungen sind und concat(⋅) die Konkatenationsoperation entlang der letzten Achse bezeichnet. Diese Repräsentation wird verwendet, um eine adaptive Adjazenzmatrix zu konstruieren:
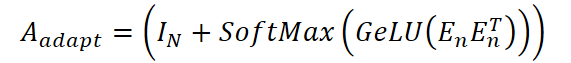
Der letzte Schritt besteht darin, Informationen aus beiden Graphen mithilfe adaptiver Graphkonvolution zu aggregieren, die zwei Kanäle kombiniert: Der eine nutzt eine vordefinierte Struktur, der andere eine adaptive. Die endgültige Darstellung der Variablen wird anhand der folgenden Formel berechnet:
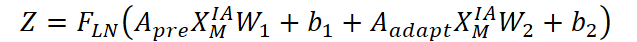
Dieses Konzept ermöglicht die Integration statischer und dynamischer räumlicher Informationen, was insbesondere bei der Prognose multivariater Zeitreihen mit teilweise fehlenden Variablen von Bedeutung ist.
Durch die Kombination der beiden Graphen erhält das Modell eine robuste und adaptive Struktur, die es ihm ermöglicht, Abhängigkeiten zwischen Variablen genauer zu erkennen und dadurch die Genauigkeit der kurz- und mittelfristigen Prognose zu verbessern.
Der Kerngedanke hinter der GinAR-Architektur besteht darin, einen Interpolation-Attention-Mechanismus (IA) und adaptive Graphkonvolution (AGCN) in ein einfaches rekursives Modell zu integrieren. Diese Kombination ermöglicht es nicht nur, fehlende Variablen zu imputieren, sondern auch raumzeitliche Abhängigkeiten effektiv zu berücksichtigen.
Sehen wir uns die Struktur einer GinAR-Zelle und den schrittweisen Prozess zur Prognose der Daten genauer an.
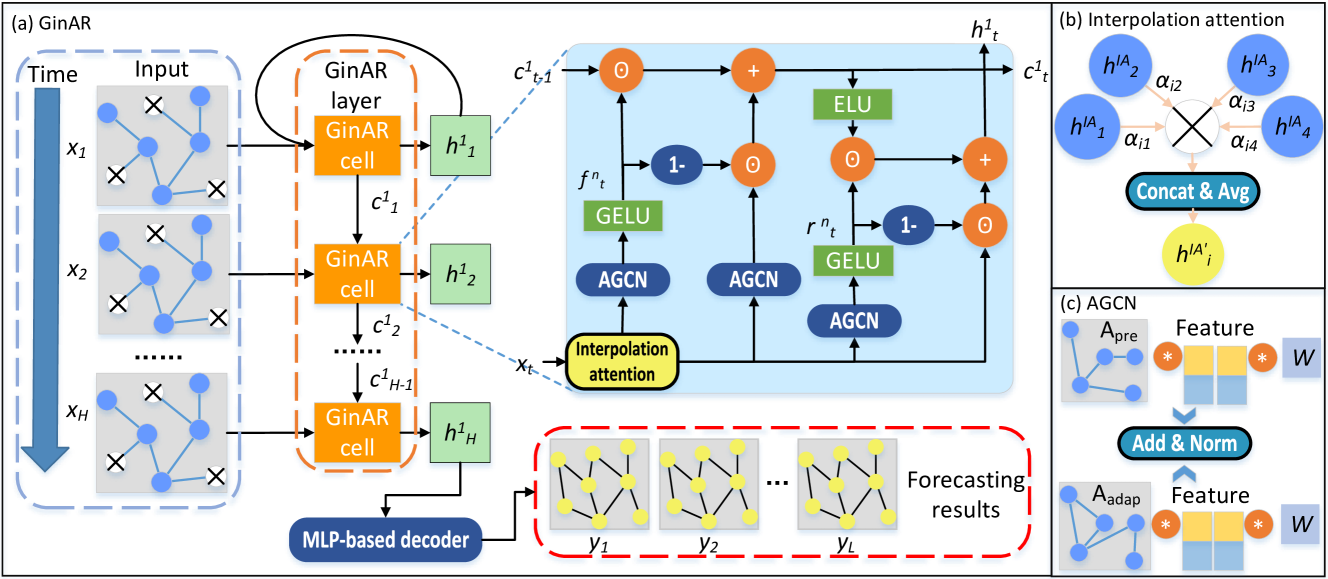
Auf der Ebene eines einzelnen Zeitschritts dient eine GinAR-Zelle als grundlegende Recheneinheit. Sie verwendet IA zur Imputation fehlender Eingabewerte und AGCN zur Verarbeitung räumlicher Beziehungen zwischen Variablen. Als Eingabe dient ein Tensor xT, der zunächst mithilfe des Interpolation-Attention-Mechanismus transformiert wird:
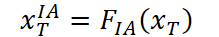
Anschließend werden das Vergessensgatter fT und das Rücksetzgatter rT berechnet, indem Informationen aus dem vordefinierten Graphen Apre und dem adaptiven Graphen Aadapt aggregiert werden:
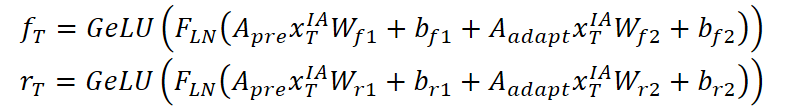
Der neue Zustand cT wird als Kombination der aktuellen transformierten Eingabe und des vorherigen Zustands cT-1 gebildet, gewichtet durch das Vergessensgatter:
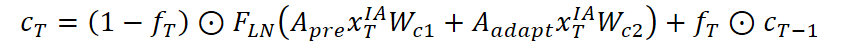
Schließlich wird der verborgene Zustand hT durch eine nichtlineare Kombination aus dem aktualisierten Zellzustand und der Eingabe berechnet:
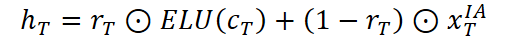
Somit führt jede GinAR-Zelle einen vollständigen Zyklus zur Aktualisierung ihrer internen Zustände aus, einschließlich der Imputation von Daten und der Aggregation räumlicher Informationen.
Auf globaler Ebene besteht der GinAR-Encoder aus mehreren GinAR-Schichten. Jede Schicht besteht aus H in Reihe geschalteten Zellen. Die ursprünglichen Eingabedaten X ∈ Rᴺ*ᴴ*ᶜ werden zunächst normalisiert und maskiert, wodurch der Tensor XM ∈ Rᴺ*ᴴ*ᶜ entsteht, wobei die Werte der M Variablen auf null gesetzt werden.
Anschließend wird XM in die erste GinAR-Schicht eingespeist, in der jede Zelle für die Verarbeitung eines einzelnen Zeitschritts zuständig ist. Der Prozess beginnt mit der Initialisierung des Zustands c₀. Anschließend werden x₁ und c₀ an die erste Zelle übergeben, wodurch h¹₁ und c₁ erzeugt werden. Diese Werte werden dann zusammen mit x₂ an die nächste Zelle weitergegeben, und so weiter. Das Ergebnis ist eine Sequenz verborgener Zustände der ersten Schicht, h¹ = [h¹₁, h¹₂, …, h¹H].
Dieser Tensor dient als Eingabe für die nächste Schicht. Der Vorgang wird so lange wiederholt, bis alle n Schichten bearbeitet wurden. Anschließend wird aus jeder Schicht der letzte verborgene Zustand hHⁱ extrahiert, und diese Zustände werden zum abschließenden Vektor halln verkettet.
Die abschließende Repräsentation halln wird in einen Decoder eingespeist, der auf einem mehrschichtigen Perzeptron (MLP) basiert und Prognosewerte erzeugt:
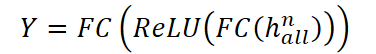
Somit ermöglicht GinAR eine vollständige Ende-zu-Ende-Verarbeitung von Zeitreihen mit fehlenden Werten, wobei die Datenimputation und die Modellierung raumzeitlicher Abhängigkeiten in einem einzigen rekursiv-konvolutionellen Framework kombiniert werden.
Nachfolgend ist die von den Autoren erstellte Visualisierung des GinAR-Frameworks dargestellt.
Implementierung in MQL5
Nachdem wir die theoretischen Aspekte des GinAR-Frameworks betrachtet haben, wenden wir uns nun dem praktischen Teil zu, in dem wir eine Möglichkeit aufzeigen, wie die von den Autoren des Frameworks beschriebenen Ansätze mithilfe von MQL5 umgesetzt werden können.
Bevor wir jedoch mit der Entwicklung des Hauptalgorithmus beginnen, müssen wir einige Vorbereitungen treffen. Wie aus der obigen Beschreibung von GinAR hervorgeht, wendet der ursprüngliche Algorithmus wiederholt eine Datennormalisierung unter Verwendung der SoftMax-Funktion an. Vor diesem Hintergrund haben wir uns entschieden, dies als separate Funktion im OpenCL-Programm zu implementieren, um so Flexibilität und hohe Leistung bei der Arbeit mit multivariaten Daten zu gewährleisten.
Vorbereitende Arbeiten
Zur besseren Übersicht haben wir die Umsetzung des Algorithmus in einzelne Funktionsblöcke unterteilt. Beginnen wir mit dem ersten Punkt: dem Ermitteln des Maximalwerts unter den Threads einer Work-Group. Die Funktion LocalMax übernimmt diese Aufgabe.
Die Funktion LocalMax nimmt zwei Parameter entgegen: den im aktuellen Thread berechneten Wert und den Index der Dimension des Ausführungsbereichs (loc), anhand dessen die Threads in Work-Groups zusammengefasst werden.
#define BarrierLoc      barrier(CLK_LOCAL_MEM_FENCE)
float LocalMax(const float value, const int loc)
  {
   const size_t id = get_local_id(loc);
   const size_t total = get_local_size(loc);
//---
   __local float Temp[LOCAL_ARRAY_SIZE];
   const uint ls = min((uint)total, (uint)LOCAL_ARRAY_SIZE);
Im ersten Schritt werden die Thread-ID innerhalb der lokalen Work-Group und die Gesamtgröße der Work-Group ermittelt. Anschließend wird ein Temp-Array erstellt und im lokalen Speicher des Geräts abgelegt; dieses Array dient zum Austausch von Zwischenwerten zwischen Threads innerhalb derselben Work-Group.
Anschließend durchläuft das Programm alle innerhalb der Work-Group gebildeten Untergruppen, um lokale Maxima zu finden. Die Werte werden in den Elementen des Temp-Arrays gespeichert.
//--- Find Max
   for(int d = 0; d < total; d += ls)
     {
      if(id >= d && id < (d + ls) &&
         (d == 0 || Temp[id - d] < value))
         Temp[id - d] = IsNaNOrInf(value, MIN_VALUE);
      BarrierLoc;
     }
Danach beginnt ein iterativer Prozess der Reduktion (Zusammenführung), bei dem das Temp-Array auf einen einzigen Wert reduziert wird – das Maximum aller seiner Elemente.
   int count = ls;
   do
     {
      count = (count + 1) / 2;
      if(id < count && (id + count) < ls && Temp[id] < Temp[id + count])
         Temp[id] = Temp[id + count];
      BarrierLoc;
     }
   while(count > 1);
//---
   return IsNaNOrInf(Temp[0], MIN_VALUE);
  }
Das Ergebnis dieser Operationen wird an das aufrufende Programm zurückgegeben.
Ähnlich wie bei der vorherigen LocalMax-Funktion wollen wir nun einen weiteren grundlegenden Baustein erstellen – eine Funktion zum Summieren von Elementen innerhalb einer lokalen Work-Group. Diese Aufgabe wird von der Funktion LocalSum übernommen, die nach dem gleichen Prinzip wie LocalMax funktioniert, jedoch Addition statt der Suche nach einem Maximum verwendet.
float LocalSum(const float value, const int loc)
  {
   const size_t id = get_local_id(loc);
   const size_t total = get_local_size(loc);
//---
   __local float Temp[LOCAL_ARRAY_SIZE];
   const uint ls = min((uint)total, (uint)LOCAL_ARRAY_SIZE);
In der Anfangsphase werden wie zuvor die Thread-Kennung und die Größe der Work-Group ermittelt. Außerdem wird ein lokales Temp-Array angelegt, um Zwischensummen zu speichern.
Als Nächstes erfolgt eine Iteration über alle Threads in der lokalen Work-Group, wobei Zwischenwerte akkumuliert werden. Beachten Sie die Verwendung der Bedingung d == 0, die sicherstellt, dass das Temp-Array bei der ersten Iteration korrekt initialisiert wird.
//--- Sum
   float result = IsNaNOrInf(value, 0);
   for(int d = 0; d < total; d += ls)
     {
      if(id >= d && id < (d + ls))
         Temp[id - d] = (d == 0 ? result : Temp[id - d] + result);
      BarrierLoc;
     }
Anschließend wird der bekannte Reduktionsprozess durchgeführt, bei dem die Anzahl der Elemente bei jedem Schritt halbiert wird; anstelle eines Vergleichs werden hier lediglich die Elemente des Temp-Arrays addiert.
   int count = ls;
   do
     {
      count = (count + 1) / 2;
      if(id < count && (id + count) < ls)
         Temp[id] += Temp[id + count];
      BarrierLoc;
     }
   while(count > 1);
   result = IsNaNOrInf(Temp[0], 0);
//---
   return result;
  }
Der Endwert, also die Summe aller Elemente in der Work-Group, wird an das aufrufende Programm zurückgegeben.
In der letzten Phase der Vorbereitungsarbeiten werden wir die zuvor implementierten Hilfsfunktionen LocalMax und LocalSum zu einem einzigen Algorithmus für die LocalSoftMax-Funktion zusammenfassen, die eine numerisch stabile Normalisierung der Werte innerhalb einer Work-Group durchführt.
float LocalSoftMax(const float value, const int loc)
  {
//--- Look Max
   const float max = LocalMax(value, loc);
   BarrierLoc;
Innerhalb der Funktion LocalSoftMax wird zunächst LocalMax aufgerufen; diese Funktion ermittelt den Maximalwert aller Threads in der Work-Group. Dies ist notwendig, um die Berechnungen zu stabilisieren: Durch das Abziehen des Maximalwerts von jedem Wert werden Überläufe verhindert und die numerische Stabilität bei Exponentialoperationen verbessert.
Anschließend wird nach Anwendung der Verschiebung der Exponentialwert jedes Werts berechnet. Das Ergebnis dieser Operation wird vorübergehend in der Variablen result gespeichert; anschließend rufen wir die Funktion LocalSum auf, um die Gesamtsumme der Exponentialwerte innerhalb der Gruppe zu berechnen.
//--- SoftMax
   float result = IsNaNOrInf(exp(value - max), 0);
   const float sum = LocalSum(result, loc);
   result = IsNaNOrInf(result / (sum == 0 ? 1 : sum), 0);
//---
   return result;
  }
Anschließend erfolgt die Normalisierung: Der Wert result wird durch die Summe aller Exponentialwerte geteilt. Zudem ist ein Schutz vor Division durch Null vorgesehen: Ist die Summe gleich Null, wird im Nenner die Zahl 1 verwendet. Als letzten Schritt geben wir den normalisierten Wert zurück.
Dank dieser Struktur lässt sich SoftMax als flexibler Baustein für nachfolgende OpenCL-Kernel einsetzen. Dadurch wird der Code übersichtlicher, die Fehlersuche vereinfacht und die Lesbarkeit der gesamten Architektur verbessert, insbesondere im Kontext von Graphmodellen und Attention-Mechanismen, die in der GinAR-Implementierung in MQL5 verwendet werden.
Ein Vorwärtsdurchlauf durch SoftMax allein reicht jedoch noch nicht aus, um das Modell zu trainieren. Um die Gewichte während der Backpropagation korrekt zu aktualisieren, muss die entsprechende Funktion zur Rückpropagation der Gradienten implementiert werden. Mit dieser Funktion kann das Modell berücksichtigen, wie sich eine Änderung des Eingabewerts auf den Gesamtfehler auswirkt.
Wir implementieren diese Funktionalität in der Funktion LocalSoftMaxGrad, die den Gradienten der SoftMax-Funktion in Bezug auf den Eingabewert bestimmt. Die Eingabeparameter sind: der Wert value, der der Ausgabe von SoftMax entspricht; der Gradient grad, der von einer nachfolgenden Schicht des Netzwerks übergeben wird; sowie der Index loc der Dimension des Arbeitsraums, auf dessen Basis Work-Groups gebildet werden.
float LocalSoftMaxGrad(const float value, const float grad, const int loc)
  {
   const size_t id = get_local_id(loc);
   const size_t total = get_local_size(loc);
//---
   __local float Temp[LOCAL_ARRAY_SIZE];
   const uint ls = min((uint)total, (uint)LOCAL_ARRAY_SIZE);
Zu Beginn der Funktion ermitteln wir die ID des aktuellen Threads und die Gesamtzahl der Threads in der lokalen Work-Group. Wir erstellen ein lokales Array Temp, um Zwischenwerte zu speichern, ähnlich wie dies bereits bei LocalMax und LocalSum geschehen ist. Die Variable val ist der bereinigte Eingabewert.
   float result = 0;
   float val = IsNaNOrInf(value, 0);
   for(uint d = 0; d < total; d += ls)
     {
      if(id >= d && id < (d + ls))
         Temp[id - d] = IsNaNOrInf(val * grad, 0);
      BarrierLoc;
      for(uint l = 0; l < min(ls, (uint)(total - d)); l++)
         result += Temp[l] * ((float)((d + l) == id) - val);
      BarrierLoc;
     }
//---
   return result;
  }
Als Nächstes beginnen wir damit, die Subgruppen innerhalb der gesamten Work-Group der Reihe nach zu durchlaufen. In jedem Block füllen wir den temporären Puffer mit den Werten des Produkts val * grad und akkumulieren das Ergebnis unter Verwendung der Standardformel für die Ableitung von SoftMax in der Variablen result. Der Ausdruck selbst verwendet die logische Prüfung (d + l) == id, wodurch sichergestellt wird, dass sowohl die diagonalen als auch die außerdiagonalen Elemente der Jacobi-Matrix korrekt verarbeitet werden.
Das Ergebnis der Funktion ist der endgültige Gradientenwert, der dem angegebenen Eingabeelement entspricht. Dieses Ergebnis wird an den aufrufenden Kernel zurückgegeben, wodurch sichergestellt wird, dass der Rückwärtsdurchlauf in der Modellarchitektur korrekt implementiert ist.
Damit vervollständigt diese Funktion die Implementierung des gesamten SoftMax-Verarbeitungszyklus innerhalb des OpenCL-Moduls – von der Vorwärtsberechnung bis hin zur korrekten Gradienten-Backpropagation.
Interpolation Attention
Nachdem wir die Vorbereitungsarbeiten im Zusammenhang mit der Implementierung grundlegender Operationen wie SoftMax und der Weitergabe seines Gradienten abgeschlossen haben, wenden wir uns nun dem Aufbau des Interpolation Attention-Mechanismus zu, der eine Schlüsselrolle in der GinAR-Architektur spielt. In der ersten Phase ist es unser Ziel, den Vorwärtsdurchlauf dieses Algorithmus mithilfe von OpenCL zu implementieren und dabei eine effiziente parallele Verarbeitung auf dem Grafikbeschleuniger sicherzustellen.
Als Eingabe nimmt der InterpositionAttention-Kernel mehrere Arrays entgegen:
- die Eingabemerkmalsmatrix matrix_in,
- trainierbare Parameter W und A,
- latente Repräsentationen GL,
- Adjazenzmatrizen Adj,
- Zwischenrepräsentationen H,
- Attention-Werte Atten,
- die resultierende Matrix matrix_out.
Die Dimension des Merkmalsraums wird ebenfalls angegeben.
__kernel void InterpositionAttention(__global const float* matrix_in,
                                     __global const float* W,
                                     __global const float* A,
                                     __global const float* GL,
                                     __global float* Adj,
                                     __global float* H,
                                     __global float* Atten,
                                     __global float* matrix_out,
                                     const int dimension
                                    )
  {
   const size_t i = get_global_id(0);
   const size_t j = get_local_id(1);
   const size_t total = get_global_size(0);
   const size_t total_loc = get_local_size(1);
Zu Beginn der Ausführung definieren wir die globalen und lokalen Thread-Indizes i und j, die zum Durchlaufen der Elemente in den Eingabe- und Ausgabe-Arrays verwendet werden. Als Nächstes berechnen wir die entsprechenden Offsets, um einen korrekten Zugriff auf die Teilarrays innerhalb des globalen Puffers zu gewährleisten.
const int shift_i = i * dimension;
const int shift_j = j * dimension;
const int shift_adj = i * total_loc + j;
Der erste Schritt besteht darin, die Adjazenzgewichte zwischen zwei Knoten, i und j, zu berechnen, indem deren latente Repräsentationen aus dem GL-Array paarweise miteinander multipliziert werden.
float adj = 0;
for(int d = 0; d < dimension; d++)
   adj += IsNaNOrInf(GL[shift_i + d] * GL[shift_j + d], 0);
adj = max(IsNaNOrInf(adj, 0), 0);
adj = LocalSoftMax(adj, 1);
Adj[shift_adj] = adj;
adj += (float)(i == j);
Das Ergebnis wird in der Variablen adj akkumuliert, mithilfe der Funktion LocalSoftMax normalisiert und in der Adjazenzmatrix Adj gespeichert. Wenn i mit j übereinstimmt, wird adj um eins erhöht, wodurch sichergestellt wird, dass das Diagonalelement erhalten bleibt.
Als Nächstes fahren wir mit der Bildung der Zwischenrepräsentation H fort. Dazu werden die Eingabemerkmale des aktuellen Knotens Schritt für Schritt mit der trainierbaren Gewichtsmatrix W multipliziert. Jeder Wert wird im Array H gespeichert, und die Barriere BarrierLoc wird zur Synchronisation zwischen den Threads verwendet.
for(int id_h = 0; id_h < dimension; id_h += total_loc)
  {
   if(j >= (dimension - id_h))
      break;
   float h = 0;
   for(int w = 0; w < dimension; w++)
      h += IsNaNOrInf(matrix_in[shift_i + w] * W[(id_h + j) * dimension + w], 0);
   H[shift_i + id_h + j] = h;
   BarrierLoc;
  }
Sobald H gebildet wurde, wird der Attention-Wert e berechnet, der die Bedeutung der Interaktion zwischen den Knoten i und j bestimmt. Der Wert wird auf eine kleine positive Zahl gesetzt, um eine Division durch Null zu vermeiden. Besteht eine positive Korrelation zwischen den Elementen, werden die gewichteten Skalarprodukte zwischen den entsprechenden Zeilen von H und dem trainierbaren Vektor A akkumuliert. Das Ergebnis wird mithilfe der LocalSoftMax-Funktion erneut normalisiert und im Atten-Array gespeichert.
float e = 1e-12f;
if(adj > 0)
  {
   e = 0;
   for(int a = 0; a < dimension; a++)
      e += IsNaNOrInf(H[shift_i + a] * A[a], 0) + IsNaNOrInf(H[shift_j + a] * A[dimension + a], 0);
  }
e = LocalSoftMax(e, 1);
Atten[shift_adj] = e;
Der letzte Schritt besteht darin, den Wert der zu analysierenden Variablen auf der Grundlage von Informationen aus anderen beobachteten Variablen zu imputieren. Der Wert der fehlenden bzw. zu imputierenden Variablen i wird durch eine gewichtete Summe der Repräsentationen der Variablen j aggregiert, wobei die Repräsentationen selbst mit den entsprechenden Attention-Koeffizienten multipliziert werden. Diese Art der Aggregation ermöglicht es, nützliche Informationen von Nachbarknoten an die Zielvariable weiterzugeben.
 for(int d = 0; d < dimension; d += total_loc)
   {
    if(j >= (dimension - d))
       break;
    float out = 0;
    int shift_h = d + j;
    int shift_att = i * total_loc;
    int shift_out = i * dimension + shift_h;
    for(int n = 0; n < total_loc; n++)
       out += IsNaNOrInf(H[shift_h + n * dimension] * Atten[shift_att + n], 0);
    matrix_out[shift_out] = Activation(out, ActFunc_LReLU);
   }
}
Um die Robustheit gegenüber Ausreißern zu verbessern und die Auswirkungen anomaler Werte abzuschwächen, wird der resultierende Wert mithilfe der LReLU-Aktivierungsfunktion normalisiert. Dies trägt dazu bei, ein stabileres Modelltraining zu gewährleisten, insbesondere bei instabilen oder verrauschten Datensätzen.
Mit diesem Schritt wird der Vorwärtsdurchlauf von Interpolation Attention abgeschlossen und die endgültige Repräsentation der Variablen i gebildet, wobei sowohl die internen Beziehungen zwischen den Variablen als auch die gelernten Korrelationsparameter berücksichtigt werden.
Der hier beschriebene OpenCL-Kernel implementiert somit den Vorwärtsdurchlauf von Interpolation Attention und nutzt dabei Parallelität effektiv zur Verarbeitung der Elemente der Graphstruktur. Er ermöglicht die Erstellung eines adaptiven Modells der Wechselwirkungen zwischen Elementen in einer Zeitreihe auf der Grundlage latenter Merkmale, wodurch Kontext berücksichtigt werden kann und sich das Modell flexibel an die Datenstruktur anpassen lässt.
Der nächste Schritt unserer Arbeit besteht darin, den Algorithmus für den Rückwärtsdurchlauf von Interpolation Attention zu implementieren, den wir ebenfalls als OpenCL-Kernel bereitstellen werden. Diese Funktion berechnet die Gradienten für alle Parameter und Eingabedaten, die am Vorwärtsdurchlauf beteiligt sind.
Die Grundidee des Codes besteht darin, für jedes Element die partiellen Ableitungen des Fehlers in Bezug auf die Zwischenvariablen zu berechnen: die verborgenen Merkmale H, die Attention-Koeffizienten Atten, die Eingabematrizen, die Gewichte und die Merkmalsmatrix GL.
__kernel void InterpositionAttentionGrad(__global const float* matrix_in,
                                         __global float* matrix_in_gr,
                                         __global const float* W,
                                         __global float* W_gr,
                                         __global const float* A,
                                         __global float* A_gr,
                                         __global const float* GL,
                                         __global float* GL_gr,
                                         __global float* Adj,
                                         __global float* H,
                                         __global float* H_gr,
                                         __global float* Atten,
                                         __global float* matrix_out_gr,
                                         const int dimension
                                        )
  {
   const size_t i = get_global_id(0);
   const size_t j = get_local_id(1);
   const size_t total = get_global_size(0);
   const size_t total_loc = get_local_size(1);
Im Kernel findet für jeden Thread (gekennzeichnet durch die Indizes i und j) die folgende sequenzielle Berechnung statt:
- Die Gradienten in Bezug auf die verborgenen Merkmale Hgrad werden aus den Ausgabegradienten und den Attention-Gewichten berechnet, wobei die LeakyReLU-Aktivierungsfunktion berücksichtigt wird.
   const int shift_i = i * dimension;
   const int shift_j = j * dimension;
   const int shift_adj = i * total_loc + j;
//--- H Gradient
   for(int d = 0; d < dimension; d += total_loc)
     {
      if(j >= (dimension - d))
         break;
      float h_grad = 0;
      int shift_h = shift_i + d + j;
      int shift_att = i;
      int shift_out = d + j;
      for(int n = 0; n < total_loc; n++)
        {
         float gr = matrix_out_gr[shift_out + n * dimension];
         h_grad += IsNaNOrInf(
                      Deactivation(gr, gr, ActFunc_LReLU) * Atten[shift_att + n * total_loc], 0);
        }
      H_gr[shift_h] = h_grad;
      BarrierLoc;
     }
- Anschließend wird der Gradient in Bezug auf die Attention-Koeffizienten, Attgrad, berechnet und durch den SoftMax-Rückwärtsdurchlauf geleitet, um eine korrekte Fehlerweitergabe in der Attention-Verteilung sicherzustellen.
//--- Attention Gradient
   float att_grad = 0;
   for(int d = 0; d < dimension; d++)
     {
      float gr = matrix_out_gr[shift_i + d];
      gr = Deactivation(gr, gr, ActFunc_LReLU);
      att_grad += IsNaNOrInf(gr * H[shift_j + d], 0)
     }
   att_grad = LocalSoftMaxGrad(Atten[shift_adj], att_grad, 1);
- Dieser Gradient wird dann verwendet, um die Gradienten in Bezug auf die verborgenen Merkmale H unter Berücksichtigung der Gewichte in der Matrix A zu aktualisieren sowie um die Gradienten in Bezug auf die Matrix A selbst zu akkumulieren.
for(int d = 0; d < dimension; d++)
  {
   float h_grad = att_grad * A[d];
   h_grad = LocalSum(h_grad, 1);
   if(j == 0)
      H_gr[shift_i + d] += h_grad;
   h_grad = att_grad * A[dimension + d];
   h_grad = LocalSum(h_grad, 1);
   if(j == 0)
      H_gr[shift_j + d] += h_grad;
   float a_grad = att_grad * H[shift_i + d];
   a_grad = LocalSum(a_grad, 1);
   A_gr[d] += a_grad;
   a_grad = att_grad * H[shift_j + d];
   a_grad = LocalSum(a_grad, 1);
   A_gr[dimension + d] += a_grad;
  }
- Die Gradienten in Bezug auf die Eingabemerkmale werden anhand der Gradienten der verborgenen Merkmale und der Gewichtsmatrizen W ermittelt, wodurch die Eingabedaten während des Trainings korrekt aktualisiert werden können.
//--- Input Gradient
   for(int d = 0; d < dimension; d += total_loc)
     {
      if(j >= (dimension - id_h))
         break;
      float grad = 0;
      for(int w = 0; w < dimension; w++)
         grad += IsNaNOrInf(H_gr[shift_i + w] * W[(id_h + j) + dimension * w], 0);
      matrix_in_gr[shift_i + d + j] = grad;
      BarrierLoc;
     }
- Schließlich werden die Gradienten in Bezug auf die adaptive Matrix GL mittels des SoftMax-Rückwärtsdurchlaufs über die Adjazenzmatrix berechnet und sowohl für die Variable i als auch für die Variable j akkumuliert.
//--- Adj Gradient
   float grad = LocalSoftMaxGrad(Adj[shift_adj], att_grad, 1);
   for(int d = 0; d < dimension; d++)
     {
      GL_gr[shift_i + d] += IsNaNOrInf(grad * GL[shift_j + d], 0);
      GL_gr[shift_j + d] += IsNaNOrInf(grad * GL[shift_i + d], 0);
     }
  }
Die Gesamtstruktur der Funktion basiert auf lokaler Thread-Synchronisation (BarrierLoc), die die Korrektheit des Datenaustauschs zwischen den Threads gewährleistet und Race Conditions verhindert.
Dieser Ansatz gewährleistet präzise und stabile Aktualisierungen aller Modellparameter während des Trainings, ermöglicht eine effektive Anpassung der Gewichte und verbessert die Qualität der Imputation fehlender Werte in multivariaten Zeitreihen.
In dieser Phase schließen wir die Implementierung der Schlüsselkomponenten im OpenCL-Programm ab. Der nächste logische Schritt wird darin bestehen, den gesamten Prozess innerhalb des Hauptprogramms zu organisieren – Integration, Verwaltung der Berechnungen und Modelltraining mithilfe von MQL5-Tools. Allerdings ist der Umfang des Materials bereits erheblich gewachsen, und um die Übersichtlichkeit und die Qualität der Darstellung zu gewährleisten, schlage ich vor, dass wir eine Pause einlegen.
Wir werden diese wichtige Arbeit im nächsten Artikel fortsetzen, in dem wir die praktische Umsetzung des Algorithmus in MQL5, die Besonderheiten der Interaktion mit OpenCL sowie die Leistungsoptimierung ausführlich erörtern werden. Auf diese Weise können wir uns ohne Eile auf jede einzelne Phase konzentrieren und gleichzeitig die Tiefe und Gründlichkeit unserer Auseinandersetzung mit dem Thema wahren.
Fazit
Abschließend sei betont, dass das hier vorgestellte GinAR-Framework einen leistungsstarken Ansatz zur Prognose multivariater Zeitreihen mit fehlenden Werten darstellt. Die Integration von Interpolation Attention und adaptiver Graphkonvolution in eine rekursive Architektur ermöglicht eine effektive Imputation fehlender Daten und berücksichtigt komplexe raumzeitliche Abhängigkeiten.
Die in diesem Artikel vorgestellte praktische Umsetzung der Schlüsselkomponenten in OpenCL eröffnet eine Vielzahl von Möglichkeiten für die weitere Optimierung und Integration in reale Handelssysteme.
Zukünftige Arbeiten werden sich darauf konzentrieren, diese Entwicklungen in das Hauptprogramm in MQL5 zu integrieren, wodurch wir das volle Potenzial der vorgeschlagenen Methoden ausschöpfen können. Ich lade die Leser ein, sich im nächsten Artikel weiter mit diesem Thema zu beschäftigen.
Literaturverzeichnis
- GinAR: An End-to-End Multivariate Time Series Forecasting Model Suitable for Variable Missing
- Weitere Artikel dieser Reihe
In diesem Artikel verwendete Programme
| # | Name | Typ | Beschreibung |
|---|---|---|---|
| 1 | Study.mq5 | EA | Expert Advisor für das Offline-Modelltraining |
| 2 | StudyOnline.mq5 | EA | Expert Advisor für Online-Modelltraining |
| 3 | Test.mq5 | EA | Expert Advisor für Modelltests |
| 4 | Trajectory.mqh | Klassenbibliothek | Struktur zur Beschreibung des Systemzustands und der Modellarchitektur |
| 5 | NeuroNet.mqh | Klassenbibliothek | Klassenbibliothek zum Aufbau eines neuronalen Netzes |
| 6 | NeuroNet.cl | Bibliothek | Codebibliothek für ein OpenCL-Programm |
Übersetzt aus dem Russischen von MetaQuotes Ltd.
Originalartikel: https://www.mql5.com/ru/articles/18854
Warnung: Alle Rechte sind von MetaQuotes Ltd. vorbehalten. Kopieren oder Vervielfältigen untersagt.
Dieser Artikel wurde von einem Nutzer der Website verfasst und gibt dessen persönliche Meinung wieder. MetaQuotes Ltd übernimmt keine Verantwortung für die Richtigkeit der dargestellten Informationen oder für Folgen, die sich aus der Anwendung der beschriebenen Lösungen, Strategien oder Empfehlungen ergeben.

 Neuronale Netze im Trading: Ein Ende-zu-Ende-Modell für multivariate Zeitreihenprognose (Kernkomponenten)
 Neuronale Netze im Handel: Probabilistische Zeitreihenprognose (Fazit)
 Neuronale Netze im Handel: Ein End-to-End-Modell zur multivariaten Zeitreihenprognose (Fazit)
 Analyse der stündlichen Kursentwicklung von Symbolen und ihrer Spreads in MetaTrader 5

- Freie Handelsapplikationen
- Über 8.000 Signale zum Kopieren
- Wirtschaftsnachrichten für die Lage an den Finanzmärkte
Sie stimmen der Website-Richtlinie und den Nutzungsbedingungen zu.