

Neuronale Netze im Handel: Probabilistische Zeitreihenprognose (Encoder)
 24
 0

Einleitung
Wir setzen unsere Untersuchung des K²VAE-Frameworks fort – einer fortschrittlichen Architektur, die speziell für die Modellierung von Zeitreihen unter Bedingungen hoher Unsicherheit entwickelt wurde. Dieses Modell basiert auf einer Synthese aus drei Kernkonzepten: linearer Dynamik im latenten Raum (mithilfe von Koopman-Operatoren), adaptiver Fehlerfilterung (unter Verwendung von KalmanNet) und probabilistischer Modellierung (auf der Grundlage eines Variational Autoencoders). Dieser Ansatz ermöglicht es, gleichzeitig sowohl die Muster in den Daten als auch den Grad der Sicherheit in diesen Mustern zu berücksichtigen.
Der Hauptvorteil von K²VAE besteht nicht einfach darin, eine Prognose zu erstellen, sondern vielmehr darin, eine Wahrscheinlichkeitsverteilung der zukünftigen Zustände des Systems zu konstruieren. Im Gegensatz zu herkömmlichen Modellen, die auf ein einziges, wahrscheinlichstes Szenario beschränkt sind, liefert dieser Ansatz eine Bandbreite möglicher Ergebnisse. Zudem hängt die Breite dieses Bereichs davon ab, wie sicher das Modell hinsichtlich des aktuellen Zustands ist. Dadurch eignet sich das Framework besonders gut für Bereiche, in denen es wichtig ist, Risiken und Unsicherheit zu berücksichtigen – beispielsweise in der Finanzprognose, in der Logistik oder bei der Steuerung technischer Systeme.
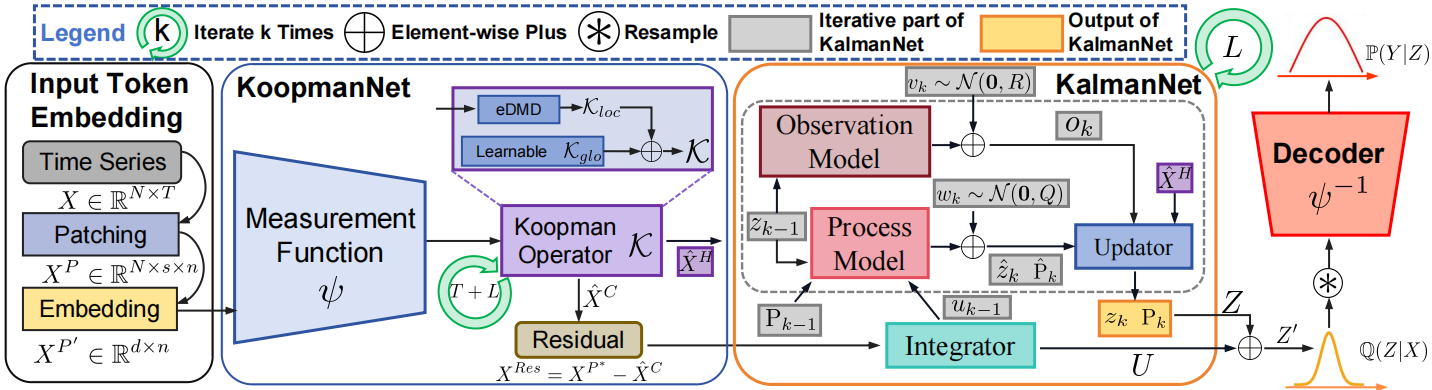
Um zu verstehen, wie diese Flexibilität und Anpassungsfähigkeit erreicht werden, wollen wir uns die Gesamtarchitektur des Modells genauer ansehen. Die K²VAE-Architektur lässt sich grob in drei Hauptkomponenten unterteilen: Patching, Encoder und Decoder, von denen jede ihre eigene Aufgabe erfüllt und gleichzeitig eng mit den anderen verbunden ist.
- Beim Patching werden die Eingabedaten aufbereitet und auf eine latente Repräsentation abgebildet.
- Der Encoder ist dafür zuständig, den verborgenen Zustand Z aus der beobachteten Zeitreihe X zu extrahieren. Im Gegensatz zu Standard-VAE-Modellen nutzt dieses Modell eine komplexe Architektur, die Folgendes umfasst:
- KoopmanNet, ein trainierbares Pendant zum Koopman-Operator, das die Entwicklung verborgener Merkmale als lineares System prognostiziert;
- Attention-Modul, das die Unterschiede zwischen rekonstruierten und tatsächlichen Werten analysiert und es so ermöglicht, Momente zu identifizieren, in denen das Modell von der Realität abweicht;
- KalmanNet, eine hybride neuronale Netzwerkimplementierung des Kalman-Filters, die auf der Grundlage von Attention-Steuersignalen eine Unsicherheits-Kovarianzmatrix bildet;
- Der VAE-Mechanismus, der zukünftige Token auf der Grundlage von Parametern sampelt, die von KalmanNet und KoopmanNet bereitgestellt werden.
- Der Decoder wandelt verborgene Variablen wieder in beobachtete Variablen um und rekonstruiert so die prognostizierten Werte der Zeitreihe. Um gleichzeitig den probabilistischen Charakter des Modells zu bewahren, wird der Decoder zudem als trainierbare neuronale Netzwerkstruktur mit zwei Ausgängen implementiert: Mittelwert und Varianz. Dadurch können wir die Verteilung P(Y|Z) vollständig modellieren und die Unsicherheit in der Prognose berücksichtigen.
Nachfolgend ist die vom Autor erstellte Darstellung des K²VAE-Frameworks abgebildet.
Im vorherigen Artikel haben wir uns auf die Grundlagen konzentriert: Wir haben die grundlegende Infrastruktur implementiert, die Wiederverwendbarkeit trainierbarer Matrizen sichergestellt und den Grundstein für eine robuste und skalierbare Architektur gelegt. Es wurden allgemein einsetzbare Klassen zur Generierung von Parametern erstellt, der Mechanismus zu deren Aktualisierung mittels standardmäßiger Backpropagation-Verfahren wurde debuggt, und eine für die weitere Erweiterung der Komponenten geeignete Struktur wurde beschrieben. Damit haben wir die Grundlage geschaffen, auf der wir nun komplexere Module entwickeln können.
Der nächste logische Schritt ist die Entwicklung des Encoders, der eine entscheidende Funktion erfüllt: Er wandelt die ursprüngliche Zeitreihe in eine verborgene latente Repräsentation um, die sich für lineare Analyse und probabilistische Modellierung eignet. Zudem wird dies nicht durch eine einfache Anordnung von Schichten erreicht, sondern durch eine sorgfältig konzipierte Struktur.
Diskussion der Entwurfsansätze
Bevor wir mit der praktischen Implementierung des Encoders in der Programmiersprache MQL5 beginnen, wollen wir uns zunächst seine Architektur und Entwurfslogik genauer ansehen. Dies wird uns nicht nur dabei helfen, uns in den folgenden Arbeitsschritten richtig zurechtzufinden, sondern auch zu verstehen, wie jedes Modul zum Gesamtverhalten des Modells beiträgt.
Der Encoder, der im K²VAE-Framework verwendet wird, ist modular aufgebaut und besteht aus vier miteinander verbundenen Komponenten, von denen jede eine genau definierte Funktion im Workflow der Zeitreihenverarbeitung erfüllt.
Das erste Element in der Verarbeitungskette ist KoopmanNet – eine auf einem neuronalen Netzwerk basierende Interpretation des Koopman-Operators; seine Hauptaufgabe besteht darin, die lineare Dynamik in einer Zeitreihe zu approximieren. Es nimmt einen verborgenen Zustand als Eingabe entgegen und gibt eine Prognose des nächsten Zustands zurück, wobei davon ausgegangen wird, dass das Verhalten des Systems als lineare Verschiebung in einem latenten Raum dargestellt werden kann. Da Zeitreihen in der Praxis jedoch selten einem streng linearen Verlauf folgen, reicht eine Projektion in den latenten KoopmanNet-Raum allein für eine zuverlässige Modellierung nicht aus. Damit das Modell nicht nur den Trend nachbilden, sondern auch seine eigene Genauigkeit bewerten kann, schlugen die Autoren des Frameworks einen äußerst originellen Mechanismus vor.
KoopmanNet wird nicht nur darauf trainiert, den nächsten Zustand zu prognostizieren, sondern auch darauf, bereits stattgefundene Übergänge zu rekonstruieren – im Wesentlichen also, die Trajektorie rückblickend anhand der vorherigen Werte der Zeitreihe zu rekonstruieren. Das Modell blickt also nicht nur nach vorn, sondern auch zurück, um zu überprüfen, inwieweit seine aktuellen Parameter mit früheren Beobachtungen übereinstimmen. Diese bidirektionale Betrachtungsweise ermöglicht es dem Modell, die Differenz zwischen der prognostizierten Dynamik und den tatsächlichen Zuständen des Systems zu berechnen.
Genau diese Abweichung (die Differenz zwischen den von KoopmanNet berechneten Übergängen und den tatsächlichen historischen Werten) dient als Grundlage für die Bewertung der Qualität der linearen Näherung. Auf diese Weise erhält das Modell die Fähigkeit zur Selbstdiagnose und kann sich dynamisch an Veränderungen oder Instabilitäten anpassen, ohne dabei den Bezug zur zugrunde liegenden linearen Struktur zu verlieren.
In der ursprünglichen Implementierung des K²VAE-Frameworks besteht das KoopmanNet-Modul aus zwei separaten, kleinen, vollständig verbundenen Modellen (MLPs), von denen jedes einen anderen Aspekt der Übergänge im latenten Raum modelliert: Das eine ist für globale Abhängigkeiten zuständig, das andere für lokale Abhängigkeiten. Dieser Ansatz ist aus theoretischer Sicht durchaus sinnvoll, könnte sich in der Praxis jedoch als zu starr und einschränkend erweisen – insbesondere bei volatilen Marktdaten.
Wir schlagen vor, KoopmanNet durch den Einsatz eines vielseitigeren und flexibleren Sparse-Mixture-of-Experts-Blocks zu erweitern — CNeuronTimeMoESparseExperts. Dies ist ein Modul aus dem TimeMoE-Framework, das das Mixture of Experts-Prinzip (MoE) umsetzt – einen Mechanismus, bei dem mehrere spezialisierte Teilmodelle (Experten) parallel arbeiten, während ein Steuerungsmechanismus anhand des Eingabekontextes das am besten geeignete Modell auswählt.
Der Sparse-Mixture-of-Experts-Block ist nicht nur eine technische Umsetzung – er bildet die logische Grundlage für die Trennung der lokalen und globalen Muster, die in Finanzzeitreihen vorkommen. In diesem Block kommen zwei Arten von Experten zum Einsatz. Zum einen handelt es sich um eine Gruppe spezialisierter lokaler Experten, von denen jeder für die Identifizierung kurzfristiger Übergänge und kontextabhängiger Muster zuständig ist. Diese Experten analysieren im Wesentlichen das Marktverhalten über begrenzte Zeiträume hinweg und passen sich dabei der aktuellen Volatilität und den Mikrotrends an.
Der zweite ist der globale Experte. Er ist in die Struktur CNeuronTimeMoESparseExperts integriert und fungiert als verallgemeinerter linearer Koopman-Operator. Sein Zweck besteht darin, die stabile, langfristige Dynamik einer Zeitreihe zu erfassen, indem die Muster identifiziert werden, die über das gesamte Trainingsfenster hinweg bestehen bleiben. Auf diese Weise erhält das Modell eine doppelte Perspektive auf die Daten: eine detaillierte lokale Analyse und eine umfassende strategische Perspektive.
Dank dieser Architektur kann KoopmanNet nicht nur den nächsten Zustand prognostizieren, sondern auch die vorangegangene Trajektorie rekonstruieren, indem es die Abfolge der Übergänge nachverfolgt, die zum aktuellen Zustand geführt haben. Durch den Vergleich der rekonstruierten Übergänge mit den tatsächlichen Werten kann das System die Genauigkeit seiner eigenen Näherung bewerten.
Sobald KoopmanNet die Rekonstruktion der Dynamik abgeschlossen und den nächsten Schritt prognostiziert hat, kommt das Attention-Modul ins Spiel; seine Aufgabe besteht nicht lediglich darin, die tatsächlichen und die modellierten Werte zu vergleichen, sondern die Abweichungen zwischen ihnen direkt zu analysieren. Im Gegensatz zum herkömmlichen Cross-Attention-Mechanismus, bei dem zwei Datenströme miteinander verglichen werden, konzentriert sich dieser Ansatz ausschließlich auf den Fehlertensor und identifiziert darin wiederkehrende Strukturen und Muster.
Die Autoren des K²VAE-Frameworks schlagen vor, diese Abweichungen nicht als Nebenprodukt, sondern als vollwertige Informationsquelle zu betrachten. Der Gedanke dahinter ist, dass die Fehler selbst ein Signal enthalten: Sie zeigen an, wo und in welchem Umfang es KoopmanNet gelingt, das System zu beschreiben, und welche lokalen Merkmale der Dynamik außerhalb des Geltungsbereichs des linearen Modells liegen. Attention ermöglicht es, aus diesen Fehlern einen Tensor von Steuersignalen zu extrahieren – eine Art Anweisung zur Anpassung der Prognosen in der nächsten Stufe.
Anstatt also lediglich Prognosen mit den tatsächlichen Ergebnissen zu vergleichen, lernt das Modell, seine eigenen Schwächen auf sinnvolle Weise zu interpretieren. Genau dieser Ansatz ist die Grundlage für die hohe Anpassungsfähigkeit und Intelligenz von K²VAE, wodurch es in der Lage ist, in einem sich verändernden, instabilen Umfeld effektiv zu arbeiten.
Im Rahmen der vorgeschlagenen Umsetzung können wir eines der Self-Attention-Module verwenden, die sich bereits in der Praxis bewährt haben und zuvor erfolgreich bei der Zeitreihenanalyse eingesetzt wurden. Dies beschleunigt nicht nur den Entwicklungsprozess erheblich, sondern gewährleistet auch die Kompatibilität mit den anderen Komponenten des Frameworks. Dieses Modul kann interne Regelmäßigkeiten in der Fehlerstruktur erkennen, indem es wiederkehrende Muster und lokale Abhängigkeiten zwischen Abweichungen über verschiedene Zeitintervalle hinweg ermittelt.
Es ist wichtig zu beachten, dass Self-Attention in diesem Zusammenhang nicht zur Verarbeitung der ursprünglichen Eingabesequenz verwendet wird, wie dies bei Standard-Transformern üblicherweise der Fall ist, sondern vielmehr zur Analyse von Rekonstruktionsfehlern, die bei der Rekonstruktion der Dynamik im KoopmanNet auftreten. Im Grunde verlagern wir den Fokus des Modells von den Daten selbst auf das Ergebnis seiner eigenen Arbeit, wodurch das System sich selbst von außen bewerten und aus seinen Fehlern nützliche Informationen gewinnen kann.
Bei der Umsetzung dieses Ansatzes ergibt sich jedoch eine interessante Besonderheit. Die Tiefe der analysierten Historie und der Planungshorizont, für den Steuersignale generiert werden, können unterschiedlich lang sein. In der ursprünglichen Version des Frameworks wird dieses Problem mithilfe einer linearen Projektion gelöst – einer kompakten Transformation, die es ermöglicht, den Steuervektor an den erforderlichen Planungshorizont anzupassen.
In unserem Fall ist die Situation etwas einfacher. Da das Modell so ausgelegt ist, dass es nur ein einziges nächstes Token generiert, benötigen wir keine Folge von Steuersignalen, sondern lediglich einen einzigen Vektor. Natürlich könnten wir dieselbe lineare Projektion verwenden. Wir schlagen jedoch vor, einen anderen Ansatz zu verfolgen – und den Fehler des letzten Tokens im Kontext der gesamten vorangegangenen Kette von Abweichungen zu betrachten.
Dieser Ansatz eröffnet neue Möglichkeiten. Anstatt einen Fehler als isolierte Größe zu betrachten, analysieren wir ihn im Zusammenhang mit der angesammelten Historie der Ungenauigkeiten. Auf diese Weise kann der Attention-Mechanismus ermitteln, welche konkreten Segmente der vergangenen Dynamik den größten Einfluss auf den aktuellen Fehler hatten. Das Ergebnis ist ein Steuervektor, der nicht nur auf die aktuelle Ungenauigkeit reagiert, sondern auch deren Ursachen widerspiegelt, die in den früheren Zuständen des Systems kodiert sind.
Diese Methode hat eine Reihe offensichtlicher Vorteile:
- Targeted Attention: Das Modell konzentriert sich auf den Fehler im letzten Schritt, anstatt die Ressourcen über die gesamte Trajektorie zu verteilen;
- Geringere Rechenlast: Es müssen nicht für jeden zukünftigen Schritt lange Vektoren generiert werden;
- Bessere Interpretierbarkeit: Das Steuersignal wird aussagekräftig und eignet sich für die visuelle Analyse und Diagnose.
Letztendlich erhalten wir einen flexiblen internen Steuerungsmechanismus, der in den Encoder integriert ist und es dem Modell ermöglicht, sich an seine eigenen Schwächen anzupassen und die Wahrscheinlichkeitsverteilung für den nächsten Schritt über KalmanNet und VAE mit größerer Konfidenz zu bilden. Dieser Ansatz macht die Architektur nicht nur robuster, sondern auch in ihrem Verhalten deutlich transparenter, was insbesondere unter Marktunsicherheit von großer Bedeutung ist.
Die nächste Komponente der Encoder-Architektur ist KalmanNet – ein Modul, das als adaptiver Kovarianzmatrix-Generator fungiert. Seine Aufgabe besteht nicht lediglich darin, Informationen weiterzugeben, sondern darin, die Zuverlässigkeit der von KoopmanNet erhaltenen linearen Prognose aktiv zu bewerten. Das vom Attention-Block kommende Steuersignal dient als eine Art Indikator für die Zuverlässigkeit des vorgelagerten Modells. Sind die Abweichungen gering und beständig, interpretiert KalmanNet dies als hohe Zuverlässigkeit und verengt dementsprechend die Kovarianzverteilung – in der Annahme, dass das weitere Verhalten der Zeitreihe mit hoher Wahrscheinlichkeit dem prognostizierten Szenario folgen wird. Werden jedoch erhebliche Ungleichgewichte oder strukturelle Verschiebungen in den Fehlern beobachtet, erweitert das Modell hingegen die Kovarianzmatrix und schafft so Raum für variablere, probabilistische Ergebnisse.
Somit fungiert KalmanNet effektiv als Zuverlässigkeitsindikator – eine Art Barometer, das sensibel auf Turbulenzen in den Daten reagiert. Es überträgt nicht nur Signale, sondern interpretiert sie auch und wandelt dabei kaum wahrnehmbare Schwankungen in eine mathematische Form um, die für die weitere Verwendung geeignet ist.
Die Verarbeitung im Encoder wird durch den Variational-Sampling-Block (VAE) abgeschlossen. Hier entsteht die endgültige latente Repräsentation des zukünftigen Zustands. Das Sampling erfolgt jedoch nicht blind – es folgt der in den vorangegangenen Stufen festgelegten Logik. Die Mittelwerte stammen von KoopmanNet – als Grundlage für die prognostizierte Dynamik –, während der Streuungsgrad durch die von KalmanNet generierte Kovarianzmatrix festgelegt wird. Dadurch erhalten wir keine Punktprognose, sondern ein probabilistisches Modell, das sowohl die lineare Struktur der Zeitreihe als auch den stochastischen Charakter des Marktes berücksichtigt.
Dieser Ansatz bietet einen klaren strategischen Vorteil. So kann das Modell auch unter Unsicherheit flexibel bleiben, ohne sich auf ein einziges Entwicklungsszenario festzulegen, und passt sein Zuverlässigkeitsniveau stattdessen an den jeweiligen Kontext an. Dadurch eignet sich das Framework besonders gut für Anwendungen, bei denen eine dynamische Entscheidungsfindung auf der Grundlage von Risiko- und Zuverlässigkeitsbewertungen wichtiger ist als die Prognose nachfolgender Zustände.
Um den Grad der Unsicherheit und das Ausmaß des potenziellen Risikos zu verdeutlichen, beschränken wir uns in unserer Umsetzung nicht auf eine einzige Prognose. Stattdessen erzeugen wir per Sampling eine festgelegte Anzahl möglicher Szenarien dafür, wie sich die Zeitreihe im nächsten Schritt entwickeln kann. Jedes dieser Szenarien ist eine separate Trajektorie, die auf Grundlage der gemeinsamen, von KoopmanNet und KalmanNet gebildeten Verteilung generiert wird. Dieser Ansatz ermöglicht es uns, nicht nur einen gemittelten Schätzwert zu erhalten, sondern ein gesamtes Spektrum wahrscheinlicher Ergebnisse abzudecken und so aufzuzeigen, wie robust das Modell die Zukunft prognostiziert.
Insgesamt bildet das Zusammenspiel zwischen KoopmanNet, dem Attention-Block, KalmanNet und VAE eine komplexe und doch überraschend logische Struktur, in der jede Komponente ihre eigene Rolle bei der Erstellung einer zuverlässigen und adaptiven Darstellung der Zukunft spielt.
Objektstruktur
Nach einer ausführlichen Erörterung der Architekturprinzipien und der Logik des Zusammenspiels der Komponenten innerhalb des Encoders von K²VAE ist es nun an der Zeit, uns mit dessen praktischer Umsetzung zu befassen. Um Modularität, Flexibilität und die Lesbarkeit des Codes zu gewährleisten, haben wir alle wesentlichen Elemente in einem einzigen Objekt der Klasse CNeuronK2VAEEncoder zusammengefasst, das seine Kernfunktionalität von CNeuronBaseOCL erbt.
Dieses Objekt umfasst alles, was für den gesamten Betriebszyklus des Encoders erforderlich ist – von der Analyse der Dynamik der Zeitreihe mithilfe von KoopmanNet über die Erstellung der Kovarianzstruktur zukünftiger Zustände in KalmanNet bis hin zum Sampling probabilistischer Prognosen über den VAE-Mechanismus. Das Objekt umfasst spezialisierte Komponenten wie das Koopman-Netzwerk, den Attention-Block und den Kalman-Filter sowie technische Schichten für Transformationen, lineare Operationen und Matrixberechnungen.
Nachfolgend ist der Aufbau der Klasse CNeuronK2VAEEncoder dargestellt, wobei jede Komponente eine bestimmte Funktion innerhalb des Gesamtprozesses der Codierung der beobachteten Sequenz erfüllt. Diese Implementierung ermöglicht eine schrittweise Analyse und Fehlerbehebung auf jeder Ebene der Modelltiefe und bietet zudem erweiterte Skalierungsmöglichkeiten bei der Arbeit mit verschiedenen Architekturkonfigurationen und unterschiedlichen Analysetiefen.
class CNeuronK2VAEEncoder   :  public CNeuronBaseOCL
  {
protected:
   //--- Koopman
   CNeuronTimeMoESparseExperts   cKoopman;
   CNeuronBaseOCL                cKoopmanPred;
   CNeuronBaseOCL                cKoopmanRest;
   //---
   CNeuronTimeMoEAttention       cAuxiliaryNet;
   //--- Kalman Filter
   CParams              cB;      // Control input matrix B
   CParams              cF;      // State transition matrix F
   CParams              cH;      // Observation matrix H
   CParams              cQ;      // Learnable covariance matrices Q
   CParams              cR;      // Learnable covariance matrices R
   CNeuronBaseOCL       cP;      // Covariance matrices P
   //---
   CNeuronTransposeOCL  cFT;
   CNeuronTransposeOCL  cHT;
   CNeuronTransposeOCL  cQT;
   CNeuronTransposeOCL  cRT;
   CNeuronTransposeOCL  cPT;
   //---
   CNeuronBaseOCL       cQ_QT;
   CNeuronBaseOCL       cR_RT;
   CNeuronBaseOCL       cXPred;
   CNeuronBaseOCL       cF_P;
   CNeuronBaseOCL       cPPred;
   //---
   CNeuronBaseOCL       cP_HT;
   CNeuronBaseOCL       cH_P_HT;
   matrix<double>       mS, mSGrad;
   CNeuronBaseOCL       cSInv;
   CNeuronBaseOCL       cK;
   CNeuronTransposeOCL  cKT;
   CNeuronBaseOCL       cYPred;
   CNeuronBaseOCL       cDeltY;
   CNeuronBaseOCL       cX;
   CNeuronBaseOCL       cK_H;
   CNeuronBaseOCL       cIdifK_H;
   CNeuronTransposeOCL  cIdifK_HT;
   matrix<double>       mP;
   matrix<double>       mPGrad;
   matrix<double>       mNoise;
   matrix<double>       mGrad;
   //---
   virtual bool      feedForward(CNeuronBaseOCL *NeuronOCL) override;
   virtual bool      updateInputWeights(CNeuronBaseOCL *NeuronOCL) override;
   virtual bool      calcInputGradients(CNeuronBaseOCL *NeuronOCL) override;

public:
                     CNeuronK2VAEEncoder(void) {};
                    ~CNeuronK2VAEEncoder(void) {};
   //---
   virtual bool      Init(uint numOutputs, uint myIndex, COpenCLMy *open_cl,
                          uint window, uint window_key, uint units_cross,
                          uint heads, uint layers, uint scenarios,
                          uint experts, uint experts_dimension, uint topK,
                          ENUM_OPTIMIZATION optimization_type, uint batch);
   //---
   virtual bool      Save(const int file_handle) override;
   virtual bool      Load(const int file_handle) override;
   //---
   virtual int       Type(void)        const                      {  return defNeuronK2VAEEncoder; }
   virtual void      TrainMode(bool flag) override;
   virtual void      SetOpenCL(COpenCLMy *obj);
   //---
   virtual bool      WeightsUpdate(CNeuronBaseOCL *source, float tau);
  };
Bei der Struktur der hier vorgestellten neuen Klasse sollte besonderes Augenmerk auf die Schlüsselkomponenten gelegt werden, die die Logik der gesamten Encoder-Architektur widerspiegeln. Als KoopmanNet kommt ein leistungsstarkes CNeuronTimeMoESparseExperts-Modul zum Einsatz, das die lokale Flexibilität einer Sparse Mixture of Experts mit der Stabilität eines globalen Prädiktors verbindet. Diese Lösung ermöglicht es, sowohl kurzfristige als auch persistente Dynamik in Zeitreihen effektiv zu modellieren.
CNeuronTimeMoEAttention wird als Attention-Modul verwendet und ist für die Analyse der Struktur von Rekonstruktionsfehlern zuständig. Es identifiziert Muster in den Abweichungen und bildet Steuermerkmale zur Bewertung der Zuverlässigkeit der KoopmanNet-Prognosen.
Der Kalman-Filterblock nimmt in der Implementierung eine besondere Stellung ein. Hier sehen wir die trainierbaren Matrizen B, F, H, Q und R, von denen jede als separate Instanz der Klasse CParams repräsentiert wird. Dieser Ansatz ermöglicht nicht nur eine zentralisierte Verwaltung der Filterparameter, sondern stellt auch sicher, dass diese während des Trainings vollständig angepasst werden können.
Neben diesen Komponenten enthält die Klassenstruktur zudem zahlreiche Hilfsobjekte, die die korrekte Umsetzung der schrittweisen Logik von KalmanNet gewährleisten und eine effiziente Verwaltung aller Tensoroperationen innerhalb des Encoders ermöglichen. Auf die Funktionsweise von Hilfsobjekten wird im Rahmen der Implementierung der Methoden der Klasse noch näher eingegangen.
Die interne Organisation der Klasse CNeuronK2VAEEncoder setzt eine statische Deklaration aller von ihr verwendeten Komponenten voraus. Diese Lösung vereinfacht den Lebenszyklus des Objekts: Wir müssen Speicher nicht manuell zuweisen und wieder freigeben. Folglich können der Konstruktor und der Destruktor der Klasse leer bleiben, ohne den Code mit unnötiger Logik zu überfrachten.
Die gesamte Einrichtung der Architektur, einschließlich der Konfiguration von KoopmanNet, der Attention-Parameter und der Parameter des Kalman-Filters, erfolgt vollständig innerhalb der Init-Methode. An dieser Stelle nimmt das Objekt seine konkrete Form an: Die Attention-Parameter werden konfiguriert, die Dimensionen der Steuermerkmale festgelegt und die Anzahl der Experten, die Tiefe des Eingabefensters sowie weitere entscheidend wichtige Modelleigenschaften eingestellt.
bool CNeuronK2VAEEncoder::Init(uint numOutputs, uint myIndex, COpenCLMy * open_cl,
                               uint window, uint window_key, uint units_cross,
                               uint heads, uint layers, uint scenarios,
                               uint experts, uint experts_dimension, uint topK,
                               ENUM_OPTIMIZATION optimization_type, uint batch)
  {
   if(!CNeuronBaseOCL::Init(numOutputs, myIndex, open_cl, window * scenarios, optimization_type, batch))
      return false;
In der ersten Phase wird die Steuerung an die gleichnamige Funktion in der Basisklasse übergeben. Dadurch ist es möglich, die bereits implementierten Mechanismen zur grundlegenden Validierung von Eingabeparametern zu nutzen sowie geerbte Schnittstellen und gemeinsam genutzte Komponenten zu initialisieren. Dieser Ansatz gewährleistet einen einheitlichen Initialisierungsstandard für alle neuronalen Schichten und vereinfacht so die Wartung und Erweiterung der Architektur.
Das Thema der Speicherorganisation verdient besondere Beachtung. Da der K²VAE-Encoder in unserer Implementierung nicht einen einzelnen Vektor, sondern eine Menge möglicher zukünftiger Szenarien zurückgibt, die durch Sampling erzeugt wurden, muss der Ergebnispuffer entsprechend dimensioniert werden.
Als Nächstes fahren wir mit der Initialisierung des KoopmanNet-Blocks fort, der in unserer Implementierung durch das Modul CNeuronTimeMoESparseExperts dargestellt wird. Wir initialisieren das Modul „Sparse Mixture of Experts“, indem wir die Anzahl der Modelle und deren Dimensionalität festlegen. Diese Komponente ist dafür zuständig, sowohl lokale als auch globale Muster aus einer Zeitreihe zu extrahieren, indem sie das Verhalten von Koopman-Operatoren simuliert.
//--- Koopman
   int index = 0;
   if(!cKoopman.Init(0, index, OpenCL, window, 2 * window, units_cross, 1, experts, topK, optimization, iBatch))
      return false;
   index++;
   if(!cKoopmanPred.Init(0, index, OpenCL, window, optimization, iBatch))
      return false;
   index++;
   if(!cKoopmanRest.Init(0, index, OpenCL, window * (units_cross - 1), optimization, iBatch))
      return false;
Als Nächstes initialisieren wir zwei Hilfsobjekte: cKoopmanPred und cKoopmanRest. Das erste dient zur Speicherung der von KoopmanNet berechneten Prognosewerte, das zweite zur Rekonstruktion der bereits beobachteten Zustände der Zeitreihe.
Der nächste Schritt besteht darin, das Attention-Modul zu initialisieren, das in unserer Implementierung durch das Objekt cAuxiliaryNet repräsentiert wird.
index++;
if(!cAuxiliaryNet.Init(0, index, OpenCL, window, window_key, 1, window, units_cross - 1,
                                                   heads, layers, optimization, iBatch))
   return false;
Ein wesentlicher Bestandteil der neuen klasseninternen Architektur betrifft jedoch die Organisation der Funktionsweise des Kalman-Filters: Hier bündeln sich der Großteil der Berechnungen und der größte Teil der in der Init-Methode implementierten Logik.
Im ersten Schritt initialisieren wir nacheinander die quadratischen Matrizen der trainierbaren Parameter des Filters: die Zustandsübergangsmatrizen F, die Steuereingangsmatrizen B, die Beobachtungsmatrizen H sowie die Kovarianzmatrizen für Modellfehler Q und Beobachtungsfehler R.
//--- Kalman Filter
   index++;
   if(!cB.Init(0, index, OpenCL, window * window, optimization, iBatch) ||
      !cB.Identity(window, window))
      return false;
   index++;
   if(!cF.Init(0, index, OpenCL, window * window, optimization, iBatch) ||
      !cF.Identity(window, window))
      return false;
   index++;
   if(!cH.Init(0, index, OpenCL, window * window, optimization, iBatch) ||
      !cH.Identity(window, window))
      return false;
   index++;
   if(!cQ.Init(0, index, OpenCL, window * window, optimization, iBatch) ||
      !cQ.Identity(window, window))
      return false;
   index++;
   if(!cR.Init(0, index, OpenCL, window * window, optimization, iBatch) ||
      !cR.Identity(window, window))
      return false;
   index++;
   if(!cP.Init(0, index, OpenCL, window * window, optimization, iBatch) ||
      !cP.getOutput().Fill(matrix<float>::Identity(window, window)))
      return false;
Bei der Initialisierung jeder dieser Matrizen werden deren Dimensionen festgelegt. Um die numerische Stabilität des Kalman-Filters während der ersten Trainingsiterationen zu gewährleisten, werden anschließend alle diese Matrizen mit Diagonalwerten initialisiert. Diese Initialisierung stellt sicher, dass die Kovarianzmatrizen positiv definit sind, und verhindert Instabilitäten bei den Berechnungen im Zusammenhang mit der Inversion der Matrix S während der Prognosekorrektur.
Der Ansatz der diagonalen Initialisierung stabilisiert nicht nur die Anfangsphasen des Trainings, sondern stellt auch sicher, dass das Modell gegenüber den verschiedenen Komponenten des latenten Zustands gleichmäßig empfindlich ist. Dies ist von entscheidender Bedeutung bei der Arbeit mit Zeitreihen, in denen dominante Trends schwache, aber signifikante Signale überdecken können.
Der nächste Schritt besteht darin, die Objekte vorzubereiten, die für die Transponierung der entsprechenden Matrizen zuständig sind. Dies ist ein wichtiges und auf den ersten Blick technisches Detail, steht jedoch in direktem Zusammenhang mit dem ordnungsgemäßen Funktionieren des gesamten Algorithmus. Das liegt daran, dass wir bei den Berechnungen des Kalman-Filters immer wieder nicht nur auf die Matrizen F, H, Q, R und P selbst, sondern auch auf deren transponierte Versionen zurückgreifen müssen. Um dies zu gewährleisten, legen wir die entsprechenden Transponierungsobjekte im Voraus an und initialisieren sie.
index++;
if(!cFT.Init(0, index, OpenCL, window, window, optimization, iBatch))
   return false;
index++;
if(!cHT.Init(0, index, OpenCL, window, window, optimization, iBatch))
   return false;
index++;
if(!cQT.Init(0, index, OpenCL, window, window, optimization, iBatch))
   return false;
index++;
if(!cRT.Init(0, index, OpenCL, window, window, optimization, iBatch))
   return false;
index++;
if(!cPT.Init(0, index, OpenCL, window, window, optimization, iBatch))
   return false;
Auf diese Weise wird eine Art Pufferung für die transponierten Darstellungen implementiert, die die Berechnungen erheblich beschleunigt und die Codestruktur im Hauptteil des Filteralgorithmus vereinfacht. Zudem wird dadurch die Modularität der Architektur verbessert, da jedes Filterelement unabhängig behandelt werden kann, ohne die gesamte Ausführungslogik zu beeinträchtigen.
Besondere Aufmerksamkeit sollte den Rauschkovarianzmatrizen gelten: Q (Prozesskovarianz) und R (Beobachtungskovarianz). Damit der Kalman-Filter-Algorithmus korrekt funktioniert, müssen diese Matrizen zwei wesentliche Eigenschaften aufweisen: Sie müssen bezüglich der Hauptdiagonalen symmetrisch und positiv definit sein. Werden diese Bedingungen nicht erfüllt, kann dies zu instabiler Filterung, zum Auftreten imaginärer Werte bei der Matrixinversion oder zu einer vollständigen Degeneration der Zustandsschätzung führen.
Um sicherzustellen, dass diese Eigenschaften während des Trainings erhalten bleiben, wenden wir eine bewährte und weitverbreitete Methode an: Wir stellen die Matrizen Q und R als Produkt der jeweiligen Matrix und ihrer Transponierten dar. Durch diese Darstellung werden die resultierenden Matrizen automatisch symmetrisch und positiv definit, es sei denn, die ursprüngliche Matrix ist singulär. Dadurch entfällt die Notwendigkeit, die Diagonalelemente manuell zu überwachen oder eine Regularisierung vorzunehmen.
index++;
if(!cQ_QT.Init(0, index, OpenCL, window * window, optimization, iBatch))
   return false;
index++;
if(!cR_RT.Init(0, index, OpenCL, window * window, optimization, iBatch))
   return false;
Der nächste Schritt bei der Konfiguration des Encoders besteht darin, die Objekte zu initialisieren, in denen die Zwischenergebnisse der Berechnungen gespeichert werden. Diese Objekte spielen eine zentrale Rolle bei der schrittweisen Umsetzung des Kalman-Filter-Algorithmus, bei dem jede Berechnung auf den Ergebnissen der vorherigen Operationen basiert. Außerdem werden wir diese Werte während des Rückwärtsdurchlaufs verwenden, um sicherzustellen, dass der Fehlergradient korrekt verteilt wird.
Zunächst initialisieren wir das cXPred-Objekt, in dem der prädizierte Zustand des Systems vor der Anwendung des Korrekturschritts gespeichert wird.
index++;
if(!cXPred.Init(0, index, OpenCL, window, optimization, iBatch))
   return false;
index++;
if(!cF_P.Init(0, index, OpenCL, window * window, optimization, iBatch))
   return false;
index++;
if(!cPPred.Init(0, index, OpenCL, window * window, optimization, iBatch))
   return false;
Als Nächstes initialisieren wir die Objekte cF_P und cPPred, die jeweils das Produkt aus der Zustandsübergangsmatrix und der Kovarianzmatrix sowie die prädizierte Kovarianz speichern. Diese Daten werden für nachfolgende Schritte benötigt, in denen die Zuverlässigkeit der Prognose bewertet wird.
Als Nächstes werden die Blöcke cP_HT und cH_P_HT nacheinander konfiguriert; sie berechnen Zwischenwerte bei der Berechnung der S-Matrix – der Kovarianz des Beobachtungsprognosefehlers.
   index++;
   if(!cP_HT.Init(0, index, OpenCL, window * window, optimization, iBatch))
      return false;
   index++;
   if(!cH_P_HT.Init(0, index, OpenCL, window * window, optimization, iBatch))
      return false;
//---
   mS = mSGrad = matrix<double>::Zeros(window, window);
Gleichzeitig werden die Matrizen mS und mSGrad erstellt und initialisiert; sie dienen dazu, während des Trainings die Kovarianzwerte selbst sowie die entsprechenden Gradienten zu speichern.
Das Objekt cSInv dient zur Speicherung der Inversen der S-Matrix, die zur Berechnung der Kalman-Verstärkung cK benötigt wird; diese Verstärkung hat zudem eine eigene Transponierte, cKT.
   index++;
   if(!cSInv.Init(0, index, OpenCL, window * window, optimization, iBatch))
      return false;
   index++;
   if(!cK.Init(0, index, OpenCL, window * window, optimization, iBatch))
      return false;
   index++;
   if(!cKT.Init(0, index, OpenCL, window, window, optimization, iBatch))
      return false;
//---
   index++;
   if(!cYPred.Init(0, index, OpenCL, window, optimization, iBatch))
      return false;
//---
   index++;
   if(!cDeltY.Init(0, index, OpenCL, window, optimization, iBatch))
      return false;
Anschließend werden der cYPred-Block – der die beobachteten Werte prognostiziert – und der cDeltY-Block – der die Differenz zwischen der Prognose und der tatsächlichen Beobachtung darstellt – initialisiert.
Besondere Aufmerksamkeit gilt dem Objekt cX, das den endgültigen, korrigierten Zustand nach Anwendung des Kalman-Filters speichert.
   index++;
   if(!cX.Init(0, index, OpenCL, window, optimization, iBatch))
      return false;
//---
   index++;
   if(!cK_H.Init(0, index, OpenCL, window * window, optimization, iBatch))
      return false;
//---
   index++;
   if(!cIdifK_H.Init(0, index, OpenCL, window * window, optimization, iBatch))
      return false;
//---
   index++;
   if(!cIdifK_HT.Init(0, index, OpenCL, window, window, optimization, iBatch))
      return false;
Darauf folgen cK_H, cIdifK_H und cIdifK_HT, die dazu dienen, die Ergebnisse der mathematischen Transformationen zu erfassen, die für eine korrekte Backpropagation des Fehlers und die Aktualisierung der Kovarianzschätzungen erforderlich sind.
Abschließend initialisieren wir die Matrizen mP und mPGrad sowie die Hilfsarrays mNoise und mGrad, die zur Erzeugung von Rauschen während der Sampling-Phase und zur Berechnung von Gradienten während des Modelltrainings verwendet werden.
   mP = mPGrad = mS;
   mNoise = mGrad = matrix<double>::Zeros(scenarios, window);
//---
   return true;
  }
Somit wird in dieser Phase eine vollwertige Recheninfrastruktur aufgebaut, um den stabilen und korrekten Betrieb des Kalman-Filters innerhalb des Encoders von K²VAE sicherzustellen. Nachdem alle internen Komponenten erfolgreich initialisiert wurden, wird die Initialisierungsmethode beendet und gibt ein boolesches Ergebnis an das aufrufende Programm zurück, das den Ausgang der Operationen angibt.
Organisation des Vorwärtsdurchlaufs
Wenn wir nun von der Initialisierung der Speicherobjekte zur Beschreibung der Methode des Vorwärtsdurchlaufs feedForward übergehen, tauchen wir tief in die Rechenlogik des Encoders von K²VAE ein. Hier werden alle zuvor vorbereiteten Komponenten zu einem einzigen System zusammengeführt. Die gesamte Struktur beginnt, wie ein gut abgestimmter Mechanismus, zu arbeiten und wandelt die ursprünglichen Beobachtungen in interne Repräsentationen um.
Der Vorwärtsdurchlauf beginnt mit dem Koopman-Block – einer Schlüsselkomponente des Modells, die während des Trainings die lineare Dynamik des Systems erlernt. Während der Inferenz erzeugt dieses Modul im Rahmen des Vorwärtsdurchlaufs eine Reihe von Rekonstruktionen und einen einzelnen prädizierten Zustand auf Grundlage der analysierten Sequenz und der zuvor erlernten linearen Struktur der Änderungen. Somit besteht seine Ausgabe aus zwei wichtigen Komponenten: erstens einer Prognose des zukünftigen Zustands, die ausschließlich auf der jüngsten Beobachtung und den erlernten linearen Mustern basiert; und zweitens einer Rekonstruktion der gesamten Folge früherer Zustände, die bis zur Tiefe der historischen Datenanalyse zurückreicht.
bool CNeuronK2VAEEncoder::feedForward(CNeuronBaseOCL * NeuronOCL)
  {
//--- Koopman
   if(!cKoopman.FeedForward(NeuronOCL))
      return false;
//--- Pred / Rest
   if(!DeConcat(cKoopmanPred.getOutput(), cKoopmanRest.getPrevOutput(), cKoopman.getOutput(),
                cKoopman.GetWindow(), cKoopman.Neurons() - cKoopman.GetWindow(), 1))
      return false;
   if(!Different(NeuronOCL.getOutput(), cKoopmanRest.getPrevOutput(),
                 cKoopmanRest.getOutput(), cKoopman.GetWindow()))
      return false;
Diese Trennung ist besonders wichtig: Die Prognose wird im Kalman-Filter-Block verwendet, während die Residuenfolge (die Differenz zwischen den tatsächlichen Daten und ihrer Rekonstruktion) an das Attention-Modul weitergeleitet wird, das jene Aspekte der Dynamik verarbeitet, die nicht in das lineare Modell passen.
//--- Rest Attention
   if(!cAuxiliaryNet.FeedForward(cKoopmanRest.AsObject()))
      return false;
Wenn sich das Modell im Trainingsmodus befindet, werden anschließend alle trainierbaren Komponenten des Kalman-Filters aktiviert. Dies sind die Zustandsübergangs-, Steuereingangs- und Beobachtungsmatrizen sowie die Kovarianzmatrizen für Modell- und Messfehler.
//--- Kalman Filter
   if(bTrain)
     {
      if(!cB.FeedForward())
         return false;
      if(!cF.FeedForward())
         return false;
      if(!cH.FeedForward())
         return false;
      if(!cQ.FeedForward())
         return false;
      if(!cR.FeedForward())
         return false;
      if(!cFT.FeedForward(cF.AsObject()))
         return false;
      if(!cHT.FeedForward(cH.AsObject()))
         return false;
      if(!cQT.FeedForward(cQ.AsObject()))
         return false;
      if(!cRT.FeedForward(cR.AsObject()))
         return false;
Da die Matrizen Q und R positiv definit sein müssen, damit der Filter korrekt funktioniert, werden sie zunächst stabilisiert, indem sie mit ihren eigenen Transponierten multipliziert werden.
 if(!MatMul(cQ.getOutput(), cQT.getOutput(), cQ_QT.getOutput(),
            cQT.GetCount(), cQT.GetWindow(), cQT.GetCount(), 1, true))
    return false;
 if(!MatMul(cR.getOutput(), cRT.getOutput(), cR_RT.getOutput(),
            cRT.GetCount(), cRT.GetWindow(), cRT.GetCount(), 1, true))
    return false;
}
Sobald alle Parameter vorbereitet sind, beginnt die Prognosephase. Zunächst wird die Prognose des Zustands für den nächsten Schritt berechnet, indem zwei Informationsströme – die Eingabedaten und die Ausgabe des Attention-Moduls – kombiniert werden. Diese Vektoren werden unter Verwendung der trainierbaren Parametermatrizen F und B projiziert und anschließend addiert. Dadurch entsteht der Zwischenzustand XPred.
//--- Prediction step
   if(!MatMul(NeuronOCL.getOutput(), cFT.getOutput(), cXPred.getGradient(),
              1, cFT.GetWindow(), cFT.GetCount(), 1, true))
      return false;
   if(!MatMul(cAuxiliaryNet.getOutput(), cB.getOutput(), cXPred.getPrevOutput(),
              1, cFT.GetWindow(), cFT.GetCount(), 1, true))
      return false;
   if(!SumAndNormilize(cXPred.getGradient(), cXPred.getPrevOutput(), cXPred.getOutput(),
                       cFT.GetCount(), false, 0, 0, 0, 1))
      return false;
Anschließend wird die prädizierte Kovarianz des Zustandsfehlers berechnet. Dazu werden die Zustandsübergangsmatrix und die aktuelle Kovarianzmatrix nacheinander multipliziert und anschließend die Modellrauschmatrix Q addiert, wodurch die prädizierte Kovarianz P_pred erzeugt wird.
if(!MatMul(cF.getOutput(), cP.getOutput(), cF_P.getOutput(),
           cFT.GetCount(), cFT.GetWindow(), cP.Neurons() / cFT.GetWindow(), 1, true))
   return false;
if(!MatMul(cF_P.getOutput(), cFT.getOutput(), cPPred.getOutput(),
           cFT.GetCount(), cFT.GetWindow(), cFT.GetCount(), 1, true))
   return false;
if(!SumAndNormilize(cPPred.getOutput(), cQ_QT.getOutput(), cPPred.getOutput(),
                    cHT.GetWindow(), false, 0, 0, 0, 1))
   return false;
An dieser Stelle beginnt die Prognoseanpassung – und genau das macht den Kalman-Filter so besonders wertvoll. Zunächst wird die Kovarianz des Messfehlers berechnet und eine Matrix S gebildet, die die Summe aus der beobachteten Varianz und der prädizierten Varianz darstellt.
//--- Update step
   if(!MatMul(cPPred.getOutput(), cHT.getOutput(), cP_HT.getOutput(),
              cPPred.Neurons() / cHT.GetWindow(), cHT.GetWindow(), cHT.GetCount(), 1, true))
      return false;
   if(!MatMul(cH.getOutput(), cP_HT.getOutput(), cH_P_HT.getOutput(),
              cHT.GetCount(), cHT.GetWindow(), cHT.GetCount(), 1, true))
      return false;
   if(!SumAndNormilize(cH_P_HT.getOutput(), cR_RT.getOutput(), cR_RT.getPrevOutput(),
                       cRT.GetWindow(), false, 0, 0, 0, 1))
      return false;
Zur Berechnung der Kalman-Verstärkung K, die als Gewichtungskoeffizient bei der Zustandskorrektur dient, wird die Inverse der Matrix S verwendet. Wir haben beschlossen, keinen Algorithmus zur Matrixinversion von Grund auf neu zu entwickeln. Stattdessen haben wir die vorhandene Funktionalität für Matrixoperationen in MQL5 genutzt. Falls erforderlich, wird die Matrix stabilisiert, diagonalisiert und rekonstruiert, um Singularität zu vermeiden.
if(cR_RT.getPrevOutput().GetData(mSGrad) <= 0)
   return false;
mS = mSGrad.Inv();
if(mS.Rows() == 0)
  {
   mSGrad = mSGrad + mSGrad.Transpose();
   vector<double> eigvals;
   matrix<double> eigvecs;
   if(!mSGrad.Eig(eigvecs, eigvals))
      return false;
   if(eigvals.Size() > 0)
     {
      if(!eigvals.Clip(1e-6, DBL_MAX))
         return false;
      mSGrad = matrix<double>::Zeros(eigvals.Size(), eigvals.Size());
      mSGrad.Diag(eigvals);
      mSGrad = eigvecs.MatMul(mSGrad.MatMul(eigvecs.Transpose()));
      mSGrad = mSGrad + mSGrad.Transpose();
      mS = mSGrad.Inv();
     }
   if(mS.Rows() == 0)
     {
      mSGrad.Identity();
      mS = mSGrad;
     }
  }
cSInv.getOutput().Fill(mS);
if(!MatMul(cP_HT.getOutput(), cSInv.getOutput(), cK.getOutput(),
           cHT.GetCount(), (int)mS.Rows(), (int)mS.Cols(), 1, true))
   return false;
Während der Messaktualisierungsphase passt das Modell den zuvor prädizierten Zustand nicht auf der Grundlage tatsächlicher Beobachtungen an, sondern anhand einer alternativen Prognose, die von KoopmanNet bereitgestellt wird. Zunächst wird der Erwartungswert der Beobachtung berechnet, indem der prädizierte Zustand XPred mit der transponierten Beobachtungsmatrix H multipliziert wird. Dieser Wert (YPred) gibt an, wie der Beobachtungswert aussehen würde, wenn dem Modell bei seiner Prognose keinerlei Fehler unterliefen.
//--- Measurement update
   if(!MatMul(cXPred.getOutput(), cHT.getOutput(), cYPred.getOutput(),
              1, cHT.GetWindow(), cHT.GetCount(), 1, true))
      return false;
   if(!Different(cKoopmanPred.getOutput(), cYPred.getOutput(), cDeltY.getOutput(),
                 1, 0, 0, 0, 1))
      return false;
   if(!MatMul(cDeltY.getOutput(), cK.getOutput(), cX.getPrevOutput(), 1,
              cDeltY.Neurons(), cX.Neurons(), 1, true))
      return false;
   if(!SumAndNormilize(cX.getPrevOutput(), cXPred.getOutput(), cX.getOutput(), 1, false, 0, 0, 0, 1))
      return false;
Die Differenz zwischen den Prognosen der beiden Modelle wird als Fehler interpretiert. Durch Multiplikation dieses Fehlers mit der Kalman-Verstärkung K erhalten wir einen Korrekturvektor, der zur ursprünglichen Prognose XPred addiert wird, woraus sich der korrigierte Zustand X ergibt.
Gleichzeitig wird die Zustandskovarianzmatrix P unter Verwendung der Joseph-stabilisierten Form aktualisiert, was dazu beiträgt, die Anhäufung numerischer Fehler zu verhindern und die Symmetrie zu bewahren.
//--- Joseph stabilized form for P
   if(!MatMul(cK.getOutput(), cH.getOutput(), cK_H.getOutput(), cKT.GetCount(),
              cKT.GetWindow(), cHT.GetWindow(), 1, true))
      return false;
   if(!IdentDifferent(cK_H.getOutput(), cIdifK_H.getOutput(), cHT.GetWindow(), 0, 0, 1))
      return false;
   if(!cIdifK_HT.FeedForward(cIdifK_H.AsObject()))
      return false;
   if(!cKT.FeedForward(cK.AsObject()))
      return false;
   if(!MatMul(cIdifK_H.getOutput(), cPPred.getOutput(), cIdifK_H.getPrevOutput(),
              cIdifK_HT.GetCount(), cIdifK_HT.GetWindow(), cIdifK_HT.GetWindow(), 1, true))
      return false;
   if(!MatMul(cIdifK_H.getPrevOutput(), cIdifK_HT.getOutput(), cP.getPrevOutput(),
              cIdifK_HT.GetCount(), cIdifK_HT.GetWindow(), cIdifK_HT.GetCount(), 1, true))
      return false;
   if(!MatMul(cK.getOutput(), cR_RT.getOutput(), cK.getPrevOutput(),
              cKT.GetCount(), cRT.GetCount(), cRT.GetCount(), 1, true))
      return false;
   if(!MatMul(cK.getPrevOutput(), cKT.getOutput(), cKT.getPrevOutput(),
              cKT.GetCount(), cKT.GetWindow(), cKT.GetCount(), 1, true))
      return false;
   if(!SumAndNormilize(cP.getPrevOutput(), cKT.getPrevOutput(), cP.getOutput(), cPT.GetWindow(), false, 0, 0, 0, 1))
      return false;
   if(!cPT.FeedForward(cP.AsObject()))
      return false;
   if(!SumAndNormilize(cP.getOutput(), cPT.getOutput(), cP.getOutput(), 1, false, 0, 0, 0, 0.5f))
      return false;
Sobald alle Berechnungen abgeschlossen sind, besteht der letzte Schritt darin, den Ausgabevektor zu erzeugen. Zu diesem Zweck wird ein Sampling auf Grundlage der ermittelten inversen Kovarianzmatrix P⁻¹ durchgeführt. Das Zufallsrauschen wird mit P skaliert, und das Ergebnis wird zum Zustandsvektor X addiert, wodurch die endgültige Repräsentation entsteht.
   if(!SumAndNormilize(cX.getOutput(), cAuxiliaryNet.getOutput(), cX.getOutput(), 1, false, 0, 0, 0, 1))
      return false;
//--- Sample Output
   if(!cP.getOutput().GetData(mPGrad))
      return false;
   if(mPGrad.HasNan() > 0)
     {
      mPGrad.Identity();
      if(!cP.getOutput().Fill(mPGrad))
         return false;
     }
   mP = mPGrad.Inv();
   if(mP.Rows() == 0)
     {
      mPGrad = mPGrad + mPGrad.Transpose();
      vector<double> eigvals;
      matrix<double> eigvecs;
      if(!mPGrad.Eig(eigvecs, eigvals))
         return false;
      if(eigvals.Size() > 0)
        {
         if(!eigvals.Clip(1e-6, DBL_MAX))
            return false;
         mPGrad = matrix<double>::Zeros(eigvals.Size(), eigvals.Size());
         mPGrad.Diag(eigvals);
         mPGrad = eigvecs.MatMul(mPGrad.MatMul(eigvecs.Transpose()));
         mPGrad = mPGrad + mPGrad.Transpose();
         mP = mPGrad.Inv();
        }
      if(mP.Rows() == 0)
        {
         mPGrad.Identity();
         if(!cP.getOutput().Fill(mPGrad))
            return false;
         mP = mPGrad.Inv();
        }
     }
   mNoise.Random(-1, 1);
   matrix<double> temp = mNoise.MatMul(mP);
   if(!PrevOutput.Fill(temp))
      return false;
   if(!SumVecMatrix(cX.getOutput(), PrevOutput, Output, (int)mNoise.Cols(), 0, 0, 0, 1))
      return false;
//---
   return true;
  }
Es sei darauf hingewiesen, dass die letzte Phase der Erzeugung des Ergebnistensors nicht auf die Erstellung eines einzigen Szenarios beschränkt ist. Stattdessen generiert das Modell ein ganzes Spektrum möglicher Trajektorien, von denen jede eine Realisierung aus einer multivariaten Verteilung ist, die durch die Kovarianzmatrix P beschrieben wird. Dies ist nicht nur ein eleganter mathematischer Kniff, sondern spiegelt vielmehr den Grad der Zuverlässigkeit des Modells in Bezug auf seine eigene Prognose wider.
Gerade dieser Ansatz macht das Modell unter Bedingungen von Marktinstabilität oder bei einem Mangel an verlässlichen Informationen besonders wertvoll: Es kann mehr, als nur ein einzelnes mögliches Zukunftsszenario zu prognostizieren; es kann ein ganzes, durch das Training fundiertes Bündel möglicher Trajektorien skizzieren. Dadurch wird die Ausgabe von feedForward in eine probabilistische Wolke möglicher Zustände umgewandelt. Jede von ihnen spiegelt verschiedene Aspekte wider, wie sich die Ereignisse entwickeln könnten.
Merkmale der Verteilung des Fehlergradienten
Sobald das Modell eine Reihe möglicher Trajektorien generiert hat, endet die Phase des Vorwärtsdurchlaufs und eine ebenso wichtige Phase beginnt: die Backpropagation des Fehlergradienten. Wir implementieren dies in der Methode calcInputGradients, deren Hauptaufgabe darin besteht, Gradienten von der Ebene der Modellausgabe an die Eingabedaten weiterzugeben und dabei den Fehler korrekt durch alle zugehörigen Komponenten zu propagieren.
Der Algorithmus beginnt damit, den Gradienten zwischen den prognostizierten Mittelwerten des linearen Modells und der Kovarianzmatrix P aufzuteilen.
bool CNeuronK2VAEEncoder::calcInputGradients(CNeuronBaseOCL *NeuronOCL)
  {
   if(!NeuronOCL)
      return false;
//--- From Output
   if(!SumVecMatrixGrad(cX.getGradient(), PrevOutput, Gradient, (int)mNoise.Cols(), 0, 0, 0, 1))
      return false;
   if(!PrevOutput.GetData(mGrad))
      return false;
   mPGrad = mNoise.Transpose().MatMul(mGrad);
   mP = mP.Transpose();
   mP = (mP * (-1)).MatMul(mPGrad.MatMul(mP));
Außerdem werden wir den Fehlergradienten durch die Joseph-stabilisierte Form leiten.
//--- Joseph stabilized form for P
   if(!cPT.getGradient().Fill(mP))
      return false;
   if(!cP.CalcHiddenGradients(cPT.AsObject()))
      return false;
   if(!SumAndNormilize(cP.getGradient(), cPT.getGradient(), cP.getGradient(), 1, false, 0, 0, 0, 0.5f))
      return false;
//---
   if(!MatMulGrad(cK.getPrevOutput(), cKT.getPrevOutput(),
                  cKT.getOutput(), cKT.getGradient(),
                  cP.getGradient(), cKT.GetCount(),
                  cKT.GetWindow(), cKT.GetCount(), 1, true))
      return false;
   if(!MatMulGrad(cK.getOutput(), cK.getPrevOutput(),
                  cR_RT.getOutput(), cR_RT.getGradient(),
                  cKT.getPrevOutput(), cKT.GetCount(),
                  cRT.GetCount(), cRT.GetCount(), 1, true))
      return false;
   if(!MatMulGrad(cIdifK_H.getPrevOutput(), cIdifK_HT.getPrevOutput(),
                  cIdifK_HT.getOutput(), cIdifK_HT.getGradient(),
                  cP.getGradient(), cIdifK_HT.GetCount(),
                  cIdifK_HT.GetWindow(), cIdifK_HT.GetCount(), 1, true))
      return false;
   if(!MatMulGrad(cIdifK_H.getOutput(), cIdifK_H.getPrevOutput(),
                  cPPred.getOutput(), cPPred.getGradient(),
                  cIdifK_HT.getPrevOutput(), cIdifK_HT.GetCount(),
                  cIdifK_HT.GetWindow(), cIdifK_HT.GetWindow(), 1, true))
      return false;
//---
   if(!cK.CalcHiddenGradients(cKT.AsObject()))
      return false;
   if(!SumAndNormilize(cK.getGradient(), cK.getPrevOutput(), cK.getGradient(), 1, false, 0, 0, 0, 1))
      return false;
Die resultierende Matrix wird weitergegeben und initialisiert die Kette der Gradientenreaktionen im Kalman-Filterblock. Zunächst über das Messaktualisierungsmodul.
//--- Measurement update
   if(!cIdifK_H.CalcHiddenGradients(cIdifK_HT.AsObject()))
      return false;
   if(!SumAndNormilize(cIdifK_H.getGradient(), cIdifK_H.getPrevOutput(), cIdifK_H.getGradient(),
                                                                          1, false, 0, 0, 0, 1))
      return false;
   if(!IdentDifferentGrad(cK_H.getGradient(), cIdifK_H.getGradient(), cHT.GetWindow(), 0, 0, 1))
      return false;
   if(!MatMulGrad(cK.getOutput(), cK.getPrevOutput(),
                  cH.getOutput(), cH.getGradient(),
                  cK_H.getGradient(), cKT.GetCount(),
                  cKT.GetWindow(), cHT.GetWindow(), 1, true))
      return false;
//---
   if(!MatMulGrad(cDeltY.getOutput(), cDeltY.getGradient(),
                  cK.getOutput(), cK.getPrevOutput(),
                  cX.getGradient(), 1,
                  cDeltY.Neurons(), cX.Neurons(), 1, true))
      return false;
   if(!SumAndNormilize(cK.getGradient(), cK.getPrevOutput(), cK.getGradient(), 1, false, 0, 0, 0, 1))
      return false;
   if(!DifferentGrad(cKoopmanPred.getGradient(), cYPred.getGradient(), cDeltY.getGradient(),
                     1, 0, 0, 0, 1))
      return false;
   if(!MatMulGrad(cXPred.getOutput(), cXPred.getGradient(),
                  cHT.getOutput(), cHT.getGradient(),
                  cYPred.getGradient(),
                  1, cHT.GetWindow(), cHT.GetCount(), 1, true))
      return false;
   if(!SumAndNormilize(cXPred.getGradient(), cX.getGradient(), cXPred.getGradient(), 1, false, 0, 0, 0, 1))
      return false;
Anschließend durchläuft die Gradientenausbreitung im Korrekturblock die Prognose- und Fehlermatrizen. All diese Schritte bauen sorgfältig einen Gradientenfluss vom Ausgaberaum in den verborgenen Raum auf und berücksichtigen vor allem die strukturellen Beziehungen zwischen den Variablen.
//--- Update step
   if(!MatMulGrad(cP_HT.getOutput(), cP_HT.getGradient(),
                  cSInv.getOutput(), cSInv.getGradient(),
                  cK.getGradient(), cHT.GetCount(),
                  (int)mS.Rows(), (int)mS.Cols(), 1, true))
      return false;
   if(cSInv.getGradient().GetData(mSGrad) <= 0)
      return false;
   mS = mS.Transpose();
   mS = (mS * (-1)).MatMul(mSGrad.MatMul(mS));
   if(cH_P_HT.getGradient().Fill(mS) <= 0)
      return false;
   if(!MatMulGrad(cH.getOutput(), cH.getPrevOutput(),
                  cP_HT.getOutput(), cP_HT.getPrevOutput(),
                  cH_P_HT.getGradient(), cHT.GetCount(),
                  cHT.GetWindow(), cHT.GetCount(), 1, true))
      return false;
   if(!SumAndNormilize(cH_P_HT.getGradient(), cR_RT.getGradient(),
                       cR_RT.getGradient(), int(mS.Cols()), false, 0, 0, 0, 1))
      return false;
   if(!SumAndNormilize(cH.getGradient(), cH.getPrevOutput(),
                       cH.getPrevOutput(), 1, false, 0, 0, 0, 1))
      return false;
   if(!SumAndNormilize(cP_HT.getGradient(), cP_HT.getPrevOutput(),
                       cP_HT.getGradient(), 1, false, 0, 0, 0, 1))
      return false;
   if(!MatMulGrad(cPPred.getOutput(), cPPred.getPrevOutput(),
                  cHT.getOutput(), cHT.getPrevOutput(),
                  cP_HT.getGradient(), cPPred.Neurons() / cHT.GetWindow(),
                  cHT.GetWindow(), cHT.GetCount(), 1, true))
      return false;
   if(!SumAndNormilize(cPPred.getGradient(), cPPred.getPrevOutput(),
                       cQ_QT.getGradient(), int(cQT.GetWindow()), false, 0, 0, 0, 1))
      return false;
   if(!SumAndNormilize(cHT.getGradient(), cHT.getPrevOutput(), cHT.getGradient(), 1, false, 0, 0, 0, 1))
      return false;
Darauf folgt der Prognoseblock – Prognoseschritt.
//--- Prediction step
   if(!MatMulGrad(cF_P.getOutput(), cF_P.getGradient(),
                  cFT.getOutput(), cFT.getGradient(),
                  cQ_QT.getGradient(), cFT.GetCount(),
                  cFT.GetWindow(), cFT.GetCount(), 1, true))
      return false;
   if(!MatMulGrad(cF.getOutput(), cF.getPrevOutput(),
                  cP.getOutput(), cP.getGradient(),
                  cF_P.getGradient(),
                  cFT.GetCount(), cFT.GetWindow(), cP.Neurons() / cFT.GetWindow(), 1, true))
      return false;
   if(!MatMulGrad(cAuxiliaryNet.getOutput(), cAuxiliaryNet.getGradient(),
                  cB.getOutput(), cB.getGradient(),
                  cXPred.getGradient(), 1,
                  cFT.GetWindow(), cFT.GetCount(), 1, true))
      return false;
   if(!MatMulGrad(NeuronOCL.getOutput(), NeuronOCL.getGradient(),
                  cFT.getOutput(), cFT.getPrevOutput(),
                  cXPred.getGradient(), 1,
                  cFT.GetWindow(), cFT.GetCount(), 1, true))
      return false;
   if(!SumAndNormilize(cFT.getGradient(), cFT.getPrevOutput(),
                       cFT.getGradient(), 1, false, 0, 0, 0, 1))
      return false;
//---
   if(!MatMulGrad(cR.getOutput(), cR.getPrevOutput(),
                  cRT.getOutput(), cRT.getGradient(),
                  cR_RT.getGradient(), cRT.GetCount(),
                  cRT.GetWindow(), cRT.GetCount(), 1, false))
      return false;
   if(!MatMulGrad(cQ.getOutput(), cQ.getPrevOutput(),
                  cQT.getOutput(), cQT.getGradient(),
                  cQ_QT.getGradient(), cQT.GetCount(),
                  cQT.GetWindow(), cQT.GetCount(), 1, false))
      return false;
   if(!cR.CalcHiddenGradients((CObject*)cRT.AsObject()))
      return false;
   if(!SumAndNormilize(cR.getGradient(), cR.getPrevOutput(),
                       cR.getGradient(), cRT.GetWindow(), false, 0, 0, 0, 0.01f))
      return false;
   if(!cQ.CalcHiddenGradients(cQT.AsObject()))
      return false;
   if(!SumAndNormilize(cQ.getGradient(), cQ.getPrevOutput(),
                       cQ.getGradient(), cQT.GetWindow(), false, 0, 0, 0, 0.01f))
      return false;
   if(!cH.CalcHiddenGradients(cHT.AsObject()))
      return false;
   if(!SumAndNormilize(cH.getGradient(), cH.getPrevOutput(),
                       cH.getGradient(), cHT.GetWindow(), false, 0, 0, 0, 0.01f))
      return false;
   if(!cF.CalcHiddenGradients(cFT.AsObject()))
      return false;
   if(!SumAndNormilize(cF.getGradient(), cF.getPrevOutput(),
                       cF.getGradient(), cFT.GetWindow(), false, 0, 0, 0, 0.01f))
      return false;
Der letzte Block befasst sich mit der Repräsentation im Koopman-Raum und dem Attention-Modul. Hier wird der Gradient an die Prognose- und Rekonstruktionsteile (KoopmanPred, KoopmanRest) weitergegeben.
//--- Rest Attention
   if(!cKoopmanRest.CalcHiddenGradients(cAuxiliaryNet.AsObject()))
      return false;
//--- Pred / Rest
   if(!NeuronOCL.getPrevOutput().Fill(0))
      return false;
   if(!DifferentGrad(NeuronOCL.getPrevOutput(), cKoopmanRest.getPrevOutput(),
                     cKoopmanRest.getGradient(), cKoopman.GetWindow()))
      return false;
   if(!SumAndNormilize(NeuronOCL.getGradient(), NeuronOCL.getPrevOutput(),
                       NeuronOCL.getPrevOutput(), 1, false, 0, 0, 0, 1))
      return false;
   if(NeuronOCL.Activation() != None)
     {
      if(!DeActivation(NeuronOCL.getOutput(), NeuronOCL.getPrevOutput(),
                       NeuronOCL.getPrevOutput(), NeuronOCL.Activation()))
         return false;
     }
   if(!Concat(cKoopmanPred.getGradient(), cKoopmanRest.getPrevOutput(), cKoopman.getGradient(),
              cKoopman.GetWindow(), cKoopman.Neurons() - cKoopman.GetWindow(), 1))
      return false;
Für Letzteren wird der Gradient bezogen auf die Differenz berechnet, und anschließend werden beide Teile zu einer einzigen Koopman-Struktur zusammengefasst.
In der letzten Phase wird der Gradient bis auf die Ebene der Originaldaten weitergegeben.
//--- Koopman
   if(!NeuronOCL.CalcHiddenGradients(cKoopman.AsObject()))
      return false;
   if(!SumAndNormilize(NeuronOCL.getGradient(), NeuronOCL.getPrevOutput(),
                       NeuronOCL.getGradient(), 1, false, 0, 0, 0, 1))
      return false;
//---
   return true;
  }
Somit verfolgt das Verfahren Schritt für Schritt den gesamten Backpropagation-Pfad und deckt dabei alle wesentlichen Komponenten des Modells ab: die probabilistische latente Komponente, die Zustandsfilterung, die Prognose, die Korrektur und die Transformation im Koopman-Raum. All dies stellt sicher, dass die Parameter des Modells feinabgestimmt werden, und ermöglicht dem Modell, effektiv aus Zeitreihendaten zu lernen.
Der vollständige Quellcode für das Objekt CNeuronK2VAEEncoder und alle seine Methoden ist im Anhang enthalten.
Heute haben wir umfangreiche und detaillierte Arbeit geleistet, und der Artikel hat bereits eine beachtliche Länge erreicht. Ich schlage vor, eine kurze Pause einzulegen, damit sich das Material setzen kann, und es sich dann mit frischem Blick noch einmal anzusehen. Im nächsten Artikel werden wir das Begonnene zu Ende bringen: Wir werden die verbleibenden Punkte ausführlich betrachten und die umgesetzten Ansätze anhand realer historischer Daten testen. Dies wird nicht nur dazu beitragen, die Theorie zu festigen, sondern auch ihre praktische Wirksamkeit zu bewerten.
Fazit
In diesem Artikel haben wir die Architektur und die wichtigsten Phasen der Implementierung des Encoders im K²VAE-Framework eingehend untersucht, das die Fähigkeiten von KoopmanNet und des Kalman-Filters in einem einzigen System für die Zeitreihenanalyse vereint. Dieser Ansatz ermöglicht es, die komplexe Dynamik von Finanzdaten effektiv zu modellieren, indem klassische lineare Prognosen mit flexiblen, adaptiven Anpassungen auf Basis von Beobachtungen kombiniert werden. Das hier vorgestellte Framework zeigt deutlich, wie sich bewährte Methoden nahtlos in moderne Technologien auf Basis neuronaler Netze integrieren lassen, wodurch sich neue Möglichkeiten für die Analyse und Prognose von Finanzmärkten eröffnen.
Im nächsten Artikel werden wir uns mit der praktischen Erprobung des Modells anhand realer historischer Daten befassen, um dessen Wirksamkeit und Potenzial unter realen Handelsbedingungen objektiv zu bewerten.
Literaturverzeichnis
- K²VAE: A Koopman-Kalman Enhanced Variational Autoencoder for Probabilistic Time Series Forecasting
- Weitere Artikel dieser Reihe
In diesem Artikel verwendete Programme
| # | Name | Typ | Beschreibung |
|---|---|---|---|
| 1 | Study.mq5 | Expert Advisor | Expert Advisor für das Offline-Modelltraining |
| 2 | StudyOnline.mq5 | Expert Advisor | Expert Advisor für das Online-Training des Modells |
| 3 | Test.mq5 | Expert Advisor | Expert Advisor für Modelltests |
| 4 | Trajectory.mqh | Klassenbibliothek | Struktur zur Beschreibung des Systemzustands und der Modellarchitektur |
| 5 | NeuroNet.mqh | Klassenbibliothek | Klassenbibliothek zum Erstellen eines neuronalen Netzes |
| 6 | NeuroNet.cl | Bibliothek | Codebibliothek für ein OpenCL-Programm |
Übersetzt aus dem Russischen von MetaQuotes Ltd.
Originalartikel: https://www.mql5.com/ru/articles/18766
Warnung: Alle Rechte sind von MetaQuotes Ltd. vorbehalten. Kopieren oder Vervielfältigen untersagt.
Dieser Artikel wurde von einem Nutzer der Website verfasst und gibt dessen persönliche Meinung wieder. MetaQuotes Ltd übernimmt keine Verantwortung für die Richtigkeit der dargestellten Informationen oder für Folgen, die sich aus der Anwendung der beschriebenen Lösungen, Strategien oder Empfehlungen ergeben.

 Analyse der stündlichen Kursentwicklung von Symbolen und ihrer Spreads in MetaTrader 5
 Training eines nichtlinearen U-Transformers anhand der Residuen eines linearen autoregressiven Modells
 Eine alternative Log-datei mit der Verwendung der HTML und CSS
 Neuronale Netze im Trading: Probabilistische Zeitreihenprognose (K²VAE)

- Freie Handelsapplikationen
- Über 8.000 Signale zum Kopieren
- Wirtschaftsnachrichten für die Lage an den Finanzmärkte
Sie stimmen der Website-Richtlinie und den Nutzungsbedingungen zu.