

神经网络在交易中的应用:一种端到端多变量时间序列预测模型(GinAR)
 37
 0

引言
多元时间序列预测(MTSF)已成为各行各业分析中不可或缺的一部分 — 从交通运输到环境科学,金融市场当然也不例外。在我们这个领域,这意味着能够基于历史动态预测多种相互关联的金融工具(股票、指数、货币)的行为。这些模型使我们能够做出更明智的投资决策、管理风险,并识别资产之间隐藏的关系。
从形式上讲,多元时间序列(MTS)可以表示为时空图,其中每个变量(无论是汇率、交易量还是收益率)都随时间变化,并通过隐含依赖关系与其他变量相关联。这些依赖关系分为两大类:时间(事件之间的因果关系)和空间(资产或市场部门之间的相互依赖关系)。
为了有效预测MTS ,识别和利用这些时空依赖性至关重要。在高波动性和市场冲击的情况下,这一点尤为重要,因为传统模型根本无法迅速适应。这时,图神经网络就派上用场了。这些模型结合了图卷积网络和循环模型的优点,能够基于变量之间的复杂关系进行更准确的预测。
但在实践中,事情并不那么简单。金融数据往往不完整。一些指标不可用,或者仅在部分时间间隔内被观察到。缺失值可能由任何原因引起:数据传输中断、指标计算方法的变化或经纪商的技术错误。如果关键资产的数据缺失,预测准确性会急剧下降。在这种情况下,图模型通常会失去充分评估依赖性的能力,从而导致错误像雪球一样越滚越大,预测质量下降。
为解决这一问题,一些尝试基于简单排除不可用变量的方法。但这是短视的 — 关键资产数据的缺失可能会破坏模型的整个逻辑结构,并导致错误的结论。更复杂的方法使用填充缺失值(插补)的方法,将时间上下文与固定的空间关系(如资产之间的相关性或网络结构)相结合。然而,当缺失数据比例较高或观察变量与缺失变量之间没有可靠关系时,这些方法往往会失败。误差会再次累积,预测变得不可靠。
那我们该怎么办?解决方案在于构建能够利用可用变量信息直接在预测过程中插补的模型,而无需将训练分为单独的“填补缺失值 → 预测”阶段。这正是文章“GinAR:一种适用于变量缺失的端到端多变量时间序列预测模型”中介绍的新型图插值注意力递归网络(GinAR)框架的工作原理。这是一种新型的端到端架构,旨在处理多变量时间序列中的缺失变量。
GinAR基于一个简单的循环网络(SRU),该网络包含两个关键组件:
- 插值注意力( IA )是一种通过将注意力算法应用于可用数据来推断缺失变量的机制。这有助于避免因试图从零值和异常值中学习而导致的错误。
- 自适应图卷积( AGCN )是一种自适应图卷积,它在插补后重建变量之间的关系结构,从而能够解释资产之间的直接和间接相关性。
因此, GinAR 可以同时预测和改进依赖模型,防止错误不断累积。尤其重要的是,即使在极端条件下它也能正常工作。在框架作者使用真实世界数据进行的测试中,即使高达 90% 的变量不可用,该模型仍保持了较高的准确度。想象一下,你的投资组合中只有少数资产的数据,而其余资产没有数据 — GinAR 仍然能为整个系统生成预测。
简而言之, GinAR 的主要成就包括:
- 这是第一个专为存在缺失变量的 MTSF 而设计的模型,无需预先插补步骤即可运行。
- 新架构( IA + AGCN )取代了 SRU 中的全连接层,最大限度地减少了依赖关系的扭曲。
- 根据作者文章中提出的实验结果, GinAR 在五个不同的数据集上优于其他 11 个模型,即使在缺失率极高的情况下也表现出稳健的性能。
对于金融市场而言,这意味着:即使部分数据缺失,也仍可进行系统且准确的预测。这意味着无需依赖理想的输入数据,即可可靠地实施自适应策略、压力测试和风险管理。毕竟,现实中市场永远不可能完美 — 而 GinAR 正是为了在这种情况下使用而创建的。
GinAR 算法
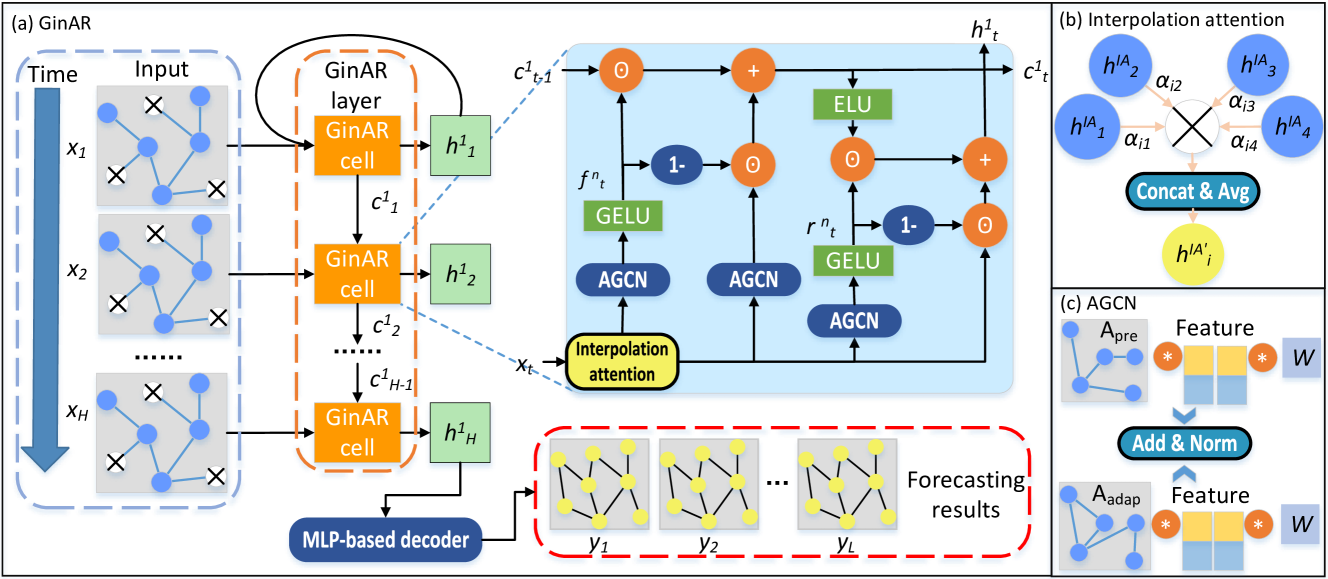
GinAR 框架的架构遵循经典的编码器(Encoder)→解码器(Decoder)方案。编码器采用 GinAR 层堆叠,解码器采用多层感知器 ( MLP ) 实现。该系统的一个关键组成部分是GinAR单元 — 一个基于递归建模原理的模块。当输入不完整数据时,即变量缺失的时间序列,该模型能够同时预测所有变量的未来值,即使是那些缺失完整历史数据的变量。
在设计 GinAR 的内部逻辑时,该框架的作者建议用两个专门的组件替换 SRU 经典递归结构中的所有全连接层:IA (插值注意力)和AGCN (自适应图卷积网络)。
第一个组件利用来自可用邻居的信息来填充缺失的变量。在金融市场的背景下,这一点尤为重要:如果关键资产的数据缺失,即使是部分缺失,模型也会大幅降低准确性。IA 机制通过基于现有数据重建缺失时间序列的有意义表示,并最大限度地减少噪声的影响,从而防止这种情况发生。
第二个组件 AGCN 摒弃了固定的依赖图,如资产、指数和行业之间的预定义关系,而是在训练过程中直接学习自适应的图结构。这使得即使变量之间的关系随时间变化或并不明显,也能灵活捕捉它们之间的空间关系。
GinAR 的编码器采用递归方案实现,在每个时间步长,将当前特征和前一步的内部状态作为输入。GinAR 单元处理这些输入,更新状态,并生成当前时间步长的隐藏表示。这种方法使得可以在单个模块内同时插补、重构依赖图并提取动态模式。得益于残差连接(跳跃连接),模型可以在不牺牲训练稳定性的前提下实现深度化。在预测复杂市场信号时,这一点尤为重要,因为短期波动和长期趋势都同样重要。
下一步是预测。为此,必须正确聚合得到的潜在表示。一方面,由于模型的递归特性,GinAR 单元的每个最终隐藏状态都包含输入数据时间结构的完整信息。另一方面,得益于其多层结构和跳跃连接的存在,每个隐藏表示反映了不同层次的抽象:从微观运动到全局相关性。因此,将所有层的特征组合成一个张量,并输入到解码器中。解码器是一个多层感知器,使用直接多步预测(DMSF)策略进行训练 — 这是一种直接的多步预测方法。这种方法使得可以一次性预测整个目标范围(例如,未来5-10 根 K 线的价格变动),而无需采用逐步迭代的预测方法,后者容易累积误差。
因此,GinAR 提供了一种稳健的架构,能够在存在缺失数据、动态关系以及时间序列之间高度相关的情况下,有效处理预测任务。该模型将缺失数据填补、图学习和预测功能集于一体,构成了一个能够适应现实世界市场不确定性的端到端解决方案。
插值注意力(IA)机制旨在重建历史数据完全缺失的变量的表示。对于每个缺失的变量,需要确定重建所依据的已观测变量集,以及这些变量的相应影响权重。这一过程包括两个关键阶段:首先,在缺失变量和可用变量之间建立对应关系,然后应用注意力机制来聚合信息并进行重建。
第一阶段,构建变量之间的对应矩阵。初始化一个单位矩阵IN ∈ Rᴺ*ᴺ ,以及两个变量的矩阵嵌入:EIA1 ∈ Rᴺ* ᵈ 且 EIA2 ∈ Rᵈ*ᴺ 。这些嵌入与模型一起学习。变量之间的相关矩阵使用以下公式计算:
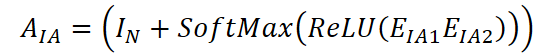
矩阵 AIA ∈ Rᴺ*ᴺ 中的元素(i, j)反映了变量 i 和 j 之间的关系程度。如果该值为正,则表示观测变量 j 可用于填补缺失变量 i 。因此,对于每个缺失变量 i ,我们可以识别一组相关的观测变量 N ( i ) ⊆ {1,…, N }。
在识别出对应关系后,利用注意力机制重建缺失变量的表示。为此,计算注意力系数 aij,该系数反映了观测变量 j 在重建变量 i 中的重要性:
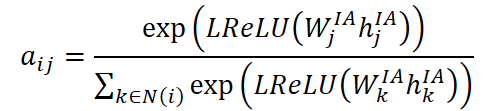
其中 hᴵᴬj 是变量 j 的当前隐藏表示, Wᴵᴬj 是可训练权重矩阵。激活是通过 LReLU 函数实现的,这有助于防止弱激活导致梯度为零。
由此得到的系数用于汇总来自观测变量的信息。缺失变量 i 的表示形式使用以下公式重建:
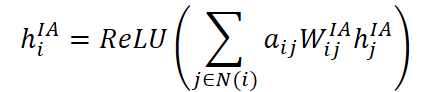
其中,Wᴵᴬij 是针对每对变量 i 和 j 的独立可训练权重矩阵,最终聚合结果再经过 ReLU 激活,以提高对异常值的鲁棒性。
对所有缺失变量重复此过程,直至所有 M 个缺失分量的表示都已重建。这将得到一个新的张量 XᴵᴬM ∈ Rᴺ*ᴴ*ᶜ′,其中所有变量(包括之前缺失的变量)都具有完整的隐藏表示。需要注意的是,在实践中,步骤 2 和 3 是通过矩阵乘法和并行计算来实现的,以提高重建表示的效率。
因此,插值注意力机制使得在具有缺失变量的多元时间序列中灵活地插补成为可能,而无需事先严格指定变量之间的关系结构。这在金融预测任务中尤为重要,因为资产之间的相关性结构可能不稳定,且历史数据可能不完整或有噪声。
在多元时间序列预测问题中,通常使用预定义的图结构来反映变量之间的空间依赖性。为此,定义了邻接矩阵 A,使模型能够捕捉到潜在的关系。然而,当数据大量缺失时,尤其是当多个变量缺乏完整信息时,这种预定义的图结构可能就不够用了。为了克服这一局限性,该框架的作者引入了自适应图卷积,它将预定义的结构与根据数据生成的图相结合。
预定义图结构的基础要么是距离信息(例如,对于交通网络),要么是变量之间的皮尔逊相关系数(如果数据不包含拓扑信息)。在这种情况下,用于图卷积的邻接矩阵计算方式如下:
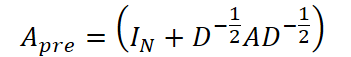
其中 IN ∈ Rᴺ*ᴺ 表示单位矩阵,D 表示图顶点的度矩阵,A 表示原始邻接矩阵。这种归一化有助于在训练过程中稳定权重尺度。
然而,当某些变量缺失或其关系未知时,必须动态地识别空间依赖性。为此,我们构建了一个自适应图,并从数据中学习。这一过程首先从初始化一个单位矩阵 IN ∈ Rᴺ*ᴺ 和随机初始化变量嵌入 EA ∈ Rᴺ*ᵈ 开始。这些嵌入会在模型训练过程中进行更新。
在使用 IA 机制对变量进行插补后,我们得到了隐藏表示张量 XᴵᴬM ∈ Rᴺ*ᴴ*ᶜ′。接下来,通过结合嵌入表示和时间表示,计算变量的更新表示 En ∈ Rᴺ*ᵈ:
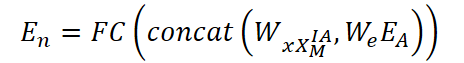
其中,Wx 和 We 分别是时间特征和嵌入的可训练权重矩阵,concat(⋅) 是沿最后一个轴的拼接操作。这种表示方法用于构建自适应邻接矩阵:
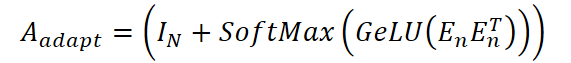
最后一步是使用自适应图卷积从两个图中聚合信息,该卷积结合了两个通道:一个使用预定义结构,另一个使用自适应结构。变量的最终表示是通过以下公式计算的:
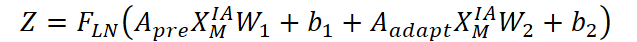
这种设计能够整合静态和动态空间信息,这在预测部分变量缺失的多元时间序列时尤为重要。
通过结合这两张图,该模型获得了一个稳健且具有适应性的结构,使其能够更准确地识别变量之间的依赖关系,从而提高了短期和中期预测的准确性。
GinAR 架构背后的主要思想是将插值注意力( IA )机制和自适应图卷积( AGCN )集成到一个简单的递归模型中。这种组合不仅使得填补缺失变量成为可能,还能有效地考虑时空依赖性。
让我们详细了解一下 GinAR 单元的结构以及数据预测的逐步过程。
在单个时间步长层面上, GinAR 单元作为基本计算单元。它使用 IA 来填补缺失的输入值,并 使用 AGCN 来处理变量之间的空间关系。输入是一个张量 x T ,首先使用插值注意力机制对其进行变换:
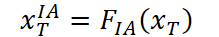
接下来,通过聚合来自预定义图 Apre 和自适应图 Aadapt 的信息,来计算遗忘门 fT 和重置门 rT:
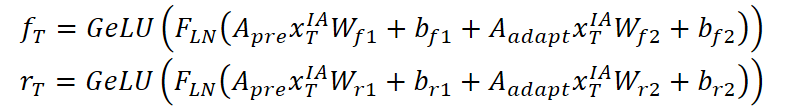
新的状态 cT 是由当前变换后的输入和前一个状态 cT-1 的组合构成的,该组合由遗忘门进行加权:
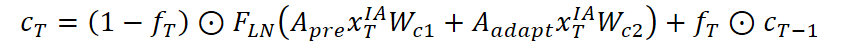
最后,隐藏状态 hT 是通过更新后的单元状态和输入的非线性组合来计算的:
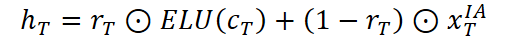
因此,每个 GinAR 单元都会执行一个完整的内部状态更新周期,包括数据插补和空间信息的聚合。
从全局层面来看, GinAR 编码器由多个 GinAR 层组成。每一层由 H 个串联连接的单元组成。原始输入数据 X ∈ Rᴺ*ᴴ*ᶜ 首先经过归一化和掩码处理,形成张量 XM ∈ Rᴺ*ᴴ*ᶜ,其中 M 变量的值被置为零。
接下来,将 XM 输入到第一个 GinAR 层中,其中每个单元负责处理单个时间步。该过程从初始化状态 c₀ 开始,之后将 x₁ 和 c₀ 传递给第一个单元,产生 h¹₁ 和 c₁。然后将这些值与 x₂ 一起传递给下一个单元,依此类推。最终得到第一层的隐藏状态序列,h¹ = [h¹₁, h¹₂, …, h¹H]。
该张量将作为下一层的输入。重复此过程,直到处理完所有 n 层。然后从每一层提取最后一个隐藏状态 hHⁱ,并将它们连接成最终的向量 halln。
最终表示 halln 被输入到基于多层感知器(MLP)的解码器中,该解码器生成预测值:
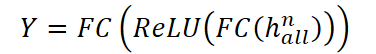
因此, GinAR 实现了对缺失值时间序列的完整端到端处理,将数据插补和时空依赖性建模结合在一个递归卷积框架内。
下面展示的是作者提供的 GinAR 框架示意图。
MQL5 中的实现
在回顾了 GinAR 框架的理论方面之后,我们进入实践部分,我们将演示如何用 MQL5 实现作者提出的方法思路。
但是,在开始开发主要算法之前,我们需要做一些准备工作。从上述对 GinAR 的描述可以看出,原始算法反复使用 SoftMax 函数进行数据归一化。鉴于此,我们决定将其作为 OpenCL 程序中的一个独立函数来实现,从而确保在处理多元数据时具有灵活性和高性能。
准备工作
为了更好地组织,我们将算法的实现分解为单独的功能模块。我们先从第一个基础模块开始:在工作组内求最大值。LocalMax 函数执行此任务。
LocalMax 函数接受两个参数:当前线程中计算的值和任务空间 ( loc ) 中的维度索引,线程通过该维度索引被分组到工作组中。
#define BarrierLoc      barrier(CLK_LOCAL_MEM_FENCE)
float LocalMax(const float value, const int loc)
  {
   const size_t id = get_local_id(loc);
   const size_t total = get_local_size(loc);
//---
   __local float Temp[LOCAL_ARRAY_SIZE];
   const uint ls = min((uint)total, (uint)LOCAL_ARRAY_SIZE);
第一步,确定本地工作组内的线程 ID 和工作组的总大小。接下来,创建一个 Temp 数组并将其存储在设备的本地内存中;该数组将用于在同一工作组内的线程之间交换中间值。
然后程序开始遍历工作组内形成的所有子组,以找到局部最大值。这些值存储在 Temp 数组的元素中。
//--- Find Max
   for(int d = 0; d < total; d += ls)
     {
      if(id >= d && id < (d + ls) &&
         (d == 0 || Temp[id - d] < value))
         Temp[id - d] = IsNaNOrInf(value, MIN_VALUE);
      BarrierLoc;
     }
之后,开始一个迭代过程,即缩减(折叠),将 Temp 数组缩减为一个值 — 即所有元素中的最大值。
   int count = ls;
   do
     {
      count = (count + 1) / 2;
      if(id < count && (id + count) < ls && Temp[id] < Temp[id + count])
         Temp[id] = Temp[id + count];
      BarrierLoc;
     }
   while(count > 1);
//---
   return IsNaNOrInf(Temp[0], MIN_VALUE);
  }
这些操作的结果会返回给调用程序。
与之前的 LocalMax 函数类似,让我们创建另一个基本构建块 — 一个用于在局部工作组内求和元素的函数。这项任务由 LocalSum 函数执行,它基于与 LocalMax 相同的原理,但使用加法而不是寻找最大值。
float LocalSum(const float value, const int loc)
  {
   const size_t id = get_local_id(loc);
   const size_t total = get_local_size(loc);
//---
   __local float Temp[LOCAL_ARRAY_SIZE];
   const uint ls = min((uint)total, (uint)LOCAL_ARRAY_SIZE);
初始阶段,与之前一样,确定线程标识符和工作组的大小。同时创建了一个局部 Temp 数组来存储中间总和。
接下来是对本地工作组中的所有线程进行迭代,并累积中间值。注意条件 d == 0 的使用,这确保了 Temp 数组在第一次迭代时正确初始化。
//--- Sum
   float result = IsNaNOrInf(value, 0);
   for(int d = 0; d < total; d += ls)
     {
      if(id >= d && id < (d + ls))
         Temp[id - d] = (d == 0 ? result : Temp[id - d] + result);
      BarrierLoc;
     }
之后,执行熟悉的缩减过程,每一步元素数量减半;这里,不是进行比较,而是简单地将 Temp 数组的元素相加。
   int count = ls;
   do
     {
      count = (count + 1) / 2;
      if(id < count && (id + count) < ls)
         Temp[id] += Temp[id + count];
      BarrierLoc;
     }
   while(count > 1);
   result = IsNaNOrInf(Temp[0], 0);
//---
   return result;
  }
最终值,即工作组中所有元素的总和,将返回给调用程序。
在准备工作的最后阶段,我们将把先前实现的辅助函数 LocalMax 和 LocalSum 合并成一个算法,用于 LocalSoftMax 函数,该函数可以对工作组内的值进行数值稳定的归一化。
float LocalSoftMax(const float value, const int loc)
  {
//--- Look Max
   const float max = LocalMax(value, loc);
   BarrierLoc;
在 LocalSoftMax 函数内部,首先调用 LocalMax ;它会在工作组的所有线程中找到最大值。这对于稳定计算是必要的:从每个值中减去最大值可以防止溢出,并提高指数运算的数值稳定性。
然后,在应用位移后,计算每个值的指数。该操作的结果暂时存储在变量 result 中,之后我们调用 LocalSum 函数来计算组内指数的总和。
//--- SoftMax
   float result = IsNaNOrInf(exp(value - max), 0);
   const float sum = LocalSum(result, loc);
   result = IsNaNOrInf(result / (sum == 0 ? 1 : sum), 0);
//---
   return result;
  }
接下来,进行归一化:将 result 值除以所有指数之和。此外,还提供了防止除以零的保护:如果和为零,则分母使用 1。最后一步,我们返回归一化值。
这种结构使得 SoftMax 可以作为后续 OpenCL 内核的灵活构建模块。这使得代码更简洁,简化了调试,并提高了整个架构的可读性,尤其是在 MQL5 中 GinAR 实现所使用的图模型和注意力机制的背景下。
然而,仅仅通过 SoftMax 进行前向传递仍然不足以训练模型。为了在反向传播过程中正确更新权重,必须实现适当的梯度传播函数。该函数允许模型考虑输入值的变化将如何影响最终误差。
我们在 LocalSoftMaxGrad 函数中实现了此功能,该函数确定 SoftMax 函数相对于输入值的梯度。输入参数为:值 value ,对应于 SoftMax 的输出;梯度 grad ,从网络的后续层传递而来;以及任务空间维度索引 loc ,根据该维度形成工作组。
float LocalSoftMaxGrad(const float value, const float grad, const int loc)
  {
   const size_t id = get_local_id(loc);
   const size_t total = get_local_size(loc);
//---
   __local float Temp[LOCAL_ARRAY_SIZE];
   const uint ls = min((uint)total, (uint)LOCAL_ARRAY_SIZE);
在函数开始时,我们确定当前线程的 ID 和本地工作组中的线程总数。我们创建了一个局部数组 Temp 来存储中间值,类似于 LocalMax 和 LocalSum 中的做法。变量 val 是一个受错误保护的输入值。
   float result = 0;
   float val = IsNaNOrInf(value, 0);
   for(uint d = 0; d < total; d += ls)
     {
      if(id >= d && id < (d + ls))
         Temp[id - d] = IsNaNOrInf(val * grad, 0);
      BarrierLoc;
      for(uint l = 0; l < min(ls, (uint)(total - d)); l++)
         result += Temp[l] * ((float)((d + l) == id) - val);
      BarrierLoc;
     }
//---
   return result;
  }
接下来,我们开始遍历整个工作组内的各个子组。在每个块中,我们将临时缓冲区填充为 val * grad 的乘积值,并使用 SoftMax 导数的标准公式,将结果累积到变量 result中。该表达式本身使用逻辑检查 (d + l) == id ,以确保雅可比矩阵的对角线元素和非对角线元素都得到正确处理。
该函数的结果是与给定输入元素对应的最终梯度值。该结果返回给调用内核,以确保反向传播在模型架构中正确实现。
因此,该函数完成了 OpenCL 模块中完整的 SoftMax 处理周期的实现 — 从前向计算到正确的梯度反向传播。
插值注意力
在完成与实现基本操作(如 SoftMax 及其梯度传播)相关的准备工作之后,我们继续构建插值注意力机制,该机制在 GinAR 架构中起着关键作用。第一阶段,我们的目标是使用 OpenCL 实现该算法的前向传播,确保在 GPU 上进行高效并行处理。
InterpositionAttention 内核的输入需要以下几个数组:
- 输入特征矩阵 matrix_in ,
- 可训练参数 W 和 A ,
- 潜在表征 GL ,
- 邻接矩阵 Adj ,
- 中间表示 H ,
- 注意力值 Atten ,
- 得到的矩阵 matrix_out 。
同时提供了特征空间 dimension。
__kernel void InterpositionAttention(__global const float* matrix_in,
                                     __global const float* W,
                                     __global const float* A,
                                     __global const float* GL,
                                     __global float* Adj,
                                     __global float* H,
                                     __global float* Atten,
                                     __global float* matrix_out,
                                     const int dimension
                                    )
  {
   const size_t i = get_global_id(0);
   const size_t j = get_local_id(1);
   const size_t total = get_global_size(0);
   const size_t total_loc = get_local_size(1);
在执行开始时,我们定义全局线程索引 i 和局部线程索引 j ,它们将用于遍历输入数组和输出数组中的元素。接下来,我们计算适当的偏移量,以确保能够正确访问全局缓冲区中的相应数据段。
const int shift_i = i * dimension;
const int shift_j = j * dimension;
const int shift_adj = i * total_loc + j;
第一步是通过将 GL 数组中两个节点 i 和 j 的潜在表示成对相乘来计算它们之间的邻接权重。
float adj = 0;
for(int d = 0; d < dimension; d++)
   adj += IsNaNOrInf(GL[shift_i + d] * GL[shift_j + d], 0);
adj = max(IsNaNOrInf(adj, 0), 0);
adj = LocalSoftMax(adj, 1);
Adj[shift_adj] = adj;
adj += (float)(i == j);
将结果累积到变量 adj 中,使用 LocalSoftMax 函数进行归一化,并存储在邻接矩阵 Adj 中。然后,如果 i 与 j 匹配,则将 1 添加到 adj ,从而确保对角元素得以保留。
接下来,我们继续形成中间表示 H。为此,将当前节点的输入特征逐步乘以可训练权重矩阵 W。每个值都存储在数组 H 中, BarrierLoc 屏障用于线程间的同步。
for(int id_h = 0; id_h < dimension; id_h += total_loc)
  {
   if(j >= (dimension - id_h))
      break;
   float h = 0;
   for(int w = 0; w < dimension; w++)
      h += IsNaNOrInf(matrix_in[shift_i + w] * W[(id_h + j) * dimension + w], 0);
   H[shift_i + id_h + j] = h;
   BarrierLoc;
  }
一旦 H 形成,就计算注意力值 e ,该值决定节点 i 和 j 之间交互的重要性。该值被初始化为一个较小的正数,以避免除以零。如果元素之间存在正相关性,则累加 H 的对应行与可训练向量 A 之间的加权点积。使用 LocalSoftMax 函数再次对结果进行归一化,并将结果存储在 Atten 数组中。
float e = 1e-12f;
if(adj > 0)
  {
   e = 0;
   for(int a = 0; a < dimension; a++)
      e += IsNaNOrInf(H[shift_i + a] * A[a], 0) + IsNaNOrInf(H[shift_j + a] * A[dimension + a], 0);
  }
e = LocalSoftMax(e, 1);
Atten[shift_adj] = e;
最后一步是根据从其他已观察变量中获得的信息,来重建当前目标变量的表示。缺失(或待补值)变量 i 的值是通过变量 j 表示的加权和来聚合的,其中表示本身乘以相应的注意力系数。这种聚合方式允许将有用的信息从邻居变量传递到目标变量。
 for(int d = 0; d < dimension; d += total_loc)
   {
    if(j >= (dimension - d))
       break;
    float out = 0;
    int shift_h = d + j;
    int shift_att = i * total_loc;
    int shift_out = i * dimension + shift_h;
    for(int n = 0; n < total_loc; n++)
       out += IsNaNOrInf(H[shift_h + n * dimension] * Atten[shift_att + n], 0);
    matrix_out[shift_out] = Activation(out, ActFunc_LReLU);
   }
}
为了提高对异常值的鲁棒性并减轻异常值的影响,使用 LReLU 激活函数对结果值进行归一化。这有助于确保模型训练更加稳定,尤其是在处理不稳定或有噪声的数据集时。
此步骤完成了插值注意力的前向传递,并形成了变量 i 的最终表示,同时考虑了变量之间的内部关系和学习到的相关参数。
因此,这里描述的 OpenCL 内核实现了插值注意力机制的前向传播,有效地利用并行性来处理图结构中的元素。它能够基于潜在特征构建时间序列中元素之间交互的自适应模型,从而考虑上下文并使模型灵活地适应数据结构。
下一步工作是实现插值注意力机制的反向传播算法,我们还将把它打包成一个 OpenCL 内核。该函数计算前向传播过程中涉及的所有参数和输入数据的梯度。
该代码背后的主要思想是,对于每个元素,计算误差对中间变量的偏导数:隐藏特征 H 、注意力系数 Atten 、输入矩阵、权重和特征矩阵 GL 。
__kernel void InterpositionAttentionGrad(__global const float* matrix_in,
                                         __global float* matrix_in_gr,
                                         __global const float* W,
                                         __global float* W_gr,
                                         __global const float* A,
                                         __global float* A_gr,
                                         __global const float* GL,
                                         __global float* GL_gr,
                                         __global float* Adj,
                                         __global float* H,
                                         __global float* H_gr,
                                         __global float* Atten,
                                         __global float* matrix_out_gr,
                                         const int dimension
                                        )
  {
   const size_t i = get_global_id(0);
   const size_t j = get_local_id(1);
   const size_t total = get_global_size(0);
   const size_t total_loc = get_local_size(1);
在内核中,对于每个线程(由索引 i 和 j 标识),执行以下顺序计算:
- 考虑到 LeakyReLU 激活函数,根据输出梯度和注意力权重计算隐藏特征的梯度,即 Hgrad。
   const int shift_i = i * dimension;
   const int shift_j = j * dimension;
   const int shift_adj = i * total_loc + j;
//--- H Gradient
   for(int d = 0; d < dimension; d += total_loc)
     {
      if(j >= (dimension - d))
         break;
      float h_grad = 0;
      int shift_h = shift_i + d + j;
      int shift_att = i;
      int shift_out = d + j;
      for(int n = 0; n < total_loc; n++)
        {
         float gr = matrix_out_gr[shift_out + n * dimension];
         h_grad += IsNaNOrInf(
                      Deactivation(gr, gr, ActFunc_LReLU) * Atten[shift_att + n * total_loc], 0);
        }
      H_gr[shift_h] = h_grad;
      BarrierLoc;
     }
- 接下来,计算注意力系数 Attgrad 的梯度,并通过 SoftMax 反向传播,以确保注意力分布中的错误正确传播。
//--- Attention Gradient
   float att_grad = 0;
   for(int d = 0; d < dimension; d++)
     {
      float gr = matrix_out_gr[shift_i + d];
      gr = Deactivation(gr, gr, ActFunc_LReLU);
      att_grad += IsNaNOrInf(gr * H[shift_j + d], 0)
     }
   att_grad = LocalSoftMaxGrad(Atten[shift_adj], att_grad, 1);
- 然后,利用该梯度来更新关于隐藏特征 H 的梯度,同时考虑矩阵 A 中的权重,并累积关于矩阵 A 本身的梯度。
for(int d = 0; d < dimension; d++)
  {
   float h_grad = att_grad * A[d];
   h_grad = LocalSum(h_grad, 1);
   if(j == 0)
      H_gr[shift_i + d] += h_grad;
   h_grad = att_grad * A[dimension + d];
   h_grad = LocalSum(h_grad, 1);
   if(j == 0)
      H_gr[shift_j + d] += h_grad;
   float a_grad = att_grad * H[shift_i + d];
   a_grad = LocalSum(a_grad, 1);
   A_gr[d] += a_grad;
   a_grad = att_grad * H[shift_j + d];
   a_grad = LocalSum(a_grad, 1);
   A_gr[dimension + d] += a_grad;
  }
- 通过隐藏特征的梯度以及权重矩阵 W 本身,可以计算输入特征的梯度,从而在训练过程中正确更新输入数据。
//--- Input Gradient
   for(int d = 0; d < dimension; d += total_loc)
     {
      if(j >= (dimension - id_h))
         break;
      float grad = 0;
      for(int w = 0; w < dimension; w++)
         grad += IsNaNOrInf(H_gr[shift_i + w] * W[(id_h + j) + dimension * w], 0);
      matrix_in_gr[shift_i + d + j] = grad;
      BarrierLoc;
     }
- 最后,通过邻接矩阵上的 SoftMax 反向传播来计算自适应矩阵 GL 的梯度,并为变量 i 和 j 累加这些梯度。
//--- Adj Gradient
   float grad = LocalSoftMaxGrad(Adj[shift_adj], att_grad, 1);
   for(int d = 0; d < dimension; d++)
     {
      GL_gr[shift_i + d] += IsNaNOrInf(grad * GL[shift_j + d], 0);
      GL_gr[shift_j + d] += IsNaNOrInf(grad * GL[shift_i + d], 0);
     }
  }
该函数的整体结构是使用本地线程同步( BarrierLoc )构建的,这确保了线程间数据交换的正确性,并防止了竞争条件。
这种方法确保了在训练过程中对所有模型参数进行准确且稳定的更新,从而能够有效调整权重,并提高多元时间序列中缺失值填充的质量。
至此,我们完成了 OpenCL 程序中关键组件的实现。下一步合乎逻辑的步骤是在主程序内组织整个流程 — 使用 MQL5 工具进行集成、计算管理和模型训练。然而,内容已经大幅增加,为了保持演示的清晰度和质量,我建议我们休息一下。
我们将在下一篇文章中继续这项重要的工作,详细讨论该算法在 MQL5 中的实际实现、与 OpenCL 交互的具体细节以及性能优化。这样,我们就可以在每个阶段都保持专注,而不必操之过急,同时还能保持对主题探索的深度和彻底性。
结论
总之,值得强调的是,本文提出的 GinAR 框架展示了一种强大的预测含缺失值的多变量时间序列的方法。将插值注意力机制和自适应图卷积集成到递归架构中,能够有效插补,并考虑复杂的时空依赖关系。
本文展示的基于 OpenCL 的关键组件实际实现,为进一步优化和集成到现实世界的交易系统中提供了广泛的机会。
未来的工作将集中在将这些开发成果整合到 MQL5 的主程序中,这将使我们能够充分发挥所提出方法的潜力。请读者们在下一篇文章中继续探讨这个话题。
参考
本文中用到的程序
| # | 名称 | 类型 | 描述 |
|---|---|---|---|
| 1 | Study.mq5 | EA | 离线模型训练的 EA |
| 2 | StudyOnline.mq5 | EA | 在线模型训练的 EA |
| 3 | Test.mq5 | EA | 模型测试 EA |
| 4 | Trajectory.mqh | 类库 | 描述系统状态和模型架构的结构 |
| 5 | NeuroNet.mqh | 类库 | 用于构建神经网络的类库 |
| 6 | NeuroNet.cl | 程序库 | OpenCL 程序的代码库 |
本文由MetaQuotes Ltd译自俄文
原文地址: https://www.mql5.com/ru/articles/18854
注意: MetaQuotes Ltd.将保留所有关于这些材料的权利。全部或部分复制或者转载这些材料将被禁止。
本文由网站的一位用户撰写,反映了他们的个人观点。MetaQuotes Ltd 不对所提供信息的准确性负责,也不对因使用所述解决方案、策略或建议而产生的任何后果负责。

 MQL5自动化交易策略(第二十九部分):构建基于价格行为的加特利谐波形态交易系统
 交易中的神经网络:解耦结构化分量——编码器实现
 新手在交易中的10个基本错误
 交易中的神经网络:结构化分量解耦(SCNN)
