

Neuronale Netze im Handel: Probabilistische Zeitreihenprognose (Fazit)
 36
 2

Einleitung
Finanzielle Zeitreihen gehören nach wie vor zu den Datenarten, deren Analyse die größten Herausforderungen mit sich bringt. Ihr Verhalten lässt sich kaum als stabil bezeichnen: Hier gibt es keine klaren Muster, sondern vielmehr eine Kombination aus Trends, Zyklen, Rauschen und unerwarteten strukturellen Verschiebungen. Aus diesem Grund erweisen sich traditionelle Modelle wie die lineare Regression oder gleitende Durchschnitte trotz ihrer Einfachheit und Schnelligkeit in den meisten Fällen als unzureichend. Andererseits leiden moderne Lösungen auf Basis neuronaler Netze, die über eine enorme Ausdruckskraft verfügen, häufig unter Überanpassung, Instabilität und mangelnder Interpretierbarkeit.
Unter solchen Umständen sind hybride Ansätze, die bewährte mathematische Konstrukte mit der Flexibilität neuronaler Netze verbinden, besonders interessant. Genau auf diesem Gleichgewicht basiert das K²VAE-Framework – ein System, das darauf ausgelegt ist, Zeitreihen unter Berücksichtigung ihrer realen Eigenschaften zu analysieren und zu prognostizieren. Ein wesentlicher Vorteil dieses Frameworks besteht darin, dass es die zugrunde liegende Dynamik des Systems erfassen kann, indem es aus Abfolgen von Marktzuständen lernt und seine Schlussfolgerungen anpasst, sobald neue Daten eintreffen.
Das Framework basiert auf drei Grundgedanken, die sich gegenseitig ergänzen und die jeweiligen Schwächen ausgleichen. Die erste ist die Koopman-Repräsentation, deren Ziel es ist, das Verhalten eines nichtlinearen Systems auf einen linearen Unterraum abzubilden. Diese Transformation ist zwar nur eine Näherung, stellt jedoch ein leistungsfähiges Instrument zur Beschreibung und Prognose dar, das es uns ermöglicht, mit Zeitreihen nicht auf der Ebene oberflächlicher Statistiken zu arbeiten, sondern durch die Rekonstruktion der zugrunde liegenden Dynamik.
Die zweite Idee ist die Verwendung des Kalman-Filters, allerdings nicht in seiner kanonischen Form, sondern in einer stabilisierten Form, die für den Einsatz in stochastischen Architekturen neuronaler Netze geeignet ist. Der Kalman-Filter fungiert hier als adaptiver Korrektor: Er verfeinert die vom KoopmanNet-Modul gelieferten Schätzwerte auf der Grundlage neuer Beobachtungen und liefert gleichzeitig Informationen über den Konfidenzgrad der einzelnen Prognosen. Dies ist besonders wertvoll, wenn der Schwerpunkt nicht nur auf der Preisprognose liegt, sondern auf der Einschätzung der Wahrscheinlichkeit bestimmter Szenarien.
Die dritte Idee ist die Integration eines Variational Autoencoders. Dadurch können wir probabilistische Prognosen anstelle von Punktprognosen erstellen: Anstelle eines einzigen möglichen Szenarios erhalten wir eine vollständige Verteilung, die sowohl den Haupttrend als auch mögliche Abweichungen widerspiegelt.
Somit ist K²VAE mehr als nur ein weiteres Modell im analytischen Instrumentarium; es handelt sich um ein System, das in der Lage ist, Unsicherheit quantitativ zu beschreiben, alternative Szenarien zu berücksichtigen und sich an neue Marktbedingungen anzupassen.
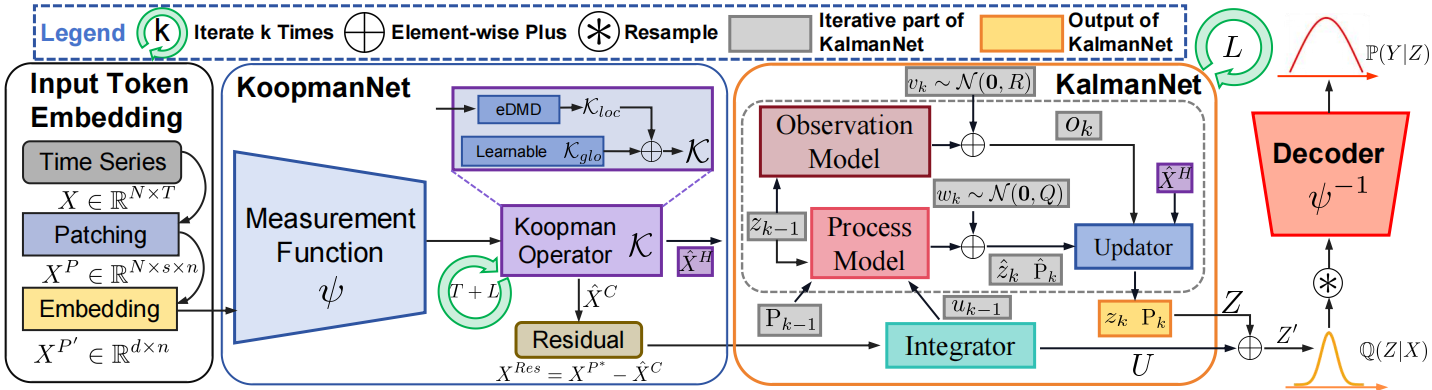
In früheren Artikeln haben wir die wichtigsten Komponenten dieses Frameworks bereits ausführlich beleuchtet. Wir haben beschrieben, wie KoopmanNet funktioniert, wie die latente Repräsentation gebildet wird, wie der Kalman-Filter in die Architektur integriert ist und wie alle Elemente gemeinsam trainiert werden. Besonderes Augenmerk wurde auf die numerische Stabilität und die Mechanismen der Informationsweitergabe innerhalb des Modells gelegt.
Modellarchitektur
Nach der schrittweisen Erstellung der einzelnen Komponenten, die das architektonische Fundament des K²VAE-Frameworks bilden, gehen wir zur nächsten logischen Phase über – der Integration aller Elemente in ein einziges funktionsfähiges System.
Es sei betont, dass es, wie bereits in unseren früheren Arbeiten, nicht unser Ziel ist, ein Prognosemodell in seiner klassischen, isolierten Form zu erstellen. Die Prognose ist hier lediglich ein Nebenprodukt, das gegenüber der grundlegenderen Aufgabe, eine aussagekräftige und stabile latente Repräsentation des aktuellen Umgebungszustands zu erstellen, zweitrangig ist. Diese Repräsentation fasst nicht nur die eingehenden Informationen zusammen, sondern dient dem trainierbaren Agenten auch als wichtige Eingabegröße für Handelsentscheidungen.
Daher betrachten wir das K²VAE-Framework nicht als eigenständiges Prognosemodell, sondern als einen fortschrittlichen Encoder für den Umgebungszustand, der in die zuvor implementierte Architektur auf Basis des Actor-Director-Critic-Ansatzes integriert ist. Hier dient die VAE-Komponente als Mechanismus zur Erzeugung einer probabilistischen Beschreibung zukünftiger Szenarien, KoopmanNet ist für die lineare Dynamik im latenten Raum zuständig und der Kalman-Filter führt auf Grundlage eingehender Beobachtungen Korrekturen und Verfeinerungen durch. All dies dient einem einzigen Zweck – dem Agenten eine Repräsentation der externen Umgebung bereitzustellen, die möglichst viele nützliche Informationen für wohlüberlegte und statistisch fundierte Handelsentscheidungen enthält.
Die Integration von K²VAE-Komponenten in die Actor-Director-Critic-Architektur verleiht dem System die erforderliche Tiefe und Stabilität. Folglich enthält der vom Encoder gebildete latente Zustand nicht nur Informationen über den aktuellen Stand der Dinge, sondern auch über die wahrscheinlichen Trajektorien seiner Entwicklung. Dies verbessert das Verhalten des Agenten in qualitativer Hinsicht: Er reagiert nicht einfach nur auf aktuelle Signale, sondern handelt unter Berücksichtigung möglicher Szenarien, was unter hochvolatilen und unvorhersehbaren Marktbedingungen besonders wichtig ist.
An dieser Stelle kommt die CreateDescriptions-Methode ins Spiel. Sie ist für die Zusammenstellung aller Architekturbeschreibungen zuständig – von den Encoder- und Prognosemodulen bis hin zu den Entscheidungsmodulen. Diese Methode schafft die Grundlage für das zukünftige Training, indem sie festlegt, welche Schichten innerhalb der einzelnen Komponenten unseres Systems in welcher Reihenfolge verwendet werden.
bool CreateDescriptions(CArrayObj *&encoder,
                        CArrayObj *&forecast1,
                        CArrayObj *&forecast2,
                        CArrayObj *&forecast3,
                        CArrayObj *&actor,
                        CArrayObj *&director,
                        CArrayObj *&critic
                       )
  {
//---
   CLayerDescription *descr;
//---
   if(!encoder)
     {
      encoder = new CArrayObj();
      if(!encoder)
         return false;
     }
   if(!forecast1)
     {
      forecast1 = new CArrayObj();
      if(!forecast1)
         return false;
     }
   if(!forecast2)
     {
      forecast2 = new CArrayObj();
      if(!forecast2)
         return false;
     }
   if(!forecast3)
     {
      forecast3 = new CArrayObj();
      if(!forecast3)
         return false;
     }
   if(!actor)
     {
      actor = new CArrayObj();
      if(!actor)
         return false;
     }
   if(!director)
     {
      director = new CArrayObj();
      if(!director)
         return false;
     }
   if(!critic)
     {
      critic = new CArrayObj();
      if(!critic)
         return false;
     }
In den Methodenparametern erhalten wir Zeiger auf eine Reihe dynamischer Arrays – jeweils eines pro Modell. Dies sind Container, in denen die Architekturbeschreibungen der neuronalen Netzwerkblöcke gespeichert werden. Bevor wir sie ausfüllen, führen wir eine obligatorische Überprüfung durch, um sicherzustellen, dass die erhaltenen Zeiger korrekt sind. Fehlt das benötigte Objekt, versuchen wir nicht, mit einem ungültigen Zeiger zu arbeiten, sondern legen stattdessen sauber eine neue Array-Instanz an. Dieser Schritt mag wie eine technische Formalität erscheinen, doch in der Praxis legt gerade er die Grundlage für die Stabilität aller weiteren Arbeitsschritte.
Danach beginnt der Hauptteil – das Befüllen jedes Arrays mit den entsprechenden Schichten und Verbindungen, die die vollständige Konfiguration des neuronalen Netzes bilden. Beginnen wir mit der zentralen Komponente des Systems – dem Encoder für den Umgebungszustand. In diese Komponente integrieren wir die Kernideen, die dem K²VAE-Framework zugrunde liegen. Zur Erinnerung: Die Aufgabe des Encoder besteht nicht lediglich darin, Informationen über die Marktbedingungen zu sammeln, sondern eine aussagekräftige und informative latente Repräsentation zu erstellen, die als zuverlässige Grundlage für Handelsentscheidungen durch den Agenten dienen kann.
Wir leiten die direkt vom Terminal empfangenen rohen Eingabedaten an die vollverbundene Schicht weiter. Hier dient sie als Schnittstelle zwischen der Außenwelt und der internen Logik des Modells.
//--- Encoder
   encoder.Clear();
//--- Input layer
   if(!(descr = new CLayerDescription()))
      return false;
   descr.type = defNeuronBaseOCL;
   uint prev_count = descr.count = (HistoryBars * BarDescr);
   descr.activation = None;
   descr.optimization = ADAM;
   if(!encoder.Add(descr))
     {
      delete descr;
      return false;
     }
//--- layer 1
   if(!(descr = new CLayerDescription()))
      return false;
   descr.type = defNeuronBatchNormWithNoise;
   descr.count = prev_count;
   descr.batch = BatchSize;
   descr.activation = None;
   descr.optimization = ADAM;
   if(!encoder.Add(descr))
     {
      delete descr;
      return false;
     }
Die Daten werden anschließend an die Vorverarbeitungsstufe weitergeleitet – die Batch-Normalisierungsschicht. Hier werden unterschiedliche Eingabemerkmale, die sich hinsichtlich Skalierung, Wertebereich oder physikalischer Bedeutung unterscheiden, in eine vergleichbare Form gebracht. Dieser Schritt ist nicht nur im Hinblick auf die numerische Stabilität wichtig, sondern auch aus Sicht des Trainings des gesamten Modells: Normalisierte Daten ermöglichen es dem neuronalen Netzwerk, schneller zu konvergieren und Zusammenhänge zwischen Merkmalen genauer zu erfassen.
In diesem Zusammenhang fungiert die Batch-Normalisierung als Filter, der statistisches Rauschen glättet und die Verteilungen der einzelnen Komponenten des Eingangssignals ausgleicht. Dadurch entsteht eine stabile und vorhersehbare Umgebung für weitere Transformationen, wodurch Verzerrungen in der Anfangsphase der Verarbeitung minimiert werden.
Sobald die Daten normalisiert sind, sind sie bereit für den nächsten wichtigen Schritt – die räumliche Aufteilung, auch Patching genannt. Die Autoren des ursprünglichen K²VAE-Frameworks schlagen vor, die vorverarbeiteten Eingabedaten in nicht überlappende Patches zu unterteilen, von denen jeder ein Fragment des gesamten Datenstroms darstellt. Gleichzeitig werden Werte aus verschiedenen Kanälen in einem einzelnen Patch kombiniert, wodurch das Modell auf natürliche Weise lernen kann, merkmalsübergreifende Abhängigkeiten zu erkennen.
In unserer Implementierung sind wir jedoch noch einen Schritt weiter gegangen und haben beschlossen, uns nicht auf das Standard-Patching-Schema zu beschränken; stattdessen haben wir eine komplexere Struktur implementiert, die von einer Reihe moderner Architekturen inspiriert ist, die wir bereits in unseren Artikeln behandelt haben. Zunächst erweitern wir das Eingabemerkmals-Array um Differenzmerkmale, die Änderungen zwischen aufeinanderfolgenden Werten der einzelnen Kanäle erfassen. Dadurch lassen sich kurzfristige Signaldynamiken berücksichtigen und die Empfindlichkeit des Modells gegenüber Veränderungen der Marktstruktur erhöhen, während gleichzeitig seine Robustheit gegenüber Rauschen erhalten bleibt.
//--- layer 2
   if(!(descr = new CLayerDescription()))
      return false;
   descr.type = defNeuronConcatDiff;
   prev_count = descr.count = HistoryBars;
   descr.layers = BarDescr;
   descr.step = 1;
   descr.batch = BatchSize;
   descr.optimization = ADAM;
   descr.activation = None;
   if(!encoder.Add(descr))
     {
      delete descr;
      return false;
     }
Den Daten werden dann Zeitstempel hinzugefügt – ein wichtiges Element, das es dem Modell ermöglicht, nicht nur die Merkmalswerte, sondern auch deren zeitliche Position zu berücksichtigen. Diese Zeitstempel liefern dem neuronalen Netzwerk Kontextinformationen über den tatsächlichen Zeitpunkt, zu dem ein Ereignis stattgefunden hat, sei es etwa auf Minuten-, Stunden- oder Wochentagsebene oder einer anderen Zeitskala. Dadurch ist das Modell in der Lage, wiederkehrende Muster und saisonale Schwankungen zu erkennen, die für finanzielle Zeitreihen charakteristisch sind. Die Einbeziehung dieser zeitlichen Informationen ist besonders wichtig bei der Arbeit mit historischen Kursdaten, bei denen zyklische Muster eine entscheidende Rolle bei der Entwicklung von Handelsstrategien spielen.
//--- layer 3
   if(!(descr = new CLayerDescription()))
      return false;
   descr.type = defMamba4CastEmbeding;
   prev_count = descr.count = HistoryBars;
   descr.window = 2 * BarDescr;
   uint prev_out = descr.window_out = NSkills;
     {
      uint temp[] = {PeriodSeconds(PERIOD_H1), PeriodSeconds(PERIOD_D1)};
      if(ArrayCopy(descr.windows, temp) < (int)temp.Size())
         return false;
     }
   descr.batch = BatchSize;
   descr.optimization = ADAM;
   descr.activation = None;
   if(!encoder.Add(descr))
     {
      delete descr;
      return false;
     }
//--- layer 4
   if(!(descr = new CLayerDescription()))
      return false;
   descr.type = defNeuronTransposeOCL;
   descr.count = prev_count;
   prev_count = descr.window = prev_out;
   descr.batch = BatchSize;
   descr.optimization = ADAM;
   descr.activation = None;
   if(!encoder.Add(descr))
     {
      delete descr;
      return false;
     }
   prev_out = descr.count;
An dieser Stelle sollte ein wichtiger Punkt hervorgehoben werden: Verschiedene Eingangskanäle können unterschiedliche interne Rhythmen aufweisen – das heißt, sie können Zyklen mit unterschiedlichen Perioden zeigen. Unter solchen Bedingungen kann eine einfache mechanische Zusammenführung der Werte aller Kanäle zu einem einzigen Datenstrom verborgene saisonale Abhängigkeiten verschleiern und die Signaldynamik verzerren.
Um den Verlust dieser Merkmale zu vermeiden, haben wir einen adaptiven Faltungsmechanismus implementiert. Sein Zweck besteht darin, die Beschaffenheit jeder zeitlichen Sequenz zu analysieren und Patches zu erzeugen, die die individuellen Merkmale des Kanals berücksichtigen. Somit erhält jeder Kanal die gleiche Anzahl von Repräsentationen im latenten Raum, während die Empfindlichkeit gegenüber seiner spezifischen Periodizität erhalten bleibt.
//--- layer 5
   if(!(descr = new CLayerDescription()))
      return false;
   descr.type = defNeuronAdaptConv;
   descr.count = Segments;
   descr.window = 2 * prev_out / Segments;
   descr.variables = prev_count;
   prev_out = descr.window_out = EmbeddingSize;
   descr.batch = BatchSize;
   descr.optimization = ADAM;
   descr.activation = None;
   if(!encoder.Add(descr))
     {
      delete descr;
      return false;
     }
   prev_count = descr.count;
   uint prev_var = descr.variables;
Wir fügen den generierten Patches eine RoPE-Kodierung (Rotary Positional Encoding) hinzu, die dem Modell Informationen über die relative Position jedes Elements in der zeitlichen Abfolge liefert. Im Gegensatz zu klassischen Positionskodierungen berücksichtigt RoPE Positionsinformationen durch die Drehung des Merkmalsvektors im latenten Raum. Dadurch bleibt die zeitliche Struktur der Daten bei der anschließenden Verarbeitung durch Transformer-Schichten erhalten, und Informationen über die Abstände zwischen Ereignissen können effizient weitergegeben werden. Dieser Ansatz ist besonders wichtig bei der Zeitreihenanalyse, bei der die Reihenfolge und die Zeitabstände zwischen den Ereignissen eine entscheidende Rolle spielen.
//--- layer 6
   if(!(descr = new CLayerDescription()))
      return false;
   descr.type = defNeuronRoPE;
   descr.count = prev_count;
   descr.window = prev_out;
   descr.variables = prev_var;
   descr.batch = BatchSize;
   descr.optimization = ADAM;
   descr.activation = None;
   if(!encoder.Add(descr))
     {
      delete descr;
      return false;
     }
Anschließend transponieren wir den resultierenden dreidimensionalen Tensor, der aus Patches unabhängiger Kanäle besteht, in das Format einer zeitlichen Sequenz gemischter Patches. Diese Transformation ermöglicht es uns, von einer Struktur der Form [Kanäle × Patches × Merkmale] zu einer Form überzugehen, die sich besser für die Verarbeitung durch ein sequentielles Modell eignet: [Patches × Kanäle × Merkmale], wobei jeder Patch nun einen zeitlichen Ausschnitt darstellt, der Daten aus allen Kanälen gleichzeitig enthält. Auf diese Weise bereiten wir die Daten für die anschließende Verarbeitung im K²VAE-Encoder vor und lenken die Aufmerksamkeit des Modells auf die Beziehungen zwischen den Merkmalen innerhalb des gesamten zeitlichen Verlaufs.
//--- layer 7
   if(!(descr = new CLayerDescription()))
      return false;
   descr.type = defNeuronTransposeRCDOCL;
   descr.count = prev_var;
   descr.window = prev_count;
   descr.step = prev_out;
   descr.batch = BatchSize;
   descr.optimization = ADAM;
   descr.activation = None;
   if(!encoder.Add(descr))
     {
      delete descr;
      return false;
     }
Dieser Ansatz zur Datendarstellung steht voll und ganz im Einklang mit den Kernideen der Autoren des K²VAE-Frameworks, insbesondere mit dem Ziel, heterogene Informationen in einem einzigen latenten Raum zu integrieren. Im Gegensatz zur Baseline-Implementierung haben wir jedoch wichtige Eigenschaften der Zeitreihenstruktur beibehalten – insbesondere die Zyklizität einzelner Kanäle –, was für Finanzdaten von entscheidender Bedeutung ist. Darüber hinaus haben wir durch erweitertes Patching, schrittweise Abweichungen und Zeitstempel die Eingaberepräsentation angereichert und so die Fähigkeit des Modells verbessert, stabile Muster und saisonale Abhängigkeiten zu erkennen, ohne dabei die Nuancen der einzelnen Datenquellen zu verlieren.
Die generierten Patches, die angereicherte und strukturierte Informationen über den aktuellen Umgebungszustand enthalten, werden in den K²VAE-Encoder eingespeist. In dieser Phase findet eine probabilistische Kodierung statt: Jede Eingabesequenz wird am Ausgang des Blocks in eine Verteilung von Embeddings umgewandelt. Jedes einzelne Embedding in dieser Verteilung stellt eine kompakte und dennoch aussagekräftige, komprimierte Beschreibung eines der möglichen Szenarien für die Entwicklung der analysierten Zeitreihe dar. Somit erzeugt das Modell nicht nur eine einzelne Punktschätzung des zukünftigen Zustands, sondern eine Reihe probabilistischer Hypothesen, die die Vielfalt potenzieller Trajektorien widerspiegeln. Dies ist angesichts der hohen Unsicherheit, die den Finanzmärkten innewohnt, besonders wichtig.
//--- layer 8
   if(!(descr = new CLayerDescription()))
      return false;
   descr.type = defNeuronK2VAEEncoder;
     {
      uint temp[] = {prev_count,                        // units in
                     NScenarios,                        // Scenarios
                     NExperts,                          // MoE
                     TopK                               // Top K
                    };
      if(ArrayCopy(descr.units, temp) < int(temp.Size()))
         return false;
     }
   descr.step = NHeads;
     {
      uint temp[] = {prev_out * prev_var,               // window
                     prev_out * prev_var / descr.step,  // Key dimension
                     2 * prev_out*prev_var / NExperts   // MoE dimension
                    };
      if(ArrayCopy(descr.windows, temp) < int(temp.Size()))
         return false;
     }
   descr.layers = 3;
   descr.variables = 1;
   descr.batch = BatchSize;
   descr.activation = None;
   descr.optimization = ADAM;
   if(!encoder.Add(descr))
     {
      delete descr;
      return false;
     }
An dieser Stelle ist es wichtig zu beachten, dass es sich ausdrücklich um die Verteilung im latenten Raum handelt, die am Ausgang des K²VAE-Encoders erhalten wird und an den Agenten zur anschließenden Handelsentscheidungsfindung weitergeleitet wird. Um jedoch die Aussagekraft und den praktischen Nutzen dieses latenten Zustands – nämlich seine Fähigkeit, Informationen über die wahrscheinlichsten Szenarien für das zukünftige Verhalten der Zeitreihe zu enthalten – sicherzustellen, müssen wir innerhalb des Modells eine vollständige Prognose-Pipeline aufbauen.
Wie bereits erwähnt, besteht das Ziel unseres Frameworks nicht darin, eine genaue Prognose im herkömmlichen Sinne zu erstellen. Dennoch müssen wir den Trainingsprozess so gestalten, dass sich der Fehlergradient vom Endergebnis bis zu jedem Element der Wahrscheinlichkeitsverteilung der Embeddings zurück ausbreiten kann. Dazu fügen wir eine spezialisierte Schicht namens TimeMoEAttention hinzu.
Diese Schicht erfüllt eine wichtige Funktion: Sie aggregiert probabilistische Embeddings, bildet daraus eine einheitliche Repräsentation und schafft so das erforderliche funktionale Analogon eines herkömmlichen Prognosemodells. Dieser Ansatz ermöglicht es uns, den probabilistischen Charakter des latenten Raums mit den Anforderungen an Trainierbarkeit und Optimierung zu verbinden, sodass die Verteilung anhand des Endergebnisses Ende zu Ende trainiert werden kann
//--- layer 9
   if(!(descr = new CLayerDescription()))
      return false;
   descr.type = defNeuronTimeMoEAttention;
   descr.window_out = EmbeddingSize;
     {
      uint temp[] = {prev_out, prev_out, 8, TopK};               //Window Main, Window Cross, Experts dimension, TopK
      if(ArrayCopy(descr.windows, temp) < ArraySize(temp))
         return false;
     }
     {
      uint temp[] = {prev_var, prev_var * NScenarios, NExperts}; //Units Main, Units Cross, Experts
      if(ArrayCopy(descr.units, temp) < ArraySize(temp))
         return false;
     }
   descr.layers = 3;
   descr.step = NHeads;                                          // Attention heads
   descr.batch = BatchSize;
   descr.activation = None;
   descr.optimization = ADAM;
   if(!encoder.Add(descr))
     {
      delete descr;
      return false;
     }//---
   CLayerDescription *latent = descr;
Als Nächstes widmen wir uns dem Aufbau der Architektur von drei standardmäßigen Prognosemodellen, von denen jedes für Vorhersagen über seinen eigenen Prognosehorizont zuständig ist – kurzfristig, mittelfristig und langfristig. Diese Modelle spielen eine wichtige Rolle: Sie bilden die im Encoder gebildete latente Repräsentation zurück in den Raum der beobachteten Daten ab. Somit wird jeder Zustand anhand von realen Größen interpretiert, die mögliche Szenarien für das zukünftige Verhalten der Zeitreihe widerspiegeln.
Es sei darauf hingewiesen, dass die Architekturen dieser Prognosemodelle in unseren früheren Veröffentlichungen ausführlich erörtert wurden. Sie haben sich in der Praxis bewährt, und genau aus diesem Grund wurden sie unverändert wiederverwendet. In diesem Artikel werden wir nicht näher auf die technischen Details ihrer Konstruktion eingehen.
Der nächste logische Schritt besteht darin, die Architektur des Actor für den Handel – des zentralen Elements des Entscheidungssystems – aufzubauen. Seine Aufgabe besteht darin, auf der Grundlage der verfügbaren Informationen die beste Handelsaktion auszuwählen. Im Gegensatz zu klassischen Vorhersagemodellen versucht der Actor nicht, das zukünftige Marktverhalten direkt vorherzusagen; stattdessen nutzt er die vom Encoder gelieferte probabilistische Beschreibung möglicher Szenarien, um die potenzielle Wirksamkeit jeder möglichen Handelsaktion zu bewerten.
Das Actor-Modell erhält zwei Informationsquellen als Eingabe. Die erste Informationsquelle ist der aktuelle Kontozustand einschließlich offener Positionen, Equity und weiterer Zusatzinformationen. Die zweite ist die Verteilung der vom K²VAE-Encoder gewonnenen latenten Repräsentationen, wobei jede Repräsentation ein mögliches zukünftiges Marktszenario beschreibt. Diese Verteilung liefert nicht nur Informationen über die wahrscheinlichsten Verläufe, sondern vermittelt auch den Grad der Unsicherheit des Modells in Bezug auf diese Szenarien.
Als erste Schicht verwenden wir wie zuvor eine vollverbundene Schicht, die als externe Schnittstelle des Modells dient. Über diese Schnittstelle erhält der Actor Informationen über den aktuellen Kontozustand als Eingabe.
//--- Actor
   latent = encoder.At(LatentLayer);
   actor.Clear();
//--- Input layer
   if(!(descr = new CLayerDescription()))
      return false;
   descr.type = defNeuronBaseOCL;
   descr.count = AccountDescr;
   descr.activation = None;
   descr.optimization = ADAM;
   if(!actor.Add(descr))
     {
      delete descr;
      return false;
     }
//--- layer 1
   if(!(descr = new CLayerDescription()))
      return false;
   descr.type = defNeuronBatchNormOCL;
   descr.count = AccountDescr;
   descr.batch = BatchSize;
   descr.activation = None;
   descr.optimization = ADAM;
   if(!actor.Add(descr))
     {
      delete descr;
      return false;
     }
Die Eingabedaten werden mithilfe einer Batch-Normalisierungsschicht in eine vergleichbare Form normiert. Dadurch lassen sich Skalenunterschiede zwischen den Merkmalen beseitigen und eine stabile Arbeitsweise der nachfolgenden Modellschichten gewährleisten, unabhängig von den ursprünglichen Größenordnungen und der Art der Daten.
Nachdem die Daten zum Kontozustand in eine vergleichbare Form normiert wurden, werden sie an das Cross-Attention-Modul weitergeleitet, das diese Informationen im Kontext der Wahrscheinlichkeitsverteilung zukünftiger Umgebungszustände berücksichtigt.
Hier ist es wichtig, einen zentralen Unterschied zu klassischen Modellen hervorzuheben: Der Actor reagiert nicht einfach nur auf die aktuelle Situation, sondern bewertet die mit der Entscheidungsfindung verbundenen Risiken unter Berücksichtigung der Breite und Form der Verteilung zukünftiger Szenarien. Je sicherer der Encoder hinsichtlich seiner Prognose ist (was sich in einer engeren und konzentrierteren Verteilung äußert), desto geringer ist die Streuung der Szenarien, die der Actor erhält. In diesem Fall kann er entschlossener handeln – beispielsweise durch eine Erhöhung des Positionsvolumens oder durch die Verwendung aggressiverer Handelsparameter. Somit passt sich die Strategie adaptiv an das sich ändernde Ausmaß der Marktunsicherheit an.
//--- layer 2
   if(!(descr = new CLayerDescription()))
      return false;
   descr.type = defNeuronCrossDMHAttention;
     {
      uint temp[] = {AccountDescr,           // Inputs window
                     latent.windows[0]       // Cross window
                    };
      if(ArrayCopy(descr.windows, temp) < (int)temp.Size())
         return false;
     }
     {
      uint temp[] = {1,                      // Input units
                     latent.units[1]         // Cross units
                    };
      if(ArrayCopy(descr.units, temp) < (int)temp.Size())
         return false;
     }
   descr.step = NHeads;                      // Heads
   descr.window_out = 8;
   descr.batch = 1e4;
   descr.layers = 2;
   descr.activation = None;
   descr.optimization = ADAM;
   if(!actor.Add(descr))
     {
      delete descr;
      return false;
     }
Die verarbeiteten Informationen werden anschließend in ein dreischichtiges, vollverbundenes neuronales Netzwerk (MLP) eingespeist, das die Verarbeitungskette abschließt und die endgültige Handelsentscheidung generiert. In dieser Phase werden alle Merkmale integriert: der aktuelle Kontozustand, die probabilistische Darstellung der Zukunft und der durch den Aufmerksamkeitsmechanismus ermittelte Kontext. Das Modell analysiert das Zusammenspiel dieser Faktoren und bestimmt die Richtung des Trades sowie dessen Parameter. Trotz ihrer scheinbaren Einfachheit spielt diese Struktur eine entscheidende Rolle bei der Gewährleistung der Flexibilität und Anpassungsfähigkeit des gesamten Handelssystems.
//--- layer 3
   if(!(descr = new CLayerDescription()))
      return false;
   descr.type = defNeuronBaseOCL;
   descr.count = LatentCount;
   descr.batch = BatchSize;
   descr.activation = TANH;
   descr.optimization = ADAM;
   if(!actor.Add(descr))
     {
      delete descr;
      return false;
     }
//--- layer 4
   if(!(descr = new CLayerDescription()))
      return false;
   descr.type = defNeuronBaseOCL;
   descr.count = LatentCount;
   descr.activation = TANH;
   descr.batch = BatchSize;
   descr.optimization = ADAM;
   if(!actor.Add(descr))
     {
      delete descr;
      return false;
     }
//--- layer 5
   if(!(descr = new CLayerDescription()))
      return false;
   descr.type = defNeuronBaseOCL;
   descr.count = 2 * NActions;
   descr.activation = SIGMOID;
   descr.optimization = ADAM;
   if(!actor.Add(descr))
     {
      delete descr;
      return false;
     }
Der Actor-Ausgang verwendet einen stochastischen Kopf zur Generierung von Handelsentscheidungen, der über die CNeuronVAEOCL-Schicht implementiert ist.
//--- layer 6
   if(!(descr = new CLayerDescription()))
      return false;
   descr.type = defNeuronVAEOCL;
   descr.count = NActions;
   descr.optimization = ADAM;
   if(!actor.Add(descr))
     {
      delete descr;
      return false;
     }
//--- layer 7
   if(!(descr = new CLayerDescription()))
      return false;
   descr.type = defNeuronConvOCL;
   descr.count = NActions / 3;
   descr.window = 3;
   descr.step = 3;
   descr.window_out = 3;
   descr.activation = SIGMOID;
   descr.optimization = ADAM;
   if(!actor.Add(descr))
     {
      delete descr;
      return false;
     }
Auf den ersten Blick mag ein solcher Ansatz übermäßig riskant erscheinen: Die Kombination der Wahrscheinlichkeitsverteilung zukünftiger Szenarien mit dem inhärent probabilistischen Charakter des Actor-Kopfes erhöht in der Tat den Zufallsanteil im Entscheidungsprozess. Vor dem Hintergrund der tatsächlichen Marktbedingungen wirft dies berechtigte Bedenken auf.
Der Kerngedanke dieses Ansatzes besteht jedoch darin, dass sich die stochastische Natur des Actor nur in den frühen Phasen des Modelltrainings vollständig ausdrückt. In dieser Phase erkundet der Actor aktiv mögliche Verhaltensweisen und lernt dabei aus einer Vielzahl von Reaktionen der Umgebung. Mit zunehmender Erfahrung und der Neubewertung der Ergebnisse konzentriert sich die Ausgabeverteilung immer stärker auf die besten Strategien, während die Streuung abnimmt. Infolgedessen stabilisiert sich das Verhalten des Actor und gewinnt die Zielgerichtetheit und Fokussierung, die für eine sichere Entscheidungsfindung unter realen Marktbedingungen erforderlich sind.
Die Bewertungsmodelle der Komponenten Director und Critic spiegeln weitgehend die Architektur des Actor wider und behalten dabei dieselbe Gesamtstruktur sowie dieselben Prinzipien der Datenverarbeitung bei. Der Hauptunterschied liegt in der Quelle des primären Eingabedatenstroms: Anstelle des aktuellen Kontozustands verwenden sie als Eingabe einen vom Actor generierten Tensor von Aktionen. Dadurch können sie jede Aktion fundierter und detaillierter bewerten.
Allerdings fehlt hier der für den Actor charakteristische stochastische Kopf für die Entscheidungsfindung. Anstelle einer Wahrscheinlichkeitsverteilung über Aktionen generieren der Director und der Critic konkrete Bewertungen und Qualitätssignale für jede Aktion. Dieses detaillierte Feedback hilft dem Actor, seine Strategien zu verfeinern und die Effektivität seiner Handelsentscheidungen zu verbessern.
Der vollständige Quellcode, der den architektonischen Aufbau aller Modelle beschreibt, ist im Anhang enthalten.
Training
Sobald wir die Phase der Architekturplanung für alle Modellkomponenten abgeschlossen haben, gehen wir zum nächsten Schritt über – dem Trainingsprozess. Wie bereits in früheren Arbeiten ist der Prozess in zwei Phasen gegliedert. In der ersten Phase führen wir ein Offline-Training anhand historischer Daten durch, die direkt im Terminal verfügbar sind. Das Besondere an diesem Ansatz ist, dass das Training ohne einen vorab vorbereiteten Trainingsdatensatz durchgeführt wird. Stattdessen integrieren wir einen Mechanismus zur Aktionsbewertung direkt in den Trainingsprozess; dies erweitert den Umfang der für die anfängliche Trainingsphase verfügbaren historischen Daten erheblich und beseitigt die Notwendigkeit einer manuellen Kennzeichnung oder der Erstellung spezieller Datensätze.
An dieser Stelle lohnt es sich, einem wichtigen Punkt, der sich bei früheren Experimenten herausgestellt hat, besondere Aufmerksamkeit zu schenken. Bei der Verwendung des Actor-Modells zur Aktionsbewertung über einen begrenzten Horizont prognostizierter Zustände hinweg lässt sich ein anhaltendes unerwünschtes Verhalten beobachten. Das Modell neigt dazu, übermäßig ambitionierte Stop-Loss- und Take-Profit-Level festzulegen, die innerhalb des angegebenen Bewertungsfensters nicht rechtzeitig erreicht werden können. Dies führt zu einem systematischen Festhalten an Verlusten, wobei Verlustpositionen zu lange gehalten werden, ohne dass ausreichende Gründe für eine Trendwende oder einen Ausstieg aus dem Markt vorliegen. Dieses Verhalten wird dominant, und das Modell verliert faktisch seine Fähigkeit, auf kurzfristige Marktveränderungen zu reagieren, wodurch die Strategie darauf reduziert wird, dem übergeordneten Trend passiv zu folgen.
Um diesem Effekt entgegenzuwirken, wurden zwei wesentliche Änderungen am Trainingsablauf vorgenommen. Zunächst haben wir den Diskontfaktor (Discount Factor) deutlich gesenkt und damit den Schwerpunkt auf die Erzielung schneller Gewinne verlagert. Diese Entscheidung ermöglicht es dem Modell, sich auf die unmittelbaren Ergebnisse seiner Handlungen zu konzentrieren und dabei den kurzfristigen Folgen größeres Gewicht beizumessen. Schließlich haben bei diesem Ansatz aktuelle Verluste einen größeren Einfluss auf die endgültige Belohnung als potenzielle Gewinne in ferner Zukunft, selbst wenn letztere beeindruckender erscheinen. Infolgedessen vermeidet das Modell zunehmend Strategien, die auf dem passiven Abwarten einer Marktumkehr beruhen, und verringert seine Neigung, Verluste weiterlaufen zu lassen, wodurch sich seine Anpassungsfähigkeit an die tatsächliche Marktdynamik erhöht.
Die zweite, diesmal strukturelle Lösung wurde in der CheckAction-Methode implementiert. Hier haben wir uns von der Bewertung von Handelsaktionen innerhalb eines begrenzten Prognosehorizonts gelöst und einen Ansatz gewählt, bei dem die Bewertung über das gesamte verfügbare historische Intervall erfolgt. Dieser Schritt verbessert die Genauigkeit des Feedbacks erheblich, da wir in den allermeisten Fällen genau wissen, welche Kursmarke (Stop Loss oder Take Profit) innerhalb dieser erweiterten Historie erreicht wird. Dies wiederum ermöglicht eine objektivere Bewertung jeder einzelnen Handelsaktion und versetzt das Lernsystem in die Lage, effektive und ineffektive Entscheidungen klarer voneinander zu unterscheiden.
double CheckAction(CBufferFloat *action, double equity, uint start_position)
  {
   if(!action || start_position >= Rates.Size())
      return 0;
Die Methode nimmt die folgenden Parameter entgegen:
- action – Tensor der Handelsaktion: Volumina, SL/TP-Level;
- equity – das aktuelle Kontoeigenkapital (Equity), das zur Schätzung des maximalen Drawdowns herangezogen wird;
- start_position – der Index des Zustands der Positionseröffnung im Rates-Array mit Marktdaten.
Zu Beginn der Methode wird überprüft, ob der Zeiger auf das action-Objekt gültig ist und ob der Startpositionsindex nicht außerhalb der Grenzen des Kursdatenarrays liegt.
Anschließend werden die Handelsparameter abgerufen.
double buy_lot = MathMax(double(action[0] - action[3]), 0);
double sell_lot = MathMax(double(action[3] - action[0]), 0);
Somit unterstützt das System eine separate Volumeneingabe für jede Richtung. Ist beispielsweise action[0] > action[3], wird davon ausgegangen, dass eine Kaufposition eröffnet wird; andernfalls wird von einer Verkaufsposition ausgegangen.
Anschließend wird die Margin-Anforderung auf Basis des aktuellen Kurses berechnet, die Kosten für eine Bewegung um einen Punkt (point_cost) werden ermittelt, und falls das Volumen unzureichend ist, also unter dem zulässigen Mindestwert liegt, gibt die Methode den erwarteten Verlust (entgangenen Gewinn) auf Basis der Barspanne zurück.
double marg = 0;
if(!OrderCalcMargin(ORDER_TYPE_BUY, Symb.Name(), 1, Symb.Ask(), marg))
   return 0;
double point_cost = Symb.TickValue() / Symb.TickSize();
if(MathMax(buy_lot, sell_lot) < Symb.LotsMin())
  {
   double loss = -MathMax(Rates[start_position].high - Rates[start_position].open,
                          Rates[start_position].open - Rates[start_position].low) *
                 point_cost * equity / (2 * marg);
   return loss;
  }
if((marg * MathMax(buy_lot, sell_lot)) >= equity)
  {
   double loss = -MathMax(Rates[start_position].high - Rates[start_position].open,
                          Rates[start_position].open - Rates[start_position].low) *
                 point_cost * MathMax(buy_lot, sell_lot);
   return loss;
  }
point_cost *= MathAbs(buy_lot - sell_lot);
Das Gleiche gilt, wenn das Volumen zu hoch ist und nicht durch die verfügbaren Mittel gedeckt ist (marg * lot > equity). Dies regt das Modell dazu an, Handelsgeschäfte innerhalb der Grenzen der verfügbaren Mittel zu tätigen, und wirkt gleichzeitig der Untätigkeit entgegen.
Als Nächstes wenden wir uns der Überprüfung der Wirksamkeit der vorgeschlagenen Aktionen zu. Zunächst überprüfen wir die Long-Positionen.
//---
  double tp = 0, sl = 0, profit = 0, reward = 0;
  int stops = MathMax(Symb.StopsLevel(), 10);
  int spread = Symb.Spread();
  if(buy_lot > 0)
    {
     tp = action[1] * MaxTP;
     sl = action[2] * MaxSL;
     if(int(tp) < stops || int(sl) < (stops + spread))
       {
        double loss = -MathMax(Rates[start_position].high - Rates[start_position].open,
                               Rates[start_position].open - Rates[start_position].low) *
                      point_cost * buy_lot;
        return loss;
       }
     tp = (tp + spread) * Symb.Point() + Rates[start_position].open;
     sl = Rates[start_position].open - (sl + spread) * Symb.Point();
     reward = profit = -spread * Symb.Point() * point_cost;
Die TakeProfit- und StopLoss-Level werden aus den Elementen des action-Tensors abgerufen. Anschließend werden sie skaliert und auf die Einhaltung der Stop-Level-Anforderungen des Brokers überprüft.
Sind die Bedingungen erfüllt, werden TP und SL in absolute Kurswerte umgerechnet. Andernfalls berechnen wir die Höhe des entgangenen Gewinns.
Anschließend wird die Kursbewegung über einen Abschnitt historischer Daten hinweg simuliert. Dazu richten wir eine Schleife ein, die die historischen Daten in chronologischer Reihenfolge durchläuft.
An dieser Stelle ist es wichtig zu beachten, dass das Rates-Array eine Zeitreihe ist. Um die historische Reihenfolge beizubehalten, werden die Daten daher in umgekehrter Reihenfolge verarbeitet.
for(uint i = start_position; i >=0; i--)
  {
   if(sl >= Rates[i].low)
     {
      double p = (Rates[i].open - sl) * point_cost;
      profit -= p;
      reward -= p * MathPow(DiscFactor, float(i - start_position));
      break;
     }
Der Schleifenkörper verfolgt einen streng risikoorientierten Ansatz: Bei der Überprüfung wird dem Stop Loss-Level Vorrang eingeräumt. Diese Entscheidung beruht auf gesundem Menschenverstand – Verluste am Markt treten in der Regel plötzlich auf und deutlich schneller, als sich Gewinne aufbauen. Wird das Stop-Level erreicht, wird die Höhe des Verlusts unter Berücksichtigung des Diskontfaktors als Geldbetrag bestimmt.
Die Verwendung eines Diskontfaktors ermöglicht eine flexible Abwägung zwischen unmittelbaren und verzögerten Ergebnissen und trainiert das Modell darauf, Aktionen zu wählen, die zu stabilen Renditen führen. Je höher der Diskontfaktor ist, desto stärker ist das Modell auf langfristige Vorteile ausgerichtet, und umgekehrt. Diese Flexibilität hat jedoch auch eine Kehrseite: Durch die Anwendung von Diskontierung ist es schwierig, tiefe Drawdowns genau zu bewerten. Verluste, die erst nach einer beträchtlichen Anzahl von Schritten auftreten, werden stark diskontiert und können vom Modell als unerheblich behandelt werden. Infolgedessen neigt das Modell dazu, Verlustpositionen in der Hoffnung auf eine Umkehr zu halten, was unter realen Marktbedingungen zu einem katastrophalen Drawdown bis zum StopOut-Level führen kann. Um ein solches Verhalten zu vermeiden, wird zusätzlich zur diskontierten Bewertung eine absolute Drawdown-Kontrolle angewendet.
Auf die gleiche Weise wird geprüft, ob das Take-Profit-Level erreicht wurde.
if(tp <= Rates[i].high)
  {
   double p = (tp - Rates[i].open) * point_cost;
   profit += p;
   reward += p * MathPow(DiscFactor, float(i - start_position));
   break;
  }
Wird keines der Handelsniveaus erreicht, wird der aktuelle Gewinn oder Verlust auf Basis des Eröffnungskurses der nächsten Bar erfasst.
double p = (Rates[i - 1].open - Rates[i].open) * point_cost;
profit += p;
reward += p * MathPow(DiscFactor, float(i - start_position));
Es ist besonders wichtig zu betonen, dass wir den Eröffnungskurs der nächsten Bar verwenden und nicht den Schlusskurs der aktuellen Bar. Auch wenn diese Werte in den meisten Fällen identisch sind oder sich nur geringfügig unterscheiden, müssen wir die spezifischen Merkmale der Marktdynamik berücksichtigen. Unser Modell trifft eine Handelsentscheidung bei der Eröffnung einer neuen Bar; daher ist es richtig, genau diesen Kurs bei der Berechnung des Ergebnisses offener Positionen heranzuziehen.
Dieser Ansatz trägt dazu bei, den Realismus der Simulation zu wahren, und stellt sicher, dass die Wahrscheinlichkeit von Kurslücken – die für stark volatile Marktbedingungen oder Zeitpunkte, zu denen wichtige Nachrichten veröffentlicht werden, charakteristisch sind – nicht außer Acht gelassen wird. Die Verwendung des Eröffnungskurses der nächsten Bar lenkt zudem die Aufmerksamkeit auf den Ablauf der Handelsereignisse und verdeutlicht den Ursache-Wirkungs-Zusammenhang zwischen der getroffenen Entscheidung und ihrer Ausführung unter realen Marktbedingungen.
Anschließend vergleichen wir die kumulierten Verluste – ohne Berücksichtigung des Diskontfaktors – mit dem Equity-Level zum Zeitpunkt der Eröffnung der Position. Dieser Ansatz ermöglicht es, sicherzustellen, dass ausreichende Mittel für die Ausführung eines Trades zur Verfügung stehen. Wenn die Verluste das verfügbare Kapital übersteigen – das heißt, wenn es zu einem vollständigen Verlust des Kontokapitals kommt –, erhöhen wir die Strafe in der Belohnungsfunktion und brechen den Simulationsprozess sofort ab. Dies simuliert eine reale Marktsituation, in der ein Mangel an Mitteln zur Aussetzung der Handelsaktivität führt, und ermöglicht eine genauere und sicherere Bewertung der Handelsstrategie während des Trainingsprozesses des Modells.
    if(-profit >= equity)
      {
       reward-=1000;
       break;
      }
   }
}
Eine Short-Position bewerten wir auf dieselbe Weise.
   if(sell_lot > 0)
     {
      tp = action[4] * MaxTP;
      sl = action[5] * MaxSL;
      if(int(tp) < stops || int(sl) < (stops + spread))
        {
         double loss = -MathMax(Rates[start_position].high - Rates[start_position].open,
                                Rates[start_position].open - Rates[start_position].low) *
                       point_cost * sell_lot;
         return loss;
        }
      tp = Rates[start_position].open - (tp + spread) * Symb.Point();
      sl = Rates[start_position].open + (sl - spread) * Symb.Point();
      for(uint i = start_position; i >=0; i--)
        {
         if(sl <= Rates[i].high)
           {
            double p = (sl - Rates[i].open) * point_cost;
            profit -= p;
            reward -= p * MathPow(DiscFactor, float(i - start_position));
            break;
           }
         if(tp >= Rates[i].low)
           {
            double p = (Rates[i].open - tp) * point_cost;
            profit += p;
            reward += p * MathPow(DiscFactor, float(i - start_position));
            break;
           }
         double p = (Rates[i - 1].open - Rates[i].open) * point_cost;
         profit -= p;
         reward -= p  * MathPow(DiscFactor, float(i - start_position));
         if(-profit >= equity)
           {
            reward-=1000;
            break;
           }
        }
     }
//---
   return reward;
  }
Anschließend schließen wir die Methode ab, indem wir die kumulierte, um den Diskontfaktor angepasste Belohnung an das aufrufende Programm zurückgeben.
Der vollständige Code des Expert Advisors für das Offline-Training des Modells, „…\Experts\K2VAE\Study.mq5“, ist im Anhang enthalten. Derselbe Anhang enthält außerdem alle Programme, die bei der Erstellung des Artikels verwendet wurden.
Tests
Wie bereits erwähnt, wird das Modell in zwei aufeinanderfolgenden Phasen trainiert. Zunächst führten wir ein Offline-Training anhand von 15 Jahren EURUSD-Kurshistorie im H1-Timeframe durch. Dieser Datensatz deckt alle Arten von Marktbedingungen ab: von anhaltenden Seitwärtsmärkten bis hin zu starken Trends und von ruhigen Phasen bis hin zu Volatilitätsspitzen. Dadurch konnte das Modell aus der Vielfalt des Marktverhaltens lernen. Der Encoder lernte, zentrale Muster zu erkennen und den Marktzustand in eine kompakte, aber dennoch aussagekräftige Repräsentation zu transformieren, die als Grundlage für die Entscheidungsfindung des Agenten diente. Der Actor nutzte unterdessen das Feedback des Critic und des Director, um eine robuste Strategie zu entwickeln, die unter verschiedenen Bedingungen effektiv funktionieren konnte.
Darauf folgte die zweite Phase — das Online-Training anhand von Daten aus dem Jahr 2024, das im MetaTrader-5-Strategietester durchgeführt wurde. Hier arbeitete das Modell nahezu in Echtzeit und analysierte den Markt Bar für Bar. Es war mit Rauschen, zufälligen Schwankungen und Verzerrungen konfrontiert, wie sie für einen Live-Markt typisch sind. Dieser Ansatz ermöglichte es nicht nur, das Modell feinabzustimmen, sondern auch sein Verhalten an reale Marktdynamiken anzupassen, seine Strategie zu verbessern und seine Robustheit gegenüber Unsicherheit zu erhöhen.
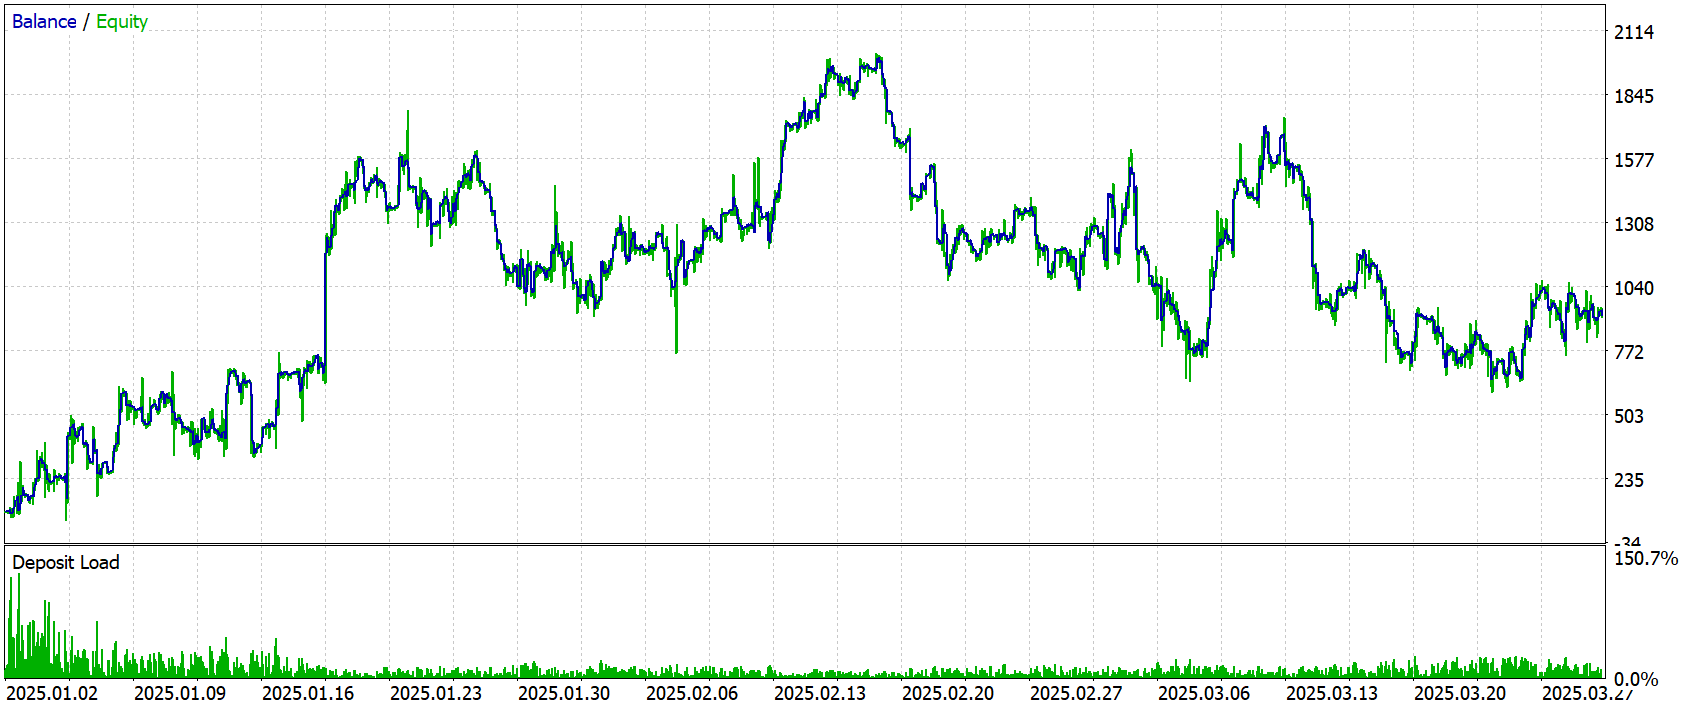
Nach Abschluss des Trainings testeten wir das Modell anhand neuer Daten — Kursdaten für Januar bis März 2025 —, wobei wir alle während des Trainings verwendeten Parameter unverändert beibehielten. Die Testergebnisse sind unten aufgeführt.
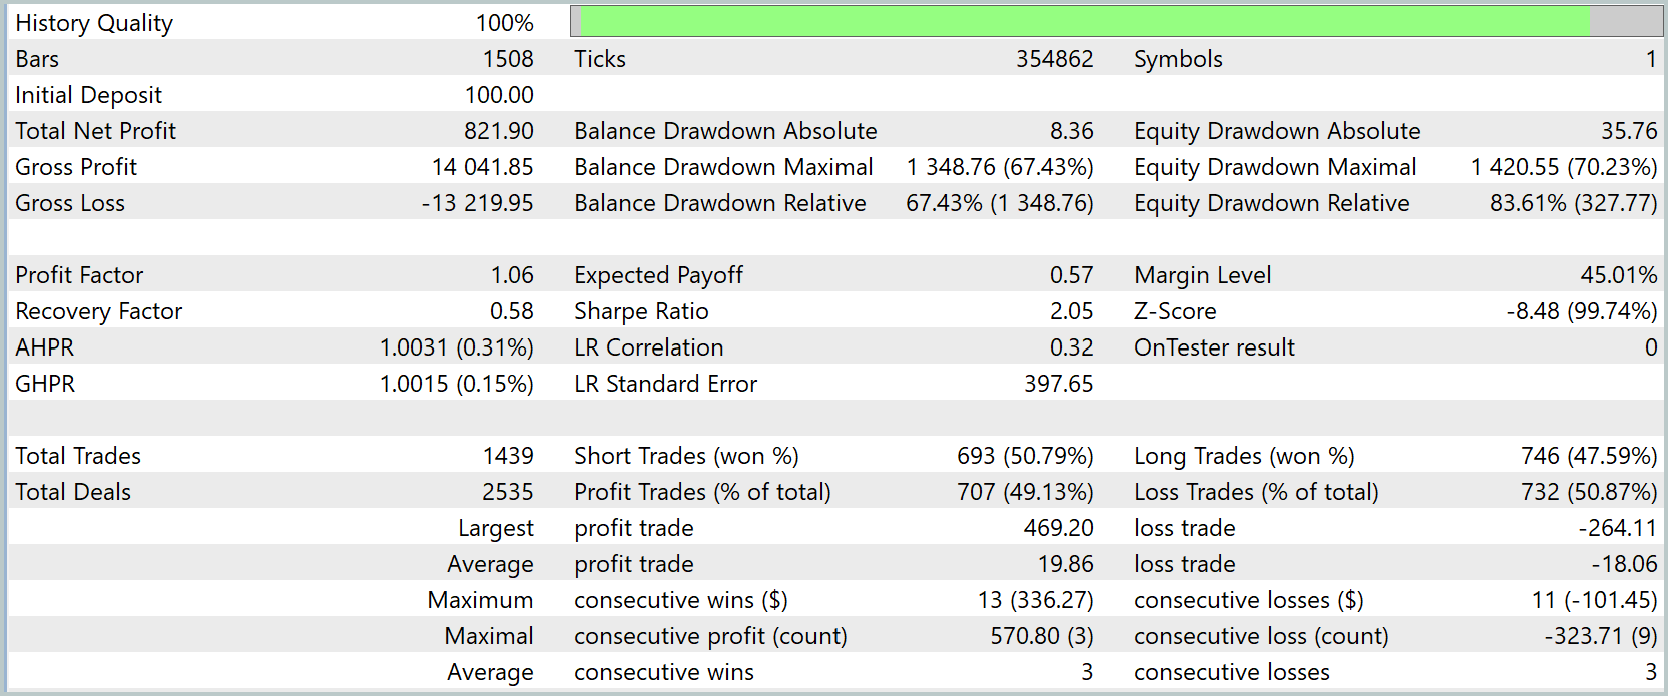
Die Testergebnisse zeigen, dass das Modell im ausgewählten historischen Zeitraum einen Gewinn erzielt hat. Der Gesamtnettogewinn betrug 821,90 $ bei einem Anfangskapital von 100,0 $, was auf Kapitalwachstum hinweist. Es ist jedoch zu beachten, dass der Profit-Faktor (Profit Factor) bei 1,06 liegt, was darauf hindeutet, dass die Gewinne die Verluste nur geringfügig übersteigen.
Die Handelskennzahlen zeigen, dass die Anzahl der gewinnbringenden Trades in etwa der Anzahl der verlustbringenden Trades entspricht – etwa 49 % bzw. 51 % –, was auf ein Gleichgewicht zwischen gewinnbringenden und verlustbringenden Positionen hindeutet.
Die Grafik zeigt, dass die Saldenkurve trotz deutlicher Drawdowns und Rückgangsphasen insgesamt ansteigt. Besonders auffällig ist ein deutlicher Aufwärtstrend beim Kontostand im Januar und in der ersten Februarhälfte. Gleichzeitig scheint der März eindeutig verlustbringend zu sein. Dies könnte darauf hindeuten, dass das Modell anhand eines längeren Zeitraums historischer Daten weiter verfeinert werden muss.
Fazit
Abschließend stellen wir fest, dass das vorgeschlagene K²VAE-Framework als Teil unseres Handelsagenten seine Tragfähigkeit unter Beweis gestellt hat und anhand historischer Daten validiert wurde. Das Modell vereint ein tiefes Verständnis der zugrunde liegenden Marktdynamik, eine adaptive Risikoanpassung und die Generierung probabilistischer Szenarien, wodurch Kapitalwachstum erzielt werden konnte. Gleichzeitig deutet der Leistungsabfall über einen längeren Testzeitraum darauf hin, dass Wege gefunden werden müssen, um die Generalisierungsfähigkeit des Modells zu verbessern.
Literaturverzeichnis
- K²VAE: A Koopman-Kalman Enhanced Variational AutoEncoder for Probabilistic Time Series Forecasting
- Weitere Artikel in dieser Reihe
In diesem Artikel verwendete Programme
| # | Name | Typ | Beschreibung |
|---|---|---|---|
| 1 | Study.mq5 | Expert Advisor | Expert Advisor für das Offline-Modelltraining |
| 2 | StudyOnline.mq5 | Expert Advisor | Expert Advisor für Online-Modelltraining |
| 3 | Test.mq5 | Expert Advisor | Expert Advisor für Modelltests |
| 4 | Trajectory.mqh | Klassenbibliothek | Struktur zur Beschreibung des Systemzustands und der Modellarchitektur |
| 5 | NeuroNet.mqh | Klassenbibliothek | Klassenbibliothek zum Erstellen eines neuronalen Netzes |
| 6 | NeuroNet.cl | Bibliothek | Codebibliothek für das OpenCL-Programm |
Übersetzt aus dem Russischen von MetaQuotes Ltd.
Originalartikel: https://www.mql5.com/ru/articles/18807
Warnung: Alle Rechte sind von MetaQuotes Ltd. vorbehalten. Kopieren oder Vervielfältigen untersagt.
Dieser Artikel wurde von einem Nutzer der Website verfasst und gibt dessen persönliche Meinung wieder. MetaQuotes Ltd übernimmt keine Verantwortung für die Richtigkeit der dargestellten Informationen oder für Folgen, die sich aus der Anwendung der beschriebenen Lösungen, Strategien oder Empfehlungen ergeben.

 Neuronale Netze im Trading: Ein Ende-zu-Ende-Modell für die multivariate Zeitreihenprognose (GinAR)
 Analyse der stündlichen Kursentwicklung von Symbolen und ihrer Spreads in MetaTrader 5
 Neuronale Netze im Trading: Ein Ende-zu-Ende-Modell für multivariate Zeitreihenprognose (Kernkomponenten)
 Neuronale Netze im Handel: Probabilistische Zeitreihenprognose (Encoder)

- Freie Handelsapplikationen
- Über 8.000 Signale zum Kopieren
- Wirtschaftsnachrichten für die Lage an den Finanzmärkte
Sie stimmen der Website-Richtlinie und den Nutzungsbedingungen zu.
Ich hatte ein paar Probleme mit VAE.mqh und habe festgestellt, dass die folgende Lösung das Problem recht gut umgeht.