

Neuronale Netze im Trading: Probabilistische Zeitreihenprognose (K²VAE)
 17
 0

Einleitung
In den letzten Jahren hat die Zeitreihenanalyse einen echten Durchbruch erlebt. Anomalieerkennung, Klassifizierung und Imputation fehlender Werte erfolgen inzwischen präziser und schneller. Für Finanzmärkte ist die probabilistische Prognose jedoch weitaus wichtiger: Es geht nicht nur darum, den Kurs eines Vermögenswerts zu prognostizieren, sondern die Bandbreite möglicher Szenarien einzuschätzen. Solche Einschätzungen helfen Tradern und Analysten, flexible Strategien zu entwickeln, Risiken zu steuern und fundierte Entscheidungen zu treffen.
Klassische Modelle eignen sich hervorragend für kurzfristige Prognosen. Blickt man jedoch etwas weiter in die Zukunft, häufen sich die Fehler, die Volatilität verstärkt die Ungenauigkeiten, und der Rechenaufwand schießt in die Höhe. Dies gilt insbesondere für Finanzmärkte, wo jedes Ereignis – sei es ein Ergebnisbericht eines Unternehmens oder eine geopolitische Überraschung – Nichtlinearität mit sich bringt und die Spielregeln verändert.
Als möglicher Ansatz zur Lösung dieser Art von Problemen wurde in der Arbeit „K²VAE: A Koopman-Kalman Enhanced Variational AutoEncoder for Probabilistic Time Series Forecasting“ ein neues Framework vorgeschlagen, das auf zwei grundlegenden Ideen basiert. Erstens überführt die Koopman-Theorie nichtlineare Prozesse in eine lineare Form. Stellen Sie sich vor, Sie betrachten ein Aktienkursdiagramm durch spezielle Linsen, und es verwandelt sich in eine gerade Linie – dieser Ansatz erleichtert das Verständnis der Dynamik. Zweitens ist der klassische Kalman-Filter darauf ausgelegt, neue Daten sorgfältig zu verarbeiten und die Prognose jedes Mal anzupassen, wenn neue Informationen verfügbar werden: ein Ergebnisbericht, eine Zinsänderung oder ein unerwartetes Ereignis.
Die Autoren der Arbeit haben diese Ideen im K²VAE-Framework zusammengeführt – einem schlanken und schnellen System, das auf einem Variational Autoencoder basiert. KoopmanNet überführt erstens historische Kursdaten und Indikatoren in eine Darstellung mit linearer Struktur. Anschließend verfeinert KalmanNet, das auf Methoden des Kalman-Filters basiert, Schritt für Schritt die Schätzungen möglicher Bewegungen und ihrer Unsicherheit. Diese Architektur ermöglicht Prognosen über kurze wie auch lange Prognosehorizonte hinweg und gewährleistet dabei hohe Genauigkeit und Stabilität.
Die wichtigsten Vorteile des K²VAE-Frameworks:
- Modelltransparenz. Die lineare Komponente liefert Tradern interpretierbare Signale, statt eine Blackbox zu sein;
- Prognoseflexibilität. Sie können schnell Szenarien für verschiedene Vermögenswerte erstellen: Währungspaare, Indizes und Rohstoffe;
- Risikomanagement. Die adaptive Anpassung des Konfidenzintervalls trägt dazu bei, das Risiko großer Verluste rechtzeitig zu verringern.
Dadurch wird K²VAE zu einer vielseitigen Lösung sowohl für Kurzfrist- als auch für Langfristprognosen, die es den Anwendern ermöglicht, über ein einzelnes Szenario hinauszugehen und sofort das gesamte Spektrum möglicher Marktbewegungen einzuschätzen. Dies verbessert die Effektivität des Portfoliomanagements und die Zuverlässigkeit automatisierter Trading-Strategien erheblich – Sie sehen nicht nur eine Punktprognose, sondern ein Bild potenzieller Risiken und Chancen.
Der K²VAE-Algorithmus
In der Dynamik der Finanzmärkte begegnen wir oft Phänomenen, die chaotisch erscheinen – Kursschwankungen, plötzliche Volatilitätsspitzen und die Auswirkungen von Nachrichtenmeldungen. Die Koopman-Theorie bietet eine Sicht von innen heraus: Anstatt zu versuchen, die Nichtlinearität direkt zu zähmen, transformieren wir unser System in einen speziellen Observablenraum. Hier wird jeder Zustandsvektor xₖ (beispielsweise eine Reihe von Kursen oder von Wirtschaftsindikatoren) über die Funktion ψ auf eine Observable abgebildet, deren Entwicklung durch einen linearen Operator 𝒦 beschrieben wird. Einfach ausgedrückt: Wir linearisieren ein komplexes Kursdiagramm, sodass es einer geraden Linie folgt, was die Analyse und Prognose der zugrunde liegenden Dynamik der Zeitreihe erheblich erleichtert. Dieser Ansatz hilft dabei, den langfristigen Trend von kurzfristigem Rauschen zu unterscheiden.
Doch selbst bei einer linearen Darstellung sind wir weiterhin mit Unsicherheiten konfrontiert: Die Preise ändern sich jede Sekunde, es werden neue Konjunkturdaten veröffentlicht, und die Zentralbanken passen die Zinssätze an. An dieser Stelle kommt der Kalman-Filter ins Spiel. Dieser Algorithmus basiert auf einem einfachen, aber leistungsstarken Prognose-Korrektur-Prinzip: Zunächst prognostizieren wir den aktuellen Zustand des Systems und schätzen unsere Sicherheit in der Prognose (Matrix Pₖ), und anschließend berechnen wir nach Erhalt der tatsächlichen Messung (Kurs, Handelsvolumen oder makroökonomischer Indikator) den Kalman-Gain Kₖ. Wir nutzen sie, um die ursprüngliche Prognose an die Realität anzupassen und unsere Einschätzung der Unsicherheit zu aktualisieren. Für einen Trader entspricht dies einer Online-Aktualisierung des Modellzustands anhand aktueller Daten: Unternehmensberichte, Veränderungen der Liquidität oder plötzliche geopolitische Ereignisse fließen sofort in die Prognose ein, wodurch die Verzögerung des Modells gegenüber dem Live-Markt minimiert wird.
Durch die Kombination der linearen Fortschreibung des Systems mit adaptiver Filterung erhalten wir eine robuste Grundlage für probabilistische Prognosen. Um jedoch nicht auf ein einziges Szenario beschränkt zu sein, nutzen wir die Leistungsfähigkeit eines Variational Autoencoder. VAE macht aus dem Problem eine bedingte Generierung: Die Eingabe besteht aus historischen Daten X (den T jüngsten Beobachtungen für N Vermögenswerte), und die Ausgabe ist kein einzelner Vektor zukünftiger Werte, sondern eine Verteilung möglicher Trajektorien Y. Der entscheidende Punkt ist die latente Variable Z, die verborgene Marktfaktoren berücksichtigt: Korrelationen, Zyklen und unerwartete Schocks. Die Optimierung erfolgt unter Verwendung einer unteren Schranke der Log-Likelihood. Die erste Komponente bestraft das Modell für eine schlechte Generierung, während die zweite es dafür bestraft, dass die latente Verteilung in extreme Bereiche abdriftet, die weit von unseren Prior-Erwartungen entfernt sind.
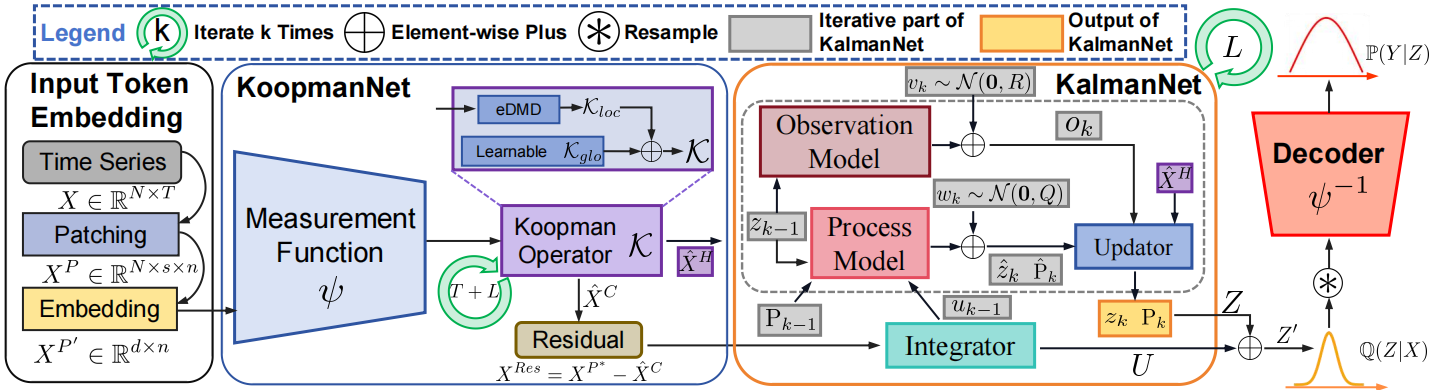
Im K²VAE-Framework existieren diese drei Komponenten (KoopmanNet, KalmanNet und VAE) nicht einfach nur nebeneinander, sondern ergänzen sich nahtlos. Insgesamt folgt die K²VAE-Architektur einer klaren mehrstufigen Pipeline, in der jede Komponente für eine eigene Stufe bei der Umwandlung der analysierten Daten in ein interpretierbares dynamisches Modell zuständig ist.
Zunächst unterteilt das Modul Input-Token-Embedding die ursprüngliche Zeitreihe in Token – kleine Abschnitte der Kursentwicklung oder Liquiditätskennzahlen. Diese Methode ähnelt der Vorgehensweise eines Analysten, der ein Kursdiagramm in Segmente mit wichtigen Unterstützungs- und Widerstandsniveaus unterteilt: Dadurch gewinnen die Daten an Aussagekraft.
KoopmanNet ordnet diese Token anschließend dem sogenannten Observablenraum zu. Hier erfolgt die Zerlegung des komplexen nichtlinearen Verhaltens von Zeitreihen (Korrelationen zwischen Vermögenswerten, kurzfristige Volatilitätsspitzen) in einfache lineare Komponenten. Mithilfe des Trainingsverfahrens identifizieren wir einen linearen Koopman-Operator, der, wenn er ausgehend vom ersten Token iteriert wird, ein Modell der Entwicklung erstellt. Natürlich gibt es keinen idealen Observablenraum, der das System vollkommen linear macht – daher die Abweichung in den Prognosen.
Danach kommt KalmanNet ins Spiel. Ähnlich wie ein Kalman-Filter nimmt es eine lineare Prognose und aktualisiert sich anhand neuer Beobachtungen, verfeinert die Kovarianz des mehrdimensionalen Zustands und bildet dadurch einen variationalen Posterior Q(Z|X) mit klarer Semantik. Dies ist im Finanzbereich von entscheidender Bedeutung: Wir konstruieren nicht nur eine Basis-Kurstrajektorie, sondern bewerten sofort auch die Spanne ihrer möglichen Abweichungen – von plötzlichen Kurslücken bis hin zu Kursumkehrungen als Reaktion auf wichtige Nachrichtenereignisse.
Schließlich führt der Decoder die inverse Abbildung aus dem Observablenraum (ψ⁻¹) durch und überführt die resultierenden Stichproben aus dem latenten Raum wieder in das vertraute Zeitreihenformat. Außerdem ist er für die Modellierung der abschließenden Verteilung P(Y|Z,X) über den Planungshorizont zuständig. Auf diese Weise erhalten wir ein einsatzbereites zukünftiges Kursszenario – nicht nur eines, sondern viele probabilistische Trajektorien, von denen jede mit einer eigenen Risiko- und Konfidenzschätzung versehen ist.
Letztendlich wandelt K²VAE finanzielle Rohdaten in ein kohärentes lineares dynamisches Modell um, das eine adaptive Verfeinerung der Unsicherheit sowie die Generierung des gesamten Spektrums möglicher Marktbewegungen ermöglicht. Es ist ein leistungsstarkes Werkzeug für die Portfolioplanung, die Risikobewertung und die Entwicklung zuverlässiger algorithmischer Strategien.
Die Aufteilung einer Zeitreihe in Patches ist weit mehr als nur ein technischer Trick. In der Finanzanalyse lässt sich dies mit dem Übergang von einzelnen Tick-Kursen zu 5-Minuten- oder 30-Minuten-Candlesticks vergleichen, die sowohl den Trend als auch wichtige Volatilitätsspitzen auf einen Blick erkennen lassen. Im K²VAE-Framework basiert die Datenvorverarbeitung auf einem ähnlichen Ansatz, geht jedoch über die herkömmliche kanalunabhängige Architektur hinaus, bei der jeder Kanal separat verarbeitet wird. Stattdessen fassen die Autoren des Frameworks alle Variablen (Preise verschiedener Vermögenswerte, Handelsvolumina und technische Indikatoren) in einem einzigen Patch zusammen, wodurch das Modell die Wechselwirkungen zwischen ihnen auf natürliche Weise berücksichtigen kann.
Zunächst wird die Kontext-Zeitreihe X – eine Matrix mit N Variablen über T Zeitschritte – in mehrere gleich lange, sich nicht überlappende Segmente der Länge s unterteilt. Jeder dieser Patches enthält gleichzeitig Daten für alle N Indikatoren zu s Zeitpunkten und liefert somit eine Momentaufnahme der Marktbedingungen in diesem Zeitraum. Anschließend flachen wir jedes Fragment zu einem Vektor der Dimension N·s ab und leiten ihn durch eine lineare Projektion, wodurch die resultierenden Informationen zu einer kompakten Darstellung als Einbettung der Dimension d komprimiert werden. Dank dieses Verfahrens lernt das Modell nicht nur, in jeden einzelnen Patch hineinzuschauen, sondern identifiziert auch automatisch die aussagekräftigsten Kombinationen von Variablen: sei es die Korrelation zwischen Aktien aus dem Technologiesektor und Halbleiteraktien oder synchronisierte Spitzen bei den Handelsvolumina in verschiedenen Marktsegmenten.
Dieser fast schon explosive Übergang von voneinander getrennten Kanälen zu mehrdimensionalen Token bietet gleich mehrere Vorteile. Erstens erkennt das Modell sofort gebündelte Phänomene, wenn Volatilität oder Kurstrends mehrere Vermögenswerte gleichzeitig betreffen. Zweitens werden lokale Störungen und zufällige Schwankungen innerhalb eines einzelnen Patches geglättet, wodurch die Anzahl der Fehlsignale deutlich reduziert wird. Drittens werden dank der breiteren Abdeckung von Variablen verborgene Zyklen und langfristige Muster innerhalb jedes Tokens deutlicher sichtbar – Muster, die bei einem herkömmlichen Ansatz möglicherweise unbemerkt geblieben oder verzerrt worden wären, wenn die Kanäle unabhängig voneinander verarbeitet worden wären.
Somit erhält K²VAE als Eingabe keine Reihe einzelner Merkmale, sondern eine umfassende, analysefertige Momentaufnahme des Marktumfelds für jedes Intervall s. Dies dient als Ausgangspunkt für die nachfolgenden Phasen.
In realen Finanzzeitreihen treten mehrere Formen der Nichtlinearität gleichzeitig auf: Die Phasen von Kurszyklen können sich relativ zueinander verschieben, statistische Merkmale ändern sich bei der Veröffentlichung wichtiger Berichte, und plötzliche Nachrichtenereignisse bringen etablierte Muster durcheinander. Um diese Komplexität zu bändigen, setzten die Autoren des K²VAE-Frameworks die Koopman-Brille auf – das heißt, sie bildeten Token aus dem Bereich chaotischer Schwingungen in einen Raum ab, in dem ihre Entwicklung einfach und linear wird.
In der Praxis sieht das so aus. Zunächst wird jeder geglättete Einbettungsvektor des Patches X′ᴾ durch ein kleines, aber leistungsstarkes MLP geleitet, das als Observablefunktion ψ fungiert. Einfach ausgedrückt: Wir destillieren die komplexen Zusammenhänge zwischen Preisen und Indikatoren in einen neuen Vektor xᴾᵢ*, in dem die zugrunde liegenden Dynamiken besser erkennbar werden.
Wenn wir all diese Vektoren zusammenfassen, erhalten wir eine Matrix X*ᴾ, wobei jede Zeile bereits eine linear interpretierbare Projektion eines einzelnen Patches darstellt. Doch es genügt nicht, sie einfach nur zu betrachten. Um zu verstehen, wie sich das System Schritt für Schritt entwickelt, verwenden wir das eDMD-Verfahren (Extended Dynamic Mode Decomposition), extrahieren das Vorher–Nachher-Paar aus X*ᴾ und berechnen den Operator 𝒦loc, der die Diskrepanz zwischen beiden minimiert. Dieser wird so trainiert, dass die erste Spalte von X*ᴾ, wenn sie mit 𝒦loc multipliziert wird, die zweite Spalte so genau wie möglich reproduziert, und so weiter bis zum Ende der Zeitreihe. Diese Technik ermöglicht es, lokale Übergangsregeln Schritt für Schritt abzuleiten.
Beim Übergang von der lokalen zur globalen Ebene fügen wir eine zweite, trainierbare Komponente 𝒦glo hinzu. Zusammen bilden sie den vollständigen Koopman-Operator 𝒦 = 𝒦loc + 𝒦glo. Genau dies ermöglicht es uns, nicht nur historische Patches zu rekonstruieren, sondern auch verlässlich in die Zukunft zu blicken, indem wir die erste Projektion x₁ᴾ* mit 𝒦ⁿ, 𝒦ⁿ⁺¹ usw. multiplizieren. In diesem Fall entsprechen die m = L/s Patches im Observablenraum eins zu eins den L Schritten in der ursprünglichen Zeitreihe.
Dadurch werden selbst die komplexesten Wechselwirkungen zwischen Aktienkursen, Handelsvolumina und technischen Indikatoren linearisiert. K²VAE kann schnell und präzise Prognosen für jeden Zeithorizont erstellen – von den nächsten Minuten bis hin zu den kommenden Monaten. Gleichzeitig bleibt das Modell transparent: Wir können sowohl die lokalen Übergangsregeln als auch die globalen Trends erkennen, während die lineare Struktur Tradern und Risikomanagern ermöglicht, zu verstehen, was die Entstehung eines bestimmten Szenarios antreibt.
Nachdem KoopmanNet die Haupttrends linearisiert und die Kontextsequenz rekonstruiert hat, bleiben zwangsläufig kleine Restfehler bestehen – die Differenz zwischen den tatsächlichen Projektionen der Patches und ihrer linearen Näherung. Die Autoren des K²VAE-Frameworks ignorieren diese Residuen nicht; im Gegenteil, sie fassen sie zu einem einheitlichen Informationsstrom aus Residuen zusammen, der aufzeigt, wo und in welchem Maß das lineare Modell zu kurz gegriffen hat.
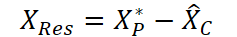
Dieses matrixbasierte Fehlerprotokoll erfasst alle Arten von Überraschungen: plötzliche Gaps, starke Volumenspitzen oder Nachrichtenschocks, die sich noch nicht im Koopman-Operator niedergeschlagen haben.
Als Nächstes übernimmt ein schlanker Transformer-Integrator die Rolle eines weisen Beraters: Er analysiert all diese angesammelten Nichtlinearitäten und wandelt sie in eine Reihe von Steuereingaben U = [u₁, …, uₘ] um. Jeder Vektor uₖ dient als Signal dafür, in welche Richtung die Prognose angepasst werden sollte – bei Schritt k. Da der Transformer Beziehungen zwischen verschiedenen Zeitpunkten berücksichtigen kann, lernt das Modell, Fehlerinformationen neu zu verteilen und diese Fehler auf die effektivste Weise zu korrigieren.
Nachdem wir die Steuereingaben erhalten haben, erstellen wir ein klassisches Prozessmodell.
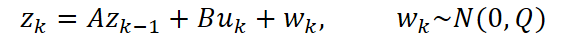
Hier ist A für den grundlegenden schrittweisen Übergang verantwortlich, B für die Wirkung der Steuereingabe, und wₖ fügt einen Anteil an Zufallsrauschen hinzu, das unvorhersehbare Marktfaktoren widerspiegelt. Wir übernehmen den Anfangszustand z₀ aus dem letzten tatsächlich beobachteten Patch, damit das Modell von einem möglichst genauen Punkt aus startet.
Als Nächstes untersuchen wir die daraus resultierende Prognose unter Berücksichtigung des Beobachtungsmodells.

Hier bildet H den internen Zustand auf das Prognoseformat ab, und vₖ fügt Messrauschen hinzu, das die dem linearen Teil des Modells innewohnenden Ungenauigkeiten widerspiegelt. Als primäre Beobachtung dient dabei die zuvor von KoopmanNet erzeugte Prognose für den Horizont.
Der traditionelle Prognose-Korrektur-Zyklus ermöglicht es KalmanNet, lineare Prognosen dynamisch gegen Fehlerinformationen abzuwägen. Zunächst erhalten wir eine vorläufige Prognose ẑₖ und eine Kovarianzmatrix P̂ₖ, die das Vertrauen des Modells quantifiziert.
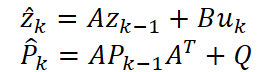
Anschließend berechnen wir durch Vergleich mit der Beobachtung den Kalman-Gain Kₖ. Anschließend verfeinern wir den Zustand und die Kovarianz.
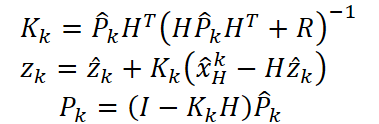
Somit verfeinert das Modell nicht nur die Prognose, sondern zeigt auch bei jedem Schritt deutlich, wie gut es den Markt versteht und wo noch zusätzliche Bestätigung erforderlich ist.
Um zu verhindern, dass die gesammelten Fehlerinformationen verloren gehen, verknüpfen die Autoren des Frameworks die Endzustände über eine Skip-Verbindung mit den Steuereingaben.
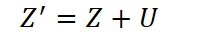
Dadurch wird sichergestellt, dass das Modell alle verfügbaren Informationen nutzt, bis KoopmanNet und KalmanNet alle Feinheiten beherrschen. Im Verlauf des Trainings strebt der Betrag von U gegen null – was bedeutet, dass die lineare Dynamik zunehmend eigenständig wird.
Daher liefert das K²VAE-Framework nicht nur eine Preisprognose, sondern zwei miteinander verbundene Schätzwerte: den Wert selbst und den Grad des Vertrauens in diesen Wert. Für Trader und Risikomanager ist dies ein unschätzbares zweiteiliges Signal: Die Prognose hilft bei der Planung von Trades, während die Kovarianz Aufschluss darüber gibt, wo Vorsicht geboten ist und wo es sich lohnen könnte, ein Risiko einzugehen. Dieser Ansatz verwandelt algorithmisches Trading von einem blinden Streben nach Punktprognosen in eine wohlüberlegte Risikomanagementstrategie.
Schließlich kommen wir zur letzten Phase der Erstellung einer probabilistischen Prognose. Zu diesem Zeitpunkt liegen uns bereits zwei wichtige Ergebnisse vor: die angepassten latenten Zustände Z' und die Kovarianzmatrizen P, die unser Vertrauen in jeder Phase der Prognose beschreiben. Zusammen definieren sie die variationale Verteilung, aus der wir zufällige Stichproben zukünftiger Szenarien ziehen werden.
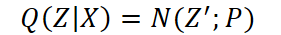
Damit Gradienten durch das zufällige Sampling propagieren können, verwenden die Autoren des Frameworks den bekannten Reparametrisierungstrick. Anstelle des direkten Ziehens von Z aus N(Z',P) erzeugen sie standardnormalverteiltes Rauschen ϵ∈N(0,1) und konstruieren:
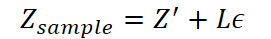
wobei L die untere Dreiecksmatrix aus der Zerlegung P = LLᵀ ist. Somit ist der Prozess selbst differenzierbar, und die Gradienten fließen ungehindert von der Verlustfunktion zu den Parametern sowohl von KalmanNet als auch von KoopmanNet.
Anschließend bilden die Autoren von K²VAE die resultierenden latenten Vektoren Zsample mithilfe eines Decoders wieder in das vertraute Zeitreihenformat ab – zwei symmetrische MLPs, die den ursprünglichen Koopman-Encoder ψ spiegeln. Das erste MLP, das wir als ψ⁻¹μ bezeichnen, prognostiziert den Mittelwertvektor μ, während das zweite, ψ⁻¹σ, den Standardabweichungsvektor σ prognostiziert.
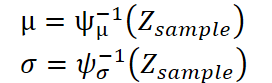
Dadurch erzeugt jedes generierte Sample einen Vektor künftiger Werte samt einer Schätzung der Streuung – das heißt, wir sehen sofort nicht nur die wahrscheinlichste Trajektorie, sondern auch die Grenzen des Konfidenzintervalls.
Um die Qualität der inversen Transformation weiter zu stärken, übergeben die Autoren des Frameworks zudem an ψ⁻¹μ die rekonstruierte Sequenz X̂C.
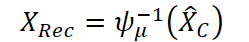
Wir erhalten XRec, womit wir den Rekonstruktionsfehler LRec berechnen. Dies hält die Observablefunktion ψ dazu an, ein tatsächlich lineares System aufzubauen, und den Decoder dazu, die Daten präzise in den ursprünglichen Raum der Preise und Indikatoren zurückabzubilden.
Nachdem wir schließlich alles zusammengeführt haben, bestimmen wir die Prognoseverteilung.
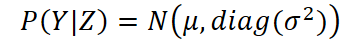
Für jedes Sample gibt der Decoder den Vektor μ und den Vektor σ aus, die zur Erstellung einer vollständigen probabilistischen Prognose verwendet werden: Median, Konfidenzintervalle und Extremszenarien.
In der Praxis bedeutet dies, dass ein Trader oder Risikomanager sofort ein umfassendes Bild möglicher Marktbewegungen erhält – von einer konservativen Drift innerhalb einer engen Spanne bis hin zu aggressiven Spitzen, die mit erhöhter Volatilität einhergehen. Dank der Reparametrisierung und des synchronen Trainings aller Komponenten (KoopmanNet, KalmanNet und Decoder) bietet K²VAE eine glatte, differenzierbare Pipeline, bei der jede Iteration nicht nur die Genauigkeit der Mittelwertprognose, sondern auch die Zuverlässigkeit der Risikoschätzungen verbessert.
Im Zentrum des Trainings von K²VAE steht ein Paar sich ergänzender Verlustfunktionen, die zusammen einen leistungsstarken Mechanismus für die Selbstverbesserung des Modells bilden. Die erste davon ist die klassische ELBO-Zielfunktion (Evidence Lower Bound), bei der das Modell zwei Dinge gleichzeitig erreichen soll: sicherstellen, dass die generierten Trajektorien Y der erwarteten Verteilung folgen, und verhindern, dass sich der latente Raum Z zu weit von unseren Prior-Annahmen entfernt.
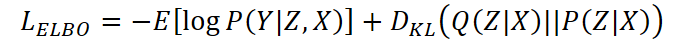
Der erste Term ist ein Strafterm für eine mangelhafte Generierung zukünftiger Szenarien: Je schlechter der Decoder die Verteilung von Y aus Stichproben von Z reproduzieren kann, desto stärker wird dies bestraft. Der zweite Term ist die KL-Divergenz zwischen unserem variationalen Posterior Q(Z|X) und einem einfachen standardnormalen Prior P(Z|X)=N(0,I). Dadurch verhindern wir, dass der latente Raum über vertretbare Grenzen hinaus davonläuft, und ermöglichen ihm eine sanfte Konvergenz zu einem stabilen Zustand, in dem das lineare System im Observablenraum stabil wird.
Allerdings garantiert ELBO allein noch nicht, dass sich unser Observablenraum tatsächlich linear verhält. An dieser Stelle kommt die zweite Schlüsselkomponente ins Spiel – der Rekonstruktionsfehler.
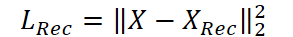
Die Autoren des Frameworks vergleichen die tatsächliche Originalsequenz X mit ihrer Rekonstruktion XRec, die über den Decoder aus der rekonstruierten Koopman-Ausgabesequenz transformiert wurde. Je genauer ein Modell Daten in den ursprünglichen Raum zurückabbilden kann, desto genauer und sauberer baut es lineare Dynamik in der Ebene des Observablenraums auf. Diese Verlustfunktion dient als eine Art Stütze für das Fundament des Modells und verhindert, dass die Observablefunktion ψ von der Linearität abweicht.
Letztlich ist die gesamte Trainingszielfunktion einfach die Summe dieser beiden Teile.
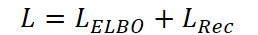
Die ELBO ist für die korrekte Generierung und einen gut strukturierten latenten Raum verantwortlich, während der Rekonstruktionsfehler die Strenge der linearen Approximation und die Qualität der inversen Transformation sicherstellt. Gemeinsam zwingen sie K²VAE dazu, nicht nur plausible Marktszenarien generieren zu lernen, sondern auch eine leicht verständliche, interpretierbare linear-dynamische Struktur auszubilden, die gegenüber Volatilitätsspitzen und unerwarteten Marktausschlägen robust ist. Damit erhalten Trader und Risikomanager nicht nur eine Prognose, sondern ein umfassendes, transparentes und zuverlässiges Instrument zur Entscheidungsfindung.
Nachfolgend ist die von den Autoren erstellte Visualisierung des K²VAE-Frameworks dargestellt.
Implementierung mit MQL5
Nachdem wir nun alle wesentlichen Komponenten des K²VAE-Frameworks im Detail untersucht haben – von der Linearisierung der KoopmanNet-Dynamik über die adaptive Verfeinerung der Unsicherheit mit KalmanNet bis hin zum abschließenden VAE-Decoder –, ist es an der Zeit, die Theorie in die Praxis umzusetzen. Im praktischen Teil unserer Arbeit werden wir systematisch zeigen, wie sich jedes dieser Module direkt in der MQL5-Umgebung implementieren lässt: von der Aufbereitung der Ausgangsdaten und der Generierung von Patches bis hin zum Training der Modellparameter und zur Erzeugung des Endergebnisses. Dieser praktische Leitfaden hilft Ihnen dabei, K²VAE Schritt für Schritt in Ihren eigenen algorithmischen Strategien zu implementieren und dabei die gesamte Flexibilität und Transparenz der vorgeschlagenen Architektur zu bewahren.
Wie Sie vielleicht bemerkt haben, basiert der Kern von K²VAE auf mehreren Schlüsselmatrizen – dem Koopman-Operator, den Übergangs- und Steuermatrizen in KalmanNet sowie den Gewichtsprojektionen im Encoder und Decoder. Im Gegensatz zur üblichen Hierarchie „Faltung → Aktivierung → Faltung“ in neuronalen Standardnetzen sind hier dieselben Parameter gleichzeitig an mehreren verschiedenen Stufen der Pipeline beteiligt. Würden wir diese Idee einfach eins zu eins übernehmen, müssten wir für jeden Schritt separate MLP-Schichten deklarieren und folglich die Gewichte duplizieren; das würde nicht nur die Ausführung verlangsamen und den Code verkomplizieren, sondern auch das Konzept eines einheitlichen linearen Operators verfälschen.
Daher müssen wir eine alternative Lösung finden, die es uns ermöglicht, das Konzept gemeinsam genutzter Parameter beizubehalten und sie zugleich in den bestehenden Trainingsmechanismus zu integrieren. An dieser Stelle lohnt es sich, an einen alten, bewährten Ansatz zu erinnern, den wir bereits in anderen Projekten angewendet haben, als wir trainierbare Matrizen außerhalb der üblichen Hierarchie neuronaler Schichten benötigten.
Die Idee besteht darin, eine trainierbare Matrix als zweischichtiges MLP (Multi-Layer Perceptron) zu implementieren. Die erste Schicht gibt einen einzigen festen Wert aus – 1,0 –, während die zweite Schicht diesen auf die gesamte erforderliche Parametermatrix erweitert. Dieses ausgeklügelte Design ermöglicht es, Standardmechanismen für Backpropagation und Gewichtsaktualisierung auch für Parameter zu nutzen, die außerhalb der Standardstruktur liegen.
Mit anderen Worten: Wir erstellen im Grunde eine Pseudoschicht, deren Zweck nicht darin besteht, die Eingabedaten zu verarbeiten, sondern lediglich darin, eine Parametermatrix zu erzeugen. Auf den ersten Blick ist sie rechnerisch nutzlos, doch gerade durch sie fließt der Gradient und trainiert die zweite Schicht – und genau dadurch erhalten wir unsere Matrizen A, B, K, H oder etwa ψ.
Der Vorteil dieses Ansatzes besteht darin, dass er die Kompatibilität mit dem allgemeinen Framework für das Training neuronaler Netze gewährleistet. Wir müssen weder einen separaten Optimierungsmechanismus entwickeln noch die Gewichte manuell aktualisieren. Alles funktioniert nach dem üblichen Mechanismus: Vorwärtsdurchlauf → Fehler → Gradientenweitergabe → Parameteraktualisierung.
Somit lassen sich sogar spezialisierte Elemente wie Koopman-Operatoren oder KalmanNet-Kovarianzmatrizen mit vollständiger Trainingsunterstützung in die Architektur integrieren.
Wenn für ein Problem lediglich eine einzige parametrisierte Matrix erforderlich ist, ist die Implementierung eines kleinen MLP innerhalb eines einzigen Objekts durchaus sinnvoll. Wir fügen der Struktur einfach ein paar interne Schichten hinzu, führen dem Eingang eine Konstante zu und erhalten am Ausgang die gewünschte Matrix, die wir dann für die Berechnungen verwenden. Das ist einfach, transparent und erfordert keine zusätzliche Architektur.
Bei den Algorithmen KoopmanNet und KalmanNet sieht die Situation jedoch anders aus: Hier benötigen wir ein ganzes Arsenal solcher Matrizen. Wenn man für jede einzelne eine eigene Implementierung verwendet, läuft man Gefahr, die Architektur zu überladen und an Lesbarkeit einzubüßen.
Daher haben wir uns für eine vielseitigere und skalierbarere Lösung entschieden – wir haben die Logik zur Generierung trainierbarer Matrizen in eine separate Klasse ausgelagert, die wir CParams nennen werden. Diese Klasse übernimmt alle Aufgaben im Zusammenhang mit der Initialisierung, Speicherung und Aktualisierung der Gewichte sowie der Rückgabe der gewünschten Matrix zum richtigen Zeitpunkt. Dadurch können wir:
- Parameter zentral verwalten,
- die Architektur beim Hinzufügen neuer Matrizen problemlos skalieren,
- eine einheitliche Schnittstelle zur Generierung verwenden,
- die Fehlersuche und Visualisierung vereinfachen.
Die Struktur des neuen Objekts ist unten dargestellt und umfasst ein minimales, aber funktional vollständiges Framework für die Integration in jede beliebige neuronale Netzwerkarchitektur.
class CParams  :  public   CNeuronBaseOCL
  {
protected:
   CNeuronBaseOCL    cOne;
   //---
   virtual bool      feedForward(CNeuronBaseOCL *NeuronOCL) override
                        { return FeedForward(); }
   virtual bool      updateInputWeights(CNeuronBaseOCL *NeuronOCL) override
                        { return UpdateInputWeights(); }
   virtual bool      calcInputGradients(CNeuronBaseOCL *NeuronOCL) override  { return true; }
   virtual bool      calcHiddenGradients(CNeuronBaseOCL *NeuronOCL) override { return true; }

public:
                     CParams(void) {};
                    ~CParams(void) {};
   //---
   virtual bool      Init(uint numOutputs, uint myIndex, COpenCLMy *open_cl, uint numNeurons,
                          ENUM_OPTIMIZATION optimization_type, uint batch) override;
   virtual bool      Identity(const int rows, const int cols);
   //---
   virtual bool      FeedForward(void);
   virtual bool      UpdateInputWeights(void);
   //---
   virtual bool      Save(const int file_handle) override;
   virtual bool      Load(const int file_handle) override;
   //---
   virtual int       Type(void) override const  {  return defParams; }
   virtual void      SetOpenCL(COpenCLMy *obj) override;
   //---
   virtual bool      WeightsUpdate(CNeuronBaseOCL *source, float tau) override;
  };
Ein wesentliches Merkmal der Implementierung ist die Verwendung einer mit Einsen gefüllten Dummy-Eingabe cOne, die an die trainierbare Schicht weitergeleitet wird. Somit ist die am Ausgang erzeugte Matrix das einzige Objekt, das die erforderlichen Parameter enthält und direkt verwendet werden kann.
Unter der Haube erbt CParams von der neuronalen Basisschicht CNeuronBaseOCL, wodurch es vollständig mit dem restlichen Framework kompatibel ist. Die zentrale Funktionslogik liegt in den Methoden FeedForward und UpdateInputWeights, die durch Aufruf der gleichnamigen geerbten Methoden mit cOne als Eingabe implementiert werden.
Das Objekt wird durch Aufruf der Methode Init initialisiert, die die erforderlichen Schnittstellen erstellt und die Verbindungen zwischen den Komponenten konfiguriert.
bool CParams::Init(uint numOutputs, uint myIndex, COpenCLMy *open_cl, uint numNeurons,
                                      ENUM_OPTIMIZATION optimization_type, uint batch)
  {
   if(!CNeuronBaseOCL::Init(numOutputs, myIndex, open_cl, numNeurons, optimization_type, batch))
      return false;
   if(!cOne.Init(numNeurons, 0, OpenCL, 1, optimization, iBatch))
      return false;
   cOne.SetActivationFunction(None);
   if(!cOne.getOutput().Fill(1))
      return false;
//---
   return true;
  }
Durch eine sorgfältige Implementierung können wir alle Komplexitäten, die mit der Unterstützung von Vorwärts- und Rückwärtsdurchläufen, der Parameteroptimierung und Puffern im OpenCL-Kontext verbunden sind, vollständig verbergen, sodass der Benutzer lediglich die Matrixform und den Verwendungszweck deklarativ angeben muss.
Das Endergebnis ist ein vielseitiger, skalierbarer und wiederverwendbarer Block aus trainierbaren Parametern, der sich für komplexe Berechnungsgraphen eignet. Mit anderen Worten: Wir erhalten ein flexibles Äquivalent zu nn.Parameter aus PyTorch, allerdings innerhalb der MQL5-Umgebung mit OpenCL-Unterstützung.
Ein wichtiges Detail ist dabei zu beachten: Operationen des Vorwärtsdurchlaufs (FeedForward) im CParams-Objekt werden ausschließlich während des Trainings durchgeführt. Das ist sinnvoll – schließlich muss genau in diesem Moment die Gewichtsmatrix an die Fehler des Modells angepasst und auf Grundlage der Backpropagation korrigiert werden.
bool CParams::FeedForward(void)
  {
   if(!bTrain)
      return true;
//---
   return CNeuronBaseOCL::feedForward(cOne.AsObject());
  }
Im Produktionsmodus – also bei der Verwendung eines trainierten Modells für Prognosen oder zur Entscheidungsfindung – ist es jedoch nicht erforderlich, die Matrix neu zu berechnen. Die durch das Training erzeugte Matrix wird zu einem statischen Parameter – sie ändert sich nicht mehr und erfordert keine zusätzlichen Operationen, insbesondere keine ressourcenintensiven Aufrufe von OpenCL-Kernels.
Wenn wir also in den Produktionsmodus wechseln, legen wir die Parameter im Wesentlichen fest und können den Vorwärtsdurchlauf sicher deaktivieren, wodurch wir dem System unnötige Berechnungen ersparen. Dadurch wird die Belastung der Rechenressourcen verringert, der Modellbetrieb beschleunigt und dessen Stabilität verbessert.
Dieser Ansatz ist ein klassisches Beispiel für die Trennung der Rechenphasen, bei der Training und Bereitstellung sowohl in logischer Hinsicht als auch hinsichtlich der Arbeitslast streng voneinander unterschieden werden. Dadurch wird die Architektur nicht nur verständlicher und flexibler, sondern auch im Betrieb besser vorhersehbar, was insbesondere bei Echtzeitsystemen von großer Bedeutung ist.
Der vollständige Code für das CParams-Objekt und alle seine Methoden ist im Anhang enthalten.
Wir haben bereits enorm viel Arbeit geleistet: Wir haben die theoretischen Grundlagen des K²VAE-Frameworks untersucht, seine wichtigsten Module im Detail unter die Lupe genommen und sogar das CParams-Objekt implementiert – einen universellen Generator für parametrisierte Matrizen, der in der Architektur des Modells unverzichtbar ist. Wir stehen nun vor einer noch ehrgeizigeren Herausforderung: Wir müssen eine klare und einheitliche Logik für das gesamte Framework etablieren, in dem jedes Detail ein wesentlicher Bestandteil einer gut geölten Maschine ist.
Aber hier besteht kein Grund zur Eile. Der Aufbau eines solchen Systems erfordert einen klaren Kopf, Aufmerksamkeit und eine neue Perspektive. Genau aus diesem Grund legen wir bis zu unserem nächsten Artikel eine Pause ein und werden mit neuer Energie und frischer Inspiration zurückkehren.
Fazit
In diesem Artikel haben wir uns mit K²VAE befasst, einem leistungsstarken und vielversprechenden Framework, das die Vorteile linearer Dynamik, variationaler Inferenz und adaptiver Filterung vereint. Seine größte Stärke liegt in seiner Fähigkeit, komplexe nichtlineare Prozesse in einem latenten Observablenraum linear zu approximieren und dabei gegenüber Rauschen und systematischen Abweichungen robust zu bleiben. Damit steht nicht nur ein Modell zur Verfügung, sondern ein Werkzeug, das sich durch ein hohes Maß an Interpretierbarkeit, Flexibilität und Genauigkeit auszeichnet – und das insbesondere für die Zeitreihenanalyse und die Prognose der Marktdynamik von Bedeutung ist.
Wir haben gerade erst damit begonnen, das Geflecht von Ideen zu entwirren, das dem K²VAE-Framework zugrunde liegt. In diesem Artikel haben wir die ersten Schritte unternommen – von den theoretischen Grundlagen bis hin zur Implementierung wichtiger Komponenten wie Parametermatrizen und der universell einsetzbaren Klasse CParams, die die gesamte Gewichtsverwaltung außerhalb der Standardarchitektur neuronaler Netze übernimmt. Dies war ein wichtiger Schritt bei der Vorbereitung des Aufbaus der vollständigen Modelllogik.
Es liegt jedoch noch viel Arbeit vor uns. Wir müssen unterschiedliche Elemente zu einem einzigen, zusammenhängenden System zusammenführen: Filtermechanismen implementieren, die probabilistische Dynamik im latenten Raum organisieren und die Architektur aus Encoder, Integrator, KalmanNet und Decoder zu einem einheitlichen Ganzen zusammenfügen. Das ist keine leichte Aufgabe, aber genau dadurch kann das Modell zu einem wirklich intelligenten System zur Entscheidungsfindung werden.
Wir schließen hier noch nicht ab – wir haben lediglich den weiteren Weg skizziert. Die wichtigsten Entwicklungen stehen noch bevor. Es ist also sinnvoll, eine kurze Pause einzulegen, damit wir unsere Reise im nächsten Teil mit neuer Energie fortsetzen können.
Literaturverzeichnis
- K²VAE: A Koopman-Kalman Enhanced Variational AutoEncoder for Probabilistic Time Series Forecasting
- Weitere Artikel dieser Reihe
In diesem Artikel verwendete Programme
| # | Name | Typ | Beschreibung |
|---|---|---|---|
| 1 | Study.mq5 | Expert Advisor | Expert Advisor für das Offline-Modelltraining |
| 2 | StudyOnline.mq5 | Expert Advisor | Expert Advisor für das Online-Training des Modells |
| 3 | Test.mq5 | Expert Advisor | Expert Advisor für Modelltests |
| 4 | Trajectory.mqh | Klassenbibliothek | Struktur zur Beschreibung des Systemzustands und der Modellarchitektur |
| 5 | NeuroNet.mqh | Klassenbibliothek | Klassenbibliothek zum Erstellen eines neuronalen Netzes |
| 6 | NeuroNet.cl | Bibliothek | Code-Bibliothek für das OpenCL-Programm |
Übersetzt aus dem Russischen von MetaQuotes Ltd.
Originalartikel: https://www.mql5.com/ru/articles/18734
Warnung: Alle Rechte sind von MetaQuotes Ltd. vorbehalten. Kopieren oder Vervielfältigen untersagt.
Dieser Artikel wurde von einem Nutzer der Website verfasst und gibt dessen persönliche Meinung wieder. MetaQuotes Ltd übernimmt keine Verantwortung für die Richtigkeit der dargestellten Informationen oder für Folgen, die sich aus der Anwendung der beschriebenen Lösungen, Strategien oder Empfehlungen ergeben.

 Training eines nichtlinearen U-Transformers anhand der Residuen eines linearen autoregressiven Modells
 Neuronale Netze im Trading: Adaptive periodische Segmentierung (Fazit)
 Neuronale Netze im Handel: Probabilistische Zeitreihenprognose (Encoder)
 Neuronale Netze im Trading: Eine intelligente Prognosepipeline (Sparse Mixture of Experts)

- Freie Handelsapplikationen
- Über 8.000 Signale zum Kopieren
- Wirtschaftsnachrichten für die Lage an den Finanzmärkte
Sie stimmen der Website-Richtlinie und den Nutzungsbedingungen zu.