

Superando las limitaciones del aprendizaje automático (Parte 3): Una nueva perspectiva sobre el error irreducible
 27
 0

Este artículo presentará al lector limitaciones avanzadas de los modelos actuales de aprendizaje automático que no se explican de forma explícita a los operadores antes de desplegar estos modelos. El campo del aprendizaje automático está dominado por la notación matemática y la literatura especializada. Además, dado que existen muchos niveles de abstracción desde los que un profesional puede estudiar, el enfoque suele variar. Por ejemplo, algunos operadores estudian el aprendizaje automático basándose únicamente en bibliotecas de alto nivel, como scikit-learn, que ofrecen un marco sencillo e intuitivo para utilizar modelos, al tiempo que abstraen los conceptos matemáticos subyacentes en los que se basan.
Sin embargo, dependiendo del nivel de dominio y del grado de control que desee el profesional, a veces es necesario eliminar estas abstracciones para ver qué ocurre realmente «bajo el capó». Por lo tanto, en cualquier proyecto que implique modelos de aprendizaje automático, el error irreducible siempre está presente, aunque rara vez se mencione directamente.
Consideremos la fórmula de la regresión lineal simple. Normalmente, la variable objetivo que intentamos predecir, Y, puede concebirse como una función, f, de unas entradas medibles, X, transformadas por un conjunto de coeficientes, B, para generar la variable objetivo, Y, dada cierta cantidad de ruido aleatorio que no podemos observar ni controlar, e. Nuestro análisis de hoy se centra en este término de error, e, que está presente de forma silenciosa en todos los modelos de aprendizaje automático. Nuestro objetivo es mostrar al lector que este término de error no es tan aleatorio como la literatura clásica nos haría creer. Creer que este término de error es aleatorio y totalmente irreducible parece contrario a la realidad.
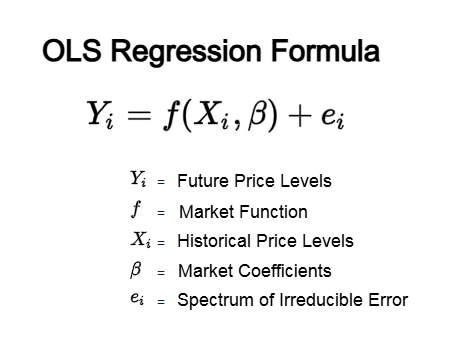
Figura 1: Las explicaciones matemáticas de la regresión por mínimos cuadrados ordinarios ofrecen pocos detalles sobre los términos de error irreducible y sus causas
Nuestro único objetivo es ofrecer al lector una nueva perspectiva sobre el error irreducible, mostrando que lo que comúnmente se conoce como una única magnitud, el «error irreducible», podría descomponerse en un espectro de fuentes de error independientes. Los dos primeros están bien establecidos en la comunidad científica:
- La variabilidad inherente o aleatoriedad natural del proceso subyacente real.
- El sesgo del propio modelo.
Por lo tanto, nuestro debate de hoy tiene como objetivo presentar un tercer componente menos conocido del error irreducible. La conclusión clave de este punto es que podemos controlar esta tercera fuente de error para mejorar nuestro rendimiento en el trading.
Los modelos de aprendizaje automático pueden analizarse desde múltiples perspectivas, lo que dificulta que cualquier lector llegue a dominarlos todos por completo. A menudo estudiamos estos modelos desde una perspectiva estadística. Sin embargo, son pocos los lectores que llegan a analizarlos desde una perspectiva geométrica, y es precisamente ahí donde se esconde la tercera fuente de error irreducible, fuera de la vista de los profesionales que se mantienen en niveles más elevados de abstracción.
Este tercer tipo de error no solo es difícil de corregir —de ahí el término «irreducible»—, sino que, además, resulta difícil incluso detectarlo en un primer momento. A menudo queda oculto tras una notación matemática concisa, lo que puede hacer que nos resulte igualmente difícil de apreciar a cualquiera de nosotros.
Nuestro artículo no pretende reducir este error a cero. Más bien, muestra cómo utilizar los modelos de aprendizaje automático de forma más inteligente y adecuada una vez que reconocemos que existe ese error.
Al estudiarlos desde una perspectiva geométrica, el lector debe comprender que los modelos de aprendizaje automático no «aprenden» realmente la función que asocia las entradas con las salidas. De hecho, el modelo no hace ningún intento real de aproximarse directamente a la función que genera la variable objetivo.
Imagine a un artista humano dibujando una imagen en un papel. El papel hace las veces de lienzo que el artista utiliza para plasmar una imagen de su musa. Del mismo modo, los modelos de aprendizaje automático utilizan las entradas que les proporcionamos para crear un nuevo «lienzo» denominado «variedad (manifold)». Ahora, imagine que sujetáramos una moneda de tal forma que proyectara una sombra sobre el «lienzo» que nuestro modelo de aprendizaje automático ha creado a partir de las entradas que le hemos proporcionado. El punto en el que la sombra incide sobre el lienzo es la predicción que realiza nuestro modelo. Pero nuestro objetivo real es la moneda real. Lo que queremos que el lector comprenda es que nuestros modelos de aprendizaje automático, en esencia, proyectan imágenes del objetivo sobre una combinación —o variedad— construida a partir de las entradas que se les proporcionaron.
Pero la variable objetivo que usted intenta predecir no reside necesariamente en la variedad que podemos crear a partir de las entradas, sino que reside en su propio espacio. Por lo tanto, siempre existe una distancia irreducible entre la variedad creada por sus entradas y aquella en la que reside el verdadero objetivo. Esta distancia constituye otra fuente de error; junto con la aleatoriedad natural del proceso y el sesgo del modelo, completa el panorama completo.
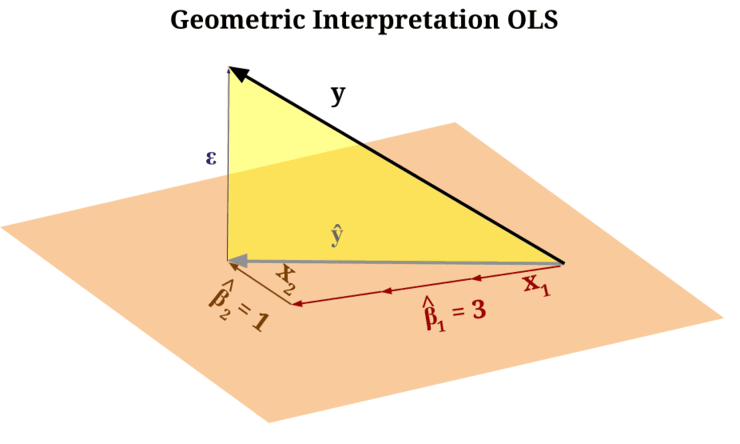
Figura 2: El «plano naranja» representa el «lienzo» que el modelo ha creado a partir de las entradas que usted le ha proporcionado, mientras que el «triángulo amarillo» es el error irreducible entre el lienzo y el objetivo real.
Los lectores que ya estén familiarizados con la geometría analítica reconocerán que el subespacio generado por las entradas proporcionadas a un modelo de aprendizaje automático define un nuevo sistema de coordenadas. A continuación, el modelo intenta describir el objetivo utilizando este nuevo sistema de coordenadas que ha aprendido a partir de los datos de entrada. Pero recuerde: ¡el objetivo se encuentra en su propio sistema de coordenadas, independiente del definido por los datos de entrada!
Los lectores avanzados que ya estén familiarizados con esta perspectiva geométrica del aprendizaje automático pueden considerar evidente lo que se expone a continuación, y pueden optar por pasar rápidamente a la siguiente sección si deciden seguir con nosotros. Para quienes aún no se hayan encontrado con el problema planteado de esta manera, el resto del artículo está pensado precisamente para esos lectores.
La conclusión principal es que podemos ejercer cierto control sobre este error en nuestra actividad de trading haciendo un uso más consciente, deliberado e inteligente de los modelos de aprendizaje automático.
Nuestra conversación comienza con el nivel de rendimiento de referencia establecido en nuestro debate anterior sobre los controladores de retroalimentación, cuyo enlace se incluye aquí. Nuestro controlador de retroalimentación mejoró considerablemente el rendimiento en comparación con el punto de partida de esa conversación. Tras realizar los ajustes sugeridos en este artículo, conseguimos superar el rendimiento del antiguo controlador de retroalimentación, que ya se situaba cerca de un nivel aceptable.
Nuestra metodología consistió en dejar de lado las comparaciones directas punto a punto. En lugar de pedir al modelo que predijera un nivel de precios futuro y compararlo con el precio actual, modelizamos los niveles de precios en dos intervalos de tiempo y operamos la pendiente o tendencia anticipada. En otras palabras, negociamos según la pendiente prevista por el modelo en dos intervalos, en lugar de realizar una comparación directa entre los precios previstos y los reales.
Realizamos un backtest de cinco años sobre el par EUR/USD utilizando estrategias idénticas, con la única diferencia de cómo hicimos que nuestros modelos representaran el precio. Los resultados mostraron una mejora en las siguientes dimensiones del rendimiento:
Rentabilidad del trading
Nuestro beneficio neto total aumentó de 245 a 253 dólares, lo que supone una mejora del 3 % en la rentabilidad. Al mismo tiempo, nuestro ratio de Sharpe subió de 0,68 a 0,84; una mejora del 23 % en el ratio de Sharpe es notable cuando se opera en un mercado financiero tan complejo como el par EUR/USD.
Aún más sorprendente fue que la pérdida bruta durante el backtest de cinco años cayó de 838 $ a 721 $; esto supone una reducción del 13 % en el riesgo total asumido por nuestra aplicación de trading. Además, nuestra actividad de trading acumulada se redujo de 152 operaciones a 139, lo que supone una disminución del 8 % en el número total de operaciones necesarias. Esto significa que nuestra aplicación obtuvo mayores márgenes de beneficio asumiendo menos riesgo. Precisión en las operaciones
Por último, la proporción de operaciones rentables aumentó un 4 %, pasando del 57,24 % en la referencia original de nuestro controlador de retroalimentación al 59,71 % tras realizar los ajustes que sugerimos. Esto significa que, en general, nuestro sistema se volvió más rentable al tiempo que asumía menos riesgo, una característica ideal para cualquier aplicación de trading.
Todos los operadores deberían tener muy en cuenta estas modificaciones. Pero empecemos por repasar los niveles de rendimiento anteriores establecidos por el primer controlador de retroalimentación que implementamos en nuestro análisis anterior.
El primer backtest se realizó desde el 1 de enero de 2020 hasta el 1 de mayo de 2025. Mantendremos las mismas fechas incluso durante esta segunda prueba.
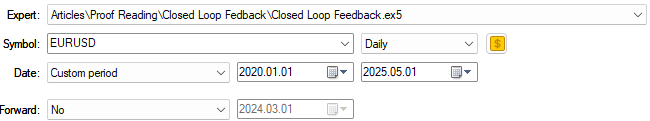
Figura 3: Revisión de los niveles de rendimiento de referencia que establecimos en nuestro análisis inicial
El antiguo controlador de retroalimentación produjo resultados realmente aceptables, pero aún podemos mejorarlos. Hemos conservado aquí estos resultados antiguos para que el lector pueda contrastarlos con los nuevos resultados que estamos a punto de presentar; por lo tanto, la figura 4 que aparece a continuación procede de nuestro antiguo controlador de retroalimentación. Nos sirve como referencia que debemos superar hoy.
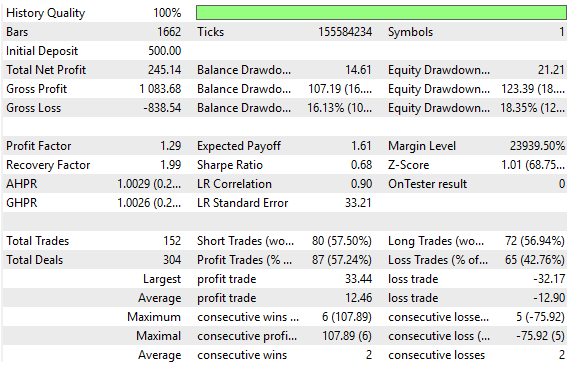
Figura 4: Los antiguos niveles de rendimiento establecidos por nuestro primer intento de construir un controlador de retroalimentación
La curva de equity generada por nuestro antiguo controlador de retroalimentación era prometedora. Conseguimos obtener más beneficios de la estrategia realizando algunos ajustes en la estrategia original, que acabaron teniendo un efecto notable en la rentabilidad de todo nuestro sistema. En la figura 5 que aparece a continuación, podemos ver que el antiguo controlador de retroalimentación solo logró alcanzar el nivel de beneficios de 700 dólares en 2023. Sin embargo, como veremos en breve, nuestro controlador de retroalimentación revisado alcanzó el nivel de beneficios de 700 dólares en 2021. Aunque experimentó un impacto negativo en la rentabilidad poco después de 2021, no hace falta decir que las mejoras introducidas son evidentes.
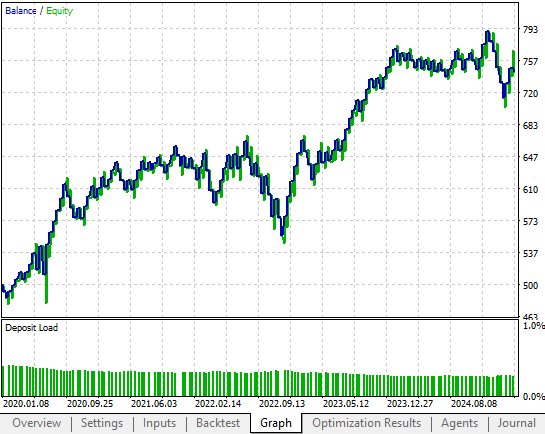
Figura 5: La curva de beneficios y equity generada por la versión de referencia de nuestra estrategia de trading
Primeros pasos en MQL5
Al igual que con todas nuestras aplicaciones de trading, comenzamos por establecer las definiciones importantes del sistema, heredadas sin cambios de la versión inicial de nuestra estrategia de trading. Recordemos que estas definiciones son importantes porque nos ayudan a garantizar que nuestras pruebas sean imparciales y nuestras comparaciones, coherentes.//+------------------------------------------------------------------+ //| Closed Loop Feedback 1.2.mq5 | //| Gamuchirai Ndawana | //| https://www.mql5.com/en/users/gamuchiraindawa | //+------------------------------------------------------------------+ #property copyright "Gamuchirai Ndawana" #property link "https://www.mql5.com/en/users/gamuchiraindawa" #property version "1.00" //+------------------------------------------------------------------+ //| System definitions | //+------------------------------------------------------------------+ #define MA_PERIOD 10 #define FEATURES 12 #define TARGETS 15 #define HORIZON 10 #define OBSERVATIONS 90 #define ACCOUNT_STATES 3
A continuación, definimos las variables globales importantes que se utilizarán en la estrategia de trading. Estas variables hacen un seguimiento de los indicadores técnicos, de la condición y el estado de nuestra cuenta de trading, de la amplitud de nuestro stop loss y de si la estrategia debe operar sin realizar una predicción o realizarla primero antes de operar. Las variables globales nos permiten definir y controlar el comportamiento de nuestra aplicación de una forma que resulta a la vez predecible y repetible.
//+------------------------------------------------------------------+
//| Global variables                                                 |
//+------------------------------------------------------------------+
int    ma_h_handler,ma_l_handler,atr_handler,scenes,b_matrix_scenes;
double ma_h[],ma_l[],atr[];
double padding;
matrix snapshots,OB_SIGMA,OB_VT,OB_U,b_vector,b_matrix;
vector S,prediction;
vector account_state;
bool predict,permission;
Todas las aplicaciones de trading tienen además dependencias que ayudan a evitar tener que reescribir el mismo código repetitivo. Por lo tanto, cargamos bibliotecas importantes, como la biblioteca de trading (para abrir y cerrar posiciones), junto con dos bibliotecas personalizadas creadas específicamente para estos análisis: la biblioteca de tiempo y la biblioteca de información de trading. La biblioteca de tiempo nos ayuda a determinar cuándo se ha formado una nueva vela, mientras que la biblioteca de información de trading proporciona detalles importantes, como el tamaño mínimo de lote permitido y los precios Bid y Ask actuales.
//+------------------------------------------------------------------+
//| Dependencies                                                     |
//+------------------------------------------------------------------+
#include <Trade\Trade.mqh>
#include <VolatilityDoctor\Time\Time.mqh>
#include <VolatilityDoctor\Trade\TradeInfo.mqh>

CTrade      Trade;

Time        *DailyTimeHandler;
TradeInfo   *TradeInfoHandler;
Durante la inicialización, creamos nuevas instancias de todas las clases personalizadas que hemos creado hasta ahora. También definimos instancias de indicadores técnicos, como la media móvil y el indicador ATR, así como las matrices y vectores importantes que necesitaremos. Cada vez que se inicia la aplicación, se inicializan las banderas booleanas y se pone a cero el contador de escenas transcurridas.
//+------------------------------------------------------------------+
//| Expert initialization function                                   |
//+------------------------------------------------------------------+
int OnInit()
  {
//---
   DailyTimeHandler  = new Time(Symbol(),PERIOD_D1);
   TradeInfoHandler  = new TradeInfo(Symbol(),PERIOD_D1);
   ma_h_handler      = iMA(Symbol(),PERIOD_D1,MA_PERIOD,0,MODE_EMA,PRICE_HIGH);
   ma_l_handler      = iMA(Symbol(),PERIOD_D1,MA_PERIOD,0,MODE_EMA,PRICE_LOW);
   atr_handler       = iATR(Symbol(),PERIOD_D1,14);
   snapshots         = matrix::Ones(FEATURES,OBSERVATIONS);
   scenes            = 0;
   b_matrix_scenes   = 0;
   account_state     = vector::Zeros(3);
   b_matrix          = matrix::Zeros(1,1);
   prediction        = vector::Zeros(2);
   predict           = false;
   permission        = true;
//---
   return(INIT_SUCCEEDED);
  }
Cuando la aplicación ya no se está utilizando, en MQL5 se recomienda llevar a cabo una gestión adecuada de la memoria. Por lo tanto, eliminamos las instancias de objetos personalizados y liberamos los indicadores técnicos que ya no se utilizan.
//+------------------------------------------------------------------+
//| Expert deinitialization function                                 |
//+------------------------------------------------------------------+
void OnDeinit(const int reason)
  {
//---
   delete DailyTimeHandler;
   delete TradeInfoHandler;
   IndicatorRelease(ma_h_handler);
   IndicatorRelease(ma_l_handler);
   IndicatorRelease(atr_handler);
  }
Cuando se reciben nuevos niveles de precios del servidor de trading, nuestro Asesor experto también llamará a su función OnTick. En esta configuración, lo primero que hay que comprobar es si se ha formado una nueva vela. Esto garantiza que nuestros backtests se ejecuten más rápido, ya que las acciones solo se realizan una vez por vela.
Una vez confirmado, actualizamos las lecturas de los indicadores técnicos y nuestra variable de padding, que nos indica qué amplitud debe tener nuestro stop loss. A continuación, registramos el precio de cierre más reciente. Si hay una o más posiciones abiertas, seleccionamos los tickets de las posiciones abiertas y modificamos sus stop loss para que se desplacen a medida que aumenta la rentabilidad.
Para configurar un trailing stop, primero registramos los valores actuales del stop loss y del take profit. Al comparar estos valores con los valores actualizados sugeridos, decidimos si actualizamos o no. Si el valor sugerido resulta más rentable, se realiza la actualización; en caso contrario, no se aplica ningún cambio. Es importante destacar que, antes de realizar esta actualización, debemos confirmar qué tipo de posición estamos modificando.
Si no hay posiciones abiertas, inicializamos el vector de estado de la cuenta. Recordemos que este vector guarda información sobre el tipo de posición que pretendemos abrir. Si el precio de cierre está por encima de la media móvil alta, abrimos una posición de compra. Si se sitúa por debajo de la media móvil baja, abrimos una posición de venta.
Las operaciones se abren directamente si la bandera booleana «predict» está establecida en «false» y la bandera booleana «permission» está establecida en «true». De lo contrario, el sistema registra todas las variables y realiza una predicción antes de abrir operaciones.
//+------------------------------------------------------------------+
//| Expert tick function                                             |
//+------------------------------------------------------------------+
void OnTick()
  {
//---
   if(DailyTimeHandler.NewCandle())
     {
      CopyBuffer(ma_h_handler,0,0,1,ma_h);
      CopyBuffer(ma_l_handler,0,0,1,ma_l);
      CopyBuffer(atr_handler,0,0,1,atr);
      padding = atr[0]*2;
      double c = iClose(Symbol(),PERIOD_D1,0);

      if(PositionsTotal() > 0)
        {
         ulong ticket = PositionSelectByTicket(PositionGetTicket(0));
         if(ticket)
           {
            double sl,tp;

            sl = PositionGetDouble(POSITION_SL);
            tp = PositionGetDouble(POSITION_TP);

            if(PositionGetInteger(POSITION_TYPE) == POSITION_TYPE_BUY)
              {
               double new_sl = TradeInfoHandler.GetBid()-padding;
               double new_tp = TradeInfoHandler.GetBid()+padding;

               if(new_sl > sl)
                  Trade.PositionModify(ticket,new_sl,new_tp);
              }

            else
               if(PositionGetInteger(POSITION_TYPE) == POSITION_TYPE_SELL)
                 {
                  double new_sl = TradeInfoHandler.GetAsk()+padding;
                  double new_tp = TradeInfoHandler.GetAsk()-padding;

                  if(new_sl < sl)
                     Trade.PositionModify(ticket,new_sl,new_tp);
                 }
           }
        }

      if(PositionsTotal() == 0)
        {
         account_state = vector::Zeros(ACCOUNT_STATES);

         if(c > ma_h[0])
           {
            if(!predict)
              {
               if(permission)
                  Trade.Buy(TradeInfoHandler.MinVolume(),Symbol(),TradeInfoHandler.GetAsk(),(TradeInfoHandler.GetBid()-(padding)),(TradeInfoHandler.GetBid()+(padding)),"");
              }

            account_state[0] = 1;
           }

         else
            if(c < ma_l[0])
              {
               if(!predict)
                 {
                  if(permission)
                     Trade.Sell(TradeInfoHandler.MinVolume(),Symbol(),TradeInfoHandler.GetBid(),(TradeInfoHandler.GetAsk()+(padding)),(TradeInfoHandler.GetAsk()-(padding)),"");
                 }

               account_state[1] = 1;
              }

            else
              {
               account_state[2] = 1;
              }
        }

      if(scenes < OBSERVATIONS)
        {
         take_snapshots();
        }

      else
        {
         matrix temp;
         temp.Assign(snapshots);
         snapshots = matrix::Ones(FEATURES,scenes+1);

         //--- The first row is the intercept and must be full of ones
         for(int i=0;i<FEATURES;i++)
            snapshots.Row(temp.Row(i),i);

         take_snapshots();
         fit_snapshots();

         predict = true;
         permission = false;
        }
      scenes++;
     }
  }
El método que utilizamos para tomar una instantánea es muy sencillo. Registra información importante del mercado en una matriz que denominamos «snapshots». Esto incluye los precios de apertura, máximo, mínimo y cierre, así como el equity de la cuenta. Los lectores que hayan seguido los debates anteriores reconocerán este código, ya que es el mismo que utilizamos al principio de la serie.
//+------------------------------------------------------------------+
//| Record the current state of our system                           |
//+------------------------------------------------------------------+
void take_snapshots(void)
  {
   snapshots[1,scenes] = iOpen(Symbol(),PERIOD_D1,1);
   snapshots[2,scenes] = iHigh(Symbol(),PERIOD_D1,1);
   snapshots[3,scenes] = iLow(Symbol(),PERIOD_D1,1);
   snapshots[4,scenes] = iClose(Symbol(),PERIOD_D1,1);
   snapshots[5,scenes] = AccountInfoDouble(ACCOUNT_BALANCE);
   snapshots[6,scenes] = AccountInfoDouble(ACCOUNT_EQUITY);
   snapshots[7,scenes] = ma_h[0];
   snapshots[8,scenes] = ma_l[0];
   snapshots[9,scenes] = account_state[0];
   snapshots[10,scenes] = account_state[1];
   snapshots[11,scenes] = account_state[2];
  }
Ahora, sin embargo, empezamos a ver las mejoras introducidas con respecto a esa versión inicial. Hasta este punto, todo debería resultar familiar a los lectores habituales. Ahora estamos preparando las entradas y salidas del sistema que modela cómo evolucionan nuestras instantáneas. Recordemos que las instantáneas recogen detalles importantes sobre cómo interactúa nuestra estrategia con el mercado; por ejemplo, cómo varían con el tiempo el saldo de nuestra cuenta y el equity.
La matriz X almacena los datos de entrada, mientras que la matriz Y almacena los datos de salida. Si el lector observa con atención la matriz Y, se dará cuenta de que las filas 4, 5, 6 y 7 de Y se han copiado de las filas 5, 6, 7 y 8 de X. A continuación, esas mismas filas de X se duplican de nuevo, pero desplazadas hacia el futuro. Esto significa que le pedimos a nuestro modelo que no solo prediga el saldo de la cuenta un paso en el futuro, sino también diez pasos en el futuro.
En función de la tendencia prevista a lo largo de estos dos horizontes, decidimos si abrir una operación. Una vez hallada la solución óptima mediante el método de la pseudoinversa (que ya se ha comentado anteriormente), nuestro modelo generará dos predicciones:
- El saldo esperado en la próxima vela[4].
- El saldo esperado tras diez velas [8].
A continuación, el modelo toma decisiones de trading basadas en estas predicciones. Si se prevé un crecimiento de la cuenta, se permiten las operaciones. Si se prevé un descenso, se deniega la autorización.
Esto supone una mejora significativa con respecto al método anterior. En análisis anteriores, comparamos el saldo de la cuenta previsto por el modelo directamente con el saldo real actual, como si ambos fueran iguales. Con este enfoque, evitamos cometer ese error.
//+------------------------------------------------------------------+
//| Fit our linear model to our collected snapshots                  |
//+------------------------------------------------------------------+
void fit_snapshots(void)
  {
   matrix X,y;
   X.Reshape(FEATURES,scenes);
   y.Reshape(TARGETS,scenes);

   for(int i=0;i<scenes-HORIZON;i++)
     {
      X[0,i] = snapshots[0,i];
      X[1,i] = snapshots[1,i];
      X[2,i] = snapshots[2,i];
      X[3,i] = snapshots[3,i];
      X[4,i] = snapshots[4,i];
      X[5,i] = snapshots[5,i];
      X[6,i] = snapshots[6,i];
      X[7,i] = snapshots[7,i];
      X[8,i] = snapshots[8,i];
      X[9,i] = snapshots[9,i];
      X[10,i] = snapshots[10,i];
      X[11,i] = snapshots[11,i];

      y[0,i] = snapshots[1,i+1];
      y[1,i] = snapshots[2,i+1];
      y[2,i] = snapshots[3,i+1];
      y[3,i] = snapshots[4,i+1];
      y[4,i] = snapshots[5,i+1];
      y[5,i] = snapshots[6,i+1];
      y[6,i] = snapshots[7,i+1];
      y[7,i] = snapshots[8,i+1];
      y[8,i] = snapshots[5,i+HORIZON];
      y[9,i] = snapshots[6,i+HORIZON];
      y[10,i] = snapshots[7,i+HORIZON];
      y[11,i] = snapshots[8,i+HORIZON];
      y[12,i] = snapshots[9,i+1];
      y[13,i] = snapshots[10,i+1];
      y[14,i] = snapshots[11,i+1];
     }

   if(PositionsTotal() == 0)
     {
      //--- Find optimal solutions
      b_vector = y.MatMul(X.PInv());
      Print("Day Number: ",scenes+1);
      Print("Snapshot");
      Print(snapshots);
      Print("Input");
      Print(X);
      Print("Target");
      Print(y);
      Print("Coefficients");
      Print(b_vector);
      Print("Prediciton");
      prediction = b_vector.MatMul(snapshots.Col(scenes-1));
      Print("Expected Balance at next candle: ",prediction[4],". Expected Balance after 10 candles: ",prediction[8]);

      permission = false;

      if(prediction[4] < prediction[8])
        {
         Print("Account size expected to grow, permission granted");
         permission = true;
        }

      else
         permission = false;

      if(permission)
        {
         if(PositionsTotal() == 0)
           {
            if(account_state[0] == 1)
               Trade.Buy(TradeInfoHandler.MinVolume(),Symbol(),TradeInfoHandler.GetAsk(),(TradeInfoHandler.GetBid()-(atr[0]*2)),(TradeInfoHandler.GetBid()+(atr[0]*2)),"");

            else
               if(account_state[1] == 1)
                  Trade.Sell(TradeInfoHandler.MinVolume(),Symbol(),TradeInfoHandler.GetBid(),(TradeInfoHandler.GetAsk()+(atr[0]*2)),(TradeInfoHandler.GetAsk()-(atr[0]*2)),"");
           }
        }
     }
  }
//+------------------------------------------------------------------+
Al igual que en nuestra conversación anterior, debemos mantener las mismas fechas para las pruebas, a fin de garantizar que las comparaciones sean justas en todo momento.
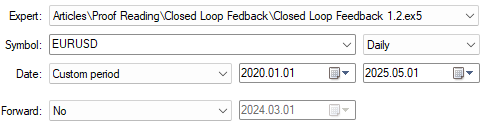
Figura 6: Backtest de la versión mejorada de nuestro controlador de retroalimentación durante el mismo periodo
Nuestras estadísticas detalladas muestran un crecimiento claro y cuantificable con respecto a la versión inicial de la estrategia de trading. Esta versión mejorada de la estrategia nos expone, en general, a menos riesgo que la versión inicial de la estrategia de trading. También resulta interesante señalar que la proporción de operaciones en corto rentables mejoró significativamente, acercándose casi al 70 %.
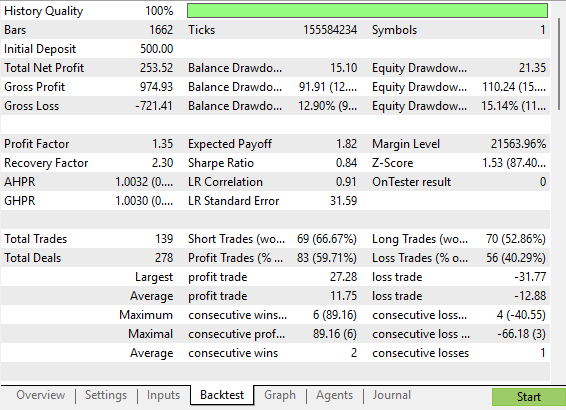
Figura 7: Análisis detallado de las mejoras que hemos introducido en nuestro sistema de trading
Nuestra nueva estrategia generó una curva de equity con menos periodos de drawdown en comparación con la estrategia original. Esta estrategia muestra un crecimiento constante y menos volátil, pero aun así más rápido que el de la versión original, de mayor riesgo, de nuestra estrategia de trading.
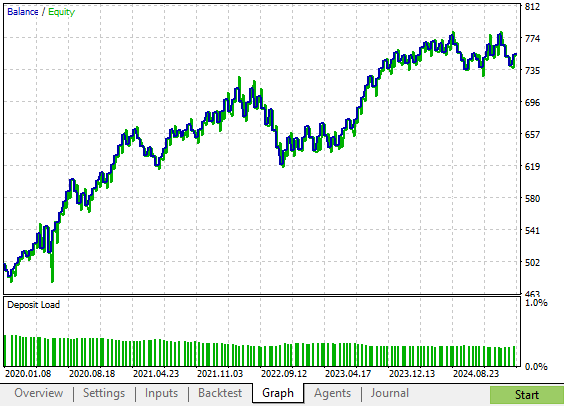
Figura 8: La curva de equity generada por nuestra versión mejorada de la estrategia de trading muestra un crecimiento acelerado en comparación con la estrategia original
Conclusión
Imagine que sostiene una pelota de golf con el brazo extendido frente al cielo y le pide a su modelo de IA que compare su tamaño con el de la Luna a simple vista. Unos días, el modelo decidiría que la Luna es un poco más grande que la pelota de golf y, otros, podría afirmar que la pelota de golf es un poco más grande que la Luna. Como seres humanos, sabemos que una actividad así es fundamentalmente errónea y, hasta cierto punto, divertida; sin embargo, la diversión se acaba aquí.
En principio, nuestros modelos de aprendizaje automático podrían cometer el mismo error de forma imperceptible al operar en los mercados financieros. En el experimento mental, el error que se comete es que el modelo no entendió que no estaba trabajando directamente con la Luna, sino que estaba comparando una imagen de la Luna tal y como se proyecta en el cielo.
Y en los mercados, nuestros modelos de aprendizaje automático no predicen el valor «real» del precio futuro, sino que crean imágenes del objetivo sobre las características. Por lo tanto, no deberíamos comparar directamente las predicciones de nuestro modelo con los precios reales, como si fueran lo mismo. En su lugar, debemos reconocer que nuestros modelos de aprendizaje automático intentan construir una representación del objetivo utilizando un sistema de coordenadas aprendido a partir de las entradas, y que las imágenes siempre están separadas de la realidad por una distancia irreducible. Esa imagen puede verse distorsionada por muchos factores, por lo que deberíamos evitar basarnos en predicciones directas.
En cambio, tras leer este artículo, el lector terminará la lectura con una comprensión más sólida, sabiendo por qué debemos utilizar múltiples horizontes de previsión para reducir el efecto de este error de desajuste, un error que suele no cuestionarse.
Traducción del inglés realizada por MetaQuotes Ltd.
Artículo original: https://www.mql5.com/en/articles/19371
Advertencia: todos los derechos de estos materiales pertenecen a MetaQuotes Ltd. Queda totalmente prohibido el copiado total o parcial.
Este artículo ha sido escrito por un usuario del sitio web y refleja su punto de vista personal. MetaQuotes Ltd. no se responsabiliza de la exactitud de la información ofrecida, ni de las posibles consecuencias del uso de las soluciones, estrategias o recomendaciones descritas.
 Creación de un sistema de trading profesional con Heikin Ashi (Parte 1): Desarrollo de un indicador personalizado
 Desarrollo de un kit de herramientas para el análisis de la acción del precio (Parte 38): VWAP con búfer de ticks y motor de desequilibrio de ventana corta
 Particularidades del trabajo con números del tipo double en MQL4
 Guía de aprendizaje automático para MetaTrader 5 (Parte 2): Etiquetado de datos financieros para modelos de aprendizaje automático

- Aplicaciones de trading gratuitas
- 8 000+ señales para copiar
- Noticias económicas para analizar los mercados financieros
Usted acepta la política del sitio web y las condiciones de uso