
Simplificando o uso de bancos de dados em MQL5 (Parte 1): Introdução aos bancos de dados e ao SQL
 19
 4

Introdução
Quando falamos em MQL5, a maioria das conversas gira em torno de indicadores, EAs, estratégias de negociação e backtests. Mas chega um momento em que qualquer trader ou desenvolvedor que leva a automação a sério percebe que armazenar dados é fundamental. É aí que entram os bancos de dados. Talvez você pense: "Mas eu já salvo meus resultados em arquivos CSV ou TXT. Por que complicar as coisas usando um banco de dados?" A resposta está na estruturação dos dados, na eficiência e na confiabilidade que um banco de dados oferece, especialmente quando precisamos lidar com grandes volumes de informações ou operações complexas.
À primeira vista, falar de bancos de dados no contexto do MQL5 pode parecer um exagero. Afinal, a linguagem é voltada principalmente ao trading, aos indicadores e aos robôs de negociação automatizada. No entanto, quando começamos a desenvolver estratégias que envolvem grandes volumes de dados, backtests complexos ou registros detalhados de ordens, as limitações dos arquivos convencionais logo se tornam evidentes. É nesse cenário que saber criar, acessar e utilizar bancos de dados passa a ser um recurso capaz de transformar seu fluxo de trabalho no trading.
Quem começa a explorar bancos de dados em MQL5 encontra dezenas de funções nativas e exemplos isolados. Armazenar registros e consultá-los é relativamente simples, mas logo surge uma questão: como estruturar tudo isso de maneira que possa ser reutilizado em projetos reais? Nesta série de artigos, vamos além da documentação. Começaremos pelas funções básicas do SQLite e avançaremos, passo a passo, até a implementação de um mini-ORM em MQL5 (TickORM). A proposta é organizar as chamadas diretas em camadas de abstração bem planejadas, inspiradas nas tecnologias Java JDBC e JPA, mas adaptadas ao ecossistema MetaTrader.
Neste artigo, apresentarei os fundamentos do uso de bancos de dados com MQL5 e SQL. Isso servirá de base para os próximos artigos, nos quais encapsularemos essas funções em classes, interfaces e, por fim, em um ORM.
O que é um banco de dados e para que ele serve?
Tecnicamente, um banco de dados é um conjunto de dados estruturados para armazenamento, consulta e gerenciamento. Ele garante a integridade dos dados, estabelece relações entre diferentes conjuntos de informações e proporciona rapidez na execução das operações.
A diferença prática entre armazenar dados em arquivos e utilizar um banco de dados está na forma como as informações são estruturadas e na facilidade de acesso. Em arquivos simples, como CSV ou TXT, cada leitura ou alteração exige percorrer todo o conteúdo, manipular strings, corrigir problemas de formatação e torcer para que o arquivo não esteja corrompido. Em um banco de dados, esses detalhes são abstraídos: é possível localizar registros específicos, atualizar vários valores de uma só vez e garantir a execução de transações completas sem perda de dados.
Mas como essa estrutura funciona internamente? Para entender a estrutura básica de um banco de dados, imagine uma planilha eletrônica. Veja um exemplo:
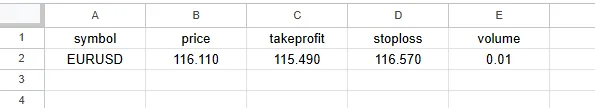
- Cada tabela de um banco de dados equivale a uma aba da planilha, destinada a um conjunto específico de informações (por exemplo, Trades).
- Dentro de cada tabela, as colunas representam os atributos de cada elemento (por exemplo, identificador, símbolo, preço etc.).
- Cada linha da tabela corresponde a um registro, como um negócio específico ou uma ordem executada.
Essa estrutura simples, baseada em tabelas, colunas e linhas, permite realizar consultas rápidas e bem estruturadas. É como ter uma quantidade ilimitada de planilhas organizadas e interligadas, com a vantagem de poder cruzar dados, aplicar filtros avançados e lidar com grandes volumes de informações sem complicações.
É daí que vem a motivação para desenvolver nosso próprio ORM em MQL5. A ideia é simples: em vez de escrever consultas SQL manualmente sempre que precisarmos interagir com uma tabela (criar registros, consultar resultados ou atualizar valores), vamos implementar uma camada que represente as tabelas como entidades e as colunas como atributos de classe. Essa camada será o núcleo do projeto que desenvolveremos ao longo da série e servirá de base para sistemas de trading mais robustos e escaláveis. Nosso ORM se chamará TickORM.
Em resumo, os bancos de dados servem de base para a criação de soluções robustas e flexíveis, e nosso ORM fará a ponte entre essa base e o código MQL5.
Para facilitar os testes, o código completo do exemplo está disponível ao final do artigo. Assim, você poderá consultá-lo, copiá-lo e adaptá-lo conforme necessário, sem precisar reunir os trechos manualmente.
Observação: a partir de agora, alguns exemplos de código exibirão mensagens de log no console. Para isso, utilizo minha biblioteca Logify, desenvolvida especificamente para facilitar o rastreamento e a depuração em MQL5. Se quiser conhecer melhor seu funcionamento ou acompanhar sua implementação passo a passo, escrevi uma série inteira de artigos sobre o desenvolvimento da biblioteca.SQL e funções nativas do MQL5
Trabalhar com bancos de dados não exige muita coisa. Felizmente, o MQL5 oferece um conjunto de funções nativas que permitem criar bancos de dados, acessar e manipular dados diretamente no código MQL5. Essas funções fazem a ponte entre seu código e o banco de dados.
A integração com SQL é direta: essas funções constituem a camada responsável pela execução das consultas. Em outras palavras, você escreve comandos SQL no código MQL5, enquanto as funções nativas cuidam da preparação e execução das consultas, além da leitura dos resultados. Isso significa que, mesmo sem bibliotecas externas, é possível realizar operações complexas, como SELECT, INSERT, UPDATE e DELETE, além de criar tabelas.
Antes de passarmos à implementação prática, precisamos conhecer essas funções e entender o que cada uma permite fazer. Para apresentar todos os recursos disponíveis, listarei as funções nativas de acesso a bancos de dados do MQL5, pois veremos como utilizar cada uma delas:
- DatabaseOpen(string filename, uint flags): Abre ou cria um banco de dados no arquivo especificado.
- DatabaseClose(int database): Fecha o banco de dados.
- DatabaseImport(int database,const string table,const string filename,uint flags,const string separator,ulong skip_rows,const string skip_comments): Importa dados de um arquivo para uma tabela.
- DatabaseExport(int database,const string table_or_sql,const string filename,uint flags,const string separator): Exporta uma tabela ou o resultado de uma consulta SQL para um arquivo CSV.
- DatabasePrint(int database,const string table_or_sql,uint flags): Exibe uma tabela ou o resultado de uma consulta SQL na aba Experts do terminal.
- DatabaseTableExists(int database,string table): Verifica se uma tabela existe no banco de dados.
- DatabaseExecute(int database, string sql): Executa uma consulta no banco de dados especificado.
- DatabasePrepare(int database, string sql): Cria um identificador para uma consulta que poderá ser executada posteriormente por meio de DatabaseRead().
- DatabaseReset(int request): Redefine o estado de uma consulta preparada com DatabasePrepare(), permitindo sua reutilização.
- DatabaseBind(int request,int index,T value): Atribui um valor a um parâmetro da consulta.
- DatabaseRead(int request): Avança para o próximo registro do resultado da consulta.
- DatabaseFinalize(int request): Libera a consulta criada por DatabasePrepare().
- DatabaseTransactionBegin(int database): Inicia uma transação.
- DatabaseTransactionCommit(int database): Confirma uma transação.
- DatabaseTransactionRollback(int database): Reverte uma transação.
- DatabaseColumnsCount(int request): Retorna o número de colunas do resultado da consulta.
- DatabaseColumnName(int request,int column,string& name): Obtém o nome de um campo pelo índice.
- DatabaseColumnType(int request,int column): Obtém o tipo de um campo pelo índice.
- DatabaseColumnSize(int request,int column): Obtém o tamanho de um campo em bytes.
- DatabaseColumnText(int request,int column,string& value): Obtém o valor do tipo string de um campo do registro atual.
- DatabaseColumnInteger(int request,int column,int& value): Obtém o valor do tipo int de um campo do registro atual.
- DatabaseColumnLong(int request,int column,long& value): Obtém o valor do tipo long de um campo do registro atual.
- DatabaseColumnDouble(int request,int column,double& value): Obtém o valor do tipo double de um campo do registro atual.
Informações detalhadas sobre todas as funções disponíveis, seus parâmetros e exemplos de uso podem ser encontradas na documentação oficial da MetaQuotes, na seção MQL5 Database Functions.
1. Abertura e fechamento de bancos de dados
Começaremos pelo básico: estabelecer uma conexão com o banco de dados. Para isso, utilizamos a função DatabaseOpen, que recebe o nome do arquivo do banco de dados e flags opcionais que determinam o modo de abertura. Esses flags podem assumir os seguintes valores:
| Valor | Descrição |
|---|---|
| DATABASE_OPEN_READONLY | Somente leitura |
| DATABASE_OPEN_READWRITE | Abertura para leitura e gravação |
| DATABASE_OPEN_CREATE | Cria o arquivo em disco, caso ainda não exista |
| DATABASE_OPEN_MEMORY | Cria o banco de dados na memória RAM |
| DATABASE_OPEN_COMMON | O arquivo fica na pasta compartilhada entre todos os terminais. |
int OnInit()
  {
   //--- Open connection
   int handler = DatabaseOpen("database.sqlite",DATABASE_OPEN_CREATE|DATABASE_OPEN_READWRITE);
   if(handler == INVALID_HANDLE)
     {
      logs.Error("Failed to open database","TickORM");
      return(INIT_FAILED);
     }
   logs.Info("Open database","TickORM");

   //--- Here you would perform queries, inserts or updates

   //--- Close connection
   logs.Info("Closed database","TickORM");
   DatabaseClose(handler);

   return(INIT_SUCCEEDED);
  }
No primeiro parâmetro, informamos o nome do banco de dados, que, neste caso, defini como "database". Basta acrescentar a extensão ".sqlite" ao nome, pois estamos utilizando um banco de dados armazenado em arquivo. Isso não é um problema, pois o acesso aos dados e a execução de consultas seguem o padrão SQL.
Neste exemplo, DATABASE_OPEN_READWRITE permite operações de leitura e gravação, enquanto DATABASE_OPEN_CREATE garante que o arquivo seja criado caso ainda não exista. Ao concluir as operações, basta fechar a conexão com DatabaseClose para liberar os recursos.
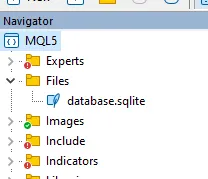
Ao executar esse código, o banco de dados é criado automaticamente na pasta <MQL5/Files>, que pode ser acessada pelo MetaEditor:
2. Criação de tabelas
Após estabelecer a conexão com o banco de dados, o primeiro passo é definir a estrutura que armazenará as informações. Em SQL, isso é feito com o comando CREATE TABLE, no qual especificamos o nome da tabela e as colunas que ela deverá conter.
No MQL5, utilizamos duas funções principais para criar tabelas:
- DatabaseTableExists(handler, table_name): verifica se a tabela já existe no banco de dados e retorna true ou false.
- DatabaseExecute(handler, sql): executa diretamente uma instrução SQL.
O procedimento mais comum é simples: verificar se a tabela existe → caso não exista, criá-la. Veja um exemplo prático:
//--- Create table
if(!DatabaseTableExists(handler,"trades"))
  {
   logs.Info("Creating user table...","TickORM");
   if(DatabaseExecute(handler,"CREATE TABLE trades (id INTEGER PRIMARY KEY AUTOINCREMENT,symbol TEXT, price FLOAT, takeprofit FLOAT, stoploss FLOAT, volume FLOAT);"))
     {
      logs.Info("'Trades' table created","TickORM");
     }
   else
     {
      logs.Error("Failed to create table",GetLastError(),"TickORM");
     }
  }
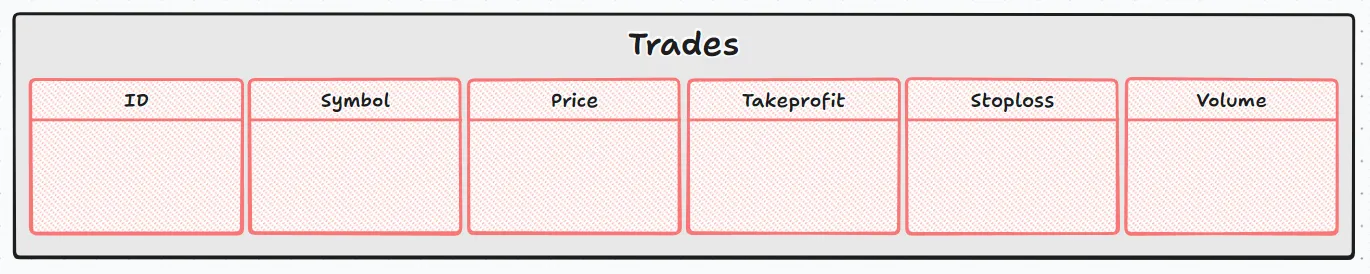
Nesse trecho de código, utilizamos o comando CREATE TABLE trades (...) para criar uma tabela chamada trades, que armazenará as principais informações de um negócio executado: id (identificador único gerado automaticamente), instrumento, preço, take-profit, stop-loss e volume.
Se a tabela já existir, a verificação com DatabaseTableExists evita que o comando de criação seja executado novamente. Procure sempre adotar esse padrão: verificar a existência da tabela e criá-la somente quando necessário.
Neste ponto, a estrutura do banco de dados será a seguinte:
O MetaEditor permite visualizar esse banco de dados. Basta dar um clique duplo no arquivo para abrir a visualização das tabelas. O MetaEditor alternará automaticamente para a aba de visualização do banco de dados no painel Navegador:
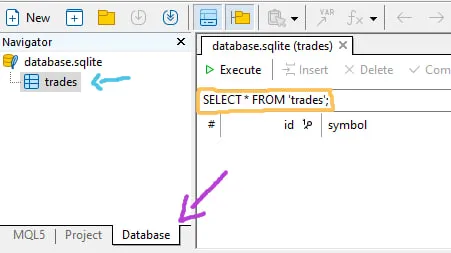
- A seta azul indica as tabelas do banco de dados.
- A área destacada em amarelo mostra onde você pode inserir comandos SQL, seja manualmente ou por meio do código, como veremos nos próximos exemplos.
- A seta roxa indica a aba "Database" do painel Navegador. Para voltar à visualização dos arquivos, como os arquivos .mqh e outros arquivos de código-fonte MQL5, basta selecionar novamente a aba "MQL5".
3. Inserção de dados em uma tabela
Seguindo a sequência, vamos inserir dados na tabela que acabamos de criar. Em SQL, utilizamos o comando INSERT INTO para adicionar registros. Sua estrutura é a seguinte:
INSERT INTO table_name
(column1,column2,...)
VALUES
(value1,value2,...)
Na cláusula VALUES, inserimos os valores diretamente na instrução SQL. Se o valor for uma string, basta colocá-lo entre aspas simples ('example'). Utilizamos a mesma função DatabaseExecute e verificamos se a execução foi bem-sucedida:
//--- Insert data
ResetLastError();
if(DatabaseExecute(handler,"INSERT INTO trades (symbol,price,takeprofit,stoploss,volume) VALUES ('EURUSD',1.16110,1.15490,1.16570,0.01);"))
  {
   logs.Info("Data saved to the trades table","TickORM");
  }
else
  {
   logs.Error("Failed to save data to the trade table",GetLastError(),"TickORM");
  }
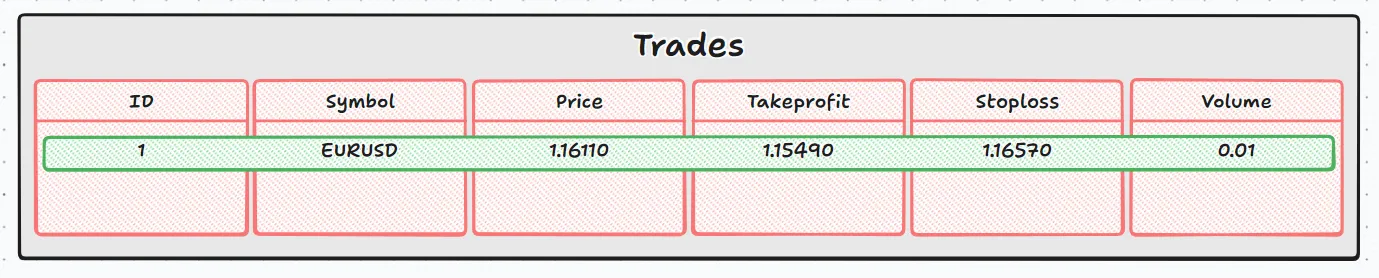
Aqui, inserimos um registro na tabela de negócios, atribuindo um valor a cada coluna:
- id: Gerado automaticamente pelo banco de dados
- instrumento: 'EURUSD'
- preço: 1.16110
- take-profit: 1.15490
- stop-loss: 1.16570
- volume: 0.01
Neste ponto, a estrutura terá a seguinte aparência:
4. Leitura de dados de uma tabela
Armazenar dados em um banco de dados é apenas metade do trabalho. O verdadeiro potencial aparece quando conseguimos consultar e recuperar essas informações de maneira estruturada. No MQL5, essa operação segue uma sequência bem definida:
- Preparar a consulta com DatabasePrepare, passando a instrução SQL.
- Ler os dados linha por linha com DatabaseRead, percorrendo os resultados.
- Finalizar a consulta com DatabaseFinalize, liberando os recursos de memória.
Veja um exemplo simples:
//--- Data reading
int request = DatabasePrepare(handler,"SELECT * FROM trades;");

//--- Number of table columns that were read
int size_cols = DatabaseColumnsCount(request);

//--- While data is available for reading (reading each line)
while(DatabaseRead(request))
  {
   //--- Scan across all columns of the current line of reading
   for(int j=0;j<size_cols;j++)
     {
      string name = "";
      DatabaseColumnName(request,j,name);
      logs.Info(name,"TickORM");
     }
  }

//--- Reset query
DatabaseFinalize(request);
Após a execução, o log exibirá o seguinte:
2025.08.21 10:14:51 [INFO]: Open database
2025.08.21 10:14:51 [INFO]: id
2025.08.21 10:14:51 [INFO]: symbol
2025.08.21 10:14:51 [INFO]: price
2025.08.21 10:14:51 [INFO]: takeprofit
2025.08.21 10:14:51 [INFO]: stoploss
2025.08.21 10:14:51 [INFO]: volume
2025.08.21 10:14:51 [INFO]: Closed database
Nesse exemplo, a consulta SELECT * FROM trades; recupera todos os registros da tabela trades. Cada chamada a DatabaseRead(request) avança o cursor para a próxima linha, enquanto o laço interno percorre todas as colunas, exibindo apenas seus nomes.
Comparando com a ilustração, teremos aproximadamente o seguinte:
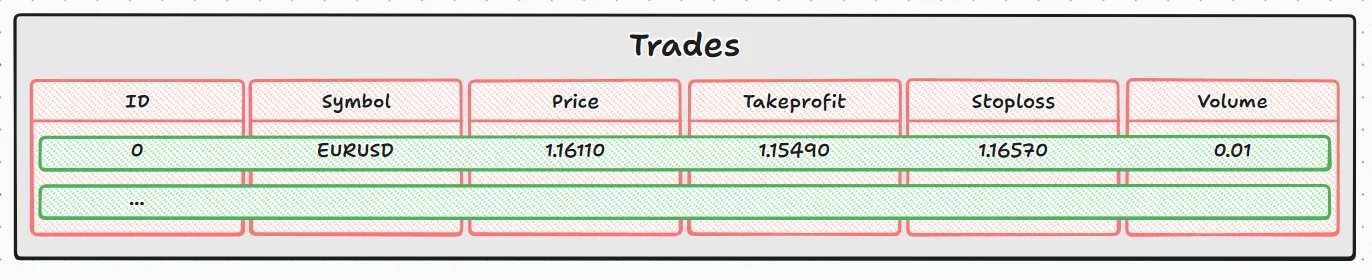
- O laço externo (while(DatabaseRead(request)) percorre os resultados linha por linha (retângulos verdes).
- O laço interno (for(int j=0;j<size_cols;j++)) percorre as colunas da linha atual (retângulos vermelhos).
Juntos, eles permitem percorrer o banco de dados de célula em célula, como em uma planilha eletrônica.
Ao passar à leitura dos valores das colunas, observe que o exemplo anterior listou apenas seus nomes. Precisamos dos valores armazenados, por isso utilizamos funções específicas de acordo com o tipo da coluna:
- DatabaseColumnType → permite determinar dinamicamente o tipo da coluna.
- DatabaseColumnText → textos (por exemplo, símbolos ou nomes).
- DatabaseColumnDouble → números de ponto flutuante (por exemplo, preços).
- DatabaseColumnLong ou DatabaseColumnInteger → valores inteiros (por exemplo, identificadores).
Exemplo completo:
//--- Data reading
int request = DatabasePrepare(handler,"SELECT * FROM trades;");

//--- Number of table columns that were read
int size_cols = DatabaseColumnsCount(request);

//--- While data is available for reading (reading each line)
while(DatabaseRead(request))
  {
   //--- Scan across all columns of the current line of reading
   for(int j=0;j<size_cols;j++)
     {
      string name = "";
      DatabaseColumnName(request,j,name);

      ENUM_DATABASE_FIELD_TYPE type = DatabaseColumnType(request,j);
      if(type == DATABASE_FIELD_TYPE_TEXT)
        {
         string data = "";
         DatabaseColumnText(request,j,data);
         logs.Info(name + " | "+data,"TickORM");
        }
      else if(type == DATABASE_FIELD_TYPE_FLOAT)
        {
         double data = 0;
         DatabaseColumnDouble(request,j,data);
         logs.Info(name + " | "+DoubleToString(data,5),"TickORM");
        }
      else if(type == DATABASE_FIELD_TYPE_INTEGER)
        {
         long id = 0;
         DatabaseColumnLong(request,j,id);
         logs.Info(name + " | "+IntegerToString(id),"TickORM");
        }
     }
  }

//--- Reset query
DatabaseFinalize(request);
Após a execução, o log exibirá o seguinte:
2025.08.21 10:18:04 [INFO]: Open database
2025.08.21 10:18:04 [INFO]: id | 1
2025.08.21 10:18:04 [INFO]: symbol | EURUSD
2025.08.21 10:18:04 [INFO]: price | 1.16110
2025.08.21 10:18:04 [INFO]: takeprofit | 1.15490
2025.08.21 10:18:04 [INFO]: stoploss | 1.16570
2025.08.21 10:18:04 [INFO]: volume | 0.01000
2025.08.21 10:18:04 [INFO]: Closed database
Nesse caso, além de percorrer linhas e colunas, também acessamos o conteúdo de cada célula. Retomando a analogia da ilustração:
- O retângulo cinza representa a tabela completa (trades).
- Cada retângulo verde representa uma linha retornada por DatabaseRead.
- Cada retângulo vermelho representa uma coluna, cujo valor na linha atual pode ser um texto (string), um número de ponto flutuante (double) ou um número inteiro (int).
- Ao utilizar DatabaseColumnType, é como se perguntássemos: "Que tipo de dado está dentro deste retângulo vermelho?"
- Em seguida, a função correspondente (DatabaseColumnText, DatabaseColumnDouble, DatabaseColumnLong) obtém o valor.
5. Atualização de dados de uma tabela
Na prática, muitas vezes precisamos ajustar informações existentes. Para isso, utilizamos o comando UPDATE, que permite modificar os valores de uma ou mais colunas em determinadas linhas da tabela.
Em SQL, a estrutura básica do comando é a seguinte:
UPDATE table_name
SET column1=value1, column2=value2, ...
WHERE condition;
No MQL5, a atualização de registros é feita com a função DatabaseExecute, que executa a instrução SQL diretamente no banco de dados. Veja um exemplo:
//--- Update data
ResetLastError();
if(DatabaseExecute(handler,"UPDATE trades SET volume=0.1 WHERE id=1"))
  {
   logs.Info("Trades table data updated","TickORM");
  }
else
  {
   logs.Error("Failed to update trades table data",GetLastError(),"TickORM");
  }
Aqui temos um caso clássico: solicitamos ao banco de dados que localize, na tabela de negócios, o registro cujo identificador seja igual a 1 e altere o valor da coluna volume para 0,1.
Esse padrão é extremamente útil no trading. Imagine que você tenha armazenado um negócio com volume inicial de 0,01 lote, mas, após ajustar a estratégia, precise alterar esse valor para 0,1 lote. Com um simples comando UPDATE, o registro é atualizado de forma confiável no banco de dados, sem a necessidade de excluir e recriar registros.
6. Exclusão de dados de uma tabela
Para excluir registros, utilizamos o comando SQL DELETE, responsável por remover linhas de uma tabela. A sintaxe geral é a seguinte:
DELETE FROM table_name
WHERE condition;
Seguimos o mesmo procedimento, utilizando DatabaseExecute para executar a instrução SQL:
//--- Delete data
ResetLastError();
if(DatabaseExecute(handler,"DELETE FROM trades WHERE id=1"))
  {
   logs.Info("Deleted trades table data","TickORM");
  }
else
  {
   logs.Error("Failed to delete data to the trade table",GetLastError(),"TickORM");
  }
Neste exemplo, solicitamos ao banco de dados que exclua da tabela de negócios o registro cujo identificador seja igual a 1. A exclusão é pontual, controlada e segura.
Um detalhe importante: assim como no UPDATE, a cláusula WHERE é essencial para evitar a exclusão acidental de todos os registros da tabela.Com esse comando, concluímos o ciclo básico de manipulação de dados: criação, inserção, atualização e exclusão. Agora temos os fundamentos necessários para avançar à próxima etapa.
7. Exclusão de uma tabela
Se uma tabela não for mais necessária, podemos excluí-la.
//--- Delete table
ResetLastError();
if(DatabaseExecute(handler,"DROP TABLE trades"))
  {
   logs.Info("Trades table deleted","TickORM");
  }
else
  {
   logs.Error("Failed to delete trades table",GetLastError(),"TickORM");
  }
Vale destacar que a exclusão de uma tabela com DROP TABLE é irreversível. Diferentemente de DELETE FROM trades, que remove apenas os registros e preserva a estrutura, DROP TABLE exclui tanto a tabela quanto os dados armazenados nela. Após executar essa instrução, será necessário recriar a tabela antes de inserir novos registros.
8. Transações e integridade dos dados
Agora vamos abordar um aspecto fundamental: a integridade do banco de dados. Em qualquer aplicação que manipule informações, preservar a integridade dos dados é essencial. Imagine uma situação em que precisamos inserir vários registros. Se uma dessas inserções falhar depois que as outras já tiverem sido executadas, o banco de dados poderá ficar em um estado inconsistente. É justamente para evitar esse problema que utilizamos transações.
Uma transação é um conjunto de operações SQL tratado como uma unidade atômica:
- Ou todas as operações são confirmadas e suas alterações são aplicadas (commit),
- Ou nenhuma das alterações é mantida (rollback).
No MQL5, contamos com funções nativas para gerenciar transações:
- DatabaseTransactionBegin(handler) → Inicia uma transação.
- DatabaseTransactionCommit(handler) → Confirma a transação e aplica as alterações.
- DatabaseTransactionRollback(handler) → Desfaz todas as alterações realizadas desde o início da transação.
O exemplo a seguir mostra como utilizar essas funções:
//--- Insert with transaction
string sql="INSERT INTO trades (symbol,price,takeprofit,stoploss,volume) VALUES ('EURUSD',1.16110,1.15490,1.16570,0.01);";
DatabaseTransactionBegin(handler);
logs.Info("Inserting data, preparing transaction","TickORM");
if(!DatabaseExecute(handler,sql))
  {
   logs.Error("Transaction failed, reverting to previous state",GetLastError(),"TickORM");
   DatabaseTransactionRollback(handler);
  }
else
  {
   logs.Info("Transaction complete, changes saved","TickORM");
   DatabaseTransactionCommit(handler);
  }
Neste trecho de código:
- Iniciamos a transação com DatabaseTransactionBegin.
- Tentamos executar a inserção com DatabaseExecute.
- Se ocorrer algum problema, utilizamos DatabaseTransactionRollback para desfazer todas as alterações.
- Caso contrário, confirmamos as alterações com DatabaseTransactionCommit.
Esse mecanismo é útil porque garante que nenhuma operação fique parcialmente concluída. Ele também oferece maior controle, pois permite agrupar várias operações e confirmar suas alterações somente depois de verificar que todas foram executadas com sucesso. Isso aumenta a segurança: em caso de falhas inesperadas, como problemas de rede, queda de energia ou erros de execução, o banco de dados retorna ao estado anterior sem comprometer a integridade dos dados.
Imagine que você precise registrar dez operações diferentes em várias tabelas. Se a oitava falhar, sem uma transação você terá sete operações registradas e três não registradas, deixando o banco de dados em um estado inconsistente. Com uma transação, basta executar um rollback para que o banco de dados retorne ao estado anterior.
9. Importação e exportação de dados
Além das transações, outro recurso que oferece mais segurança e praticidade é a possibilidade de importar e exportar dados. Isso permite criar cópias de segurança periódicas dos dados do banco, ajudando a evitar perdas e facilitando sua transferência e recuperação. Para isso, contamos com as funções DatabaseExport e DatabaseImport, que permitem exportar dados para arquivos CSV e, quando necessário, importá-los novamente para o banco de dados.
O exemplo a seguir mostra como exportar a tabela de negócios para um arquivo chamado backup_trades.csv:
//--- Export table
ResetLastError();
long data = DatabaseExport(handler,"trades","backup_trades.csv",DATABASE_EXPORT_HEADER,";");
if(data > 0)
  {
   logs.Info("Backup of the 'trades' table created successfully","TickORM");
  }
else
  {
   logs.Error("Failed to create backup of table 'trades'",GetLastError(),"TickORM");
  }
Alguns pontos importantes:
-
Nome do arquivo: o caminho é relativo à pasta MQL5\Files. Isso significa que você também pode armazenar as cópias de segurança em subpastas, se desejar.
-
Formato CSV: é amplamente utilizado e pode ser aberto no Excel, Google Sheets, Python, R etc.
-
Flags: neste exemplo, utilizamos DATABASE_EXPORT_HEADER, que inclui os nomes das colunas na primeira linha do arquivo. Isso facilita a interpretação dos dados posteriormente.
Valor Descrição DATABASE_EXPORT_HEADER Inclui os nomes das colunas na primeira linha. DATABASE_EXPORT_INDEX Inclui os números das linhas. DATABASE_EXPORT_NO_BOM Não insere o marcador BOM no início do arquivo (por padrão, o BOM é incluído). DATABASE_EXPORT_CRLF Utiliza CRLF como terminador de linha (o padrão é LF). DATABASE_EXPORT_APPEND Acrescenta os dados ao final de um arquivo existente (por padrão, o arquivo é sobrescrito). Se o arquivo não existir, será criado. DATABASE_EXPORT_QUOTED_STRINGS Coloca os valores de texto entre aspas duplas. DATABASE_EXPORT_COMMON_FOLDER O arquivo CSV será criado na pasta compartilhada entre todos os terminais: \Terminal\Common\File. -
Separador: utilizamos ";", mas também podemos usar "," ou "\t", entre outros, conforme a preferência ou os requisitos do sistema que processará o arquivo.
A função retorna a quantidade de registros exportados. Se o valor retornado for negativo, ocorreu um erro, que pode ser identificado por meio de GetLastError().
Agora imagine a situação inversa: precisamos restaurar ou importar dados para a tabela de negócios:
//--- Import table
ResetLastError();
long data = DatabaseImport(handler,"trades","backup_trades.csv",DATABASE_IMPORT_HEADER|DATABASE_IMPORT_APPEND,";",0,NULL);
if(data > 0)
  {
   logs.Info("'trades' table imported successfully","TickORM");
  }
else
  {
   logs.Error("Failed to import 'trades' table",GetLastError(),"TickORM");
  }
Veja alguns detalhes importantes:
-
Combinação de flags: utilizamos DATABASE_IMPORT_HEADER (o sistema interpreta a primeira linha como cabeçalho) e DATABASE_IMPORT_APPEND (os dados importados são adicionados à tabela existente, sem excluir os registros já armazenados).
Valor Descrição DATABASE_IMPORT_HEADER Indica que a primeira linha contém os nomes das colunas da tabela. DATABASE_IMPORT_CRLF Utiliza CRLF como terminador de linha (o padrão é LF). DATABASE_IMPORT_APPEND Acrescenta os dados à tabela existente. DATABASE_IMPORT_QUOTED_STRINGS Indica que os valores de texto estão entre aspas duplas. DATABASE_IMPORT_COMMON_FOLDER O arquivo está localizado na pasta compartilhada entre todos os terminais: \Terminal\Common\File. -
Separador: deve ser o mesmo utilizado na exportação.
-
skip_rows: permite ignorar as linhas iniciais (por exemplo, quando queremos desconsiderar comentários ou dados antigos).
-
skip_comments: define os caracteres que identificam as linhas a serem ignoradas. É especialmente útil ao trabalhar com arquivos CSV que contêm anotações inseridas manualmente.
A função retorna a quantidade de registros importados.
Com as funções DatabaseExport e DatabaseImport, concluímos as operações básicas de importação e exportação de dados. Agora sabemos como criar tabelas, inserir registros, executar consultas, atualizar e excluir informações, além de exportar cópias dos dados ou restaurá-los quando necessário.
No entanto, observe um detalhe: cada operação exige escrever instruções SQL diretamente e utilizar chamadas específicas das funções nativas. Essa abordagem funciona bem em exemplos pequenos, mas, à medida que o sistema cresce, a complexidade aumenta, assim como o risco de erros. É nesse momento que surge uma pergunta inevitável: será que precisamos mesmo escrever tudo isso manualmente?
É aqui que entra a ideia de ORM. Na próxima seção, veremos o que é um ORM, por que ele pode transformar radicalmente a maneira como interagimos com bancos de dados em MQL5 e como se encaixa na solução que estamos desenvolvendo.
O que é ORM e por que precisamos dele?
Até aqui, aprendemos a utilizar SQL diretamente em MQL5 para manipular tabelas e registros. Essa abordagem funciona, mas, conforme o sistema cresce, as instruções SQL acabam espalhadas por diferentes partes do código, dificultando a manutenção, aumentando a duplicação de lógica e elevando o risco de erros. É justamente para resolver esses problemas que entra em cena o ORM (mapeamento objeto-relacional).
O ORM é uma camada de abstração que faz a ponte entre a programação orientada a objetos e os bancos de dados relacionais. Em vez de escrever instruções SQL manualmente, definimos nossas entidades como classes e deixamos que o ORM as converta em comandos SQL. Em outras palavras, em vez de lidar diretamente com INSERT INTO trades (...) VALUES (...), basta criar um objeto Trade e chamar um método como repository.save(trade).
Entre as principais características de um ORM, destacam-se:
- Mapeamento automático: mapeia classes e atributos para tabelas e colunas.
- Abstração de SQL: permite trabalhar com objetos e métodos em vez de escrever instruções SQL como strings.
- Consistência: reduz a duplicação de lógica ao centralizar operações comuns, como salvar, consultar e excluir registros.
- Portabilidade: em alguns ORMs, a mesma lógica pode funcionar com diferentes bancos de dados sem a necessidade de modificar o código-fonte.
Em MQL5, essa abordagem faz ainda mais sentido, pois espalhar consultas SQL diretamente pelo código pode se tornar um verdadeiro pesadelo. Imagine um EA com dezenas de entidades (negócios, ordens, logs, métricas de desempenho). Cada operação INSERT, SELECT ou UPDATE distribuída por diferentes partes do código representa mais pontos de falha, maior dificuldade para evoluir a lógica e mais possibilidades de inconsistência.
O "problema" que o ORM resolve é justamente esse:
- Evita a duplicação de instruções SQL em diferentes partes do EA.
- Facilita a manutenção, pois as alterações na estrutura de uma tabela se refletem em um único lugar do código (a classe da entidade).
- Permite escrever um código mais legível e natural, trabalhando com objetos do domínio da aplicação (como Negociação, Usuário ou Ordem), em vez de lidar diretamente com tabelas e colunas.
- Abre caminho para funcionalidades avançadas, como criação automática de tabelas, versionamento do esquema do banco de dados e integração mais simples com bibliotecas de logging e auditoria.
Em resumo, sem ORM, cada operação exige um trecho de SQL no código. Com ORM, o SQL passa a ser um detalhe de implementação, permitindo que você se concentre no que realmente importa: a lógica de trading.
Nosso projeto de ORM em MQL5
Agora que entendemos a utilidade de um ORM, precisamos visualizar como essa abordagem pode ser aplicada ao ecossistema MQL5. Diferentemente de linguagens mais tradicionais no universo dos ORMs, como Java, C# e Python, não contamos com frameworks consolidados e prontos para uso. Isso significa que precisaremos desenvolver nossa própria solução, adaptada às limitações e particularidades da linguagem.
O objetivo do projeto é claro: criar uma camada que permita ao desenvolvedor trabalhar com objetos em vez de escrever SQL diretamente, sem abrir mão da simplicidade e do desempenho necessários em um ambiente de trading.
As funcionalidades previstas incluem:
- Entidades: cada tabela do banco de dados será representada por uma classe MQL5, contendo metadados que descrevem suas colunas (tipo de dado, chave primária, se é autoincremental, se aceita NULL etc.). Assim, a classe Trade corresponderá diretamente à tabela de negócios, mas poderá ser manipulada como um objeto nativo.
- Repositórios: em vez de escrever manualmente instruções INSERT, UPDATE ou SELECT, teremos um repositório para cada entidade, responsável pelas operações de persistência e recuperação de dados. Por exemplo, TradeRepository centralizará métodos como Save(trade), FindById(id) e Delete(trade). Dessa forma, o código do EA ficará mais limpo, sem consultas SQL espalhadas por diferentes partes da implementação.
- Construtor de consultas: para situações que exigirem consultas mais complexas, como filtros, ordenações e junções entre tabelas, teremos um construtor de consultas. Esse componente permitirá montar instruções SQL de forma programática e segura, evitando erros na concatenação de strings e reduzindo a necessidade de escrever SQL diretamente.
- Criação automática de tabelas: com base nos metadados das entidades, o ORM poderá gerar automaticamente as tabelas correspondentes. Antes de criar uma tabela, verificará se ela já existe no banco de dados. Essa funcionalidade elimina a necessidade de escrever scripts SQL manualmente no início do projeto e garante que a estrutura do banco de dados acompanhe a evolução das entidades.
- Integração com logs e auditoria: cada operação executada pelo ORM (inserção, atualização ou exclusão) poderá ser registrada em logs utilizando bibliotecas já desenvolvidas em MQL5. Isso facilita a auditoria das operações realizadas no banco de dados e ajuda a identificar possíveis problemas.
- Extensibilidade: a arquitetura será projetada para permitir futuras ampliações. Inicialmente, trabalharemos com as operações básicas de CRUD, mas poderemos acrescentar suporte a migrações de esquema, relacionamentos entre entidades (um para muitos e muitos para muitos) e até mecanismos de cache em memória para otimizar as consultas.
O objetivo não é recriar o framework Hibernate em MQL5, mas oferecer uma camada de abstração minimalista e eficiente, que atenda às necessidades reais de quem trabalha com trading algorítmico e precisa armazenar dados de forma estruturada.
Conclusão e próximos passos
Chegamos ao final da primeira parte desta série, e o cenário começa a ficar mais claro: os bancos de dados em MQL5 não são apenas arquivos para armazenar informações, mas estruturas poderosas que, quando utilizadas corretamente, permitem registrar, consultar e manipular dados de forma estruturada e confiável. Vimos como utilizar SQL na prática, desde a criação de tabelas, inserção e leitura de registros até a manipulação de colunas e o tratamento dos respectivos tipos de dados, utilizando funções nativas do MQL5, como DatabaseOpen, DatabaseExecute, DatabasePrepare e DatabaseRead.
Mais importante ainda, entendemos que escrever SQL manualmente em cada projeto logo gera repetição de código, aumenta o risco de erros e dificulta a manutenção. É aí que entra o conceito de ORM: uma camada de abstração que representa tabelas como objetos e transforma consultas SQL em chamadas de métodos simples. Isso permite trabalhar com entidades de maneira natural, mantendo o código limpo e a lógica de acesso aos dados centralizada.
Nas próximas partes desta série, começaremos a implementar essa camada de abstração. Nosso objetivo será desenvolver um ORM minimalista e eficiente, com classes de entidades, repositórios, um construtor de consultas e um mecanismo de criação automática de tabelas. Assim, operações como salvar, recuperar ou excluir dados deixarão de depender de instruções SQL espalhadas pelo código e passarão a ser realizadas por métodos intuitivos, que refletem diretamente o domínio de trading que estamos modelando.
Ao dominar essas ferramentas, você não apenas aumenta a eficiência e a segurança no tratamento dos dados, mas também estabelece uma base sólida para desenvolver sistemas de trading mais complexos, capazes de realizar análises aprofundadas, backtests confiáveis e manter históricos detalhados de ordens e estratégias.
Com isso, concluímos a primeira etapa. A próxima parte da série será prática: começaremos definindo as classes iniciais do ORM e implementando a persistência de objetos, transformando toda a teoria apresentada até aqui em código funcional em MQL5.
Traduzido do Inglês pela MetaQuotes Ltd.
Artigo original: https://www.mql5.com/en/articles/19285
Aviso: Todos os direitos sobre esses materiais pertencem à MetaQuotes Ltd. É proibida a reimpressão total ou parcial.
Esse artigo foi escrito por um usuário do site e reflete seu ponto de vista pessoal. A MetaQuotes Ltd. não se responsabiliza pela precisão das informações apresentadas nem pelas possíveis consequências decorrentes do uso das soluções, estratégias ou recomendações descritas.


Neste primeiro artigo, mostrei apenas a ponta do iceberg. O TickORM vai muito além: a ideia é mudar completamente a maneira como você trabalha com bancos de dados no MQL5. O objetivo é alcançar algo direto, simples e poderoso, em que abrir um banco de dados, criar um repositório e manipular entidades seja tão natural quanto trabalhar com matrizes. Ao final da série, o uso se assemelhará ao exemplo abaixo, no qual você salva, pesquisa, atualiza e exclui registros sem escrever uma única consulta manualmente. Esse é o caminho que estou abrindo com o TickORM.
Para sua informação: uma implementação de ORM para MQL5 foi apresentada no livro.