
Simplificación de bases de datos en MQL5 (Parte 1): Introducción a las bases de datos y SQL
 22
 4

Introducción
Cuando hablamos de MQL5, la mayoría de las conversaciones giran en torno a los indicadores, los Expert Advisors, las estrategias de trading y los backtests. Pero llega un momento en el que cualquier operador o desarrollador que se dedique en serio a la automatización se da cuenta de que la persistencia de los datos es fundamental. Y aquí es donde entran en juego las bases de datos. Quizá incluso pienses: «Pero si ya guardo mis resultados en archivos CSV o TXT, ¿por qué complicar las cosas con una base de datos?». La respuesta radica en la organización, el rendimiento y la fiabilidad que ofrece una base de datos, sobre todo cuando se trata de grandes volúmenes de información u operaciones complejas.
En el contexto de MQL5, hablar de bases de datos puede parecer una exageración a primera vista. Al fin y al cabo, este lenguaje está muy orientado al trading, a los indicadores y a los robots de ejecución automática. Sin embargo, cuando empezamos a trabajar con estrategias que implican grandes volúmenes de datos, pruebas retrospectivas complejas o registros detallados de órdenes, la simplicidad de los archivos estándar pronto resulta insuficiente. Es aquí donde saber cómo crear, acceder y manipular una base de datos se convierte en una herramienta capaz de transformar tu flujo de trabajo en el trading.
Un operador que empiece a explorar las bases de datos en MQL5 encontrará docenas de funciones nativas y ejemplos independientes. Basta con guardar y consultar registros, pero pronto surge la pregunta: ¿cómo organizar todo esto de forma clara y reutilizable en proyectos reales? En esta serie de artículos, vamos más allá de la documentación. Empezamos con las funciones básicas de SQLite y avanzamos paso a paso para crear un "mini-ORM en MQL5 (TickORM)". La idea es transformar las llamadas directas en capas bien diseñadas, inspiradas en JDBC y JPA de Java, pero adaptadas al ecosistema de MetaTrader.
En este artículo, explico los conceptos básicos de las bases de datos en MQL5 y SQL. Esto allana el camino para que los artículos siguientes encapsulen estas funciones en clases, interfaces y, finalmente, en el ORM.
¿Qué es una base de datos y para qué sirve?
Técnicamente, una base de datos es una forma organizada de estructurar la información que permite almacenar, consultar y manipular los datos guardados. Garantiza la integridad, establece relaciones entre distintos conjuntos de información y agiliza las operaciones.
La diferencia práctica entre guardar datos en archivos y utilizar una base de datos radica en su organización y facilidad de acceso. En archivos sencillos, como los CSV o los TXT, cada lectura o modificación requiere revisar todo el contenido, manipular cadenas de caracteres, solucionar errores de formato y esperar que el archivo no se dañe. En una base de datos, estas operaciones se abstraen: es posible buscar registros concretos, actualizar varios valores a la vez y garantizar que las transacciones se realicen íntegramente sin pérdida de datos.
Pero, ¿cómo se lleva a cabo esta organización a nivel interno? Piensa en la estructura básica de una base de datos como una hoja de cálculo. Aquí tienes un ejemplo:
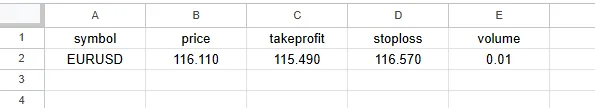
- Cada tabla de la base de datos equivale a una pestaña de la hoja de cálculo, dedicada a un conjunto específico de información (por ejemplo, Trades).
- Dentro de cada tabla hay columnas, igual que en una hoja de cálculo, que representan los atributos de cada elemento (por ejemplo, id, símbolo, precio, etc.).
- Y cada fila de la tabla corresponde a un único registro, es decir, a una operación concreta o a una orden ejecutada.
Esta sencilla arquitectura, compuesta por tablas, columnas y filas, constituye la base para realizar consultas rápidas y bien estructuradas. Es como si tuvieras un sinfín de hojas de cálculo organizadas e interconectadas, pero con la ventaja de poder cruzar datos, aplicar filtros avanzados y manipular grandes volúmenes de información sin que te dé dolor de cabeza.
De ahí surge precisamente la motivación para crear nuestro propio ORM en MQL5. La idea es sencilla: en lugar de escribir código SQL manualmente cada vez que queramos manipular una tabla (crear registros, recuperar resultados, actualizar valores), vamos a crear una capa que trate las tablas como entidades y las columnas como atributos de clase. Este será el núcleo del proyecto que desarrollaremos a lo largo de la serie y servirá de base para crear sistemas de negociación más sólidos y escalables. El nombre del ORM será TickORM.
En resumen, las bases de datos son la base para crear soluciones fiables y flexibles, y nuestro ORM será el nexo entre esta base y el código en MQL5.
Para facilitarte las pruebas, al final se adjunta todo el código de ejemplo. De esta forma, podrás consultarlo, copiarlo y adaptarlo según sea necesario, sin tener que volver a montar manualmente los fragmentos de código.
Nota: A partir de aquí, algunos ejemplos de código mostrarán registros de log en la consola. Para ello, utilizo mi biblioteca Logify, desarrollada precisamente para facilitar el seguimiento y la depuración en MQL5. Si quieres saber más sobre cómo funciona o seguir su implementación paso a paso, he escrito toda una serie de artículos en los que explico su desarrollo.SQL y funciones nativas de MQL5
Para trabajar con bases de datos no hace falta mucho. Afortunadamente, el lenguaje ofrece un conjunto de funciones nativas que permiten crear, acceder y manipular datos directamente desde el propio lenguaje. Estas funciones sirven de puente entre tu código y la base de datos.
La relación con SQL es directa: estas funciones actúan como una capa de ejecución de consultas. En otras palabras, se escriben comandos SQL dentro de MQL5, y las funciones nativas se encargan de la preparación, la ejecución y la lectura de los resultados. Esto significa que, incluso sin recurrir a bibliotecas externas, puedes realizar operaciones complejas como SELECT, INSERT, UPDATE, DELETE e incluso crear tablas.
Este es el punto de partida para comprender cada función y sus posibilidades antes de pasar a la aplicación práctica. Para ofrecer una descripción detallada de todas las funciones disponibles, voy a enumerar todas las funciones nativas de la base de datos, ya que veremos cómo se utiliza cada una de ellas:
- DatabaseOpen(string filename, uint flags): Abre o crea una base de datos en el archivo especificado.
- DatabaseClose(int database): Cierra una base de datos.
- DatabaseImport(int database,const string table,const string filename,uint flags,const string separator,ulong skip_rows,const string skip_comments): Importa datos de un archivo a una tabla.
- DatabaseExport(int database,const string table_or_sql,const string filename,uint flags,const string separator): Exporta una tabla o el resultado de la ejecución de una consulta SQL a un archivo CSV.
- DatabasePrint(int database,const string table_or_sql,uint flags): Muestra una tabla o el resultado de la ejecución de una consulta SQL en el diario de Expert.
- DatabaseTableExists(int database,string table): Comprueba si la tabla existe en una base de datos.
- DatabaseExecute(int database, string sql): Ejecuta una consulta en una base de datos especificada.
- DatabasePrepare(int database, string sql): Crea un identificador para una consulta, que luego se puede ejecutar mediante DatabaseRead().
- DatabaseReset(int request): Restablece una solicitud, por ejemplo, tras llamar a DatabasePrepare().
- DatabaseBind(int request,int index,T value): Establece el valor de un parámetro en una solicitud.
- DatabaseRead(int request): Pasa a la siguiente entrada como consecuencia de una solicitud.
- DatabaseFinalize(int request): Elimina una solicitud creada en DatabasePrepare().
- DatabaseTransactionBegin(int database): Inicia la ejecución de la transacción.
- DatabaseTransactionCommit(int database): Finaliza la ejecución de la transacción.
- DatabaseTransactionRollback(int database): Revierte transacciones.
- DatabaseColumnsCount(int request): Obtiene el número de campos de una solicitud.
- DatabaseColumnName(int request,int column,string& name): Obtiene el nombre de un campo por índice.
- DatabaseColumnType(int request,int column): Obtiene el tipo de un campo por su índice.
- DatabaseColumnSize(int request,int column): Obtiene el tamaño del campo en bytes.
- DatabaseColumnText(int request,int column,string& value): Obtiene el valor de un campo como cadena de caracteres del registro actual.
- DatabaseColumnInteger(int request,int column,int& value): Obtiene el valor de tipo int del registro actual.
- DatabaseColumnLong(int request,int column,long& value): Obtiene el valor de tipo «long» del registro actual.
- DatabaseColumnDouble(int request,int column,double& value): Obtiene el valor de tipo «double» del registro actual.
Para obtener información detallada sobre todas las funciones, parámetros y ejemplos disponibles, MetaQuotes ofrece documentación oficial en: Manual de referencia de MQL5 > Trabajo con la base de datos.
1. Abrir y cerrar bases de datos
Empecemos por lo básico: abrir una conexión con la base de datos. Esto se hace mediante la función DatabaseOpen, que recibe el nombre del archivo de base de datos y unos parámetros opcionales que definen el modo de apertura, el cual puede adoptar los siguientes valores:
| Valor | Descripción |
|---|---|
| DATABASE_OPEN_READONLY | Solo lectura |
| DATABASE_OPEN_READWRITE | Abierto para lectura y escritura |
| DATABASE_OPEN_CREATE | Cree el archivo en un disco, si es necesario |
| DATABASE_OPEN_MEMORY | Crear una base de datos en la RAM |
| DATABASE_OPEN_COMMON | El archivo se encuentra en la carpeta común de todos los terminales |
int OnInit()
  {
   //--- Open connection
   int handler = DatabaseOpen("database.sqlite",DATABASE_OPEN_CREATE|DATABASE_OPEN_READWRITE);
   if(handler == INVALID_HANDLE)
     {
      logs.Error("Failed to open database","TickORM");
      return(INIT_FAILED);
     }
   logs.Info("Open database","TickORM");

   //--- Here you would perform queries, inserts or updates

   //--- Close connection
   logs.Info("Closed database","TickORM");
   DatabaseClose(handler);

   return(INIT_SUCCEEDED);
  }
En el primer parámetro definimos el nombre de la base de datos; en este caso, he utilizado «database». Y al final solo hay que añadir «.sqlite», que es la extensión del archivo, ya que se trata de una base de datos almacenada en un archivo, pero eso no supone ningún problema, pues la forma de obtener los datos y realizar consultas sigue el estándar SQL.
En este ejemplo, DATABASE_OPEN_READWRITE permite la lectura y la escritura, mientras que DATABASE_OPEN_CREATE garantiza que el archivo se creará si aún no existe. Una vez finalizadas las operaciones, basta con cerrar la conexión con DatabaseClose para liberar recursos.
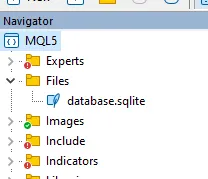
Al ejecutar este código, se crea automáticamente la base de datos en la carpeta <MQL5/Files>, que puedes ver en el MetaEditor:
2. Crear una tabla
El primer paso tras conectarse a la base de datos es definir la estructura en la que se almacenarán los datos. En SQL, esto se hace con el comando CREATE TABLE. En él se describe el nombre de la tabla y los campos que debe contener.
En MQL5, la creación de tablas implica el uso de dos funciones principales:
- DatabaseTableExists(handler, table_name): Comprueba si una tabla ya existe en la base de datos y devuelve «true» o «false».
- DatabaseExecute(handler, sql): Ejecuta directamente una instrucción SQL.
El proceso más habitual es el siguiente: Comprobar si la tabla existe → si no existe, crear la tabla. He aquí un ejemplo práctico:
//--- Create table
if(!DatabaseTableExists(handler,"trades"))
  {
   logs.Info("Creating user table...","TickORM");
   if(DatabaseExecute(handler,"CREATE TABLE trades (id INTEGER PRIMARY KEY AUTOINCREMENT,symbol TEXT, price FLOAT, takeprofit FLOAT, stoploss FLOAT, volume FLOAT);"))
     {
      logs.Info("'Trades' table created","TickORM");
     }
   else
     {
      logs.Error("Failed to create table",GetLastError(),"TickORM");
     }
  }
En este fragmento de código, utilizamos CREATE TABLE trades (...) para crear una tabla llamada trades, con información básica sobre una operación: id (identificador único generado automáticamente), símbolo, precio, takeprofit, stoploss y volumen.
Si la tabla ya existe, la función DatabaseTableExists impide que el comando se vuelva a ejecutar. Sigue siempre este procedimiento: comprueba si la tabla existe y, si no, créala.
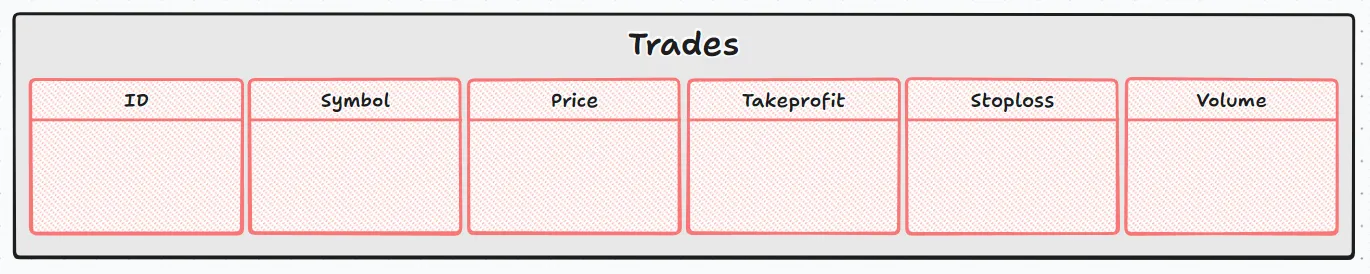
La representación de la etapa actual quedaría así, tal y como se muestra en esta imagen de la base de datos:
MetaEditor permite visualizar esta base de datos; basta con hacer doble clic en el archivo de visualización de tablas y la pestaña del navegador cambiará automáticamente:
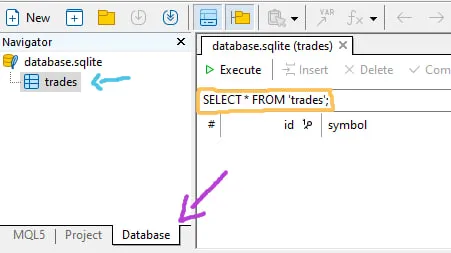
- La flecha azul señala las tablas de la base de datos
- El color amarillo indica dónde se escribe el comando SQL (esto se puede hacer manualmente o dentro del código; veremos ejemplos en el siguiente paso)
- El color morado indica la pestaña «Base de datos» del navegador; si quieres volver a ver los archivos (.mq5 o .mqh), solo tienes que volver a la pestaña «MQL5».
3. Introducir datos en la tabla
Siguiendo el proceso, vamos a introducir datos en la tabla que acabamos de crear. En SQL, utilizamos el comando INSERT INTO para añadir registros. Sigue esta estructura:
INSERT INTO table_name
(column1,column2,...)
VALUES
(value1,value2,...)
En los valores, pasamos los datos en formato sin procesar; si se trata de una cadena, basta con entrecomillarla entre comillas simples ('ejemplo'). Utilizamos la misma función DatabaseExecute y comprobamos que la ejecución se haya realizado correctamente:
//--- Insert data
ResetLastError();
if(DatabaseExecute(handler,"INSERT INTO trades (symbol,price,takeprofit,stoploss,volume) VALUES ('EURUSD',1.16110,1.15490,1.16570,0.01);"))
  {
   logs.Info("Data saved to the trades table","TickORM");
  }
else
  {
   logs.Error("Failed to save data to the trade table",GetLastError(),"TickORM");
  }
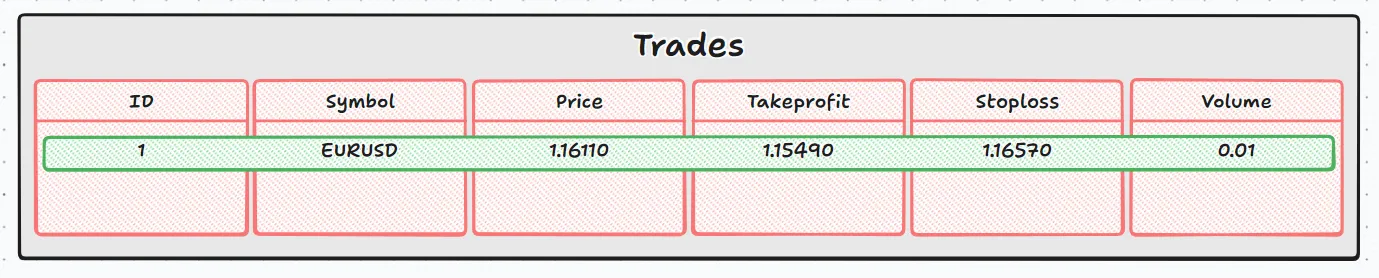
Aquí añadimos un registro a la tabla «trades» y asignamos un valor a cada columna:
- id: Generado automáticamente por la base de datos.
- symbol: 'EURUSD'
- price: 1.16110
- takeprofit: 1.15490
- stoploss: 1.16570
- volume: 0.01
Así es como se presenta la situación actual:
4. Lectura de datos de la tabla
Guardar los datos en la base de datos es solo la mitad del trabajo; el verdadero potencial surge cuando podemos consultar y extraer esos datos de forma estructurada. En MQL5, este proceso sigue un flujo bien definido:
- Prepara la consulta con DatabasePrepare, pasando el comando SQL.
- Leer línea por línea con DatabaseRead, desplazándose por los resultados.
- Finaliza la consulta con DatabaseFinalize, liberando recursos de memoria.
Un ejemplo sencillo:
//--- Data reading
int request = DatabasePrepare(handler,"SELECT * FROM trades;");

//--- Number of table columns that were read
int size_cols = DatabaseColumnsCount(request);

//--- While data is available for reading (reading each line)
while(DatabaseRead(request))
  {
   //--- Scan across all columns of the current line of reading
   for(int j=0;j<size_cols;j++)
     {
      string name = "";
      DatabaseColumnName(request,j,name);
      logs.Info(name,"TickORM");
     }
  }

//--- Reset query
DatabaseFinalize(request);
Al ejecutarlo, aparece lo siguiente en el registro:
2025.08.21 10:14:51 [INFO]: Open database
2025.08.21 10:14:51 [INFO]: id
2025.08.21 10:14:51 [INFO]: symbol
2025.08.21 10:14:51 [INFO]: price
2025.08.21 10:14:51 [INFO]: takeprofit
2025.08.21 10:14:51 [INFO]: stoploss
2025.08.21 10:14:51 [INFO]: volume
2025.08.21 10:14:51 [INFO]: Closed database
En este caso, la consulta SELECT * FROM trades; recupera todos los registros de la tabla «trades». Cada llamada a DatabaseRead(request) desplaza el cursor a la siguiente fila, y el bucle interno recorre todas las columnas, mostrando únicamente los nombres.
Si lo comparamos con una imagen, quedaría más o menos así:
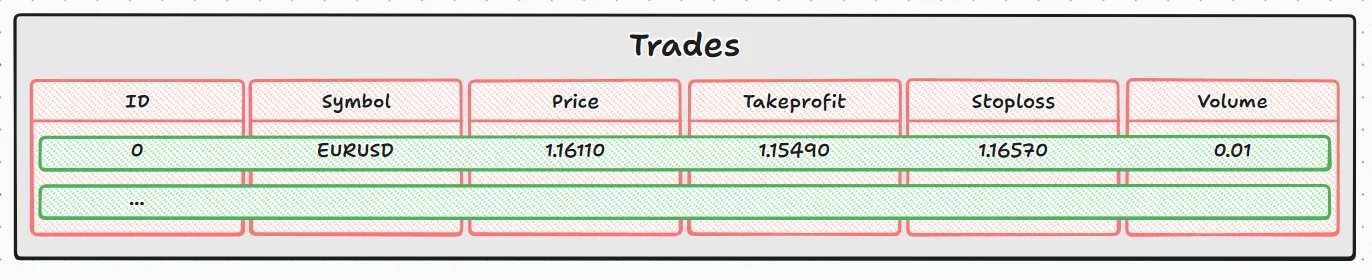
- El bucle exterior (while(DatabaseRead(request))) recorre fila por fila (los rectángulos verdes).
- El bucle interior (for(int j=0;j<size_cols;j++) ) recorre columna por columna dentro de la fila actual (los rectángulos rojos).
Juntos, te permiten desplazarte por la base de datos celda a celda, igual que si estuvieras desplazándote por una hoja de cálculo.
Continuando y analizando los valores de las columnas, el ejemplo anterior solo enumera los nombres de las columnas. Necesitamos los valores almacenados, por lo que utilizamos funciones específicas según el tipo de columna:
- DatabaseColumnType → nos permite determinar dinámicamente el tipo de columna.
- DatabaseColumnText → textos (como símbolos o nombres).
- DatabaseColumnDouble → números de coma flotante (como los precios).
- DatabaseColumnLong o DatabaseColumnInteger → valores enteros (como los ID).
Ejemplo completo:
//--- Data reading
int request = DatabasePrepare(handler,"SELECT * FROM trades;");

//--- Number of table columns that were read
int size_cols = DatabaseColumnsCount(request);

//--- While data is available for reading (reading each line)
while(DatabaseRead(request))
  {
   //--- Scan across all columns of the current line of reading
   for(int j=0;j<size_cols;j++)
     {
      string name = "";
      DatabaseColumnName(request,j,name);

      ENUM_DATABASE_FIELD_TYPE type = DatabaseColumnType(request,j);
      if(type == DATABASE_FIELD_TYPE_TEXT)
        {
         string data = "";
         DatabaseColumnText(request,j,data);
         logs.Info(name + " | "+data,"TickORM");
        }
      else if(type == DATABASE_FIELD_TYPE_FLOAT)
        {
         double data = 0;
         DatabaseColumnDouble(request,j,data);
         logs.Info(name + " | "+DoubleToString(data,5),"TickORM");
        }
      else if(type == DATABASE_FIELD_TYPE_INTEGER)
        {
         long id = 0;
         DatabaseColumnLong(request,j,id);
         logs.Info(name + " | "+IntegerToString(id),"TickORM");
        }
     }
  }

//--- Reset query
DatabaseFinalize(request);
Al ejecutarlo, aparece lo siguiente en el registro:
2025.08.21 10:18:04 [INFO]: Open database
2025.08.21 10:18:04 [INFO]: id | 1
2025.08.21 10:18:04 [INFO]: symbol | EURUSD
2025.08.21 10:18:04 [INFO]: price | 1.16110
2025.08.21 10:18:04 [INFO]: takeprofit | 1.15490
2025.08.21 10:18:04 [INFO]: stoploss | 1.16570
2025.08.21 10:18:04 [INFO]: volume | 0.01000
2025.08.21 10:18:04 [INFO]: Closed database
En este caso, además de desplazarnos por las filas y columnas, también accedemos al contenido de cada celda. Volviendo a la analogía de la imagen didáctica:
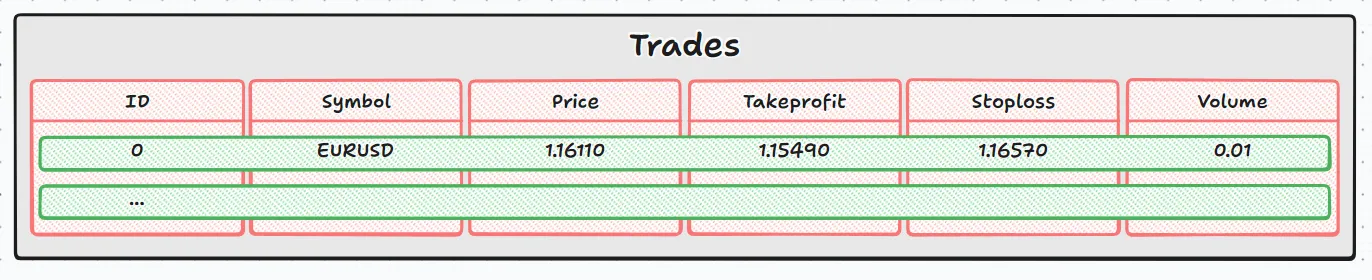
- El rectángulo gris es la tabla completa (trades).
- Cada rectángulo verde es una fila devuelta por DatabaseRead.
- Cada rectángulo rojo es una columna, cuyo valor puede ser texto (cadena), un número decimal (double) o un número entero (int).
- Al utilizar DatabaseColumnType, es como si preguntáramos: «¿Qué tipo de datos hay dentro de este rectángulo rojo?».
- A continuación, la función correspondiente (DatabaseColumnText, DatabaseColumnDouble, DatabaseColumnLong) obtiene el valor.
5. Actualización de los datos de la tabla
En situaciones de la vida real, no es raro que tengamos que modificar la información existente. Aquí es donde entra en juego el comando UPDATE, que permite modificar los valores de una o varias columnas en filas concretas de una tabla.
En SQL, la estructura básica del comando es:
UPDATE table_name
SET column1=value1, column2=value2, ...
WHERE condition;
En MQL5, la actualización de registros se realiza mediante la función DatabaseExecute, que envía el comando SQL directamente a la base de datos. He aquí un ejemplo:
//--- Update data
ResetLastError();
if(DatabaseExecute(handler,"UPDATE trades SET volume=0.1 WHERE id=1"))
  {
   logs.Info("Trades table data updated","TickORM");
  }
else
  {
   logs.Error("Failed to update trades table data",GetLastError(),"TickORM");
  }
Aquí tenemos un caso clásico: le estamos indicando a la base de datos que busque el registro de la tabla «trades» cuyo id sea igual a 1 y, una vez encontrado, que cambie el valor de la columna «volume» a 0,1.
Este patrón resulta extremadamente útil en el trading. Imagina que has guardado una operación con un volumen inicial de 0,01 lotes, pero que, tras realizar ajustes en la estrategia, necesitas corregirlo a 0,1. Con un simple comando UPDATE, la información se sincroniza de forma fiable en la base de datos, sin necesidad de eliminar ni volver a crear registros.
6. Eliminación de datos de la tabla
Para eliminar datos, utilizamos el comando DELETE de SQL, que se encarga de eliminar filas de una tabla. La forma general del comando es:
DELETE FROM table_name
WHERE condition;
Sigue el mismo patrón: utilizamos la función DatabaseExecute para enviar el comando SQL:
//--- Delete data
ResetLastError();
if(DatabaseExecute(handler,"DELETE FROM trades WHERE id=1"))
  {
   logs.Info("Deleted trades table data","TickORM");
  }
else
  {
   logs.Error("Failed to delete data to the trade table",GetLastError(),"TickORM");
  }
En este ejemplo, le pedimos a la base de datos que elimine de la tabla «trades» el registro cuyo campo «id» sea igual a 1. Un borrado único, controlado y seguro.
Detalle importante: Al igual que con la instrucción UPDATE, es imprescindible utilizar la cláusula WHERE para evitar borrar accidentalmente todos los registros de la tabla.Con este comando, hemos completado el ciclo básico de manipulación de datos: crear, insertar, actualizar y eliminar. A partir de aquí, ya tenemos todos los elementos básicos para el siguiente paso.
7. Eliminar una tabla
Si la tabla ya no nos sirve, podemos eliminarla.
//--- Delete table
ResetLastError();
if(DatabaseExecute(handler,"DROP TABLE trades"))
  {
   logs.Info("Trades table deleted","TickORM");
  }
else
  {
   logs.Error("Failed to delete trades table",GetLastError(),"TickORM");
  }
Vale la pena destacar que la instrucción DROP TABLE es irreversible. A diferencia de las sentencias DELETE FROM, que solo eliminan los registros pero conservan la estructura, la sentencia DROP TABLE elimina tanto la tabla como los datos. Si ejecutas esta instrucción, será necesario volver a crear la tabla antes de que pueda recibir nuevos registros.
8. Transacciones e integridad de los datos
Pasemos ahora a un aspecto fundamental: la integridad de la base de datos. En cualquier aplicación que manipule datos, la integridad es un aspecto fundamental. Imagina una situación en la que tengamos que escribir varios registros; si una de estas inserciones falla y las demás ya se han aplicado, la base de datos podría quedar en un estado incoherente. Las transacciones sirven para evitar este problema.
Una transacción es un conjunto de operaciones SQL que debe tratarse como una unidad atómica:
- O bien se aplican todas las instrucciones que contiene (commit),
- o no se conserva ninguna (rollback).
En MQL5 disponemos de funciones nativas que nos permiten controlar este flujo:
- DatabaseTransactionBegin(handler) → Inicia la transacción.
- DatabaseTransactionCommit(handler) → Confirma y aplica los cambios.
- DatabaseTransactionRollback(handler) → Deshacer todos los cambios realizados desde el inicio de la transacción.
El siguiente ejemplo muestra cómo utilizarlos:
//--- Insert with transaction
string sql="INSERT INTO trades (symbol,price,takeprofit,stoploss,volume) VALUES ('EURUSD',1.16110,1.15490,1.16570,0.01);";
DatabaseTransactionBegin(handler);
logs.Info("Inserting data, preparing transaction","TickORM");
if(!DatabaseExecute(handler,sql))
  {
   logs.Error("Transaction failed, reverting to previous state",GetLastError(),"TickORM");
   DatabaseTransactionRollback(handler);
  }
else
  {
   logs.Info("Transaction complete, changes saved","TickORM");
   DatabaseTransactionCommit(handler);
  }
En este fragmento:
- Iniciamos la transacción con DatabaseTransactionBegin.
- Intentamos ejecutar la inserción (DatabaseExecute).
- Si algo sale mal, utilizamos DatabaseTransactionRollback para deshacerlo todo.
- De lo contrario, confirmamos los cambios con DatabaseTransactionCommit.
Esto resulta útil porque garantiza que no queden datos incompletos. Esto te permite tener un mayor control: puedes agrupar varias operaciones y aplicarlas solo cuando estés seguro de que todas han funcionado. Y, por consiguiente, aumenta la seguridad: en caso de fallos imprevistos (fallos de red, cortes de corriente o errores de ejecución), la base de datos vuelve a su estado anterior sin que se vean comprometidos los datos.
Imagina que tienes que registrar diez operaciones diferentes en varias tablas. Si la octava falla, sin una transacción se habrían registrado siete operaciones y faltarían tres, lo que supondría un estado incoherente. Con esta operación, solo tienes que revertirla y la base de datos volverá a estar exactamente como estaba antes del intento.
9. Importación y exportación de datos
Además de las transacciones, otra ventaja en cuanto a seguridad y practicidad es la posibilidad de importar y exportar datos. Esto permite crear copias de seguridad periódicas de la base de datos, lo que garantiza no solo la protección frente a posibles pérdidas, sino también la movilidad y la facilidad de recuperación. Para ello, existen las funciones DatabaseExport y DatabaseImport, que permiten extraer los datos en formato CSV y, cuando sea necesario, volver a importarlos a la base de datos.
El siguiente ejemplo muestra cómo exportar la tabla «trades» a un archivo llamado «backup_trades.csv»:
//--- Export table
ResetLastError();
long data = DatabaseExport(handler,"trades","backup_trades.csv",DATABASE_EXPORT_HEADER,";");
if(data > 0)
  {
   logs.Info("Backup of the 'trades' table created successfully","TickORM");
  }
else
  {
   logs.Error("Failed to create backup of table 'trades'",GetLastError(),"TickORM");
  }
A continuación, te indicamos algunos puntos importantes:
-
Nombre del archivo: es relativo a la carpeta MQL5\\Files. Esto significa que, si lo deseas, puedes organizar las copias de seguridad en subcarpetas.
-
Formato CSV: universalmente aceptado; se puede abrir en Excel, Google Sheets, Python, R, etc.
-
Indicadores: en el ejemplo hemos utilizado DATABASE_EXPORT_HEADER, que incluye los nombres de las columnas en la primera línea. Esto facilita la tarea a quien tenga que interpretar los datos más adelante.
Valor Descripción DATABASE_EXPORT_HEADER Muestra los nombres de los campos en la primera línea DATABASE_EXPORT_INDEX Muestra los números de fila DATABASE_EXPORT_NO_BOM No inserta una etiqueta BOM al principio del archivo (la BOM se inserta de forma predeterminada) DATABASE_EXPORT_CRLF Utiliza CRLF (por defecto, LF) para los saltos de línea DATABASE_EXPORT_APPEND Añade datos al final de un archivo ya existente (por defecto, el archivo se sobrescribe). Si el archivo no existe, se creará. DATABASE_EXPORT_QUOTED_STRINGS Muestra los valores de cadena entre comillas dobles. DATABASE_EXPORT_COMMON_FOLDER El archivo CSV se creará en la carpeta compartida de todos los terminales: \Terminal\Common\File. -
Separador: utilizamos «;», pero podría ser «,», «\\t», etc., dependiendo de tus preferencias o del sistema que vaya a procesar el archivo.
El valor devuelto indica cuántos registros se han exportado. Si es negativo, significa que se ha producido un error y GetLastError() te indicará cuál es.
Ahora imagina el caso contrario: restaurar o cargar datos en la tabla «trades»:
//--- Import table
ResetLastError();
long data = DatabaseImport(handler,"trades","backup_trades.csv",DATABASE_IMPORT_HEADER|DATABASE_IMPORT_APPEND,";",0,NULL);
if(data > 0)
  {
   logs.Info("'trades' table imported successfully","TickORM");
  }
else
  {
   logs.Error("Failed to import 'trades' table",GetLastError(),"TickORM");
  }
A continuación te ofrecemos algunos datos interesantes:
-
Indicadores combinados: Utilizamos DATABASE_IMPORT_HEADER (el sistema reconoce la primera fila como encabezado) y DATABASE_IMPORT_APPEND (los datos importados se añadirán a la tabla existente, sin borrar lo que ya hay en ella).
Valor Descripción DATABASE_IMPORT_HEADER La primera línea contiene los nombres de los campos de la tabla DATABASE_IMPORT_CRLF El salto de línea es CRLF (por defecto, LF) DATABASE_IMPORT_APPEND Añade datos al final de una tabla ya existente DATABASE_IMPORT_QUOTED_STRINGS Los valores de cadena se escriben entre comillas dobles DATABASE_IMPORT_COMMON_FOLDER El archivo se encuentra en la carpeta común de todos los terminales de cliente: \Terminal\Common\File -
Separador: Debe coincidir con el utilizado en la exportación.
-
skip_rows: Te permite omitir las primeras líneas (por ejemplo, si quieres ignorar comentarios o datos antiguos).
-
skip_comments: Define los símbolos que marcan las líneas que deben omitirse. Resulta muy útil cuando se trabaja con archivos CSV anotados manualmente.
El valor devuelto indica cuántos registros se han importado.
Con DatabaseExport y DatabaseImport, hemos completado el ciclo básico de introducción y extracción de datos de la base de datos. Ahora sabemos cómo crear tablas, insertar, consultar, actualizar y eliminar datos, e incluso guardar copias externas o restaurar información cuando sea necesario.
Pero hay que tener en cuenta un detalle: cada operación requiere manejar directamente el SQL y realizar llamadas específicas a funciones nativas. Esto funciona bien en ejemplos pequeños, pero a medida que el sistema crece, la complejidad aumenta y, con ella, el riesgo de que se produzcan errores. Y aquí es precisamente donde surge la siguiente pregunta inevitable: ¿De verdad tenemos que escribirlo todo a mano?
Aquí es donde entra en juego la idea de un ORM. En la siguiente sección, veremos qué es, por qué puede cambiar radicalmente la forma en que interactuamos con las bases de datos en MQL5 y cómo encaja en el camino que estamos trazando.
¿Qué es un ORM y para qué lo necesitamos?
Hasta ahora, hemos visto cómo utilizar SQL directamente en MQL5, manipulando tablas y registros «sobre la marcha». Este enfoque funciona, pero a medida que el sistema crece, también lo hace la cantidad de código SQL disperso por todo el código, lo que conlleva problemas de mantenimiento, repeticiones y el riesgo de que se produzcan errores. Aquí es donde entra en juego el ORM (Object-Relational Mapping).
Un ORM es una capa que sirve de puente entre el mundo orientado a objetos y el mundo relacional de las bases de datos. En lugar de escribir código SQL manualmente, describimos nuestras entidades como clases y dejamos que el ORM se encargue de traducirlas a comandos SQL. En otras palabras: en lugar de utilizar la instrucción INSERT INTO trades (...) VALUES (...), basta con crear un objeto Trade y llamar a algo como repository.save(trade).
Las principales características de un ORM son las siguientes:
- Asignación automática: transforma clases y atributos en tablas y columnas.
- Abstracción de SQL: se trabaja con objetos y métodos, no con cadenas de SQL.
- Coherencia: reduce la duplicación de la lógica, ya que las operaciones comunes, como guardar, buscar o eliminar, están centralizadas.
- Portabilidad: en algunos ORM, la misma lógica puede funcionar en diferentes bases de datos sin necesidad de modificar el código fuente.
En MQL5, esta idea tiene aún más sentido, ya que escribir código SQL incrustado en el código se convierte rápidamente en una pesadilla. Imagina un asesor experto con docenas de entidades (operaciones, órdenes, registros, métricas de rendimiento). Cada instrucción INSERT, SELECT o UPDATE repartida por todo el código supone más puntos de fallo, más dificultad a la hora de desarrollar la lógica y más posibilidades de que se produzcan incoherencias.
El «problema» que resuelve el ORM es:
- Evita la duplicación de código SQL en distintas partes del EA.
- Esto facilita el mantenimiento, ya que los cambios en la estructura de la tabla se reflejan en un único lugar (la clase de entidad).
- Te permite escribir código más legible y natural, pensando en términos de objetos de dominio (por ejemplo, «Trade», «User», «Order») en lugar de tablas y columnas.
- Esto abre nuevas posibilidades para funciones avanzadas como la generación automática de tablas, el control de versiones de esquemas e incluso una integración más sencilla con bibliotecas de registro y auditoría.
En resumen: sin ORM, cada operación es un fragmento de código SQL dentro del programa; con ORM, el código SQL pasa a ser un detalle oculto y tú te centras en lo que realmente importa: la lógica de negociación.
Nuestro proyecto ORM en MQL5
Ahora que comprendemos la utilidad de un ORM, debemos imaginar cómo se aplica esto al ecosistema MQL5. A diferencia de los lenguajes más tradicionales del mundo de los ORM (Java, C#, Python), aquí no disponemos de marcos sólidos listos para usar, lo que significa que tendremos que crear nuestra propia solución, adaptada a las limitaciones y particularidades del lenguaje.
El alcance previsto para este proyecto es claro: crear una capa que permita al desarrollador trabajar con objetos en lugar de utilizar SQL directamente, pero sin perder la simplicidad y el rendimiento que exige un entorno de negociación.
Las funcionalidades previstas incluyen:
- Entidades: Cada tabla de la base de datos estará representada por una clase MQL5, con metadatos que describan sus columnas (tipo, clave primaria, si es autoincremental, si admite valores nulos, etc.). Por lo tanto, la clase «Trade» reflejará directamente la tabla «trades», pero se manipulará como un objeto nativo.
- Repositorios: En lugar de escribir INSERT, UPDATE o SELECT manualmente, cada entidad contará con un repositorio encargado de las operaciones de persistencia y recuperación. Por ejemplo, TradeRepository centralizará métodos como Save(trade), FindById(id) o Delete(trade). De esta forma, el código del EA es limpio y no contiene fragmentos de SQL dispersos.
- Generador de consultas: Para aquellos casos en los que necesitemos consultas más complejas (filtros, ordenación, combinaciones JOIN), dispondremos de un generador de consultas. Te permitirá crear consultas mediante programación y de forma segura, evitando errores de concatenación de cadenas y reduciendo la exposición directa al SQL.
- Creación automática de tablas: A partir de los metadatos de la entidad, el ORM podrá generar automáticamente la tabla correspondiente, comprobando primero si ya existe antes de crearla. Esta funcionalidad elimina la necesidad de utilizar scripts SQL manuales al inicio del proyecto y garantiza que la base de datos se adapte a la evolución de las entidades.
- Integración con los registros y la auditoría: Todas las operaciones realizadas por el ORM (inserción, actualización, eliminación) pueden registrarse en los registros, aprovechando las bibliotecas ya desarrolladas en MQL5. Esto facilita la auditoría de lo que ocurre en la base de datos y ayuda a diagnosticar problemas.
- Extensibilidad: La arquitectura se diseñará para poder evolucionar: hoy empezamos con funciones CRUD básicas, pero nada nos impide añadir compatibilidad con migraciones de esquemas, relaciones entre entidades (uno a muchos, muchos a muchos) o incluso almacenamiento en caché en memoria para optimizar las consultas.
El objetivo no es recrear un marco de trabajo como Hibernate dentro de MQL5, sino proporcionar una capa de abstracción minimalista y eficiente que satisfaga las necesidades reales de quienes trabajan con el trading algorítmico y necesitan una persistencia estructurada.
Conclusión y próximos pasos
Hemos llegado al final de esta primera parte de la serie, y el panorama empieza a aclararse: las bases de datos en MQL5 no son solo archivos para almacenar información, sino potentes estructuras que, cuando se aprovechan adecuadamente, permiten registrar, consultar y manipular datos de forma organizada y fiable. Hemos visto cómo funciona SQL en la práctica, desde la creación de tablas, la inserción y lectura de registros, hasta la manipulación de columnas y tipos de datos, utilizando funciones nativas de MQL5 como DatabaseOpen, DatabaseExecute, DatabasePrepare y DatabaseRead.
Y lo que es más importante, somos conscientes de que escribir código SQL manualmente en cada proyecto se convierte rápidamente en una tarea repetitiva, propensa a errores y difícil de mantener. Aquí es donde entra en juego el concepto de ORM: una capa de abstracción que convierte las tablas en objetos y las consultas SQL en métodos sencillos, lo que te permite trabajar con entidades de forma natural, al tiempo que mantienes el código limpio y centralizado.
Como siguientes pasos de la serie, vamos a empezar a crear esta capa de abstracción. Nuestro objetivo será crear un ORM minimalista y eficiente, con clases de entidad, repositorios, un generador de consultas y un mecanismo de creación automática de tablas. De este modo, operaciones como guardar, recuperar o eliminar datos ya no dependerán de código SQL disperso por todo el código, sino de métodos intuitivos que reflejen directamente el ámbito de las operaciones bursátiles que estamos modelando.
Al dominar estas herramientas, no solo ganarás en eficiencia y seguridad en el manejo de datos, sino que también sentarás unas bases sólidas para desarrollar sistemas de negociación complejos, lo que te permitirá realizar análisis más avanzados, pruebas retrospectivas fiables e historiales detallados de órdenes y estrategias.
Con esto concluye esta primera fase. La próxima parte de la serie tendrá un carácter práctico: empezaremos a definir las clases ORM iniciales y a implementar la persistencia de objetos, relacionando toda la teoría que hemos visto aquí con código funcional en MQL5.
Traducción del inglés realizada por MetaQuotes Ltd.
Artículo original: https://www.mql5.com/en/articles/19285
Advertencia: todos los derechos de estos materiales pertenecen a MetaQuotes Ltd. Queda totalmente prohibido el copiado total o parcial.
Este artículo ha sido escrito por un usuario del sitio web y refleja su punto de vista personal. MetaQuotes Ltd. no se responsabiliza de la exactitud de la información ofrecida, ni de las posibles consecuencias del uso de las soluciones, estrategias o recomendaciones descritas.
 Creación de sistemas de trading basados en IA en MQL5 (Parte 1): Implementación del manejo de JSON para APIs de IA
 El oscilador Parafrac V2: integración de Parabolic SAR con Average True Range
 Creación de un sistema de trading profesional con Heikin Ashi (Parte 2): Desarrollo de un EA
 Desarrollo de un indicador personalizado de matriz de rendimiento de cuenta

- Aplicaciones de trading gratuitas
- 8 000+ señales para copiar
- Noticias económicas para analizar los mercados financieros
Usted acepta la política del sitio web y las condiciones de uso
En este primer artículo, solo he mostrado la punta del iceberg. TickORM va mucho más allá: la idea es cambiar por completo la forma de trabajar con bases de datos en MQL5. El objetivo es conseguir algo directo, sencillo y potente, en el que abrir una base de datos, crear un repositorio y manipular entidades resulte tan natural como trabajar con matrices. Al final de la serie, el uso se parecerá al ejemplo que se muestra a continuación, en el que se guardan, buscan, actualizan y eliminan registros sin escribir ni una sola consulta manual. Este es el camino que estoy allanando con TickORM.
Nota: En el libro se ha presentado una implementación de ORM para MQL5.