

Do iniciante ao especialista: Criação de relatórios detalhados de negociação com o EA Reporting EA
 13
 0

Sumário:
- Introdução
- Visão geral do EA Reporting EA
- Atualização do código do EA Reporting EA
- Atualização do script Python reports_processor
- Testes
- Conclusão
- Principais lições
- Anexos
Introdução
Neste artigo, abordamos os desafios relacionados à geração e disponibilização de relatórios de negociação no MetaTrader 5. Na publicação anterior, descrevemos o fluxo de trabalho do sistema e os requisitos necessários para seu funcionamento eficiente. Também apresentamos o EA Reporting EA, desenvolvido para gerar e disponibilizar relatórios de negociação em formato PDF, com uma periodicidade configurável pelo usuário.
Dando continuidade ao artigo anterior, nosso objetivo é aprimorar a solução apresentada, ampliando tanto o nível de detalhamento das informações quanto a eficiência na apresentação dos relatórios. Esses avanços são possíveis graças à integração do MQL5 com bibliotecas avançadas do Python, que permitem produzir relatórios mais completos e automatizar sua geração de maneira mais fluida. Ao longo desse desenvolvimento, também veremos como a integração entre linguagens pode ser aproveitada para criar soluções de trading confiáveis e capazes de operar sem interrupções.
A importância desse aprimoramento fica ainda mais evidente quando consideramos o impacto que relatórios detalhados podem ter na forma de pensar do trader e em seu processo de tomada de decisão. Na versão anterior, o arquivo PDF gerado continha apenas quatro itens de dados, uma limitação evidente que reforça a necessidade de relatórios mais completos. A partir de agora, nossos relatórios passarão a incluir métricas mais abrangentes, visualizações, gráficos e diversos elementos analíticos descritos na seção 2 do artigo anterior, dedicada aos recursos de geração de relatórios.
O objetivo final é desenvolver uma ferramenta de geração de relatórios flexível e rica em informações, que cada analista ou trader possa adaptar às suas estratégias de negociação e ao seu fluxo de trabalho.
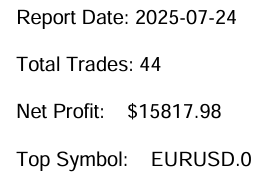
Figura 1: Captura de tela de um relatório de negociação gerado por uma versão anterior do EA Reporting EA
A imagem acima mostra um trecho do relatório em PDF gerado pela primeira versão do nosso script reports_processor.py. O trecho de código correspondente é apresentado a seguir. Neste artigo, vamos aprimorar esse código para que ele permita gerar relatórios mais detalhados e informativos.
Ao longo deste artigo, exploraremos outros recursos que o Python oferece para a geração de relatórios e mostraremos como otimizar a integração entre MQL5 e Python para aumentar a eficiência e a flexibilidade da solução.
def generate_pdf(report, output_path):
    pdf = FPDF()
    pdf.add_page()
    pdf.set_font("Arial", size=12)
    pdf.cell(0, 10, f"Report Date: {report['date']}", ln=True)
    pdf.cell(0, 10, f"Total Trades: {report['trade_count']}", ln=True)
    pdf.cell(0, 10, f"Net Profit:    ${report['net_profit']:.2f}", ln=True)
    pdf.cell(0, 10, f"Top Symbol:    {report['top_symbol']}", ln=True)
    pdf.output(output_path)
Ao comparar os recursos de geração de relatórios apresentados na Figura 1, acima, e na Figura 2, abaixo, fica claro que ainda há bastante espaço para melhorias. Nosso objetivo não é reinventar soluções existentes, mas oferecer uma alternativa flexível e personalizável para gerar relatórios de negociação.
A imagem da seção de relatórios do terminal MetaTrader 5 mostra os recursos disponíveis atualmente, que servirão de referência para os aprimoramentos que pretendemos implementar.
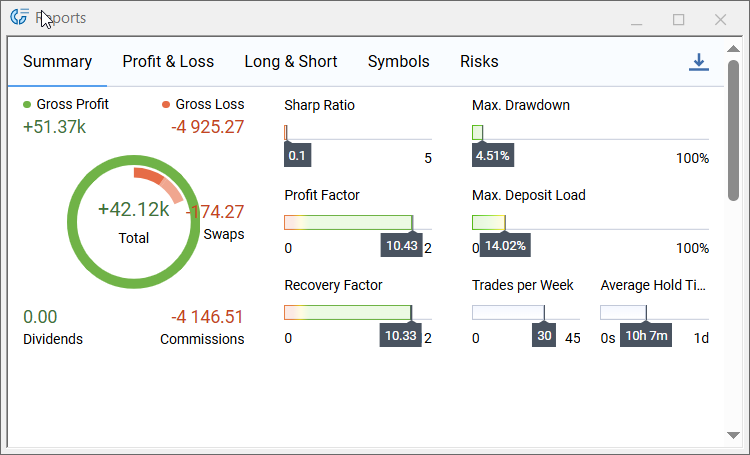
Figura 2: Recursos dos relatórios de negociação do MQL5
Visão geral da atualização do EA Reporting EA
A Figura 3 (diagrama de blocos), apresentada abaixo, ilustra o fluxo de processamento que será implementado com a atualização do EA Reporting EA. O EA exporta o histórico de negociações para um arquivo CSV identificado pela data e executa um gerador de relatórios em Python, que processa esse arquivo para calcular métricas analíticas, criar gráficos e gerar o relatório final em PDF, além de um arquivo JSON compacto com os campos status, pdf_path e email_sent. Em seguida, o EA consulta esse arquivo JSON, lê e interpreta seu conteúdo, verifica os caminhos de saída informados e os tamanhos dos arquivos e, se todas as verificações forem bem-sucedidas, envia notificações e, opcionalmente, arquiva ou abre o relatório, concluindo o ciclo automatizado de geração de relatórios.
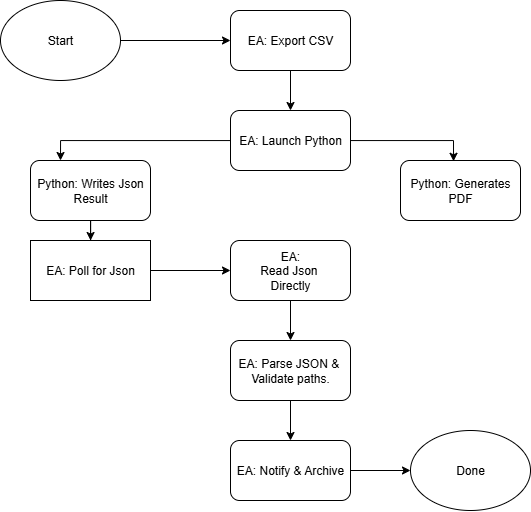
Figura 3: Diagrama de blocos do EA Reporting EA
Atualização do código do EA Reporting EA
Nesta etapa, implementaremos a atualização em MQL5 para garantir a geração de relatórios de alta qualidade. Dividiremos o EA em seções lógicas e explicaremos os trechos de código que contribuem diretamente para nossos objetivos de geração de relatórios. Vale lembrar que os EAs em MQL5 não se limitam à abertura de operações de negociação. Eles também podem automatizar diversas tarefas rotineiras de trading, e a geração de relatórios é um excelente exemplo disso. Embora nosso foco atual seja desenvolver um EA especializado e leve, dedicado à geração de relatórios, futuramente poderemos integrar o mesmo módulo a um EA com funcionalidades mais abrangentes. Ao desenvolver um EA especializado, podemos dividir um problema complexo em partes mais fáceis de gerenciar, implementar e aprimorar o recurso de geração de relatórios de forma independente, validá-lo por meio de testes de fumaça e depuração direcionada e, posteriormente, integrar o componente aprimorado a sistemas mais complexos, com o mínimo possível de desvantagens.
1. Cabeçalho, importações do Windows e parâmetros de entrada do usuário
Nesta seção, declaramos os metadados do EA, importamos apenas as funções necessárias da API do Windows (para verificar os atributos de arquivos por meio de caminhos absolutos e executar o cmd.exe) e definimos os parâmetros de entrada configuráveis pelo usuário. Configure esses valores de acordo com seu ambiente (caminho do Python, caminho do script e diretório de saída), para que o EA possa validá-los durante a inicialização. Os parâmetros ReportFormats, EnableEmail e TestOnInit permitem controlar o comportamento do EA sem modificar o código.
#property copyright "Clemence Benjamin"
#property version   "1.01"
#property description "Exports trading history in CSV and generates reports via Python"
#property strict

#define SW_HIDE                 0
#define INVALID_FILE_ATTRIBUTES 0xFFFFFFFF

#import "kernel32.dll"
uint   GetFileAttributesW(string lpFileName);
#import

#import "shell32.dll"
int    ShellExecuteW(int hwnd, string lpOperation, string lpFile, string lpParameters, string lpDirectory, int nShowCmd);
#import

//--- User inputs
input string PythonPath   = "C:\\Users\\YOUR_COMPUTER_NAME\\AppData\\Local\\Programs\\Python\\Python312\\python.exe";
input string ScriptPath   = "C:\\Users\\YOUR_COMPUTER_NAME\\PATH_TO\\reports_processor.py";
input string ReportFormats= "html,pdf";
input string OutputDir    = "C:\\Users\\YOUR_COMPUTER_NAME\\PATH_TO_WHERE_YOUR_Reports_are_ saved";
input bool   EnableEmail  = true;
input bool   TestOnInit   = true;
2. Inicialização e verificação do ambiente (OnInit)
OnInit() inicializa o EA e o gerador de números aleatórios (RNG), normaliza os caminhos configurados, registra o diretório de arquivos do terminal, verifica a existência do executável do Python e do diretório de saída e confirma as permissões de gravação em MQL5\Files. Quando TestOnInit está ativado, o EA realiza uma execução de teste, conhecida como teste de fumaça, para confirmar que todos os componentes do fluxo estão corretamente conectados, de ponta a ponta.
int OnInit()
{
   Print(">> Reporting EA initializing…");
   MathSrand((uint)TimeLocal());

   string cleanPythonPath = CleanPath(PythonPath);
   string cleanScriptPath = CleanPath(ScriptPath);
   string cleanOutputDir = CleanPath(OutputDir);
   Print("PythonPath set to: ", cleanPythonPath);
   Print("ScriptPath set to: ", cleanScriptPath);
   Print("OutputDir set to: ", cleanOutputDir);

   string filesDir = TerminalInfoString(TERMINAL_DATA_PATH) + "\\MQL5\\Files\\";
   Print("Terminal Files directory: ", filesDir);

   if(GetFileAttributesW(cleanPythonPath) == INVALID_FILE_ATTRIBUTES)
      Print("!! Python executable not found at: ", cleanPythonPath);
   else
      Print("✔ Found Python at: ", cleanPythonPath);

   // Write-permission test (MQL5\\Files)
   int h = FileOpen("test_perm.txt", FILE_WRITE|FILE_TXT);
   if(h == INVALID_HANDLE)
      Print("!! Cannot write to MQL5\\Files directory! Error: ", GetLastError());
   else
   {
      FileWrite(h, "OK");
      FileFlush(h);
      FileClose(h);
      FileDelete("test_perm.txt");
      Print("✔ Write permission confirmed.");
   }

   if(TestOnInit)
   {
      Print(">> Test mode: running initial export.");
      RunDailyExport();
      lastRunTime = TimeCurrent();
   }

   return(INIT_SUCCEEDED);
}
3. Utilitários de caminhos e funções auxiliares essenciais
A padronização dos caminhos e a verificação confiável dos arquivos ajudam a evitar diversos erros durante a execução. CleanPath() padroniza as barras dos caminhos e alerta sobre a presença de espaços. FileExists() encapsula a chamada GetFileAttributesW para verificar arquivos por meio de caminhos absolutos e recorre a FileOpen como alternativa para arquivos acessíveis na área de arquivos do terminal, como MQL5\Files. Essas funções auxiliares devem ser reutilizadas em todo o EA para manter a consistência das verificações.
string CleanPath(string path)
{
   string cleaned = path;
   StringReplace(cleaned, "/", "\\");
   while(StringFind(cleaned,"\\\\")>=0) StringReplace(cleaned, "\\\\", "\\");
   StringTrimLeft(cleaned);
   StringTrimRight(cleaned);
   return cleaned;
}

bool FileExists(string path)
{
   if(StringFind(path, "\\", 0) >= 0)
   {
      uint attrs = GetFileAttributesW(path);
      return(attrs != INVALID_FILE_ATTRIBUTES);
   }
   else
   {
      int fh = FileOpen(path, FILE_READ|FILE_TXT);
      if(fh == INVALID_HANDLE) return false;
      FileClose(fh);
      return true;
   }
}
4. Lógica de geração e exportação de arquivos CSV
A função ExportHistoryToCSV() seleciona os registros do histórico de negociação e os exporta para um arquivo CSV, incluindo uma linha de cabeçalho e uma linha para cada negócio. Ela utiliza MakeUniqueFilename() para evitar conflitos entre nomes de arquivos, especialmente em execuções repetidas, e armazena o nome do arquivo gerado na variável global LastExportedCSV. É importante garantir que o CSV seja determinístico e contenha todas as colunas esperadas pelo script Python.
string MakeUniqueFilename(string baseName)
{
   int dot = StringFind(baseName, ".", 0);
   string name = dot >= 0 ? StringSubstr(baseName, 0, dot) : baseName;
   string ext  = dot >= 0 ? StringSubstr(baseName, dot) : "";
   string ts = TimeToString(TimeCurrent(), TIME_DATE | TIME_SECONDS);
   StringReplace(ts, ".", ""); StringReplace(ts, " ", "_"); StringReplace(ts, ":", "");
   int suffix = MathAbs(MathRand()) % 9000 + 1000;
   return name + "_" + ts + "_" + IntegerToString(suffix) + ext;
}

bool ExportHistoryToCSV(string filename)
{
   datetime end = TimeCurrent();
   datetime start = end - 7776000; // 90 days
   if(!HistorySelect(start, end)) { Print("!! HistorySelect failed."); return false; }
   int total = HistoryDealsTotal();
   if(total == 0) { Print("!! No trading history found."); return false; }

   int attempts = 3;
   string tryName = filename;
   int fh = INVALID_HANDLE;
   for(int a=0; a<attempts; a++)
   {
      fh = FileOpen(tryName, FILE_WRITE|FILE_CSV|FILE_ANSI, ",");
      if(fh != INVALID_HANDLE) break;
      tryName = MakeUniqueFilename(filename);
      Sleep(200);
   }
   if(fh == INVALID_HANDLE) { Print("!! FileOpen failed after retries."); return false; }

   FileWrite(fh, "Ticket,Time,Type,Symbol,Volume,Price,Profit,Commission,Swap,Balance,Equity");

   // ... iterate deals and FileWrite rows ...
   FileFlush(fh); FileClose(fh);
   LastExportedCSV = tryName;
   return true;
}
5. Execução e gerenciamento do Python (RunDailyExport)
RunDailyExport() coordena a execução: monta o caminho do arquivo CSV, inicia o Python por meio do cmd.exe e redireciona stdout e stderr para o arquivo python_run.log, localizado em MQL5\Files, permitindo que o EA consulte a saída do script. Em seguida, a função procura prioritariamente o arquivo report_result_YYYY-MM-DD.json, gerado pelo Python, e, caso ele não esteja disponível, recorre à verificação periódica do arquivo PDF. Nessa arquitetura, a troca estruturada de dados por meio de JSON tem prioridade, permitindo que o EA confirme de forma confiável o êxito da execução e a disponibilidade dos anexos.
void RunDailyExport()
{
   string filesDir = TerminalInfoString(TERMINAL_DATA_PATH) + "\\MQL5\\Files\\";
   string dateStr = TimeToString(TimeCurrent(), TIME_DATE); StringReplace(dateStr, ".", "");
   string csvBase = "History_" + dateStr + ".csv";

   LastExportedCSV = "";
   if(!ExportHistoryToCSV(csvBase)) { Print("!! CSV export failed"); return; }
   string csvFull = filesDir + LastExportedCSV;

   string cleanOutputDir  = CleanPath(OutputDir);
   string pyLogName = "python_run.log";
   string pyLogFull = filesDir + pyLogName;

   string pythonCmd = StringFormat("\"%s\" \"%s\" \"%s\" --formats %s --outdir \"%s\" %s > \"%s\" 2>&1",
      CleanPath(PythonPath), CleanPath(ScriptPath), csvFull, "pdf", cleanOutputDir, EnableEmail ? "--email" : "", pyLogFull);

   string fullCmd = "/c " + pythonCmd;
   PrintFormat("→ Launching: cmd.exe %s", fullCmd);
   int result = ShellExecute(fullCmd);
   PrintFormat("← ShellExecute returned: %d", result);

   // Then poll for JSON or fallback to PDF; see next section for JSON handling...
}
6. Estratégia de processamento de JSON e leitura alternativa
Para evitar a dependência de logs destinados à leitura humana, o EA dá preferência aos resultados estruturados em JSON, que podem ser interpretados automaticamente. A função ReadFileText() tenta ler diretamente os arquivos JSON por meio de seus caminhos absolutos. Quando o MetaTrader 5 não permite utilizar FileOpen com caminhos absolutos, CopyToFilesAndRead() usa o comando copy do cmd para copiar o JSON para MQL5\Files e, em seguida, lê o arquivo com FileOpen. JsonExtractString e JsonExtractBool são funções auxiliares simples e práticas de extração de valores, suficientes para interpretar o contrato JSON utilizado, que contém os campos pdf_path e email_sent.
string ReadFileText(string fullpath)
{

   if(StringFind(fullpath, "\\", 0) >= 0)
   {
      uint attrs = GetFileAttributesW(fullpath);
      if(attrs == INVALID_FILE_ATTRIBUTES) return("");
      int fh = FileOpen(fullpath, FILE_READ|FILE_TXT);
      if(fh == INVALID_HANDLE) return("");
      string txt = "";
      while(!FileIsEnding(fh)) { txt += FileReadString(fh); if(!FileIsEnding(fh)) txt += "\n"; }
      FileClose(fh);
      return txt;
   }

   else
   {
      int fh = FileOpen(fullpath, FILE_READ|FILE_TXT);
      if(fh == INVALID_HANDLE) return("");

      // ... read and return ...
   }
}

string CopyToFilesAndRead(string absPath, string filesName)
{
   string filesDir = TerminalInfoString(TERMINAL_DATA_PATH) + "\\MQL5\\Files\\";
   string destAbs = filesDir + filesName;
   string cmd = "/c copy /Y \"" + absPath + "\" \"" + destAbs + "\" > nul 2>&1";
   int r = ShellExecute(cmd);

   // wait briefly for copy then read local file
   return ReadTerminalLogFile(filesName);
}

string JsonExtractString(string json, string key) { /* tiny extractor: locate "key": "value" */ }
bool   JsonExtractBool(string json, string key)   { /* tiny extractor: locate "key": true/false */ }
7. Verificação, notificações e alternativas de recuperação
Depois de interpretar o arquivo JSON, o EA verifica os caminhos indicados em pdf_path e html_path por meio de FileExists() e, quando necessário, envia uma notificação ao trader utilizando SendNotification(). Se a leitura do JSON ou alguma verificação falhar, o EA recorre ao python_run.log para confirmar a conclusão da execução e procura o arquivo PDF esperado, Report_YYYY-MM-DD.pdf, verificando se seu tamanho é maior que zero. Essa abordagem em várias camadas combina a confiabilidade da validação por JSON com a capacidade de recuperação oferecida pelos mecanismos alternativos baseados no PDF e no log.
if(StringLen(pdfp) > 0)
{
   if(FileExists(pdfp))
   {
      PrintFormat("✔ PDF exists at (from JSON): %s", pdfp);
      SendNotification("Report PDF created: " + pdfp);
   }
   else
      Print("!! JSON says PDF path but file not found: ", pdfp);
}

// fallback: if JSON unavailable -> poll expectedPdf in OutputDir and check size
8. Funções auxiliares de apoio e desinicialização
Utilitários como GetFileSizeByOpen(), responsável por verificar com segurança o tamanho dos arquivos, ReadTerminalLogFile(), que lê arquivos de MQL5\Files, e a função wrapper ShellExecute() são pequenos, mas desempenham papéis importantes. OnDeinit() exibe uma mensagem de limpeza ao encerrar o EA. Mantenha essas funções compactas e bem documentadas, pois elas facilitam a depuração e reduzem a duplicação de código.
long GetFileSizeByOpen(string filename)

{

   int fh = FileOpen(filename, FILE_READ|FILE_BIN);
   if(fh == INVALID_HANDLE) return -1;
   int pos = FileSeek(fh, 0, SEEK_END);
   FileClose(fh);
   return (pos < 0) ? -1 : (long)pos;
}

string ReadTerminalLogFile(string filename)

{
   int fh = FileOpen(filename, FILE_READ | FILE_TXT);
   if(fh == INVALID_HANDLE) return("");
   string content = "";
   while(!FileIsEnding(fh)) { content += FileReadString(fh); if(!FileIsEnding(fh)) content += "\n"; }
   FileClose(fh);
   return content;
}
int ShellExecute(string command)
{
   return ShellExecuteW(0, "open", "cmd.exe", command, NULL, SW_HIDE);
}
Atualização do script Python reports_processor
O EA funciona em conjunto com o script Python reports_processor.py. Agora que atualizamos o EA, precisamos adaptar o script Python para salvar os resultados e disponibilizar os relatórios de uma forma que o EA possa utilizá-los com eficiência. Nesta seção, examinaremos o código do script em detalhes e mostraremos como cada componente se integra ao EA, desde o processamento do CSV e os cálculos analíticos até a geração do PDF e a disponibilização dos resultados em JSON. O objetivo é estabelecer um fluxo confiável e automatizado de geração de relatórios.
Antes de analisar o código do script, precisamos configurar o ambiente Python para garantir que todas as funcionalidades sejam executadas corretamente. Nas próximas etapas, veremos como preparar esse ambiente, começando pela instalação. Essa configuração é fundamental para assegurar que as dependências estejam disponíveis e que possamos realizar os testes necessários durante o desenvolvimento do reports_processor sem dificuldades relacionadas ao ambiente.
Guia passo a passo: Configuração do Python no Windows para o script reports_processor
1. Instale o Python 3.9 ou superior pelo site python.org e verifique se o comando python está disponível no PATH.
2. Abra o PowerShell e crie e ative um ambiente virtual (venv):
python -m venv venv
.\venv\Scripts\Activate.ps1
3. Atualize o pip:
python -m pip install --upgrade pip
4. Instale os pacotes essenciais (o pacote fpdf é o backend padrão para geração de PDF; outros podem ser adicionados conforme a necessidade):
pip install pandas numpy jinja2 matplotlib fpdf yagmail
Backends opcionais:
pip install pdfkit weasyprint
Se utilizar o wkhtmltopdf, baixe o instalador para Windows e adicione o executável ao PATH ou configure a variável de ambiente WKHTMLTOPDF_PATH.
5. Configure as variáveis de ambiente para o envio de e-mails (por exemplo, nas Propriedades do Sistema → Variáveis de Ambiente ou pelo PowerShell):
setx YAGMAIL_USERNAME "you@example.com"
setx YAGMAIL_PASSWORD "your-email-password"
setx WKHTMLTOPDF_PATH "C:\Program Files\wkhtmltopdf\bin\wkhtmltopdf.exe"  # if using wkhtmltopdf
6. Execução de teste (a partir da pasta do projeto, com o ambiente virtual ativado):
python reports_generator.py "C:\path\to\MQL5\Files\History_20250821.csv" --formats pdf --outdir "C:\path\to\Reports" --email
7. Verifique os arquivos gerados em C:\path\to\Reports:
- Report_YYYY-MM-DD.pdf (relatório principal)
- equity_curve_YYYY-MM-DD.png (gráfico)
- report_result_YYYY-MM-DD.json (arquivo de confirmação para o EA)
Reports_processor.py
1. Inicialização, importações e detecção de backends
Ao iniciar, o script carrega as bibliotecas padrão do Python (os, sys, logging, datetime, argparse, glob) e as principais bibliotecas para processamento de dados (pandas, numpy). Em seguida, tenta importar as ferramentas opcionais WeasyPrint, pdfkit (wkhtmltopdf), FPDF e yagmail, registrando indicadores de disponibilidade para cada uma delas. Esses indicadores permitem que o script selecione, durante a execução, o método adequado para gerar arquivos PDF ou enviar e-mails, conforme as bibliotecas instaladas. Dessa forma, ele continua funcionando mesmo em ambientes nos quais algumas dependências opcionais não estão disponíveis. O sistema de logging é configurado logo no início, permitindo que o script produza mensagens informativas e de erro acompanhadas de marcas de tempo, que o EA pode registrar no arquivo python_run.log.
#!/usr/bin/env python
# reports_processor.py
__version__ = "1.0.1"
import sys
import os
import traceback
import argparse
import glob
from datetime import datetime, timedelta
import logging

# core data libs
import pandas as pd
import numpy as np

# templating & plotting
from jinja2 import Environment, FileSystemLoader
import matplotlib.pyplot as plt

# optional libraries: import safely
WEASY_AVAILABLE = False
PDFKIT_AVAILABLE = False
FPDF_AVAILABLE = False
YAGMAIL_AVAILABLE = False

try:
    from weasyprint import HTML          # may fail if native libs aren't installed
    WEASY_AVAILABLE = True
except Exception:
    WEASY_AVAILABLE = False

try:
    import pdfkit                       # wrapper for wkhtmltopdf
    PDFKIT_AVAILABLE = True
except Exception:
    PDFKIT_AVAILABLE = False

try:
    from fpdf import FPDF               # pure-python PDF writer (no native deps)
    FPDF_AVAILABLE = True
except Exception:
    FPDF_AVAILABLE = False

try:
    import yagmail
    YAGMAIL_AVAILABLE = True
except Exception:
    YAGMAIL_AVAILABLE = False

# Configure logging
logging.basicConfig(level=logging.INFO, format='%(asctime)s - %(levelname)s - %(message)s')
2. Análise dos argumentos e contrato da linha de comando
O script oferece uma interface simples de linha de comando: o argumento posicional csv_path aceita o caminho de um arquivo CSV ou de uma pasta na qual procurar arquivos; --formats define quais formatos devem ser gerados (HTML, PDF ou ambos); --outdir especifica o diretório em que os arquivos resultantes serão salvos; --email habilita ou desabilita o envio dos relatórios por e-mail; e --pdf-backend seleciona o método de geração de PDF. Essa interface segue a forma como o EA executa o script: ele fornece o caminho do arquivo CSV, o diretório de saída e, opcionalmente, o parâmetro de envio por e-mail. Em seguida, monitora o diretório de saída até encontrar o arquivo JSON com o resultado da execução.
def parse_args():
    """Parse command-line arguments."""
    parser = argparse.ArgumentParser(description="Generate trading reports (HTML/PDF) from CSV.")
    parser.add_argument("csv_path", help="Path to the trades CSV file or a folder to search for History_*.csv")
    parser.add_argument("-f", "--formats", nargs="+", choices=["html", "pdf"], default=["pdf"],
                        help="Report formats to generate (html, pdf, or both)")
    parser.add_argument("-o", "--outdir", default=".", help="Directory to write report files")
    parser.add_argument("--email", action="store_true", help="Send report via email")
    parser.add_argument("--pdf-backend", choices=["weasyprint","wkhtmltopdf","fpdf"],
                        default="fpdf",
                        help="PDF backend to use. 'weasyprint', 'wkhtmltopdf', or 'fpdf' (no native deps). Default: fpdf")
    return parser.parse_args()
3. Identificação do arquivo CSV de entrada
Quando csv_path aponta para uma pasta ou é fornecido de forma mais genérica, o script identifica o arquivo CSV que deverá processar. Se csv_path indicar um diretório, o script procura arquivos que correspondam ao padrão History_*.csv. Caso não encontre nenhum, amplia a busca para todos os arquivos .csv e seleciona aquele com a data de modificação mais recente. Se for informado o caminho completo de um arquivo CSV, o script o utiliza diretamente. Essa flexibilidade facilita tanto a execução pelo EA, que informa um arquivo CSV específico, quanto a execução manual.
def resolve_csv_path(csv_path):
    """
    Ensure csv_path points to an existing file. If not, try to locate the
    most recent History_*.csv in the same directory or the provided folder.
    Returns resolved path or raises FileNotFoundError.
    """
    # If csv_path is a directory -> look there
    if os.path.isdir(csv_path):
        search_dir = csv_path
    else:
        # If path exists as file -> return
        if os.path.isfile(csv_path):
            return csv_path
        # otherwise, take parent directory to search
        search_dir = os.path.dirname(csv_path) or "."

    pattern = os.path.join(search_dir, "History_*.csv")
    candidates = glob.glob(pattern)
    if not candidates:
        # also allow any .csv if no History_*.csv found
        candidates = glob.glob(os.path.join(search_dir, "*.csv"))
    if not candidates:
        raise FileNotFoundError(f"No CSV files found in {search_dir} (tried {pattern})")

    # pick the newest file by modification time
    candidates.sort(key=os.path.getmtime, reverse=True)
    chosen = candidates[0]
    logging.info(f"Resolved CSV path: {chosen} (searched: {search_dir})")
    return chosen
4. Carregamento e normalização dos dados de negociação
O módulo de carregamento utiliza pandas para ler o arquivo CSV e tenta converter os valores da coluna de tempo para o tipo datetime. Também garante a presença das colunas necessárias, como lucro, símbolo, saldo e equity, preenchendo valores padrão ou calculando os dados ausentes sempre que possível. Isso inclui, por exemplo, o cálculo de somas acumuladas para saldo e equity, quando necessário. Após a normalização, o DataFrame é ordenado cronologicamente, formando um conjunto de dados consistente para os cálculos analíticos e a geração dos gráficos.
def load_data(csv_path):
    """Load and validate CSV data, computing missing columns if necessary."""
    try:
        if not os.path.isfile(csv_path):
            logging.error(f"CSV file not found: {csv_path}")
            raise FileNotFoundError(f"CSV file not found: {csv_path}")
        # try parsing Time; if fails, read without parse and try to coerce later
        try:
            df = pd.read_csv(csv_path, parse_dates=["Time"])
        except Exception:
            df = pd.read_csv(csv_path)
            if "Time" in df.columns:
                df["Time"] = pd.to_datetime(df["Time"], errors="coerce")
        # Provide minimal defaults if columns missing
        if "Profit" not in df.columns:
            df["Profit"] = 0.0
        if "Symbol" not in df.columns:
            df["Symbol"] = "N/A"
        required_cols = ["Time", "Symbol", "Profit", "Balance", "Equity"]
        for col in required_cols:
            if col not in df.columns:
                logging.warning(f"Missing column: {col}. Attempting to compute.")
                if col == "Balance":
                    # create cumsum of profit + commission + swap if possible
                    df["Commission"] = df.get("Commission", 0)
                    df["Swap"] = df.get("Swap", 0)
                    df["Balance"] = (df["Profit"] + df["Commission"] + df["Swap"]).cumsum()
                elif col == "Equity":
                    df["Equity"] = df.get("Balance", df["Profit"].cumsum())
        # ensure Time column exists and is sorted
        if "Time" in df.columns:
            df = df.sort_values(by="Time")
        return df
    except Exception as e:
        logging.error(f"Error loading CSV: {e}")
        raise
5. Cálculo de estatísticas e indicadores
Na etapa compute_stats, são calculados os principais indicadores do relatório, relevantes tanto para o EA quanto para o usuário: a data do relatório em formato de texto, o lucro líquido, o número total de negócios, o instrumento de melhor desempenho (com base no lucro acumulado), o drawdown máximo calculado a partir da curva de equity e uma estimativa simplificada do índice de Sharpe. Esses valores são reunidos em um dicionário de estatísticas e posteriormente incorporados aos templates HTML e às páginas do PDF, oferecendo um resumo dos resultados.
def compute_stats(df):
    """Compute trading statistics from the DataFrame."""
    try:
        top_symbol = None
        try:
            top_symbol = df.groupby("Symbol")["Profit"].sum().idxmax()
        except Exception:
            top_symbol = "N/A"
        eq = df.get("Equity")
        if eq is None:
            eq = df.get("Balance", df["Profit"].cumsum())
        max_dd = float((eq.cummax() - eq).max()) if len(eq) > 0 else 0.0
        sharpe = 0.0
        if len(df) > 1 and "Profit" in df.columns:
            dif = df["Profit"].diff().dropna()
            if dif.std() != 0:
                sharpe = float((dif.mean() / dif.std()) * np.sqrt(252))
        stats = {
            "date": datetime.now().strftime("%Y-%m-%d"),
            "net_profit": float(df["Profit"].sum()) if "Profit" in df.columns else 0.0,
            "trade_count": int(len(df)),
            "top_symbol": top_symbol,
            "max_drawdown": max_dd,
            "sharpe_ratio": sharpe
        }
        return stats
    except Exception as e:
        logging.error(f"Error computing stats: {e}")
        raise
6. Geração do gráfico: curvas de equity e saldo
O script utiliza matplotlib para gerar um gráfico da curva de equity em formato PNG. Quando existem marcas de tempo disponíveis, o gráfico apresenta a evolução do saldo e do equity ao longo do tempo. Caso contrário, utiliza os índices dos registros no eixo horizontal para representar os valores de saldo e equity. O arquivo PNG gerado é salvo no diretório especificado por --outdir e, posteriormente, referenciado no template HTML ou incorporado ao arquivo PDF, oferecendo ao leitor uma visão gráfica do desempenho da conta na janela de relatórios.
# Generate equity curve plot
curve_image = os.path.join(args.outdir, f"equity_curve_{stats['date']}.png")
plt.figure()
# handle possibility of NaT in Time
if "Time" in df.columns and not df["Time"].isnull().all():
    plt.plot(df["Time"], df["Balance"], label="Balance")
    plt.plot(df["Time"], df["Equity"], label="Equity")
else:
    # fallback: plot index vs balance/equity
    plt.plot(df.index, df["Balance"], label="Balance")
    plt.plot(df.index, df["Equity"], label="Equity")
plt.title("Balance & Equity Curve")
plt.legend()
plt.tight_layout()
plt.savefig(curve_image)
plt.close()
logging.info(f"Equity curve saved: {curve_image}")
7. Renderização de HTML com Jinja2
Quando a geração de HTML é solicitada, ou quando esse formato é necessário como arquivo intermediário, o script utiliza Jinja2 para renderizar o template report_template.html. O template recebe o dicionário de estatísticas, um resumo dos lucros por símbolo e o nome do arquivo que contém a imagem da curva de equity. O HTML gerado é salvo no diretório de saída, e essa operação é registrada no log. Esse arquivo HTML pode ser utilizado como relatório final ou servir de entrada para ferramentas de conversão de HTML em PDF.
def render_html(df, stats, outpath, curve_image):
    """Render the HTML report using a Jinja2 template."""
    try:
        env = Environment(loader=FileSystemLoader(os.path.dirname(__file__)))
        tmpl_path = os.path.join(os.path.dirname(__file__), "report_template.html")
        if not os.path.isfile(tmpl_path):
            logging.error(f"Template not found: {tmpl_path}")
            raise FileNotFoundError(f"Missing template: {tmpl_path}")
        tmpl = env.get_template("report_template.html")
        html = tmpl.render(stats=stats, symbol_profits=df.groupby("Symbol")["Profit"].sum().to_dict(), curve_image=curve_image)
        os.makedirs(os.path.dirname(outpath), exist_ok=True)
        with open(outpath, "w", encoding="utf-8") as f:
            f.write(html)
        logging.info(f"HTML written: {outpath}")
    except Exception as e:
        logging.error(f"Error rendering HTML: {e}")
        raise
8. Geração de arquivos PDF com diferentes backends
O script oferece três métodos de geração de PDF e seleciona um deles de acordo com o argumento --pdf-backend e a disponibilidade das ferramentas instaladas:
- WeasyPrint: converte o HTML renderizado diretamente em PDF (HTML → PDF) utilizando a biblioteca WeasyPrint, quando disponível.
- wkhtmltopdf (pdfkit): também converte HTML em PDF, utilizando o executável wkhtmltopdf, desde que esteja devidamente configurado.
- FPDF: oferece uma alternativa inteiramente em Python, que gera o PDF por meio de código e incorpora gráficos e tabelas de dados, sem depender da renderização de HTML/CSS. Esse método permite criar relatórios PDF de várias páginas em formato A4, com capa, seções de indicadores principais, gráfico de equity, tabelas de lucro por símbolo e uma amostra das operações mais recentes.
def convert_pdf_weasy(html_path, pdf_path):
    if not WEASY_AVAILABLE:
        raise RuntimeError("WeasyPrint backend requested but weasyprint is not available.")
    os.makedirs(os.path.dirname(pdf_path), exist_ok=True)
    HTML(html_path).write_pdf(pdf_path)
    logging.info(f"PDF written: {pdf_path}")

def convert_pdf_wkhtml(html_path, pdf_path, wk_path=None):
    if not PDFKIT_AVAILABLE:
        raise RuntimeError("wkhtmltopdf/pdfkit backend requested but pdfkit is not available.")
    config = None
    if wk_path and os.path.isfile(wk_path):
        config = pdfkit.configuration(wkhtmltopdf=wk_path)
    pdfkit.from_file(html_path, pdf_path, configuration=config)
    logging.info(f"PDF written: {pdf_path}")

def convert_pdf_with_fpdf(df, stats, curve_image_path, pdf_path):
    if not FPDF_AVAILABLE:
        raise RuntimeError("FPDF backend requested but fpdf is not installed.")
    pdf = FPDF(orientation='P', unit='mm', format='A4')
    pdf.set_auto_page_break(auto=True, margin=15)
    pdf.add_page()
    pdf.set_font("Arial", "B", 16)
    pdf.cell(0, 8, f"Trading Report - {stats.get('date','')}", ln=True, align='C')
    # ... add stats, insert curve image and tables ...
    if curve_image_path and os.path.isfile(curve_image_path):
        try:
            pdf.image(curve_image_path, x=10, y=None, w=190)
        except Exception as e:
            logging.warning(f"Could not insert curve image into PDF: {e}")
    pdf.output(pdf_path)
    logging.info(f"PDF written: {pdf_path}")
Cada backend salva o arquivo final Report_YYYY-MM-DD.pdf no diretório de saída configurado e registra a conclusão da geração no log.
9. Envio de e-mails
Quando o parâmetro --email está ativado, o script utiliza uma rotina auxiliar para enviar os arquivos de relatório gerados ao destinatário configurado, por meio de uma biblioteca de e-mail disponível. A rotina registra se o envio foi bem-sucedido, e essa informação é posteriormente incluída no arquivo JSON de resultado, permitindo que o EA determine se o e-mail foi enviado durante aquela execução.
def send_email(files, stats):
    """Send the generated reports via email."""
    try:
        if not YAGMAIL_AVAILABLE:
            logging.error("yagmail not available; cannot send email. Install yagmail or remove --email flag.")
            return
        user = os.getenv("Your YAGMAIL ACCOUNT")
        pw = os.getenv("Your Email password")
        if not user or not pw:
            logging.error("Email credentials not set in environment variables (YAGMAIL_USERNAME, YAGMAIL_PASSWORD).")
            return
        yag = yagmail.SMTP(user, pw)
        subject = f"Trading Report {stats['date']}"
        contents = [f"See attached report for {stats['date']}"] + files
        yag.send(to=user, subject=subject, contents=contents)
        logging.info("Email sent.")
    except Exception as e:
        logging.error(f"Error sending email: {e}")
10. Geração do JSON de resultado para comunicação com o EA
Após gerar os arquivos de saída, o script prepara um arquivo JSON compacto, estruturado para leitura automática, contendo os campos pdf_path, html_path, email_sent, uma marca de tempo e exit_code. O JSON é gravado de forma atômica, primeiro em um arquivo temporário e depois por meio de uma operação de renomeação, no diretório definido por --outdir, com o nome report_result_YYYY-MM-DD.json. Como a gravação é atômica, o EA pode verificar com segurança a existência desse arquivo como um sinal confiável de que o processamento pelo Python foi concluído. Em seguida, pode ler seu conteúdo para identificar os caminhos exatos dos arquivos gerados e verificar se o e-mail foi enviado.
def write_result_json(outdir, pdf_path=None, html_path=None, email_sent=False, exit_code=0):
    """Write a small JSON file with the report result so MQL5 can poll/verify."""
    import json, tempfile
    try:
        result = {
            "pdf_path": pdf_path or "",
            "html_path": html_path or "",
            "email_sent": bool(email_sent),
            "timestamp": datetime.now().isoformat(),
            "exit_code": int(exit_code)
        }
        os.makedirs(outdir, exist_ok=True)
        fname = os.path.join(outdir, f"report_result_{datetime.now().strftime('%Y-%m-%d')}.json")
        # atomic write
        fd, tmp = tempfile.mkstemp(prefix="._report_result_", dir=outdir, text=True)
        with os.fdopen(fd, "w", encoding="utf-8") as f:
            json.dump(result, f, indent=2)
        os.replace(tmp, fname)
        logging.info(f"Result JSON written: {fname}")
        return fname
    except Exception as e:
        logging.error(f"Failed to write result JSON: {e}")
        return None
11. Fluxo principal de execução
A função main() coordena todas as etapas: faz o parsing dos argumentos da linha de comando, identifica o arquivo CSV de entrada e processa seus dados, carregando-os e normalizando-os, calcula as estatísticas, gera o gráfico de equity, renderiza o HTML quando solicitado, gera os arquivos PDF utilizando o backend selecionado, envia o e-mail quando necessário, remove relatórios antigos do diretório de saída, grava o resultado em JSON e encerra a execução com um código que indica sucesso ou falha. A sequência dessas etapas e o registro das mensagens no log permitem que o EA responsável por iniciar o script acompanhe o andamento da execução pelo arquivo python_run.log e reaja ao resultado registrado em report_result_...json.
def main():
    """Main function to generate reports."""
    args = parse_args()
    try:
        # Ensure output directory exists
        os.makedirs(args.outdir, exist_ok=True)

        # Resolve csv_path in case a folder or variable-name was provided
        try:
            csv_path_resolved = resolve_csv_path(args.csv_path)
        except FileNotFoundError as e:
            logging.error(str(e))
            return 1

        # Load data and compute stats
        df = load_data(csv_path_resolved)
        stats = compute_stats(df)

        # Generate equity curve plot
        curve_image = os.path.join(args.outdir, f"equity_curve_{stats['date']}.png")
        # ... plotting code ...

        base = os.path.join(args.outdir, f"Report_{stats['date']}")
        files_out = []

        # Generate HTML report (if requested or needed by PDF backend)
        html_path = base + ".html"
        if "html" in args.formats:
            render_html(df, stats, html_path, os.path.basename(curve_image))
            files_out.append(html_path)

        # Decide PDF backend and generate PDF
        backend = args.pdf_backend.lower() if hasattr(args, "pdf_backend") else "fpdf"
        if "pdf" in args.formats:
            pdf_path = base + ".pdf"
            if backend == "weasyprint":
                convert_pdf_weasy(html_path, pdf_path)
            elif backend == "wkhtmltopdf":
                convert_pdf_wkhtml(html_path, pdf_path, wk_path=os.getenv("WKHTMLTOPDF_PATH"))
            elif backend == "fpdf":
                convert_pdf_with_fpdf(df, stats, curve_image, pdf_path)
            files_out.append(pdf_path)

        # Send email if enabled
        if args.email:
            send_email(files_out, stats)

        # write result JSON for MQL5
        pdf_file = next((f for f in files_out if f.endswith(".pdf")), "")
        html_file = next((f for f in files_out if f.endswith(".html")), "")
        write_result_json(args.outdir, pdf_path=pdf_file, html_path=html_file,
                          email_sent=args.email, exit_code=0)

        return 0

    except Exception as e:
        logging.error(f"Main execution error: {e}")
        traceback.print_exc()
        try:
            write_result_json(args.outdir, exit_code=1)
        except:
            pass
        return 1

if __name__ == "__main__":
    sys.exit(main())
12. Tratamento de erros e geração garantida do JSON em caso de falha
Na função main(), as exceções são capturadas no nível mais externo. Assim, caso ocorra algum erro não tratado nas etapas internas, o script registra o traceback e ainda gera o arquivo report_result_YYYY-MM-DD.json, com exit_code indicando a falha. Isso garante que o EA receba um objeto JSON com estrutura determinística para verificar se a execução foi bem-sucedida ou terminou com erro, simplificando sua lógica de validação e os mecanismos alternativos de recuperação.
except Exception as e:
    logging.error(f"Main execution error: {e}")
    traceback.print_exc()
    # ensure a JSON is still written so MQL5 knows it failed
    try:
        write_result_json(args.outdir, exit_code=1)
    except:
        pass
    return 1
13. Política de limpeza e retenção de arquivos
Ao final de uma execução bem-sucedida, o script realiza uma limpeza do diretório de saída, removendo os arquivos antigos com o prefixo Report_ que ultrapassaram o período de retenção configurável (atualmente definido como 30 dias). Isso mantém o diretório de saída organizado e evita o crescimento descontrolado do espaço ocupado em disco nos sistemas que geram relatórios com frequência.
# Clean up old reports (older than 30 days)
cutoff = datetime.now() - timedelta(days=30)
for f in os.listdir(args.outdir):
    if f.startswith("Report_") and f.endswith(tuple(args.formats)):
        full = os.path.join(args.outdir, f)
        if datetime.fromtimestamp(os.path.getmtime(full)) < cutoff:
            os.remove(full)
            logging.info(f"Deleted old file: {full}")
Como o EA e o script Python se integram durante a execução
A comunicação entre os componentes durante a execução é simples: o EA exporta o arquivo CSV e inicia o script Python, passando o caminho do CSV, o parâmetro --outdir e os demais parâmetros opcionais. O script processa o CSV e salva os arquivos gerados (PNG e PDF) no diretório de saída. Por último, grava o arquivo report_result_YYYY-MM-DD.json. O EA verifica periodicamente a existência desse arquivo JSON e, quando ele está disponível, lê seu conteúdo, valida os caminhos informados e os tamanhos dos arquivos e executa as ações seguintes, como enviar notificações, arquivar os relatórios e confirmar o envio por e-mail. Juntos, o arquivo de log python_run.log e o resultado em JSON estabelecem uma interface confiável e legível por máquina entre os dois componentes.
Testes
Os testes são realizados por meio da implantação do EA na plataforma MetaTrader 5, enquanto o script Python é iniciado e executado em segundo plano. Podemos acompanhar os resultados pelo log da aba Experts do terminal e verificar se os arquivos foram gerados nos diretórios de saída configurados. Durante meu teste, encontrei um relatório chamado Report_2025-08-21. Seu conteúdo é muito mais completo do que o das versões anteriores. Agora, o relatório inclui tabelas bem estruturadas, curvas de equity e diversos indicadores calculados, apresentados de maneira clara e organizada para oferecer informações úteis à análise dos traders. As capturas de tela abaixo mostram os arquivos de relatório gerados e parte do conteúdo do PDF.
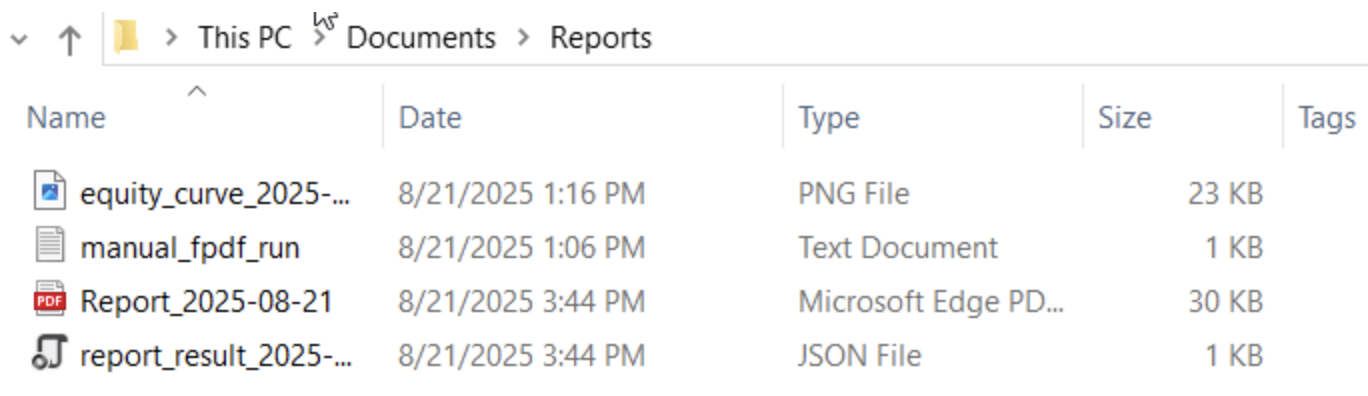
Figura 4: Arquivos de saída visualizados no Explorador de Arquivos do Windows
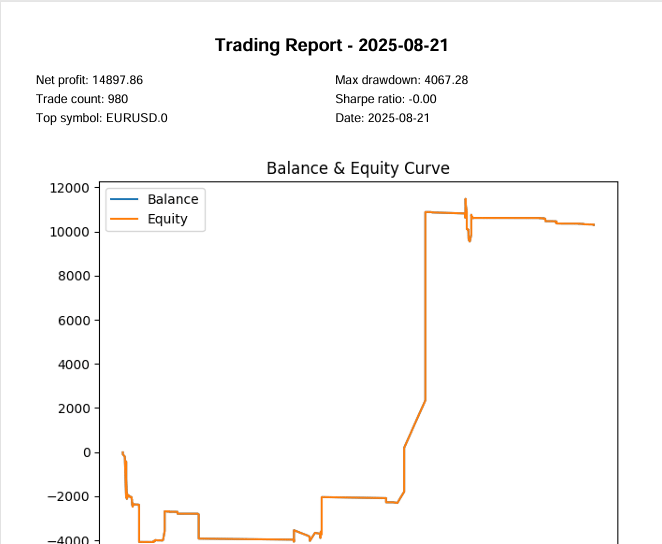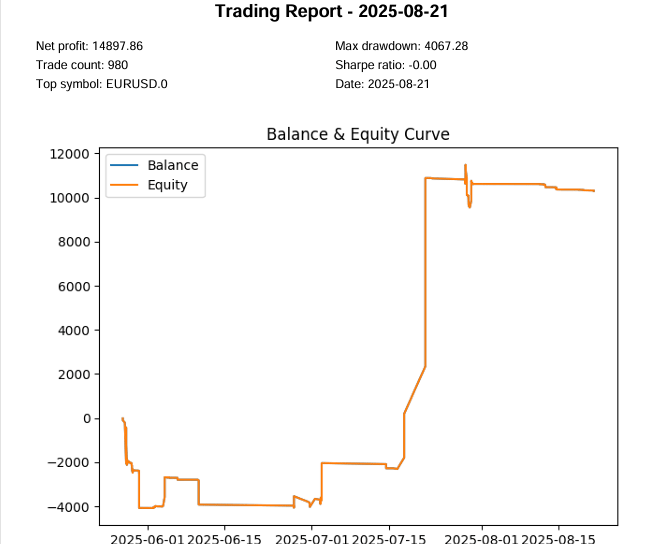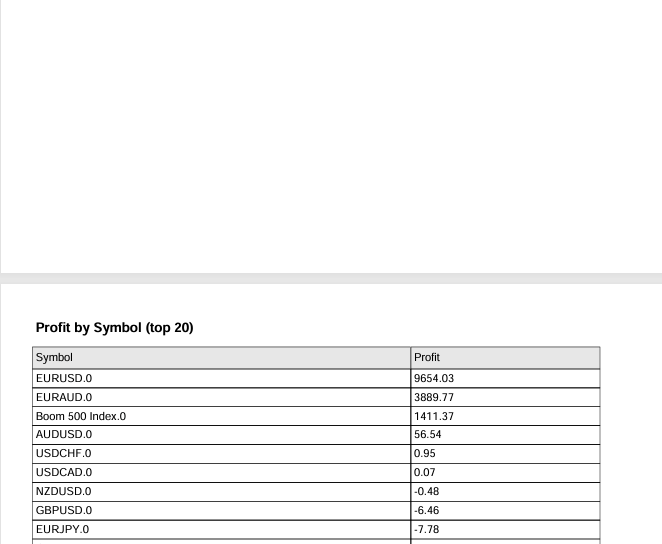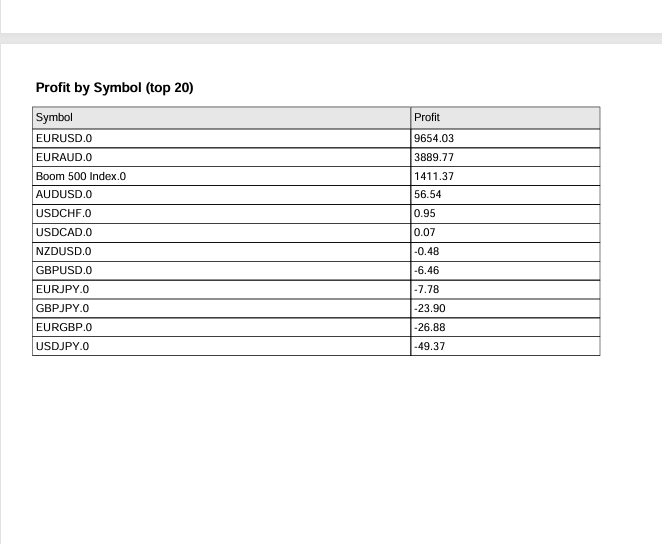
Figura 5: Captura de tela animada dos relatórios em PDF gerados
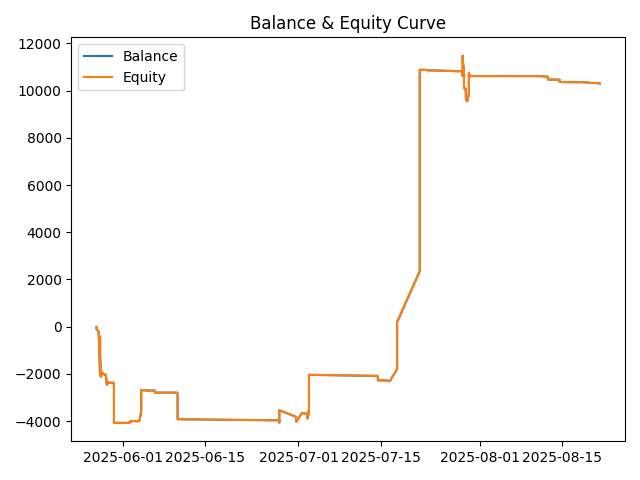
Figura 6: Curva de equity apresentada nos relatórios
Conclusão
Demonstramos como integrar MQL5 e Python para gerar relatórios de negociação com recursos avançados, que vão muito além dos resultados básicos oferecidos pela versão anterior do EA Reporting EA. Um dos principais destaques é a geração automática do gráfico de equity, que mostra a evolução do saldo e do equity ao longo do tempo, permitindo que os traders visualizem rapidamente o desempenho da conta. O sistema comprova que é possível conectar um EA a um mecanismo externo de geração de relatórios desenvolvido em Python e mostra como essa integração pode ser aprimorada e ampliada futuramente.
Ao aprimorar continuamente o código do EA e aproveitar bibliotecas avançadas do Python, como Pandas, Matplotlib e FPDF, podemos calcular estatísticas mais completas, gerar tabelas informativas e incorporar visualizações claras aos relatórios. A implementação de uma comunicação simplificada por JSON entre o EA e o script Python permite validar com segurança os arquivos gerados, tornando o fluxo de trabalho mais fluido e transparente. Além disso, recursos opcionais, como o envio automático por e-mail e a possibilidade de utilizar diferentes backends de PDF, demonstram a flexibilidade da solução para funcionar em diversos ambientes.
Esse desenvolvimento estabelece uma base sólida para soluções de geração de relatórios a longo prazo. Os documentos produzidos podem servir como ferramentas abrangentes de análise do desempenho das negociações, ajudando traders e investidores a identificar tendências no mercado à vista, avaliar riscos, como os drawdowns, e analisar suas estratégias com maior clareza. Em última análise, o EA Reporting EA, em conjunto com o script reports_processor.py, demonstra como a integração entre linguagens pode ampliar a automação, melhorar a tomada de decisões e abrir caminho para análises ainda mais avançadas no futuro.
Principais lições
| Lição principal | Descrição: |
|---|---|
| Verifique as dependências externas durante a inicialização. | Sempre verifique os caminhos das ferramentas e dos diretórios externos (executável do Python, caminho do script e diretório de saída) durante a execução de OnInit, utilizando verificações dos atributos dos arquivos. A validação antecipada com GetFileAttributesW evita falhas difíceis de diagnosticar durante a execução. |
| Prefira confirmações legíveis por máquina (JSON). | Utilize um pequeno arquivo de resultados estruturado em JSON como sinal canônico de confirmação enviado pelo Python ao MQL5, em vez de interpretar logs sem formato definido. Isso torna a validação determinística e permite automatizá-la por código. |
| Grave os arquivos de resultado de forma atômica. | Primeiro, grave o JSON em um arquivo temporário e depois renomeie ou substitua o arquivo de destino por meio de uma operação atômica. Isso evita leituras parciais enquanto o EA verifica se o processamento foi concluído. |
| Considere as restrições de caminhos absolutos no MQL5. | A função FileOpen do MQL5 frequentemente não consegue acessar arquivos por caminhos absolutos arbitrários. Implemente um mecanismo alternativo: copie o arquivo para MQL5\Files ou utilize a função ReadFile da API do Windows para que o EA consiga acessar os dados gerados de maneira confiável. |
| Implemente verificações confiáveis da existência e do tamanho dos arquivos. | Não presuma que a existência de um arquivo significa que sua gravação foi concluída. Verifique seus atributos e tamanho, abrindo-o e posicionando o cursor no final, para confirmar que o relatório ou arquivo binário foi completamente gravado antes de utilizá-lo. |
| Utilize nomes de arquivo exclusivos para evitar conflitos. | Gere nomes para os arquivos CSV e relatórios que incluam marcas de tempo e sufixos aleatórios. Isso evita que execuções repetidas sobrescrevam os resultados anteriores e preserva os arquivos históricos para fins de auditoria. |
| Mantenha a exportação de CSV consistente com os requisitos do Python. | Defina as colunas do CSV, incluindo cabeçalhos, formatos e representação de data e hora, de acordo com o que o script Python espera receber. Uma estrutura de exportação padronizada elimina ambiguidades na interpretação dos dados e reduz os erros de processamento. |
| Centralize as funções auxiliares. | Mantenha as rotinas de normalização de caminhos, verificação da existência de arquivos, extração de valores JSON e os pequenos wrappers de leitura e gravação em um local centralizado. Assim, todos os componentes do EA podem reutilizar a mesma lógica confiável, como CleanPath, FileExists e ReadTerminalLogFile. |
| Implemente verificações periódicas com limites de tempo adequados. | Ao aguardar a conclusão de um processo externo, utilize um laço de verificação periódica com intervalos curtos e um tempo limite total. Isso permite equilibrar a capacidade de resposta com o consumo de CPU, além de evitar esperas indefinidas. |
| Implemente mecanismos alternativos e validação em várias camadas. | Estruture a validação em etapas: dê prioridade à confirmação por JSON; se ela não estiver disponível, verifique a conclusão da execução pelo arquivo python_run.log; caso essa alternativa também falhe, procure periodicamente o arquivo PDF esperado. Dispor de diferentes mecanismos de validação aumenta a confiabilidade do sistema. |
| Registre informações detalhadas e disponibilize mensagens de diagnóstico. | Produza registros informativos no log e apresente as entradas completas do log do Python na aba Experts do terminal. Mensagens de diagnóstico claras facilitam a identificação e a correção de problemas durante a operação em ambiente real. |
| Nunca inclua credenciais diretamente no código. | Mantenha as informações confidenciais fora do código-fonte. Utilize variáveis de ambiente para armazenar as credenciais de e-mail e documente quais variáveis precisam ser configuradas. Essa prática aumenta a segurança e facilita a portabilidade da solução. |
| Ofereça suporte a diferentes backends de PDF e detecte sua disponibilidade. | Desenvolva o script Python de modo que ele não dependa de um único backend. Detecte a disponibilidade de WeasyPrint, wkhtmltopdf/pdfkit e da alternativa inteiramente em Python com fpdf, selecionando a melhor opção disponível durante a execução. |
| Utilize ambientes virtuais e documente a configuração. | Documente um procedimento reproduzível de configuração no Windows, incluindo a versão do Python, a criação do ambiente virtual, a lista de pacotes a instalar com pip e os requisitos específicos dos backends opcionais. Isso torna a implantação mais previsível. |
| Realize um teste de fumaça de ponta a ponta. | Execute um teste rápido de todo o fluxo: coloque o EA em funcionamento, faça a exportação do CSV, execute o script Python e verifique o log da aba Experts e o diretório de saída para confirmar a presença dos arquivos PDF e JSON. Os testes de fumaça permitem validar rapidamente o funcionamento básico da integração antes de realizar verificações de qualidade mais abrangentes. |
| Garanta a geração de resultados JSON com estrutura determinística em caso de falha. | Sempre que ocorrer uma exceção, grave um resultado JSON com o campo exit_code e as informações de diagnóstico. Isso garante que o EA consiga identificar as falhas e acionar os mecanismos alternativos de recuperação, em vez de permanecer aguardando indefinidamente. |
Anexos
| Nome do arquivo | Versão | Descrição |
|---|---|---|
| Reporting_EA.mq5 | 1.01 | EA que exporta o histórico de negociações para arquivos CSV com nomes exclusivos, executa o script Python de geração de relatórios e valida os resultados. Seus recursos incluem normalização de caminhos, verificação de dependências, geração de nomes de arquivo exclusivos, comunicação com o Python por meio de JSON, mecanismo alternativo que copia arquivos JSON para MQL5\Files para leitura quando não for possível acessá-los por caminhos absolutos, verificação periódica do PDF como alternativa, registros detalhados no log da aba Experts e notificações push opcionais. |
| Reports_processor.py | 1.0.1 | Sistema de geração de relatórios em Python que processa o arquivo CSV exportado pelo EA, calcula indicadores analíticos (lucro líquido, drawdown, índice de Sharpe e resultados agregados por símbolo), gera gráficos e produz relatórios em HTML e/ou PDF, com suporte a diferentes backends (fpdf, wkhtmltopdf e WeasyPrint). Também permite o envio opcional por e-mail e grava atomicamente o arquivo report_result_YYYY-MM-DD.json, utilizado para sinalizar o resultado da execução e confirmar a comunicação com o EA. Inclui ainda a remoção de relatórios antigos conforme a política de retenção e um tratamento robusto de erros, que garante a geração do JSON de resultado mesmo em caso de falha. |
Traduzido do Inglês pela MetaQuotes Ltd.
Artigo original: https://www.mql5.com/en/articles/19006
Aviso: Todos os direitos sobre esses materiais pertencem à MetaQuotes Ltd. É proibida a reimpressão total ou parcial.
Esse artigo foi escrito por um usuário do site e reflete seu ponto de vista pessoal. A MetaQuotes Ltd. não se responsabiliza pela precisão das informações apresentadas nem pelas possíveis consequências decorrentes do uso das soluções, estratégias ou recomendações descritas.


