

Recursos do Assistente MQL5 que você precisa conhecer (Parte 79): Uso dos osciladores Gator e A/D no aprendizado supervisionado
 46
 0

Introdução
Nos dois artigos anteriores, testamos, como de costume, dez padrões de sinal utilizando os osciladores Gator e Acumulação/Distribuição. Assim como em estudos anteriores, identificamos três padrões com desempenho consistentemente inferior: 0, 3 e 4. Em vez de descartá-los, vamos investigar se o aprendizado supervisionado pode melhorar seus resultados. Para isso, utilizaremos uma CNN combinada com regressão por kernel e similaridade baseada no produto escalar, avaliando se essa arquitetura consegue revelar o potencial oculto de sinais que, à primeira vista, parecem pouco promissores. Assim como nos dois artigos anteriores, todos os testes serão realizados no par GBP/JPY, no timeframe de 30 minutos.
Regressão por kernel com similaridade baseada no produto escalar
Como modelo de aprendizado supervisionado, escolhemos uma CNN que utiliza regressão por kernel e similaridade baseada no produto escalar. A regressão por kernel estima as representações de saída de cada camada da CNN, atribuindo pesos aos dados de entrada observados conforme seu grau de similaridade com um determinado ponto de consulta. Essa similaridade é quantificada por meio do produto escalar, utilizado como função kernel. Em nosso modelo, cujo código será apresentado na próxima seção, o método _dot_product_kernel_regression calcula a similaridade entre todas as posições temporais do mapa de características por meio da operação torch.bmm(x, x.T). Em seguida, o resultado é normalizado com Softmax, de maneira bastante semelhante ao mecanismo de autoatenção.
O produto escalar funciona como uma medida de similaridade adaptativa aos dados: um valor elevado indica que duas posições apresentam o mesmo padrão de ativação ao longo dos canais e, portanto, exercem maior influência sobre a soma ponderada. Podemos visualizar esse mecanismo da seguinte forma: cada posição recebe "votos" em quantidade proporcional à sua similaridade com a posição de consulta. Uma camada da CNN pode ser representada como uma tabela cujas linhas correspondem aos passos temporais e cujas colunas representam as características. Nesse modelo, cada linha corresponde a uma "posição". Assim, a "posição de consulta" é a linha atual, cujos valores estão sendo atualizados. Durante essa atualização, a linha é comparada com todas as demais posições para quantificar o grau de similaridade entre elas. Essas atualizações ocorrem durante a retropropagação do erro.
Matematicamente, os novos pesos podem ser definidos da seguinte forma. Para os vetores de características xi e xj, o peso wij é calculado por:
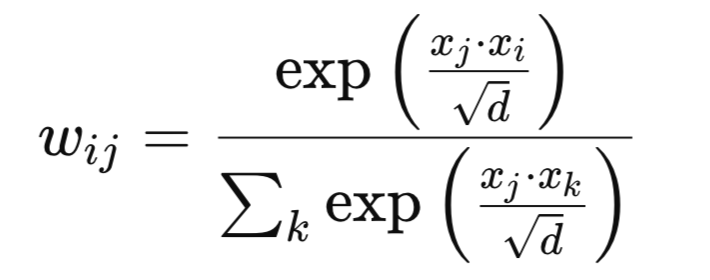
Em que:
- d: dimensão dos canais;
- exp: função exponencial.
Nossa matriz de pesos realiza uma suavização não local ao longo de toda a sequência, sem se restringir às posições vizinhas, como ocorre na convolução. Isso permite que o modelo identifique dependências de longo alcance e correlações no espaço de características, o que pode melhorar o desempenho em tarefas envolvendo séries temporais e dados estruturados. A similaridade baseada no produto escalar é especialmente útil quando existem correlações relevantes entre características não adjacentes e precisamos de um mecanismo semelhante ao de atenção, mas sem adicionar projeções de consulta, chave e valor. Essa abordagem funciona particularmente bem em conjunto com uma CNN: enquanto a rede extrai características locais, a regressão por kernel incorpora o contexto global.
Seleção dos tamanhos dos kernels e da quantidade de canais da CNN com base na similaridade por produto escalar
A regressão por kernel baseada no produto escalar permite identificar onde as correlações são mais fortes e em quais escalas de resolução elas se manifestam. Ajustar os tamanhos dos kernels e a quantidade de canais da CNN de acordo com a estrutura de similaridade oferece duas vantagens. Primeiro, permite adequar os campos receptivos ao comprimento de correlação. Isso é especialmente relevante para kernels maiores, quando a similaridade permanece elevada mesmo entre posições distantes. Segundo, permite definir a quantidade de canais conforme a complexidade das correlações. Quando os padrões de similaridade apresentam diferenças significativas, são utilizados mais canais; quando são mais homogêneos, menos canais podem ser suficientes. Dessa forma, podemos obter uma arquitetura adaptada tanto aos dados quanto às características da tarefa, em vez de depender de heurísticas fixas.
Em nossa implementação, cujo código será apresentado nas próximas seções, os tamanhos dos kernels variam ciclicamente na sequência [3, 5, 7, 9], enquanto a quantidade de canais aumenta de 32 para 320. A regressão baseada no produto escalar é aplicada em camadas alternadas, permitindo que elas tenham acesso a mapas globais de correlação. Se os mapas de similaridade apresentarem picos largos, podemos utilizar kernels maiores nas camadas convolucionais seguintes. Se apresentarem picos estreitos e bem definidos, kernels menores podem ser suficientes, permitindo concentrar o processamento em refinamentos locais. Essa abordagem pode ser entendida como um ajuste adaptativo do campo receptivo orientado por um sinal global de correlação.
Ao aplicar essa abordagem a uma CNN, é recomendável primeiro processar os dados com uma CNN pequena e um bloco de regressão por kernel baseada no produto escalar. A análise do comprimento das correlações pode servir de base para definir os tamanhos dos kernels e a quantidade de canais da CNN principal. Além disso, nas primeiras camadas, é preferível utilizar kernels menores para detectar bordas e padrões locais, enquanto os tamanhos dos kernels das camadas seguintes podem ser definidos de acordo com a largura observada na distribuição de similaridade.
Possíveis limitações e alternativas
A principal limitação do kernel baseado no produto escalar que utilizamos é bastante previsível: o alto custo computacional. O cálculo da similaridade por produto escalar tem complexidade computacional O(L²), em que L representa o comprimento da sequência. Para sinais longos ou conjuntos extensos de características de entrada, isso pode exigir muitos recursos computacionais. Outro problema é a suavização excessiva. Quando os pesos apresentam uma distribuição muito uniforme, as características podem se tornar homogêneas demais, causando a perda de detalhes mais sutis. Há também o risco de instabilidade durante o treinamento. Quando os valores de similaridade são elevados, a ausência de normalização pode provocar um crescimento explosivo dos pesos. Por fim, o armazenamento da matriz completa de similaridade pode exigir uma quantidade excessiva de memória.
Esses problemas, porém, podem ser atenuados, por exemplo, com o uso de janelas locais de atenção. Em vez de calcular a similaridade entre todas as posições, operação que apresenta a complexidade computacional mencionada anteriormente, as comparações ficam restritas a uma janela fixa ao redor de cada posição de consulta. Isso reduz o custo computacional e o consumo de memória, concentrando o processamento no contexto local mais relevante. Outra possibilidade é utilizar o escalonamento por temperatura. Nesse caso, os valores de similaridade são multiplicados por 1/τ, em que τ representa a temperatura. Temperaturas mais baixas produzem pesos mais concentrados e seletivos, fazendo com que algumas posições ou linhas da camada exerçam maior influência. Já valores mais altos de τ resultam em uma distribuição de pesos mais suave e uniforme entre todas as posições da camada. A temperatura passa, assim, a ser um hiperparâmetro adicional.
Por fim, podemos aplicar uma subamostragem antes da regressão por kernel. Para isso, o comprimento L da sequência de dados de entrada é reduzido por meio de pooling ou convoluções com stride, antes do cálculo do produto escalar. A redução de L deve acelerar o cálculo da similaridade e diminuir o consumo de memória, preservando a capacidade de identificar correlações em escalas maiores.
Alternativas para aprimorar CNNs com base no produto escalar
Além da regressão por kernel baseada no produto escalar, podemos utilizar redes neurais convolucionais híbridas com mecanismos de autoatenção. Nessa configuração, a regressão baseada no produto escalar funciona como um bloco não local em conjunto com as camadas da CNN, em vez de atuar como uma camada de atenção convencional. Essa abordagem difere da nossa implementação, cujo código-fonte será apresentado na próxima seção, porque, em nosso modelo, a regressão por kernel é aplicada periodicamente ao longo da sequência de camadas convolucionais. Já na arquitetura híbrida, esse bloco é distribuído em ramos paralelos, cujas saídas são posteriormente combinadas. Outra alternativa é utilizar a regressão por kernel para realizar a fusão multiescala de características. Nesse caso, ela é aplicada às características extraídas de várias camadas da CNN, e os resultados são posteriormente reunidos. A diferença em relação à nossa abordagem é que, nela, a regressão por kernel é aplicada a apenas uma camada por vez. A fusão multiescala permite integrar o contexto global proveniente de diferentes camadas e níveis de resolução.
A regressão por kernel também poderia ser utilizada em tarefas pretextuais como forma de regularização. Nesse cenário, o modelo é treinado para resolver tarefas auxiliares a partir das saídas da regressão por kernel, além da tarefa principal, como prever o embedding do próximo passo temporal. Isso difere da abordagem apresentada a seguir: em nossa implementação, o kernel é utilizado apenas para refinar as características, enquanto, nesse cenário, também contribui para a regularização. Por fim, a regressão por kernel poderia ser aplicada a outra abordagem que exploramos em artigos anteriores: a seleção dinâmica do tamanho do kernel. Nesse método, as estatísticas de similaridade obtidas pela regressão por kernel são utilizadas para ajustar os tamanhos dos kernels convolucionais durante o treinamento e a inferência. Na implementação descrita a seguir, porém, esses tamanhos são definidos antecipadamente.
A rede
A seguir, apresentamos o código da classe da nossa rede, que implementa a regressão por kernel baseada no produto escalar:
class DotProductKernelRegressionConv1D(nn.Module):
    def __init__(self, input_length=100):
        super().__init__()
        self.input_length = input_length

        self.kernel_sizes, self.channels = self._design_architecture()

        self.conv_layers = nn.ModuleList()
        self.use_kernel_regression = []  # <-- Python list for markers

        in_channels = 1
        for i, (out_channels, kernel_size) in enumerate(zip(self.channels, self.kernel_sizes)):
            conv_layer = nn.Sequential(
                nn.Conv1d(in_channels, out_channels, kernel_size=kernel_size, padding=kernel_size // 2),
                nn.BatchNorm1d(out_channels),
                nn.ReLU(),
                nn.Dropout(0.2))
            self.conv_layers.append(conv_layer)

            self.use_kernel_regression.append(i % 2 == 0)
            in_channels = out_channels

        self.head = nn.Sequential(
            nn.AdaptiveAvgPool1d(1),
            nn.Flatten(),
            nn.Linear(in_channels, 128),
            nn.ReLU(),
            nn.Dropout(0.2),
            nn.Linear(128, 64),
            nn.ReLU(),
            nn.Linear(64, 1),
            nn.Sigmoid()
        )

    def _dot_product_kernel_regression(self, x):
        """
        Dot product kernel regression.
        For each time position, outputs a weighted sum of all positions using dot product similarity as weights.
        """
        # x: (B, C, L)
        x_ = x.permute(0, 2, 1)  # (B, L, C)
        # Dot product similarity
        sim = torch.bmm(x_, x_.transpose(1, 2))  # (B, L, L)
        # Optionally normalize for stability (like attention)
        weights = F.softmax(sim / (x_.size(-1) ** 0.5), dim=-1)  # (B, L, L)
        out = torch.bmm(weights, x_)  # (B, L, C)
        return out.permute(0, 2, 1)  # (B, C, L)

    def _design_architecture(self):
        num_layers = 10
        kernel_sizes = [3 + (i % 4) * 2 for i in range(num_layers)]
        channels = [32 * (i + 1) for i in range(num_layers)]
        return kernel_sizes, channels

    def forward(self, x):
        x = x.unsqueeze(1)  # (B, 1, L)
        for conv_layer, use_kr in zip(self.conv_layers, self.use_kernel_regression):
            x = conv_layer(x)
            if use_kr:
                x = self._dot_product_kernel_regression(x)
        return self.head(x)
No início do código apresentado acima, são definidos a estrutura básica da classe e seu construtor. A classe herda de nn.Module, permitindo o rastreamento dos parâmetros pelo PyTorch e o uso de métodos como .to(device), .eval(), entre outros. O valor de input_length é armazenado, embora as convoluções não dependam do comprimento da sequência de entrada. Isso é útil para verificações de consistência, exportação para ONNX e futuras implementações de lógica dependente do comprimento da sequência de entrada. Em seguida, passamos à definição da arquitetura, especificando os tamanhos dos kernels convolucionais e a quantidade de canais. Essa etapa é importante porque concentra em um único ponto tanto a configuração dos campos receptivos, determinada pelos tamanhos dos kernels, quanto o dimensionamento da capacidade da rede, representado aqui pela quantidade de canais. Essa centralização oferece duas vantagens. Primeiro, permite adequar os tamanhos dos kernels ao comportamento de decaimento da similaridade observado na regressão por kernel. Segundo, facilita o dimensionamento da rede para representar padrões de similaridade mais complexos.
Ao desenvolver a função _design_architecture, devemos orientar as escolhas arquiteturais pelos dados. Podemos analisar um lote de dados, medir o decaimento da similaridade no bloco de regressão e, com base nisso, aumentar os tamanhos dos kernels convolucionais. Além disso, podemos relacionar a quantidade de canais à entropia da distribuição de similaridade. Nesse caso, uma entropia mais elevada indicaria a necessidade de mais canais para representar a maior variabilidade dos dados.
Na sequência, o código define a sequência de camadas convolucionais e os marcadores que indicam em quais camadas a regressão por kernel é aplicada. Isso é importante porque ModuleList registra as camadas, permitindo salvar e carregar seus pesos. A escolha de um padding equivalente à metade do tamanho do kernel convolucional permite preservar praticamente todo o comprimento da sequência. Essa preservação é importante porque as etapas posteriores de regressão por kernel pressupõem que o comprimento da sequência permaneça constante.
A normalização por lote, a ativação ReLU e as camadas de dropout também contribuem para a estabilidade do modelo: a normalização por lote estabiliza o treinamento, a ReLU introduz não linearidade e o dropout atua como regularizador. O parâmetro booleano use_kernel_regression permite evitar a aplicação da regressão por kernel, que tem alto custo computacional, em todas as camadas, reservando-a apenas para aquelas em que oferece benefícios. Se a regressão por kernel exercer uma influência muito forte, podemos adicionar conexões residuais ao redor dos blocos conv_layer para facilitar a otimização.
Em seguida, definimos o bloco de saída responsável pela previsão. Essa sequência de camadas é importante porque reúne vários componentes essenciais. Primeiro, AdaptiveAvgPool1d(1) gera uma representação global resumida de cada canal, independentemente do comprimento da sequência. Isso é importante quando os dados de entrada têm comprimento variável. Em outras palavras, essa operação reduz a série temporal de cada canal a um único valor médio, produzindo um vetor de características de tamanho fixo. Assim, a saída da rede não depende do comprimento da sequência de entrada, o que é especialmente útil quando a quantidade de passos temporais varia entre as amostras.
A MLP transforma esse vetor resumido de características em um único valor escalar de saída. Essa configuração é adequada para regressão com valores entre 0.0 e 1.0. Por isso, faz sentido utilizar Sigmoid nesse caso. Para uma saída de regressão sem limites predefinidos, podemos optar por Identity; para classificação multiclasse, por LogSoftmax. Se for necessário distinguir direções, como posições compradas e vendidas, podemos substituir Sigmoid por uma estrutura de saída com duas cabeças. A primeira cabeça pode produzir uma saída probabilística usando Sigmoid, enquanto a segunda pode estimar a magnitude por meio da função de ativação Softplus. Se a interpretabilidade for importante, o vetor agregado também poderá ser utilizado para calcular a importância de cada canal.
Depois, definimos a função principal de regressão por kernel. Primeiro, permutamos os eixos do tensor de entrada x para obter o formato "tamanho do lote - quantidade de canais - comprimento da sequência". Em seguida, calculamos o produto escalar entre as representações das posições, considerando os valores de todos os canais. Assim, C, que representa a quantidade de canais, passa a ser a dimensão interna do cálculo. Construímos então a matriz não local de similaridade entre todas as posições, com complexidade computacional quadrática em relação ao comprimento da sequência. Essa matriz recebe o nome sim. Na sequência, calculamos os pesos dividindo os valores de sim pela raiz quadrada da quantidade de canais. Esse escalonamento evita que os logits atinjam valores excessivamente elevados à medida que a quantidade de canais aumenta. A função Softmax transforma os valores brutos de similaridade em uma distribuição de pesos normalizados, pertencente ao simplex de probabilidades. Dessa forma, a representação de cada posição passa a ser uma combinação convexa das representações de todas as posições. Na etapa seguinte, realizamos a regressão por kernel multiplicando esses pesos pelo tensor de entrada x transposto, com os eixos reorganizados. Com isso, cada posição incorpora informações de outras posições semelhantes ao longo de toda a janela.
Para sequências longas, podemos utilizar janelas locais ou um mecanismo de atenção bloco-diagonal, métodos de baixo posto, como Nyström ou Linformer, ou ainda aplicar subamostragem, executar a regressão por kernel e depois restaurar a resolução original. Em tarefas de previsão ou que exigem causalidade, adicionar uma máscara causal antes da aplicação de Softmax ajuda a evitar o vazamento de dados e o uso de informações futuras. Se houver sinais de suavização excessiva, podemos introduzir um hiperparâmetro de temperatura:
weights = F.softmax(sim / (tau * x_.size(-1) ** 0.5), dim=-1)

x = x + alpha * self._dot_product_kernel_regression(x)
A próxima função define a arquitetura do modelo. Ela faz os tamanhos dos kernels convolucionais variarem ciclicamente de 3 a 9, proporcionando uma cobertura multiescala para que cada etapa aproveite o contexto global fornecido pela regressão por kernel. O aumento linear da quantidade de canais amplia a capacidade das camadas mais profundas da rede, nas quais as características se tornam mais abstratas. É recomendável adaptar essa sequência à largura observada na distribuição de similaridade: quanto maior essa largura, maior deve ser a preferência por kernels convolucionais maiores nas camadas seguintes. A quantidade de canais não deve ser aumentada sem considerar os dados. Em vez disso, devemos monitorar a esparsidade das ativações e a entropia da regressão por kernel para alocar mais canais onde forem necessários.
A última função da classe da rede implementa a propagação para frente. Primeiro, adicionamos uma dimensão aos dados para adequá-los ao formato esperado "lote - canal - comprimento da sequência". Nas redes neurais convolucionais unidimensionais, a quantidade inicial de canais de entrada é igual a 1. A alternância entre convoluções locais e regressão por kernel global forma uma arquitetura eficiente. Após a detecção dos padrões locais, as informações são propagadas de acordo com as similaridades aprendidas. Em seguida, as camadas convolucionais posteriores refinam essas informações localmente. O retorno por meio de self.head() mantém o grafo da propagação para frente simples e facilita a exportação para ONNX e a implantação do modelo.
Para melhorar a propagação dos gradientes, podemos adicionar normalização por camada antes e depois da regressão por kernel ou das conexões residuais.
Implementação do indicador
Para utilizar os padrões de sinal dos dois artigos anteriores como dados de entrada do modelo de rede neural convolucional com regressão por kernel descrito acima, precisamos de uma implementação equivalente dos indicadores em Python. Existem vários módulos de indicadores prontos para Python, mas implementá-los do zero mostrou-se igualmente simples e nos permite controlar integralmente as decisões envolvidas no cálculo de seus valores. Como nos artigos anteriores, codificamos os valores dos indicadores como sinais de alta ou de baixa em um vetor bidimensional cujos elementos podem assumir apenas os valores 0 e 1. A regressão por kernel é especialmente útil nesse contexto, pois as características extraídas codificam padrões estruturais das barras e dos osciladores. Posições distantes que apresentam padrões semelhantes ou representações com alta similaridade pelo produto escalar podem reforçar umas às outras. Assim, a regressão por kernel (KR) permite que o modelo combine evidências estatísticas de trechos semelhantes da série temporal. Isso é particularmente valioso quando cada padrão, isoladamente, é relativamente raro ou pouco expressivo.
Além disso, aplicar a KR nas camadas iniciais ajuda a propagar os padrões mais simples pela rede. Já sua aplicação nas camadas posteriores permite combinar padrões de nível mais elevado. Vale testar a aplicação da KR em camadas menos profundas, com menos canais, e em camadas mais profundas, com mais canais.
Oscilador Gator
Essa função calcula os componentes do indicador Alligator de Bill Williams utilizando médias móveis suavizadas do preço mediano, com os respectivos deslocamentos para a frente das linhas "mandíbula", "dentes" e "lábios". Esse procedimento já foi abordado nos artigos anteriores. Geramos dois buffers: o primeiro contém o valor absoluto da diferença entre a "mandíbula" e os "dentes", identificado como "gator up"; o segundo contém o negativo do valor absoluto da diferença entre as médias móveis dos "dentes" e dos "lábios". Também adicionamos estados de cor que representam a expansão e a contração. Essa é a lógica geral da função que implementaremos em Python:
def Gator_Oscillator(df: pd.DataFrame,
                     jaw_period: int = 13, jaw_shift: int = 8,
                     teeth_period: int = 8, teeth_shift: int = 5,
                     lips_period: int = 5, lips_shift: int = 3) -> pd.DataFrame:
    """
    Calculate the Bill Williams Gator Oscillator and append the columns to the input DataFrame.

    Adds color columns for each bar:
    - Gator_Up_Color: 'green' for increasing, 'red' for decreasing, else previous color.
    - Gator_Down_Color: 'green' for increasing (less negative), 'red' for decreasing (more negative), else previous color.

    Args:
        df (pd.DataFrame): DataFrame with 'high' and 'low' columns.
        jaw_period (int): Jaw period (default 13).
        jaw_shift (int): Jaw shift (default 8).
        teeth_period (int): Teeth period (default 8).
        teeth_shift (int): Teeth shift (default 5).
        lips_period (int): Lips period (default 5).
        lips_shift (int): Lips shift (default 3).

    Returns:
        pd.DataFrame: Input DataFrame with 'Gator_Up', 'Gator_Down', 'Gator_Up_Color', 'Gator_Down_Color'.
    """
    required_cols = {'high', 'low'}
    if not required_cols.issubset(df.columns):
        raise ValueError("DataFrame must contain 'high' and 'low' columns")
    if not all(p > 0 for p in [jaw_period, jaw_shift, teeth_period, teeth_shift, lips_period, lips_shift]):
        raise ValueError("Period and shift values must be positive integers")

    result_df = df.copy()
    median_price = (result_df['high'] + result_df['low']) / 2

    def smma(series, period):
        smma_vals = []
        smma_prev = series.iloc[0]
        smma_vals.append(smma_prev)
        for price in series.iloc[1:]:
            smma_new = (smma_prev * (period - 1) + price) / period
            smma_vals.append(smma_new)
            smma_prev = smma_new
        return pd.Series(smma_vals, index=series.index)

    jaw = smma(median_price, jaw_period).shift(jaw_shift)
    teeth = smma(median_price, teeth_period).shift(teeth_shift)
    lips = smma(median_price, lips_period).shift(lips_shift)

    result_df['Gator_Up'] = (jaw - teeth).abs()
    result_df['Gator_Down'] = -(teeth - lips).abs()

    # Color logic
    up_vals = result_df['Gator_Up'].values
    down_vals = result_df['Gator_Down'].values

    up_colors = ['green']  # Start with green (or change to None/'grey' if you want)
    for i in range(1, len(up_vals)):
        if pd.isna(up_vals[i]) or pd.isna(up_vals[i-1]):
            up_colors.append(up_colors[-1])
        elif up_vals[i] > up_vals[i-1]:
            up_colors.append('green')
        elif up_vals[i] < up_vals[i-1]:
            up_colors.append('red')
        else:
            up_colors.append(up_colors[-1])

    down_colors = ['green']  # Start with green for "less negative" (getting closer to zero is "increasing")
    for i in range(1, len(down_vals)):
        if pd.isna(down_vals[i]) or pd.isna(down_vals[i-1]):
            down_colors.append(down_colors[-1])
        elif down_vals[i] > down_vals[i-1]:
            down_colors.append('green')  # "less negative" = "up"
        elif down_vals[i] < down_vals[i-1]:
            down_colors.append('red')    # "more negative" = "down"
        else:
            down_colors.append(down_colors[-1])

    result_df['Gator_Up_Color'] = up_colors
    result_df['Gator_Down_Color'] = down_colors

    return result_df
Analisando o código linha por linha, vemos que a função começa verificando se os dados de entrada e os hiperparâmetros são válidos. Os valores de deslocamento devem ser positivos, pois as linhas do Alligator são intencionalmente deslocadas para a frente, de modo que apareçam visualmente à frente do preço. Em seguida, criamos uma cópia do dataframe de entrada para processamento e calculamos o vetor de preços medianos. Dessa forma, os dados originais permanecem inalterados, enquanto o uso do preço mediano reduz o ruído em comparação com o uso exclusivo do preço de fechamento. Essa abordagem está alinhada com a prática convencional de utilização do Alligator.
Depois, definimos a implementação da média móvel suavizada. A SMMA é um método recursivo de suavização que reage mais lentamente do que uma EMA convencional, sendo adequada para filtrar séries temporais com oscilações bruscas. Inicializar o primeiro valor com series.iloc evita um período prolongado de aquecimento do indicador. Em seguida, definimos as linhas do Alligator e seus respectivos deslocamentos para a frente. Os períodos diminuem da "mandíbula" para os "dentes" e, depois, para os "lábios". Todas as linhas são deslocadas para a frente, fazendo com que a "boca" do indicador pareça abrir ou fechar antecipadamente em relação à barra atual.
Na sequência, definimos os dois buffers de saída: gator up e gator down. Esses buffers representam a magnitude das diferenças entre as respectivas linhas do Alligator, indicando o grau de abertura do indicador. Para fins de visualização, as barras recebem sinais positivos ou negativos. Por fim, implementamos a lógica de cores com base na variação da distância entre as linhas, indicando se ela está aumentando ou diminuindo. A barra inferior é exibida abaixo da linha zero e, portanto, apresenta valores negativos. Se essa barra subir, isso não significa que seu valor tenha se tornado positivo, mas apenas que ficou menos negativo. Ao tratar valores NaN, preservamos os estados anteriores para evitar oscilações visuais das cores no início de um trecho instável.
Oscilador A/D
Esse oscilador calcula a linha de Acumulação/Distribuição a partir do produto entre o multiplicador do fluxo de dinheiro e o volume. Ele avalia a relação entre a pressão compradora e a vendedora com base na posição do preço de fechamento dentro da faixa de preços da barra, levando em consideração o volume real ou o volume de ticks. Sua implementação em Python é a seguinte:
def AD_Oscillator(df: pd.DataFrame, fast_period: int = 5, slow_period: int = 13) -> pd.DataFrame:
    """
    Calculate the Accumulation/Distribution Oscillator (A/D Oscillator) and append it to the input DataFrame.

    A/D Oscillator = EMA(ADL, fast_period) - EMA(ADL, slow_period)

    ADL (Accumulation/Distribution Line) is calculated as:
    Money Flow Multiplier = [(Close - Low) - (High - Close)] / (High - Low)
    Money Flow Volume = Money Flow Multiplier * Volume
    ADL = cumulative sum of Money Flow Volume

    Args:
        df (pd.DataFrame): DataFrame with 'high', 'low', 'close', 'volume' columns.
        fast_period (int): Fast EMA period (default 3).
        slow_period (int): Slow EMA period (default 10).

    Returns:
        pd.DataFrame: Input DataFrame with 'ADL' and 'AD_Oscillator' columns added.
    """
    required_cols = {'high', 'low', 'close', 'tick_volume'}
    if not required_cols.issubset(df.columns):
        raise ValueError("DataFrame must contain 'high', 'low', 'close', 'tick_volume' columns")
    if not all(p > 0 for p in [fast_period, slow_period]):
        raise ValueError("Period values must be positive integers")
    if fast_period >= slow_period:
        raise ValueError("fast_period must be less than slow_period")

    result_df = df.copy()
    high = result_df['high']
    low = result_df['low']
    close = result_df['close']
    volume = result_df['tick_volume']

    # Avoid divide by zero, replace zero ranges with np.nan
    range_ = high - low
    range_ = range_.replace(0, pd.NA)

    mfm = ((close - low) - (high - close)) / range_
    mfv = mfm * volume
    result_df['ADL'] = mfv.cumsum()

    fast_ema = result_df['ADL'].ewm(span=fast_period, adjust=False).mean()
    slow_ema = result_df['ADL'].ewm(span=slow_period, adjust=False).mean()
    result_df['AD_Oscillator'] = fast_ema - slow_ema

    return result_df
Assim como na implementação do Gator apresentada acima, as primeiras linhas do código verificam se o dataframe de entrada contém os quatro campos necessários de preço e volume. Como estamos testando pares de moedas, assim como nos artigos anteriores, utilizamos o volume de ticks em vez do volume real, pelos motivos já explicados. Em seguida, verificamos se a configuração do oscilador é válida: o período lento deve ser maior que o período rápido. Depois, extraímos os dados necessários para calcular a amplitude da barra, evitando divisões por zero. Quando o preço máximo é igual ao mínimo, como pode ocorrer em candles do tipo doji ou em cotações fora de mercado, a amplitude é zero, o que pode resultar em valores excessivamente elevados do multiplicador.
Em seguida, calculamos o multiplicador do fluxo de dinheiro e o volume. O multiplicador assume valores limitados ao intervalo de -1 a +1: os valores mais altos se aproximam de +1, enquanto os mais baixos se aproximam de -1. Esse buffer é identificado como mfm, e sua versão ponderada pelo volume, como mfv. A função cumsum acumula essa pressão ponderada pelo volume ao longo do tempo, formando a linha A/D. Depois, calculamos os buffers das EMAs rápida e lenta da linha A/D. Quando o parâmetro adjust é definido como false, obtemos a EMA recursiva convencional, com a qual a maioria dos traders está familiarizada. A diferença entre esses buffers reforça o sinal: valores positivos indicam que a acumulação recente pode estar superando a tendência de longo prazo.
Padrões de sinal selecionados
Cada uma das funções correspondentes aos padrões 0, 3 e 4 retorna um array NumPy com formato (comprimento_do_dataframe_de_entrada, 2). Como nos artigos anteriores, a coluna [:, 0] codifica o sinal de compra (alta) com base nos valores dos indicadores definidos no artigo anterior. Quando o padrão é de alta, recebe o valor 1; caso contrário, recebe 0. Já a coluna [:, 1] codifica o sinal para posição vendida (baixa): recebe 1 quando o padrão de baixa está presente e 0 quando está ausente. Os três padrões de sinal combinam as cores dos histogramas superior e inferior do oscilador Gator, condições de Price Action baseadas em comparações entre os preços máximos, mínimos e de fechamento por meio da função shift, além do momentum e da pressão compradora ou vendedora ponderada pelo volume, representados pelo indicador A/D, também avaliados por comparações com deslocamento. Em todas as funções, as primeiras linhas recebem o valor 0, em quantidade determinada pela profundidade das comparações, para evitar sinais falsos.
Característica 0
Como vimos no penúltimo artigo, esse sinal combina uma divergência do Gator com um rompimento confirmado pelo indicador A/D. A implementação dessa característica em Python é a seguinte:
def feature_0(df):
    """
//+------------------------------------------------------------------+
//| Check for Pattern 0.                                             |
//+------------------------------------------------------------------+

    """
    feature = np.zeros((len(df), 2))

    cond_1 = df['Gator_Up_Color'] == 'red'
    cond_2 = df['Gator_Down_Color'] == 'green'

    feature[:, 0] = (cond_1 &
                     cond_2 &
                     (df['high'].shift(2) > df['high'].shift(3)) &
                     (df['high'].shift(1) >= df['high'].shift(2)) &
                     (df['close'] > df['high'].shift(1)) &
                     (df['AD_Oscillator'].shift(1) > df['AD_Oscillator'].shift(2)) &
                     (df['AD_Oscillator'] <= df['AD_Oscillator'].shift(1))).astype(int)

    feature[:, 1] = (cond_1 &
                     cond_2 &
                     (df['low'].shift(2) < df['low'].shift(3)) &
                     (df['low'].shift(1) <= df['low'].shift(2)) &
                     (df['close'] < df['low'].shift(1)) &
                     (df['AD_Oscillator'].shift(1) < df['AD_Oscillator'].shift(2)) &
                     (df['AD_Oscillator'] >= df['AD_Oscillator'].shift(1))).astype(int)


    feature[0, :] = 0
    feature[1, :] = 0

    return feature
No código apresentado acima, criamos uma matriz binária com duas colunas para os sinalizadores de posições compradas e vendidas. Em seguida, definimos o filtro principal baseado nas cores do Gator. Essencialmente, a condição exige que o histograma superior esteja se contraindo (vermelho), enquanto o inferior esteja se expandindo (verde). Depois, definimos formalmente as condições para posições compradas na coluna 0. Nessa etapa, codificamos o estado do Gator utilizando condições de cor predefinidas para identificar o regime de mercado. A condição de compra também exige máximas ascendentes, que confirmam o desenvolvimento do movimento, enquanto o rompimento é confirmado pelo momentum, evidenciado por uma alta acentuada do indicador A/D. Todos esses elementos são importantes para confirmar a direção de alta, pois o sinal exige a combinação entre o regime de mercado, o desenvolvimento do movimento, o rompimento e uma confirmação por momentum sujeita a critérios específicos. Trata-se de um sinal estruturado, relativamente fraco, mas consistente.
Para posições vendidas, aplicamos a lógica inversa: um rompimento de baixa após um movimento descendente é confirmado pela desaceleração da distribuição. Por fim, todos os valores indefinidos em decorrência dos deslocamentos são definidos como 0, evitando sinais falsos. Ao testar exclusivamente esse padrão em um EA criado com o Assistente MQL5, após exportar para ONNX a rede que processa esses dados de saída, obtemos o seguinte relatório:
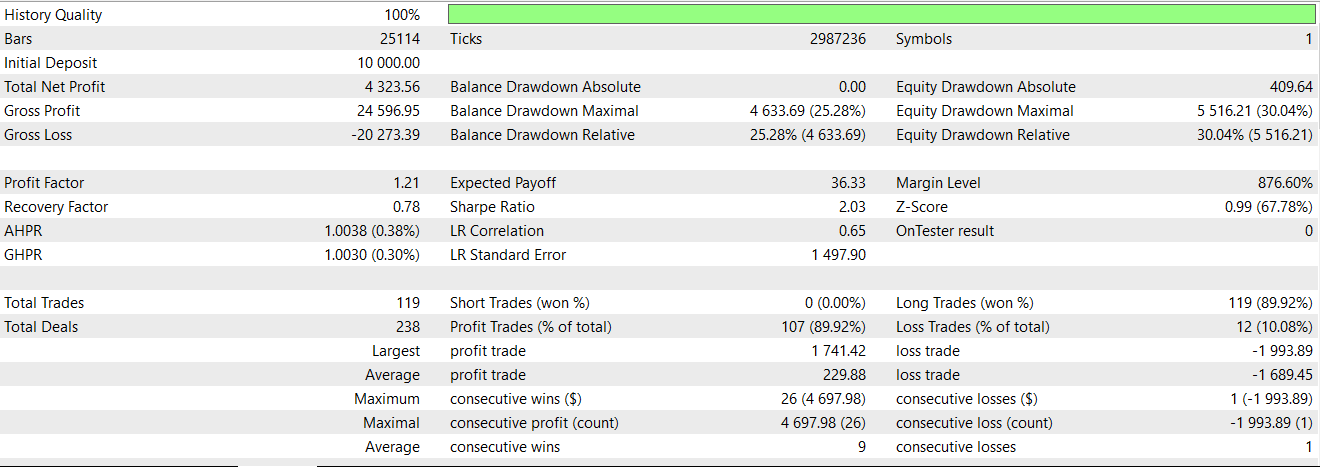
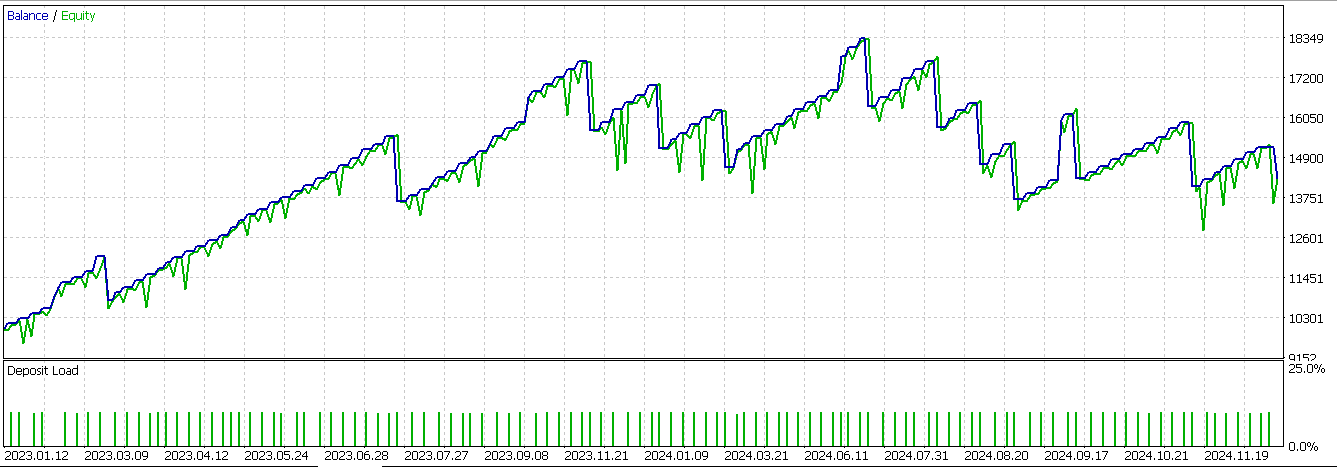
Apesar do número significativo de operações lucrativas, esse sinal aparentemente não conseguiu apresentar lucro no teste forward de 2024.
Característica 3
O segundo padrão de sinal se baseia na transição da contração para a expansão, acompanhada de um impulso dentro da barra. Sua implementação em Python é a seguinte:
def feature_3(df):
    """
//+------------------------------------------------------------------+
//| Check for Pattern 3.                                             |
//+------------------------------------------------------------------+
    """
    feature = np.zeros((len(df), 2))

    cond_1 = df['Gator_Up_Color'].shift(1) == 'red'
    cond_2 = df['Gator_Down_Color'].shift(1) == 'red'
    cond_3 = df['Gator_Up_Color'] == 'red'
    cond_4 = df['Gator_Down_Color'] == 'green'

    feature[:, 0] = (cond_1 &
                     cond_2 &
                     cond_3 &
                     cond_4 &
                     (df['close']-df['low'].shift(1) > 0.5*(df['high'].shift(1)-df['low'].shift(1))) &
                     (df['AD_Oscillator'].shift(2) > df['AD_Oscillator']) &
                     (df['AD_Oscillator'] > df['AD_Oscillator'].shift(1))).astype(int)

    feature[:, 1] = (cond_1 &
                     cond_2 &
                     cond_3 &
                     cond_4 &
                     (df['high'].shift(1)-df['close'] < 0.5*(df['high'].shift(1)-df['low'].shift(1))) &
                     (df['AD_Oscillator'].shift(2) < df['AD_Oscillator']) &
                     (df['AD_Oscillator'] < df['AD_Oscillator'].shift(1))).astype(int)


    feature[0, :] = 0
    feature[1, :] = 0

    return feature
A condição principal exige que as barras anteriores dos dois histogramas do Gator estejam vermelhas e que, em seguida, um dos histogramas mude para verde, sinalizando a transição descrita no penúltimo artigo. Como esses padrões já foram explicados detalhadamente naquele artigo, passaremos diretamente ao relatório do teste desse mesmo padrão, agora utilizando a rede neural como filtro. Obtemos o seguinte relatório:
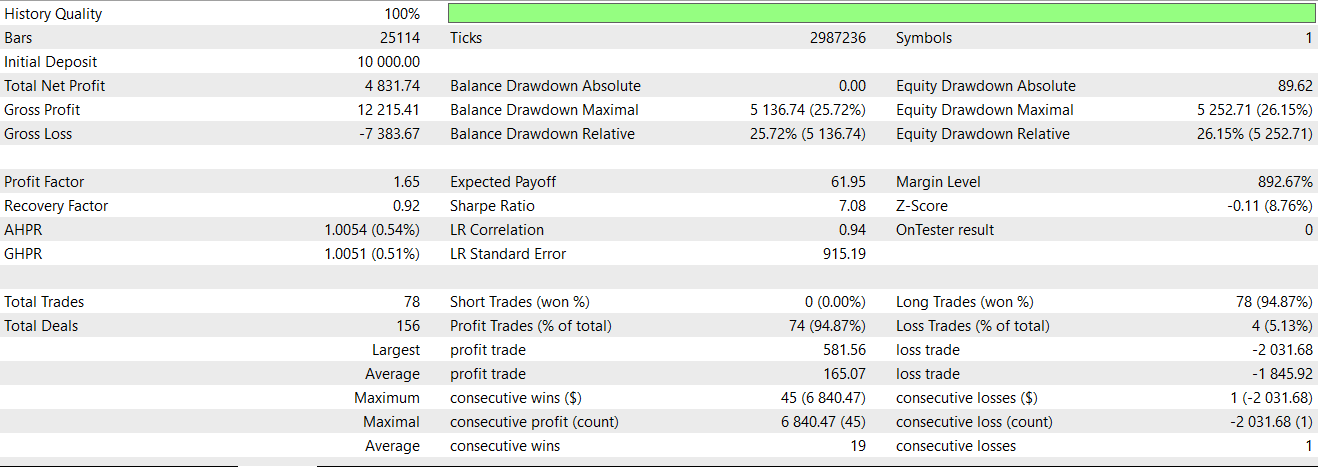
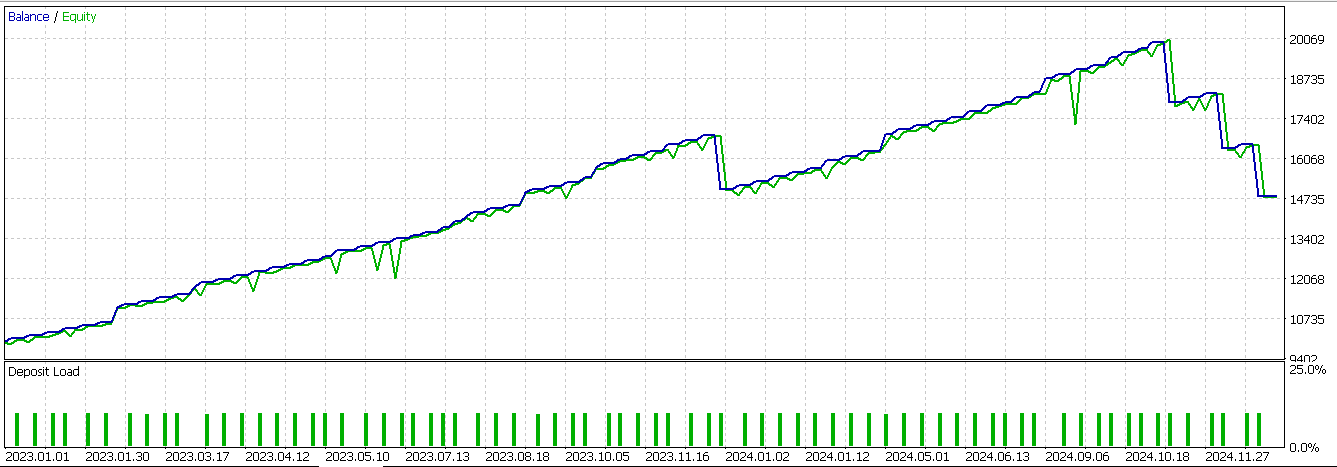
A estratégia esteve perto de concluir o teste forward com resultados positivos, mas foi prejudicada pela última sequência de operações com prejuízo. Como nossos sistemas sempre utilizam níveis de take-profit, mas não de stop-loss, o resultado foi afetado pela necessidade de encerrar operações perdedoras quando surgiam sinais de reversão.
Característica 4
O último padrão de sinal analisado corresponde a uma continuação após uma mudança de cor, com confirmação simples por momentum. Se a barra anterior apresentava expansão, com o histograma superior verde e o inferior vermelho, e nas barras seguintes o histograma superior muda para vermelho, indicando contração, enquanto o inferior permanece verde, isso pode sinalizar uma mudança de regime do oscilador Gator. Também verificamos a rejeição do preço e o momentum do indicador A/D, já descritos nas partes anteriores. A implementação desse sinal em Python é a seguinte:
def feature_4(df):
    """
//+------------------------------------------------------------------+
//| Check for Pattern 4.                                             |
//+------------------------------------------------------------------+
    """
    feature = np.zeros((len(df), 2))

    cond_1 = df['Gator_Up_Color'].shift(1) == 'green'
    cond_2 = df['Gator_Down_Color'].shift(1) == 'red'
    cond_3 = df['Gator_Up_Color'] == 'red'
    cond_4 = df['Gator_Down_Color'] == 'green'

    feature[:, 0] = (cond_1 &
                     cond_2 &
                     cond_3 &
                     cond_4 &
                     (df['close'] > df['close'].shift(1)) &
                     (df['low'].shift(1) > df['low']) &
                     (df['AD_Oscillator'] > df['AD_Oscillator'].shift(1))).astype(int)

    feature[:, 1] = (cond_1 &
                     cond_2 &
                     cond_3 &
                     cond_4 &
                     (df['close'] < df['close'].shift(1)) &
                     (df['high'].shift(1) < df['high']) &
                     (df['AD_Oscillator'] < df['AD_Oscillator'].shift(1))).astype(int)


    feature[0, :] = 0
    feature[1, :] = 0

    return feature
Ao testar esse sinal, a rede neural atua como um filtro adicional para o EA apresentado nos artigos anteriores. Obtemos o seguinte relatório:
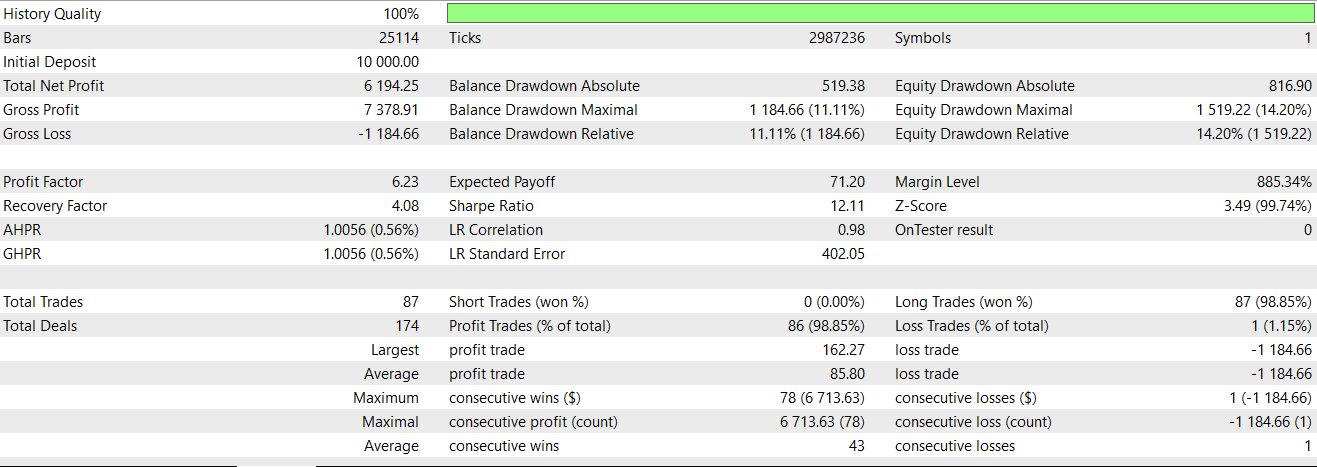
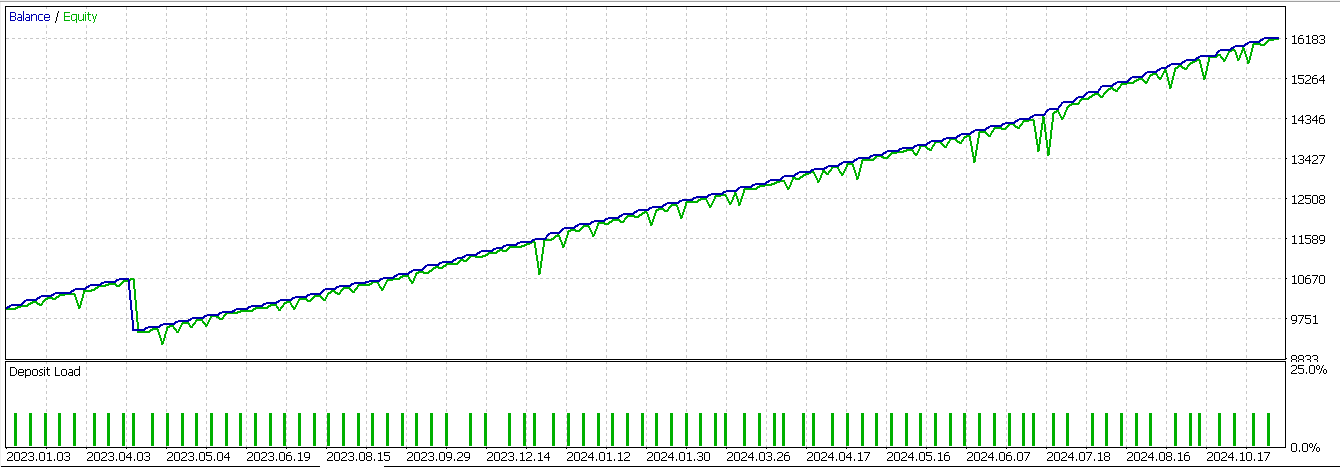
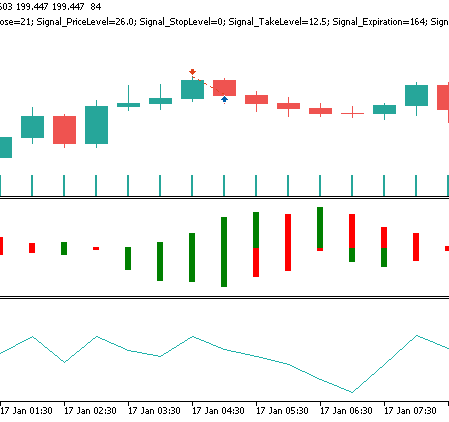
Dos três sinais que voltamos a analisar neste artigo, apenas este apresentou uma melhora significativa em relação ao teste inicial. Vale ressaltar mais uma vez que o período de testes está limitado a apenas 2 anos. Portanto, quem pretende desenvolver esse sinal deve realizar suas próprias verificações. O padrão de sinal para posição vendida da característica 4 pode aparecer no gráfico de preços da seguinte forma:
Conclusão
Modelos de aprendizado supervisionado, como a rede neural convolucional combinada com regressão por kernel e similaridade baseada no produto escalar apresentada neste artigo, podem ajudar a melhorar padrões de sinal pouco expressivos. Embora nem todos os padrões testados tenham apresentado o mesmo grau de melhoria, a característica 4 se destacou pelo avanço significativo nos resultados. Isso sugere que essa abordagem pode ser útil como filtro para EAs. Ainda assim, o horizonte limitado de testes não permite tirar conclusões mais amplas. Apesar dessa restrição, o método demonstra que arquiteturas adaptativas são capazes de extrair informações úteis de sinais com histórico de desempenho pouco confiável.
| nome | descrição |
|---|---|
| WZ-79.mq5 | EA criado com o Assistente MQL5, cujo cabeçalho indica os arquivos utilizados. As instruções de uso do Assistente estão disponíveis aqui. |
| SignalWZ-79.mqh | Arquivo da classe de sinal utilizado pelo Assistente MQL5 para criar o EA |
| 79_0.onnx | Rede neural exportada para o padrão de sinal 0 |
| 79_3.onnx | Rede neural exportada para o padrão de sinal 3 |
| 79_4.onnx | Rede neural exportada para o padrão de sinal 4 |
Traduzido do Inglês pela MetaQuotes Ltd.
Artigo original: https://www.mql5.com/en/articles/19220
Aviso: Todos os direitos sobre esses materiais pertencem à MetaQuotes Ltd. É proibida a reimpressão total ou parcial.
Esse artigo foi escrito por um usuário do site e reflete seu ponto de vista pessoal. A MetaQuotes Ltd. não se responsabiliza pela precisão das informações apresentadas nem pelas possíveis consequências decorrentes do uso das soluções, estratégias ou recomendações descritas.



