
Arquitetura do sistema de aprendizado de máquina no MetaTrader 5 (Parte 2): Rotulagem de dados financeiros para aprendizado de máquina
 22
 2

Sumário
- Introdução
- Visão geral dos métodos de rotulagem
- Implementação: método de rotulagem da barreira tripla (Triple-Barrier)
- Meta-rotulagem na prática: estratégia baseada nas Bandas de Bollinger
- Conclusão
Introdução
Imagine que você esteja treinando para se tornar um atirador de elite. O que escolheria: praticar com círculos perfeitos desenhados em um alvo de papel ou com alvos em forma de silhueta humana que simulem situações reais de combate? Evidentemente, você precisa de alvos que representem as situações que enfrentará na prática.
O mesmo princípio se aplica ao aprendizado de máquina em finanças. A maioria dos estudos acadêmicos utiliza a chamada "rotulagem com horizonte temporal fixo", equivalente a praticar com aqueles círculos perfeitos. Essa abordagem procura responder a uma pergunta simples: "O preço estará acima ou abaixo do nível atual daqui a exatamente X dias?". O problema é que, para quem opera no mercado, não basta saber aonde o preço chegará. O percurso também importa: quando o stop-loss será acionado, quando realizar o lucro e como o preço se comporta ao longo desse intervalo.
Seja bem-vindo de volta à nossa série "MetaTrader 5 e aprendizado de máquina: guia prático". Na Parte 1, examinamos a crítica "armadilha das marcas de tempo", que compromete silenciosamente a maioria dos algoritmos de trading. Agora, vamos enfrentar um desafio igualmente importante: como criar rótulos que realmente reflitam a maneira como você opera no mercado.
Pense da seguinte forma: se você estivesse desenvolvendo um modelo para prever a ocorrência de um infarto, não analisaria apenas se a pessoa estaria viva ou morta exatamente 365 dias depois. Você também procuraria identificar sinais de alerta, intervenções precoces e a sequência de eventos relevantes para a tomada de decisões médicas. Nos mercados financeiros, a lógica é a mesma.
Este artigo pressupõe que você já saiba trabalhar com Python e tenha conhecimentos básicos dos conceitos de aprendizado de máquina. Vamos nos aprofundar no código e em exemplos de aplicações reais que você poderá colocar em prática imediatamente.
Resumo da Parte 1: vazamento de dados e correção das marcas de tempo
Na primeira parte da série, abordamos um problema crítico, mas frequentemente ignorado, que pode comprometer silenciosamente o desempenho dos modelos de aprendizado de máquina nos mercados financeiros: a "armadilha das marcas de tempo" e os problemas de vazamento de dados associados à estrutura padrão dos dados no MetaTrader 5. Estabelecemos uma base essencial ao tratar da integridade dos dados e destacar a necessidade de construir barras limpas e sem viés a partir de dados brutos de ticks. Essa base é indispensável para desenvolver modelos confiáveis de aprendizado de máquina aplicados às finanças. Se você ainda não leu a Parte 1, recomendamos que o faça antes de continuar.
Essa base garante:
- Integridade dos dados: todas as marcas de tempo correspondem ao momento em que as informações efetivamente se tornaram disponíveis.
- Validade estatística: as barras baseadas na atividade do mercado apresentam propriedades estatísticas mais adequadas para os modelos de aprendizado de máquina.
- Correspondência com a realidade: a construção das barras corresponde ao fluxo real de informações do mercado.
Agora que resolvemos esses problemas fundamentais de qualidade dos dados, dispomos de conjuntos de dados limpos e sem viés, prontos para a próxima etapa crítica do nosso pipeline de aprendizado de máquina: a aplicação de métodos de rotulagem que realmente reflitam a dinâmica do mercado.
Visão geral dos métodos de rotulagem
A maioria dos modelos de aprendizado de máquina aplicados às finanças fracassa por um motivo surpreendentemente simples: não por causa de algoritmos inadequados ou da falta de capacidade computacional, mas por graves deficiências na rotulagem dos dados. Quando comecei a desenvolver modelos de trading, passei meses otimizando atributos e experimentando diferentes arquiteturas de redes neurais, até descobrir que meu esquema de rotulagem apresentava uma falha fundamental. Na prática, eu estava ensinando meu modelo a acertar o centro de um alvo estático, quando precisava que ele acertasse um alvo em movimento em meio a um furacão.
Os mercados financeiros estão repletos de ruído. Cada tick contém uma mistura de informações relevantes e oscilações aleatórias, e nossa tarefa é extrair o sinal útil, reconhecendo que a maioria dos movimentos de preço resulta simplesmente de participantes do mercado mudando de opinião ou de algoritmos reagindo a oscilações em escala de microssegundos. Uma boa rotulagem não se limita a indicar o que aconteceu: ela nos ajuda a identificar o que realmente importa para tomar decisões de negociação na prática.
A abordagem mais simples, pela qual a maioria das pessoas começa, é a rotulagem com horizonte temporal fixo. Você escolhe um período, digamos, cinco dias, e verifica se o preço estará acima ou abaixo do nível inicial ao final desse intervalo. Se as ações da Apple fecharem na segunda-feira a $150 e atingirem $155 na sexta-feira, a segunda-feira receberá um rótulo de compra. É uma abordagem simples, intuitiva e fundamentalmente inadequada para a maneira como o trading funciona na prática. Quando foi a última vez que você comprou uma ação pensando: "Vou voltar para conferir o resultado daqui a exatamente cinco dias, aconteça o que acontecer"? Se as ações caírem 20% na terça-feira, você não esperará até sexta-feira para reavaliar a situação. Se dispararem 15% na quarta-feira, talvez decida realizar o lucro imediatamente.
Isso nos leva ao método da barreira tripla, que transformou a maneira como os profissionais que atuam de forma rigorosa na área abordam o aprendizado de máquina aplicado às finanças. Em vez de adotar horizontes temporais arbitrários, você estabelece três barreiras para cada operação potencial, exatamente como faria um trader profissional. A primeira é a meta de lucro, que pode estar 5% acima do preço de entrada. A segunda é o stop-loss, digamos, 3% abaixo do preço de compra. A terceira é um limite de tempo, pois você não quer manter posições perdedoras indefinidamente. O rótulo depende de qual dessas barreiras é atingida primeiro. Assim, em vez de aprender a prever movimentos abstratos de preço, seu modelo passa a identificar se determinados setups de trading atingirão suas metas de lucro antes que os stop-losses sejam acionados.
A grande vantagem dessa abordagem é que ela reflete a psicologia real do trading. Para um trader, pouco importa se uma ação acabará se valorizando caso, antes disso, seu preço caia o suficiente para acionar as regras de gestão de risco. O percurso do preço é tão importante quanto seu destino, e o método da barreira tripla incorpora naturalmente essa dependência da trajetória. Você pode até tornar as barreiras dinâmicas, utilizando stops mais amplos em períodos de alta volatilidade e mais estreitos quando o mercado estiver tranquilo.
Nos mercados em que a duração das tendências varia consideravelmente, os métodos de varredura de tendências oferecem uma solução elegante. Em vez de impor intervalos temporais fixos, esses algoritmos analisam diferentes horizontes futuros e identificam a tendência de maior significância estatística. Por exemplo, uma tendência de 5 dias pode ser fraca, a de 10 dias pode ser forte e a de 15 dias, moderada. O método seleciona o sinal mais forte e atribui o rótulo correspondente. É como permitir que o próprio algoritmo determine o horizonte de previsão mais adequado para cada condição de mercado.
Há também a meta-rotulagem, que resolve um problema completamente diferente. Em vez de prever a direção do mercado, ela procura responder à pergunta: "Quando devo confiar nas minhas outras previsões?". Imagine que você já tenha uma estratégia de trading que gera sinais de compra e venda. A meta-rotulagem utiliza um segundo modelo para estimar a probabilidade de cada sinal resultar em uma operação lucrativa. Sua estratégia principal pode indicar "comprar", mas o meta-modelo considera fatores adicionais, como o desempenho recente, a volatilidade do mercado e o tempo decorrido desde o último acontecimento relevante noticiado, para calcular um nível de confiança. Com um nível de confiança elevado, você abre uma posição maior. Com um nível baixo, deixa de executar a operação ou abre uma posição menor.
Essa abordagem parte de uma constatação fundamental: saber quando suas previsões têm maior probabilidade de estar corretas costuma ser mais valioso do que simplesmente tentar aumentar a frequência de acertos. Essa é a diferença entre ser bom em fazer previsões e ser um trader lucrativo. Muitas estratégias fracassam não porque suas previsões sobre a direção do mercado sejam ruins, mas porque destinam o mesmo capital a operações baseadas em sinais de alta e baixa confiança.
Cada método de rotulagem ensina algo diferente ao modelo. Os métodos com horizonte fixo se concentram exclusivamente na direção do preço. O método da barreira tripla incorpora a gestão de risco e a dependência da trajetória do preço. A varredura de tendências se adapta às mudanças nas condições de mercado. Já a meta-rotulagem otimiza a confiança e o dimensionamento das posições. O método escolhido determina, em grande medida, o que seu modelo aprende e como ele se comporta nas operações reais.
Principais considerações ao trabalhar com dados financeiros
- Evite o viés de retrospectiva (hindsight bias): certifique-se de que a rotulagem respeite a disponibilidade temporal das informações utilizadas para definir os atributos e os rótulos. Por exemplo, ao rotular um dado referente a "hoje", você deve utilizar apenas informações de "hoje" ou de períodos anteriores para definir os atributos. Já para determinar o rótulo, pode utilizar informações do "futuro" em relação a "hoje".
- Equilibre as classes: ao utilizar rótulos como "compra", "venda" e "manter", você pode descobrir que os sinais de "manter" (ou movimentos pequenos de preço) são muito mais frequentes. Um desequilíbrio acentuado entre as classes pode dificultar o aprendizado das classes minoritárias. Existem técnicas para lidar com esse problema, como sobreamostragem, subamostragem e utilização de métricas de avaliação adequadas.
- Considere a volatilidade: nos mercados financeiros, a volatilidade varia ao longo do tempo. Um movimento de preço de 2% pode ser expressivo em um mercado tranquilo, mas pouco significativo durante um período de alta volatilidade. Considere utilizar limites ajustados pela volatilidade para definir seus rótulos, como ocorre no método da barreira tripla.
- Estacionariedade: as séries temporais financeiras frequentemente não são estacionárias, ou seja, suas propriedades estatísticas, como média e variância, mudam ao longo do tempo. Embora a rotulagem, por si só, não torne os dados estacionários, a escolha do método de rotulagem (por exemplo, rotular retornos, que geralmente apresentam maior estacionariedade do que os preços) e a posterior engenharia de atributos desempenham um papel fundamental.
- Experimente e aperfeiçoe: sua primeira abordagem de rotulagem pode não ser a melhor. Esteja preparado para testar diferentes métodos, horizontes temporais e valores-limite para identificar quais produzem os melhores resultados para seus objetivos específicos e os ativos analisados.
Implementação: método de rotulagem da barreira tripla (Triple-Barrier)
Definição de barreiras dinâmicas
Como discutimos na seção anterior, na prática, queremos definir níveis de realização de lucro e stop-loss de acordo com o risco associado a cada operação. Caso contrário, dependendo da volatilidade atual, podemos estabelecer metas excessivamente altas (𝜏 ≫ 𝜎ti,0) ou excessivamente baixas (𝜏 ≪ 𝜎ti,0).
O código a seguir calcula a volatilidade diária em pontos de avaliação intradiários, utilizando um desvio-padrão móvel com ponderação exponencial e uma janela retrospectiva (lookback) definida. Essa estimativa de volatilidade será utilizada para estabelecer as barreiras de realização de lucro e stop-loss.
def get_daily_vol(close, lookback=100):
    """
    Advances in Financial Machine Learning, Snippet 3.1, page 44.

    Daily Volatility Estimates

    Computes the daily volatility at intraday estimation points.

     Otherwise, sometimes we will be aiming too high (tao ≫ sigma_t_i,0), and sometimes too low
    (tao ≪ sigma_t_i,0), considering the prevailing volatility. Snippet 3.1 computes the daily volatility
    at intraday estimation points, applying a span of lookback days to an exponentially weighted moving
    standard deviation.


    Note: This function is used to compute dynamic thresholds for profit taking and stop loss limits.

    :param close: (pd.Series) Closing prices
    :param lookback: (int) Lookback period to compute volatility
    :return: (pd.Series) Daily volatility value
    """
    # Find previous valid trading day for each date
    prev_idx = close.index.searchsorted(close.index - pd.Timedelta(days=1))
    prev_idx = prev_idx[prev_idx > 0]  # Drop indices before the start

    # Align current and previous closes
    curr_idx = close.index[close.shape[0] - prev_idx.shape[0] :]
    prev_close = close.iloc[prev_idx - 1].values  # Previous day's close
    ret = close.loc[curr_idx] / prev_close - 1
    vol = ret.ewm(span=lookback).std()
    return vol
Definição de barreiras verticais (limites de tempo)
Para definir as barreiras verticais, utilizamos a função a seguir. Ao trabalhar com barras baseadas na atividade do mercado (activity-driven bars), faz mais sentido estabelecer o vencimento das barreiras com base na quantidade de barras, em vez de utilizar um intervalo de tempo fixo, pois o número de barras geradas durante um mesmo período pode variar drasticamente.
# Snippet 3.4 page 49, Adding a Vertical Barrier
def add_vertical_barrier(t_events, close, num_bars=0, **time_delta_kwargs):
    """
    Advances in Financial Machine Learning, Enhanced Implementation.

    Adding a Vertical Barrier

    For each event in t_events, finds the timestamp of the next price bar at or immediately after:
    - A fixed number of bars (for activity-based sampling), OR
    - A time delta (for time-based sampling)

    This function creates a series of vertical barrier timestamps aligned with the original events index.
    Out-of-bound barriers are marked with NaT for downstream handling.

    :param t_events: (pd.Series) Series of event timestamps (e.g., from symmetric CUSUM filter)
    :param close: (pd.Series) Close price series with DateTimeIndex
    :param num_bars: (int) Number of bars for vertical barrier (activity-based mode).
                     Takes precedence over time delta parameters when > 0.
    :param time_delta_kwargs: Time components for time-based barrier (mutually exclusive with num_bars):
        :param days: (int) Number of days
        :param hours: (int) Number of hours
        :param minutes: (int) Number of minutes
        :param seconds: (int) Number of seconds
    :return: (pd.Series) Vertical barrier timestamps with same index as t_events.
             Out-of-bound events return pd.NaT.

    Example:
        # Activity-bar mode (tick/volume/dollar bars)
        vertical_barriers = add_vertical_barrier(t_events, close, num_bars=10)

        # Time-based mode
        vertical_barriers = add_vertical_barrier(t_events, close, days=1, hours=3)
    """
    # Validate inputs
    if num_bars and time_delta_kwargs:
        raise ValueError("Use either num_bars OR time deltas, not both")

    # BAR-BASED VERTICAL BARRIERS
    if num_bars > 0:
        indices = close.index.get_indexer(t_events, method="nearest")
        t1 = []
        for i in indices:
            if i == -1:  # Event not found
                t1.append(pd.NaT)
            else:
                end_loc = i + num_bars
                t1.append(close.index[end_loc] if end_loc < len(close) else pd.NaT)
        return pd.Series(t1, index=t_events)

    # TIME-BASED VERTICAL BARRIERS
    td = pd.Timedelta(**time_delta_kwargs) if time_delta_kwargs else pd.Timedelta(0)
    barrier_times = t_events + td

    # Find next index positions
    t1_indices = np.searchsorted(close.index, barrier_times, side="left")
    t1 = []
    for idx in t1_indices:
        if idx < len(close):
            t1.append(close.index[idx])
        else:
            t1.append(pd.NaT)  # Mark out-of-bound for downstream

    return pd.Series(t1, index=t_events)
Aplicação do método da barreira tripla
O método da barreira tripla é, por natureza, dependente da trajetória do preço (path-dependent). Isso significa que não podemos simplesmente observar o preço final para determinar o rótulo. Precisamos acompanhar toda a trajetória do preço, desde a abertura até o encerramento da posição, seja pelo atingimento da meta de lucro, pelo acionamento do stop-loss ou pelo término do prazo estabelecido.
Ao aplicar o método da barreira tripla, estamos basicamente perguntando: "A partir do instante ti,0, qual evento ocorrerá primeiro à medida que o tempo avança?". A análise prossegue até o instante ti,1, que corresponde ao primeiro toque em uma das barreiras. Esse evento pode ser o atingimento da meta de lucro, o acionamento do stop-loss ou o término do período máximo de permanência na posição (barreira vertical definida em ti,0 + h). O retorno utilizado na rotulagem é calculado entre o instante de entrada ti,0 e o instante do primeiro toque ti,1.
A função apply_pt_sl_on_t1() implementa essa lógica e precisa de alguns dados de entrada para funcionar corretamente. Primeiro, ela recebe uma série de preços de fechamento, que permite acompanhar a trajetória efetiva do preço. O DataFrame events contém as informações necessárias para cada operação potencial: a coluna t1 indica o prazo de vencimento de cada operação (barreira vertical), enquanto a coluna trgt determina a distância utilizada como referência para definir as barreiras horizontais.
O parâmetro pt_sl é especialmente importante. Trata-se de uma lista com dois elementos que controlam a distância das barreiras. O primeiro elemento (pt_sl[0]) define o multiplicador aplicado ao valor de referência (trgt) para estabelecer a barreira de realização de lucro. O segundo elemento (pt_sl[1]) desempenha a mesma função para a barreira de stop-loss. Se qualquer um desses valores for zero, a barreira correspondente será desativada. Essa flexibilidade permite estabelecer relações assimétricas entre risco e retorno. Por exemplo, você pode definir um stop-loss mais próximo do preço de entrada e deixar o lucro crescer.
A função avalia sistematicamente essas barreiras, acompanhando os movimentos do preço barra a barra até que uma delas seja atingida. Dessa forma, obtemos as informações sobre o instante de saída e o retorno da operação, necessárias para atribuir os rótulos com precisão.
# Snippet 3.2, page 45, Triple Barrier Labeling Method
def apply_pt_sl_on_t1(close, events, pt_sl, molecule):
    """
    Advances in Financial Machine Learning, Snippet 3.2, page 45.

    Triple Barrier Labeling Method

    This function applies the triple-barrier labeling method. It works on a set of
    datetime index values (molecule). This allows the program to parallelize the processing.

    Mainly it returns a DataFrame of timestamps regarding the time when the first barriers were reached.

    :param close: (pd.Series) Close prices
    :param events: (pd.Series) Indices that signify "events" (see cusum_filter function for more details)
    :param pt_sl: (np.array) Element 0, indicates the profit taking level; Element 1 is stop loss level
    :param molecule: (an array) A set of datetime index values for processing
    :return: (pd.DataFrame) Timestamps of when first barrier was touched
    """
    # Apply stop loss/profit taking, if it takes place before t1 (end of event)
    events = events.loc[molecule].copy()
    out = events[["t1"]].copy(deep=True)

    profit_taking_multiple = pt_sl[0]
    stop_loss_multiple = pt_sl[1]

    # Profit taking active
    if profit_taking_multiple > 0:
        profit_taking = np.log(1 + profit_taking_multiple * events["trgt"])
    else:
        profit_taking = pd.Series(index=events.index)  # NaNs

    # Stop loss active
    if stop_loss_multiple > 0:
        stop_loss = np.log(1 - stop_loss_multiple * events["trgt"])
    else:
        stop_loss = pd.Series(index=events.index)  # NaNs

    # Use dictionary to collect barrier hit times
    barrier_dict = {"sl": {}, "pt": {}}

    # Get events
    for loc, vertical_barrier in events["t1"].fillna(close.index[-1]).items():
        closing_prices = close[loc:vertical_barrier]  # Path prices for a given trade
        cum_returns = np.log(closing_prices / close[loc]) * events.at[loc, "side"]  # Path returns
        barrier_dict["sl"][loc] = cum_returns[
            cum_returns < stop_loss[loc]
        ].index.min()  # Earliest stop loss date
        barrier_dict["pt"][loc] = cum_returns[
            cum_returns > profit_taking[loc]
        ].index.min()  # Earliest profit taking date

    # Convert dictionary to DataFrame and join to `out`
    barrier_df = pd.DataFrame(barrier_dict)
    out = out.join(barrier_df)  # Join on index (loc)

    return out
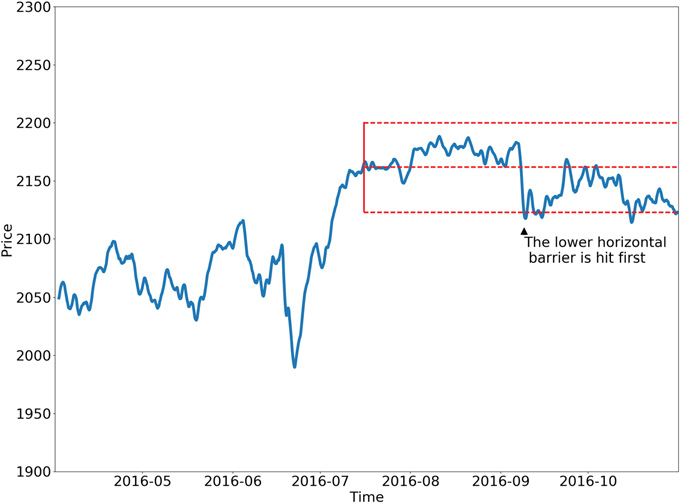
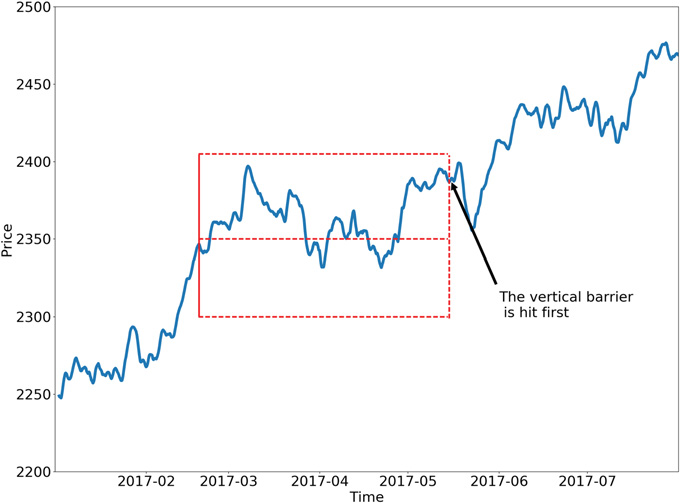
O método da barreira tripla admite oito configurações possíveis, dependendo das barreiras ativadas. Cada configuração pode ser representada pela combinação [lucro, stop-loss, tempo], em que 1 indica uma barreira ativa e 0 indica uma barreira desativada.
- A maioria das estratégias práticas de trading utiliza uma das três configurações:
- [1,1,1] - Configuração completa: as três barreiras estão ativas. Você busca atingir uma meta de lucro, ao mesmo tempo que controla o risco de perda e o período de permanência na posição. Essa configuração reflete a maneira como a maioria dos traders profissionais opera na prática.
- [0,1,1] - Deixar os lucros correrem: não há uma meta de lucro predefinida, mas a posição será encerrada após X períodos, a menos que o stop-loss seja acionado antes. É uma configuração ideal para estratégias de momentum, nas quais o objetivo é acompanhar a tendência.
- [1,1,0] - Sem limite de tempo: a meta de lucro e o stop-loss estão ativos, mas não há prazo máximo de permanência na posição. Você mantém a operação aberta até que uma das barreiras de preço seja atingida, independentemente do tempo necessário.
- Três configurações tecnicamente possíveis, mas menos realistas:
- [0,0,1] - Horizonte fixo: a saída ocorre apenas pelo limite de tempo. Na prática, equivale à rotulagem com horizonte temporal fixo, embora também possa ser utilizada com barras baseadas na atividade do mercado.
- [1,0,1] - Ignorar as perdas: a posição é mantida até atingir a meta de lucro ou o limite de tempo, independentemente das perdas intermediárias. É uma abordagem perigosa para a gestão de risco.
- [1,0,0] - Manter indefinidamente: não há stop-loss nem limite de tempo. Manter posições perdedoras até que eventualmente se tornem lucrativas é uma receita para destruir o capital da carteira.
- Duas configurações praticamente inúteis:
- [0,1,0] - Esperar pelo prejuízo: a posição é mantida até que o stop-loss seja acionado. Por que abrir uma operação se o único resultado previsto é uma perda?
- [0,0,0] - Sem saída: todas as barreiras estão desativadas. As posições nunca são encerradas e nenhum rótulo é gerado.
A seguir, apresentamos duas configurações possíveis do método da barreira tripla.
Treinamento para determinar a direção e o tamanho da posição
As funções desta seção utilizam o método da barreira tripla para treinar um modelo que preveja a direção {1, 0, -1}, quando side_prediction=None em get_events(), ou para treinar um modelo que determine o tamanho das posições com base nos dados de meta-rotulagem, quando a direção já é conhecida. O treinamento para prever a direção da operação pressupõe que as barreiras horizontais estejam ausentes ou sejam simétricas. Isso ocorre porque, nessa etapa, ainda não podemos distinguir as barreiras de realização de lucro das barreiras de stop-loss. Quando a direção já é conhecida, podemos otimizar as barreiras para encontrar a combinação que produz o modelo com melhor desempenho. Para obter, em cada evento, a data do primeiro toque em uma das barreiras, executamos get_events().
# Snippet 3.3 -> 3.6 page 50, Getting the Time of the First Touch, with Meta Labels
def get_events(close, t_events, pt_sl, target, min_ret, num_threads, vertical_barrier_times=False,
               side_prediction=None, verbose=True):
    """
    Advances in Financial Machine Learning, Snippet 3.6 page 50.

    Getting the Time of the First Touch, with Meta Labels

    This function is orchestrator to meta-label the data, in conjunction with the Triple Barrier Method.

    :param close: (pd.Series) Close prices
    :param t_events: (pd.Series) of t_events. These are timestamps that will seed every triple barrier.
        These are the timestamps selected by the sampling procedures discussed in Chapter 2, Section 2.5.
        E.g.: CUSUM Filter
    :param pt_sl: (list) Element 0, indicates the profit taking level; Element 1 is stop loss level.
        A non-negative float that sets the width of the two barriers. A 0 value means that the respective
        horizontal barrier (profit taking and/or stop loss) will be disabled.
    :param target: (pd.Series) of values that are used (in conjunction with pt_sl) to determine the width
        of the barrier. In this program this is daily volatility series.
    :param min_ret: (float) The minimum target return required for running a triple barrier search.
    :param num_threads: (int) The number of threads concurrently used by the function.
    :param vertical_barrier_times: (pd.Series) A pandas series with the timestamps of the vertical barriers.
        We pass a False when we want to disable vertical barriers.
    :param side_prediction: (pd.Series) Side of the bet (long/short) as decided by the primary model
    :param verbose: (bool) Flag to report progress on asynch jobs
    :return: (pd.DataFrame) Events
            -events.index is event's starttime
            -events['t1'] is event's endtime
            -events['trgt'] is event's target
            -events['side'] (optional) implies the algo's position side
            -events['pt'] is profit taking multiple
            -events['sl']  is stop loss multiple
    """

    # 1) Get target
    target = target.reindex(t_events)
    target = target[target > min_ret]  # min_ret

    # 2) Get vertical barrier (max holding period)
    if vertical_barrier_times is False:
        vertical_barrier_times = pd.Series(pd.NaT, index=t_events, dtype=t_events.dtype)

    # 3) Form events object, apply stop loss on vertical barrier
    if side_prediction is None:
        side_ = pd.Series(1.0, index=target.index)
        pt_sl_ = [pt_sl[0], pt_sl[0]]
    else:
        side_ = side_prediction.reindex(target.index)  # Subset side_prediction on target index.
        pt_sl_ = pt_sl[:2]

    # Create a new df with [v_barrier, target, side] and drop rows that are NA in target
    events = pd.concat({'t1': vertical_barrier_times, 'trgt': target, 'side': side_}, axis=1)
    events = events.dropna(subset=['trgt'])

    # Apply Triple Barrier
    first_touch_dates = mp_pandas_obj(func=apply_pt_sl_on_t1,
                                      pd_obj=('molecule', events.index),
                                      num_threads=num_threads,
                                      close=close,
                                      events=events,
                                      pt_sl=pt_sl_,
                                      verbose=verbose)

    for ind in events.index:
        events.at[ind, 't1'] = first_touch_dates.loc[ind, :].dropna().min()

    if side_prediction is None:
        events = events.drop('side', axis=1)

    # Add profit taking and stop loss multiples for vertical barrier calculations
    events['pt'] = pt_sl[0]
    events['sl'] = pt_sl[1]

    return events
Utilizamos get_bins() para retornar o DataFrame events, no qual:
- events.index - instante de início do evento
- events['t1'] - instante de término do evento
- events['trgt'] - nível-alvo do evento
- events['side'] (opcional) - indica a direção da posição definida pela estratégia
- Caso 1: se "side" estiver ausente em events → bin∈ {-1, 1} (rotulagem baseada no movimento do preço)
- Caso 2: se "side" estiver presente → bin ∈ {0, 1} (rotulagem baseada em lucro ou prejuízo, ou seja, meta-rotulagem)
# Snippet 3.4 -> 3.7, page 51, Labeling for Side & Size with Meta Labels
def get_bins(triple_barrier_events, close, vertical_barrier_zero=False, pt_sl=[1, 1]):
    """
    Advances in Financial Machine Learning, Snippet 3.7, page 51.

    Labeling for Side & Size with Meta Labels

    Compute event's outcome (including side information, if provided).
    events is a DataFrame where:

    Now the possible values for labels in out['bin'] are {0,1}, as opposed to whether to take the bet or pass,
    a purely binary prediction. When the predicted label the previous feasible values {−1,0,1}.
    The ML algorithm will be trained to decide is 1, we can use the probability of this secondary prediction
    to derive the size of the bet, where the side (sign) of the position has been set by the primary model.

    :param triple_barrier_events: (pd.DataFrame) Events DataFrame with the following structure:
    - **index**: pd.DatetimeIndex of event start times
    - **t1**: (pd.Series) Event end times
    - **trgt**: (pd.Series) Target returns
    - **side**: (pd.Series, optional) Algo's position side
      Labeling behavior depends on the presence of 'side':
        - Case 1: If 'side' not in events → `bin ∈ {-1, 1}` (label by price action)
        - Case 2: If 'side' is present    → `bin ∈ {0, 1}`  (label by PnL — meta-labeling)
    :param close: (pd.Series) Close prices
    :param vertical_barrier_zero: (bool) If True, set bin to 0 for events that touch vertical barrier, else bin is the sign of the return.
    :param pt_sl: (list) Take-profit and stop-loss multiples
    :return: (pd.DataFrame) Meta-labeled events
    :returns index: Event start times
    :returns t1: Event end times
    :returns trgt: Target returns
    :returns side: Optional. Algo's position side
    :returns ret: Returns of the event
    :returns bin: Labels for the event, where 1 is a positive return, -1 is a negative return, and 0 is a vertical barrier hit
    """

    # 1. Align prices with their respective events
    events = triple_barrier_events.dropna(subset=["t1"])
    all_dates = events.index.union(other=events["t1"].array).drop_duplicates()
    prices = close.reindex(all_dates, method="bfill")

    # 2. Create out DataFrame
    out_df = events[["t1"]].copy()
    out_df["ret"] = np.log(prices.loc[events["t1"].array].array / prices.loc[events.index])
    out_df["trgt"] = events["trgt"]

    # Meta labeling: Events that were correct will have pos returns
    if "side" in events:
        out_df["ret"] *= events["side"]  # meta-labeling

    if vertical_barrier_zero:
        # Label 0 when vertical barrier reached
        out_df["bin"] = barrier_touched(
            out_df["ret"].values,
            out_df["trgt"].values,
            np.array(pt_sl, dtype=float),
        )
    else:
        # Label is the sign of the return
        out_df["bin"] = np.where(out_df["ret"] > 0, 1, -1).astype("int8")

    # Meta labeling: label incorrect events with a 0
    if "side" in events:
        out_df.loc[out_df["ret"] <= 0, "bin"] = 0

    # Add the side to the output. This is useful for when a meta label model must be fit
    if "side" in triple_barrier_events.columns:
        out_df["side"] = triple_barrier_events["side"].astype("int8")

    out_df["ret"] = np.exp(out_df["ret"]) - 1  # Convert log returns to simple returns
    return out_df
NOTA: mp_pandas_obj(), utilizada anteriormente, é uma função auxiliar que permite o processamento paralelo de objetos pandas, já que, por padrão, o pandas executa os cálculos em apenas um núcleo do processador. O arquivo multiprocess.py contém essa função e outras ferramentas auxiliares para multiprocessamento.
Para atribuir o rótulo zero quando a barreira vertical é atingida, chamamos barrier_touched() dentro de get_bins().
# Snippet 3.9, page 55, Question 3.3
def barrier_touched(ret, target, pt_sl):
    """
    Advances in Financial Machine Learning, Snippet 3.9, page 55, Question 3.3.

    Adjust the getBins function (Snippet 3.7) to return a 0 whenever the vertical barrier is the one touched first.

    Top horizontal barrier: 1
    Bottom horizontal barrier: -1
    Vertical barrier: 0

    :param ret: (np.array) Log-returns
    :param target: (np.array) Volatility target
    :param pt_sl: (ArrayLike) Take-profit and stop-loss multiples
    :return: (np.array) Labels
    """
    N = ret.shape[0]  # Number of events
    store = np.empty(N, dtype=np.int8)  # Store labels in an array

    profit_taking_multiple = pt_sl[0]
    stop_loss_multiple = pt_sl[1]

    # Iterate through the DataFrame and check if the vertical barrier was reached
    for i in range(N):
        pt_level_reached = ret[i] > np.log(1 + profit_taking_multiple * target[i])
        sl_level_reached = ret[i] < np.log(1 - stop_loss_multiple * target[i])

        if ret[i] > 0.0 and pt_level_reached:
            # Top barrier reached
            store[i] = 1
        elif ret[i] < 0.0 and sl_level_reached:
            # Bottom barrier reached
            store[i] = -1
        else:
            # Vertical barrier reached
            store[i] = 0

    return store
Quando atribuir o rótulo zero e quando utilizar o sinal do retorno
Atribuir o rótulo zero a um evento que não atingiu nenhuma das barreiras de preço faz sentido quando queremos que o modelo se concentre exclusivamente em resultados bem definidos, com limites de risco estabelecidos. Já utilizar o sinal do retorno ao final do horizonte permite considerar todos os movimentos direcionais do preço, mesmo quando os limites de risco definidos não são atingidos.
Atribua o rótulo zero quando:
- Você estiver desenvolvendo um classificador de três classes (alta, baixa e neutro) e quiser que "neutro" represente a ausência de um movimento significativo dentro dos limites de risco estabelecidos.
- Você preferir excluir do treinamento os sinais ambíguos, ou seja, pequenos movimentos de preço que não chegaram a atingir nenhuma das barreiras.
- Você quiser avaliar o sucesso de um evento exclusivamente pelo atingimento dos limites de lucro ou prejuízo definidos, desconsiderando todos os demais resultados.
Atribua o rótulo correspondente ao sinal do retorno quando:
- Você precisar que cada exemplo tenha uma classificação binária de direção (alta ou baixa) e quiser evitar uma quantidade excessiva de rótulos neutros.
- Você estiver modelando o momentum ou o retorno ao longo de um horizonte temporal, em vez de resultados determinados estritamente por limites de risco.
- Você considerar que qualquer movimento de preço, por menor que seja, contém informações relevantes e deve influenciar o modelo.
Além dessa escolha, é importante considerar seus efeitos sobre o equilíbrio entre as classes e o ruído dos rótulos. Se houver muitos rótulos zero, você poderá aplicar subamostragem (undersampling) aos exemplos neutros ou elevar os níveis das barreiras horizontais. Por outro lado, se os rótulos baseados no sinal do retorno apresentarem muito ruído, você poderá estabelecer um limite mínimo de retorno antes de atribuir os rótulos +1/−1.
Amostragem baseada em eventos
Os traders não decidem aleatoriamente quando comprar ou vender valores mobiliários. Em vez disso, aguardam a ocorrência de determinados eventos no mercado antes de tomar uma decisão. Esses "eventos desencadeadores" podem incluir:
- A divulgação de indicadores econômicos importantes, como dados de emprego ou relatórios de inflação.
- Momentos em que os preços de mercado apresentam um aumento repentino e acentuado da volatilidade.
- Situações em que o diferencial de preço entre instrumentos relacionados se afasta significativamente de seu nível habitual.
Quando um desses eventos ocorre, ele pode indicar que algo relevante está acontecendo no mercado. A partir daí, podemos utilizar algoritmos de aprendizado de máquina para verificar se, nessas condições, existe uma função preditiva precisa.
A questão central é determinar se é possível desenvolver um modelo capaz de prever os movimentos do mercado com precisão nas condições em que esses eventos ocorrem. Se o algoritmo mostrar que determinado tipo de evento não permite gerar previsões precisas, precisaremos redefinir o que consideramos um evento significativo ou testar outros atributos como entradas do modelo.
Filtro CUSUM
Uma técnica eficaz de amostragem baseada em eventos é o filtro CUSUM, um método de controle estatístico da qualidade utilizado para detectar mudanças na média de uma variável observada. Em finanças, podemos adaptar esse filtro para selecionar pontos de dados sempre que uma variável de mercado, como o preço, apresentar um desvio significativo. O filtro CUSUM acumula os desvios em relação a um valor esperado e gera um evento de amostragem quando o desvio acumulado ultrapassa um limite predefinido.
O filtro CUSUM simétrico é definido da seguinte forma:
-
S⁺ = max(0, S⁺ + ΔP)
-
S⁻ = min(0, S⁻ + ΔP)
Em que ΔP representa a variação do preço. Um evento é gerado quando S⁺ ultrapassa o limiar positivo h ou S⁻ cai abaixo do limiar negativo -h. Quando isso ocorre, o acumulador correspondente é reiniciado. Esse método evita acionamentos repetidos quando o preço oscila próximo ao limiar, uma deficiência comum em indicadores de mercado populares, como as Bandas de Bollinger. Com o filtro CUSUM, podemos construir uma matriz de atributos X cujas observações são amostradas nos momentos de atividade significativa do mercado, fornecendo dados mais relevantes para nossos modelos de aprendizado de máquina.
# Snippet 2.4, page 39, The Symmetric CUSUM Filter.
def cusum_filter(raw_time_series, threshold, time_stamps=True):
    """
    Advances in Financial Machine Learning, Snippet 2.4, page 39.

    The Symmetric Dynamic/Fixed CUSUM Filter.

    The CUSUM filter is a quality-control method, designed to detect a shift in the mean value of a measured quantity
    away from a target value. The filter is set up to identify a sequence of upside or downside divergences from any
    reset level zero. We sample a bar t if and only if S_t >= threshold, at which point S_t is reset to 0.

    One practical aspect that makes CUSUM filters appealing is that multiple events are not triggered by raw_time_series
    hovering around a threshold level, which is a flaw suffered by popular market signals such as Bollinger Bands.
    It will require a full run of length threshold for raw_time_series to trigger an event.

    Once we have obtained this subset of event-driven bars, we will let the ML algorithm determine whether the occurrence
    of such events constitutes actionable intelligence. Below is an implementation of the Symmetric CUSUM filter.

    Note: As per the book this filter is applied to closing prices but we extended it to also work on other
    time series such as volatility.

    :param raw_time_series: (pd.Series) Close prices (or other time series, e.g. volatility).
    :param threshold: (float or pd.Series) When the abs(change) is larger than the threshold, the function captures
                      it as an event, can be dynamic if threshold is pd.Series
    :param time_stamps: (bool) Default is to return a DateTimeIndex, change to false to have it return a list.
    :return: (datetime index vector) Vector of datetimes when the events occurred. This is used later to sample.
    """

    t_events = []
    s_pos = 0
    s_neg = 0

    # log returns
    raw_time_series = pd.DataFrame(raw_time_series)  # Convert to DataFrame
    raw_time_series.columns = ['price']
    raw_time_series['log_ret'] = raw_time_series.price.apply(np.log).diff()
    if isinstance(threshold, (float, int)):
        raw_time_series['threshold'] = threshold
    elif isinstance(threshold, pd.Series):
        raw_time_series.loc[threshold.index, 'threshold'] = threshold
    else:
        raise ValueError('threshold is neither float nor pd.Series!')

    raw_time_series = raw_time_series.iloc[1:]  # Drop first na values

    # Get event time stamps for the entire series
    for tup in raw_time_series.itertuples():
        thresh = tup.threshold
        pos = float(s_pos + tup.log_ret)
        neg = float(s_neg + tup.log_ret)
        s_pos = max(0.0, pos)
        s_neg = min(0.0, neg)

        if s_neg < -thresh:
            s_neg = 0
            t_events.append(tup.Index)

        elif s_pos > thresh:
            s_pos = 0
            t_events.append(tup.Index)

    # Return DatetimeIndex or list
    if time_stamps:
        event_timestamps = pd.DatetimeIndex(t_events)
        return event_timestamps

    return t_events
Vamos analisar o desempenho de uma estratégia de reversão à média (mean-reverting) baseada nas Bandas de Bollinger, comparando sinais de entrada sem filtragem com sinais filtrados pelo CUSUM. Para treinamento e validação, utilizaremos barras temporais de 5 minutos do par EURUSD, referentes ao período de 2018-01-01 a 2021-12-31. Para o teste fora da amostra, utilizaremos os dados de 2022-01-01 a 2024-12-31.
Para esta demonstração, utilizaremos intencionalmente uma configuração sensível das Bandas de Bollinger (período de 20 e 1,5 desvios-padrão), a fim de gerar um grande número de sinais de trading para avaliação pelo meta-modelo. Embora essa configuração gere sinais excessivamente ruidosos para ser utilizada isoladamente como estratégia, ela oferece condições ideais para submeter nosso pipeline de rotulagem e filtragem a um teste de estresse.
Para garantir consistência e compatibilidade entre todas as estratégias, prefiro estruturá-las seguindo o paradigma de programação orientada a objetos do Python, especificamente por meio de uma interface comum ou classe-base. Essa abordagem permite que todas as estratégias disponibilizem as mesmas funcionalidades essenciais, como geração de sinais e filtragem de eventos, facilitando sua comparação, expansão e integração a fluxos de trabalho mais abrangentes. O uso de TA-Lib e Pandas TA para gerar sinais comumente utilizados é vantajoso porque essas bibliotecas implementam fórmulas padronizadas do setor e utilizam um backend altamente otimizado em C, o que as torna de 2 a 4 vezes mais rápidas do que implementações equivalentes em Python puro. Além disso, elas garantem saídas padronizadas e tratamento consistente de casos-limite, simplificando etapas posteriores, como rotulagem, filtragem e visualização. A instalação dessa biblioteca pode apresentar algumas dificuldades, por isso recomendo seguir as instruções apresentadas neste artigo.
import pandas as pd
from typing import Tuple, Union
import logging

from abc import ABC, abstractmethod
from typing import Dict, Tuple, Union

import numpy as np
import pandas as pd
import talib
from loguru import logger

class BaseStrategy(ABC):
    """Abstract base class for trading strategies"""

    @abstractmethod
    def generate_signals(self, data: pd.DataFrame) -> pd.Series:
        """Generate trading signals (1 for long, -1 for short, 0 for no position)"""
        pass

    @abstractmethod
    def get_strategy_name(self) -> str:
        """Return strategy name"""
        pass

    @abstractmethod
    def get_objective(self) -> str:
        """Return strategy objective"""
        pass

class BollingerMeanReversionStrategy(BaseStrategy):
    """Bollinger Bands mean reversion strategy"""

    def __init__(self, window: int = 20, num_std: float = 2.0, objective: str = "mean_reversion"):
        self.window = window
        self.num_std = num_std
        self.objective = objective

    def generate_signals(self, data: pd.DataFrame) -> pd.Series:
        """Generate mean-reversion signals using Bollinger Bands"""
        close = data["close"]

        # Calculate Bollinger Bands
        upper_band, _, lower_band = talib.BBANDS(
            close, timeperiod=self.window, nbdevup=self.num_std, nbdevdn=self.num_std
        )

        # Generate signals
        signals = pd.Series(0, index=data.index, dtype="int8", name="side")
        signals[(close >= upper_band)] = -1  # Sell signal (mean reversion)
        signals[(close <= lower_band)] = 1  # Buy signal (mean reversion)
        return signals

    def get_strategy_name(self) -> str:
        return f"Bollinger_w{self.window}_std{self.num_std}"

    def get_objective(self) -> str:
        return self.objective

def get_entries(
    strategy: 'BaseStrategy',
    data: pd.DataFrame,
    filter_events: bool = False,
    filter_threshold: Union[float, pd.Series] = None,
    on_crossover: bool = True,
) -> Tuple[pd.Series, pd.DatetimeIndex]:
    """Get timestamps and position information for entry events.

    This function processes signals from a given `BaseStrategy` to identify trade
    entry points. It can apply a CUSUM filter to isolate significant events or,
    by default, detect entries at signal crossover points.

    Args:
        strategy (BaseStrategy): The trading strategy object that generates the
            primary signals.
        data (pd.DataFrame): A pandas DataFrame containing the input data, expected
            to have a 'close' column if `filter_events` is True.
        filter_events (bool, optional): If True, a CUSUM filter is applied to the
            signals to identify significant events. Defaults to False.
        filter_threshold (Union[float, pd.Series], optional): The threshold for the
            CUSUM filter. Must be a float or a pandas Series. Defaults to None.
        on_crossover (bool, optional): If True, only events where the signal changes
            from the previous period are considered entry points. Defaults to True.

    Raises:
        ValueError: If `filter_events` is True and `filter_threshold` is not a
            `float` or `pd.Series`.

    Returns:
        Tuple[pd.Series, pd.DatetimeIndex]: A tuple containing:
            side (pd.Series): A Series with the same index as the input data,
                where each value represents the trading position (-1 for short,
                1 for long, 0 for no position).
            t_events (pd.DatetimeIndex): A DatetimeIndex of the timestamps for
                each detected entry event.
    """
    primary_signals = strategy.generate_signals(data)
    signal_mask = primary_signals != 0

    # Vectorized CUSUM filter application
    if filter_events:
        try:
            close = data.close
        except AttributeError as e:
            logger.error(f"Dataframe must have a 'close' column: {e}")
            raise e

        if not isinstance(filter_threshold, (pd.Series, float)):
            raise ValueError("filter_threshold must be a Series or a float")
        elif isinstance(filter_threshold, pd.Series):
            filter_threshold = filter_threshold.copy().dropna()
            close = close.reindex(filter_threshold.index)

        # Assuming cusum_filter is a function that takes a Series and a threshold
        filtered_events = cusum_filter(close, filter_threshold)
        signal_mask &= primary_signals.index.isin(filtered_events)
    else:
        # Vectorized signal change detection
        if on_crossover:
            signal_mask &= primary_signals != primary_signals.shift()

    t_events = primary_signals.index[signal_mask]

    side = pd.Series(index=data.index, name="side")
    side.loc[t_events] = primary_signals.loc[t_events]
    side = side.ffill().fillna(0).astype("int8")

    if filter_events:
        s = " generated by CUSUM filter"
    elif on_crossover:
        s = " generated by crossover"
    else:
        s = ""

    logger.info(f"Generated {len(t_events):,} trade events{s}.")

    return side, t_events
Engenharia de atributos para meta-rotulagem (Meta-Labeling)
Para captar as nuances da dinâmica das séries temporais financeiras, desenvolvemos um conjunto abrangente de atributos que combina rigor estatístico e conhecimento especializado em finanças. Esse conjunto inclui indicadores de momentum ajustados pela volatilidade, estruturas de autocorrelação e momentos de ordem superior dos retornos (assimetria e excesso de curtose), além de métricas baseadas nas Bandas de Bollinger e diferenças normalizadas entre médias móveis. Indicadores técnicos como RSI, MACD, ADX e ATR foram calculados com as bibliotecas TA-Lib e pandas-ta, garantindo consistência e reprodutibilidade dos resultados. Ao combinar atributos de curto e longo prazo, desde retornos defasados e estimativas de volatilidade de Yang-Zhang até indicadores de acompanhamento de tendências, o modelo consegue identificar mudanças sutis no comportamento do mercado e se adaptar às mudanças nas condições de negociação. O código está disponível no arquivo features.py, fornecido em anexo.
Para demonstrar a eficácia do filtro CUSUM, treinei um modelo Random Forest utilizando sinais não filtrados e sinais filtrados, com base nos nossos dados de 5 minutos do EURUSD. As barreiras horizontais foram definidas utilizando a volatilidade diária ponderada exponencialmente, calculada com uma janela retrospectiva de 100 dias, como referência para definir as barreiras horizontais, armazenada na variável target. O multiplicador da barreira de realização de lucro (take-profit) foi definido como 1, enquanto o da barreira de stop-loss foi definido como 2. A barreira vertical (período máximo de permanência na posição) foi estabelecida em 50 barras.
target = get_daily_vol(close, lookback=100)
cusum_filter_threshold = target.mean()
Impacto da filtragem dos dados
Antes de comparar os modelos, vamos examinar brevemente as principais métricas apresentadas em cada relatório de classificação:- Precisão (Precision): proporção de previsões positivas corretas em relação ao total de previsões positivas realizadas. Uma precisão elevada indica poucos falsos positivos.
- Revocação (Recall): proporção de casos efetivamente positivos que foram identificados corretamente. Uma revocação elevada indica que poucos eventos positivos deixaram de ser identificados.
- Medida F1 (F1-score): a acurácia (Accuracy) pode não ser uma métrica adequada para avaliar modelos em tarefas de meta-rotulagem (meta-labeling). Suponha que, após aplicar a meta-rotulagem, o número de casos negativos (rótulo '0') seja muito maior do que o de casos positivos (rótulo '1'). Nesse cenário, um classificador que preveja todos os casos como negativos alcançará uma acurácia elevada (Accuracy), embora sua revocação (Recall) seja igual a 0 e sua precisão (Precision) seja indefinida. A medida F1 permite contornar essa limitação ao avaliar o classificador por meio da média harmônica da precisão e da revocação, atribuindo o mesmo peso às duas métricas.
- Suporte (Support): número de exemplos de cada classe no conjunto de validação.
- Acurácia (Accuracy): proporção total de previsões corretas, considerando todas as classes.
Para uma explicação detalhada dessas métricas, consulte o artigo "Como interpretar o relatório de classificação do sklearn".
Antes de comparar os resultados, observe como o filtro CUSUM reduz o tamanho da amostra em 76,1%.
| Sinais não filtrados | Sinais filtrados | Sinais filtrados Redução, % |
|---|---|---|
| 32.828 | 7.825 | 76,1 |
TABELA 0: Quantidade de sinais — filtrados versus não filtrados
O filtro CUSUM tem como objetivo eliminar o "ruído" associado à dinâmica da classe 0 (eventos neutros). O resultado ideal é melhorar a medida F1 da classe 1 (identificação mais eficaz de eventos significativos), preservando a medida F1 da classe 0 (ausência de sinais falsos). Nosso modelo principal com filtragem apresenta o resultado ideal, mas o meta-modelo (meta-model) com filtragem registra uma redução de 5,8% na medida F1 da classe 0. Para atenuar esse efeito, podemos ajustar os hiperparâmetros do modelo ou modificar o conjunto de atributos.
| Métrica | Sem filtragem | Com filtragem | Δ |
|---|---|---|---|
| Revocação (Recall) (1) | 1,00 | 1,00 | 0% |
| Precisão (Precision) (1) | 0,33 | 0,38 | +15,2% |
| F1 (1) | 0,49 | 0,55 | +11,0% |
| Métrica | Sem filtragem | Com filtragem | Δ |
|---|---|---|---|
| F1 (0) | 0,69 | 0,65 | -5,8% |
| F1 (1) | 0,57 | 0,60 | +5,3% |
| Acurácia | 0,64 | 0,63 | -1,6% |
Tabela 4: Comparação dos meta-modelos filtrados e não filtrados (Meta-Models)
A relação entre a redução do volume de dados e o desempenho do modelo pode ser avaliada da seguinte forma:
- Retenção do desempenho = (desempenho com filtragem / desempenho sem filtragem) × 100
- Benefício líquido = retenção do desempenho - redução do volume de dados
Se o benefício líquido for positivo, o filtro é considerado eficaz e deve ser utilizado.
| Modelo | Redução dos dados | Retenção do desempenho | Benefício líquido |
|---|---|---|---|
| Modelo principal | 76,1% | 112,2% | +36,1% |
| Meta-modelo (Meta) | 76,1% | 98,5% | +22,4% |
Tabela 5: Análise da relação entre redução de dados e desempenho
As principais conclusões da comparação entre os sinais não filtrados e os sinais filtrados são:
- O filtro CUSUM eliminou 76,1% dos eventos, considerados ruído.
- A filtragem melhorou a precisão tanto do modelo principal quanto do meta-modelo.
- Apesar da redução de 76% no volume de dados, a filtragem provocou apenas uma pequena queda no desempenho geral do meta-modelo. A medida F1 da classe 1 aumentou 5,3%, enquanto a da classe 0 caiu 5,6%. Mesmo com essa redução na medida F1 da classe 0, o uso do filtro CUSUM ainda proporcionou um benefício líquido positivo.
Meta-rotulagem na prática: estratégia baseada nas Bandas de Bollinger
Os relatórios de classificação e as curvas ROC apresentados a seguir reforçam uma conclusão importante: a meta-rotulagem é mais eficaz quando combinada com métodos de rotulagem realistas que levam o risco em consideração.
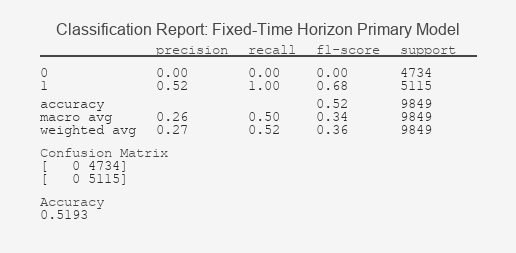
Figura 1: Relatório de classificação do modelo principal com horizonte temporal fixo
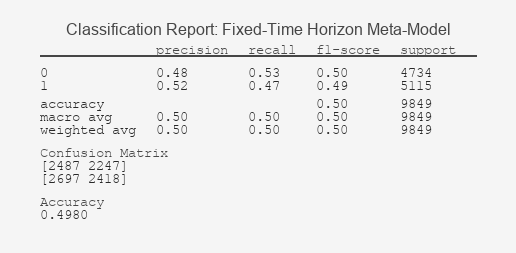
Figura 2: Relatório de classificação do meta-modelo com horizonte temporal fixo
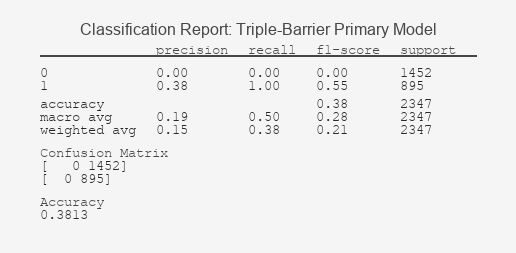
Figura 3: Relatório de classificação do modelo principal com o método da barreira tripla
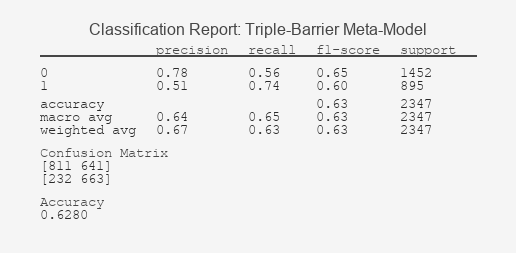
Figura 4: Relatório de classificação do meta-modelo com o método da barreira tripla
Curvas ROC
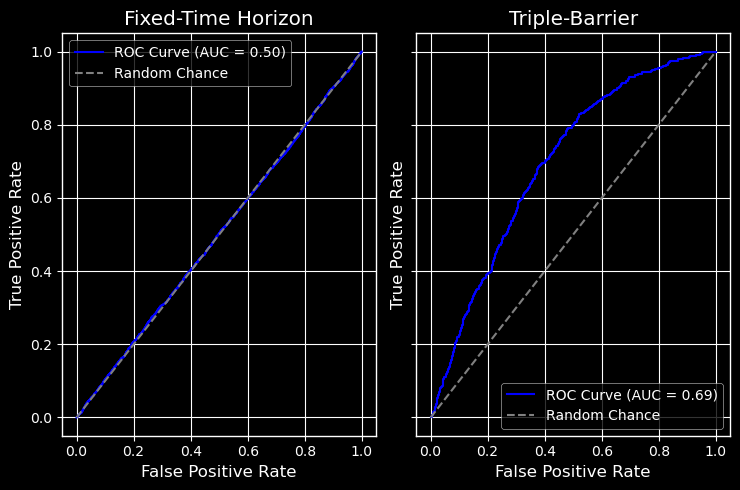
Figura 5: curvas ROC: comparação dos meta-modelos com horizonte temporal fixo e com o método da barreira tripla
Interpretação dos resultados: compreendendo o desempenho do modelo
O contraste marcante entre os resultados obtidos confirma a hipótese central: a rotulagem dos dados é determinante para o sucesso do modelo. O relatório de classificação do modelo com horizonte temporal fixo revela sua incapacidade de aprender padrões relevantes. A curva ROC praticamente coincidente com a diagonal confirma visualmente que o modelo não consegue distinguir os sinais melhor do que uma classificação aleatória, característica de um classificador sem utilidade preditiva. Em contrapartida, o relatório do modelo baseado no método da barreira tripla demonstra que ele conseguiu identificar padrões com capacidade preditiva. Esse resultado é reforçado pela curvatura acentuada da curva ROC em direção ao canto superior esquerdo, indicando um compromisso favorável entre a taxa de verdadeiros positivos e a taxa de falsos positivos. O valor de AUC-ROC significativamente superior a 0,5 confirma que esse modelo apresenta capacidade preditiva relevante.
Mais importante ainda, as métricas de precisão (precision) têm implicações diretas para o trading: uma precisão maior na classe "1" significa que uma proporção maior das operações previstas como lucrativas (meta-rótulos) provavelmente se confirmará. Isso, por sua vez, aumenta a rentabilidade potencial da estratégia e fornece uma base estatística concreta para dimensionar as posições de acordo com a confiança do modelo.
Relevância econômica: resultados fora da amostra
Embora o modelo baseado no método da barreira tripla tenha apresentado uma melhora estatisticamente significativa na AUC, seu verdadeiro valor fica evidente na curva de capital simulada. A Figura 7 mostra que a estratégia que utiliza nosso novo método de rotulagem obteve um retorno de -0,03%, com drawdown máximo de 36,9%, superando significativamente a estratégia de referência com horizonte temporal fixo, que registrou um retorno de -0,71% e drawdown máximo de 76%.
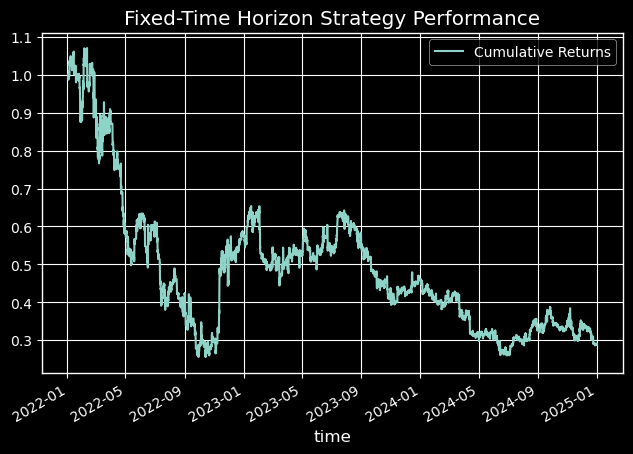
Figura 6: Curva de capital da estratégia com horizonte temporal fixo
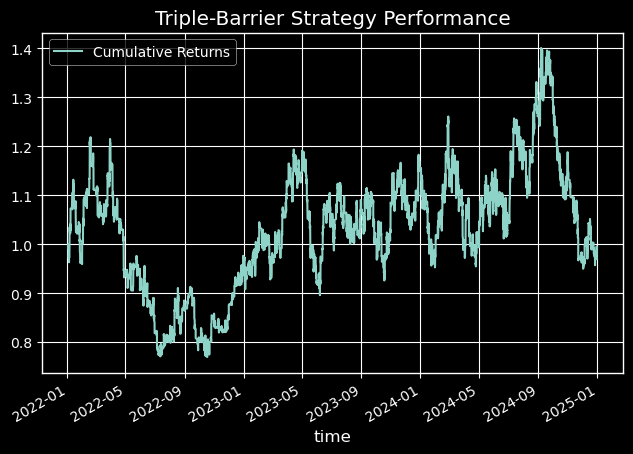
Figura 7: Curva de capital da estratégia com o método da barreira tripla
A tabela a seguir apresenta todas as métricas de desempenho de cada método de rotulagem:
| Métrica (Metrics) | Horizonte temporal fixo (Fixed-Time Horizon) | Barreira tripla (Triple-Barrier) |
|---|---|---|
| Retorno total (total_return) | -0,709771 | -0,028839 |
| Retorno anualizado (annualized_return) | -0,338102 | -0,009714 |
| Volatilidade (volatility) | 0,483111 | 0,37613 |
| Volatilidade de baixa (downside volatility) | 0,336945 | 0,231413 |
| Índice de Sharpe (sharpe_ratio) | -4,778646 | -0,021566 |
| Índice de Sortino (sortino_ratio) | -6,851611 | -0,035053 |
| var_95 | -0,002864 | -0,00215 |
| cvar_95 | -0,004164 | -0,002992 |
| Coeficiente de assimetria (skewness) | -0,014451 | 0,034745 |
| Excesso de curtose (kurtosis) | 3,857222 | 2,507046 |
| Drawdown máximo (max_drawdown) | 0,761708 | 0,368585 |
| Drawdown médio (avg_drawdown) | 0,08375 | 0,039945 |
| Duração do drawdown (drawdown_duration) | 84 dias 01:18:50 | 32 dias 03:17:12 |
| Índice de Úlcera (Ulcer Index) | 0,217503 | 0,098507 |
| Índice de Calmar (calmar_ratio) | -0,443874 | -0,026354 |
| Frequência de apostas (bet_frequency) | 3901 | 3969 |
| Número de apostas por ano (bets_per_year) | 1300,040115 | 1322,701671 |
| Número de operações (num_trades) | 37691 | 27426 |
| Número de operações por ano | 12560,83363 | 9139,93853 |
| Taxa de acerto (Win Rate) | 0,497546 | 0,504339 |
| Ganho médio (avg_win) | 0,001266 | 0,001081 |
| Perda média (avg_loss) | -0,001322 | -0,001105 |
| Melhor operação (best_trade) | 0,014599 | 0,01451 |
| Pior operação (worst_trade) | -0,013828 | -0,010548 |
| Fator de lucro (Profit Factor) | 0,952754 | 0,999799 |
| Retorno esperado (Expectancy) | -0,000034 | -0,000002 |
| Critério de Kelly (kelly_criterion) | -0,027194 | -0,002226 |
| Número de operações vencedoras consecutivas (consecutive_wins) | 77 | 92 |
| Número de operações perdedoras consecutivas (consecutive_losses) | 66 | 90 |
| Duração média das operações (avg_trade_duration) | 0 dias 00:39:18 | 0 dias 06:22:15 |
Tabela 6: Métricas de desempenho fora da amostra
Conclusão
Nesta segunda parte da série de artigos "MetaTrader 5 e aprendizado de máquina: guia prático", analisamos como a escolha do método de rotulagem influencia o comportamento e a confiabilidade dos modelos financeiros. Ao deixar de lado os horizontes temporais fixos e adotar métodos que consideram a trajetória do preço, como o método da barreira tripla, mostramos como incorporar critérios de risco e a dinâmica realista das operações diretamente ao treinamento dos modelos.
A meta-rotulagem (Meta-labeling) mostrou-se um complemento estratégico, capaz de filtrar sinais com baixo nível de confiança e aumentar a precisão, especialmente quando combinada com métodos de rotulagem confiáveis. Os relatórios de classificação e as curvas ROC demonstram como essa abordagem em múltiplas camadas melhora a qualidade dos sinais, mesmo com uma filtragem agressiva.
Mas nossa jornada está longe de terminar.
No próximo artigo, implementaremos o método de varredura de tendências (trend-scanning method), que permitirá aos modelos selecionar dinamicamente seus horizontes de previsão com base em movimentos de preço estatisticamente significativos. Isso abre novas possibilidades de adaptação às condições de mercados voláteis.
Também abordaremos o problema da simultaneidade (concurrency) nos dados financeiros, que ocorre quando vários sinais se sobrepõem no tempo. Para isso, introduziremos pesos das amostras (sample weights), que refletem o grau de unicidade e a relevância de cada observação. Isso garante que nossos modelos aprenderão com sinais efetivamente independentes, em vez de serem influenciados por ruído redundante.
Por fim, veremos como utilizar as probabilidades geradas pela meta-rotulagem para dimensionar as posições de maneira mais inteligente. Em vez de simplesmente executar ou descartar cada sinal, utilizaremos as probabilidades estimadas pelo modelo para ajustar o tamanho das posições, alinhando o capital alocado ao nível de confiança das previsões.
Em conjunto, esses aprimoramentos nos aproximarão da construção de um pipeline de aprendizado de máquina para mercados financeiros pronto para produção, que seja não apenas tecnicamente sólido, mas também estrategicamente alinhado ao comportamento real de negociação.
Traduzido do Inglês pela MetaQuotes Ltd.
Artigo original: https://www.mql5.com/en/articles/18864
Aviso: Todos os direitos sobre esses materiais pertencem à MetaQuotes Ltd. É proibida a reimpressão total ou parcial.
Esse artigo foi escrito por um usuário do site e reflete seu ponto de vista pessoal. A MetaQuotes Ltd. não se responsabiliza pela precisão das informações apresentadas nem pelas possíveis consequências decorrentes do uso das soluções, estratégias ou recomendações descritas.


Tem uma coisa que não entendo:
Se você treinar modelos não com os dados brutos de ticks, mas com barras construídas (tempo, tick etc.), é preciso construir essas barras durante a negociação em tempo real?
Tem uma coisa que eu não entendo:
Se você treinar modelos não com os dados brutos de ticks, mas com barras construídas (tempo, tick etc.), é preciso construir essas barras durante a negociação ao vivo?