
Recursos do Assistente MQL5 que você precisa conhecer (Parte 74): Uso dos padrões Ichimoku e ADX-Wilder com aprendizado supervisionado
 21
 0

Introdução
No artigo anterior, analisamos a combinação dos indicadores Ichimoku e ADX-Wilder como ferramentas complementares para identificar níveis de suporte e resistência e avaliar tendências. Como de costume, realizamos os testes em um EA criado com o Assistente MQL5 e examinamos 10 padrões de sinal diferentes. A maioria dos padrões avaliados com essa combinação apresentou resultados satisfatórios no teste forward de um ano, após realizar os testes e a otimização no ano anterior. No entanto, três padrões não apresentaram resultados satisfatórios: os padrões 0, 1 e 5. Vamos dar continuidade à análise iniciada naquele artigo e investigar se o aprendizado supervisionado pode melhorar seus resultados. Nossa abordagem consiste em representar os sinais de cada um desses padrões como um vetor de entrada simples para uma rede neural, fazendo com que ela atue, essencialmente, como um filtro adicional dos sinais.
A rede
Como modelo de aprendizado supervisionado, escolhemos uma rede neural baseada em um kernel de mistura espectral (Spectral Mixture Kernel), definido pela seguinte fórmula:

em que:
- τ \tau - diferença de tempo entre dois pontos.
- Q - número de componentes espectrais.
- wi - peso do i-ésimo componente (amplitude).
- li - escala de comprimento do i-ésimo componente (controla o decaimento).
- fi - frequência do i-ésimo componente (frequência de oscilação).
Utilizamos o kernel de mistura espectral para definir a camada de entrada de uma rede neural simples, seguida por camadas lineares do PyTorch (PyTorch-Linear). Vamos criar e utilizar uma camada de mistura espectral. Implementaremos essa camada e as redes regressoras subsequentes em Python, conforme mostrado abaixo:
class DeepSpectralMixtureRegressor(nn.Module):
    def __init__(self, input_dim=2, num_components=96):
        super().__init__()
        self.smk = DeepSpectralMixtureLayer(input_dim, num_components)
        feature_dim = input_dim * num_components  # 2 * 96 = 192

        self.head = nn.Sequential(
            nn.Linear(feature_dim, 1024),
            nn.ReLU(),
            nn.Linear(1024, 512),
            nn.ReLU(),
            nn.Linear(512, 256),
            nn.ReLU(),
            nn.Linear(256, 128),
            nn.ReLU(),
            nn.Linear(128, 1)  # <--- Removed sigmoid!
        )

    def forward(self, x):
        features = self.smk(x)
        output = self.head(features)
        return output
Alguns estudos indicam que o uso desse kernel de mistura específico na entrada permite extrair atributos dos dados, enquanto as camadas seguintes, responsáveis pela regressão na saída, são adequadas quando o modelo atua como regressor, como ilustrado pelo exemplo que utiliza a função sigmoide. No algoritmo baseado no kernel de mistura espectral que escolhemos, a primeira camada modela os padrões periódicos dos dados, enquanto as camadas do bloco regressor aprendem as frequências, as variâncias e os pesos da rede. Nossa abordagem de implementação é especialmente adequada para tarefas de regressão em que os dados de entrada apresentam padrões oscilatórios. Ela também combina a flexibilidade das redes neurais com conceitos dos processos gaussianos.
Nossa rede neural recebe o nome DeepSpectralMixtureRegressor. Também adotamos uma arquitetura modular dividida em dois componentes: extração de atributos e regressão. A primeira etapa, dedicada à extração de atributos, é implementada pela função DeepSpectralMixtureLayer, cujo código é apresentado a seguir:
class DeepSpectralMixtureLayer(nn.Module):
    def __init__(self, input_dim, num_components):
        super().__init__()
        self.num_components = num_components
        hidden = 512  # Wider hidden layers

        # Go deeper with 4 layers
        def make_subnet():
            return nn.Sequential(
                nn.Linear(input_dim, hidden),
                nn.ReLU(),
                nn.Linear(hidden, hidden),
                nn.ReLU(),
                nn.Linear(hidden, hidden),
                nn.ReLU(),
                nn.Linear(hidden, num_components),
            )

        self.freq_net = make_subnet()
        self.var_net = nn.Sequential(*make_subnet(), nn.Softplus())
        self.weight_net = nn.Sequential(*make_subnet(), nn.Softplus())

    def forward(self, x):
        mu = self.freq_net(x)
        v = self.var_net(x)
        w = self.weight_net(x)

        expanded = x.unsqueeze(2)
        mu = mu.unsqueeze(1)
        v = v.unsqueeze(1)
        w = w.unsqueeze(1)

        x_cos = torch.cos(2 * np.pi * expanded * mu)
        x_exp = torch.exp(-v * expanded**2)
        features = w * x_exp * x_cos

        return features.flatten(start_dim=1)
A função descrita acima utiliza redes neurais para aprender as frequências, as variâncias e os pesos. A função de ativação softplus garante que os valores das variâncias e dos pesos sejam positivos. O bloco de regressão transforma os atributos extraídos em um único sinal de saída, utilizando uma função de ativação sigmoide para tarefas de regressão com valores de saída limitados ou classificação binária. Uma das principais vantagens dessa arquitetura é sua capacidade de adaptação a diferentes padrões nos dados. Isso a torna adequada para tarefas como a previsão de séries temporais, especialmente quando há componentes periódicos. Assim, a arquitetura combina os recursos das redes neurais com métodos baseados em kernels.
Wilson et al. (2013) observam que os kernels de mistura espectral podem ser implementados em bibliotecas como GPyTorch como funções de covariância de processos gaussianos para modelar padrões periódicos, desde que a densidade espectral seja representada como uma mistura de componentes. Nossa abordagem adapta esse conceito a uma rede neural, utilizando redes neurais para parametrizar os componentes do kernel: frequência, variância e pesos. Isso permite ao modelo aprender a partir dos dados e extrair atributos, o que pode ser especialmente útil em tarefas como a previsão de séries temporais que apresentam padrões periódicos ou oscilatórios. Esse aspecto também foi destacado por Sebastian Callh em seu blog sobre kernels de mistura espectral. Para utilizar esse kernel, também nos baseamos, em parte, nas ideias apresentadas na documentação do GPyTorch.
Em resumo, em vez de utilizar um conjunto fixo de parâmetros, nosso modelo emprega redes neurais para aprender as frequências, representadas por μ, as variâncias, representadas por v, e os pesos, representados por w. Essa abordagem permite que o modelo se adapte a diferentes padrões nos dados. A primeira camada extrai os atributos por meio da fórmula 'w exp(-v x^2) * cos(2πμx)', que captura a periodicidade por meio da modulação cossenoidal, enquanto o fator exponencial promove uma atenuação suave da amplitude. A separação entre a extração de atributos, realizada pela camada DeepSpectralMixtureLayer, e o bloco de regressão, implementado como um componente independente, torna a arquitetura mais flexível. O bloco de regressão, por sua vez, consiste em uma rede neural profunda e totalmente conectada, que utiliza uma função de ativação sigmoide para transformar os atributos em um único sinal de saída. Como já mencionado, essa configuração é adequada para tarefas de regressão com valores de saída limitados ou classificação binária.
Vamos examinar atentamente o código apresentado acima para entender como os recursos descritos foram implementados. O código começa com as importações padrão do PyTorch e de bibliotecas relacionadas. Essas importações disponibilizam ferramentas para operações com tensores, construção de redes neurais, otimização, processamento de dados e exportação do modelo treinado para ONNX, permitindo executar a inferência em plataformas externas. Esses recursos são essenciais para criar, treinar e implantar o modelo, além de serem fundamentais não apenas para o desenvolvimento com PyTorch, mas também para o aprendizado de máquina em geral. Recomenda-se ainda garantir a compatibilidade entre as versões do PyTorch e do ONNX para permitir o carregamento eficiente dos dados durante o treinamento.
Em seguida, passamos à inicialização de DeepSpectralMixtureLayer, que define três redes neurais: uma para as frequências, outra para as variâncias e outra para os pesos. Cada rede transforma os dados de entrada em um número definido de componentes de saída. A função de ativação softplus garante que os valores das variâncias e dos pesos sejam positivos, conforme exige a definição do kernel. Isso é importante porque essas redes parametrizam separadamente os componentes do kernel de mistura espectral, permitindo extrair atributos dos dados com base em conceitos associados aos processos gaussianos. O parâmetro num_components controla a riqueza da representação dos atributos e pode ser ajustado de acordo com a complexidade da tarefa. O uso da ativação softplus também evita valores negativos que poderiam causar instabilidade numérica.
Em seguida, implementamos a função de propagação para frente da rede. Essa função calcula os atributos da mistura espectral utilizando a fórmula apresentada anteriormente. Ela transforma os dados de entrada e os parâmetros em uma representação que pode ser encaminhada ao bloco de saída. A combinação das funções cosseno e exponencial produz atributos que representam oscilações com amplitude suavemente atenuada, posteriormente utilizados pelas camadas de regressão. Essa transformação principal simula o comportamento do kernel de mistura espectral. Os dados de entrada x devem ter o formato (batch_size, input_dim). Além disso, para manter a estabilidade numérica no cálculo de exp, pode ser necessário limitar a variância v. O parâmetro num_components também pode ser ajustado conforme a dimensionalidade desejada para os atributos.
Depois de analisar a camada de extração de atributos, podemos passar ao regressor, definido como uma classe no modelo. O objetivo principal é combinar a camada de mistura espectral descrita anteriormente com um módulo composto por camadas totalmente conectadas. Esse módulo transforma os atributos extraídos pelo kernel em um único sinal de saída no intervalo de 0 a 1, utilizando uma função de ativação sigmoide. Sua arquitetura pode ser ajustada de acordo com a complexidade da tarefa, aumentando o tamanho das camadas ou sua quantidade. Para tarefas de regressão sem limites nos valores de saída, a função sigmoide pode ser removida. Por fim, também definimos a função forward, assim como fizemos na camada espectral apresentada anteriormente. Os dados de entrada passam primeiro pela camada de mistura espectral, responsável pela extração de atributos, e depois pelo módulo de regressão, que gera a saída final. A função forward define toda a propagação para frente da rede, permitindo o treinamento de ponta a ponta e a inferência.
A dimensão do parâmetro de entrada x deve corresponder a input-dim. Considerando o uso da função de ativação sigmoide, uma função de perda como a BCE é adequada para nosso modelo. O parâmetro num-components tem grande influência no desempenho da rede, pois determina o número total de componentes espectrais. Valores mais altos aumentam a capacidade expressiva do modelo, mas também elevam o risco de sobreajuste. Uma abordagem razoável é começar com 64 componentes e ajustar esse valor conforme a complexidade dos dados. Dada a elevada capacidade expressiva da camada de mistura espectral, pode ser decisivo monitorar sinais de sobreajuste durante o treinamento. Técnicas de regularização e parada antecipada podem ajudar a reduzir esse risco.
A análise dos parâmetros aprendidos μ, v e w pode ajudar a compreender os padrões periódicos observados nos exemplos do GPyTorch. Diferentemente dos modelos tradicionais de processos gaussianos, nossa abordagem não fornece estimativas de incerteza. Poderíamos complementar a análise com medidas quantitativas dessa incerteza. Por fim, a propagação para frente pode exigir um custo computacional elevado, especialmente quando o parâmetro num-components assume valores muito altos ou os dados de entrada têm alta dimensionalidade. Esse é mais um fator a considerar durante o ajuste fino e a otimização do modelo.
Implementação dos indicadores
Com base nos padrões de sinal avaliados no artigo anterior, a maioria apresentou resultados satisfatórios nos testes forward, com exceção dos padrões 0, 1 e 5. Em resumo, testamos e otimizamos 10 padrões de sinal para o GBPUSD em 2023. Utilizamos o período gráfico de 30 minutos, em vez das 4 horas habituais, porque os sinais do Ichimoku tendem a ocorrer com menor frequência em períodos gráficos mais longos. Como de costume, nossos testes forward abrangeram o ano de 2024. Embora 7 dos 10 padrões tenham apresentado resultados satisfatórios no teste forward de 2025, nossa avaliação abrangeu apenas dois anos. Por isso, recomendamos que o leitor realize verificações adicionais e testes mais rigorosos com históricos de preços mais extensos antes de utilizar os padrões apresentados em operações reais.
Com isso em mente, vamos examinar como as funções dos indicadores Ichimoku e ADX-Wilder são implementadas em Python, juntamente com as funções de extração de atributos dos padrões 0, 1 e 5.
Ichimoku em Python
A função do Ichimoku em Python é implementada da seguinte forma:
def Ichimoku(df, tenkan_period: int = 9, kijun_period: int = 26, senkou_span_b_period: int = 52, displacement: int = 26) -> pd.DataFrame:
    """
    Calculate Ichimoku Kinko Hyo components and append them to the input DataFrame.

    The components are:
        - Tenkan-sen (Conversion Line)
        - Kijun-sen (Base Line)
        - Senkou Span A (Leading Span A)
        - Senkou Span B (Leading Span B)
        - Chikou Span (Lagging Span)

    Args:
        df (pd.DataFrame): DataFrame with 'high', 'low', and 'close' columns.
        tenkan_period (int): Lookback period for Tenkan-sen (default 9).
        kijun_period (int): Lookback period for Kijun-sen (default 26).
        senkou_span_b_period (int): Lookback period for Senkou Span B (default 52).
        displacement (int): Forward displacement of Senkou spans and backward shift of Chikou span (default 26).

    Returns:
        pd.DataFrame: Input DataFrame with added Ichimoku columns.
    """
    # Input validation
    required_cols = {'high', 'low', 'close'}
    if not required_cols.issubset(df.columns):
        raise ValueError("DataFrame must contain 'high', 'low', and 'close' columns")
    if not all(p > 0 for p in [tenkan_period, kijun_period, senkou_span_b_period, displacement]):
        raise ValueError("All period values must be positive integers")

    result_df = df.copy()

    # Tenkan-sen (Conversion Line)
    high_tenkan = result_df['high'].rolling(window=tenkan_period).max()
    low_tenkan = result_df['low'].rolling(window=tenkan_period).min()
    result_df['Tenkan_sen'] = (high_tenkan + low_tenkan) / 2

    # Kijun-sen (Base Line)
    high_kijun = result_df['high'].rolling(window=kijun_period).max()
    low_kijun = result_df['low'].rolling(window=kijun_period).min()
    result_df['Kijun_sen'] = (high_kijun + low_kijun) / 2

    # Senkou Span A (Leading Span A)
    result_df['Senkou_Span_A'] = ((result_df['Tenkan_sen'] + result_df['Kijun_sen']) / 2).shift(displacement)

    # Senkou Span B (Leading Span B)
    high_span_b = result_df['high'].rolling(window=senkou_span_b_period).max()
    low_span_b = result_df['low'].rolling(window=senkou_span_b_period).min()
    result_df['Senkou_Span_B'] = ((high_span_b + low_span_b) / 2).shift(displacement)

    # Chikou Span (Lagging Span)
    result_df['Chikou_Span'] = result_df['close'].shift(-displacement)

    return result_df
A função apresentada acima calcula os componentes do indicador e os adiciona ao DataFrame de entrada, utilizando os seguintes parâmetros padrão: 9 períodos para o Tenkan-sen, 26 para o Kijun-sen, deslocamento de 26 períodos e 52 períodos para o Senkou Span B. A primeira linha do código verifica os dados de entrada. Essa verificação garante que o DataFrame contenha as colunas de preços necessárias e que os parâmetros dos períodos sejam positivos, evitando erros de cálculo. Essa etapa é essencial para preservar a integridade dos dados e prevenir erros de execução. Nossa função do indicador precisa receber dados de entrada válidos para funcionar corretamente. É sempre recomendável validar os dados antes do processamento, a fim de lidar adequadamente com valores ausentes ou parâmetros inválidos.
Concluída a validação dos dados, passamos ao cálculo da Tenkan-sen. O código calcula a média entre a máxima mais alta e a mínima mais baixa registradas ao longo do período definido por tenkan-period. Normalmente, utilizamos 9 períodos, o que permite à linha representar a tendência de curto prazo. Esse buffer ajuda a identificar possíveis reversões de tendência quando ocorre um cruzamento com a linha Kijun-sen. Isso pode ser útil para decisões de trading de curto prazo, pois reflete os movimentos recentes dos preços. O parâmetro Tenkan-period pode ser ajustado conforme a sensibilidade desejada às oscilações de curto prazo. Períodos menores tornam a linha mais sensível às variações de preço, enquanto períodos maiores reduzem essa sensibilidade.
Em seguida, calculamos o buffer Kijun-sen. Seu cálculo é semelhante ao da Tenkan-sen, mas considera um período mais longo, normalmente de 26 períodos. Com isso, obtemos um indicador da tendência de médio prazo. A Kijun-sen é importante porque ajuda a confirmar a direção da tendência e atua como nível de suporte ou resistência, oferecendo uma referência geralmente mais estável para a análise do mercado do que a Tenkan-sen. Por isso, é útil na análise de médio prazo, e os cruzamentos com a linha Tenkan-sen também podem gerar sinais de trading.
Depois, calculamos a Senkou Span A, que corresponde à média entre a Tenkan-sen e a Kijun-sen, deslocada para a frente pelo número de períodos definido no parâmetro de deslocamento, normalmente 26. Essa linha forma uma das bordas da nuvem Kumo. Sua importância está na indicação de possíveis níveis futuros de suporte e resistência, oferecendo uma perspectiva prospectiva para a análise da tendência com base nos níveis projetados, como já mencionado. É importante observar a posição do preço em relação à nuvem: quando está acima dela, isso indica uma tendência de alta; quando está abaixo, uma tendência de baixa.
Na sequência, calculamos a Senkou Span B, obtida pela média entre a máxima mais alta e a mínima mais baixa de um período normalmente definido como 52, com o resultado deslocado para a frente. Essa linha forma a segunda borda da nuvem Kumo. A Senkou Span B oferece uma perspectiva de prazo mais longo sobre os níveis de suporte e resistência e contribui para identificar a tendência, especialmente em períodos gráficos mais longos. A espessura da nuvem, definida pela distância entre as linhas Senkou Span A e B, também pode ser utilizada como referência de volatilidade. Assim, nuvens mais espessas podem indicar níveis de suporte ou resistência mais fortes.
Por fim, calculamos o último buffer, a Chikou Span. Ele corresponde ao preço de fechamento deslocado para trás por um número de períodos normalmente igual a 26, permitindo comparar os preços atuais com os históricos. Essa comparação ajuda a confirmar a tendência ao mostrar se os preços atuais estão acima ou abaixo dos anteriores, o que é útil para validar sua direção. Portanto, a principal função da Chikou Span é servir como elemento de confirmação na análise dos dados. Para isso, é importante dispor de dados históricos suficientes, considerando os deslocamentos e os períodos mais longos utilizados no cálculo das médias.
ADX-Wilder em Python
Após implementar o Ichimoku em Python, passamos ao ADX de Wilder. Essa função calcula o ADX utilizando o método de Wilder. Assim como fizemos com o Ichimoku, adicionamos aos dados originais de preços os buffers ADX, +DI e -DI. O indicador utiliza um período padrão de 14, que pode ser ajustado para alinhar seu período aos parâmetros do Ichimoku ou aumentar sua sensibilidade às variações de preço. Neste caso, porém, mantemos o período padrão de 14. Sua implementação em Python é a seguinte:
def ADX_Wilder(df, period: int = 14) -> pd.DataFrame:
    """
    Calculate the Average Directional Index (ADX) using Wilder's method and
    append the ADX, +DI, and -DI columns to the input DataFrame.

    ADX measures trend strength, while +DI and -DI measure trend direction.

    Args:
        df (pd.DataFrame): DataFrame with 'high', 'low', and 'close' columns.
        period (int): The lookback period to use. Default is 14.

    Returns:
        pd.DataFrame: Input DataFrame with 'ADX', '+DI', and '-DI' columns.
    """
    if not all(col in df.columns for col in ['high', 'low', 'close']):
        raise ValueError("DataFrame must contain 'high', 'low', and 'close' columns")
    if period <= 0:
        raise ValueError("Period must be a positive integer")

    result_df = df.copy()

    # Calculate directional movements
    up_move = result_df['high'].diff()
    down_move = result_df['low'].diff()

    plus_dm = np.where((up_move > down_move) & (up_move > 0), up_move, 0)
    minus_dm = np.where((down_move > up_move) & (down_move > 0), down_move, 0)

    # Calculate True Range (TR)
    high_low = result_df['high'] - result_df['low']
    high_close = np.abs(result_df['high'] - result_df['close'].shift(1))
    low_close = np.abs(result_df['low'] - result_df['close'].shift(1))
    tr = np.maximum(high_low, np.maximum(high_close, low_close))

    # Apply Wilder's smoothing
    atr = pd.Series(tr).rolling(window=period).mean()
    plus_di = 100 * pd.Series(plus_dm).rolling(window=period).sum() / atr
    minus_di = 100 * pd.Series(minus_dm).rolling(window=period).sum() / atr
    dx = 100 * np.abs(plus_di - minus_di) / (plus_di + minus_di)
    adx = dx.rolling(window=period).mean()

    result_df['+DI'] = plus_di
    result_df['-DI'] = minus_di
    result_df['ADX'] = adx

    return result_df
Começamos validando os dados de entrada da função. Como de costume, verificamos se as colunas de preços necessárias estão presentes e se o período do indicador é válido, evitando erros de cálculo. Essa etapa é importante para preservar a integridade dos dados e garantir que os cálculos utilizem informações confiáveis. Também é necessário tratar adequadamente os casos em que há dados ausentes. Concluída a validação, passamos ao cálculo dos movimentos direcionais. As diferenças entre as máximas e mínimas determinam os movimentos direcionais positivos e negativos (DM). Esses valores ajudam a avaliar a força das tendências de alta e de baixa, fornecendo informações essenciais para analisar a direção da tendência. Para calcular corretamente essas diferenças, é importante dispor de dados históricos suficientes e verificar se há lacunas na série de preços.
Em seguida, calculamos o True Range, ou amplitude verdadeira. Esse valor corresponde ao maior resultado entre a diferença da máxima e da mínima atuais, a diferença entre a máxima atual e o fechamento anterior e a diferença entre a mínima atual e o fechamento anterior. Utilizamos os valores absolutos dessas diferenças para manter a consistência dos cálculos. A amplitude verdadeira é utilizada para normalizar os movimentos direcionais, permitindo compará-los entre diferentes ativos, conforme exige o cálculo do ADX. É essencial garantir que o DataFrame de preços de entrada não contenha valores ausentes, tratando eventuais lacunas para evitar que valores NaN comprometam os cálculos.
Depois, calculamos a amplitude verdadeira suavizada por meio de uma média móvel. Também suavizamos os buffers dos movimentos direcionais positivos e negativos (DM), normalizando os indicadores direcionais +DI e -DI e multiplicando seus valores por 100 para expressá-los em termos percentuais. Com isso, o índice direcional DX, utilizado para medir a força da tendência, é calculado pela diferença absoluta entre os valores positivos e negativos de DM, normalizada pela soma desses valores. Por fim, o buffer principal do indicador, o ADX, é obtido pela suavização do DX ao longo do período definido para o indicador, que, em nosso caso, é de 14. O resultado permite avaliar a força da tendência predominante.
Como vimos no artigo anterior, o ADX expressa a força da tendência em uma escala de 0 a 100, sendo que valores acima de 25 costumam indicar uma tendência forte. Por outro lado, valores abaixo de 20 geralmente indicam tendências fracas ou ainda em formação. Os índices direcionais positivo e negativo quantificam, respectivamente, a força dos movimentos de alta e de baixa, e a diferença entre eles pode fornecer sinais de entrada em operações. O período padrão de 14 também pode ser ajustado conforme a sensibilidade desejada: períodos menores permitem detectar sinais e pontos fractais mais cedo, enquanto períodos mais longos produzem valores menos voláteis.
Ao aplicar o kernel de mistura espectral por meio da rede regressora, conforme definimos após a introdução, representamos os dados dos dois indicadores em um vetor de entrada simples, com duas dimensões. Em alguns artigos anteriores, investigamos a possibilidade de aumentar a dimensão do vetor de entrada das nossas redes de aprendizado supervisionado, representando separadamente os diferentes sinais de cada padrão por valores lógicos de 0 ou 1. Essa abordagem melhorou os resultados durante o treinamento e a otimização, mas os ganhos não se confirmaram nos testes forward. Por isso, na implementação atual, combinamos os sinais e os padrões de cada indicador em um único valor lógico, em vez de representar separadamente seus componentes. No vetor bidimensional, cada dimensão combina os sinais dos dois indicadores. O primeiro indicador é destinado exclusivamente à confirmação de sinais de alta, enquanto o segundo confirma sinais de baixa.
Atributo 0
Vamos aplicar à nossa rede os três atributos que apresentaram desempenho inferior ou insatisfatório: 0, 1 e 5. Começaremos implementando o atributo 0 em Python, da seguinte forma:
def feature_0(df):
    """
    """
    feature = np.zeros((len(df), 2))

    feature[:, 0] = ((df['close'].shift(1) < df['Senkou_Span_A'].shift(1)) &
                     (df['close'] > df['Senkou_Span_A']) &
                     (df['ADX'] >= 25.0)).astype(int)

    feature[:, 1] = ((df['close'].shift(1) > df['Senkou_Span_A'].shift(1)) &
                     (df['close'] < df['Senkou_Span_A']) &
                     (df['ADX'] >= 25.0)).astype(int)

    feature[0, :] = 0
    feature[1, :] = 0

    return feature
A função começa criando um array NumPy vazio. Esse array de atributos tem o mesmo número de linhas do DataFrame de entrada, mas apenas duas colunas. Isso fornece uma estrutura inicial para gerar os sinais, evitando que valores residuais interfiram nos resultados. Em seguida, preenchemos a primeira coluna com os resultados da verificação das condições para um sinal de alta. Conforme os critérios descritos no artigo anterior, atribuímos o valor 1 às linhas dessa coluna do array NumPy em que o preço de fechamento anterior esteja abaixo da Senkou Span A, o fechamento atual esteja acima da Senkou Span A atual e o ADX seja igual ou superior a 25. O cruzamento de alta, quando o preço ultrapassa a linha Senkou Span A, costuma indicar uma possível tendência de alta. A exigência de um ADX igual ou superior a 25 faz com que o sinal seja gerado apenas quando o indicador aponta uma tendência forte, reduzindo a ocorrência de sinais falsos em mercados com tendências fracas.
Nesse caso, o uso de arrays NumPy permite atribuir valores a várias linhas simultaneamente. Essa capacidade de realizar operações vetorizadas é uma das principais vantagens do Python no desenvolvimento e treinamento de modelos. Em seguida, preenchemos a coluna destinada aos sinais de baixa. Atribuímos o valor 1 a cada linha correspondente quando o preço de fechamento anterior está acima da Senkou Span A anterior, o fechamento atual está abaixo da Senkou Span A atual e o buffer principal do ADX apresenta um valor igual ou superior a 25. Essas condições identificam um cruzamento de baixa, que pode indicar uma tendência de queda. O filtro ADX garante que o sinal seja acompanhado por uma tendência com força suficiente.
Depois de atribuir os valores correspondentes aos sinais de alta e de baixa, definimos como zero as duas primeiras linhas do array de atributos, pois os deslocamentos utilizados geram valores NaN nessas posições. Conseguimos treinar nossa rede neural utilizando apenas esse padrão, exportamos o modelo como 74_0.onnx e o importamos para a classe de sinais personalizada do EA MQL5. No artigo anterior, mostramos que esse padrão não apresentou resultados satisfatórios no teste forward. No entanto, ao testá-lo novamente, agora com a rede neural atuando como filtro adicional dos sinais de entrada dos indicadores, obtivemos o seguinte resultado:
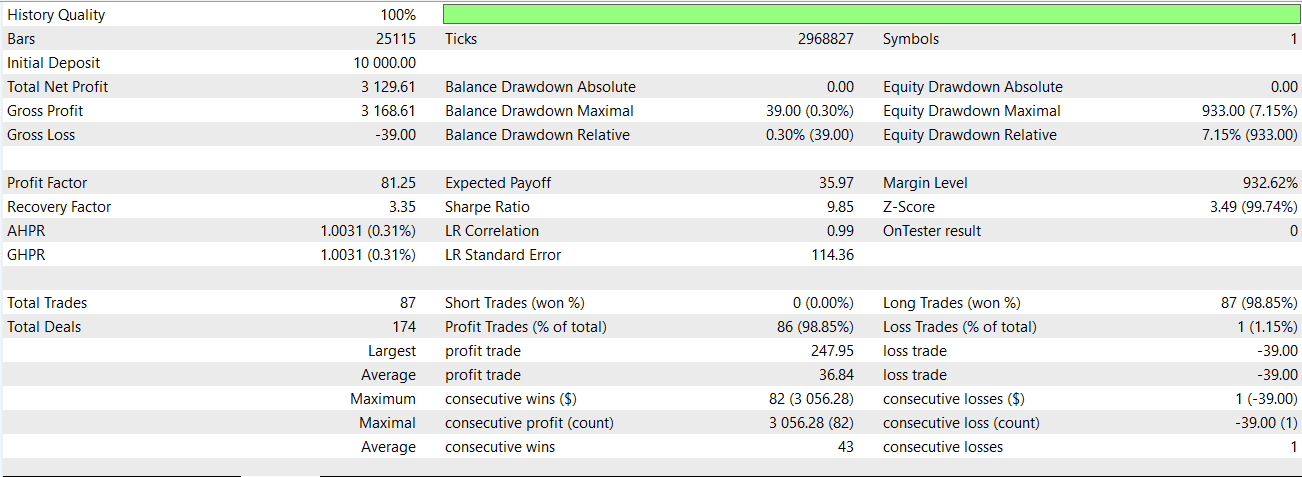
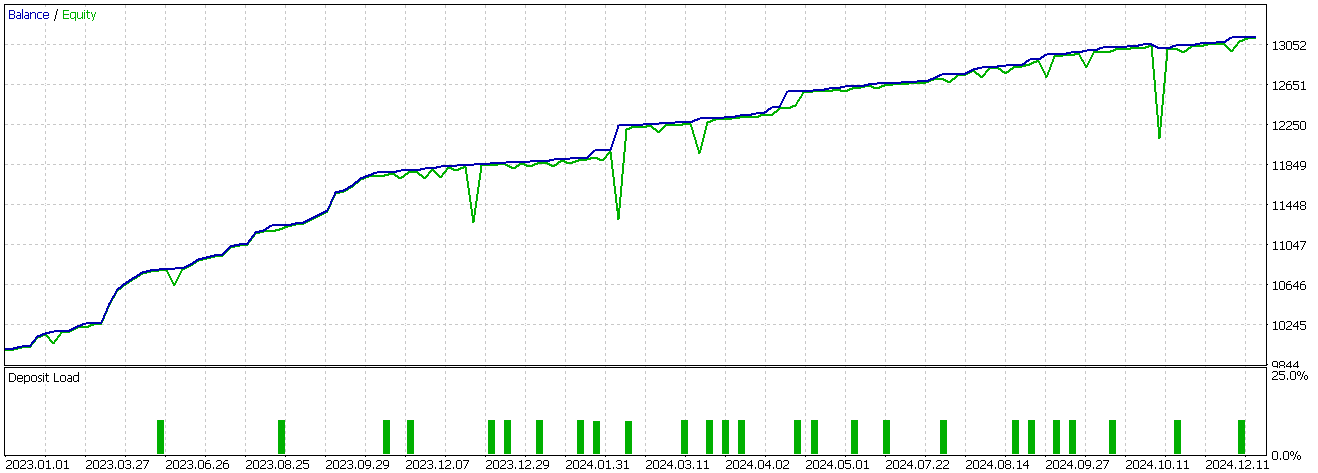
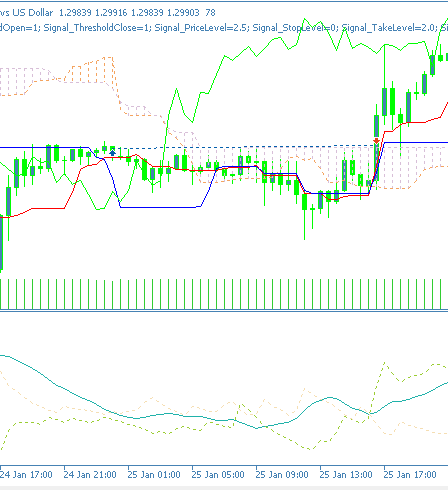
Os resultados parecem ter melhorado, mas essa melhora se limita às posições compradas. Além disso, como sempre, nossos testes utilizam uma amostra de dados bastante restrita e, portanto, têm caráter exclusivamente exploratório. O sinal de compra do atributo 0 aparece no gráfico da seguinte forma:
Atributo 1
Outro atributo ou padrão que apresentou resultados extremamente insatisfatórios no artigo anterior foi o atributo 1. Sua implementação em Python é a seguinte:
def feature_1(df):
    """

    """
    feature = np.zeros((len(df), 2))

    feature[:, 0] = ((df['Tenkan_sen'].shift(1) < df['Kijun_sen'].shift(1)) &
                     (df['Tenkan_sen'] > df['Kijun_sen']) &
                     (df['ADX'] >= 20.0)).astype(int)

    feature[:, 1] = ((df['Tenkan_sen'].shift(1) > df['Kijun_sen'].shift(1)) &
                     (df['Tenkan_sen'] < df['Kijun_sen']) &
                     (df['ADX'] >= 20.0)).astype(int)

    feature[0, :] = 0
    feature[1, :] = 0

    return feature
Mais uma vez, inicializamos com zeros o array de saída, também denominado feature, e definimos seu tamanho de acordo com o DataFrame de entrada. Para cada linha de dados, reservamos duas colunas destinadas a registrar os sinais de alta e de baixa. Na primeira coluna, atribuímos o valor 1 quando há confirmação de um sinal de alta, ou seja, quando a Tenkan-sen anterior está abaixo da Kijun-sen anterior, a Tenkan-sen atual está acima da Kijun-sen atual e o ADX apresenta um valor igual ou superior a 20. Esse sinal representa um cruzamento de alta entre a Tenkan-sen e a Kijun-sen. Trata-se de um sinal de médio prazo que antecipa o início das principais tendências. Por isso, não é necessário exigir um ADX de 25, sendo suficiente um valor de 20.
O sinal de baixa, registrado na segunda coluna de cada linha do array NumPy, recebe o valor 1 quando são atendidas as condições correspondentes ao cruzamento de baixa. Se a Tenkan-sen anterior estava acima da Kijun-sen anterior, a Tenkan-sen atual está abaixo da Kijun-sen atual e o ADX apresenta um valor igual ou superior a 20, mantendo uma trajetória ascendente, temos um sinal de baixa. Nossa abordagem exige que várias condições de sinal sejam atendidas antes de atribuir um valor diferente de zero. Trata-se de um critério mais restritivo, em contraste com a alternativa mencionada anteriormente, que consiste em utilizar arrays de maior dimensão, nos quais os sinais individuais dos indicadores são representados como valores binários, que são então utilizados para alimentar a rede neural. Por fim, atribuímos zero às duas primeiras linhas do array NumPy, pois as comparações com valores deslocados fazem com que algumas posições contenham NaN em vez de dados dos indicadores. A seguir, apresentamos o relatório dos testes do padrão 1 no GBPUSD, no período gráfico M30, abrangendo dois anos de dados, incluindo os períodos de treinamento e teste:
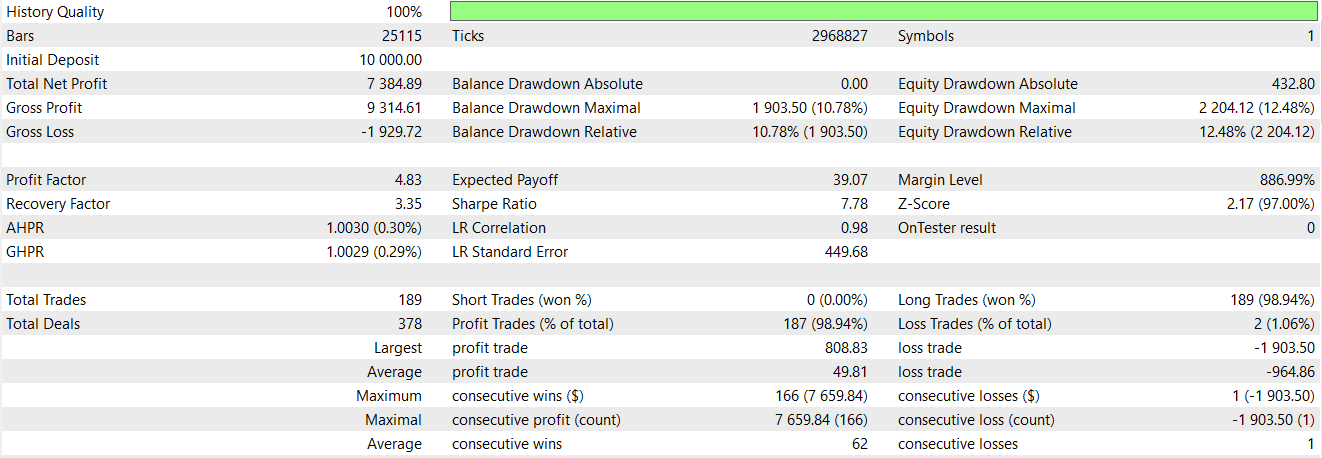
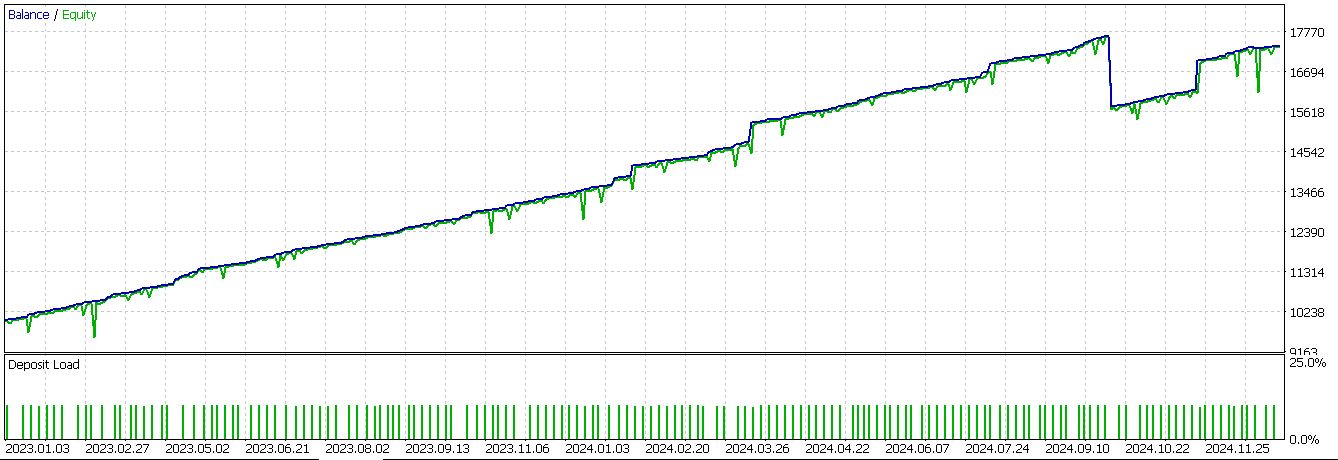
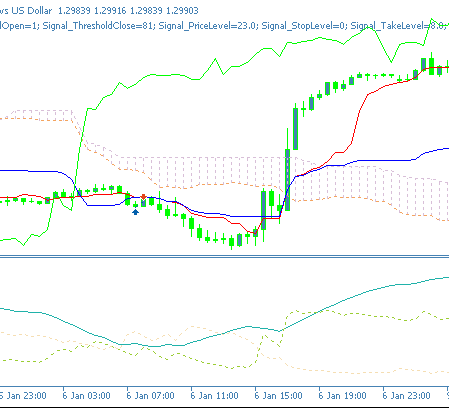
Mais uma vez, nossa rede neural, que utiliza o processamento de sinais descrito no artigo anterior como mecanismo de filtragem, parece melhorar os resultados do EA criado com o Assistente MQL5. O padrão de alta do atributo 1 pode ser representado em um gráfico de velas da seguinte forma:
Atributo 5
Chegamos ao padrão 5. Sua implementação em Python é a seguinte:
def feature_5(df):
    """

    """
    feature = np.zeros((len(df), 2))

    feature[:, 0] = ((df['close'].shift(2) > df['close'].shift(1)) &
                     (df['close'].shift(1) < df['close']) &
                     (df['close'].shift(2) > df['Tenkan_sen'].shift(2)) &
                     (df['close'] > df['Tenkan_sen']) &
                     (df['close'].shift(1) <= df['Tenkan_sen'].shift(1)) &
                     (df['+DI'] > df['-DI']) &
                     (df['ADX'] >= 25.0)).astype(int)

    feature[:, 1] = ((df['close'].shift(2) < df['close'].shift(1)) &
                     (df['close'].shift(1) > df['close']) &
                     (df['close'].shift(2) < df['Tenkan_sen'].shift(2)) &
                     (df['close'] < df['Tenkan_sen']) &
                     (df['close'].shift(1) >= df['Tenkan_sen'].shift(1)) &
                     (df['+DI'] < df['-DI']) &
                     (df['ADX'] >= 25.0)).astype(int)


    feature[0, :] = 0
    feature[1, :] = 0

    return feature
Seguimos a mesma estrutura utilizada nos padrões 0 e 1 descritos anteriormente. Inicializamos o array NumPy de saída e definimos suas dimensões. Para atribuir o valor 1 à primeira coluna, responsável pela confirmação dos sinais de alta, o preço de fechamento deve apresentar uma reversão em forma de U acima da linha Tenkan-sen. Além disso, o DM positivo (+DM) deve ser maior que o DM negativo (-DM), e o ADX precisa apresentar um valor igual ou superior a 25. Esse comportamento do preço costuma indicar a continuidade da tendência, mas também é necessário considerar as magnitudes relativas dos buffers de movimento direcional e o valor do ADX.
Na segunda coluna, substituímos o valor padrão 0 por 1 quando o preço se afasta da linha Tenkan-sen pelo lado inferior, mantendo o fechamento atual abaixo dela. Além disso, o ADX deve apresentar um valor igual ou superior a 25, e o movimento direcional negativo precisa superar o positivo, confirmando o sinal de baixa. Por fim, atribuímos zero às duas primeiras linhas do array de atributos para tratar os valores NaN decorrentes dos cálculos com deslocamentos, considerando que os dados de entrada constituem uma sequência finita. Também testamos essa configuração nas mesmas condições utilizadas para os dois padrões anteriores e obtivemos os seguintes resultados:
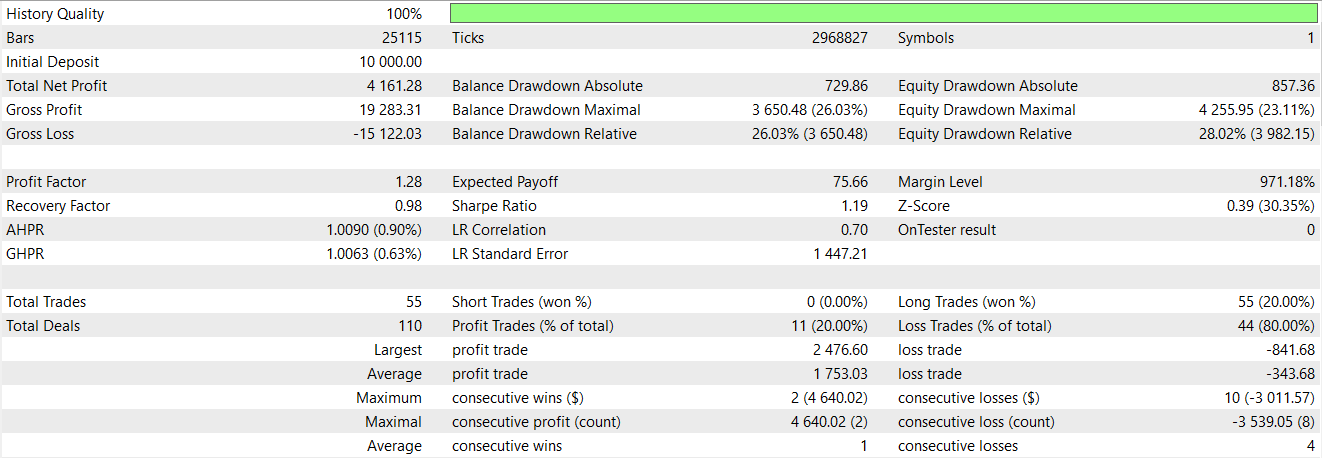
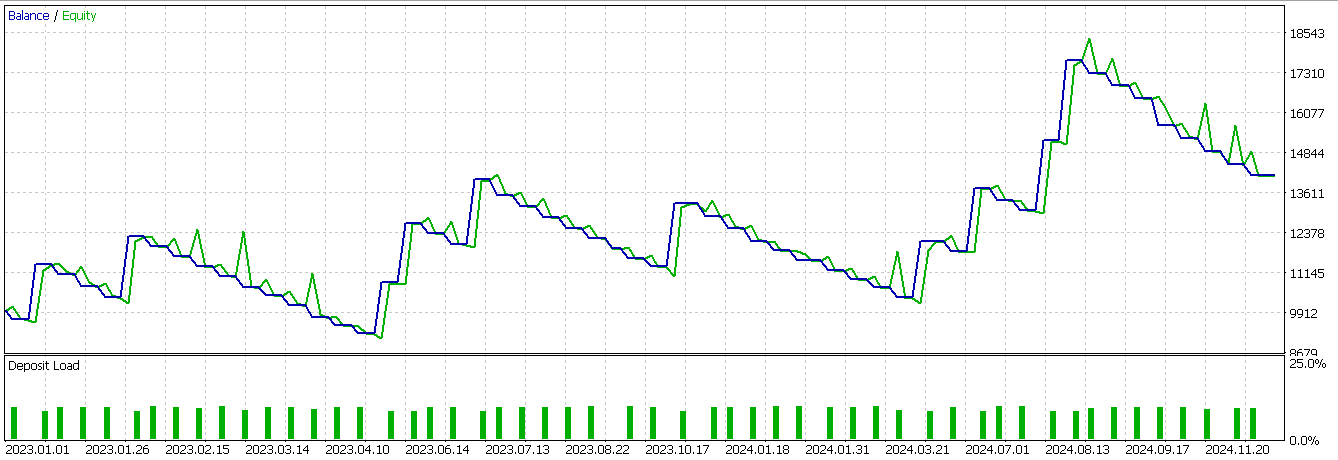
Nosso modelo apresentou lucro, mas a curva de equity apresentou oscilações bastante acentuadas. Ainda assim, os resultados indicam que há motivos para considerar a complementação do aprendizado de máquina com sinais tradicionais dos indicadores. Embora os resultados não sejam ideais e os testes tenham sido limitados, podemos afirmar que uma rede neural baseada em um kernel de mistura espectral pode ser utilizada como filtro adicional dos sinais dos indicadores, permitindo refinar os pontos de entrada nas operações e potencialmente melhorar o desempenho.
Conclusão
Investigamos o uso de uma rede neural baseada em um kernel de mistura espectral para refinar os sinais de trading originais gerados pela combinação dos indicadores Ichimoku e ADX-Wilder. A rede neural específica que utilizamos apresentou resultados promissores e diferenças perceptíveis de desempenho em relação ao artigo anterior, no qual as operações eram realizadas exclusivamente com base nos sinais dos indicadores. Como sempre, os resultados apresentados exigem cautela adicional por parte do leitor antes de serem aceitos ou incorporados aos sistemas de trading existentes. Durante a criação de um EA com o Assistente MQL5, é possível selecionar vários sinais personalizados.
| Arquivo | Descrição |
|---|---|
| WZ-74.mq5 | EA criado pelo Assistente MQL5, cujo cabeçalho inclui os arquivos utilizados em sua montagem |
| SignalWZ-74.mqh | Arquivo da classe de sinais personalizados |
| 74-5.onnx | Rede neural ONNX para o padrão de sinal 5 |
| 74-1.onnx | Rede neural ONNX para o padrão de sinal 1 |
| 74-0.onnx | Rede neural ONNX para o padrão de sinal 0 |
Traduzido do Inglês pela MetaQuotes Ltd.
Artigo original: https://www.mql5.com/en/articles/18776
Aviso: Todos os direitos sobre esses materiais pertencem à MetaQuotes Ltd. É proibida a reimpressão total ou parcial.
Esse artigo foi escrito por um usuário do site e reflete seu ponto de vista pessoal. A MetaQuotes Ltd. não se responsabiliza pela precisão das informações apresentadas nem pelas possíveis consequências decorrentes do uso das soluções, estratégias ou recomendações descritas.
 Caminhe em novos trilhos: Personalize indicadores no MQL5
 Desenvolvimento de um EA dinâmico para múltiplos pares (Parte 3): Estratégias de reversão à média e momentum
 Está chegando o novo MetaTrader 5 e MQL5
 Conhecendo a linguagem MQL5 (Parte 18): Introdução ao padrão "Ondas de Wolfe"

- Aplicativos de negociação gratuitos
- 8 000+ sinais para cópia
- Notícias econômicas para análise dos mercados financeiros
Você concorda com a política do site e com os termos de uso