
Recursos do Assistente MQL5 que você precisa conhecer (Parte 72): Uso de padrões MACD e OBV com aprendizado supervisionado
 25
 0

Introdução
No artigo anterior, em que apresentamos a combinação dos indicadores MACD e OBV, analisamos 10 possíveis sinais que podem ser gerados a partir do uso complementar desses indicadores. Como de costume, testamos os 10 padrões de sinal obtidos dessa combinação por meio de um teste forward de um ano, após realizar o treinamento ou a otimização com dados do ano anterior. No artigo anterior, apenas um padrão de sinal (padrão 7) conseguiu gerar lucro no teste forward. Analisamos alguns dos motivos pelos quais essa combinação apresentou resultados insatisfatórios em comparação com outros indicadores. No entanto, esses resultados também abriram espaço para investigar como o machine learning poderia melhorar alguns desses padrões de sinal.
Neste artigo, veremos como uma rede neural convolucional (CNN) que utiliza um kernel racional quadrático pode ajudar a interpretar e aplicar os sinais dos indicadores de maneira mais eficaz, possivelmente melhorando os resultados. O kernel racional quadrático (Rational Quadratic, RQ) é definido pela seguinte fórmula:
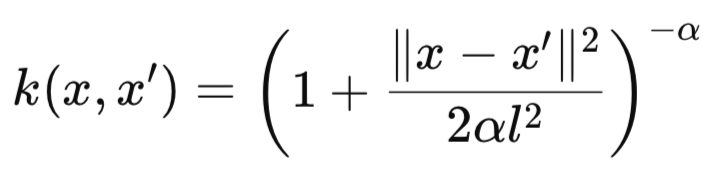
onde:
- k(x,x′) é o valor de similaridade calculado pelo kernel entre duas entradas x e x′. Esse valor varia de 0 a 1, sendo que valores próximos de 1 indicam maior similaridade.
- x e x′ são dois vetores de entrada (por exemplo, segmentos de um sinal unidimensional, vetores de atributos ou coordenadas temporais). Podem ser valores escalares (dimensionalidade = 1) ou vetores multidimensionais.
- ∥x−x′∥2 representa o quadrado da distância euclidiana entre os dois vetores de entrada. Essa medida expressa a distância entre x e x′ no espaço de atributos e pode ser calculada pela seguinte fórmula:
-
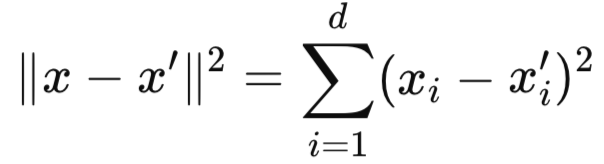
- l é o parâmetro de escala de comprimento (ou escala característica) do kernel. Ele determina a rapidez com que a similaridade diminui à medida que a distância aumenta:
- Um valor pequeno de l provoca uma queda rápida da similaridade (sensibilidade local).
- Um valor grande de l provoca uma queda mais lenta da similaridade (similaridade em uma região mais ampla).
- α, ou alpha, é o parâmetro de mistura de escalas (também chamado de parâmetro de forma). Ele controla a contribuição relativa das variações em diferentes escalas:
- Quando α tende ao infinito, o kernel se torna equivalente ao kernel exponencial quadrático (RBF).
- Um valor pequeno de α produz caudas mais pesadas no kernel, permitindo capturar relações entre pontos mais distantes.
Na nossa implementação do kernel racional quadrático (Rational Quadratic Kernel, RQK) em uma rede neural convolucional (CNN), utilizamos esse kernel para definir os tamanhos dos kernels e o número de canais da CNN. No entanto, existem outras formas de aplicar o kernel RQ em uma CNN que o leitor também pode explorar.
Aplicações alternativas e vantagens do kernel RQ
A primeira possibilidade é o mascaramento adaptativo de atenção (adaptive attention masking). Nessa aplicação, o kernel RQ gera máscaras de atenção espaciais ou temporais dentro da CNN, o que pode ser útil em tarefas de segmentação ou previsão de séries temporais. O método consiste em destacar regiões que apresentam alta similaridade com uma região de referência, como uma janela centrada no centroide. Outra aplicação possível é o pooling sensível à distância (distance-aware pooling). Nesse caso, em vez de calcular a média de todas as ativações, são agrupadas apenas aquelas cuja similaridade, medida pelo kernel RQ, atende a um limiar predefinido. Isso permite realizar um pooling adaptativo que leva em consideração a proximidade entre os elementos.
Outra possibilidade é o ajuste de escala da importância dos atributos (feature importance scaling). Nessa abordagem, os canais da CNN recebem uma ponderação suave aprendida pelo modelo. Por fim, o kernel RQ também pode ser utilizado para reduzir ou "podar" os pesos da CNN cuja influência, medida pelo kernel no espaço de entrada da rede, seja mínima. As vantagens de utilizar esse kernel em uma CNN também são diversas. A tabela a seguir resume algumas delas.
| Robustez a valores atípicos | As caudas mais pesadas dos kernels RQ tornam a arquitetura menos sensível a anomalias espaciais ou temporais. |
| Transições suaves | O decaimento suave do kernel evita mudanças bruscas nas representações dos dados entre as camadas, favorecendo o fluxo de gradientes. |
| Arquitetura dinâmica | O kernel permite selecionar os tamanhos dos kernels da CNN ou ampliar o número de canais de acordo com as características dos dados, utilizando medidas de similaridade. |
Essa arquitetura de CNN (conv-1d), baseada no kernel RQ, é especialmente adequada para entradas unidimensionais nas quais a similaridade local é importante, como as séries temporais financeiras que analisamos neste artigo. Outros contextos adequados para essa abordagem incluem o processamento de sinais de áudio e a detecção de padrões binários. Ao utilizar essa CNN, é importante normalizar ou padronizar os vetores de entrada para o intervalo de 0 a 1, como fizemos com as redes neurais apresentadas nos artigos anteriores. Os dados de entrada geralmente têm o formato (batch_size, input_length), com vetores compostos por zeros ou uns.
O kernel RQ possui alguns hiperparâmetros importantes, conforme indicado na fórmula apresentada anteriormente. O primeiro deles é alpha (alfa), responsável por controlar o decaimento das caudas do kernel. Com valores mais elevados, seu comportamento se aproxima do de um kernel RBF convencional. À medida que esse valor diminui, porém, o kernel RQ passa a se comportar como uma combinação de múltiplas funções de base radial (RBF) em diferentes escalas, cuja contribuição é controlada pelo parâmetro alpha. Outro hiperparâmetro é o length-scale (escala de comprimento), que determina a sensibilidade da medida de similaridade à distância entre as entradas.
Se nossa rede neural funcionar como um classificador que produz uma distribuição de probabilidades, podemos utilizar a função de perda BCE (BCE loss-function) durante o treinamento. Devido à arquitetura não convencional da nossa rede, a inicialização adequada dos parâmetros e a programação da taxa de aprendizado também podem ser importantes. Para ampliar suas capacidades, podemos adicionar conexões residuais entre as camadas, melhorando a propagação dos gradientes. Além disso, o kernel RQ pode ser integrado como um mecanismo de controle. Também é possível utilizar algoritmos de eliminação seletiva baseados em similaridade entre as camadas.
Estudos indicam que os kernels RQ podem determinar os pesos das camadas Conv1D, permitindo capturar determinados padrões nos dados. O uso desse kernel reduz claramente o número total de parâmetros necessários e melhora a interpretabilidade do modelo, mas pode limitar sua capacidade de adaptação em comparação com kernels cujos pesos são aprendidos durante o treinamento. Evidências de resultados superiores também sugerem que esse kernel pode ser especialmente útil em camadas de processos gaussianos e na otimização de hiperparâmetros durante o desenvolvimento de arquiteturas CNN mais abrangentes, como descrito neste artigo sobre processos gaussianos profundos com kernels convolucionais.
O uso de kernels com tamanhos predefinidos realmente reduz o número de parâmetros treináveis e o risco de sobreajuste, especialmente quando há poucos dados disponíveis. Isso foi demonstrado neste estudo sobre a classificação de doenças da mandioca. No entanto, embora os kernels predefinidos facilitem a compreensão de como os atributos são extraídos, em contraste com kernels aprendidos segundo uma abordagem de "caixa-preta", sua capacidade de adaptação apresenta algumas limitações. Em geral, kernels com parâmetros fixos se adaptam menos aos dados do que aqueles cujos pesos são aprendidos durante o treinamento, o que pode comprometer o desempenho em tarefas complexas. Essa limitação também aparece nos resultados do estudo sobre doenças da mandioca mencionado anteriormente, no qual os kernels híbridos apresentaram desempenho superior ao dos kernels RQ utilizados isoladamente. Alguns dos resultados desse estudo são apresentados a seguir:
| Tipo de kernel | Acurácia |
|---|---|
| Kernel RQ | 88,5% |
| Kernel exponencial quadrático | 88,0% |
| Kernel híbrido | 90,1% |
A tabela acima, baseada no estudo sobre doenças da mandioca, mostra pequenas diferenças de desempenho entre kernels aprendidos e kernels fixos. Os resultados favorecem uma abordagem híbrida. Anteriormente, o papel do kernel RQ não estava tão bem definido. No entanto, como indicam algumas das referências mencionadas, estudos como este, este e este ajudaram a identificar possibilidades de aplicação desse kernel em processos gaussianos profundos (Deep Gaussian Processes), especialmente no processamento de imagens e na adaptação a arquiteturas Conv1D. O estudo sobre doenças da mandioca concentrou-se no uso de pesos predefinidos como forma de equilibrar as abordagens baseadas em kernels fixos e kernels aprendidos.
Ao projetar as redes utilizadas, definimos o tamanho dos kernels com base no hiperparâmetro length-scale l. Para capturar características dos dados em diferentes escalas, utilizamos múltiplos canais, seguindo a abordagem das CNNs que trabalham com diferentes campos receptivos. Na implementação final, também adotamos o pooling global por média para aumentar a flexibilidade da arquitetura. Isso tornou a saída da rede independente do comprimento da sequência de entrada, uma característica especialmente adequada para produzir valores escalares no intervalo de 0 a 1.
A rede
Nossa rede neural foi implementada em Python porque, como já discutimos nos artigos anteriores, a programação e o treinamento nesse ambiente são mais eficientes do que a execução das mesmas tarefas em MQL5. Portanto, implementamos a CNN em Python. A rede ajusta os tamanhos de seus kernels e o número de canais com base no kernel RQ, conforme veremos a seguir.
import torch
import torch.nn as nn
import torch.nn.functional as F

import pandas as pd
import numpy as np

class RationalQuadraticConv1D(nn.Module):
    def __init__(self, alpha=1.0, length_scale=1.0, input_length=100):
        super(RationalQuadraticConv1D, self).__init__()
        self.alpha = alpha
        self.length_scale = length_scale
        self.input_length = input_length

        # Deeper and wider design
        self.kernel_sizes, self.channels = self._design_architecture()

        self.conv_layers = nn.ModuleList()
        in_channels = 1

        for i, (out_channels, kernel_size) in enumerate(zip(self.channels, self.kernel_sizes)):
            layer = nn.Sequential(
                nn.Conv1d(in_channels, out_channels, kernel_size=kernel_size, padding=kernel_size // 2),
                nn.BatchNorm1d(out_channels),
                nn.ReLU(),
                nn.Dropout(0.2)
            )
            self.conv_layers.append(layer)
            in_channels = out_channels

        # Fully connected head to increase parameter count
        self.head = nn.Sequential(
            nn.AdaptiveAvgPool1d(1),
            nn.Flatten(),
            nn.Linear(in_channels, 128),
            nn.ReLU(),
            nn.Dropout(0.2),
            nn.Linear(128, 64),
            nn.ReLU(),
            nn.Linear(64, 1),
            nn.Sigmoid()
        )

    def _rq_kernel(self, x, x_prime):
        dist_sq = (x - x_prime) ** 2
        return (1 + dist_sq / (2 * self.alpha * self.length_scale ** 2)) ** -self.alpha

    def _design_architecture(self):
        x = torch.linspace(0, 1, self.input_length)
        center = 0.5
        responses = self._rq_kernel(x, center)
        thresholded = responses[responses > 0.01]  # allow more spread

        num_layers = 10
        kernel_sizes = [3 + (i % 4) * 2 for i in range(num_layers)]  # cyclic 3, 5, 7, 9
        channels = [32 * (i + 1) for i in range(num_layers)]  # 32, 64, ..., 320

        return kernel_sizes, channels

    def forward(self, x):
        x = x.unsqueeze(1)  # (B, 1, L)
        for layer in self.conv_layers:
            x = layer(x)
        return self.head(x)
Primeiro, definimos um módulo personalizado do PyTorch que recebe alguns dos principais parâmetros apresentados anteriormente na fórmula do kernel RQ. Nossa classe, denominada RationalQuadraticConv1D, herda de nn.Module, que, como vimos nos artigos anteriores, é a classe base de todos os módulos de redes neurais do PyTorch. O construtor inicializa três parâmetros importantes do kernel RQ: alpha, length-scale e input-length. Como já mencionado, alpha controla a forma do kernel, length-scale determina a distância ao longo da qual o valor do kernel decai e input-length especifica o comprimento esperado do vetor de entrada.
Essas etapas iniciais são importantes porque estabelecem a estrutura básica do modelo e permitem ajustar o comportamento do kernel. Além disso, garantem que a arquitetura seja compatível com o comprimento do vetor de entrada. Os parâmetros alpha e length-scale devem ser ajustados para controlar a sensibilidade do kernel às diferenças entre os dados de entrada. Por exemplo, um valor menor de length-scale permite concentrar a análise em padrões locais, enquanto um valor maior favorece a identificação de similaridades mais amplas. Como sempre, é importante verificar se input-length corresponde ao comprimento dos dados de entrada.
Após a inicialização, definimos dinamicamente os tamanhos dos kernels e o número de canais das camadas convolucionais. Essa linha de código chama o método _design_architecture, que examinaremos mais adiante, para calcular esses valores com base no perfil de similaridade produzido pelo kernel RQ no espaço de entrada. Esse é o principal diferencial da nossa rede. Ao contrário das CNNs tradicionais, que utilizam uma arquitetura fixa, nossa abordagem adapta a estrutura do modelo às características dos dados. Isso pode melhorar tanto a eficiência quanto a qualidade da extração de atributos. Graças a essa capacidade de adaptação, o modelo pode ser utilizado com conjuntos de dados que apresentam diferentes padrões de similaridade. No entanto, é importante monitorar os resultados produzidos pelo método _design_architecture para garantir que a arquitetura definida seja compatível com a complexidade da tarefa.
Nas próximas linhas de código, criamos uma sequência flexível de camadas convolucionais com propriedades definidas dinamicamente. A função nn.ModuleList() cria um contêiner capaz de armazenar um número variável de camadas convolucionais. O laço percorre pares de valores out-channels, que representam o número de canais de saída, e kernel-size, que corresponde ao tamanho do kernel convolucional. Esses valores são obtidos de self.channels e self.kernel-size, respectivamente. Cada camada nn.Conv1D recebe um número de canais de entrada definido por in-channels, que começa com o valor 1 na primeira camada. A camada produz out-channels canais de saída e utiliza kernel-size com padding adequado para preservar o comprimento da sequência de entrada. Em seguida, o valor de out-channels passa a definir in-channels da próxima camada, estabelecendo uma sequência de camadas conectadas.
Essa estrutura é importante porque permite configurar dinamicamente o número de camadas e parâmetros do modelo. Ao mesmo tempo, o padding mantém o comprimento da sequência de saída igual ao da entrada, o que é fundamental no processamento de dados sequenciais. Valores maiores de kernel-size geralmente permitem capturar padrões mais abrangentes nos dados de entrada, enquanto um número maior de out-channels amplia a diversidade de atributos extraídos. Caso não seja necessário preservar o comprimento original da sequência, podemos ajustar o padding, por exemplo, definindo-o como 0 para reduzir a resolução.
Em seguida, definimos o bloco "final" da rede, responsável por processar a saída das camadas convolucionais e convertê-la em um único valor com interpretação probabilística. Esse bloco estabelece uma sequência de operações composta por nn.AdaptiveAvgPool1D, nn.Flatten, nn.Linear e nn.Sigmoid. Essas operações desempenham, respectivamente, as seguintes funções: reduzir a dimensão espacial a 1 por meio do cálculo da média ao longo da sequência; transformar o tensor em um vetor unidimensional; mapear os atributos suavizados para uma única saída; e produzir um valor entre 0 e 1, adequado para tarefas de classificação binária ou regressão.
Na etapa final, essas operações são combinadas para produzir uma saída adaptada à tarefa específica. Isso permite utilizar o modelo em aplicações como classificação binária ou estimativa de probabilidades. Para problemas de classificação multiclasse, podemos substituir as camadas linear e sigmoide por nn.Linear(in_channels, num_classes) e nn.Softmax(), respectivamente. Já em tarefas de regressão, será necessário remover a função sigmoide, pois ela é mais adequada à classificação.
Nossa classe também possui um método responsável por calcular a similaridade entre pontos ou vetores de dados, denominado _rq_kernel. Como esperado, esse cálculo utiliza o kernel RQ. Primeiro, é determinada a distância euclidiana entre x e x′. Em seguida, aplica-se a fórmula do kernel RQ apresentada anteriormente, fazendo com que o valor de similaridade diminua à medida que a distância aumenta, considerando valores moderados dos hiperparâmetros alpha e length-scale. Dessa forma, o kernel RQ quantifica a similaridade entre os dados de entrada e fornece a base para definir a arquitetura da rede neural convolucional (CNN).
Sua flexibilidade está na capacidade de capturar tanto padrões locais quanto globais. Valores maiores de alpha aproximam o comportamento do kernel ao de uma distribuição gaussiana, enquanto valores menores proporcionam maior flexibilidade. Também é importante ajustar length-scale para controlar a taxa de decaimento da similaridade, já que valores menores dão maior destaque às similaridades locais.
Isso nos leva ao método _design_architecture, mencionado anteriormente. Ele define dinamicamente a arquitetura da CNN com base no perfil de decaimento do kernel RQ. A primeira etapa consiste em criar um intervalo normalizado de posições dos dados de entrada, representado por x. Em seguida, definimos um ponto de referência para calcular a similaridade, denominado center (centro). Depois, calculamos os valores de resposta (responses) do kernel RQ para cada posição em relação ao centro. Na sequência, filtramos as posições correspondentes às respostas do kernel superiores a 0,2, concentrando a análise nas regiões mais relevantes.
A partir dessas posições, ajustamos os tamanhos dos kernels, começando pelo valor 3 e aumentando-o conforme a distância em relação a center. Na penúltima etapa, atribuímos mais canais às regiões com menor similaridade, partindo de 4 canais. Por fim, retornamos os parâmetros da arquitetura, limitando sua configuração a três camadas.
Esse método adapta a CNN à estrutura de similaridade dos dados. Kernels maiores permitem identificar padrões mais abrangentes, enquanto um número maior de canais favorece a extração de atributos mais complexos. O limiar de 0,2 e os fatores de escala de 4 para os kernels e 60 para os canais podem ser ajustados. Em tarefas que exigem uma extração de atributos mais profunda, podemos aumentar o número de camadas conforme necessário, desde que haja um equilíbrio entre a complexidade da arquitetura e o custo computacional.
Por fim, a classe RationalQuadraticConv1D é concluída com o método de propagação para frente. Ele executa os cálculos do modelo desde a entrada até a saída. Inicialmente, o método adiciona uma dimensão de canal aos dados de entrada para torná-los compatíveis com nn.Conv1D. Em seguida, aplicamos a função de ativação ReLU após cada camada convolucional para introduzir não linearidade. O resultado passa então pelas camadas finais, que produzem a saída da rede. Nosso método de propagação para frente define como os dados percorrem o modelo, utilizando a arquitetura gerada dinamicamente para extrair os atributos que servirão de base às previsões.
É fundamental garantir que os dados de entrada tenham o formato (batch_size, input_length) e que a função de ativação escolhida seja adequada à tarefa. Incompatibilidades no formato dos tensores são problemas frequentes em redes neurais. Por isso, uma prática importante durante a depuração é exibir as dimensões dos dados em cada etapa da execução. Agora podemos examinar como preparar os dados de entrada da rede, começando pelas implementações dos indicadores MACD e OBV em Python.
MACD
Implementamos nossos indicadores do zero em Python, embora existam bibliotecas e módulos capazes de realizar parte desses cálculos. Essa escolha busca simplificar a implementação e reduzir o consumo de recursos durante a compilação e a execução. O indicador MACD calcula a linha MACD, a linha de sinal e o histograma, componentes que ajudam a analisar o comportamento do preço de um ativo. Sua implementação em Python é apresentada a seguir:
def MACD(df, fast_period: int = 12, slow_period: int = 26, signal_period: int = 9) -> pd.DataFrame:
    """
    Calculate Moving Average Convergence Divergence (MACD) and append it to the input DataFrame.

    The MACD line is the difference between a fast and slow EMA.
    The Signal line is an EMA of the MACD line.
    The Histogram is the difference between the MACD and Signal lines.

    Args:
        df (pd.DataFrame): DataFrame with a 'close' column.
        fast_period (int): Lookback period for the fast EMA. Default is 12.
        slow_period (int): Lookback period for the slow EMA. Default is 26.
        signal_period (int): Lookback period for the Signal line EMA. Default is 9.

    Returns:
        pd.DataFrame: Input DataFrame with new 'MACD', 'Signal_Line', and 'MACD_Histogram' columns.
    """
    # Input validation
    if 'close' not in df.columns:
        raise ValueError("DataFrame must contain a 'close' column")
    if not all(p > 0 for p in [fast_period, slow_period, signal_period]):
        raise ValueError("All period values must be positive integers")
    if fast_period >= slow_period:
        raise ValueError("fast_period must be less than slow_period")

    # Create a copy to avoid modifying the original DataFrame
    result_df = df.copy()

    # Calculate Fast and Slow Exponential Moving Averages (EMA)
    ema_fast = result_df['close'].ewm(span=fast_period, adjust=False).mean()
    ema_slow = result_df['close'].ewm(span=slow_period, adjust=False).mean()

    # Calculate MACD line
    result_df['MACD'] = ema_fast - ema_slow

    # Calculate Signal line (EMA of MACD)
    result_df['Signal_Line'] = result_df['MACD'].ewm(span=signal_period, adjust=False).mean()

    # Calculate MACD Histogram
    result_df['MACD_Histogram'] = result_df['MACD'] - result_df['Signal_Line']

    return result_df
Nossa função segue o mesmo formato utilizado anteriormente: recebe um DataFrame do pandas com uma coluna de preços de fechamento e três parâmetros inteiros opcionais: fast-period (período rápido, padrão 12), slow-period (período lento, padrão 26) e signal-period (período de sinal, padrão 9). O uso de um DataFrame como entrada segue a abordagem que adotamos até aqui, na qual os dados de preços são importados por meio do módulo Python do MT5. A função retorna uma cópia do DataFrame de entrada, com novas colunas para os valores do MACD, a linha MACD e a linha de sinal.
Nas primeiras linhas de código, verificamos se o DataFrame de entrada contém a coluna de preços de fechamento, necessária para calcular as médias móveis exponenciais (EMAs). Também verificamos se todos os parâmetros de período são números inteiros positivos, pois representam as janelas históricas utilizadas nos cálculos. Além disso, validamos se o período rápido é menor que o período lento, garantindo que o MACD represente a diferença entre as tendências de curto e longo prazo. Essas verificações evitam erros durante a execução e mantêm a consistência lógica dos cálculos. É sempre importante evitar interpretações incorretas dos indicadores, pois elas podem levar a decisões de negociação desfavoráveis.
Em seguida, criamos uma cópia do DataFrame de entrada para armazenar os resultados sem modificar os dados originais. Essa abordagem preserva a integridade do DataFrame, que pode ser utilizado por outras funções, e evita alterações que poderiam comprometer os resultados das análises. Em Python, isso também favorece a modularidade e a reutilização do código. Depois de criar a cópia, utilizamos a função de média móvel exponencialmente ponderada do pandas para calcular as EMAs dos preços de fechamento nos períodos rápido e lento. Definimos o parâmetro adjust como False para utilizar a fórmula convencional da EMA, enquanto span define o parâmetro de decaimento correspondente ao período da EMA. A escolha de span afeta diretamente a sensibilidade da média: valores menores fazem a EMA reagir mais rapidamente às variações de preço, enquanto valores maiores proporcionam maior suavização e reduzem o efeito do ruído.
Após calcular as EMAs rápida e lenta, adicionamos a primeira nova série do pandas ao DataFrame de saída, identificada como MACD. Essa série contém a linha MACD, calculada pela diferença entre a EMA rápida e a EMA lenta. A linha MACD é um indicador importante da convergência e divergência entre os movimentos de preço de curto e longo prazo. De modo geral, valores positivos indicam uma tendência de alta, enquanto valores negativos apontam para uma tendência de baixa. Acompanhar a direção e a magnitude da linha MACD pode ajudar a avaliar a força da tendência. Além disso, seus cruzamentos podem sinalizar possíveis mudanças de tendência.
Na sequência, calculamos a série correspondente à linha de sinal e a adicionamos ao DataFrame de saída. Essa linha é obtida calculando uma EMA da linha MACD com o período definido por signal-period. Ela suaviza as oscilações do MACD e fornece uma referência para a geração de sinais de negociação. Os cruzamentos entre a linha MACD e a linha de sinal também representam pontos importantes para a tomada de decisões. Com o período padrão de 9, a linha de sinal oferece um equilíbrio entre a rapidez de resposta e a suavização das oscilações. No entanto, esse parâmetro pode ser ajustado conforme as características e as condições de mercado do ativo negociado.
Como último componente adicionado ao DataFrame de saída, calculamos o histograma MACD. Esse cálculo corresponde à diferença entre o buffer MACD e o buffer da linha de sinal. O histograma ajuda a visualizar a força do momentum: valores positivos indicam uma tendência de alta, enquanto valores negativos indicam uma tendência de baixa. Além disso, uma mudança de sinal no histograma pode indicar uma possível reversão de tendência. Depois de adicionar as três séries do pandas ao DataFrame de saída, a execução da função termina e o DataFrame resultante é retornado.
OBV
Esta função calcula o volume em balanço (On-Balance Volume, OBV), um indicador de volume que relaciona as variações de preço ao volume negociado. Sua implementação em Python é apresentada a seguir:
def OBV(df) -> pd.DataFrame:
    """
    Calculate On-Balance Volume (OBV) and append it as an 'OBV' column
    to the input DataFrame.

    OBV is a momentum indicator that uses volume flow to predict changes in stock price.

    Args:
        df (pd.DataFrame): DataFrame with 'close' and 'volume' columns.

    Returns:
        pd.DataFrame: Input DataFrame with a new 'OBV' column.
    """
    # Input validation
    if not all(col in df.columns for col in ['close', 'tick_volume']):
        raise ValueError("DataFrame must contain 'close' and 'volume' columns")

    # Create a copy to avoid modifying the original DataFrame
    result_df = df.copy()
    # print(result_df.columns)

    # Calculate the direction of price change
    # np.sign returns 1 for positive, -1 for negative, and 0 for zero change
    direction = np.sign(result_df['close'].diff())

    # Calculate the OBV
    # Multiply the volume by the direction of price movement
    # Then calculate the cumulative sum
    obv = (result_df['tick_volume'] * direction).cumsum()

    # The first value of diff() is NaN, so the first OBV will be NaN.
    # We can fill it with the first day's volume or 0. A common practice is to start at 0.
    result_df['OBV'] = obv.fillna(0)

    return result_df
O código acima começa verificando se o DataFrame contém as colunas necessárias: preço de fechamento e volume de ticks (tick-volume). Utilizamos o volume de ticks porque ele geralmente está disponível para a maioria das classes de ativos, ao contrário do volume real, que é difícil de obter para pares de moedas devido à natureza descentralizada do mercado Forex. Após essa verificação, criamos uma cópia do DataFrame de entrada, pois vamos adicionar a ele os valores calculados do OBV. Como já discutimos na implementação da função MACD, preservar a integridade dos dados originais é uma prática recomendável.
Em seguida, calculamos direction (direção), que representa o sentido da variação do preço de fechamento entre períodos consecutivos. Para isso, utilizamos a função np.sign, que retorna -1, +1 ou 0, indicando, respectivamente, queda do preço, alta do preço ou ausência de variação. Essa etapa é importante porque identifica a direção do movimento do preço, que determina como o volume será acumulado no OBV. Além disso, simplifica a análise das tendências ao representar as variações de preço por um sinal numérico, facilitando sua combinação com os dados de volume negociado.
Depois de determinar o vetor de direção, calculamos o OBV multiplicando o volume pelo sinal correspondente e aplicando a soma cumulativa aos resultados. Dessa forma, acompanhamos a evolução do OBV ao longo do tempo. O OBV relaciona as variações de preço ao volume negociado, somando os volumes nos períodos de alta e subtraindo-os nos períodos de baixa. Assim, seu comportamento pode revelar a predominância da pressão compradora ou vendedora. A tendência do OBV é mais importante do que seu valor absoluto. Comparar a direção do OBV com a direção do preço pode ajudar a confirmar a tendência observada no mercado.
A próxima linha de código substitui o valor NaN presente no primeiro registro do OBV, gerado pela função diff(), pois esse valor impediria a realização de comparações. A mesma linha também adiciona os valores calculados a uma nova série OBV do pandas no DataFrame de saída. No caso específico do OBV, substituir esse valor por 0 é uma escolha adequada, pois zero representa uma condição neutra, na qual não há acumulação de volume em nenhuma das direções. Isso é diferente de atribuir 0 ao buffer de preços de uma média móvel.
Considerações sobre os resultados anteriores
Muitos dos padrões de sinal apresentados no artigo anterior, em que analisamos a combinação dos indicadores MACD e OBV, não conseguiram gerar lucro no teste forward. Apenas o padrão 7 apresentou resultados positivos, enquanto, nas outras combinações de indicadores que estudamos, geralmente pelo menos 6 dos 10 padrões testados foram lucrativos. Vamos selecionar alguns dos padrões que apresentaram desempenho especialmente baixo no artigo anterior e verificar se conseguimos melhorar seus resultados com o uso de aprendizado supervisionado. Para este artigo, escolhemos 3 dos 9 padrões que tiveram desempenho insatisfatório: os padrões 2, 3 e 5.
Padrão 2
Implementamos o padrão 2 em Python da seguinte forma:
def feature_2(macd_df, obv_df, price_df):
    """

    """
    feature = np.zeros((len(macd_df), 2))

    feature[:, 0] = ((price_df['low'] < price_df['low'].shift(1)) &
                     (macd_df['MACD_Histogram'] > macd_df['MACD_Histogram'].shift(1)) &
                     (obv_df['OBV'] > obv_df['OBV'].shift(1))).astype(int)

    feature[:, 1] = ((price_df['high'] > price_df['high'].shift(1)) &
                     (macd_df['MACD_Histogram'] < macd_df['MACD_Histogram'].shift(1)) &
                     (obv_df['OBV'] < obv_df['OBV'].shift(1))).astype(int)

    feature[0, :] = 0
    feature[1, :] = 0

    return feature
Em resumo, esse método se baseia na divergência entre o preço e a tendência. Um fundo mais baixo no preço, acompanhado por um MACD em alta, indica uma divergência oculta de alta. Da mesma forma, um topo mais alto no preço, combinado com um MACD em queda, caracteriza uma divergência oculta de baixa. Esses sinais são combinados com a confirmação pelo volume. Um OBV em alta confirma a acumulação, representando um sinal de alta, enquanto um OBV em queda indica distribuição, caracterizando um sinal de baixa. Em essência, o modelo busca confirmar, por meio dos sinais de volume, as divergências que revelam uma perda de força do momentum, mesmo quando o preço continua formando novos extremos.
Dessa forma, o padrão permite identificar padrões de continuação de tendência. Ele tende a ser mais confiável em mercados com tendências bem estabelecidas, sejam elas de alta ou de baixa. Além disso, geralmente é necessária uma confirmação ao longo de duas barras antes de utilizar o sinal. Realizamos os testes com uma CNN cuja arquitetura utiliza o kernel RQ, alimentando a rede com os sinais gerados por esse padrão no período de 01/01/2023 a 01/01/2025. O treinamento e a otimização foram realizados com dados de 01/01/2023 a 01/01/2024, utilizando o par de moedas GBPJPY no timeframe H4. O relatório do teste é apresentado a seguir:
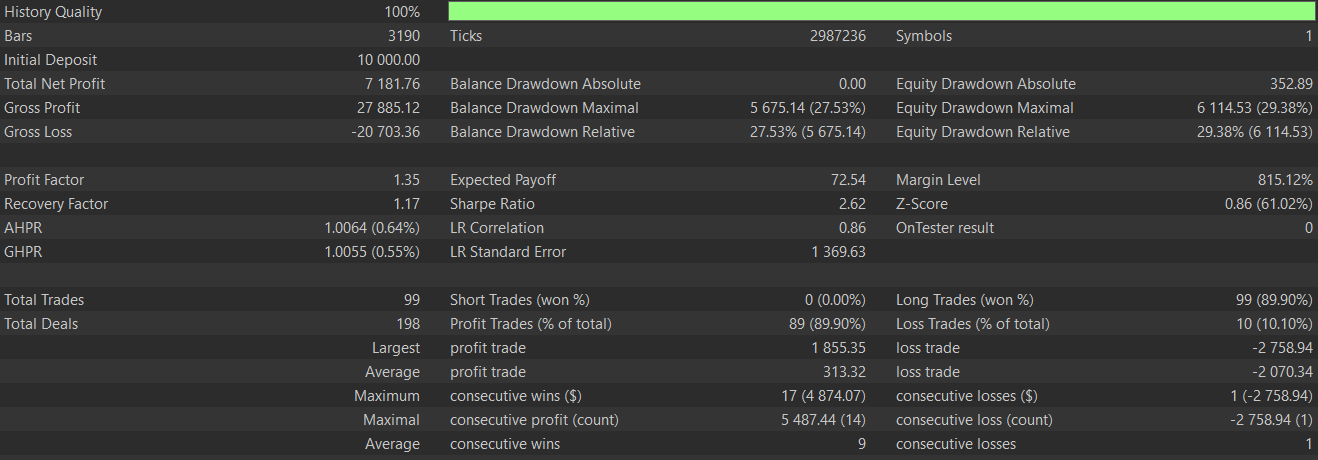
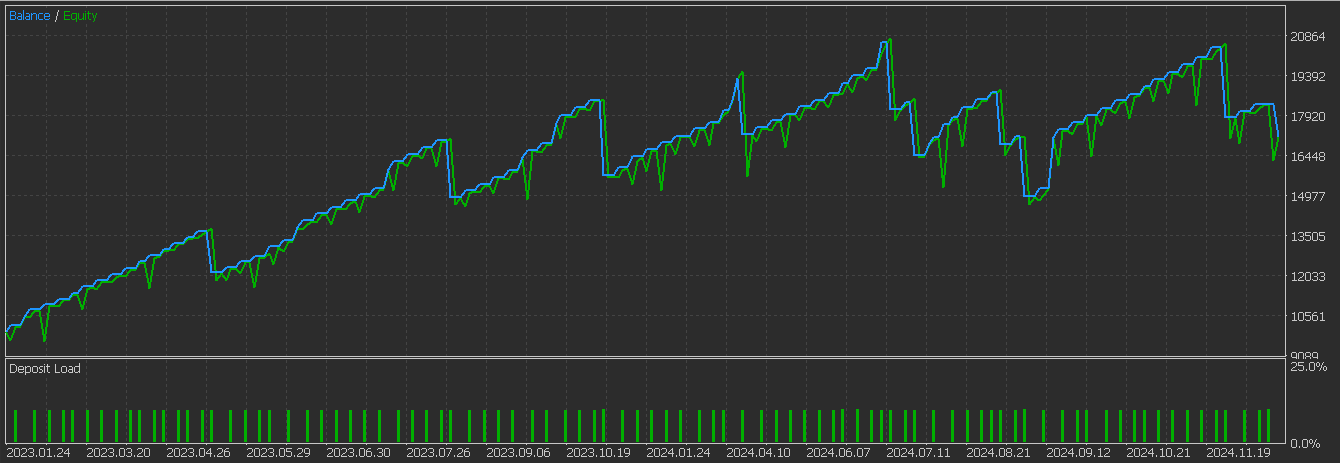
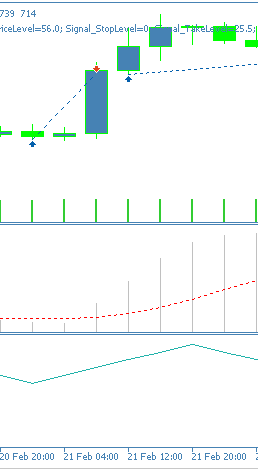
É evidente que houve uma melhora evidente em relação aos resultados obtidos no artigo anterior. Portanto, podemos considerar que nossa abordagem baseada em aprendizado supervisionado produziu resultados positivos. Como sempre, é fundamental que o leitor tenha cautela e realize testes independentes antes de aplicar qualquer uma das ideias apresentadas aqui em contas reais. Embora esses artigos sejam voltados à negociação automatizada, também pode ser útil visualizar diretamente no gráfico os padrões que estamos analisando. A seguir, apresentamos um exemplo de sinal de alta do padrão 2.
Padrão 3
Implementamos esse padrão em Python da seguinte forma:
def feature_3(macd_df, obv_df, price_df):
    """
    """
    feature = np.zeros((len(macd_df), 2))

    feature[:, 0] = ((macd_df['MACD_Histogram'] > macd_df['MACD_Histogram'].shift(1)) &
                     (macd_df['MACD_Histogram'].shift(1) < macd_df['MACD_Histogram'].shift(2)) &
                     (obv_df['OBV'] > obv_df['OBV'].shift(1))).astype(int)

    feature[:, 1] = ((macd_df['MACD_Histogram'] < macd_df['MACD_Histogram'].shift(1)) &
                     (macd_df['MACD_Histogram'].shift(1) > macd_df['MACD_Histogram'].shift(2)) &
                     (obv_df['OBV'] < obv_df['OBV'].shift(1))).astype(int)

    feature[0, :] = 0
    feature[1, :] = 0

    return feature
Esse padrão identifica reversões no histograma MACD. Um sinal de alta é confirmado quando o histograma forma um fundo e começa a subir após um período de queda. Por outro lado, um sinal de baixa é confirmado quando o histograma forma um topo e passa a cair, depois de apresentar uma trajetória ascendente nas barras anteriores. O objetivo é identificar pontos de inflexão do momentum por meio do comportamento do histograma. Para reconhecer corretamente a formação de topos e fundos e reduzir a ocorrência de sinais falsos, o padrão também exige uma sequência de três barras.
Além disso, o indicador OBV confirma a direção da tendência, verificando se o comportamento do volume acompanha a tendência do preço. Valores positivos confirmam sinais de alta, enquanto valores negativos confirmam sinais de baixa. Em teoria, essa confirmação indica a participação de investidores institucionais. Ao testar o padrão nas mesmas condições descritas anteriormente para o padrão 2, obtemos o seguinte resultado, que aparentemente indica que o padrão passou no teste forward:
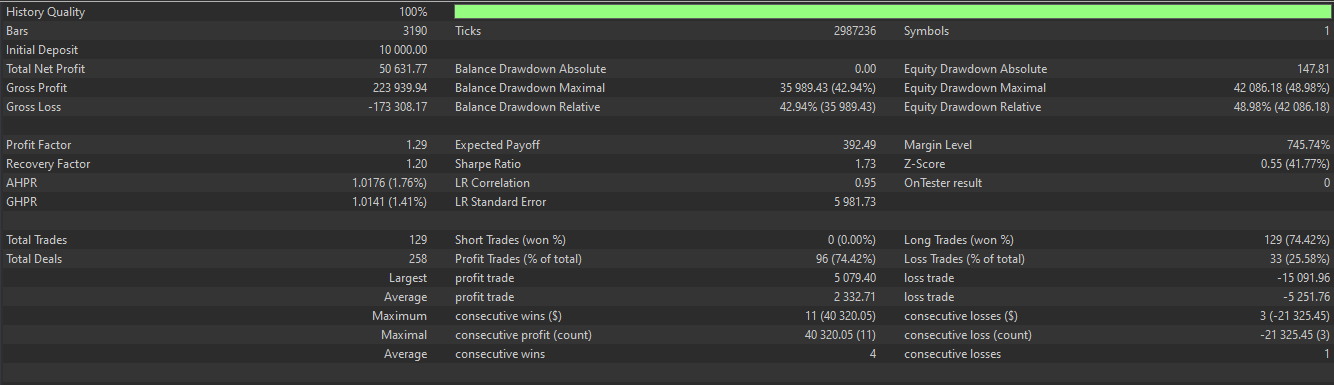
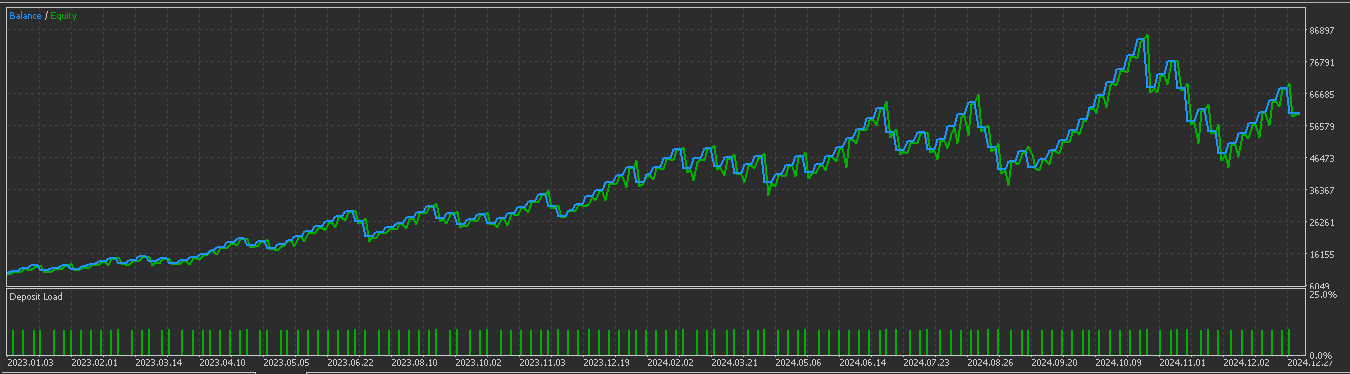
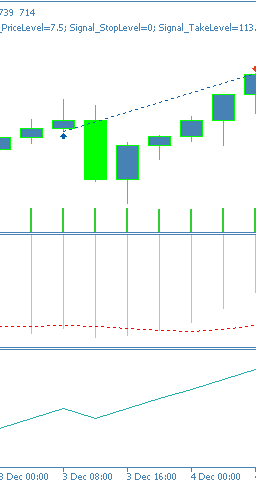
Esse padrão de sinal é adequado para identificar reversões de tendência e pode ser eficaz em níveis de sobrecompra e sobrevenda. Ele exige pelo menos 3 barras de histórico de preços. Por isso, as duas primeiras barras da série recebem o valor 0, já que não há dados anteriores suficientes para realizar as comparações. No gráfico, um sinal de alta pode ser representado da seguinte forma:
Padrão 5
Implementamos esse padrão em Python da seguinte forma:
def feature_5(macd_df, obv_df, price_df):
    """

    """
    feature = np.zeros((len(macd_df), 2))

    feature[:, 0] = ((macd_df['MACD_Histogram'] > macd_df['MACD_Histogram'].shift(1)) &
                     (macd_df['MACD_Histogram'] < 0.0) &
                     (obv_df['OBV'] > obv_df['OBV'].shift(1))).astype(int)

    feature[:, 1] = ((macd_df['MACD_Histogram'] < macd_df['MACD_Histogram'].shift(1)) &
                     (macd_df['MACD_Histogram'] > 0.0) &
                     (obv_df['OBV'] < obv_df['OBV'].shift(1))).astype(int)

    feature[0, :] = 0
    feature[1, :] = 0

    return feature
O padrão 5 se baseia na posição do MACD em relação à linha zero. A estratégia busca identificar pontos de entrada antecipados, gerando um sinal de alta quando o MACD está abaixo de zero, na região negativa do MACD, e um sinal de baixa quando o MACD está acima de zero. O uso de um indicador adicional para identificar mudanças no momentum no momento em que o padrão gera um sinal pode ajudar a evitar sinais falsos. O filtro de direção do volume também deve acompanhar as mudanças na dinâmica do volume, reforçando a indicação de interesse dos participantes institucionais.
Nesse padrão, os sinais de alta tendem a perder força em condições de sobrevenda com momentum crescente, enquanto os sinais de baixa enfraquecem em situações de sobrecompra, acompanhados por uma perda de momentum. O padrão tende a funcionar melhor em mercados laterais e exige que o MACD esteja em uma fase de reversão ou recuperação. Após o treinamento e a otimização, obtivemos o seguinte resultado no teste do padrão:
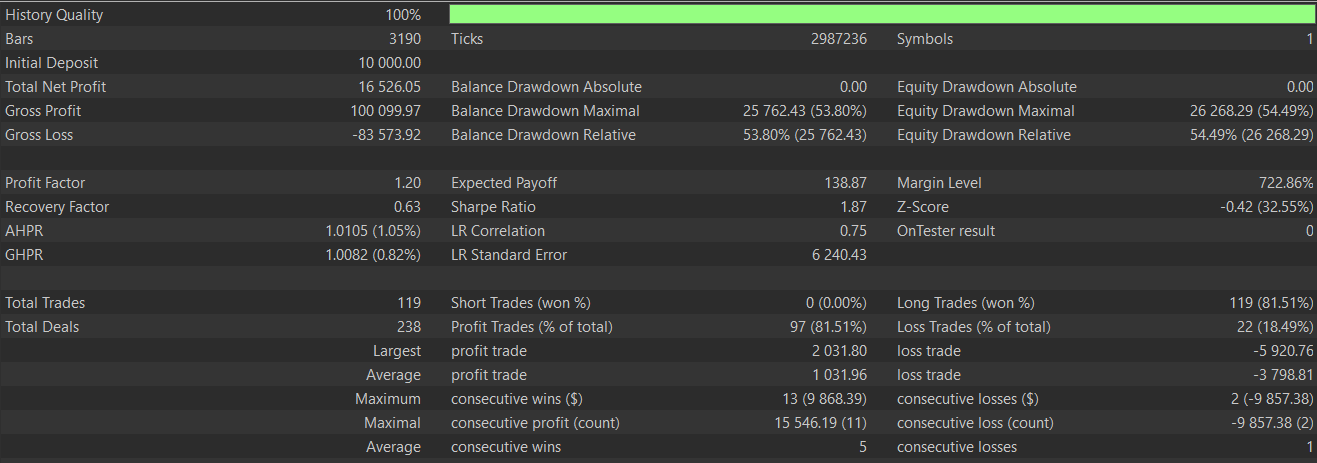
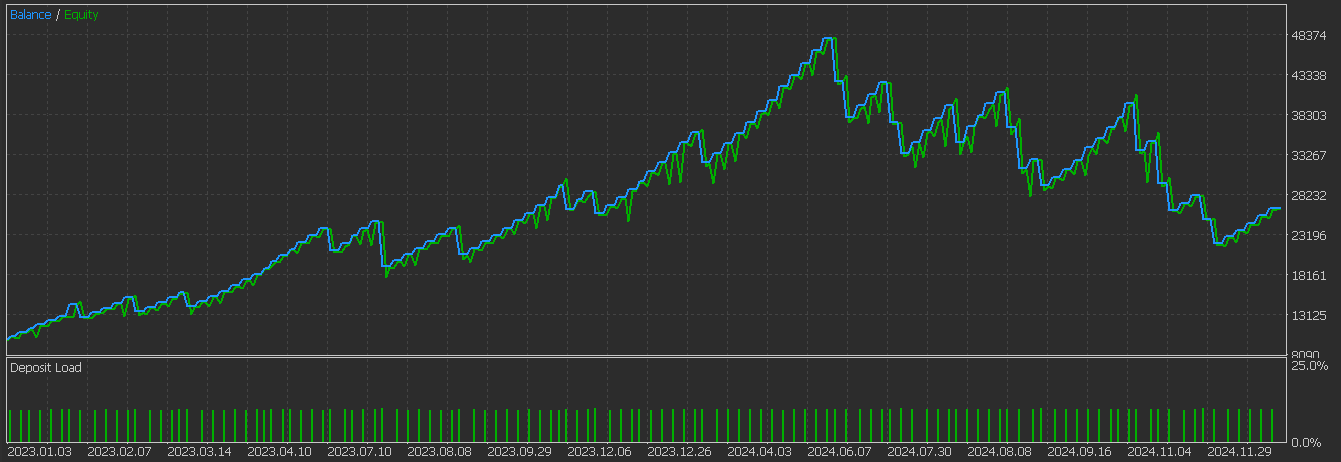
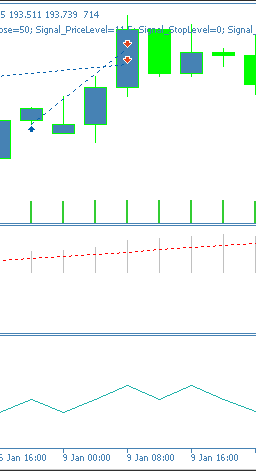
Dos três padrões testados, este parece continuar apresentando dificuldades no teste forward. Uma possível explicação é a geração de sinais falsos pelo MACD, devido à determinação antecipada do momento do sinal sem a confirmação independente de uma reversão do momentum. A representação do padrão no gráfico é apresentada a seguir:
Conclusão
Voltamos a analisar a combinação dos indicadores MACD e OBV, apresentada no artigo anterior, para verificar se seria possível melhorar o desempenho insatisfatório de alguns de seus padrões de sinal. Conseguimos obter resultados melhores em 2 dos 3 padrões reavaliados, utilizando uma CNN com aprendizado supervisionado que emprega um kernel racional quadrático para definir os tamanhos dos kernels e o número de canais. Quanto ao padrão 5, atribuímos seu desempenho insatisfatório à fragilidade dos sinais de entrada, que exigem confirmação adicional.
| Nome | Descrição |
|---|---|
| WZ-72.mq5 | EA criado pelo Assistente MQL5, com os arquivos utilizados descritos no cabeçalho |
| SignalWZ_72.mqh | Arquivo personalizado da classe de sinais para a criação do EA no Assistente MQL5 |
| 72_2.onnx | Rede neural Python exportada para o padrão de sinal 2 |
| 72_3.onnx | Rede neural Python exportada para o padrão de sinal 3 |
| 72_5.onnx | Rede neural Python exportada para o padrão de sinal 5 |
Traduzido do Inglês pela MetaQuotes Ltd.
Artigo original: https://www.mql5.com/en/articles/18697
Aviso: Todos os direitos sobre esses materiais pertencem à MetaQuotes Ltd. É proibida a reimpressão total ou parcial.
Esse artigo foi escrito por um usuário do site e reflete seu ponto de vista pessoal. A MetaQuotes Ltd. não se responsabiliza pela precisão das informações apresentadas nem pelas possíveis consequências decorrentes do uso das soluções, estratégias ou recomendações descritas.
 Desenvolvimento de ferramentas para análise de Price Action (Parte 30): EA CCI Zero Line
 Automatização de estratégias de trading em MQL5 (Parte 21): Aprimorando o trading baseado em redes neurais com taxas de aprendizado adaptativas
 Está chegando o novo MetaTrader 5 e MQL5
 Ferramentas de Trading em MQL5 (Parte 3): Construindo um Painel de Scanner Multitemporal para Negociação Estratégica

- Aplicativos de negociação gratuitos
- 8 000+ sinais para cópia
- Notícias econômicas para análise dos mercados financeiros
Você concorda com a política do site e com os termos de uso