

Training eines nichtlinearen U-Transformers anhand der Residuen eines linearen autoregressiven Modells
 22
 1

Im modernen algorithmischen Handel stehen Entwickler vor einem grundlegenden Dilemma: Lineare Modelle sind einfach und nachvollziehbar, können jedoch komplexe nichtlineare Zusammenhänge in Finanzzeitreihen nicht erfassen. Tiefe neuronale Netze hingegen können theoretisch jede beliebige Nichtlinearität modellieren, neigen jedoch bei starkem Marktrauschen und begrenzten Datenmengen zu Overfitting und Instabilität.
Der Artikel stellt einen innovativen hybriden Ansatz vor, der diesem Dilemma mit einem zweistufigen Modellierungsansatz begegnet: Zunächst extrahiert ein lineares autoregressives Modell mit 25 Merkmalen wichtige statistische Muster aus den Kursdaten; anschließend wird eine spezielle U-Transformer-Architektur auf den Residuen des linearen Modells trainiert, wodurch verborgene nichtlineare Muster aufgedeckt werden, die die erste Stufe nicht erfassen konnte.
Die zentrale Neuerung besteht in der Anpassung der U-Net-Architektur (die ursprünglich für die Bildsegmentierung entwickelt wurde) durch die Integration von Transformer-Blöcken für die Zeitreihenanalyse. Das System ist in MQL5 implementiert und umfasst eine vollständige Handelslogik mit dynamischem Positionsmanagement, automatischer Parameter-Reoptimierung und Online-Training des neuronalen Netzwerks.
Die experimentelle Validierung belegt die Überlegenheit des hybriden Ansatzes gegenüber rein linearen Methoden, wobei die Recheneffizienz und die Interpretierbarkeit der Ergebnisse gewahrt bleiben. Das vorgestellte System ist in der Lage, in Echtzeit zu arbeiten und sich automatisch an veränderte Marktbedingungen anzupassen.
Einleitung
Finanzmärkte sind komplexe adaptive Systeme, in denen traditionelle Prognosemethoden mit mehreren grundlegenden Herausforderungen konfrontiert sind. Das erste und offensichtlichste dieser Probleme ist die Nichtlinearität. Marktdaten offenbaren komplexe Muster, die sich einer einfachen linearen Beschreibung entziehen: Regimewechsel bei der Volatilität, asymmetrische Reaktionen auf Nachrichten und kaskadierende Liquiditätseffekte. Versuche, leistungsstarke nichtlineare Modelle des maschinellen Lernens auf Finanzdaten anzuwenden, führen jedoch häufig zu einem zweiten Problem: Overfitting und Prognoseinstabilität.
Dieses Problem ist im algorithmischen Handel besonders ausgeprägt, da das Modell Kursbewegungen nicht nur präzise prognostizieren, sondern dies auch über verschiedene Marktbedingungen hinweg konsistent leisten und zugleich für den Echtzeitbetrieb recheneffizient bleiben muss. Klassische ökonometrische Modelle wie ARIMA oder VAR bieten Stabilität und Interpretierbarkeit, doch aufgrund ihres linearen Charakters sind sie bei der Modellierung komplexer Marktdynamiken stark eingeschränkt.
Andererseits sind moderne Deep-Learning-Architekturen – LSTM, GRU, Transformer – theoretisch in der Lage, beliebige nichtlineare Zusammenhänge zu approximieren, doch ihre Anwendung auf Finanzdaten wird durch mehrere Faktoren erschwert. Erstens führen stark verrauschte Marktdaten dazu, dass neuronale Netze zufällige Schwankungen auswendig lernen, anstatt die zugrunde liegenden Muster zu erkennen. Zweitens bedeutet die Nichtstationarität finanzieller Zeitreihen, dass aus historischen Daten erlernte Muster schnell irrelevant werden können.
Das dritte Problem ist praktischer Natur: Die rechnerischen Einschränkungen von Handelsplattformen, insbesondere in der Programmiersprache MQL5, lassen eine vollständige Nutzung moderner Deep-Learning-Frameworks nicht zu. Der Entwickler ist gezwungen, Algorithmen für neuronale Netze von Grund auf selbst zu implementieren, was die Komplexität der Architekturen, die realistisch umgesetzt werden können, erheblich einschränkt.
Die in diesem Beitrag vorgeschlagene Lösung basiert auf dem Ansatz, das Prognoseproblem in zwei Phasen unterschiedlicher Art zu unterteilen: eine lineare Phase zur Erfassung der wichtigsten statistischen Regelmäßigkeiten und eine nichtlineare Phase zur Modellierung komplexer Abhängigkeiten in den Residuen. Dieser Ansatz ermöglicht es, die Stärken beider Methodengruppen zu nutzen und gleichzeitig ihre Schwächen zu minimieren.
Das lineare autoregressive Modell der ersten Stufe basiert auf einem sorgfältig konzipierten 25-dimensionalen Merkmalsraum, der nicht nur klassische, verzögerte Kurswerte, sondern auch deren nichtlineare Transformationen, technische Indikatoren und zyklische Komponenten umfasst. Dieses Modell wird mittels Gradientenabstieg optimiert und bietet bei hoher Interpretierbarkeit ein grundlegendes Niveau der Prognosequalität.
Die neuronale Netzkomponente der zweiten Stufe nutzt eine angepasste U-Transformer-Architektur, die die Prinzipien von U-Net (eine Encoder-Decoder-Struktur mit Skip-Verbindungen) und die Attention-Mechanismen der Transformer-Architektur kombiniert. Das wesentliche Merkmal dieses Ansatzes besteht darin, dass das neuronale Netz nicht anhand der ursprünglichen Kursdaten, sondern anhand der Residuen des linearen Modells trainiert wird, was die Aufgabe erheblich vereinfacht und das Risiko von Overfitting verringert.
Diese Zerlegung sorgt für eine natürliche Regularisierung: Wenn sich die Marktbedingungen ändern und die neuronale Netzkomponente instabile Prognosen erzeugt, wechselt das System automatisch zu den konservativeren Prognosen des linearen Modells. Dies wird durch ein adaptives Gewichtungsschema erreicht, bei dem das Gewicht der neuronalen Netzkomponente von der aktuellen Qualität beider Modelle abhängt.
Theoretische Grundlagen der U-Transformer-Architektur
Die U-Transformer-Architektur ist eine Synthese aus zwei leistungsstarken Konzepten aus den Bereichen Computer Vision und Verarbeitung natürlicher Sprache: U-Net und Attention-Mechanismen. U-Net wurde ursprünglich für Aufgaben der medizinischen Bildsegmentierung entwickelt, bei denen eine genaue Objektlokalisierung unter Beibehaltung des globalen Kontexts erforderlich ist. Der Kerngedanke von U-Net ist eine symmetrische Encoder-Decoder-Architektur mit horizontalen Skip-Verbindungen, die es ermöglichen, detaillierte Informationen aus frühen Schichten direkt an spätere Schichten des Decoders weiterzugeben.
Im Zusammenhang mit der Zeitreihenanalyse erhält diese Architektur eine neue Bedeutung. Der Encoder komprimiert zeitliche Informationen schrittweise, indem er zunehmend abstraktere Muster extrahiert, während der Decoder die zeitliche Auflösung mithilfe sowohl abstrakter Darstellungen als auch detaillierter Merkmale über Skip-Verbindungen wiederherstellt. Dies ist besonders wichtig bei Finanzdaten, bei denen lokale Schwankungen ebenso bedeutend sein können wie globale Trends.
struct UTransformerNet
{
    NeuralLayer encoder_layers[3];     // Encoder: information compression
    NeuralLayer decoder_layers[3];     // Decoder: restore resolution
    AttentionBlock attention_heads[4]; // Multi-head attention
    double skip_connections[3][32];    // U-Net horizontal connections
    double residuals[6000];            // Residuals for training
    double neural_predictions[6000];   // Neural network predictions
};
Der aus der Transformer-Architektur übernommene Self-Attention-Mechanismus verleiht dem Modell die Fähigkeit, sich dynamisch auf die relevantesten Teile der Eingabesequenz zu konzentrieren. Im Gegensatz zu Faltungs- oder rekurrenten Schichten ermöglicht Attention dem Modell, zeitlich weit auseinanderliegende Ereignisse direkt miteinander in Beziehung zu setzen, was für Finanzmärkte von entscheidender Bedeutung ist, da die Auswirkungen von Ereignissen dort verzögert eintreten können.
void SelfAttention(double &inputs[], AttentionBlock &attention, double &outputs[])
{
    double queries[32], keys[32], values[32];

    // Calculate Q, K, V transformations
    for (int i = 0; i < NeuralNodes; i++)
    {
        queries[i] = 0; keys[i] = 0; values[i] = 0;
        for (int j = 0; j < NeuralNodes; j++)
        {
            queries[i] += inputs[j] * attention.query_weights[j][i];
            keys[i] += inputs[j] * attention.key_weights[j][i];
            values[i] += inputs[j] * attention.value_weights[j][i];
        }
    }

    // Calculate attention scores: Q × K^T
    for (int i = 0; i < NeuralNodes; i++)
    {
        attention.attention_scores[i] = 0;
        for (int j = 0; j < NeuralNodes; j++)
        {
            attention.attention_scores[i] += queries[i] * keys[j];
        }
        attention.attention_scores[i] /= MathSqrt(NeuralNodes); // Scaling
    }
}
Der wesentliche Unterschied der vorgeschlagenen Architektur gegenüber Standard-Transformern besteht darin, dass sie auf eindimensionale Zeitreihen zugeschnitten ist und nicht auf die in Standard-Transformer-Modellen üblicherweise verwendeten Token-Sequenz-Darstellungen. Anstelle der Positionskodierung werden Zeitmerkmale (Stunde des Tages, zyklische Komponenten) verwendet, wodurch das Modell die Intraday-Saisonalität der Handelssitzungen berücksichtigen kann.
Hybridmodell: Lineare Regression plus neuronales Netzwerk
Der Kerngedanke des hybriden Ansatzes ist die additive Zerlegung der Prognose in zwei Komponenten unterschiedlicher Natur:
Final_Prediction = Linear_Model(X) + α × U_Transformer(Residuals)
wobei α ein adaptiver Gewichtungskoeffizient ist, der von der aktuellen Qualität beider Modelle abhängt.
Die lineare Komponente ist als klassisches autoregressives Modell mit einem erweiterten Merkmalsraum aufgebaut:
// Calculate linear prediction
double linear_pred = 0;
for (int i = 0; i < 25; i++)
    linear_pred += g_pair.coeffs[i] * features[i];
Die neuronale Netzkomponente wird nicht anhand der ursprünglichen Kursdaten trainiert, sondern anhand der Residuen des linearen Modells:
void TrainUTransformer()
{
    // Calculate the residuals of a linear model
    for (int i = 0; i < g_pair.data_size; i++)
    {
        double linear_pred = 0;
        for (int j = 0; j < 25; j++)
            linear_pred += g_pair.coeffs[j] * g_pair.features[i][0][j];

        g_pair.neural_net.residuals[i] = g_pair.prices[i] - linear_pred;
    }

    // Train a neural network on residuals
    for (int epoch = 0; epoch < NeuralEpochs; epoch++)
    {
        double total_loss = 0;
        for (int i = 0; i < g_pair.data_size; i++)
        {
            double prediction = UTransformerForward(g_pair.coeffs,
                                                   g_pair.neural_net.residuals[i]);
            double error = prediction - g_pair.neural_net.residuals[i];
            total_loss += error * error;
        }
    }
}
Diese Zerlegung bietet mehrere entscheidende Vorteile. Erstens löst das neuronale Netzwerk ein wesentlich einfacheres Problem: die Modellierung von Residuen anstelle der ursprünglichen Zeitreihe. Residuen weisen in der Regel eine geringere Varianz und stärker stationäre statistische Eigenschaften auf, was das Training vereinfacht und das Risiko von Overfitting verringert.
Zweitens implementiert das System auf natürliche Weise das „Fail-Safe“-Prinzip: Wenn die neuronale Netzkomponente beginnt, instabile Prognosen zu erzeugen (hoher Loss), erhöht das System automatisch die Gewichtung der linearen Komponente:
double GetHybridPrediction(double price_t1, double price_t2, double price_t3)
{
    // Linear prediction
    double linear_pred = 0;
    for (int i = 0; i < 25; i++)
        linear_pred += g_pair.coeffs[i] * features[i];

    // Neural network correction
    double neural_correction = 0;
    if (g_pair.neural_net.is_trained)
    {
        neural_correction = UTransformerForward(g_pair.coeffs, 0);
    }

    // Adaptive weighting
    double confidence = MathMin(g_pair.current_r2, 0.8);
    double neural_weight = g_pair.neural_net.is_trained ? (1.0 - confidence) : 0.0;

    return linear_pred + neural_weight * neural_correction;
}
Der Koeffizient neural_weight passt sich automatisch an die Qualität des Modells an: Bei einem hohen Bestimmtheitsmaß R² der linearen Komponente (gute Qualität) erhält die neuronale Netzkomponente ein geringeres Gewicht; bei einem niedrigen Bestimmtheitsmaß R² erhält sie ein höheres Gewicht. Dies gewährleistet die Stabilität des Systems in verschiedenen Marktregimen und verhindert, dass ein schlecht trainiertes neuronales Netzwerk hochwertige lineare Prognosen beeinträchtigt.
Mehrdimensionaler Merkmalsraum und Feature Engineering
Die Qualität eines jeden Modells des maschinellen Lernens hängt entscheidend von der Aussagekraft der Eingabemerkmale ab. Bei der Finanzprognose ist diese Abhängigkeit besonders ausgeprägt, da Marktdaten durch ein hohes Maß an Marktrauschen und Nichtstationarität gekennzeichnet sind. Das vorgeschlagene System nutzt einen sorgfältig konzipierten 25-dimensionalen Merkmalsraum, der sowohl klassische, verzögerte Kurswerte als auch deren nichtlineare Transformationen, technische Indikatoren und zyklische Komponenten umfasst.
Der Basissatz an Merkmalen umfasst direkte und quadratische Terme der verzögerten Kurswerte:
void CalculateFeatures(double price_t1, double price_t2, double price_t3,
                      int bar_index, string symbol, double &features[])
{
    // Linear price components
    features[0] = price_t1;                    // X(t-1)
    features[1] = MathPow(price_t1, 2);        // X(t-1)²
    features[2] = price_t2;                    // X(t-2)
    features[3] = MathPow(price_t2, 2);        // X(t-2)²
    features[4] = price_t3;                    // X(t-3)

    // Difference operators (momentum)
    features[5] = (price_t1 - price_t2);      // Short-term momentum
    features[9] = (price_t1 - price_t3);      // Medium-term momentum
    features[18] = MathPow(price_t1 - price_t2, 2); // Quadratic momentum
}
Zyklische Komponenten bilden periodische Muster auf verschiedenen Zeitskalen ab:
// Low-frequency cycles (daily seasonality)
    features[6] = MathSin(price_t1);
    features[7] = MathCos(price_t1);

    // High-frequency cycles (intraday patterns)
    features[13] = MathSin(price_t1 * 1000);
    features[14] = MathCos(price_t1 * 1000);

    // Time component (trading session hour)
    datetime bar_time = iTime(symbol, PERIOD_H1, bar_index);
    MqlDateTime dt;
    TimeToStruct(bar_time, dt);
    features[17] = (dt.hour / 24.0);
Nichtlineare Transformationen helfen dem Modell, sich an unterschiedliche Volatilitätsregime anzupassen:
// Root and exponential transformations
    features[15] = MathSqrt(MathAbs(price_t1));
    features[16] = MathExp(-MathAbs(price_t1 - price_t2));

    // Hyperbolic tangent for limiting outliers
    features[23] = MathTanh(price_t1 - ma);
Technische Indikatoren liefern zusätzliche Informationen über die Marktmikrostruktur:
// RSI and its nonlinear versions
    double rsi = 50.0; // Simplified calculation for demonstration
    features[10] = (rsi / 100.0);
    features[21] = MathPow(rsi / 100.0, 2);

    // Deviation from the moving average
    double ma = price_t1; // Simplified calculation
    features[11] = (price_t1 - ma);

    // Volatility (ATR)
    double atr = MathAbs(price_t1 - price_t2);
    features[12] = atr;
    features[20] = (atr * (price_t1 - price_t2)); // Interaction of volatility and momentum
Eine besondere Kategorie bilden Interaktionsmerkmale, die nichtlineare Effekte zwischen verschiedenen Komponenten modellieren:
// Pairwise interactions
    features[8] = (price_t1 * price_t2);
    features[19] = (price_t1 / price_t2);

    // Triple interactions
    features[22] = (price_t1 * price_t2 * price_t3);

    // Constant term
    features[24] = 1.0;
Dank dieser Vielfalt an Merkmalen kann das lineare Modell ein breites Spektrum an Marktmustern erfassen, von einfachen Trendbewegungen bis hin zu komplexen nichtlinearen Mustern. In diesem Fall wird die neuronale Netzkomponente auf den Residuen dieses reichhaltigen linearen Modells trainiert, was ihre Aufgabe erheblich vereinfacht.
Datenstrukturen und Speicherorganisation in MQL5
Die Implementierung komplexer Algorithmen des maschinellen Lernens in der MQL5-Umgebung erfordert besondere Aufmerksamkeit bei der Organisation von Speicher und Datenstrukturen. Im Gegensatz zu modernen Deep-Learning-Frameworks, die Speicher und Berechnungsgraphen automatisch verwalten, muss der Entwickler in MQL5 effiziente Datenstrukturen manuell entwerfen.
Die zentrale Struktur des Systems, PairData, fasst alle erforderlichen Daten für ein Handelspaar zusammen:
struct PairData
{
    string analyst_symbol;    // Symbol for analysis (EURUSD)
    string trade_symbol;      // Symbol for trading (USDJPY)

    // Linear model coefficients
    double coeffs[25];        // Current coefficients
    double best_coeffs[25];   // Best coefficients found

    // Quality metrics
    double current_r2;        // Current R²
    double best_r2;           // Best achieved R²
    double learning_rate;     // Adaptive learning rate

    // Time series and features
    double prices[6000];                    // Target prices
    double features[6000][50][25];          // Sequences of features
    int data_size;                          // Actual data size

    // Position state for averaging/pyramiding
    double last_buy_price;    // Price of the last BUY position
    double last_sell_price;   // Price of the last SELL position
    int buy_levels;           // Number of BUY levels
    int sell_levels;          // Number of SELL levels

    // Neural network component
    UTransformerNet neural_net;
};
Die Struktur der neuronalen Schicht ist für eine effiziente Matrixmultiplikation optimiert:
struct NeuralLayer
{
    double weights[64][64];   // Layer weight matrix
    double biases[64];        // Bias vector
    double outputs[64];       // Neuron outputs
    double gradients[64];     // Gradients for backpropagation
    int size;                 // Actual size of the layer
};
Der Attention-Block implementiert eine vereinfachte Version von Multi-Head-Attention:
struct AttentionBlock
{
    double query_weights[32][32];  // Query transformation matrix
    double key_weights[32][32];    // Key transformation matrix
    double value_weights[32][32];  // Value transformation matrix
    double attention_scores[32];   // Attention weights
    double context[32];            // Context vector
};
Ein wesentliches Merkmal der Speicherorganisation ist die Verwendung statischer Arrays fester Größe anstelle dynamischer Strukturen. Dies liegt daran, dass ein vorhersehbarer Speicherverbrauch gewährleistet werden muss:
// Maximum array sizes are specified as constants
double prices[6000];                    // Maximum 6000 historical points
double features[6000][50][25];          // Sequences of 50 bars
double residuals[6000];                 // Residuals for training the neural network
Das dreidimensionale Array features[6000][50][25] verdient besondere Beachtung. Die erste Dimension entspricht historischen Datenpunkten, die zweite Zeitsequenzen der Länge 50 (zur möglichen Verwendung in rekurrenten oder Attention-Mechanismen) und die dritte 25 Merkmalen. Diese Organisation ermöglicht einen effizienten Zugriff auf Daten für Training und Prognose.
Zur Initialisierung der Gewichte des neuronalen Netzes wird die Xavier/Glorot-Initialisierung verwendet, um ein stabiles Training zu gewährleisten:
void InitializeNeuralNetwork()
{
    MathSrand(GetTickCount());

    for (int layer = 0; layer < NeuralLayers; layer++)
    {
        int input_size = (layer == 0) ? 25 : NeuralNodes;
        double scale = MathSqrt(2.0 / (input_size + NeuralNodes));

        for (int i = 0; i < input_size; i++)
        {
            for (int j = 0; j < NeuralNodes; j++)
            {
                g_pair.neural_net.encoder_layers[layer].weights[i][j] =
                    (MathRand() / 32767.0 - 0.5) * 2.0 * scale;
            }
        }
    }
}
Diese Speicherorganisation gewährleistet einen effizienten Systembetrieb auch bei begrenzten Ressourcen der Handelsplattform und ermöglicht gleichzeitig die Implementierung komplexer Algorithmen des maschinellen Lernens.
Lernalgorithmus des Zwei-Komponenten-Systems
Das Training eines Hybridsystems ist ein iterativer Prozess, bei dem die lineare und die neuronale Netzkomponente abwechselnd, jedoch koordiniert optimiert werden. Dieser Ansatz gewährleistet eine stabile Konvergenz und ermöglicht es jeder Komponente, sich auf ihren jeweiligen Teil des Prognoseproblems zu spezialisieren.
Der erste Schritt besteht darin, das lineare Modell mithilfe von Gradientenabstieg mit adaptiver Lernrate zu optimieren:
void OptimizeCoefficients()
{
    double best_coeffs[25];
    ArrayCopy(best_coeffs, g_pair.coeffs);
    double best_r2 = CalculateR2();

    g_pair.learning_rate = InitialLearningRate;

    for (int iter = 0; iter < MaxIterations; iter++)
    {
        double gradients[25];
        ArrayInitialize(gradients, 0.0);

        // Calculate gradients for all training examples
        for (int i = 0; i < g_pair.data_size; i++)
        {
            double actual = g_pair.prices[i];
            double predicted = 0.0;

            // Forward pass of the linear model
            for (int j = 0; j < 25; j++)
                predicted += g_pair.coeffs[j] * g_pair.features[i][0][j];

            double error = predicted - actual;

            // Accumulate gradients: ∂L/∂w_j = 2 * error * x_j
            for (int j = 0; j < 25; j++)
                gradients[j] += 2.0 * error * g_pair.features[i][0][j];
        }

        // Normalize gradients
        for (int j = 0; j < 25; j++)
            gradients[j] /= g_pair.data_size;
Ein entscheidendes Element ist Gradient Clipping, um explodierende Gradienten zu verhindern:
// Gradient clipping for stability
        double gradient_norm = 0.0;
        for (int j = 0; j < 25; j++)
            gradient_norm += gradients[j] * gradients[j];
        gradient_norm = MathSqrt(gradient_norm);

        if (gradient_norm > 1.0)
        {
            for (int j = 0; j < 25; j++)
                gradients[j] /= gradient_norm;
        }

        // Update coefficients
        for (int j = 0; j < 25; j++)
            g_pair.coeffs[j] -= g_pair.learning_rate * gradients[j];
Eine adaptive Lernrate passt sich automatisch an die Optimierungsdynamik an:
double new_r2 = CalculateR2();

        if (new_r2 > best_r2)
        {
            // Improvement found - increasing learning rate
            best_r2 = new_r2;
            ArrayCopy(best_coeffs, g_pair.coeffs);
            g_pair.learning_rate *= 1.01;
        }
        else
        {
            // Deterioration - roll back and reduce the rate
            ArrayCopy(g_pair.coeffs, best_coeffs);
            g_pair.learning_rate *= 0.8;

            if (g_pair.learning_rate < InitialLearningRate * 0.01)
                break;// Too low speed - stop
        }
    }
}
Die zweite Phase besteht darin, das neuronale Netzwerk auf den Residuen des optimierten linearen Modells zu trainieren:
void TrainUTransformer()
{
    // Calculate residuals after optimizing a linear model
    for (int i = 0; i < g_pair.data_size; i++)
    {
        double linear_pred = 0;
        for (int j = 0; j < 25; j++)
            linear_pred += g_pair.coeffs[j] * g_pair.features[i][0][j];

        g_pair.neural_net.residuals[i] = g_pair.prices[i] - linear_pred;
    }

    double best_loss = 1e6;
    int no_improve_count = 0;

    for (int epoch = 0; epoch < NeuralEpochs; epoch++)
    {
        double total_loss = 0;

        for (int i = 0; i < g_pair.data_size; i++)
        {
            // Forward pass neural networks
            double prediction = UTransformerForward(g_pair.coeffs,
                                                   g_pair.neural_net.residuals[i]);

            // Calculate MSE loss
            double error = prediction - g_pair.neural_net.residuals[i];
            total_loss += error * error;

            // Simplified backpropagation (gradient by last layer)
            double gradient = 2.0 * error / g_pair.data_size;

            for (int layer = NeuralLayers - 1; layer >= 0; layer--)
            {
                for (int j = 0; j < NeuralNodes; j++)
                {
                    for (int k = 0; k < NeuralNodes; k++)
                    {
                        g_pair.neural_net.encoder_layers[layer].weights[k][j] -=
                            g_pair.neural_net.learning_rate * gradient * 0.01;
                    }
                }
            }
        }

        total_loss /= g_pair.data_size;

        // Early stopping to prevent overfitting
        if (total_loss < best_loss)
        {
            best_loss = total_loss;
            no_improve_count = 0;
        }
        else
        {
            no_improve_count++;
            if (no_improve_count > 5) break;
        }
    }
}
Die Koordination des Lernprozesses der beiden Komponenten wird durch regelmäßige Reoptimierung erreicht:
if (g_pair.bars_since_optimization >= OptimizationInterval)
{
    PrepareOptimizationData();
    OptimizeCoefficients();        // Linear model first

    // Retrain the neural network every 5 optimization cycles
    if (g_pair.neural_net.training_steps % 5 == 0)
    {
        TrainUTransformer();       // Then the neural network on the new residues
    }

    g_pair.bars_since_optimization = 0;
}
Verfahren für den Forward Pass durch den U-Transformer
Der Forward Pass durch den U-Transformer ist die sequenzielle Verarbeitung von Eingabedaten in einer Encoder-Decoder-Architektur mit integrierten Attention-Mechanismen. Das Verfahren beginnt mit der Vorbereitung eines Eingabevektors, der über die Zeitsequenz gemittelte Merkmale enthält:
double UTransformerForward(double &coefficients[], double residual)
{
    double layer_input[32];
    double layer_output[32];
    double attention_output[32];

    // Input data preparation: averaging features over a sequence
    double avg_features[25];
    for (int i = 0; i < 25; i++)
    {
        avg_features[i] = 0;
        for (int j = 0; j < 50; j++)
        {
            avg_features[i] += g_pair.features[0][j][i];
        }
        avg_features[i] /= 50;
    }

    // Initialize the input layer
    for (int i = 0; i < 25; i++)
        layer_input[i] = avg_features[i];
Der Encoder-Teil der Architektur verarbeitet Informationen sequenziell durch mehrere Schichten, von denen jede auf die Extraktion von Merkmalen auf einer jeweils anderen Abstraktionsebene spezialisiert ist:
// Pass through encoder layers while preserving skip connections
    for (int layer = 0; layer < NeuralLayers; layer++)
    {
        int input_size = (layer == 0) ? 25 : NeuralNodes;

        // Forward pass via a fully connected layer
        ForwardLayer(layer_input, input_size,
                    g_pair.neural_net.encoder_layers[layer], layer_output);

        // Apply self-attention (for the first layers)
        if (layer < TransformerHeads)
        {
            SelfAttention(layer_output,
                         g_pair.neural_net.attention_heads[layer],
                         attention_output);

            // Residual connection: output = layer + attention
            for (int i = 0; i < NeuralNodes; i++)
                layer_output[i] = layer_output[i] + attention_output[i];
        }

        // Save skip connection for decoder
        for (int i = 0; i < NeuralNodes; i++)
            g_pair.neural_net.skip_connections[layer][i] = layer_output[i];

        // Prepare the input for the next layer
        for (int i = 0; i < NeuralNodes; i++)
            layer_input[i] = layer_output[i];
    }
Die vollständig verbundene Schicht implementiert die standardmäßige lineare Transformationsoperation mit nichtlinearer Aktivierung:
void ForwardLayer(double &inputs[], int input_size, NeuralLayer &layer, double &outputs[])
{
    for (int j = 0; j < layer.size; j++)
    {
        double sum = layer.biases[j];

        // Matrix multiplication: W * x + b
        for (int i = 0; i < input_size; i++)
            sum += inputs[i] * layer.weights[i][j];

        // GELU activation for better convergence
        outputs[j] = GELU(sum);
    }
}
GELU (Gaussian Error Linear Unit) wird als moderne Alternative zu ReLU verwendet:
double GELU(double x)
{
    return 0.5 * x * (1.0 + Tanh(MathSqrt(2.0 / M_PI) * (x + 0.044715 * x * x * x)));
}
Der Self-Attention-Mechanismus berechnet Attention-Gewichte für verschiedene Teile der Eingabesequenz:
void SelfAttention(double &inputs[], AttentionBlock &attention, double &outputs[])
{
    double queries[32], keys[32], values[32];

    // Calculate Query, Key, Value vectors
    for (int i = 0; i < NeuralNodes; i++)
    {
        queries[i] = 0; keys[i] = 0; values[i] = 0;
        for (int j = 0; j < NeuralNodes; j++)
        {
            queries[i] += inputs[j] * attention.query_weights[j][i];
            keys[i] += inputs[j] * attention.key_weights[j][i];
            values[i] += inputs[j] * attention.value_weights[j][i];
        }
    }

    // Softmax normalization of attention weights
    double max_score = attention.attention_scores[0];
    for (int i = 1; i < NeuralNodes; i++)
        if (attention.attention_scores[i] > max_score)
            max_score = attention.attention_scores[i];

    double sum_exp = 0;
    for (int i = 0; i < NeuralNodes; i++)
    {
        attention.attention_scores[i] = MathExp(attention.attention_scores[i] - max_score);
        sum_exp += attention.attention_scores[i];
    }

    for (int i = 0; i < NeuralNodes; i++)
        attention.attention_scores[i] /= sum_exp;

    // Apply attention weights to values
    for (int i = 0; i < NeuralNodes; i++)
    {
        outputs[i] = 0;
        for (int j = 0; j < NeuralNodes; j++)
            outputs[i] += attention.attention_scores[j] * values[j];
    }
}
Bei der abschließenden Aggregation wird Average Pooling verwendet, um einen skalaren Ausgabewert zu erzeugen:
// Decoder part (simplified - uses only the last encoder output)
    double final_sum = 0;
    for (int i = 0; i < NeuralNodes; i++)
        final_sum += layer_output[i];

    return final_sum / NeuralNodes; // Average pooling
}
Diese Architektur ermöglicht eine mehrstufige Informationsverarbeitung: Low-Level-Schichten extrahieren lokale Muster, Attention-Mechanismen modellieren langfristige Abhängigkeiten, und Skip-Verbindungen speichern detaillierte Informationen für die abschließende Prognose.
System zur Erzeugung von Handelssignalen
Bei der Generierung von Handelssignalen im Hybridsystem kommt eine zweistufige Architektur zum Einsatz, bei der je nach Qualität der einzelnen Komponenten automatisch zwischen den Signalquellen umgeschaltet wird. Diese Architektur gewährleistet die Robustheit des Systems gegenüber verschiedenen Marktregimen und verhindert Leistungseinbußen, wenn die Qualität eines der Modelle nachlässt.
Die primäre Signalquelle ist der U-Transformer, der aktiviert wird, sobald eine ausreichende Trainingsqualität erreicht ist:
void ProcessPair()
{
    // Obtain data for analysis from the analyst symbol
    double price_t1 = iClose(g_pair.analyst_symbol, PERIOD_H1, 1);
    double price_t2 = iClose(g_pair.analyst_symbol, PERIOD_H1, 2);
    double price_t3 = iClose(g_pair.analyst_symbol, PERIOD_H1, 3);

    // Current price of the trading symbol
    double current_ask = SymbolInfoDouble(g_pair.trade_symbol, SYMBOL_ASK);
    double current_bid = SymbolInfoDouble(g_pair.trade_symbol, SYMBOL_BID);
    double current_price = (current_ask + current_bid) / 2.0;

    int signal = 0;

    // MAIN SIGNAL: U-Transformer (at high quality)
    if (g_pair.neural_net.is_trained && g_pair.neural_net.loss < 0.01)
    {
        double features[25];
        CalculateFeatures(price_t1, price_t2, price_t3, 1, g_pair.analyst_symbol, features);
        double neural_prediction = UTransformerForward(g_pair.coeffs, 0);

        double neural_threshold = 0.0001;

        if (neural_prediction > neural_threshold) signal = 1;      // BUY signal
        else if (neural_prediction < -neural_threshold) signal = -1; // SELL signal
    }
}
Die Backup-Signalquelle wird aktiviert, wenn das neuronale Netzwerk noch nicht trainiert wurde oder unbefriedigende Ergebnisse zeigt:
// BACKUP SIGNAL: Linear Model
    if (signal == 0 && g_pair.current_r2 > 0.1)
    {
        double predicted_price = GetHybridPrediction(price_t1, price_t2, price_t3);
        double base_threshold = g_pair.current_r2 * 0.001;

        if (predicted_price > current_ask + base_threshold) signal = 1;
        if (predicted_price < current_bid - base_threshold) signal = -1;
    }
Ein kritisches Element ist der adaptive Reaktionsschwellenwert, der abhängig von der Qualität des Modells skaliert. Bei Signalen aus neuronalen Netzen wird ein fester Schwellenwert verwendet, da das Modell auf normalisierten Residuen trainiert wird. Bei linearen Signalen ist der Schwellenwert proportional zum Bestimmtheitsmaß R² des Modells – je höher die Anpassungsqualität, desto aggressivere Signale kann das System erzeugen.
Die Protokollierung der Signalquelle gewährleistet Transparenz bei Handelsentscheidungen:
if (OpenPosition(true, lot))
{
    Print(g_pair.trade_symbol, ": BUY opened by ",
          g_pair.neural_net.is_trained ? "U-TRANSFORMER" : "LINEAR",
          " R2=", DoubleToString(g_pair.current_r2, 3),
          " UT_Loss=", DoubleToString(g_pair.neural_net.loss, 6));
}
Durch die Trennung von Symbolen für Analyse und Handel ist es möglich, den Handel mit synthetischen Symbolen (zum Beispiel Renko-Bars) zu praktizieren. Beispielsweise kann eine Renko-Analyse des EURUSD-Paares Signale für den Handel mit EURUSD liefern, was die Leistungsfähigkeit des Systems erweitert und durch die Nutzung zusätzlicher Informationen potenziell die Qualität der Signale verbessert.
Positionsmanagement- und Risikomanagementstrategien
Das Positionsmanagementsystem setzt zwei sich ergänzende Strategien um: Averaging (Aufstocken unprofitabler Positionen) und Pyramiding (Ausbau profitabler Positionen). Diese Strategien passen sich automatisch an die Marktbedingungen an und sind in ein System zur Signalerzeugung integriert.
Die Struktur zur Positionsverfolgung umfasst alle notwendigen Parameter zur Umsetzung komplexer Strategien:
struct PairData
{
    // Track the status of positions
    double last_buy_price;      // Price of the last BUY position
    double last_sell_price;     // Price of the last SELL position
    int buy_levels;             // Number of BUY position levels
    int sell_levels;            // Number of levels of SELL positions
    bool last_was_averaging;    // Flag of the last averaging operation
};
Die Averaging-Strategie wird aktiviert, wenn sich der Kurs um einen festgelegten Abstand entgegen der offenen Position bewegt und das System weiterhin Signale in derselben Richtung generiert:
// AVERAGING BUY positions
if (g_pair.last_buy_price > 0)
{
    double distance_points = (g_pair.last_buy_price - current_price) /
                            SymbolInfoDouble(g_pair.trade_symbol, SYMBOL_POINT);

    if (EnableAveraging && distance_points >= DistancePoints && signal == 1 &&
        g_pair.buy_levels < MaxAveragingLevels)
    {
        double lot = NormalizeLot(g_pair.trade_symbol, LotSize * AveragingLotMultiplier);
        if (OpenPosition(true, lot))
        {
            g_pair.last_buy_price = current_price;
            g_pair.buy_levels++;
            g_pair.last_was_averaging = true;

            Print(g_pair.trade_symbol, ": BUY AVERAGING level ", g_pair.buy_levels,
                  " at distance ", DoubleToString(distance_points, 1), " points");
        }
    }
}
Das Pyramiding funktioniert genau umgekehrt – es stockt profitable Positionen auf:
// PYRAMIDING BUY positions
distance_points = (current_price - g_pair.last_buy_price) /
                  SymbolInfoDouble(g_pair.trade_symbol, SYMBOL_POINT);

if (EnablePyramiding && distance_points >= DistancePoints && signal == 1 &&
    g_pair.buy_levels < MaxPyramidingLevels && !g_pair.last_was_averaging)
{
    double lot = NormalizeLot(g_pair.trade_symbol, LotSize * PyramidingLotMultiplier);
    if (OpenPosition(true, lot))
    {
        g_pair.last_buy_price = current_price;
        g_pair.buy_levels++;

        Print(g_pair.trade_symbol, ": BUY PYRAMIDING level ", g_pair.buy_levels,
              " at distance ", DoubleToString(distance_points, 1), " points");
    }
}
Ein wesentliches Merkmal der Implementierung ist das Verbot der gleichzeitigen Anwendung von Averaging und Pyramiding (das Flag „last_was_averaging“), wodurch verhindert wird, dass die Strategie zu einer chaotischen Anhäufung von Positionen ausartet.
Beim Lotgrößenmanagement werden für verschiedene Arten von Operationen Multiplikatoren verwendet:
double NormalizeLot(string symbol, double lot)
{
    double min_lot = SymbolInfoDouble(symbol, SYMBOL_VOLUME_MIN);
    double max_lot = SymbolInfoDouble(symbol, SYMBOL_VOLUME_MAX);
    double lot_step = SymbolInfoDouble(symbol, SYMBOL_VOLUME_STEP);

    lot = MathRound(lot / lot_step) * lot_step;
    lot = MathMax(min_lot, MathMin(max_lot, lot));

    return lot;
}
Diese Architektur für das Positionsmanagement bietet Flexibilität im Positionsmanagement und gewährleistet gleichzeitig die Kontrolle über das maximale Risiko. Das System kann sich an verschiedene Marktbedingungen anpassen, indem es in Trendmärkten Averaging und bei Impulsbewegungen Pyramiding einsetzt, wobei klar definierte Regeln für die Gewinnmitnahme gelten.
Automatische Reoptimierung der Modellkoeffizienten
Die Anpassungsfähigkeit an sich ändernde Marktbedingungen ist eine entscheidende Voraussetzung für jedes Handelssystem. Finanzmärkte weisen ein nichtstationäres Verhalten auf, bei dem sich statistische Muster aufgrund makroökonomischer Ereignisse, Veränderungen in der Marktmikrostruktur oder Verschiebungen im Verhalten der Marktteilnehmer ändern können. Das System implementiert eine automatische Reoptimierung, die die Modellparameter regelmäßig auf der Grundlage eines gleitenden Fensters historischer Daten aktualisiert.
Der Auslöser für die Reoptimierung ist die Ansammlung einer festgelegten Anzahl neuer Bars:
void OnTick()
{
    if (!g_initialized) return;

    ProcessPair();

    // Check the need for reoptimization
    if (isNewBar())
    {
        if (g_pair.bars_since_optimization >= OptimizationInterval)
        {
            PrepareOptimizationData();      // Data preparation
            OptimizeCoefficients();         // Re-optimization of the linear model

            // Retrain the neural network every 5 cycles
            if (g_pair.neural_net.training_steps % 5 == 0)
            {
                TrainUTransformer();
            }

            g_pair.bars_since_optimization = 0;
        }
    }
}
Bei der Datenaufbereitung für die Optimierung wird ein gleitendes Fenster mit fester Größe verwendet, das ein Gleichgewicht zwischen Modellstabilität und Anpassungsfähigkeit an Veränderungen gewährleistet:
void PrepareOptimizationData()
{
    g_pair.data_size = 0;

    int available_bars = iBars(g_pair.analyst_symbol, PERIOD_H1);
    if (available_bars < 50)
    {
        Print("WARNING: Insufficient bars for ", g_pair.analyst_symbol);
        return;
    }

    int max_data_points = MathMin(OptimizationBars, 6000);

    for (int i = 50; i < MathMin(max_data_points + 50, available_bars - 1); i++)
    {
        if (g_pair.data_size >= 6000) break;

        double price_t0 = iClose(g_pair.analyst_symbol, PERIOD_H1, i - 1);
        if (price_t0 <= 0) continue;

        g_pair.prices[g_pair.data_size] = price_t0;

        // Collection of time sequences of features
        for (int j = 0; j < 50; j++)
        {
            double price_t1 = iClose(g_pair.analyst_symbol, PERIOD_H1, i - j);
            double price_t2 = iClose(g_pair.analyst_symbol, PERIOD_H1, i - j - 1);
            double price_t3 = iClose(g_pair.analyst_symbol, PERIOD_H1, i - j - 2);

            if (price_t1 <= 0 || price_t2 <= 0 || price_t3 <= 0) continue;

            double features[25];
            CalculateFeatures(price_t1, price_t2, price_t3, i - j,
                            g_pair.analyst_symbol, features);

            for (int k = 0; k < 25; k++)
            {
                g_pair.features[g_pair.data_size][j][k] = features[k];
            }
        }

        g_pair.data_size++;
    }

    Print(g_pair.analyst_symbol, ": Prepared ", g_pair.data_size, " data points");
}
Das Optimierungsverfahren umfasst einen Mechanismus zum Speichern der besten ermittelten Koeffizienten:
void OptimizeCoefficients()
{
    if (g_pair.data_size < 10)
    {
        Print(g_pair.analyst_symbol, ": Insufficient data (", g_pair.data_size, ")");
        return;
    }

    double best_coeffs[25];
    ArrayCopy(best_coeffs, g_pair.coeffs);
    double best_r2 = CalculateR2();

    // Improvement criterion for continuing optimization
    double initial_r2 = g_pair.current_r2;

    for (int iter = 0; iter < MaxIterations; iter++)
    {
        // ... gradient descent code ...

        double new_r2 = CalculateR2();

        if (new_r2 > best_r2)
        {
            best_r2 = new_r2;
            ArrayCopy(best_coeffs, g_pair.coeffs);
            g_pair.learning_rate *= 1.01; // Acceleration when improving
        }
        else
        {
            ArrayCopy(g_pair.coeffs, best_coeffs);
            g_pair.learning_rate *= 0.8;  // Slowdown when deteriorating

            if (g_pair.learning_rate < InitialLearningRate * 0.01)
                break;
        }

        // Stop criterion for minimum improvement
        if (iter > 10 && (best_r2 - initial_r2) < MinR2Improvement)
            break;
    }

    // Update the best coefficients
    ArrayCopy(g_pair.coeffs, best_coeffs);
    g_pair.current_r2 = best_r2;

    if (best_r2 > g_pair.best_r2)
    {
        g_pair.best_r2 = best_r2;
        ArrayCopy(g_pair.best_coeffs, best_coeffs);
    }

    Print(g_pair.analyst_symbol, ": R2=", DoubleToString(g_pair.current_r2, 4),
          " Best=", DoubleToString(g_pair.best_r2, 4));
}
Das System überwacht die Qualität des Modells anhand des Bestimmtheitsmaßes R², das den Anteil der erklärten Varianz angibt:
double CalculateR2()
{
    if (g_pair.data_size < 10) return 0.0;

    double sum_actual = 0.0;
    double sum_squared_total = 0.0;
    double sum_squared_residual = 0.0;

    // Calculate the average value
    for (int i = 0; i < g_pair.data_size; i++)
        sum_actual += g_pair.prices[i];
    double mean_actual = sum_actual / g_pair.data_size;

    // Calculate R² components
    for (int i = 0; i < g_pair.data_size; i++)
    {
        double actual = g_pair.prices[i];
        double predicted = 0.0;

        for (int j = 0; j < 25; j++)
            predicted += g_pair.coeffs[j] * g_pair.features[i][0][j];

        double residual = actual - predicted;
        double total_variance = actual - mean_actual;

        sum_squared_residual += residual * residual;
        sum_squared_total += total_variance * total_variance;
    }

    if (sum_squared_total <= 0.0) return 0.0;

    return 1.0 - (sum_squared_residual / sum_squared_total);
}
Online-Training eines neuronalen Netzes auf Residuen
Das Online-Training einer neuronalen Netzwerkkomponente ist im Vergleich zur linearen Optimierung eine komplexere Aufgabe. Das neuronale Netz wird nicht bei jedem Optimierungszyklus neu trainiert, sondern periodisch – alle 5 Zyklen –, wodurch Overfitting verhindert und die Rechenlast verringert wird.
void TrainUTransformer()
{
    if (g_pair.data_size < 10)
    {
        Print("Insufficient data for U-Transformer training: ", g_pair.data_size);
        return;
    }

    // Calculate residuals from the optimized linear model
    for (int i = 0; i < g_pair.data_size; i++)
    {
        double linear_pred = 0;
        for (int j = 0; j < 25; j++)
            linear_pred += g_pair.coeffs[j] * g_pair.features[i][0][j];

        g_pair.neural_net.residuals[i] = g_pair.prices[i] - linear_pred;
    }

    Print("Training U-Transformer on ", g_pair.data_size, " residuals...");

    double best_loss = 1e6;
    int no_improve_count = 0;
Das Trainingsverfahren nutzt eine vereinfachte Version der Backpropagation, die an die Einschränkungen von MQL5 angepasst ist:
for (int epoch = 0; epoch < NeuralEpochs; epoch++)
    {
        double total_loss = 0;

        for (int i = 0; i < g_pair.data_size; i++)
        {
            // Forward pass
            double prediction = UTransformerForward(g_pair.coeffs,
                                                   g_pair.neural_net.residuals[i]);
            g_pair.neural_net.neural_predictions[i] = prediction;

            // Calculate MSE loss
            double error = prediction - g_pair.neural_net.residuals[i];
            total_loss += error * error;

            // Simplified backpropagation
            double gradient = 2.0 * error / g_pair.data_size;

            // Update weights (simplified scheme)
            for (int layer = NeuralLayers - 1; layer >= 0; layer--)
            {
                for (int j = 0; j < NeuralNodes; j++)
                {
                    for (int k = 0; k < NeuralNodes; k++)
                    {
                        g_pair.neural_net.encoder_layers[layer].weights[k][j] -=
                            g_pair.neural_net.learning_rate * gradient * 0.01;
                    }
                }
            }
        }

        total_loss /= g_pair.data_size;

        // Early stopping mechanism
        if (total_loss < best_loss)
        {
            best_loss = total_loss;
            no_improve_count = 0;
        }
        else
        {
            no_improve_count++;
            if (no_improve_count > 5) break; // Stop if there are no improvements
        }

        if (epoch % 5 == 0)
            Print("U-Transformer epoch ", epoch, " loss: ", DoubleToString(total_loss, 6));
    }
Zum Abschluss des Trainings werden die Metriken und der Zustand des neuronalen Netzes aktualisiert:
g_pair.neural_net.loss = best_loss;
    g_pair.neural_net.is_trained = true;
    g_pair.neural_net.training_steps++;

    Print("U-Transformer training completed. Loss: ", DoubleToString(best_loss, 6));
}
Das Qualitätskriterium für das neuronale Netz (Loss < 0,01) legt fest, wann sich das System auf die Signale des neuronalen Netzes verlassen kann:
// In the signal generation function
if (g_pair.neural_net.is_trained && g_pair.neural_net.loss < 0.01)
{
    // Use U-Transformer to generate signals
    double neural_prediction = UTransformerForward(g_pair.coeffs, 0);
    // ...
}
Diese Online-Lernarchitektur ermöglicht es der neuronalen Netzwerkkomponente, sich an veränderte Marktbedingungen anzupassen und dabei die Recheneffizienz aufrechtzuerhalten sowie Overfitting zu verhindern.
Der EA aus dem Artikel über Regressionsmodelle diente als Grundlage und wurde um das Hybridmodell ergänzt.
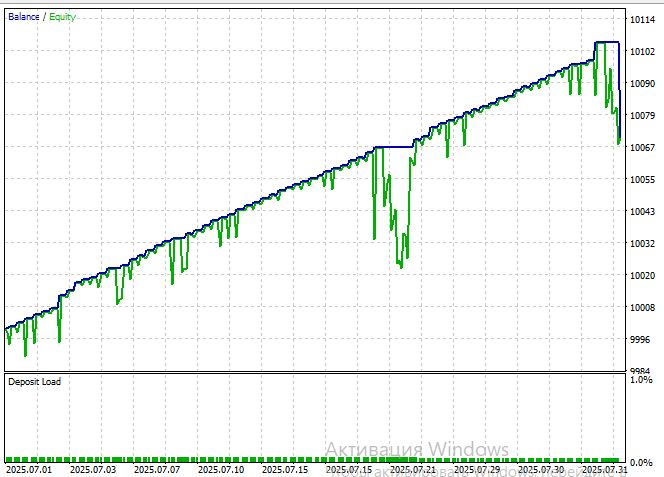
Betrachten wir die Performance des Modells für EURUSD M15 im Zeitraum ab dem 1. Juli 2025:
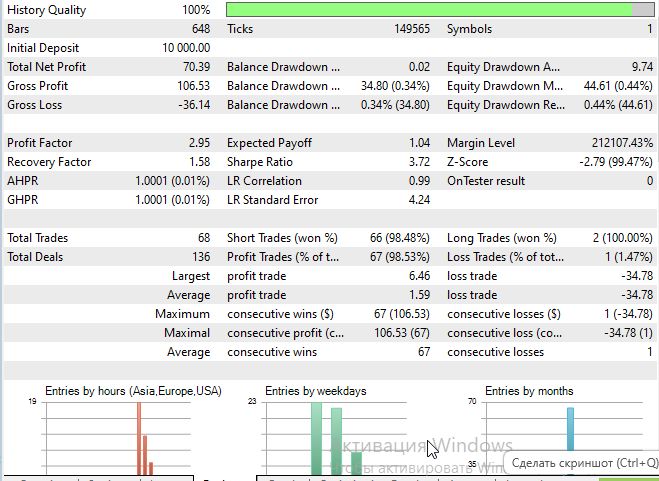
Die Sharpe-Ratio fiel recht gut aus:
Fazit
Das vorgestellte Hybridsystem belegt die praktische Machbarkeit, moderne Deep-Learning-Architekturen mit klassischen ökonometrischen Methoden innerhalb der Beschränkungen der MQL5-Handelsplattform zu integrieren. Durch eine zweistufige Zerlegung des Prognoseproblems in lineare und nichtlineare Komponenten lassen sich die Stärken beider Ansätze nutzen und gleichzeitig ihre Schwächen minimieren.
Zu den wichtigsten Ergebnissen dieser Arbeit zählen die erfolgreiche Anpassung der U-Net-Architektur an die Analyse finanzieller Zeitreihen, die Integration von Attention-Mechanismen zur Modellierung langfristiger Abhängigkeiten sowie die Implementierung eines automatischen Umschaltsystems zwischen Signalquellen. Dank einer adaptiven Gewichtung der Komponenten und einer periodischen Reoptimierung der Parameter zeigt das System einen stabilen Betrieb unter verschiedenen Marktbedingungen.
Der praktische Wert der Lösung liegt in ihrer Einsatzbereitschaft für den realen Handel. Das System umfasst eine vollständige Handelslogik mit Positionsmanagement, Risikomanagement und detaillierter Transaktionsprotokollierung. Die Trennung von Symbolen für Analyse und Handel erweitert die Möglichkeiten zur Nutzung von Intermarket-Korrelationen.
Allerdings sollten die Einschränkungen der derzeitigen Umsetzung ehrlich eingeräumt werden. Eine vereinfachte Backpropagation, das Fehlen moderner Regularisierungstechniken und eine feste Netzwerkarchitektur schränken das Potenzial der neuronalen Netzwerkkomponente ein. Die Verwendung statischer Arrays anstelle dynamischer Datenstrukturen schränkt die Skalierbarkeit des Systems erheblich ein.
Dennoch eröffnet der vorgeschlagene Ansatz eine vielversprechende Richtung für die Entwicklung von Handelssystemen. Das Konzept, ein neuronales Netzwerk anhand der Residuen eines linearen Modells zu trainieren, lässt sich auf eine breitere Klasse von Prognoseproblemen anwenden und ist nicht auf Finanzmärkte beschränkt. Die modulare Architektur des Systems ermöglicht es, problemlos mit verschiedenen Arten von neuronalen Netzen und Strategien für das Positionsmanagement zu experimentieren.
Von besonderem Wert ist der Nachweis, dass fortschrittliche Techniken des maschinellen Lernens sogar in eingeschränkten Entwicklungsumgebungen wie MQL5 implementiert werden können. Dies eröffnet Möglichkeiten für eine Vielzahl von Händlern und Entwicklern, die keinen Zugang zu modernen Deep-Learning-Frameworks haben.
Literaturverzeichnis
- Attention Is All You Need (Vaswani et al., 2017)
- U-Net: Convolutional Networks for Biomedical Image Segmentation (Ronneberger et al., 2015)
Übersetzt aus dem Russischen von MetaQuotes Ltd.
Originalartikel: https://www.mql5.com/ru/articles/18916
Warnung: Alle Rechte sind von MetaQuotes Ltd. vorbehalten. Kopieren oder Vervielfältigen untersagt.
Dieser Artikel wurde von einem Nutzer der Website verfasst und gibt dessen persönliche Meinung wieder. MetaQuotes Ltd übernimmt keine Verantwortung für die Richtigkeit der dargestellten Informationen oder für Folgen, die sich aus der Anwendung der beschriebenen Lösungen, Strategien oder Empfehlungen ergeben.

 Neuronale Netze im Handel: Probabilistische Zeitreihenprognose (Encoder)
 Neuronale Netze im Trading: Probabilistische Zeitreihenprognose (K²VAE)
 Analyse der stündlichen Kursentwicklung von Symbolen und ihrer Spreads in MetaTrader 5
 Neuronale Netze im Trading: Adaptive periodische Segmentierung (Fazit)

- Freie Handelsapplikationen
- Über 8.000 Signale zum Kopieren
- Wirtschaftsnachrichten für die Lage an den Finanzmärkte
Sie stimmen der Website-Richtlinie und den Nutzungsbedingungen zu.