取引におけるニューラルネットワーク:適応的周期セグメンテーション(トークンの生成)
 21
 0

はじめに
前回の記事では、LightGTS (Lightweight General Time Series Forecasting)フレームワーク理論的基礎を詳しく検討しました。LightGTSは、現在の時系列予測における先進的で緻密に設計された手法の一つであり、論文「LightGTS: A Lightweight General Time Series Forecasting Model」で発表されています。その基本理念は、金融・経済データに特有の周期性を深く理解することと、時系列構造の処理に特化してTransformerアーキテクチャを再構成することにあります。 前回は主に、LightGTSが周期的なパターンをどのように処理し、学習コストを最小限に抑えながら、異質でノイズの多いデータに対しても高い汎化性能を確保するのかに焦点を当てました。
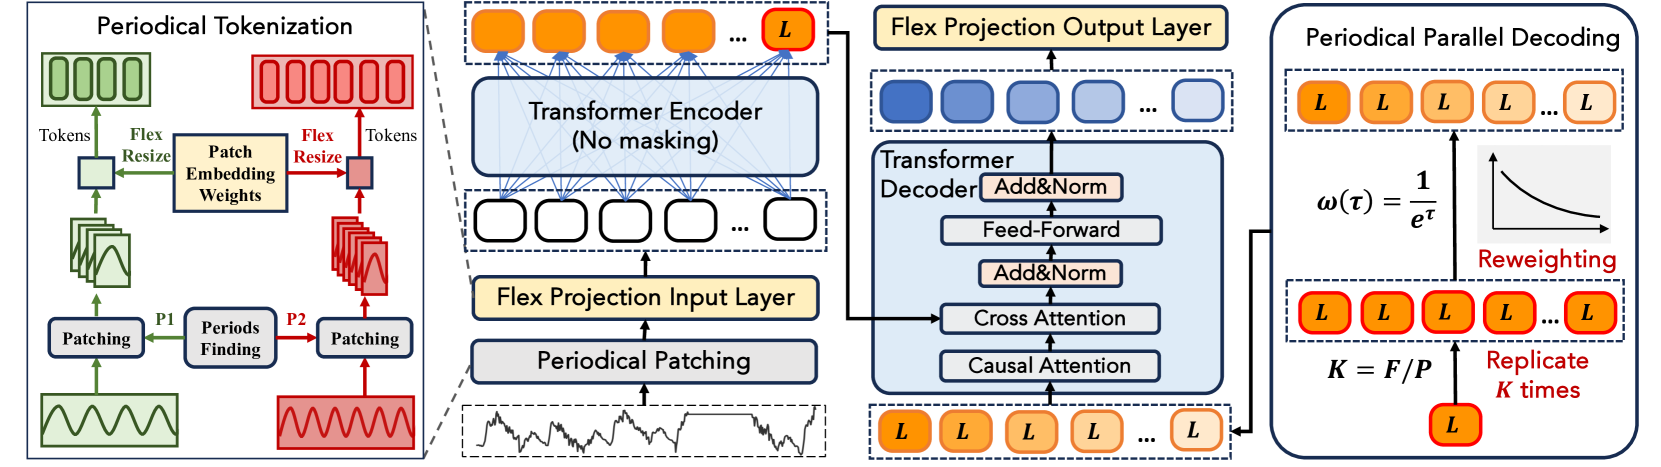
このフレームワークは、周期パッチ化と呼ばれる仕組みから始まります。これは、分析対象の信号が持つ固有の周波数に対応するセグメントへ、時系列を分割する仕組みです。 この周波数は手動で設定するのではなく、高速フーリエ変換(FFT)によって得られた周波数スペクトルを分析し、モデルが自動的に決定します。 抽出された各パッチは、顕著な局所パターンを含む1周期分のデータを表します。 この部分データが、射影によってトークンへと変換されます。 ここで登場する最初のアーキテクチャ上の革新がFlex Projection Layer(柔軟投影層)です。この層は、重みを柔軟に線形変換することで、長さの異なるパッチを処理できるようにします。 この射影は、単にデータのスケールを変換するだけではありません。異なるスケールや周波数の間で変換をおこなう際にも、トークンの等価性を維持します。
Encoderブロックでは、ロータリー位置エンコーディング(Rotary Positional Encoding, RoPE)を使用します。 これは、トークン間の相対位置をコンパクトかつ安定的に表現する手法です。金融時系列では、系列内の要素同士の相対的な位置関係が、絶対的な位置よりも重要になることが多いため、特に有効です。 その後、トークンは、複数のTransformerブロックからなる標準的な構造によって処理されます。各ブロックは、Multi-Head Self-AttentionモジュールとFeed-Forwardモジュールで構成されます。
LightGTSの著者らが提案した独創的な仕組みの一つが、周期的並列デコーディング(Periodical Parallel Decoding)メカニズムです。これは、自己回帰型の予測戦略とは概念的に正反対のアプローチです。 系列を1ステップずつ予測する代わりに、モデルは隠れ表現の最後のトークンを利用します。このトークンには、それまでの系列に関する情報が集約されています。モデルはそのトークンを複製し、位置に応じた重み付けを適用することで、出力系列全体を一度に生成します。 この手法は、予測を高速化するだけでなく、モデルの出力における時系列構造の周期的一貫性も維持します。
最後に、フレームワークはデコーダの射影層にFlex-resizeを適用し、予測結果の長さを予測対象の信号の実際の長さに合わせます。 モデルの学習は、予測値と正解系列との間で標準的なMSE(平均二乗誤差)損失関数を最小化することに帰着します。
このように、LightGTSは単なるTransformerの改良版ではありません。 周期性の処理から、自己回帰方式に代わる完全並列生成の採用まで、各構成要素が時系列データの特性に合わせて設計されたアーキテクチャです。 こうした徹底した適応によって、低い計算コストで高い予測精度を実現しています。
著者らによるLightGTSフレームワークの構成図を以下に示します。
前回の記事の実践編では、LightGTSアーキテクチャの主要な構成要素の一つである適応的周期パッチ化のアルゴリズム開発に着手しました。 MQL5やOpenCLの一般的な実行環境では動的なメモリ割り当てを利用できないという制約について、詳しく検討しました。 この制約により、出力トークン数を任意に変化させるという方針を断念せざるを得ませんでした。
そこで私たちは、戦略的に妥当な判断を下しました。パッチ数を固定し、各セグメントの長さの変動を補う手段として、パッチ間のオーバーラップを利用することにしたのです。 これにより、時系列の実際の周期性に対するモデルの適応性を維持しながら、ハードウェアリソースの効率的な利用に不可欠な計算の安定性も確保できます。 このアプローチによって、分析対象データの周期構造を忠実に表現すると同時に、メモリ管理の予測可能性も維持できます。これは、高頻度取引向けのモデルや、実行環境に制約がある状況での実装において、極めて重要です。
支配的な周波数を選択するアルゴリズムは、すでに実装済みです。このアルゴリズムは、入力時系列に含まれる各単変量系列について、主要な周期性を効果的に抽出します。 これにより、後続のデータ分割に用いる基準スケールを設定できるようになります。 今回は、これまでの作業を引き継ぎ、次のステップとして、OpenCLの実行環境内でトークン生成アルゴリズムを実装します。
目標は、各時系列を一定数のセグメントに分割することです。セグメントのサイズは特定された支配的周波数に基づいて決定し、オーバーラップによってウィンドウ長への適応を調整します。 これらの処理はすべて、GPUで実行可能なコードを用いて、厳密に並列化する必要があります。各スレッド(ワークアイテム)は、分析対象の系列を構成する単変量成分のいずれかについて、1つのトークンを生成します。
OpenCLカーネルの構築
FFTを用いて支配的周波数を特定したところで、いよいよ重要な段階に入ります。特定された周期性に対応する時系列の断片、すなわちトークンを生成する仕組みの構築です。 前のセクションでは、現在の市場の周波数に対するモデルの適応性と、出力パッチ数を固定するという要件を両立させるという重要な課題を取り上げました。これは、動的メモリ割り当てを利用できないMQL5環境でモデルを実行するうえで、特に重要な要件です。
私たちのアプローチは、次の原則に基づいています。トークン(patches)の数は一定に保ち、その長さを現在の周波数に応じて調整するとともに、分析対象の時系列全体を漏れなくカバーできるよう、パッチ間のオーバーラップを制御します。 これにより、柔軟性とリソース管理のバランスを効果的に保つことができます。 ただし、ここには技術的な課題があります。畳み込みウィンドウのサイズが変わるのであれば、理論上、重み行列もそれに合わせて調整する必要があります。そのためには、ウィンドウサイズが変わるたびに重み行列を再構築するか、新しい空間に射影しなければなりません。
原論文で、LightGTSフレームワークフレームワークの著者らは一つの解決策を提案しています。学習サンプルの統計に基づいて固定したウィンドウサイズで重み行列を学習し、新しいウィンドウサイズに対応する際には、ムーア・ペンローズ擬似逆行列を用いて重みを射影するという方法です。 数学的には洗練されていますが、実際の運用では扱いにくい手法です。
実際の金融市場は容赦ありません。今日の周期が明日も同じとは限らないのです。 周期性は変動するため、それに適応するには柔軟性が求められます。 特にオンライン処理や高頻度取引において、擬似逆行列をその都度計算することは、形式的な数学的厳密性を優先する代わりに、処理速度とリソース効率を犠牲にすることを意味します。 そのようなコストは、到底許容できません。
そこで、私たちはより実用的な解決策を採用しました。 重み行列を繰り返し再構築する代わりに、許容される最大サイズの行列を使用し、ゼロパディングによって不要な重みの影響を無効化します。 つまり、データセグメントが現在のウィンドウの有効範囲外にある場合、その値をゼロにすることで、対応する重みが計算結果に影響しないようにします。 シンプルで効果的な方法です。
このアプローチには、次のような利点があります。
- 重み行列の構造を固定することで、計算コストの高い演算を回避できる。
- ウィンドウサイズとパッチ間のストライドを動的に調整できる。
- モデルを停止したり、パラメータを再計算したりすることなく、市場の周波数変動にリアルタイムで適応できる。
これらはすべて、OpenCL環境のFeedForwardAdaptConvカーネル内に実装されています。各ワークアイテムは、いずれかの単変量系列における、特定のセグメントとフィルタの組み合わせを担当します。
__kernel void FeedForwardAdaptConv(__global const float *matrix_w,
                                   __global const float *matrix_i,
                                   __global float *matrix_o,
                                   __global const float *main_freq,
                                   const int inputs,
                                   const int window_in,
                                   const int activation
                                  )
  {
   const size_t u = get_global_id(0);
   const size_t f = get_global_id(1);
   const size_t v = get_global_id(2);
   const size_t units = get_global_size(0);
   const size_t filters = get_global_size(1);
   const size_t variables = get_global_size(2);
カーネル本体では、まず3次元のタスク空間におけるワークアイテムのインデックスを取得します。 次に、単変量系列の識別子vを用いて、解析対象の変数の支配的周波数をグローバルバッファmain_freqから取得します。
const int freq = main_freq[v];
int window = (inputs / variables + freq - 1) / freq;
これに基づいて、ストライドと分割境界を考慮しながら、ウィンドウサイズを計算します。 また、入力テンソルのサイズと生成するトークン数に応じて、解析ウィンドウのストライドも決定します。 ここでの目的は、系列全体を均等にカバーし、データの取りこぼしが生じないようにすることです。
const int step = (int)(inputs / variables + units + 1) / (units + 2);
if(window < step)
   window = (int)((step + window - 1) / window) * window;
if(window > window_in)
   window = window_in;
次に、重要なポイントがあります。 データの取りこぼしを防ぐため、ウィンドウサイズはストライド以上でなければなりません。 そのため、検出された周期が短すぎる場合は、ウィンドウサイズをその整数倍に拡大し、許容される最大値を超えない範囲で、少なくともストライドと同じ大きさにします。
続いて、入力配列、出力配列、および重み行列のオフセットを決定します。 これは、グローバルバッファ内のデータを正しく参照するために必要です。
const int shift_in = (u < (units - 1) ? u * step : inputs / variables - window);
const int shift_in_var =  v * inputs / variables;
const int shift_out = (u + v * units) * filters + f;
const int shift_weight = (v * filters + f) * (window_in + 1);
ここで重要なのは、入力系列の末尾まで含め、系列全体を漏れなくカバーすることです。 固定のストライドでセグメント化し、各ウィンドウの長さを動的に決定すると、末尾の数要素が解析対象から漏れてしまう可能性があります。 そこで、入力系列全体を確実にカバーするため、最後のセグメントの開始位置を、解析対象系列の全長からウィンドウサイズを引いた値として算出します。 これにより、ウィンドウサイズが動的に決定され、許容される最大サイズより小さくなった場合でも、最後のウィンドウを適切な位置にずらし、系列末尾のデータ点まで確実に取り込むことができます。
続いて、主要な計算処理である畳み込み演算をおこない、各トークンの最終値を算出します。 まず、バイアス成分に対応する初期値を取得します。 この値は、事前に計算されたオフセットを用いて重み行列から取り出され、解析ウィンドウ内の各要素の寄与を累積する際の初期値となります。
float sum = matrix_w[shift_weight + window_in];
for(int i = 0; i < window; i++)
   if((shift_in + i) < (inputs / variables))
      sum += IsNaNOrInf(matrix_i[shift_in_var + shift_in + i], 0) *
             matrix_w[shift_weight + i];
次に、解析ウィンドウ内の各要素を順に処理します。 ここで、本実装の重要な特徴であるゼロパディング戦略が活用されます。 系列の要素が実際の計算対象となるウィンドウの範囲外にある場合、その要素は計算から除外されます。 これにより、無関係なデータの混入によって生じる信号の歪みを防ぎます。 この手法により、ウィンドウサイズが変化しても一貫性を保ち、正確な計算を実現できます。 さらに、ゼロパディングによって重み行列の次元を一定に保ちやすくなります。これは、使用しない位置を、最終的な合計値に影響しないゼロで埋められるためです。
最後に、選択した活性化関数を適用し、その結果を出力バッファに格納します。
 matrix_o[shift_out] = Activation(sum, activation);
}
その結果、現在の市場の周波数に適応し、明確な局所コンテキストを備えた、Transformerブロックへの入力に適した埋め込みが得られます。 これらすべてを、高コストな演算を避け、リソース消費を最小限に抑えながら、MQL5環境の制約に完全に適合する形で実現しています。
得られたトークンをTransformerブロックの渦に送り込む前に、モデルが学習の初期段階で行き詰まることなく、実際に学習できることを確認する必要があります。 そのためには、完全な逆伝播(誤差逆伝播)が欠かせません。逆伝播は勾配を計算し、適応畳み込みフィルターを調整するための重要な段階です。 これがなければ、順伝播で行った処理はすべて停滞してしまいます。フィルターはランダムな状態に固定されたままとなり、モデルは新たな市場ショックに適応できず、自らの誤りに囚われたままになってしまいます。
逆伝播の実行は、オーケストラにフィードバックを返すようなものです。ある楽器の演奏がずれていれば、何を修正すべきかを正確に示す指示とともに、その情報を送り返す必要があります。 可変ウィンドウを用いる適応畳み込みでは、これは容易ではありません。各入力値が複数のトークンに同時に寄与する可能性があり、それぞれのトークンに対応する誤差を、元の入力へと適切に逆伝播させる必要があるためです。
この処理を実現するために、私たちはOpenCLカーネルCalcHiddenGradientAdaptConvを開発しました。 このカーネルは2次元空間で動作します。inp軸は元の単変量系列内の位置を表し、v軸は各チャネル(単変量系列)を表します。 この構成により、解析対象データの各要素に対して、対応する正確な勾配を計算できます。
__kernel void CalcHiddenGradientAdaptConv(__global const float *matrix_w,
                                          __global const float *matrix_i,
                                          __global float *matrix_ig,
                                          __global const float *matrix_og,
                                          __global const float *main_freq,
                                          const int outputs,
                                          const int window_in,
                                          const int window_out,
                                          const int activation
                                         )
  {
   const size_t inp = get_global_id(0);
   const size_t v = get_global_id(1);
   const size_t inputs = get_global_size(0);
   const size_t variables = get_global_size(1);
カーネル内では、まずレーダーを起動し、タスク空間のすべての次元における現在のワークアイテムを特定します。 次に、順伝播用カーネルと同様に、各単変量系列のセグメントサイズとストライドを個別に決定します。
const int units = outputs / (window_out * variables);
const int freq = main_freq[v];
int window = (inputs / variables + freq - 1) / freq;
const int step = (int)(inputs + units + 1) / (units + 2);
if(window < step)
   window = (int)((step + window - 1) / window) * window;
if(window > window_in)
   window = window_in;
続いて、データバッファ内の必要な要素を参照するためのオフセットを求めます。
const int shift_in = v * inputs + inp;
int u = inp / step;
int shift_out_var = v * (outputs / variables);
int shift_weight_var = (v * window_out) * (window_in + 1);
次に、誤差勾配を分配する主要な処理に移ります。 まず、元のデータバッファ内の現在の要素を使って生成されたトークンを特定し、その要素の寄与を考慮しながら、生成されたトークン内の各要素から誤差勾配を累積します。
ただし、セグメントをオーバーラップさせることで、元データの1つの要素が異なる位置にある複数のトークンの生成に使われる場合があります。 そのため、誤差勾配を集約する処理をループで囲みます。
float sum = 0;
while(u * step <= inp && u < (units - 1))
  {
   int pos = inp - u * step;
   if(pos >= window)
     {
      u++;
      continue;
     }
   int shift_out = u * window_out;
   int shift_weight = pos + shift_weight_var;
   for(int out = 0; out < window_out; out++)
     {
      if((shift_out + out) >= (outputs / variables))
         continue;
      sum += IsNaNOrInf(matrix_og[shift_out_var + shift_out + out] *
                        matrix_w[shift_weight + out * (window_in + 1)], 0);
     }
   u++;
  }
最後のセグメントがどのように形成されるかも考慮する必要があります。 誤差勾配の分配アルゴリズムでは、このセグメントを独立したブロックで処理します。
if(inp >= (inputs - window))
  {
   int pos = inp + window - inputs;
   int shift_out = (units - 1) * window_out;
   int shift_weight = pos + shift_weight_var;
   for(int out = 0; out < window_out; out++)
     {
      if((shift_out + out) >= (outputs / variables))
         continue;
      sum += IsNaNOrInf(matrix_og[shift_out_var + shift_out + out] *
                        matrix_w[shift_weight + out * (window_in + 1)], 0);
     }
  }
最後に、累積した誤差勾配の合計に活性化関数の導関数を適用し、その結果をグローバルデータバッファの対応する要素に格納します。
 matrix_ig[shift_in] = Deactivation(sum, matrix_i[shift_in], activation);
}
トークンを順に走査するこの手法により、入力データの各要素は、たとえ複数のトークンに同時に声を届けていたとしても、その寄与に応じた誤差勾配を正しく受け取ります。 これにより、適応フィルターは孤立した断片だけでなく、市場データのまとまり全体から学習できるようになります。
しかし、誤差勾配の分配は、まだ道半ばにすぎません。 本当の意味での学習は、次にこれらの勾配を使ってモデルのパラメータを更新するときに始まります。 収穫を終えた庭師が、次の季節にさらに多くの実がなるよう、どの木を剪定し、どの木に肥料を与えるかを判断する場面を想像してください。 同じように、最適化アルゴリズムは計算された勾配を利用して重みを調整し、予測誤差全体を最小化します。
本モデルでは、パラメータの更新処理をOpenCLカーネルUpdateWeightsAdaptConvAdam内に実装しています。 これは単なる技術的な処理ではありません。誤差逆伝播の全工程の集大成であり、モデルが自らの誤りから学び、改善へと一歩踏み出す瞬間です。
__kernel void UpdateWeightsAdaptConvAdam(__global float *matrix_w,
                                         __global const float *matrix_og,
                                         __global const float *matrix_i,
                                         __global float *matrix_m,
                                         __global float *matrix_v,
                                         __global float *main_freq,
                                         const int inputs,
                                         const int outputs,
                                         const float l,
                                         const float b1,
                                         const float b2
                                        )
  {
   const size_t id_in = get_global_id(0);    // input shift
   const size_t id_out = get_global_id(1);   // filter shift
   const size_t id_v = get_global_id(2);     // variable
   const size_t window_in = get_global_size(0) - 1;
   const size_t window_out = get_global_size(1);
   const size_t variables = get_global_size(2);
このカーネルは、3つの座標軸を持つ多層的なステージのような構造になっており、それぞれの軸が計算処理において明確な役割を担います。 第1軸は入力データの解析ウィンドウ(セグメント)内の位置(id_in)、第2軸はフィルター番号、つまりトークンの出力における特定の位置(id_out)、第3軸は単変量系列のインデックス(id_vであり、入力データの独立したチャネルを表します。
この3次元の計算分割は、単にアーキテクチャ上の都合で採用したものではなく、戦略的な設計上の選択です。 これにより、処理を完全に分解できます。重み行列の各学習可能パラメータは、対応する入力系列のセグメント内でのみ適用され、特定のフィルターおよびチャネルに結び付けられます。 各フィルタを、それぞれ自分のチャートだけを担当し、他の担当者の書類には手を出さない独立したアナリストだと考えてみてください。 この設計により、時系列間で信号が混ざるのを防ぎます。ノイズや不安定性が日常的に発生する金融データを扱ううえで、これは特に重要です。
この手法によって、独立したレンズを備えた顕微鏡のような仕組みが実現します。それぞれのフィルターは固有のデータセグメントに焦点を合わせ、信号のわずかな変動まで高精度に捉えられるよう調整されます。 あるチャネルが激しく素早い変動を示し、別のチャネルが安定しているものの緩やかなトレンドを示していても、アルゴリズムは細部を見失うことなく、それぞれに適切に対応できます。 つまり、各重みは、あたかも大きなシステムの中に独立したモデルが存在するかのように、固有の局所的なタスクに合わせて学習されます。
カーネル本体では、まず3次元のタスク空間におけるワークアイテムを特定し、学習可能なパラメータ行列から単一の要素を選び出して、後続の処理に備えます。
続いて、支配的周波数main_freq[id_v]に基づき、対象の重みを適用する現在のセグメントサイズwindowを計算します。
const int units = outputs / (window_out * variables);
const int freq = main_freq[id_v];
int window = (inputs / variables + freq - 1) / freq;
const int step = (int)(inputs / variables + units + 1) / (units + 2);
if(window < step)
   window = (int)((step + window - 1) / window) * window;
if(window > window_in)
   window = window_in;
この方法には、次のような利点があります。
- パラメータの独立性:各重みは、自身に対応付けられた入力データに対してのみ作用する。
- 完全な並列性:各ワークアイテムは重み行列内の異なる要素を処理するため、互いに干渉しない。
- 精度:フィルタはデータの周波数に同期し、関連するセグメントだけを処理する。
すべての計算が、データの最大解析ウィンドウに対応する汎用的な枠組みの中で行われることも忘れてはなりません。 しかし、実際には個々のセグメントが最大サイズより小さくなることがよくあります。 貴重なGPUの処理時間と電力を無駄にしないため、各ワークアイテムの冒頭で、そのパラメータが現在のセグメントに属するかどうかを確認し、不要なワークアイテムを直ちに終了させます。
if(id_in != window_in &&
   id_in >= window)
   return;
その結果、全体的なパフォーマンスが大幅に向上し、モデルの実行速度も目に見えて速くなります。これは、無駄な迂回を即座に切り捨て、ゴールまでの最短ルートを進む、目標志向のレーサーのようなものです。
次に、グローバルデータバッファ内のオフセットを決定します。これがなければ、ワークアイテムは必要な要素を見つけることができません。
const int shift_in_var = id_v * inputs / variables;
const int shift_out_var = id_v * outputs / variables;
const int shift_weight = (id_v * window_out + id_out) *
                         (window_in + 1) + id_in;
const bool bias = (id_in == window_in);
このシンプルながら極めて重要な手法により、各フィルターのパラメータは、各時点で自身が担当するデータ領域だけを処理します。その結果、モデル全体の効率と予測可能性が向上します。
続いて、最も重要な処理の1つである、選択したパラメータの誤差勾配の計算に移ります。勾配は抽象的な数値ではありません。モデルの予測精度を高めるために、重みをどの方向へ、どの程度調整すべきかを示す、まさに道しるべです。
対象パラメータの実際の寄与を求めるため、単変量系列全体を走査し、出力トークンに現れるすべての応答を累積します。
float grad = 0;
for(int u = 0; u < (units - 1); u++)
  {
   const int shift_in_loc = id_in + u * step;
   if(shift_in_loc >= (inputs / variables))
      continue;
   float inp = (bias ? 1 : IsNaNOrInf(matrix_i[shift_in_var + shift_in_loc], 0));
   grad += IsNaNOrInf(inp * matrix_og[shift_out_var + u * window_out + id_out], 0);
  }
最後のセグメントの形成方法も忘れてはなりません。 この部分は独立したブロックで処理します。
{
 const int shift_in_loc = id_in + inputs / variables - window;
 if(shift_in_loc < (inputs / variables))
   {
    float inp = (bias ? 1 : IsNaNOrInf(matrix_i[shift_in_var + shift_in_loc], 0));
    grad += IsNaNOrInf(inp * matrix_og[shift_out_var + (units - 1) * window_out + id_out], 0);
   }
}
この勾配集約手法は、徹底的かつ網羅的です。 入力データに現れる応答を1つも取りこぼさず、重みの調整に用いる、できる限り正確な方向ベクトルを得られます。 このように丁寧に逆方向へたどることで、モデルが局所的な誤差に囚われることなく、変化し続ける金融市場のリズムに確実かつ滑らかに適応できるようになります。
次に、適応型最適化手法であるAdamアルゴリズムを適用します。Adamは、勾配の平滑化をおこなうMomentum勾配の二乗の移動平均を利用して変動を正規化するRMSPropの長所を組み合わせた手法です。 この処理では、2つの補助配列を使用します。matrix_mは一次モーメント(累積勾配)を、matrix_vは二次モーメント(勾配の二乗の累積値)を保持します。
float mt = IsNaNOrInf(clamp(b1 * matrix_m[shift_weight] + (1 - b1) * grad, -1.0e5f, 1.0e5f), 0);
float vt = IsNaNOrInf(clamp(b2 * matrix_v[shift_weight] + (1 - b2) * pow(grad, 2), 1.0e-6f, 1.0e6f), 1.0e-6f);
float weight = clamp(matrix_w[shift_weight] + IsNaNOrInf(l * mt / sqrt(vt), 0), -MAX_WEIGHT, MAX_WEIGHT);
パラメータ値は、変化の方向(mt)と変化の安定性(vt)の両方を考慮して調整されます。 更新された値は、グローバルデータバッファに書き戻されます。
 matrix_w[shift_weight] = weight;
 matrix_m[shift_weight] = mt;
 matrix_v[shift_weight] = vt;
}
このように、各フィルタのパラメータは、それまでの更新履歴から得られる豊富な情報を活用しながら適応します。 これにより、モデルは局所的な誤差に素早く対応するだけでなく、パラメータの急激な変動も抑え、データに対して滑らかで安定した適応を実現できます。 このようなきめ細かな調整は、特に変動の激しい金融時系列を扱う場合に重要です。たった1つの不要なインパルスでさえ、過学習や汎化性能の低下につながる可能性があるためです。
これで、プログラムのOpenCL側の実装は完了です。 完全なコードは、この記事の添付ファイルに提供されています。
オブジェクトの作成
これまで、可変ウィンドウを用いた適応畳み込み、動的なトークン生成、勾配計算、重み更新が、OpenCLプログラムの各カーネル内でどのように実装されているかを順を追って見てきました。 しかし、計算ロジックを実装するだけでは、まだ全体の半分にすぎません。 このアーキテクチャをリアルタイムで動作させ、モデル全体に組み込むには、メインプログラムとの適切な統合が必要です。
ここからが、最も興味深い部分である統合です。 優れたオーケストラでは、ソリスト(カーネル)の才能だけでなく、指揮者の的確な指揮も重要です。指揮者は、適切なタイミングで必要な処理を開始し、それらの連携を管理し、作品全体の一貫性を保ちます。
本実装では、CNeuronAdaptConvクラスが指揮者の役割を担います。 支配的周波数の分析から適応畳み込みの実行、誤差逆伝播からAdamオプティマイザによる重みの更新まで、すべての処理を統括します。 これは単なるOpenCLプログラムのラッパーではありません。各種の計算段階を連携させ、必要な判断を下し、反復処理の間で状態を保持する、本格的な制御モジュールです。
新しいオブジェクトの構造を以下に示します。
class CNeuronAdaptConv    :  public CNeuronConvOCL
  {
protected:
   CBufferFloat      bMainFreq;
   //---
   virtual bool      FFT(CBufferFloat *inp_re, CBufferFloat *inp_im,
                         CBufferFloat *out_re, CBufferFloat *out_im,
                         uint variables, bool reverse = false);
   virtual bool      PeriodsFinding(CBufferFloat *inp_re, CBufferFloat *inp_im,
                                    CBufferFloat *main_freq, uint variables);
   virtual bool      AdaptiveConvolution(CNeuronBaseOCL *NeuronOCL, CBufferFloat *main_freq);
   //---
   virtual bool      feedForward(CNeuronBaseOCL *NeuronOCL) override;
   virtual bool      updateInputWeights(CNeuronBaseOCL *NeuronOCL) override;
   virtual bool      calcInputGradients(CNeuronBaseOCL *NeuronOCL) override;

public:
                     CNeuronAdaptConv(void) {};
                    ~CNeuronAdaptConv(void) {};
   //---
   virtual bool      Init(uint numOutputs, uint myIndex, COpenCLMy *open_cl, uint window,
                          uint window_out, uint units_count, uint variables,
                          ENUM_OPTIMIZATION optimization_type, uint batch);
   //---
   virtual int       Type(void) override const  {  return defNeuronAdaptConv;   }
   //--- methods for working with files
   virtual bool      Save(int const file_handle) override;
   virtual bool      Load(int const file_handle) override;
   //---
   virtual void      SetOpenCL(COpenCLMy *obj)   override;
  };
ご覧のとおり、CNeuronAdaptConvクラスで独自に宣言されているバッファは、支配的周波数を格納するためのbMainFreqだけです。 動作に必要なその他のオブジェクトは、親クラスである畳み込み層クラスCNeuronConvOCLから継承しています。これにより、共通の処理ロジックを再利用し、コードの重複を削減できます。
bMainFreqバッファはクラスのメンバーとして確保され、オブジェクトの存続期間中保持されます。コンストラクタとデストラクタは空のままです。 このバッファと継承したすべてのオブジェクトの初期化は、Initメソッドでおこないます。このメソッドのパラメータには、作成するオブジェクトのアーキテクチャを一意に定めるための定数群が渡されます。
bool CNeuronAdaptConv::Init(uint numOutputs, uint myIndex, COpenCLMy *open_cl,
                            uint window, uint window_out, uint units_count, uint variables,
                            ENUM_OPTIMIZATION optimization_type, uint batch)
  {
   if(!CNeuronConvOCL::Init(numOutputs, myIndex, open_cl, window, window, window_out,
                                    units_count, variables, optimization_type, batch))
      return false;
このメソッドのアルゴリズムは非常にシンプルです。 まず、検証と初期化のすべてを親クラスの基本処理に委ねます。必要なパラメータやバッファの扱いを熟知したメンターに任せるようなものです。 これにより、不要な定型処理を自前のコードに実装せずに済みます。 その後、支配的周波数を格納するバッファを初期化するだけです。
   bMainFreq.BufferFree();
   if(!bMainFreq.BufferInit(iVariables, 1) ||
      !bMainFreq.BufferCreate(OpenCL))
      return false;
//---
   return true;
  }
続いて、メソッドの戻り値である真偽値を呼び出し元のプログラムに返します。
新しいオブジェクトのメソッドの大半は、すでに説明したアルゴリズムに従って、対応するカーネルの実行をキューに登録するための単なるラッパーである点に注目してください。
- FFT:高速フーリエ変換を用いて、時系列を周波数成分に分解する。
- PeriodsFinding:支配的周波数を特定する。
- AdaptiveConvolution:適応畳み込みの順伝播を実行する。
高速フーリエ変換と支配的周波数の探索アルゴリズムは、学習可能なパラメータを使用せず、誤差勾配の逆伝播も必要としません。そのため、逆伝播用のメソッドは、それぞれ対応する処理を呼び出すラッパーとなります。 一方、順伝播を担うfeedForwardメソッドは、複数の処理を組み合わせて実行する点で、明確に異なります。
bool CNeuronAdaptConv::feedForward(CNeuronBaseOCL *NeuronOCL)
  {
   if(!NeuronOCL)
      return false;
メソッドのパラメータとして入力データのオブジェクトへのポインタを受け取り、まずその有効性を確認します。 次に、FFTメソッドを呼び出し、取得したデータを周波数成分に分解します。
if(!FFT(NeuronOCL.getOutput(), NULL, Output, PrevOutput, iVariables, false))
   return false;
得られたスペクトルから、各単変量系列の支配的周波数を特定します。
if(!PeriodsFinding(Output, PrevOutput, GetPointer(bMainFreq), iVariables))
   return false;
最後に、適応畳み込みメソッドを呼び出し、必要なトークンを生成します。
 return AdaptiveConvolution(NeuronOCL, GetPointer(bMainFreq));
}
各処理の実行結果を示す真偽値を、呼び出し元のプログラムに返します。
このように、CNeuronAdaptConvクラスは計算パイプライン全体を統括する真の「マエストロ」として機能します。複雑で冗長な処理を自ら実装するのではなく、必要な箇所に処理を委譲しながら、パイプラインの各段階を的確に連携・同期させます。
結論
本記事では、スペクトル解析と適応畳み込みを単一の統合アルゴリズムに組み合わせた、包括的な時系列処理パイプラインの開発を完了しました。 FFTと支配的周波数の検出によって各データチャネルのリズムを特定し、その情報に基づいて、オブジェクトの出力トークン数を一定に保ちながら、セグメント幅を柔軟に調整する方法を示しました。
特に、MQL5およびOpenCL環境での実践的な実装に重点を置きました。 スペクトル解析やパッチの切り出しから、誤差逆伝播、Adamオプティマイザによる重みの更新に至るまで、すべての処理を順を追って解説しました。 各処理段階は、小規模ながら独立したカーネルとして実装されています。そして、制御クラスCNeuronAdaptConvが計算オーケストラの指揮者となり、各カーネルの動作を調整・同期させます。
各GPUスレッドが自身の重みと担当するデータ断片だけを処理するよう、アーキテクチャを慎重に設計することで、ワークアイテム同士が干渉することなく、高い並列性を実現しました。 ゼロパディングと厳密なオフセット管理により、情報の欠落やチャネル間でのデータの混在を防ぎます。 また、適応型のAdamオプティマイザは、一次モーメントと二次モーメントを適切に考慮することで、滑らかで安定したモデル学習を実現します。
次の記事では、今回生成したトークンを、改良版のTransformerスタックでどのように活用するかについて解説します。
参考文献
本記事で使用したプログラム
| # | 名前 | 種類 | 説明 |
|---|---|---|---|
| 1 | Study.mq5 | EA | モデルのオフライン学習用EA |
| 2 | StudyOnline.mq5 | EA | モデルのオフライン学習用EA |
| 3 | Test.mq5 | EA | モデルテスト用EA |
| 4 | Trajectory.mqh | クラスライブラリ | システム状態とモデルアーキテクチャを記述するための構造体 |
| 5 | NeuroNet.mqh | クラスライブラリ | ニューラルネットワークを作成するためのクラスライブラリ |
| 6 | NeuroNet.cl | ライブラリ | OpenCLプログラム用のコードライブラリ |
MetaQuotes Ltdによってロシア語から翻訳されました。
元の記事: https://www.mql5.com/ru/articles/18629
警告: これらの資料についてのすべての権利はMetaQuotes Ltd.が保有しています。これらの資料の全部または一部の複製や再プリントは禁じられています。
この記事はサイトのユーザーによって執筆されたものであり、著者の個人的な見解を反映しています。MetaQuotes Ltdは、提示された情報の正確性や、記載されているソリューション、戦略、または推奨事項の使用によって生じたいかなる結果についても責任を負いません。