

Neuronale Netze im Trading: Adaptive periodische Segmentierung (Token-Generierung)
 21
 0

Einleitung
Im vorherigen Artikel haben wir die theoretischen Grundlagen des LightGTS-Frameworks (Lightweight General Time Series Forecasting) eingehend untersucht – eines der derzeit fortschrittlichsten und einer der derzeit fortschrittlichsten und am besten konzipierten Ansätze zur Zeitreihenprognose, das in der Arbeit „LightGTS: A Lightweight General Time Series Forecasting Model“ vorgestellt wurde. Sein Konzept basiert auf einem tiefgreifenden Verständnis der für Finanz- und Wirtschaftsdaten charakteristischen Periodizität sowie auf einer durchdachten Neugestaltung der Transformer-Architektur für die spezifischen Aufgaben der Verarbeitung zeitlicher Strukturen. Wir haben uns vor allem darauf konzentriert, wie LightGTS mit periodischen Mustern umgeht, um die Trainingskosten zu minimieren und eine robuste Generalisierung auch bei heterogenen und verrauschten Daten zu gewährleisten.
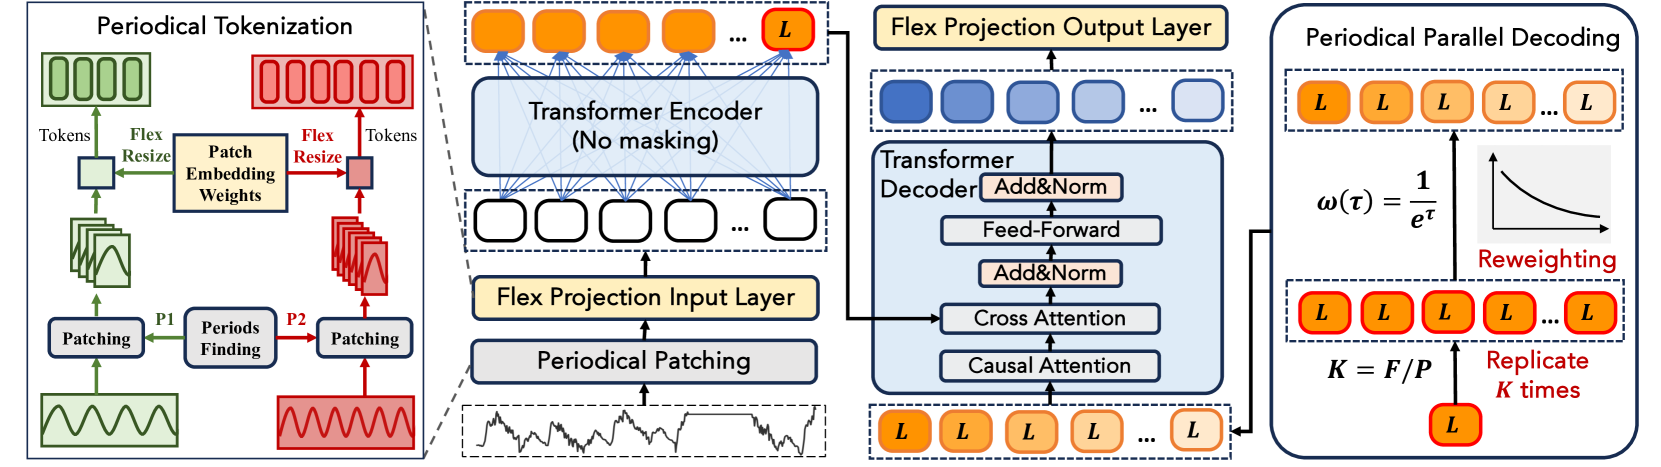
Das Framework beginnt mit dem sogenannten Period Patching – einem Mechanismus, bei dem eine Zeitreihe in Segmente unterteilt wird, die der inhärenten Frequenz des analysierten Signals entsprechen. Diese Frequenz wird nicht manuell festgelegt, sondern vom Modell auf der Grundlage einer Analyse des Frequenzspektrums ermittelt, das mithilfe der schnellen Fourier-Transformation gewonnen wird. Jeder extrahierte Patch repräsentiert einen einzelnen Zyklus, der signifikante lokale Muster enthält. Genau dieses Fragment wird durch Projektion in ein Token umgewandelt. An dieser Stelle kommt die erste architektonische Innovation ins Spiel – die Flex Projection Layer, die die Verarbeitung von Patches variabler Länge mittels einer flexiblen linearen Transformation der Gewichte ermöglicht. Diese Projektion skaliert die Daten nicht einfach nur; sie bewahrt die Äquivalenz der Token beim Wechsel zwischen verschiedenen Skalen und Frequenzen.
Der Encoder-Block nutzt das Rotary Positional Encoding (RoPE), das eine kompakte und stabile Darstellung der relativen Positionen von Token ermöglicht. Dies ist besonders wichtig bei Finanzzeitreihen, bei denen die absolute Position oft weit weniger bedeutend ist als die relativen Positionen der Elemente innerhalb der Sequenz. Die Token werden anschließend durch einen klassischen Stapel aus Transformer-Blöcken verarbeitet, von denen jeder aus einem Multi-Head-Self-Attention-Modul und einem Feed-Forward-Modul besteht.
Eine der originellsten Lösungen, die die Autoren von LightGTS vorgeschlagen haben, war der Mechanismus des Periodical Parallel Decoding, der als konzeptionelles Gegenteil autoregressiver Strategien gilt. Anstatt die Sequenz Schritt für Schritt vorherzusagen, nutzt das Modell das letzte Token der latenten Repräsentation (das alle Informationen über die vorherige Sequenz enthält) und generiert auf der Grundlage dieses Tokens gleichzeitig die gesamte Ausgabesequenz auf einmal, indem es dieses Token repliziert und anschließend eine Positionsgewichtung anwendet. Dieser Ansatz beschleunigt nicht nur die Prognose, sondern gewährleistet auch die periodische Konsistenz in der zeitlichen Struktur der Modellausgabe.
Schließlich wendet das Framework Flex-resize auf die Projektionsschicht des Decoders an und stellt so sicher, dass die Vorhersagen mit der tatsächlichen Länge des prognostizierten Signals übereinstimmen. Das gesamte Modelltraining läuft letztlich darauf hinaus, die klassische MSE-Verlustfunktion zwischen den vorhergesagten Werten und der Zielsequenz zu minimieren.
Somit ist LightGTS nicht nur ein modifizierter Transformer. Es handelt sich um eine gut durchdachte Architektur, bei der jede Komponente auf die spezifischen Eigenschaften von Zeitreihen zugeschnitten ist: von der Behandlung der Periodizität bis hin zur Abkehr von der Autoregression zugunsten einer vollständig parallelen Generierung. Gerade aufgrund dieser tiefgreifenden Anpassung erzielt das Framework eine hohe Genauigkeit bei geringem Rechenaufwand.
Nachfolgend ist die von den Autoren erstellte Darstellung des LightGTS-Frameworks zu sehen.
Im praktischen Teil des vorherigen Artikels haben wir mit der Entwicklung eines Algorithmus für adaptives periodisches Patching begonnen – einem der Schlüsselelemente der LightGTS-Architektur. Die Einschränkungen, die sich aus der fehlenden Möglichkeit ergeben, in den für MQL5 und OpenCL typischen Laufzeitumgebungen dynamische Speicherzuweisung zu nutzen, wurden eingehend untersucht. Diese Einschränkungen zwangen uns, die Idee einer beliebigen Anzahl von Ausgabe-Token aufzugeben.
Stattdessen haben wir eine strategisch fundierte Entscheidung getroffen: Wir haben die Anzahl der Patches fest vorgegeben und nutzen die Überlappung der Patches als Mittel, um Längenunterschiede bei den einzelnen Segmenten auszugleichen. Auf diese Weise ist es uns gelungen, ein Gleichgewicht zwischen Anpassungsfähigkeit (das Modell bleibt für die tatsächliche Periodizität der Zeitreihe empfindlich) und rechnerischer Stabilität herzustellen, die für die effiziente Nutzung der Hardware-Ressourcen erforderlich ist. Dieser Ansatz ermöglichte es, sowohl die Darstellungstreue der zyklischen Strukturen in den analysierten Daten als auch die Vorhersagbarkeit der Speicherverwaltung zu erhalten, was für Hochfrequenz-Trading-Modelle und für die Implementierung in einem eingeschränkten Ausführungskontext von entscheidender Bedeutung ist.
Wir haben den Algorithmus zur Bestimmung der dominanten Frequenz bereits implementiert: Er extrahiert effektiv die Hauptperiodizität für jede univariate Sequenz in der Eingabezeitreihe. Dadurch können wir einen Basismaßstab für die anschließende Datensegmentierung festlegen. Heute werden wir die begonnene Arbeit fortsetzen und den nächsten Schritt gehen: die Implementierung des Algorithmus zur Token-Generierung im OpenCL-Kontext.
Unser Ziel ist es, jede Zeitreihe in eine feste Anzahl von Segmenten zu unterteilen, wobei die Segmentgröße anhand der ermittelten dominanten Frequenz bestimmt wird, während die Überlappung die Anpassung an die Fensterlänge steuert. All dies muss streng parallel unter Verwendung von GPU-kompatiblem Code erfolgen, wobei jeder Thread (Work-Item) für die Erzeugung eines einzelnen Tokens in einer der univariaten Komponenten der zu analysierenden Sequenz zuständig ist.
OpenCL-Kernel erstellen
Nachdem wir die dominante Frequenz mithilfe der schnellen Fourier-Transformation ermittelt haben, sind wir nun direkt an der Schlüsselphase angelangt: dem Aufbau eines Mechanismus zur Generierung von Tokens, also von Zeitreihenfragmenten, die der ermittelten Periodizität entsprechen. Zur Erinnerung: Im vorigen Abschnitt haben wir uns auf eine wichtige Aufgabe konzentriert: die Kombination der Anpassung des Modells an die aktuelle Marktfrequenz mit der Anforderung einer festen Anzahl von Ausgabe-Patches, was insbesondere für den Betrieb in der MQL5-Umgebung wichtig ist, in der keine dynamische Speicherzuweisung verfügbar ist.
Unser Ansatz basiert auf folgendem Prinzip: Die Anzahl der Tokens (Patches) bleibt konstant, während ihre Länge an die aktuelle Frequenz angepasst und die Überlappung so geregelt wird, dass eine vollständige Abdeckung der zu analysierenden Zeitreihe gewährleistet ist. Dies ermöglicht ein ausgewogenes Verhältnis zwischen Flexibilität und Ressourcenkontrolle. Allerdings gibt es hier einen technischen Haken: Wenn sich das Faltungsfenster ändert, muss sich logischerweise auch die Gewichtsmatrix anpassen – entweder, indem sie jedes Mal neu aufgebaut wird, oder indem sie auf einen neuen Raum projiziert wird.
In der ursprünglichen Veröffentlichung schlugen die Autoren des LightGTS-Frameworks eine Lösung vor: Die Gewichtsmatrix wird mit einer festen Fenstergröße trainiert, die sich aus den statistischen Eigenschaften der Trainingsdaten ergibt, und anschließend werden die Gewichte für jede neue Fenstergröße mithilfe der Moore-Penrose-Pseudoinversen projiziert. Mathematisch elegant, in der Praxis aber umständlich.
Reale Finanzmärkte kennen keine Gnade: Der Zyklus von heute ist nicht der von morgen. Die Periodizität driftet, und Anpassung erfordert Flexibilität. Die Berechnung der pseudoinversen Matrix zur Laufzeit – insbesondere bei der Online-Verarbeitung oder im Hochfrequenz-Trading – bedeutet, Geschwindigkeit und Ressourceneffizienz zugunsten formaler Strenge zu opfern. Und das ist ein Luxus, den man sich nicht leisten kann.
Unsere Lösung ist wesentlich praktischer. Anstatt die Gewichte ständig neu aufzubauen, haben wir einen anderen Ansatz gewählt: Wir verwenden eine Matrix mit der maximal zulässigen Größe, in der wir unnötige Gewichte einfach ignorieren, indem wir Zero Padding verwenden. Mit anderen Worten: Liegt ein Datensegment nicht innerhalb des aktiven Fensters, werden entsprechende Positionen mit Nullen aufgefüllt, sodass diese Gewichte keinen Beitrag zum Ergebnis leisten. Einfach und effektiv.
Dieser Ansatz ermöglicht es:
- eine feste Struktur für die Gewichtsmatrix beizubehalten und dadurch rechenintensive Operationen zu vermeiden;
- die Fenstergröße und die Schrittweite zwischen den Patches dynamisch anzupassen;
- sich laufend an Frequenzschwankungen des Marktes anzupassen, ohne das Modell anzuhalten oder dessen Parameter neu zu berechnen.
All dies wird im OpenCL-Kontext im FeedForwardAdaptConv-Kernel implementiert, wobei jedes Work-Item für ein bestimmtes Segment-Filter-Paar für eine der univariaten Sequenzen zuständig ist.
__kernel void FeedForwardAdaptConv(__global const float *matrix_w,
                                   __global const float *matrix_i,
                                   __global float *matrix_o,
                                   __global const float *main_freq,
                                   const int inputs,
                                   const int window_in,
                                   const int activation
                                  )
  {
   const size_t u = get_global_id(0);
   const size_t f = get_global_id(1);
   const size_t v = get_global_id(2);
   const size_t units = get_global_size(0);
   const size_t filters = get_global_size(1);
   const size_t variables = get_global_size(2);
Im Hauptteil des Kernels ermitteln wir zunächst die Work-Item-Indizes im dreidimensionalen Aufgabenraum. Anschließend rufen wir mithilfe der Kennung v für die univariate Sequenz die dominante Frequenz der zu analysierenden Variablen aus dem globalen Puffer main_freq ab.
const int freq = main_freq[v];
int window = (inputs / variables + freq - 1) / freq;
Daraus wird die Fenstergröße berechnet, mit Anpassungen für die Schrittweite und die Fragmentierungsgrenzen. An dieser Stelle legen wir außerdem die Schrittweite des Analysefensters fest, basierend auf der Größe des Eingangstensors und der Anzahl der zu generierenden Token. Die Aufgabe besteht darin, die gesamte Sequenz gleichmäßig und lückenlos abzudecken.
const int step = (int)(inputs / variables + units + 1) / (units + 2);
if(window < step)
   window = (int)((step + window - 1) / window) * window;
if(window > window_in)
   window = window_in;
Nun kommt der entscheidende Punkt. Es ist wichtig, dass das Fenster nicht kleiner als die Schrittweite ist; andernfalls wird möglicherweise ein Teil der Daten nicht erfasst. Sollte sich die ermittelte Periode als zu klein erweisen, vergrößern wir daher die Fenstergröße um ein Vielfaches, sodass sie mindestens der Schrittweite entspricht, ohne dabei den maximal zulässigen Wert zu überschreiten.
Anschließend werden die Offsets in den Eingabe- und Ausgabe-Arrays sowie in der Gewichtsmatrix ermittelt. Dies ist erforderlich, um Daten innerhalb der globalen Puffer korrekt zu adressieren.
const int shift_in = (u < (units - 1) ? u * step : inputs / variables - window);
const int shift_in_var =  v * inputs / variables;
const int shift_out = (u + v * units) * filters + f;
const int shift_weight = (v * filters + f) * (window_in + 1);
An dieser Stelle ist eine wichtige Nuance zu beachten: Wir müssen die gesamte Eingabesequenz abdecken, einschließlich ihres letzten Abschnitts. Wird die Segmentierung mit einer festen Schrittweite durchgeführt und die Länge jedes Fensters dynamisch bestimmt, können einige der letzten Elemente bei der Analyse unberücksichtigt bleiben. Daher berechnen wir die Startposition des letzten Segments als Differenz zwischen der Gesamtlänge der analysierten Sequenz und der Fenstergröße, um eine vollständige Abdeckung der gesamten Eingabesequenz zu gewährleisten. Dadurch kann das letzte Fenster so verschoben werden, dass es garantiert die letzten Datenpunkte der Sequenz erfasst, selbst wenn seine Größe dynamisch festgelegt wurde und sich als kleiner als die maximal zulässige Größe erwiesen hat.
Als Nächstes folgt der eigentliche Rechenvorgang – die Faltungsoperation, bei der der Endwert für jedes Token berechnet wird. Im ersten Schritt nehmen wir den Basiswert, der der Bias-Komponente entspricht und mithilfe eines vorab berechneten Offsets aus der Gewichtsmatrix extrahiert wird. Dieses Element dient als Ausgangspunkt für die Summierung der Beiträge der einzelnen Elemente des Analysefensters.
float sum = matrix_w[shift_weight + window_in];
for(int i = 0; i < window; i++)
   if((shift_in + i) < (inputs / variables))
      sum += IsNaNOrInf(matrix_i[shift_in_var + shift_in + i], 0) *
             matrix_w[shift_weight + i];
Als Nächstes beginnen wir damit, jedes Element des Analysefensters nacheinander durchzugehen. An dieser Stelle kommt das zentrale Merkmal unserer Implementierung ins Spiel – die Zero-Padding-Strategie. Liegt ein Element der Sequenz außerhalb des tatsächlich berechneten Fensters, wird es einfach aus den Berechnungen ausgeschlossen. Dadurch lassen sich Signalverzerrungen vermeiden, die auftreten könnten, wenn irrelevante Daten einbezogen würden. Diese Methode gewährleistet konsistente Ergebnisse und ermöglicht präzise Berechnungen, unabhängig von der aktuellen Fenstergröße. Zudem erleichtert Zero Padding die Beibehaltung einer festen Dimensionalität der Gewichtsmatrix, da wir so sicherstellen können, dass alle leeren Positionen mit Nullen gefüllt werden, die keinen Einfluss auf die Endsumme haben.
Abschließend wenden wir die ausgewählte Aktivierungsfunktion an und speichern das Ergebnis im Ausgabepuffer.
 matrix_o[shift_out] = Activation(sum, activation);
}
Dadurch erhalten wir Einbettungen, die an die aktuelle Marktfrequenz angepasst sind, einen klaren lokalen Kontext aufweisen und direkt in Transformer-Blöcke eingespeist werden können. All dies wird ohne kostspielige Vorgänge, mit minimalem Ressourcenverbrauch und in voller Übereinstimmung mit den Vorgaben der MQL5-Umgebung erreicht.
Bevor wir die gewonnenen Token in den Strudel der Transformer-Blöcke einspeisen, müssen wir sicherstellen, dass das Modell selbst nicht schon beim ersten Schritt aufgibt und lernfähig ist. Dazu benötigen wir einen vollständigen Backpropagation-Durchlauf (Backpropagation) – genau die Phase, in der die Gradienten berechnet werden, sodass wir die adaptiven Faltungsfilter anpassen können. Ohne ihn würde alles, was wir im Vorwärtsdurchlauf getan haben, in Stagnation übergehen: Die Filter würden in zufälligen Zuständen stecken bleiben, und das Modell wäre schlicht nicht in der Lage, sich an neue Marktschocks anzupassen, und würde in seinen eigenen Fehlern erstarren.
Den Rückwärtsdurchlauf auszuführen ist, als würde man einem Orchester Feedback geben: Wenn ein Instrument aus dem Takt gerät, muss das Signal mit präzisen Korrekturhinweisen zurückgeführt werden – mit präzisen Hinweisen darauf, was zu korrigieren ist. In der Welt der adaptiven Faltung mit variablen Fenstern ist dies keine leichte Aufgabe: Jeder Quellwert kann an mehreren Token gleichzeitig beteiligt sein, und bei allen muss der Fehler wieder auf ihre jeweiligen Quellen zurückverteilt werden.
Genau zu diesem Zweck haben wir den OpenCL-Kernel CalcHiddenGradientAdaptConv entwickelt. Er arbeitet in einem zweidimensionalen Raum: Entlang der inp-Achse liegen die Positionen in den ursprünglichen univariaten Sequenzen, und entlang der v-Achse liegen verschiedene Kanäle (univariate Sequenzen). Dieser Ansatz stellt sicher, dass jedem Element der analysierten Daten sein genauer Gradient zugeordnet wird.
__kernel void CalcHiddenGradientAdaptConv(__global const float *matrix_w,
                                          __global const float *matrix_i,
                                          __global float *matrix_ig,
                                          __global const float *matrix_og,
                                          __global const float *main_freq,
                                          const int outputs,
                                          const int window_in,
                                          const int window_out,
                                          const int activation
                                         )
  {
   const size_t inp = get_global_id(0);
   const size_t v = get_global_id(1);
   const size_t inputs = get_global_size(0);
   const size_t variables = get_global_size(1);
Im Kernel wird zunächst das Radar eingeschaltet – wir identifizieren das aktuelle Work-Item über alle Dimensionen des Aufgabenraums hinweg. Anschließend bestimmen wir, wie im Kernel des Vorwärtsdurchlaufs, für jede univariate Sequenz individuell die Segmentgröße sowie die zugehörige Schrittweite.
const int units = outputs / (window_out * variables);
const int freq = main_freq[v];
int window = (inputs / variables + freq - 1) / freq;
const int step = (int)(inputs + units + 1) / (units + 2);
if(window < step)
   window = (int)((step + window - 1) / window) * window;
if(window > window_in)
   window = window_in;
Anschließend ermitteln wir die Offsets in den Datenpuffern zu den gewünschten Elementen.
const int shift_in = v * inputs + inp;
int u = inp / step;
int shift_out_var = v * (outputs / variables);
int shift_weight_var = (v * window_out) * (window_in + 1);
Als Nächstes wenden wir uns dem Hauptprozess der Verteilung des Fehlergradienten zu. Hier ermitteln wir zunächst, welches Token unter Verwendung des aktuellen Elements des Quelldatenpuffers gebildet wurde, und akkumulieren anschließend den Fehlergradienten über alle Elemente des resultierenden Tokens hinweg, wobei wir den Beitrag des gerade analysierten Elements berücksichtigen.
Es ist jedoch zu beachten, dass die Verwendung überlappender Segmente es ermöglicht, ein einzelnes Element der Quelldaten bei der Generierung mehrerer Token an verschiedenen Positionen zu verwenden. Deshalb fassen wir den Vorgang zum Sammeln des Fehlergradienten in eine Schleife ein.
float sum = 0;
while(u * step <= inp && u < (units - 1))
  {
   int pos = inp - u * step;
   if(pos >= window)
     {
      u++;
      continue;
     }
   int shift_out = u * window_out;
   int shift_weight = pos + shift_weight_var;
   for(int out = 0; out < window_out; out++)
     {
      if((shift_out + out) >= (outputs / variables))
         continue;
      sum += IsNaNOrInf(matrix_og[shift_out_var + shift_out + out] *
                        matrix_w[shift_weight + out * (window_in + 1)], 0);
     }
   u++;
  }
Wir sollten auch bedenken, wie das letzte Segment gebildet wird. Im Algorithmus zur Verteilung des Fehlergradienten behandeln wir ihn in einem separaten Block.
if(inp >= (inputs - window))
  {
   int pos = inp + window - inputs;
   int shift_out = (units - 1) * window_out;
   int shift_weight = pos + shift_weight_var;
   for(int out = 0; out < window_out; out++)
     {
      if((shift_out + out) >= (outputs / variables))
         continue;
      sum += IsNaNOrInf(matrix_og[shift_out_var + shift_out + out] *
                        matrix_w[shift_weight + out * (window_in + 1)], 0);
     }
  }
Und noch ein letzter Schritt: Wir passen die kumulierte Summe der Fehlergradienten anhand der Ableitung der Aktivierungssumme an und speichern sie im entsprechenden Element des globalen Datenpuffers.
 matrix_ig[shift_in] = Deactivation(sum, matrix_i[shift_in], activation);
}
Dieser Ansatz mit einer Schleife über die Token stellt sicher, dass jedes Bit der Eingabedaten den ihm zustehenden Fehlergradienten erhält, selbst wenn seine Stimme in mehreren Token gleichzeitig zu hören war. Dadurch können unsere adaptiven Filter nicht aus einzelnen Ausschnitten, sondern aus ganzen Batches von Marktdaten lernen.
Die Verteilung des Fehlergradienten ist jedoch erst die halbe Miete. Die eigentliche Magie geschieht erst danach, wenn wir diese Gradienten nutzen, um die Parameter des Modells zu aktualisieren. Stellen Sie sich einen Gärtner vor, der nach der Ernte entscheidet, welche Bäume er zurückschneidet und welche er düngt, damit die Zweige in der nächsten Saison noch mehr Früchte tragen. Ebenso nutzen unsere Optimierungsalgorithmen die berechneten Gradienten, um die Gewichte so anzupassen, dass der gesamte Vorhersagefehler minimiert wird.
In unserem Fall wird die Aktualisierung der Modellparameter im OpenCL-Kernel UpdateWeightsAdaptConvAdam implementiert. Dies ist nicht nur ein technischer Schritt, sondern der Höhepunkt des gesamten Backpropagation-Prozesses – der Moment, in dem das Modell aus seinen Fehlern lernt und einen Schritt in Richtung Verbesserung macht.
__kernel void UpdateWeightsAdaptConvAdam(__global float *matrix_w,
                                         __global const float *matrix_og,
                                         __global const float *matrix_i,
                                         __global float *matrix_m,
                                         __global float *matrix_v,
                                         __global float *main_freq,
                                         const int inputs,
                                         const int outputs,
                                         const float l,
                                         const float b1,
                                         const float b2
                                        )
  {
   const size_t id_in = get_global_id(0);    // input shift
   const size_t id_out = get_global_id(1);   // filter shift
   const size_t id_v = get_global_id(2);     // variable
   const size_t window_in = get_global_size(0) - 1;
   const size_t window_out = get_global_size(1);
   const size_t variables = get_global_size(2);
Der Arbeitsablauf des Kernels ist wie eine mehrstufige Struktur mit drei Koordinatenachsen aufgebaut, von denen jede eine klar definierte Rolle im Rechenprozess spielt. Die erste Achse ist die Position innerhalb des Analysefensters (Segment) der Eingabedaten (id_in), die zweite ist die Filternummer – oder, mit anderen Worten, eine bestimmte Position im Token an der Ausgabe des Objekts (id_out) – und die dritte ist der Index der univariaten Sequenz (id_v), der einen separaten Kanal der Eingabedaten darstellt.
Diese dreidimensionale Verteilung der Berechnungen ist nicht bloß eine architektonische Zweckmäßigkeit, sondern eine strategische Designentscheidung. Sie ermöglicht eine vollständige Zerlegung der Aufgabe: Jeder trainierbare Parameter der Gewichtsmatrix wird streng im Kontext des entsprechenden Segments der Eingabesequenz angewendet und ist an einen bestimmten Filter sowie einen bestimmten Kanal gebunden. Stellen Sie sich vor, jeder Filter wäre ein eigener Analyst, der an seinem eigenen Chart arbeitet und die Unterlagen der anderen nicht durcheinanderbringt. Dadurch wird verhindert, dass Signale zwischen Zeitreihen vermischt werden, wodurch zeitreihenübergreifende Verzerrungen vermieden werden, die besonders bei der Arbeit mit Finanzdaten kritisch sind, wo Rauschen und Instabilität an der Tagesordnung sind.
Dieser Ansatz schafft eine Art Mikroskop mit unabhängigen Linsen: Jeder Filter ist auf ein eigenes Datensegment fokussiert, was eine äußerst präzise Abstimmung auf kleinste Signalschwankungen ermöglicht. Wenn ein Kanal volatile, schnelle Schwankungen aufweist und der andere einen gleichmäßigen, aber trägen Trend, kann der Algorithmus jeden von ihnen verarbeiten, ohne seine Fähigkeit zur Erkennung von Details zu verlieren. Tatsächlich wird jedes einzelne Gewicht individuell für seine spezifische lokale Aufgabe trainiert, so als wäre es ein eigenständiges Modell innerhalb eines größeren Systems.
Im Kernel-Rumpf identifizieren wir sofort das Work-Item im dreidimensionalen Aufgabenraum, wodurch wir ein einzelnes Element aus der Matrix der trainierbaren Parameter für weitere Operationen auswählen können.
Unmittelbar danach berechnen wir anhand der dominanten Frequenz main_freq[id_v] die aktuelle Segmentgröße window, die den Bereich bestimmt, auf den dieses Gewicht angewendet wird.
const int units = outputs / (window_out * variables);
const int freq = main_freq[id_v];
int window = (inputs / variables + freq - 1) / freq;
const int step = (int)(inputs / variables + units + 1) / (units + 2);
if(window < step)
   window = (int)((step + window - 1) / window) * window;
if(window > window_in)
   window = window_in;
Dieser Ansatz gewährleistet:
- Parameterisolierung – jedes Gewicht wirkt nur auf die Eingabedaten, an die es gebunden ist;
- Vollständige Parallelität – die Work-Items beeinträchtigen sich nicht gegenseitig, da sie an unterschiedlichen Elementen der Gewichtsmatrix arbeiten;
- Genauigkeit – Der Filter ist auf die Datenfrequenz abgestimmt und verarbeitet nur relevante Segmente.
Wir dürfen nicht vergessen, dass alle unsere Berechnungen innerhalb eines universellen Frameworks erfolgen – einer Gewichtsmatrix, die für das maximal mögliche Analysefenster der Daten ausgelegt ist. In der Realität erweist sich jedes einzelne Segment jedoch oft als kleiner als diese maximale Größe. Um zu vermeiden, dass wertvolle GPU-Zeit und Energie für unnötige Arbeit verschwendet werden, prüfen wir gleich zu Beginn jedes Work-Items, ob der Parameter zum aktuellen Segment gehört, und beenden nicht benötigte Work-Items sofort.
if(id_in != window_in &&
   id_in >= window)
   return;
Dadurch steigt die Gesamtleistung erheblich, und das Modell läuft spürbar schneller – wie ein zielstrebiger Rennfahrer, der sofort alle unnötigen Kurven verwirft und den direktesten Weg zur Ziellinie nimmt.
Der nächste Schritt besteht darin, die Offsets in den globalen Datenpuffern zu ermitteln – ohne diese Angaben kann kein Work-Item die benötigten Elemente finden.
const int shift_in_var = id_v * inputs / variables;
const int shift_out_var = id_v * outputs / variables;
const int shift_weight = (id_v * window_out + id_out) *
                         (window_in + 1) + id_in;
const bool bias = (id_in == window_in);
Diese einfache, aber äußerst wichtige Technik stellt sicher, dass jeder Filterparameter pro Zeiteinheit nur seinen eigenen Teil der Daten verarbeitet, wodurch die Effizienz und Vorhersagbarkeit des gesamten Modells verbessert wird.
Als Nächstes kommen wir zu einem der wichtigsten Schritte – der Berechnung des Fehlergradienten für den ausgewählten Parameter. Der Gradient ist keine abstrakte Größe, sondern ein echter Wegweiser, der uns zeigt, in welche Richtung und um wie viel wir das Gewicht anpassen müssen, damit das Modell genauere Vorhersagen liefert.
Um den tatsächlichen Beitrag des untersuchten Parameters zu ermitteln, durchlaufen wir die gesamte univariate Sequenz und sammeln alle dabei entstehenden Antworten in den Ausgabe-Token.
float grad = 0;
for(int u = 0; u < (units - 1); u++)
  {
   const int shift_in_loc = id_in + u * step;
   if(shift_in_loc >= (inputs / variables))
      continue;
   float inp = (bias ? 1 : IsNaNOrInf(matrix_i[shift_in_var + shift_in_loc], 0));
   grad += IsNaNOrInf(inp * matrix_og[shift_out_var + u * window_out + id_out], 0);
  }
Vergessen wir nicht die Besonderheiten bei der Bildung des letzten Segments. Wir haben das in einem separaten Block behandelt.
{
 const int shift_in_loc = id_in + inputs / variables - window;
 if(shift_in_loc < (inputs / variables))
   {
    float inp = (bias ? 1 : IsNaNOrInf(matrix_i[shift_in_var + shift_in_loc], 0));
    grad += IsNaNOrInf(inp * matrix_og[shift_out_var + (units - 1) * window_out + id_out], 0);
   }
}
Diese Methode zur Ermittlung des Gradienten ist gründlich und umfassend. Wir lassen keine einzige Antwort in den Eingabedaten außer Acht und erhalten dadurch den genauesten Richtungsvektor für die Gewichtsanpassung. Gerade diese sorgfältige Rückverfolgung stellt sicher, dass das Modell nicht bei lokalen Fehlern stecken bleibt, sondern sich stattdessen zuverlässig und reibungslos an den sich wandelnden Rhythmus der Finanzmärkte anpasst.
Anschließend wird der Adam-Algorithmus aktiviert – ein adaptives Optimierungsverfahren, das die Vorteile der Gradientenglättung (Momentum) und der Varianznormalisierung (RMSProp) vereint. Es verwendet zwei Hilfsarrays: matrix_m für das erste Moment (den akkumulierten Gradienten) und matrix_v für das zweite Moment (den akkumulierten quadrierten Fehler).
float mt = IsNaNOrInf(clamp(b1 * matrix_m[shift_weight] + (1 - b1) * grad, -1.0e5f, 1.0e5f), 0);
float vt = IsNaNOrInf(clamp(b2 * matrix_v[shift_weight] + (1 - b2) * pow(grad, 2), 1.0e-6f, 1.0e6f), 1.0e-6f);
float weight = clamp(matrix_w[shift_weight] + IsNaNOrInf(l * mt / sqrt(vt), 0), -MAX_WEIGHT, MAX_WEIGHT);
Der Parameterwert wird so angepasst, dass sowohl die Richtung (mt) als auch die Stabilität (vt) der Veränderung berücksichtigt werden. Die aktualisierten Werte werden wieder in die globalen Datenpuffer geschrieben.
 matrix_w[shift_weight] = weight;
 matrix_m[shift_weight] = mt;
 matrix_v[shift_weight] = vt;
}
Somit passt sich jeder Filterparameter an, indem er auf den umfangreichen Kontext seiner bisherigen Aktualisierungen zurückgreift. Dadurch kann das Modell nicht nur schnell auf lokale Fehler reagieren, sondern auch abrupte Parameterschwankungen vermeiden, was eine reibungslose und stabile Anpassung an die Daten gewährleistet. Diese Art der Feinabstimmung ist besonders wichtig beim Umgang mit volatilen Finanzzeitreihen, bei denen bereits ein einziger Störimpuls zu Overfitting oder einem Verlust der Generalisierungsfähigkeit führen kann.
Damit ist unsere Arbeit am OpenCL-Teil des Programms abgeschlossen. Der vollständige Code ist als Anhang zum Artikel beigefügt.
Erstellen eines Objekts
Wir haben untersucht, wie die adaptive Faltung mit variablem Fenster, die dynamische Token-Generierung, die Gradientenberechnung und die Gewichtsaktualisierungen Schritt für Schritt in den Kerneln des OpenCL-Programms implementiert werden. Die Berechnungslogik allein ist jedoch nur die halbe Wahrheit. Damit diese Architektur in Echtzeit und innerhalb eines vollständigen Modells funktioniert, muss sie ordnungsgemäß in das Hauptprogramm integriert werden.
Und hier beginnt der interessanteste Teil – Integration. Genau wie in einem guten Orchester kommt es nicht nur auf das Talent der Solisten (Kernel) an, sondern auch auf die präzise Führung des Dirigenten – der im richtigen Moment die richtigen Abläufe in Gang setzt, ihr Zusammenspiel steuert und die Einheit der gesamten Komposition gewährleistet.
In unserem Fall fungiert die Klasse CNeuronAdaptConv als Dirigent. Sie koordiniert alles: von der Analyse der dominanten Frequenzen bis zur Ausführung der adaptiven Faltung, von der Backpropagation bis zur Aktualisierung der Gewichte mit dem Adam-Optimierer. Es handelt sich hierbei nicht nur um eine Hülle um das OpenCL-Programm, sondern um ein vollwertiges Steuermodul, das Entscheidungen trifft, die verschiedenen Rechenphasen miteinander verknüpft und sicherstellt, dass der Zustand zwischen den Iterationen erhalten bleibt.
Die Struktur des neuen Objekts ist unten dargestellt.
class CNeuronAdaptConv    :  public CNeuronConvOCL
  {
protected:
   CBufferFloat      bMainFreq;
   //---
   virtual bool      FFT(CBufferFloat *inp_re, CBufferFloat *inp_im,
                         CBufferFloat *out_re, CBufferFloat *out_im,
                         uint variables, bool reverse = false);
   virtual bool      PeriodsFinding(CBufferFloat *inp_re, CBufferFloat *inp_im,
                                    CBufferFloat *main_freq, uint variables);
   virtual bool      AdaptiveConvolution(CNeuronBaseOCL *NeuronOCL, CBufferFloat *main_freq);
   //---
   virtual bool      feedForward(CNeuronBaseOCL *NeuronOCL) override;
   virtual bool      updateInputWeights(CNeuronBaseOCL *NeuronOCL) override;
   virtual bool      calcInputGradients(CNeuronBaseOCL *NeuronOCL) override;

public:
                     CNeuronAdaptConv(void) {};
                    ~CNeuronAdaptConv(void) {};
   //---
   virtual bool      Init(uint numOutputs, uint myIndex, COpenCLMy *open_cl, uint window,
                          uint window_out, uint units_count, uint variables,
                          ENUM_OPTIMIZATION optimization_type, uint batch);
   //---
   virtual int       Type(void) override const  {  return defNeuronAdaptConv;   }
   //--- methods for working with files
   virtual bool      Save(int const file_handle) override;
   virtual bool      Load(int const file_handle) override;
   //---
   virtual void      SetOpenCL(COpenCLMy *obj)   override;
  };
Wie Sie sehen können, wird innerhalb von CNeuronAdaptConv nur ein eigener Puffer deklariert: bMainFreq, der zur Speicherung der dominanten Frequenzen dient. Alle anderen für den Betrieb erforderlichen Objekte werden von der übergeordneten Faltungsschichtklasse CNeuronConvOCL geerbt, was die Wiederverwendung gemeinsamer Logik ermöglicht und Code-Duplikation reduziert.
Der Puffer bMainFreq ist als persistentes Mitglied der Klasse vorgesehen; Konstruktor und Destruktor bleiben leer. Die Initialisierung dieses Puffers und aller vererbten Objekte erfolgt in der Methode Init, deren Parameter eine Reihe von Konstanten bereitstellen, anhand derer wir die Architektur des zu erstellenden Objekts eindeutig interpretieren können.
bool CNeuronAdaptConv::Init(uint numOutputs, uint myIndex, COpenCLMy *open_cl,
                            uint window, uint window_out, uint units_count, uint variables,
                            ENUM_OPTIMIZATION optimization_type, uint batch)
  {
   if(!CNeuronConvOCL::Init(numOutputs, myIndex, open_cl, window, window, window_out,
                                    units_count, variables, optimization_type, batch))
      return false;
Der Algorithmus für diese Methode ist recht einfach. Zunächst delegieren wir die gesamte Validierung und Initialisierung an die Basislogik der übergeordneten Klasse, so als würden wir einem Mentor vertrauen, der bereits weiß, mit welchen Parametern und Puffern er arbeiten muss. Dadurch wird unser Code von unnötigen Routineaufgaben befreit. Dann muss nur noch der Puffer für die dominante Frequenz initialisiert werden.
   bMainFreq.BufferFree();
   if(!bMainFreq.BufferInit(iVariables, 1) ||
      !bMainFreq.BufferCreate(OpenCL))
      return false;
//---
   return true;
  }
Anschließend geben wir das boolesche Ergebnis der Methode an das aufrufende Programm zurück.
Es sei darauf hingewiesen, dass die meisten Methoden zum Einreihen der Kernel-Ausführung in die OpenCL-Queue des neuen Objekts lediglich Wrapper sind, wobei der Ihnen bereits bekannte Algorithmus zum Einsatz kommt:
- FFT – die Zerlegung einer Zeitreihe in ihre Frequenzkomponenten mithilfe der schnellen Fourier-Transformation;
- PeriodsFinding – Ermittlung der dominanten Frequenz;
- AdaptiveConvolution – der Vorwärtsdurchlauf der adaptiven Faltung.
Da die schnelle Fourier-Transformation und die Suche nach der dominanten Frequenz weder trainierbare Parameter verwenden noch eine Gradientenrückführung erfordern, beschränken sich die zugehörigen Methoden hier auf einfache Wrapper-Aufrufe. Im Gegensatz dazu sticht die Vorwärtsdurchlauf-Methode feedForward deutlich hervor, da sie mehrere Iterationen kombiniert.
bool CNeuronAdaptConv::feedForward(CNeuronBaseOCL *NeuronOCL)
  {
   if(!NeuronOCL)
      return false;
In den Methodenparametern erhalten wir einen Zeiger auf das Quelldatenobjekt und überprüfen dessen Gültigkeit sofort. Anschließend zerlegen wir die erhaltenen Daten durch Aufruf der FFT-Methode in Frequenzkomponenten.
if(!FFT(NeuronOCL.getOutput(), NULL, Output, PrevOutput, iVariables, false))
   return false;
Anhand des daraus resultierenden Spektrums ermitteln wir die dominanten Frequenzen für jede univariate Sequenz.
if(!PeriodsFinding(Output, PrevOutput, GetPointer(bMainFreq), iVariables))
   return false;
Abschließend rufen wir die Methode der adaptiven Faltung auf, die die benötigten Token generiert.
 return AdaptiveConvolution(NeuronOCL, GetPointer(bMainFreq));
}
Wir geben das logische Ergebnis der Operationen an das aufrufende Programm zurück.
Somit fungiert die Klasse CNeuronAdaptConv als der eigentliche „Maestro“ der Rechenpipeline: Sie enthält keine schwerfälligen Implementierungen, verfügt jedoch über die perfekte Fähigkeit, alle Phasen des Prozesses zu koordinieren und zu synchronisieren, wobei sie die Kontrolle nur dort abgibt, wo sie wirklich benötigt wird.
Fazit
In diesem Artikel haben wir die Entwicklung einer umfassenden Pipeline zur Verarbeitung von Zeitreihen abgeschlossen, die Spektralanalyse und adaptive Faltung in einem einzigen, integrierten Algorithmus vereint. Wir haben gezeigt, wie wir mithilfe der FFT und der Erkennung der dominanten Frequenz den Rhythmus jedes Datenkanals bestimmen und anschließend auf der Grundlage dieser Informationen die Segmentbreite flexibel anpassen können, während die Anzahl der Token am Ausgang des Objekts konstant bleibt.
Besonderes Augenmerk wurde auf die praktische Umsetzung in den Umgebungen MQL5 und OpenCL gelegt. Wir haben alle Schritte durchlaufen: von der Analyse des Spektrums und dem Zerlegen in Patches bis hin zur Backpropagation und zur Aktualisierung der Gewichte mithilfe des Adam-Optimierers. Jede Phase wird als kleiner, aber eigenständiger Kernel implementiert, und die Steuerungsklasse CNeuronAdaptConv koordiniert und synchronisiert deren Betrieb und fungiert dabei als Dirigent eines Rechenorchesters.
Dank einer sorgfältig konzipierten Architektur, bei der jeder GPU-Thread nur sein eigenes Gewicht und sein eigenes Datenfragment verarbeitet, konnten wir eine beeindruckende Parallelität erzielen, ohne dass sich die Work-Items gegenseitig beeinträchtigten. Zero Padding und ein striktes Offset-System stellen sicher, dass keine Informationen verloren gehen oder zwischen den Kanälen verwechselt werden. Der adaptive Adam-Optimierer gewährleistet durch die sorgfältige Berücksichtigung von Momenten erster und zweiter Ordnung ein reibungsloses und stabiles Modelltraining.
Im nächsten Artikel werden wir erläutern, wie man die gewonnenen Token in einem modifizierten Transformer-Stack einsetzt.
Literaturverzeichnis
In diesem Artikel verwendete Programme
| # | Name | Typ | Beschreibung |
|---|---|---|---|
| 1 | Study.mq5 | Expert Advisor (EA) | Expert Advisor (EA) für das Offline-Modelltraining |
| 2 | StudyOnline.mq5 | Expert Advisor (EA) | Expert Advisor (EA) für das Online-Modelltraining |
| 3 | Test.mq5 | Expert Advisor (EA) | Expert Advisor (EA) für Modelltests |
| 4 | Trajectory.mqh | Klassenbibliothek | Struktur zur Beschreibung des Systemzustands und der Modellarchitektur |
| 5 | NeuroNet.mqh | Klassenbibliothek | Klassenbibliothek zum Erstellen neuronaler Netze |
| 6 | NeuroNet.cl | Bibliothek | Codebibliothek für das OpenCL-Programm |
Übersetzt aus dem Russischen von MetaQuotes Ltd.
Originalartikel: https://www.mql5.com/ru/articles/18629
Warnung: Alle Rechte sind von MetaQuotes Ltd. vorbehalten. Kopieren oder Vervielfältigen untersagt.
Dieser Artikel wurde von einem Nutzer der Website verfasst und gibt dessen persönliche Meinung wieder. MetaQuotes Ltd übernimmt keine Verantwortung für die Richtigkeit der dargestellten Informationen oder für Folgen, die sich aus der Anwendung der beschriebenen Lösungen, Strategien oder Empfehlungen ergeben.

 Neuronale Netze im Handel: Adaptive periodische Segmentierung (LightGTS)
 Von den Grundlagen bis zur Mittelstufe: Navigation durch die Sandbox
 Neuronale Netze im Trading: Eine intelligente Prognosepipeline (Sparse Mixture of Experts)
 Von den Grundlagen bis zur Mittelstufe: Direkter Dateizugriff (II)

- Freie Handelsapplikationen
- Über 8.000 Signale zum Kopieren
- Wirtschaftsnachrichten für die Lage an den Finanzmärkte
Sie stimmen der Website-Richtlinie und den Nutzungsbedingungen zu.