

Neuronale Netze im Handel: Robuste Handelssignale in jedem Marktregime (Attention-Module)
 6
 1

Einleitung
Die Finanzmärkte sind wie ein lebender Organismus, der atmet, sich weiterentwickelt und sich ständig verändert. Hier gibt es keine absolute Stabilität. Die üblichen Korrelationen zwischen Vermögenswerten können innerhalb weniger Handelssitzungen verschwinden. Der Markt besteht nicht nur aus Zahlen in Diagrammen, sondern spiegelt auch menschliche Emotionen, Erwartungen und Entscheidungen wider, die in einem äußerst komplexen Geflecht von Zusammenhängen miteinander verflochten sind. Und in dieser Welt voller Chaos und Unsicherheit sind Werkzeuge, mit denen sich eine verborgene Ordnung erkennen lässt, besonders wertvoll.
Das ST-Expert-Framework, dessen Besprechung wir im vorherigen Artikel begonnen haben, wurde genau zu dem Zweck entwickelt, dort Muster zu erkennen, wo herkömmliche Analysemethoden an ihre Grenzen stoßen. Sein Hauptmerkmal ist die Fähigkeit, zwei Dimensionen miteinander zu verbinden: die zeitliche und die räumliche. Der zeitliche Aspekt ist ein klassisches Element der Finanzprognose: die Analyse historischer Daten und der Versuch, auf der Grundlage vergangener Kurse die Zukunft vorherzusagen. Der räumliche Aspekt eröffnet eine neue Ebene des Verständnisses: Der Markt wird als Netzwerk betrachtet, in dem jeder Vermögenswert mit anderen verbunden ist und Veränderungen in einem Segment unweigerlich Auswirkungen auf benachbarte Segmente haben.
Stellen Sie sich vor, wir würden den Aktienmarkt analysieren. Wenn der Ölpreis zu steigen beginnt, schlägt sich dies fast sofort in den Aktienkursen der Ölkonzerne nieder. Und die Währungen der Ölförderländer – ebenso wie ganze Sektoren der damit verbundenen Branchen – könnten dieser Entwicklung folgen. Ein klassisches Modell, das ausschließlich auf Preiszeitreihen basiert, erfasst lediglich die direkte Entwicklung eines bestimmten Finanzinstruments. ST-Expert hingegen ist in der Lage, die gesamte Kette von Veränderungen zu erfassen, da es nicht nur mit der Zeit, sondern auch mit dem Raum der Marktbeziehungen arbeitet.
Die Architektur des Frameworks basiert auf dem Prinzip „Mixture of Experts“ – einer Kombination verschiedener Experten. Dieser Ansatz lässt sich mit der Arbeit eines Anlageausschusses vergleichen. Dort kommen Analysten mit unterschiedlichen Profilen zusammen: Der eine ist auf technische Analyse spezialisiert, ein anderer auf Makroökonomie und ein dritter untersucht Korrelationen zwischen verschiedenen Sektoren. Für sich genommen verfügt jeder von ihnen nur über begrenzte Fähigkeiten. Wenn ihre Meinungen jedoch zusammengeführt werden, liegt die endgültige Entscheidung viel näher an der Realität. Das Gleiche gilt für ST-Expert: Jeder Expertenblock ist für seinen eigenen Analysebereich zuständig, und das System kombiniert die Prognosen der Expertenblöcke zu einer schlüssigen Lösung.
Diese Aufgabenteilung bietet dem System drei wesentliche Vorteile:
- Anpassungsfähigkeit. Der Markt verändert sich von Minute zu Minute, und das System muss sich entsprechend anpassen. Wenn gestern der Rohstoffsektor die treibende Kraft hinter den Kursbewegungen war und heute die Währungen diese Rolle übernehmen, konfiguriert sich ST-Expert neu und verlagert die Gewichtung zwischen seinen Experten.
- Robustheit. Wenn einer der Experten falsch liegt, bleibt die Qualität der Gesamtprognose dank der kollektiven Abstimmung erhalten. Dadurch sinkt das Risiko einer übermäßigen Festlegung auf eine einzige Strategie, und das System wird robuster.
- Interpretierbarkeit. Für einen Trader ist es wichtig, nicht nur das Ergebnis einer Prognose zu verstehen, sondern auch die Gründe dafür. In ST-Expert können Sie jederzeit sehen, welcher Experte den größten Beitrag geleistet hat und welche Beziehungen sich als aussagekräftig erwiesen haben. Damit ist das System keine „Black Box“, sondern ein Werkzeug, das bewusst eingesetzt werden kann.
Aus Sicht des Handels ist ST-Expert nicht nur ein Indikator, sondern ein komplettes Navigationssystem. Es berücksichtigt Trendbewegungen, erfasst lokale Impulse, analysiert Korrelationen zwischen Vermögenswerten und erstellt in Echtzeit eine Karte des Marktes. Zudem kann das System diese Karte aktualisieren, wenn sich vertraute Routen als versperrt erweisen. Im praktischen Handel bedeutet dies weniger Fehlsignale und mehr Entscheidungen, die die tatsächliche Marktdynamik widerspiegeln.
Die Architektur des Frameworks umfasst mehrere Schlüsselelemente. Im Mittelpunkt steht ein Graphenmodell, in dem Knoten Vermögenswerte oder Zeitpunkte darstellen und Kanten die Verbindungen zwischen ihnen. Diese Zusammenhänge können direkt und offensichtlich sein, wie beispielsweise die Abhängigkeit des Goldpreises vom Dollar-Wechselkurs, oder aber versteckt, wie beispielsweise Korrelationen zwischen einzelnen Aktien innerhalb einer Branche. Das System dient nicht nur dazu, diese Verbindungen zu identifizieren, sondern auch dazu, sie neu zu konfigurieren, wenn der Markt neue Bedingungen vorgibt.
Das Modul zur adaptiven Graphenkombination spielt eine entscheidende Rolle. Man kann es mit einem Orchesterdirigenten vergleichen. Jedes Instrument hat seinen eigenen Part, doch der Dirigent entscheidet, welche Stimme im richtigen Moment lauter erklingen soll. Wenn manche Beziehungen an Bedeutung verlieren, stärkt das System andere und gewährleistet so die Integrität der Prognose.
Ebenso wichtig ist der Trainingsmechanismus von ST-Expert. Er ist so konzipiert, dass das System mit verschiedenen Szenarien vertraut wird. Dadurch ist das System auf neue Situationen vorbereitet – sei es ein plötzlicher Anstieg des Nachrichtenaufkommens, eine Verschiebung der Korrelationen oder das Aufkommen neuer Markttreiber. Aus Sicht des Handels entspricht dies der Vorbereitung auf jedes mögliche Marktszenario: von einem ruhigen Seitwärtsmarkt bis hin zu einem turbulenten Trend.
Nachfolgend ist die vom Autor erstellte Visualisierung des ST-Expert-Frameworks zu sehen.
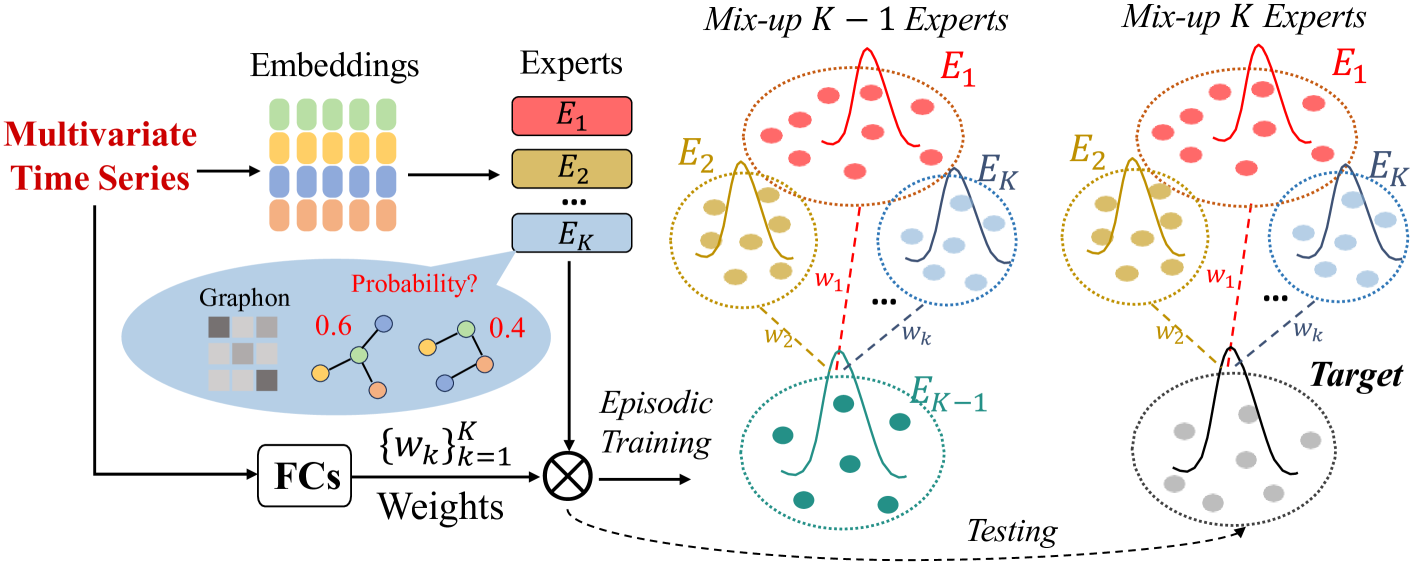
Im vorherigen Artikel haben wir uns nicht auf die Theorie beschränkt, sondern den ersten Schritt zur praktischen Umsetzung der ST-Expert-Ansätze mithilfe von MQL5 unternommen. Wir haben ein Objekt zur Erzeugung von Graphons entwickelt – eine Schlüsselkomponente der Architektur, die für die Modellierung probabilistischer Beziehungen zuständig ist. Diese zentrale Komponente schafft die Voraussetzungen für die adaptive Analyse räumlicher Strukturen.
Heute setzen wir die Arbeit fort, die wir begonnen haben. Unser Ziel ist es, das Framework Schritt für Schritt weiterzuentwickeln und es von einer Sammlung von Ideen in ein vollwertiges Werkzeug für den algorithmischen Handel zu verwandeln.
Anwendungsideen
Bevor wir nun mit der Arbeit am Modell fortfahren, lohnt es sich, noch einmal auf ein weiteres wichtiges Merkmal des ST-Expert-Frameworks hinzuweisen – nämlich seine Vielseitigkeit. Die Autoren des Frameworks betonen, dass die von ihnen vorgeschlagenen Ansätze nicht auf die Anwendung in graphenbasierten Modellen beschränkt sind. Im Gegenteil, sie lassen sich in eine Vielzahl klassischer Modelle integrieren, wodurch diese erweitert und mit neuen Eigenschaften ausgestattet werden. Im Wesentlichen geht es hier um Modularität. ST-Expert lässt sich als eine Reihe adaptiver Komponenten betrachten, die sowohl eigenständig als auch als Teil größerer Systeme betrieben werden können.
Diese Vielseitigkeit ist insbesondere im Finanzbereich von großem Wert. Schließlich beschränkt sich ein Händler oder Forscher selten auf ein einziges Modell – in den meisten Fällen greift er auf eine ganze Reihe von Instrumenten zurück. Die Möglichkeit, Ansätze von ST-Expert in diese Werkzeuge zu integrieren, eröffnet neue Experimentiermöglichkeiten. Sie können ihre Robustheit gegenüber räumlichen Verteilungsverschiebungen verbessern, ihre Analysefähigkeiten erweitern oder ihnen eine neue Ebene der Interpretierbarkeit verleihen.
In dieser Arbeit haben wir uns entschlossen, diesen speziellen Ansatz weiterzuverfolgen. Das Framework Extralonger wurde als experimentelle Grundlage ausgewählt. Es basiert auf dem Ansatz, lokale und globale Faktoren zu kombinieren, was eine genauere Modellierung komplexer Prozesse auf dem Finanzmarkt ermöglicht.
Die Integration von ST-Expert und Extralonger erscheint als logischer Schritt. Der erste Ansatz führt einen Mechanismus für die Arbeit mit dynamischen Graphen sowie eine Mixture of Experts ein, die sich an Veränderungen in der Verbindungsstruktur anpassen kann. Der zweite Ansatz bietet eine bewährte Umgebung für die Arbeit mit Zeitreihen sowie bereits implementierte Module für die raumzeitliche Analyse. Zusammen bilden sie eine Symbiose, in der sich beide Seiten gegenseitig stärken. Extralonger gewinnt ein zusätzliches Maß an Anpassungsfähigkeit und Robustheit, während ST-Expert eine bewährte Plattform für die Integration in den algorithmischen Handel erhält.
Stellen wir uns einmal vor, wie das in der Praxis aussehen könnte. Angenommen, Extralonger analysiert das Verhalten eines Währungspaares und erstellt auf der Grundlage der zeitlichen Dynamik eine Prognose. Irgendwann beginnen jedoch die Rohstoffpreise oder Aktienindizes, einen erheblichen Einfluss auf den Markt auszuüben. Wenn Sie nur die Grundfunktionen von Extralonger nutzen, bleibt eine solche Veränderung der maßgeblichen Einflussfaktoren möglicherweise unbemerkt. Die integrierten ST-Expert-Module, die mit Graphons und Expertenblöcken arbeiten, werden jedoch die neuen Verbindungen erfassen und das Bild neu gestalten. Daher bleibt die Prognose auch dann zutreffend, wenn sich die Marktbedingungen drastisch verändert haben.
Um von einer Idee zur praktischen Umsetzung zu gelangen, müssen die Integrationspunkte ermittelt werden. Ich möchte Sie daran erinnern, dass das Extralonger-Framework auf einem modular aufgebauten Transformer mit drei Verarbeitungspfaden basiert. Es kombiniert drei Arten der Analyse: zeitliche, räumliche und gemischte. Jeder dieser Verarbeitungspfade ist für eine eigene Ebene der Auswertung von Marktdaten zuständig, und durch ihr Zusammenspiel lässt sich eine umfassende Prognose erstellen.
Die zeitliche Analyse in Extralonger erfolgt mithilfe eines klassischen Transformers, der Datensequenzen verarbeitet und Muster aus Zeitreihen extrahiert. Dieses Modul ist wie ein Fundament – es schafft eine solide Grundlage für die Analyse, indem es bekannte dynamische Zusammenhänge aufzeigt.
Die räumliche Analyse basiert auf einem global-lokalen Ansatz. Hier betrachtet die Architektur den Markt als ein Netzwerk miteinander verbundener Knoten, in dem benachbarte Elemente lokale Muster bilden, während entfernte Verbindungen eine globale Perspektive bieten. Dieser Ansatz ist insbesondere im Finanzkontext von Bedeutung, wo Finanzinstrumente entweder direkt oder über komplexere Mechanismen miteinander verknüpft sein können, etwa durch Zusammenhänge zwischen dem Technologiesektor und Aktienindizes (wie beispielsweise zwischen dem Technologiesektor und Aktienindizes).
Schließlich vereint der gemischte Verarbeitungspfad beide Ansätze – den zeitlichen und den räumlichen. Dadurch kann das Modell verschiedene Analyseebenen miteinander verknüpfen und so eine Art dreidimensionale Sichtweise schaffen. Damit ist Extralonger in der Lage, gleichzeitig Trenddynamiken zu verfolgen und Netzwerkabhängigkeiten zu berücksichtigen.
Genau hier bietet sich die Möglichkeit, ST-Expert zu integrieren. Seine Graphon-Experten lassen sich nahtlos in das Modul integrieren und verbessern so dessen Fähigkeit, sich verändernde Verknüpfungsstrukturen zu verarbeiten. Zudem passt die Idee einer Mischung von Experten (Mixture of Experts) perfekt zum modularen Aufbau von Extralonger, bei dem die Aufgaben bereits nach Verarbeitungspfaden aufgeteilt sind.
Beginnen wir mit dem zeitlichen Verarbeitungspfad. Es ist hilfreich, die Architektur eines klassischen Transformers mit einem Graphenmodell zu vergleichen. Der Self-Attention-Mechanismus erstellt im Wesentlichen eine Tabelle mit Logits, die den probabilistischen Einfluss jedes Elements in der Sequenz auf die anderen widerspiegelt. Betrachtet man die Elemente der Sequenz als Knoten, so wird die Tabelle mit Logits zu einem Graphen, in dem die Kanten die Stärke der gegenseitigen Beeinflussung darstellen. In diesem Sinne analysiert der Transformer nicht einfach nur eine Sequenz, sondern wandelt sie in ein dynamisches Netzwerk von Interaktionen um, wodurch es möglich wird, lokale und globale Abhängigkeiten zu erkennen, die andernfalls verborgen blieben.
Und das eröffnet eine interessante Möglichkeit. Wir können auf den herkömmlichen Mechanismus zur Erzeugung von Logits in der Self-Attention verzichten und stattdessen einen Graphen verwenden, der auf den Prinzipien des ST-Expert-Frameworks basiert. Dieser Ansatz ermöglicht es, aussagekräftigere Beziehungen zwischen Elementen einer Sequenz herzustellen, die auf statistischen Korrelationen, Expertenregeln und strukturierten Abhängigkeiten basieren. Wir gehen davon aus, dass das Modell den Markt besser verstehen kann, indem es subtile Zusammenhänge erfasst, die bei herkömmlicher Self-Attention möglicherweise übersehen werden.
Einen ähnlichen Ansatz können wir im Modul zur Analyse global-lokaler Abhängigkeiten anwenden. Hier bildet das Modell eine Art Marktgerüst, das allgemeine Muster und Trends erfasst. Globale Zusammenhänge helfen dabei, allgemeine Marktentwicklungen vorherzusagen, sodass das Modell den Wald und nicht nur die einzelnen Bäume sieht.
Lokale Abhängigkeiten erfordern jedoch einen anderen Ansatz. Wir müssen einen dünn besetzten Graphen erstellen, der nur die wichtigsten und wahrscheinlichsten Verbindungen zwischen den Sequenzknoten berücksichtigt. Dies ähnelt dem Ansatz eines erfahrenen Traders, der sich auf wichtige Ein- und Ausstiegspunkte konzentriert und dabei störende, unbedeutende Signale ignoriert. Die Methoden des ST-Expert-Frameworks lassen sich auch hier anwenden, wobei jedoch besonderes Augenmerk auf die Auswahl der wichtigsten Beziehungen zu legen ist. Dieser Ansatz ermöglicht es dem Modell, gleichzeitig den Überblick zu behalten und auf Details zu achten sowie Mikroeinflüsse zu erkennen, die kurzfristige Schwankungen maßgeblich beeinflussen.
Das Konzept ist klar. Nun ist es an der Zeit, von der Theorie zur Praxis überzugehen – diese Ideen mithilfe von MQL5 in die Tat umzusetzen.
Graph-Attention-Modul
Um die oben vorgeschlagene Graphon-basierte Transformer-Variante zu implementieren, erstellen wir ein CNeuronGraphAttention-Objekt, das die Grundfunktionalität von CNeuronBaseOCL erbt und zum Kern unseres Graph-Attention-Modells wird. Dieses Objekt verbindet nicht nur die herkömmliche Wertverarbeitung mit Graphstrukturen, sondern wandelt eine Datenfolge in ein dynamisches Beziehungsnetzwerk um.
class CNeuronGraphAttention   :  public CNeuronBaseOCL
  {
protected:
   CNeuronConvOCL    cValue;
   CNeuronGraphons   cGraphs;
   CNeuronSoftMaxOCL cScores;
   CNeuronBaseOCL    cAttention;
   CNeuronBaseOCL    cResidual;
   CNeuronConvOCL    cFeedForward[2];
   //---
   virtual bool      feedForward(CNeuronBaseOCL *NeuronOCL) override;
   virtual bool      updateInputWeights(CNeuronBaseOCL *NeuronOCL) override;
   virtual bool      calcInputGradients(CNeuronBaseOCL *NeuronOCL) override;

public:
                     CNeuronGraphAttention(void) {};
                    ~CNeuronGraphAttention(void) {};
   virtual bool      Init(uint numOutputs, uint myIndex, COpenCLMy *open_cl,
                          uint units, uint window, uint emb_dimension,
                          uint experts, float dropout,
                          ENUM_OPTIMIZATION optimization_type, uint batch);
   //---
   virtual int       Type(void) override const   {  return defNeuronGraphAttention;   }
   //--- methods for working with files
   virtual bool      Save(int const file_handle) override;
   virtual bool      Load(int const file_handle) override;
   //---
   virtual bool      WeightsUpdate(CNeuronBaseOCL *source, float tau) override;
   virtual void      SetOpenCL(COpenCLMy *obj) override;
   virtual void      SetActivationFunction(ENUM_ACTIVATION value) override { };
   virtual void      TrainMode(bool flag) override;
  };
Innerhalb des Modells definieren nach den ST-Expert-Prinzipien erstellte Graphen die Struktur der Beziehungen zwischen den Elementen in der Sequenz, wodurch wichtige Zusammenhänge identifiziert und Störsignale ignoriert werden können. Gleichzeitig erzeugt die SoftMax-Funktion eine probabilistische Attention-Verteilung über den Graphen und hebt dabei die wichtigsten Interaktionen hervor, während die Residualverbindungen sowohl neue als auch zuvor erfasste Abhängigkeiten bewahren und integrieren und so eine Art Modellgedächtnis schaffen.
Es ist wichtig zu beachten, dass wir innerhalb des Objekts vom üblichen Self-Attention-Schema abweichen und keine standardmäßigen Query- und Key-Entitäten bilden. Bei einem klassischen Transformer werden sie verwendet, um eine Matrix aus Logits zu bilden, die die gegenseitige Beeinflussung der Elemente in der Sequenz widerspiegelt. In unserem Ansatz wird diese Funktion jedoch von einem Graphen übernommen, der nach den Prinzipien von ST-Expert konstruiert wird. Auf diese Weise können wir die Beziehungen zwischen den Knoten direkt verwalten und uns auf die wichtigsten Interaktionen konzentrieren, ohne unnötige Zwischentabellen erstellen zu müssen. In diesem Fall bleiben nur die Value-Werte übrig, die zur Erzeugung der endgültigen Attention-Ergebnisse verwendet werden. Wie Rohmaterial in den Händen eines erfahrenen Handwerkers durchlaufen sie Graph- und FeedForward-Blöcke und verwandeln sich so in aussagekräftige Signale für Marktprognosen.
Dieser Ansatz ermöglicht es dem Modell, gezielter zu arbeiten. Die Attention konzentriert sich auf die entscheidenden Beziehungen, die für die Finanzzeitreihe wirklich wichtig sind, anstatt sich gleichmäßig auf alle Elemente zu verteilen. So erhalten wir einen Mechanismus, der die Leistungsfähigkeit des Transformers bewahrt und gleichzeitig eine wesentlich aussagekräftigere und strukturiertere Interpretation der Beziehungen innerhalb der Sequenz ermöglicht.
Die Methode Init ist dafür zuständig, das CNeuronGraphAttention-Objekt für die Verwendung vorzubereiten. Hier fügt sich das Modell wie ein fein abgestimmter Mechanismus zusammen und ist bereit, Finanzdaten zu verarbeiten.
bool CNeuronGraphAttention::Init(uint numOutputs, uint myIndex, COpenCLMy *open_cl,
                                 uint units, uint window, uint emb_dimension,
                                 uint experts, float dropout,
                                 ENUM_OPTIMIZATION optimization_type, uint batch)
  {
   if(!CNeuronBaseOCL::Init(numOutputs, myIndex, open_cl, units * window, optimization_type, batch))
      return false;
   activation = None;
Zunächst wird die Initialisierung der übergeordneten Klasse aufgerufen, in der die allgemeinen Parameter des Neurons festgelegt werden. Anschließend werden die internen Komponenten des Objekts nacheinander konfiguriert.
Der cValue-Block wird zuerst initialisiert; er ist für die anfängliche Kodierung der Werte der Sequenz zuständig. Das Analysefenster und die Anzahl der Elemente in der zu analysierenden Sequenz werden festgelegt. Die Aktivierungsfunktion wird deaktiviert, damit die Daten so unverfälscht wie möglich weitergeleitet werden können.
   int index = 0;
   if(!cValue.Init(0, index, OpenCL, window, window, window, units, 1, optimization, iBatch))
      return false;
   cValue.SetActivationFunction(None);
Anschließend wird ein Graphon-Block namens cGraphs erstellt, der nach den Prinzipien von ST-Expert aufgebaut ist und die Struktur der Beziehungen zwischen den Elementen der Sequenz definiert.
   index++;
   if(!cGraphs.Init(0, index, OpenCL, units, window, emb_dimension, experts, dropout, optimization, iBatch))
      return false;
Die Ausgabe des cGraphs-Moduls ist ein Graph, der die Wahrscheinlichkeiten der Verbindungen zwischen den Knoten der Sequenz widerspiegelt. Das sind zwar bereits wertvolle Informationen, doch für das Attention-Modul müssen wir diese Wahrscheinlichkeiten in eine vollständige Verteilung des Einflusses umwandeln, den jedes Element in der Sequenz auf das zu analysierende Objekt ausübt. An dieser Stelle kommt der cScores-Block mit der SoftMax-Funktion ins Spiel. Er normalisiert die Wahrscheinlichkeiten sorgfältig, stärkt dabei die wichtigsten Verbindungen und schwächt nachrangige ab, wodurch eine genaue und interpretierbare Attention-Verteilung entsteht. Dadurch wird jedem Sequenzelement in der Analyse ein eigenes Gewicht, das seine Bedeutung für die Analyse ausdrückt, zugewiesen, und das Modell kann sich auf wirklich signifikante Wechselwirkungen konzentrieren, während Rauschen und unbedeutende Schwankungen ignoriert werden.
Dieser Ansatz ermöglicht es, die von ST-Expert erstellten graphenbasierten Verbindungen nahtlos in den klassischen Attention-Mechanismus zu integrieren und so abstrakte Wahrscheinlichkeiten in konkrete Signale umzuwandeln, die für die weitere Verarbeitung und die Prognose von Finanzzeitreihen bereitstehen.
   index++;
   if(!cScores.Init(0, index, OpenCL, units * units, optimization, iBatch))
      return false;
   cScores.SetHeads(units);
Anschließend werden die Blöcke cAttention und cResidual so konfiguriert, dass sie die Ergebnisse des Attention-Mechanismus und der Residualverbindungen speichern. Auch für diese Blöcke wird die Aktivierung deaktiviert, um Signalverzerrungen zu vermeiden.
   index++;
   if(!cAttention.Init(0, index, OpenCL, Neurons(), optimization, iBatch))
      return false;
   cAttention.SetActivationFunction(None);
   index++;
   if(!cResidual.Init(0, index, OpenCL, Neurons(), optimization, iBatch))
      return false;
   cResidual.SetActivationFunction(None);
Abschließend werden zwei aufeinanderfolgende Schichten des FeedForward-Blocks konfiguriert. Die erste Schicht verwendet die SoftPlus-Aktivierung, wodurch die Nichtlinearität des Modells und seine Fähigkeit zur Erkennung komplexer Zusammenhänge erhöht werden, während die zweite die Informationen ohne zusätzliche Aktivierung komprimiert und in das endgültige Attention-Signal umwandelt.
   index++;
   if(!cFeedForward[0].Init(0, index, OpenCL, window, window, 2 * window, units, 1, optimization, iBatch))
      return false;
   cFeedForward[0].SetActivationFunction(SoftPlus);
   index++;
   if(!cFeedForward[1].Init(0, index, OpenCL, cFeedForward[0].GetFilters(), cFeedForward[0].GetFilters(),
                                                                  window, units, 1, optimization, iBatch))
      return false;
   cFeedForward[1].SetActivationFunction(None);
//---
   return true;
  }
Dadurch bindet die Init-Methode alle Komponenten nahtlos in ein einziges System ein. Die Blöcke zur Value-Verarbeitung, die Graphen, die Attention-Verteilung und die FeedForward-Schichten sind nun betriebsbereit und bilden einen voll funktionsfähigen Graph-Attention-Mechanismus, der die Dynamik von Finanzzeitreihen effektiv analysieren kann.
Nach der Initialisierung des Objekts folgt im Modellablauf der Vorwärtsdurchlauf, der in der Methode feedForward implementiert ist.
bool CNeuronGraphAttention::feedForward(CNeuronBaseOCL *NeuronOCL)
  {
   if(!cValue.FeedForward(NeuronOCL))
      return false;
Dies ist eine Reise durch eine komplexe und dynamische Finanzlandschaft. Alles beginnt mit dem cValue-Objekt, das als Späher fungiert. Es untersucht jedes Marktsignal sorgfältig und wandelt Rohdaten in eine leicht analysierbare Darstellung um – so, als würde man vor einer Wanderung das Gelände kartieren.
Als Nächstes kommt das Graphmodul cGraphs ins Spiel, das Verbindungen für Interaktionen zwischen den Knoten der Sequenz aufbaut.
   if(!cGraphs.FeedForward(NeuronOCL))
      return false;
Man kann sich das wie ein Netz aus Straßen und Wegen auf dieser Karte vorstellen, wobei jede Verbindung die Stärke des Einflusses eines Elements auf ein anderes darstellt. Der cScores-Block mit SoftMax fungiert als Expeditionsleiter und legt fest, welche Pfade am wichtigsten sind und welche zuerst eingeschlagen werden sollten. Er wandelt die rohen Verbindungswahrscheinlichkeiten in eine klare Strategie für das weitere Vorgehen um, hebt wichtige Interaktionen hervor und ignoriert unbedeutende Störsignale.
   if(!cScores.FeedForward(cGraphs.AsObject()))
      return false;
Sobald die Erkundung abgeschlossen ist, werden die Informationen aus cValue und die Attention-Verteilung mittels Matrixmultiplikation kombiniert, wodurch die Ergebnisse des Attention-Moduls in cAttention entstehen. Das ist so, als würde man alle Erkundungsdaten auf einer einzigen Karte zusammenfassen, um zu erkennen, welche Kräfte und Einflüsse auf das untersuchte Objekt einwirken.
   if(!MatMul(cScores.getOutput(), cValue.getOutput(), cAttention.getOutput(),
              cValue.GetUnits(), cValue.GetUnits(), cValue.GetFilters(), 1, false))
      return false;
Im nächsten Schritt werden die Daten mit dem Residualsignal kombiniert und in cResidual normalisiert, wodurch die Daten stabilisiert werden und verhindert wird, dass zufällige Schwankungen das Modell aus der Bahn werfen.
   if(!SumAndNormilize(NeuronOCL.getOutput(), cAttention.getOutput(), cResidual.getOutput(),
                       cValue.GetFilters(), true, 0, 0, 0, 1))
      return false;
Anschließend übernimmt der FeedForward-Block die Verarbeitung und wirkt dabei wie ein Team erfahrener Analysten der Expedition. Das erste Modul mit SoftPlus-Aktivierung deckt verborgene wechselseitige Abhängigkeiten auf und verstärkt wichtige Signale – ähnlich wie Forscher, die auf einer Karte genau bestimmen, wo wichtige Ressourcen verborgen sind. Das zweite Modul wandelt die Informationen in eine kompakte und interpretierbare Darstellung um, die für Prognosen genutzt werden kann.
   if(!cFeedForward[0].FeedForward(cResidual.AsObject()))
      return false;
   if(!cFeedForward[1].FeedForward(cFeedForward[0].AsObject()))
      return false;
   if(!SumAndNormilize(cFeedForward[1].getOutput(), cResidual.getOutput(), Output,
                       cFeedForward[1].GetFilters(), true, 0, 0, 0, 1))
      return false;
//---
   return true;
  }
Bei der abschließenden Normalisierung werden die Residualdaten mit den FeedForward-Ergebnissen kombiniert, wodurch das endgültige Signal entsteht, das die Sicht des Modells auf den Markt widerspiegelt – sowohl im Überblick als auch im Detail.
Letztendlich wandelt die feedForward-Methode eine komplexe Abfolge von Finanzdaten in strukturiertes, aussagekräftiges Wissen um, das für Prognosen genutzt werden kann.
Der Vorwärtsdurchlauf ist nur der erste Teil der Arbeit des Modells. Um wirklich aussagekräftige Vorhersagen zu erhalten, ist ein Prozess zur Fehleranalyse erforderlich, der in der Methode calcInputGradients implementiert ist.
bool CNeuronGraphAttention::calcInputGradients(CNeuronBaseOCL *NeuronOCL)
  {
   if(!NeuronOCL)
      return false;
Diese Phase lässt sich als eine Art Rückweg entlang der bereits zurückgelegten Strecke betrachten, bei dem das Modell bewertet, welche Entscheidungen richtig waren und wo Abweichungen auftraten.
Der Prozess beginnt mit dem letzten FeedForward-Block des Vorwärtsdurchlaufs, in dem das Signal die inverse Aktivierung durchläuft, um die Fehlergradienten korrekt zu berechnen.
   if(!DeActivation(cFeedForward[1].getOutput(), cFeedForward[1].getGradient(),
                    Gradient, cFeedForward[1].Activation()))
      return false;
   if(!cFeedForward[0].CalcHiddenGradients(cFeedForward[1].AsObject()))
      return false;
   if(!cResidual.CalcHiddenGradients(cFeedForward[0].AsObject()))
      return false;
Die Gradienten werden anschließend an die erste Schicht des Blocks und an den Residualblock cResidual weitergeleitet, wodurch Anpassungen an den in den vorherigen Stufen verarbeiteten Informationen möglich sind. In dieser Phase werden die Gradienten summiert, was dazu beiträgt, die Robustheit des Modells zu erhalten und ein Auseinanderlaufen der Signale während der Fehlerrückpropagation zu verhindern.
   if(!SumAndNormilize(Gradient, cResidual.getGradient(), cAttention.getOutput(),
                       cValue.GetFilters(), false, 0, 0, 0, 1))
      return false;
Anschließend werden die Gradienten mittels Matrixmultiplikation durch den Block cScores für die Attention-Verteilung und den Block cValue weitergeleitet, wodurch die Stärke des Einflusses jedes Elements auf die anderen angepasst werden kann. Der Graphblock cGraphs erhält seine Gradienten und verfeinert anhand der kumulierten Fehler die Wahrscheinlichkeiten der Verbindungen zwischen den Knoten.
   if(!MatMulGrad(cScores.getOutput(), cScores.getGradient(),
                  cValue.getOutput(), cValue.getGradient(),
                  cAttention.getGradient(), cValue.GetUnits(),
                  cValue.GetUnits(), cValue.GetFilters(), 1, false))
      return false;
   if(!cGraphs.CalcHiddenGradients(cScores.AsObject()))
      return false;
An die Ebene der Eingabedaten im Objekt NeuronOCL werden dann die Gradienten aus dem Block cValue weitergeleitet, wo schließlich ermittelt wird, inwieweit jedes Element der Sequenz zum Fehler des Modells beigetragen hat.
   if(!NeuronOCL.CalcHiddenGradients(cGraphs.AsObject()))
      return false;
Es ist wichtig zu beachten, dass die Eingabedaten während des Vorwärtsdurchlaufs gleichzeitig drei Verarbeitungspfade durchlaufen: den Value-Block cValue, die Graphverbindungen von cGraphs und den Mechanismus der Residualverbindungen. Jeder dieser Verarbeitungspfade bildet einen eigenen Informationsfluss, der verschiedene Aspekte der Zusammenhänge innerhalb der Sequenz widerspiegelt.
Daher müssen während des Rückwärtsdurchlaufs die Gradienten aus allen drei Verarbeitungspfaden sorgfältig kombiniert werden. Das ist wie bei einer Expedition, bei der die Forscher nach ihrer Rückkehr von mehreren parallel verlaufenden Pfaden ihre Beobachtungen zusammenführen, um sich ein umfassendes Bild von der Landschaft zu verschaffen. Zunächst werden am Ausgang jedes Verarbeitungspfads Gradienten erzeugt. Anschließend werden sie unter Berücksichtigung der Residualverbindungen summiert, sodass die Informationen kohärent und ausgewogen bleiben. Erst nach einer solchen Integration erhält das Modell ein genaues Verständnis davon, wo die Fehler aufgetreten sind, welche Einflüsse unterschätzt und welche überschätzt wurden.
   if(!DeActivation(NeuronOCL.getOutput(), cResidual.getGradient(),
                    cAttention.getGradient(), NeuronOCL.Activation()))
      return false;
   if(!SumAndNormilize(NeuronOCL.getGradient(), cResidual.getGradient(), cResidual.getGradient(),
                       cValue.GetWindow(), false, 0, 0, 0, 1))
      return false;
   if(!NeuronOCL.CalcHiddenGradients(cValue.AsObject()))
      return false;
   if(!SumAndNormilize(NeuronOCL.getGradient(), cResidual.getGradient(), NeuronOCL.getGradient(),
                       cValue.GetWindow(), false, 0, 0, 0, 1))
      return false;
//---
   return true;
  }
Dank dieses Ansatzes lässt sich der Graph-Transformer effektiv trainieren. Es berücksichtigt sowohl globale als auch lokale Wechselwirkungen und passt diese über den gesamten Verarbeitungspfad hinweg an, nicht nur in einzelnen Abschnitten. Dadurch erhält jeder Knoten in der Sequenz eine faire Bewertung seiner Rolle beim Modellfehler, und der Trainingsprozess wird konsistent, stabil und möglichst aussagekräftig.
Das Training der Modellparameter ist in der Methode updateInputWeights implementiert, die den Betrieb des gesamten Systems koordiniert. In dieser Phase nimmt das Objekt selbst keine direkten Gewichtsanpassungen vor, sondern überträgt diese Aufgabe an seine internen Komponenten.
bool CNeuronGraphAttention::updateInputWeights(CNeuronBaseOCL *NeuronOCL)
  {
   if(!cValue.UpdateInputWeights(NeuronOCL))
      return false;
   if(!cGraphs.UpdateInputWeights(NeuronOCL))
      return false;
   if(!cFeedForward[0].UpdateInputWeights(cResidual.AsObject()))
      return false;
   if(!cFeedForward[1].UpdateInputWeights(cFeedForward[0].AsObject()))
      return false;
//---
   return true;
  }
Mit anderen Worten: Die Methode updateInputWeights fungiert wie ein Dirigent, der alle Musiker innerhalb des Objekts koordiniert. Jeder Block leistet seinen eigenen Beitrag, doch die Gesamtharmonie entsteht erst durch das gemeinsame Wirken aller Blöcke. Infolgedessen verbessert das Modell seine Vorhersagen schrittweise, indem es aus den während des Rückwärtsdurchlaufs identifizierten Fehlern lernt und die wesentlichen Beziehungen zwischen den Elementen in der Sequenz verstärkt.
Der vollständige Quellcode der Klasse CNeuronGraphAttention mit Implementierungen aller Methoden ist im Anhang enthalten. Er veranschaulicht, wie die konzeptionellen Ideen hinter der Graph-Attention in einen funktionsfähigen Mechanismus umgesetzt werden, der zur Analyse dynamischer Finanzzeitreihen bereit ist.
Sparse SoftMax
Der nächste Schritt besteht darin, einen dünn besetzten Graphen für das Modul für lokale Attention zu erstellen. Dabei muss das Objekt zur Graphenerzeugung nicht vollständig überarbeitet werden – minimale Änderungen reichen aus, während die grundlegende Architektur und die Funktionslogik erhalten bleiben. Im oben beschriebenen Graph-Attention-Modul wird der erzeugte Abhängigkeitsgraph am Ausgang mithilfe der SoftMax-Funktion in eine Wahrscheinlichkeitsverteilung umgewandelt, wodurch die bedeutenderen Wechselwirkungen hervorgehoben werden.
Bei der lokalen Attention können wir noch einen Schritt weiter gehen. Setzen wir die weniger wahrscheinlichen Verbindungen auf null und behalten nur die wesentlichen Wechselbeziehungen bei. Dieser Ansatz ermöglicht es, die Rechenressourcen auf die wichtigsten Wechselwirkungen zwischen den Knoten zu konzentrieren, was insbesondere bei der Analyse lokaler Schwankungen in Finanzzeitreihen von Bedeutung ist. In der Praxis ähnelt dies der Arbeit eines erfahrenen Analysten: Anstatt jedes Signal von geringer Aussagekraft zu untersuchen, konzentriert er sich ausschließlich auf die entscheidenden Faktoren, die den aktuellen Trend tatsächlich beeinflussen.
Um das Modell weiter zu optimieren, wird am Ausgang eine dünn besetzte Matrix erstellt, in der nur die aktiven, signifikanten Verbindungen gespeichert werden. Dadurch wird der Speicherbedarf erheblich reduziert und die Berechnungen werden beschleunigt, ohne dass dabei der Informationsgehalt beeinträchtigt wird. Dank der dünn besetzten Struktur kann das Modell große Zeitfenster und komplexe Sequenzen verarbeiten, ohne den Rechenblock zu überlasten, während die lokale Attention zu einem schnellen und präzisen Werkzeug zur Identifizierung von Mikroeinflüssen wird.
Letztendlich vereint dieser Ansatz zwei strategische Vorteile. Einerseits bleiben die durch ST-Expert-Graphen definierten globalen Verbindungen erhalten, was ein Verständnis des Gesamtmarktbildes ermöglicht; andererseits erlauben es die durch eine dünn besetzte Matrix identifizierten lokalen Verbindungen, sich auf besonders wichtige, feingranulare Interaktionen zu konzentrieren.
Wir beginnen mit der praktischen Umsetzung der dünn besetzten lokalen Attention, indem wir einen Sparse SoftMax-Algorithmus im OpenCL-Programm implementieren. Seine Aufgabe besteht darin, die aus dem Graphblock gewonnenen Verbindungswahrscheinlichkeiten in eine Attention-Verteilung umzuwandeln und dabei gleichzeitig weniger wichtige Elemente auf null zu setzen und eine dünn besetzte Matrix zu erzeugen.
__kernel void SparseSoftMax(__global const float *data,
                            __global float *outputs,
                            __global float *indexes,
                            const int out_dimension
                           )
  {
   const size_t row = get_global_id(0);
   const size_t col_in = get_local_id(1);
   const int total_rows = (int)get_global_size(0);
   const int total_cols_in = (int)get_local_size(1);
//---
   __local float Temp[LOCAL_ARRAY_SIZE];
   const int ls = min(total_cols_in, (int)LOCAL_ARRAY_SIZE);
Jeder Worker-Thread verarbeitet eine separate Zeile des Quelldaten-Arrays, wobei die Zeile die Wahrscheinlichkeiten der Knotenbeziehungen darstellt. Zunächst werden die Werte auf ihre Gültigkeit überprüft: NaN-Werte oder unendliche Werte werden ausgeschlossen und durch den Minimalwert ersetzt. Jeder Thread berechnet dann die Position seines Werts im Verhältnis zu den anderen Elementen in der Zeile. Gehört ein Wert zu den am wenigsten bedeutenden Werten, wird er auf null gesetzt.
   const int shift_in = RCtoFlat(row, col_in, total_rows, total_cols_in, 0);
//--- calc position
   float value = IsNaNOrInf(data[shift_in], MIN_VALUE);
   int position = 0;
   for(int l = 0; l < total_cols_in; l += ls)
     {
      if(col_in >= l && col_in < (l + ls))
         Temp[col_in - l] = value;
      BarrierLoc;
      for(int i = 0; i < ls; i++)
        {
         if(i == (col_in - l))
            continue;
         if(Temp[i] > value)
            position++;
         else
            if(Temp[i] == value && i < (col_in - l))
               position++;
        }
      BarrierLoc;
     }
Anschließend wird die klassische SoftMax-Funktion auf die verbleibenden Elemente angewendet, allerdings mit lokaler Normalisierung innerhalb von Untergruppen der Elemente.
//--- SoftMax
   if(position >= out_dimension)
      value = MIN_VALUE;
   value = LocalSoftMax(value, 1, Temp);
//--- result
   const int shift_out = RCtoFlat(row, position, total_rows, out_dimension, 0);
   if(position < out_dimension)
     {
      outputs[shift_out] = value;
      indexes[shift_out] = (float)col_in;
     }
  }
Dieser Ansatz ermöglicht es, nur die wichtigsten Zusammenhänge zu berücksichtigen und gleichzeitig die Stabilität der numerischen Berechnungen zu gewährleisten. Die Ausgabe ist eine dünn besetzte Matrix: Werte, die einen festgelegten Schwellenwert überschreiten, werden beibehalten, während alle anderen ignoriert werden, was das Datenvolumen deutlich reduziert und die Effizienz des Modells verbessert.
Das Endergebnis besteht aus zwei Arrays:
- outputs, das nur für signifikante Verbindungen normalisierte Werte enthält,
- indexes, das die Positionen dieser aktiven Elemente speichert.
Diese Informationen können direkt im Modul für lokale Attention verwendet werden, sodass sich das Modell auf kritische lokale Interaktionen zwischen Sequenzknoten konzentrieren kann, ohne den Speicher und die Rechenressourcen zu überlasten.
Im Hauptprogramm erstellen wir ein neues CNeuronSparseSoftMax-Objekt, das seine Grundfunktionalität von der CNeuronSoftMaxOCL-Schicht erbt und auf die Arbeit mit dünn besetzten Verteilungen spezialisiert ist. Im Gegensatz zum Standard-SoftMax ermöglicht dieses Objekt, die Attention ausschließlich auf die wichtigsten Verbindungen zwischen Elementen einer Sequenz zu richten und dabei den Speicherbedarf zu reduzieren und die Recheneffizienz zu verbessern.
class CNeuronSparseSoftMax    :  public CNeuronSoftMaxOCL
  {
protected:
   uint              iDimensionIn;
   CBufferFloat      cIndexes;
   //---
   virtual bool      feedForward(CNeuronBaseOCL *NeuronOCL) override;
   virtual bool      calcInputGradients(CNeuronBaseOCL *NeuronOCL) override;

public:
                     CNeuronSparseSoftMax(void) {};
                    ~CNeuronSparseSoftMax(void) {};
   //---
   virtual bool      Init(uint numOutputs, uint myIndex, COpenCLMy *open_cl,
                          uint units, uint dimension_in, uint dimension_out,
                          ENUM_OPTIMIZATION optimization_type, uint batch);
   //---
   virtual bool      Save(int const file_handle) override;
   virtual bool      Load(int const file_handle) override;
   virtual int       Type(void) override const { return defNeuronSparseSoftMax; }
   virtual void      SetOpenCL(COpenCLMy *obj) override;
   virtual CBufferFloat* GetIndexes(void)  { return GetPointer(cIndexes); }
   virtual uint      DimensionOut(void) const {  return uint(Neurons() / iHeads); }
  };
Die Klasse speichert Informationen über die Dimensionalität der Eingabedaten (iDimensionIn) sowie einen Puffer mit Indizes aktiver Verbindungen (cIndexes), deren Werte auf die Elemente verweisen, die bei der Bildung der Attention-Verteilung berücksichtigt werden. Die Methoden feedForward und calcInputGradients sind Wrapper für die Kernel des Vorwärts- und Rückwärtsdurchlaufs im OpenCL-Programm. Sie ermöglichen es dem Modell, Daten korrekt zu verarbeiten und aus Fehlern zu lernen, wobei nur aktive, aussagekräftige Verbindungen berücksichtigt werden.
Das Objekt wird in der Methode Init initialisiert, die das Modell für die Arbeit mit dünn besetzten Attention-Verteilungen vorbereitet.
bool CNeuronSparseSoftMax::Init(uint numOutputs, uint myIndex, COpenCLMy *open_cl,
                                uint units, uint dimension_in, uint dimension_out,
                                ENUM_OPTIMIZATION optimization_type, uint batch)
  {
   if(dimension_in < dimension_out)
      return false;
   if(!CNeuronSoftMaxOCL::Init(numOutputs, myIndex, open_cl, units * dimension_out, optimization_type, batch))
      return false;
Zunächst wird die Korrektheit der Eingabedimensionalität überprüft: dimension_in muss mindestens so groß sein wie dimension_out, damit das Modell die Verteilung korrekt bilden kann. Als Nächstes wird die Basisklasse initialisiert.
Anschließend wird die Anzahl der Attention-Köpfe festgelegt, die Dimensionalität der Eingabedaten gespeichert und der Indexpuffer cIndexes angelegt, um ausschließlich aktive, aussagekräftige Verbindungen zu speichern.
   SetHeads(units);
   iDimensionIn = dimension_in;
   if(!cIndexes.BufferInit(Neurons(), -1) ||
      !cIndexes.BufferCreate(OpenCL))
      return false;
//---
   return true;
  }
Der Puffer wird initialisiert und der dafür benötigte Speicher reserviert, wobei auch OpenCL zur Beschleunigung der Berechnungen unterstützt wird. Damit ist das Objekt vollständig betriebsbereit: Es kann Eingabedaten entgegennehmen, wichtige Verbindungen identifizieren und eine dünn besetzte Attention-Verteilung bilden, wobei es die Ressourcen effizient nutzt.
Somit wandelt CNeuronSparseSoftMax den dünn besetzten Graphen der lokalen Attention in eine zweckmäßige und effiziente Verteilung um, bei der sich die Attention auf die wichtigsten Verbindungen konzentriert. Dadurch kann das Modell gleichzeitig das durch den Hauptgraphen von ST-Expert definierte Gesamtbild beibehalten und lokale Einflüsse präzise berücksichtigen, wodurch detaillierte und aussagekräftige Prognosen für Finanzzeitreihen erstellt werden.
Um in unserem Modell die lokale Attention zu organisieren, reicht eine minimale, aber wirksame Änderung aus. Wir können das bereits implementierte Graph-Transformer-Objekt verwenden und dessen probabilistisches SoftMax-Projektionsmodul durch die dünn besetzte Variante CNeuronSparseSoftMax ersetzen. Dieser Ansatz ermöglicht es, einen kompletten Neuaufbau der gesamten Architektur zu vermeiden und dabei die globalen Graphverbindungen sowie die Blocklogik beizubehalten; gleichzeitig gewährleistet er eine präzise Identifizierung lokaler Wechselwirkungen.
Sparse SoftMax konzentriert sich auf die wichtigsten Verbindungen zwischen den Knoten, ignoriert dabei die weniger wichtigen und optimiert so die Nutzung von Speicher und Rechenressourcen.
class CNeuronSparseGraphAttention   :  public CNeuronBaseOCL
  {
protected:
   CNeuronConvOCL       cValue;
   CNeuronGraphons      cGraphs;
   CNeuronSparseSoftMax cScores;
   CNeuronBaseOCL       cAttention;
   CNeuronBaseOCL       cResidual;
   CNeuronConvOCL       cFeedForward[2];
   //---
   virtual bool      feedForward(CNeuronBaseOCL *NeuronOCL) override;
   virtual bool      updateInputWeights(CNeuronBaseOCL *NeuronOCL) override;
   virtual bool      calcInputGradients(CNeuronBaseOCL *NeuronOCL) override;

public:
                     CNeuronSparseGraphAttention(void) {};
                    ~CNeuronSparseGraphAttention(void) {};
   virtual bool      Init(uint numOutputs, uint myIndex, COpenCLMy *open_cl,
                          uint units, uint window, uint experts, float dropout,
                          uint emb_dimension, uint sparse_dimension,
                          ENUM_OPTIMIZATION optimization_type, uint batch);
   //---
   virtual int       Type(void) override const   {  return defNeuronSparseGraphAttention;   }
   //--- methods for working with files
   virtual bool      Save(int const file_handle) override;
   virtual bool      Load(int const file_handle) override;
   //---
   virtual bool      WeightsUpdate(CNeuronBaseOCL *source, float tau) override;
   virtual void      SetOpenCL(COpenCLMy *obj) override;
   virtual void      SetActivationFunction(ENUM_ACTIVATION value) override { };
   virtual void      TrainMode(bool flag) override;
  };
Der vollständige Code für alle vorgestellten Klassen sowie die Implementierung ihrer jeweiligen Methoden sind im Anhang zu diesem Artikel verfügbar.
Wir haben viel Arbeit geleistet und bedeutende Ergebnisse erzielt. Jetzt ist der perfekte Zeitpunkt für eine kurze Pause, damit die Informationen verarbeitet werden und im Gedächtnis bleiben. Im nächsten Artikel werden wir dort weitermachen, wo wir aufgehört haben, uns der Bewertung der Wirksamkeit der implementierten Lösungen zuwenden und untersuchen, wie gut das Modell die Analyse von Finanzzeitreihen bewältigt.
Fazit
Im Rahmen unserer Arbeit haben wir einen anspruchsvollen Weg zurückgelegt, die Graph-Transformer-Architektur untersucht und ihre Schlüsselkomponenten gemeistert: Value-Blöcke, Abhängigkeitsgraphen und die Attention-Verteilung. Jedes dieser Elemente trug seinen Teil dazu bei, ähnlich wie die Mitglieder einer Expedition, die gemeinsam daran arbeiten, einen Weg durch die komplexe und sich ständig verändernde Landschaft des Finanzmarktes zu finden.
Besonderes Augenmerk haben wir auf die Implementierung von Sparse SoftMax für die lokale Attention gelegt. Dieses Werkzeug ermöglichte es dem Modell, die wichtigsten Korrelationen zu identifizieren und dabei weniger bedeutende Signale zu ignorieren, wodurch es Ressourcen schonte und die Genauigkeit erhöhte, mit der es durch die Marktdynamik navigiert. Vorwärts- und Rückwärtsdurchläufe sowie Gewichtsaktualisierungen sorgten für eine kontinuierliche Kurskorrektur, sodass das Modell aus seinen Fehlern lernen und seine Vorhersagen schrittweise verbessern konnte.
Die erzielten Ergebnisse bildeten eine solide Grundlage für die weitere Forschung. Im nächsten Artikel werden wir unsere Untersuchung fortsetzen, indem wir die Wirksamkeit der implementierten Lösungen bewerten, die Genauigkeit der Prognosen analysieren und ermitteln, wie gut das Modell die Dynamik der Finanzzeitreihen abbildet.
Links
In diesem Artikel verwendete Programme
| # | Name | Typ | Beschreibung |
|---|---|---|---|
| 1 | Study.mq5 | Expert Advisor | Expert Advisor für das Offline-Modelltraining |
| 2 | StudyOnline.mq5 | Expert Advisor | Expert Advisor für Online-Modelltraining |
| 3 | Test.mq5 | Expert Advisor | Expert Advisor für Modelltests |
| 4 | Trajectory.mqh | Klassenbibliothek | Struktur zur Beschreibung des Systemzustands und der Modellarchitektur |
| 5 | NeuroNet.mqh | Klassenbibliothek | Klassenbibliothek zum Erstellen eines neuronalen Netzes |
| 6 | NeuroNet.cl | Bibliothek | Codebibliothek für ein OpenCL-Programm |
Übersetzt aus dem Russischen von MetaQuotes Ltd.
Originalartikel: https://www.mql5.com/ru/articles/19624
Warnung: Alle Rechte sind von MetaQuotes Ltd. vorbehalten. Kopieren oder Vervielfältigen untersagt.
Dieser Artikel wurde von einem Nutzer der Website verfasst und gibt dessen persönliche Meinung wieder. MetaQuotes Ltd übernimmt keine Verantwortung für die Richtigkeit der dargestellten Informationen oder für Folgen, die sich aus der Anwendung der beschriebenen Lösungen, Strategien oder Empfehlungen ergeben.



Der Artikel „Neuralnetze im Trading: Zuverlässige Handelssignale in allen Marktphasen (Aufmerksamkeitsmodule)“ wurde veröffentlicht:
Autor: Dmitriy Gizlyk