

Neuronale Netze im Handel: Eine einheitliche Sicht auf Raum und Zeit (global-lokale Attention)
 15
 0

Einleitung
Die Finanzmärkte sind ein komplexes und dynamisches System, in dem Raum und Zeit eng miteinander verflochten sind. Jede Kursbewegung spiegelt nicht nur das momentane Gleichgewicht zwischen Angebot und Nachfrage wider, sondern auch die Spuren früherer Ereignisse sowie den Einfluss verwandter Finanzinstrumente, Sektoren und sogar ganzer Volkswirtschaften. Die Vorhersage des Verhaltens eines solchen Systems mit herkömmlichen Methoden war schon immer eine äußerst komplexe Aufgabe. Statistische Modelle und klassische neuronale Netze schnitten bei der Kurzfristprognose recht gut ab, verloren jedoch an Stabilität und Genauigkeit, sobald der Prognosehorizont über einige Stunden hinausging. Das Hauptproblem bestand darin, dass zeitliche und räumliche Faktoren getrennt betrachtet wurden. Versuche, diese zu kombinieren, führten jedoch zu einem explosionsartigen Anstieg des Rechenaufwands.
Das Extralonger-Framework, mit dem wir uns im vorherigen Artikel erstmals beschäftigt haben, bot einen grundlegend anderen Ansatz. Die Autoren ließen sich von der Vorstellung leiten, dass Raum und Zeit als ein einziges Ganzes betrachtet werden sollten. Diese Philosophie, die an Einsteins Relativitätstheorie anknüpft, fand ihren Ausdruck in der einheitlichen räumlich-zeitlichen Repräsentation – einer Repräsentation, in der Zeitreihen und räumliche Beziehungen ohne künstliche Trennung miteinander verknüpft sind. Diese Lösung führte zu einer drastischen Verringerung der Rechenkomplexität. Während die Anzahl der Rechenoperationen zuvor exponentiell wuchs, reduzierte Extralonger dieses Wachstum auf einen quadratischen Zusammenhang. Die praktischen Ergebnisse waren beeindruckend. Das Training wurde mehrere Hundert Male schneller., der Speicherbedarf wurde um ein Vielfaches reduziert, und vor allem wurde es möglich, Prognosen zu erstellen, die sich nicht nur über Stunden, sondern über ganze Tage und sogar Wochen erstrecken.
Dies eröffnet neue Möglichkeiten für die Finanzmärkte. Während sich Händler und Analysten bisher in der Regel auf kurzfristige Einschätzungen beschränkt haben, besteht nun die Möglichkeit, mehrere Handelssitzungen vorauszublicken oder Marktbewegungen im Zusammenhang mit der Veröffentlichung makroökonomischer Daten und mit Zentralbankentscheidungen vorherzusagen. Extralonger macht aus der Wochenprognose als unerreichbarem Traum ein praktisch nutzbares Werkzeug.
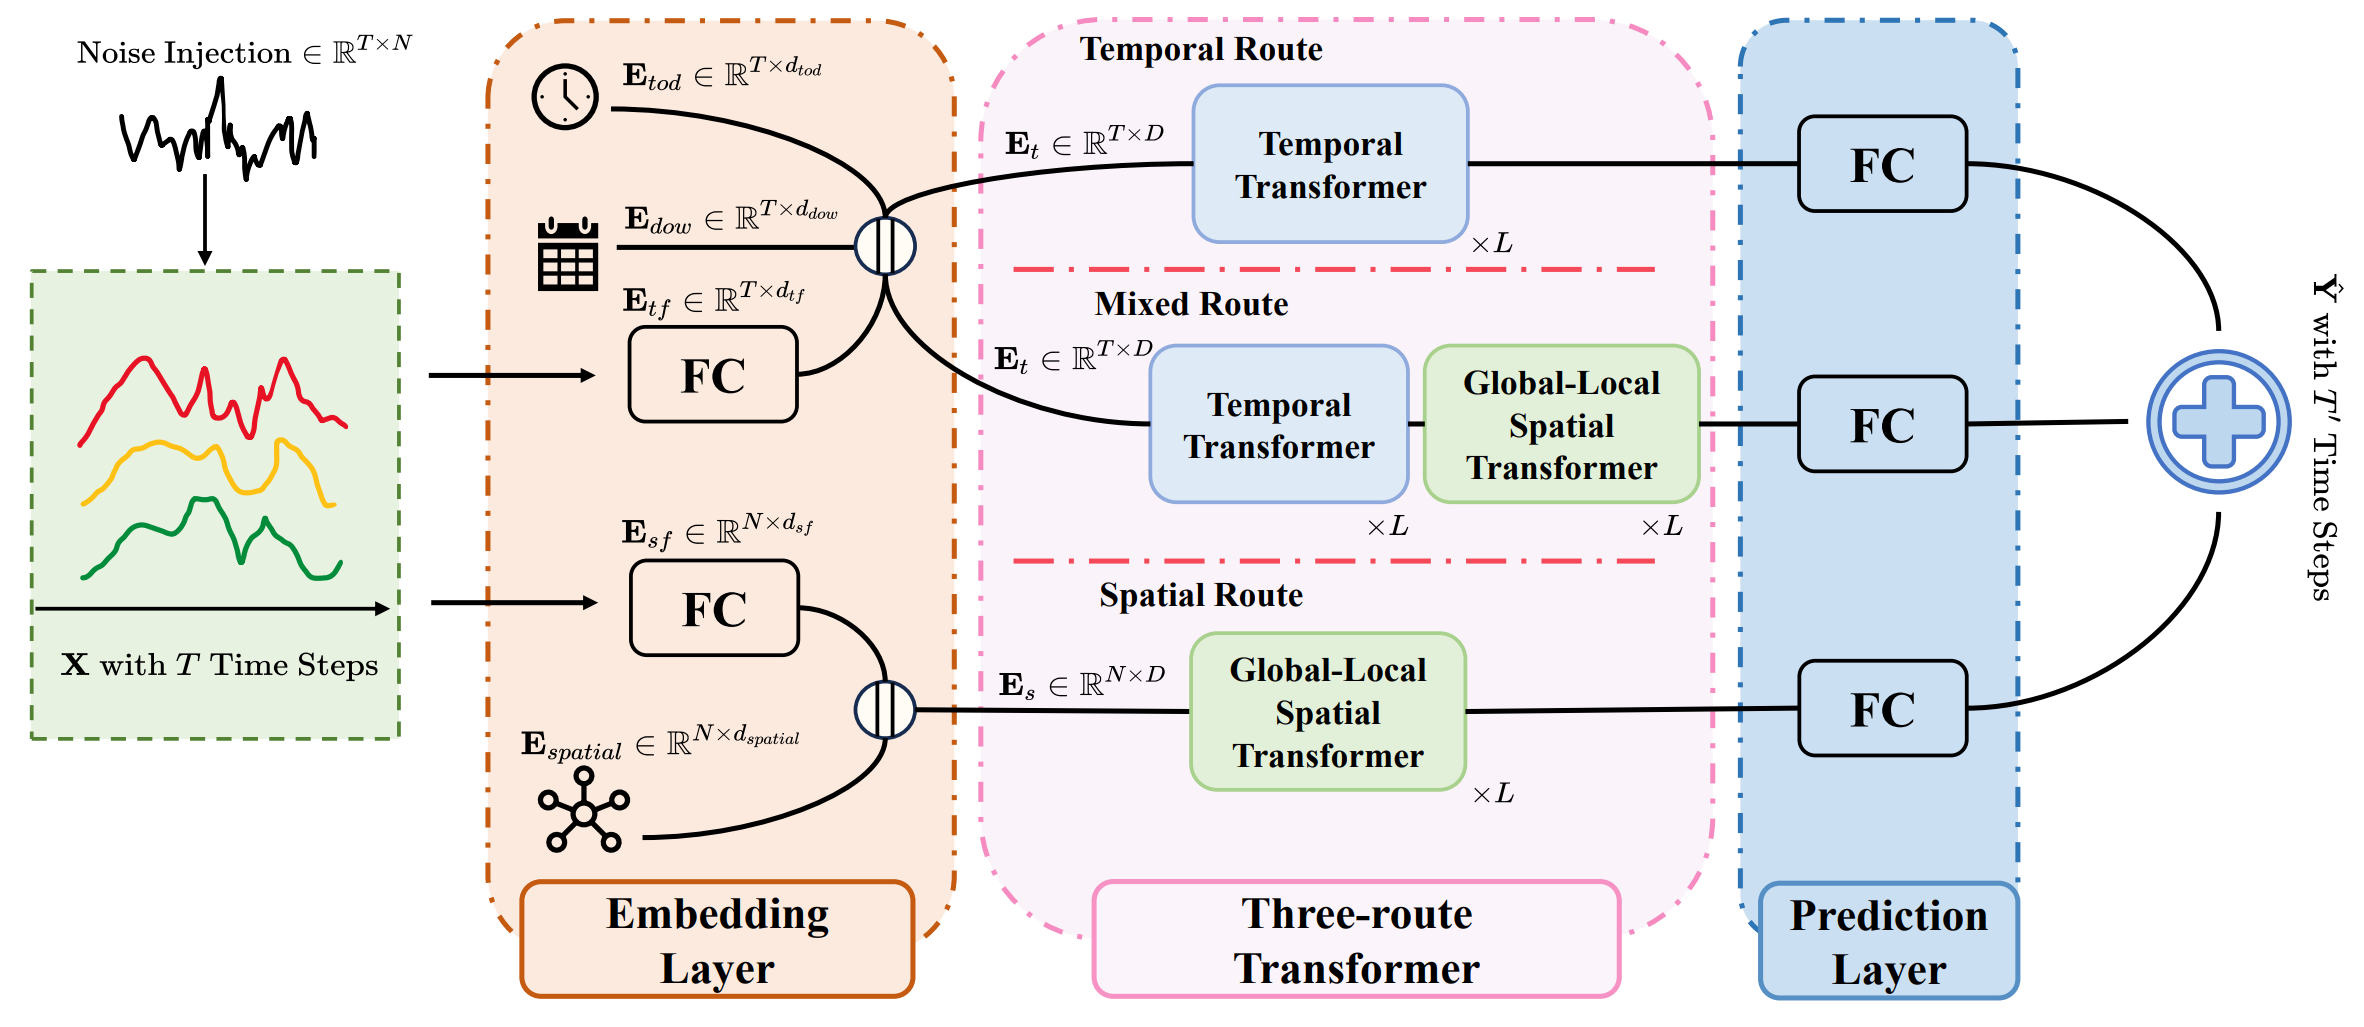
Die wahre Stärke des Frameworks zeigt sich jedoch in seiner Architektur. Es basiert auf einem Transformer mit drei Zweigen, wobei jeder Zweig für einen bestimmten Aspekt der Analyse zuständig ist.
Der zeitliche Zweig lässt sich mit einem makroökonomischen Analysten vergleichen. Er untersucht Marktrhythmen, erkennt Wachstums- und Rückgangszyklen und deckt saisonale Schwankungen sowie wiederkehrende Muster auf. Mithilfe des Self-Attention-Mechanismus verknüpft das Modell weit voneinander entfernte Segmente der Zeitreihe. Die aktuelle Kursentwicklung des Währungspaares könnte eine Fortsetzung des Trends sein, der vor einem Monat eingesetzt hat.
Der räumliche Zweig fungiert als Spezialist für marktübergreifende Beziehungen. Auf den Finanzmärkten existiert kein Vermögenswert isoliert. Die Entwicklung des Goldpreises spiegelt sich in den Aktienindizes wider. Der Dollarkurs wirkt sich auf die Rohstoffmärkte aus. Die Anleiherenditen geben wiederum den Ton für die Aktienmärkte an. Extralonger berücksichtigt dies mithilfe des global-lokalen räumlichen Transformers, der zwei Perspektiven miteinander verbindet: eine globale, bei der jedes Wertpapier mit allen anderen verknüpft ist, und eine lokale, bei der der Fokus auf Clustern von Vermögenswerten liegt, die nach Branchen oder Regionen gruppiert sind.
Der gemischte Zweig entspricht am ehesten der Rolle eines Portfoliomanagers. Seine Aufgabe besteht darin, zeitliche Dynamiken und räumliche Zusammenhänge zu einem einheitlichen Gesamtbild zu vereinen. Dadurch erfasst das Modell den Markt ganzheitlich. Für das Modell ist eine Zunahme der Volatilität im Technologiesektor, begleitet von Veränderungen der Ölpreise und Zinsschwankungen, keine Ansammlung zufälliger Fakten, sondern ein Signal dafür, dass sich ein bedeutendes Marktszenario abzeichnet.
Die endgültige Prognose ergibt sich an dem Punkt, an dem sich die drei Zweige kreuzen. Ähnlich wie in einem Investitionsausschuss, in dem jeder Experte einen Beitrag leistet, fasst Extralonger die Schlussfolgerungen aller Teilnehmer zu einer gewichteten Entscheidung zusammen. Dadurch gewinnt das Modell nicht nur lokale analytische Tiefe und einen Überblick über globale Zusammenhänge, sondern auch eine ganzheitliche Wahrnehmung der Marktprozesse im Zeitverlauf.
Durch diesen Aufbau eignet sich das Framework besonders gut für Finanzanwendungen. Es vereint die Tiefe der Zeitreihenanalyse, eine umfassende Betrachtung marktübergreifender Zusammenhänge und eine ganzheitliche Sichtweise. Daher kann Extralonger zuverlässige Prognosen erstellen, während andere Modelle entweder an Genauigkeit einbüßen oder übermäßige Ressourcen erfordern.
Nachfolgend ist die vom Autor erstellte Visualisierung des Extralonger-Frameworks zu sehen.
Im praktischen Teil des vorherigen Artikels haben wir die ersten Schritte zur Umsetzung der vorgeschlagenen Ansätze mit MQL5 unternommen. Es wurde ein Modul zur räumlichen Kodierung entwickelt, um die Wechselbeziehungen zwischen den Instrumenten zu berücksichtigen, und es wurden zudem einzelne Blöcke des OpenCL-Programms zur zeitlichen Kodierung vorgestellt. Diese Entwicklungen bilden nun die Grundlage, auf der wir eine vollwertige technische Umsetzung des Frameworks aufbauen können.
Heute setzen wir diese Arbeit fort und kommen der praktischen Umsetzung der Ideen hinter Extralonger einen Schritt näher. Unser Ziel ist es, die von den Autoren vorgeschlagene Architektur schrittweise in die MQL5-Umgebung zu portieren und dabei sicherzustellen, dass sie mit echten Finanzdaten funktioniert.
Zeitliche Einbettung
Wir setzen unsere Arbeit an der Entwicklung von Algorithmen für das Extralonger-Framework unter Verwendung von MQL5 fort. Im vorherigen Artikel haben wir uns eingehend mit den Kerneln des OpenCL-Programms befasst, die den Eingabedaten zeitliche Einbettungen hinzufügen. Nun wenden wir uns der Organisation dieses Prozesses auf der Seite des Hauptprogramms zu. Dazu erstellen wir ein neues CNeuronTempEmbedding-Objekt, das die Grundfunktionalität der Klasse CNeuronBaseOCL erbt.
class CNeuronTempEmbedding    : public CNeuronBaseOCL
  {
protected:
   uint              iWindow;
   uint              iUnits;
   uint              aiEmbeddingDim[2];
   uint              aiFrames[2];
   uint              aiPeriod[2];
   CParams           caEmbeddings[2];
   //---
   virtual bool      ConcatByLabel(CNeuronBaseOCL *NeuronOCL, CBufferFloat *SecondInput);
   virtual bool      ConcatByLabelGrad(CNeuronBaseOCL *NeuronOCL, CBufferFloat *SecondInput);
   //---
   virtual bool      feedForward(CNeuronBaseOCL *NeuronOCL) override {return false;}
   virtual bool      feedForward(CNeuronBaseOCL *NeuronOCL, CBufferFloat *SecondInput) override;
   virtual bool      updateInputWeights(CNeuronBaseOCL *NeuronOCL) override;
   virtual bool      calcInputGradients(CNeuronBaseOCL *NeuronOCL) override {return false;}
   virtual bool      calcInputGradients(CNeuronBaseOCL *NeuronOCL,
                                        CBufferFloat *SecondInput,
                                        CBufferFloat *SecondGradient,
                                        ENUM_ACTIVATION SecondActivation = None
                                       ) override;

public:
                     CNeuronTempEmbedding(void) {};
                    ~CNeuronTempEmbedding(void) {};
   //---
   virtual bool      Init(uint numOutputs, uint myIndex, COpenCLMy *open_cl,
                          uint units, uint window,
                          uint embed_dim1, uint period1, uint frame1,
                          uint embed_dim2, uint period2, uint frame2,
                          ENUM_OPTIMIZATION optimization_type, uint batch);
   //---
   virtual int       Type(void)   const   {  return defNeuronTempEmbedding;   }
   //--- methods for working with files
   virtual bool      Save(int const file_handle) override;
   virtual bool      Load(int const file_handle) override;
   //---
   virtual bool      WeightsUpdate(CNeuronBaseOCL *source, float tau) override;
   virtual void      SetOpenCL(COpenCLMy *obj) override;
   virtual void      SetActivationFunction(ENUM_ACTIVATION value) override { };
  };
Zu den wichtigsten Parametern des Objekts gehören die Anzahl der analysierten Merkmale (iWindow), die Sequenzlänge (iUnits), die Einbettungsdimensionen (aiEmbeddingDim), die Größe eines einzelnen Schritts (iFrames) und die Wiederholungsperioden (aiPeriod). All dies wird mithilfe von Arrays definiert, wodurch das Objekt flexibel und an unterschiedliche Zeitskalen von Finanzdaten anpassbar ist.
Die Objektstruktur wird in der Methode Init definiert, die für die Initialisierung aller wichtigen Parameter der zeitlichen Kodierungsschicht und ihrer internen Komponenten zuständig ist.
bool CNeuronTempEmbedding::Init(uint numOutputs, uint myIndex, COpenCLMy *open_cl,
                                uint units, uint window,
                                uint embed_dim1, uint period1, uint frame1,
                                uint embed_dim2, uint period2, uint frame2,
                                ENUM_OPTIMIZATION optimization_type, uint batch)
  {
   if(!CNeuronBaseOCL::Init(numOutputs, myIndex, open_cl,
                            (window + embed_dim1 + embed_dim2)*units, optimization_type, batch))
      return false;
Im ersten Schritt wird die Oberklasse CNeuronBaseOCL initialisiert. Hier werden die wichtigsten Eigenschaften der Schicht festgelegt und die geerbten Schnittstellen initialisiert. Wenn die Basisinitialisierung fehlschlägt, gibt die Funktion false zurück, wodurch die weitere Erstellung eines ungültigen Objekts verhindert wird.
Anschließend werden zwei caEmbeddings-Komponenten initialisiert, um zeitliche Einbettungen für die Daten zu generieren. Jede Einbettung wird auf der Grundlage ihrer eigenen Dimension (embed_dim1 und embed_dim2) und Wiederholungsperiode (period1 und period2) erstellt. Dadurch kann das Modell zeitliche Muster auf unterschiedlichen Zeitskalen und in unterschiedlicher Analysetiefe erfassen, was insbesondere bei der Untersuchung der Dynamik von Finanzmärkten von Bedeutung ist.
   if(!caEmbeddings[0].Init(0, 0, OpenCL, embed_dim1 * period1, optimization, iBatch))
      return false;
   if(!caEmbeddings[1].Init(0, 1, OpenCL, embed_dim2 * period2, optimization, iBatch))
      return false;
Nachdem die Einbettungskomponenten erfolgreich initialisiert wurden, werden die Parameter des Objekts in internen Variablen gespeichert. Diese Parameter legen die Struktur der zeitlichen Schicht fest und steuern, wie das Neuron im Zeitverlauf den Markt wahrnimmt.
   iWindow = window;
   iUnits = units;
   aiEmbeddingDim[0] = embed_dim1;
   aiEmbeddingDim[1] = embed_dim2;
   aiFrames[0] = MathMax(1, frame1);
   aiFrames[1] = MathMax(1, frame2);
   aiPeriod[0] = period1;
   aiPeriod[1] = period2;
//---
   return true;
  }
Schließlich gibt die Methode true zurück und bestätigt damit, dass ein voll funktionsfähiges Objekt erfolgreich erstellt wurde.
Die Methode feedForward implementiert die Vorwärtsausbreitung des Signals durch die Schicht. Zunächst wird geprüft, ob sich das Objekt im Trainingsmodus befindet (bTrain == true). In diesem Fall wird für jede Komponente der Einbettung ein separater Vorwärtsdurchlauf durchgeführt. Dieser Schritt ermöglicht es uns, einen Tensor aus zeitlichen Merkmalen zu konstruieren, um Muster über verschiedene Zeitskalen hinweg zu erfassen. Wenn auch nur eine Einbettung nicht verarbeitet werden kann, gibt die Funktion false zurück und verhindert so die weitere Weitergabe ungültiger Daten.
bool CNeuronTempEmbedding::feedForward(CNeuronBaseOCL *NeuronOCL, CBufferFloat *SecondInput)
  {
   if(bTrain)
      for(uint i = 0; i < caEmbeddings.Size(); i++)
         if(!caEmbeddings[i].FeedForward())
            return false;
//---
   return ConcatByLabel(NeuronOCL, SecondInput);
  }
Nach dem erfolgreichen Vorwärtsdurchlauf der Komponenten der Einbettung werden die Daten mithilfe der Methode ConcatByLabel zusammengeführt, die als Wrapper-Methode für den entsprechenden Kernel des OpenCL-Programms dient. Hier werden die zeitlichen Merkmale sorgfältig in die Eingabedaten integriert. Infolgedessen erzeugt das Objekt ein Signal, das für die Weiterverarbeitung bereit ist und historische Daten mit aktuellen Marktbeobachtungen kombiniert, wodurch die Genauigkeit des Modells und seine Sensitivität gegenüber der Dynamik der Finanzmärkte gewährleistet werden.
Wie Sie sehen können, ist die Methode für den Vorwärtsdurchlauf relativ einfach und linear umgesetzt. Ebenso sind die Methoden für den Rückwärtsdurchlauf und die Gradientenaktualisierung einfach aufgebaut und folgen der üblichen Logik beim Training neuronaler Netze; für ein tieferes Verständnis können Sie ihre Funktionsweise daher selbstständig untersuchen. Der vollständige Quellcode für die Klasse CNeuronTempEmbedding und alle ihre Methoden sind im Anhang enthalten. So können Sie die Implementierung und die Einbindung dieses Objekts in die Rechenkette des Modells im Detail untersuchen.
Attention-Objekt
Nachdem wir die zeitlichen Einbettungen vorbereitet und in die Eingabedaten integriert haben, wenden wir uns dem nächsten Schritt unserer Arbeit zu – der Implementierung der Algorithmen des Moduls für global-lokale räumliche Attention. Bevor wir zur Programmierung übergehen, ist es wichtig, den von den Autoren des Frameworks vorgeschlagenen Ansatz zu erörtern.
Der Grundgedanke besteht darin, die für die klassische Self-Attention charakteristische globale Attention mit dem lokalen Fokus zu kombinieren, der durch eine Adjazenzmatrix umgesetzt wird. Dieser Ansatz ähnelt den bereits bekannten Methoden der Graphfaltung, wurde in diesem Fall jedoch an die räumlich-zeitliche Struktur der Daten angepasst.
Die Autoren des Artikels machen keine detaillierten Angaben dazu, wie die Adjazenzmatrix erstellt wurde. Um diese Lücke zu schließen, verwenden wir den Algorithmus Significant Neighbors Sampling aus dem SAGDFN-Framework. Dieser Algorithmus wird verwendet, um eine dünn besetzte Adjazenzmatrix zu erstellen, wodurch Rechenressourcen erheblich eingespart werden, während die Fähigkeit des Modells, wesentliche lokale Abhängigkeiten zu berücksichtigen, erhalten bleibt. Es ist zu beachten, dass dieser Ansatz gewisse Feinheiten bei der Umsetzung des Prozesses mit sich bringt, da die Arbeit mit einer dünn besetzten Matrix einen sorgfältigen Umgang mit Indizes und Rechen-Threads erfordert.
Implementierung im OpenCL-Kontext
Bei der Portierung von Algorithmen in ein OpenCL-Programm stehen wir vor zwei großen Herausforderungen, die sich direkt auf die Geschwindigkeit und Genauigkeit der Marktdatenanalyse auswirken. Die erste Herausforderung ist die sequenzielle Ausführung der globalen und der lokalen Attention, die die Gesamtleistung des Modells verringert und die Verarbeitung großer Datenströme historischer Kursdaten verlangsamt. Die zweite Herausforderung ist noch subtiler: Wie lassen sich sämtliche Threads der globalen Attention mit einer dünn besetzten Adjazenzmatrix so koordinieren, dass keine wichtigen Informationen über lokale Beziehungen zwischen Preisniveaus verloren gehen? Wie effektiv das Modell komplexe Marktmuster erkennen kann, hängt direkt von der Qualität dieser Konfiguration ab.
Die Lösung beider Probleme erwies sich als überraschend einfach. Im Sinne des „Multi-Head-Attention“-Ansatzes haben wir die Berechnungen auf separate Threads verteilt, sodass das Modell verschiedene Aspekte der Marktdaten gleichzeitig analysieren kann. Natürlich musste der Algorithmus dafür je nach dem jeweiligen Attention-Kopf verzweigt werden. Dieser Ansatz ermöglichte es jedoch, die Geschwindigkeit und Genauigkeit bei der Verarbeitung umfangreicher historischer Zeitreihen aufrechtzuerhalten, was für die rechtzeitige Erkennung von Marktmustern von entscheidender Bedeutung ist.
Nachdem die Probleme hinsichtlich der Ausführungsarchitektur für die globale und die lokale Attention innerhalb der parallelen Threads eines einzelnen Kernels gelöst waren, war es an der Zeit, zur praktischen Implementierung des Algorithmus für den Vorwärtsdurchlauf überzugehen. Wir haben ihn im Kernel GlobalLocalAttention implementiert. Jede Zeile hier steht für einen Schritt, den das Modell bei der Analyse historischer Daten und der Identifizierung aussagekräftiger Signale durchläuft.
__kernel void GlobalLocalAttention(__global const float *q,
                                   __global const float2* kv,
                                   __global float *scores,
                                   __global const float* mask,
                                   __global const float* label,
                                   __global float *out,
                                   const int dimension,
                                   const int total_kv,
                                   const int total_mask
                                  )
  {
//--- init
   const int q_id = get_global_id(0);
   const int local_id = get_local_id(1);
   const int h_id = get_global_id(2);
   const int total_q = get_global_size(0);
   const int total_local = get_local_size(1);
   const int total_heads = get_global_size(2);
//---
   __local float temp[LOCAL_ARRAY_SIZE];
Der Kernel empfängt alle wichtigen Daten:
- Abfragevektoren q – unsere aktuellen Marktabfragen,
- Schlüssel-Wert-Paare kv – historische Muster und ihre Ergebnisse,
- eine Maske und Kennzeichnungen für lokale Einschränkungen,
- Parameter für die Dimensionen des Merkmalsraums und die Datenmengen.
Im Rumpf des Kernels ermittelt das Modell zunächst die Bedeutung der Indizes, und zwar im dreidimensionalen Problemraum:
- q_id ist eine bestimmte Abfrage;
- local_id ist ein Thread innerhalb einer Gruppe, der je nach Attention-Kopf entweder auf ein Schlüssel-Abfrage-Paar oder auf eine Position in einer dünn besetzten Adjazenzmatrix verweist:
- h_id ist ein Attention-Kopf, der einen bestimmten Aspekt des Marktes analysiert.
Ein lokales Array dient als temporärer Puffer für Zwischenberechnungen, ähnlich wie ein Händlerpult, auf dem alle aktuellen Ergebnisse gesammelt werden, bevor die endgültige Auswertung erfolgt.
Als Nächstes ermitteln wir den Speicher-Offset der zu analysierenden Abfrage – das ist so, als würde man den richtigen Kursbalken in einem Chart finden, um ihn mit historischen Kursbewegungen zu vergleichen.
int shift_q = RCtoFlat(h_id, 0, total_heads, dimension, q_id);
Anschließend richten wir im Algorithmus eine Verzweigung ein: Die Attention-Köpfe mit geradem Index liefern eine globale Sicht auf den Markt, bei der wichtige Muster über den gesamten historischen Datensatz hinweg ausgewertet werden, während die Attention-Köpfe mit ungeradem Index eine lokale Sicht bieten.
Für die Attention-Köpfe mit geradem Index berechnen wir die Positionen der Schlüssel und die entsprechenden Attention-Koeffizienten. Das ist so, als würde man alle bisherigen Unterstützungs- und Widerstandsniveaus im Chart für die aktuelle Abfrage markieren.
   if(h_id % 2 == 0)
     {
      const int shift_kv = RCtoFlat(h_id, 0, total_heads, dimension, local_id);
      const int shift_s = RCtoFlat(h_id / 2, local_id, total_heads / 2, total_kv + total_mask, q_id);
      float score = 0;
      if(local_id < total_kv)
        {
         //---
         for(int d = 0; d < dimension; d++)
            score += IsNaNOrInf(q[shift_q + d] * kv[shift_kv + d].s0, 0);
        }
      else
         score = MIN_VALUE;
      //--- norm score
      score = LocalSoftMax(score, 1, temp);
      if(local_id < total_kv)
         scores[shift_s] = score;
Wir berechnen die Korrelation zwischen der aktuellen Abfrage und den historischen Daten. Wenn ein Thread nicht an der Berechnung beteiligt ist, weisen wir ihm den Minimalwert zu, damit er das Bild nicht verzerrt – ähnlich wie inaktive Händler auf dem Markt. Anschließend normalisieren wir die Gewichtung jedes Musters. Das ist so, als würde man die Bedeutung von Signalen gegeneinander abwägen: Manche Kursniveaus haben einen stärkeren Einfluss, während andere kaum berücksichtigt werden.
Abschließende Berechnung des Ergebnisses: Wir multiplizieren die historischen Werte mit ihren Gewichten und summieren sie.
      //--- out
      for(int d = 0; d < dimension; d++)
        {
         float val = (local_id < total_kv ? kv[shift_kv + d].s1 * score : 0);
         val = LocalSum(val, 1, temp);
         if(local_id == 0)
            out[shift_q + d] = val;
        }
     }
Das Ergebnis ist ein Signal für die aktuelle Abfrage, das zur Analyse oder zur Verwendung in einer Handelsstrategie bereitsteht.
Der zweite Zweig des Algorithmus verarbeitet lokale Verbindungen unter Verwendung der entsprechenden Maske. Hier arbeiten wir im Wesentlichen mit einer dünn besetzten Adjazenzmatrix, in der viele Elemente entweder fehlen oder für die aktuelle Analyse irrelevant sind.
Der Algorithmus prüft zunächst, ob für das aktuelle lokale Element eine Verbindung besteht. Die lokale Variable kv_id verweist auf den tatsächlichen Schlüssel, mit dem der Attention-Koeffizient berechnet werden muss. Ist kv_id kleiner als 0, bedeutet dies, dass in der dünn besetzten Matrix kein entsprechendes Element vorhanden ist, und der Thread wird übersprungen. Die Maske m filtert zudem ungültige Verbindungen heraus.
   else
     {
      int kv_id = -1;
      float score = 0;
      int shift_kv = -1;
      float m = 0;
      if(local_id < total_mask)
        {
         const int shift_s = RCtoFlat(h_id / 2, total_kv + local_id, total_heads / 2,
                                                        total_kv + total_mask, q_id);
         const int l = RCtoFlat(q_id, local_id, total_q, total_mask, 0);
         kv_id = IsNaNOrInf(label[l], -1);
         m = IsNaNOrInf(mask[l], 0);
         shift_kv = RCtoFlat(h_id, 0, total_heads, dimension, kv_id);
         if(kv_id >= 0)
            for(int d = 0; d < dimension; d++)
               score += IsNaNOrInf(q[shift_q + d] * kv[shift_kv + d].s0, 0);
         else
            score = MIN_VALUE;
        }
      else
         score = MIN_VALUE;
      //--- norm score
      score = LocalSoftMax(score * m, 1, temp);
      if(local_id < total_mask)
         scores[shift_s] = score;
Bei der Berechnung der Attention-Koeffizienten werden nur vorhandene lokale Verbindungen berücksichtigt; den übrigen wird ein Mindestwert zugewiesen. Dadurch wird sichergestellt, dass die dünn besetzte Struktur das Ergebnis nicht verfälscht und sich das Modell ausschließlich auf relevante lokale Muster konzentriert.
Bei der SoftMax-Normalisierung wird die Maske berücksichtigt, sodass sich die Gesamtwahrscheinlichkeit ausschließlich auf die tatsächlichen lokalen Elemente verteilt.
Abschließend erzeugen wir die Ausgabe für die Abfrage, wobei wir nur jene lokalen Muster berücksichtigen, die tatsächlich in der dünn besetzten Matrix vorhanden sind.
      //--- out
      for(int d = 0; d < dimension; d++)
        {
         float val = (kv_id >= 0 ? IsNaNOrInf(kv[shift_kv + d].s1, 0) * score : 0);
         val = LocalSum(val, 1, temp);
         if(local_id == 0)
            out[shift_q + d] = val;
        }
     }
  }
Die Verwendung einer dünn besetzten Matrix macht es unmöglich, einen einfachen, universellen Algorithmus für alle Attention-Köpfe zu entwickeln. Der globale Attention-Kopf arbeitet mit einer dicht besetzten Matrix – alle Elemente sind vorhanden, und die Berechnungen sind unkompliziert. Der lokale Attention-Kopf arbeitet mit einer dünn besetzten Struktur – es fehlen viele Verbindungen, sodass Prüfungen der Maske und der Kennzeichnungen, eine Filterung von NaN/Inf sowie eine separate Summierungslogik erforderlich sind. Daher mussten wir innerhalb eines einzigen Kernels zwei separate Algorithmen implementieren, die jeweils für ihren eigenen Datentyp optimiert waren: einen für eine dicht besetzte globale Matrix und den anderen für eine dünn besetzte lokale Matrix.
Nachdem der Vorwärtsdurchlauf implementiert war, standen wir vor einer weitaus schwierigeren Aufgabe – der Verteilung der Fehlergradienten. Der Kernel GlobalLocalAttentionGrad verhält sich hier wie ein erfahrener Händler, der gleichzeitig sowohl das große Ganze als auch lokale Muster im Blick behält. Jeder Thread im Kernel ist wie ein eigener Analyst, dem ein eigener Abschnitt des Diagramms zugewiesen ist. Der Aufgabenbereich ist dabei jedoch keineswegs eng begrenzt.
Die Interpretation von global_id hängt hier von der jeweiligen Phase ab. Der Index kann auf die Abfrage, den Schlüssel oder den Wert verweisen. Seine Rolle ändert sich in jeder Phase und gibt das Objekt an, für das der Fehlergradient berechnet wird. Ebenso ändert sich die Funktion von local_id; dieser Index bestimmt den Thread innerhalb einer Gruppe, ähnlich wie ein Trader, der mehrere Zeitrahmen betrachtet. Und h_id bestimmt den Attention-Kopf – also den Aspekt des Marktes, auf den sich der Analyst konzentriert.
All diese Indizes bilden ein Beobachtungsnetzwerk, das eine präzise Verteilung der Gradienten ermöglicht – so, als würden wir unsere Aufmerksamkeit auf verschiedene Kursnotierungen verteilen, damit kein Detail übersehen wird.
__kernel void GlobalLocalAttentionGrad(__global const float *q,
                                       __global float *q_gr,
                                       __global const float *kv,
                                       __global float *kv_gr,
                                       __global float *scores,
                                       __global const float *mask,
                                       __global const float *mask_gr,
                                       __global const float *label,
                                       __global float *out_gr,
                                       const int dimension,
                                       const int total_q,
                                       const int total_kv,
                                       const int total_mask
                                      )
  {
//--- init
   const int global_id = get_global_id(0);
   const int local_id = get_local_id(1);
   const int h_id = get_global_id(2);
   const int total_global = get_global_size(0);
   const int total_local = get_local_size(1);
   const int total_heads = get_global_size(2);
//---
   __local float temp[LOCAL_ARRAY_SIZE];
Bei Attention-Köpfen mit geradem Index, die mit einer globalen, dicht besetzten Matrix arbeiten, ähnelt der Prozess einer Marktanalyse auf der Grundlage vollständiger historischer Daten. Zunächst werden die Gradienten für den Wert berechnet: Jeder Thread akkumuliert den Einfluss seiner Position auf das Gesamtergebnis durch Summierung mithilfe von LocalSum. Das funktioniert ähnlich wie bei einem Trader, der Signale aus allen historischen Kerzen zusammenfasst, um den übergeordneten Trend zu erkennen.
   if(h_id % 2 == 0)
     {
      //--- Value Gradient global_id -> v_id, local_id -> q_id
      for(int d = 0; d < dimension; d++)
        {
         const int shift_v = RCtoFlat(h_id, 2 * d + 1, total_heads, 2 * dimension, global_id);
         float grad = 0;
         for(int q_id = local_id; q_id < total_q; q_id += total_local)
           {
            int shift_s = RCtoFlat(h_id / 2, global_id, total_heads / 2, total_kv + total_mask, q_id);
            int shift_q = RCtoFlat(h_id, d, total_heads, dimension, q_id);
            grad += IsNaNOrInf(scores[shift_s] * out_gr[shift_q], 0);
           }
         grad = LocalSum(grad, 1, temp);
         kv_gr[shift_v] = grad;
        }
Anschließend werden die Gradienten für die Abfrage berechnet. Hierbei ist es wichtig, die SoftMax-Normalisierung zu berücksichtigen – so wie ein Analyst die Bedeutung jedes einzelnen Signals im Verhältnis zu allen anderen bewertet, damit das Bild nicht durch Rauschen verzerrt wird. Die Gradienten der Abfrage werden über lokale Threads hinweg sorgfältig summiert und in q_gr geschrieben.
      //--- Query Gradient global_id -> q_id, local_id -> k_id/v_id
      if(global_id < total_q)
        {
         //--- 1. Score grad
         float grad_s = 0;
         const int shift_v = RCtoFlat(h_id, 1, total_heads, 2 * dimension, local_id);
         const int shift_s = RCtoFlat(h_id / 2, local_id, total_heads / 2,
                                          total_kv + total_mask, global_id);
         int shift_q = RCtoFlat(h_id, 0, total_heads, dimension, global_id);
         if(local_id < total_kv)
            for(int d = 0; d < dimension; d++)
               grad_s += IsNaNOrInf(kv[shift_v + 2 * d] * out_gr[shift_q + d], 0);
         //--- 2. SoftMax grad
         grad_s = LocalSoftMaxGrad(scores[shift_s], grad_s, 1, temp);
         //--- 3. Query grad
         const int shift_k = shift_v - 1;
         for(int d = 0; d < dimension; d++)
           {
            float grad = 0;
            if(local_id < total_kv)
               grad = kv[shift_k + 2 * d] * grad_s;
            grad = LocalSum(grad, 1, temp);
            if(local_id == 0)
               q_gr[shift_q + d] = grad;
           }
        }
Der Schlüssel erhält die endgültigen Gradienten durch Summierung der Beiträge aller Abfragen.
      //--- Key Gradient global_id -> k_id, local_id -> score_id/v_id/dimension
      if(global_id < total_kv)
        {
         float grad = 0;
         for(int q_id = 0; q_id < total_q; q_id++)
           {
            //--- 1. Score grad local_id -> score_id/v_id
            float grad_s = 0;
            const int shift_v = RCtoFlat(h_id, 1, total_heads, 2 * dimension, local_id);
            const int shift_s = RCtoFlat(h_id / 2, local_id, total_heads / 2,
                                                total_kv + total_mask, q_id);
            int shift_q = RCtoFlat(h_id, 0, total_heads, dimension, q_id);
            if(local_id < total_kv)
               for(int d = 0; d < dimension; d++)
                  grad_s += IsNaNOrInf(kv[shift_v + 2 * d] * out_gr[shift_q + d], 0);
            //--- 2. SoftMax grad
            grad_s = LocalSoftMaxGrad(scores[shift_s], grad_s, 1, temp);
            BarrierLoc;
            if(global_id == local_id)
               temp[0] = grad_s;
            BarrierLoc;
            grad_s = temp[0];
            //--- 3. Key grad local_id -> dimension
            shift_q = RCtoFlat(h_id, local_id, total_heads, dimension, q_id);
            if(local_id < dimension)
               grad += IsNaNOrInf(q[shift_q] * grad_s, 0);
           }
         const int shift_k = RCtoFlat(h_id, 2 * local_id, total_heads, 2 * dimension, global_id);
         if(local_id < dimension)
            kv_gr[shift_k] = IsNaNOrInf(grad);
        }
     }
Bei der globalen Matrix läuft der Prozess reibungslos ab, da alle Daten vorliegen und der Algorithmus die Gradienten parallel verteilen kann.
Ungeradzahlig nummerierte Attention-Köpfe, die mit einer lokal dünn besetzten Matrix arbeiten, verlangen dem Kernel echte Akribie wie bei einem Trader ab. Wie im oben vorgestellten Algorithmus durchlaufen und summieren wir zunächst die Gradienten für den Wert aus allen Abfrage-Einträgen. Hier prüfen wir jedoch bei jedem Eintrag zunächst anhand der Maske und der Kennzeichnungen, ob eine Verbindung besteht. Wenn keine Verbindung besteht oder die Maske die Verwendung des Elements untersagt, wird der Abfrage-Thread übersprungen.
   else
     {
      //--- Value Gradient global_id -> v_id, local_id -> mask_index/dimension
      if(global_id < total_kv)
        {
         float grad = 0;
         for(int q_id = 0; q_id < total_q; q_id++)
           {
            //--- 1. kv_id
            int kv_id = -1;
            float m = 0;
            const int l = RCtoFlat(q_id, local_id, total_q, total_mask, 0);
            const int shift_s = RCtoFlat(h_id / 2, total_kv + local_id, total_heads / 2,
                                                           total_kv + total_mask, q_id);
            //--- Check whether current Value is used
            if(local_id < total_mask)
               kv_id = (int)label[l];
            if(local_id == 0)
               temp[0] = 0;
            BarrierLoc;
            if(kv_id == global_id)
               temp[0] = scores[shift_s];
            BarrierLoc;
            if(temp[0] == 0)
               continue;
Der Gradient des Werts wird nur für vorhandene Elemente berechnet. Der Attention-Koeffizient wird mit dem entsprechenden Ausgabegradienten multipliziert und das Produkt akkumuliert.
            //--- Value grad
            int shift_q = RCtoFlat(h_id, local_id, total_heads, dimension, q_id);
            if(local_id < dimension)
               grad += IsNaNOrInf(temp[0] * out_gr[shift_q], 0);
           }
         const int shift_v = RCtoFlat(h_id, 2 * local_id + 1, total_heads, 2 * dimension, global_id);
         if(local_id < dimension)
            kv_gr[shift_v] = IsNaNOrInf(grad, 0);
        }
Die Gradienten der Abfrage werden unter Berücksichtigung von SoftMax und der Maske gebildet, wodurch sich Störsignale herausfiltern lassen – genauso, wie ein Trader verrauschte Kursbalken und falsche Muster ignoriert.
      //--- Query Gradient global_id -> q_id, local_id -> mask label
      if(global_id < total_q)
        {
         //--- 1. kv_id;
         int kv_id = -1;
         float m = 0;
         const int l = RCtoFlat(global_id, local_id, total_q, total_mask, 0);
         if(local_id < total_mask)
           {
            kv_id = (int)IsNaNOrInf(label[l], -1);
            m = IsNaNOrInf(mask[l], 0);
           }
         //--- 2. Score grad
         float grad_s = 0;
         const int shift_v = RCtoFlat(h_id, 1, total_heads, 2 * dimension, kv_id);
         const int shift_s = RCtoFlat(h_id / 2, total_kv + local_id, total_heads / 2,
                                                   total_kv + total_mask, global_id);
         int shift_q = RCtoFlat(h_id, 0, total_heads, dimension, global_id);
         if(local_id < total_mask)
            for(int d = 0; d < dimension; d++)
               grad_s += IsNaNOrInf(kv[shift_v + 2 * d] * out_gr[shift_q + d], 0);
         //--- 3. SoftMax grad
         float score = IsNaNOrInf(scores[shift_s], 0);
         grad_s = LocalSoftMaxGrad(scores[shift_s], grad_s, 1, temp);
         mask_gr[l] = IsNaNOrInf(grad_s * score, 0);
         grad_s *= m;
         //--- 4. Query grad
         const int shift_k = shift_v - 1;
         for(int d = 0; d < dimension; d++)
           {
            float grad = 0;
            if(local_id < total_mask)
               grad = kv[shift_k + 2 * d] * grad_s;
            grad = LocalSum(grad, 1, temp);
            if(local_id == 0)
               q_gr[shift_q + d] = grad;
           }
        }
Die Gradienten des Schlüssels werden nur für jene Abfragen akkumuliert, die tatsächlich eine Verbindung zum Schlüssel haben, und die Thread-Synchronisation über BarrierLoc stellt sicher, dass kein Signal verloren geht. Es ist, als würde ein Analyst die Ergebnisse seiner Kollegen gegenprüfen, bevor er endgültig eine Handelsposition eröffnet. Jede Berechnung spiegelt die tatsächliche Einflussverteilung in der lokal dünn besetzten Matrix genau wider und verhindert eine Verfälschung der Gradienten durch überflüssige Daten.
      //--- Key Gradient global_id -> k_id, local_id -> score_id/v_id/dimension
      if(global_id < total_kv)
        {
         float grad = 0;
         for(int q_id = 0; q_id < total_q; q_id++)
           {
            //--- 1. kv_id;
            int kv_id = -1;
            float m = 0;
            const int l = RCtoFlat(global_id, local_id, total_q, total_mask, 0);
            if(local_id < total_mask)
              {
               kv_id = (int)label[l];
               if(kv_id == global_id)
                  m = mask[l];
              }
            m = LocalSum(m, 1, temp);
            if(m == 0)
               continue;
            //--- 2. Score grad local_id -> score_id/v_id
            float grad_s = 0;
            const int shift_v = RCtoFlat(h_id, 1, total_heads, 2 * dimension, kv_id);
            const int shift_s = RCtoFlat(h_id / 2, total_kv + local_id, total_heads / 2,
                                                           total_kv + total_mask, q_id);
            int shift_q = RCtoFlat(h_id, 0, total_heads, dimension, q_id);
            if(local_id < total_mask)
               for(int d = 0; d < dimension; d++)
                  grad_s += IsNaNOrInf(kv[shift_v + 2 * d] * out_gr[shift_q + d], 0);
            //--- 3. SoftMax grad
            grad_s = LocalSoftMaxGrad(scores[shift_s], grad_s, 1, temp);
            BarrierLoc;
            if(global_id == local_id)
               temp[0] = grad_s * m;
            BarrierLoc;
            grad_s = temp[0];
            //--- 4. Key grad local_id -> dimension
            shift_q = RCtoFlat(h_id, local_id, total_heads, dimension, q_id);
            if(local_id < dimension)
               grad += IsNaNOrInf(q[shift_q] * grad_s, 0);
           }
         const int shift_k = RCtoFlat(h_id, 2 * local_id, total_heads, 2 * dimension, global_id);
         if(local_id < dimension)
            kv_gr[shift_k] = IsNaNOrInf(grad);
        }
     }
  }
In einem einzigen Kernel werden zwei logisch voneinander getrennte Algorithmen implementiert, da die globalen und lokalen Matrizen grundlegend unterschiedliche Ansätze erfordern. Eine global dicht besetzte Matrix ermöglicht es, Gradienten direkt für alle Elemente zu berechnen, so als könnte der Trader den gesamten Markt auf einen Blick erfassen. Eine lokal dünn besetzte Matrix erfordert sorgfältiges Filtern und Synchronisieren sowie eine Summierung ausschließlich über bestehende Verbindungen. Ähnlich wie ein Trader, der jedes wichtige Signal in einem begrenzten Bereich des Charts sorgfältig prüft. Diese Trennung gewährleistet eine korrekte und effiziente Verteilung der Gradienten beim Training des Modells anhand umfangreicher historischer Zeitreihen, in denen dichte globale Abhängigkeiten und dünn besetzte lokale Korrelationsstrukturen nebeneinander bestehen.
Jede Aktion des Kernels gleicht einem einzelnen Schritt, den ein Händler unternimmt. Die Überprüfung der Maske und der Kennzeichnungen ähnelt der Auswahl wirklich bedeutsamer Preisniveaus. Das Herausfiltern von NaN und Inf bedeutet, verrauschte Daten zu ignorieren. Die Summierung über LocalSum und die Thread-Synchronisation entsprechen der Koordination der Analysten, damit wichtige Signale nicht übersehen werden. Dadurch erhält das Modell genaue Gradienten für Wert, Abfrage und Schlüssel, was es ihm ermöglicht, aus historischen Daten zu lernen, wichtige Marktmuster zu erkennen und den Vorhersagefehler zu minimieren. Der Kernel wandelt abstrakte Berechnungen in einen dynamischen Marktanalyseprozess um, bei dem jede Gradientenoperation die tatsächliche Aufmerksamkeit und die Handlungen des Analysten widerspiegelt und so ein präzises und stabiles Training gewährleistet.
Der vollständige Kernel-Code ist im Anhang enthalten.
Implementierung im Hauptprogramm
Im Hauptprogramm ist der Algorithmus für die global-lokale räumliche Attention übersichtlich als neues Objekt CNeuronGlobalLocalAttention implementiert, das die Funktionalität der Multi-Head-Feed-Forward-Struktur CNeuronMHFeedForward erbt. Dieses Objekt vereint mehrere Schlüsselkomponenten, von denen jede eine genau definierte Rolle beim Aufbau des Attention-Mechanismus spielt.
class CNeuronGlobalLocalAttention   :  public CNeuronMHFeedForward
  {
protected:
   CNeuronSNSMHAttention   cMask;
   CNeuronConvOCL          cQ;
   CNeuronConvOCL          cKV;
   CNeuronBaseOCL          cScore;
   CNeuronBaseOCL          cMHAttention;
   CNeuronConvOCL          cW0;
   CNeuronBaseOCL          cResidual;
   //---
   virtual bool      GlobalLocalAttention(void);
   virtual bool      GlobalLocalAttentionGrad(void);
   //---
   virtual bool      feedForward(CNeuronBaseOCL *NeuronOCL) override;
   virtual bool      updateInputWeights(CNeuronBaseOCL *NeuronOCL) override;
   virtual bool      calcInputGradients(CNeuronBaseOCL *NeuronOCL) override;

public:
                     CNeuronGlobalLocalAttention(void) {};
                    ~CNeuronGlobalLocalAttention(void) {};
   //---
   virtual bool      Init(uint numOutputs, uint myIndex, COpenCLMy *open_cl,
                          uint units, uint window, uint dimension_k,
                          uint heads, uint m_units, float sparse,
                          ENUM_OPTIMIZATION optimization_type, uint batch);
   //---
   virtual int       Type(void)   const   {  return defNeuronGlobalLocalAttention;   }
   //--- methods for working with files
   virtual bool      Save(int const file_handle) override;
   virtual bool      Load(int const file_handle) override;
   //---
   virtual bool      WeightsUpdate(CNeuronBaseOCL *source, float tau) override;
   virtual void      SetOpenCL(COpenCLMy *obj) override;
   virtual void      SetActivationFunction(ENUM_ACTIVATION value) override { };
  };
Innerhalb der Klasse befindet sich das Objekt cMask, das für die Verwaltung von Masken für lokale Verbindungen zuständig ist und es der Klasse ermöglicht, eine dünn besetzte Matrix korrekt zu verarbeiten und irrelevante lokale Muster herauszufiltern. Zwei Faltungsobjekte, cQ und cKV, transformieren Abfragen bzw. Schlüssel-Wert-Paare und bereiten die Daten so für die Berechnung der Attention-Koeffizienten vor. Das Element cScore speichert die Attention-Scores., während cMHAttention die Ergebnisse der Multi-Head-Attention erfasst und dabei globale und lokale Komponenten kombiniert. Schließlich sind cW0 und cResidual für die lineare Transformation und die Hinzufügung der Residualverbindung zuständig und gewährleisten so die Stabilität und Korrektheit der Aktualisierungen des Ausgangssignals. Die Funktionalität des FeedForward-Blocks wird von der übergeordneten Klasse implementiert.
Die Methode Init ist für die vollständige Initialisierung des Neurons zuständig und legt alle wichtigen Parameter für den Algorithmus der global-lokalen räumlichen Attention fest. Zunächst wird die Basisklasse CNeuronMHFeedForward initialisiert. Hier werden alle wichtigen Parameter des Objekts angegeben.
bool CNeuronGlobalLocalAttention::Init(uint numOutputs, uint myIndex, COpenCLMy *open_cl,
                                       uint units, uint window, uint dimension_k,
                                       uint heads, uint m_units, float sparse,
                                       ENUM_OPTIMIZATION optimization_type, uint batch)
  {
   if(!CNeuronMHFeedForward::Init(numOutputs, myIndex, open_cl, window, 2 * window, units,
                                                      1, heads, optimization_type, batch))
      return false;
   activation = None;
Sollte in dieser Phase ein Fehler auftreten, wird die Handelssitzung nicht gestartet: Das Objekt wird nicht initialisiert, wodurch fehlerhafte Berechnungen verhindert werden.
Als Nächstes deaktivieren wir die Aktivierungsfunktion, so als hätte der Trader beschlossen, ohne emotionale Filter zu handeln und sich dabei ausschließlich auf direkte Marktsignale zu verlassen.
Den Anfang macht cMask. Es verwaltet lokale Masken und filtert dabei dünn besetzte Muster, damit der Händler nicht durch unbedeutende Signale abgelenkt wird. Mit seiner Hilfe erkennt das Modell, welche lokalen Verbindungen wichtig sind und welche vernachlässigt werden können.
   int index = 0;
   if(!cMask.Init(0, index, OpenCL, units, window, heads, m_units, sparse, optimization, iBatch))
      return false;
Anschließend werden cQ und cKV generiert, wodurch Rohdaten in aussagekräftige Analysesignale umgewandelt werden. cQ verarbeitet Abfragen, ähnlich wie ein Händler aktuelle Marktpositionen bewertet, während cKV Schlüssel und Werte sammelt, ähnlich wie ein Händler Informationen über vergangene Kerzen, Unterstützungsniveaus und Widerstandsniveaus zusammenträgt. Bei beiden Blöcken ist die Aktivierungsfunktion deaktiviert, damit die Analyselinien klar und linear bleiben und keine Verzerrungen auftreten.
   index++;
   if(!cQ.Init(0, index, OpenCL, window, window, 2 * dimension_k * heads, units, 1,
                                                             optimization, iBatch))
      return false;
   cQ.SetActivationFunction(None);
   index++;
   if(!cKV.Init(0, index, OpenCL, window, window, 4 * dimension_k * heads, units, 1,
                                                              optimization, iBatch))
      return false;
   cKV.SetActivationFunction(None);
Anschließend wird cScore aktiviert, das die empfangenen Bewertungen zusammenfasst – ähnlich wie ein Trader die Signale aller Indikatoren kombiniert, um zu entscheiden, wo er eine Position eingehen soll.
   index++;
   if(!cScore.Init(0, index, OpenCL, (units + m_units)*units * heads, optimization, iBatch))
      return false;
   cScore.SetActivationFunction(None);
   index++;
   if(!cMHAttention.Init(0, index, OpenCL, 2 * dimension_k * heads * units, optimization, iBatch))
      return false;
   cMHAttention.SetActivationFunction(None);
Auf der Grundlage dieser Bewertungen verteilt cMHAttention, ein Multi-Head-Attention-Mechanismus, die Ressourcen auf verschiedene Instrumente und Zeitintervalle. Genauso wie ein erfahrener Analyst entscheidet, worauf er sich in der aktuellen Marktsituation am meisten konzentrieren sollte.
Die Kette wird durch cW0 und cResidual vervollständigt. Ersteres führt eine lineare Transformation der Signale durch, ähnlich wie ein Händler seine Berechnungen anpasst, um das aktuelle Marktvolumen und die Liquidität zu berücksichtigen.
   index++;
   if(!cW0.Init(0, index, OpenCL, 2 * dimension_k * heads, 2 * dimension_k * heads,
                                           window, units, 1, optimization, iBatch))
      return false;
   cW0.SetActivationFunction(None);
   index++;
   if(!cResidual.Init(0, index, OpenCL, Neurons(), optimization, iBatch))
      return false;
   cResidual.SetActivationFunction(None);
//---
   return true;
  }
Zweiteres fügt eine Residualverbindung hinzu, wodurch sichergestellt wird, dass Informationen über frühere Trainingsschritte nicht verloren gehen und das Signal stabil bleibt – ähnlich wie bei der Überprüfung der Positionen aus früheren Trades, bevor ein neuer Trade eröffnet wird.
Jedem Block werden ein eindeutiger Index und Parameter zugewiesen; er wird mit dem OpenCL-Kontext verknüpft und ist bereit, mit den anderen zusammenzuarbeiten. Das Ganze gleicht einem gut abgestimmten Team aus Händlern und Analysten: Der eine filtert Signale, der andere bewertet Trends, ein dritter fasst die Ergebnisse zusammen und ein vierter verteilt die Aufmerksamkeit auf die verschiedenen Instrumente. Sobald die Initialisierung abgeschlossen ist, ist das Objekt daher voll funktionsfähig und in der Lage, gleichzeitig globale und lokale Marktmuster zu analysieren, Störsignale herauszufiltern und auf der Grundlage historischer Daten präzise Entscheidungen zu treffen.
Sobald das Objekt initialisiert und alle Blöcke konfiguriert wurden, beginnt der Vorwärtsdurchlauf – der Zeitpunkt, an dem das Modell tatsächlich den Markt beobachtet und seine Prognosen erstellt. Die Methode feedForward definiert eine klare Abfolge von Aktionen, bei der jede Komponente eine genau festgelegte Rolle übernimmt und die Daten die gesamte Transformationskette durchlaufen – ähnlich wie bei der Arbeit eines gut koordinierten Teams von Händlern.
bool CNeuronGlobalLocalAttention::feedForward(CNeuronBaseOCL *NeuronOCL)
  {
   if(!cMask.FeedForward(NeuronOCL))
      return false;
Zunächst wird cMask aktiviert, um lokale Verbindungen zu überprüfen und zu filtern. Es ist so, als würde ein Trader sorgfältig nur die Signale auswählen, die wirklich von Bedeutung sind, und dabei störende oder fehlende Muster ignorieren. Sollte hier etwas schiefgehen, ist eine weitere Analyse nicht möglich – das Modell erstellt keine Prognose auf der Grundlage falscher Daten.
Anschließend werden cQ und cKV nacheinander ausgeführt. Der erste verarbeitet die Abfragen und bereitet sie für den Vergleich mit den Schlüsseln vor – genau so, wie ein Analyst die aktuellen Marktpositionen bewertet und eine Liste potenzieller Einstiegspunkte erstellt.
   if(!cQ.FeedForward(NeuronOCL))
      return false;
   if(!cKV.FeedForward(NeuronOCL))
      return false;
Der zweite sammelt Schlüssel und Werte, als würde er eine Historie der Kursnotierungen und Handelsvolumina für jedes Instrument zusammenstellen, und schafft so eine Grundlage für die Bewertung der Auswirkungen jedes Signals.
Nach erfolgreichem Abschluss der Vorbereitungsphase wird die Wrapper-Methode GlobalLocalAttention aufgerufen, die den gleichnamigen Kernel zur Ausführung in die Warteschlange einreiht; dieser führt den Hauptalgorithmus innerhalb des OpenCL-Kontexts aus.
   if(!GlobalLocalAttention())
      return false;
Hier werden Abfragen und Schlüssel im Rahmen der globalen und lokalen Attention kombiniert. Die Magie des Modells entfaltet sich: Jedes Muster wird unter Berücksichtigung aller relevanten Verbindungen – sowohl dünn als auch dicht besetzter – ausgewertet, und die Beiträge werden über alle Attention-Köpfe hinweg sorgfältig summiert.
Diese Phase ähnelt dem Moment, in dem ein Trader aktuelle Signale mit historischen Daten vergleicht und entscheidet, welche Positionen die größte Aufmerksamkeit verdienen.
Anschließend wird cW0 ausgeführt, wodurch eine lineare Transformation auf die Ergebnisse der Multi-Head-Attention angewendet wird. Man kann sich das so vorstellen, dass die Signale angepasst werden, um die Marktgröße, die Liquidität und die Gewichtung der einzelnen Muster zu berücksichtigen.
   if(!cW0.FeedForward(cMHAttention.AsObject()))
      return false;
   if(!SumAndNormilize(NeuronOCL.getOutput(), cW0.getOutput(), cResidual.getOutput(),
                       cW0.GetFilters(), true, 0, 0, 0, cW0.GetUnits()))
      return false;
//---
   return CNeuronMHFeedForward::feedForward(cResidual.AsObject());
  }
Anschließend werden die Daten durch die Funktion SumAndNormalize geleitet. Sie summiert die Ausgaben des linearen Blocks und der Residualverbindung und normalisiert sie anschließend. Dieser Schritt stellt sicher, dass das Signal stabil und skalierbar bleibt – so, als hätte der Trader die Erkenntnisse mehrerer Analysten zusammengefasst, deren Übereinstimmung überprüft und die Gesamtstärke des Signals bewertet, bevor er eine Entscheidung trifft.
Schließlich wird das aktualisierte Signal an die gleichnamige Methode in der übergeordneten Klasse CNeuronMHFeedForward übergeben, die den Vorwärtsdurchlauf abschließt, indem sie die Funktionalität des FeedForward-Blocks ausführt und die Ergebnisse in die gesamte Modellstruktur integriert.
Somit lässt sich der gesamte Vorwärtsdurchlauf als sequenzielle Marktanalyse betrachten, bei der jeder Block eine bestimmte Funktion erfüllt: das Filtern, Auswerten, Sammeln, Anpassen und Summieren von Daten, wodurch die Genauigkeit und Konsistenz der Prognosen gewährleistet wird.
Sobald das Modell einen Vorwärtsdurchlauf erfolgreich abgeschlossen und eine Vorhersage generiert hat, beginnt die Trainingsphase – der Zeitpunkt, an dem das Neuron bewertet, wie genau es gearbeitet hat, und seine internen Parameter anpasst. Die Methode calcInputGradients ist für diese Auswertung sowie für die Verteilung des quantifizierten Einflusses jeder Modellkomponente auf das Endergebnis zuständig.
bool CNeuronGlobalLocalAttention::calcInputGradients(CNeuronBaseOCL *NeuronOCL)
  {
   if(!NeuronOCL)
      return false;
   if(!CNeuronMHFeedForward::calcInputGradients(cResidual.AsObject());)
      return false;
Zunächst wird die Gültigkeit des empfangenen Zeigers auf das Eingabedatenobjekt NeuronOCL überprüft. Fehlt das Objekt, sind weitere Berechnungen unmöglich – genauso, als würde ein Händler versuchen, Daten ohne Chart oder Kursnotierungen zu analysieren.
Anschließend wird die gleichnamige Methode in der übergeordneten Klasse aufgerufen, die die Rückpropagation der Gradienten bis zum Objekt der Residualverbindung einleitet.
Anschließend wird die Methode DeActivation für den Block cW0 aufgerufen, wobei die ermittelten Gradienten auf der Grundlage der Aktivierungsfunktion der linearen Schicht angepasst werden. Dies entspricht in etwa der Vorgehensweise eines Analysten, der die Auswirkungen der einzelnen Indikatoren auf die endgültige Entscheidung berücksichtigt, indem er die Signale filtert und normalisiert.
   if(!DeActivation(cW0.getOutput(), cW0.getGradient(), cResidual.getGradient(), cW0.Activation()))
      return false;
Die Gradienten werden anschließend an cMHAttention weitergeleitet, wo der Einfluss jedes Multi-Head-Attention-Musters kumuliert wird.
   if(!cMHAttention.CalcHiddenGradients(cW0.AsObject()))
      return false;
   if(!GlobalLocalAttentionGrad())
      return false;
In dieser Phase wird GlobalLocalAttentionGrad aufgerufen, wodurch die präzise Verteilung der Gradienten zwischen den globalen und lokalen Matrizen unter Berücksichtigung dünn und dicht besetzter Verbindungen gewährleistet wird – ähnlich wie ein Trader den Beitrag jeder Kerze und jedes Unterstützungsniveaus zum Gesamttrend bewertet. Und die Gradienten werden sorgfältig an die Blöcke cQ und cKV weitergeleitet.
Als Nächstes müssen wir die Fehlergradienten auf der Ebene der Eingabedaten aus allen Informationsströmen erfassen. Und wir haben vier davon. Zunächst leiten wir die Gradienten von cQ nach unten weiter.
   if(!NeuronOCL.CalcHiddenGradients(cQ.AsObject()))
      return false;
Wir addieren die resultierenden Werte zu den Gradienten der Residualverbindungspfade, passen jedoch zuvor die Gradienten dieser Pfade an die Aktivierungsfunktion der Eingabedatenschicht an.
   if(!DeActivation(cResidual.getOutput(), cResidual.getGradient(),
                    cResidual.getGradient(), NeuronOCL.Activation()))
      return false;
   if(!SumAndNormilize(NeuronOCL.getGradient(), cResidual.getGradient(), cResidual.getGradient(),
                       cW0.GetFilters(), false, 0, 0, 0, cW0.GetUnits()))
      return false;
Im nächsten Schritt werden die Gradienten von cKV verarbeitet und anschließend zu den zuvor akkumulierten Daten addiert.
   if(!NeuronOCL.CalcHiddenGradients(cKV.AsObject()))
      return false;
   if(!SumAndNormilize(NeuronOCL.getGradient(), cResidual.getGradient(), cResidual.getGradient(),
                       cW0.GetFilters(), false, 0, 0, 0, cW0.GetUnits()))
      return false;
Zu guter Letzt – aber nicht weniger wichtig – leiten wir die Gradienten der lokalen Masken cMask nach unten weiter. Auch ihren Beitrag addieren wir zu den zuvor akkumulierten Daten.
   if(!NeuronOCL.CalcHiddenGradients(cMask.AsObject()))
      return false;
   if(!SumAndNormilize(NeuronOCL.getGradient(), cResidual.getGradient(), NeuronOCL.getGradient(),
                       cW0.GetFilters(), false, 0, 0, 0, cW0.GetUnits()))
      return false;
//---
   return true;
  }
Damit liefert die Methode calcInputGradients eine umfassende und detaillierte Bewertung des Einflusses aller Modellkomponenten – von globalen und lokalen Attention-Köpfen bis hin zu Abfragen, Schlüsseln, Werten und Masken. Jeder Block erhält quantitatives Feedback, wodurch das Modell seine Gewichte korrekt aktualisieren, Fehler minimieren und die Genauigkeit seiner Prognosen verbessern kann. Dieser Prozess wandelt abstrakte Gradientenberechnungen in eine konkrete Bewertung der Bedeutung jedes einzelnen Elements im System um und macht den Trainingsprozess so transparent und kontrollierbar wie möglich.
Sobald das Modell den Einfluss der einzelnen Komponenten mittels Fehlerrückpropagation geschätzt hat, ist es an der Zeit zu handeln – die internen Parameter zu justieren und das Modell an reale Marktdaten anzupassen. Die Methode updateInputWeights erfüllt genau diese Aufgabe.
bool CNeuronGlobalLocalAttention::updateInputWeights(CNeuronBaseOCL *NeuronOCL)
  {
   if(!cMask.UpdateInputWeights(NeuronOCL))
      return false;
   if(!cQ.UpdateInputWeights(NeuronOCL))
      return false;
   if(!cKV.UpdateInputWeights(NeuronOCL))
      return false;
   if(!cW0.UpdateInputWeights(cMHAttention.AsObject()))
      return false;
//---
   return CNeuronMHFeedForward::updateInputWeights(cResidual.AsObject());
  }
Der Algorithmus, der dieser Methode zugrunde liegt, ist eigentlich sehr einfach – er überträgt die Steuerung nacheinander an interne Komponenten, die die trainierbaren Parameter enthalten. Zunächst werden die Gewichte der lokalen Masken cMask aktualisiert; anschließend werden die Parameter der Abfragen cQ und der Schlüssel/Werte cKV angepasst. Anschließend werden die Gewichte der linearen Transformation cW0 aktualisiert. Am Ende werden die Parameter der übergeordneten Klasse angepasst.
Jeder Schritt ist ein einfacher, aber wichtiger Prozess: Das Modell passt seine Parameter an, um den Markt genauer einzuschätzen und Prognosen zu erstellen, während alle Komponenten im Einklang zusammenarbeiten – wie ein Team von Händlern, das einer einheitlichen Strategie folgt.
Wir haben viel Arbeit geleistet und zahlreiche Aufgaben erfolgreich abgeschlossen. Jetzt ist der perfekte Zeitpunkt, um eine kurze Pause einzulegen, durchzuatmen und über die Ergebnisse nachzudenken. Im nächsten Artikel werden wir unsere Arbeit mit neuer Energie und aus einer neuen Perspektive fortsetzen und zu einem logischen Abschluss bringen.
Fazit
Wir haben einen langen Weg zurückgelegt: Jeder Baustein des Algorithmus für die global-lokale räumliche Attention wurde sorgfältig integriert und in eine einheitliche Berechnungspipeline eingeordnet. Der Vorwärtsdurchlauf, die Gradientenverteilung und die Aktualisierung der Modellparameter – all dies ähnelte der Arbeit eines erfahrenen Händlers, der Signale filtert, die Auswirkungen der einzelnen Instrumente bewertet und Positionen anpasst, um das bestmögliche Ergebnis zu erzielen.
Der in MQL5 umgesetzte Ansatz hat gezeigt, wie komplexe Attention-Algorithmen für den praktischen Einsatz angepasst werden können, um abstrakte Berechnungen in präzise und kontrollierbare Prognosen umzusetzen. Jeder Block des Modells fungierte als eigenständiger Analyst und trug zur endgültigen Entscheidung bei, wodurch die Flexibilität, Robustheit und Skalierbarkeit des gesamten Systems gewährleistet wurden.
Die nächste Phase wird die abschließende Bewährungsprobe für unsere Arbeit sein: Wir werden das Modell fertigstellen, es anhand realer Marktdaten testen und die praktische Wirksamkeit des vorgeschlagenen Frameworks bewerten.
Literaturverzeichnis
- Extralonger: Auf dem Weg zu einer einheitlichen Betrachtung räumlich-zeitlicher Faktoren für die extrem langfristige Verkehrsprognose
- Weitere Artikel in dieser Reihe
In diesem Artikel verwendete Dateien
| # | Name | Typ | Beschreibung |
|---|---|---|---|
| 1 | Study.mq5 | Expert Advisor | Expert Advisor für das Offline-Modelltraining |
| 2 | StudyOnline.mq5 | Expert Advisor | Expert Advisor für Online-Modelltraining |
| 3 | Test.mq5 | Expert Advisor | Expert Advisor für Modelltests |
| 4 | Trajectory.mqh | Klassenbibliothek | Struktur zur Beschreibung des Systemzustands und der Modellarchitektur |
| 5 | NeuroNet.mqh | Klassenbibliothek | Klassenbibliothek zum Erstellen eines neuronalen Netzes |
| 6 | NeuroNet.cl | Bibliothek | Codebibliothek für das OpenCL-Programm |
Übersetzt aus dem Russischen von MetaQuotes Ltd.
Originalartikel: https://www.mql5.com/ru/articles/19538
Warnung: Alle Rechte sind von MetaQuotes Ltd. vorbehalten. Kopieren oder Vervielfältigen untersagt.
Dieser Artikel wurde von einem Nutzer der Website verfasst und gibt dessen persönliche Meinung wieder. MetaQuotes Ltd übernimmt keine Verantwortung für die Richtigkeit der dargestellten Informationen oder für Folgen, die sich aus der Anwendung der beschriebenen Lösungen, Strategien oder Empfehlungen ergeben.



