

Neuronale Netze im Handel: Eine einheitliche Betrachtung von Raum und Zeit (Extralonger)
 8
 0

Einleitung
Die Vorhersage des Verhaltens komplexer Systeme gehört seit jeher zu den zentralen Aufgaben der Datenanalyse. Die Qualität und Tiefe von Prognosen bestimmen nicht nur das wissenschaftliche Interesse der Forscher, sondern auch ganz konkrete Ergebnisse: die Optimierung von Strömen, die Senkung von Kosten und das Risikomanagement. Dieses Problem zeigt sich am deutlichsten in zwei Bereichen, die auf den ersten Blick nichts miteinander zu tun haben – bei intelligenten Verkehrssystemen und auf Finanzmärkten. Auf den ersten Blick haben Straßen mit ihren Verkehrsströmen und Börsen mit ihren Orderströmen wenig gemeinsam. Bei genauerer Betrachtung zeigt sich jedoch eine tiefgreifende strukturelle Ähnlichkeit.
In der Verkehrsforschung bilden die Daten ein Netzwerk, in dem die Knoten Messstationen sind und die Kanten die Verbindungen zwischen ihnen darstellen. In der Finanzwelt spielen Vermögenswerte, Börsen, Broker und Handelsplattformen eine ähnliche Rolle, wobei Informationen und Kapital kontinuierlich zwischen ihnen zirkulieren. Wenn in einem Straßennetz der Verkehr das Signal ist, dann sind in Finanzsystemen Preise, Volumina, Liquidität und das Verhalten der Marktteilnehmer solche Signale. In beiden Fällen besteht das Ziel darin, durch die Analyse historischer Daten Muster in der räumlich-zeitlichen Dynamik zu erkennen und Vorhersagen für die Zukunft zu treffen.
Herkömmliche Ansätze zur Lösung solcher Probleme basierten darauf, die räumlichen und zeitlichen Komponenten getrennt zu betrachten. In der Verkehrsforschung bedeutete dies, dass die Verkehrszeitreihen getrennt von der Topologie des Straßennetzes analysiert wurden. Im Finanzwesen konzentrierten sich ähnliche Methoden entweder auf die zeitliche Dynamik von Kursreihen oder auf strukturelle Korrelationen zwischen Vermögenswerten. Diese Trennung zwischen Raum und Zeit führt zu erheblichen Einschränkungen: Algorithmen werden übermäßig ressourcenintensiv, und ihre Fähigkeit, langfristige Vorhersagen zu treffen, nimmt drastisch ab.
Die größte Herausforderung besteht darin, dass die Verarbeitung zeitlicher Merkmale wiederholte Iterationen über räumliche Beziehungen erfordert. Gleichzeitig erfordert die Analyse der strukturellen Abhängigkeiten zwischen Knoten mehrere Durchläufe entlang der Zeitachse. Infolgedessen ist die Rechenkomplexität um eine Größenordnung höher als bei Aufgaben der reinen Zeitreihenprognose. Wenn wir dazu noch die rasant wachsenden Datenmengen hinzurechnen, die für Verkehrssysteme und Finanzmärkte charakteristisch sind, wird deutlich, dass es ohne einen grundlegend neuen Ansatz praktisch unmöglich ist, über einen Horizont von wenigen Stunden oder wenigen Zeitschritten hinauszublicken.
Eine mögliche Lösung für dieses Problem wurde von den Autoren des Artikels „Extralonger: Toward a Unified Perspective of Spatial-Temporal Factors for Extra-Long-Term Traffic Forecasting“ vorgeschlagen. Die Autoren lassen sich von Albert Einsteins Vorstellungen über die Untrennbarkeit von Raum und Zeit inspirieren und vertreten die Auffassung, dass räumliche und zeitliche Faktoren untrennbar und gleichzeitig berücksichtigt werden müssen. Diese Idee ist im Konzept der Unified Spatial-Temporal Representation verankert: einer einheitlichen räumlich-zeitlichen Repräsentation, die eine künstliche Trennung der Daten in zeitliche und räumliche Komponenten überflüssig macht. In jedem Zeitschritt sind räumliche Informationen enthalten, und an jedem Netzwerkknoten sind zeitliche Informationen enthalten.
Im Verkehrsbereich hat dieser Ansatz es erstmals in der Geschichte ermöglicht, den Prognosehorizont von den üblichen 2–4 Stunden auf eine ganze Woche auszudehnen. Für die Finanzmärkte ist das Potenzial sogar noch beeindruckender. Stellen Sie sich ein Modell vor, das nicht nur auf kurzfristige Impulse reagieren kann, sondern auch aussagekräftige Prognosen über Zeithorizonte hinweg liefert, die für den strategischen Handel, das Risikomanagement und die Investitionsplanung relevant sind. In einem Umfeld, in dem bereits ein geringer Vorsprung beim Verständnis zukünftiger Preisdynamiken zu erheblichen finanziellen Ergebnissen führen kann, eröffnet die Fähigkeit, Prognosen auf der Grundlage einer einheitlichen räumlich-zeitlichen Repräsentation zu erstellen, völlig neue Perspektiven.
Zudem führt die Vereinigung von Raum und Zeit zu einer radikalen Senkung des Rechenaufwands. Während in der klassischen Formulierung die Komplexität der Algorithmen rapide zunahm und die Forscher dadurch praktisch auf einen kurzen Zeithorizont beschränkt waren, zeigt Extralonger eine Verringerung der Komplexität um eine Größenordnung. Das bedeutet, dass die Algorithmen schneller laufen und in realen Szenarien eingesetzt werden können, in denen Reaktionszeit und Ressourceneffizienz entscheidend sind. Dadurch läuft das Modelltraining mehrere Hundert Mal schneller ab, und der Speicherbedarf wird auf ein Maß reduziert, das langfristige Prognosen selbst bei begrenzter Infrastruktur ermöglicht.
Dies ist insbesondere für die Finanzmärkte von Bedeutung. Schließlich besteht der Markt nicht nur aus riesigen Mengen historischer Daten, sondern auch aus einem kontinuierlichen Strom neuer Signale, die in Echtzeit verarbeitet werden müssen. Traditionelle Architekturen gerieten oft genau in dieser Phase ins Straucheln. Die übermäßige Komplexität hinderte sie daran, langfristige Planungsaufgaben zu bewältigen, sodass sie gezwungen waren, Abstriche entweder bei der Geschwindigkeit oder bei der Zuverlässigkeit zu machen. Und manchmal bei beidem. Das Extralonger-Framework zeigt, dass solche Kompromisse nicht mehr notwendig sind.
Der Extralonger-Algorithmus
Die meisten bestehenden Prognosemodelle basieren auf der sogenannten klassischen Darstellung von Daten.
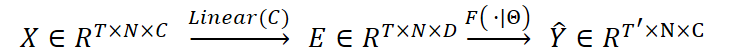
wobei T die Länge des Zeitfensters, N die Anzahl der Netzwerkknoten, C die Anzahl der ursprünglichen Merkmale und D die Dimensionalität des transformierten Merkmalsraums ist.
In der Praxis bedeutet dies, dass die Daten zunächst linear in einen Raum mit fester Dimension projiziert und anschließend von Modulen verarbeitet werden, die für die Extraktion zeitlicher und räumlicher Informationen zuständig sind.
Eine klassische Architektur umfasst in der Regel zwei Arten von Modulen: zeitliche und räumliche. Sie lassen sich in unterschiedlicher Reihenfolge kombinieren – etwa indem zunächst die Zeit und dann der Raum analysiert wird. Oder man kann umgekehrt versuchen, beide Dimensionen gleichzeitig zu verarbeiten. In der Praxis wies eine solche Zerlegung jedoch stets denselben Nachteil auf: Die Verarbeitung von Merkmalen entlang einer Achse erforderte mehrere Iterationen entlang der anderen Achse. Infolgedessen stieg die Rechenkomplexität rapide an. Bei Self-Attention-Mechanismen beispielsweise lag die Komplexität in der Größenordnung von O(NT2 + TN2), was mit einem entsprechenden Anstieg des Speicherbedarfs einherging. Für die Finanzmärkte bedeutet dies, dass Prognosen mit einem langen Prognosehorizont äußerst ressourcenintensiv werden. Große Mengen historischer Kursdaten und die Zusammenhänge zwischen den verschiedenen Finanzinstrumenten überlasten das System schlichtweg.
Es wurden bereits Versuche unternommen, diese Einschränkungen zu überwinden, unter anderem mithilfe von Faltungsnetzwerken (CNN). In diesem Fall wurden die Daten als Bild verarbeitet, wobei eine Achse der Zeit und die andere einer Menge von Knoten entspricht. Dieser Ansatz ermöglicht es zwar, Raum und Zeit gleichzeitig zu betrachten, hat jedoch seine Grenzen. Mit einem Faltungsfenster lässt sich nicht das gesamte Bild erfassen, sondern nur lokale Bereiche. Zudem wurde die Komplexität des Algorithmus mit O(k2TN) angegeben, wobei k die Größe des Faltungskerns ist, was die Möglichkeit zur Erweiterung des Prognosehorizonts weiterhin einschränkte.
Das Extralonger-Framework verändert diese Situation grundlegend durch die Einführung der einheitlichen räumlich-zeitlichen Repräsentation. Der Kerngedanke ist einfach: Raum und Zeit sind nicht voneinander getrennt, sondern werden auf einheitliche Weise beschrieben. Dazu wird die ursprüngliche Darstellung X∈RT×N×C zunächst entlang der Merkmalsdimension komprimiert; anschließend werden zwei lineare Projektionen angewendet: eine entlang der räumlichen und eine entlang der zeitlichen Dimension. Daraus ergeben sich zwei Mengen von Repräsentationen:
- Et ∈ RT×D – jeder Zeitschritt enthält Informationen über alle Netzwerkknoten,
- Es ∈ RN×D – jeder Knoten sammelt Daten für alle Zeitschritte.
Somit liefert jede Beobachtung ein vollständiges räumlich-zeitliches Bild und nicht nur einen lokalen Ausschnitt. Das ist der grundlegende Unterschied: Während sich die klassische Darstellung auf einzelne Merkmale stützte, bietet die neue Darstellung eine ganzheitliche Betrachtung.
Dieser Ansatz bietet gleich mehrere wesentliche Vorteile. Erstens: eine Verringerung der Komplexität. Durch die Eliminierung redundanter Iterationen werden zeitliche und räumliche Abhängigkeiten nun gemeinsam behandelt, und die Komplexität des Algorithmus wird auf O(T2 + N2) reduziert. Dadurch lassen sich Vorhersagen um Dutzende oder sogar Hunderte Zeitschritte im Voraus treffen, ohne an die Grenzen der Rechenkapazitäten zu stoßen.
Zweitens: gleichzeitige Aggregation. Während klassische Methoden gezwungen waren, sich entlang einer einzigen Achse zu bewegen und dabei nach und nach Informationen von der anderen Achse einzubeziehen, ermöglicht Extralonger, dass jeder Knoten zu jedem Zeitschritt gleichzeitig mit allen anderen verbunden ist. Folglich ist der Algorithmus in der Lage, sowohl die Wechselwirkungen zwischen verschiedenen Instrumenten als auch die Dynamik ihrer Veränderungen im Zeitverlauf gleichzeitig zu berücksichtigen, was für eine umfassende Analyse von Korrelationen und marktübergreifenden Zusammenhängen von entscheidender Bedeutung ist.
Und schließlich, drittens, die vollständige Abdeckung des rezeptiven Feldes. Durch den Einsatz von Self-Attention innerhalb einer einheitlichen Darstellung stellt Extralonger sicher, dass jeder Knoten jederzeit mit jedem anderen Knoten verbunden ist. Dadurch kann das Modell die weitreichendsten Abhängigkeiten erfassen – von täglichen und wöchentlichen Zyklen bis hin zu komplexeren Mustern, die beispielsweise mit saisonalen Schwankungen am Aktienmarkt oder mehrtägigen Trendphasen zusammenhängen. Zum Vergleich: Bei RNNs, Aufmerksamkeitsmechanismen oder klassischen Transformer-Modellen erfolgt die Aggregation entlang separater Dimensionen, während CNNs auf ein lokales rezeptives Fenster beschränkt sind.
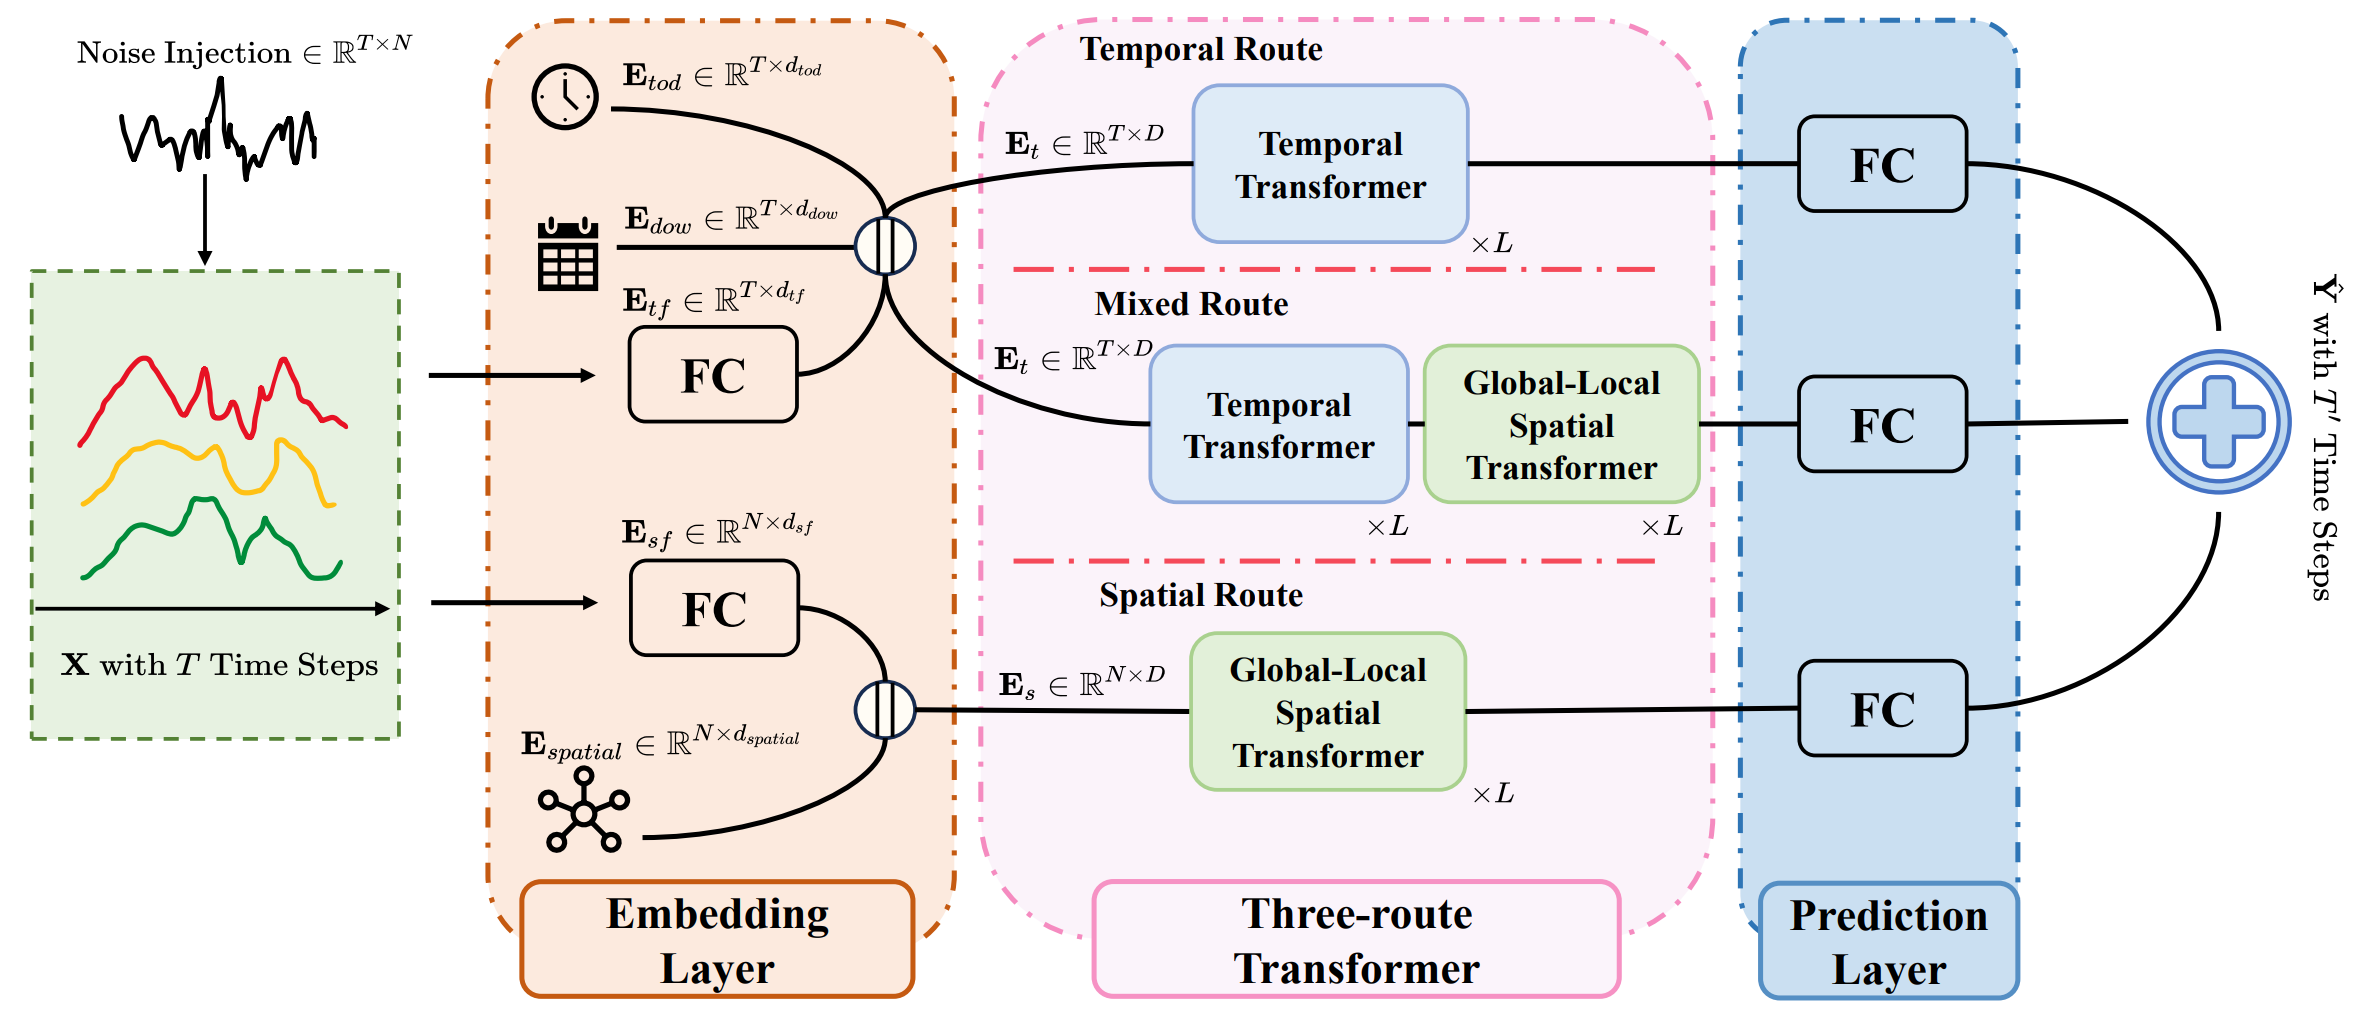
Die Extralonger-Architektur besteht aus drei Hauptkomponenten:
- der Embedding-Schicht,
- dem Transformer-Modul mit drei Verarbeitungspfaden
- der Prognoseschicht.
Die Embedding-Schicht wandelt die Eingabedaten in eine interne Repräsentation um, die zwei Schlüsselelemente umfasst: die räumliche Repräsentation Es und die zeitliche Repräsentation Et. Ein charakteristisches Merkmal der Architektur ist, dass die Daten bereits bei ihrer Eingabe in das System einer Vorverarbeitung unterzogen werden. In den Eingabedatensatz X wird „lernbares Rauschen“ eingebracht, wodurch die Widerstandsfähigkeit des Modells gegenüber durch Marktrauschen verursachten Schwankungen verbessert wird.
Anschließend werden zwei lineare Projektionen mithilfe vollständig verbundener Schichten vorgenommen: Die eine bildet zeitliche Merkmale Etf ∈ RT×dtf, die andere räumliche Merkmale Esf ∈ RN×dsf.
Um die zyklische Natur realer Prozesse zu erfassen, wurden der Extralonger-Architektur lernbare Periodizitäts-Embeddings hinzugefügt. Für die Zeitachse wird das Tageszeit-Embedding Etod ∈ RT×d_tod verwendet, das den Tageszyklus widerspiegelt, sowie das Wochentags-Embedding Edow ∈ RT×d_dow, das die wöchentliche Saisonalität modelliert. In ähnlicher Weise wird für die räumliche Dimension ein lernbares Embedding Espatial ∈ RN×d_spatial eingeführt, das es ermöglicht, stabile räumliche Muster zu erfassen.
Die endgültigen Repräsentationen erhält man durch Konkatenation dieser Embeddings:
- eine zeitliche Repräsentation Et = Etf ‖ Etod ‖ Edow ∈ RT×D,
- eine räumliche Repräsentation Es = Esf ‖ Espatial ∈ RN×D.
Somit fließen grundlegende Zyklen und räumliche Beziehungen bereits in der Phase, in der die Merkmale entstehen, in das Modell ein. Dies ist insbesondere für die Finanzmärkte von großem Wert: Tägliche Schwankungen der Liquidität, wöchentliche Aktivitätsmuster sowie Korrelationen zwischen Finanzinstrumenten und Handelsplätzen spiegeln sich unmittelbar in der Datenstruktur wider.
Das Herzstück des Systems bildet ein Transformer mit drei Verarbeitungspfaden, in dem ein zeitlicher, ein räumlicher und ein gemischter Verarbeitungspfad parallel arbeiten. Durch die Verwendung einer einheitlichen räumlich-zeitlichen Repräsentation können alle drei Verarbeitungspfade gleichzeitig sowohl die zeitliche als auch die räumliche Struktur der Daten berücksichtigen. Gleichzeitig verfolgt jeder Verarbeitungspfad sein eigenes Ziel. Der zeitliche Transformer im rein zeitlichen und im gemischten Verarbeitungspfad ist als Standard-Transformer-Encoder implementiert, während der räumliche und der gemischte Verarbeitungspfad durch ein spezielles Modul – den global-lokalen räumlichen Transformer – ergänzt werden, mit dem sich sowohl lokale als auch globale Beziehungen effektiv erfassen lassen.
Im Gegensatz zum herkömmlichen Self-Attention-Mechanismus, bei dem alle Netzwerkknoten auf dieselbe Weise verarbeitet werden, ohne ihre tatsächliche Struktur zu berücksichtigen, ist der global-lokale räumliche Transformer speziell darauf ausgelegt, die topologischen Merkmale des untersuchten Systems zu nutzen. Bei einem Verkehrsproblem bezieht sich dies auf ein Straßennetz, in dem einige Messstationen direkt miteinander verbunden sind, während andere nur indirekt miteinander verbunden sind. In der Finanzwelt zeigt sich eine ähnliche Struktur in Form eines Graphen von Vermögenswerten: Einige Wertpapiere weisen eine starke Korrelation untereinander auf, während andere lediglich durch globale Markttrends miteinander verbunden sind.
Ein herkömmlicher Transformer behandelt alle Verbindungen als gleichwertig. Dadurch lässt sich zwar das Gesamtbild erfassen, gleichzeitig führt dies jedoch zum Verwischen lokaler Merkmale. Umgekehrt erfassen Modelle, die sich ausschließlich auf lokale Verbindungen konzentrieren, zwar Details gut, verlieren dabei jedoch die Fähigkeit, weitreichende Abhängigkeiten zu erkennen. Genau hier ergibt sich die Notwendigkeit, ein Gleichgewicht zu finden – indem man sowohl globale als auch lokale Muster gleichzeitig berücksichtigt.
Das GLST-Modul setzt diese Idee direkt um, indem es zwei Aufmerksamkeitsmechanismen – einen globalen und einen lokalen – kombiniert. In der ersten Phase werden die Abfrage-, Schlüssel- und Wertmatrizen aus der räumlichen Repräsentation Es gebildet. Auf der Grundlage dieser Matrizen werden die globalen Aufmerksamkeitskoeffizienten berechnet.
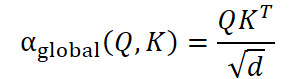
Diese Matrix spiegelt die Stärke der Verbindungen zwischen allen Knoten gleichzeitig wider. Im finanziellen Kontext kann dies als Matrix der Kreuzkorrelationen zwischen Finanzinstrumenten verstanden werden.
Als Nächstes kommt die lokale Aufmerksamkeit ins Spiel. Zu diesem Zweck wird die Adjazenzmatrix A verwendet, die die Struktur der tatsächlichen Verbindungen definiert. Bei verkehrsbezogenen Aufgabenstellungen steht A für Straßenverbindungen; im Finanzwesen hingegen kann eine solche Matrix einen Graphen stabiler Korrelationen oder ein Netzwerk von Wechselbeziehungen zwischen Finanzinstrumenten darstellen. Durch die Verwendung von A wird die Aufmerksamkeit ausschließlich auf benachbarte Knoten beschränkt, wodurch eine lokale Komponente entsteht.

wobei ⊙ das elementweise Produkt bezeichnet.
Somit erfasst die globale Komponente übergreifende Zusammenhänge, während sich die lokale Komponente auf die engsten und bedeutendsten Verbindungen konzentriert.
Beide Matrizen werden einer SoftMax-Normalisierung unterzogen und zu einem einzigen Ausdruck zusammengefasst.
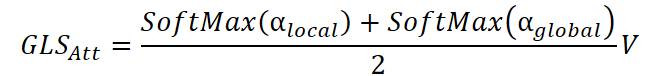
Das Ergebnis ist eine ausgewogene Aggregation, bei der jeder Knoten gleichzeitig Informationen sowohl über das gesamte System als auch über seine unmittelbaren Verbindungen erhält.
Anschließend werden im Sinne des klassischen Transformers eine Normalisierungsschicht, Residualverbindungen (Skip-Connections) und ein Feedforward-Netz angewendet. Diese Schritte ergeben die endgültige, aktualisierte räumliche Repräsentation Ês.
Es ist wichtig, zu betonen, dass dieses Modul besonders gut für Finanzmärkte geeignet ist. Die Korrelationen zwischen Vermögenswerten ändern sich im Laufe der Zeit; die Beziehungen zwischen den Instrumenten können stabil oder dynamisch sein. Der Einsatz von global-lokaler Aufmerksamkeit verleiht dem Modell Flexibilität: Es kann sich an die aktuelle Marktstruktur anpassen, zwischen stabilen und vorübergehenden Zusammenhängen unterscheiden und so eine zuverlässigere Prognose erstellen.
Damit fungiert der global-lokale räumliche Transformer gewissermaßen als Brücke zwischen der Mikro- und der Makroebene der Analyse. Auf der Mikroebene beobachtet er lokale Marktsignale und kurzfristige Zusammenhänge. Auf der Makroebene identifiziert er globale Trends und langfristige Korrelationen. Die Kombination dieser beiden Perspektiven macht das Modell theoretisch robust und im realen Handel einsetzbar, wo gerade die Verbindung von Details und dem übergeordneten Kontext über den Erfolg von Strategien entscheidet.
Sobald der Transformer mit drei Verarbeitungspfaden die Datenverarbeitung abgeschlossen und räumlich-zeitliche Repräsentationen erzeugt hat, beginnt die letzte Phase: die Vorhersage. Ihre Aufgabe besteht darin, abstrakte Embeddings in konkrete Prognosewerte für einen bestimmten Planungshorizont umzuwandeln.
Dazu werden lineare Projektionen verwendet, um die Ausgabetensoren aus dem verborgenen Raum in das Format der Prognosewerte zu überführen. Da die Problemformulierung in Extralonger asymmetrisch ist (T → T′) – das heißt, die Länge des historischen Zeitfensters T und die Länge des Prognoseintervalls T′ sind nicht identisch –, ist es erforderlich, die Ausgaben des Transformers explizit auf die Dimension T′ zu projizieren. Mit anderen Worten: Aus einem historischen Datenabschnitt fester Länge leiten wir eine Prognose für einen längeren oder kürzeren Zeithorizont ab, was insbesondere für die Finanzmärkte von Bedeutung ist, wo die Größe des Zeitfensters je nach Strategie angepasst werden kann.
Nach der Projektion werden die Ergebnisse aller drei Verarbeitungspfade (zeitlich, räumlich und gemischt) kombiniert. Hier lassen die Autoren des Frameworks die Gewichte nicht automatisch lernen, sondern verwenden stattdessen eine vordefinierte Kombination – eine manuelle Abstimmung der Gewichtungskoeffizienten. Dieser Ansatz ermöglicht es uns, den Beitrag jedes einzelnen Verarbeitungspfads zur endgültigen Prognose gezielt anzupassen: Auf Wunsch können wir die Rolle der zeitlichen Komponente bei Märkten mit ausgeprägten Trends hervorheben oder uns umgekehrt auf räumliche Abhängigkeiten konzentrieren, wenn die Struktur der Korrelationen zwischen den Vermögenswerten von größerer Bedeutung ist.
Insgesamt macht die vorgeschlagene Architektur Extralonger zu einem leistungsstarken Werkzeug, bei dem sich die einzelnen Module gegenseitig verstärken. Der zeitliche Verarbeitungspfad erfasst die längerfristige Dynamik der Kursdaten und Handelsvolumina, der räumliche Verarbeitungspfad erfasst die Wechselbeziehungen zwischen Vermögenswerten und Märkten, und der gemischte Verarbeitungspfad vereint beide Aspekte und liefert so einen umfassenden Überblick über die Marktlage.
Nachfolgend ist die von den Autoren erstellte Visualisierung des Frameworks Extralonger dargestellt.
Implementierung mit MQL5
Nachdem wir die theoretischen Aspekte des Frameworks Extralonger behandelt haben, wenden wir uns nun dem praktischen Teil unserer Arbeit zu, in dem wir versuchen werden, eine mögliche Implementierung seiner Algorithmen mithilfe von MQL5 nachzubilden. Der Vorteil der von den Autoren vorgeschlagenen Architektur liegt in ihrer Modularität. Jede Komponente kann isoliert, geprüft und gegebenenfalls ausgetauscht oder modifiziert werden. Dies ist besonders wertvoll für Handelssysteme, bei denen Flexibilität und die Fähigkeit, sich an die spezifischen Merkmale bestimmter Märkte anzupassen, eine wichtige Rolle spielen. In unserem Fall werden wir ebenfalls schrittweise vorgehen – Modul für Modul – und dabei die bereits entwickelten Objekte bestmöglich nutzen, um Funktionsdopplungen zu vermeiden.
Wie im theoretischen Teil bereits erwähnt, beginnt die Verarbeitung der Rohdaten mit der Hinzufügung von lernbarem Rauschen. Es ist jedoch wichtig zu beachten, dass sich „Rauschen“ hier nicht auf die herkömmliche Zufallskomponente bezieht, die von Pseudozufallszahlengeneratoren erzeugt wird. Im Gegenteil, es handelt sich hierbei um eine Matrix aus lernbaren Parametern, die als zusätzliche Verschiebung fungiert. Mit anderen Worten: Es handelt sich hierbei nicht um eine zufällige Verzerrung, sondern um eine gezielte Erweiterung des Merkmalsraums, die es dem Modell ermöglicht, verborgene Zusammenhänge zu erfassen, die in den Originaldaten nicht erkennbar sind.
Wenn wir eine Analogie zu klassischen Architekturen ziehen, erfüllt diese Schicht dieselbe Funktion wie die lernbare Positionskodierung in Transformer-Modellen. Dort ermöglicht sie dem Modell, zwischen Positionen in einer Zeitreihe zu unterscheiden; hier bietet sie zusätzlich die Möglichkeit, die Daten in eine Richtung zu verschieben, die die anschließende Erkennung von Mustern erleichtert. Und genau diese Eigenschaft macht den Ansatz für die Finanzmärkte besonders wertvoll: Solche Verschiebungen können tatsächlich stabile saisonale Muster oder schwache Korrelationen kodieren, die sich nicht direkt in den Kursreihen widerspiegeln.
Unsere Bibliothek enthält bereits das Objekt CNeuronLearnabledPE, das eine ähnliche Funktion erfüllt. Es dient dazu, den Eingabedaten eine lernbare positionsbezogene Verschiebung hinzuzufügen, und eignet sich bei der Implementierung des Extralonger-Frameworks ideal für das Hinzufügen von lernbarem Rauschen. Im Grunde genommen können wir eine vorgefertigte, bewährte Lösung nutzen, ohne eine neue Komponente entwickeln zu müssen.
Das spart nicht nur Aufwand, sondern gewährleistet auch Zuverlässigkeit, da das Objekt bereits in früheren Experimenten getestet wurde.
Der nächste Schritt nach dem Hinzufügen der lernbaren Verschiebung besteht darin, Projektionen in der zeitlichen und räumlichen Ebene zu bilden. In der theoretischen Beschreibung des Extralonger-Frameworks werden zu diesem Zweck zwei vollständig verbundene Schichten verwendet; diese arbeiten parallel und erzeugen zwei Sätze von Embeddings.
In unserer Implementierung können wir diese Aufgabe an Faltungsschichtobjekte vom Typ CNeuronConvOCL delegieren. Diese Lösung ist naheliegend und praktisch. Faltungsoperationen haben sich bereits als vielseitiges Werkzeug zur Transformation von Eingabe-Arrays bewährt. Durch die Festlegung der Größe des Faltungskerns lässt sich die Anzahl der Ein- und Ausgangskanäle ganz einfach steuern. Folglich lässt sich die Bildung zeitlicher und räumlicher Projektionen durch zwei parallele Faltungsschichten umsetzen: Die erste arbeitet entlang der Zeitachse und bildet Et, während die zweite entlang der Knotenachse arbeitet und Es bildet. Dies steht voll und ganz im Einklang mit der Idee der Autoren von Extralonger und gewährleistet gleichzeitig die Einheitlichkeit unserer Implementierung.
Hinzufügen räumlicher Embeddings
Als Nächstes folgt die Phase, in der räumliche und zeitliche Embeddings hinzugefügt werden. Auf den ersten Blick gibt es hier keine besonderen Schwierigkeiten. Wir sind schon früher auf ähnliche Vorgänge gestoßen. Das Erstellen eines räumlichen Embeddings mit einer festen Datenstruktur ähnelt dem vorherigen Schritt, bei dem lernbares Rauschen hinzugefügt wurde. In dieser Phase summieren wir die Tensoren jedoch nicht, sondern konkatenieren sie und kombinieren so Informationen aus verschiedenen Quellen. Der Prozess wird im neuen Objekt CNeuronSpatialEmbedding implementiert, das die Kernfunktionalität von CNeuronBaseOCL erbt und entsprechend unseren Anforderungen erweitert.
class CNeuronSpatialEmbedding   :     public CNeuronBaseOCL
  {
protected:
   uint              iWindow;
   uint              iUnits;
   uint              iEmbeddingDim;
   CParams           cEmbedding;
   //---
   virtual bool      feedForward(CNeuronBaseOCL *NeuronOCL) override;
   virtual bool      updateInputWeights(CNeuronBaseOCL *NeuronOCL) override;
   virtual bool      calcInputGradients(CNeuronBaseOCL *NeuronOCL) override;

public:
                     CNeuronSpatialEmbedding(void) {};
                    ~CNeuronSpatialEmbedding(void) {};
   //---
   virtual bool      Init(uint numOutputs, uint myIndex, COpenCLMy *open_cl,
                          uint units, uint window, uint embed_dim,
                          ENUM_OPTIMIZATION optimization_type, uint batch);
   //---
   virtual int       Type(void)   const   {  return defNeuronSpatialEmbedding;   }
   //--- methods for working with files
   virtual bool      Save(int const file_handle) override;
   virtual bool      Load(int const file_handle) override;
   //---
   virtual bool      WeightsUpdate(CNeuronBaseOCL *source, float tau) override;
   virtual void      SetOpenCL(COpenCLMy *obj) override;
   virtual void      SetActivationFunction(ENUM_ACTIVATION value) override { };
  };
Die Architektur des Neurons wird in der Initialisierungsmethode Init definiert. Hier werden die wichtigsten Parameter festgelegt: die Anzahl der einzelnen Sequenzen, die Größe jeder einzelnen Sequenz und die Embedding-Dimension.
bool CNeuronSpatialEmbedding::Init(uint numOutputs, uint myIndex, COpenCLMy *open_cl,
                                   uint units, uint window, uint embed_dim,
                                   ENUM_OPTIMIZATION optimization_type, uint batch)
  {
   if(!CNeuronBaseOCL::Init(numOutputs, myIndex, open_cl, (window + embed_dim)*units,
                                                           optimization_type, batch))
      return false;
   activation = None;
Innerhalb der Methode wird zunächst die übergeordnete Neuronenklasse mit OpenCL-Unterstützung initialisiert. Die Dimension des Ergebnistensors berechnet sich als Summe aus der Länge der Repräsentation einer einzelnen Sequenz und der Embedding-Dimension, multipliziert mit der Anzahl solcher Sequenzen. Sollte die Basisinitialisierung fehlschlagen, wird die Methode ordnungsgemäß beendet und gibt ein Fehlersignal zurück.
Als Nächstes konfiguriert das Neuron die Aktivierungsfunktion, obwohl diese vom Neuron selbst noch nicht verwendet wird.
Als Nächstes initialisieren wir das Objekt zur Erzeugung der Embeddings. Hier verwenden wir den Tangens hyperbolicus TANH als Aktivierungsfunktion; er führt eine Nichtlinearität ein und beschränkt die Werte auf den Bereich [-1, 1]. Dies hilft dem Modell dabei, robustere Darstellungen von Marktmustern zu erstellen, und verhindert, dass Extremwerte einen übermäßigen Einfluss auf den Lernprozess ausüben.
   if(!cEmbedding.Init(0, 0, OpenCL, embed_dim * units, optimization, iBatch))
      return false;
   cEmbedding.SetActivationFunction(TANH);
//---
   iUnits = units;
   iWindow = window;
   iEmbeddingDim = embed_dim;
//---
   return true;
  }
Die Parameter des Neurons werden anschließend für nachfolgende Vorwärts- und Rückwärtsdurchläufe gespeichert.
Dadurch schlägt die Init-Methode eine nahtlose Brücke zwischen Theorie und Praxis. Das Neuron ist nun vollständig bereit, Daten zu verarbeiten, Embeddings zu konkatenieren und strukturierte Informationen weiterzugeben. Dies bildet eine solide Grundlage für die Entwicklung von Handelsmodellen, mit denen Marktsignale über verschiedene Zeithorizonte hinweg analysiert und verborgene Zusammenhänge erkannt werden können, die für fundierte Handelsentscheidungen von Bedeutung sind.
Die Methode feedForward implementiert den Algorithmus für den Vorwärtsdurchlauf der Daten durch das Neuron – von den Eingängen zu den Ausgängen. Im Finanzkontext lässt sich dies damit vergleichen, wie ein Trader historische Daten systematisch analysiert und sich ein umfassendes Bild von der aktuellen Marktsituation verschafft.
Zunächst prüft das System, ob der Zeiger auf das vorhergehende NeuronOCL-Neuron gültig ist. Ist dieser nicht vorhanden, gibt die Methode sofort false zurück. Das ist wichtig. Ohne Quelldaten ist ein Vorwärtsdurchlauf unmöglich, genauso wie es unmöglich ist, Entscheidungen ohne Kursdaten zu treffen.
bool CNeuronSpatialEmbedding::feedForward(CNeuronBaseOCL *NeuronOCL)
  {
   if(!NeuronOCL)
      return false;
Befindet sich das Neuron im Trainingsmodus (bTrain=true), wird anschließend ein Vorwärtsdurchlauf für das cEmbedding-Objekt durchgeführt. Hier werden räumliche Embeddings generiert, die wichtige Marktzusammenhänge innerhalb des ausgewählten Datenfensters kodieren. Sollte dieser Vorgang fehlschlagen, gibt die Methode false zurück, um auf ein Problem bei der Erstellung der Embeddings hinzuweisen.
   if(bTrain)
      if(!cEmbedding.FeedForward())
         return false;
Bitte beachten Sie, dass dieser Vorgang ausschließlich während des Trainingsprozesses durchgeführt wird. Schließlich hängen die Embeddings in diesem Fall nicht von den Quelldaten ab, sondern kodieren lediglich die Positionen der Sequenzen. Folglich bleiben die Werte während des Betriebs unverändert, und wir vermeiden unnötige Schritte, was den Entscheidungsprozess beschleunigt.
Sobald die Embeddings generiert wurden, besteht der nächste wichtige Schritt in der Konkatenation der Quelldaten mit den Embeddings. Die Methode Concat kombiniert die Ausgaben des vorherigen Neurons und das Embedding zu einem einzigen Tensor Output, wobei die Repräsentationsgröße jeder einzelnen Sequenz und die Embedding-Dimension berücksichtigt werden.
   if(!Concat(NeuronOCL.getOutput(), cEmbedding.getOutput(), Output, iWindow, iEmbeddingDim, iUnits))
      return false;
//---
   return true;
  }
Wenn schließlich alle Operationen erfolgreich waren, gibt die Methode true zurück, was bedeutet, dass der Vorwärtsdurchlauf des Neurons korrekt abgeschlossen wurde und der Ergebnistensor bereit ist, an die nächste Schicht des Modells weitergeleitet zu werden.
Wie Sie sehen können, ist der Algorithmus der Methode für den Vorwärtsdurchlauf recht einfach und linear aufgebaut. Er überprüft nacheinander die Eingabedaten, generiert räumliche Embeddings und konkateniert diese mit den Ausgaben der vorherigen Schicht, wodurch ein Tensor entsteht, der zur Weiterleitung bereit ist. Die Methoden für den Rückwärtsdurchlauf sind ähnlich aufgebaut und folgen demselben Muster, jedoch in umgekehrter Richtung. Dank dieser klaren und einheitlichen Struktur sind beide Methoden leicht verständlich und ermöglichen es Ihnen, sich auf die wesentlichen Merkmale der Verarbeitung von Finanzzeitreihen durch ein Neuron zu konzentrieren.
Für ein vertieftes Verständnis empfehlen wir Ihnen, die Implementierung des Rückwärtsdurchlaufs selbstständig zu untersuchen. Der vollständige Code der Klasse CNeuronSpatialEmbedding und aller ihrer Methoden ist im Anhang enthalten, sodass die Funktionsweise des Neurons von der Initialisierung über die Erzeugung des Embeddings bis hin zur Übertragung von Informationen an das Modell nachvollzogen werden kann.
Zeitliches Embedding
Etwas komplizierter wird es, wenn es um zeitliche Embeddings geht. Erstens gibt es mehrere davon, und jedes kodiert unterschiedliche zeitliche Zyklen. Die Autoren des Frameworks schlagen vor, zwei Ebenen zu verwenden: eine Ebene für den Tageszyklus und eine für den Wochenzyklus. Diese Aufgabe ist uns aus unseren früheren Experimenten mit dem zeitlichen Encoder des HimNet-Frameworks bekannt, bei denen wir ebenfalls Embeddings für Zeitreihen generiert haben. Damals wurden rekurrente Blöcke verwendet, und bei jedem Schritt erhielt der Eingabedaten-Tensor nur die Embeddings des gerade analysierten Zustands.
Jetzt ist die Aufgabe etwas schwieriger. Bei jedem Durchlauf durch das Neuron wird eine gesamte zeitliche Sequenz analysiert, und jeder ihrer Zeitschritte muss sein eigenes zeitliches Embedding erhalten. Dies ähnelt der Arbeit eines Traders, der nicht nur den aktuellen Kurs oder einen Indikator betrachtet, sondern gleichzeitig eine ganze Reihe historischer Signale auswertet, um verborgene Zyklen und Muster zu erkennen.
Wir werden natürlich die Entwicklungen von HimNet nutzen, diese jedoch an die neue Architektur anpassen, bei der zeitliche Embeddings für alle Zeitschritte der Sequenz gleichzeitig generiert werden, wodurch das Modell die Marktdynamik genauer erfassen und angemessener auf Marktveränderungen reagieren kann.
Wir beginnen mit der Implementierung des Algorithmus für zeitliche Embeddings im OpenCL-Programm, in dem wir den Kernel ConcatByLabel erstellen. Dieser Kernel konkateniert die Eingabedaten mit Embeddings mehrerer Ebenen – in unserem Fall mit zwei zeitlichen Embeddings, die den tagesinternen und wocheninternen Zyklen entsprechen. Im finanziellen Kontext lässt sich dies mit der gleichzeitigen Analyse mehrerer Zeithorizonte vergleichen: Sowohl kurzfristige Schwankungen als auch längerfristige Zyklen beeinflussen die Prognose, und das Modell muss sie alle berücksichtigen.
Der Kernel verwendet ein dreidimensionales Raster globaler Kennungen: row_id, col_id und buffer_id. Dadurch können wir die Zeilen und Spalten des Quelltensors gleichzeitig verarbeiten und auswählen, mit welchem Puffer wir arbeiten – mit dem Quelldatenpuffer oder einem der Embedding-Puffer.
__kernel void ConcatByLabel(__global const float* data,
                            __global const float* label,
                            __global const float* embedding1,
                            __global const float* embedding2,
                            __global float *output,
                            const int dimension_data,
                            const int dimension_emb1,
                            const int dimension_emb2,
                            const int frame1,
                            const int frame2,
                            const int period1,
                            const int period2
                           )
  {
   const size_t row_id = get_global_id(0);
   const size_t col_id = get_global_id(1);
   const size_t buffer_id = get_global_id(2);
   const size_t total_rows = get_global_size(0);
   const size_t total_cols = get_global_size(1);
   const size_t total_buffers = get_global_size(2);
Zunächst werden jedem Thread globale Kennungen zugewiesen:
- row_id – der Zeilenindex, der einem Zeitstempel oder einem Zeitschritt einer Zeitreihe entspricht;
- col_id – der Spaltenindex, der einer bestimmten Variablen oder einem bestimmten Merkmal entspricht;
- buffer_id — gibt an, mit welchem Puffer dieser Thread arbeitet: dem Puffer für die Eingabedaten, dem ersten oder dem zweiten Embedding-Puffer.
Die globalen Dimensionen des Problemraums bestimmen das gesamte Thread-Raster. An dieser Stelle ist es wichtig zu verstehen, dass total_buffers festlegt, wie viele verschiedene Datensätze wir konkatenieren. Die endgültige Dimensionalität des Ausgabevektors wird entsprechend bestimmt.
   __global const float *buffer;
   int dimension_in, dimension_out;
   int shift_in, shift_out;
//---
   switch(total_buffers)
     {
      case 1:
         dimension_out = dimension_data;
         break;
      case 2:
         dimension_out = dimension_data + dimension_emb1;
         break;
      case 3:
         dimension_out = dimension_data + dimension_emb1 + dimension_emb2;
         break;
      default:
         return;
     }
Wenn mehr als drei Puffer vorhanden sind, kehrt der aktuelle Thread einfach aus dem Kernel zurück, wodurch eine fehlerhafte Verwendung verhindert wird.
Im nächsten Schritt wird ein bestimmter Puffer ausgewählt, und die Versätze für das Lesen und Schreiben von Daten werden berechnet.
   switch(buffer_id)
     {
      case 0:
         buffer = data;
         dimension_in = dimension_data;
         shift_in = RCtoFlat(row_id, col_id, total_rows, dimension_in, 0);
         shift_out = RCtoFlat(row_id, col_id, total_rows, dimension_out, 0);
         break;
      case 1:
         buffer = embedding1;
         dimension_in = dimension_emb1;
         shift_in = ((int)IsNaNOrInf(label[row_id] / frame1, 0)) % period1;
         shift_in = RCtoFlat(shift_in, col_id, period1, dimension_in, 0);
         shift_out = RCtoFlat(row_id, dimension_data + col_id, total_rows, dimension_out, 0);
         break;
      case 2:
         buffer = embedding2;
         dimension_in = dimension_emb2;
         shift_in = ((int)IsNaNOrInf(label[row_id] / frame2, 0)) % period2;
         shift_in = RCtoFlat(shift_in, col_id, period2, dimension_in, 0);
         shift_out = RCtoFlat(row_id, dimension_data + dimension_emb1 + col_id, total_rows,
                                                                           dimension_out, 0);
         break;
     }
Für die Eingabedaten werden shift_in und shift_out direkt mithilfe der Funktion RCtoFlat berechnet, die die zweidimensionalen Zeilen- und Spaltenindizes in einen linearen Index des globalen Puffers umwandelt.
Bei Embeddings hängt shift_in vom Zeitstempelwert des jeweiligen Sequenzschritts, label[row_id], geteilt durch die Periode (frame1 oder frame2), ab. Dies ermöglicht die zyklische Auswahl eines Embeddings, das einer bestimmten Phase des Zeitzyklus entspricht, was insbesondere für Finanzdaten mit wiederkehrenden Mustern innerhalb eines Tages und innerhalb einer Woche von Bedeutung ist.
Nachdem die Vorbereitungsarbeiten abgeschlossen sind, werden die entsprechenden Daten in den Ergebnispuffer geschrieben.
   if(col_id < dimension_in)
      output[shift_out] = IsNaNOrInf(buffer[shift_in], 0);
  }
An dieser Stelle ist zu beachten, dass wir von unterschiedlichen Dimensionalitäten für die Eingabedaten und die Embeddings ausgehen. Wenn der Kernel zur Ausführung in die Warteschlange gestellt wird, wird der maximale Parameterwert verwendet; daher prüfen wir vor der Durchführung von Pufferzugriffsoperationen, ob der Spaltenindex für den verwendeten Puffer gültig ist. Zudem werden die Daten von ungültigen Werten (NaN oder Inf) bereinigt, um nachfolgende Berechnungen nicht zu beeinträchtigen.
Im Ergebnis erzeugt der Kernel einen vollständig konkatenierten Tensor, der alle angegebenen Embeddings und die Eingabedaten berücksichtigt. Jeder Zeitschritt erhält einen eigenen Satz von Embeddings, wodurch das Modell die gesamte Marktdynamik auf einmal erfassen kann – einschließlich kurzfristiger Schwankungen und längerer Zyklen –, was die Qualität der Prognosen und die Robustheit der Handelsmodelle verbessert.
Sobald der Algorithmus für den Vorwärtsdurchlauf entwickelt wurde, ist der nächste logische Schritt die Implementierung der Fehlerrückpropagation. Während der Vorwärtsdurchlauf Embeddings generiert und diese mit den Eingabedaten kombiniert, ist der Rückwärtsdurchlauf dafür zuständig, die Gewichte anzupassen und die Qualität der Informationsrepräsentationen zu verbessern. Im finanziellen Kontext lässt sich dies mit der Arbeit eines Traders vergleichen, der durch die Auswertung der Folgen vergangener Entscheidungen seine Strategie für den nächsten Schritt anpasst. Anhand von Prognosefehlern aus früheren Zeitschritten kann das Modell die Embeddings anpassen, um die Marktdynamik besser widerzuspiegeln.
In diesem Fall findet die Fehlerrückpropagation zwischen den Eingabedaten und den entsprechenden Embeddings statt. Und dies ist im Kernel ConcatByLabelGrad implementiert. Im Wesentlichen handelt es sich hierbei um den Schritt, in dem das Netzwerk Fehler zurückpropagiert und sie so an jede Komponente weitergibt, sodass die Gewichte angepasst und die Vorhersage verbessert werden können.
__kernel void ConcatByLabelGrad(__global float* data_gr,
                                __global const float* label,
                                __global float* embedding1_gr,
                                __global float* embedding2_gr,
                                __global float *output_gr,
                                const int dimension_data,
                                const int dimension_emb1,
                                const int dimension_emb2,
                                const int frame1,
                                const int frame2,
                                const int period1,
                                const int period2,
                                const int units
                               )
  {
   const size_t row_id = get_global_id(0);
   const size_t col_id = get_global_id(1);
   const size_t buffer_id = get_global_id(2);
   const size_t total_rows = get_global_size(0);
   const size_t total_cols = get_global_size(1);
   const size_t total_buffers = get_global_size(2);
//---
   __global float *buffer;
   int dimension_in, dimension_out;
   int shift_in, shift_out, shift_col;
   int period, frame, rows;
Zunächst wird jeder Thread im dreidimensionalen Problemraum identifiziert. Dadurch kann ein separater Thread eine bestimmte Kombination aus Zeitschritt, Merkmal und Puffer verarbeiten.
Als Nächstes wird die endgültige Dimensionalität des Ergebnistensors – in diesem Fall der Fehlergradienten – bestimmt.
   switch(total_buffers)
     {
      case 1:
         dimension_out = dimension_data;
         break;
      case 2:
         dimension_out = dimension_data + dimension_emb1;
         break;
      case 3:
         dimension_out = dimension_data + dimension_emb1 + dimension_emb2;
         break;
      default:
         return;
     }
Ich denke, Ihnen sind die wiederkehrenden Operationen aus dem Kernel für den Vorwärtsdurchlauf aufgefallen. Im weiteren Verlauf gibt es jedoch Unterschiede. Wenn es sich bei dem zu verarbeitenden Puffer um die Eingabedaten handelt (buffer_id == 0), werden die Gradienten einfach direkt aus dem Fehlergradientenpuffer auf der Ausgabeebene kopiert. Danach kehren wir aus dem Kernel zurück.
   switch(buffer_id)
     {
      case 0:
         if(col_id < dimension_data && row_id<units)
           {
            shift_in = RCtoFlat(row_id, col_id, total_rows, dimension_in, 0);
            shift_out = RCtoFlat(row_id, col_id, total_rows, dimension_out, 0);
            data_gr[shift_in] = IsNaNOrInf(output_gr[shift_out], 0);
           }
         return;
Bei Embeddings (buffer_id == 1 oder 2) ist der Algorithmus jedoch etwas komplexer. Hier bestimmen wir zunächst die Periode und den Versatz, für die wir Gradienten sammeln.
      case 1:
         rows = period1;
         buffer = embedding1_gr;
         dimension_in = dimension_emb1;
         shift_in = RCtoFlat(row_id, col_id, period1, dimension_in, 0);
         shift_col = dimension_data;
         period = period1;
         frame = frame1;
         break;
      case 2:
         rows = period2;
         buffer = embedding2_gr;
         dimension_in = dimension_emb2;
         shift_in = RCtoFlat(row_id, col_id, period2, dimension_in, 0);
         shift_col = dimension_data + dimension_emb1;
         period = period2;
         frame = frame2;
         break;
     }
Als Nächstes prüfen wir, ob der aktuelle Thread hinsichtlich der Repräsentationsdimension und der Datenperiodizität innerhalb der Grenzen des entsprechenden Embeddings liegt. Erst dann richten wir eine Schleife ein, die alle Zeitschritte des Fehlergradiententensors auf der Ausgabeebene durchläuft und den Fehlerbeitrag für jedes Embedding akkumuliert.
   if(row_id >= rows || col_id >= dimension_in)
      return;
   float grad = 0;
   for(uint r = 0; r < total_rows; r ++)
     {
      int row = ((int)IsNaNOrInf(label[r] / frame, 0)) % period;
      if(row != row_id)
         continue;
         shift_out = RCtoFlat(r, shift_col + col_id, total_rows, dimension_out, 0);
      grad += IsNaNOrInf(output_gr[shift_out], 0);
     }
   buffer[shift_in] = IsNaNOrInf(grad, 0);
  }
Im Schleifenkörper ermitteln wir zunächst, zu welcher Position innerhalb der Periode der aktuelle Schritt gehört, damit die Gradienten entsprechend der jeweiligen Phasenposition des Zeitzyklus akkumuliert werden. Nur wenn der resultierende Wert mit dem zu analysierenden Element übereinstimmt, summieren wir die Fehler auf der Ausgabeebene.
Der akkumulierte Fehlergradient wird in den globalen Gradientenpuffer für das entsprechende Embedding geschrieben. Vergessen Sie dabei nicht, das erhaltene Ergebnis zu bereinigen, indem Sie alle ungültigen Werte (NaN oder Inf) entfernen.
Dadurch verteilt der Kernel ConcatByLabelGrad die Fehler präzise auf die Eingabedaten und die Embeddings und stellt so sicher, dass die Gewichte auf allen Ebenen der zeitlichen Sequenz korrekt aktualisiert werden. Dadurch kann sich das Modell an die komplexen Zyklen finanzieller Zeitreihen anpassen, was die Prognosegenauigkeit und die Robustheit gegenüber Rauschen verbessert.
Wir haben viel Arbeit investiert, und der Artikel ist bereits recht umfangreich geworden. Ich schlage vor, wir machen eine kurze Pause, damit wir die Informationen sacken lassen und sie in Ruhe verarbeiten können. Wir werden die begonnene Umsetzung fortsetzen und im nächsten Artikel ausführlich darauf eingehen.
Fazit
In diesem Artikel haben wir uns mit dem Extralonger-Framework befasst, das räumliche und zeitliche Faktoren in einem einzigen Modell zur Prognose von Zeitreihen vereint. Dieser Ansatz reduziert die Rechenkomplexität und den Speicherbedarf im Vergleich zu herkömmlichen Methoden erheblich. Dadurch werden die Prognosehorizonte auf ein bisher unerreichtes Maß erweitert.
Der besondere Vorteil dieses Ansatzes liegt darin, dass jedem Element der Zeitreihe ein eigenes Embedding zugewiesen wird, wodurch das Modell sowohl kurzfristige Schwankungen als auch langfristige Muster gleichzeitig berücksichtigen kann. Dieses Prinzip lässt sich auf eine Vielzahl von Problemstellungen anwenden, bei denen das Zusammenspiel von räumlichen und zeitlichen Faktoren eine wichtige Rolle spielt – von den Finanzmärkten über die städtische Infrastrukturplanung bis hin zur Wettervorhersage.
Extralonger eröffnet neue Möglichkeiten für die Erstellung effektiver Prognosemodelle auf der Grundlage von räumlich-zeitlichen Daten und vereint dabei hohe Genauigkeit, Ressourceneffizienz und Skalierbarkeit über lange Zeithorizonte hinweg.
Literaturverzeichnis
- Extralonger: Toward a Unified Perspective of Spatial-Temporal Factors for Extra-Long-Term Traffic Forecasting
- Weitere Artikel in dieser Reihe
In diesem Artikel verwendete Software
| # | Name | Typ | Beschreibung |
|---|---|---|---|
| 1 | Study.mq5 | Expert Advisor | Expert Advisor für das Offline-Modelltraining |
| 2 | StudyOnline.mq5 | Expert Advisor | Expert Advisor für Online-Modelltraining |
| 3 | Test.mq5 | Expert Advisor | Expert Advisor zum Testen des Modells |
| 4 | Trajectory.mqh | Klassenbibliothek | Struktur zur Beschreibung des Systemzustands und der Modellarchitektur |
| 5 | NeuroNet.mqh | Klassenbibliothek | Klassenbibliothek zum Erstellen eines neuronalen Netzes |
| 6 | NeuroNet.cl | Bibliothek | Codebibliothek für ein OpenCL-Programm |
Übersetzt aus dem Russischen von MetaQuotes Ltd.
Originalartikel: https://www.mql5.com/ru/articles/19494
Warnung: Alle Rechte sind von MetaQuotes Ltd. vorbehalten. Kopieren oder Vervielfältigen untersagt.
Dieser Artikel wurde von einem Nutzer der Website verfasst und gibt dessen persönliche Meinung wieder. MetaQuotes Ltd übernimmt keine Verantwortung für die Richtigkeit der dargestellten Informationen oder für Folgen, die sich aus der Anwendung der beschriebenen Lösungen, Strategien oder Empfehlungen ergeben.



