

Redes neuronales en el trading: señales de trading estables en cualquier régimen de mercado (Módulos de atención)
 77
 1

Introducción
Los mercados financieros son un organismo vivo que respira, evoluciona y cambia constantemente. Aquí no existe una estabilidad absoluta. Las correlaciones habituales entre activos pueden desaparecer en tan solo unas pocas sesiones de negociación. El mercado no es solo cifras en gráficos, sino también un reflejo de las emociones, las expectativas y las decisiones humanas, que se entrelazan en una red de relaciones sumamente compleja. Y en este mundo de caos e incertidumbre, son especialmente valiosas las herramientas capaces de percibir el orden oculto.
El framework ST-Expert, del que empezamos a hablar en el artículo anterior, se creó precisamente para buscar patrones allí donde los métodos habituales de análisis resultan ineficaces. Su principal característica es su capacidad para combinar dos dimensiones: la temporal y la espacial. El aspecto temporal es un elemento clásico de la previsión financiera: el análisis de datos históricos, el intento de predecir el futuro basándose en cotizaciones pasadas. El aspecto espacial aporta un nuevo nivel de comprensión: el mercado se considera una red en la que cada activo está vinculado a los demás, y los cambios en un segmento repercuten inevitablemente en los segmentos relacionados.
Imagine que estamos analizando el mercado de valores. Si el precio del petróleo comienza a subir, esto se refleja casi de inmediato en las cotizaciones de las empresas petroleras. Y dicha tendencia puede extenderse a las divisas de los países productores de petróleo y a sectores enteros de industrias afines. El modelo clásico, basado únicamente en series temporales de precios, solo ve la trayectoria lineal de un instrumento concreto. ST-Expert, en cambio, es capaz de captar toda la cascada de cambios, ya que no solo trabaja con el tiempo, sino también con el espacio de las relaciones de mercado.
La arquitectura del framework se basa en el principio de Mixture of Experts (mezcla de expertos). Este enfoque puede compararse con el trabajo de un comité de inversión. En él se reúnen analistas de diferentes especialidades: uno se especializa en análisis técnico, otro en macroeconomía y un tercero se dedica a estudiar las correlaciones entre sectores. Por separado, cada uno de ellos tiene unas capacidades limitadas. Pero cuando se suman sus opiniones, la decisión final resulta estar mucho más cerca de la realidad. Lo mismo ocurre en ST-Expert: cada bloque experto se encarga de su propia área de análisis, y el sistema combina sus previsiones para formular una decisión integral.
Esta distribución de tareas aporta al sistema tres ventajas fundamentales:
- Capacidad de adaptación. El mercado cambia cada minuto, y el sistema debe adaptarse a esos cambios. Si ayer el principal factor impulsor del movimiento se encontraba en el sector de las materias primas y hoy son las divisas, ST-Expert se adapta, redistribuyendo el peso de los expertos.
- Robustez. Cuando uno de los expertos se equivoca, la calidad de la previsión global se mantiene gracias al consenso colectivo. Esto reduce el riesgo de que el sistema termine sesgándose hacia una sola estrategia y hace que el sistema sea más fiable.
- Interpretabilidad. Para un trader, es importante comprender no solo el resultado de la previsión, sino también sus causas. En ST-Expert siempre se puede ver qué experto ha realizado la mayor contribución y qué relaciones han resultado significativas. Esto hace que el sistema no sea una «caja negra», sino una herramienta con la que se puede trabajar de forma consciente.
Si hablamos en términos de trading, ST-Expert no es solo un indicador, sino todo un sistema de navegación. Tiene en cuenta las tendencias, detecta los impulsos locales, analiza las correlaciones entre activos y traza un mapa del mercado en tiempo real. Es más, el sistema es capaz de actualizar este mapa cuando las rutas habituales quedan cortadas. En la práctica, esto se traduce en menos señales falsas y más decisiones que se ajustan a la dinámica real del mercado.
La arquitectura del framework incluye varios elementos clave. En el centro hay un modelo de grafo, en el que los vértices representan activos o puntos temporales, y las aristas, las relaciones entre ellos. Estas relaciones pueden ser directas y evidentes, como la dependencia del oro respecto al tipo de cambio del dólar, o ocultas, como las correlaciones entre acciones concretas dentro de un mismo sector. El objetivo del sistema no es solo registrar estas relaciones, sino también ser capaz de reestructurarlas cuando el mercado imponga nuevas condiciones.
El módulo de combinación adaptativa de grafos desempeña un papel fundamental. Se le puede comparar con el director de una orquesta. Cada instrumento tiene su propia parte, pero es el director quien decide qué voz debe sonar más fuerte en el momento adecuado. Si algunas relaciones pierden importancia, el sistema refuerza otras, manteniendo así la integridad de la predicción.
El mecanismo de aprendizaje de ST-Expert es igualmente importante. Está diseñado para que el sistema se familiarice con distintos escenarios. Esto le permite estar preparado para afrontar nuevas situaciones, ya sea un repentino aumento del flujo de noticias, un cambio en las correlaciones o la aparición de nuevos factores impulsores del mercado. En el lenguaje del trading, esto equivale a prepararse para cualquier escenario de mercado: desde un movimiento lateral tranquilo hasta una tendencia fuerte.
A continuación se muestra una representación del framework ST-Expert realizada por el autor.
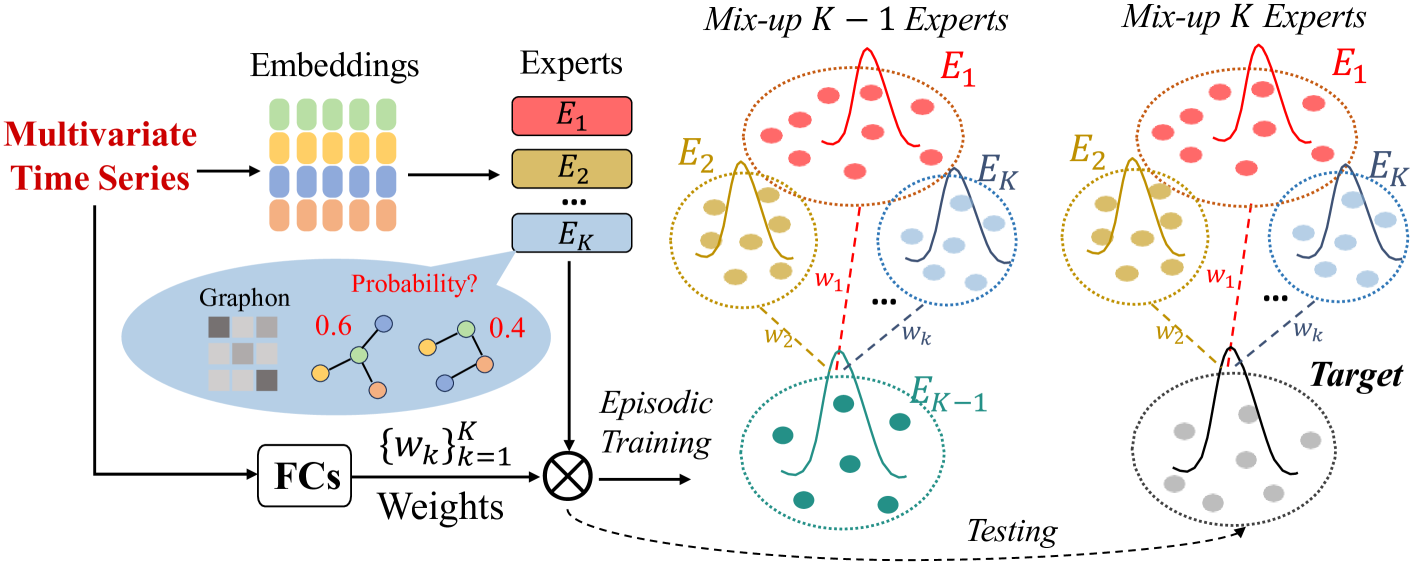
En el artículo anterior no nos limitamos a la teoría, sino que dimos el primer paso hacia la implementación práctica de los enfoques de ST-Expert mediante MQL5. Así, creamos un objeto de generación de grafones, un elemento clave de la arquitectura encargado de modelar las relaciones probabilísticas. Este componente fundamental sienta las bases para el análisis adaptativo de las estructuras espaciales.
Hoy vamos a continuar el trabajo iniciado. Nuestro objetivo es desarrollar la implementación del framework paso a paso, para que deje de ser un conjunto de ideas y se convierta en una herramienta completa de trading algorítmico.
Ideas de uso
Al pasar a trabajar en el modelo, conviene recordar otra característica importante del framework ST-Expert: su versatilidad. Los autores del framework subrayan que los enfoques que proponen no se limitan únicamente al uso en modelos de grafos. Por el contrario, pueden integrarse en los más diversos modelos clásicos, potenciándolos y dotándolos de nuevas propiedades. En esencia, se trata de la modularidad. ST-Expert puede considerarse un conjunto de componentes adaptativos, capaces de funcionar tanto de forma independiente como integrados en sistemas más amplios.
Esta versatilidad resulta especialmente valiosa en el ámbito financiero. Y es que un trader o un investigador rara vez se limita a un solo modelo; lo más habitual es que utilice todo un conjunto de herramientas. La posibilidad de integrar en ellos los enfoques de ST-Expert abre un amplio abanico de posibilidades para la experimentación. Es posible reforzar su robustez frente a los desplazamientos espaciales, ampliar las posibilidades de análisis o añadir un nuevo nivel de interpretabilidad.
En este artículo hemos decidido desarrollar precisamente esta línea de investigación. Hemos elegido el framework Extralonger como base experimental. En su base se encuentra la idea de combinar factores locales y globales, lo que permite modelar con mayor precisión los procesos complejos del mercado financiero.
La integración de ST-Expert y Extralonger parece un paso lógico. El primero incorpora al sistema un mecanismo para trabajar con grafos dinámicos y una mezcla de expertos capaces de adaptarse a los cambios en la estructura de las relaciones. El segundo ofrece un entorno depurado para trabajar con series temporales y módulos de análisis espaciotemporal ya implementados. Juntos forman una simbiosis en la que cada parte potencia a la otra. Extralonger obtiene un nivel adicional de adaptabilidad y robustez, mientras que ST-Expert cuenta con una plataforma contrastada para su integración en el trading algorítmico.
Imaginemos cómo podría ser esto en la práctica. Supongamos que Extralonger analiza el comportamiento de un par de divisas y elabora una previsión basándose en la evolución temporal. Sin embargo, llega un momento en el que las cotizaciones de las materias primas o los índices bursátiles empiezan a influir de forma significativa en el mercado. Si solo se utilizan las funciones básicas de Extralonger, es posible que este cambio de factores impulsores pase desapercibido. Sin embargo, los módulos integrados de ST-Expert, que funcionan con grafones y bloques expertos, detectarán nuevas relaciones y reestructurarán el panorama. Como resultado, la previsión mantiene su precisión, incluso si las condiciones del mercado han cambiado radicalmente.
Para pasar de la idea a la práctica, es necesario definir los puntos de integración. Recordemos que el framework Extralonger se basa en un Transformer de tres rutas, construido según un principio modular. Combina tres tipos de análisis: temporal, espacial y mixto. Cada una de las rutas se encarga de su propio nivel de interpretación de los datos de mercado, y su trabajo conjunto permite elaborar una previsión global.
El análisis temporal en Extralonger se realiza mediante un Transformer clásico, que procesa secuencias de datos y extrae patrones de las series temporales. Este módulo es como los cimientos: se encarga de sentar una base sólida para el análisis, detectando las relaciones dinámicas habituales.
El análisis espacial se basa en un enfoque global-local. En este contexto, la arquitectura considera el mercado como una red de nodos interconectados, en la que los elementos adyacentes forman patrones locales, mientras que las conexiones a distancia aportan una visión global. Este enfoque reviste especial importancia en el ámbito financiero, donde los instrumentos pueden estar relacionados tanto de forma directa como a través de mecanismos más complejos (por ejemplo, el sector tecnológico y los índices bursátiles).
Por último, la ruta mixta combina ambos enfoques: el temporal y el espacial. Permite al modelo sintetizar distintos niveles de análisis, creando una visión más profunda y multidimensional. Gracias a ello, Extralonger es capaz de analizar simultáneamente la evolución de las tendencias y tener en cuenta las interdependencias de la red.
Es precisamente aquí donde surge la oportunidad de integrar ST-Expert. Sus grafones expertos pueden integrarse orgánicamente en este módulo, reforzando su capacidad para trabajar con estructuras de enlaces cambiantes. Es más, la propia idea de la mezcla de expertos (Mixture of Experts) encaja a la perfección con el concepto modular de Extralonger, en el que ya se ha previsto la división de tareas por rutas.
Empecemos con la ruta temporal. Resulta útil comparar la arquitectura del Transformer clásico con un modelo de grafos. El mecanismo de Self-Attention construye, de hecho, una tabla de logits que refleja la influencia probabilística de cada elemento de la secuencia sobre los demás. Si consideramos los elementos de la secuencia como nodos, la tabla de logits se convierte en un grafo en el que las aristas expresan la intensidad de la interacción mutua. En este sentido, el Transformer no se limita a analizar la secuencia, sino que la transforma en una red dinámica de interacciones, lo que permite identificar dependencias locales y globales que, de otro modo, permanecerían ocultas.
Y aquí surge una oportunidad interesante. Podemos prescindir del mecanismo clásico de generación de logits en Self-Attention y, en su lugar, utilizar un grafo basado en los principios del framework ST-Expert. Este enfoque permite establecer relaciones más significativas entre los elementos de la secuencia, basándose en la correlación estadística, las reglas de expertos y las dependencias estructuradas. Esperamos que el modelo sea capaz de comprender el mercado con mayor profundidad, detectando las sutiles interrelaciones que el Self-Attention convencional podría pasar por alto.
Podemos aplicar un enfoque similar en el módulo de análisis de dependencias globales y locales. En este caso, el modelo construye una especie de estructura del mercado, identificando patrones y tendencias generales. Las conexiones globales ayudan a predecir los movimientos generales del mercado, lo cual permite al modelo ver el bosque y no solo los árboles por separado.
No obstante, las dependencias locales requieren un enfoque diferente. Es necesario construir un grafo disperso en el que solo se tengan en cuenta las conexiones más significativas y probables entre los nodos de la secuencia. Resulta similar al trabajo de un trader experimentado, que se centra en los puntos clave de entrada y salida, ignorando las señales ruidosas y poco significativas. Aquí también se pueden aplicar los métodos del framework ST-Expert, pero prestando especial atención a la selección de las interrelaciones más importantes. Este enfoque permite al modelo mantener al mismo tiempo una visión general y la atención a los detalles, identificando las microinfluencias que afectan de manera significativa a las fluctuaciones a corto plazo.
El concepto está claro. Ahora ha llegado el momento de pasar de la teoría a la práctica: implementar estas ideas mediante MQL5.
Módulo de atención de grafos
Para implementar la variante de Transformer basada en grafones propuesta anteriormente, creamos el objeto CNeuronGraphAttention, que hereda la funcionalidad básica del objeto de capa totalmente conectada CNeuronBaseOCL y se convierte en el núcleo de nuestro modelo de atención de grafos. Este objeto no solo combina el procesamiento clásico de valores con estructuras de grafos, sino que convierte una secuencia de datos en una red dinámica de relaciones.
class CNeuronGraphAttention   :  public CNeuronBaseOCL
  {
protected:
   CNeuronConvOCL    cValue;
   CNeuronGraphons   cGraphs;
   CNeuronSoftMaxOCL cScores;
   CNeuronBaseOCL    cAttention;
   CNeuronBaseOCL    cResidual;
   CNeuronConvOCL    cFeedForward[2];
   //---
   virtual bool      feedForward(CNeuronBaseOCL *NeuronOCL) override;
   virtual bool      updateInputWeights(CNeuronBaseOCL *NeuronOCL) override;
   virtual bool      calcInputGradients(CNeuronBaseOCL *NeuronOCL) override;

public:
                     CNeuronGraphAttention(void) {};
                    ~CNeuronGraphAttention(void) {};
   virtual bool      Init(uint numOutputs, uint myIndex, COpenCLMy *open_cl,
                          uint units, uint window, uint emb_dimension,
                          uint experts, float dropout,
                          ENUM_OPTIMIZATION optimization_type, uint batch);
   //---
   virtual int       Type(void) override const   {  return defNeuronGraphAttention;   }
   //--- methods for working with files
   virtual bool      Save(int const file_handle) override;
   virtual bool      Load(int const file_handle) override;
   //---
   virtual bool      WeightsUpdate(CNeuronBaseOCL *source, float tau) override;
   virtual void      SetOpenCL(COpenCLMy *obj) override;
   virtual void      SetActivationFunction(ENUM_ACTIVATION value) override { };
   virtual void      TrainMode(bool flag) override;
  };
En el interior del modelo, los grafos construidos según los principios de ST-Expert definen la estructura de las relaciones entre los elementos de la secuencia, lo que permite destacar las conexiones significativas e ignorar el ruido. Al mismo tiempo, la función SoftMax genera una distribución de probabilidad de la atención a lo largo del grafo, haciendo hincapié en las interacciones más críticas, mientras que las conexiones residuales garantizan la conservación y la integración tanto de las dependencias nuevas como de las ya acumuladas, creando así una especie de memoria del modelo.
Es importante destacar que, dentro del objeto, nos alejamos del esquema habitual de Self-Attention y no creamos las entidades estándar Query y Key. En un Transformer clásico, sirven para construir una matriz de logits que refleja la influencia mutua de los elementos de la secuencia. Sin embargo, en nuestro enfoque, esta función la asume el grafo construido según los principios de ST-Expert. Gracias a ello, podemos gestionar directamente las relaciones entre los nodos y centrarnos en las interacciones más significativas, sin generar tablas intermedias innecesarias. De este modo, solo quedan los valores «Value», que se utilizan para calcular los resultados finales de la atención. Al igual que el material en manos de un artesano experto, pasan por el grafo y los bloques Feed-Forward, transformándose en señales informativas para la predicción del mercado.
Este enfoque permite que el modelo funcione de forma más focalizada. La atención se centra en las interrelaciones clave que son realmente importantes para la serie financiera, en lugar de dispersarse por todos los elementos por igual. Como resultado, obtenemos un mecanismo que conserva la eficacia del Transformer, pero ofrece una interpretación mucho más coherente y estructurada de las relaciones que existen dentro de la secuencia.
La preparación del objeto CNeuronGraphAttention para su funcionamiento corre a cargo del método Init. Es precisamente aquí donde el modelo se ensambla, como un mecanismo perfectamente ajustado, listo para procesar datos financieros.
bool CNeuronGraphAttention::Init(uint numOutputs, uint myIndex, COpenCLMy *open_cl,
                                 uint units, uint window, uint emb_dimension,
                                 uint experts, float dropout,
                                 ENUM_OPTIMIZATION optimization_type, uint batch)
  {
   if(!CNeuronBaseOCL::Init(numOutputs, myIndex, open_cl, units * window, optimization_type, batch))
      return false;
   activation = None;
En primer lugar, se invoca la inicialización de la clase padre, donde se definen los parámetros generales de la neurona. A continuación, se configuran uno a uno los componentes internos del objeto.
Primero, se inicializa el bloque cValue, que se encarga de la codificación inicial de los valores de la secuencia. Se le especifican la ventana de análisis y el número de elementos de la secuencia que se va a analizar. Luego se desactiva su función de activación para transmitir los datos lo más limpios posible,
   int index = 0;
   if(!cValue.Init(0, index, OpenCL, window, window, window, units, 1, optimization, iBatch))
      return false;
   cValue.SetActivationFunction(None);
y se crea un bloque de grafones cGraphs, construido según los principios de ST-Expert, que define la estructura de las relaciones entre los elementos de la secuencia.
   index++;
   if(!cGraphs.Init(0, index, OpenCL, units, window, emb_dimension, experts, dropout, optimization, iBatch))
      return false;
A la salida del módulo cGraphs, obtenemos un grafo que refleja las probabilidades de que existan conexiones entre los nodos de la secuencia. Esta información ya es valiosa, pero para el módulo de atención necesitamos convertir estas probabilidades en una distribución de atención plenamente funcional que ejerce cada elemento de la secuencia sobre el objeto analizado. Aquí entra en escena el bloque cScores con la función SoftMax. Esta normaliza con precisión las probabilidades, reforzando las conexiones clave y debilitando las secundarias, lo que da lugar a una distribución de la atención precisa y fácil de interpretar. Como resultado, cada elemento de la secuencia adquiere su propia importancia ponderada en el análisis, y el modelo es capaz de centrarse en las interacciones realmente significativas, ignorando el ruido y las fluctuaciones irrelevantes.
Este enfoque permite integrar de forma fluida las conexiones del grafo creadas por ST-Expert con el mecanismo clásico de atención, transformando las probabilidades abstractas en señales concretas, listas para su posterior procesamiento y uso en la predicción de series financieras.
   index++;
   if(!cScores.Init(0, index, OpenCL, units * units, optimization, iBatch))
      return false;
   cScores.SetHeads(units);
Después se configuran los bloques cAttention y cResidual, destinados a conservar los resultados del mecanismo de atención y las conexiones residuales. En estos bloques también se desactiva la activación para no distorsionar las señales.
   index++;
   if(!cAttention.Init(0, index, OpenCL, Neurons(), optimization, iBatch))
      return false;
   cAttention.SetActivationFunction(None);
   index++;
   if(!cResidual.Init(0, index, OpenCL, Neurons(), optimization, iBatch))
      return false;
   cResidual.SetActivationFunction(None);
Por último, se configuran dos capas consecutivas del bloque Feed-Forward. La primera usa la activación SoftPlus, lo que potencia la no linealidad y la capacidad del modelo para detectar relaciones complejas, mientras que la segunda sirve para comprimir y transformar la información en una señal de atención final sin activación adicional.
   index++;
   if(!cFeedForward[0].Init(0, index, OpenCL, window, window, 2 * window, units, 1, optimization, iBatch))
      return false;
   cFeedForward[0].SetActivationFunction(SoftPlus);
   index++;
   if(!cFeedForward[1].Init(0, index, OpenCL, cFeedForward[0].GetFilters(), cFeedForward[0].GetFilters(),
                                                                  window, units, 1, optimization, iBatch))
      return false;
   cFeedForward[1].SetActivationFunction(None);
//---
   return true;
  }
Como resultado, el método Init integra de forma ordenada todos los componentes en un único sistema. Los bloques de procesamiento de valores, los grafos, la distribución de la atención y las capas Feed-Forward quedan listos para funcionar, creando un mecanismo de atención de grafos plenamente operativo, capaz de analizar eficazmente la dinámica de las series financieras.
Tras la inicialización del objeto, la siguiente etapa del funcionamiento del modelo es la pasada directa, implementada en el método feedForward.
bool CNeuronGraphAttention::feedForward(CNeuronBaseOCL *NeuronOCL)
  {
   if(!cValue.FeedForward(NeuronOCL))
      return false;
Se trata de un recorrido por un panorama financiero complejo y dinámico. Todo empieza con el objeto cValue, que actúa como explorador. Analiza minuciosamente cada señal del mercado, transforma los datos brutos en un formato fácil de analizar, como si estuviera elaborando un mapa del terreno antes de una excursión.
A continuación, entra en escena el módulo de grafos cGraphs, que traza rutas de interacción entre los nodos de la secuencia.
   if(!cGraphs.FeedForward(NeuronOCL))
      return false;
Se puede representar como una red de carreteras y senderos en este mapa, en la que cada conexión refleja la fuerza de la influencia de un elemento sobre otro. El bloque cScores con SoftMax actúa como el jefe de la expedición, determinando qué rutas son las más importantes y por cuáles conviene pasar en primer lugar. Convierte las probabilidades brutas de las conexiones en una estrategia clara de avance, destacando las interacciones clave e ignorando las señales ruidosas de poca importancia.
   if(!cScores.FeedForward(cGraphs.AsObject()))
      return false;
Una vez finalizado el proceso de exploración, la información de cValue y la distribución de la atención se combinan mediante una multiplicación matricial, lo que da lugar a los resultados del módulo de atención en cAttention. Es como reunir toda la información de inteligencia en un solo mapa para ver qué fuerzas e influencias actúan sobre el objeto de análisis.
   if(!MatMul(cScores.getOutput(), cValue.getOutput(), cAttention.getOutput(),
              cValue.GetUnits(), cValue.GetUnits(), cValue.GetFilters(), 1, false))
      return false;
El siguiente paso consiste en combinar los datos con la señal residual y normalizarlos en cResidual, lo que estabiliza los datos e impide que las fluctuaciones aleatorias desvíen el modelo de su curso.
   if(!SumAndNormilize(NeuronOCL.getOutput(), cAttention.getOutput(), cResidual.getOutput(),
                       cValue.GetFilters(), true, 0, 0, 0, 1))
      return false;
Entonces comienza la fase del bloque Feed-Forward, que actúa como los expertos analistas de la expedición. El primer bloque, con la función de activación SoftPlus, detecta interdependencias ocultas y potencia las señales importantes, como si los investigadores localizaran en un mapa los recursos clave ocultos. El segundo bloque transforma la información en una representación compacta y clara, lista para su uso en la predicción.
   if(!cFeedForward[0].FeedForward(cResidual.AsObject()))
      return false;
   if(!cFeedForward[1].FeedForward(cFeedForward[0].AsObject()))
      return false;
   if(!SumAndNormilize(cFeedForward[1].getOutput(), cResidual.getOutput(), Output,
                       cFeedForward[1].GetFilters(), true, 0, 0, 0, 1))
      return false;
//---
   return true;
  }
La normalización final combina los datos residuales con los resultados de Feed-Forward, generando una señal definitiva que refleja la visión del mercado que tiene el modelo, a la vez amplia y detallada.
En definitiva, el método feedForward transforma una secuencia compleja de datos financieros en conocimiento estructurado, significativo y listo para su uso en la predicción.
La pasada directa es solo la primera parte del trabajo del modelo. Para obtener predicciones realmente informativas, es necesario organizar el proceso de análisis de errores, que se realiza en el método calcInputGradients.
bool CNeuronGraphAttention::calcInputGradients(CNeuronBaseOCL *NeuronOCL)
  {
   if(!NeuronOCL)
      return false;
Esta etapa puede concebirse como una expedición de vuelta por la ruta ya recorrida, en la que el modelo evalúa qué decisiones fueron acertadas y en qué puntos se produjeron desviaciones.
El proceso comienza en el último bloque de la pasada directa, Feed-Forward, donde la señal pasa por la activación inversa para calcular correctamente los gradientes de error.
   if(!DeActivation(cFeedForward[1].getOutput(), cFeedForward[1].getGradient(),
                    Gradient, cFeedForward[1].Activation()))
      return false;
   if(!cFeedForward[0].CalcHiddenGradients(cFeedForward[1].AsObject()))
      return false;
   if(!cResidual.CalcHiddenGradients(cFeedForward[0].AsObject()))
      return false;
A continuación, los gradientes se transmiten a la primera capa del bloque y al bloque residual cResidual, lo que permite corregir la información que se ha procesado en las etapas anteriores. En esta etapa se realiza la suma de los gradientes, lo que contribuye a mantener la estabilidad del modelo y evita la divergencia de las señales durante la retropropagación.
   if(!SumAndNormilize(Gradient, cResidual.getGradient(), cAttention.getOutput(),
                       cValue.GetFilters(), false, 0, 0, 0, 1))
      return false;
Luego la multiplicación matricial propaga los gradientes a través del bloque de distribución de atención cScores y del bloque cValue, lo que permite ajustar la intensidad de la influencia de cada elemento sobre los demás. El bloque de grafos cGraphs recibe sus gradientes y ajusta las probabilidades de las conexiones entre los nodos en función de los errores acumulados.
   if(!MatMulGrad(cScores.getOutput(), cScores.getGradient(),
                  cValue.getOutput(), cValue.getGradient(),
                  cAttention.getGradient(), cValue.GetUnits(),
                  cValue.GetUnits(), cValue.GetFilters(), 1, false))
      return false;
   if(!cGraphs.CalcHiddenGradients(cScores.AsObject()))
      return false;
A continuación, los gradientes se transmiten hasta el nivel de los datos de entrada en el objeto NeuronOCL desde el bloque cValue, donde se determina definitivamente cómo ha influido cada elemento de la secuencia en el error del modelo.
   if(!NeuronOCL.CalcHiddenGradients(cGraphs.AsObject()))
      return false;
Debemos destacar que, durante la pasada directa, los datos de entrada recorren simultáneamente tres rutas: a través del bloque de valores cValue, a través de las conexiones de grafos cGraphs y a través del mecanismo de conexiones residuales. Cada una de estas rutas genera su propio flujo de información, que refleja diferentes aspectos de las interrelaciones dentro de la secuencia.
Por lo tanto, en la pasada inversa es necesario recopilar con precisión los gradientes de las tres rutas. Es como una expedición en la que, tras regresar de varios senderos paralelos, los investigadores combinan sus observaciones para obtener una imagen completa del panorama. En primer lugar, los gradientes se generan en la salida de cada ruta. Después se suman teniendo en cuenta las conexiones residuales, para que la información siga siendo coherente y equilibrada. Solo tras dicha integración, el modelo obtiene una visión precisa de dónde se produjeron los errores, qué influencias se habían subestimado y cuáles se habían sobreestimado.
   if(!DeActivation(NeuronOCL.getOutput(), cResidual.getGradient(),
                    cAttention.getGradient(), NeuronOCL.Activation()))
      return false;
   if(!SumAndNormilize(NeuronOCL.getGradient(), cResidual.getGradient(), cResidual.getGradient(),
                       cValue.GetWindow(), false, 0, 0, 0, 1))
      return false;
   if(!NeuronOCL.CalcHiddenGradients(cValue.AsObject()))
      return false;
   if(!SumAndNormilize(NeuronOCL.getGradient(), cResidual.getGradient(), NeuronOCL.getGradient(),
                       cValue.GetWindow(), false, 0, 0, 0, 1))
      return false;
//---
   return true;
  }
Gracias a este enfoque, el Transformer de grafos puede aprender de forma eficaz. Tiene en cuenta tanto las interrelaciones globales como las locales, ajustándolas a lo largo de todo el recorrido, y no solo en segmentos concretos. Como resultado, cada nodo de la secuencia recibe una valoración justa de su papel en el error del modelo, y el aprendizaje se vuelve coherente, estable y lo más informativo posible.
El entrenamiento de los parámetros del modelo se lleva a cabo en el método updateInputWeights, que puede considerarse como la coordinación del funcionamiento de todo el sistema. En esta fase, el objeto no realiza por sí mismo el ajuste directo de los pesos, sino que delega esta tarea en sus componentes internos.
bool CNeuronGraphAttention::updateInputWeights(CNeuronBaseOCL *NeuronOCL)
  {
   if(!cValue.UpdateInputWeights(NeuronOCL))
      return false;
   if(!cGraphs.UpdateInputWeights(NeuronOCL))
      return false;
   if(!cFeedForward[0].UpdateInputWeights(cResidual.AsObject()))
      return false;
   if(!cFeedForward[1].UpdateInputWeights(cFeedForward[0].AsObject()))
      return false;
//---
   return true;
  }
En otras palabras, el método updateInputWeights actúa como un director de orquesta que coordina el trabajo de todos los músicos dentro del objeto. Cada bloque aporta su granito de arena, pero la armonía general solo se consigue gracias a su trabajo conjunto. Como resultado, el modelo mejora gradualmente sus predicciones, aprendiendo de los errores detectados durante la pasada inversa y reforzando las relaciones significativas entre los elementos de la secuencia.
El código completo de la clase CNeuronGraphAttention, con la implementación de todos los métodos, se incluye en el anexo, donde se muestra cómo las ideas conceptuales de la atención de grafos se transforman en un mecanismo operativo, listo para analizar series financieras dinámicas.
SoftMax disperso
El siguiente paso consiste en crear un grafo disperso para el módulo de atención local. Para ello, no es necesario rediseñar por completo el objeto de generación de grafos: basta con realizar cambios mínimos, conservando la arquitectura básica y la lógica de funcionamiento. En el módulo de atención de grafos presentado anteriormente, el grafo de dependencias generado en la salida se transforma en una distribución de probabilidad mediante la función SoftMax, que pone el énfasis en las interacciones más significativas.
En la fase de atención local se puede ir más allá. Así, anulamos las conexiones menos probables y conservamos únicamente las interdependencias clave. Este método permite concentrar los recursos computacionales en las interacciones más significativas entre los nodos, lo cual resulta especialmente importante a la hora de analizar las oscilaciones locales de las series financieras. En la práctica, esto se asemeja al trabajo de un analista experimentado: en lugar de analizar cada señal de poca importancia, se centra únicamente en los factores críticos que influyen realmente en la tendencia actual.
Para optimizar aún más el modelo, en la salida se crea una matriz dispersa que almacena únicamente las conexiones activas y significativas. Esto reduce considerablemente el consumo de memoria y acelera los cálculos, sin que por ello se pierda información. La estructura dispersa permite al modelo procesar grandes ventanas temporales y secuencias complejas sin sobrecargar la unidad de cálculo, mientras que la atención local se convierte en una herramienta rápida y precisa para detectar influencias a pequeña escala.
En definitiva, este enfoque aúna dos ventajas estratégicas. Por un lado, se mantienen las relaciones globales definidas por los grafos de ST-Expert, que permiten comprender el panorama general del mercado; por otro, las relaciones locales, identificadas a través de una matriz dispersa, permiten centrarse en las pequeñas interacciones de importancia crítica.
Comenzaremos la implementación práctica de la atención local dispersa creando el algoritmo Sparse SoftMax en el programa OpenCL. Su función consiste en transformar las probabilidades de las conexiones, obtenidas del bloque de grafos, en una distribución de atención, al tiempo que pone a cero los elementos menos significativos y crea una matriz dispersa.
__kernel void SparseSoftMax(__global const float *data,
                            __global float *outputs,
                            __global float *indexes,
                            const int out_dimension
                           )
  {
   const size_t row = get_global_id(0);
   const size_t col_in = get_local_id(1);
   const int total_rows = (int)get_global_size(0);
   const int total_cols_in = (int)get_local_size(1);
//---
   __local float Temp[LOCAL_ARRAY_SIZE];
   const int ls = min(total_cols_in, (int)LOCAL_ARRAY_SIZE);
Cada flujo de ejecución procesa una fila del array de datos original, que representa las probabilidades de las relaciones entre los nodos. En primer lugar, se comprueba la validez de los valores: los valores NaN o infinitos se sustituyen por el valor mínimo. A continuación, cada flujo de ejecución calcula la posición de su valor con respecto a los demás elementos de la fila. Si el valor se encuentra entre los menos significativos, se anulará.
   const int shift_in = RCtoFlat(row, col_in, total_rows, total_cols_in, 0);
//--- calc position
   float value = IsNaNOrInf(data[shift_in], MIN_VALUE);
   int position = 0;
   for(int l = 0; l < total_cols_in; l += ls)
     {
      if(col_in >= l && col_in < (l + ls))
         Temp[col_in - l] = value;
      BarrierLoc;
      for(int i = 0; i < ls; i++)
        {
         if(i == (col_in - l))
            continue;
         if(Temp[i] > value)
            position++;
         else
            if(Temp[i] == value && i < (col_in - l))
               position++;
        }
      BarrierLoc;
     }
A continuación, se aplica la función SoftMax clásica a los elementos restantes, pero con normalización local por subgrupos de elementos.
//--- SoftMax
   if(position >= out_dimension)
      value = MIN_VALUE;
   value = LocalSoftMax(value, 1, Temp);
//--- resultado
   const int shift_out = RCtoFlat(row, position, total_rows, out_dimension, 0);
   if(position < out_dimension)
     {
      outputs[shift_out] = value;
      indexes[shift_out] = (float)col_in;
     }
  }
Este enfoque permite tener en cuenta únicamente las relaciones más significativas y, al mismo tiempo, mantener la estabilidad de los cálculos numéricos. Como resultado, se genera una matriz dispersa: se conservan los valores que superan el umbral establecido y se descartan todos los demás, lo que reduce drásticamente el volumen de datos y mejora la eficiencia del modelo.
El resultado final son dos arrays:
- outputs, que contiene valores normalizados únicamente para las relaciones significativas,
- indexes, que registra las posiciones de estos elementos activos.
Esta información está lista para su uso en el módulo de atención local, lo que permite al modelo centrarse en las interrelaciones locales críticas entre los nodos de la secuencia, sin sobrecargar la memoria ni los recursos computacionales.
En el programa principal, creamos un nuevo objeto CNeuronSparseSoftMax, que hereda la funcionalidad básica de la capa CNeuronSoftMaxOCL y está especializado en el tratamiento de distribuciones dispersas. A diferencia del SoftMax estándar, este objeto permite centrarse únicamente en las relaciones más significativas entre los elementos de la secuencia, al tiempo que reduce el consumo de memoria y aumenta la eficiencia de los cálculos.
class CNeuronSparseSoftMax    :  public CNeuronSoftMaxOCL
  {
protected:
   uint              iDimensionIn;
   CBufferFloat      cIndexes;
   //---
   virtual bool      feedForward(CNeuronBaseOCL *NeuronOCL) override;
   virtual bool      calcInputGradients(CNeuronBaseOCL *NeuronOCL) override;

public:
                     CNeuronSparseSoftMax(void) {};
                    ~CNeuronSparseSoftMax(void) {};
   //---
   virtual bool      Init(uint numOutputs, uint myIndex, COpenCLMy *open_cl,
                          uint units, uint dimension_in, uint dimension_out,
                          ENUM_OPTIMIZATION optimization_type, uint batch);
   //---
   virtual bool      Save(int const file_handle) override;
   virtual bool      Load(int const file_handle) override;
   virtual int       Type(void) override const { return defNeuronSparseSoftMax; }
   virtual void      SetOpenCL(COpenCLMy *obj) override;
   virtual CBufferFloat* GetIndexes(void)  { return GetPointer(cIndexes); }
   virtual uint      DimensionOut(void) const {  return uint(Neurons() / iHeads); }
  };
Dentro de la clase se almacena información sobre la dimensión de los datos de entrada iDimensionIn y el búfer de índices de conexiones activas cIndexes, cuyos valores apuntan a los elementos que se han tenido en cuenta al generar la distribución de la atención. Los métodos feedForward y calcInputGradients son envoltorios de los núcleos de las pasadas directa e inversa del programa OpenCL, lo que permite al modelo procesar correctamente los datos y aprender de los errores teniendo en cuenta únicamente las conexiones activas y significativas.
La inicialización del objeto se realiza en el método Init, que prepara el modelo para trabajar con distribuciones de atención dispersas.
bool CNeuronSparseSoftMax::Init(uint numOutputs, uint myIndex, COpenCLMy *open_cl,
                                uint units, uint dimension_in, uint dimension_out,
                                ENUM_OPTIMIZATION optimization_type, uint batch)
  {
   if(dimension_in < dimension_out)
      return false;
   if(!CNeuronSoftMaxOCL::Init(numOutputs, myIndex, open_cl, units * dimension_out, optimization_type, batch))
      return false;
En primer lugar, se comprueba que la dimensión de entrada sea correcta: dimension_in debe ser igual o mayor que dimension_out para que el modelo pueda generar correctamente la distribución. A continuación, se invoca la inicialización de la clase base.
Luego se establece el número de cabezas de atención, se guarda la dimensión de los datos de entrada y se crea el búfer de índices cIndexes, que almacenará únicamente las conexiones activas y significativas.
   SetHeads(units);
   iDimensionIn = dimension_in;
   if(!cIndexes.BufferInit(Neurons(), -1) ||
      !cIndexes.BufferCreate(OpenCL))
      return false;
//---
   return true;
  }
El búfer se inicializa y se reserva en memoria, lo que incluye la posibilidad de utilizar OpenCL para realizar cálculos acelerados. Como resultado, el objeto está totalmente listo para funcionar: es capaz de recibir datos de entrada, identificar las conexiones clave y generar una distribución dispersa de la atención, manteniendo al mismo tiempo la eficiencia en el uso de los recursos.
De este modo, CNeuronSparseSoftMax transforma el grafo disperso de atención local en una distribución práctica y eficaz, en la que la atención se centra en las interrelaciones más significativas. Esto permite al modelo conservar al mismo tiempo la visión global definida por el grafo principal de ST-Expert y considerar con precisión las influencias locales, generando previsiones detalladas e informativas de las series financieras.
Y para organizar la atención local en nuestro modelo basta con un cambio mínimo, pero eficaz. Podemos tomar un objeto Transformer de grafos ya implementado y sustituir en él el módulo de proyección probabilística SoftMax por la versión dispersa CNeuronSparseSoftMax. Este enfoque permite no tener que reestructurar toda la arquitectura, conservando las conexiones globales del grafo y la lógica de los bloques, al tiempo que garantiza una identificación precisa de las interacciones locales.
El SoftMax disperso se centrará en las conexiones más significativas entre los nodos, ignorando las conexiones menos relevantes y optimizando así el uso de la memoria y los recursos computacionales.
class CNeuronSparseGraphAttention   :  public CNeuronBaseOCL
  {
protected:
   CNeuronConvOCL       cValue;
   CNeuronGraphons      cGraphs;
   CNeuronSparseSoftMax cScores;
   CNeuronBaseOCL       cAttention;
   CNeuronBaseOCL       cResidual;
   CNeuronConvOCL       cFeedForward[2];
   //---
   virtual bool      feedForward(CNeuronBaseOCL *NeuronOCL) override;
   virtual bool      updateInputWeights(CNeuronBaseOCL *NeuronOCL) override;
   virtual bool      calcInputGradients(CNeuronBaseOCL *NeuronOCL) override;

public:
                     CNeuronSparseGraphAttention(void) {};
                    ~CNeuronSparseGraphAttention(void) {};
   virtual bool      Init(uint numOutputs, uint myIndex, COpenCLMy *open_cl,
                          uint units, uint window, uint experts, float dropout,
                          uint emb_dimension, uint sparse_dimension,
                          ENUM_OPTIMIZATION optimization_type, uint batch);
   //---
   virtual int       Type(void) override const   {  return defNeuronSparseGraphAttention;   }
   //--- methods for working with files
   virtual bool      Save(int const file_handle) override;
   virtual bool      Load(int const file_handle) override;
   //---
   virtual bool      WeightsUpdate(CNeuronBaseOCL *source, float tau) override;
   virtual void      SetOpenCL(COpenCLMy *obj) override;
   virtual void      SetActivationFunction(ENUM_ACTIVATION value) override { };
   virtual void      TrainMode(bool flag) override;
  };
El código completo de todas las clases presentadas y la implementación de cada uno de sus métodos están disponibles en el archivo adjunto al artículo.
Hoy hemos realizado un trabajo considerable y hemos logrado resultados importantes. Ahora es el momento ideal para hacer una pequeña pausa, para que la información se asimile y quede grabada en la memoria. En el próximo artículo continuaremos con lo que hemos empezado, pasaremos a evaluar la eficacia de las soluciones implementadas y veremos hasta qué punto el modelo es capaz de analizar con éxito las series financieras.
Conclusión
A lo largo de nuestro trabajo, hemos recorrido un camino complejo, investigando la arquitectura del Transformer de grafos y familiarizándonos con sus componentes clave: los bloques de valores, los grafos de dependencias y la distribución de la atención. Cada uno de estos elementos ha desempeñado su papel, como si fueran miembros de una expedición que, juntos, trazan una ruta a través del complejo y cambiante paisaje del mercado financiero.
Hemos prestado especial atención a la implementación de SoftMax disperso para la atención local. Esta herramienta permitió al modelo identificar las relaciones más significativas, ignorando las señales de menor importancia, lo que supuso un ahorro de recursos y una mayor precisión a la hora de orientarse en la dinámica del mercado. Las pasadas directa e inversa, así como la actualización de los pesos, garantizaron un ajuste continuo del rumbo, lo que permitió al modelo aprender de sus errores y mejorar gradualmente sus predicciones.
Los resultados obtenidos han sentado unas bases sólidas para futuras investigaciones. En el próximo artículo continuaremos nuestro recorrido evaluando la eficacia de las soluciones implementadas, analizando la precisión de las previsiones y determinando en qué medida el modelo se adapta a la dinámica de las series financieras.
Enlaces
Programas utilizados en el artículo
| # | Nombre | Tipo | Descripción |
|---|---|---|---|
| 1 | Study.mq5 | Asesor experto | Asesor Experto para el entrenamiento offline de modelos |
| 2 | StudyOnline.mq5 | Asesor experto | Asesor Experto para el entrenamiento en línea de modelos |
| 3 | Test.mq5 | Asesor experto | Asesor experto para probar el modelo |
| 4 | Trajectory.mqh | Biblioteca de clases | Estructura de la descripción del estado del sistema y de la arquitectura de los modelos |
| 5 | NeuroNet.mqh | Biblioteca de clases | Biblioteca de clases para crear una red neuronal |
| 6 | NeuroNet.cl | Biblioteca | Biblioteca de código del programa OpenCL |
Traducción del ruso hecha por MetaQuotes Ltd.
Artículo original: https://www.mql5.com/ru/articles/19624
Advertencia: todos los derechos de estos materiales pertenecen a MetaQuotes Ltd. Queda totalmente prohibido el copiado total o parcial.
Este artículo ha sido escrito por un usuario del sitio web y refleja su punto de vista personal. MetaQuotes Ltd. no se responsabiliza de la exactitud de la información ofrecida, ni de las posibles consecuencias del uso de las soluciones, estrategias o recomendaciones descritas.

 Superando las limitaciones del aprendizaje automático (Parte 4): Cómo superar el error irreducible mediante múltiples horizontes de previsión
 Redes neuronales en el trading: Señales de trading robustas en cualquier régimen de mercado (Conclusión)
 Explorador de la biblioteca estándar de MQL5 (Parte 1): Introducción con CTrade, CiMA y CiATR
 Automatización del indicador del sentimiento del mercado

- Aplicaciones de trading gratuitas
- 8 000+ señales para copiar
- Noticias económicas para analizar los mercados financieros
Usted acepta la política del sitio web y las condiciones de uso
Se ha publicado el artículo «Las redes neuronales en el trading: señales de trading fiables en cualquier situación del mercado (Módulos de atención)»:
Autor: Dmitriy Gizlyk