

Neuronale Netze im Handel: Eine einheitliche Betrachtung von Raum und Zeit (Abschluss)
 14
 0

Einleitung
Finanzmärkte lassen sich mit einem lebenden Organismus vergleichen, in dem jede Kursbewegung einem Puls gleicht und jede Nachricht oder makroökonomische Entscheidung wie ein Herzschlag wirkt, der Wellen der Veränderung durch das gesamte System sendet. Sie atmen, schwanken, steigen und fallen in einem komplexen Rhythmus, der das Verhalten von Millionen von Teilnehmern widerspiegelt. In einem solchen Umfeld stehen Analysten und Händler vor der Aufgabe, nicht nur unmittelbare Impulse zu erfassen, sondern auch längerfristige Trends vorherzusagen, die oft unter dem oberflächlichen Rauschen verborgen liegen. Hier steht die Arbeit mit räumlich-zeitlichen Daten im Mittelpunkt. Schließlich entwickelt sich jede Marktsituation gleichzeitig entlang zweier Dimensionen: der Zeitachse und der Preisachse, die den Raum der Handelsentscheidungen widerspiegelt.
Das Extralonger-Framework zielt darauf ab, die Grenzen herkömmlicher Modelle zu überwinden und die Prognose auf ein neues Niveau zu heben. Sein entscheidender Vorteil ist seine Fähigkeit, über extrem lange Zeiträume hinweg zuverlässig zu funktionieren. Im Vergleich dazu beschränken sich die allermeisten bestehenden Algorithmen auf Zeitintervalle von Minuten oder Stunden. Innerhalb solcher Grenzen ist es zwar möglich, kurzfristige Impulse oder lokale Trends zu verfolgen, jedoch unmöglich, eine systematische Perspektive zu entwickeln, die es ermöglicht, über den Horizont hinauszuschauen und sich abzeichnende größere Entwicklungen zu erkennen. Extralonger hingegen eröffnet die Möglichkeit langfristiger Prognosen und gewährleistet dabei Genauigkeit und Stabilität selbst dort, wo andere Methoden die Orientierung verlieren.
Diese Eigenschaft ist im Handel besonders wichtig. Für einen Trader, der mit Intraday-Zeitrahmen arbeitet, kann jede Minute entscheidend sein. Noch wertvoller ist es jedoch, zu verstehen, wie sich der Markt morgen oder in ein paar Tagen verhalten wird. Für einen Anleger ist die Kenntnis zukünftiger Trends über einen Zeithorizont von einer Woche oder mehr ein Instrument für das Risikomanagement und die Strategieentwicklung. Extralonger verbindet diese beiden Ansätze und ermöglicht es, den Markt sowohl aus der Nähe als auch aus der Ferne zu betrachten. Dies ist vergleichbar mit einem Reisenden, der eine Lupe benutzt, um die Details einer Karte zu studieren, und ein Fernrohr, um die entfernten Umrisse des Geländes zu erkennen.
Der zweitwichtigste Vorteil des Frameworks ist seine hohe Recheneffizienz. Das Problem bei klassischen Methoden besteht darin, dass sie die zeitliche und die räumliche Dimension getrennt voneinander analysieren. Bei der Analyse der Dynamik von Zeitreihen muss der Algorithmus die Berechnungen für jeden Marktdatenpunkt oder jedes Instrument wiederholen, und bei der Verarbeitung räumlicher Zusammenhänge wiederholt er die Operationen im Zeitbereich. Durch diese doppelten Berechnungen steigt der Ressourcenbedarf rasch an. Das Modell benötigt immer mehr Arbeitsspeicher und Rechenzeit, was den Prognosehorizont einschränkt. Auf den Finanzmärkten, wo die Reaktionsgeschwindigkeit auf Kursänderungen entscheidend ist, stellen solche Einschränkungen ein erhebliches Hindernis dar.
Extralonger löst dieses Problem auf eine grundlegend neue Art und Weise. Es basiert auf dem Konzept der Unified Spatial-Temporal Representation – einer einheitlichen räumlich-zeitlichen Repräsentation. Diese Idee ist von Einsteins Relativitätstheorie inspiriert. So wie Raum und Zeit in der Physik ein einziges Kontinuum bilden, kann auch bei Finanzdaten ein Zeitpunkt nicht losgelöst vom Preisniveau betrachtet werden, ebenso wenig wie die lokale Marktstruktur analysiert werden kann, ohne den zeitlichen Kontext zu berücksichtigen. Somit enthält jedes Datenelement gleichzeitig sowohl zeitliche als auch räumliche Informationen. Dadurch entfallen wiederholte Berechnungen, und die Komplexität des Modells wird um eine Größenordnung reduziert.
Daher bietet Extralonger enorme Vorteile:
- geringerer Speicherbedarf,
- beschleunigtes Training,
- höhere Prognosegeschwindigkeit.
In der Praxis bedeutet dies, dass das Modell auch in Umgebungen mit begrenzten Rechenressourcen trainiert und ausgeführt werden kann.
Auf architektonischer Ebene basiert das Extralonger-Framework auf drei parallelen Verarbeitungspfaden für Informationen: dem zeitlichen, dem räumlichen und dem gemischten. Jeder Verarbeitungspfad erfüllt eine bestimmte Aufgabe. Der zeitliche Verarbeitungspfad analysiert die Abfolge von Marktereignissen und sucht nach Mustern in der Kursdynamik. Der räumliche Verarbeitungspfad untersucht das Netzwerk der Zusammenhänge zwischen Instrumenten und Vermögenswerten und deckt dabei verborgene Korrelationen und Strukturen auf. Der gemischte Verarbeitungspfad kombiniert beide Ansätze, um ein umfassendes Bild zu erstellen.
Eine besondere Rolle spielt in Extralonger das Modul „Global-Local Spatial Transformer“, das mit der doppelten Sichtweise eines Analysten verglichen werden kann. Einerseits ermöglicht die globale Attention, die Verbindungen zwischen weit voneinander entfernten Marktelementen zu berücksichtigen. Andererseits konzentriert sich die lokale Attention auf die engsten Zusammenhänge, wie beispielsweise kurzfristige Korrelationen zwischen benachbarten Währungen innerhalb einer einzelnen Handelssitzung. Dank dieser Kombination kann das Modell sowohl große Trends als auch lokale Impulse gleichermaßen gut berücksichtigen.
Eine weitere Besonderheit von Extralonger ist sein vollständiges rezeptives Feld. Das bedeutet, dass das Modell in der Lage ist, alle verfügbaren historischen Daten gleichzeitig zu berücksichtigen und sie mit jedem aktuellen Ereignis zu verknüpfen. Im Gegensatz zu Algorithmen, die durch ein gleitendes Fenster oder einen festen Zeitschritt eingeschränkt sind, kann Extralonger den Markt erfassen – und zwar in seiner Gesamtheit. Es kann das heutige Kursverhalten mit Ereignissen von vor einer Woche vergleichen oder eine langfristige Abhängigkeit erkennen, die sich erst über längere Zeiträume hinweg zeigt. Dies ist insbesondere für die Finanzmärkte von großem Wert, da viele Kursbewegungen nicht durch einzelne Ereignisse ausgelöst werden, sondern durch eine Anhäufung von Faktoren, die sich nach und nach summieren und in weitreichenden Trends zum Ausdruck kommen.
Nachfolgend ist die Visualisierung des Frameworks Extralonger durch den Autor zu sehen.
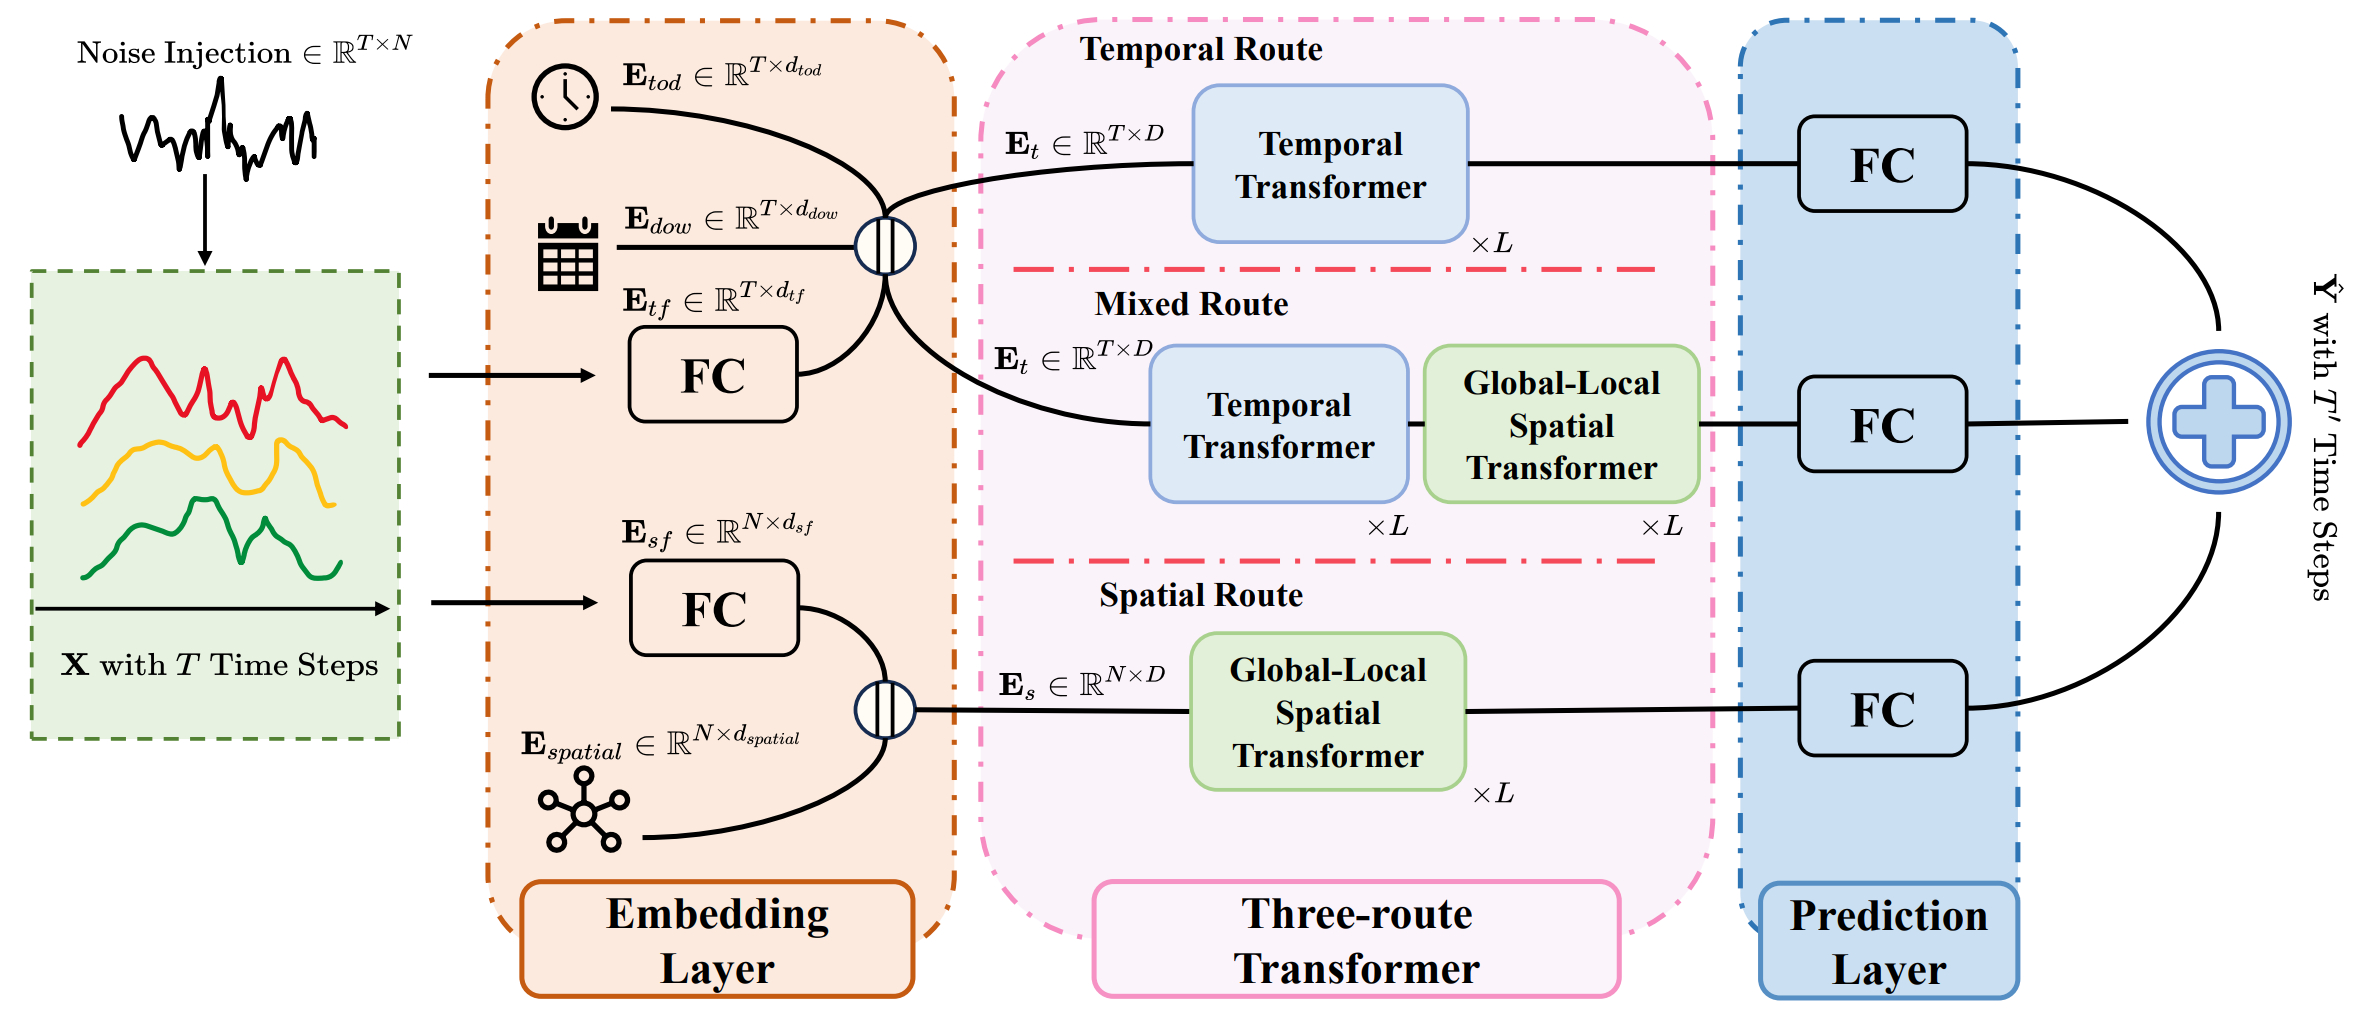
Unser Projekt entwickelt sich schrittweise vom Einfachen zum Komplexen, von einzelnen Elementen hin zu einer zusammenhängenden Architektur. Zunächst haben wir uns auf die konzeptionellen Grundlagen von Extralonger konzentriert und die ersten praktischen Schritte zur Umsetzung mithilfe von MQL5 unternommen. In dieser Phase haben wir Module zur räumlichen und zeitlichen Kodierung implementiert, die es uns ermöglichten, die Daten in der Marktstruktur zu verankern und die Grundlage für eine weitere Integration zu schaffen.
Anschließend wandten wir uns dem architektonischen Entwurf des Frameworks zu. Während wir früher hauptsächlich mit Ziegeln gearbeitet haben, haben wir nun damit begonnen, Wände und Deckenplatten zu errichten. Wir haben die Implementierung des Moduls Global-Local Spatial Transformer eingehend untersucht. In dieser Phase gelang es uns, einzelne Elemente zu einem zusammenhängenden Berechnungsprozess zu integrieren. Mit anderen Worten: Wir haben damit begonnen, genau jenes Beobachtungsframework aufzubauen, das es uns letztendlich ermöglichen wird, den Markt in all seinen Dimensionen zu erfassen.
Diese beiden Schritte lassen sich mit den Vorbereitungen für eine große Inszenierung vergleichen. Zunächst haben wir das Bühnenbild gestaltet und festgelegt, wo die wichtigsten Elemente platziert werden sollten; dann haben wir die ersten Darsteller – die Datenverarbeitungsmodule – auf die Bühne gebracht. Und nun haben wir die Gelegenheit, dem Publikum das gesamte Konzept hinter der Inszenierung zu enthüllen. Nun kommen wir zum Algorithmus selbst – dem Herzstück von Extralonger. Gerade hier – an der Schnittstelle zwischen global-lokaler Attention, einer einheitlichen Repräsentation und drei parallelen Verarbeitungspfaden – wird die Einzigartigkeit dieses Ansatzes deutlich.
Objekt der obersten Ebene
An der Spitze der gesamten Hierarchie unserer Implementierung der Ansätze des Extralonger-Frameworks steht das Objekt CNeuronExtralonger, das als Herzstück der Architektur betrachtet werden kann und die wichtigsten Module in einem einzigen Rechenzyklus vereint. Während die zuvor besprochenen Klassen und Blöcke für einzelne Strukturelemente zuständig waren, haben wir es hier mit einem zentralen Knotenpunkt zu tun, der alles miteinander verbindet.
class CNeuronExtralonger   :  public CNeuronMHAttentionPooling
  {
protected:
   CLayer               cProjectionT;
   CLayer               cTimeModule;
   CLayer               cSpatialModule;
   CLayer               cMixModule;
   CNeuronBaseOCL       cConcatResults;
   //---
   virtual bool      feedForward(CNeuronBaseOCL *NeuronOCL) override {return false;}
   virtual bool      feedForward(CNeuronBaseOCL *NeuronOCL, CBufferFloat *SecondInput) override;
   virtual bool      updateInputWeights(CNeuronBaseOCL *NeuronOCL) override;
   virtual bool      calcInputGradients(CNeuronBaseOCL *NeuronOCL) override {return false;}
   virtual bool      calcInputGradients(CNeuronBaseOCL *NeuronOCL,
                                        CBufferFloat *SecondInput,
                                        CBufferFloat *SecondGradient,
                                        ENUM_ACTIVATION SecondActivation = None
                                       ) override;

public:
                     CNeuronExtralonger(void) {};
                    ~CNeuronExtralonger(void) {};
   //---
   virtual bool      Init(uint numOutputs, uint myIndex, COpenCLMy *open_cl,
                          uint time_steps_in, uint time_steps_out, uint variables,
                          uint dimension, uint emb_dimension, uint period1,
                          uint frame1, uint period2, uint frame2, uint layers,
                          uint heads, uint dimension_k, uint m_units, float sparse,
                          ENUM_OPTIMIZATION optimization_type, uint batch);
   //---
   virtual int       Type(void)   const   {  return defNeuronExtralonger;   }
   //--- methods for working with files
   virtual bool      Save(int const file_handle) override;
   virtual bool      Load(int const file_handle) override;
   //---
   virtual bool      WeightsUpdate(CNeuronBaseOCL *source, float tau) override;
   virtual void      SetOpenCL(COpenCLMy *obj) override;
   virtual void      SetActivationFunction(ENUM_ACTIVATION value) override { };
  };
Strukturell gesehen ist CNeuronExtralonger von der Klasse CNeuronMHAttentionPooling abgeleitet, was sofort auf seine funktionale Ausrichtung hinweist. Die Datenverarbeitung basiert weiterhin auf einem Multi-Head-Attention-Mechanismus mit einem Aggregationsmechanismus, auf dem zusätzliche Schichten aufbauen, um die einzigartigen Ideen von Extralonger umzusetzen.
Und damit kommen wir zu einem wichtigen Unterschied zwischen unserer Umsetzung und dem ursprünglichen Entwurf. In der ursprünglichen Version von Extralonger sind die Gewichtungskoeffizienten für die drei Verarbeitungspfade des Datenflusses (zeitlich, räumlich und gemischt) fest programmiert und bleiben unverändert. Dieser Ansatz ist aufgrund seiner Einfachheit praktisch, führt jedoch angesichts der Volatilität der Finanzmärkte unweigerlich zu einem Verlust an Flexibilität. In manchen Situationen spielen kurzfristige zeitliche Muster eine Schlüsselrolle; in anderen sind globale räumliche Korrelationen entscheidend; und manchmal ist eine Kombination aus beidem ausschlaggebend. Feste Gewichte können dieser Verlagerung des Schwerpunkts nicht dynamisch Rechnung tragen, was die Prognosegenauigkeit beeinträchtigt.
Genau aus diesem Grund sind wir in unserer Implementierung noch einen Schritt weiter gegangen und haben einen adaptiven Attention-Pooling-Mechanismus eingeführt, den wir aus dem R-MAT-Framework entlehnt haben. Entscheidend ist, dass die Gewichtungskoeffizienten für die Verarbeitungspfade nicht im Voraus festgelegt, sondern während der Ausführung des Modells berechnet werden. Jedes neue Eingabesignal erhält eine eigene Attention-Verteilung über die zeitlichen, räumlichen und gemischten Module hinweg. Infolgedessen reagiert das System empfindlich auf das Marktumfeld. In einer Phase ruhiger Konsolidierung gewinnt die zeitliche Analyse an Bedeutung; bei externen Schocks werden räumliche Zusammenhänge wichtiger; und in Zeiten hoher Volatilität tritt der gemischte Verarbeitungspfad in den Vordergrund.
Diese Lösung macht CNeuronExtralonger zu einem wesentlich dynamischeren Werkzeug. Im Gegensatz zum ursprünglichen statischen Schema, bei dem die Attention-Verteilung immer gleich bleibt, sorgt das adaptive Attention-Pooling dafür, dass das System flexibel ist und sich selbst anpasst. Es verhält sich wie ein erfahrener Händler, der es versteht, je nach Situation den Schwerpunkt zu verlagern.
Das Objekt enthält vier Schlüsselkomponenten, bei denen es sich um dynamische Arrays handelt. Sie nehmen Sequenzen neuronaler Schichten aus den internen Informationsflüssen auf. Auf den ersten Blick mag es seltsam erscheinen, vier interne Module zu erstellen. Schließlich werden in der Extralonger-Architektur nur drei Zweige genannt – der zeitliche, der räumliche und der gemischte. An dieser Stelle ist es wichtig, auf ein bestimmtes Merkmal hinzuweisen. Der zeitliche und der gemischte Analysezweig verwenden denselben Datenaufbereitungsblock. Um Doppelarbeit zu vermeiden und die Verwaltbarkeit zu verbessern, haben wir beschlossen, den Block zur Datenaufbereitung in eine eigenständige Komponente – cProjectionT – auszulagern. Im Wesentlichen handelt es sich um ein universell einsetzbares Gateway, das die konsistente Umwandlung von Eingabesequenzen in für die weitere Verarbeitung geeignete Einbettungen gewährleistet.
Wir haben den räumlichen Analysezweig mit dem entsprechenden Modul zur Datenaufbereitung zu einer einzigen Einheit zusammengefasst – cSpatialModule. Dieser Schritt ergibt sich aus der besonderen Natur räumlicher Abhängigkeiten. Hier sind die Datenvorverarbeitung und das Modell selbst so eng miteinander verflochten, dass es sinnvoll ist, sie als eine einzige interne Struktur zu betrachten.
Somit haben wir letztendlich vier Komponenten:
- cProjectionT – der Block zur Datenaufbereitung für den zeitlichen und den gemischten Zweig,
- cTimeModule – ein Modell zur zeitlichen Analyse,
- cSpatialModule – ein integriertes Modell zur Datenaufbereitung und räumlichen Analyse,
- cMixModule – ein gemischter Verarbeitungspfad, der zeitliche und räumliche Merkmale integriert.
Gerade diese Struktur ermöglicht es uns, die Logik der ursprünglichen Extralonger-Architektur beizubehalten und gleichzeitig die Implementierung modularer und wartungsfreundlicher zu gestalten.
Ausgehend vom übergeordneten architektonischen Framework wenden wir uns nach und nach dessen internen Details zu, und gerade hier wird die tatsächliche Komplexität der Struktur deutlich. Auf der obersten Ebene sehen wir nur vier dynamische Arrays – den vorbereitenden zeitlichen Projektionsblock, das zeitliche Modul, das räumliche Modul und den gemischten Verarbeitungspfad. Hinter dieser übersichtlichen Fassade verbirgt sich jedoch ein ganzes Ökosystem aus kleineren Komponenten: Faltungs- und Normalisierungsschichten, Transpositionskonverter, lernbare Einbettungen und Attention-Blöcke. Sie existieren nicht isoliert; jede einzelne spielt eine genau definierte Rolle, und ihr Zusammenspiel bildet einen dynamischen Informationsfluss, der durch CNeuronExtralonger verläuft.
Diese gesamte interne Welt wird in der Methode Init erstellt. Man kann sagen, dass hier die Struktur und die Logik des Verhaltens des Modells festgelegt werden. Die Initialisierung beginnt mit dem Aufruf der gleichnamigen Methode in der übergeordneten Klasse, die das allgemeine Framework für Multi-Head-Attention-Pooling bereitstellt.
bool CNeuronExtralonger::Init(uint numOutputs, uint myIndex, COpenCLMy *open_cl,
                              uint time_steps_in, uint time_steps_out, uint variables,
                              uint dimension, uint emb_dimension, uint period1,
                              uint frame1, uint period2, uint frame2, uint layers,
                              uint heads, uint dimension_k, uint m_units, float sparse,
                              ENUM_OPTIMIZATION optimization_type, uint batch)
  {
   if(!CNeuronMHAttentionPooling::Init(numOutputs, myIndex, open_cl, variables, time_steps_out,
                                       3, optimization_type, batch))
      return false;
Und dann beginnt der interessanteste Teil. Schritt für Schritt setzen wir einen komplexen Organismus zusammen, bei dem jede Schicht dem Gesamtbild ihre eigene Nuance verleiht. Aber zunächst ein wenig Vorarbeit: Deklarieren wir ein paar lokale Variablen, um Zeiger auf Objekte vorübergehend zu speichern.
   CNeuronBatchNormOCL           *norm    = NULL;
   CNeuronConvOCL                *conv    = NULL;
   CNeuronTransposeOCL           *transp  = NULL;
   CNeuronLearnabledPE           *lnoise  = NULL;
   CNeuronSpatialEmbedding       *semb    = NULL;
   CNeuronTempEmbedding          *temb    = NULL;
   CNeuronMLMHAttentionOCL       *att     = NULL;
   CNeuronGlobalLocalAttention   *glatt   = NULL;
Als Erstes kommt der Block zur Aufbereitung der Eingabedaten für die zeitlichen und gemischten Analysezweige zum Einsatz. Das ist so, als würde ein Stimmer die Instrumente vor einem Konzert vorbereiten. Das Positionskodierungsobjekt fügt dem Eingabedatenstrom einen trainierbaren Offset hinzu, den die Autoren des Frameworks als „trainierbares Rauschen“ bezeichnen. An dieser Stelle muss betont werden: Es handelt sich hierbei nicht um eine zufällige Beimischung, sondern um den bewussten Versuch, dem Modell die Fähigkeit zu verleihen, den zeitlichen Rhythmus des Marktes wahrzunehmen. Preis- und Volumendaten sind niemals völlig störungsfrei; sie unterliegen stets Mikroschwankungen. Durch die Einbettung von trainierbarem Rauschen wird diese Eigenschaft zu einem Werkzeug: Das Modell beginnt, Muster besser vom Chaos zu unterscheiden und seine Wahrnehmung von Zeit auf der Grundlage realer Marktrhythmen aufzubauen.
//--- Time projection
   cProjectionT.Clear();
   cProjectionT.SetOpenCL(OpenCL);
   int index = 0;
   lnoise = new CNeuronLearnabledPE();
   if(!lnoise ||
      !lnoise.Init(0, index, OpenCL, time_steps_in * variables, optimization, iBatch) ||
      !cProjectionT.Add(lnoise))
     {
      DeleteObj(lnoise);
      return false;
     }
Unmittelbar danach folgt eine Faltungsschicht, die eine besondere Rolle spielt. Sie wandelt jeden Zeitschritt in eine Einbettung um, die Informationen über alle analysierten Merkmale genau zu diesem Zeitpunkt enthält. Im Wesentlichen ergibt die Ausgabe eine kompakte und aussagekräftige Darstellung, die für jeden Schritt eine Art Momentaufnahme der Marktlage darstellt. Preis, Volumen, Indikatoren und andere Variablen werden zu einem einzigen Vektor zusammengefasst. Auf diese Weise kann das Modell statt mit isolierten Zahlen mit ganzheitlichen Darstellungen arbeiten, die das gesamte Spektrum der Beobachtungen im Zeitverlauf widerspiegeln.
   index++;
   conv = new CNeuronConvOCL();
   if(!conv ||
      !conv.Init(0, index, OpenCL, variables, variables, dimension, time_steps_in, 1,
                 optimization, iBatch) ||
      !cProjectionT.Add(conv))
     {
      DeleteObj(conv);
      return false;
     }
   conv.SetActivationFunction(None);
Der nächste Schritt ist die zeitliche Einbettung, bei der die Zeitreihen eine zusätzliche Dimension erhalten, die Zyklen und Perioden widerspiegelt. Die Architektur berücksichtigt hier zwei Arten von Wiederholungen: kurzfristige und längerfristige Muster, die mit den täglichen und wöchentlichen Rhythmen des Marktes zusammenhängen. Das ist so, als würde ein Musiker den Rhythmus und die Taktart spüren. Unabhängig von der Melodie gibt es immer eine rhythmische Grundlage, ohne die es unmöglich ist, eine Komposition zu schaffen. Bei Finanzdaten spiegelt sich dies im Wechsel zwischen den Handelssitzungen, in saisonalen Schwankungen oder in regelmäßigen Aktivitätsmustern der wichtigsten Marktteilnehmer wider. Durch die zeitliche Einbettung wird dieser Rhythmus buchstäblich in die Daten eingewoben, wodurch das Modell für Muster sensibilisiert wird, die sich von Tag zu Tag oder von Woche zu Woche wiederholen.
   index++;
   temb = new CNeuronTempEmbedding();
   uint half_emb = (emb_dimension + 1) / 2;
   if(!temb ||
      !temb.Init(0, index, OpenCL, time_steps_in, dimension, half_emb, period1,
                 frame1, dimension - half_emb, period2, frame2, optimization, iBatch) ||
      !cProjectionT.Add(temb))
     {
      DeleteObj(temb);
      return false;
     }
Mit der Normalisierung endet die Vorbereitungsphase. Sie lässt sich mit dem Glätten einer Leinwand vor dem Farbauftrag vergleichen. Wenn die Oberfläche uneben ist, wird das Bild verzerrt. Durch die Normalisierung werden zufällige Verzerrungen beseitigt, die Daten in eine stabile Verteilung gebracht und damit die Grundlage für die weitere Verarbeitung durch komplexere Module geschaffen.
   index++;
   norm = new CNeuronBatchNormOCL();
   if(!norm ||
      !norm.Init(0, index, OpenCL, temb.Neurons(), iBatch, optimization) ||
      !cProjectionT.Add(norm))
     {
      DeleteObj(norm);
      return false;
     }
Wenn die Daten den Vorbereitungsblock verlassen, gelangen sie in die Hände des Moduls zur zeitlichen Analyse. Hier kommt die Multi-Head-Attention ins Spiel, die mehrere parallele Perspektiven gleichzeitig eröffnet. Sie sucht nach Zusammenhängen zwischen Zeitpunkten, die Dutzende von Zeitschritten auseinanderliegen, und lernt, Muster zu erkennen, die bei einer einfachen, linearen Betrachtung nicht ersichtlich sind.
//--- Temporal Module
   cTimeModule.Clear();
   cTimeModule.SetOpenCL(OpenCL);
   index++;
   att = new CNeuronMLMHAttentionOCL();
   if(!att ||
      !att.Init(0, index, OpenCL, dimension + emb_dimension, dimension_k, heads,
                time_steps_in, layers, optimization, iBatch) ||
      !cTimeModule.Add(att))
     {
      DeleteObj(att);
      return false;
     }
Anschließend wird der Block aktiviert, der die Daten auf einen festgelegten Planungshorizont projiziert. Er lässt sich mit einer Brücke vergleichen, die historische Daten mit der Zukunft verbindet. Er umfasst mehrere Faltungsschichten, die die Einbettungen in eine multimodale Zeitreihensequenz umwandeln und gleichzeitig deren Länge anpassen, indem sie die Sequenz auf den erforderlichen Planungshorizont erweitern. Diese Schichten wirken wie Linsen mit unterschiedlicher Schärfentiefe: Einige betonen lokale Bewegungen, während andere eine breite Perspektive eröffnen.
   index++;
   conv = new CNeuronConvOCL();
   if(!conv ||
      !conv.Init(0, index, OpenCL, dimension + emb_dimension, dimension + emb_dimension,
                 variables, time_steps_in, 1, optimization, iBatch) ||
      !cTimeModule.Add(conv))
     {
      DeleteObj(conv);
      return false;
     }
   conv.SetActivationFunction(TANH);
   index++;
   transp = new CNeuronTransposeOCL();
   if(!transp ||
      !transp.Init(0, index, OpenCL, time_steps_in, variables, optimization, iBatch) ||
      !cTimeModule.Add(transp))
     {
      DeleteObj(transp);
      return false;
     }
   index++;
   conv = new CNeuronConvOCL();
   if(!conv ||
      !conv.Init(0, index, OpenCL, time_steps_in, time_steps_in, time_steps_out, variables,
                 1, optimization, iBatch) ||
      !cTimeModule.Add(conv))
     {
      DeleteObj(conv);
      return false;
     }
   conv.SetActivationFunction(SoftPlus);
   index++;
   conv = new CNeuronConvOCL();
   if(!conv ||
      !conv.Init(0, index, OpenCL, time_steps_out, time_steps_out, time_steps_out, variables,
                 1, optimization, iBatch) ||
      !cTimeModule.Add(conv))
     {
      DeleteObj(conv);
      return false;
     }
   conv.SetActivationFunction(None);
   index++;
   norm = new CNeuronBatchNormOCL();
   if(!norm ||
      !norm.Init(0, index, OpenCL, conv.Neurons(), iBatch, optimization) ||
      !cTimeModule.Add(norm))
     {
      DeleteObj(norm);
      return false;
     }
   index++;
   transp = new CNeuronTransposeOCL();
   if(!transp ||
      !transp.Init(0, index, OpenCL, variables, time_steps_out, optimization, iBatch) ||
      !cTimeModule.Add(transp))
     {
      DeleteObj(transp);
      return false;
     }
Das Ergebnis ist nicht mehr nur eine Menge von Einbettungen, sondern ein an den Planungshorizont angepasster Prognoseverlauf.
Gleichzeitig nimmt das Mischmodul seine Arbeit auf, und genau hier begeben sich die Daten auf eine besonders ereignisreiche Reise. Seine Rolle ist einzigartig: Es verbindet zeitliche und räumliche Merkmale und wandelt sie in einen einzigen Informationsstrom um. Als Erstes kommt ein klassischer Multi-Head-Attention-Block zum Einsatz, der die zeitliche Sequenz in ihrer reinen Form analysiert. Er sucht nach Mustern, Entsprechungen und wiederkehrenden Motiven, die in der Struktur der Sequenz verborgen sind, und schafft so eine solide Grundlage für die weitere Analyse.
//--- Mixed Module
   cMixModule.Clear();
   cMixModule.SetOpenCL(OpenCL);
   uint att_layers = (layers + 1) / 2;
   index++;
   att = new CNeuronMLMHAttentionOCL();
   if(!att ||
      !att.Init(0, index, OpenCL, dimension + emb_dimension, dimension_k, heads,
                time_steps_in, att_layers, optimization, iBatch) ||
      !cMixModule.Add(att))
     {
      DeleteObj(att);
      return false;
     }
Die Daten werden anschließend einer Transposition unterzogen, einer Art Perspektivwechsel. Während wir die Zeitreihe zunächst unter dem Gesichtspunkt der Zeitschritte betrachtet haben, verlagert sich der Fokus nun auf Merkmale, und in diesem neuen Koordinatensystem kommt das Global-Local-Attention-Modul ins Spiel. Hier werden zwei gegensätzliche Perspektiven in Einklang gebracht: eine globale Sichtweise, die den gesamten Markt umfasst, und ein lokaler Fokus, der es ermöglicht, subtile Zusammenhänge zwischen einzelnen Instrumenten oder kurzzeitige Ausschläge zu erkennen. Diese Kombination ist im finanziellen Kontext besonders wichtig: Der Markt kann sich wochenlang innerhalb der Grenzen eines übergeordneten Trends bewegen, doch einzelne Vermögenswerte können aufgrund von Nachrichten oder lokalen Ereignissen plötzlich die Richtung wechseln.
   index++;
   transp = new CNeuronTransposeOCL();
   if(!transp ||
      !transp.Init(0, index, OpenCL, time_steps_in, dimension + emb_dimension, optimization, iBatch) ||
      !cMixModule.Add(transp))
     {
      DeleteObj(transp);
      return false;
     }
   for(uint i = (att_layers == layers ? 0 : att_layers - 1); i < layers; i++)
     {
      index++;
      glatt = new CNeuronGlobalLocalAttention();
      if(!glatt ||
         !glatt.Init(0, index, OpenCL, dimension + emb_dimension, time_steps_in, dimension_k, heads,
                     m_units, sparse, optimization, iBatch) ||
         !cMixModule.Add(glatt))
        {
         DeleteObj(glatt);
         return false;
        }
     }
Der letzte Schritt ist der Prognoseblock, der dafür zuständig ist, alle gesammelten Informationen in ein Format umzuwandeln, das für die Planung über einen bestimmten Planungshorizont geeignet ist. Mehrere Faltungsschichten in diesem Block wandeln die Einbettungen in eine Folge von Prognosewerten um, deren Länge der Länge des erforderlichen Fensters entspricht. Hier werden abstrakte Darstellungen in ein konkretes Ergebnis umgewandelt – eine Prognose, die sowohl den globalen Kontext als auch lokale Besonderheiten widerspiegelt.
   index++;
   conv = new CNeuronConvOCL();
   if(!conv ||
      !conv.Init(0, index, OpenCL, time_steps_in, time_steps_in, time_steps_out,
                             dimension + emb_dimension, 1, optimization, iBatch) ||
      !cMixModule.Add(conv))
     {
      DeleteObj(conv);
      return false;
     }
   conv.SetActivationFunction(SoftPlus);
   index++;
   conv = new CNeuronConvOCL();
   if(!conv ||
      !conv.Init(0, index, OpenCL, time_steps_out, time_steps_out, time_steps_out,
                 dimension + emb_dimension, 1, optimization, iBatch) ||
      !cMixModule.Add(conv))
     {
      DeleteObj(conv);
      return false;
     }
   conv.SetActivationFunction(TANH);
   index++;
   transp = new CNeuronTransposeOCL();
   if(!transp ||
      !transp.Init(0, index, OpenCL, dimension + emb_dimension, time_steps_out,
                                                          optimization, iBatch) ||
      !cMixModule.Add(transp))
     {
      DeleteObj(transp);
      return false;
     }
   index++;
   conv = new CNeuronConvOCL();
   if(!conv ||
      !conv.Init(0, index, OpenCL, dimension + emb_dimension, dimension + emb_dimension,
                                     variables, time_steps_out, 1, optimization, iBatch) ||
      !cMixModule.Add(conv))
     {
      DeleteObj(conv);
      return false;
     }
   conv.SetActivationFunction(None);
   index++;
   norm = new CNeuronBatchNormOCL();
   if(!norm ||
      !norm.Init(0, index, OpenCL, conv.Neurons(), iBatch, optimization) ||
      !cMixModule.Add(norm))
     {
      DeleteObj(norm);
      return false;
     }
Dadurch fungiert das gemischte Modul als Syntheselabor: Zunächst werden zeitliche Muster erfasst; anschließend werden sie den räumlichen Beziehungen überlagert; und schließlich durchläuft das resultierende Signal einen Prognoseblock und wird zu einem vollwertigen Ergebnis, in dem mehrere Analyseebenen miteinander verwoben sind.
Die letzte Etappe des internen Datenwegs ist das räumliche Modul. Es sorgt dafür, dass der Markt nicht mehr als eine Ansammlung unabhängiger Zeitreihen betrachtet wird. Zunächst werden hier räumliche Einbettungen gebildet; diese erfassen die langfristigen Beziehungen zwischen Instrumenten, Sektoren und Indizes.
//--- Spatial Module
   cSpatialModule.Clear();
   cSpatialModule.SetOpenCL(OpenCL);
   index++;
   transp = new CNeuronTransposeOCL();
   if(!transp ||
      !transp.Init(0, index, OpenCL, time_steps_in, variables, optimization, iBatch) ||
      !cSpatialModule.Add(transp))
     {
      DeleteObj(transp);
      return false;
     }
   index++;
   conv = new CNeuronConvOCL();
   if(!conv ||
      !conv.Init(0, index, OpenCL, time_steps_in, time_steps_in, dimension, variables,
                 1, optimization, iBatch) ||
      !cSpatialModule.Add(conv))
     {
      DeleteObj(conv);
      return false;
     }
   conv.SetActivationFunction(None);
   index++;
   semb = new CNeuronSpatialEmbedding();
   if(!semb ||
      !semb.Init(0, index, OpenCL, variables, dimension, emb_dimension, optimization, iBatch) ||
      !cSpatialModule.Add(semb))
     {
      DeleteObj(semb);
      return false;
     }
Auf dieser Grundlage erstellen die global-lokalen Attention-Blöcke schrittweise ein umfassendes Bild der Korrelationen und detaillierten Beziehungen zwischen bestimmten Vermögenswerten. Man kann sagen, dass dieses Modul den Finanzmarkt in ein lebendiges Netzwerk verwandelt, in dem jedes Glied mit den anderen verbunden ist, und genau dieses Netzwerk wird zum Gegenstand der Analyse.
   index++;
   norm = new CNeuronBatchNormOCL();
   if(!norm ||
      !norm.Init(0, index, OpenCL, semb.Neurons(), iBatch, optimization) ||
      !cSpatialModule.Add(norm))
     {
      DeleteObj(norm);
      return false;
     }
   for(uint i = 0; i < layers; i++)
     {
      index++;
      glatt = new CNeuronGlobalLocalAttention();
      if(!glatt ||
         !glatt.Init(0, index, OpenCL, dimension + emb_dimension, variables, dimension_k,
                     heads, m_units, sparse, optimization, iBatch) ||
         !cSpatialModule.Add(glatt))
        {
         DeleteObj(glatt);
         return false;
        }
     }
Und wie bei den beiden oben vorgestellten Verarbeitungspfaden werden die Ergebnisse der Analyse an den Prognoseblock weitergeleitet, der alle Informationen sorgfältig in einem Format aufbereitet, das für die Planung über einen bestimmten Zeitraum geeignet ist.
   index++;
   conv = new CNeuronConvOCL();
   if(!conv ||
      !conv.Init(0, index, OpenCL, dimension + emb_dimension, dimension + emb_dimension,
                 time_steps_out, variables, 1, optimization, iBatch) ||
      !cSpatialModule.Add(conv))
     {
      DeleteObj(conv);
      return false;
     }
   conv.SetActivationFunction(SoftPlus);
   index++;
   conv = new CNeuronConvOCL();
   if(!conv ||
      !conv.Init(0, index, OpenCL, time_steps_out, time_steps_out, time_steps_out,
                 variables, 1, optimization, iBatch) ||
      !cSpatialModule.Add(conv))
     {
      DeleteObj(conv);
      return false;
     }
   conv.SetActivationFunction(None);
   index++;
   norm = new CNeuronBatchNormOCL();
   if(!norm ||
      !norm.Init(0, index, OpenCL, conv.Neurons(), iBatch, optimization) ||
      !cMixModule.Add(norm))
     {
      DeleteObj(norm);
      return false;
     }
   index++;
   transp = new CNeuronTransposeOCL();
   if(!transp ||
      !transp.Init(0, index, OpenCL, variables, time_steps_out, optimization, iBatch) ||
      !cMixModule.Add(transp))
     {
      DeleteObj(transp);
      return false;
     }
Alle drei Verarbeitungspfade (der zeitliche, der gemischte und der räumliche) laufen am Konkatenationspunkt zusammen. Hier werden ihre Ergebnisse zusammengeführt, und in dieser Phase wird unser zentraler Mechanismus – das adaptive Attention-Pooling – aktiviert. Im Gegensatz zur ursprünglichen Version mit festen Gewichtungen lassen wir die Verarbeitungspfade untereinander entscheiden, wessen Rolle zu einem bestimmten Zeitpunkt wichtiger ist. Daher ist das endgültige Signal kein statisches Konstrukt, sondern ein flexibles Instrument, das im Rhythmus des Marktes atmet.
   index++;
   if(!cConcatResults.Init(0, index, OpenCL, 3 * variables * time_steps_out, optimization, iBatch))
      return false;
   cConcatResults.SetActivationFunction(None);
//---
   return true;
  }
So verwandelt die Init-Methode eine trockene Abfolge von Aufrufen in eine dynamische Architektur, in der jede Komponente eine wichtige Rolle spielt und deren Zusammenspiel ein einzigartiges Analysewerkzeug hervorbringt. Hier entsteht ein Organismus namens CNeuronExtralonger, und jeder seiner Teile trägt zum Gesamtergebnis bei.
Nach der Initialisierung des Objekts entwickeln wir den Algorithmus für den Vorwärtsdurchlauf, der in der Methode feedForward implementiert ist. Die Methodensignatur spricht schon für sich. Als Parameter erhält sie einen Zeiger auf das Quelldatenobjekt NeuronOCL sowie einen zusätzlichen Puffer namens SecondInput, der die Zeitstempel der zu analysierenden Sequenz enthält.
bool CNeuronExtralonger::feedForward(CNeuronBaseOCL *NeuronOCL, CBufferFloat *SecondInput)
  {
   CNeuronBaseOCL *prev = NeuronOCL;
   CNeuronBaseOCL *current = NULL;
Die erste interne Operation ist die Deklaration zweier lokaler Variablen. Einer davon wird ein Zeiger auf das Quelldatenobjekt zugewiesen. Dies ist eine gängige Technik zur Weitergabe von Ergebnissen: prev dient als zuletzt verfügbares Ergebnis, das an die nächste Schicht weitergegeben wird. Und current dient als temporäre Variable, in der bei jeder Iteration ein Zeiger auf die gerade verarbeitete Schicht gespeichert wird. Dieser Ansatz ermöglicht es, eine Kette von Schichten linear aufzubauen, wodurch unnötige Kopiervorgänge vermieden werden und die Kontrolle über die Reihenfolge der Berechnungen gewahrt bleibt.
Anschließend wird eine Schleife über den Container cProjectionT zur Aufbereitung der Quelldaten gestartet. Für jede Projektion rufen wir einen Zeiger auf das aktuelle Objekt ab und prüfen sofort die Gültigkeit des Zeigers. Als Nächstes rufen wir die Methode für den Vorwärtsdurchlauf des Objekts auf. Tritt in irgendeinem Schritt ein Fehler auf, beendet sich die Methode sofort und gibt false zurück. Dies ist ein Fail-Fast-Muster: Es ist besser, beim ersten Problem abzubrechen, als die Verarbeitung beschädigter Daten fortzusetzen.
//--- Time projection
   for(int i = 0; i < cProjectionT.Total(); i++)
     {
      current = cProjectionT[i];
      if(!current ||
         !current.FeedForward(prev, SecondInput))
         return false;
      prev = current;
     }
Es ist wichtig zu beachten, dass in diesem Block die Methode FeedForward der internen Objekte zwei Argumente entgegennimmt: das vorherige Ergebnis und die Zeitstempel in SecondInput. Schließlich erfordert die Generierung zeitlicher Einbettungen zusätzlichen Kontext.
Wenn alles erfolgreich war, wird die Variable prev so aktualisiert, dass sie auf current verweist, sodass die nächste Iteration die Ausgabe der gerade verarbeiteten Schicht verwendet.
Sobald die Projektionen abgeschlossen sind, wird die Steuerung an das zeitliche Modul übergeben. Die Schleife über den Container cTimeModule sieht fast genauso aus, doch hier wird die Methode FeedForward der internen Objekte mit nur einem Argument aufgerufen. Dies deutet darauf hin, dass das zeitliche Modul die resultierende Sequenz ohne zusätzlichen Puffer verarbeitet.
//--- Temporal Module
   for(int i = 0; i < cTimeModule.Total(); i++)
     {
      current = cTimeModule[i];
      if(!current ||
         !current.FeedForward(prev))
         return false;
      prev = current;
     }
Fehlt eine Schicht des zeitlichen Moduls oder meldet ihre Methode FeedForward einen Fehler, brechen wir die Verarbeitung erneut ab und geben false zurück.
Dann verlagert sich der Fokus auf das gemischte Modul. Es ist jedoch zu beachten, dass dieses Modul auch mit den Ergebnissen der Datenvorverarbeitung arbeitet; daher setzen wir vor Beginn der Schleife die Variable prev auf einen Zeiger auf die letzte Schicht des Containers cProjectionT. Der zeitliche und der gemischte Zweig folgen parallelen Verarbeitungspfaden und verarbeiten dieselben Eingabemerkmale auf unterschiedliche Weise.
//--- Mixed Module
   prev = cProjectionT[-1];
   for(int i = 0; i < cMixModule.Total(); i++)
     {
      current = cMixModule[i];
      if(!current ||
         !current.FeedForward(prev))
         return false;
      prev = current;
     }
Anschließend wird für jedes Element von cMixModule dieselbe Überprüfung der Zeigergültigkeit durchgeführt und die Methode für den Vorwärtsdurchlauf aufgerufen; danach wird der Zeiger in prev aktualisiert. Jeder Fehler führt erneut dazu, dass die Funktion sofort beendet wird und den Wert false zurückgibt.
Das räumliche Modul ist separat organisiert und erhält NeuronOCL als Eingabedaten. Das bedeutet, dass der Spatial-Zweig das Eingangssignal parallel zu den anderen Zweigen analysiert, ohne die Zwischentransformationen zu übernehmen. Die cSpatialModule-Schichten werden anschließend nacheinander ausgeführt, wobei die übliche Fail-Fast-Logik zum Einsatz kommt und prev aktualisiert wird.
//--- Spatial Module
   prev = NeuronOCL;
   for(int i = 0; i < cSpatialModule.Total(); i++)
     {
      current = cSpatialModule[i];
      if(!current ||
         !current.FeedForward(prev))
         return false;
      prev = current;
     }
Dadurch erhalten wir letztendlich drei vollständige Zweige: den zeitlichen, den gemischten und den räumlichen. Der nächste Schritt ist die Konkatenation. Wir führen die Ausgaben der drei Zweige in einem einzigen Puffer zusammen, bilden so ein Fenster und legen die endgültige Dimensionalität fest. Wenn die Konkatenation fehlschlägt, gibt die Methode false zurück.
//--- Concatenate
   if(!Concat(cTimeModule[-1].getOutput(), cMixModule[-1].getOutput(), cSpatialModule[-1].getOutput(),
              cConcatResults.getOutput(), iWindow, iWindow, iWindow, iUnits))
      return false;
//---
   return CNeuronMHAttentionPooling::feedForward(cConcatResults.AsObject());
  }
Nach erfolgreicher Konkatenation muss das aggregierte Ergebnis an das Attention-Pooling-Modul übergeben werden.
Aus architektonischer Sicht wird deutlich, dass das System aus parallelen Verarbeitungspfaden besteht, von denen jeder die Eingabedaten mit einer eigenen Zielsetzung untersucht: Die Projektionen bereiten zeitliche Repräsentationen auf, das zeitliche Modul analysiert die Sequenz, das gemischte Modul kombiniert die Projektionen und das Spatial-Modul konzentriert sich auf räumliche Merkmale. Dieses Schema lässt sich mit einem Orchester vergleichen: Jedes Instrument hat seinen eigenen Part, und der Dirigent – das Attention-Pooling – fügt alles zu einem Ganzen zusammen.
Die Methode der Fehlergradientenausbreitung spiegelt weitgehend die Struktur des Vorwärtsdurchlaufs wider, mit dem Unterschied, dass die Daten in die entgegengesetzte Richtung fließen und die Fehlerströme sorgfältig summiert werden müssen.
bool CNeuronExtralonger::calcInputGradients(CNeuronBaseOCL *NeuronOCL,
                                            CBufferFloat *SecondInput,
                                            CBufferFloat *SecondGradient,
                                            ENUM_ACTIVATION SecondActivation = None)
  {
   if(!NeuronOCL)
      return false;
//---
   if(!CNeuronMHAttentionPooling::calcInputGradients(cConcatResults.AsObject()))
      return false;
Zunächst überprüfen wir die Gültigkeit des Zeigers auf das Quelldatenobjekt. Ist der Zeiger leer, gibt die Methode sofort false zurück. Anschließend wird die gleichnamige Methode in der übergeordneten Klasse aufgerufen. Dieser Schritt ermöglicht es, den von der nachfolgenden neuronalen Schicht empfangenen Fehlergradienten bis zum Konkatenationspuffer weiterzuleiten. Die erhaltenen Werte werden anschließend wieder auf die drei Zweige – den zeitlichen, den gemischten und den räumlichen – verteilt. Es ist wichtig zu beachten, dass der im gemeinsamen Puffer gesammelte Fehler streng gemäß der Architektur des Modells aufgeteilt wird. Jedem Zweig wurde der richtige Gradient zugewiesen. Sollte einer der Vorgänge fehlschlagen, wird der Prozess unterbrochen.
//--- DeConcatenate
   if(!cTimeModule[-1] || !cMixModule[-1] || !cSpatialModule[-1] ||
      !DeConcat(cTimeModule[-1].getGradient(), cMixModule[-1].getGradient(),
                cSpatialModule[-1].getGradient(), cConcatResults.getOutput(),
                iWindow, iWindow, iWindow, iUnits))
      return false;
Anschließend werden die Gradienten in umgekehrter Reihenfolge durch die Module weitergeleitet. Zunächst der räumliche Zweig. Die Schleife läuft vom Ende zum Anfang; für jedes aktuelle Element wird eine Referenz auf die nächste Schicht abgerufen und die Methode des internen Objekts zur Weiterleitung des Fehlergradienten aufgerufen. Der Fehler wird sorgfältig Schicht für Schicht zurückgeleitet.
   CNeuronBaseOCL *next = NULL;
   CNeuronBaseOCL *current = NULL;
//--- Spatial Module
   for(int i = cSpatialModule.Total() - 1; i >= 0; i--)
     {
      current = (i > 0 ? cSpatialModule[i - 1] : NeuronOCL);
      next = cSpatialModule[i];
      if(!current ||
         !current.CalcHiddenGradients(next))
         return false;
     }
Die gleiche Logik gilt auch für das gemischte Modul, mit dem Unterschied, dass hier das letzte Element der zeitlichen Projektionen als Bezugspunkt dient. Dies spiegelt die parallele Struktur des Modells wider: Verschiedene Zweige geben Fehler über ihre eigenen Kanäle zurück, jedoch stets synchron.
//--- Mixed Module
   for(int i = cMixModule.Total() - 1; i >= 0; i--)
     {
      current = (i > 0 ? cMixModule[i - 1] : cProjectionT[-1]);
      next = cMixModule[i];
      if(!current ||
         !current.CalcHiddenGradients(next))
         return false;
     }
Das zeitliche Modul ist von besonderem Interesse. An dieser Stelle sei angemerkt, dass es den Fehlergradienten an die letzte Schicht des Moduls zur Datenvorverarbeitung weiterleitet. Und genau dorthin haben wir gerade die Werte aus dem gemischten Modul übergeben. Daher speichern wir vor dem Rückwärtsdurchlauf des zeitlichen Analysemoduls einen Zeiger auf den aktuellen Fehlergradientenpuffer, der die gespeicherten Werte enthält, in der lokalen Variablen temp. Anschließend übergeben wir dem Objekt einen Zeiger auf einen freien Puffer.
//--- Temporal Module
   CBufferFloat *temp = current.getGradient();
   if(!current.SetGradient(current.getPrevOutput(), false))
      return false;
   for(int i = cTimeModule.Total() - 1; i >= 0; i--)
     {
      current = (i > 0 ? cTimeModule[i - 1] : cProjectionT[-1]);
      next = cTimeModule[i];
      if(!current ||
         !current.CalcHiddenGradients(next))
         return false;
     }
   if(!SumAndNormilize(temp, current.getGradient(), temp, 1, false, 0, 0, 0, 1) ||
      !current.SetGradient(temp, false))
      return false;
Anschließend werden in der Schleife – erneut vom Ende zum Anfang – die Gradienten durch das Modul weitergegeben. Nach Abschluss des Rückwärtsdurchlaufs entlang des zeitlichen Zweigs summieren wir die aus den beiden Datenströmen erhaltenen Werte und stellen den ursprünglichen Zustand der Datenpufferzeiger wieder her.
Der letzte Schritt besteht darin, die zeitlichen Projektionen zu verarbeiten. Hier wird der Gradient bis auf die Ebene des Quelldatenobjekts zurückgeleitet. Ich möchte Sie jedoch daran erinnern, dass wir die Fehlergradienten aus dem räumlichen Zweig bereits dorthin weitergeleitet haben. Daher wenden wir erneut den Trick mit dem Austausch des Datenpuffers an und führen anschließend die Operationen zur Weiterleitung des Fehlergradienten durch.
//--- Time projection
   temp = NeuronOCL.getGradient();
   if(!NeuronOCL.SetGradient(NeuronOCL.getPrevOutput(), false))
      return false;
   for(int i = cProjectionT.Total() - 1; i >= 0; i--)
     {
      current = (i > 0 ? cProjectionT[i - 1] : NeuronOCL);
      next = cProjectionT[i];
      if(!current ||
         !current.CalcHiddenGradients(next, SecondInput, SecondGradient, SecondActivation))
         return false;
     }
   if(!SumAndNormilize(temp, NeuronOCL.getGradient(), temp, 1, false, 0, 0, 0, 1) ||
      !NeuronOCL.SetGradient(temp, false))
      return false;
//---
   return true;
  }
Somit verteilt die Methode die Gradienten sorgfältig auf drei parallele Zweige – Spatial, Mix und Temporal. In jedem Zweig verläuft der Rückwärtsdurchlauf Schicht für Schicht in umgekehrter Reihenfolge, und die Fehler werden an den Verbindungspunkten der Zweige summiert. Dies entspricht dem gleichen architektonischen Konzept wie beim Vorwärtsdurchlauf: Die Daten fließen durch parallele Kanäle, werden aber letztendlich zu einem einzigen Ergebnis zusammengefasst.
Der vollständige Klassencode, einschließlich aller Methoden, ist im Anhang enthalten, sodass Sie die Gesamtstruktur und die Funktionsweise der Implementierung nachvollziehen können.
Modellarchitektur
Sobald wir alle für die Implementierung des Extralonger-Frameworks erforderlichen Objekte erstellt haben, besteht der nächste logische Schritt darin, die Architektur des Modells selbst zu beschreiben. An dieser Stelle ist es wichtig zu betonen, dass wir uns nicht auf die Prognose von Zeitreihen beschränken, wie dies in der Implementierung des Autors der Fall ist. Unser Ziel ist umfassender und praxisorientierter – wir entwickeln einen vollwertigen Handelsroboter, der in der Lage ist, eigenständig Entscheidungen zu treffen und Handelsgeschäfte am Markt auszuführen.
Bei diesem Ansatz ist die Prognose von Preisreihen nicht mehr das eigentliche Endziel, sondern dient lediglich als Teil des Systems – genauer gesagt als Encoder des Umgebungszustands. Eine Art Sensor, der Marktdaten in ein Format umwandelt, das der Algorithmus verstehen kann. Unter Beibehaltung des Actor–Critic-Konzepts entwickeln wir drei funktionale Modelle: Encoder, Actor und Critic.
Die Methode CreateDescriptions dient dazu, deren Architektur zu beschreiben. Darin werden für jeden der drei Teile des Modells Arrays mit Schichtbeschreibungen sorgfältig erstellt und initialisiert.
bool CreateDescriptions(CArrayObj *&encoder,
                        CArrayObj *&actor,
                        CArrayObj *&critic
                       )
  {
//---
   CLayerDescription *descr;
//---
   if(!encoder)
     {
      encoder = new CArrayObj();
      if(!encoder)
         return false;
     }
   if(!actor)
     {
      actor = new CArrayObj();
      if(!actor)
         return false;
     }
   if(!critic)
     {
      critic = new CArrayObj();
      if(!critic)
         return false;
     }
Der Code beginnt mit der Überprüfung der übergebenen Array-Zeiger. Falls eines der Arrays noch nicht existiert, wird ein neues angelegt. Dieser Schritt gewährleistet Zuverlässigkeit – wir stellen sicher, dass das anschließende Eintragen der Beschreibungen nicht aufgrund einer fehlenden Struktur zu Fehlern führt.
Anschließend werden die Arrays geleert und die Schichten des Encoders Schritt für Schritt aufgebaut. Zunächst wird die Quelldatenschicht hinzugefügt.
//--- Encoder
   encoder.Clear();
//--- Input layer
   if(!(descr = new CLayerDescription()))
      return false;
   descr.type = defNeuronBaseOCL;
   uint prev_count = descr.count = (HistoryBars * BarDescr);
   descr.activation = None;
   descr.optimization = ADAM;
   if(!encoder.Add(descr))
     {
      delete descr;
      return false;
     }
Der nächste Schritt ist eine Normalisierungsschicht mit hinzugefügtem Rauschen, die durch stochastische Verzerrungen zur Verbesserung der Trainingsstabilität beiträgt.
//--- Layer 1
   if(!(descr = new CLayerDescription()))
      return false;
   descr.type = defNeuronBatchNormWithNoise;
   descr.count = prev_count;
   descr.batch = BatchSize;
   descr.activation = None;
   descr.optimization = ADAM;
   if(!encoder.Add(descr))
     {
      delete descr;
      return false;
     }
Anschließend wird eine Schicht erstellt, die Differenzen erster Ordnung als Merkmale hinzufügt. Ihr Zweck besteht darin, Zeitscheiben zu erzeugen, indem die Werte der Kursbar miteinander verknüpft werden. Dadurch erzeugt diese Schicht doppelt so viele Merkmale, da die Werte selbst und ihre Differenzen kombiniert werden.
//--- Layer 2
   if(!(descr = new CLayerDescription()))
      return false;
   descr.type = defNeuronConcatDiff;
   prev_count = descr.count = HistoryBars;
   descr.layers = BarDescr;
   descr.step = 1;
   descr.batch = BatchSize;
   descr.optimization = ADAM;
   descr.activation = None;
   if(!encoder.Add(descr))
     {
      delete descr;
      return false;
     }
   uint prev_out = descr.layers*2 ;
Von besonderem Interesse ist die nächste Schicht, defNeuronExtralonger. Sie definiert die Architektur des von uns erstellten CNeuronExtralonger-Objekts auf oberster Ebene. Im Wesentlichen ist dies das gesamte Extralonger-Framework. Darin legen wir alle erforderlichen Parameter fest: Zeitfenster, den Prognosehorizont, kurze und lange Perioden sowie die Dimensionalität der verborgenen Merkmale. Dieser Block verwandelt den Encoder in einen intelligenten Filter, der historische Daten und die Zukunft in einer einheitlichen Repräsentation miteinander verknüpft.
//--- Layer 3
   if(!(descr = new CLayerDescription()))
      return false;
   descr.type = defNeuronExtralonger;
     {
      uint temp[] = {HistoryBars,   // History time steps
                     NForecast,     // Forecast time steps
                     ShortPeriod,   // Period 2
                     LongPeriod,    // Period 2
                     BarDescr/2     // M units
                    };
      if(ArrayCopy(descr.units, temp) < (int)temp.Size())
         return false;
     }
   prev_count = descr.units[1];
   descr.window = prev_out;            // Variables
   descr.window_out = EmbeddingSize;   // Inside Dimension
     {
      uint temp[] = {EmbeddingSize,             // Embedding Dimension
                     PeriodSeconds(PERIOD_H1),  // Frame 1
                     PeriodSeconds(PERIOD_D1),  // Frame 2
                     2*EmbeddingSize/NHeads
                    };
      if(ArrayCopy(descr.windows, temp) < (int)temp.Size())
         return false;
     }
   descr.layers=2;
   descr.step=NHeads;
   descr.probability=0.3f;
   descr.optimization=ADAM;
   descr.batch=BatchSize;
   descr.activation = None;
   if(!encoder. Add(descry))
     {
      delete descry;
      return false;
     }
   uint window=descr.window;
   uint count=prev_count;
Am Ausgang des Extralonger-Moduls erhalten wir einen bereits aufbereiteten Block von Prognosewerten, der zur weiteren Verwendung bereitsteht. Man darf jedoch nicht vergessen, dass wir die Daten bereits vor der Eingabe in dieses Modul um Merkmale auf Basis von Differenzen erster Ordnung angereichert hatten. Diese Methode machte die Zeitreihe informativer, erhöhte aber gleichzeitig die Dimensionalität der Daten.
Es scheint, als wäre der einfachste Weg, dieses Problem zu lösen, die überflüssigen Merkmale einfach zu verwerfen. Dieser Ansatz würde jedoch zum Verlust genau jener Informationen führen, derentwegen die Differenz erster Ordnung überhaupt eingeführt wurde. Anstelle einer vereinfachten Lösung verwenden wir eine Faltungsschicht, die nicht nur die Dimensionalität reduziert, sondern auch die aussagekräftigsten lokalen Muster herausfiltert. Dadurch wird die Modulausgabe einer Feinfilterung unterzogen: Die Daten werden kompakter, behalten dabei jedoch sämtliche wesentlichen Merkmale bei, die für Handelsentscheidungen erforderlich sind.
//--- layer 4
   if(!(descr = new CLayerDescription()))
      return false;
   descr.type = defNeuronConvOCL;
   descr.count = prev_count;
   descr.window = prev_out;
   descr.step = prev_out;
   prev_out = descr.window_out = BarDescr;
   descr.activation = TANH;
   descr.optimization = ADAM;
   if(!encoder.Add(descr))
     {
      delete descr;
      return false;
     }
Die letzte Komponente des Encoders für den Umgebungszustand ist die Schicht zur umgekehrten Denormalisierung (defNeuronRevInDenormOCL). Diese Schicht führt die Werte wieder auf die Skala der analysierten Daten zurück und beseitigt dabei den Versatz, der bei der Kodierung und Normalisierung entstanden ist. Somit lässt sich das Ergebnis mit den tatsächlichen Marktwerten vergleichen.
//--- layer 5
   if(!(descr = new CLayerDescription()))
      return false;
   descr.type = defNeuronRevInDenormOCL;
   descr.count = prev_count * prev_out;
   descr.layers = 1;
   if(!encoder.Add(descr))
     {
      delete descr;
      return false;
     }
Die Architektur der Actor- und Critic-Modelle stammt vollständig aus unseren früheren Arbeiten und wurde in keiner Weise verändert. Genau aus diesem Grund werden wir in diesem Artikel nicht näher darauf eingehen. Zur Abrundung finden die Leser im Anhang eine vollständige Beschreibung der Architektur aller trainierbaren Modelle. Dort können sie jedes Implementierungsdetail nachvollziehen und die Integrität der entwickelten Lösung überprüfen.
Tests
Das Modelltraining ist eine umfassende Vorbereitung auf den Handel. Bevor wir die Strategie im Live-Handel einsetzen, unterzogen wir sie anhand historischer Daten einem gründlichen Backtest. Die erste Phase – das Offline-Training – wurde anhand einer Datenstichprobe des Währungspaares EURUSD im H1-Zeitrahmen für den Zeitraum von Januar 2024 bis Juni 2025 durchgeführt. Dieser Zeitraum erwies sich als abwechslungsreich und facettenreich: Ruhige Seitwärtsphasen wechselten sich mit starken Trendbewegungen ab, während rund um Nachrichtenveröffentlichungen die Volatilität stark anstieg. Dank dieser Kombination von Bedingungen konnte das Modell lernen, eine Vielzahl von Marktszenarien zu unterscheiden und robuste Handelsentscheidungen zu treffen, ohne in komplexen Situationen die Orientierung zu verlieren.
Nachdem die erste Vorbereitungsphase abgeschlossen war, gingen wir zur zweiten über – der Online-Feinabstimmung im Strategietester von MetaTrader 5. Hier trafen die Daten in Echtzeit ein – eine Kerze nach der anderen –, und das Modell lernte die Dynamik der Arbeit mit einem Live-Datenstrom kennen. Es lernte, trotz Marktrauschen stabil zu bleiben, mit geringer Liquidität umzugehen und auch bei plötzlichen Kurssprüngen den Kurs zu halten. Diese Phase diente als eine Art Strategieverfeinerung. Diese Phase veränderte das auf historischen Daten aufgebaute Framework zwar nicht, half aber dabei, es an reale Bedingungen anzupassen und das Risiko einer Überanpassung zu verringern.
Der abschließende Test wurde anhand von Daten aus dem Juli 2025 durchgeführt – diese Daten waren zuvor noch nicht verwendet worden und für das Modell völlig neu. Alle in den vorangegangenen Phasen ermittelten Parameter wurden unverändert geladen. Dieser reine Out-of-Sample-Test ermöglichte es, die Generalisierungsfähigkeit des Modells ohne jegliche Feinabstimmung oder Anpassungen objektiv zu bewerten.
Die Testergebnisse sind im Folgenden aufgeführt.


Anhand der Testergebnisse lässt sich das Modell unter realen Marktbedingungen ohne jegliche Anpassungen bewerten. Fangen wir mit den Kennzahlen an. Bei einer Anfangseinlage von 100 US-Dollar betrug das endgültige Nettoergebnis 3,02 US-Dollar, was bedeutet, dass sich der Kontostand während des einmonatigen Testzeitraums um drei Prozent erhöht hat. Der Gesamtgewinn belief sich auf 27,26 US-Dollar, die Gesamtverluste betrugen 24,24 US-Dollar. Der Profitfaktor lag bei 1,12. Dies deutet darauf hin, dass die gewinnbringenden Trades die verlustbringenden Trades leicht überwiegen.
Allerdings gibt es auch eine Schwäche: Der Erholungsfaktor beträgt lediglich 0,22. Das bedeutet, dass das Modell nach einer Reihe von Verlusten sein Kapital nur langsam wieder aufbaut. Der maximale Drawdown des Kontostands betrug 12,75 % – ein recht hoher Wert, der jedoch für den vollautomatischen Handel noch nicht kritisch ist. Der durchschnittliche Erwartungswert pro Trade fiel mit 0,06 US-Dollar zwar bescheiden aus, doch die Sharpe-Ratio (3,04) deutet unter Berücksichtigung der Volatilität auf ein gutes Rendite-Risiko-Verhältnis hin.
Auch die Handelsstatistiken sind interessant. Insgesamt gab es 50 Trades, darunter 28 Short-Trades (mit einer Erfolgsquote von 53,57 %) und 22 Long-Trades (die nur in 36,36 % der Fälle erfolgreich waren). Insgesamt lag der Anteil der gewinnbringenden Trades bei 46 %. Der größte Gewinn bei einem einzelnen Trade betrug 6,70 US-Dollar, der größte Verlust 4,73 US-Dollar. Auch die Serien waren aufschlussreich: Dem Modell gelang es, bis zu fünf Trades in Folge zu gewinnen, während es höchstens drei Trades in Folge verlor.
Die Kapitalkurve bestätigt das Bild, das sich aus den Zahlen ergibt. Die ersten Julitage waren von Schwankungen und einer Reihe von Drawdowns geprägt, woraufhin der Kontostand allmählich zu steigen begann. Mitte des Monats gab es mehrere erfolgreiche Handelsserien, wodurch das Kapital in den positiven Bereich gelangte. Gegen Ende Juli stabilisierte sich die Lage, und die Ergebnisse blieben stabil, ohne dass es zu neuen starken Einbrüchen kam.
Der Test hat somit gezeigt, dass das Modell in der Lage ist, moderate Renditen zu erzielen und dabei ein ausgewogenes Verhältnis zwischen Risiko und Rendite zu wahren. Der Testzeitraum ist jedoch recht kurz, und für den Einsatz im realen Handel sind weitere Optimierungen erforderlich. In erster Linie bedeutet dies, den Drawdown zu verringern und den Anteil der gewinnbringenden Trades zu erhöhen. Vor allem aber hat das System einen sauberen Out-of-Sample-Test mit neuen Daten bestanden und seine Generalisierungsfähigkeit unter Beweis gestellt – ein entscheidendes Kriterium für die Qualität eines algorithmischen Modells.
Und vergessen wir nicht, dass das Trainieren von Transformern ein recht komplexer Prozess ist, der umfangreiche Trainingsdatensätze erfordert.
Fazit
Im Rahmen unserer Arbeit haben wir festgestellt, dass die vom Framework Extralonger vorgeschlagenen Ansätze in der Lage sind, räumliche und zeitliche Faktoren nahtlos zu integrieren und damit eine solide Grundlage für die Analyse von Marktdynamiken zu bilden.
Tests haben die praktische Wirksamkeit der Algorithmen bestätigt, und dank der Flexibilität der Architektur lässt sich das System an verschiedene Prognosehorizonte und Klassen von Finanzinstrumenten anpassen. Die Umsetzung in MQL5 hat gezeigt, dass klassische Ansätze in Kombination mit modernen Methoden neuronaler Netze Ergebnisse liefern, die mit denen komplexerer Systeme vergleichbar sind, dabei aber äußerst transparent und gut handhabbar bleiben.
Links
- Extralonger: Auf dem Weg zu einer einheitlichen Betrachtung räumlich-zeitlicher Faktoren für die extrem langfristige Verkehrsprognose
- Weitere Artikel in dieser Reihe
In diesem Artikel verwendete Dateien
| # | Name | Typ | Beschreibung |
|---|---|---|---|
| 1 | Study.mq5 | Expert Advisor | Expert Advisor für das Offline-Modelltraining |
| 2 | StudyOnline.mq5 | Expert Advisor | Expert Advisor für Online-Modelltraining |
| 3 | Test.mq5 | Expert Advisor | Expert Advisor für Modelltests |
| 4 | Trajectory.mqh | Klassenbibliothek | Struktur zur Beschreibung des Systemzustands und der Modellarchitektur |
| 5 | NeuroNet.mqh | Klassenbibliothek | Klassenbibliothek zum Erstellen eines neuronalen Netzes |
| 6 | NeuroNet.cl | Bibliothek | Codebibliothek für ein OpenCL-Programm |
Übersetzt aus dem Russischen von MetaQuotes Ltd.
Originalartikel: https://www.mql5.com/ru/articles/19564
Warnung: Alle Rechte sind von MetaQuotes Ltd. vorbehalten. Kopieren oder Vervielfältigen untersagt.
Dieser Artikel wurde von einem Nutzer der Website verfasst und gibt dessen persönliche Meinung wieder. MetaQuotes Ltd übernimmt keine Verantwortung für die Richtigkeit der dargestellten Informationen oder für Folgen, die sich aus der Anwendung der beschriebenen Lösungen, Strategien oder Empfehlungen ergeben.



