

Handelsroboter mit Multithreading und maschinellem Lernen: Vom Konzept zur Umsetzung
 23
 1

Dieses Projekt ist eine Neuauflage eines meiner alten Programme. Der Code schlummert seit Jahren auf verstaubten Festplatten und läuft mittlerweile nicht mehr: In der Entwicklungsumgebung hat sich zu viel verändert. Ich habe beschlossen, nicht nur die Entwicklung wieder aufzunehmen, sondern sie auch in mehreren Artikeln Schritt für Schritt zu erläutern.
Die ursprüngliche Idee war es, einen Handelsroboter mit Multithreading zu entwickeln, der leistungsstarke parallele Rechenverfahren nutzt, möglicherweise sogar unter Einsatz von Cloud-Computing-Clustern. Stellen Sie sich Folgendes vor: Sie sitzen vor mehreren Bildschirmen, beobachten die Kursbewegungen verschiedener Währungspaare und stellen fest, dass das menschliche Gehirn schlichtweg nicht in der Lage ist, Dutzende Finanzinstrumente gleichzeitig im Blick zu behalten, Hunderte Indikatoren zu analysieren und Entscheidungen in der Geschwindigkeit zu treffen, die moderne Märkte erfordern. Zu diesem Zeitpunkt entstand die Idee, einen intelligenten Handelsroboter zu entwickeln, der in der Lage ist, mit einem Portfolio verschiedener Finanzinstrumente zu arbeiten und Daten aus mehreren Jahrzehnten parallel zu analysieren.
Aber warum Python und nicht das integrierte MQL5? Diese Frage stellt sich wahrscheinlich jedem, der die Hybridarchitektur unserer Lösung sieht. Die Antwort liegt in der Art der Probleme, die wir lösen. Für maschinelles Lernen sind leistungsstarke Bibliotheken wie scikit-learn, XGBoost und pandas erforderlich – ein Ökosystem, das für solche Aufgaben wie geschaffen zu sein scheint.
Ein weiterer Grund für diese Entscheidung: Die Architektur unseres Roboters basiert auf dem Prinzip der Aufteilung von Verantwortlichkeiten und der Arbeitsteilung. Python ist für das „Gehirn“ zuständig – Datenerfassung, Vorverarbeitung, Merkmalserstellung, Modelltraining und Generierung von Handelssignalen. MetaTrader 5 übernimmt über seine Python-API die Rolle der „Hände“ – für die Orderausführung, die Positionsverwaltung und die Bereitstellung von Marktdaten in Echtzeit.
Multithreading entwickelt sich nicht nur zu einer technischen Lösung, sondern zu einer Notwendigkeit. Wenn Ihr Roboter EURUSD, GBPUSD, AUDUSD und andere Währungspaare gleichzeitig analysieren muss, wird die sequenzielle Verarbeitung zum Engpass. Jeder Thread erhält ein eigenes Währungspaar, ein eigenes Modell und einen eigenen Entscheidungskontext. Das ist vergleichbar damit, wie erfahrene Händler mehrere Handelsideen gleichzeitig im Kopf behalten können – nur mit der Rechenleistung einer Maschine.
Ein charakteristisches Merkmal unseres Ansatzes ist die Integration des Risikomanagements auf Portfolioebene. Anstatt jedes Finanzinstrument unabhängig zu handeln, führen wir die globale Variable TOTAL_PORTFOLIO_RISK ein, die das Gesamtrisiko des Portfolios begrenzt. Das bedeutet, dass bei der Berechnung der Positionsgröße für jedes Finanzinstrument nicht nur dessen Volatilität, sondern auch bereits offene Positionen in anderen Finanzinstrumenten berücksichtigt werden.
TOTAL_PORTFOLIO_RISK: float = 500.0
POSITION_SIZES: Dict[str, float] = {}
SYMBOL_TRADES: Dict[str, bool] = {}
Protokollierungssystem und Abruf von Marktdaten
Bevor wir uns mit Algorithmen des maschinellen Lernens befassen, müssen wir eine solide Grundlage schaffen – ein Protokollierungs- und Datenabrufsystem. Haben Sie schon einmal versucht, eine Multithread-Anwendung ohne Protokolle zu debuggen? Das ist so, als würde man mit verbundenen Augen nach einer Nadel im Heuhaufen suchen.
Unser Protokollierungssystem basiert auf einer Warteschlange mit begrenzter Größe – eine Lösung, die zwar übermäßig komplex erscheinen mag, jedoch weitreichende Auswirkungen hat. Stellen Sie sich folgende Situation vor: Fünf Threads versuchen gleichzeitig, Informationen auf der Konsole auszugeben. Ohne Koordination entsteht am Ende ein Durcheinander aus vermischten Meldungen. Die Warteschlange gewährleistet Konsistenz, und ein separater Ausgabe-Thread sorgt für die Lesbarkeit der Protokolle.
log_queue = queue.Queue(maxsize=1000)

def log_printer():
    while True:
        try:
            log_message = log_queue.get(timeout=10)
            if log_message is None:
                break
            print(log_message)
        except queue.Empty:
            continue
Warum genau 1000 Nachrichten in der Warteschlange? Das ist das Ergebnis praktischer Erfahrungen. Eine zu kleine Warteschlange führt dazu, dass in Zeiten hoher Auslastung wichtige Nachrichten verloren gehen, während eine zu große Warteschlange einen übermäßigen Speicherverbrauch zur Folge hat. Eine Kapazität von 1000 Nachrichten bietet für einen Handelsroboter den optimalen Kompromiss.
Nun kommen wir zum Kern unseres Systems – der Funktion „retrieve_data“. Sie wirkt einfach, doch dahinter steckt eine auf Zuverlässigkeit ausgerichtete Philosophie. Sehen Sie sich die Variable retries_limit = 300 an. Diese Zahl ist nicht willkürlich gewählt. Im realen Handel kann es vorkommen, dass die Server der Broker für einige Sekunden, manchmal sogar für Minuten, nicht erreichbar sind. 300 Versuche im Sekundentakt geben uns ein Zeitfenster von 5 Minuten zur Wiederherstellung der Verbindung.
Besonderes Augenmerk wird auf die Erstellung technischer Indikatoren gelegt. Wir berechnen nicht nur den RSI oder den MACD – wir schaffen ein ganzes Ökosystem miteinander vernetzter Merkmale. Der RSI zeigt an, ob ein Vermögenswert überkauft oder überverkauft ist. Der MACD zeigt Veränderungen im Momentum an. Der ATR misst die Volatilität. Doch die wahre Magie entfaltet sich erst, wenn diese Indikatoren innerhalb eines Modells für maschinelles Lernen zusammenwirken.
# RSI (Relative Strength Index)
delta = raw_data['close'].diff()
gain = delta.where(delta > 0, 0).rolling(14).mean()
loss = (-delta.where(delta < 0, 0)).rolling(14).mean()
rs = gain / loss
raw_data['RSI_14'] = (100 - (100 / (1 + rs))).astype(np.float64)
Beachten Sie, dass wir „np.float64“ anstelle von „float32“ verwenden. Das scheint zwar eine Verschwendung von Speicherplatz zu sein, doch spätere Funktionen erfordern Berechnungen mit hoher Genauigkeit. Abstriche bei der Genauigkeit können zu Instabilität beim Merkmalsclustering führen.
Jeder technische Indikator hat seine eigene „Persönlichkeit“. Der Williams %R reagiert sehr stark auf Kursänderungen. Der Aroon-Oszillator zeigt die Stärke des Trends an. Die Efficiency Ratio (Effizienzverhältnis) misst die „Reinheit“ der Kursbewegung. Wenn all diese Indikatoren in Modellen des maschinellen Lernens zusammengeführt werden, ergeben sie ein mehrdimensionales Bild des Marktes, das über die menschlichen Wahrnehmungsgrenzen hinausgeht.
Datenaugmentation und Erstellung synthetischer Datenbeispiele
Maschinelles Lernen ist datenhungrig, doch die Finanzmärkte sind mit historischen Beispielen sehr sparsam. Wie lässt sich dieses Dilemma lösen? Die Datenaugmentation ist unser Schlüssel dazu, aus einer begrenzten Datenhistorie einen umfangreichen Trainingsdatensatz zu erstellen.
Die Funktion „augment_data“ implementiert vier Strategien zur Datenaugmentation, die jeweils auf fundierten Überlegungen beruhen. Die erste Strategie besteht darin, Rauschen hinzuzufügen. Man könnte fragen: Warum sollte man saubere Daten verfälschen? Die Antwort liegt in der Natur echter Märkte. Preise verlaufen nie vollkommen gleichmäßig – es gibt immer Mikroschwankungen, Slippage und zufällige Ausschläge. Durch das Hinzufügen von kontrolliertem Rauschen bereiten wir das Modell auf reale Bedingungen vor.
noisy_data = raw_data.astype(np.float32) + np.random.normal(0, noise_level, raw_data.shape).astype(np.float32) Der Parameterwert „noise_level = 0.01“ wurde nicht zufällig gewählt. Das entspricht etwa 1 % des Merkmalswerts – genug, um Variabilität zu erzeugen, aber nicht so viel, dass Muster verzerrt werden. Stellen Sie sich das wie eine sanfte Wellenbewegung auf dem Wasser vor: Sie verändert die Fließrichtung nicht, sorgt aber für mehr Realismus.
Die zweite Strategie ist die Zeitverschiebung. Wir erstellen eine um eine Stunde nach vorne verschobene Kopie der Daten. Das mag künstlich erscheinen, aber Muster an den Finanzmärkten wiederholen sich oft mit leichten zeitlichen Verschiebungen. Die morgendliche Volatilität könnte am Abend wieder auftreten, und die wöchentlichen Zyklen könnten sich um ein oder zwei Tage verschieben.
Die dritte Strategie ist die Skalierung. Wir multiplizieren alle Werte mit einem zufälligen Koeffizienten zwischen 0,9 und 1,1. Dadurch werden verschiedene Marktbedingungen simuliert: Phasen hoher und niedriger Volatilität sowie Hausse- und Baissephasen. Ein Modell, das nur auf Daten aus einem einzigen Zeitraum trainiert wurde, ist möglicherweise machtlos, wenn sich die Marktbedingungen ändern.
Die vierte Strategie ist die Vorzeichenumkehr in den Preisspalten. Wir multiplizieren die Preisdaten mit -1 und drehen damit das Diagramm praktisch auf den Kopf. Dadurch wird das Modell darauf trainiert, spiegelbildliche Muster zu erkennen. Bei einer Invertierung wird aus der Schulter-Kopf-Schulter-Formation eine inverse Schulter-Kopf-Schulter-Formation, wobei die mathematischen Zusammenhänge zwischen den Merkmalen erhalten bleiben.
for col in price_columns:
    if col in inverted_data.columns:
        inverted_data[col] *= -1
Es ist von entscheidender Bedeutung, die Ergebnisse der Datenaugmentation korrekt zu verarbeiten. Gleitkommaoperationen können unendliche Werte oder NaN ergeben. Unsere Datenbereinigungsstrategie verwendet Mediane, um problematische Werte zu ersetzen – ein robusterer Ansatz als die Verwendung von Mittelwerten, die durch Ausreißer verzerrt werden können.
Nach der Datenaugmentation verfünffacht sich das Datenvolumen. Aus 1.000 Stunden historischer Daten erhalten wir 5.000 Trainingsbeispiele. Doch dabei handelt es sich nicht nur um eine quantitative Steigerung – es ist eine qualitative Bereicherung. Das Modell berücksichtigt nicht nur, was tatsächlich geschehen ist, sondern auch Möglichkeiten, wie es unter leicht anderen Bedingungen hätte kommen können.
Besonderes Augenmerk legen wir auf die Verarbeitung des Handelsvolumens. Im Gegensatz zu Preisen kann das Volumen nicht negativ sein. Daher lassen wir es bei der Invertierung unverändert und begrenzen es beim Hinzufügen von Rauschen nach unten auf null. So bleibt die wirtschaftliche Logik der Daten erhalten.
Datenlabeling und Erstellung von Zielvariablen
Maschinelles Lernen ohne korrekt mit Labels versehene Daten ist so, als würde man versuchen, einem Kind das Lesen beizubringen, indem man ihm Buchstaben zeigt, ohne ihm deren Bedeutung zu erklären. Die Funktionen „markup_data“ und „label_data“ lösen das grundlegende Problem, Rohpreisdaten in Trainingsbeispiele mit eindeutigen Ziellabels umzuwandeln.
Die Funktion „markup_data“ implementiert den einfachsten Ansatz für das Datenlabeling: Sie sagt voraus, ob der Preis nach einer Periode den aktuellen Preis um den Wert „markup_ratio“ übersteigt. Dieser Ansatz mag primitiv erscheinen, doch seine Einfachheit täuscht. Der Parameter „markup_ratio“ = 0,00002 (2 Pips für die meisten Währungspaare) berücksichtigt die tatsächlichen Handelskosten.
def markup_data(
    data: pd.DataFrame,
    target_column: str,
    label_column: str,
    markup_ratio: float = 0.00002
) -> pd.DataFrame:
    log("Starting markup_data function")
    data[label_column] = np.where(
        data[target_column].shift(-1) > data[target_column] + markup_ratio,
        1,
        0
    ).astype(np.int8)
    data.loc[data[label_column].isna(), label_column] = 0
    log(f"Number of labels set for price change greater than markup ratio: {data[label_column].sum()}")
    return data
Die Funktion „label_data“ stellt einen ausgefeilteren Ansatz dar. Anstatt lediglich Preise im Abstand einer Periode zu vergleichen, simuliert die Funktion eine reale Handelsstrategie mit Stop-Loss- und Take-Profit-Aufträgen. Dies ist von entscheidender Bedeutung, da Finanzmärkte nichtlinear sind. Der Kurs könnte zwar Ihr Kursziel erreichen, auf dem Weg dorthin aber Ihren Stop-Loss auslösen.
def label_data(
    data: pd.DataFrame,
    symbol: str,
    min_days: int = 2,
    max_days: int = 72
) -> pd.DataFrame:
    if not mt5.initialize(path=TERMINAL_PATH):
        log("Terminal connection error")
        return data

    symbol_info = mt5.symbol_info(symbol)
    stop_level: float = 300 * symbol_info.point
    take_level: float = 800 * symbol_info.point
    labels: List[Optional[int]] = []

    for i in range(data.shape[0] - max_days):
        rand: int = random.randint(min_days, max_days)
        curr_pr: float = data['close'].iloc[i]
        future_pr: float = data['close'].iloc[i + rand]
        min_pr: float = data['low'].iloc[i:i + rand].min()
        max_pr: float = data['high'].iloc[i:i + rand].max()
        price_change: float = abs(future_pr - curr_pr)

        if (price_change > take_level and
            future_pr > curr_pr and
            min_pr > curr_pr - stop_level):
            labels.append(1)
        elif (price_change > take_level and
              future_pr < curr_pr and
              max_pr < curr_pr + stop_level):
            labels.append(0)
        else:
            labels.append(None)
Der Algorithmus für das Datenlabeling funktioniert wie folgt: Für jeden Zeitpunkt wählen wir einen zufälligen Zeithorizont zwischen min_days und max_days (zwischen 2 und 72 Stunden) aus. Anschließend analysieren wir das Kursverhalten in diesem Intervall. Die Prüfung erfolgt in drei Stufen: Ist die Kursbewegung groß genug (price_change > take_level), stimmt die Richtung (future_pr > curr_pr bei Käufen) und wurde der Stop-Loss nicht vorzeitig ausgelöst (min_pr > curr_pr - stop_level)?
Warum zufällige Zeithorizonte? Dadurch wird eine Überanpassung des Modells an feste Zeitintervalle verhindert. Die Märkte kennen unsere Analysezeiträume nicht – ein Muster kann sich innerhalb von 5 Stunden oder innerhalb von 50 Stunden entwickeln. Durch den Zufallscharakter passt sich das Modell besser an unterschiedliche Zeitskalen der Marktbewegungen an.
data = data.iloc[:len(labels)].copy()
    data['labels'] = labels
    data.dropna(inplace=True)

    X = data.drop('labels', axis=1)
    y = data['labels']

    rus = RandomUnderSampler(random_state=2)
    X_balanced, y_balanced = rus.fit_resample(X, y)

    data_balanced = pd.concat([X_balanced, y_balanced], axis=1)
    log(f"Number of growth labels (1.0): {data_balanced['labels'].value_counts().get(1.0, 0)}")
    log(f"Number of decline labels (0.0): {data_balanced['labels'].value_counts().get(0.0, 0)}")
    return data_balanced
Die Parameter „stop_level = 300 Punkte“ und „take_level = 800 Punkte“ legen das Risiko-Ertrags-Verhältnis auf etwa 1:2,67 fest. Diese Werte werden mit „symbol_info.point“ multipliziert, wodurch sie automatisch an das jeweilige Finanzinstrument angepasst werden. Für EURUSD mit point = 0.00001 entspricht dies einem Stop-Loss von 300 Punkten und einem Take-Profit von 800 Punkten (etwa 30 bzw. 80 Pips, je nach Kursformat des Brokers).
RandomUnderSampler löst das Problem des Klassenungleichgewichts auf radikale Weise – dabei werden zufällig ausgewählte Beispiele aus der Mehrheitsklasse entfernt, bis ein Gleichgewicht erreicht ist. Bei Finanzdaten gibt es immer mehr Phasen mit „keinem klaren Signal“ als eindeutige Handelsmöglichkeiten. Ohne Ausgleich lernt das Modell, in 90 % der Fälle „kein Signal“ vorherzusagen, und ist zwar formal korrekt, aber praktisch nutzlos.
Merkmalsgenerierung und Clusterbildung mit gaußschen Mischmodellen
Sobald wir eine Reihe grundlegender technischer Indikatoren erstellt haben, stellt sich die Frage: Wie können wir noch mehr Informationen aus den verfügbaren Daten gewinnen? Die Funktion „generate_new_features“ löst dieses Problem, indem sie automatisch abgeleitete Merkmale anhand zufälliger Kombinationen bestehender Merkmale generiert.
Die Philosophie hinter diesem Ansatz ist einfach, aber wirkungsvoll: Wenn zwei Merkmale für sich genommen nützliche Informationen enthalten, können ihre mathematischen Kombinationen verborgene Muster aufdecken. Stellen Sie sich vor, ein Indikator zeigt die Stärke eines Trends an und ein anderer dessen Beständigkeit. Ihr Produkt kann Momente aufzeigen, in denen ein starker Trend nicht mehr aufrechterhalten werden kann.
def generate_new_features(
    data: pd.DataFrame,
    num_features: int = 10,
    random_seed: int = 1
) -> pd.DataFrame:
    random.seed(random_seed)
    new_features: Dict[str, pd.Series] = {}

    columns = data.columns
    for i in range(num_features):
        feature_name = f'feature_{i}'
        col1_idx, col2_idx = random.sample(range(len(columns)), 2)
        col1, col2 = columns[col1_idx], columns[col2_idx]
        operation = random.choice([
            'add', 'subtract', 'multiply', 'divide',
            'shift', 'rolling_mean', 'rolling_std',
            'rolling_max', 'rolling_min', 'rolling_sum'
        ])
Die Zufälligkeit bei der Auswahl der Spalten und Operationen mag chaotisch erscheinen, sorgt aber für Abwechslung. Bei einem deterministischen Ansatz könnten nicht offensichtliche, aber nützliche Kombinationen übersehen werden. Die Division erfordert besondere Sorgfalt – wir addieren einen kleinen Wert von 1e-8 zum Nenner, um eine Division durch Null zu vermeiden.
elif operation == 'divide':
            new_features[feature_name] = (data[col1] / (data[col2] + 1e-8)).astype(np.float32)
        elif operation == 'shift':
            shift = random.randint(1, 10)
            new_features[feature_name] = data[col1].shift(shift).fillna(method='ffill').fillna(method='bfill').astype(np.float32)
Verschiebungsoperationen erzeugen verzögerte Merkmale mit einer zufälligen Verzögerung von 1 bis 10 Perioden. Dadurch kann sich das Modell die Vergangenheit über verschiedene Zeithorizonte hinweg „merken“. Gleitende Statistiken fügen geglättete Versionen der ursprünglichen Merkmale hinzu, wodurch langfristige Trends sichtbar werden können, die im kurzfristigen Rauschen verborgen sind.
Der nächste Schritt ist das Merkmalsclustering mithilfe von gaußschen Mischmodellen. Dies ist einer der elegantesten Teile unseres Systems. GMM geht davon aus, dass die Daten durch eine Mischung aus mehreren Normalverteilungen erzeugt werden. Im Zusammenhang mit den Finanzmärkten bedeutet dies eine Einteilung in verschiedene Marktregime – Hausse, Baisse, Seitwärtsbewegung, hohe Volatilität, geringe Volatilität.
def cluster_features_by_gmm(
    data: pd.DataFrame,
    n_components: int = 6
) -> pd.DataFrame:
    X = data.drop(['label', 'labels'], axis=1, errors='ignore').astype(np.float32)
    X = X.replace([np.inf, -np.inf], np.nan).fillna(X.median(numeric_only=True))

    gmm = GaussianMixture(
        n_components=n_components,
        covariance_type='full',
        reg_covar=0.1,
        random_state=1
    )
    gmm.fit(X)
    data['cluster'] = gmm.predict(X).astype(np.int16)
    return data
Der Wert n_components = 6 wurde als Kompromiss zwischen Detailgenauigkeit und Interpretierbarkeit gewählt. Zu wenige Cluster führen zu einem Verlust an Nuancen, zu viele zu Überanpassung und Instabilität. Anhand von sechs Clustern lassen sich die wichtigsten Marktregime erfassen: starker Aufwärtstrend, schwacher Aufwärtstrend, Seitwärtsbewegung mit geringer Volatilität, Seitwärtsbewegung mit hoher Volatilität, schwacher Abwärtstrend, starker Abwärtstrend.
Der Parameter „covariance_type='full'“ ermöglicht es GMM, Korrelationen zwischen Merkmalen zu modellieren. Dies ist in der Finanzwelt von entscheidender Bedeutung, wo Variablen selten unabhängig voneinander sind. RSI und MACD können sich unter verschiedenen Marktbedingungen unterschiedlich verhalten, und die vollständige Kovarianzmatrix trägt dem Rechnung.
Die Kovarianz-Regularisierung (reg_covar=0.1) verhindert eine Modelldegeneration in Fällen, in denen die Daten nahezu linear voneinander abhängig sind. Bei Finanzdaten treten solche Situationen regelmäßig auf, beispielsweise wenn mehrere Indikatoren gleichzeitig Extremwerte aufweisen.
Die Cluster-Zugehörigkeit wird zu einem neuen, aussagekräftigen Merkmal. Das Modell für maschinelles Lernen erhält nicht nur Informationen über die konkreten Werte der Indikatoren, sondern auch über das Marktregime, zu dem die aktuelle Situation gehört. Dadurch werden Kontextinformationen hinzugefügt, die die Interpretation anderer Merkmale erheblich verändern können.
Rekursive Merkmalselimination und XGBoost-Training mit Ensemblebildung
Angesichts Dutzender technischer Indikatoren, generierter Merkmale und Cluster-Labels stehen wir vor dem klassischen Problem des „Fluchs der Dimensionalität“. Mehr Merkmale bedeuten nicht immer ein besseres Modell. Umgekehrt können redundante und korrelierte Merkmale zu Überanpassung und einer verminderten Generalisierungsfähigkeit führen.
Die Funktion „feature_engineering“ löst dieses Dilemma mithilfe der rekursiven Merkmalselimination mit Kreuzvalidierung (RFECV). Diese Methode arbeitet wie ein erfahrener Trader, der nach und nach unnötige Indikatoren aus seinem Arsenal aussortiert und nur die aussagekräftigsten behält.
def feature_engineering(
    data: pd.DataFrame,
    n_features_to_select: int = 15
) -> pd.DataFrame:
    X = data.drop(['label', 'labels'], axis=1, errors='ignore').astype(np.float32)
    y = data['labels'].astype(np.int8)
    X = X.replace([np.inf, -np.inf], np.nan).fillna(X.median(numeric_only=True))

    unique_classes = y.unique()
    if len(unique_classes) < 2:
        log(f"Error in feature_engineering: Only one class found in labels: {unique_classes}")
        raise ValueError(f"The target 'y' needs to have more than 1 class. Got {len(unique_classes)} class instead")

    clf = RandomForestClassifier(n_estimators=100, random_state=1)
    rfecv = RFECV(
        estimator=clf,
        step=1,
        cv=5,
        scoring='accuracy',
        n_jobs=1,
        verbose=1,
        min_features_to_select=n_features_to_select
    )
    rfecv.fit(X, y)
RFECV arbeitet iterativ: Es beginnt mit allen Merkmalen, trainiert das Modell, ermittelt die Wichtigkeit jedes Merkmals, entfernt das unwichtigste Merkmal und wiederholt den Vorgang. „step=1“ bedeutet, dass bei jeder Iteration nur ein Merkmal entfernt wird – langsam, aber präzise. Eine Alternative wäre „step=5“, um den Vorgang zu beschleunigen, doch im Finanzbereich sind die Kosten eines Fehlers zu hoch.
Die Wahl des „RandomForestClassifier“ als Basisschätzer ist kein Zufall. Ein Zufallswald eignet sich gut für heterogene Merkmale und ist robust gegenüber Ausreißern. Seine Werte für „feature_importances_“ basieren auf der Abnahme der Gini-Unreinheit, die ein intuitives Maß für die Merkmalswichtigkeit liefert.
selected_features = X.columns[rfecv.get_support()]
    selected_data = data[selected_features.tolist() + ['label', 'labels']]
    log("\nBest features:")
    log(str(pd.DataFrame({'Feature': selected_features})))
    return selected_data
Kommen wir nun zum Kern unseres Systems: dem XGBoost-Training mit Ensemble-Ansatz. XGBoost ist aufgrund seiner Fähigkeit, nichtlineare Wechselwirkungen zwischen Merkmalen zu modellieren, und seiner Widerstandsfähigkeit gegenüber Überanpassung für seine Leistungsfähigkeit bei finanziellen Problemstellungen bekannt.
def train_xgboost_classifier(
    data: pd.DataFrame,
    num_boost_rounds: int = 500
) -> BaggingClassifier:
    if data.empty:
        raise ValueError("Data should not be empty")

    X = data.drop(['label', 'labels'], axis=1).astype(np.float32)
    y = data['labels'].astype(np.int8)

    clf = xgb.XGBClassifier(
        objective='binary:logistic',
        random_state=1,
        max_depth=5,
        learning_rate=0.2,
        n_estimators=300,
        subsample=0.01,
        colsample_bytree=0.1,
        reg_alpha=1,
        reg_lambda=1
    )
Die XGBoost-Parameter sind für die Arbeit mit Finanzdaten ausgelegt: „max_depth=5“ begrenzt die Tiefe der Bäume und verhindert so Überanpassung bei verrauschten Daten; „learning_rate=0.2“ gewährleistet ein ausreichend schnelles Training bei gleichzeitiger Wahrung der Stabilität. Die Regularisierungsparameter sind entscheidend: „subsample=0.01“ bedeutet, dass jeder Baum nur mit 1 % der Daten trainiert wird, was die Überanpassung drastisch reduziert; „colsample_bytree=0.1“ gibt an, dass jeder Baum nur 10 % der Merkmale verwendet. Das mag extrem erscheinen, doch in Kombination mit einer großen Anzahl von Bäumen (n_estimators=300) entsteht so ein leistungsstarkes Ensemble aus vielfältigen, schwachen Lernmodellen.
bagging_clf = BaggingClassifier(estimator=clf, random_state=1)
    param_grid = {
        'n_estimators': [10, 20, 30],
        'max_samples': [0.5, 0.7, 1.0],
        'max_features': [0.5, 0.7, 1.0]
    }

    grid_search = GridSearchCV(bagging_clf, param_grid, cv=5, scoring='accuracy')
    grid_search.fit(X, y)
    accuracy = grid_search.best_score_
    log(f"Average cross-validation accuracy: {accuracy:.2f}")
    return grid_search.best_estimator_
Darüber hinaus fügt BaggingClassifier über XGBoost eine weitere Ebene der Ensemblebildung hinzu. Wir erstellen ein Meta-Ensemble: Jedes Element ist bereits ein Gradient-Boosting-Ensemble, und durch Bagging werden mehrere solcher XGBoost-Modelle kombiniert. Dieses zweischichtige Ensemble zeichnet sich durch eine außergewöhnliche Robustheit gegenüber Überanpassung aus.
GridSearchCV wählt automatisch die optimalen Bagging-Parameter mittels Kreuzvalidierung aus; „max_samples“ legt fest, welcher Anteil der Daten zum Trainieren der einzelnen Modelle im Ensemble verwendet wird, und „max_features“ bestimmt den Anteil der Merkmale, die jedem Modell zur Verfügung stehen. Das Zusammenspiel dieser Parameter sorgt für Vielfalt im Ensemble – den Schlüssel zu seiner Wirksamkeit.
Portfoliorisikomanagement und dynamische Positionsgrößenbestimmung
Stellen Sie sich folgende Situation vor: Ihr Handelsroboter erzielt bei jedem einzelnen Finanzinstrument hervorragende Ergebnisse, doch sobald Sie ihn mit einem Portfolio handeln lassen, kommt es zu einer Katastrophe. Der Grund dafür ist einfach: mangelnde Abstimmung zwischen den einzelnen Positionen. Fünf gleichzeitige Trades von jeweils 1 Lot in einem Umfeld mit stark korrelierten Währungspaaren können ein Risiko verursachen, das dem einer Position von 5 Lot entspricht.
Die Funktion „calculate_portfolio_position_sizes“ revolutioniert den Ansatz im Risikomanagement. Anstelle fester Positionsgrößen berechnen wir diese dynamisch auf der Grundlage der aktuellen Volatilität der einzelnen Finanzinstrumente und des Gesamtrisikolimits des Portfolios.
def calculate_portfolio_position_sizes(symbols: List[str]) -> None:
    global POSITION_SIZES

    if not mt5.initialize(path=TERMINAL_PATH):
        log("Error connecting to the terminal for calculating positions")
        return

    try:
        symbol_risks = {}
        for symbol in symbols:
            symbol_info = mt5.symbol_info(symbol)
            if symbol_info is None:
                continue

            # Get ATR for the last 14 days
            rates = mt5.copy_rates_from_pos(symbol, mt5.TIMEFRAME_D1, 0, 20)
            if rates is None or len(rates) < 14:
                continue

            df = pd.DataFrame(rates)
            df['tr'] = np.maximum(df['high'] - df['low'],
                                 np.maximum(abs(df['high'] - df['close'].shift(1)),
                                           abs(df['low'] - df['close'].shift(1))))
            atr = df['tr'].rolling(14).mean().iloc[-1]

            # Risk per standard lot
            risk_per_lot = (atr / symbol_info.point) * symbol_info.trade_tick_value
            symbol_risks[symbol] = risk_per_lot
Der ATR (Average True Range) bildet die Grundlage unseres Risikomanagementsystems. Dieser Indikator misst die durchschnittliche Volatilität eines Finanzinstruments über einen Zeitraum von 14 Tagen und berücksichtigt dabei nicht nur die täglichen Schwankungen, sondern auch Kurslücken zwischen Schluss- und Eröffnungskurs. Die „True Range“ für jeden Tag wird als das Maximum aus drei Werten berechnet: der Differenz zwischen dem Tageshöchst- und dem Tagestiefstkurs, der Differenz zwischen dem Tageshöchstkurs und dem vorherigen Schlusskurs sowie der Differenz zwischen dem vorherigen Schlusskurs und dem Tagestiefstkurs.
Die Formel „risk_per_lot = (atr / symbol_info.point) * symbol_info.trade_tick_value“ wandelt die Volatilität in einen Geldwert um. Wenn der ATR für EURUSD bei 0,00080 (80 Pips) liegt, beträgt das Risiko bei einem Standardlot 80 USD bei einem Pip-Wert von 1 USD.
# Risk per instrument
        risk_per_instrument = TOTAL_PORTFOLIO_RISK / len(symbols)

        # Calculate position sizes
        for symbol, risk_per_lot in symbol_risks.items():
            symbol_info = mt5.symbol_info(symbol)
            base_size = risk_per_instrument / risk_per_lot

            # Normalize to the broker's requirements
            min_lot = symbol_info.volume_min
            lot_step = symbol_info.volume_step
            normalized_size = max(min_lot, round(base_size / lot_step) * lot_step)

            POSITION_SIZES[symbol] = normalized_size
            SYMBOL_TRADES[symbol] = False

            log(f"{symbol}: lot={normalized_size:.3f}, risk={normalized_size * risk_per_lot:.2f}")
Die gleichmäßige Verteilung des Risikos auf die einzelnen Finanzinstrumente (risk_per_instrument = TOTAL_PORTFOLIO_RISK / len(symbols)) mag zwar simpel erscheinen, gewährleistet jedoch ein ausgewogenes Portfolio. Bei TOTAL_PORTFOLIO_RISK = 500 USD und fünf Währungspaaren erhält jedes Finanzinstrument ein Risikolimit von 100 USD.
Es ist von entscheidender Bedeutung, die Positionsgrößen an die Anforderungen des Brokers anzupassen. In der Praxis legen Broker Beschränkungen fest: eine Mindestlotgröße (in der Regel 0,01) und eine Schrittweite für Änderungen der Lotgröße (in der Regel 0,01). Die Funktion „round(base_size / lot_step) * lot_step“ rundet die berechnete Größe auf den nächstgelegenen gültigen Wert.
Das SYMBOL_TRADES-Flag-System verhindert, dass mehrere Positionen für ein und dasselbe Finanzinstrument eröffnet werden. Dies ist besonders wichtig in einer Multithread-Umgebung, in der jeder Thread unabhängig ein Handelssignal empfangen kann.
def check_and_update_position_flags() -> None:
    global SYMBOL_TRADES

    if not mt5.initialize(path=TERMINAL_PATH):
        return

    try:
        positions = mt5.positions_get()
        if positions is None:
            positions = []

        open_symbols = set()
        for pos in positions:
            if pos.magic == 123456:  # Our magic number
                open_symbols.add(pos.symbol)

        # Reset flags for symbols without open positions
        for symbol in list(SYMBOL_TRADES.keys()):
            if symbol not in open_symbols and SYMBOL_TRADES[symbol]:
                SYMBOL_TRADES[symbol] = False
                log(f"Flag reset for {symbol} - position is closed")
Die Funktion „check_and_update_position_flags“ sorgt für die Synchronisation zwischen dem internen Zustand des Handelsroboters und den tatsächlichen Positionen im Terminal. Die Position kann vom Händler manuell oder durch einen Stop-Loss bzw. Take-Profit geschlossen werden. Ohne regelmäßige Überprüfungen könnte der Handelsroboter „annehmen“, dass die Position noch offen ist, und dadurch neue Handelsmöglichkeiten verpassen.
Die Magic Number 123456 dient dazu, unsere Positionen von denen anderer Handelsroboter oder aus manuellen Trades zu unterscheiden. Dadurch wird sichergestellt, dass wir ausschließlich Positionen verwalten, die wir selbst eröffnet haben.
Handelslogik und Orderausführung in Echtzeit
Der Moment der Wahrheit für jeden Handelsroboter kommt, wenn die Orders ausgeführt werden. Alle vorangegangenen Schritte – Datenerfassung, Merkmalserstellung, Modelltraining – dienen einem einzigen Ziel: der Entscheidung, ob „gekauft“, „verkauft“ oder „abgewartet“ werden soll. Die Funktion „online_trading“ setzt diese Entscheidungen in reale Marktpositionen um.
def online_trading(
    symbol: str,
    features: np.ndarray,
    model: Any
) -> Optional[Any]:
    global SYMBOL_TRADES, POSITION_SIZES

    # Check and update position flags
    check_and_update_position_flags()

    if not mt5.initialize(path=TERMINAL_PATH):
        log("Error: Failed to connect to MetaTrader 5 terminal")
        return None

    # Check if a position is already open for this symbol
    if SYMBOL_TRADES.get(symbol, False):
        log(f"Position for {symbol} already open")
        mt5.shutdown()
        return None

    # Get the position size from the portfolio calculation
    volume = POSITION_SIZES.get(symbol, 0.1)
Die ersten Zeilen der Funktion veranschaulichen defensives Programmieren. Die Überprüfung der Positionsflags verhindert doppelte Trades. Die Initialisierung des Terminals kann aufgrund von Netzwerkproblemen oder eines Neustarts des Terminals unerwartet fehlschlagen. Die Ermittlung des Handelsvolumens anhand der vorab berechneten Werte in POSITION_SIZES stellt sicher, dass es mit der übergeordneten Risikomanagementstrategie im Einklang steht.
Besondere Aufmerksamkeit verdient die Schleife zur Abfrage von Symbolinformationen. Im Live-Handel kann „symbol_info“ aufgrund von Verbindungsproblemen mit dem Server des Brokers vorübergehend den Wert „None“ zurückgeben. Anstatt sofort aufzugeben, unternimmt der Handelsroboter bis zu 30.000 Versuche im Abstand von jeweils 5 Sekunden.
attempts: int = 30000
    symbol_info = None
    for _ in range(attempts):
        symbol_info = mt5.symbol_info(symbol)
        if symbol_info is not None:
            break
        log(f"Error: Instrument not found. Attempt {_ + 1} of {attempts}")
        time.sleep(5)

    if symbol_info is None:
        mt5.shutdown()
        return None

    tick = mt5.symbol_info_tick(symbol)
    price_bid: float = tick.bid
    price_ask: float = tick.ask
    signal = model.predict(features)
    positions_total: int = mt5.positions_total()
30.000 Versuche mögen übertrieben erscheinen, doch im Zusammenhang mit dem algorithmischen Handel entsprechen sie etwa 41 Stunden ununterbrochener Versuche. Die Märkte sind rund um die Uhr geöffnet, und kurzfristige technische Probleme sollten nicht dazu führen, dass Handelsmöglichkeiten verpasst werden.
Die Logik hinter Handelsentscheidungen besticht durch ihre Einfachheit. Das Modell liefert eine Wahrscheinlichkeit, und wir verwenden einen Schwellenwert von 0,5, um zwischen Kauf- und Verkaufssignalen zu unterscheiden. Eine zusätzliche Überprüfung, ob positions_total < MAX_OPEN_TRADES gilt, verhindert eine übermäßige Hebelwirkung.
request = None
    if positions_total < MAX_OPEN_TRADES and signal[-1] > 0.5:
        request = {
            "action": mt5.TRADE_ACTION_DEAL,
            "symbol": symbol,
            "volume": volume,
            "type": mt5.ORDER_TYPE_BUY,
            "price": price_ask,
            "sl": price_ask - 50 * symbol_info.point,
            "tp": price_ask + 100 * symbol_info.point,
            "deviation": 20,
            "magic": 123456,
            "comment": "Portfolio Buy",
            "type_time": mt5.ORDER_TIME_GTC,
            "type_filling": mt5.ORDER_FILLING_FOK,
        }
Die Struktur einer Handelsanfrage enthält zahlreiche wichtige Parameter. TRADE_ACTION_DEAL bedeutet eine sofortige Ausführung zum Marktpreis. ORDER_TYPE_BUY/SELL bestimmt die Richtung. Ein Stop-Loss von 50 Pips und ein Take-Profit von 100 Pips ergeben ein Risiko-Ertrags-Verhältnis von 1:2.
Der Parameter „deviation=20“ ermöglicht es dem Broker, den Auftrag mit einer Abweichung von bis zu 20 Punkten vom gewünschten Kurs auszuführen. In schnelllebigen Märkten verhindert dies, dass Aufträge aufgrund winziger Kursschwankungen zwischen dem Zeitpunkt des Kursempfangs und der Auftragserteilung abgelehnt werden.
ORDER_TIME_GTC (Good Till Cancelled) bedeutet, dass die Order bis zu ihrer Stornierung gültig ist. ORDER_FILLING_FOK (Fill Or Kill) schreibt vor, dass die Order entweder vollständig ausgeführt oder abgelehnt werden muss – Teilausführungen sind nicht zulässig.
for _ in range(attempts):
        result = mt5.order_send(request)
        if result.retcode == mt5.TRADE_RETCODE_DONE:
            # Mark that the position is open for this symbol
            SYMBOL_TRADES[symbol] = True
            log(f"Position opened {symbol}: {'Buy' if signal[-1] > 0.5 else 'Sell'}, lot={volume}")
            mt5.shutdown()
            return result.order
        log(f"Error: Trade request not executed, retcode={result.retcode}. Attempt {_ + 1}/{attempts}")
        time.sleep(3)
Auch im Zyklus der Orderausführung werden mehrere Versuche unternommen. TRADE_RETCODE_DONE bedeutet, dass die Ausführung erfolgreich war. Andere Codes können auf unzureichende Deckung, Liquiditätsprobleme oder technische Probleme hinweisen. 3-Sekunden-Intervalle zwischen den Versuchen geben dem Markt Zeit, sich zu stabilisieren.
Das Setzen des Flags SYMBOL_TRADES[symbol] = True nach einer erfolgreichen Ausführung ist entscheidend, um doppelte Positionen in einer Multithread-Umgebung zu vermeiden. Die Protokollierung mit Positionsrichtung und Volumen gewährleistet eine lückenlose Rückverfolgbarkeit der Handelsaktivitäten.
Multithread-Architektur und Thread-Koordination
Stellen Sie sich ein Orchester vor, in dem jeder Musiker seinen eigenen Part spielt, aber alle demselben Dirigenten folgen. Unsere Multithread-Architektur funktioniert nach dem gleichen Prinzip: Jeder Thread verarbeitet sein eigenes Finanzinstrument am Devisenmarkt eigenständig, doch alle Threads werden über gemeinsam genutzte globale Variablen und Funktionen koordiniert.
Die Funktion process_symbol übernimmt die zentrale Verarbeitung für jeden Thread. Sie kapselt den gesamten Lebenszyklus eines einzelnen Finanzinstruments: von der Erfassung historischer Daten bis hin zum endlosen Zyklus des Echtzeithandels.
def process_symbol(symbol: str) -> None:
    global all_symbols_done
    try:
        raw_data = retrieve_data(symbol)
        if raw_data is None:
            log(f"Data not found for symbol {symbol}")
            return

        labeled_data_engineered = process_data(raw_data)
        train_data = labeled_data_engineered[labeled_data_engineered.index <= FORWARD]
        test_data = labeled_data_engineered[labeled_data_engineered.index > FORWARD]

        if train_data.empty or len(train_data['labels'].unique()) < 2:
            log(f"Skipping symbol {symbol}: Insufficient data or single class in labels")
            return

        xgb_clf = train_xgboost_classifier(train_data, num_boost_rounds=1000)
        test_features = test_data.drop(['label', 'labels'], axis=1)
        test_labels = test_data['labels']
        accuracy = evaluate_xgboost_classifier(xgb_clf, test_features, test_labels)
        log(f"Accuracy for symbol {symbol}: {accuracy * 100:.2f}%")
Die zeitbasierte Aufteilung von Daten in Trainings- und Testdatensätze ist im Finanzwesen von entscheidender Bedeutung. Die Grenze FORWARD = datetime(2025, 1, 1) bedeutet, dass das Modell anhand von Daten vor 2025 trainiert und anhand von Daten nach diesem Stichtag getestet wird. Dies simuliert reale Bedingungen, unter denen das Modell die Zukunft auf der Grundlage der Vergangenheit vorhersagen muss.
Die Prüfung len(train_data['labels'].unique()) < 2 verhindert Versuche, das Modell mit Daten einer einzigen Klasse zu trainieren. In Phasen geringer Volatilität können alle Beispiele mit dem Label „kein Signal“ versehen werden, was das Lernen unmöglich macht.
Der unendliche Handelszyklus beginnt, nachdem das Modell erfolgreich trainiert wurde:
features = test_features.values
        position_id = None
        while not all_symbols_done:
            position_id = online_trading(symbol, features, xgb_clf)
            time.sleep(6)

        all_symbols_done = True
    except Exception as e:
        log(f"Error processing symbol {symbol}: {e}")
Die globale Variable all_symbols_done dient als Mechanismus für das geordnete Beenden aller Threads. Jeder Thread kann dieses Flag auf True setzen und damit den anderen Threads signalisieren, sich zu beenden. Dies kann verschiedene Ursachen haben: einen schwerwiegenden Fehler, das Erreichen des täglichen Verlustlimits oder einen Benutzerbefehl.
Das Intervall „time.sleep(6)“ zwischen den Handelszyklen wurde als Kompromiss zwischen Reaktionsgeschwindigkeit und Systemauslastung gewählt. Zu kurze Intervalle belasten die Broker-API übermäßig und können zu einer Sperrung führen, während bei zu langen Intervallen Handelsmöglichkeiten verpasst werden können.
Die Hauptfunktion koordiniert die Erstellung und Beendigung von Threads:
if __name__ == "__main__":
    symbols = ["EURUSD", "GBPUSD", "AUDUSD", "NZDUSD", "USDCAD"]

    # First, we calculate the position sizes for the entire portfolio
    calculate_portfolio_position_sizes(symbols)

    threads = []
    for symbol in symbols:
        thread = threading.Thread(target=process_symbol, args=(symbol,))
        thread.start()
        threads.append(thread)

    for thread in threads:
        thread.join()

    log_queue.put(None)
Durch den Aufruf von calculate_portfolio_position_sizes(symbols) vor dem Start der Threads wird sichergestellt, dass alle Positionsgrößen berechnet wurden und in POSITION_SIZES verfügbar sind, bevor der Handel beginnt. Dadurch werden Situationen verhindert, in denen ein Thread versucht, mit einer undefinierten Positionsgröße zu handeln.
Der Aufruf der Methode thread.join() für jeden Thread stellt sicher, dass das Programm geordnet beendet wird. Der Hauptthread wartet, bis alle untergeordneten Threads beendet sind, bevor er sich selbst beendet. Der abschließende Aufruf von log_queue.put(None) weist den Protokollierungs-Thread an, den Betrieb zu beenden.
Die Auswahl der konkreten Währungspaare ["EURUSD", "GBPUSD", "AUDUSD", "NZDUSD", "USDCAD"] ist nicht zufällig. Alle Währungspaare enthalten den US-Dollar entweder als Basis- oder als Kurswährung, was zwar eine gewisse Korrelation mit sich bringt, aber dennoch genügend Vielfalt bietet, um das Risiko zu streuen.
Die Architektur bietet eine elegante Lösung für ein klassisches Problem der nebenläufigen Programmierung: Wie lässt sich die Unabhängigkeit der Threads gewährleisten, wenn zugleich eine Koordination erforderlich ist? Die globalen Variablen POSITION_SIZES, SYMBOL_TRADES und all_symbols_done dienen als Kommunikationskanäle zwischen Threads, und das warteschlangenbasierte Protokollierungssystem verhindert Konflikte, wenn Nachrichten gleichzeitig geschrieben werden.
Die Ausnahmebehandlung in jedem Thread ist von entscheidender Bedeutung. Eine unbehandelte Ausnahme in einem Thread sollte nicht dazu führen, dass das gesamte System abstürzt. Jeder Thread „beendet sich geordnet“, indem er den Fehler protokolliert und seine Ausführung sauber abschließt.
Systemtests und ehrgeizige Entwicklungspläne
Die vorliegende Funktion „test_model“ veranschaulicht einen grundlegenden Ansatz zur Validierung von Handelsstrategien durch die Simulation von Gewinn und Verlust anhand historischer Daten unter Berücksichtigung von Aufschlägen und Ausstiegszeiträumen:
def test_model(
    model: Any,
    X_test: pd.DataFrame,
    y_test: pd.Series,
    markup: float,
    initial_balance: float = 10000.0,
    point_cost: float = 0.00001
) -> None:
    balance = initial_balance
    trades = 0
    profits = []

    predicted_labels = model.predict(X_test.values)
    close = X_test['close'].values

    for i in range(len(predicted_labels) - 10):
        entry_price = close[i]
        exit_price = close[i + 10]
        # Detailed trading logic taking into account direction and markup
        ...
    total_profit = balance - initial_balance
    log(f"Total accumulated profit or loss: {total_profit:.2f}")
Aber das ist erst der Anfang. Die wahre Zukunft des Systems liegt in einer radikalen Skalierung und dem Übergang auf eine qualitativ neue Ebene.
Bislang liegt die Genauigkeit des Systems auf dem Testabschnitt bei etwa 64–65 %, wobei der durchschnittliche Gewinn deutlich höher ist als der durchschnittliche Verlust.
Das haben wir in wenigen Handelstagen erreicht:
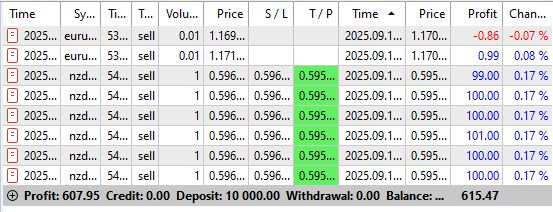
Auch die Rentabilitätssimulationen bei einer vorgegebenen Gewinnquote und einem vorgegebenen Risiko – sowohl für ein Portfolio aus Positionen als auch für eine einzelne Position – sind sehr vielversprechend:
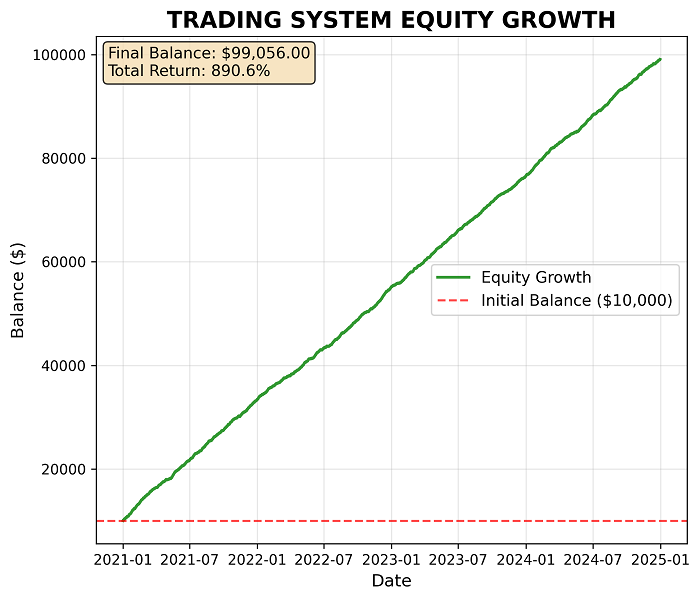
Allerdings habe ich kein großes Vertrauen in selbst entwickelte Python-Testprogramme, daher werde ich das System entweder im Echtgeldhandel ausgiebig testen müssen oder die Logik in MQL5 umschreiben, um Zugang zu einem leistungsstarken Strategietester mit einer echten Tick-Datenbank und einer Requote-Emulation zu erhalten.
Vollständige Portierung auf MQL5: eine architektonische Revolution
Die Python-MetaTrader-5-Hybridarchitektur weist grundlegende Geschwindigkeitsbeschränkungen auf. Für eine vollständige Portierung auf MQL5 müssen wir eigene Bibliotheken für maschinelles Lernen erstellen. Zu den wichtigsten Modulen zählen hochleistungsfähige Matrixoperationen für XGBoost, eine Implementierung von Gradient Boosting mit nativer Optimierung für die x64-Architektur sowie eine angepasste Version von gaußschen Mischmodellen für das Merkmalsclustering. Dies ist eine technisch anspruchsvolle Aufgabe, wird jedoch jegliche API-Latenz beseitigen und eine 10- bis 50-fache Leistungssteigerung bewirken.
Grafische Benutzeroberfläche der nächsten GenerationEs ist geplant, ein vollwertiges Echtzeit-GUI-System mit modularer Architektur zu entwickeln. Das Dashboard zeigt die aktuellen Positionen aller Finanzinstrumente, Gewinn und Verlust in Echtzeit, die Auslastung der Risikolimits sowie den Status jedes Handels-Threads an. Ein entscheidender Bestandteil wird das Modul zur dynamischen Parameterverwaltung sein – die Möglichkeit, TOTAL_PORTFOLIO_RISK, Modellschwellenwerte und Zeithorizonte zu ändern, ohne das System neu starten zu müssen. Das Warnsystem umfasst Benachrichtigungen über die Überschreitung der täglichen Verlustlimits, ungewöhnliche Modellsignale und den Verlust der Verbindung zum Broker.
Ein übergeordneter Risikomanager: ein Quantensprung im PortfoliomanagementDas derzeitige Risikomanagementsystem wirkt im Vergleich zu dem geplanten System recht primitiv. Der neue Risikomanager wird die Korrelationen zwischen den Finanzinstrumenten in Echtzeit analysieren und dabei rollierende Zeitfenster unterschiedlicher Länge verwenden. Value-at-Risk-Berechnungen auf der Grundlage von Monte-Carlo-Simulationen prognostizieren potenzielle Portfolioverluste mit unterschiedlichen Wahrscheinlichkeitsniveaus. Das dynamische Hedging-System eröffnet automatisch Gegenpositionen, sobald die Grenzwerte für Korrelationsrisiken überschritten werden.
Multithread-Training: eine ganze Armee von ModellenDer Übergang zum massiv parallelen Modelltraining wird revolutionär sein. Jeder CPU-Thread testet verschiedene Kombinationen aus XGBoost-Hyperparametern, Trainingsperioden und Merkmalsmengen. Das System wählt für jeden Zeitraum automatisch das beste Modell auf der Grundlage von Out-of-Sample-Ergebnissen aus. Ein Ensemble aus einem Zufallswald, einer SVM, neuronalen Netzen und LightGBM wird ein Metamodell bilden, das jede einzelne Implementierung übertrifft.
GAN zur Generierung von 25-Jahres-Datensätzen: Synthetische MarkthistorieDas ehrgeizigste Vorhaben besteht darin, mithilfe generativer adversarialer Netzwerke synthetische Kursreihen der wichtigsten Währungspaare über einen Zeitraum von 25 Jahren zu erstellen. Das GAN wird anhand realer historischer Daten trainiert und generiert anschließend riesige Datensätze, die die statistischen Eigenschaften realer Märkte bewahren: Volatilitätsclustering, Verteilungen mit schweren Verteilungsschwänzen und Autokorrelationen. Damit wird das Problem des Datenmangels für Deep Learning gelöst.
Ein Ensemble aus 100 spezialisierten Modellen: Segmentierung des Zeit-Preis-RaumsDen Höhepunkt bildet die Erstellung eines Ensembles aus 100 Modellen, von denen jedes für einen eigenen „Bereich“ der Marktbedingungen zuständig ist. Jedes Modell wird anhand von Daten aus einem bestimmten Marktregime trainiert: hohe Volatilität, Seitwärtsbewegung, starke Trends, Nachrichtenphasen oder Handelssitzungen vor Feiertagen. Solche Marktregime lassen sich beispielsweise durch Merkmalsclustering, Markov-Ketten oder SSM-basierte Ansätze identifizieren. Der „BaggingClassifier“ sorgt für jedes Modell für zusätzliche Stabilität. Der Meta-Klassifikator ermittelt das aktuelle Marktregime mit extrem hoher Genauigkeit und aktiviert die entsprechenden Spezialmodelle. Diese Architektur ermöglicht eine beispiellose Prognosegenauigkeit und passt sich in Echtzeit an alle Marktbedingungen an.
Integration in die Google Cloud Platform: Die Rechenleistung von Supercomputern mit 1.000 KernenLokale Rechenressourcen werden bei der Umsetzung solch ehrgeiziger Pläne zum Engpass. Die Google Cloud Platform bietet die Lösung durch eine direkte Integration über eine Python-API. Die Bibliothek „google-cloud-compute“ ermöglicht die programmgesteuerte Erstellung virtueller Maschinen mit Hunderten CPU-Kernen und mehreren Terabyte Arbeitsspeicher für das parallele Modelltraining.
from google.cloud import compute_v1
from google.cloud import storage

# Creating a high-performance cluster
instance_client = compute_v1.InstancesClient()
operation = instance_client.insert(
    project="trading-ai-project",
    zone="us-central1-a",
    instance_resource={
        "name": "trading-cluster-node",
        "machine_type": "zones/us-central1-a/machineTypes/c2-standard-60",
        "scheduling": {"preemptible": True}  # Cost reduction by 5 times
    }
)
AI Platform Training ermöglicht das verteilte Training von XGBoost und neuronalen Netzen auf Dutzenden Rechnern gleichzeitig. Cloud Storage bietet sofortigen Zugriff auf Petabytes an historischen Daten. BigQuery ML lässt sich direkt in Handelsalgorithmen integrieren, um Muster in Echtzeit zu analysieren.
Ein entscheidender Vorteil ist die automatische Skalierung der Rechenressourcen. Während der Modell-Neutrainingsphasen startet das System automatisch Hunderte Instanzen, und in ruhigen Phasen reduziert es deren Anzahl auf ein Minimum, wodurch die Kosten optimiert werden. Unterbrechbare (preemptible) Instanzen senken die Rechenkosten um den Faktor 5 und machen so das Training unserer zukünftigen, hochkomplexen Modelle wirtschaftlich realisierbar.
Fazit
In diesem Artikel haben wir die ersten Schritte zur Entwicklung eines Handelsroboters mit Multithreading unter Verwendung von Methoden des maschinellen Lernens unternommen. Die betrachtete Architektur deckt den gesamten Prozess ab – von der Datenerfassung und Datenaugmentation über die Merkmalsgenerierung und das Clustering bis hin zum Training von XGBoost-Modellen und zur Integration des Portfoliorisikomanagements. Wir haben gesehen, wie wir durch die Aufgabenteilung zwischen Python und MetaTrader 5 das Beste aus beiden Welten nutzen können: die Flexibilität und das umfangreiche Ökosystem der Python-Bibliotheken für maschinelles Lernen sowie die Robustheit von MetaTrader 5 für die Handelsausführung in Echtzeit.
Dies ist jedoch nur der erste Teil der Serie. In zukünftigen Veröffentlichungen möchte ich mich mit folgenden Themen befassen: der Portierung des Systems auf MQL5, der Entwicklung einer grafischen Benutzeroberfläche, der Integration in Cloud-Dienste, der Verwendung von GANs zur Generierung synthetischer Datensätze sowie dem Aufbau von Ensembles spezialisierter Modelle. Diese Schritte werden den Einsatzumfang des Handelsroboters erheblich erweitern, seine Effizienz steigern und damit den Weg für seine vollständige Implementierung ebnen.
Übersetzt aus dem Russischen von MetaQuotes Ltd.
Originalartikel: https://www.mql5.com/ru/articles/19577
Warnung: Alle Rechte sind von MetaQuotes Ltd. vorbehalten. Kopieren oder Vervielfältigen untersagt.
Dieser Artikel wurde von einem Nutzer der Website verfasst und gibt dessen persönliche Meinung wieder. MetaQuotes Ltd übernimmt keine Verantwortung für die Richtigkeit der dargestellten Informationen oder für Folgen, die sich aus der Anwendung der beschriebenen Lösungen, Strategien oder Empfehlungen ergeben.


Ein hervorragender Artikel! Vielen Dank für die Veröffentlichung. Ich freue mich schon auf den nächsten!