

Neuronale Netze im Handel: Robuste Handelssignale in jedem Marktregime (ST-Expert)
 4
 0

Einleitung
Die heutigen Finanzmärkte sind ein dynamisches Ökosystem, in dem Millionen von Transaktionen, regulatorische Entscheidungen, Unternehmensberichte und makroökonomische Signale zusammenkommen und ein komplexes Muster bilden. Für einen Händler oder Analysten besteht die wichtigste Aufgabe darin, Regelmäßigkeiten in diesem Muster zu erkennen und diese zur Erstellung einer Prognose zu nutzen. Doch genau hier liegt der Hauptwiderspruch: Der Markt verändert sich schneller, als sich traditionelle Modelle anpassen können. Was gestern noch funktioniert hat, könnte sich morgen nicht nur als nutzlos, sondern sogar als gefährlich erweisen.
Wir sind es gewohnt, in Korrelationen zu denken. Es besteht ein stabiler Zusammenhang zwischen dem Ölpreis und dem Wechselkurs des kanadischen Dollars, zwischen den Zinssätzen der Fed und dem Technologiesektor sowie zwischen der Nachfrage nach Gold und den Kursschwankungen des Dollars. Sobald sich jedoch die äußeren Bedingungen ändern, brechen diese Abhängigkeiten zusammen. Während des durch COVID-19 ausgelösten Börsencrashs im Jahr 2020 spiegelten die üblichen Korrelationen zwischen Aktien, Anleihen und Rohstoffen innerhalb weniger Wochen nicht mehr die Realität wider. Selbst geringfügigere Regimewechsel, wie etwa Zyklen von Zinserhöhungen und -senkungen durch die Federal Reserve, können Korrelationen drastisch verändern und Modelle untergraben, die einst als zuverlässig galten.
Der Kern des Problems besteht darin, dass moderne Algorithmen anhand relativ kurzer und homogener Datenintervalle trainiert werden. Unter diesen Laborbedingungen liefern sie beeindruckende Ergebnisse, indem sie subtile Korrelationen zwischen Vermögenswerten erkennen. Sobald der Markt jedoch von seiner üblichen statistischen Verteilung abweicht, sinkt die Genauigkeit der Prognosen drastisch. Im Grunde funktionieren die Modelle in ruhigen Phasen einwandfrei, sind jedoch nicht in der Lage, Phasenübergänge am Markt zu bewältigen.
Diese Situation erinnert in vielerlei Hinsicht an städtische Verkehrsnetze – ein Beispiel, anhand dessen die Autoren der Arbeit „Robust Traffic Forecasting against Spatial Shift over Years“ (Robuste Verkehrsprognosen trotz räumlicher Verschiebungen über Jahre hinweg) ein neues Framework namens ST-Expert vorschlagen. Solange sich die Stadt nicht verändert, funktionieren die Verkehrsprognosen einwandfrei. Doch sobald eine neue Anschlussstelle gebaut wird oder ein großes Einkaufszentrum eröffnet, sind die alten Routen überholt. Im Finanzbereich sind diese Einflussfaktoren regulatorische Entscheidungen, Sanktionen, geopolitische Konflikte oder das Aufkommen neuer Technologien. Das Gefüge der Beziehungen verändert sich, und alte Modelle erweisen sich als unwirksam.
Um diese Herausforderung zu bewältigen, schlagen die Autoren von ST-Expert eine originelle Lösung vor, die auf dem Ansatz Mixture of Experts (MoE) basiert. Der Kerngedanke besteht darin, dass das Modell nicht anhand einer einzigen starren Struktur von Abhängigkeiten lernt, sondern anhand einer Reihe von Graphgeneratoren, die als „Graphons“ bezeichnet werden. Jedes davon spiegelt eine bestimmte Art von Marktverhalten wider. Das eine identifiziert Muster bei einem anhaltenden Trend, das andere beschreibt eine Phase hoher Volatilität und das dritte erkennt lokale Korrelationen innerhalb von Branchen. Wenn sich der Markt verändert, bricht das System nicht zusammen, sondern kombiniert auf adaptive Weise zuvor erlernte Szenarien, schafft neue Verbindungen zwischen den Instrumenten und gewährleistet so weiterhin die Prognosegenauigkeit.
Genau hier zeigt sich der erste – und vielleicht wichtigste – Vorteil dieses Ansatzes: seine Fähigkeit, sich an veränderte Marktbedingungen anzupassen. Während Standardmodelle in einer bestimmten historischen Periode verhaftet bleiben, betrachtet das neue Framework den Markt als ein Mosaik, in dem jedes Marktregime lediglich ein vorübergehendes Fragment des Ganzen darstellt. Dadurch kann der Algorithmus aus bereits erlernten Elementen eine neue Kombination zusammenstellen und eine genaue Prognose liefern, wo andere Systeme an Robustheit verlieren. Für einen Trader bedeutet dies weniger Fehlsignale in Zeiten von Marktturbulenzen und eine höhere Zuverlässigkeit bei der Entwicklung langfristiger Strategien.
Aber Anpassungsfähigkeit ist nur ein Aspekt. Ein weiterer wesentlicher Vorteil ist die Vielseitigkeit der Architektur. Die Schicht der Experten-Graphons lässt sich problemlos in bestehende Lösungen integrieren. Sie lässt sich sowohl in graphneuronale Netze integrieren, die Netzwerkbeziehungen zwischen Vermögenswerten analysieren, als auch in Transformer, die mit Zeitreihen von Kursnotierungen arbeiten. Dadurch ist dieser Ansatz für Praktiker besonders wertvoll. Er erfordert keine radikale Umgestaltung der Infrastruktur und kann bereits etablierte Systeme verbessern.
Ein weiterer Vorteil liegt in seiner Robustheit gegenüber sogenannten Regimewechseln. Die Geschichte der Finanzmärkte zeigt deutlich, dass Beständigkeit selten ist, während Wandel die Regel ist. Jedes Jahrzehnt bringt eine neue Krise mit sich, und jede Phase innerhalb einer Krise geht mit einer Kette unvorhersehbarer Schocks einher. Der Versuch, zeitlose Invarianten zu finden, erweist sich als Illusion. Das neue Framework trägt dem ständigen Wandel der Märkte offen Rechnung und bezieht seine Stärke gerade aus seiner Fähigkeit, zwischen verschiedenen Szenarien zu wechseln. Dies ist besonders wichtig für Stresstests und Langzeitprognosen, bei denen die Kosten von Fehlern extrem hoch sind.
Gleichzeitig bleibt der Ansatz kompakt und effizient. In Finanzanwendungen ist Zeit ein entscheidender Faktor. Handelsentscheidungen müssen innerhalb von Millisekunden getroffen werden. Daher dürfen Modelle, egal wie genau sie auch sein mögen, keinen übermäßigen Rechenaufwand verursachen. Das vorgeschlagene Framework berücksichtigt diesen Faktor. Dies sorgt für mehr Flexibilität und Robustheit, ohne dass die Rechenkosten dabei stark ansteigen. Daher kann es in Echtzeitsystemen eingesetzt werden – vom algorithmischen Handel bis zum Risikomanagement.
Abschließend sei noch auf die Flexibilität hinsichtlich der Erweiterbarkeit hingewiesen. Experten-Graphons sind nicht auf einen bestimmten Markt oder eine bestimmte Anlageklasse beschränkt. Sie können an den Aktien-, Anleihen-, Devisen- und Kryptowährungsmärkten eingesetzt werden. Darüber hinaus können sie verschiedene Arten von Daten integrieren – von Marktnotierungen und Nachrichtenfeeds bis hin zu makroökonomischen Indikatoren. Dies ebnet den Weg für die Entwicklung wirklich umfassender Modelle, die der Vielschichtigkeit von Finanzsystemen Rechnung tragen.
Dies ist eine grundlegend neue Sichtweise auf das Wesen der Modellierung unter Unsicherheit. Während traditionelle Modelle beharrlich nach bestimmten zeitlosen Mustern suchen, bringt ST-Expert dem System bei, sich an eine sich wandelnde Welt anzupassen. Dadurch wird die Prognose zu einem dynamischen Prozess, der unerwartete Veränderungen berücksichtigen und sich in Echtzeit anpassen kann.
ST-Expert-Algorithmus
Um ein zuverlässiges Prognosemodell für Finanzmärkte zu entwickeln, muss man in der Lage sein, zwischen verschiedenen Marktregimen zu unterscheiden und diese zu berücksichtigen. In Wirklichkeit ist die Struktur der Korrelationen zwischen den Vermögenswerten alles andere als statisch. Was gestern noch wie eine robuste Regel erschien, könnte sich morgen als bloßer Zufall herausstellen. In Wachstumsphasen des Technologiesektors sind die Zusammenhänge zwischen den Aktien von IT-Unternehmen und den Zinssätzen zwar möglicherweise minimal, treten jedoch bei den ersten Anzeichen einer Überhitzung deutlich in den Vordergrund. Auf den Rohstoffmärkten ist die Korrelation zwischen den Ölpreisen und den Währungen der Exportländer in Krisenzeiten besonders ausgeprägt, kann danach aber praktisch verschwinden. Es liegt auf der Hand, dass ein Modell, das versucht, diese ganze Vielfalt auf eine einzige feste Beziehungsmatrix zu reduzieren, zwangsläufig an Genauigkeit einbüßt.
Genau aus diesem Grund schlagen die Autoren einen Ansatz vor, der darauf basiert, charakteristische Zeitabschnitte zu identifizieren, in denen sich der Markt relativ einheitlich verhält. Die Idee ist einfach. Wenn wir alle historischen Daten als einen einzigen Datensatz behandeln, gehen wichtige Marktregime unter, und kein Experte wird in der Lage sein, sie korrekt zu erlernen. Wenn wir die historischen Daten jedoch in Zeiträume unterteilen, von denen jeder seine eigene robuste Korrelationsstruktur aufweist, lässt sich für jeden dieser Zeiträume ein spezialisierter Experte erstellen. Anschließend wird das Modell diese Experten zusammenführen und so eine flexible Darstellung des Marktumfelds erstellen.
Formal führt dies zum Problem der maximalen räumlich-zeitlichen Graphaufteilung (MSGD). Die gesamte Zeitreihe (bezeichnet als T) wird in K sich nicht überschneidende Intervalle unterteilt. Jedes Intervall Tk umfasst die Paare (Xt, Yt) für t ∈ [tk, tk+1). Es ist wichtig zu beachten, dass innerhalb eines solchen Intervalls die Marktbeziehungen durch dieselbe Struktur Rk beschrieben werden, während sich diese Strukturen zwischen den Intervallen unterscheiden.
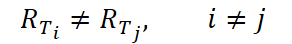
Im Grunde bedeutet dies, dass sich die morgendlichen Börsensitzungen untereinander ähneln können, auch wenn sie an verschiedenen Tagen stattfinden. Die Aktivitäten der Privatanleger führen zu einer bestimmten Art von Korrelation, während sich in den Abendstunden, wenn institutionelle Anleger in den Markt einsteigen, ein völlig anderes Muster von Zusammenhängen abzeichnet. Die Idee hinter MSGD besteht darin, die Daten genau so aufzuteilen, dass der Unterschied zwischen den identifizierten Intervallen maximiert wird.
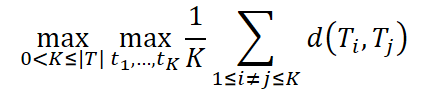
Unter den folgenden Bedingungen
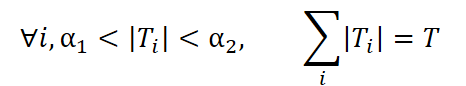
Als Maß für die Unähnlichkeit d(•,•) schlagen die Autoren des Frameworks vor, Kendalls Tau-Koeffizienten τ zu verwenden, der widerspiegelt, inwieweit sich die Korrelationsstrukturen zwischen den Zeiträumen unterscheiden. Die Nebenbedingungen α1 und α2 legen die minimal und maximal zulässigen Intervalllängen fest, und T ist die Gesamtdauer der Reihe.
Somit läuft die Aufgabe darauf hinaus, die historischen Daten in Teile aufzuteilen, die sich hinsichtlich der Art ihrer Abhängigkeiten am stärksten voneinander unterscheiden. Mit anderen Worten: Wir suchen nach reinen Marktregimen: einer Aufwärtstrendphase, einer Seitwärtsphase und einer Phase hoher Volatilität. Dieser Ansatz ähnelt der Erstellung thematischer Indizes. Jeder Index fasst Wertpapiere einer bestimmten Art zusammen und bildet deren Wertentwicklung ab, ohne diese mit der anderer Marktsegmente zu vermischen.
Dieses Problem zu lösen, ist natürlich nicht einfach. Da sich dies nicht analytisch ausdrücken lässt, greifen die Autoren des Frameworks auf dynamische Programmierung zurück. Dadurch lassen sich sowohl die Anzahl der Intervalle K als auch deren Grenzen effizient bestimmen, selbst bei großen Datenmengen.
Sobald die Zeiträume festgelegt sind, stellt sich die Frage: Wie genau sollten wir die Struktur der Beziehungen innerhalb der einzelnen Zeiträume definieren? Zu diesem Zweck wird das Konzept eines „Graphons“ – eines probabilistischen Graphgenerators – eingeführt. Im Gegensatz zu einer festen Adjazenzmatrix wird das Graphon hier durch eine Wahrscheinlichkeitsmatrix P definiert, wobei das Element P(i,j) die Wahrscheinlichkeit einer Verbindung zwischen den Vermögenswerten i und j darstellt. Ein Graphon legt also das Vorhandensein von Kanten nicht eindeutig fest, sondern beschreibt vielmehr deren Wahrscheinlichkeitsverteilung. Dies entspricht viel eher der Realität des Finanzmarktes, auf dem Beziehungen stochastischer Natur sind.
Um für jeden Experten ein Graphon zu erstellen, werden trainierbare Einbettungsmatrizen Egk ∈ R|V|*d und eine dynamische Einbettungsschicht Et ∈ R|V|*d, die von den aktuellen Marktdaten abhängt, verwendet. In diesem Fall wird die Wahrscheinlichkeitsmatrix für den k-ten Experten anhand der folgenden Formel berechnet:
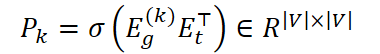
wobei σ eine Sigmoid-Funktion ist, die alle Werte auf den Bereich (0, 1) abbildet.
Um aus dieser Wahrscheinlichkeitsmatrix einen konkreten Graphen zu erhalten, wird eine Reparametrisierung unter Verwendung von Gumbel-SoftMax durchgeführt.
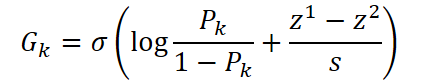
wobei z1 und z2 aus einer Gumbel(0,1)-Verteilung gezogen werden und s der Temperaturparameter ist.
Im Wesentlichen ermöglicht uns diese Technik, konkrete Beziehungen durch Zufallsziehung zu bestimmen, dabei eine strikte Binarisierung zu vermeiden und gleichzeitig den Einfluss schwacher, verrauschter Korrelationen zu minimieren, die auf den Finanzmärkten häufig vorkommen.
Im Ergebnis erhält jeder Experte einen eigenen Graphgenerator, der eine einzigartige Art des Marktverhaltens widerspiegelt. Manche Graphons neigen dazu, dichte Cluster zu bilden – beispielsweise innerhalb bestimmter Branchen. Andere werden weniger dichte Verbindungen aufbauen, wie sie für globale Korrelationen zwischen Anlageklassen typisch sind. Zusammen bilden sie ein ganzes Ensemble von Experten, das neue Marktregime beschreiben und kombinieren kann, selbst wenn diese zuvor noch nicht aufgetreten sind.
Die Erstellung der Experten ist jedoch nur der erste Schritt. Entscheidend ist, sie unter wechselnden Bedingungen zu trainieren. In der Praxis unterliegen Marktabhängigkeiten ständigen Veränderungen. Korrelationsstrukturen zwischen Vermögenswerten entstehen und lösen sich unter dem Einfluss einer Vielzahl von Faktoren auf. Entscheidungen der Zentralbanken verändern das Verhalten von Währungen und Anleihen. Änderungen in der Steuerpolitik oder der Regulierung gestalten die sektoralen Verflechtungen neu. Krisen oder technologische Umbrüche bringen ihre eigenen drastischen Anpassungen mit sich. Für ein Modell, das auf einem relativ stabilen Datensatz trainiert wurde, stellen solche Änderungen ein ernstes Problem dar. Sein Marktbild entspricht plötzlich nicht mehr der Realität.
Um das System auf diese Art von Unsicherheit vorzubereiten, schlagen die Autoren des Frameworks vor, episodisches Lernen einzusetzen. Das Wesentliche an diesem Ansatz ist die Aufteilung der Aufgaben der Experten. Wenn eine Beobachtung xi ∈ Ti als Eingabe eingeht, übernimmt nur das diesem Zeitintervall zugeordnete Graphon Pi die Hauptaufgabe der Prognose. Es wird zur Erstellung des Graphen Gi ⁓ Pi verwendet, der anschließend in das ST-GNN-Modul eingespeist wird, um eine Prognose zu erstellen.
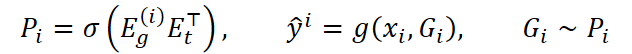
Somit wird der jeweils zugehörige Experte über die Hauptverlustfunktion trainiert, die für die Prognosegenauigkeit verantwortlich ist.
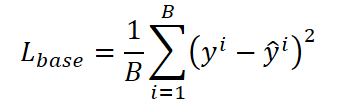
Doch damit ist der Trainingsprozess noch nicht abgeschlossen. Die übrigen Experten {Pk}Kk=1,k≠i spielen, obwohl sie in diesem Fall nicht für direkte Prognosen herangezogen werden, eine wichtige unterstützende Rolle. Sie werden verwendet, um eine Graphonmischung Pimix(x) zu bilden, die die Struktur des Referenzgraphons Pi so genau wie möglich nachbilden soll.
Zu diesem Zweck wird ein Gating-Netzwerk eingeführt, das aus dem Eingangssignal xi einen Gewichtsvektor berechnet.
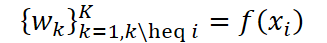
Diese Gewichte bestimmen die Anteile, zu denen die anderen Experten kombiniert werden.
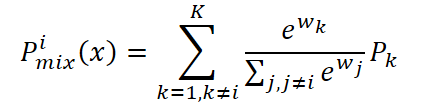
Anschließend wird die resultierende Graphonmischung mit dem Referenzgraphon Pi verglichen.
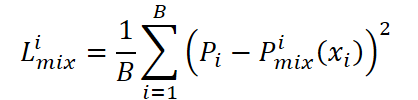
Es ist wichtig zu beachten, dass Lmix lediglich die Mischungsgewichte w aktualisiert, ohne die Parameter der Graphons selbst zu beeinflussen. Dadurch behalten die Experten ihre Unabhängigkeit und spezialisieren sich weiterhin auf ihre jeweiligen Marktregime, während der Gewichtsvektor lernt, diese korrekt zu kombinieren, um die Eigenschaften des Referenzgraphons nachzubilden.
Somit wird das Lernen in zwei parallele Prozesse unterteilt. Jeder Experte verfeinert seine Prognosefähigkeit speziell innerhalb seines eigenen Marktregimes, ohne die anderen zu beeinflussen, während das Gating-Netzwerk anhand einer Imitationsaufgabe trainiert wird. Es muss lernen, das Wissen der anderen Experten so zu bündeln, dass sie gemeinsam die Struktur der aktuellen Referenz nachbilden. Diese Rollenverteilung macht das Modell sowohl hochspezialisiert als auch flexibel, sodass es sich an neue Marktbedingungen anpassen kann.
Dies lässt sich mit der Arbeit eines Analystenteams vergleichen. Jeder von ihnen hat sein eigenes Fachgebiet. Der eine kennt sich besser mit Rohstoffanlagen aus, ein anderer ist auf Devisenmärkte spezialisiert und ein dritter auf Anleihen. Wenn eine neue Situation eintritt, wird die Prognose von dem Analysten erstellt, dessen Fachgebiet am relevantesten ist. In diesem Moment übernehmen die anderen eine unterstützende Rolle. Sie helfen dem Team dabei, besser einzuschätzen, inwieweit ihre gemeinsamen Perspektiven die wichtigsten Erkenntnisse des führenden Experten nachbilden können.
Nach dem Training, wenn das Modell mit realen Marktdaten konfrontiert wird, befindet es sich zum ersten Mal in einer Situation völliger Ungewissheit. Hatte es während des Trainings stets Zugriff auf das richtige Graphon Pi, das dem jeweiligen Zeitintervall zugeordnet war, so verfügt es nun nicht mehr über einen solchen Anhaltspunkt. Dies entspricht der natürlichen Situation im Handel. Ein Trader kann sich zwar auf historische Muster stützen, kann aber niemals im Voraus genau wissen, in welcher Phase des Zyklus sich der Markt gerade befindet.
Der erste Schritt in der Inferenzphase besteht darin, dass alle Experten gleichzeitig eine Reihe von probabilistischen Graphons generieren. Jeder von ihnen entwickelt seine eigene Interpretation der Struktur der Beziehungen zwischen den Vermögenswerten. Im Grunde genommen stellt jeder Experte seine eigene Markthypothese auf. Einige Experten identifizieren klar definierte sektorale Cluster, während andere globale Korrelationen zwischen Währungen und Rohstoffanlagen erfassen und wieder andere instabile, aber aussagekräftige lokale Wechselbeziehungen erkennen.
Der nächste Schritt besteht darin, den Gewichtsvektor auf der Grundlage des aktuellen Marktsignals xtest zu berechnen.
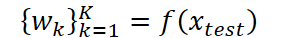
Diese Gewichte spiegeln die momentane Bedeutung jedes einzelnen Experten wider. Man könnte sagen, dass das Gating-Netzwerk als Schiedsrichter fungiert, der die Bedeutung der Meinung jedes Experten in diesem bestimmten Moment bestimmt. Kommt es beispielsweise am Markt zu einem starken Anstieg der Volatilität bei Rohstoffanlagen, erhalten Experten, die anhand entsprechender Szenarien trainiert wurden, ein höheres Gewicht.
Nachdem die Gewichte berechnet wurden, wird ein abschließendes gemischtes Graphon erstellt, das einen aggregierten Überblick über die Marktbeziehungen bietet.
Der wesentliche Unterschied zwischen der Inferenzphase und der Trainingsphase besteht darin, dass nun alle Experten gleichzeitig in den Prozess eingebunden sind. Während das System früher wusste, welcher Experte der richtige war, und die anderen nur zur Nachahmung heranzog, muss es sich nun auf eine kollektive Bewertung verlassen. Dieser Punkt ist von grundlegender Bedeutung. Der reale Markt bietet keine vorgefertigten Referenzstandards, und das Modell muss in der Lage sein, aus dem gesammelten Wissen eine neue Darstellung zu synthetisieren.
In der letzten Phase wird aus der resultierenden Wahrscheinlichkeitsmatrix ein konkreter Graph gezogen, der die aktuelle Verteilung der Beziehungen zwischen den Vermögenswerten widerspiegelt. Dieser Graph wird im ST-GNN-Modul zur Erstellung einer Prognose verwendet. Hier erstellt das System im Wesentlichen eine Prognose der Marktdynamik, die nicht auf einer starr festgelegten Struktur basiert, sondern auf einer flexibel gestalteten Darstellung, die gemeinsam von allen Experten erarbeitet wird.
Das Ergebnis ist ein Modell, das sich in der Inferenzphase wie ein erfahrener Portfoliomanager verhält. Es stützt sich nicht auf eine einzige Informationsquelle, sondern vergleicht und kombiniert verschiedene Perspektiven, um ein dynamisches Marktbild zu erstellen. Dieser Ansatz macht das Modell robust, flexibel und in der Lage, die Prognosegenauigkeit auch dann aufrechtzuerhalten, wenn bekannte Marktmuster unter dem Druck neuer Ereignisse zusammenbrechen.
Ein weiterer wesentlicher Vorteil des vorgeschlagenen Ansatzes liegt in der Vielseitigkeit der trainierbaren Graphons. Obwohl sie in der obigen Beschreibung in Verbindung mit räumlich-zeitlichen graphneuronalen Netzen (ST-GNNs) verwendet werden, ist ihr Potenzial weitaus größer. Graphons sind an sich ein flexibles Werkzeug zur Beschreibung probabilistischer Beziehungen und können als verbindendes Element für eine Vielzahl von Architekturen dienen.
Insbesondere in Transformer-Modellen kann das Graphon als dynamische Maske oder als generierte Aufmerksamkeitsmatrix fungieren, wobei die Verbindungen zwischen Elementen einer Sequenz nicht durch vordefinierte Regeln, sondern durch eine gelernte probabilistische Struktur bestimmt werden. Dies ebnet den Weg für die Entwicklung anpassungsfähigerer Transformer, die sich verändernde Marktmuster besser erfassen können. Darüber hinaus können Graphons auch in Hybridsystemen eingesetzt werden, die CNNs, RNNs und Aufmerksamkeitsmechanismen kombinieren, wodurch die Leistung jeder dieser Komponenten verbessert wird.
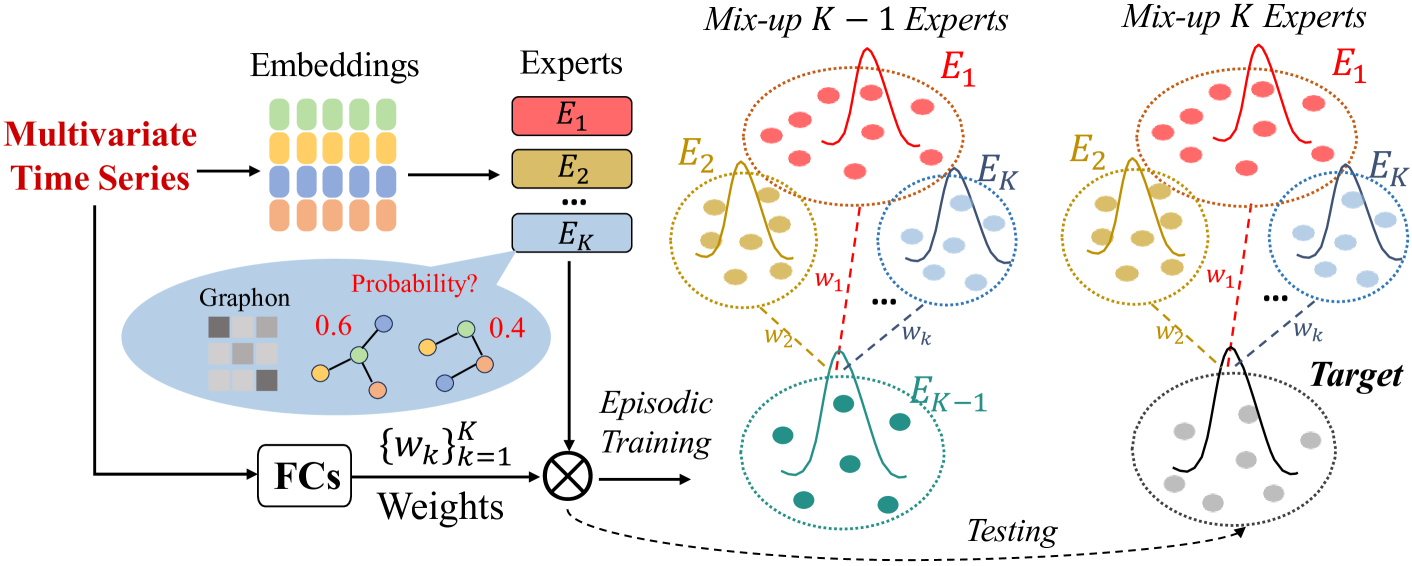
Nachfolgend ist die vom Autor erstellte Darstellung des ST-Expert-Frameworks zu sehen.
Implementierung mit MQL5
Nachdem wir die theoretischen Aspekte des ST-Expert-Frameworks behandelt haben, wenden wir uns nun der praktischen Umsetzung der darin enthaltenen Ansätze mithilfe von MQL5 zu. Und natürlich werden wir unsere Arbeit mit der Konstruktion von Graphons beginnen. Aber lassen Sie uns zunächst die Ansätze besprechen, die wir bei unserer Umsetzung verfolgen.
Zwei Aspekte des von den Autoren des Frameworks vorgeschlagenen Trainingsprozesses machen mich persönlich stutzig. Der erste Aspekt ist die Notwendigkeit, den Trainingsdatensatz vorzuverarbeiten, um bestimmte Marktregime zu identifizieren. Dieser Prozess ist recht arbeitsintensiv, erfordert einen zusätzlichen Optimierungsschritt und stützt sich häufig auf Heuristiken. Unter realen Marktbedingungen könnte sich eine derart strenge Segmentierung nicht nur als ressourcenintensiv, sondern auch als nicht ganz zuverlässig erweisen. Die Grenzen zwischen diesen Marktregimen sind oft verschwommen, und die Regime selbst können sich rasch ändern. Wenn wir die historischen Daten segmentieren und dabei zu starr vorgehen, laufen wir Gefahr, wichtige Übergangsphasen zu verlieren, die doch gerade die Grundlage vieler Marktbewegungen bilden.
Der zweite Punkt betrifft die Logik des Trainings von Graphons und Gewichten an sich. In der ursprünglichen Formulierung wird davon ausgegangen, dass bei Eingabe einer Beobachtung aus dem Intervall Ti der entsprechende Experte Pi die Vorhersage trifft, während die übrigen Experten zu einer Mischung zusammengefasst werden, die dessen Struktur nachbilden soll. Aus formaler Sicht wirkt dieser Ansatz elegant. Jedes Graphon lernt, sein eigenes Marktregime vorherzusagen, während das Gating-Netzwerk lernt, die übrigen Graphons so zu kombinieren, dass sie das Referenzgraphon nachahmen können. In der Praxis wirft dies jedoch ein subtiles Problem auf. Im Grunde legen wir die Rollen der Experten starr fest und schließen ein wechselseitiges Training der Experten aus. Dies birgt die Gefahr einer Überspezialisierung, bei der ein Experte zwar in seiner engen Nische wirklich gute Leistungen erbringt, bei der geringsten Veränderung des Marktkontexts jedoch völlig überfordert ist.
Zudem macht dieser Ansatz das Training der Gewichte von der Korrektheit des Referenzgraphons abhängig. Sollte sich Pi irgendwann als durch Rauschen verfälscht erweisen oder einen atypischen Marktzustand erfassen, wird das Gating-Netzwerk gezwungen sein, es nachzubilden, anstatt ein allgemeineres Muster zu erkennen. Bei Finanzdaten, die mit zufälligen Ausreißern und Scheinkorrelationen übersät sind, kann dies zu einer erheblichen Fehlerquelle werden.
In unserer Umsetzung werden wir versuchen, diese starre Hierarchie aufzulockern. Anstatt jedem Experten dauerhaft ein eigenes Marktregime zuzuweisen, sollten wir zulassen, dass jedes Graphon mit einer Wahrscheinlichkeit zur Prognose beiträgt, die vom aktuellen Marktzustand abhängt. Formal besteht das System aus N Experten, wobei jeder Experte seine eigene Prognose abgibt. Gating ist ein schlankes Netzwerk, das auf der Grundlage von Marktmerkmalen Logits zurückgibt. Um eine episodische Struktur zu erzeugen und zu verhindern, dass ein einzelner Experte die gesamte Aufmerksamkeit auf sich vereint, verwenden wir eine zufällige Dropout-Maske und leiten die Ausgabe durch eine SoftMax-Funktion. Dadurch erhalten wir die Gewichte und die endgültige Prognose des Ensembles. Dieser Ansatz ermöglicht es, die Gewichte nicht nur anhand der Nachahmung der Referenz zu lernen, sondern auch anhand der gemeinsamen Verbesserung der Prognose – wobei die Bedeutung eines Experten davon abhängt, inwieweit sein Beitrag das Ensemble in einem bestimmten Marktzustand verbessert.
Die Verlustfunktion ist als eine Kombination verschiedener Aufgaben aufgebaut. Sie sollte auf einem Maß für die Qualität des Ensembles basieren, zu dem eine gewichtete Summe der individuellen Verluste der Experten hinzugerechnet wird. Dies motiviert die Experten dazu, ihre Prognosen genau dort zu verbessern, wo ihr Beitrag am wichtigsten ist.
Dropout im Gating-Modul verwandelt das Training in einen episodischen Versuch. Bei jedem Batch ändert sich die aktive Gruppe von Experten geringfügig, und das Modell lernt, sich nicht ständig auf einen einzigen zufällig erfolgreichen Experten zu verlassen. Dropout ist während des Trainings aktiviert, während der Inferenz jedoch deaktiviert, wodurch das Wissen aller Experten genutzt werden kann.
Die neue Klasse CNeuronGraphons dient als domänenspezifischer Wrapper für unsere Implementierung eines flexiblen Graphon-Ensembles. Sie kapselt den Gate-Zustand, die Einbettungen der Eingabedaten, die Expertenparameter und die Graphon-Menge selbst – also alles, was benötigt wird, um in jedem Schritt aus einer Menge von Expertenstimmen ein gewichtetes Graphon zu generieren.
class CNeuronGraphons   :  public CNeuronBaseOCL
  {
protected:
   CLayer            acProbability;
   CLayer            acDataEmb;
   CParams           cExpertsEmb;
   CNeuronBaseOCL    cGraphs;
   //---
   virtual bool      feedForward(CNeuronBaseOCL *NeuronOCL) override;
   virtual bool      updateInputWeights(CNeuronBaseOCL *NeuronOCL) override;
   virtual bool      calcInputGradients(CNeuronBaseOCL *NeuronOCL) override;

public:
                     CNeuronGraphons(void) {};
                    ~CNeuronGraphons(void) {};
   virtual bool      Init(uint numOutputs, uint myIndex, COpenCLMy *open_cl,
                          uint units, uint window, uint emb_dimension,
                          uint experts, float dropout,
                          ENUM_OPTIMIZATION optimization_type, uint batch);
   //---
   virtual int       Type(void) override const   {  return defNeuronGraphons;   }
   //--- methods for working with files
   virtual bool      Save(int const file_handle) override;
   virtual bool      Load(int const file_handle) override;
   //---
   virtual bool      WeightsUpdate(CNeuronBaseOCL *source, float tau) override;
   virtual void      SetOpenCL(COpenCLMy *obj) override;
   virtual void      SetActivationFunction(ENUM_ACTIVATION value) override { };
   virtual void      TrainMode(bool flag) override;
  };
Innerhalb der Klasse werden vier interne Objekte deklariert, von denen jedes eine eigene Funktion erfüllt – auf die Einzelheiten werden wir bei der Implementierung der Methoden eingehen. In dieser Implementierung wird ihr Lebenszyklus innerhalb der Klasse verwaltet, sodass der Konstruktor und der Destruktor leer bleiben können. Beim Erstellen eines Objekts ist keine zusätzliche Initialisierung oder Bereinigung erforderlich. Dieser Ansatz vereinfacht die Ressourcenverwaltung, reduziert den mit der Erstellung mehrerer Instanzen verbundenen Aufwand und macht das Verhalten der Klasse vorhersehbarer.
Die Initialisierung über `Init` bietet vollständige Kontrolle über die Konfiguration: die Anzahl der Ausgänge, den Neuronenindex im Netzwerk, einen Zeiger auf den OpenCL-Kontext, die Anzahl der internen Einheiten und das Aggregationsfenster, die Einbettungsgröße, die Anzahl der Experten, den Dropout-Wert, den Optimierungstyp und die Batchgröße. Dies ermöglicht es einerseits, eine ressourcenschonende MLP-Implementierung des Gating-Netzwerks für schnelle Tests einzurichten, und andererseits bei Bedarf auf einen leistungsstarken OpenCL-Pfad umzuschalten. Die Methode `TrainMode(bool)` steuert den Betriebsmodus: Während des Trainings ist „Inverted Dropout“ aktiviert, und es können zusätzliche stochastische Verfahren zum Einsatz kommen; während der Inferenz sorgt die Deaktivierung von „Dropout“ für ein deterministisches Verhalten, was für den Produktivbetrieb und stabile Handelsentscheidungen wichtig ist.
Die Methode Init übernimmt den gesamten Aufbau der Objektarchitektur und die Einrichtung der internen Komponenten und koordiniert dabei den gesamten Prozess. Sie baut die grundlegende Neuronenhierarchie auf, verknüpft die internen Komponenten mit dem OpenCL-Kontext und überprüft jeden Schritt sorgfältig, um ein vollständig einsatzbereites Modul zu erstellen.
bool CNeuronGraphons::Init(uint numOutputs, uint myIndex, COpenCLMy *open_cl,
                           uint units, uint window, uint emb_dimension,
                           uint experts, float dropout,
                           ENUM_OPTIMIZATION optimization_type, uint batch)
  {
   if(!CNeuronBaseOCL::Init(numOutputs, myIndex, open_cl, units * units, optimization_type, batch))
      return false;
   activation = None;
Zunächst wird die gleichnamige Methode der übergeordneten Klasse aufgerufen – dies dient der erforderlichen Vorinitialisierung des Basisobjekts. Wenn die Methode false zurückgibt, bedeutet dies, dass die Basisinfrastruktur noch nicht bereit ist und eine Fortsetzung des Aufbaus sinnlos ist; daher wird die Methode sofort mit dem Rückgabewert false beendet. Nach erfolgreicher Rückkehr setzen wir die Aktivierung explizit zurück, da wir die jeweiligen Aktivierungsfunktionen für die Unterkomponenten im Folgenden einzeln festlegen werden.
Der nächste Schritt besteht darin, den cGraphs-Puffer zu initialisieren – hier bereiten wir einen Container vor, in dem die einzelnen Graphons unserer Experten gespeichert werden. Anschließend wird SIGMOID explizit als Aktivierungsfunktion festgelegt, damit die interne Logik im gewünschten Wertebereich arbeitet.
   int index = 0;
   if(!cGraphs.Init(0, index, OpenCL, Neurons()*experts, optimization, iBatch))
      return false;
   cGraphs.SetActivationFunction(SIGMOID);
Anschließend wird eine Reihe von lokalen Variablen deklariert, um vorübergehend Zeiger auf die Teilkomponenten zu speichern, die wir während des schrittweisen Zusammenbaus des Modells bearbeiten werden.
   CNeuronBaseOCL       *neuron  = NULL;
   CNeuronConvOCL       *conv    = NULL;
   CNeuronTransposeOCL  *transp  = NULL;
   CNeuronDropoutOCL    *dout    = NULL;
   CNeuronSoftMaxOCL    *softmax = NULL;
Nun wenden wir uns der Erstellung des Modells zu, das die Wahrscheinlichkeiten für den Einsatz der einzelnen Experten ermittelt. Zunächst löschen wir das entsprechende dynamische Array und binden es an den OpenCL-Kontext.
//--- Probability
   acProbability.Clear();
   acProbability.SetOpenCL(OpenCL);
   index++;
   conv = new CNeuronConvOCL();
   if(!conv ||
      !conv.Init(experts, index, OpenCL, window, window, experts, units, 1, optimization, iBatch) ||
      !acProbability.Add(conv))
     {
      DeleteObj(conv);
      return false;
     }
   conv.SetActivationFunction(SoftPlus);
Nun beginnen wir mit dem schrittweisen Aufbau. Zunächst erstellen wir eine Faltungsschicht mit der SoftPlus-Nichtlinearität, die eine glatte, monoton steigende Transformation der Logits vor der nächsten Schicht bewirkt. Anschließend erstellen wir eine vollständig verbundene Schicht, die experts Werte zurückgibt – also genau den Vektor der Logits vor Dropout.
   index++;
   neuron = new CNeuronBaseOCL();
   if(!neuron ||
      !neuron.Init(0, index, OpenCL, experts, optimization, iBatch) ||
      !acProbability.Add(neuron))
     {
      DeleteObj(neuron);
      return false;
     }
Wie zuvor löschen wir bei Auftreten eines Speicherallokations- oder Initialisierungsfehlers das Objekt ordnungsgemäß und brechen die Initialisierung mit false ab.
Als Nächstes erstellen wir eine Dropout-Schicht – dieses Objekt implementiert das zuvor erwähnte zufällige Deaktivieren von Experten.
   index++;
   dout = new CNeuronDropoutOCL();
   if(!dout ||
      !dout.Init(0, index, OpenCL, experts, dropout, optimization, iBatch) ||
      !acProbability.Add(dout))
     {
      DeleteObj(dout);
      return false;
     }
Der nächste Schritt besteht darin, eine SoftMax-Schicht zu erstellen, die die zuvor ermittelten Logits in einen Vektor von Wahrscheinlichkeiten umwandelt, welche die Wichtigkeit der einzelnen Experten ausdrücken.
   index++;
   softmax = new CNeuronSoftMaxOCL();
   if(!softmax ||
      !softmax.Init(0, index, OpenCL, experts, optimization, iBatch) ||
      !acProbability.Add(softmax))
     {
      DeleteObj(softmax);
      return false;
     }
   softmax.SetHeads(1);
Als Nächstes beginnen die Vorbereitungen für den Block acDataEmb zur Einbettung der Eingabedaten. Wir leeren ihn, binden ihn an OpenCL und beginnen dann, ihn auf dieselbe Weise aus Faltungsschichten zusammenzusetzen. Hier verwenden wir ein kleines MLP, das aus zwei aufeinanderfolgenden Faltungsschichten besteht, zwischen denen eine SoftPlus-Nichtlinearität liegt.
//--- Data Embedding
   acDataEmb.Clear();
   acDataEmb.SetOpenCL(OpenCL);
   index++;
   conv = new CNeuronConvOCL();
   if(!conv ||
      !conv.Init(0, index, OpenCL, window, window, 2 * emb_dimension, units, 1, optimization,
                                                                                   iBatch) ||
      !acDataEmb.Add(conv))
     {
      DeleteObj(conv);
      return false;
     }
   conv.SetActivationFunction(SoftPlus);
   index++;
   conv = new CNeuronConvOCL();
   if(!conv ||
      !conv.Init(0, index, OpenCL, 2 * emb_dimension, 2 * emb_dimension, emb_dimension, units,
                                                                   1, optimization, iBatch) ||
      !acDataEmb.Add(conv))
     {
      DeleteObj(conv);
      return false;
     }
   conv.SetActivationFunction(None);
Als Ausgabe dieses MLP erwarten wir Einbettungen für jeden Zeitschritt der analysierten multimodalen Sequenz. Um jedoch Graphons zu erzeugen, benötigen wir eine transponierte Kopie dieser Darstellung. Daher wird als Nächstes eine Datentranspositionsschicht hinzugefügt.
   index++;
   transp = new CNeuronTransposeOCL();
   if(!transp ||
      !transp.Init(0, index, OpenCL, units, emb_dimension, optimization, iBatch) ||
      !acDataEmb.Add(transp))
     {
      DeleteObj(transp);
      return false;
     }
   transp.SetActivationFunction((ENUM_ACTIVATION)conv.Activation());
Als Nächstes müssen wir nur noch das Objekt zur Erzeugung der Einbettungen unserer Experten, cExpertsEmb, initialisieren. Hier wird Platz für ihre individuellen Darstellungen geschaffen.
   index++;
   if(!cExpertsEmb.Init(0, index, OpenCL, units * emb_dimension * experts, optimization, iBatch))
      return false;
//---
   return true;
  }
Wenn keine Fehler vorliegen, gibt die Methode schließlich true zurück, was bedeutet, dass das Objekt vollständig initialisiert und für das Training bereit ist.
Im Ablauf der Methode lässt sich eine klare Entwurfsphilosophie erkennen: Zunächst wird ein Graphon-Container vorbereitet; anschließend wird eine Pipeline zur Wahrscheinlichkeitsgenerierung aufgebaut; dann wird die Einbettung der Eingabedaten gebildet; und schließlich wird der Parameterraum für die Experten reserviert. Diese Abfolge gewährleistet einen logischen Erstellungsprozess, der die Fehlersuche und die anschließende Integration in OpenCL erleichtert.
Die Methode feedForward führt den Vorwärtsdurchlauf in klar definierten Schritten aus. Zunächst speichern wir einen Zeiger auf die aktuelle Signalquelle in einer lokalen Variablen und deklarieren eine zusätzliche Variable, um vorübergehend einen Verweis auf die gerade verarbeitete Schicht zu speichern.
bool CNeuronGraphons::feedForward(CNeuronBaseOCL *NeuronOCL)
  {
   CNeuronBaseOCL* prev = NeuronOCL;
   CNeuronBaseOCL* current = NULL;
Als Nächstes folgt ein Durchlauf durch den Block, der die Wahrscheinlichkeiten für den Einsatz von Experten vorhersagt. In der Schleife durchlaufen wir alle Unterkomponenten, die für die Erzeugung von Logits zuständig sind.
//--- Probability
   for(int i = 0; i < acProbability.Total(); i++)
     {
      current = acProbability[i];
      if(!current ||
         !current.FeedForward(prev))
         return false;
      prev = current;
     }
In jeder Iteration nehmen wir die nächste Komponente und weisen sie an, ihren eigenen Vorwärtsdurchlauf durchzuführen. Fehlt die Komponente oder gibt ihre Methode FeedForward false zurück, brechen wir die Methode sofort mit dem Rückgabewert false ab. Dies ist eine strenge und zuverlässige „Fail-Fast“-Richtlinie, die vor einer fehlerhaften Zusammenstellung der Pipeline schützt.
Nachdem die Schicht erfolgreich ausgeführt wurde, setzen wir den Zeiger auf das Objekt der aktuellen Schicht. Dessen Ausgabe dient der nächsten Schicht als Eingabe. Als Ergebnis dieser Schleife erhalten wir einen fertigen Vektor normierter Wahrscheinlichkeiten.
Als Nächstes initialisieren wir den Zeiger auf die Quelldaten neu und durchlaufen den acDataEmb-Block nach genau demselben Muster. Dieser zweite lineare Durchlauf erzeugt Einbettungen der Quelldaten.
//--- Data Embedding
   prev = NeuronOCL;
   for(int i = 0; i < acDataEmb.Total(); i++)
     {
      current = acDataEmb[i];
      if(!current ||
         !current.FeedForward(prev))
         return false;
      prev = current;
     }
Als Nächstes folgt eine kleine, aber wichtige Verzweigung: Befinden wir uns im Trainingsmodus, rufen wir die Methode zur Generierung von Experteneinbettungen auf. Das bedeutet, dass die Parameter bzw. die Expertenrepräsentationen nur während des Trainingslaufs aktualisiert werden. Im Inferenzmodus gehen wir davon aus, dass cExpertsEmb bereits fertige Gewichte enthält. Daher überspringen wir diesen Schritt, um Zeit zu sparen.
//--- Experts
   if(bTrain)
      if(!cExpertsEmb.FeedForward())
         return false;
Als Nächstes folgen die zentralen algebraischen Berechnungen. Wir berechnen die Hilfsdimensionen der Architektur des Objekts.
//--- Graphs
   uint units = (uint)MathSqrt((double)Neurons());
   uint emb_dim = acDataEmb[-1].Neurons() / units;
   uint experts = cExpertsEmb.Neurons() / acDataEmb[-1].Neurons();
Diese einfachen Berechnungen stellen sicher, dass die Dimensionen vor der Matrixmultiplikation zueinander passen. Bei der ersten Matrixmultiplikation wird für jeden Experten eine eigene Graphmatrix erstellt. Der daraus resultierende cGraphs-Puffer enthält übersichtlich eine Abfolge solcher Matrizen für alle Experten.
   if(!MatMul(cExpertsEmb.getOutput(), current.getOutput(), cGraphs.getOutput(),
              units, emb_dim, units, experts, false))
      return false;
   if(cGraphs.Activation() != None)
      if(!Activation(cGraphs.getOutput(), cGraphs.getOutput(), cGraphs.Activation()))
         return false;
Nachdem wir die rohen Graphon-Matrizen erhalten haben, wenden wir die gewählte Aktivierungsfunktion an. Hier wenden wir die ausgewählte Aktivierungsfunktion auf alle Elemente des Ausgabepuffers an. Dies ist ein wichtiger Schritt, um die Werte in den erforderlichen Bereich zu bringen und die gewünschte Nichtlinearität hinzuzufügen.
Die abschließende Reduktion wandelt eine Menge von Expertenmatrizen und einen Wahrscheinlichkeitsvektor in einen einzigen Ergebnistensor um, der einen gewichteten Graphen darstellt. Mit anderen Worten: Wir nehmen den Vektor der normierten Gewichte aus der letzten acProbability-Schicht und fassen die Matrizen aller Experten zu einem einzigen gewichteten Ergebnis zusammen.
//--- Result
   if(!MatMul(acProbability[-1].getOutput(), cGraphs.getOutput(), Output, 1, experts, units * units, 1, false))
      return false;
//---
   return true;
  }
Wenn alle Schritte erfolgreich abgeschlossen wurden, gibt die Methode true zurück und bestätigt damit, dass der Vorwärtsdurchlauf korrekt abgeschlossen wurde.
Die Methoden für den Rückwärtsdurchlauf folgen derselben Logik wie der Vorwärtsdurchlauf, jedoch in umgekehrter Richtung. Fehlersignale durchlaufen alle Schichten in umgekehrter Reihenfolge; die Gradienten werden sorgfältig summiert und von den Ausgängen zu den Eingängen weitergeleitet, wodurch sichergestellt wird, dass alle Komponenten korrekt trainiert werden. Da die Struktur die Methode feedForward vollständig widerspiegelt und alle Schritte anhand der bereits erläuterten Abfolge leicht nachvollzogen werden können, ist es nicht nötig, hier auf jede einzelne Phase im Detail einzugehen. Für ein umfassendes Verständnis und die praktische Arbeit mit allen Methoden der Klasse finden Sie im Anhang den vollständigen Code einschließlich des Rückwärtsdurchlaufs.
Wir haben heute hart gearbeitet, und jetzt ist es an der Zeit, eine kurze Pause einzulegen und die Informationen sacken und sich im Kopf ordnen zu lassen. Im nächsten Artikel werden wir die begonnene Arbeit fortsetzen und uns eingehend mit der praktischen Anwendung von Graphons befassen.
Fazit
In diesem Artikel haben wir uns eingehend mit den theoretischen Aspekten des Frameworks ST-Expert befasst, das die Prinzipien des flexiblen Gatings, des kollektiven Lernens und der adaptiven Aggregation miteinander verbindet. Wir haben untersucht, wie eine Kombination aus Blöcken zur Wahrscheinlichkeitserzeugung, Einbettungen von Eingabedaten und Expertenrepräsentationen die Erstellung von Modellen ermöglicht, die robust gegenüber Rauschen und Unsicherheit sind.
Im praktischen Teil wird die Architektur der Klasse CNeuronGraphons vorgestellt, die die Erstellung und das Training von Graphons ermöglicht. Die beschriebenen Methoden bilden eine solide Grundlage für die anschließende praktische Anwendung.
Literaturverzeichnis
Im Artikel verwendete Programme
| # | Name | Typ | Beschreibung |
|---|---|---|---|
| 1 | Study.mq5 | Expert Advisor (EA) | Expert Advisor für das Offline-Modelltraining |
| 2 | StudyOnline.mq5 | Expert Advisor (EA) | Expert Advisor für Online-Modelltraining |
| 3 | Test.mq5 | Expert Advisor (EA) | Expert Advisor für Modelltests |
| 4 | Trajectory.mqh | Klassenbibliothek | Struktur zur Beschreibung des Systemzustands und der Modellarchitektur |
| 5 | NeuroNet.mqh | Klassenbibliothek | Klassenbibliothek zum Erstellen eines neuronalen Netzes |
| 6 | NeuroNet.cl | Bibliothek | Codebibliothek für das OpenCL-Programm |
Übersetzt aus dem Russischen von MetaQuotes Ltd.
Originalartikel: https://www.mql5.com/ru/articles/19595
Warnung: Alle Rechte sind von MetaQuotes Ltd. vorbehalten. Kopieren oder Vervielfältigen untersagt.
Dieser Artikel wurde von einem Nutzer der Website verfasst und gibt dessen persönliche Meinung wieder. MetaQuotes Ltd übernimmt keine Verantwortung für die Richtigkeit der dargestellten Informationen oder für Folgen, die sich aus der Anwendung der beschriebenen Lösungen, Strategien oder Empfehlungen ergeben.



