

Redes neuronales en el trading: Señales de trading robustas en cualquier régimen de mercado (ST-Expert)
 19
 0

Introducción
Los mercados financieros actuales constituyen un ecosistema dinámico en el que millones de operaciones, las decisiones de los reguladores, los informes corporativos y las señales macroeconómicas se entrelazan formando un patrón complejo. Para un operador o un analista, la tarea fundamental consiste en identificar las regularidades de este patrón y, a partir de ellas, elaborar una previsión. Pero es precisamente aquí donde surge la principal contradicción: el mercado cambia más rápido de lo que pueden adaptarse los modelos habituales. Lo que ayer funcionaba, mañana puede resultar no solo inútil, sino también peligroso.
Estamos acostumbrados a pensar en términos de correlaciones. Existe una relación constante entre el precio del petróleo y el tipo de cambio del dólar canadiense, entre los tipos de interés de la Reserva Federal y el sector tecnológico, y entre la demanda de oro y la evolución del dólar. Pero basta con que cambien las circunstancias externas para que esas dependencias se desmoronen. Durante la crisis del COVID-19 de 2020, en cuestión de semanas, las relaciones habituales entre las acciones, los bonos y las materias primas dejaron de reflejar la realidad. Incluso los cambios de régimen más moderados, como, por ejemplo, los ciclos de subida y bajada de los tipos de interés de la Reserva Federal, pueden alterar drásticamente las correlaciones y desbaratar modelos que parecían fiables.
El quid de la cuestión es que los algoritmos actuales se entrenan con intervalos de datos relativamente cortos y homogéneos. En estas condiciones de laboratorio, muestran resultados impresionantes al captar las sutiles interrelaciones entre los activos. Pero en cuanto el mercado se sale de los límites de la distribución habitual, la precisión de las previsiones desciende drásticamente. En esencia, los modelos funcionan perfectamente en épocas de calma, pero no son capaces de hacer frente a las transiciones de fase del mercado.
Esta situación recuerda en gran medida a las redes de transporte urbano, ejemplo a partir del cual los autores del trabajo «Robust Traffic Forecasting against Spatial Shift over Years» propusieron un nuevo framework ST-Expert. Mientras la ciudad permanece sin cambios, las previsiones de tráfico funcionan a la perfección. Pero basta con construir un nuevo nudo vial o inaugurar un gran centro comercial para que las rutas anteriores dejen de ser válidas. En el ámbito financiero, estos catalizadores son las decisiones de los organismos reguladores, las sanciones, los conflictos geopolíticos o la aparición de nuevas tecnologías. El mapa de interrelaciones cambia, y los modelos antiguos resultan impotentes.
Para hacer frente a esta tarea, los autores de ST-Expert proponen una solución original basada en Mixture of Experts. Su idea clave consiste en que el modelo no aprende a partir de una única estructura rígida de dependencias, sino a partir de un conjunto de generadores de grafos, los denominados grafones. Cada uno de ellos refleja un tipo concreto de comportamiento del mercado. Uno capta patrones en condiciones de tendencia estable, otro describe una fase de alta volatilidad y un tercero detecta correlaciones locales dentro de los sectores. Cuando el mercado cambia, el sistema no se viene abajo, sino que combina de forma adaptativa los escenarios ya aprendidos, creando nuevas conexiones entre los instrumentos y manteniendo la precisión de la previsión.
Es precisamente aquí donde se pone de manifiesto la primera y, quizá, principal ventaja del enfoque: la capacidad de adaptarse a unas condiciones de mercado cambiantes. Si los modelos estándar quedan anclados en un periodo histórico concreto, el nuevo framework considera el mercado como un mosaico en el que cada régimen no es más que un fragmento temporal del todo. Gracias a ello, el algoritmo es capaz de ensamblar una nueva combinación a partir de elementos ya estudiados y ofrecer una previsión precisa allí donde otros sistemas pierden estabilidad. Para el trader, esto significa menos señales falsas en periodos de turbulencia y una mayor fiabilidad a la hora de diseñar estrategias a largo plazo.
Pero la adaptabilidad es solo una de sus facetas. Otra ventaja no menos importante es la versatilidad de la arquitectura. La capa de grafones especializados se integra fácilmente en las soluciones existentes. Se puede incorporar tanto a redes neuronales de grafos que analizan las interrelaciones en red entre activos como a transformadores que trabajan con series temporales de cotizaciones. Esto hace que el enfoque resulte especialmente valioso para los profesionales. No requiere una revisión radical de la infraestructura y puede reforzar sistemas ya depurados.
Otra ventaja reside en su resistencia a los denominados cambios de régimen. La historia de los mercados financieros demuestra de manera convincente que la constancia es una rareza, mientras que el cambio es la norma. Cada década trae consigo una nueva crisis, y cada etapa dentro de esa crisis viene acompañada de una cascada de perturbaciones imprevisibles. El intento de encontrar invariantes eternos resulta ser una ilusión. El nuevo framework reconoce abiertamente la variabilidad de los mercados y basa su fortaleza precisamente en la capacidad de alternar entre escenarios. Esto es especialmente importante para las pruebas de estrés y las previsiones a largo plazo, en las que el coste de un error es extremadamente elevado.
Al mismo tiempo, el enfoque sigue siendo compacto y eficiente. En las aplicaciones financieras, el tiempo es un factor crítico. La decisión sobre la operación debe tomarse en milisegundos. Por eso, por muy precisos que sean, los modelos no pueden permitirse ser excesivamente pesados. El framework propuesto tiene en cuenta este factor. Aporta flexibilidad y estabilidad sin un aumento drástico de los costes computacionales. Gracias a ello, se puede aplicar en sistemas en tiempo real, desde el trading algorítmico hasta la gestión de riesgos.
Por último, cabe destacar también la flexibilidad en la ampliación. Los grafones expertos no se limitan a un único mercado o clase de activos. Se pueden utilizar en mercados de acciones, bonos, divisas y criptomonedas. Es más, son capaces de integrar datos de distintos tipos, desde cotizaciones y flujos de noticias hasta indicadores macroeconómicos. Esto allana el camino para la creación de modelos verdaderamente integrales que tengan en cuenta toda la naturaleza multicapa de los sistemas financieros.
Se trata de una visión totalmente nueva de la propia naturaleza de la modelización en condiciones de incertidumbre. Mientras que los modelos tradicionales buscan obstinadamente ciertas leyes eternas, ST-Expert enseña al sistema a desenvolverse en un mundo cambiante. Convierte la previsión en un proceso dinámico, capaz de tener en cuenta cambios inesperados y reconfigurarse en tiempo real.
El algoritmo ST-Expert
La elaboración de un modelo predictivo fiable para los mercados financieros requiere la capacidad de distinguir y tener en cuenta los distintos regímenes de mercado. En realidad, la estructura de las correlaciones entre activos dista mucho de ser estática. Lo que ayer parecía una regla fija, mañana puede resultar ser una mera coincidencia. En los periodos de crecimiento del sector tecnológico, las relaciones entre las acciones de empresas de TI y los tipos de refinanciación pueden ser mínimas, pero ante los primeros indicios de sobrecalentamiento pasan a primer plano. En los mercados de materias primas, la correlación entre el precio del petróleo y las divisas de los países exportadores se manifiesta con especial intensidad en periodos de crisis, para luego desaparecer prácticamente por completo. Es evidente que un modelo que intente reducir toda esta diversidad a una única matriz fija de relaciones está abocado a perder precisión.
Precisamente por eso, los autores proponen un enfoque basado en la identificación de segmentos temporales característicos, dentro de los cuales el mercado se comporta de forma relativamente homogénea. La idea es sencilla. Si se considera toda la historia como un único conjunto de datos, los regímenes importantes se difuminarán y ningún experto podrá aprenderlos correctamente. Pero si se divide la historia en periodos, cada uno de los cuales presenta su propio tipo de correlaciones estables, es posible crear un experto especializado para cada uno de esos periodos. Más adelante, el modelo combinará a estos expertos, creando una representación flexible del entorno de mercado.
Formalmente, esto da lugar al problema de la división espaciotemporal máxima de grafos (Maximum Spatiotemporal Graph Division, MSGD). Toda la serie temporal (que denotaremos por T) se divide en K intervalos que no se solapan. Cada intervalo Tk incluye pares (Xt, Yt) para t ∈ [tk, tk+1). Es importante señalar que, dentro de ese intervalo, las relaciones de mercado se describen mediante una misma estructura Rk, mientras que, para intervalos distintos, estas estructuras son diferentes.
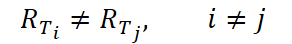
En esencia, esto significa que las sesiones matutinas del mercado de valores pueden ser muy similares entre sí, aunque tengan lugar en días diferentes. La actividad de los inversores particulares genera un tipo de correlaciones, mientras que las horas de la tarde, cuando los participantes institucionales entran en el mercado, dibujan un panorama de relaciones completamente diferente. La idea de MSGD consiste en dividir los datos de tal forma que la diferencia entre los intervalos seleccionados sea máxima.
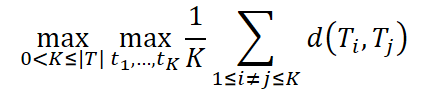
Bajo las condiciones
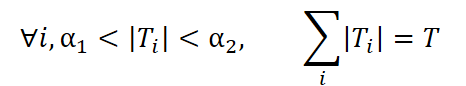
Aquí, como medida de diferencia d(•,•), los autores del framework proponen utilizar el coeficiente de Kendall τ, que refleja en qué medida difieren las estructuras de correlación en los distintos periodos. Las restricciones α1, α2 establecen la longitud mínima y máxima admisible del intervalo, y T es la duración total de la serie.
Por lo tanto, la tarea consiste en dividir el historial en partes que se diferencien lo máximo posible entre sí por el tipo de dependencias. En otras palabras, buscamos regímenes de mercado puros: la fase de crecimiento, la fase lateral y la fase de alta volatilidad. Este enfoque recuerda a la creación de índices temáticos. Cada índice agrupa valores de un mismo tipo y muestra su evolución sin mezclarla con la de otros segmentos del mercado.
Resolver este problema, desde luego, no es fácil. No se expresa de forma analítica, por lo que los autores del framework recurren a la programación dinámica. Esto permite seleccionar de forma eficaz tanto el número de intervalos K como sus límites, incluso con grandes volúmenes de datos.
Una vez definidos los periodos, surge la pregunta: ¿cómo se establece exactamente la estructura de las relaciones dentro de cada uno de ellos? Para ello, se introduce el concepto de grafón: un generador probabilístico de grafos. A diferencia de una matriz de adyacencia fija, aquí el grafón se define mediante una matriz probabilística P, en la que el elemento P(i,j) refleja la probabilidad de que exista una conexión entre los activos i y j. Por lo tanto, el grafón no fija rígidamente la presencia de aristas, sino que describe su distribución probabilística. Esto se acerca mucho más a la realidad del mercado financiero, donde las relaciones tienen un carácter estocástico.
Para construir un grafón para cada experto, se utilizan matrices de embeddings entrenables Egk ∈ R|V|*d y una capa dinámica de embedding Et ∈ R|V|*d, que depende de los datos actuales del mercado. En ese caso, la matriz probabilística para el experto k-ésimo se calcula mediante la fórmula:
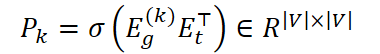
donde σ es una función sigmoide que transforma todos los valores al intervalo (0,1).
Para obtener un grafo concreto a partir de esta matriz probabilística, se aplica una reparametrización mediante Gumbel-SoftMax.
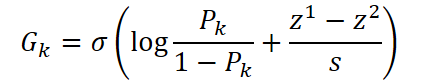
donde z1 y z2 se muestrean a partir de la distribución Gumbel(0,1), y s es el parámetro de temperatura.
En esencia, esta técnica permite muestrear relaciones concretas, evitando una binarización rígida y, al mismo tiempo, minimizando la influencia de las correlaciones débiles y ruidosas, que abundan en los mercados financieros.
Como resultado, cada experto dispone de su propio generador de grafos, que refleja un tipo único de comportamiento del mercado. Algunos grafones tenderán a formar clústeres densos, por ejemplo, dentro de los sectores. Otros construirán conexiones más dispersas, características de las correlaciones globales entre clases de activos. Y, en conjunto, forman todo un ensamble de expertos, preparados para describir y combinar nuevos regímenes de mercado, incluso si estos no se habían presentado antes.
Sin embargo, la construcción de expertos no es más que el primer paso. Lo fundamental es su entrenamiento en condiciones de variabilidad. En el mundo real, las dependencias de mercado están sujetas a cambios constantes. Las estructuras de correlación entre activos se forman y se destruyen bajo la influencia de toda una serie de factores. Las decisiones de los bancos centrales cambian el comportamiento de las divisas y los bonos. Los cambios en la política fiscal o en la regulación reconfiguran las relaciones sectoriales. Las crisis o los cambios tecnológicos introducen sus propias correcciones bruscas. Para un modelo que se ha entrenado con un conjunto de datos relativamente estable, este tipo de cambios supone un serio problema. De repente, su mapa del mercado deja de coincidir con la realidad.
Para preparar el sistema para este tipo de incertidumbre, los autores del framework proponen utilizar el aprendizaje episódico. La esencia de este enfoque radica en la división de funciones entre los expertos. Cuando a la entrada llega una observación xi ∈ Ti, solo el grafón Pi, asignado a ese intervalo temporal, realiza la tarea principal de predicción. Se utiliza para construir el grafo Gi ⁓ Pi, que posteriormente se introduce en el módulo ST-GNN para generar la predicción.
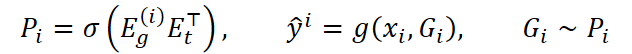
Así, es precisamente su propio experto el que se entrena mediante la función de pérdidas principal, que responde de la precisión de la predicción.
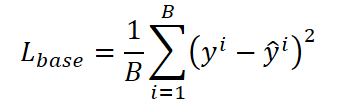
Pero el proceso de entrenamiento no termina ahí. Los demás expertos {Pk}Kk=1,k≠i, aunque no se utilizan para la predicción directa en este caso, desempeñan una importante función auxiliar. Con su ayuda se forma una mezcla de grafones Pimix(x), que debe reproducir con la mayor precisión posible la estructura del grafón de referencia Pi.
Para ello, se introduce una red de gating que, a partir de la señal de entrada xi, calcula un vector de pesos.
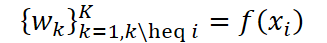
Estos pesos determinan en qué proporción se combinan los demás expertos.
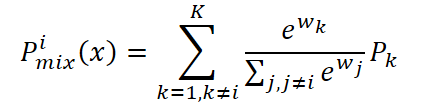
A continuación, se compara con el grafón de referencia Pi.
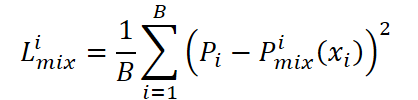
Es importante señalar que Lmix actualiza únicamente los pesos de mezcla w, sin modificar los parámetros de los grafones propiamente dichos. Gracias a ello, los expertos conservan su independencia y siguen especializándose en sus respectivos regímenes de mercado, mientras que el vector de pesos aprende a combinarlos adecuadamente para reproducir las propiedades del grafón de referencia.
De este modo, el entrenamiento se divide en dos procesos paralelos. Cada experto perfecciona su capacidad de predicción precisamente en su propio régimen de mercado, sin interferir en los de los demás, mientras que la red de compuerta se entrena en la tarea de imitación. Debe aprender a integrar los conocimientos de los demás expertos de modo que el conjunto reproduzca la estructura de la referencia actual. Esta división de funciones hace que el modelo sea, al mismo tiempo, altamente especializado y flexible, capaz de adaptarse a nuevas situaciones de mercado.
Se podría comparar con el trabajo de un equipo de analistas. Cada uno de ellos tiene su propio ámbito de especialización. Uno entiende mejor los activos relacionados con las materias primas, otro se especializa en los mercados de divisas y un tercero, en los bonos. Cuando surge una nueva situación, el pronóstico lo elabora precisamente aquel analista cuyo ámbito de conocimientos es el más relevante. El resto desempeña, en ese momento, un papel secundario. Ayudan al equipo a valorar mejor en qué medida sus puntos de vista combinados pueden reflejar la visión clave del experto principal.
Tras el entrenamiento, cuando el modelo se enfrenta a datos reales del mercado, se encuentra por primera vez en una situación de total incertidumbre. Si durante el entrenamiento siempre tuvo acceso al grafón correcto, (Pi)_, asociado al intervalo de tiempo correspondiente, ahora ya no dispone de esa pista. Esto corresponde a una situación natural en el trading. Un trader puede apoyarse en patrones históricos, pero nunca sabe de antemano en qué fase concreta del ciclo se encuentra hoy el mercado.
El primer paso de la fase de inferencia consiste en que todos los expertos generen simultáneamente un conjunto de grafones probabilísticos. Cada uno de ellos ofrece su propia interpretación de la estructura de las relaciones entre los activos. En esencia, cada experto plantea su propia hipótesis sobre el mercado. Uno ve clústeres claramente delimitados por sectores; otro, correlaciones globales entre divisas y activos de materias primas; y un tercero, relaciones locales inestables pero significativas.
El siguiente paso consiste en calcular un vector de pesos a partir de la señal de mercado actual xtest.
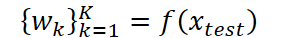
Estos pesos reflejan la importancia de cada uno de los expertos en este momento. Se podría decir que la red de compuerta actúa como un árbitro que determina la importancia de la opinión de cada experto en ese preciso momento. Si, por ejemplo, el mercado experimenta un repunte de la volatilidad en los activos de materias primas, se dará mayor peso a los expertos entrenados en los escenarios correspondientes.
Una vez calculados los pesos, se genera el grafón mixto final, que representa una imagen agregada de las relaciones del mercado.
La diferencia clave entre la fase de inferencia y la de entrenamiento radica en que ahora todos los expertos participan en el proceso al mismo tiempo. Si antes el sistema conocía al experto correcto y utilizaba a los demás solo para la imitación, ahora debe confiar en la valoración colectiva. Este punto es de vital importancia. El mercado real no ofrece referencias ya preparadas, y el modelo debe ser capaz de sintetizar una nueva representación a partir de los conocimientos acumulados.
En la etapa final, a partir de la matriz de probabilidades obtenida, se muestrea un grafo concreto que refleja la distribución actual de las relaciones entre los activos. Este grafo es precisamente el que se utiliza en el módulo ST-GNN para elaborar la previsión. Aquí, de hecho, el sistema construye una previsión de la dinámica del mercado basándose no en una estructura rígidamente fijada, sino en una representación formada de manera flexible y creada conjuntamente por todos los expertos.
El resultado es un modelo que, durante su funcionamiento, se comporta como un gestor de carteras con experiencia. No se basa en una única fuente de información, sino que compara y combina diferentes puntos de vista, creando un mapa dinámico del mercado. Este enfoque lo convierte en una solución robusta, flexible y capaz de mantener la precisión de sus previsiones incluso cuando las regularidades habituales del mercado se rompen bajo la presión de nuevos acontecimientos.
Otra ventaja fundamental del enfoque propuesto radica en la universalidad de los grafones entrenables. Aunque en la descripción anterior se utilizan en combinación con redes de grafos espaciotemporales (ST-GNNs), su potencial es mucho más amplio. Los grafones, por sí mismos, son una herramienta flexible para describir dependencias probabilísticas y pueden servir de nexo de unión para toda una serie de arquitecturas.
En concreto, en los modelos de Transformer, el grafón puede actuar como una máscara dinámica o como una matriz de atención generada, en la que las conexiones entre los elementos de la secuencia no vienen determinadas por reglas preestablecidas, sino por una estructura probabilística entrenada. Esto allana el camino para crear modelos de Transformer más adaptativos, capaces de captar mejor los patrones cambiantes del mercado. Es más, los grafones también pueden utilizarse en sistemas híbridos, en los que se combinan las CNN, las RNN y los mecanismos de atención, lo que aumenta la eficacia de cualquiera de estos bloques.
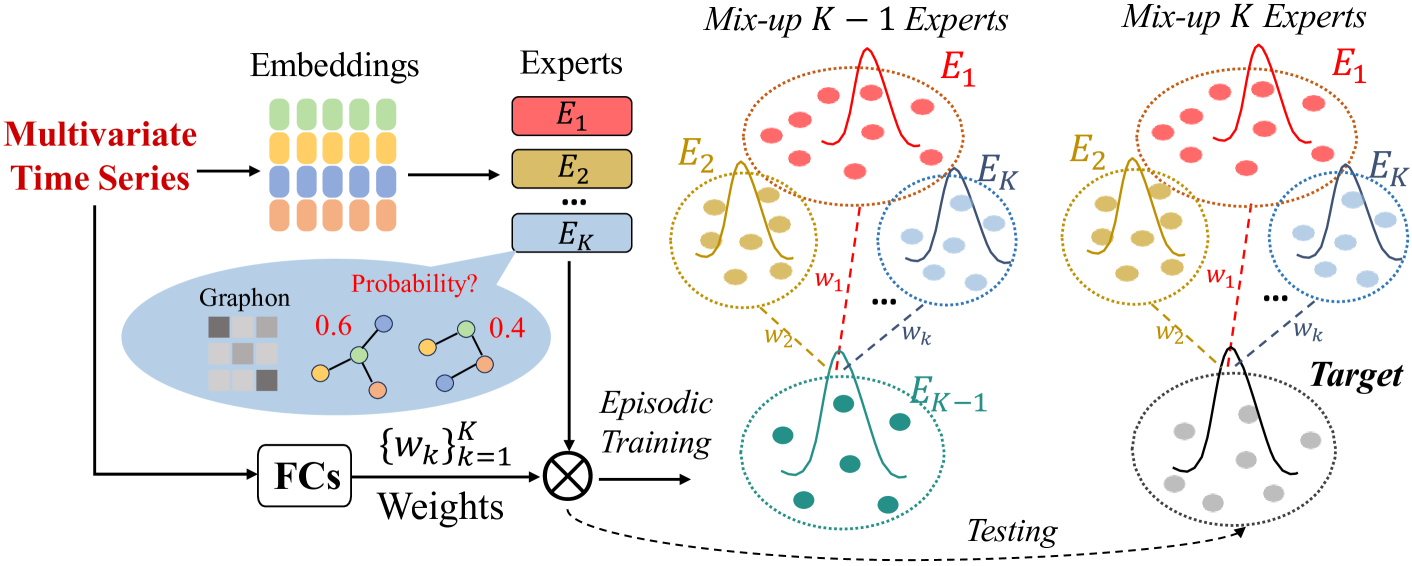
A continuación se muestra una visualización del framework ST-Expert realizada por el autor.
Implementación en MQL5
Tras analizar los aspectos teóricos del framework ST-Expert, pasamos a la implementación práctica de sus enfoques mediante MQL5. Y, como es lógico, comenzaremos nuestro trabajo con la construcción de grafones. Pero antes, analicemos los enfoques de nuestra implementación.
Personalmente, hay dos aspectos del proceso de entrenamiento propuesto por los autores del framework que me generan dudas. En primer lugar, está la necesidad de procesar previamente la muestra de entrenamiento para identificar regímenes de mercado concretos. Este proceso es bastante laborioso, requiere un procedimiento de optimización adicional y, a menudo, se basa en heurísticas. En las condiciones del mercado real, una segmentación tan rígida puede resultar no solo costosa en términos de recursos, sino también poco fiable. Los límites entre los distintos regímenes suelen ser difusos, y estos pueden alternarse rápidamente. Si dividimos la historia de forma demasiado rígida, corremos el riesgo de pasar por alto importantes fases de transición, que son precisamente las que constituyen la base de muchos movimientos del mercado.
El segundo aspecto está relacionado con la propia lógica del aprendizaje de los grafones y de los pesos. En la formulación original se parte de la base de que, cuando se introduce una observación procedente del intervalo Ti, es precisamente el experto correspondiente Pi quien realiza la predicción, mientras que los restantes se combinan en una mezcla que debe reproducir su estructura. Desde un punto de vista formal, este esquema resulta elegante. Cada grafón aprende a predecir su propio régimen, y la red de compuerta aprende a agrupar los demás de manera que puedan imitar el grafón de referencia. Sin embargo, en la práctica surge aquí un problema delicado. En la práctica, estamos fijando rígidamente los papeles de los expertos y excluyendo el aprendizaje cruzado. Esto conlleva el riesgo de una especialización excesiva, en la que el experto solo rinde realmente bien en su ámbito específico, pero pierde por completo su capacidad de generalización ante el más mínimo cambio en el contexto del mercado.
Es más, este esquema hace que el aprendizaje de los pesos dependa de la corrección del grafón de referencia. Si en algún momento Pi resultara afectado por el ruido o registrara un estado de mercado atípico, la red de compuerta se vería obligada a aprender a reproducirlo precisamente a él, en lugar de identificar una pauta más general. En un contexto en el que los datos financieros están plagados de valores atípicos aleatorios y correlaciones falsas, esto puede constituir una fuente importante de errores.
En nuestra implementación, intentaremos suavizar esta jerarquía tan rígida. En lugar de asignar de forma definitiva su régimen a cada experto, permitamos que cada grafón contribuya a la previsión con una probabilidad que dependa de la situación actual del mercado. Formalmente, en el sistema hay N expertos, y cada uno de ellos ofrece su pronóstico. El gating es una red ligera que, en función de las características del mercado, devuelve logits. Para añadir variabilidad y evitar que un solo experto acapare toda la atención, utilizamos una máscara aleatoria Dropout y la pasamos por SoftMax. Como resultado, obtenemos los pesos y el pronóstico final del ensamble. Este esquema permite que los pesos aprendan no solo en la tarea de imitar el grafón de referencia, sino también en la mejora colectiva del pronóstico: la importancia de un experto viene determinada por la medida en que su aportación mejora el ensamble en un estado determinado del mercado.
La función de pérdidas se construye como una mezcla de tareas. Debe basarse en una medida de la calidad del ensamble, pero a ella se le añade una suma ponderada de las pérdidas individuales de los expertos. Esto anima a los expertos a mejorar sus previsiones precisamente allí donde son importantes.
El Dropout en el gating convierte el entrenamiento en una prueba episódica. En cada batch, el conjunto de expertos activos varía ligeramente, y el modelo aprende a no depender constantemente de un único experto con suerte. Durante el entrenamiento, Dropout está activado, mientras que durante la inferencia se desactiva, lo que permite aprovechar los conocimientos de todos los expertos.
La nueva clase CNeuronGraphons sirve de envoltorio de dominio para nuestra implementación de un ensamble flexible de grafones. Encapsula el estado del gate, los embeddings de los datos de entrada, los parámetros de los expertos y el propio conjunto de grafones: todo lo necesario para generar un grafón ponderado a partir de múltiples votos de expertos en cada paso.
class CNeuronGraphons   :  public CNeuronBaseOCL
  {
protected:
   CLayer            acProbability;
   CLayer            acDataEmb;
   CParams           cExpertsEmb;
   CNeuronBaseOCL    cGraphs;
   //---
   virtual bool      feedForward(CNeuronBaseOCL *NeuronOCL) override;
   virtual bool      updateInputWeights(CNeuronBaseOCL *NeuronOCL) override;
   virtual bool      calcInputGradients(CNeuronBaseOCL *NeuronOCL) override;

public:
                     CNeuronGraphons(void) {};
                    ~CNeuronGraphons(void) {};
   virtual bool      Init(uint numOutputs, uint myIndex, COpenCLMy *open_cl,
                          uint units, uint window, uint emb_dimension,
                          uint experts, float dropout,
                          ENUM_OPTIMIZATION optimization_type, uint batch);
   //---
   virtual int       Type(void) override const   {  return defNeuronGraphons;   }
   //--- methods for working with files
   virtual bool      Save(int const file_handle) override;
   virtual bool      Load(int const file_handle) override;
   //---
   virtual bool      WeightsUpdate(CNeuronBaseOCL *source, float tau) override;
   virtual void      SetOpenCL(COpenCLMy *obj) override;
   virtual void      SetActivationFunction(ENUM_ACTIVATION value) override { };
   virtual void      TrainMode(bool flag) override;
  };
Dentro de la clase se declaran cuatro objetos internos, y cada uno de ellos cumple una función concreta; hablaremos de los detalles cuando veamos la implementación de los métodos. Todos ellos están declarados de forma estática, lo que significa que el ciclo de vida de estos componentes se gestiona a nivel de clase. Gracias a ello, el constructor y el destructor pueden quedar vacíos. No es necesario realizar ninguna inicialización ni limpieza adicional cada vez que se crea un objeto. Esta solución simplifica la gestión de recursos, reduce los sobrecostes asociados a la creación de múltiples instancias y hace que el comportamiento de la clase sea más predecible.
La inicialización mediante `Init` ofrece un control total sobre la configuración: el número de salidas, el índice de la neurona en la red, el puntero al contexto de OpenCL, el número de unidades internas y la ventana de agregación, el tamaño del embedding, el número de expertos, el valor de dropout, el tipo de optimización y el tamaño del batch. Esto permite, por un lado, definir una implementación MLP ligera del gate para pruebas rápidas y, por otro, cambiar a la ruta OpenCL de alto rendimiento cuando sea necesario. El método `TrainMode(bool)` controla el modo de funcionamiento: durante el entrenamiento se activa el inverted Dropout y pueden aplicarse técnicas estocásticas adicionales; en la inferencia, la desactivación de Dropout hace que el comportamiento sea determinista, lo cual es importante para el entorno de producción y para tomar decisiones de trading estables.
Todo el proceso de creación de la arquitectura del objeto y de configuración de los componentes internos se ha trasladado al método Init, que actúa como director de todo el proceso. Este inicializa la jerarquía básica de neuronas, vincula los componentes internos con el contexto OpenCL y comprueba minuciosamente cada paso para obtener, como resultado, un módulo totalmente listo para funcionar.
bool CNeuronGraphons::Init(uint numOutputs, uint myIndex, COpenCLMy *open_cl,
                           uint units, uint window, uint emb_dimension,
                           uint experts, float dropout,
                           ENUM_OPTIMIZATION optimization_type, uint batch)
  {
   if(!CNeuronBaseOCL::Init(numOutputs, myIndex, open_cl, units * units, optimization_type, batch))
      return false;
   activation = None;
En primer lugar, se invoca el método homónimo de la clase padre; se trata de una inicialización previa obligatoria del objeto base. Si devuelve false, significa que la infraestructura básica no está lista y que no tiene sentido continuar con el ensamblaje, por lo que el método finaliza inmediatamente con el resultado false. Tras un retorno satisfactorio, desactivamos explícitamente la activación, ya que las funciones de activación concretas de los subcomponentes las configuraremos más adelante de forma individual.
El siguiente paso consiste en inicializar el búfer cGraphs; aquí preparamos el contenedor para registrar los grafones individuales de nuestros expertos. A continuación, se define explícitamente la función de activación SIGMOID para que su lógica interna funcione en el rango deseado.
   int index = 0;
   if(!cGraphs.Init(0, index, OpenCL, Neurons()*experts, optimization, iBatch))
      return false;
   cGraphs.SetActivationFunction(SIGMOID);
A continuación, se declara un conjunto de variables locales para almacenar temporalmente los punteros a los subcomponentes con los que vamos a trabajar durante el montaje paso a paso del modelo.
   CNeuronBaseOCL       *neuron  = NULL;
   CNeuronConvOCL       *conv    = NULL;
   CNeuronTransposeOCL  *transp  = NULL;
   CNeuronDropoutOCL    *dout    = NULL;
   CNeuronSoftMaxOCL    *softmax = NULL;
Pasamos a formar el modelo de generación de probabilidades de uso de los expertos. En primer lugar, vaciamos el array dinámico correspondiente y lo vinculamos al contexto OpenCL.
//--- Probabilidad
   acProbability.Clear();
   acProbability.SetOpenCL(OpenCL);
   index++;
   conv = new CNeuronConvOCL();
   if(!conv ||
      !conv.Init(experts, index, OpenCL, window, window, experts, units, 1, optimization, iBatch) ||
      !acProbability.Add(conv))
     {
      DeleteObj(conv);
      return false;
     }
   conv.SetActivationFunction(SoftPlus);
Y empezamos el ensamblaje secuencial. En primer lugar, creamos una capa convolucional con la no linealidad SoftPlus, lo que proporciona una transformación suave y monótonamente creciente de los logits antes de la siguiente capa. Y a continuación creamos una capa totalmente conectada que devuelve experts números: se trata precisamente de ese vector de logits antes de Dropout.
   index++;
   neuron = new CNeuronBaseOCL();
   if(!neuron ||
      !neuron.Init(0, index, OpenCL, experts, optimization, iBatch) ||
      !acProbability.Add(neuron))
     {
      DeleteObj(neuron);
      return false;
     }
Al igual que antes, si se produce un error de asignación o inicialización, eliminamos correctamente el objeto y finalizamos la inicialización con false.
A continuación, creamos una capa Dropout: es precisamente este objeto el que implementa la exclusión aleatoria de expertos de la que hablábamos antes.
   index++;
   dout = new CNeuronDropoutOCL();
   if(!dout ||
      !dout.Init(0, index, OpenCL, experts, dropout, optimization, iBatch) ||
      !acProbability.Add(dout))
     {
      DeleteObj(dout);
      return false;
     }
Otro paso más es la creación de una capa SoftMax, que convierte los logits obtenidos anteriormente en un vector de probabilidades de importancia de los expertos.
   index++;
   softmax = new CNeuronSoftMaxOCL();
   if(!softmax ||
      !softmax.Init(0, index, OpenCL, experts, optimization, iBatch) ||
      !acProbability.Add(softmax))
     {
      DeleteObj(softmax);
      return false;
     }
   softmax.SetHeads(1);
Luego comienza la preparación del bloque de embeddings de los datos de origen acDataEmb. Lo limpiamos, lo vinculamos a OpenCL y, siguiendo el mismo procedimiento, comenzamos a ensamblarlo a partir de capas convolucionales. Aquí utilizamos una pequeña MLP compuesta por dos capas convolucionales consecutivas con una no linealidad SoftPlus entre ellas.
//--- Embedding de datos
   acDataEmb.Clear();
   acDataEmb.SetOpenCL(OpenCL);
   index++;
   conv = new CNeuronConvOCL();
   if(!conv ||
      !conv.Init(0, index, OpenCL, window, window, 2 * emb_dimension, units, 1, optimization,
                                                                                   iBatch) ||
      !acDataEmb.Add(conv))
     {
      DeleteObj(conv);
      return false;
     }
   conv.SetActivationFunction(SoftPlus);
   index++;
   conv = new CNeuronConvOCL();
   if(!conv ||
      !conv.Init(0, index, OpenCL, 2 * emb_dimension, 2 * emb_dimension, emb_dimension, units,
                                                                   1, optimization, iBatch) ||
      !acDataEmb.Add(conv))
     {
      DeleteObj(conv);
      return false;
     }
   conv.SetActivationFunction(None);
A la salida de esta MLP, esperamos obtener los embeddings de cada paso temporal de la secuencia multimodal analizada. Sin embargo, para generar grafones necesitaremos una copia transpuesta de esta representación. Por eso, a continuación se añade una capa de transposición de datos.
   index++;
   transp = new CNeuronTransposeOCL();
   if(!transp ||
      !transp.Init(0, index, OpenCL, units, emb_dimension, optimization, iBatch) ||
      !acDataEmb.Add(transp))
     {
      DeleteObj(transp);
      return false;
     }
   transp.SetActivationFunction((ENUM_ACTIVATION)conv.Activation());
Después solo nos queda inicializar el objeto de generación de embeddings de nuestros expertos, cExpertsEmb. Aquí se prepara un espacio para sus representaciones individuales.
   index++;
   if(!cExpertsEmb.Init(0, index, OpenCL, units * emb_dimension * experts, optimization, iBatch))
      return false;
//---
   return true;
  }
Por último, si no hay errores, el método devuelve true, lo que indica que el objeto está completamente inicializado y listo para el entrenamiento.
En el comportamiento del método se aprecia un planteamiento claro: primero se prepara un contenedor de grafones, a continuación se construye un pipeline de generación de probabilidades, se forma el embedding de los datos de origen y, por último, se reserva un espacio de parámetros para los expertos. Esta secuencia garantiza un ensamblaje lógico, cómodo para la depuración y la posterior integración con OpenCL.
El método feedForward construye la pasada directa como una fábrica de señales cuidadosamente definida. En primer lugar, guardamos un puntero a la fuente de señal actual en una variable local y creamos otra variable adicional para almacenar temporalmente la referencia a la capa que se está procesando.
bool CNeuronGraphons::feedForward(CNeuronBaseOCL *NeuronOCL)
  {
   CNeuronBaseOCL* prev = NeuronOCL;
   CNeuronBaseOCL* current = NULL;
A continuación, se recorre el bloque de predicción de probabilidades de uso de los expertos. En un ciclo recorremos todos los subcomponentes encargados de generar logits.
//--- Probabilidad
   for(int i = 0; i < acProbability.Total(); i++)
     {
      current = acProbability[i];
      if(!current ||
         !current.FeedForward(prev))
         return false;
      prev = current;
     }
En cada iteración, tomamos el siguiente componente y le pedimos que realice su pasada directa. Si el componente no está presente o su FeedForward devuelve false, finalizamos inmediatamente la ejecución del método con el resultado false. Se trata de una política estricta y fiable de fail-fast que protege contra un ensamblado incorrecto del pipeline.
Una vez ejecutada correctamente la capa, desplazamos el puntero al objeto de datos de origen. La siguiente capa recibirá como entrada la salida de la actual. Como resultado de este ciclo, obtenemos un vector de probabilidades normalizadas.
Luego reinicializamos el puntero a la fuente de datos de origen y recorremos el bloque acDataEmb siguiendo exactamente el mismo patrón. Esta pasada lineal secundaria genera embeddings de los datos de origen.
//--- Embedding de datos
   prev = NeuronOCL;
   for(int i = 0; i < acDataEmb.Total(); i++)
     {
      current = acDataEmb[i];
      if(!current ||
         !current.FeedForward(prev))
         return false;
      prev = current;
     }
A continuación viene una rama pequeña pero importante: si estamos en modo de entrenamiento, llamamos al método de generación de embeddings de los expertos. Esto significa que los parámetros o las representaciones de los expertos se actualizan solo en la pasada de entrenamiento. En el modo de inferencia, damos por hecho que cExpertsEmb ya contiene los pesos preparados, y omitimos este paso para ahorrar tiempo.
//--- Expertos
   if(bTrain)
      if(!cExpertsEmb.FeedForward())
         return false;
Después comienza el álgebra clave. Calculamos las dimensiones auxiliares de la arquitectura del objeto.
//--- Grafos
   uint units = (uint)MathSqrt((double)Neurons());
   uint emb_dim = acDataEmb[-1].Neurons() / units;
   uint experts = cExpertsEmb.Neurons() / acDataEmb[-1].Neurons();
Estos sencillos cálculos garantizan la compatibilidad de los formatos antes de las multiplicaciones matriciales. La primera multiplicación matricial construye, para cada experto, su propia matriz de grafo. El búfer cGraphs resultante contiene de forma ordenada una secuencia de estas matrices para todos los expertos.
   if(!MatMul(cExpertsEmb.getOutput(), current.getOutput(), cGraphs.getOutput(),
              units, emb_dim, units, experts, false))
      return false;
   if(cGraphs.Activation() != None)
      if(!Activation(cGraphs.getOutput(), cGraphs.getOutput(), cGraphs.Activation()))
         return false;
Una vez obtenidas las matrices de grafones sin procesar, se aplica una no linealidad de control. Aquí aplicamos la función de activación seleccionada a todos los elementos del búfer de salida. Este es un paso importante para llevar los valores al rango requerido y añadir la no linealidad deseada.
La reducción final transforma el conjunto de matrices expertas y el vector de probabilidades en un único tensor final del grafo ponderado. En otras palabras, tomamos el vector de pesos normalizados de la última capa acProbability y combinamos las matrices de todos los expertos en un único resultado ponderado.
//--- Resultado
   if(!MatMul(acProbability[-1].getOutput(), cGraphs.getOutput(), Output, 1, experts, units * units, 1, false))
      return false;
//---
   return true;
  }
Si todos los pasos se han completado correctamente, el método devuelve true, lo que confirma la finalización correcta de la pasada directa.
El algoritmo de los métodos de pasada inversa sigue la misma lógica que la pasada directa, pero avanza en sentido contrario. Las señales de error recorren todas las capas en orden inverso; los gradientes se acumulan con precisión y se transmiten de las salidas a las entradas, lo que garantiza un aprendizaje correcto de todos los componentes. Dado que la estructura es totalmente especular respecto al método feedForward y que todos los pasos se pueden seguir fácilmente a partir de la secuencia ya analizada, no tiene sentido detenerse ahora en detalle en cada etapa. Para comprender plenamente y trabajar de forma práctica con todos los métodos de la clase, todo el código, incluida la pasada inversa, se presenta en el archivo adjunto.
Hoy hemos trabajado mucho, y ha llegado el momento de descansar un poco, para que la información se asiente y se organice en nuestra mente. En el próximo artículo continuaremos con el trabajo iniciado y analizaremos en detalle la aplicación práctica de los grafones.
Conclusión
En este artículo hemos analizado en profundidad los aspectos teóricos del framework ST-Expert, que combina los principios del gating flexible, el aprendizaje colectivo y la agregación adaptativa. Hemos analizado cómo la combinación de bloques de generación de probabilidades, embeddings de los datos de entrada y representaciones expertas permite crear modelos resistentes al ruido y a la incertidumbre.
En la parte práctica se presenta la arquitectura de la clase CNeuronGraphons, que permite implementar la construcción y el entrenamiento de grafones. Los métodos descritos constituyen una base sólida para su posterior aplicación práctica.
Enlaces
Programas utilizados en el artículo
| # | Nombre | Tipo | Descripción |
|---|---|---|---|
| 1 | Study.mq5 | Asesor experto | Asesor experto para el entrenamiento offline de modelos |
| 2 | StudyOnline.mq5 | Asesor experto | Asesor experto para el entrenamiento online de modelos |
| 3 | Test.mq5 | Asesor experto | Asesor experto para probar el modelo |
| 4 | Trajectory.mqh | Biblioteca de clases | Estructura de descripción del estado del sistema y la arquitectura de los modelos |
| 5 | NeuroNet.mqh | Biblioteca de clases | Biblioteca de clases para crear una red neuronal |
| 6 | NeuroNet.cl | Biblioteca | Biblioteca de código del programa OpenCL |
Traducción del ruso hecha por MetaQuotes Ltd.
Artículo original: https://www.mql5.com/ru/articles/19595
Advertencia: todos los derechos de estos materiales pertenecen a MetaQuotes Ltd. Queda totalmente prohibido el copiado total o parcial.
Este artículo ha sido escrito por un usuario del sitio web y refleja su punto de vista personal. MetaQuotes Ltd. no se responsabiliza de la exactitud de la información ofrecida, ni de las posibles consecuencias del uso de las soluciones, estrategias o recomendaciones descritas.
 Desarrollo de asesores expertos autooptimizables en MQL5 (Parte 11): Una introducción sencilla a los fundamentos del álgebra lineal
 Robot de trading multiflujo con aprendizaje automático: del concepto a la implementación
 Particularidades del trabajo con números del tipo double en MQL4
 Red neuronal en la práctica: Descenso de gradiente estocástico

- Aplicaciones de trading gratuitas
- 8 000+ señales para copiar
- Noticias económicas para analizar los mercados financieros
Usted acepta la política del sitio web y las condiciones de uso