

Neuronale Netze im Trading: Ein domänenübergreifendes Framework zur Zeitreihenprognose (Fazit)
 24
 0

Einleitung
In den letzten Jahrzehnten hat sich der Finanzhandel grundlegend gewandelt und sich zu einem hochtechnisierten und äußerst disziplinierten Bereich entwickelt. Während der Erfolg eines Händlers früher weitgehend von Intuition, Erfahrung und persönlichen Beobachtungen abhing, steht heute die Fähigkeit im Vordergrund, riesige Datenmengen schnell und effektiv zu verarbeiten, präzise Prognosen zu erstellen und Entscheidungen auf der Grundlage fortschrittlicher Algorithmen zu treffen. Dank der zunehmenden Rechenleistung und der Entwicklung moderner Methoden des maschinellen Lernens stehen Händlern und Forschern nun neue Werkzeuge zur Verfügung, mit denen sich Muster und Trends im scheinbaren Chaos der Marktdaten erkennen lassen. Dennoch bleibt die kurz- und mittelfristige Prognose von Zeitreihen an den Finanzmärkten trotz erheblicher Fortschritte eine äußerst komplexe Aufgabe.
Der Grund dafür liegt in der Einzigartigkeit und Komplexität der Finanzmärkte. Finanzmärkte sind Systeme mit hohem Rauschanteil – in denen echte Signale oft durch eine Vielzahl zufälliger Schwankungen und Artefakte überdeckt werden. Marktdaten sind nichtstationär: Ihre statistischen Eigenschaften ändern sich im Laufe der Zeit, was sich in Wechseln zwischen verschiedenen Marktphasen äußert – von ruhigen Phasen zu volatilen und wieder zurück. Zudem unterliegen Märkte plötzlichen Ereignissen – wie beispielsweise Nachrichten, Krisen oder regulatorischen Eingriffen –, die die üblichen Kursmuster stören. All dies schafft ein Umfeld, in dem traditionelle Zeitreihenmodelle an ihre Grenzen stoßen.
Klassische statistische Methoden haben sich bei der Analyse stationärer Prozesse als wirksam erwiesen; ihre Anwendbarkeit auf moderne Marktdaten ist jedoch begrenzt. Andererseits werden neuronale Netze – darunter LSTM und GRU – vielfach als flexiblere Werkzeuge zur Modellierung komplexer zeitlicher Abhängigkeiten eingesetzt. Allerdings benötigen sie auch große Datenmengen für das Training, und beim Übergang zu neuen Handelsinstrumenten oder Marktbedingungen verlieren sie oft an Genauigkeit und Stabilität. Der Grund dafür ist, dass die meisten Modelle an bestimmte Datenstrukturen und Muster gebunden sind, die nicht immer allgemeingültig sind.
In diesem Zusammenhang stellt sich eine zentrale Herausforderung: Wie lässt sich ein Modell entwickeln, das ohne zusätzliches Training generalisieren und sich anpassen kann – dies wird als Zero-Shot-Vorhersage bezeichnet. Ein solches Modell, das mit einer großen Anzahl vielfältiger Zeitreihen aus verschiedenen Domänen trainiert wurde, sollte über eine interne Repräsentation verfügen, die es ihm ermöglicht, ähnliche Muster und Regelmäßigkeiten in völlig neuen, bisher nicht gesehenen Daten zu erkennen. Dies verändert den Vorhersageansatz grundlegend: Das Modell ist nicht länger ein Spezialist für einen einzelnen Markt, sondern wird zu einem vielseitigen Analysten, der in der Lage ist, Wissen über verschiedene Aufgaben hinweg zu übertragen.
Das TimeFound-Framework, mit dem wir uns im vorherigen Artikel erstmals beschäftigt haben, wurde speziell für dieses Konzept entwickelt. TimeFound ist ein leistungsstarkes und vielseitiges domänenübergreifendes Zeitreihenmodell, das auf der Transformer-Architektur basiert. Transformer, eine revolutionäre Methode, die ursprünglich für Aufgaben der natürlichen Sprachverarbeitung vorgeschlagen wurde, hat aufgrund ihrer Fähigkeit, weitreichende Abhängigkeiten in Sequenzen effektiv zu erfassen, breite Anwendung gefunden. In TimeFound wird dieses Potenzial zur Analyse finanzieller Zeitreihen genutzt, allerdings mit einer wichtigen Ergänzung: dem Multi-Resolution-Patching-Mechanismus.
Die Idee hinter dem Multi-Resolution-Patching besteht darin, die ursprüngliche Zeitreihe in Patches zu unterteilen – Segmente unterschiedlicher Länge, die verschiedene Zeitskalen widerspiegeln. So erfassen beispielsweise kurze Patches lokale und schnelle Schwankungen, während längere Patches langsamere, globalere Trends erfassen. Dieser mehrstufige Ansatz ermöglicht es dem Modell, mehrere Informationsebenen gleichzeitig zu berücksichtigen, was für Finanzdaten von entscheidender Bedeutung ist, da Signale dort über verschiedene Zeithorizonte hinweg entstehen.
Aus technischer Sicht besteht die TimeFound-Architektur aus einer Reihe unabhängiger Projektionsmodule – jeweils eines für jede Gruppe von Patches einer bestimmten Skala. Jedes dieser Module besteht aus einem kleinen zweischichtigen Perzeptron mit Residual Connections. Es nimmt Patches und binäre Masken gültiger Punkte als Eingabe entgegen, wodurch es Padding und künstlich aufgefüllte fehlende Werte effektiv ignorieren kann. Dank separater Projektionsmodule und der Besonderheiten der Patch-Wiederholung unterscheidet das Modell den Beitrag jeder Zeitskala, was für Robustheit gegenüber Phasenverschiebungen, Schwankungen in der Länge der Eingabedaten und fehlenden Werten sorgt.
Um TimeFound zu trainieren, wurde ein umfangreicher Datensatz mit Zeitreihen aus sehr unterschiedlichen Domänen – von makroökonomischen Indikatoren über Marktdaten bis hin zu physikalischen Prozessen – zusammengestellt und sorgfältig aufbereitet. Dadurch konnte das Modell die Fähigkeit entwickeln, zu verallgemeinern und bei neuen, bisher unbekannten Daten gute Ergebnisse zu erzielen.
Nachfolgend ist eine eigens erstellte Visualisierung des Frameworks dargestellt.
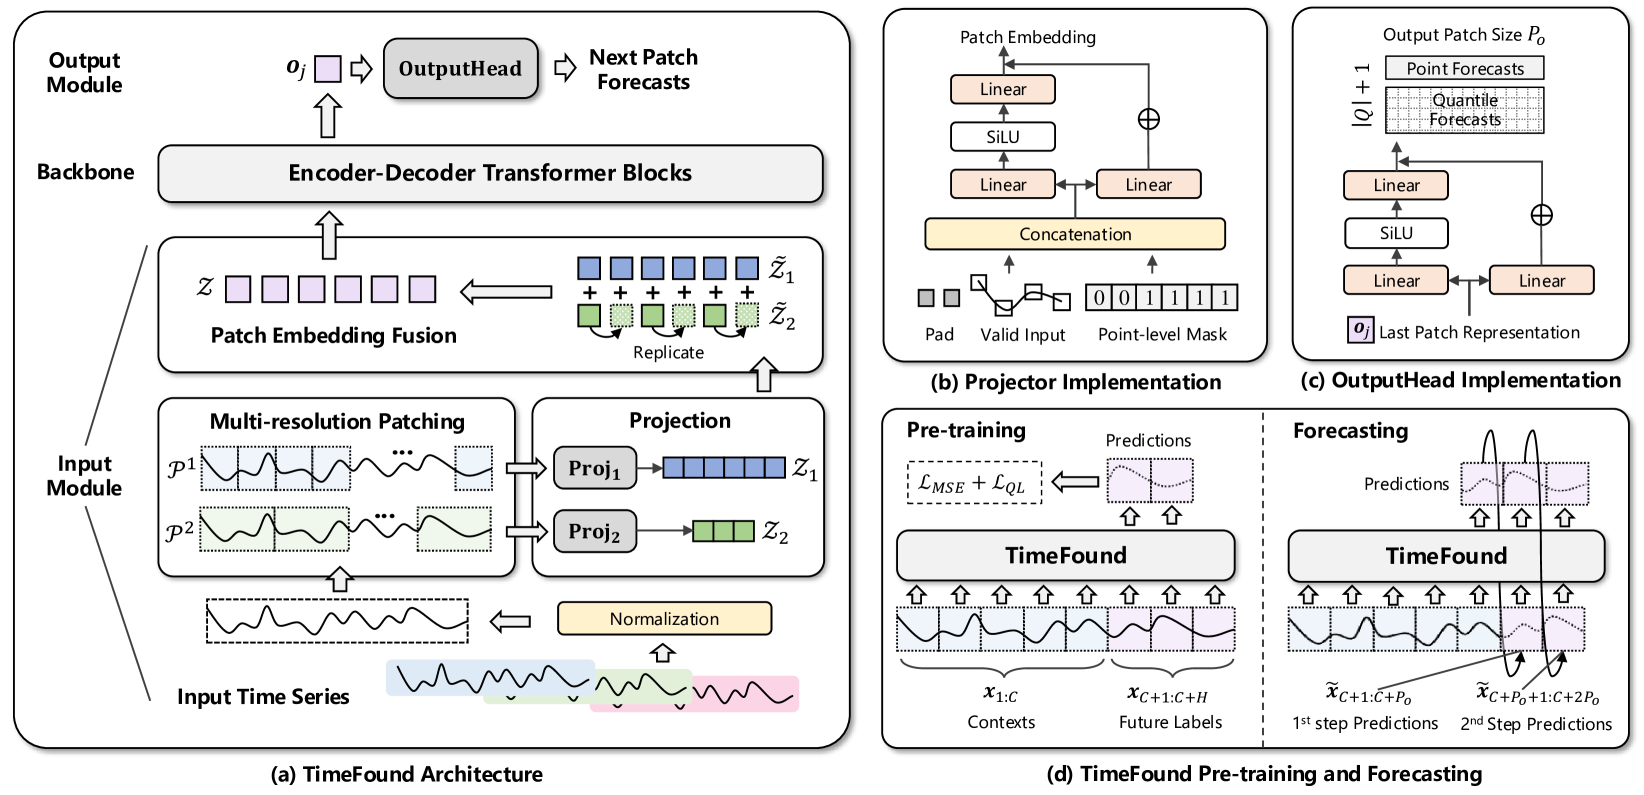
Im praktischen Teil des vorherigen Artikels haben wir uns eingehend mit der Implementierung des Multi-Scale-Patching-Moduls befasst – einer Schlüsselkomponente des Datenaufbereitungsblocks des TimeFound-Frameworks. Dieses Modul ist dafür zuständig, auf effiziente Weise informative Token zu generieren – kompakte, informationsreiche Darstellungen einzelner Fragmente einer Zeitreihe, die in Patches unterschiedlicher Länge und Skala unterteilt ist. Gerade dank dieses Mechanismus ist das Modell in der Lage, Daten zu erfassen und zu verarbeiten und dabei sowohl lokale als auch globale Marktmerkmale zu berücksichtigen.
Heute werden wir die Arbeit fortsetzen, die wir begonnen haben.
TimeFound-Encoder–Decoder
Der Token-Tensor, der während der Patching-Phase gebildet wird, wird zur weiteren Analyse an den Transformer-Block übergeben. Hier beginnt die intelligente Datenverarbeitung – das Erkennen verborgener Muster, die Prognose der Dynamik und das Generieren von Signal
Die Autoren des TimeFound-Frameworks schlagen vor, in diesem Teil der Architektur die klassische Encoder–Decoder-Architektur zu verwenden, die aus Modellen der maschinellen Übersetzung und der Sequenzanalyse bekannt ist. Im Zusammenhang mit Zeitreihen wurde dieses Schema jedoch angepasst und durch eine Reihe von Ergänzungen erweitert, um den spezifischen Eigenschaften der Daten Rechnung zu tragen.
Der Encoder nutzt bidirektionale Self-Attention. Das bedeutet, dass jedes Token im Kontext aller anderen analysiert wird, sowohl vorwärts als auch rückwärts entlang der Zeitachse. Somit kann das Modell nicht nur berücksichtigen, was bis zum aktuellen Zeitpunkt geschehen ist, sondern auch mögliche Abhängigkeiten von Ereignissen, die später eintreten. Dies ist besonders nützlich bei der Analyse bereits abgeschlossener Segmente historischer Daten. Dieser Ansatz ermöglicht es, tiefere Zusammenhänge zu identifizieren.
Im Decoder hingegen ist die Sichtbarkeit bewusst eingeschränkt: Jedes Token kann nur diejenigen sehen, die zeitlich vor ihm liegen. Eine zentrale Komponente des Decoders ist das Cross-Attention-Modul (Cross-Attention). Hier werden die vom Encoder empfangenen Daten als Kontext bereitgestellt, und der Decoder setzt die Eingabetoken mit diesen Kontextinformationen in Beziehung. Dies ermöglicht genauere Prognosen der Ausgabewerte.
Diese Aufgabenteilung zwischen Encoder und Decoder sowie der Einsatz von Attention-Mechanismen machen die TimeFound-Architektur besonders flexibel. Sie ist nicht nur in der Lage, auf jüngste Kursbewegungen zu reagieren, sondern auch das Verhalten eines Assets in einem breiten historischen Kontext zu analysieren, dabei Marktmuster zu berücksichtigen und zwischen gewöhnlichem Rauschen und aussagekräftigen Signalen zu unterscheiden.
Unsere Bibliothek umfasst bereits eine breite Palette an Varianten von Self- und Cross-Attention-Modulen – von einfachen bis hin zu fortgeschrittenen Versionen mit Maskierung und dynamischer Auswahl der Attention-Heads. Und natürlich werden wir uns die Gelegenheit nicht entgehen lassen, im Rahmen der Umsetzung des TimeFound-Modells auf diesen Vorarbeiten aufzubauen. Allerdings ist es wichtig, an dieser Stelle auf eine konzeptionelle Nuance hinzuweisen: Die Autoren des Frameworks schlagen vor, zur Prognoseerstellung einen autoregressiven Ansatz zu verwenden.
Das Modell erstellt nicht in einem einzigen Schritt eine Prognose für den gesamten Zeitraum. Stattdessen arbeitet es iterativ. Bei jeder Iteration nimmt der Transformer historische Daten als Eingabe entgegen – einen Token-Tensor, der verschiedene Skalen von Marktmustern darstellt – und generiert ein einzelnes Token, das dem nächsten Segment entspricht. Dieses Token wird als Prognosezustand interpretiert. Das Ergebnis wird zu den historischen Daten hinzugefügt, und der Vorgang wird wiederholt. Somit wird die Prognose Schritt für Schritt über den gesamten relevanten Horizont hinweg erstellt.
In unserem Fall zielen wir nicht darauf ab, Prognosen weit in die Zukunft zu erstellen. Wir betreiben keine Wahrsagerei, sondern entwickeln einen systematischen Algorithmus für die Positionsverwaltung. Das Modell wird bei jedem neuen Kursbalken ausgeführt, berechnet den Zustand auf Grundlage tatsächlicher, bereits bekannter Daten neu und gibt eine Entscheidung aus: Position halten, schließen, umkehren oder die Positionsgröße erhöhen. Natürlich erstellen wir bei der Ausführung eines Trades eine Prognose über einen bestimmten Zeithorizont, passen sie jedoch bei jedem neuen Kursbalken an die aktualisierte Realität an.
Dennoch stellt das Prinzip der Autoregression selbst bestimmte Anforderungen an die Architektur. Bei jedem Schritt muss derselbe Satz historischer Daten sowohl in den Encoder als auch in den Decoder eingespeist werden. Der Encoder analysiert diese Daten im Kontext der gesamten Historie und identifiziert dabei allgemeine Muster, während der Decoder den aktuellen Zustand – der Teil derselben historischen Sequenz ist – nutzt, um ihn im Kontext der vom Encoder identifizierten historischen Abhängigkeiten zu analysieren und Prognosewerte zu generieren. Auf diese Weise erhalten wir zwei parallele Verarbeitungsströme, die mit denselben Daten arbeiten.
Um diese Synchronisation sicherzustellen, erstellen wir ein CNeuronTimeFoundTransformerUnit-Objekt. Sein Zweck besteht darin, den Informationsfluss zentral zu steuern. Dies trägt dazu bei, eine übersichtliche Architektur beizubehalten und künftige Skalierungen oder den Austausch von Komponenten zu vereinfachen. Die Struktur des neuen Objekts ist unten dargestellt.
class CNeuronTimeFoundTransformerUnit  :  public CNeuronCrossDMHAttention
  {
protected:
   CNeuronMVMHAttentionMLKV   cSelfAttention;
   //---
   virtual bool      feedForward(CNeuronBaseOCL *NeuronOCL) override;
   virtual bool      feedForward(CNeuronBaseOCL *NeuronOCL, CBufferFloat *SecondInput) override
                                                              { return feedForward(NeuronOCL); }
   virtual bool      calcInputGradients(CNeuronBaseOCL *prevLayer) override;
   virtual bool      calcInputGradients(CNeuronBaseOCL *NeuronOCL, CBufferFloat *SecondInput,
                                        CBufferFloat *SecondGradient, ENUM_ACTIVATION SecondActivation = None)
                                        override
                                        { return calcInputGradients(NeuronOCL); }
   virtual bool      updateInputWeights(CNeuronBaseOCL *NeuronOCL) override;
   virtual bool      updateInputWeights(CNeuronBaseOCL *NeuronOCL, CBufferFloat *SecondInput) override
                                        { return updateInputWeights(NeuronOCL); }

public:
                     CNeuronTimeFoundTransformerUnit(void) {};
                    ~CNeuronTimeFoundTransformerUnit(void) {};
   //---
   virtual bool      Init(uint numOutputs, uint myIndex, COpenCLMy *open_cl, uint window,
                          uint window_key, uint heads, uint heads_kv, uint units_count,
                          uint layers, uint layers_to_one_kv, uint variables,
                          ENUM_OPTIMIZATION optimization_type, uint batch);
   //---
   virtual int       Type(void) override const { return defNeuronTimeFoundTransformerUnit; }
   //---
   virtual bool      Save(int const file_handle) override;
   virtual bool      Load(int const file_handle) override;
   virtual bool      WeightsUpdate(CNeuronBaseOCL *source, float tau) override;
   virtual void      SetOpenCL(COpenCLMy *obj) override;
  };
In der dargestellten Struktur der neuen Klasse sehen wir nur ein internes Objekt – das Self-Attention-Modul, das als Encoder für das zu erstellende Modell dient. Die Funktionalität des Decoders wird mithilfe der übergeordneten Klasse implementiert, bei der es sich um ein Cross-Attention-Modul handelt.
Hinter dieser scheinbaren Einfachheit verbirgt sich jedoch ein sorgfältig ausgearbeiteter Algorithmus. Die Rolle des Encoders wird vom unabhängigen Kanalanalyseblock CNeuronMVMHAttentionMLKV übernommen. Sein Hauptmerkmal ist die Fähigkeit, jede univariate Sequenz – also jede Variable oder jeden Indikator – separat eigenständig zu analysieren. Werden beispielsweise Preise, Volumina und Volatilität in das Modell eingespeist, ermittelt CNeuronMVMHAttentionMLKV kausale Zusammenhänge innerhalb jeder Zeitreihe, ohne die Signale in einem frühen Stadium zu vermischen. Dadurch wird störendes Rauschen zwischen den Signalen reduziert, und das Modell kann die Struktur der einzelnen Datenquellen besser erfassen, was die Interpretierbarkeit der erzielten Ergebnisse erheblich verbessert.
Zusätzliche Effizienz ergibt sich aus der Verwendung des Multi-Layer-Key-Value-Mechanismus (MLKV) – einer der elegantesten Ideen zur Optimierung der Rechenkomplexität der Transformer-Architektur. In klassischen Implementierungen verwendet jede Self-Attention-Schicht ihre eigenen Key- und Value-Tensoren. Hier werden diese Tensoren jedoch gespeichert und über mehrere Schichten hinweg wiederverwendet, während der Query-Tensor auf jeder Ebene verfeinert wird. Dieser Ansatz verringert den Rechenaufwand und ermöglicht es gleichzeitig, Repräsentationen schrittweise zu verfeinern – so, als würden wir einen vertrauten Text erneut lesen und dabei jedes Mal neue Details entdecken. Dies ist insbesondere im Trading von großem Wert: Beim ersten Durchlauf kann das Modell lokale Muster identifizieren und anschließend zunehmend allgemeinere Marktstrukturen erkennen.
In dieser Implementierung erfüllt der Encoder somit einen doppelten Zweck:
- Einerseits ermittelt die klassische bidirectionale Self-Attention Beziehungen zwischen Token in beide Richtungen entlang der Zeitachse.
- Andererseits ermöglicht er eine modulare Analyse jeder univariaten Sequenz und damit ein vielschichtiges Verständnis ihrer Struktur.
Kommen wir nun zum Decoder. In diesem Abschnitt verwenden wir das CNeuronCrossDMHAttention-Modul, das diversifizierte Multi-Head-Cross-Attention implementiert. Zudem bietet es eine Reihe architektonischer Vorteile.
Zunächst umfasst der Decoder gemäß der Standard-Transformer-Architektur zwei Arten von Attention-Modulen:
- Self-Attention – analysiert die Beziehungen zwischen den Token im Hauptdatenstrom;
- Cross-Attention – bereichert diese Token mit Kontextinformationen, die vom Encoder bereitgestellt werden.
In beiden Fällen werden Module zur relativen Positionskodierung verwendet. Das bedeutet, dass der Attention-Block nicht nur die absolute Position des Tokens berücksichtigt, sondern auch dessen relative Position im Verhältnis zu anderen Token. Darüber hinaus wird dieser Attention-Mechanismus durch drei Arten von Biases ergänzt:
- ein inhaltsabhängiger Positions-Bias,
- ein globaler Kontext-Bias,
- ein globaler Positions-Bias.
Dadurch kann das Modell nicht nur die Abstände zwischen den Ereignissen, sondern auch die qualitativen Beziehungen zwischen ihnen genauer berücksichtigen – was für die Analyse sequenzieller Marktdaten von entscheidender Bedeutung ist.
Auf das Attention-Modul folgt der Multi-Head-FeedForward-Block. Sein Zweck besteht darin, eine unabhängige nichtlineare Verarbeitung in verschiedenen Merkmalsunterräumen durchzuführen. Dadurch lässt sich eine Vielzahl von Marktmustern erkennen, ohne dabei wichtige strukturelle Elemente der Sequenz aus den Augen zu verlieren.
Es ist außerdem wichtig, auf einen wesentlichen Unterschied zwischen den Komponenten der Architektur hinzuweisen. Im Gegensatz zum Encoder trennt der Decoder univariate Sequenzen nicht voneinander. Während im Encoder jede Variable isoliert analysiert wird, wobei unabhängige univariate Sequenzen erhalten bleiben, werden im Decoder alle Token zu einem einzigen Datenstrom zusammengefasst. Zu diesem Zeitpunkt gibt es keine Grenzen mehr zwischen den univariaten Sequenzen – das Modell betrachtet sie als eine Einheit.
Dadurch kann der Decoder domänenübergreifende Abhängigkeiten analysieren. Das heißt, Zusammenhänge zwischen Variablen, die bei einer Betrachtung im Einzelnen möglicherweise nicht offensichtlich sind. Der Kurs lässt sich nicht nur durch seine eigene Entwicklung erklären, sondern auch durch Volatilität, Handelsvolumen oder beispielsweise die Nachrichtenlage. All diese Abhängigkeiten treten gerade in den Cross-Attention-Blöcken zutage, wo die Token des aktuellen Zustands mit den vom Encoder kodierten Informationen angereichert werden.
Das Ergebnis ist eine leistungsstarke, interpretierbare Architektur, in der das kompakte und elegante Encoder-Modul CNeuronMVMHAttentionMLKV mit einem flexiblen und adaptiven Decoder auf Basis von CNeuronCrossDMHAttention kombiniert wird. Dieses Modell lässt sich gut skalieren, eignet sich für verschiedene Arten von Marktdaten und zeichnet sich durch eine hohe Recheneffizienz aus.
Der Encoder wird statisch deklariert, wodurch wir den Konstruktor und den Destruktor der Klasse leer lassen können. Vererbte und deklarierte Komponenten werden zentral in der Methode Init initialisiert. Die Methodenparameter stellen eine Reihe von Konstanten bereit, die es uns ermöglichen, die Architektur des zu erstellenden Objekts eindeutig zu interpretieren.
bool CNeuronTimeFoundTransformerUnit::Init(uint numOutputs, uint myIndex, COpenCLMy *open_cl, uint window,
                                           uint window_key, uint heads, uint heads_kv, uint units_count,
                                           uint layers, uint layers_to_one_kv, uint variables,
                                           ENUM_OPTIMIZATION optimization_type, uint batch)
  {
   if(!CNeuronCrossDMHAttention::Init(numOutputs, myIndex, open_cl, window, window_key, variables, window,
                                      units_count * variables, heads, layers, optimization_type, batch))
      return false;
   SetActivationFunction(None);
Im Methodenkörper rufen wir zunächst die gleichnamige Methode der übergeordneten Klasse auf, die bereits den Algorithmus zur Initialisierung geerbter Objekte und Schnittstellen implementiert.
An dieser Stelle lohnt es sich, einen genaueren Blick auf die Initialisierungsparameter zu werfen, die an die Methode der übergeordneten Klasse übergeben werden. Zunächst ist anzumerken, dass das übergeordnete Objekt – im Gegensatz zu dem, das wir gerade erstellen – zwei Eingabedatenströme benötigt: die zu analysierenden Daten und den Kontext. Wir planen jedoch, am Eingang des Objekts nur einen Datenstrom zu empfangen. Der Kontext wird vom Encoder innerhalb des Moduls gebildet.
Darüber hinaus wird dem Objekt als Eingabedaten eine multimodale Sequenz von Token übergeben, die das zu analysierende historische Datenfenster beschreibt. Jede univariate Sequenz wird durch eine Reihe von Token dargestellt, wobei jedes Token einem einzelnen Patch entspricht – einem lokalen Segment der Zeitreihe. Diese Patches ermöglichen es dem Modell, sich auf lokale Veränderungen und Muster zu konzentrieren und dabei kurzfristige Abhängigkeiten innerhalb jeder Variablen zu erkennen.
Die Ausgabe des Objekts soll für jede univariate Sequenz nur ein Token enthalten, wobei jedes Token die codierte Prognose für das nächste Segment der analysierten multimodalen Zeitreihe darstellt. Gleichzeitig ist die Transformer-Architektur so konzipiert, dass die Dimensionen des Hauptinformationsflusses erhalten bleiben.
Vor diesem Hintergrund haben wir beschlossen, nur die Token, die das letzte Segment des Umgebungszustands beschreiben, in den Hauptpfad des Decoders einzuspeisen: je eines für jede univariate Sequenz. Gleichzeitig werden alle empfangenen Informationen, die im Encoder um interne Abhängigkeiten ergänzt wurden, durch einen zusätzlichen Informationsfluss geleitet.
Nachdem die Methode der übergeordneten Klasse erfolgreich ausgeführt wurde, fahren wir mit der Initialisierung des Encoders fort. Hier geben wir die Gesamtlänge der analysierten Sequenz an.
   if(!cSelfAttention.Init(0, 0, OpenCL, window, window_key, heads, heads_kv, units_count, layers, layers_to_one_kv,
                           variables, optimization, iBatch))
      return false;
   cSelfAttention.SetActivationFunction(None);
//---
   return true;
  }
Bitte beachten Sie, dass der Encoder und der Decoder in unserer Implementierung Objekte mit einer mehrschichtigen Architektur verwenden. Wir verwenden in beiden Modulen die gleiche Anzahl von Schichten.
Der nächste Schritt unserer Arbeit besteht darin, einen Algorithmus für den Vorwärtsdurchlauf unseres Objekts zu entwickeln. Der Algorithmus ist recht einfach – wir müssen lediglich die entsprechenden Methoden aufrufen: zuerst die des Encoders und dann die des Decoders. Es ist jedoch wichtig, bestimmte Feinheiten der Informationsflüsse zu beachten. In den Methodenparametern erhalten wir einen Zeiger auf das Quelldatenobjekt. Darin erwarten wir Daten in Form eines dreidimensionalen Tensors [Sequenzlänge × Variable × Token-Größe]. Das ist genau die Datenanordnung, die wir für den Encoder benötigen, und wir übergeben ihm direkt einen Zeiger auf das Objekt.
bool CNeuronTimeFoundTransformerUnit::feedForward(CNeuronBaseOCL *NeuronOCL)
  {
   if(!cSelfAttention.FeedForward(NeuronOCL))
      return false;
Wir haben vereinbart, die Token des Segments, das den jüngsten Umgebungszustand enthält, als Eingabedaten für den Hauptinformationsfluss des Decoders zu verwenden. Wir wissen jedoch, dass die analysierten Daten in umgekehrter chronologischer Reihenfolge in das Modell eingespeist werden: Die aktuellsten Daten kommen zuerst. Daher befinden sich die benötigten Token am Anfang des Quelldatenpuffers. Wir machen uns diesen Umstand zunutze und überspringen den Schritt des Kopierens des benötigten Datenfragments. Stattdessen übergeben wir einfach einen Zeiger auf das Quelldatenobjekt über den Hauptinformationsfluss und die Ausgabe des Encoders über den Hilfsfluss.
   if(!CNeuronCrossDMHAttention::feedForward(NeuronOCL, cSelfAttention.getOutput()))
      return false;
//---
   return true;
  }
Anschließend schließen wir die Methode ab, indem wir zunächst das boolesche Ergebnis der Operationen an das aufrufende Programm zurückgeben.
Ich schlage vor, dass Sie sich die Algorithmen für die Rückwärtsdurchlauf-Methoden selbst genauer ansehen. Der vollständige Quellcode für die CNeuronCrossDMHAttention-Klasse und alle ihre Methoden ist im Anhang enthalten.
Modellarchitektur
Sobald wir alle erforderlichen Objekte erstellt haben, aus denen sich die strukturellen Komponenten unseres Modells zusammensetzen, gehen wir zur nächsten Phase über – dem Aufbau einer kohärenten Architektur. An dieser Stelle ist es wichtig zu beachten, dass wir – wie bereits bei unseren früheren Entwicklungen – einen Trading-Agent entwickeln, der im Rahmen des Reinforcement Learning arbeitet.
Im Rahmen der vorliegenden Aufgabe dient das TimeFound-Framework ausschließlich der Analyse des Umgebungszustands – der Vorverarbeitung von Marktdaten und der Identifizierung verborgener Muster in historischen Zeitreihen. In dieser Funktion wird die entsprechende Komponente in die Architektur des Environment Encoders integriert; dieser stellt dem restlichen Modell eine strukturierte, bereinigte und interpretierbare Darstellung der aktuellen Marktsituation bereit.
Innerhalb des gesamten Trading-Agenten folgen wir der Actor–Director–Critic-Struktur, bei der jede Komponente eine genau definierte Aufgabe erfüllt. In seiner derzeitigen Implementierung besteht das System aus vier eigenständigen Modellen, die zusammenarbeiten:
- Der Environment State Encoder (Encoder) ist für die gründliche Analyse der eingehenden Marktdaten zuständig. Er identifiziert stabile Muster in der analysierten Zeitreihe und erzeugt so eine reichhaltige Repräsentation des aktuellen Handelskontexts. Diese Darstellung wird dann an den Actor weitergeleitet.
- Der Actor (Actor) ist das zentrale Element des Agenten. Auf Grundlage der Eingabedaten, die er vom Encoder erhält, generiert er konkrete Handelsentscheidungen.
- Director (Director) und Critic (Critic) sind Bewertungssubsysteme. Sie bewerten die vom Actor getroffenen Entscheidungen anhand eines internen Modells der Zukunft und prognostizieren mögliche Konsequenzen. Zudem liefert der Director eine restriktivere binäre Bewertung – nämlich, ob ein solches Verhalten überhaupt erwägenswert ist –, während der Critic eine quantitative Metrik der erwarteten Belohnung bereitstellt. Gemeinsam erzeugen sie das Feedback-Signal, das der Agent benötigt, um zu lernen und sich an veränderte Marktbedingungen anzupassen.
Dieser Ansatz gewährleistet die Modularität und Flexibilität des Systems: Jede Komponente kann unabhängig verbessert oder an eine bestimmte Klasse von Handelsstrategien angepasst werden.
Die Architektur aller Modelle wird in der Methode CreateDescriptions definiert, die Zeiger auf vier dynamische Arrays (eines für jedes Modell) als Parameter entgegennimmt. Jedes davon speichert eine eindeutige Sequenz von Objekten, die eine vollständige Darstellung des zu erstellenden Modells liefert.
bool CreateDescriptions(CArrayObj *&encoder,
                        CArrayObj *&actor,
                        CArrayObj *&director,
                        CArrayObj *&critic
                       )
  {
//---
   CLayerDescription *descr;
//---
   if(!encoder)
     {
      encoder = new CArrayObj();
      if(!encoder)
         return false;
     }
   if(!actor)
     {
      actor = new CArrayObj();
      if(!actor)
         return false;
     }
   if(!director)
     {
      director = new CArrayObj();
      if(!director)
         return false;
     }
   if(!critic)
     {
      critic = new CArrayObj();
      if(!critic)
         return false;
     }
Beginnen wir mit dem Encoder. Wir planen, einen Tensor mit der Historie der Zeitreihe in das Modell einzuspeisen und dessen Daten sofort an eine vollständig verbundene Schicht mit ausreichender Dimensionalität weiterzuleiten. Diese Schicht dient als eine Art Eingangsfilter für das Modell. Wir legen die Anzahl der Neuronen so fest, dass sie dem Produkt aus der Anzahl der historischen Kursbalken und der Anzahl der Deskriptoren pro Kursbalken entspricht. Auf diese Weise können wir alle Informationen über Kursdynamik, Volumina und andere Indikatoren bewahren.
//--- Encoder
   encoder.Clear();
//--- Input layer
   if(!(descr = new CLayerDescription()))
      return false;
   descr.type = defNeuronBaseOCL;
   int prev_count = descr.count = (HistoryBars * BarDescr);
   descr.activation = None;
   descr.optimization = ADAM;
   if(!encoder.Add(descr))
     {
      delete descr;
      return false;
     }
Als Nächstes folgt die BatchNormWithNoise-Schicht. Sie dient dazu, den Trainingsprozess zu stabilisieren und eine kleine stochastische Komponente einzuführen, die dem Modell hilft, während der Optimierung nicht in lokalen Minima stecken zu bleiben. An dieser Stelle kommt die Rauschsteuerung ins Spiel: Während des Normalisierungsprozesses werden zufällige Schwankungen hinzugefügt, um eine bessere Generalisierungsleistung auf realen Marktdaten zu gewährleisten, die häufig verrauscht sind.
//--- layer 1
   if(!(descr = new CLayerDescription()))
      return false;
   descr.type = defNeuronBatchNormWithNoise;
   descr.count = prev_count;
   descr.batch = BatchSize;
   descr.activation = None;
   descr.optimization = ADAM;
   if(!encoder.Add(descr))
     {
      delete descr;
      return false;
     }
Nachdem wir die Daten normalisiert haben, fügen wir mithilfe des Moduls ConcatDiff einige Informationen zu deren Dynamik hinzu. Diese Schicht berechnet erste Differenzen entlang der Zeitachse und fügt sie den Originaldaten als neue Kanäle hinzu, sodass das Modell die Änderungsraten der Indikatoren besser erfassen kann.
//--- layer 2
   if(!(descr = new CLayerDescription()))
      return false;
   descr.type = defNeuronConcatDiff;
   prev_count = descr.count = HistoryBars;
   descr.layers = BarDescr;
   descr.step = 1;
   descr.batch = BatchSize;
   descr.optimization = ADAM;
   descr.activation = None;
   if(!encoder.Add(descr))
     {
      delete descr;
      return false;
     }
Als Nächstes folgt Mamba4CastEmbedding – hier führen wir eine zeitliche Kodierung für jeden historischen Kursbalken ein. Wir legen Harmonische mit zwei Periodizitäten fest – stündlich und täglich –, damit das Modell tägliche Muster und Intraday-Schwankungen erfasst. Anschließend werden die Embeddings der einzelnen Kursbalken zu einer Gesamtrepräsentation zusammengeführt.
//--- layer 3
   if(!(descr = new CLayerDescription()))
      return false;
   descr.type = defMamba4CastEmbeding;
   prev_count = descr.count = HistoryBars;
   descr.window = 2 * BarDescr;
   int prev_out = descr.window_out = NSkills;
     {
      int temp[] = {PeriodSeconds(PERIOD_H1), PeriodSeconds(PERIOD_D1)};
      if(ArrayCopy(descr.windows, temp) < (int)temp.Size())
         return false;
     }
   descr.batch = BatchSize;
   descr.optimization = ADAM;
   descr.activation = None;
   if(!encoder.Add(descr))
     {
      delete descr;
      return false;
     }
Sobald das Embedding bereit ist, fahren wir mit TimeFoundPatching fort. Das Modul unterteilt den resultierenden Tensor in eine vorgegebene Anzahl gleich großer Segmente (Patches) und ordnet sie in einer einzigen Matrix an. Jeder Patch enthält Informationen zur lokalen Dynamik, und zusammen dienen sie als Eingabe für den Transformer-Block.
//--- layer 4
   if(!(descr = new CLayerDescription()))
      return false;
   descr.type = defNeuronTimeFoundPatching;
   descr.count = prev_count;
   prev_count=descr.window = Segments;
   descr.variables = prev_out;
   descr.window_out = EmbeddingSize;
   descr.step = 8;
   descr.batch = BatchSize;
   descr.optimization = ADAM;
   descr.activation = None;
   if(!encoder.Add(descr))
     {
      delete descr;
      return false;
     }
Und hier kommt unsere zentrale Schicht ins Spiel: TimeFoundTransformerUnit. Dieses Objekt ermöglicht es dem Modell, jede univariate Sequenz einzeln zu analysieren und gleichzeitig domänenübergreifende Abhängigkeiten zu erkennen.
//--- layer 5
   if(!(descr = new CLayerDescription()))
      return false;
   descr.type = defNeuronTimeFoundTransformerUnit;
   descr.count = prev_count;
   descr.window = EmbeddingSize;
   descr.window_out =descr.window/4;
   {
      int temp[]={4,2};
      if(ArrayCopy(descr.heads,temp)<ArraySize(temp))
        return false;
   }
   descr.layers=3;
   descr.step=3;
   descr.variables=prev_out;
   descr.batch = BatchSize;
   descr.activation = None;
   descr.optimization = ADAM;
   if(!encoder.Add(descr))
     {
      delete descr;
      return false;
     }
Am Ausgang des Transformers erwarten wir für jeden analysierten Kanal Prognose-Token für den nächsten Patch. Ich möchte Sie daran erinnern, dass die Anzahl der Kanäle während der Vorverarbeitungsphase erheblich erweitert wurde. Nun haben wir für jeden Kanal einen neuen Token, der die Prognose seines Verhaltens im nächsten Zeitintervall widerspiegelt.
Um diese kompakte Repräsentation wieder zu einer vollständigen Prognosereihe für einen bestimmten Planungshorizont zu erweitern, verwenden wir eine Faltungsschicht. Sie nimmt einen Satz von Prognose-Token entgegen, leitet diese durch mehrere Filter und wandelt sie in eine Sequenz von Elementen der erforderlichen Länge um, die dann vom Handelsroboter weiterverwendet werden können. Dieser Ansatz ermöglicht es uns, die Vorteile der autoregressiven Prognoseerstellung auf Token-Ebene beizubehalten und gleichzeitig eine vollständige Zeitreihe für den Einsatz in Strategien zu erzeugen.
//--- layer 6
   if(!(descr = new CLayerDescription()))
      return false;
   descr.type = defNeuronConvOCL;
   descr.count = 1;
   descr.step = EmbeddingSize;
   prev_count=descr.layers = prev_out;
   descr.window = EmbeddingSize;
   prev_out=descr.window_out = NForecast;
   descr.batch = BatchSize;
   descr.optimization = ADAM;
   descr.activation = SoftPlus;
   if(!encoder.Add(descr))
     {
      delete descr;
      return false;
     }
Am Ausgang der Faltungsschicht erhalten wir einen Satz univariater Sequenzen der gewünschten Länge. Jede davon spiegelt die Prognose für den jeweiligen Kanal wider. Für den Vergleich mit tatsächlichen Daten benötigen wir jedoch keinen Satz separater Zeitreihen, sondern eine einzige multimodale Sequenz, in der benachbarte Elemente verschiedenen Informationsquellen zum selben Zeitpunkt entsprechen. Daher besteht der nächste Schritt darin, das Ergebnis zu transponieren. Das Ergebnis ist eine Matrix mit den Dimensionen [Planungshorizont × Anzahl der Kanäle].
//--- layer 7
   if(!(descr = new CLayerDescription()))
      return false;
   descr.type = defNeuronTransposeOCL;
   descr.window=prev_out;
   descr.count = prev_count;
   descr.batch = BatchSize;
   descr.optimization = ADAM;
   descr.activation = None;
   if(!encoder.Add(descr))
     {
      delete descr;
      return false;
     }
Anschließend wenden wir auf die resultierende Matrix eine weitere Faltungsschicht an, deren Zweck darin besteht, die Anzahl der Kanäle wieder auf die ursprüngliche Dimensionalität zurückzuführen.
//--- layer 8
   if(!(descr = new CLayerDescription()))
      return false;
   descr.type = defNeuronConvOCL;
   descr.count = prev_out;
   descr.window = prev_count;
   descr.step = prev_count;
   descr.layers = 1;
   prev_out=descr.window_out = BarDescr;
   descr.batch = BatchSize;
   descr.optimization = ADAM;
   descr.activation = TANH;
   if(!encoder.Add(descr))
     {
      delete descr;
      return false;
     }
   prev_count=descr.count;
Um unsere Prognosen schließlich in reale Werte umzuwandeln, leiten wir sie durch eine Denormalisierungsschicht. Sie nimmt jede der resultierenden multimodalen Sequenzen und stellt die ursprünglichen statistischen Parameter – den Mittelwert und die Varianz – für dieselben Kanäle wieder her, mit denen wir begonnen haben. Auf diese Weise können wir standardisierte Token wieder in vertraute Maßeinheiten umrechnen.
//--- layer 9
   if(!(descr = new CLayerDescription()))
      return false;
   descr.type = defNeuronRevInDenormOCL;
   descr.count = prev_count * prev_out;
   descr.layers = 1;
   descr.activation = None;
   if(!encoder.Add(descr))
     {
      delete descr;
      return false;
     }
Somit liefert der Encoder einen vollständigen Satz von Prognosewerten für die multimodale Zeitreihe in Tradern vertrauten Maßeinheiten – Kurse, Volumina und Indikatoren. Diese Daten lassen sich visualisieren, mit tatsächlichen Kursdaten vergleichen und zur Interpretation der Handlungen des Agenten heranziehen.
Darüber hinaus ermöglicht uns dies, den Encoder im Self-Supervised-Learning-Modus zu trainieren, indem künftige Bewegungen anhand einer großen Menge nicht annotierter historischer Daten prognostiziert werden. Dies wiederum wird es ermöglichen, aussagekräftige latente Repräsentationen der Prognose-Token zu generieren. Genau diese Repräsentationen wollen wir an den Actor, Director und Critic weitergeben und so die Stabilität, Anpassungsfähigkeit und Generalisierungsfähigkeit des Modells sicherstellen.
CLayerDescription *latent = encoder. At(LatentLayer);
Als Nächstes wenden wir uns der Beschreibung der Actor-Architektur zu. Wie bereits erwähnt, analysiert dieses Modell den aktuellen Kontozustand im Kontext der Marktbedingungen und trifft eine Handelsentscheidung. Wir planen, einen Tensor, der die Konto-Repräsentation beschreibt – Kontostand, Eigenkapital und offene Positionen –, über den Hauptdatenpfad in das Modell einzuspeisen.
Zur Gewinnung und Vorverarbeitung der Eingabedaten verwenden wir eine Kombination aus einer vollständig verbundenen Schicht und einer Batch-Normalisierungsschicht. Im Gegensatz zum Encoder fügen wir jedoch kein Rauschen hinzu – schließlich toleriert unser finanzieller Zustand keine künstlichen Schwankungen. Zunächst wird der Kontozustandstensor durch eine vollständig verbundene Schicht mit ausreichender Dimensionalität geleitet und anschließend normalisiert, wodurch eine stabile und deterministische Repräsentation gewährleistet wird.
//--- Actor
   actor.Clear();
//--- Input layer
   if(!(descr = new CLayerDescription()))
      return false;
   descr.type = defNeuronBaseOCL;
   descr.count = AccountDescr;
   descr.activation = None;
   descr.optimization = ADAM;
   if(!actor.Add(descr))
     {
      delete descr;
      return false;
     }
//--- Layer 1
   if(!(descr = new CLayerDescription()))
      return false;
   descr.type = defNeuronBatchNormOCL;
   descr.count = AccountDescr;
   descr.batch = BatchSize;
   descr.activation = None;
   descr.optimization = ADAM;
   if(!actor.Add(descr))
     {
      delete descr;
      return false;
     }
Die aufbereiteten Daten werden im diversifizierten Multi-Head-Cross-Attention-Modul mit dem Kontext der Marktinformationen angereichert, wodurch Beziehungen zwischen dem Kontozustand und globalen Marktmustern berücksichtigt werden können, was eine fundiertere Wahl der Handelsstrategie ermöglicht.
//--- Layer 2
   if(!(descr = new CLayerDescription()))
      return false;
   descr.type = defNeuronCrossDMHAttention;
     {
      int temp[] = {AccountDescr,    // Input window
                    latent.window    // Cross window
                   };
      if(ArrayCopy(descr.windows, temp) < (int)temp.Size())
         return false;
     }
     {
      int temp[] = {1,                 // Input units
                    latent.variables    // Cross units
                   };
      if(ArrayCopy(descr.units, temp) < (int)temp.Size())
         return false;
     }
   descr.step = 4;                  // Heads
   descr.window_out = 32;
   descr.batch = 1e4;
   descr.layers = 3;
   descr.activation = None;
   descr.optimization = ADAM;
   if(!actor.Add(descr))
     {
      delete descr;
      return false;
     }
Zur endgültigen Entscheidung wird ein dreischichtiges MLP verwendet, bei dem zwischen den Schichten unterschiedliche Aktivierungsfunktionen zum Einsatz kommen, um die erforderliche Nichtlinearität zu erzeugen. In der ersten Schicht wird eine hyperbolische Tangensfunktion (tanh) angewendet, wodurch der Einfluss der Signale in positive und negative Richtungen getrennt werden kann. Nach der zweiten Schicht wird SoftPlus angewendet, wodurch positive Antworten hervorgehoben und niedrige Werte geglättet werden. Schließlich wird die Ausgabeschicht durch eine Sigmoid-Funktion gesteuert, die den Aktionsraum des Actors normalisiert und seine Werte auf den Bereich [0, 1] beschränkt, was die Skalierung von Handelsparametern erleichtert.
//--- Layer 3
   if(!(descr = new CLayerDescription()))
      return false;
   descr.type = defNeuronBaseOCL;
   descr.count = LatentCount;
   descr.batch = BatchSize;
   descr.activation = TANH;
   descr.optimization = ADAM;
   if(!actor.Add(descr))
     {
      delete descr;
      return false;
     }
//--- Layer 4
   if(!(descr = new CLayerDescription()))
      return false;
   descr.type = defNeuronBaseOCL;
   descr.count = LatentCount;
   descr.activation = SoftPlus;
   descr.batch = BatchSize;
   descr.optimization = ADAM;
   if(!actor.Add(descr))
     {
      delete descr;
      return false;
     }
//--- Layer 5
   if(!(descr = new CLayerDescription()))
      return false;
   descr.type = defNeuronBaseOCL;
   prev_count = descr.count = NActions;
   descr.activation = SIGMOID;
   descr.batch = BatchSize;
   descr.optimization = ADAM;
   if(!actor.Add(descr))
     {
      delete descr;
      return false;
     }
Die Modelle Director und Critic weisen eine ähnliche Architektur auf, mit dem Unterschied, dass der Kontozustandstensor durch den Aktionsvektor des Actor ersetzt und die Größe der Ausgabeschicht geändert wird. Daher werden wir in diesem Artikel nicht näher darauf eingehen, sondern dies dem eigenständigen Studium überlassen. Die vollständige Architektur aller Modelle ist im Anhang enthalten.
Trainingsprogramm für den Environment Encoder
Damit kommen wir zum Modelltraining. Dieser Prozess wurde in drei Phasen unterteilt. Zunächst haben wir das Training des Umgebungszustands-Encoders als eigenständige Phase herausgegriffen. Um sicherzustellen, dass das Training auf der größtmöglichen Menge verfügbarer Daten basiert, erfolgt dieser Vorgang ohne die Erstellung eines expliziten Trainingssets – alle erforderlichen Daten werden in Echtzeit direkt aus dem Handelsterminal zugeführt.
Diese Trainingsphase wird im Expert Advisor „…\Experts\TimeFound\StudyEncoder.mq5“ implementiert. Hier ist die Methode CreateBuffers für die Pufferverwaltung zuständig; ihre Parameter umfassen den Startindex des Zustands und Zeiger auf zwei Puffer: einen für die zu analysierenden Quelldaten und einen für die Zielwerte der vorherzusagenden Bewegung. Dieser Ansatz ermöglicht es, ein Self-Supervised-Training des Encoders durchzuführen, ohne dass zusätzliche Kosten für das Labeling historischer Zeitreihen entstehen.
bool CreateBuffers(const int start_bar, CBufferFloat* state, CBufferFloat *time, CBufferFloat* forecast)
  {
   if(!state || !time || start_bar < 0 ||
      (start_bar + HistoryBars + NForecast) >= int(Rates.Size()))
      return false;
//---
   vector<float> vState = vector<float>::Zeros(HistoryBars * BarDescr);
   vector<float> vForecast = vector<float>::Zeros(NForecast * BarDescr);
   time.Clear();
   time.Reserve(HistoryBars);
Im Hauptteil der Methode prüfen wir, ob die zuvor geladenen Daten ausreichende Informationen enthalten, und richten interne Puffer ein, um die Werte zu speichern. Als Nächstes werden die Schleifen zur Datenaufbereitung eingerichtet. Die zuvor aus dem Terminal geladenen Quellzeitreihen werden so gespeichert, dass die neuesten Punkte am Anfang und die älteren Punkte gegen Ende stehen, wobei die zeitliche Reihenfolge beibehalten wird. Um die Parameter des Encoders anzupassen, müssen wir bei jedem Trainingsschritt ein vollständiges Zeitintervall ermitteln, das sich über das Fenster mit den historischen Daten und den festgelegten Planungshorizont erstreckt.
Zunächst wird der Vektor konstruiert, der den zu analysierenden Zustand darstellt: Ausgehend von dem in den Parametern angegebenen Index gehen wir um den festgelegten Planungshorizont zurück und kopieren alle folgenden Elemente in den Quelldatenpuffer. Diese Abfolge von Operationen, die der Chronologie der Zeitreihe entspricht, minimiert den mit der Datenaufbereitung verbundenen Aufwand und stellt sicher, dass das Modell effizient in Echtzeit arbeitet.
int bar = start_bar + NForecast;
for(int b = 0; b < (int)HistoryBars; b++)
  {
   float open = (float)Rates[b + bar].open;
   float rsi = (float)RSI.Main(b + bar);
   float cci = (float)CCI.Main(b + bar);
   float atr = (float)ATR.Main(b + bar);
   float macd = (float)MACD.Main(b + bar);
   float sign = (float)MACD.Signal(b + bar);
   if(rsi == EMPTY_VALUE || cci == EMPTY_VALUE || atr == EMPTY_VALUE ||
      macd == EMPTY_VALUE || sign == EMPTY_VALUE)
      return false;
   //---
   int shift = b * BarDescr;
   vState[shift] = (float)(Rates[b + bar].close - open);
   vState[shift + 1] = (float)(Rates[b + bar].high - open);
   vState[shift + 2] = (float)(Rates[b + bar].low - open);
   vState[shift + 3] = (float)(Rates[b + bar].tick_volume / 1000.0f);
   vState[shift + 4] = rsi;
   vState[shift + 5] = cci;
   vState[shift + 6] = atr;
   vState[shift + 7] = macd;
   vState[shift + 8] = sign;
   if(!time.Add(float(Rates[b + bar].time)))
      return false;
  }
Als Nächstes fahren wir mit der Vorbereitung der Zielwerte fort. Da es sich hierbei um Prognosedaten handelt, beziehen sie sich auf die Zukunft, und die Reihenfolge der Werte muss umgekehrt werden, um die Zielpuffer korrekt zu bilden. Zu diesem Zweck verwenden wir bei der Datenübertragung eine umgekehrte Indizierung: Das letzte Element des Zielhorizonts wird zum ersten Element im Puffer, gefolgt von den übrigen Elementen in der richtigen Reihenfolge. Diese Technik stellt sicher, dass das Modell bei jedem Trainingsschritt die aktuelle Eingabe korrekt am entsprechenden zukünftigen Wert ausrichtet.
bar--;
for(int b = 0; b < (int)NForecast; b++)
  {
   float open = (float)Rates[bar - b].open;
   float rsi = (float)RSI.Main(bar - b);
   float cci = (float)CCI.Main(bar - b);
   float atr = (float)ATR.Main(bar - b);
   float macd = (float)MACD.Main(bar - b);
   float sign = (float)MACD.Signal(bar - b);
   if(rsi == EMPTY_VALUE || cci == EMPTY_VALUE || atr == EMPTY_VALUE ||
      macd == EMPTY_VALUE || sign == EMPTY_VALUE)
      return false;
   //---
   int shift = (NForecast - b - 1) * BarDescr;
   vForecast[shift] = (float)(Rates[bar - b].close - open);
   vForecast[shift + 1] = (float)(Rates[bar - b].high - open);
   vForecast[shift + 2] = (float)(Rates[bar - b].low - open);
   vForecast[shift + 3] = (float)(Rates[bar - b].tick_volume / 1000.0f);
   vForecast[shift + 4] = rsi;
   vForecast[shift + 5] = cci;
   vForecast[shift + 6] = atr;
   vForecast[shift + 7] = macd;
   vForecast[shift + 8] = sign;
  }
Wir übertragen die aufbereiteten Zeitreihen in die Datenpuffer und schließen die Methode ab, indem wir das boolesche Ergebnis der Operationen an das aufrufende Programm zurückgeben.
   if(!state.AssignArray(vState))
      return false;
   if(!forecast.AssignArray(vForecast))
      return false;
   if(time.GetIndex() >= 0)
      if(!time.BufferWrite())
         return false;
//---
   return true;
  }
Der Trainingsprozess selbst ist in der Methode Train organisiert. In dieser Methode bestimmen wir zunächst die Größe des Trainingsset-Puffers anhand des vom Benutzer angegebenen Start- und Enddatums des Trainingszeitraums.
void Train(void)
  {
   int start = iBarShift(Symb.Name(), TimeFrame, Start);
   int end = iBarShift(Symb.Name(), TimeFrame, End);
   int bars = CopyRates(Symb.Name(), TimeFrame, 0, start, Rates);
Auf Grundlage dieser Grenzen wird die Anzahl der Kursbalken berechnet und der erforderliche Speicher für die Datenpuffer zugewiesen.
if(!RSI.BufferResize(bars) || !CCI.BufferResize(bars) ||
   !ATR.BufferResize(bars) || !MACD.BufferResize(bars))
  {
   PrintFormat("%s -> %d", __FUNCTION__, __LINE__);
   ExpertRemove();
   return;
  }
Anschließend werden historische Daten für das angegebene Instrument und den angegebenen Timeframe dynamisch aus dem Terminal geladen.
   int count = -1;
   bool load = false;
   do
     {
      RSI.Refresh();
      CCI.Refresh();
      ATR.Refresh();
      MACD.Refresh();
      count++;
      load = (RSI.BarsCalculated() >= bars &&
              CCI.BarsCalculated() >= bars &&
              ATR.BarsCalculated() >= bars &&
              MACD.BarsCalculated() >= bars
             );
      Sleep(100);
      count++;
     }
   while(!load && count < 100);
   if(!load)
     {
      PrintFormat("%s -> %d The training data has not been loaded", __FUNCTION__, __LINE__);
      ExpertRemove();
      return;
     }
//---
   if(!ArraySetAsSeries(Rates, true))
     {
      PrintFormat("%s -> %d", __FUNCTION__, __LINE__);
      ExpertRemove();
      return;
     }
   bars -= end + HistoryBars + NForecast;
   if(bars < 0)
     {
      PrintFormat("%s -> %d", __FUNCTION__, __LINE__);
      ExpertRemove();
      return;
     }
Nachdem wir die Trainingsdaten vorbereitet haben, fahren wir direkt mit dem Trainingsprozess fort und organisieren ihn innerhalb einer verschachtelten Schleifenstruktur. Die äußere Schleife ist für die Verfolgung der Trainingsiterationen zuständig. Die Gesamtzahl der Iterationen wird vom Benutzer über die Programmparameter festgelegt.
   vector<float> result, target, neg_target;
   bool Stop = false;
//---
   uint ticks = GetTickCount();
//---
   for(int iter = 0; (iter < Iterations && !IsStopped() && !Stop); iter ++)
     {
      int posit = (int)((MathRand() * MathRand() / MathPow(32767, 2)) * bars);
      if(!CreateBuffers(posit + end, GetPointer(bState), GetPointer(bTime), Result))
        {
         PrintFormat("%s -> %d", __FUNCTION__, __LINE__);
         ExpertRemove();
         return;
        }
Im Hauptteil der äußeren Trainingsschleife ziehen wir den Index eines einzelnen Zustands aus dem Trainingsset und verwenden ihn als Referenz für die Bildung der Eingabedaten und der Zieldaten. Dieser Index wird zusammen mit Zeigern auf die entsprechenden Puffer an die Methode CreateBuffers übergeben, wodurch jede Iteration korrekt ausgerichtete historische Sequenzen und Prognosesequenzen für effektives Self-Supervised Learning erhält.
Als nächstes richten wir eine innere Schleife ein, deren Anzahl von Iterationen vom Benutzer über den Parameter „Repeats“ festgelegt wird. Hier muss man äußerst vorsichtig sein: Innerhalb dieser Schleife trainieren wir das Modell wiederholt mit denselben Eingabedaten und Zieldaten. Eine Normalisierungsschicht mit hinzugefügtem Rauschen im Encoder sorgt für die erforderliche Augmentation: Das Modell lernt, sich eher auf die interne Struktur der Daten als auf bestimmte Werte zu konzentrieren. Bei zu vielen Wiederholungen besteht jedoch die Gefahr, dass das Modell – wenn die Zielwerte unverändert bleiben – die Eingabedaten ignoriert und immer wieder dasselbe Ergebnis liefert. Daher empfehlen wir, den Parameter Repeats auf etwa fünf Iterationen einzustellen.
for(int r = 0; r < Repeats; r++)
  {
   //--- Feed Forward
   if(!cEncoder.feedForward((CBufferFloat*)GetPointer(bState), 1, false, (CBufferFloat*)GetPointer(bTime)))
     {
      PrintFormat("%s -> %d", __FUNCTION__, __LINE__);
      Stop = true;
      break;
     }
   //--- Study
   if(!cEncoder.backProp(Result, (CBufferFloat*)NULL))
     {
      PrintFormat("%s -> %d", __FUNCTION__, __LINE__);
      Stop = true;
      break;
     }
Der Schleifenkörper führt die Operationen des Vorwärtsdurchlaufs und des Rückwärtsdurchlaufs des Modells aus. Anschließend informieren wir den Benutzer über den Trainingsfortschritt und fahren mit der nächsten Iteration der Schleifenstruktur fort.
    if(GetTickCount() - ticks > 500)
      {
       double percent = double(iter) * 100.0 / (Iterations);
       string str = StringFormat("%-12s %6.2f%% -> Error %15.8f\n", "Encoder",
                                   percent, cEncoder.getRecentAverageError());
       Comment(str);
       ticks = GetTickCount();
      }
   }
}
Sobald alle Iterationen abgeschlossen sind, werden die Trainingsergebnisse in das Log geschrieben, und wir beenden das Programm.
   Comment("");
//---
   PrintFormat("%s -> %d -> %-15s %10.7f", __FUNCTION__, __LINE__, "Encoder", cEncoder.getRecentAverageError());
   ExpertRemove();
//---
  }
Die Programme für das Offline-Training und das Online-Fine-Tuning der Modelle Actor, Director und Critic wurden vollständig und unverändert aus früheren Projekten übernommen. Darüber hinaus haben wir bewährte Lösungen für die Erstellung des Trainingssets und das Testen der trainierten Modelle verwendet, wodurch wir uns auf architektonische Innovationen konzentrieren konnten, ohne Ressourcen für die Neugestaltung unterstützender Komponenten aufwenden zu müssen.
Der gesamte Quellcode der Programme, die bei der Erstellung dieses Artikels verwendet wurden, ist im Anhang enthalten.
Tests
Wie bereits erwähnt, war der Modelltrainingsprozess in drei aufeinanderfolgende Phasen gegliedert, wodurch es möglich war, das gesamte System logisch, Schritt für Schritt und mit maximaler Zuverlässigkeit aufzubauen.
Der erste Schritt bestand darin, den Encoder anhand von fünf Jahren historischer Daten für das EURUSD-Paar im Ein-Minuten-Timeframe zu trainieren. Dieser Umfang und dieser Detaillierungsgrad ermöglichen es, eine wirklich tiefgehende und aussagekräftige latente Repräsentation des aktuellen Marktzustands zu erstellen. Der Encoder lernt, wichtige Muster zu unterscheiden, Gesetzmäßigkeiten zu erkennen und die Marktsituation als kompakten und dennoch aussagekräftigen Vektor zu codieren, der anschließend von allen anderen Modulen verwendet wird.
Als Nächstes folgt die zweite Phase – das Offline-Training der wichtigsten aktiven Komponenten unserer Architektur: Actor, Director und Critic. Zu diesem Zweck wurde ein Datensatz mit Marktdaten aus dem Jahr 2024 erstellt, wobei alle beim Training des Encoders verwendeten Parameter unverändert blieben. Der Trainingsprozess basierte auf dem Konzept einer nahezu perfekten Trajektorie: Die Aktionen des Agents wurden nicht willkürlich ausgewählt, sondern auf Grundlage einer Analyse der nachfolgenden Kursbewegungen. Mit anderen Worten: Da uns der gesamte Kursverlauf zur Verfügung stand, wussten wir im Voraus, welche Aktionen zu den besten Ergebnissen geführt hätten, und genau diese Aktionen haben wir für das Training verwendet. Dieser Ansatz ermöglicht es uns, dem Modell zu zeigen, wie es handeln soll, anstatt es dazu zu zwingen, durch Versuch und Irrtum blind nach einer effektiven Strategie zu suchen und ohne Orientierung durch die Umgebung zu irren. Infolgedessen lernt der Agent aus zuvor validierten Beispielen – klaren, fundierten Beispielen, deren Ergebnis so nah wie möglich am Ideal liegt. Dies vereinfacht nicht nur den Trainingsprozess, sondern sorgt auch dafür, dass er zielgerichtet und wirtschaftlich sinnvoll ist.
Der letzte Schritt ist das Online-Fine-Tuning, das direkt im Strategietester durchgeführt wird. Hier werden die Modelle historischen Daten in einem Modus ausgesetzt, der dem realen Handel so nahe wie möglich kommt, und passen ihre Parameter an die Dynamik des realen Marktes an. Dies ist besonders wichtig, da es uns ermöglicht, das Verhalten des Agenten unter Berücksichtigung sich ändernder Bedingungen, von Marktrauschen und zufälligen Schwankungen, die im Trainingsset nicht erkennbar sind, weiter zu verfeinern.
Nachdem die gesamte Trainingspipeline abgeschlossen war, wurde das Modell anhand neuer Daten getestet – Kursdaten für Januar 2025. Alle während des Trainings verwendeten Parameter und Einstellungen wurden unverändert beibehalten, wodurch vollständige Objektivität und Fairness bei der Bewertung gewährleistet wurden. Die Testergebnisse sind im Folgenden aufgeführt.
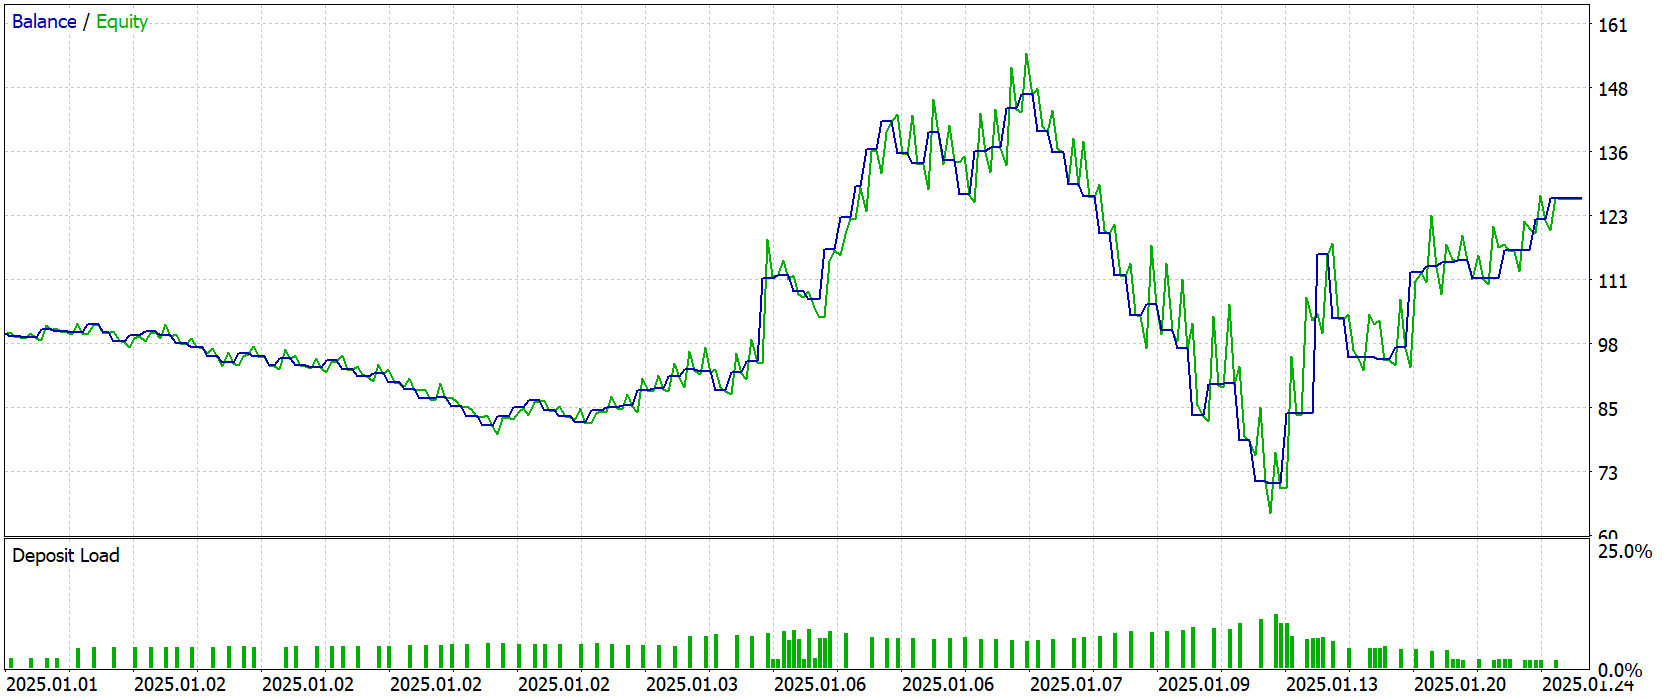
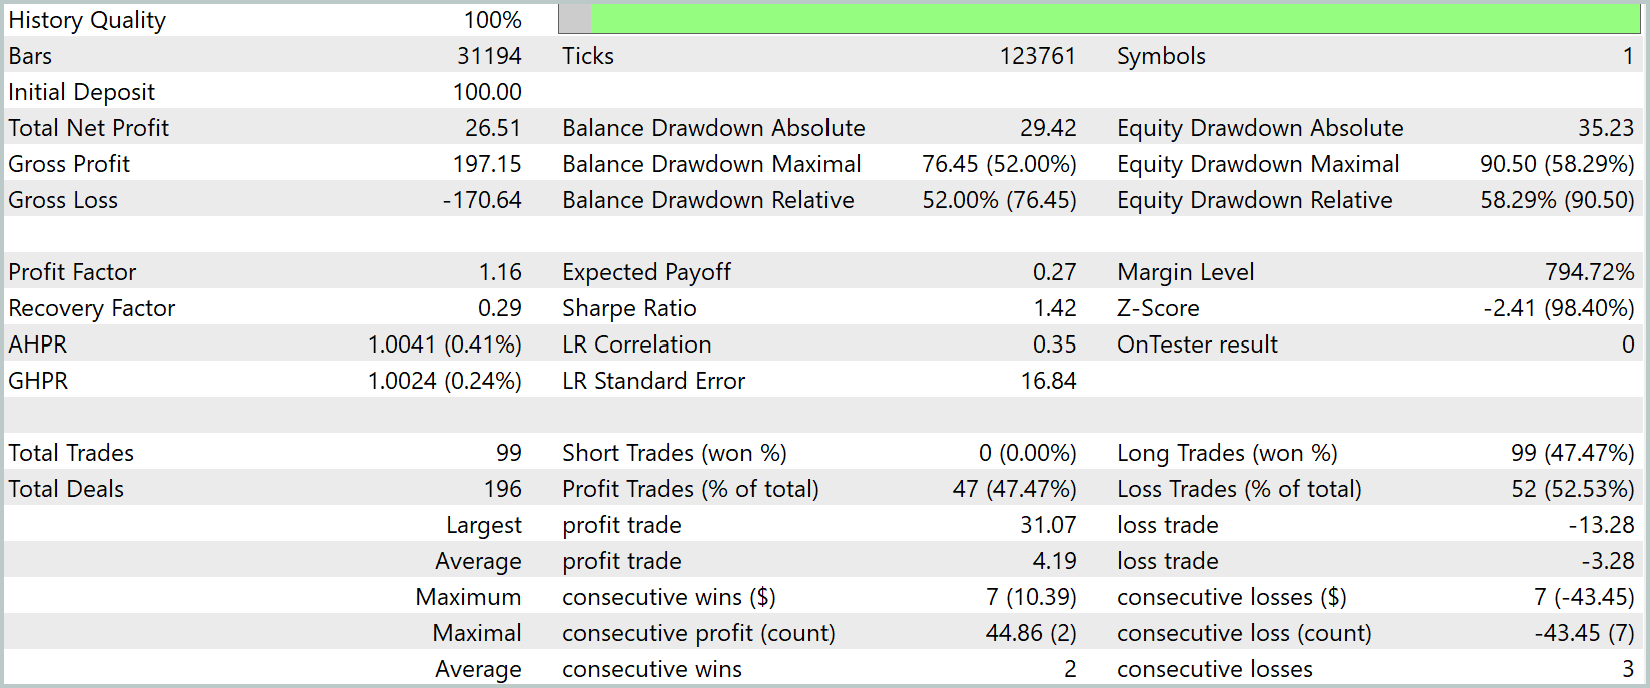
Die Testergebnisse lassen sich als ermutigend bezeichnen, allerdings mit einigen Einschränkungen. Die Gesamtrendite für den Monat betrug +26,5 %, doch das Kontostandsdiagramm lässt keinen anhaltenden Aufwärtstrend erkennen. Vielmehr ist die meiste Zeit eine Seitwärtsbewegung zu beobachten, mit Phasen der Instabilität und erheblichen Drawdowns. Der maximale Drawdown erreichte 58 %, was auf hohe Volatilität und instabile Entscheidungen in bestimmten Marktsituationen hindeutet.
Dieses Muster deutet darauf hin, dass das Modell noch dabei ist, einen konsistenten Handelsstil zu finden, anstatt einer klaren, profitablen Trajektorie zu folgen. Dennoch ist das positive Ergebnis an sich ein ermutigendes Zeichen: Der Grundstein ist gelegt; nun gilt es, die Stabilität zu verbessern.
Fazit
Im Rahmen dieser Arbeit sind wir vom Konzept der universellen domänenübergreifenden Prognoseerstellung für Zeitreihen bis zu dessen praktischer Umsetzung in der MetaTrader-5-Umgebung gelangt. Wir haben die Struktur des Encoders eingehend untersucht, uns mit dem Mechanismus des Multi-Scale-Patching vertraut gemacht und anschließend die daraus resultierenden latenten Repräsentationen in die Actor–Director–Critic-Architektur integriert. Jeder Schritt – von der Datenaufbereitung und dem Self-Supervised-Training des Encoders bis hin zum Offline- und Online-Fine-Tuning der Schlüsselmodule – hat gezeigt, wie eine ausgewogene Kombination aus modernster Forschung und technischen Lösungen die Qualität der Analyse der Marktdynamik verbessern kann.
Tests anhand der Marktdaten vom Januar 2025 haben gezeigt, dass unser System Gewinne erzielen kann, auch wenn es nicht frei von tiefen Drawdowns ist. Dies unterstreicht, wie wichtig es ist, das Risikomanagement und adaptive Mechanismen zur Verlustbegrenzung weiter zu verfeinern. Gleichzeitig deutet gerade die Tatsache, dass ohne zusätzliche Parameteroptimierung positive Renditen erzielt wurden, darauf hin, dass die gewählte Architektur über ein robustes Backbone verfügt und Prognosen durch die Wiederverwendung bereits gewonnenen Wissens ermöglicht.
Literaturverzeichnis
In diesem Artikel verwendete Programme
| # | Name | Typ | Beschreibung |
|---|---|---|---|
| 1 | Research.mq5 | Expert Advisor | Expert Advisor zum Sammeln von Beispielen |
| 2 | ResearchRealORL.mq5 | Expert Advisor | Expert Advisor zum Sammeln von Beispielen mit der Real-ORL-Methode |
| 3 | StudyEncoder.mq5 | Expert Advisor | Expert Advisor zum Trainieren des Umgebungs-Encoders |
| 4 | Study.mq5 | Expert Advisor | Expert Advisor für das Offline-Modelltraining |
| 5 | StudyOnline.mq5 | Expert Advisor | Expert Advisor für das Online-Training des Modells |
| 6 | Test.mq5 | Expert Advisor | Expert Advisor zum Testen des Modells |
| 7 | Trajectory.mqh | Klassenbibliothek | Struktur zur Beschreibung des Systemzustands und der Modellarchitekturen |
| 8 | NeuroNet.mqh | Klassenbibliothek | Eine Klassenbibliothek zum Erstellen neuronaler Netze |
| 9 | NeuroNet.cl | Bibliothek | OpenCL-Programmcode-Bibliothek |
Übersetzt aus dem Russischen von MetaQuotes Ltd.
Originalartikel: https://www.mql5.com/ru/articles/18447
Warnung: Alle Rechte sind von MetaQuotes Ltd. vorbehalten. Kopieren oder Vervielfältigen untersagt.
Dieser Artikel wurde von einem Nutzer der Website verfasst und gibt dessen persönliche Meinung wieder. MetaQuotes Ltd übernimmt keine Verantwortung für die Richtigkeit der dargestellten Informationen oder für Folgen, die sich aus der Anwendung der beschriebenen Lösungen, Strategien oder Empfehlungen ergeben.
 Die Übertragung der Trading-Signale in einem universalen Expert Advisor.
 Neuronale Netze im Trading: Eine intelligente Prognose-Pipeline (Time-MoE)
 Eine alternative Log-datei mit der Verwendung der HTML und CSS
 Von der Grundstufe bis zur Mittelstufe: Direkter Dateizugriff (I)

- Freie Handelsapplikationen
- Über 8.000 Signale zum Kopieren
- Wirtschaftsnachrichten für die Lage an den Finanzmärkte
Sie stimmen der Website-Richtlinie und den Nutzungsbedingungen zu.