Von den Grundlagen bis zur Mittelstufe: Warteschlangen, Listen und Bäume (I)
 16
 0

Einleitung
In unserem vorherigen Artikel „Von den Grundlagen bis zur Mittelstufe: Bubblesort anpassen und optimieren“ haben wir gezeigt, wie man einen sehr einfachen Sortiermechanismus implementiert. Auch wenn dies hinsichtlich der Ausführungszeit vielleicht nicht besonders effizient ist, eignet sich dieser Ansatz in vielen Fällen für eine Vielzahl von Situationen, in denen das Ziel darin besteht, einen Datensatz zu sortieren und dadurch die Interpretation der Daten sowie einfache Suchvorgänge innerhalb des Datensatzes zu vereinfachen.
Der im vorherigen Artikel beschriebene Mechanismus wird nicht immer für sich allein eingesetzt. In den meisten Fällen sind Sortier- und Suchsysteme mit anderen Arten von Mechanismen verbunden. In diesem Artikel werden wir einen dieser Mechanismen näher betrachten.
Zwar konzentrieren wir uns noch auf grundlegende Themen, doch für manche könnte der hier behandelte Stoff bereits fortgeschrittener sein. All dies hängt jedoch mit den Grundlagen zusammen, die jeder professionelle Programmierer kennen sollte.
Gut, um gleich richtig loszulegen, kommen wir nun zu einem neuen Thema. Bitte beachten Sie: Sollten Sie Schwierigkeiten haben, die hier dargestellten Informationen zu verstehen, oder sollten Themen zur Sprache kommen, die in diesem Artikel nicht behandelt werden, schlagen Sie bitte in früheren Artikeln nach. Dort finden Sie alle Informationen, die Sie benötigen, um diesen Artikel zu verstehen.
Warteschlangen, Listen und Bäume (I)
Viele Anfänger vernachlässigen bestimmte Lerninhalte, weil sie diese für unnötig halten, obwohl sie sie eigentlich gründlich verstehen und beherrschen sollten. Diese von Anfängern oft unterschätzten Lerninhalte dienen gerade dazu, eine korrekte Analyse und Strukturierung von Daten zu gewährleisten.
Achtung, lieber Leser! Es macht keinen Sinn, zu lernen, wie man einen Expert Advisor oder auch nur einen einfachen Indikator erstellt, wenn man nicht weiß, wie man all die Daten, die die Anwendung generiert, richtig analysiert. Halten Sie nun einen Moment inne und denken Sie darüber nach. Wenn Sie verstehen, wie sich die von der Anwendung empfangenen Daten analysieren und kategorisieren lassen, können Sie den Betrieb der Anwendung optimieren, sodass sie schneller läuft.
Derzeit herrscht große Begeisterung rund um maschinelles Lernen und damit verbundene Themen. Allerdings sind selbst Systeme der künstlichen Intelligenz nichts anderes als einfache Klassifikatoren und Systeme zur statistischen Datenanalyse. Diese Systeme verfügen unter keinen Umständen über echte Intelligenz, die in der Lage wäre, die menschliche Kreativität und die Fähigkeit, ein bestimmtes Thema zu verstehen, zu übertreffen.
Mit anderen Worten: Auch wenn künstliche Intelligenz oder maschinelles Lernen – die von vielen als der Gipfel der Technologie angesehen werden – beeindruckend erscheinen mögen, sind sie letztendlich nichts anderes als Algorithmen, die eine Reihe von Grundlagen anwenden können, die jeder gute Programmierer beherrschen sollte. Es kann entscheidend sein, zu verstehen, wie – und vor allem warum – Sie dieses bestimmte Implementierungsmodell anstelle eines anderen verwenden sollten. Diese Kunst werden Sie erst mit der Zeit durch gezieltes Üben und Erfahrung beherrschen können. Der Zweck dieser Artikel besteht nicht darin, Ihnen vorzuschreiben, wann Sie ein bestimmtes Implementierungsmodell verwenden sollen, sondern vielmehr darin, diese Modelle vorzustellen und zu zeigen, wie sie mit MQL5 genutzt werden können, um Ergebnisse in MetaTrader 5 zu erzielen.
Die Darstellung des Stoffes, den wir hier besprechen werden, folgt also einer gewissen logischen Abfolge – wenn man das so nennen kann. Und da ich mich so klar wie möglich ausdrücken möchte – und manche Anfänger die Bedeutung dieses Stoffs vielleicht noch nicht ganz verstehen –, fangen wir mit der einfachsten Umsetzung an: Warteschlangen.
Grundsätzlich kann eine Warteschlange einem Array ähneln. Trotz dieser Ähnlichkeit kann eine Warteschlange verschiedene Formen annehmen, von denen sich manche stark voneinander unterscheiden. Daher können diese Formen je nach den konkreten Umständen und der Art ihrer Umsetzung ganz unterschiedlichen Zwecken dienen. Gerade weil sie Daten-Arrays so ähnlich sind, verwechseln viele Anfänger sie oft mit Arrays – und das aus gutem Grund. Warteschlangen sind jedoch nicht unbedingt Arrays, da sie sich hinsichtlich ihres Zwecks und ihrer Verarbeitung erheblich von Arrays unterscheiden.
Da Warteschlangen sehr unterschiedliche und zugleich recht interessante Eigenschaften aufweisen können – und je nach den Möglichkeiten der jeweiligen Programmiersprache sogar sehr ausgefallene Umsetzungen haben können –, beginnen wir mit etwas ganz Einfachem. Tatsache ist, dass das Konzept und die Funktionsweise von Klassen noch nicht erläutert wurden. Dennoch wurde bereits genügend Stoff behandelt, sodass wir verschiedene Strukturen ohne größere Schwierigkeiten umsetzen können. Daher können wir den unten gezeigten Code schreiben – oder, genauer gesagt, implementieren.
01. //+------------------------------------------------------------------+
02. #property copyright "Daniel Jose"
03. //+------------------------------------------------------------------+
04. template <typename T> struct stFIFO
05. {
06.     private:
07. //+----------------+
08.         T   value[];
09. //+----------------+
10.     public:
11. //+----------------+
12.     T Restore(void)
13.     {
14.         T local = NULL;
15.
16.         if (value.Size() > 0)
17.         {
18.             local = value[0];
19.             ArrayRemove(value, 0, 1);
20.         };
21.         return local;
22.     };
23. //+----------------+
24.     void Stock(T arg)
25.     {
26.         T local[1];
27.         local[0] = arg;
28.         ArrayInsert(value, local, value.Size());
29.     }
30. //+----------------+
31. };
32. //+------------------------------------------------------------------+
33. void OnStart(void)
34. {
35.     stFIFO <char> fifo;
36.
37.     fifo.Stock(10);
38.     fifo.Stock(84);
39.     fifo.Stock(-6);
40.
41.     Print(fifo.Restore());
42.     Print(fifo.Restore());
43.     Print(fifo.Restore());
44.     Print(fifo.Restore());
45. }
46. //+------------------------------------------------------------------+
Code 01
Das ist also unser erster Schritt hin zu einem umfassenderen Verständnis dieser Datenstrukturen, die in der Programmierung als Warteschlangen, Listen und Bäume bezeichnet werden. Nun, lieber Leser, möchte ich Sie bitten, sich einige Details in diesem Code genauer anzusehen. Bitte beachten Sie, dass wir in Zeile 08 ein dynamisches Array deklarieren, das Werte beliebigen Typs enthalten kann, wie Sie allein schon anhand der Deklaration in Zeile 08 erkennen können.
Dieses Array sollte nicht auf dieselbe Weise betrachtet werden wie die Arrays, die wir bisher gesehen haben. Der Grund dafür liegt in der Funktion in Zeile 12 und der Prozedur in Zeile 24. Diese Prozeduren und Funktionen können beliebige Namen haben. Was wirklich zählt, ist, wie sie funktionieren. Bitte achten Sie daher genau auf die folgende Erklärung. Denn je nach den beteiligten Funktionen und Prozeduren kann sich die implementierte Struktur sehr schnell ändern. Dies könnte zu einer Änderung des Warteschlangentyps führen oder sogar radikale Veränderungen auslösen, bis hin zur Implementierung einer Liste oder sogar eines Baums anstelle einer Warteschlange.
Das ist der einfachste Teil. Wenn Sie sich den Code für die Funktion Restore in Zeile 12 ansehen, werden Sie feststellen, dass wir, wenn das in Zeile 08 deklarierte Array Daten enthält, immer die Daten an Index 0 dieses Arrays entnehmen, damit wir sie später an den Aufrufer zurückgeben können. Das Wichtigste dabei ist, was Zeile 19 tatsächlich bewirkt. Der Zweck besteht darin, das Element am Index 0 zu entfernen. „Aber Moment mal. Ich verstehe das nicht. Wenn wir immer den Inhalt von Index 0 zurückgeben, führt das Entfernen genau dieses Indexes letztendlich zu einer gewissen Inkonsistenz im Code. Denn beim nächsten Aufruf wird der Index 0 keine Daten enthalten.“
Nun, lieber Leser, in Wirklichkeit wird es nicht ganz so kommen. Wie ich bereits erwähnt habe, verwechseln viele Anfänger diese Konzepte gerade deshalb, weil sie den Code nur oberflächlich überfliegen, ohne zu verstehen, was im Hintergrund vor sich geht. Aber ich versichere Ihnen, dass Sie bald alles besser verstehen werden. Hören Sie einfach genau zu, was ich Ihnen jetzt erklären werde.
Nun wissen wir also, dass die Funktion in Zeile 12 immer den Inhalt am Index 0 des Arrays zurückgibt. Wie sieht es mit der Prozedur in Zeile 24 aus? Was macht sie? Gut, in diesem Fall speichert diese Prozedur die an sie übergebenen Daten in einem Array. Diese Daten werden jedoch immer am Ende des Arrays gespeichert. „Hmm, das verstehe ich nicht. Könntest du das etwas genauer erklären?“
Ja, lieber Leser. Sie wissen bereits, dass ein Array verschiedene Indizes haben kann, die von Null bis zu einem beliebigen Wert reichen. Wenn der erste Wert an die Prozedur „Stock“ in Zeile 24 übergeben wird, wird er unter dem Index 0 gespeichert. So weit, so gut, denn wenn wir die Funktion Restore verwenden, lesen wir genau den Inhalt am Index 0 ein. Genau an dieser Stelle geraten viele Programmieranfänger ins Straucheln. Der nächste an „Stock“ gesendete Datenwert wird unter Index 1 gespeichert. Das liegt daran, dass unter Index 0 bereits Daten vorhanden sind. Das nächste Element wird aus demselben Grund unter Index 2 gespeichert: Unter Index 1 befinden sich bereits Daten. Und so weiter.
In jeder dieser Situationen liest die Funktion Restore jedoch weiterhin immer den Inhalt am Index 0. Aber genau hier wird die Erklärung erst richtig interessant. Wenn Sie die Funktion Restore verwendest, werden die verbleibenden Elemente um eine Position nach unten verschoben. So erstellen wir eine Verarbeitungswarteschlange. Um dies in der Praxis zu sehen, werfen wir einen Blick auf die Liste der Befehle in der Prozedur „OnStart“, beginnend mit Zeile 33. Wenn die Zeilen 37 bis 39 ausgeführt werden, wird eine Warteschlange in genau derselben Reihenfolge erstellt, in der wir die Werte deklariert haben. Umgekehrt lesen wir, wenn wir die Zeilen 41 bis 44 ausführen, das aus, was in die Warteschlange eingefügt wurde. Es mag vielleicht etwas seltsam erscheinen, aber es funktioniert. Das Ergebnis der Ausführung ist in der folgenden Abbildung dargestellt.
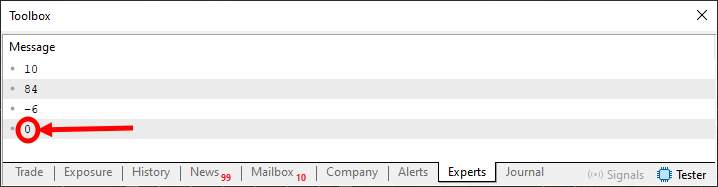
Bild 01
Bitte beachten Sie, dass in Abbildung 01 ein anderes Element hervorgehoben ist. Die Funktion Restore gibt den Wert zurück, da sich keine Elemente mehr in der Warteschlange befinden. Das liegt daran, dass wir in Zeile 14 festlegen, welcher Wert zurückgegeben wird, wenn das in Zeile 08 deklarierte Array keine Daten enthält.
Es ist klar, dass wir die in die Warteschlange eingefügten Daten weiterhin sehen können, obwohl wir in der Funktion Restore immer auf den Index 0 zugreifen. Diese Art von Warteschlange hat einen bestimmten Namen: FIFO – das steht für „first in, first out“ („zuerst hinein, zuerst hinaus“). Führen Sie doch ein paar Tests durch, um sich ein besseres Bild davon zu machen. Fügen Sie beispielsweise mehrere Werte zur Warteschlange hinzu, lesen Sie einige davon aus und fügen Sie anschließend weitere Werte hinzu. Versuchen Sie zu verstehen, wie die Lese- und Schreibvorgänge funktionieren.
Diese Art von Warteschlange ist in verschiedenen Situationen sehr nützlich, in denen wir Daten in einer bestimmten Reihenfolge analysieren müssen und diese Reihenfolge nicht aus den Augen verlieren dürfen. Bevor Sie also zur nächsten Option übergehen, sollten Sie zunächst üben und verstehen, wie dieser erste Codeausschnitt funktioniert.
Im folgenden Code, den wir uns gleich genauer ansehen werden, erstellen wir eine andere Art von Warteschlange, deren Zweck sich völlig von dem der zuvor besprochenen unterscheidet. Bevor Sie jedoch versuchen zu verstehen, was im nächsten Codeausschnitt passieren wird, empfehle ich Ihnen, lieber Leser, dringend, sich etwas Zeit zu nehmen, um wirklich zu verstehen, was in Code 01 gezeigt wurde und wie es funktioniert. Dadurch lassen sich Unklarheiten darüber vermeiden, was wir im folgenden Code sehen werden.
01. //+------------------------------------------------------------------+
02. #property copyright "Daniel Jose"
03. //+------------------------------------------------------------------+
04. template <typename T> struct stQueue
05. {
06.     private:
07. //+----------------+
08.         T       value[];
09.         uint    c_Pos,
10.                 c_Max;
11. //+----------------+
12.     public:
13. //+----------------+
14.     void Init(uint arg)
15.     {
16.         ArrayResize(value, arg + 1);
17.         c_Pos = c_Max = 0;
18.     }
19. //+----------------+
20.     bool GetInfo(T &arg)
21.     {
22.         if (c_Pos == c_Max)
23.             return false;
24.         c_Pos = (c_Pos < value.Size() - 1 ? c_Pos + 1 : 0);
25.         arg = value[c_Pos];
26.
27.         return true;
28.     }
29. //+----------------+
30.     void Stock(const T arg)
31.     {
32.         c_Max = (c_Max < value.Size() - 1 ? c_Max + 1 : 0);
33.         c_Pos = (c_Pos == c_Max ? (c_Pos < value.Size() - 1 ? c_Pos + 1 : 0) : c_Pos);
34.         value[c_Max] = arg;
35.     }
36. //+----------------+
37. };
38. //+------------------------------------------------------------------+
39. void OnStart(void)
40. {
41.     stQueue <char> Queue;
42.
43.     Queue.Init(5);
44.
45.     Queue.Stock(10);
46.     Queue.Stock(84);
47.     Queue.Stock(-6);
48.     Queue.Stock(15);
49.     Queue.Stock(-35);
50.     Queue.Stock(40);
51.     Queue.Stock(-35);
52.
53.     for (char info; Queue.GetInfo(info);)
54.         Print(info);
55. }
56. //+------------------------------------------------------------------+
Code 02
In Code 02 implementieren wir eine weitere Art von Warteschlange, die unter Programmierern als Ringwarteschlange bekannt ist. Auch wenn diese Art der Implementierung bei der Verwendung von Klassen einfacher ist, spricht nichts dagegen, sie mithilfe der bereits in früheren Artikeln beschriebenen Mittel zu implementieren. Wenn wir dies mithilfe von Klassen umsetzen, werden Sie feststellen, dass alles viel einfacher wird – sowohl bei der Erstellung als auch bei der Verwendung der hier vorgestellten Implementierung. Aber das ist ein Thema für ein anderes Mal. Konzentrieren wir uns auf das, was wir gerade haben.
Und nun, lieber Leser, lesen Sie bitte noch aufmerksamer mit. Wenn Ihnen Code 01 schon etwas verwirrend und kompliziert vorkam, dann wird Sie Code 02 noch mehr verwirren, denn hier machen wir etwas, das vielen Menschen wie reiner Wahnsinn vorkommen könnte. In der Praxis kann dies jedoch in vielen Situationen sehr nützlich sein. Bitte beachten Sie, dass ein Teil der in Zeile 04 von Code 02 deklarierten Struktur dem sehr ähnlich ist, was in Code 01 gemacht wurde. Sie enthält sogar sehr ähnliche Fragmente. Die hier implementierte Version unterscheidet sich jedoch erheblich von der in Code 01. Und nicht nur das. In diesem Fall können bei Verwendung von Code 02 – anders als bei Code 01 – einige Daten verloren gehen.
„Aber Moment mal. Wie ist es überhaupt möglich, dass Daten verloren gehen? Stellt das nicht ein Problem für den Code dar?“ Nein, eigentlich nicht, lieber Leser. Es gibt Situationen, in denen dies zu erwarten ist – oder, mit anderen Worten: Wir können Daten verlieren, ohne befürchten zu müssen, dass dies Auswirkungen auf das Endergebnis hat. Das mag vielen von Ihnen etwas seltsam vorkommen. Aber schauen wir uns einmal die im Chart verwendeten gleitenden Durchschnitte an. Gleitende Durchschnitte fungieren gewissermaßen als eine Warteschlange von Werten, aus der die ältesten Werte entfernt werden. Ein gleitender Durchschnitt mit 20 Perioden speichert beispielsweise 20 Werte: Der erste ist der aktuellste, und der letzte wird verworfen, sobald ein neuerer Wert in die Warteschlange aufgenommen wird.
Lesen Sie jetzt aufmerksam mit, denn das ist wichtig. Da wir es mit einem festen Wertebereich zu tun haben und die Werte durch neuere ersetzt werden, sollten wir diese Art von Struktur eher als Warteschlange denn als Liste bezeichnen. Wertelisten dienen einem anderen Zweck; Warteschlangen hingegen haben einen sehr einfachen und praktischen Zweck. Diese beiden Begriffe werden oft verwechselt. Um jedoch jegliche Unklarheiten bei der Interpretation zu vermeiden, bezeichnen wir die hier dargestellte Struktur als Warteschlange. Dabei mag dies auf den ersten Blick nur wie eine Liste von Werten aussehen.
Gut, beachten Sie nun, dass wir im Fall einer Ringwarteschlange eine Möglichkeit benötigen, den Bereich oder die Anzahl der Werte in der Warteschlange zu begrenzen. Dies geschieht mithilfe der in Zeile 14 beschriebenen Prozedur. Hier legen wir die Anzahl der Werte fest, die die Warteschlange enthalten soll; diese Zahl kann ein beliebiger Wert größer als Null sein. Daher reservieren wir in Zeile 16 genügend Speicherplatz für das in Zeile 08 angelegte dynamische Array. Da wir jedoch unsere Ringwarteschlange initialisieren, müssen wir auch zwei weitere Werte initialisieren. Dies geschieht in Zeile 17. Damit ist die Warteschlange angelegt, und es können Daten eingefügt oder daraus ausgelesen werden.
An dieser Stelle sind viele Menschen, die zum ersten Mal mit diesem Ansatz in Berührung kommen, oft ziemlich verwirrt. Da wir Elemente aus der Warteschlange auslesen müssen, haben wir die Funktion in Zeile 20 implementiert. Diese Funktion gibt ein beliebiges Element aus der Warteschlange zurück. Welches Element? Nun, das hängt von den Umständen ab, lieber Leser. Um den Grund für meine Antwort zu verstehen, beachten Sie bitte, dass in Zeile 22 eine Überprüfung durchgeführt wird. Wenn der Wert von `c_Pos`, der die aktuelle Leseposition angibt, gleich dem Wert von `c_Max` ist, der die aktuelle Schreibposition angibt, dann gibt es keine Elemente, die zurückgegeben werden können. Daher kann die Überprüfung in Zeile 22 in manchen Fällen den Wert `false` zurückgeben.
Geschieht dies nicht, bedeutet dies, dass ein Wert zum Auslesen vorhanden ist. In dieser Situation verwenden wir Zeile 24, um eine neue Leseposition innerhalb der Warteschlange zu berechnen. Wozu benötigen wir diese Berechnung? Wäre es nicht einfacher, den Wert des Zählers `c_Pos` zu erhöhen? Nein, nicht wirklich, lieber Leser. Das liegt daran, dass wir mit einer Ringwarteschlange arbeiten: Wenn deren Größe kleiner ist als der gesamte Wertebereich des Typs `uint`, muss der Index wieder an den Anfang springen, wie dies in Zeile 24 geschieht. Infolgedessen zeigt der Zähler `c_Pos` wieder auf den Index 01 des Arrays, sobald er die Obergrenze der Warteschlange erreicht. So wird eine Ringwarteschlange erstellt. Der Rest des Codes ist einfach.
Kommen wir also nun zu der Prozedur in Zeile 30, da sie für einen sehr interessanten und zugleich äußerst faszinierenden Vorgang zuständig ist. Beachten Sie Folgendes: In Zeile 32 finden wir eine Logik, die der in Zeile 24 sehr ähnlich ist; der einzige Unterschied besteht darin, welche Variable angepasst wird. Das Ziel bleibt jedoch dasselbe: Sobald die in Zeile 16 festgelegte maximale Anzahl an Elementen erreicht ist, soll zum Anfang des Arrays zurückgekehrt werden.
„Moment mal – jetzt wird es wirklich kompliziert. Ich sage das, weil mir auffällt, dass in Zeile 34 derselbe Wert, `c_Max`, verwendet wird, um den Index anzugeben, an dem der von uns übergebene Wert gespeichert wird. Sie geben jedoch an, dass der Index in Zeile 32 bei Erreichen der Grenze wieder auf 0 gesetzt wird. Wenn wir nämlich 20 Elemente speichern können und 21 speichern (also eines mehr als das in Zeile 16 festgelegte Limit), können wir dann nur ein Element auslesen?“ Nein, lieber Leser. Die 20 bereits gespeicherten Elemente können wir weiterhin lesen. Das erste in der Warteschlange gespeicherte Element wird jedoch durch dieses neue Element – das 21. Element – ersetzt. „Was für eine verworrene Erklärung. Ich verstehe nicht, wie wir das schaffen sollen.“ Keine Sorge, Sie werden bald alles verstehen. Damit diese Lesemöglichkeit jedoch in der gesamten Ringwarteschlange erhalten bleibt, müssen Sie Zeile 33 implementieren. Diese Zeile rückt die Warteschlange weiter, ohne dass die Array-Elemente verschoben werden müssen.
Bitte beachten Sie: Wenn c_Max gleich c_Pos ist, bedeutet dies, dass die Warteschlange voll ist. Andernfalls werden diese Werte niemals gleich sein. Da die Warteschlange bereits voll ist, setzen wir c_Pos gezielt auf die nächste Position. Um jedoch sicherzustellen, dass `c_Pos` auf die nächste gültige Position in der Warteschlange zeigt, verwenden wir einen zweiten ternären Operator und stellen damit sicher, dass die Grenzen der Ringwarteschlange eingehalten werden. Daher ist dieser zweite ternäre Operator genau derselbe wie der Operator in Zeile 24. Da ich weiß, dass die meisten von Ihnen Anfänger sind und möglicherweise Schwierigkeiten haben, Code 02 zu verstehen, finden Sie im Anhang eine leicht abgeänderte Version des Codes. Der Code ist unten aufgeführt:
01. //+------------------------------------------------------------------+
02. #property copyright "Daniel Jose"
03. //+------------------------------------------------------------------+
04. template <typename T> struct stQueue
05. {
06.     #define macro_AdjustLimit(A) (A < value.Size() - 1 ? A + 1 : 0)
07. //+----------------+
08.     private:
09. //+----------------+
10.         T       value[];
11.         uint    c_Pos,
12.                 c_Max;
13. //+----------------+
14.     public:
15. //+----------------+
16.     void Init(uint arg)
17.     {
18.         ArrayResize(value, arg + 1);
19.         c_Pos = c_Max = 0;
20.     }
21. //+----------------+
22.     bool GetInfo(T &arg)
23.     {
24.         if (c_Pos == c_Max)
25.             return false;
26.         c_Pos = macro_AdjustLimit(c_Pos);
27.         arg = value[c_Pos];
28.
29.         return true;
30.     }
31. //+----------------+
32.     void Stock(const T arg)
33.     {
34.         c_Max = macro_AdjustLimit(c_Max);
35.         c_Pos = (c_Pos == c_Max ? macro_AdjustLimit(c_Pos) : c_Pos);
36.         value[c_Max] = arg;
37.     }
38. //+----------------+
39.     #undef macro_AdjustLimit
40. //+----------------+
41. };
42. //+------------------------------------------------------------------+
43. void OnStart(void)
44. {
45.     stQueue <char> Queue;
46.
47.     Queue.Init(5);
48.
49.     Queue.Stock(10);
50.     Queue.Stock(84);
51.     Queue.Stock(-6);
52.     Queue.Stock(15);
53.     Queue.Stock(-35);
54.     Queue.Stock(40);
55.     Queue.Stock(-35);
56.
57.     for (char info; Queue.GetInfo(info);)
58.         Print(info);
59. }
60. //+------------------------------------------------------------------+
Code 03
Code 03 hat dieselbe Funktion wie Code 02. Der einzige Unterschied liegt in der Definition des Makros in Zeile 06 von Code 03. Dadurch lässt sich Zeile 33 von Code 02 jedoch etwas leichter verstehen. Das liegt daran, dass Zeile 35 von Code 03 viel leichter zu lesen ist. Obwohl es sich um dieselbe Zeile wie Zeile 33 in Code 02 handelt, ist sie leichter zu lesen.
Uns interessiert jedoch vielmehr, wie diese Struktur funktioniert und wie sie eine sogenannte Ringwarteschlange erzeugt und aufrechterhält. Um diese Struktur, die eine Ringwarteschlange bildet, zu testen, nutzen wir den Inhalt der Prozedur „OnStart“.
Wenden wir uns nun Code 03 zu. So können wir die angegebenen Codezeilen nachvollziehen. Zunächst definieren wir die Warteschlange selbst. Die Definition findet sich in Zeile 45. Als Nächstes legen wir fest, wie viele Elemente die Warteschlange enthalten soll. In diesem Fall ist dies in Zeile 47 angegeben. Beachten Sie, dass wir in diesem Fall festlegen, dass die Anzahl der Elemente höchstens fünf betragen darf.
Jetzt kommt der interessanteste Teil – die Verwendung einer Ringwarteschlange. Dazu verwenden wir die Zeilen 49 bis 55. Bitte beachten Sie Folgendes: Wir haben eine Warteschlange, die bis zu fünf Elemente enthalten kann. Wir geben jedoch die Anweisung, diese Warteschlange sieben Elemente hinzuzufügen. Frage: Was wird hier passieren? Antwort: Beim Fortschreiten der Warteschlange werden ältere Elemente überschrieben. Wie können wir uns dessen sicher sein? Dazu verwenden wir Zeile 57 mit einer Schleife, die auf den ersten Blick rätselhaft erscheinen mag. In einem anderen Artikel habe ich jedoch anschaulich erklärt, wie wir mit der `for`-Anweisung Schleifen für einige sehr interessante Zwecke erstellen können. Dies ist ein solcher Fall. Beachten Sie, dass die Schleife selbst die notwendigen Voraussetzungen für ihre Ausführung und Beendigung schafft. Wir interessieren uns für die Ausführung von Zeile 58. Anhand dieser Zeile können wir erkennen, welche Elemente entfernt wurden und welche noch in der Warteschlange verbleiben.
Wenn wir also Code 03 oder Code 02 ausführen, erhalten wir das in der folgenden Abbildung gezeigte Ergebnis:
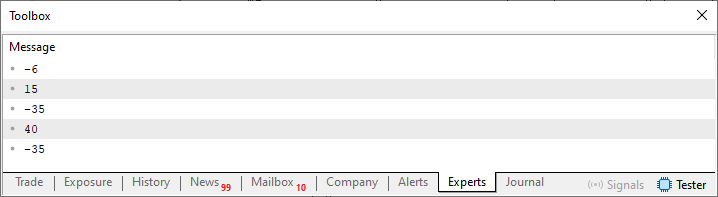
Bild 02
Das war's, lieber Leser. Ich möchte, dass Sie einen Moment innehalten und über das in Abbildung 02 gezeigte Ergebnis nachdenken. Vergleichen Sie dieses Ergebnis mit den Zeilen 49 bis 55 von Code 03. Verstehen Sie, was hier vor sich geht? Erkennen Sie einen Zusammenhang zwischen dem, was in Code 01 gezeigt wurde – wo wir eine FIFO-Warteschlange (zuerst hinein, zuerst hinaus) implementiert haben –, und der in Code 03 implementierten Ringwarteschlange? Ja? Nein? Vielleicht. Sie sehen den Zusammenhang wahrscheinlich nicht, aber es gibt einen Zusammenhang zwischen dem, was zu Beginn dieses Artikels erläutert wurde, und dem, was wir hier sehen. Der Punkt ist folgender: Das erste Element in der Warteschlange wird immer zuerst abgerufen. Ebenso wird das letzte Element in der Warteschlange als Letztes angezeigt. Im Gegensatz zu früheren Methoden begrenzen wir hier die Anzahl der Elemente, die sich in der Warteschlange befinden können. Diese Grenze ist in Zeile 47 von Code 03 definiert.
Genau hier entsteht die Verwirrung – und das ist etwas, was viele Menschen nicht verstehen. Wenn wir mit dem Programmieren anfangen, verschwenden wir viel Zeit damit, etwas zu entwickeln oder umzusetzen. Es ist jedoch durchaus wahrscheinlich, dass es irgendwo bereits eine Implementierung dessen gibt, was wir umzusetzen versuchen. Betrachten Sie nun Folgendes: Angenommen, Sie erstellen einen Expert Advisor zur Analyse eines gleitenden Durchschnitts mit einer Periode von X. „Warum mehr als X Kurswerte speichern? Das ergibt keinen Sinn.“ Ebenso ergibt es keinen Sinn, Kursdaten zu ändern, nur um ein Array mit X Kurswerten auf dem neuesten Stand zu halten. Sie müssen lediglich eine Datenstruktur wie beispielsweise eine Ringwarteschlange erstellen oder implementieren. Die Implementierung selbst sorgt dafür, dass die Kurse stets auf dem neuesten Stand bleiben, und zwar praktisch ohne Verschiebungsoperationen, da die von uns verwendeten Indexzähler diese Verschiebung für uns übernehmen. Dadurch läuft der ausführbare Code wesentlich schneller und lässt sich leichter warten.
Abschließende Gedanken
In diesem Artikel haben wir begonnen, uns mit einem der unter Programmieranfängern am wenigsten bekannten Themen auseinanderzusetzen. Oft möchten Menschen unbedingt programmieren lernen, versuchen aber gar nicht erst, die grundlegenden Konzepte zu verstehen. Meiner Meinung nach ist ein fundiertes Verständnis dieser Konzepte weitaus wichtiger und notwendiger als das endlose Schreiben von Code. Das liegt daran, dass ein fundiertes Verständnis bestimmter Konzepte uns dabei helfen kann, Code zu schreiben, der wesentlich sicherer, schneller und leichter zu warten ist.
Also, lieber Leser, nehmen Sie sich Zeit, das, was Sie aus diesem Artikel gelernt haben, zu vertiefen und in die Praxis umzusetzen. Ich habe ziemlich lange gebraucht, um diese Grundlagen zu verstehen, die ich Ihnen nun zu vermitteln versuche. Als ich mich mit diesem Thema beschäftigte, schenkte ihm niemand große Beachtung. Alle verlangten von uns nur Ergebnisse, ganz gleich, wie wir diese erzielten. Aber hier zeige ich Ihnen diesen Weg. Sie werden lernen müssen, sich auf diesem Weg zurechtzufinden. Auf diese Weise verläuft Ihr Lernprozess so reibungslos und gleichmäßig wie möglich. Nehmen Sie sich Zeit. Vertiefen Sie das, was wir in diesem Artikel gelernt haben, und setzen Sie es in die Praxis um. Im nächsten Artikel werden wir unsere Diskussion über Warteschlangen, Listen und Bäume fortsetzen.
| Datei | Beschreibung |
|---|---|
| Code 01 | Einfache Warteschlange |
| Code 02 | Einfache Warteschlange |
Übersetzt aus dem Portugiesischen von MetaQuotes Ltd.
Originalartikel: https://www.mql5.com/pt/articles/16491
Warnung: Alle Rechte sind von MetaQuotes Ltd. vorbehalten. Kopieren oder Vervielfältigen untersagt.
Dieser Artikel wurde von einem Nutzer der Website verfasst und gibt dessen persönliche Meinung wieder. MetaQuotes Ltd übernimmt keine Verantwortung für die Richtigkeit der dargestellten Informationen oder für Folgen, die sich aus der Anwendung der beschriebenen Lösungen, Strategien oder Empfehlungen ergeben.