

Neuronale Netze im Trading: Adaptive periodische Segmentierung (Fazit)
 20
 0

Einleitung
In früheren Artikeln haben wir Schritt für Schritt untersucht, wie das LightGTS-Framework Zeitreihen in Partituren umwandelt. Zunächst werden im Period Patching-Modul die zu analysierenden Daten automatisch in vollständige Zyklen unterteilt, die mithilfe der FFT ermittelt werden. Jeder dieser Zyklen wird anschließend mithilfe der Flex Projection Layer in ein Token projiziert, was eine flexible Verarbeitung von Fragmenten unterschiedlicher Länge ermöglicht. Im Encoder werden diese Token mit Rotary Positional Encoding (RoPE) angereichert – einer kompakten Methode, um Phasenverschiebungen und relative Positionen einzuweben –, woraufhin klassische Transformer-Blöcke mit Multi-Head Attention lokale Muster zu einem einheitlichen Kontext zusammenführen. Die Prognose wird mithilfe des Mechanismus Periodical Parallel Decoding erstellt, der die gesamte Ausgabesequenz sofort und ohne Autoregression erzeugt. Das Ergebnis wird im Flex-resize-Modul angepasst, wodurch die periodische Konsistenz gewahrt bleibt.
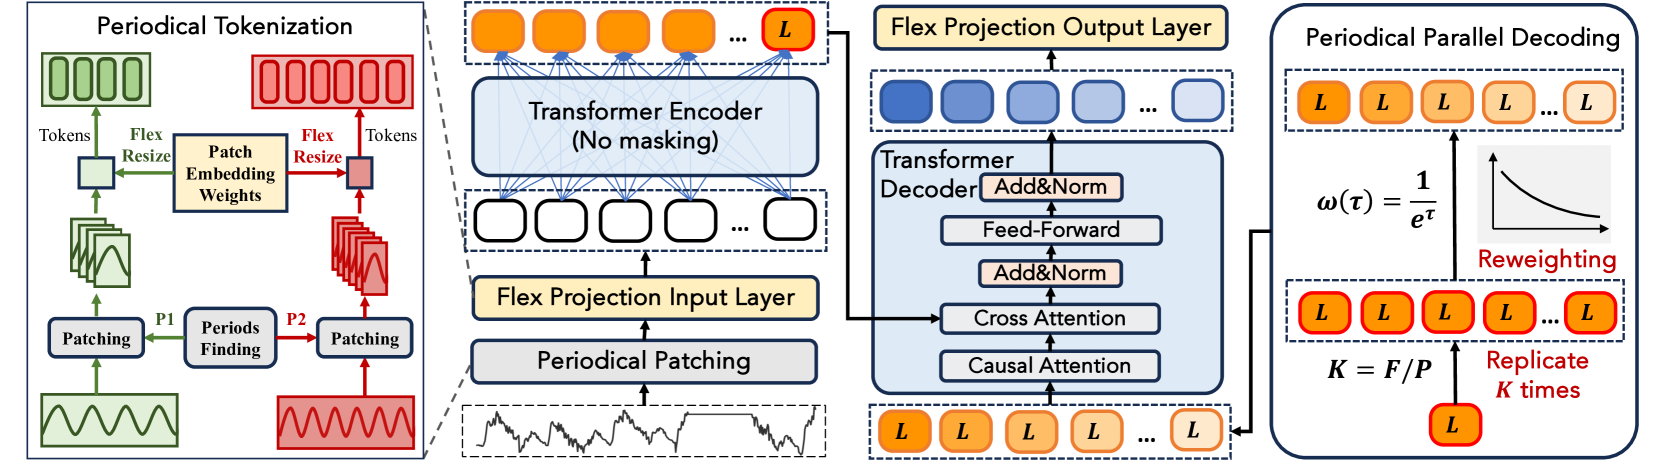
Zu diesem Zeitpunkt hatten wir die Kernideen von LightGTS bereits erfolgreich in Code umgesetzt: Wir hatten gelernt, wie man eine Zeitreihe mithilfe von adaptivem Patching automatisch in periodische Segmente unterteilt, sowie jedes Segment in ein aussagekräftiges Token umwandelt. Wir haben die ursprünglichen Algorithmen um eigene Elemente ergänzt, die Logik hinter der flexiblen Projektion verfeinert und so einsatzbereite Darstellungen lokaler Marktzyklen gewonnen. Heute werden wir den nächsten Schritt unternehmen, um uns eine eigene Sichtweise auf die von den Autoren des LightGTS-Frameworks vorgeschlagenen Ansätze zu erarbeiten.
Der RoPE-Mechanismus
Nachdem die adaptive Faltung eine konzentrierte Menge informativer Token aus der Rohzeitreihe extrahiert hatte, war es an der Zeit, diese durch den leistungsstarken Filter der Transformer-Blöcke zu leiten. In der Standard-Encoder-Decoder-Architektur werden diesen Token einfach sinusoidale oder lernbare Positionskodierungsvektoren hinzugefügt, woraufhin sie an den Aufmerksamkeitsmechanismus weitergeleitet werden. Die Autoren des LightGTS-Frameworks schlagen einen wesentlich eleganteren und flexibleren Ansatz vor: Rotary Positional Encoding (RoPE). Anstelle fester Positionskodierungsvektoren wird jedes Token im Einbettungsraum gedreht.
Der Grundgedanke hinter RoPE besteht darin, eine vektorielle Phasenverschiebung einzuführen, die proportional zur Position des Tokens und zu seinen Dimensionsindizes ist, ohne dabei auf zusätzliche Parameter zurückzugreifen. Es sei darauf hingewiesen, dass diese Technik erstmals in der Arbeit „RoFormer: Enhanced Transformer with Rotary Position Embedding“ vorgestellt wurde, in der die Autoren zeigten, dass das Modell durch die Rotation der Koordinatenpaare der Query- und Key-Vektoren mithilfe einer Rotationsmatrix relative zeitliche Verschiebungen zuverlässig erfassen kann.
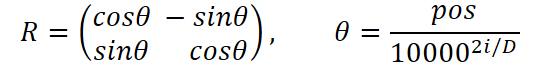
Die Methode lässt sich leicht auf mehrdimensionale Räume verallgemeinern, indem man die Dimensionalität in Wertepaare aufteilt. Daraus ergibt sich eine Einschränkung: Die Dimension des Raums muss gerade sein.
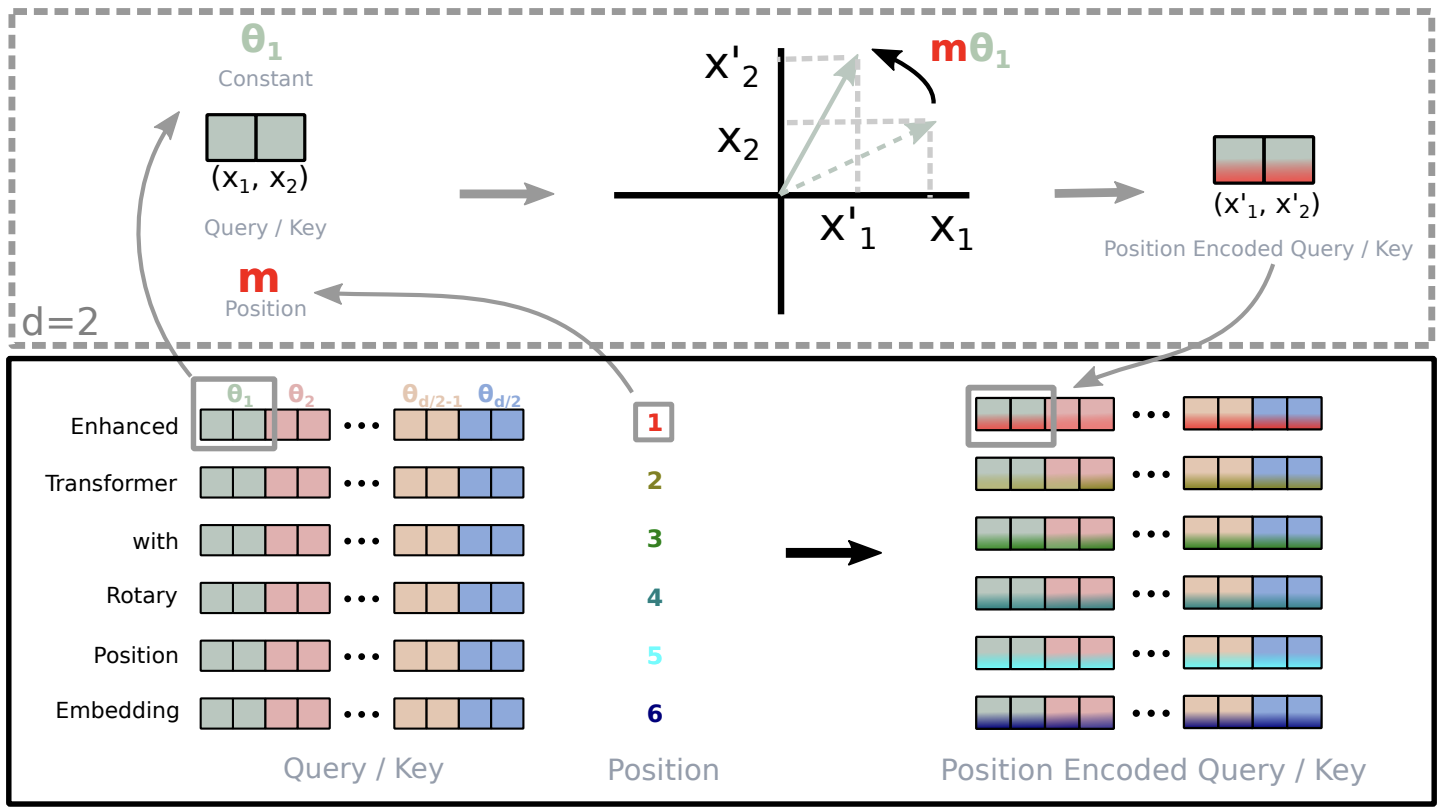
Dank dieser Rotation kann das Modell selbst bei unterschiedlichen Fenstergrößen und einer dynamischen Schrittweite genau bestimmen, welche Token zeitlich näher beieinander liegen und welche weiter voneinander entfernt sind. Dadurch wird der Self-Attention-Mechanismus zu einem hochempfindlichen Detektor für zeitliche Muster: Er vergleicht nicht nur den Inhalt von Query und Key, sondern berücksichtigt auch Phasenunterschiede zwischen den Token. Infolgedessen sind die Token nach mehreren Schichten aus Multi-Head Attention und Feed-Forward tief kontextualisiert.
Nachdem wir uns nun mit den mathematischen und konzeptionellen Grundlagen von Rotary Positional Encoding befasst haben, ist es an der Zeit, uns mit den praktischen Details der Implementierung zu beschäftigen und zu sehen, wie sich all dies in OpenCL-Programmcode umsetzen lässt. Wir haben bereits Token vorbereitet – ein Array aus Vektoren, die jeweils D Dimensionen haben. Außerdem werden wir für jede Position Sinus- und Kosinustabellen vorab berechnen. Unser Ziel ist es, jeden Vektor im Einbettungsraum so zu drehen, dass seine Phase den Zeitstempel widerspiegelt, ohne dabei den Gesamtdurchsatz der Pipeline zu beeinträchtigen. Dazu erstellen wir einen RoPE-Kernel, der in einem dreidimensionalen Ausführungsraum arbeitet. Die erste Dimension entspricht dem Index des Koordinatenpaares innerhalb des Vektors. Diese Dimension entspricht der Hälfte der Länge des Vektors. Die zweite Dimension gibt die Länge der Sequenz an (die Anzahl der Token). Die dritte Dimension gibt die Anzahl der einzelnen Sequenzen an.
Bitte beachten Sie, dass wir der Einfachheit halber bei der Arbeit mit Wertepaaren den Vektordatentyp float2 verwenden.
__kernel void RoPE(__global const float2* __attribute__((aligned(8))) inputs,
                   __global const float2* __attribute__((aligned(8))) position_emb,
                   __global float2* __attribute__((aligned(8))) outputs
                  )
  {
   const size_t id_d = get_global_id(0);     // dimension
   const size_t id_u = get_global_id(1);     // unit
   const size_t id_v = get_global_id(2);     // variable
   const size_t dimension = get_global_size(0);
   const size_t units = get_global_size(1);
   const size_t variables = get_global_size(2);
Im Kernel-Rumpf ermitteln wir zunächst die Koordinaten des aktuellen Work-Items im dreidimensionalen Aufgabenraum. Dies ist notwendig, damit jedes Work-Item genau weiß, mit welchem Datenfragment es arbeiten wird: welches Paar von Vektorkoordinaten es verarbeiten soll, zu welchem Token es gehört und aus welcher Variablen (bzw. welchem Kanal) es stammt.
Sobald die Work-Item-Koordinaten bekannt sind, besteht der nächste Schritt darin, die Offsets in den flachen Arrays der OpenCL-Puffer zu berechnen. Trotz der mehrdimensionalen logischen Struktur werden alle Daten in OpenCL linear gespeichert, sodass Sie den genauen Speicherort des gewünschten Elements manuell berechnen müssen.
   const int shift_in = (id_v * units + id_u) * dimension + id_d;
   const int shift_pos = id_u * dimension + id_d;
   const float2 inp = inputs[shift_in];
   const float2 pe = position_emb[shift_pos];
Um kostspielige Zugriffe auf den globalen Speicher zu minimieren, laden wir das initiale Koordinatenpaar und die entsprechenden Sinus-/Kosinus-Faktoren sofort in lokale Vektorvariablen, die für den Kernel praktisch in Registern verbleiben. Schließlich ist jeder Zugriff auf Puffer im globalen Speicher deutlich aufwendiger als die Arbeit mit Vektoren, die bereits lokal vorgehalten werden. Dadurch werden wiederholte Lesezugriffe auf den globalen Speicher nahezu vollständig vermieden, und häufig genutzte Daten werden in Registern oder im lokalen GPU-Speicher gehalten, was den gesamten Prozess der Token-Rotation erheblich beschleunigt und die Effizienz der Kernel-Ausführung maximiert.
Sobald alle Bestandteile (die Eingabedaten und die sin-/cos-Werte) zur Hand sind, können wir zum Hauptereignis übergehen – der Phasenverschiebung. Es ist genau diese Verschiebung, die den Tokens zeitliche Information verleiht und dafür sorgt, dass der Aufmerksamkeitsmechanismus ordnungsgemäß funktioniert.
   float2 result = 0;
   result.s0 = inp.s0 * pe.s0 - inp.s1 * pe.s1;
   result.s1 = inp.s0 * pe.s1 + inp.s1 * pe.s0;
//---
   outputs[shift_in] = result;
  }
Hier wenden wir einfache arithmetische Operationen auf lokale Variablen an: vier Multiplikationen und zwei Additionen für jedes Wertepaar. Dank der vorgeladenen Daten ist dieser Schritt fast augenblicklich abgeschlossen.
Danach schreiben wir das gedrehte Koordinatenpaar sofort in den Ergebnispuffer.
Das ist der Kern des Verfahrens: Indem wir einfach mit vorab berechneten cos- und sin-Werten multiplizieren, geben wir jedem Token Informationen über Phase und relative Zeit, ohne einen einzigen neuen Parameter hinzuzufügen. Daher zeigt dieser Kernel Folgendes:
- Maximale Parallelität – jedes Work-Item wird unabhängig ausgeführt.
- Kein Trainings-Overhead – die Positionskodierung enthält keine trainierbaren Parameter.
- Nahtlose Integration in nachfolgende Aufmerksamkeitsmodule – die Einbettungen berücksichtigen nicht nur den Inhalt der Token, sondern auch deren Phasendifferenzen.
Obwohl RoPE keinen einzigen trainierbaren Parameter in das Modell einführt, ist es uns wichtig, dass Gradienten korrekt fließen können: durch diese Schicht hindurch und zurück zu den Eingabedaten. Dazu erstellen wir einen speziellen Backward-Pass-Kernel namens CalcHiddenGradRoPE, der eine inverse Rotation der Vektoren durchführt.
Das Prinzip ist einfach: Der Forward-Pass-Kernel multiplizierte die Eingabedaten (x, y) mit einer Rotationsmatrix. In Rückwärtsrichtung müssen wir ihre Transponierte anwenden – das heißt, eine Drehung um −θ, wobei gilt: cos(−θ) = cosθ und sin(−θ) = −sinθ.
Der Algorithmus des Backward-Pass-Kernels ist praktisch identisch mit dem oben für den Forward Pass beschriebenen. Es wird derselbe Aufgabenraum verwendet, und die Offsets in den globalen Datenpuffern werden auf ähnliche Weise definiert. Der einzige kleine Unterschied besteht in der Drehung der Vektoren. Zudem sind die Eingabedaten für die Ausführung der Operationen die Fehlergradienten auf der Ausgabeebene.
__kernel void CalcHiddenGradRoPE(__global float2* __attribute__((aligned(8))) inputs_gr,
                                 __global const float2* __attribute__((aligned(8))) position_emb,
                                 __global const float2* __attribute__((aligned(8))) outputs_gr
                                )
  {
   const size_t id_d = get_global_id(0);     // dimension
   const size_t id_u = get_global_id(1);     // unit
   const size_t id_v = get_global_id(2);     // variable
   const size_t dimension = get_global_size(0);
   const size_t units = get_global_size(1);
   const size_t variables = get_global_size(2);
//---
   const int shift_in = (id_v * units + id_u) * dimension + id_d;
   const int shift_pos = id_u * dimension + id_d;
   const float2 grad = outputs_gr[shift_in];
   const float2 pe = position_emb[shift_pos];
//---
   float2 grad_x;
   grad_x.s0 = grad.s0 * pe.s0 + grad.s1 * pe.s1;
   grad_x.s1 = grad.s1 * pe.s0 - grad.s0 * pe.s1;
//---
   inputs_gr[shift_in] = grad_x;
  }
Keine bedingten Verzweigungen oder komplizierten Formeln – nur vier Multiplikationen und ein paar Additionen. Infolgedessen werden die Gradienten der RoPE-Schicht genauso schnell und effizient entdrehen, wie die Token während des Forward Pass gedreht wurden.
Dadurch macht CalcHiddenGradRoPE die RoPE-Schicht zu einem vollwertigen Bestandteil des Trainingsprozesses: Wir können sie in beliebiger Tiefe des Netzwerks einbinden, und sie gibt die Gradienten verlustfrei an die Eingabetensoren zurück, wobei Ausführungsgeschwindigkeit und Parallelität erhalten bleiben.
Nachdem unsere OpenCL-Kernel für Rotary Positional Encoding nun bis zur Perfektion ausgefeilt sind, ist es an der Zeit, diese Leistungsfähigkeit in die MQL5-Welt zu übertragen und sie in einen Handelsroboter zu integrieren. Wir verfügen bereits über einen fertigen Mechanismus zum Rotieren von Tokens auf der GPU – nun muss nur noch ein schlanker Wrapper dafür erstellt werden, der sich in die vertraute Struktur von MQL5-Expert-Advisors einfügt. Genau zu diesem Zweck werden wir die Klasse CNeuronRoPE erstellen, deren Struktur im Folgenden dargestellt ist.
class CNeuronRoPE  :  public CNeuronPositionEncoder
  {
protected:
   uint              iWindow;
   uint              iVariables;
   //---
   virtual bool      feedForward(CNeuronBaseOCL *NeuronOCL) override;
   virtual bool      calcInputGradients(CNeuronBaseOCL *NeuronOCL)override;

public:
                     CNeuronRoPE(void) : iWindow(0), iVariables(0) {};
                    ~CNeuronRoPE(void) {};
   //---
   virtual bool      Init(uint numOutputs, uint myIndex, COpenCLMy *open_cl,
                          uint count, uint window, uint variables,
                          ENUM_OPTIMIZATION optimization_type, uint batch);
   //--- methods for working with files
   virtual bool      Save(int const file_handle) override;
   virtual bool      Load(int const file_handle) override;
   //---
   virtual int       Type(void) override const {  return defNeuronRoPE; }
  };
Die Klasse CNeuronRoPE ist so einfach wie möglich gehalten: Sie verfügt nur über zwei Variablen: iWindow, die die Dimensionalität eines einzelnen Token-Vektors definiert, und iVariables, die die Anzahl der Kanäle angibt. Die gesamte übrige aufwendige Funktionalität im Zusammenhang mit Puffern und der Parameterprüfung wird von CNeuronPositionEncoder geerbt, daher sind der Konstruktor und der Destruktor hier leer. Die Grundlage für die Funktionsweise der gesamten Schicht wird in der Methode Init gelegt.
bool CNeuronRoPE::Init(uint numOutputs, uint myIndex, COpenCLMy *open_cl,
                       uint count, uint window, uint variables,
                       ENUM_OPTIMIZATION optimization_type, uint batch)
  {
   if(window % 2 > 0)
      return false;
   if(!CNeuronBaseOCL::Init(numOutputs, myIndex, open_cl, count * window * variables, optimization_type, batch))
      return false;
Gleich zu Beginn der Methode führen wir eine einfache, aber äußerst wichtige Überprüfung durch: Die Dimension jedes Tokens muss gerade sein, da RoPE mit Koordinatenpaaren arbeitet. Ohne diese Einschränkung können wir einfach nicht weitermachen: Wir wären nicht in der Lage, Wertepaare eindeutig zu drehen. Sobald dieser Prüfschritt erfolgreich durchlaufen wurde, übergeben wir die Kontrolle an die gleichnamige Methode in der übergeordneten Klasse, in der die verbleibenden Prüfungen und der Initialisierungsalgorithmus für die geerbten Schnittstellen bereits implementiert sind.
Als Nächstes speichern wir die Parameter des Eingabedatentensors in internen Variablen.
   iWindow = window;
   iVariables = variables;
Nun wenden wir uns der Konstruktion der Einbettungsmatrix zu, die für RoPE von zentraler Bedeutung ist: ein zweidimensionales Array, in dessen geraden Spalten die Kosinuswerte (θ) und in dessen ungeraden Spalten die Sinuswerte (θ) stehen.
Zunächst erstellen wir eine pe-Matrix der erforderlichen Größe. Dies ist eine Arbeitsfläche, die wir gleich mit Sinus- und Kosinuswerten füllen werden. Um zu verstehen, wie jede Spalte der Matrix auf den entsprechenden Schritt der Zeitreihe reagiert, konstruieren wir zunächst einen Positionsvektor: Wir nehmen einen Vektor aus Einsen, berechnen dessen Präfixsummen und subtrahieren eins, sodass sich [0, 1, 2, …, count–1] ergibt. Dieser Vektor gibt uns genau an, welchen Schritt wir gerade kodieren.
   matrix<float> pe = matrix<float>::Zeros(count, iWindow);
   vector<float> position = vector<float>::Ones(count);
   position = position.CumSum() - 1;
Als Nächstes folgt der Hauptteil: Wir durchlaufen alle Dimensionspaare, da jedes Paar von Token-Koordinaten einen eigenen Satz von Winkeln erfordert. Für jedes solche Paar nehmen wir den Positionsvektor und dividieren ihn durch einen wachsenden Nenner, der gleich pow(10000, 2 * i / iWindow) ist, um die Rotation der Dimensionen höherer Ordnung zu verlangsamen und die der Dimensionen niedrigerer Ordnung zu beschleunigen. Als Ergebnis erhalten wir ein Array von Winkeln: keine einzelnen Zahlen, sondern einen Vektor θ für alle Positionen.
   for(uint i = 0; i < iWindow / 2; i++)
     {
      vector<float> temp = position / MathPow(10000.0f, 2.0f * i / window);
      pe.Col(MathCos(temp), i * 2);
      pe.Col(MathSin(temp), i * 2 + 1);
     }
So schreiben wir in jede gerade Spalte der pe-Matrix die Kosinuswerte der resultierenden Winkel und in die benachbarte ungerade Spalte die Sinuswerte. Dadurch wird die Matrix zu einer gebrauchsfertigen Tabelle, in der jede Spalte mit einem eigenen Wertepaar [cos(θ), sin(θ)] versehen ist, um jedes Token rotieren zu können. Wir führen all diese Berechnungen einmalig im CPU-Code durch, damit wir anschließend einen einsatzbereiten Satz von Funktionen an die GPU-Kernel übergeben können.
Wir übertragen die gefüllte Matrix in den Datenpuffer und schließen die Methode ab, indem wir das boolesche Ergebnis der Operationen an das aufrufende Programm zurückgeben.
   PositionEncoder.BufferFree();
   if(!PositionEncoder.AssignArray(pe))
      return false;
   SetActivationFunction(None);
//---
   return PositionEncoder.BufferCreate(open_cl);
  }
Dank dieses Ansatzes erhalten unsere OpenCL-Kernel eine vorberechnete Sinus-/Kosinus-Tabelle als Eingabe und können mit voller Leistung arbeiten, ohne durch unnötige mathematische Operationen belastet zu werden.
Dadurch konzentriert sich die gesamte Ersteinrichtung auf eine einzige Methode: Ändern Sie einfach die Parameter window oder variables, und die Schicht passt sich sofort an die neuen Bedingungen an. Dieser Ansatz gewährleistet, dass der Code sauber und klar bleibt, und gibt uns gleichzeitig die volle Kontrolle über das Verhalten des RoPE-Moduls.
Wenn der Forward Pass beginnt, müssen Sie lediglich die Methode feedForward aufrufen und ihr einen Zeiger auf das Quelldatenobjekt übergeben, das bereits mit Token gefüllt wurde. Im Hintergrund achtet die Methode auf jedes Detail: Sie prüft, ob der empfangene Zeiger gültig ist, reiht einen RoPE-Kernel mit den passenden Work-Group-Größen zur Ausführung ein, wartet auf dessen Abschluss und gibt dann die Kontrolle zurück. Das Ergebnis ist ein Puffer mit rotierten Token, der bereit ist, an das Attention-Modul weitergegeben zu werden.
Während des Trainings kommt die Methode calcInputGradients zum Einsatz. Diese Methode startet den CalcHiddenGradRoPE-Kernel. Die Logik selbst ist fast das Spiegelbild des Forward Pass: dieselben Koordinaten, dieselben Offsets, aber die Drehung erfolgt in die entgegengesetzte Richtung, um den Gradienten wieder in seine ursprüngliche Darstellung zu bringen. Das Endergebnis wird sauber im Eingangsgradientenpuffer abgelegt und reibungslos an die früheren Schichten des Modells weitergereicht.
Beide Methoden sind im Wesentlichen Wrapper für die entsprechenden Kernel und folgen einem Algorithmus, mit dem Sie bereits vertraut sind. Daher werden wir in diesem Artikel nicht näher darauf eingehen. Den vollständigen Code für die hier vorgestellte Klasse sowie alle ihre Methoden finden Sie im Anhang.
Nachdem die Token nun den RoPE-Phasenfilter durchlaufen haben, sind sie bereit, in das Herzstück des Modells zu gelangen – das Aufmerksamkeitsmodul. Standardmäßig baut das LightGTS-Framework seine Logik auf der klassischen Encoder–Decoder-Architektur auf, sodass wir das Rad nicht neu erfinden müssen: Alle erforderlichen Komponenten sind bereits in unserer Bibliothek vorhanden. Sie müssen lediglich die rotierten Token in eines der vorhandenen Self-Attention-Module einspeisen, wo Multi-Head Attention sehr effektiv arbeitet und lokale Muster mit dem globalen Kontext der Zeitreihe verknüpft.
In der ursprünglichen Version von LightGTS schlagen die Autoren vor, das letzte versteckte Token nach dem Encoder zu nehmen und es genau so oft zu replizieren, wie es erforderlich ist, um den angegebenen Prognosehorizont abzudecken, sodass der Decoder die gesamte Ausgabesequenz auf einmal generieren kann. Wir hingegen haben einen mutigen Schritt in Richtung Vereinfachung unternommen: Wir brauchen keine Replikation. Erstens ist es nicht unser Ziel, hochpräzise Zahlenwerte zu erhalten, sondern alle wertvollen Informationen aus der latenten Darstellung für den Agent zu extrahieren, der sie nutzen wird, um Handelsentscheidungen zu treffen. Zweitens führen wir bei jedem neuen Bar Berechnungen durch, der stets kürzer ist als ein vollständiger Marktzyklus. Ein finales Token für jede Einheitssequenz reicht uns also völlig aus.
Daher leiten wir diese finale Einbettung – ohne mehrere Kopien zu erzeugen – über die Hauptpipeline an den Decoder weiter. Dort durchläuft sie dieselbe Multi-Head Attention und denselben Feed-Forward-Block, jedoch ohne unnötige Wiederholungen: Das Modell stützt sich auf eine reine, konzentrierte Darstellung, die alle relevanten Informationen über die jüngsten Marktbewegungen enthält. Dieser Ansatz schont Ressourcen, vereinfacht die Logik und ermöglicht es dem Agent, so schnell wie möglich zu handeln – schließlich erfordert jede Bar eine sofortige Reaktion, und wir brauchen keine tausend Kopien eines Tokens, sondern ein einziges starkes Signal, das zu Gewinn führen kann.
Modellarchitektur
Schließlich erreichen wir den Höhepunkt – den Moment, in dem alle sorgfältig getesteten und fehlerbereinigten Module zu einem einzigen, reibungslos funktionierenden System zusammenwachsen. In unserem MQL5-Projekt geschieht dies in der Funktion CreateDescriptions, in der wir die sieben Zweige des neuronalen Netzes Schritt für Schritt aufbauen: den Encoder, drei Prognoseströme und die drei Komponenten des Agent – Actor, Director und Critic.
bool CreateDescriptions(CArrayObj *&encoder,
                        CArrayObj *&forecast1,
                        CArrayObj *&forecast2,
                        CArrayObj *&forecast3,
                        CArrayObj *&actor,
                        CArrayObj *&director,
                        CArrayObj *&critic
                       )
  {
//---
   CLayerDescription *descr;
//---
   if(!encoder)
     {
      encoder = new CArrayObj();
      if(!encoder)
         return false;
     }
   if(!forecast1)
     {
      forecast1 = new CArrayObj();
      if(!forecast1)
         return false;
     }
   if(!forecast2)
     {
      forecast2 = new CArrayObj();
      if(!forecast2)
         return false;
     }
   if(!forecast3)
     {
      forecast3 = new CArrayObj();
      if(!forecast3)
         return false;
     }
   if(!actor)
     {
      actor = new CArrayObj();
      if(!actor)
         return false;
     }
   if(!director)
     {
      director = new CArrayObj();
      if(!director)
         return false;
     }
   if(!critic)
     {
      critic = new CArrayObj();
      if(!critic)
         return false;
     }
Zunächst überprüfen wir, ob die Zeiger auf die dynamischen Arrays in jedem Container gültig sind. Falls eines davon noch nicht angelegt wurde, reservieren wir sorgfältig Speicher für ein neues dynamisches Array. Diese Container bilden die Struktur, in die die Beschreibungen der neuronalen Schichten eingefügt werden.
Im Encoder beginnt alles mit einer einfachen, vollverbundenen Schicht, die die Rohdaten empfängt – eine Sequenz historischer Bars, von denen jeder durch einen Satz von Merkmalen beschrieben wird.
//--- Encoder
   encoder.Clear();
//--- Input layer
   if(!(descr = new CLayerDescription()))
      return false;
   descr.type = defNeuronBaseOCL;
   uint prev_count = descr.count = (HistoryBars * BarDescr);
   descr.activation = None;
   descr.optimization = ADAM;
   if(!encoder.Add(descr))
     {
      delete descr;
      return false;
     }
//--- layer 1
   if(!(descr = new CLayerDescription()))
      return false;
   descr.type = defNeuronBatchNormWithNoise;
   descr.count = prev_count;
   descr.batch = BatchSize;
   descr.activation = None;
   descr.optimization = ADAM;
   if(!encoder.Add(descr))
     {
      delete descr;
      return false;
     }
Anschließend führen wir Batch-Normalisierung mit zusätzlichem Rauschen ein, wodurch die Verteilung der Aktivierungen sanft angeglichen wird. Anschließend fahren wir mit der ersten Operation auf den Eingabedaten fort, bei der die Differenzen zwischen benachbarten Punkten in der Sequenz extrahiert werden. Auf diese Weise können wir die Veränderungsdynamik hervorheben.
//--- layer 2
   if(!(descr = new CLayerDescription()))
      return false;
   descr.type = defNeuronConcatDiff;
   prev_count = descr.count = HistoryBars;
   descr.layers = BarDescr;
   descr.step = 1;
   descr.batch = BatchSize;
   descr.optimization = ADAM;
   descr.activation = None;
   if(!encoder.Add(descr))
     {
      delete descr;
      return false;
     }
Die nächste Schicht fügt den Rohdaten zeitgestempelte Harmonische hinzu und wandelt jede Bar nicht nur in einen Satz von Kurs- und Volumenmerkmalen um, sondern in einen Punkt auf einer Zeitachse.
//--- layer 3
   if(!(descr = new CLayerDescription()))
      return false;
   descr.type = defMamba4CastEmbeding;
   prev_count = descr.count = HistoryBars;
   descr.window = 2 * BarDescr;
   uint prev_out = descr.window_out = NSkills;
     {
      uint temp[] = {PeriodSeconds(PERIOD_H1), PeriodSeconds(PERIOD_D1)};
      if(ArrayCopy(descr.windows, temp) < (int)temp.Size())
         return false;
     }
   descr.batch = BatchSize;
   descr.optimization = ADAM;
   descr.activation = None;
   if(!encoder.Add(descr))
     {
      delete descr;
      return false;
     }
//--- layer 4
   if(!(descr = new CLayerDescription()))
      return false;
   descr.type = defNeuronTransposeOCL;
   descr.count = prev_count;
   prev_count = descr.window = prev_out;
   descr.batch = BatchSize;
   descr.optimization = ADAM;
   descr.activation = None;
   if(!encoder.Add(descr))
     {
      delete descr;
      return false;
     }
   prev_out = descr.count;
Anschließend transponieren wir das Ergebnis, um es für die Eingabe in die adaptive Faltung CNeuronAdaptConv vorzubereiten. Auf den ersten Blick mag dies wie ein routinemäßiger technischer Vorgang erscheinen, doch genau hier findet der entscheidende Übergang statt: Wir strukturieren die Daten so um, dass sich jede einzelne Sequenz in adaptive Patches aufteilen lässt – kompakte, lokalisierte Segmente der Zeitreihe, die lokale Muster enthalten.
Dadurch kann sich CNeuronAdaptConv flexibel an die Eigenschaften der Eingabedaten anpassen: Einige Patches erfassen impulsartige Bewegungen, während andere Phasen der Stabilität oder Schwingungen erfassen. Im Wesentlichen versorgen wir das Modell nicht nur mit einem flachen Wertearray, sondern mit einer strukturierten Darstellung, die eine klar definierte räumlich-zeitliche Hierarchie aufweist. Dadurch kann der Encoder den kurzfristigen Kontext bewahren und gleichzeitig tief liegende, verborgene Muster in komplexen Zeitreihen aufdecken.
//--- layer 5
   if(!(descr = new CLayerDescription()))
      return false;
   descr.type = defNeuronAdaptConv;
   descr.count = Segments;
   descr.window = 2*prev_out/Segments;
   descr.variables = prev_count;
   prev_out = descr.window_out = EmbeddingSize;
   descr.batch = BatchSize;
   descr.optimization = ADAM;
   descr.activation = None;
   if(!encoder.Add(descr))
     {
      delete descr;
      return false;
     }
   prev_count = descr.count;
   uint prev_var = descr.variables;
Der nächste Schritt ist RoPE (Rotary Positional Encoding) – ein Mechanismus, der auf den ersten Blick überflüssig erscheinen mag, da die Quelldaten bereits mit Zeitstempeln versehen wurden. Der entscheidende Unterschied liegt hier jedoch in der Anwendungsebene.
Die hinzugefügten Zeitstempel beziehen sich auf einzelne Bars – also auf die Rohdaten. Sie dienen dazu, die absoluten Zeitkoordinaten jeder Beobachtung zu erfassen, bevor die strukturelle Verarbeitung beginnt.
Die Daten durchlaufen anschließend eine Patching-Phase, in der Gruppen aufeinanderfolgender Bars zu Segmenten zusammengefasst werden. Dieses Segment wird dann in ein einzelnes Token umgewandelt – eine aggregierte Darstellung des lokalen Zeitintervalls. An dieser Stelle wird RoPE auf die resultierenden Token angewendet.
Somit kodiert RoPE keine Positionen innerhalb des Patches – schließlich wurden diese zu diesem Zeitpunkt bereits zu einer einzigen Darstellung zusammengefasst. Stattdessen bettet es Informationen über die Position des Patches innerhalb der Gesamtsequenz ein. Mit anderen Worten: RoPE ermöglicht es dem Modell, die Reihenfolge zu erfassen, in der die Patches relativ zueinander auftreten, was für die Analyse der globalen Struktur der untersuchten Zeitreihe von entscheidender Bedeutung ist.
Diese Positionierung von RoPE macht es zu einer idealen Ergänzung: In Kombination mit Zeitstempeln auf Bar-Ebene ermöglicht es ein hierarchisches Zeitverständnis – von detaillierten Werten auf Bar-Ebene bis hin zu den relativen Positionen aggregierter Blöcke.
//--- layer 6
   if(!(descr = new CLayerDescription()))
      return false;
   descr.type = defNeuronRoPE;
   descr.count = prev_count;
   descr.window = prev_out;
   descr.variables = prev_var;
   descr.batch = BatchSize;
   descr.optimization = ADAM;
   descr.activation = None;
   if(!encoder.Add(descr))
     {
      delete descr;
      return false;
     }
Nach der Anwendung von RoPE transponieren wir die Daten erneut – dieses Mal so, dass das nachfolgende Multi-Head Self-Attention-Modul das Array der Token-Vektoren unter Berücksichtigung ihrer chronologischen Reihenfolge effektiv auslesen kann. Dies ist ein rein technischer, aber wichtiger Schritt: Der Aufmerksamkeitsmechanismus muss die Daten in der richtigen Form sehen; andernfalls erhalten wir am Ende nichts als Chaos statt eines gewichteten Vergleichs der Token.
Als Nächstes kommt die Self-Attention ins Spiel, die mit 4 Attention-Heads und 3 aufeinanderfolgenden Schichten konfiguriert ist. Diese Architektur ermöglicht es dem Modell, verschiedene Aspekte der Beziehungen zwischen Token parallel zu analysieren – jeder Head konzentriert sich dabei auf seinen eigenen Merkmalsunterraum. Das ist so, als hätte man vier Experten, von denen jeder auf seine eigene Weise die Bedeutung der Verbindungen zwischen Patches bewertet.
//--- layer 7
   if(!(descr = new CLayerDescription()))
      return false;
   descr.type = defNeuronTransposeRCDOCL;
   descr.count = prev_var;
   descr.window = prev_count;
   descr.step = prev_out;
   descr.batch = BatchSize;
   descr.optimization = ADAM;
   descr.activation = None;
   if(!encoder.Add(descr))
     {
      delete descr;
      return false;
     }
//--- layer 8
   if(!(descr = new CLayerDescription()))
      return false;
   descr.type = defNeuronComplexMLMHAttentionOCL;
   descr.count = prev_count;
   descr.window = prev_out / 2 * prev_var;
   descr.window_out = descr.window / 4;
   descr.layers = 3;
   descr.step = 4;
   descr.batch = BatchSize;
   descr.activation = None;
   descr.optimization = ADAM;
   if(!encoder.Add(descr))
     {
      delete descr;
      return false;
     }
An dieser Stelle sei betont, dass der RoPE-Mechanismus nicht nur eine Möglichkeit ist, Positionsinformationen hinzuzufügen. Es rotieren Token-Vektoren in der komplexen Ebene unter Verwendung von Elementen der komplexen Mathematik. Dieser Ansatz ermöglicht es uns, die relativen Positionen der Token explizit zu berücksichtigen, indem wir Phasenverschiebungen in die Einbettungen integrieren.
Genau aus diesem Grund haben wir uns – im Gegensatz zur Implementierung des LightGTS-Frameworks durch den Autor, bei der Standard-Self-Attention zum Einsatz kam – bewusst für die komplexe Version des Aufmerksamkeitsmoduls CNeuronComplexMLMHAttentionOCL entschieden. Dadurch wird mathematische Konsistenz gewährleistet: Wenn die Positionskodierung im komplexen Bereich erfolgt, muss auch die Attention-Schicht in der Lage sein, mit komplexwertigen Größen zu arbeiten.
Dadurch ist das Modell nicht nur in der Lage, die Beziehungen zwischen Token zu erkennen, sondern auch deren Phasenverschiebung zu berücksichtigen, was bei der Arbeit mit periodischen und wellenartigen Strukturen in Finanzzeitreihen von entscheidender Bedeutung ist. Drei Attention-Schichten sorgen für Verarbeitungstiefe, wodurch das Modell sowohl lokale als auch weiter entfernte Abhängigkeiten in der Zeitreihe erfassen kann. Auf diese Weise entsteht eine kontextreiche Darstellung – eine Art komprimierter Überblick über die gesamte Sequenz, der für die nächsten Stufen des Modells aufbereitet wird.
Als Decoder verwenden wir das Modul CNeuronTimeMoEAttention, das die Leistungsfähigkeit der Multi-Head Attention mit der eleganten Mechanik einer „Sparse Mixture of Experts“ (MoE) kombiniert. Dieses Modul wurde speziell für die effiziente Zeitreihenanalyse und die Erstellung aussagekräftiger latenter Darstellungen entwickelt, was insbesondere in Finanzanwendungen von Bedeutung ist, bei denen jedes Detail der zeitlichen Dynamik eine Rolle spielt.
Eine zentrale Neuerung ist der Ersatz des klassischen Feed-Forward-Blocks durch einen Block vom Typ Sparse Mixture of Experts – CNeuronTimeMoESparseExperts. Dieser Ansatz ermöglicht es, Rechenressourcen flexibel und effizient unter verschiedenen Experten zuzuweisen, von denen jeder seine eigene Teilmenge von Merkmalen analysiert, wodurch die Verarbeitungsqualität verbessert und Redundanzen reduziert werden.
//--- layer 9
   if(!(descr = new CLayerDescription()))
      return false;
   descr.type = defNeuronTimeMoEAttention;
   descr.window_out = EmbeddingSize;
     {
      uint temp[] = {prev_out, prev_out, 8, TopK};               //Window Main, Window Cross, Experts dimension, TopK
      if(ArrayCopy(descr.windows, temp) < ArraySize(temp))
         return false;
     }
     {
      uint temp[] = {prev_var, prev_var * prev_count, NExperts}; //Units Main, Units Cross, Experts
      if(ArrayCopy(descr.units, temp) < ArraySize(temp))
         return false;
     }
   descr.layers = 3;
   descr.step = 4;                                                // Attention heads
   descr.batch = BatchSize;
   descr.activation = None;
   descr.optimization = ADAM;
   if(!encoder.Add(descr))
     {
      delete descr;
      return false;
     }//---
   CLayerDescription *latent = descr;
Als Ausgabe des Environment State Encoder erhalten wir eine kompakte und dennoch aussagekräftige latente Darstellung der analysierten Daten.
Diese Darstellung ist nicht nur eine Sammlung von Vektoren. Es handelt sich um eine sorgfältig verfeinerte, äußerst detaillierte Beschreibung der aktuellen Marktsituation, die alle wesentlichen Merkmale der Marktdynamik, der Saisonalität und kurzfristiger Anomalien bewahrt. Der Encoder scheint das Marktverhalten aufzunehmen, Rauschen herauszufiltern und dessen Essenz zu destillieren, um sie als kompakte Token weiterzugeben.
Diese Token enthalten nicht die gesamte Historie – stattdessen sammeln sie Bedeutung an, aggregieren Ursache-Wirkungs-Beziehungen und identifizieren die wichtigsten Faktoren. Und genau diese Token werden anschließend zu einer universellen Wissensquelle für alle anderen Komponenten des Systems: für die Prognoseblöcke, das Entscheidungsmodul (Actor) und die Evaluatoren (Director und Critic).
Tatsächlich ist der Encoder in unserer Architektur der einzige semantische Kompressionskanal, durch den alle historischen und aktuellen Marktinformationen geleitet werden. Das Ergebnis seiner Arbeit lässt sich mit einer hochwertigen Aufnahme einer komplexen Szene vergleichen: komprimiert und dennoch scharf, reich an Details, die für die weitere Analyse und Entscheidungsfindung wichtig sind.
Während des Trainings verwenden wir drei parallele Prognosemodelle mit jeweils unterschiedlichem Prognosehorizont, um einen reichhaltigen und stabilen latenten Raum zu bilden. Dieser Ansatz ermöglicht es unserem Encoder, sowohl kurzfristige Impulse als auch langfristige Markttrends zu erfassen, ohne dabei seine Fähigkeit zur Verallgemeinerung zu verlieren.
Jedes dieser Modelle hat Zugriff auf die Ausgabe desselben Encoder, wird jedoch mit seinem eigenen Target trainiert, das einem bestimmten Prognosehorizont entspricht. Während der Backpropagation werden die Gradienten aller drei Modelle aggregiert, sodass der Encoder gleichzeitig auf ein multidimensionales Ziel hin trainiert werden kann:
- kurzfristig schnell und präzise zu sein;
- gegenüber Marktrauschen robust zu bleiben;
- seine strategische Ausrichtung nicht zu verlieren.
So zwingen wir den latenten Raum bereits in der Trainingsphase dazu, verschiedene Ebenen der Marktlogik aufzunehmen, was später allen anderen Komponenten des Systems einen erheblichen Vorteil verschafft. Der von diesem Encoder erzeugte Zustand eignet sich gleichermaßen gut zur Generierung von Handelsentscheidungen (Actor) wie auch zur Bewertung ihrer Qualität (Critic und Director).
Die Architektur der Prognosemodelle wurde vollständig und unverändert aus unserer früheren Arbeit übernommen. Da sie sich bereits bei einer Reihe von Aufgaben bewährt hat, ist es in diesem Artikel nicht sinnvoll, näher auf ihre Details einzugehen.
Die Architektur des Actor wurde jedoch erheblich verbessert, um die Adaptivität und Ausdrucksfähigkeit der Policy zu erhöhen. Die aktualisierte Struktur umfasst sieben Schichten, von denen jede dem Modell spezifische Fähigkeiten hinzufügt. Zunächst wird, wie bisher, eine grundlegende vollverbundene Schicht verwendet; wir übergeben ihr Informationen über den aktuellen Kontozustand und offene Positionen.
//--- Actor
   actor.Clear();
//--- Input layer
   if(!(descr = new CLayerDescription()))
      return false;
   descr.type = defNeuronBaseOCL;
   descr.count = AccountDescr;
   descr.activation = None;
   descr.optimization = ADAM;
   if(!actor.Add(descr))
     {
      delete descr;
      return false;
     }
//--- layer 1
   if(!(descr = new CLayerDescription()))
      return false;
   descr.type = defNeuronBatchNormOCL;
   descr.count = AccountDescr;
   descr.batch = BatchSize;
   descr.activation = None;
   descr.optimization = ADAM;
   if(!actor.Add(descr))
     {
      delete descr;
      return false;
     }
Anschließend erfolgt eine Batch-Normalisierung, um das Training zu stabilisieren und die Skala der aus verschiedenen Quellen gewonnenen Merkmale anzugleichen.
Die Multi-Head-Cross-Attention-Schicht ermöglicht es dem Modell, den aktuellen Kontozustand mit dem Kontext der analysierten Marktsituation abzugleichen, der vom Environment State Encoder bereitgestellt wird.
//--- layer 2
   if(!(descr = new CLayerDescription()))
      return false;
   descr.type = defNeuronCrossDMHAttention;
     {
      uint temp[] = {AccountDescr,           // Input window
                    latent.windows[0]        // Cross window
                   };
      if(ArrayCopy(descr.windows, temp) < (int)temp.Size())
         return false;
     }
     {
      uint temp[] = {1,                      // Input units
                    latent.units[0]          // Cross units
                   };
      if(ArrayCopy(descr.units, temp) < (int)temp.Size())
         return false;
     }
   descr.step = 4;                  // Heads
   descr.window_out = 8;
   descr.batch = 1e4;
   descr.layers = 2;
   descr.activation = None;
   descr.optimization = ADAM;
   if(!actor.Add(descr))
     {
      delete descr;
      return false;
     }
Dank seiner zweischichtigen Attention-Architektur mit vier Attention-Heads kann das Modell relevante Aspekte des Kontexts auswählen, um Aktionen zu generieren.
Als Nächstes folgt ein dreischichtiges MLP zur Entscheidungsfindung. Hier verwendet jede Schicht ihre eigene Aktivierungsfunktion. Die hyperbolische Tangensfunktion ermöglicht es, Token in einen kompakten, kontinuierlichen Raum mit höherer Empfindlichkeit im Grenzbereich.
//--- layer 3
   if(!(descr = new CLayerDescription()))
      return false;
   descr.type = defNeuronBaseOCL;
   descr.count = LatentCount;
   descr.batch = BatchSize;
   descr.activation = TANH;
   descr.optimization = ADAM;
   if(!actor.Add(descr))
     {
      delete descr;
      return false;
     }
Darauf folgt eine glatte Nichtlinearität, die positive Werte beibehält. Dies ist wichtig für die Generierung von Aktionsparametern.
//--- layer 4
   if(!(descr = new CLayerDescription()))
      return false;
   descr.type = defNeuronBaseOCL;
   descr.count = LatentCount;
   descr.activation = SoftPlus;
   descr.batch = BatchSize;
   descr.optimization = ADAM;
   if(!actor.Add(descr))
     {
      delete descr;
      return false;
     }
Außerdem werden Logits für das anschließende Aktions-Sampling generiert. Die verdoppelte Anzahl der Ausgaben könnte mit der Parametrisierung von Mittelwert und Varianz im Sinne probabilistischer Policies zusammenhängen.
//--- layer 5
   if(!(descr = new CLayerDescription()))
      return false;
   descr.type = defNeuronBaseOCL;
   descr.count = 2 * NActions;
   descr.activation = SoftPlus;
   descr.optimization = ADAM;
   if(!actor.Add(descr))
     {
      delete descr;
      return false;
     }
Durch die Einführung einer variationalen Schicht lassen sich Aktionen stochastisch generieren, während die Kontrolle über die Verteilung erhalten bleibt. Dadurch wird die Explorationsfähigkeit des Agent verbessert.
//--- layer 6
   if(!(descr = new CLayerDescription()))
      return false;
   descr.type = defNeuronVAEOCL;
   descr.count = NActions;
   descr.optimization = ADAM;
   if(!actor.Add(descr))
     {
      delete descr;
      return false;
     }
Der letzte Schritt ist eine Faltung, die auf die bereits generierten Aktionen angewendet wird. Dadurch lassen sich lokale Abhängigkeiten zwischen Aktionsparametern verstärken und weiche probabilistische Filter einführen, die die Aktionsparameter auf den Bereich [0, 1] abbilden.
//--- layer 7
   if(!(descr = new CLayerDescription()))
      return false;
   descr.type = defNeuronConvOCL;
   descr.count = NActions / 3;
   descr.window = 3;
   descr.step = 3;
   descr.window_out = 3;
   descr.activation = SIGMOID;
   descr.optimization = ADAM;
   if(!actor.Add(descr))
     {
      delete descr;
      return false;
     }
Insgesamt zeigt die neue Architektur des Actor-Moduls eine tiefere Interaktion mit dem Kontext, ein hohes Maß an Verhaltensvariabilität und beim Treffen von Handelsentscheidungen die Fähigkeit, historische Abhängigkeiten zu berücksichtigen.
Die Bewertungsmodelle Director (Director) und Critic (Critic) sowie die Prognosekomponenten wurden unverändert aus früheren Arbeiten übernommen. Dieser Teil der Architektur hat sich über die Jahre bewährt und sich beim Training von Agents als wirksam erwiesen. Die vollständige Architektur aller trainierbaren Komponenten ist im Anhang enthalten.
Tests
Das Modelltraining wurde in zwei Phasen unterteilt, wodurch das System schrittweise, zuverlässig und ohne Zeitdruck aufgebaut werden konnte.
Zunächst führten wir ein Offline-Training durch. Dazu wurden 15 Jahre historischer Daten für das EURUSD-Paar im M1-Zeitrahmen verwendet. Dieser Datenumfang deckt eine Vielzahl von Marktbedingungen ab: von anhaltenden Seitwärtsbewegungen bis hin zu raschen Trends und von stabilen Phasen bis hin zu Phasen hoher Volatilität. Das Modell hatte die einzigartige Gelegenheit, zu beobachten, wie sich der Markt unter den unterschiedlichsten Bedingungen verhält. Der Encoder lernte, Regelmäßigkeiten zu erkennen, aussagekräftige Muster zu identifizieren und die Marktlage in einen kompakten und informationsreichen Merkmalsvektor zu kodieren. Dieser Vektor bildet die Grundlage für alle Entscheidungen, die der Agent künftig trifft. Während des Trainings erlernte der Actor eine Verhaltensstrategie auf der Grundlage von Feedbacksignalen des Critic und des Director – dadurch konnte ein stabiles und logisches Verhaltensmodell entstehen.
Anschließend gingen wir zur zweiten Phase über – der Online-Feinabstimmung des Modells unter Verwendung historischer Daten aus dem Jahr 2024. Hier wurde das Training unter Bedingungen durchgeführt, die dem Echtzeit-Handel sehr nahe kamen: Das Modell interagierte Kerze für Kerze mit dem Markt und war dabei Marktrauschen, zufälligen Schwankungen und zeitlichen Verzerrungen ausgesetzt. Dadurch war es nicht nur möglich, das Modell feinzujustieren, sondern auch sein Verhalten an die Echtzeitdynamik des Marktes anzupassen, die Strategie zu optimieren und seine Widerstandsfähigkeit gegenüber Unsicherheit zu verbessern.
Nach Abschluss des Trainings führten wir umfassende Tests mit neuen Daten durch – Kursnotierungen für Januar bis März 2025. Alle Einstellungen wurden im Vorfeld festgelegt und blieben während des gesamten Tests unverändert. Dadurch wurden die Objektivität und Transparenz der Bewertung gewährleistet und jegliche Form von Curve-Fitting oder Eingriffen ausgeschlossen. Die Testergebnisse sind unten aufgeführt.
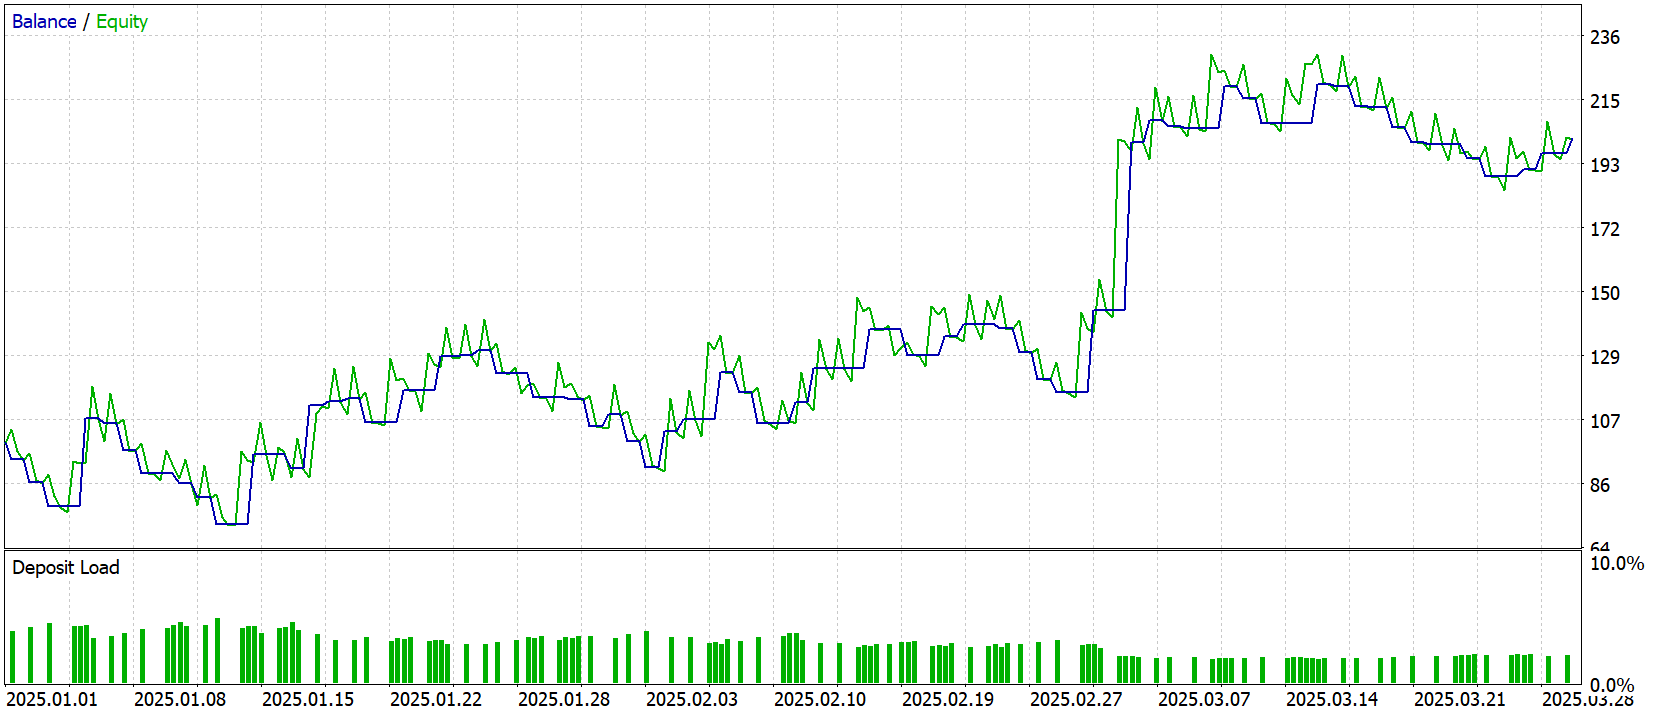
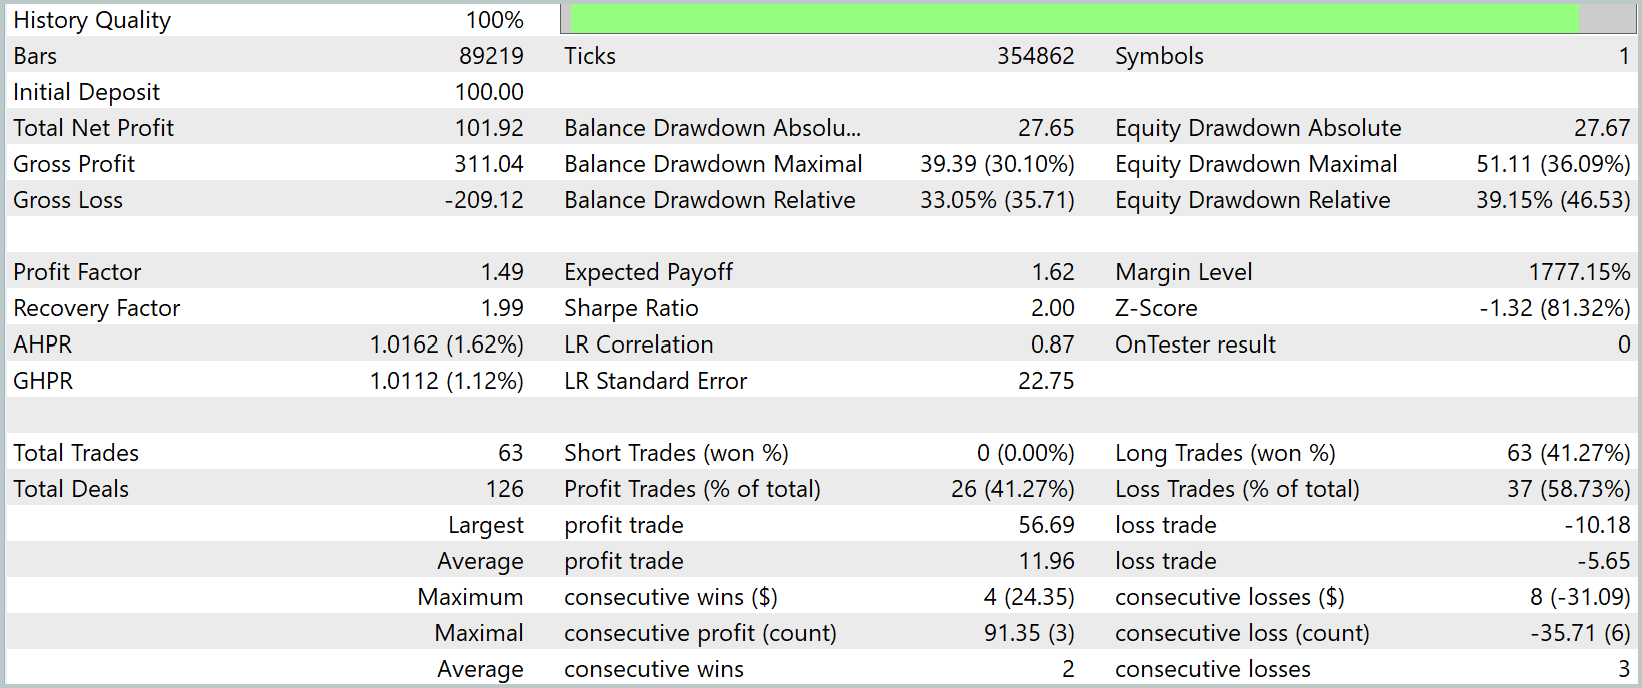
In einem dreimonatigen Test auf dem Ein-Minuten-Chart (M1) erzielte unser Modell ein beeindruckendes Kapitalwachstum – von 100 USD auf fast 202 USD, womit sich das Startkapital mehr als verdoppelte. Gleichzeitig waren zwar nur etwa 41 % der Trades profitabel, doch der durchschnittliche Gewinn von 12 USD lag deutlich über dem durchschnittlichen Verlust von 5,6 USD, was zu einem Profit Factor von 1,49 führte. Die Equity-Kurve zeigt deutlich starke Rallys nach jedem Drawdown, und ein Recovery Factor von fast zwei bestätigt eine rasche Erholung vom maximalen Drawdown von 36 %.
Trotz all dieser positiven Aspekte fällt jedoch ein gravierender Bias auf: Das Modell geht durchweg nur Long-Positionen ein und folgt konsequent dem übergeordneten Aufwärtstrend. Dies zeigt sich besonders deutlich im Ein-Minuten-Zeitrahmen: Solange die Kurse steigen, realisiert der Agent Gewinne, doch beim geringsten Anzeichen einer Trendwende verpasst er die Gelegenheit, von einer Short-Position zu profitieren.
Um die Strategie wirklich vielseitig zu gestalten, müssen wir noch daran arbeiten, sie zu optimieren.
Fazit
Im Rahmen unserer Arbeit haben wir eine flexible Architektur neuronaler Netze entwickelt: von adaptivem Patching und RoPE bis hin zu komplexen Modulen wie Time‑MoEAttention und Actor–Director–Critic. Das System ist in der Lage, sowohl kurzfristige Impulse als auch langfristige Trends zu erkennen, und seine dreifache Prognose über verschiedene Prognosehorizonte hinweg macht es robust gegenüber Marktrauschen. Der nächste Schritt besteht darin, die Strategie für den Handel in beide Richtungen zu optimieren, indem sowohl Long- als auch Short-Positionen unterstützt werden und das Risikomanagement für beide Richtungen feinjustiert wird. Erst nach Abschluss einer Phase umfangreicher Tests und Feinabstimmungen auf der Grundlage von Realdaten werden wir in der Lage sein, ein wirklich wettbewerbsfähiges automatisiertes Handelssystem zu entwickeln.
Literaturverzeichnis
- LightGTS: A Lightweight General Time Series Forecasting Model
- RoFormer: Enhanced Transformer with Rotary Position Embedding
- Andere Artikel dieser Serie
In diesem Artikel verwendete Programme
| # | Name | Typ | Beschreibung |
|---|---|---|---|
| 1 | Study.mq5 | Expert Advisor | Expert Advisor für das Offline-Modelltraining |
| 2 | StudyOnline.mq5 | Expert Advisor | Expert Advisor für das Online-Training des Modells |
| 3 | Test.mq5 | Expert Advisor | Expert Advisor zum Testen des Modells |
| 4 | Trajectory.mqh | Klassenbibliothek | Struktur zur Beschreibung des Systemzustands und der Modellarchitektur |
| 5 | NeuroNet.mqh | Klassenbibliothek | Klassenbibliothek zum Erstellen neuronaler Netze |
| 6 | NeuroNet.cl | Bibliothek | Codebibliothek für ein OpenCL-Programm |
Übersetzt aus dem Russischen von MetaQuotes Ltd.
Originalartikel: https://www.mql5.com/ru/articles/18686
Warnung: Alle Rechte sind von MetaQuotes Ltd. vorbehalten. Kopieren oder Vervielfältigen untersagt.
Dieser Artikel wurde von einem Nutzer der Website verfasst und gibt dessen persönliche Meinung wieder. MetaQuotes Ltd übernimmt keine Verantwortung für die Richtigkeit der dargestellten Informationen oder für Folgen, die sich aus der Anwendung der beschriebenen Lösungen, Strategien oder Empfehlungen ergeben.

 Die Übertragung der Trading-Signale in einem universalen Expert Advisor.
 Neuronale Netze im Trading: Eine intelligente Prognosepipeline (Sparse Mixture of Experts)
 Eine alternative Log-datei mit der Verwendung der HTML und CSS
 Neuronale Netze im Handel: Adaptive periodische Segmentierung (LightGTS)

- Freie Handelsapplikationen
- Über 8.000 Signale zum Kopieren
- Wirtschaftsnachrichten für die Lage an den Finanzmärkte
Sie stimmen der Website-Richtlinie und den Nutzungsbedingungen zu.