

交易中的神经网络:结构化分量解耦(SCNN)
 25
 0

引言
多变量时间序列预测是机器学习领域的基础问题。借助这一研究视角,我们可以分析大量实际应用问题:从需求预估、流量预测,到识别市场参与者行为与报价波动。该问题在金融领域尤为关键 —— 归根结底,几乎所有资产(无论是股票、货币还是大宗商品)都可以视为复杂的多变量时间序列,包含大量互相关联的影响因子:成交量、价格、技术指标、宏观经济数据、行为信号等等。
这类预测的核心难点在于识别时空相关模式。空间维度体现在外部环境特征:流动性差异、交易时段区别、区域性市场活跃度。而时间模式则和市场自身节律相关:交易周期、消息驱动的行情脉冲、宏观数据发布的周期性。在实际场景中,金融时间序列远非平稳序列。序列会遭遇突变、分布偏移,还会在不同行情阶段之间发生复杂切换:趋势行情、横盘震荡、恐慌抛售与狂热牛市。此外,自相关关系并不稳定:当下有效的规律,到明天可能不再具备预测能力。
以Transformer、循环神经网络、卷积结构为代表的现代神经网络方法,无需满足平稳性假设,在短期预测任务中表现出色。然而,在真实的市场环境下,这类模型大多只在遇到训练中见过的模式时才表现稳健。一旦遭遇突变(例如流动性枯竭、市场参与者行为模式转变),预测精度会急剧下滑。另外,这类模型本质上仍是黑箱模型,计算开销大,可解释性有限。
在此背景下,时间序列分解思想(即将序列拆分为趋势项、季节项与残差波动项)正受到越来越多关注。这种思路能够简化问题结构、增强模型的自适应能力,也让预测依据变得更加透明。在部分场景下,即便是采用分解思想的简单线性模型,在预测精度与稳定性上甚至优于复杂神经网络。
但必须承认,这类方法同样存在局限性。许多分解方案只关注长期分量与季节分量,而忽略了短期或高波动片段 —— 恰恰是这些片段中藏着市场的关键信号。另外,如果对各分量独立处理、分量之间不进行信息交互,则难以捕捉高层级的非线性相互作用。然而,面对动态变化的自相关特性,静态参数方案效果欠佳:模型的最优参数必须根据当前市场状态灵活调整。
为克服上述难题,论文《Disentangling Structured Components: Towards Adaptive, Interpretable and Scalable Time Series Forecasting》(解耦结构化分量:面向自适应、可解释且可扩展的时间序列预测)中提出了一种全新架构 —— 结构化分量神经网络(SCNN),这也是首个完全基于时间序列结构分解构建的神经网络。SCNN的核心思路是将数据策略性地拆解为多种异质分量:不仅包含长期趋势与季节波动,还包含快速变化的高波动片段。每一类分量都交由专属子网络处理,而子网络本身正是针对该分量的动力学特性而调优。依托该方法,模型对市场环境变化的响应能力更强,模型的工作机制也更易理解,透明度更高。
SCNN的一大核心特征是分解与重构过程内置在神经网络架构内部,而不是仅局限于输入和输出阶段。该架构不仅可以对数据进行深度分解,还能够捕捉各分量之间复杂的相互作用,包括跨连接与隐依赖关系。此外,每个网络模块均采用双分支结构:一个分支根据当前市场状态动态调整模型参数;另一分支利用这些参数对隐特征进行处理。本质上讲,模型可以实时重构自身,自适应匹配当前的自相关结构。
为进一步提升SCNN的鲁棒性与泛化能力,框架作者引入了一种特殊的结构正则化机制。该机制引导模型重点关注时间序列中受噪声与畸变影响更小的分量。因此,即便在不稳定的市场环境中(部分模式快速衰减且新模式突然涌现),SCNN依旧可以维持较高的预测精度与可靠性。
框架作者在三组独立数据集上开展了大量实验测试,验证了上述结论。SCNN的表现持续优于对比方法,尤其是面对数据剧烈分布偏移与异常值场景时优势明显。尤为重要的是,该模型的计算负载处于合理水平,既支持本地运算,也便于集成到交易系统当中。
SCNN算法
在论文中,SCNN框架的作者假定:时间序列是分阶段形成的,从随机扰动逐步演化为复杂市场结构。
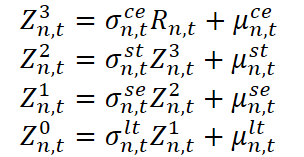
式中,Z⁰n,t为观测时间序列原始值(例如价格或成交量);当i = 1, 2, 3时,Zⁱn,t代表不同结构层级的中间表征。Rn,t为残差分量,包含噪声或意外异常值。每一个阶段同时包含乘性系数σ(表征缩放效应)与加性偏移µ(对应绝对调整量)。
为直观理解该结构,我们类比市场数据分析来阐释。以某资产的价格走势为例:长期分量:反映基本面变动,例如利率带来的影响或经济层面的结构性变革。季节分量:由周期性重复模式构成,与季度财报、缴税周期、大型市场参与者的行为相关。短期分量:捕捉局部波动,例如新闻发布、交易活跃度抬升、临时流动性短缺所引发的行情。协同演化层:对同步市场事件建模,例如同一板块多只股票同步对同一条宏观新闻做出反应。残差分量由白噪声或异常值构成,例如单笔大额订单、报价错误带来的扰动。
需要注意的是,在真实市场环境下,各层级之间的边界是动态模糊的。举例来说,某只股票成交量突然放大,一开始会被视作异常值,但如果该现象持续,则演变为短期趋势;倘若延续数周,最终会融入长期结构。模式的这种演化特性,要求模型具备灵活性,能够适配不断变化的数据结构。
在该框架内,每一个分量同时具备乘性效应与加性效应。乘性效应用于对比例变化建模,而加性效应则反映恒定偏移,例如企业分红、季节性费用这类不依赖当前价格水平的持续性影响。正是这两类效应的组合,让模型可以尽可能真实地刻画市场数据。毕竟,在部分场景中相对变化是核心因素,而另一些场景下绝对值更为关键。
长期分量用于识别时间序列中稳定的结构化模式,例如成交量稳步增长、经济上行背景下市场活跃度扩张。这里所说的模式并非单纯指时间先后序列,而是聚合数据的分布形态,不绑定特定时间点。因此,长期结构由跨越多个季节周期、在较长时段采集数据的统计特征决定。
其思路很简单:融合不同周期的观测样本,平滑短期波动,对持续性趋势得到更清晰、噪声更少的估计。该方法有助于避免对临时异常(一次性成交量脉冲、短期回调)过拟合,使模型聚焦于底层市场动力学。
实现该机制时,会使用长度为∆的滑动窗口,在每个时间步动态选取观测样本。随后计算两项核心统计参数:均值(分布中心)和标准差(刻画波动幅度)。两个参数共同构成长期分量的表征。之后,对每一段待分析序列做归一化:减去长期均值,再除以标准差。该操作将所有片段统一到相同量纲,消除长期偏移,为下一阶段的季节分解预处理数据。
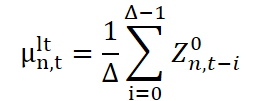
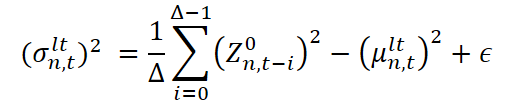
式中,μˡᵗn,t和σˡᵗn,t 分别为窗口∆内求得的长期均值与尺度(标准差);Z¹n,t是剔除长期分量后的归一化值,送入下一级处理,用于提取季节性特征。
这一阶段可理解为市场的平滑后的表征,已经将持续性结构趋势纳入考量。这一点在金融预测中尤为重要:日内策略这类短期策略,需要滤除长期偏移的数据,才能识别局部机会,而不被全局趋势干扰。
季节分量用于提取时间序列里循环往复的周期性模式。放到金融市场场景中,这类模式可以是日内交易活跃度峰谷:早盘冲高、午盘交投清淡、收盘前再度放量。也包含周度规律,如周五波动率走低、周一成交量抬升;还有财报、宏观数据发布带来的季度、年度季节效应。
框架假设季节周期长度在一段时间内保持恒定,这是一个简化但具备实用性的假设。然而,针对周期长度可变的场景,作者提出可引入FFT (快速傅里叶变换)自动估计季节性周期。
技术层面上,季节分量的提取流程和长期归一化类似,但存在一处关键差异:使用膨胀窗口(dilated window),窗口步长等于周期长度。设τ为窗口尺寸,m为膨胀因子(本质就是周期长度)。以此按照匹配季节结构的间隔对数据进行扫描。
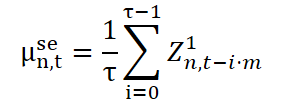
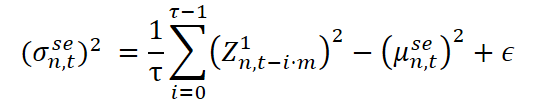
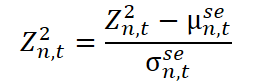
这里的Z²n,t代表经过归一化、季节调整后的数据,将送入下一处理阶段。
短期分量用于捕捉无法由长期趋势或季节模式解释的局部不规则偏离。在金融市场中,这类扰动可能由消息面突发反应、技术故障、流动性投机性激增,或是波动率环境下交易者情绪的急剧转向所引发。这是一种市场的短时脉动,反映市场在极短时间区间内对外界刺激的敏感程度。
与长期归一化不同,此处采用较小的平滑窗口,避免对短期波动造成过度平滑。设δ为该窗口长度。 基于样本的位置参数与尺度参数等标准统计量,随后对数据执行归一化。
得到的Z³n,t是经过滤波、剔除短期扰动后的中间表征,送入归一化的最终阶段。
但该分量存在局限性:第一,无法对剧烈突变即时响应,模型存在惯性;第二,如果变化仅持续2或3个时间步,则有可能被忽略,高方差环境下该问题尤为明显。这类似于市场场景:单只标的的短期波动,若其幅值淹没在聚合噪声中,会被整体系统忽略。
为弱化该效应、提升模型对短期信号的敏感度,SCNN引入协同演化时间序列机制。换言之,当在某个品种上观测到偏离时,模型会检索其他资产(衍生品、指数、成交量等)是否存在同步信号。因此,短期分量不仅具备响应能力,还拥有上下文感知能力 —— 这在高频与算法交易中尤为关键。
协同演化分量在模型整体结构中承担特殊作用。前述三个分量均单独分析单条时间序列自身行为;而该模块依托空间相关性,可捕捉多条时序同时发生的瞬时变化。如果两条及以上时间序列在同一时刻展现相近动态,则强烈暗示存在共同生成过程。此时可通过聚合相关观测值,对该过程进行估计。
然而,实现该机制需要解决一个核心难题:准确判定哪些时序参与这一联合过程。本质就是度量时间序列之间的相关性。这里有两种实现思路:一是基于专家知识预先固定相关矩阵;二是直接从数据中学习得到相关矩阵。该框架作者选用第二种方案 —— 灵活性更强、通用性更好,尤其在缺少数据结构先验信息的场景。
对于每一对时间序列n和n',单独计算注意力系数,再通过SoftMax函数归一化。保证每条时序对应的权重之和等于1。
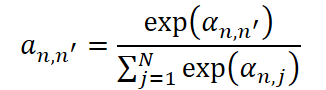
利用这些权重,计算协同演化分量的参数。首先计算均值,在考虑变量间关联的前提下完成局部中心化。
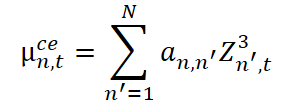
接下来,估计尺度(标准差),计算时引入稳定常数ϵ。
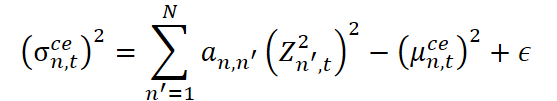
基于上述结果,构造归一化残差项。
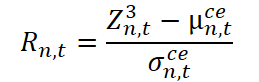
残差Rn,t代表无法被前述任意分量解释的信号部分。它反映残余不确定性、结构性噪声,或是某条特定序列偏离整体动态、难以形式化建模的独有偏差。
当处理大量时间序列时,可进一步提升模型可扩展性。为此引入了邻接矩阵学习模块,以便灵活调整注意力架构、优化计算开销。
在最终阶段,将所有中间表征合并为单个特征向量。
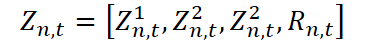
同时,生成归一化参数的辅助向量。
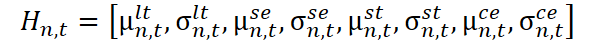
因此,时间序列不再只是随时间记录的一组数值。它被转化为多分量表征,每个分量对应一类特定动力学特征:结构性趋势、周期性季节震荡、局部短期波动,或是跨标的集体同步变化。借此实现更精准的数据分析、构建可解释模型,并开发稳健的预测算法。
由于各分量的演化规律及其可预测性各不相同,自然需要对它们分开建模。这一点在短期预测场景下尤为重要:长期分量与季节分量通常保持稳定,遵循较规则的模式。在此条件下,可直接外推,无需引入额外参数或复杂模型。
因此,长期分量采用最简假设:在整个预测时域内,其数值保持恒定。也就是说,只要已知该分量当前参数估计值,直接将其延拓至未来即可。
而季节分量依托周期性,处理方式会稍复杂。由于循环特性保持不变,我们复用周期内同相位历史时点的参数。即t+i时刻的季节分量取值取自t-m+i时刻,其中,m为周期长度。
该方法保留季节节律,可高精度外推分量行为,且不会额外增加模型计算负担。
与长期和季节分量不同,短期分量、协同演化层以及残差表征的随机性要强得多。其动态规律更加不规则,无法使用固定启发式规则或刚性外推公式。因此,框架作者针对这三类分量,采用基于自回归的参数化模型,刻画其复杂、不可预测的波动。
在预测时域内的每个时间点i,利用前δ个历史值,通过带可训练权重的线性模型,计算对应分量的值。短期分量、协同演化分量和残差分量使用同一套外推流程,表达式如下:
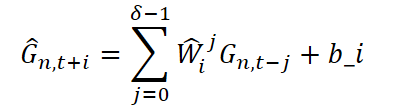
式中,G ∈ {Zˡn,t+i, μstn,t+i, σstn,t+i,μcen,t+i, σcen,t+i}代表各分量对应的外推参数;Ŵji ∈ Rdz · dz为可训练权重矩阵,反映历史值的贡献;bi为可训练偏置项(bias)。
完成外推后,所有分量合并为两组向量:
- Ĥn, t+i —— 统计参数集合;
- Źn, t+i —— 归一化表征集合。
为建模两组特征之间的相互作用,对两组经过线性投影的特征做逐元素相乘;两组线性投影均由可训练参数矩阵生成。
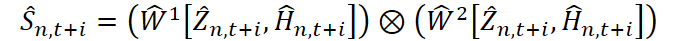
最终形成预测表征,综合了所研究过程中的全部统计显著特征。
MQL5的实现
在详细梳理SCNN框架的理论基础之后,我们进入模型的工程实现部分。本节介绍一种具体的实现方案:使用MQL5把模型的核心思想落实到实际应用中。我们将演示如何把时间序列分解为各结构分量,以及如何搭建模型的预测模块,同时保留模型的可解释性与模块化特性。借助这一方案,我们可以基于复杂神经网络架构,构建直观、灵活且具备自适应能力的交易策略。
在SCNN框架实现的第一阶段,我们重点搭建核心模块:一套用于在固定时间区间内提取统计特征并对输入数据做归一化的算法。这一阶段是时间序列分解流程中的关键环节:长期分量与短期分量都在此生成,而后续所有预测计算都依赖这两个分量。
该算法被封装为名为PeriodNorm的OpenCL内核,负责在时间序列的滑动窗口内计算统计特征并完成数据归一化。其实现采用了并行计算的方式,能够同时处理所有变量和全部时间窗口的数据。
__kernel void PeriodNorm(__global const float* inputs,
                         __global float2* mean_stdevs,
                         __global float* outputs,
                         const int total_inputs
                        )
  {
   const size_t i = get_global_id(0);
   const size_t p = get_local_id(1);
   const size_t v = get_global_id(2);
   const size_t windows = get_global_size(0);
   const size_t period = get_local_size(1);
   const size_t variable = get_global_size(2);
该函数接收输入值数组inputs,同时还包含用于存放归一化结果的数组outputs,以及保存统计参数(均值与标准差)的数组mean_stdevs。传入参数还有total_inputs,用于定义单个变量对应的时间序列长度。
工作项(work-item)采用三维组织形式:第一维对应窗口编号(时间段),第二维对应窗口内的位置,第三维为变量索引。因此,每个工作项负责处理某个变量、某个窗口内的一个特定时间序列元素。
首先,计算内存中正确读取数据所需的索引。变量shift_i代表当前点相对于时间序列起点的位置;shift_v代表跨变量的偏移量;shift_ms代表统计量数组内的位置。
   __local float Temp[LOCAL_ARRAY_SIZE];
   const int shift_i = i * period + p;
   const int shift_v = v * total_inputs;
   const int shift_ms = v * windows + i;
随后,从源数组读取时间序列数值,并校验无效值:如果遇到NaN(非数值)或无穷值,则将其替换为 0。
//---
   float val = 0;
   if((shift_i) < total_inputs)
      val = IsNaNOrInf(inputs[shift_v + shift_i], 0);
下一步计算当前窗口内的均值。这里调用辅助函数LocalSum,该函数对本地工作组内各个工作项的元素值做求和运算,能够大幅提升计算性能。
   float mean = IsNaNOrInf(LocalSum(val, 1, Temp) / period, 0);
   val -= mean;
   BarrierLoc;
将得到的均值从当前观测值中减去,再基于此计算标准差,即均方偏差的平方根。所有计算环节均内置数值稳定性校验,防止除零错误与误差累积。
   float stdev = LocalSum(val * val, 1, Temp) / period;
   stdev = IsNaNOrInf(sqrt(stdev), 1);
计算结果以两种形式保存:第一,将每个窗口、每个变量对应的统计量写入mean_stdevs数组;第二,归一化后的数值存入outputs数组输出。
   mean_stdevs[shift_ms] = (float2)(mean, stdev);
   if((shift_i) < total_inputs)
      outputs[shift_v + shift_i] = IsNaNOrInf(val / stdev, 0);
  }
归一化采用经典 z-score(标准化)公式,以实时计算得到的标准差作为归一化基准。
该内核具备良好的可扩展性:修改窗口大小、变量数量或时间序列长度,都无需改动核心逻辑。特别地,当窗口长度增大时,归一化计算会对长期趋势变得敏感,可用于提取趋势分量。反之,缩小窗口尺寸,则可以更精准地捕捉短期偏离与异常信号。
如果要实现包含反向传播的完整训练周期模型,必须保证梯度能够从神经网络的输出端反向传播至输入端。尽管PeriodNorm内核不含任何可训练参数(全部计算均为纯统计运算,仅依赖输入时序数据),但如果归一化操作是计算图的一部分,仍然需要计算梯度。因此,我们在架构中新增第二个内核:PeriodNormGrad。
__kernel void PeriodNormGrad(__global const float* inputs,
                             __global float* inputs_gr,
                             __global const float2* mean_stdevs,
                             __global const float2* mean_stdevs_gr,
                             __global const float* outputs,
                             __global const float* outputs_gr,
                             const int total_inputs
                            )
  {
   const size_t i = get_global_id(0);
   const size_t p = get_local_id(1);
   const size_t v = get_global_id(2);
   const size_t windows = get_global_size(0);
   const size_t period = get_local_size(1);
   const size_t variable = get_global_size(2);
与带有可训练参数的传统网络模块不同,PeriodNormGrad内核专门解决的是:如何在不包含神经元与权重的网络层中正确地反向传播误差。首先,在内核内部为每个变量建立对时序各个时间窗口的逐元素访问机制。索引的计算方式与前向传播完全一致:
- i —— 窗口编号,
- p —— 窗口内位置,
- v —— 变量编号。
通过上述方式得到坐标后,提取全部所需数据:输入值(inp)、归一化后的输出值(out)、归一化输出对应的误差梯度(out_gr),以及窗口预先计算好的均值与标准差(mean_stdev),还有均值、标准差对应的梯度(mean_stdev_gr);当这些统计量被复用时,也可以读取对应的梯度。SCNN框架中,这组统计量会用于数据外推预测。所有数值都会做有效性校验:过滤掉NaN(非数值)与无穷值,防止计算结果受到影响。
   __local float Temp[LOCAL_ARRAY_SIZE];
   const int shift_i = i * period + p;
   const int shift_v = v * total_inputs;
   const int shift_ms = v * windows + i;
//---
   float inp = 0;
   float inp_gr = 0;
   float out = 0;
   float out_gr = 0;
   const float2 mean_stdev = means_stdev[shift_ms];
   const float2 mean_stdev_gr = means_stdev_gr[shift_ms];
   if((shift_i) < total_inputs)
     {
      inp = IsNaNOrInf(inputs[shift_v + shift_i], 0);
      out = IsNaNOrInf(outputs[shift_v + shift_i], 0);
      out_gr = IsNaNOrInf(output_gr[shift_v + shift_i], 0);
     }
接下来是最核心的部分:要衡量每个输入值对模型最终误差的影响,我们需要计算当该输入值发生微小变动时,误差会如何变化。统计学中的归一化操作,是减去均值后再除以标准差。这意味着输入的任何变化,都会同时影响分子(与均值的偏差)和分母(窗口内数据的离散程度)。因此,我们需要分别计算对两个参数的梯度 —— 均值梯度与标准差梯度。
   float mean_gr = LocalSum(out_gr, 1, Temp) / period + IsNaNOrInf(mean_stdev.x, 0);
   BarrierLoc;
   float stdev_gr = out * LocalSum(IsNaNOrInf(out * out_gr, 0), 1, Temp) / period +
                                                        IsNaNOrInf(mean_stdev.y, 0);
为此,我们首先在当前窗口内对该层所有输出梯度out_gr求和并取平均值,这就是对均值的梯度贡献mean_gr。请注意,这里并不是简单直接传递梯度;而是考虑均值发生变化时,会如何影响整个窗口内所有归一化后的值。
下一步,标准差梯度stdev_gr的计算要相对复杂一些:将经均值中心化后的值乘以其误差梯度,再对结果取平均,以此得到误差对数据离散程度的敏感度。
得到这两组梯度之后,就可以计算核心结果 —— 输入本身对应的梯度。我们把out_gr梯度连同它对均值和标准差的导数组合在一起。最终公式经过平衡处理,能够精准反映每个输入值对模型总误差的贡献,同时兼顾该值在窗口内的位置及其对整体统计特征带来的影响。
   inp_gr = (out_gr - mean_gr - stdev_gr) / IsNaNOrInf(mean_stdev.y, 1);
//---
   if((shift_i) < total_inputs)
      inpurs_gr[shift_v + shift_i] = IsNaNOrInf(inp_gr, 0);
  }
最后,和常规流程一致,计算结果回写到输入梯度数组(inputs_gr)。全部运算都做数组边界判断:如果当前索引超出数组范围,则不执行任何计算。
因此,PeriodNormGrad 绝不只是对梯度的形式化实现,更是连接经典统计学与现代模型训练方法的桥梁。它让统计运算能够作为完整节点参与计算图并投入训练,把误差信息正确回传至源头。
在主程序中,我们会创建专用类CNeuronPeriodNorm,用于封装周期归一化OpenCL内核的调用逻辑,同时支持前向传播与反向传播。该类继承自基类CNeuronBaseOCL,说明它属于计算模型组件层级体系中的一员。该新对象的结构如下。
class CNeuronPeriodNorm :  public CNeuronBaseOCL
  {
protected:
   uint                    iPeriod;
   uint                    iVariables;
   uint                    iCount;
   CNeuronBaseOCL          cMeanSTDevs;
   //---
   virtual bool      feedForward(CNeuronBaseOCL *NeuronOCL) override;
   virtual bool      updateInputWeights(CNeuronBaseOCL *NeuronOCL) override { return true; }
   virtual bool      calcInputGradients(CNeuronBaseOCL *NeuronOCL) override;

public:
                     CNeuronPeriodNorm(void) : iPeriod(-1), iVariables(1) {};
                    ~CNeuronPeriodNorm(void) {};
   //---
   virtual bool      Init(uint numOutputs, uint myIndex, COpenCLMy *open_cl,
                          uint units_count, uint period, uint variables,
                          ENUM_OPTIMIZATION optimization_type, uint batch);
   //---
   virtual bool      Save(const int file_handle) override;
   virtual bool      Load(const int file_handle) override;
   //---
   virtual int       Type(void) override const  {  return defNeuronPeriodNorm; }
   virtual void      SetOpenCL(COpenCLMy *obj) override;
//---
   CNeuronBaseOCL*   GetMeanSTDevs(void) { return cMeanSTDevs.AsObject(); }
   virtual uint      GetPeriod(void) const { return iPeriod; }
   virtual uint      GetVariables(void) const { return iVariables; }
   virtual uint      GetUnits(void) const { return iCount; }
  };
该类的内部成员变量对应核心配置参数。具体来说,变量iPeriod用于指定窗口长度,统计处理(均值与标准差计算)都在该窗口内完成。参数iVariables定义待处理变量(或特征)的数量;iCount代表单条序列上独立窗口的总数。
除此之外,类中包含对象cMeanSTDevs,作为前向传播过程中计算所得均值、标准差的中间缓冲区。该缓冲区同样参与反向传播,供PeriodNormGrad内核调用实现。
Init方法承担初始化构造器的作用:接收全部入参,基于参数完成内部结构准备,并将对象绑定到所需的OpenCL资源。
前向传播与反向传播方法本质上只是两个封装层。它们并不亲自执行计算,而是准备好全部所需资源,再把对应的OpenCL内核正确地送入任务队列。
请注意,GetMeanSTDevs函数提供访问已计算统计量缓冲区的接口,可供模型其他组件调用,例如可视化或后续处理。
因此,CNeuronPeriodNorm是一个完整、独立且灵活的组件。它不仅完成归一化计算,还保证自身能够集成到支持训练的计算模型架构之中。整套实现严格遵循神经网络框架设计原则,同时保留MQL5 + OpenCL这种允许手动管控计算流程的系统所特有的清晰逻辑。
附件中有该类包含全部成员方法的完整源码,可供自主研读。
至此,我们已经完成了很多扎实的工作。本文内容信息密度较高,需要一定时间消化理解。现在正好可以短暂休息,调整状态 —— 在下一篇文章中,我们将以全新的精力继续研究。
结论
本文探究了SCNN框架的理论体系,该框架提出一套原创且逻辑自洽的方案,将时间序列分解为具备可解释性的分量:长期分量、季节分量、短期分量与残差分量。该结构不仅提升预测精度,还大幅增强模型透明度,让模型行为更可预测,能够适应不断变化的市场环境。
需要强调的是,各分量的动力学特性存在差异,因此要采用专门的推断方法:长期分量与季节分量采用简单的重复性模式,而短期波动与残差项则使用可训练的自回归结构建模。
在实际实现的章节,我们基于上述理论方案开展自研实现,搭建了模型基础模块之一:时间序列分段周期归一化算法。我们深入研究OpenCL端的计算实现细节,包含前向传播与反向传播。后续即可将该模块嵌入可训练的神经网络架构:这是将SCNN框架适配到MQL5交易任务的关键一步。
在下一篇文章中,我们将继续完善这套实现,新增模型组件,逐步搭建一套基于SCNN框架、用于时序分析与预测的完整系统。
链接
文中所用的程序
| # | 名称 | 类型 | 描述 |
|---|---|---|---|
| 1 | Study.mq5 | EA | 用于离线模型训练的EA |
| 2 | StudyOnline.mq5 | EA | 用于在线模型训练的EA |
| 3 | Test.mq5 | EA | 用于模型测试的EA |
| 4 | Trajectory.mqh | 类库 | 用于描述系统状态与模型架构的结构 |
| 5 | NeuroNet.mqh | 类库 | 用于创建神经网络的类库 |
| 6 | NeuroNet.cl | 库 | OpenCL程序代码库 |
本文由MetaQuotes Ltd译自俄文
原文地址: https://www.mql5.com/ru/articles/18950
注意: MetaQuotes Ltd.将保留所有关于这些材料的权利。全部或部分复制或者转载这些材料将被禁止。
本文由网站的一位用户撰写,反映了他们的个人观点。MetaQuotes Ltd 不对所提供信息的准确性负责,也不对因使用所述解决方案、策略或建议而产生的任何后果负责。

 交易中的神经网络:解耦结构化分量——编码器实现
 神经网络在交易中的应用:时间序列的概率预测(结论)
 神经网络在交易中的应用:一种端到端多变量时间序列预测模型(GinAR)
 借助PythonAnywhere对接MetaTrader与谷歌表格:安全数据传输指南
