

Архитектура машинного обучения в MetaTrader 5 (Часть 23): Предварительный отбор признаков
 42
 0

Содержание
- Введение
- Почему предварительному отбору признаков нужно собственное откалиброванное нулевое распределение
- Конвейер с тремя этапами проверки
- Этап проверки 1: стационарность, совместное применение тестов ADF и KPSS
- Этап проверки 2: энтропия, разбиение на интервалы равной ширины, а не квантильное разбиение
- Этап проверки 3: взаимная информация и поправка для контроля групповой вероятности ошибки первого рода
- Предварительный отбор признаков на данных EURUSD H1
- Чего не показывает результат
- Заключение
- Прикрепленные файлы
Введение
В каждой статье этой серии вплоть до 19-й части предполагалось, что матрица признаков уже существует. Появляется столбец-кандидат, к нему применяется дробное дифференцирование или z-стандартизация, после чего он включается в модель. Ни один этап этого конвейера не проверяет, оправдано ли включение данного столбца в модель. Обычный первый шаг (расчет корреляции или быстрое построение модели с оценкой важности признаков) неявно опирается на нулевую гипотезу, которая не подходит для финансовых данных. Очевидное решение — перестановочный тест: перемешать значения целевой переменной, пересчитать статистику и посмотреть, как часто ее значение после перемешивания превышает исходное. Это решение тоже может быть некорректным, и во втором разделе статьи оценивается масштаб возникающей ошибки на данных EURUSD, а не на учебном примере.
Причина некорректной работы вполне конкретна. При обычном перемешивании ряда целевой переменной предполагается, что все наблюдения обменны. Для будущей доходности за двадцать баров предположение об обменности не выполняется: доходности для бара t и бара t+1 имеют девятнадцать общих слагаемых из двадцати. Независимая перестановка разрушает это перекрытие, поэтому нулевое распределение описывает иную и более простую задачу оценивания, чем та, с которой приходится иметь дело при проверке признака. В исследованной ниже конфигурации (синтетический признак с персистентностью проверяется на связь с реальной целевой переменной EURUSD с перекрывающимися метками) наивное перемешивание приводило к отклонению истинной нулевой гипотезы во всех 200 испытаниях при номинальном уровне значимости 5%. В том же разделе показано, что величина искажения зависит от персистентности признака, перекрытия меток и статистики критерия, поэтому она не является фиксированным свойством перемешивания.
В статье представлена реализация afml.screening с тремя этапами проверки: стационарности, энтропии и взаимной информации. Эти этапы проверки — не три варианта одной идеи. На этапе проверки 1 для каждого признака проводятся две формальные проверки гипотез (ADF и KPSS). Этап проверки 2 — описательный фильтр без нулевой гипотезы и p-значения. Этап проверки 3 — единственный этап, на котором опорное распределение получают с помощью уровня ресэмплинга из раздела 2, и единственный, на котором можно отобрать признак. Все приведенные ниже численные результаты получены на наборе данных EURUSD H1, используемом во всей серии (42 584 согласованных по времени бара за 2018–2024 годы), при предварительном отборе признаков относительно реальной будущей доходности за двадцать баров. Один из девяти столбцов-кандидатов является синтетическим, что явно указывается везде, где он фигурирует.
Эта статья является 23-й частью серии. Она открывает цикл из четырех частей, посвященный предотвращению ухудшения качества: в части 23 проводится предварительный отбор признаков; в части 24 количественно оценивается риск последовательности; в части 25 заменяется последовательный тест; в части 26 проверяется устойчивость процесса. Для понимания статьи необходимо ознакомиться с разбором ошибки заглядывания в будущее при дробном дифференцировании в части 1 этой серии. Здесь этап проверки стационарности применяется только к исходным признакам-кандидатам и не должен применяться к результатам дробного дифференцирования по причинам, изложенным в разделе 4.
Почему предварительному отбору признаков нужно собственное калиброванное нулевое распределение
Рассмотрим признак, который по построению независим от целевой переменной: процесс AR(1) с φ = 0.95, сгенерированный из потока случайных чисел, при формировании которого не использовался ряд целевой переменной. Сопоставим этот признак с реальной целевой переменной — будущей логарифмической доходностью EURUSD H1 за двадцать баров, для которой в каждом испытании берется случайное непрерывное окно длиной 5 000 баров. Статистика критерия — нормированная взаимная информация с поправкой Миллера — Мэдоу; эта же статистика используется на этапе проверки 3. Каждое отклонение нулевой гипотезы является ложноположительным результатом, поэтому корректно откалиброванный тест должен отклонять ее примерно в 5% случаев, в соответствии с номинальным уровнем значимости.
Сравниваются четыре нулевых распределения. Первый метод, naive_shuffle, применяет независимую случайную перестановку к значениям целевой переменной. Второй метод, circular_shift, циклически сдвигает ряд целевой переменной на случайное число позиций, сохраняя ее автокорреляцию при каждом лаге k, за исключением стыка конца и начала ряда. Третий метод добавляет к циклическому сдвигу параметр period=24, ограничивая сдвиг целым числом баров, кратным 24 и тем самым сохраняя для каждого наблюдения исходный час суток. Четвертый метод, stationary_bootstrap, выполняет ресэмплинг целевой переменной блоками, длина которых имеет геометрическое распределение со средним L. В каждом испытании используется 200 повторных выборок.
Схема | Испытания | Частота отклонения нулевой гипотезы | 95-процентный интервал |
|---|---|---|---|
| naive_shuffle | 200 | 100.0% | от 98.2% до 100.0% |
| circular_shift | 1 000 | 4.1% | от 3.0% до 5.5% |
| circular_shift, period=24 | 1 000 | 5.4% | от 4.1% до 7.0% |
| stationary_bootstrap, L=100 | 1 000 | 9.3% | от 7.6% до 11.3% |
Частота отклонения истинной нулевой гипотезы в зависимости от схемы ресэмплинга и длины блока
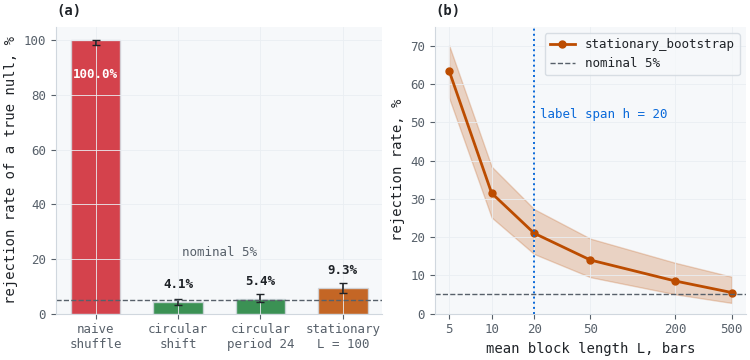
Рисунок 1. Двухпанельная иллюстрация калибровки нулевого распределения при истинной нулевой гипотезе
- Панель (a): частота ложноположительных результатов теста взаимной информации при четырех нулевых распределениях с точными 95%-ными доверительными интервалами; номинальный уровень 5% показан штриховой линией.
- Панель (b): частота ложноположительных результатов стационарного бутстрэпа по мере увеличения средней длины блока L; 200 испытаний на каждую точку; пунктирная линия отмечает длительность горизонта метки — 20 баров.
Интерпретация результатов калибровки
naive_shuffle отклонял истинную нулевую гипотезу в каждом испытании. И для circular_shift, и для circular_shift с period=24 доверительные интервалы включают 5%. При L = 100 размер критерия на основе стационарного бутстрэпа превышает номинальный уровень и сильно зависит от L: истинная нулевая гипотеза отклоняется в 63.5% случаев при L = 5, в 21.0% при 20, в 8.5% при 200 и в 5.5% при 500. В данной конфигурации размер критерия на основе бутстрэпа приближается к номинальному уровню лишь тогда, когда средняя длина блока примерно в 25 раз превышает длительность горизонта метки, поэтому длину блока необходимо выбирать, измерять и указывать при представлении каждого результата, полученного с использованием этой схемы. Модуль выдает ошибку, если параметр mean_block не указан.
Статистика тоже имеет значение. Если в том же эксперименте (200 испытаний) заменить нормализованную взаимную информацию модулем коэффициента корреляции Пирсона, частота ложноположительных результатов составит 58.0% для naive_shuffle, 3.5% для circular_shift и 4.5% для stationary_bootstrap при L = 100. Порядок схем остался прежним. Но масштаб ошибки при наивном перемешивании изменился.
В чем причина сбоя
Причины ошибки при наивном перемешивании и базовый ориентир мощности проверки стационарности в скользящих окнах
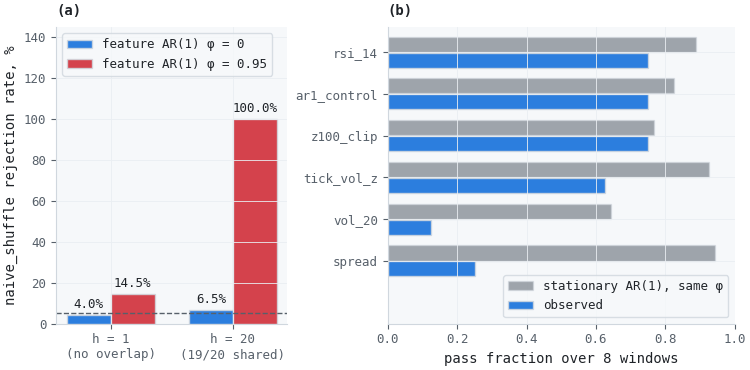
Рисунок 2. Двухпанельная иллюстрация размера критерия при наивном перемешивании и мощности проверки стационарности в скользящих окнах
- Панель (a): частота ложноположительных результатов naive_shuffle для признака типа белого шума и персистентного признака при использовании целевой переменной с неперекрывающимися и с перекрывающимися метками.
- Панель (b): доля из восьми окон, в которых для каждого непрерывного признака-кандидата получен вердикт stationary (синий цвет), в сравнении с такой же долей для стационарного ряда AR(1) с той же персистентностью (серый цвет); обсуждение приведено в разделе 7.
На панели (a) эти два фактора показаны по отдельности. Для признака в виде белого шума naive_shuffle отклоняет 4.0% истинных нулевых гипотез при проверке зависимости от целевой переменной с неперекрывающимися метками и 6.5% — с перекрывающимися. Для признака с персистентностью этот метод отклоняет 14.5% истинных нулевых гипотез при проверке зависимости от целевой переменной с неперекрывающимися метками и 100% — с перекрывающимися. Таким образом, этот сбой возникает при наличии персистентности у признака, а перекрытие меток превращает умеренное искажение в полное. Частота отклонения нулевой гипотезы не снижается с увеличением объема выборки: она остается на уровне 100% как при 2 000, так и при 10 000 барах. Нулевое распределение, полученное перемешиванием, занижает выборочную изменчивость статистики, рассчитанной для двух рядов с временной зависимостью, и увеличение объема данных этого не исправляет. Значение 14.5% в соответствующей ячейке отражает отдельный эффект, который в данном исследовании не разбирается на составляющие. Для circular_shift частота отклонения нулевой гипотезы во всех четырех ячейках составляет от 3.0% до 5.0%.
Следует отметить одно ограничение циклического сдвига. Циклический сдвиг сохраняет временную зависимость самой целевой переменной и последовательность ее режимов волатильности, но нарушает ее привязку к календарю. Если у признака и целевой переменной есть общая внутридневная или недельная сезонная компонента, при обычном циклическом сдвиге эта общая компонента будет выявлена как зависимость. Используемый здесь синтетический признак не имеет сезонности, поэтому результаты обычного циклического сдвига и сдвига с period=24 совпадают. Для реального признака эти результаты не обязательно совпадают; в разделе 7 приведен пример, в котором это различие имеет значение. В данных с календарным индексом и пропущенными барами параметр period=24 сохраняет привязку по числу баров, но не обязательно сохраняет исходный час суток.
Именно поэтому afml.screening.permutation реализован как самостоятельный модуль, а не как внутренняя вспомогательная функция каждого этапа проверки. Этот модуль используется для получения нулевых распределений на этапе проверки 3 и при мониторинге, описанном в частях 24 и 25. Некорректная калибровка схемы в этом модуле сказывается везде, где он используется повторно.
Конвейер с тремя этапами проверки
Конвейер выполняет три этапа проверки в фиксированном порядке, который отражает соображения затрат, переносимости и мощности.
Этап проверки | Функция | Статистический статус | Может ли этап отбирать признаки? |
|---|---|---|---|
| 1. Стационарность | stationarity_gate | Проверки гипотез ADF и KPSS на уровне значимости α; без нулевого распределения, полученного ресэмплингом | Нет, только исключает признаки |
| 2. Энтропия | entropy_screen | Пороговые значения описательных характеристик; без нулевого распределения и p-значения | Нет, только исключает признаки |
| 3. Взаимная информация | mi_screen | Совместное нулевое распределение, полученное ресэмплингом, с поправкой Уэстфолла — Янга | Да, это единственный этап проверки, который может отбирать признаки |
Стационарность проверяется первой, но не потому, что нестационарный признак нарушает корректность нулевого распределения, полученного ресэмплингом. Когда ресэмплинг применяется к целевой переменной, а признак остается неизменным, корректность нулевого распределения на этапе проверки 3 зависит от свойств целевой переменной; в разделе 7 показано, что столбец цен с единичным корнем дает корректное нулевое распределение. Есть еще две причины. Зависимость, оцененная по данным с дрейфующим распределением признака, отличается от зависимости, с которой модель сталкивается вне обучающей выборки, что представляет собой проблему переносимости. Для дрейфующего признака при разбиении на интервалы равной ширины нулевое распределение взаимной информации также значительно шире (у столбца исходных цен в разделе 7 среднее нулевого распределения примерно в семь раз выше, чем у RSI), что снижает мощность как теста для самого признака, так и, при использовании поправки на основе максимальной статистики, всех остальных тестов в семействе.
Проверка энтропии выполняется второй, поскольку имеет сложность O(N) и может только исключать признаки. В силу неравенства I(X; Y) ≤ H(X), непрерывный признак, который почти не варьируется после разбиения на интервалы, содержит мало информации о любой целевой переменной, и его исключение позволяет сэкономить бюджет перестановок для кандидатов, потенциально содержащих больше информации. Расчет взаимной информации выполняется последним, поскольку требует n_perm полных вычислений, и только этот этап проверки позволяет отобрать признак.
Учет ошибок требует осторожности, поскольку этапы проверки различаются. На этапе проверки 1 для каждого признака выполняются два теста гипотез со своими вероятностями ошибок, причем поправка на множественное тестирование по признакам не применяется. Они могут только исключать признаки. Ошибочное исключение на этапе проверки 1 или 2 приводит к потере признака, но не может привести к ложному отбору, поскольку ни один признак не отбирается без прохождения этапа проверки 3. То, искажают ли фильтры групповую вероятность ошибки первого рода на этапе проверки 3, зависит от одного свойства: оба фильтра зависят только от признаков и не используют целевую переменную. При ресэмплинге целевой переменной и фиксированных признаках результат фильтрации одинаков во всех повторениях, что соответствует условию независимой фильтрации Бургона, Джентльмена и Хубера (2010). В таком случае допустимо применять поправку только к признакам, прошедшим фильтрацию. Это условие нарушается, если порог настраивают после просмотра результатов этапа проверки 3, поскольку тогда фильтр зависит от целевой переменной через действия исследователя. Кроме того, при использовании bar_permute это условие выполняется лишь приближенно: признаки пересчитываются для каждого переставленного ряда, а фильтры применяются только один раз — к исходным признакам.
Установите значения min_entropy, max_modal_occupancy и alpha один раз, прежде чем просматривать какие-либо результаты, и не изменяйте их для каждого набора признаков.
from afml.screening import screen_features

report = screen_features(
    features, target,
    alpha=0.05,
    min_entropy=0.5,
    max_modal_occupancy=0.5,
    scheme="circular_shift",
    scheme_kwargs={"period": 24},   # keep hour-of-day alignment
    n_perm=500,
    seed=0,
)
print(report)             # ScreeningReport(k/n selected, m tested at gate 3, effective_tests=...)
report.summary()          # one row per feature, gate-by-gate outcome
report.settings           # thresholds, scheme and scheme arguments behind every p-value
screen_features возвращает объект ScreeningReport, содержащий диагностические таблицы для каждого этапа проверки, список отобранных признаков, словарь, сопоставляющий каждому исключенному признаку этап проверки, на котором он был исключен, настройки, использованные при расчете p-значений, и effective_tests — эффективное число тестов для семейства, дошедшего до этапа проверки 3, то есть эквивалентное число независимых тестов, определенное по совместному нулевому распределению, полученному ресэмплингом, а не заданное предположением. В разделе 7 эта процедура применяется к реальным признакам-кандидатам для EURUSD.
Этап проверки 1: стационарность, совместное применение тестов ADF и KPSS
Модуль afml.features.stationary.is_stationary, который заменяется этим этапом проверки, выполняет только расширенный тест Дики — Фуллера с фиксированным порядком лага, равным единице, и возвращает логическое значение. Использование одного теста имеет два недостатка. Нулевая гипотеза теста ADF состоит в наличии единичного корня, поэтому ее неотклонение означает отсутствие свидетельств против единичного корня, а не свидетельство стационарности. На короткой выборке для персистентного, но стационарного признака нулевая гипотеза не отклоняется, и признак исключается. С другой стороны, отклонение нулевой гипотезы тестом ADF говорит лишь о том, что ряд не является чистым случайным блужданием. Тест не способен выявлять отклонения от стационарности относительно уровня с короткой памятью, такие как сдвиги уровня, медленно меняющаяся дисперсия или долгая память, поэтому такие признаки проходят проверку. В разделе 7 показан второй тип ошибки на реальных данных: этап проверки, использующий только ADF, исключает один из девяти столбцов и пропускает три столбца, которые KPSS отмечает как проблемные.
В тесте KPSS нулевая гипотеза обратная: он проверяет гипотезу о стационарности и отклоняет ее, когда данные свидетельствуют против нее. Применение обоих тестов к одному и тому же ряду и совместная интерпретация их результатов позволяют различить четыре исхода, которые один тест не разграничивает:
ADF | KPSS | Вердикт |
|---|---|---|
| отклоняет | не отклоняет | stationary |
| не отклоняет | отклоняет | unit_root: перейти к дробному дифференцированию |
| отклоняет | отклоняет | conflicting либо trend_stationary, если повторное выполнение тестов с учетом линейного тренда устраняет противоречие |
| не отклоняет | не отклоняет | inconclusive: недостаточная мощность |
Третья строка не соответствует какому-то одному классу процессов. В спецификации с константой без тренда отклонение нулевых гипотез обоими тестами означает, что ряд не является ни случайным блужданием, ни стационарным рядом с короткой памятью вокруг постоянного среднего. Возможные причины включают детерминированный тренд, структурный сдвиг среднего, долгую память и сильную гетероскедастичность; каждая из них может завышать статистику KPSS. Поэтому функция assess_stationarity повторно выполняет оба теста с учетом линейного тренда. Если в этой спецификации ADF отклоняет нулевую гипотезу, а KPSS — нет, присваивается вердикт trend_stationary. В противном случае сохраняется вердикт conflicting, и на этом этапе проверки не делается вывод о том, какой именно механизм вызвал противоречие.
Спецификация фиксирована, чтобы обеспечить воспроизводимость вердиктов. В тест ADF включается только константа, а порядок лага выбирается по AIC с верхней границей Шверта 12(n/100)0.25. Тест KPSS проверяет стационарность относительно уровня с использованием оценки долгосрочной дисперсии Ньюи — Уэста и ширины окна, определяемой по данным методом Хобейна, Франсеса и Оомса (1998). В обоих случаях используется одно и то же значение α. Это формальные проверки гипотез, каждая со своей вероятностью ошибки: при α = 0.05 тест KPSS сам по себе отклоняет гипотезу стационарности примерно для одного действительно стационарного ряда из двадцати. Их p-значения получают интерполяцией табличных значений и ограничивают граничными значениями таблиц, поэтому p-значение KPSS, равное 0.01, означает «не более 0.01», а 0.10 — «не менее 0.10». При наличии десятков тысяч наблюдений оба теста также выявляют отклонения, слишком малые, чтобы иметь значение для модели, которую регулярно переобучают. Вывод — это утверждение о выборке, а не величина эффекта.
Функция stationarity_gate также возвращает показатель rolling_stationarity: долю из восьми неперекрывающихся подпериодов, для которых отдельная проверка дает результат stationary. Эту долю необходимо рассматривать с учетом базового показателя мощности. Каждое окно содержит одну восьмую данных, поэтому мощность обоих тестов в нем снижается, и персистентный, но стационарный ряд не проходит проверку в некоторых окнах уже по одной этой причине. Функция rolling_power_baseline оценивает коэффициент авторегрессии первого порядка для признака, моделирует стационарные ряды AR(1) с этим коэффициентом и соответствующей длиной и возвращает среднюю по этим рядам долю окон, прошедших проверку. Если признак проходит проверку в гораздо меньшей доле окон, чем предполагает его базовый показатель, это указывает на нестабильность, которую нельзя объяснить снижением мощности. Если же доля окон, в которых признак проходит проверку, близка к его базовому показателю, оснований для такого вывода нет.
Исключение признака на этапе проверки 1 — это решение о его дальнейшем пути обработки, а не вывод о его информативности. Признак может нести реальную информацию о целевой переменной и все же не пройти этот этап проверки, поскольку зависимость, выученная на данных с дрейфующим распределением, может не сохраняться вне обучающей выборки. В разделе 7 оцениваются связанные с этим потери.
Важное исключение. Этот этап проверки предназначен для исходных признаков-кандидатов и не должен применяться к результатам дробного дифференцирования. KPSS проверяет нулевую гипотезу о стационарности с короткой памятью, а ряд, полученный дробным дифференцированием с окном фиксированной ширины при 0 < d < 1, по построению стационарен и обладает долгой памятью, поэтому KPSS обоснованно, но бесполезно отклоняет эту гипотезу. Требование прохождения обоих тестов для результатов FFD приводит к измеримой потере той памяти, ради сохранения которой и применяется преобразование. Для уже продифференцированных входных данных вызовите screen_features(…, skip_stationarity=True).
На этом этапе проверки решение о стационарности также не делегируется функции fracdiff_optimal из-за дефекта, обнаруженного в ходе работы над этой статьей в рамках данной серии. Двоичный поиск минимального порядка дифференцирования в функции fracdiff_optimal начинается с d = 0.5 и никогда напрямую не проверяет d = 0. Если ряд уже стационарен, при каждом проверяемом значении d он проходит проверку ADF в ходе поиска, расстояние от верхней границы до нижней на каждом шаге сокращается вдвое, и функция возвращает d ≈ 0.0005 вместо тождественного преобразования. В результате начальные наблюдения отсекаются без каких-либо статистических оснований. Если бы функция stationarity_gate делегировала принятие решения этой функции, каждый уже стационарный признак подвергался бы преобразованию еще до фиксации результата этапа проверки. Поэтому на этом этапе проверки явно выполняется тест ADF при d = 0, а уже стационарные признаки остаются без изменений. В остальных случаях на этом этапе проверки может быть рекомендовано значение d, но само преобразование не применяется. Рекомендуемое значение d оценивается по всей выборке, поэтому его автоматическое применение вновь привело бы к ошибке заглядывания в будущее. Вычислите d на обучающей части выборки и используйте это значение для последующих данных.
Этап проверки 2: энтропия, разбиение на интервалы равной ширины, а не квантильное разбиение
Энтропия отвечает на узкий вопрос: сколько информации о любой целевой переменной потенциально может содержать этот признак? Для дискретизированного признака X и любой целевой переменной Y взаимная информация ограничена энтропией самого признака: I(X; Y) ≤ H(X). Таким образом, низкая энтропия ограничивает общее количество информации, которое может нести признак после разбиения его значений на интервалы. Это не означает, что признак вообще не несет информации. Индикатор редкого события по своей сути имеет низкую энтропию, но тем не менее может быть ценным, поскольку его ценность заключается в тех немногих барах, где он срабатывает. Высокая энтропия ничего не доказывает. Этот этап проверки лишь исключает признаки, но никогда не подтверждает их полезность; он не использует нулевое распределение, а его пороги условны, а не статистически откалиброваны.
Поэтому на этом этапе проверки к двум типам признаков применяются разные правила. Непрерывные признаки, то есть признаки с числом различных значений больше max_discrete_levels, разбиваются на интервалы равной ширины и должны удовлетворять нижнему порогу энтропии и верхнему порогу доли наблюдений в модальном интервале. Дискретные признаки, такие как фиктивные переменные торговых сессий, флаги режимов и индикаторы событий, оцениваются с учетом их фактического числа различных значений и исключаются только тогда, когда самый редкий уровень представлен менее чем min_level_count наблюдениями, поскольку при меньшем числе наблюдений на этапе проверки по взаимной информации нечего оценивать. Для них по-прежнему указываются энтропия и доля наблюдений в модальном интервале, но эти показатели не определяют результат проверки. Нормировать энтропию бинарного индикатора на логарифм числа интервалов, равного 51, и на этом основании исключать его — значит наказывать его за форму, ничего не выясняя о содержании.
Для непрерывных признаков именно выбор способа разбиения на интервалы определяет работу этапа проверки. При квантильном разбиении в каждый интервал по определению попадает примерно одинаковое число наблюдений, поэтому нормированная энтропия признака с достаточным числом различных значений оказывается близка к 1.0 почти независимо от формы его распределения, и на этапе предварительного отбора ничего не исключается. Именно поэтому наивно реализованный энтропийный фильтр на ранних этапах тестирования, казалось бы, работает: он пропускает все подряд. Разбиение собственного диапазона значений признака на интервалы равной ширины позволяет выявить признаки, которые достигают насыщения или большую часть времени находятся в одном состоянии, поскольку заполненность интервалов равномерной сетки отражает расположение данных, а не положение квантилей.
У равномерных сеток есть свой недостаток — масштаб. Если сетка охватывает весь эмпирический диапазон, несколько выбросов растягивают ее настолько, что основная часть данных оказывается в одном интервале. Поэтому сетка здесь охватывает диапазон от квантиля 0.1% до квантиля 99.9% (grid_quantiles), а наблюдения за этими границами учитываются в крайних интервалах. Настоящее насыщение остается заметным: если много наблюдений сосредоточено на границе ограничения, эта граница сама становится одним из квантилей. Один и тот же ряд получает существенно разные оценки при этих трех вариантах:
from afml.screening.entropy_features import indicator_entropy

squared_return = log_return ** 2
indicator_entropy(squared_return, method="quantile")                      # 1.000
indicator_entropy(squared_return, method="uniform")                       # 0.215
indicator_entropy(squared_return, method="uniform", grid_quantiles=None)  # 0.040
Распределение квадратов доходности имеет тяжелые хвосты, поэтому большая часть его массы приходится на нижние интервалы, а энтропия при разбиении на интервалы равной ширины остается низкой даже при ограничении границ сетки квантилями. На этом этапе проверки выявляется такая форма распределения. Это не означает, что признак бесполезен; логарифмическое преобразование повысило бы его оценку. Показатель modal_occupancy используется наряду с энтропией для непрерывных признаков и показывает долю наблюдений в наиболее заполненном интервале. Энтропия обобщает все распределение и может оставаться умеренной для признака, который большую часть времени находится в одном состоянии и лишь изредка отклоняется от него; доля наблюдений в модальном интервале позволяет выявить именно такой случай. Непрерывный признак должен удовлетворять обоим пороговым условиям.
Этап проверки 3: взаимная информация и поправка для контроля групповой вероятности ошибки первого рода
Взаимная информация выявляет немонотонные и нелинейные зависимости, которые не обнаруживает корреляция, и, в отличие от меры важности, полученной из обученной модели, не требует, чтобы модель уже была построена. Это второе свойство часто преувеличивают. В сводном справочнике по статистически обоснованным индикаторам утверждается, что предварительный отбор признаков на основе энтропии не требует модели и потому не подвержен проблемам переобучения, характерным для мер важности, полученных из обученных моделей. Это утверждение несостоятельно по двум причинам, которые следует рассматривать отдельно, и mi_screen явно учитывает обе из них.
Смещение оценки. Подстановочная оценка взаимной информации по данным, разбитым на интервалы, при независимости имеет положительное смещение, приблизительно равное (Bx − 1)(By − 1) / (2N ln 2), где Bx и By — число интервалов для каждой переменной. При 2000 наблюдениях и выборе числа интервалов по правилу Хасине-Гарби, уже используемому в других частях afml, нормированная взаимная информация без поправки между двумя независимыми гауссовскими рядами в среднем по 300 испытаниям составляет 0.0109, а не ноль. С учетом поправки Миллера — Мэдоу, реализованной в miller_madow_bias, среднее значение составляет 0.0030. Таким образом, фиксированный порог не является критерием отбора. Поправка снижает фоновый уровень оценки, но не устраняет его, поскольку она асимптотическая и предполагает независимость наблюдений, а при перекрытии меток это предположение нарушается.
Перестановочное нулевое распределение уже содержит то же смещение, поскольку оцениватель добавляет практически одну и ту же величину как на реальных данных, так и на каждом ресэмпле. Таким образом, калибровка по нулевому распределению устраняет это смещение, и корректность теста обеспечивается не поправкой Миллера — Мэдоу. В разделе 7 показан практический эффект: исходные p-значения с поправкой и без нее различаются менее чем на 0.02, и ни одно решение не меняется. Поправка служит для облегчения интерпретации. Она сдвигает приводимое значение статистики и среднее нулевого распределения к шкале, на которой превышение над нулевым распределением легче сравнивать между признаками с разной заполненностью интервалов.
Отбор. Предварительный отбор K признаков представляет собой ту же проблему множественных сравнений, которую в этой литературе справедливо отмечают применительно к выбору стратегий, а проклятие победителя возникает независимо от того, обучалась ли модель. У лучшего из пятидесяти признаков, сконструированных так, чтобы не нести никакой информации, нескорректированная статистика в среднем равна 0.0149 — примерно на 36% выше среднего для одного признака, равного 0.0109, — исключительно за счет выбора максимума из пятидесяти случайных значений. Предварительный отбор, основанный только на энтропии, не позволяет скорректировать этот эффект, поскольку не предусматривает сравнения с нулевым распределением.
Обе проблемы решаются сравнением наблюдаемой статистики с нулевым распределением, полученным с помощью ресэмплинга, и применением поправки Уэстфолла — Янга ко всему семейству проверок. Нулевое распределение формируется совместно: в каждом повторении один и тот же ресэмпл применяется ко всем признакам, оставшимся после отбора, поэтому корреляция между признаками определяется по данным, а не задается предположением. Именно поэтому функция mi_screen принимает матрицу признаков, а не вызывается отдельно для каждого столбца. Цикл по столбцам создавал бы K независимых нулевых распределений и приводил бы к потере корреляции, которую должна учитывать поправка.
Метод опирается на определенные допущения, и его описание не должно создавать впечатления, что это не так. Схема ресэмплинга должна воспроизводить совместное нулевое распределение, поэтому ошибка калибровки такой схемы, как naive_shuffle, напрямую переносится в результат применения поправки. Для сильного контроля групповой вероятности ошибки первого рода необходима пивотальность подмножеств (Westfall and Young, 1993); при ресэмплинге целевой переменной с фиксированными признаками это условие выполняется лишь приближенно, без строгого доказательства. Распределение для сравнения оценивается по конечному числу повторений, поэтому каждое скорректированное p-значение имеет ошибку Монте-Карло, примерно равную квадратному корню из p(1 − p)/B. Функция mi_screen выводит эту ошибку рядом с каждым скорректированным p-значением.
Реализованы два варианта. westfall_young_maxt сравнивает исходные значения статистик разных признаков, что корректно лишь тогда, когда все нулевые распределения имеют одинаковый масштаб. Взаимная информация, рассчитанная после разбиения на интервалы, этому условию не удовлетворяет: положение ее нулевого распределения зависит от маргинального распределения признака, поэтому один признак с широким нулевым распределением доминирует при вычислении максимума по семейству и снижает мощность проверок для остальных признаков. westfall_young_minp сначала преобразует статистики каждого повторения в p-значения, рассчитанные по нулевому распределению соответствующего признака, тем самым стандартизируя каждый признак относительно его собственного нулевого распределения. Этот вариант используется по умолчанию. В разделе 7 показано различие между вариантами на реальном семействе проверок.
from afml.screening.multiple_testing import (
    westfall_young_minp, westfall_young_maxt, holm_bonferroni, monte_carlo_se,
)

p_minp = westfall_young_minp(raw_p, null_matrix)          # per-feature null p-values; the default
p_maxt = westfall_young_maxt(observed_mi, null_matrix)    # raw statistics; needs a common scale
p_holm = holm_bonferroni(raw_p)                           # worst case; ignores correlation
se     = monte_carlo_se(p_minp, n_perm=500)               # resampling error of the adjusted p
Метод Холма — Бонферрони контролирует групповую вероятность ошибки первого рода при любой структуре зависимости, исходя из наихудшего случая, тогда как признаки Blueprint обычно далеки от этого наихудшего случая. Ряды цены после дробного дифференцирования при соседних значениях d, несколько оценок волатильности и семейство фиктивных переменных торговых сессий коррелированы в силу способа их построения. Для контроля ожидаемой доли ложных открытий реализованы процедуры Бенджамини — Хохберга и Бенджамини — Екутиели. Поправка Уэстфолла — Янга используется по умолчанию, поскольку она определяет структуру зависимостей по результатам того же ресэмплинга, который в любом случае требуется на этом этапе проверки. effective_number_of_tests характеризует эту структуру через число независимых тестов, которому эквивалентно данное семейство.
Предварительный отбор признаков на данных EURUSD H1
Девять столбцов-кандидатов, построенных на основе того же ряда EURUSD H1, который используется во всем цикле статей (42 584 выровненных часовых бара за 2018–2024 годы), проходят предварительный отбор по связи с реальной будущей логарифмической доходностью за двадцать баров. Семь из них — обычные признаки, которые могли бы входить в первоначальный вариант набора признаков. Два из них — намеренные ошибки: исходная цена и z-оценка цены с настолько жестким ограничением значений, что она достигает насыщения. Девятый ряд, ar1_noise_control, представляет собой синтетический ряд AR(1) с φ = 0.95. Это единственный столбец, не полученный из цены; он включен потому, что демонстрация предварительного отбора без истинно отрицательного примера ничего не доказывает о качестве самого отбора.
features = pd.DataFrame({
    "price_level":        close,                                   # deliberate mistake: raw price
    "rsi_14":             rsi(close, 14),
    "volatility_20":      log_return.rolling(20).std(),
    "spread":             bars["spread"],
    "is_asian_session":   bars.index.hour.isin(range(0, 8)),
    "is_month_end":       bars.index.is_month_end,
    "tick_volume_z":      zscore(bars["tick_volume"], window=500),
    "price_z100_clipped": zscore(close, window=100).clip(-0.5, 0.5),   # deliberate mistake: saturated
    "ar1_noise_control":  ar1_process(phi=0.95, seed=0),           # synthetic control
})
target = log_close.shift(-20) - log_close
Этап проверки 1
Признак | ADF p | KPSS p | Вердикт |
|---|---|---|---|
| rsi_14 | <0.001 | ≥0.10 | stationary |
| ar1_noise_control | <0.001 | ≥0.10 | stationary |
| price_z100_clipped | <0.001 | ≥0.10 | stationary |
| is_asian_session | <0.001 | ≥0.10 | stationary |
| is_month_end | <0.001 | ≥0.10 | stationary |
| price_level | 0.194 | ≤0.01 | unit_root |
| volatility_20 | <0.001 | ≤0.01 | conflicting |
| spread | <0.001 | ≤0.01 | conflicting |
| tick_volume_z | <0.001 | 0.036 | conflicting |
Исключены четыре столбца: price_level — из-за наличия единичного корня, а volatility_20, spread и tick_volume_z — из-за противоречивых результатов тестов (статус conflicting). Повторная проверка с линейным трендом не устранила противоречия ни для одного из трех столбцов, поэтому ни один из них не получил статус trend_stationary. Для tick_volume_z результат теста KPSS пограничный (p = 0.036 при проверке стационарности относительно уровня и 0.044 при учете тренда). Прежний этап проверки, использующий только тест ADF с фиксированным числом лагов, равным одному, пропускает восемь из девяти столбцов и исключает только price_level. Именно эти три столбца со статусом conflicting выявляет совместная проверка, тогда как этап проверки только по ADF их пропускает.
Проверка в скользящих окнах позволяет отличить нестабильность от снижения мощности. В среднем по 20 смоделированным стационарным рядам AR(1) с персистентностью, соответствующей каждому признаку, ожидаемые доли окон, в которых проверка пройдена (рис. 2, панель (b)), составляют 0.64 для volatility_20, 0.94 для spread и 0.93 для tick_volume_z. Наблюдаемые доли составляют 0.125, 0.25 и 0.625. Признаки volatility_20 и spread не проходят проверку в гораздо большем числе окон, чем можно объяснить их персистентностью, что согласуется со сменами режимов внутри выборки, охватывающей шок волатильности 2020 года и цикл повышения ставок 2022 года. Тест не позволяет связать непрохождение проверки с каким-либо из этих двух событий. Для tick_volume_z отставание от ожидаемой доли прохождения умеренное. У прошедших отбор непрерывных признаков наблюдаемые доли ближе к базовым значениям: для rsi_14 — 0.75 против 0.89, для ar1_noise_control — 0.75 против 0.83, а для price_z100_clipped — 0.75 против 0.77.
У этапа проверки 1 есть своя цена, и данные это показывают. При отдельной проверке связи с той же целевой переменной взаимная информация для volatility_20 составляет 0.0182 при среднем нулевого распределения 0.0061 (нескорректированное p = 0.004), то есть исключенный на этапе проверки признак информативен. Обычный способ решения этой проблемы — переход к стационарному представлению, поэтому был построен признак log(volatility_20 / volatility_500) и повторно проведен его предварительный отбор. Он проходит этап проверки 1 (статус stationary, доля скользящих окон, в которых проверка пройдена, — 0.875 при базовом значении 0.78) и этап проверки 2 (энтропия 0.875), но не проходит этап проверки 3: скорректированное p-значение составляет 0.29. Использование отношения не позволило восстановить сигнал. Информация в volatility_20 содержалась в уровне этого признака, что и делает ее непереносимой. Таким образом, отклонение признака на этапе проверки 1 означает, что он «непригоден для использования в текущем виде», а способ исправления нужно проверить, а не считать действенным по умолчанию.
Этап проверки 2
Признак | Тип | Энтропия | Результат |
|---|---|---|---|
| rsi_14 | непрерывный | 0.924 | проходит проверку |
| ar1_noise_control | непрерывный | 0.903 | проходит проверку |
| price_z100_clipped | непрерывный | 0.462 | отклонен: энтропия |
| is_asian_session | дискретный | 0.913 | проходит проверку: самый редкий уровень — 13 974 бара |
| is_month_end | дискретный | 0.209 | проходит проверку: самый редкий уровень — 1 406 баров |
price_z100_clipped — единственный признак, отклоненный на этом этапе. Его энтропия, равная 0.462, ниже минимального порога 0.5, а 42% наблюдений попадают в один интервал, поскольку ограничение значений приводит к их скоплению на границах. is_asian_session принимает значение true примерно на трети баров, а is_month_end — примерно на 3% баров. Оба признака проходят проверку, поскольку дискретный признак оценивается по тому, достаточно ли наблюдений на его самом редком уровне для получения каких-либо оценок, и 1 406 баров конца месяца для этого достаточно. По прежнему правилу, при котором бинарный признак нормировался на логарифм числа интервалов, равного 51, оба признака были бы отклонены еще до этапа проверки 3. Специалисты-практики, которым нужно более строгое правило, могут увеличить значение параметра min_level_count.
Этап проверки 3
Результаты проверки энтропии и нулевые распределения взаимной информации для признаков на реальных данных EURUSD
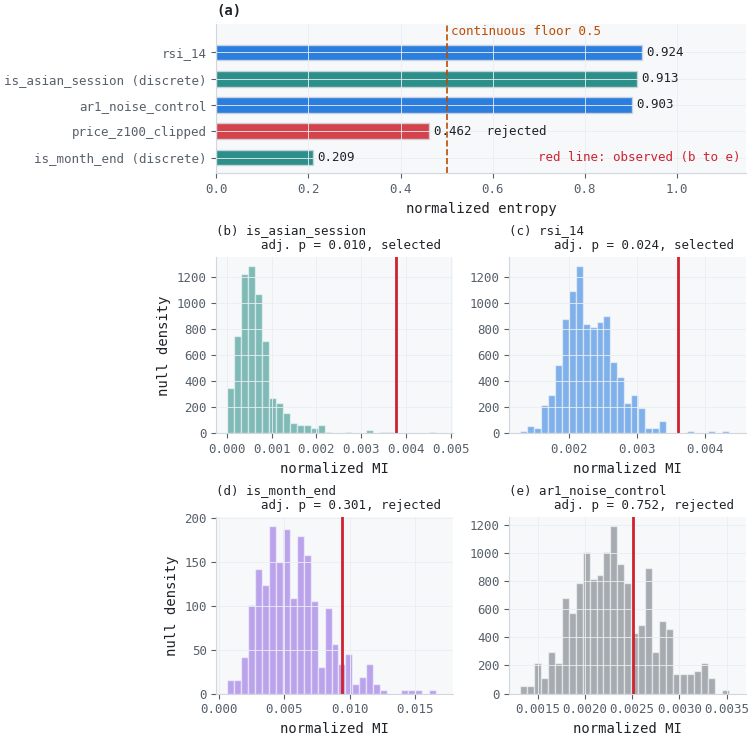
Рисунок 3. Иллюстрация из пяти панелей с результатами проверки энтропии на этапе проверки 2 и взаимной информации на этапе проверки 3 для EURUSD H1
- Панель (a): нормированная энтропия пяти признаков, прошедших этап проверки 1; для дискретных признаков (бирюзовый цвет) она рассчитывается с учетом их фактического числа различных значений, а для непрерывных признаков (синий цвет) должна превышать нижний порог 0.5; z-оценка цены с ограничением значений (красный цвет) этот порог не преодолевает.
- Панель (b): is_asian_session: наблюдаемое значение статистики находится далеко в правом хвосте нулевого распределения.
- Панель (c): rsi_14: наблюдаемое значение статистики находится в правом хвосте нулевого распределения.
- Панель (d): is_month_end: наблюдаемое значение статистики находится в верхней части широкого нулевого распределения.
- Панель (e): ar1_noise_control: наблюдаемое значение статистики находится в основной части нулевого распределения.
Признак | Наблюдаемая взаимная информация | Среднее нулевого распределения | Скорректированное p-значение |
|---|---|---|---|
| is_asian_session | 0.00377 | 0.00067 | 0.010 |
| rsi_14 | 0.00361 | 0.00231 | 0.024 |
| is_month_end | 0.00943 | 0.00569 | 0.301 |
| ar1_noise_control | 0.00251 | 0.00231 | 0.753 |
ScreeningReport(2/9 selected, 4 tested at gate 3, effective_tests=4.0), с параметрами scheme="circular_shift", n_perm=500, seed=0. Выбраны два признака: is_asian_session и rsi_14 — индикатор, которому в этой серии уже посвящена целая статья «Meta-Labeling the Classics, Part 1». Два признака доходят до этапа проверки 3, но не проходят отбор. is_month_end прошел этап проверки энтропии, поскольку на его редчайшем уровне было достаточно наблюдений; его нулевое распределение широкое, и наблюдаемое значение статистики на его фоне не выделяется. ar1_noise_control — заведомо неинформативный контрольный признак, который был правильно исключен. У него почти такая же энтропия, как у rsi_14 (0.903 против 0.924), и при предварительном отборе только по энтропии эти признаки неразличимы, однако наблюдаемое значение его статистики (0.00251) находится в основной части нулевого распределения (среднее 0.00231), что и отражает скорректированное p-значение 0.753. На панелях (c) и (e) рисунка 3 это различие показано непосредственно. Эффективное число тестов, равное 4.0, означает, что четыре оставшихся признака ведут себя как четыре независимых теста, поэтому поправка, рассчитанная на наихудший случай, здесь привела бы лишь к небольшой потере мощности.
Три проверки позволяют определить, насколько можно доверять этим цифрам. Во-первых, при 500 повторных выборках ошибки Монте-Карло для скорректированных p-значений составляют примерно от 0.005 до 0.02. При повторении предварительного отбора с десятью разными начальными значениями генератора случайных чисел скорректированные p-значения обоих выбранных признаков каждый раз остаются ниже 0.05 (от 0.002 до 0.026 для is_asian_session и от 0.002 до 0.034 для rsi_14), а у двух неотобранных признаков — в диапазоне от 0.23 до 0.80. Во-вторых, при использовании нулевого распределения с учетом календарной структуры (period=24) оба признака по-прежнему проходят отбор: скорректированное p-значение составляет 0.026 для is_asian_session и 0.002 для rsi_14. В-третьих, отключение поправки Миллера — Мэдоу изменяет исходные p-значения менее чем на 0.02 (0.080 против 0.088 для is_month_end, 0.273 против 0.291 для ar1_noise_control) и не меняет ни одного решения.
Для этого семейства тестов выбор варианта на основе максимальной статистики или минимального p-значения меняет результат. На тех же повторных выборках метод westfall_young_maxt дает для rsi_14 скорректированное p-значение 0.79, а для is_asian_session — 0.77, тогда как метод westfall_young_minp дает соответственно 0.024 и 0.010. У is_month_end нулевое распределение гораздо шире, чем у остальных признаков, поэтому в большинстве повторений именно этот признак задает максимум по семейству, который ни один другой признак не может превзойти. Добавление price_level в семейство с rsi_14 и ar1_noise_control еще сильнее ухудшает ситуацию: среднее его нулевого распределения составляет 0.0167, что примерно в семь раз больше, чем у rsi_14, а скорректированное p-значение для rsi_14 при использовании maxT возрастает до 1.0, тогда как minP дает 0.020.
Какая информация
Взаимная информация выявляет зависимость любого рода, поэтому отбор признака не означает, что он указывает направление движения цены. Оба отобранных признака содержат информацию об абсолютной величине будущей доходности, но предварительный отбор не выявляет в них информации о ее знаке. Для is_asian_session взаимная информация с абсолютным значением целевой переменной составляет 0.0036 при среднем нулевого распределения 0.0006 (p = 0.003), тогда как для взаимной информации со знаком целевой переменной p-значение равно 0.18. Стандартное отклонение доходности за двадцать баров составляет 0.00434 для баров азиатской сессии против 0.00392 для остальных баров, то есть примерно на 11% выше. Для rsi_14 соответствующие p-значения составляют 0.010 для взаимной информации с абсолютным значением целевой переменной и 0.27 — с ее знаком. Предварительный отбор признаков показал, что оба столбца дают модели информацию о величине будущего изменения цены. При этом не было установлено, что хотя бы один из этих признаков дает модели информацию о направлении движения цены.
Чего не показывает результат
Результат получен на одном наборе данных, для одного рынка и одного семейства горизонтов. Из этого следует несколько ограничений, каждое из которых важно учитывать при использовании полученных результатов.
- Результат зависит от горизонта. При повторном предварительном отборе тех же девяти столбцов с целевой переменной, рассчитанной на горизонте в пять баров, отбирается только is_month_end (скорректированное p-значение = 0.002), а для rsi_14 скорректированное p-значение составляет 0.79. При целевой переменной, рассчитанной на горизонте в шестьдесят баров, не отбирается ни один признак, а скорректированное p-значение для rsi_14 составляет 0.31.
- Значимость — это не экономическая ценность. В рамках предварительного отбора признаков не оцениваются ни транзакционные издержки, ни емкость стратегии, ни ее стабильность вне обучающей выборки. Признак, прошедший этап проверки 3, содержит информацию, отличимую от уровня шума метода оценивания, — и не более того.
- Ложноотрицательные результаты не учитываются. Ни одна поправка не учитывает стационарный признак, исключенный из-за ложного отклонения нулевой гипотезы тестом KPSS, или признак редкого события, исключенный из-за минимально допустимого числа наблюдений на уровне. Фильтры не могут приводить к ложному отбору признаков, если они не используют целевую переменную, но они все же исключают кандидатов.
- Энтропийный этап проверки был пересмотрен после анализа результатов. Правило для дискретных признаков и сетка с границами, ограниченными квантилями, были добавлены после того, как более ранняя версия этого предварительного отбора признаков исключила обе индикаторные переменные торговых сессий. Использованные здесь пороговые значения были зафиксированы до описанных выше запусков этапа проверки 3, однако сам пересмотр учитывал более ранние результаты, поэтому полученные p-значения не свободны от влияния этой предыстории.
- Один синтетический контрольный признак — это один истинноотрицательный результат. Он показывает, что предварительный отбор признаков позволяет отсеять персистентный неинформативный признак. Он не позволяет оценить частоту ошибочного отбора по множеству таких признаков.
- Калибровочное исследование охватывает один вариант эксперимента. Результаты оценки размера критерия получены для синтетического признака AR(1), одной целевой переменной, 5 000 баров и одной статистики. Для других признаков, схем формирования меток или статистик нужны отдельные измерения; шаблоном служит part23_size_study.py из приложенных файлов.
Заключение
Из девяти признаков-кандидатов для EURUSD отбор проходят два, но дело не в количестве. Для каждого исключенного признака была указана конкретная, проверяемая причина: единичный корень; противоречие между результатами совместно применяемых тестов, при котором этап проверки только по ADF пропустил бы признак; недостижение минимального порога энтропии насыщенным признаком; либо статистика взаимной информации, неотличимая от значений из собственного нулевого распределения. Для каждого отобранного признака были указаны среднее нулевого распределения, скорректированное p-значение и измеренная ошибка Монте-Карло. Предварительный отбор признаков, который сообщает лишь «отклонено», не указывая этап проверки и статистику, на которой основано решение, заслуживает не большего доверия, чем полное отсутствие отбора.
Основные выводы:
- Не проводите предварительный отбор персистентного признака относительно целевой переменной с перекрывающимися метками с помощью naive_shuffle. Измеренная частота ложноположительных результатов составила 100% для взаимной информации и 58% для абсолютной корреляции. Используйте circular_shift и добавляйте параметр period, если хотя бы в одном из рядов есть календарная закономерность.
- Указывайте параметры схемы вместе с результатом. Размер критерия при использовании стационарного бутстрэпа зависит от длины блока, а каждое p-значение — от схемы, по которой было получено его нулевое распределение.
- Рассматривайте исключение на этапе проверки 1 как перенаправление на обработку, а не удаление. Преобразуйте признак, повторите его предварительный отбор и проверьте, сохранилась ли информация после преобразования.
- Задавайте пороги до просмотра результатов, а не после. Перенастройка параметра min_entropy после того, как стало видно, какие признаки он исключает, меняет правила оценки для всех p-значений на последующих этапах.
- Прохождение отбора — это результат предварительной фильтрации, а не торговый сигнал. Оба отобранных признака несут информацию о величине движения, а не о его направлении; ни один из них не проверялся с точки зрения торговых издержек или емкости стратегии.
В части 24 рассматривается не затронутый в этой статье вопрос риска, связанного с последовательностью сделок: даже набор признаков, прошедший здесь все этапы проверки, может лежать в основе стратегии, фактически полученная история бэктеста которой занижает истинный риск просадки, поскольку максимальная просадка зависит от порядка совершения сделок, а этот порядок не является свойством стратегии.
Примечание к исправленной версии. В более ранней версии этой статьи приводились частоты ложноположительных результатов 55.5% для naive_shuffle и 6.0% для двух других схем без указания статистики критерия, а этапы проверки стационарности и энтропии описывались как не использующие гипотез. Частоты, приведенные в разделе 2, были повторно измерены с использованием статистики, фактически применяемой на этапе проверки 3. При использовании абсолютной корреляции повторно измеренные значения (58.0%, 3.5%, 4.5%) близки к прежним, а при использовании взаимной информации они составляют 100%, 4.1% и 9.3% при L = 100. В предыдущем тексте также говорилось, что три признака не проходят этап проверки 1, хотя на самом деле его не проходят четыре, и что один признак доходит до этапа проверки 3, хотя на самом деле до него доходят два. В результате описанных выше исправлений изменились результаты этапов проверки, обработка дискретных признаков на энтропийном этапе проверки и набор отобранных признаков.
Прикрепленные файлы
| Файл | Модуль | Описание |
|---|---|---|---|
| 1. | permutation.py | afml.screening | Схемы генерации нулевого распределения: naive_shuffle_indices, circular_shift_indices (с параметром period), stationary_bootstrap_indices, resample_indices, bar_permutation, build_null, suggested_block_length. |
| 2. | stationarity.py | afml.screening | Этап проверки 1. assess_stationarity, rolling_stationarity, rolling_power_baseline, stationarity_gate. |
| 3. | entropy_features.py | afml.screening | Этап проверки 2. bin_counts, indicator_entropy, modal_occupancy, entropy_screen. |
| 4. | mutual_information.py | afml.screening | Этап проверки 3. miller_madow_bias, normalized_mutual_info, mi_screen. |
| 5. | multiple_testing.py | afml.screening | Методы Бонферрони, Холма — Бонферрони, Бенджамини — Хохберга, Бенджамини — Екутиели, westfall_young_maxt, westfall_young_minp, null_pvalue_matrix, monte_carlo_se, effective_number_of_tests. |
| 6. | pipeline.py | afml.screening | Оркестрация. ScreeningReport, screen_features. |
| 7. | report.py | afml.screening | Класс данных ScreeningResult, связывающий каждую статистику с нулевым распределением, используемым для ее калибровки; results_to_frame. |
| 8. | __init__.py | afml.screening | Публичные экспорты подпакета. |
| 9. | size_calibration.py | afml.screening.notes | Исследование размера критерия на синтетических данных для схем ресэмплинга. |
| 10. | part23_data.py | afml.screening.notes | Построение признаков и целевой переменной по данным EURUSD H1 для этой статьи. |
| 11. | EURUSD_H1_time_2018-01-01-2024-12-31.parq | afml.screening.notes | Бары EURUSD H1 за 2018–2024 годы (42 584 выровненных бара после построения признаков). Храните его в той же папке, что и файл part23_data.py. |
| 12. | part23_size_study.py | afml.screening.notes | Исследование размера критерия на реальной целевой переменной EURUSD: схемы ресэмплинга, длины блоков, персистентность, перекрытие меток, длина окна. |
| 13. | part23_screen_demo.py | afml.screening.notes | Полный запуск предварительного отбора признаков, чувствительность к начальному значению генератора случайных чисел, нулевое распределение с учетом календаря, сравнение minP и maxT, повторный предварительный отбор признаков по волатильности, проверка горизонта. |
| 14. | test_screening_gates.py | afml.tests | Тесты для трех этапов проверки и поправок. |
| 15. | test_screening_permutation.py | afml.tests | Тесты для схем ресэмплинга и контейнера результатов. |
| 16. | test_screening_revisions.py | afml.tests | Тесты для циклического сдвига с ограничением по периоду, проверки допустимости длины блока, вердикта conflicting, базового уровня мощности, дискретных признаков и minP. |
Дополнительная литература
- Лопес де Прадо, М. (2018). Достижения в области финансового машинного обучения. John Wiley & Sons.
- Мастерс, Т. (2020). Перестановочные тесты и тесты рандомизации для разработки торговых систем.
- Мастерс, Т. (2019). Статистически обоснованные индикаторы для торговли на финансовых рынках.
- Политис, Д. Н. и Романо, Дж. П. (1994). Стационарный бутстрэп. Журнал Американской статистической ассоциации, 89(428), 1303–1313.
- Дики, Д. А. и Фуллер, У. А. (1979). Распределение оценок для авторегрессионных временных рядов с единичным корнем. Журнал Американской статистической ассоциации, 74(366a), 427–431.
- Квятковский, Д., Филлипс, П. С. Б., Шмидт, П. и Шин, Ю. (1992). Проверка нулевой гипотезы о стационарности против альтернативной гипотезы о наличии единичного корня. Journal of Econometrics, 54(1–3), 159–178.
- Хобейн, Б., Франсес, П. Х. и Оомс, М. (1998). Обобщения теста KPSS на стационарность. Отчет Института эконометрики № 9802/A.
- Шверт, Г. У. (1989). Тесты на наличие единичных корней: исследование методом Монте-Карло. Journal of Business & Economic Statistics, 7(2), 147–159.
- Уэстфолл, П. Х., и Янг, С. С. (1993). Множественное тестирование на основе ресэмплинга. John Wiley & Sons.
- Бургон, Р., Джентлмен, Р. и Хубер, В. (2010). Независимая фильтрация повышает мощность обнаружения в высокопроизводительных экспериментах. Труды Национальной академии наук, 107(21), 9546–9551.
- Миллер, Г. А. (1955). Примечание о смещении оценок информации. «Теория информации в психологии: проблемы и методы», с. 95–100.
- Кавер, Т. М. и Томас, Дж. А. (2006). «Основы теории информации» (2-е изд.). John Wiley & Sons.
Перевод с английского произведен MetaQuotes Ltd.
Оригинальная статья: https://www.mql5.com/en/articles/24468
Предупреждение: все права на данные материалы принадлежат MetaQuotes Ltd. Полная или частичная перепечатка запрещена.
Данная статья написана пользователем сайта и отражает его личную точку зрения. Компания MetaQuotes Ltd не несет ответственности за достоверность представленной информации, а также за возможные последствия использования описанных решений, стратегий или рекомендаций.


