

Архитектура машинного обучения для MetaTrader 5 (Часть 21): Анализ важности признаков
 26
 0

Содержание
- Введение
- Почему одного столбца «Важность» недостаточно
- Эксперимент, в котором ответ известен заранее
- Как распределяется вклад одного сигнала
- Результаты двух кластерных методов расходятся
- Метод оценки важности отдельного признака измеряет нечто иное
- Включение анализа в процесс обучения
- Как читать отчет
- Заключение
- Прикрепленные файлы
Введение
В конце работы обученная модель, рассматриваемая в этой серии статей, усредняет значения feature_importances_ по всем деревьям своего ансамбля и сортирует результат. Этот столбец отвечает на один узкий вопрос: какие столбцы деревья использовали для наиболее эффективных разбиений на обучающей выборке? Это внутривыборочная оценка, специфичная для моделей на основе деревьев, и у нее есть свойство, которое становится проблемой, как только число столбцов в наборе признаков превышает несколько. Два признака, несущие одинаковую информацию, взаимозаменяемы при каждом разбиении, поэтому каждый выбирается примерно в половине случаев и получает примерно половину приписываемого вклада.
Это не погрешность округления. Если на основе одного предиктора сконструировать шесть вариантов, каждый из них может оказаться в рейтинге ниже признаков, несущих лишь малую долю информации, хотя сам рейтинг будет выглядеть вполне правдоподобно. В выводе нет ничего, что указывало бы на это. Ранжирование верно отражает то, что делали деревья, но неверно отражает реальную важность признаков.
Лопес де Прадо описывает проблему и три способа ее устранения в главе 8 книги Advances in Financial Machine Learning (AFML), а четвертый — в разделе 6.5.2 книги Machine Learning for Asset Managers (MLAM). В этой статье масштаб проблемы оценивается на данных, в которых правильный ответ задан при их построении; затем применяется каждый из способов коррекции и указывается, какие из них позволяют восстановить этот ответ. Два из этих методов дают расходящиеся результаты, причем это расхождение обусловлено самими методами, а не данными.
Почему одного столбца «Важность» недостаточно
Среднее уменьшение неоднородности
MDI суммирует величину уменьшения неоднородности при каждом разбиении в каждом дереве, приписывая ее признаку, по которому выполнено разбиение. Метод требует мало вычислительных затрат, поскольку эта величина уже вычисляется при обучении. Кроме того, этот метод дает внутривыборочную оценку, применяется только к ансамблям деревьев и приписывает каждому признаку некоторую важность независимо от того, несет ли он информацию.
Размывание важности обусловлено тем, как выбирается разбиение. Узел выбирает один столбец и одно пороговое значение. Если два столбца кодируют одну и ту же величину, оба позволяют разбить узел примерно одинаково хорошо, поэтому выбор между ними делается практически произвольно. Величина уменьшения неоднородности одинакова независимо от того, какой столбец выбран, но целиком приписывается выбранному столбцу. В масштабе всего ансамбля каждый из двух столбцов выбирается примерно в половине случаев, и приписываемый вклад каждого составляет около половины важности лежащей в их основе величины.
Во фрагменте кода 8.2 рекомендуется обучать модель для оценки важности с параметром max_features=1. Если при каждом разбиении рассматривается только один признак-кандидат, деревья не могут систематически отдавать предпочтение одному признаку из группы коррелированных признаков перед другим, что устраняет маскирование. Это не устраняет размывание важности. Маскирование — это вытеснение одного признака другим; размывание важности — распределение приписываемого вклада одного признака между несколькими. Первое — это систематическое смещение при выборе столбца, второе — следствие самой необходимости выбрать какой-либо столбец.
Среднее снижение точности
MDA обучает модель на каждом обучающем фолде, оценивает ее качество на отложенном фолде, затем поочередно перемешивает значения в каждом столбце и повторно оценивает качество. Важность столбца определяется ухудшением качества, вызванным перемешиванием его значений. Этот подход применим к любому классификатору, а оценка является вневыборочной, что делает его более надежным из двух методов. Необходимо использовать перекрестную проверку с очисткой и эмбарго, поскольку перекрывающиеся метки, полученные при разметке методом тройного барьера, приводят к утечке данных через обычную границу между фолдами.
MDA по-прежнему подвержен замещению, причем в большей степени, чем MDI. Перемешивание значений в одном столбце разрушает информацию только в этом столбце. Если второй, идентичный столбец остается нетронутым, это не затрагивает ни одно дерево, использующее его для разбиений, а ухудшение работы деревьев, использующих столбец с перемешанными значениями, может компенсироваться остальной частью ансамбля. Оценка качества практически не меняется, поэтому оба столбца признаются неважными. При использовании MDI важность дублирующегося предиктора занижается; при использовании MDA она может оказаться нулевой.
Кластерные методы на основе неоднородности и точности
В разделе 6.5.2 MLAM предлагается сгруппировать признаки по зависимости и присвоить группам оценки. Кластерный MDI суммирует оценки важности признаков на основе неоднородности внутри каждого кластера. Кластерный MDA совместно перемешивает значения во всех столбцах кластера, поэтому у модели не остается нетронутой копии, на которую она могла бы переключиться. Затем оба метода присваивают оценку кластера каждому входящему в него признаку, так что все признаки кластера получают одинаковое значение.
Сама кластеризация выполняется методом ONC (оптимальное число кластеров), который ищет число кластеров, максимизирующее t-статистику коэффициентов силуэта. Это метод обучения без учителя: он использует структуру зависимостей в матрице признаков, но не использует метки. Именно эта независимость делает корректировку объективной; по той же причине разбиение на кластеры нужно проверять, а не принимать на веру: если метрика не выявит взаимосвязь, взаимозаменяемые признаки останутся в разных кластерах.
Это тот же механизм, который был разработан в части 20, а используемая им корреляционная матрица — тот самый объект, очистке которого была посвящена вся часть 20. Эта связь носит скорее структурный, чем декоративный характер. ONC выполняет кластеризацию по матрице расстояний, полученной на основе выборочной корреляционной матрицы. Корреляционная матрица, оцененная по T наблюдениям N признаков, содержит шумовые собственные значения, разброс которых закон Марченко — Пастура предсказывает на основе одного лишь отношения T/N. Любой остаточный шум влияет на разбиение на кластеры. Это разбиение на кластеры, в свою очередь, определяет все кластерные оценки, приведенные в этой статье. Таким образом, кластеризация на основе исходной корреляционной матрицы означает игнорирование результата, полученного в части 20.
Перед применением ONC мы вносим поправку из части 20. Мы подгоняем плотность распределения по закону Марченко — Пастура к эмпирическому распределению собственных значений, оцениваем верхнюю границу шумового спектра, сохраняем собственные значения выше этой границы, а значения ниже нее заменяем их общим средним, чтобы сохранить след матрицы. В восстановленной матрице сохраняется структура ведущих компонент, а шумовая часть спектра становится плоской.
Один из параметров этой аппроксимации играет более важную роль, чем остальные. Верхняя граница шумового спектра зависит от числа наблюдений на переменную, а в наборе признаков с устойчивой временной зависимостью не каждую строку можно считать независимым наблюдением. Поправка на эффективный размер выборки для модели AR(1), описанная в части 20, заменяет T на T(1-ρ)/(1+ρ). В используемой здесь матрице средняя автокорреляция с лагом 1 составляет 0.764, поэтому 1 470 строк соответствуют 197 эффективным наблюдениям, а значение q снижается с 33.4 до 4.48. Верхняя граница шумового спектра повышается с 1.376 до 2.169, а число собственных значений, относимых к сигналу, уменьшается с восьми до пяти. Если не вносить эту поправку, три шумовых собственных значения останутся незатронутыми сжатием.
Важность отдельного признака
Метод SFI полностью исключает замещение: на каждом признаке по отдельности обучается модель, для которой затем приводится оценка, полученная при перекрестной проверке. Когда есть только один столбец, заменить его нечем. Цена этого — исчезновение совместных эффектов: признак, полезный только в сочетании с другим, получает оценку как бесполезный, а признаку, полезному для объяснения разбиений по другому признаку, вообще не приписывается вклад.
Эксперимент, в котором ответ известен заранее
Чтобы измерить размывание важности, нужно знать, каким должен быть результат без такого размывания. Используемый здесь синтетический рынок построен на основе медленно меняющегося скрытого состояния AR(1), которое определяет дрейф следующего бара; дополнительно введена стохастическая волатильность, чтобы методу тройного барьера было к чему адаптироваться. Скрытое состояние действительно обладает прогностической силой в отношении следующего движения, но не определяет его однозначно.
В конвейер поступают признаки из четырех источников. Первый источник представляет скрытое состояние шестью способами: копия с шумом, версия с экспоненциальным взвешиванием, скользящий процентильный ранг, гиперболический тангенс, копия с ограничением значений и сглаженный наклон. Каждый из них представляет собой монотонное или почти монотонное преобразование одной и той же величины, что как раз и соответствует ситуации, возникающей в библиотеке индикаторов, когда несколько ее элементов отражают одно и то же базовое состояние рынка. Второй источник дает один признак моментума без дублирующих копий. Третий источник дает обычные столбцы цены и волатильности, а четвертый — восемь столбцов чистого шума. Конвейер добавляет собственный блок календарных и сессионных признаков, доводя число столбцов матрицы до 44.
Метки получают с помощью той же процедуры разметки методом тройного барьера, которая использовалась бы при обучении модели, а веса наблюдений — в ходе того же поиска схемы взвешивания, поэтому важность признаков оценивается с использованием тех же меток и весов, что и при реальном запуске обучения. После сопоставления признаков с событиями и удаления начальных строк, необходимых для расчета признаков, остается 1 470 событий. Для оценки важности признаков используется случайный лес с параметром max_features=1, который при выбранной схеме взвешивания достигает оценки на внепакетных наблюдениях 0.9442 и отрицательной логарифмической потери −1.0025 по результатам перекрестной проверки.
Таким образом, истинная картина задана еще до запуска любого метода оценки важности признаков. Шесть столбцов несут один сигнал. Один столбец несет более слабый независимый сигнал. Восемь столбцов не несут сигнала, как и календарный блок, добавляемый конвейером, поскольку на синтетическом рынке нет сессионной структуры, которую можно было бы выявить.
Как распределяется вклад одного сигнала
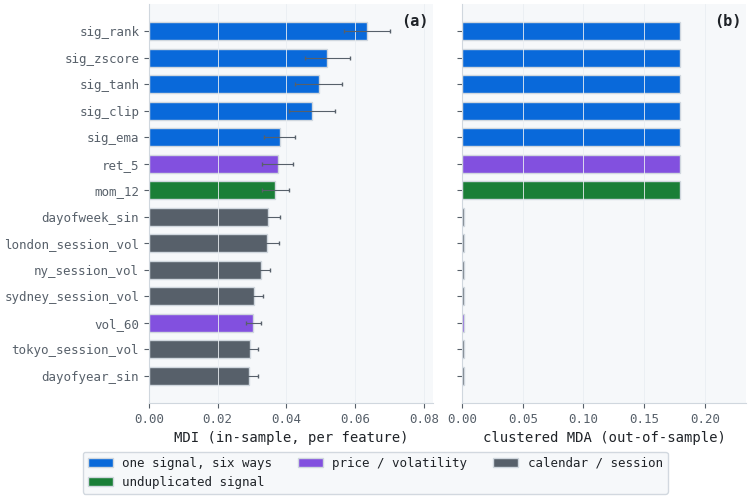
Рисунок 1. Иллюстрация из двух панелей, показывающая распределение приписываемого вклада одного сигнала между шестью сконструированными копиями
- Панель (a): семнадцать признаков с наибольшими значениями MDI, рассчитанными отдельно для каждого признака. Пять из шести копий скрытого сигнала занимают первые пять мест с оценками от 0.0381 до 0.0635. Шестая копия, sig_slope, занимает последнее место на панели с оценкой 0.0250, уступая одиннадцати признакам, которые не являются копиями чего-либо.
- Панель (b): те же семнадцать признаков, оцененных с помощью кластерного MDA. Девять из них образуют кластер, несущий сигнал, и каждому присвоена общая оценка кластера — 0.1927. Остальные имеют значение 0.0019.
- Нижняя полоса на каждой панели: sig_slope нагляднее всего показывает результат корректировки. При оценке отдельных признаков методом MDI он занимает последнее место, а при использовании кластерного MDA его полоса имеет полную длину, поскольку очищенная корреляционная матрица объединяет его с остальными копиями сигнала.
- Шкалы: на панелях представлены разные величины, и общим у них является только список признаков. На панели (a) показаны доли общего объема важности, в сумме равные единице по всем 44 столбцам; на панели (b) — вневыборочное ухудшение логарифмической потери. Полосы можно сравнивать внутри одной панели, но не между двумя панелями.
Панель (a) дает количественную оценку размывания важности. Оценки шести копий составляют 0.0635, 0.0519, 0.0495, 0.0475, 0.0381 и 0.0250, а их сумма равна 0.2755. Лучший из восьми столбцов, содержащих чистый шум, имеет значение 0.0152. Поскольку MDI нормирован так, что сумма всех оценок в столбце равна единице, эти значения представляют собой доли фиксированного общего объема важности. Поэтому сумма долей шести столбцов, кодирующих одну величину, дает обоснованную оценку ее важности для модели: примерно в восемнадцать раз выше, чем у лучшего шумового столбца.
Ни одна отдельная копия даже близко не достигает этого значения. Оценка самой сильной копии примерно в четыре раза выше оценки лучшего шумового столбца, а самой слабой — примерно в 1.6 раза. Шестнадцать признаков имеют более высокий рейтинг, чем sig_slope. Пять из них — другие копии того же сигнала, а три содержат реальную информацию, но остальные восемь — это семь календарных признаков и один признак волатильности, ни один из которых не несет информации о направлении следующего движения. Рейтинг, в котором восемь неинформативных столбцов стоят выше настоящего предиктора, нельзя считать надежной основой для исключения признаков.
Важно подчеркнуть: панель (a) не выглядит некорректной. В верхней части списка находятся признаки, которые действительно важны, в нижней — те, которые действительно не важны, а порядок между ними выглядит вполне правдоподобным. Специалист, отбрасывающий нижнюю половину полной таблицы, удаляет sig_slope и оставляет london_session_vol. Метод дал не явно ошибочный ответ, а ответ с незаметной ошибкой, и ничто в его результатах не позволяет отличить один случай от другого.
На панели (b) показано, что происходит, когда значения всех копий перемешивают совместно, а не по одной копии за раз. ONC объединил все шесть признаков в один кластер вместе с признаком моментума и двумя столбцами доходности, а остальные 35 признаков поместил во второй кластер. Разрушение структуры первого кластера увеличивает логарифмическую потерю модели на отложенном фолде на 0.1927; второго — на 0.0019. Соотношение важности значимых и незначимых признаков увеличивается примерно с 4:1 при наивном MDI до примерно 100:1 здесь по простой причине: когда все копии перемешаны одновременно, у модели не остается признаков, по которым можно восстановить скрытое состояние.
То, что все шесть копий попадают в один кластер, — следствие этапа очистки, а не нечто само собой разумеющееся. sig_slope — это сглаженная разность значений скрытого состояния с лагом в четыре бара, поэтому этот признак отслеживает скорость изменения состояния, а не его уровень; его исходная линейная корреляция с уровнем настолько слаба, что неотличима от шума. При кластеризации на основе исходной выборочной корреляционной матрицы этот признак попадает вместе с шумовыми признаками в кластер из 36 признаков, где его оценка важности остается размытой и равной 0.0250, а коррекция его так и не затрагивает. Предварительное сжатие шумовых собственных значений позволяет вывести этот признак из шумовой области, и разбиение на кластеры меняется: теперь в них 35 и 9 признаков, причем все копии входят в информативную группу.
Удаление ведущих компонент доступно в том же вызове и здесь по умолчанию отключено — на основании полученных результатов, а не личных предпочтений. Исключение ведущего собственного вектора является стандартной практикой в тех случаях, когда первая мода представляет собой рыночный фактор, общий для всех активов в портфеле. В наборе признаков, построенном вокруг одного предиктора, ведущая мода и есть этот предиктор, а ее удаление приводит к слиянию сигнальной группы с другими признаками в кластер из 31 признака, который уже ничего не обособляет. Применяйте удаление ведущих компонент, когда первый собственный вектор отражает фактор, влияние которого нужно исключить при анализе; оставляйте эту процедуру отключенной, когда он отражает именно то, что требуется выявить.
Результаты двух кластерных методов расходятся
Оба кластерных метода применялись к одному и тому же разбиению на кластеры, полученному с помощью ONC. Они ранжировали кластеры в противоположном порядке.
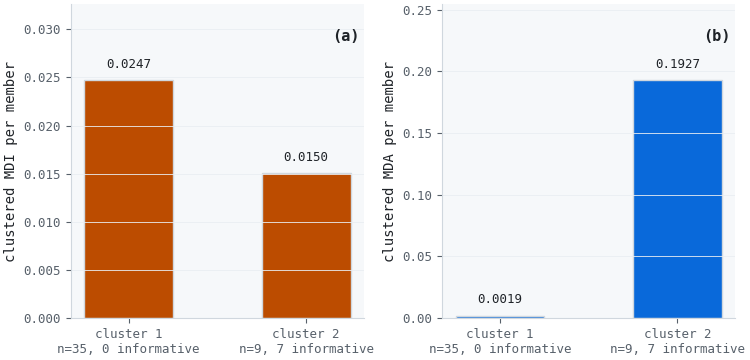
Рисунок 2. Иллюстрация из двух панелей, показывающая результаты кластерного MDI и кластерного MDA при одном и том же разбиении на кластеры
- Панель (a): кластерный MDI. Кластер из 35 элементов получает оценку 0.0247 на один элемент, тогда как кластер из 9 элементов, несущий сигнал, — 0.0150, поэтому порядок оказывается обратным.
- Панель (b): кластерный MDA на том же разбиении на кластеры; оценки двух кластеров различаются в 100.6 раза в пользу кластера, несущего сигнал.
| Кластер | Элементы кластера | Кластерный MDI | Кластерный MDA |
|---|---|---|---|
| С преобладанием шума | 35 | 0.0247 | 0.0019 |
| Несущий сигнал | 9 | 0.0150 | 0.1927 |
Причина кроется в арифметике, а не в статистике. Последовательность действий такова. В методе кластерного MDI сначала суммируются оценки вклада признаков кластера для уменьшения неоднородности. Затем эта сумма присваивается каждому элементу кластера в качестве его оценки. Наконец, весь столбец нормализуется так, чтобы сумма его значений равнялась единице. Именно при нормализации проявляется влияние размера: кластер из 35 элементов записывает свою сумму в столбец 35 раз, тогда как кластер из 9 элементов — только 9 раз, поэтому более крупный кластер вносит основной вклад в знаменатель, на который делятся оба значения. Итоговая оценка каждого элемента оказывается пропорциональной исходной сумме его кластера, а использование таких сумм дает преимущество более крупным кластерам. Сумма важностей тридцати пяти посредственных признаков составляет 0.6222; девяти хороших — 0.3778.
В кластерном MDA нет аналогичного этапа. Перемешивание значений в 35 столбцах не ухудшает качество модели в 35 раз сильнее, чем перемешивание значений в 9 столбцах; степень ухудшения зависит от содержимого столбцов, а не от их количества. Именно поэтому эти два метода могут давать разные результаты на одном и том же разбиении на кластеры.
Это соответствует опубликованному методу. В работе MLAM кластерный MDI представлен как способ сравнения кластеров, и сравнивать два кластера, резко различающихся по размеру, по показателю, зависящему от размера, — значит неправильно применять метод, а не выявлять его недостаток. Практический вывод в любом случае остается в силе: если размеры кластеров неодинаковы, следует предпочесть кластерный MDA.
Сравнение по отдельным признакам не позволяет выявить этот эффект. Внутри каждого кластера все элементы получают одинаковую кластерную оценку и, следовательно, занимают одинаковую позицию в рейтинге. При разбиении на два кластера это означает всего два различных ранга для 44 признаков, причем половина признаков более крупного кластера выглядит улучшившей свои позиции лишь из-за того, как были упорядочены признаки с одинаковой оценкой. В ранней версии данного анализа использовалось именно это сравнение, и переменная noise_02 была обозначена как замаскированный предиктор.
Вместо этого конвейер выдает показатель для каждого кластера: сумму исходных оценок важности его признаков, деленную на наибольшую из этих оценок.
| Кластер | Суммарный MDI | Лучший признак | Размывание важности |
|---|---|---|---|
| С преобладанием шума | 0.6222 | 0.0346 | 17.97 |
| Несущий сигнал | 0.3778 | 0.0635 | 5.95 |
Этот коэффициент непосредственно показывает, на сколько долей был разделен приписываемый вклад. Если весь вклад кластера приходится на один признак, то суммарная оценка и оценка лучшего признака почти совпадают, а коэффициент близок к 1; это означает, что исходному ранжированию признаков этого кластера можно доверять. Если n признаков делят приписываемый вклад поровну, то суммарная оценка в n раз больше оценки любого из них, а коэффициент приближается к n, то есть важность каждого признака занижена примерно во столько раз. Для кластера, несущего сигнал, коэффициент составляет 5.95, что близко к числу копий, действительно заложенных в него, — шести.
Сам по себе высокий коэффициент не доказывает наличие замещения, и значение 17.97 для кластера с преобладанием шума показывает почему. Тридцать пять независимых слабых признаков также дают суммарную оценку, значительно превышающую оценку любого из них по отдельности. Размывание важности показывает, насколько широко распределен приписываемый вклад кластера, но не говорит о том, имел ли этот вклад какую-либо ценность. Именно столбец «Кластерный MDA» в предыдущей таблице позволяет различить эти два случая, и оба показателя нужно рассматривать совместно: сильное размывание важности при высокой кластерной оценке означает, что вклад одного сигнала распределен между многими признаками, а сильное размывание важности при кластерной оценке, близкой к нулю, означает наличие множества признаков, которые ни по отдельности, ни вместе не несут прогностической информации.
Важность отдельного признака измеряет нечто иное
SFI возвращает непосредственно оценку качества модели с одним признаком, полученную при перекрестной проверке, а не величину снижения качества. Эти значения имеют иной масштаб, чем MDI или MDA, поэтому их нельзя показывать рядом на графике, не вводя читателя в заблуждение. При наличии трех классов меток неинформативный признак дает модель, которая предсказывает вероятности, близкие к базовым частотам классов, и получает оценку около -ln(3), или -1.0986.
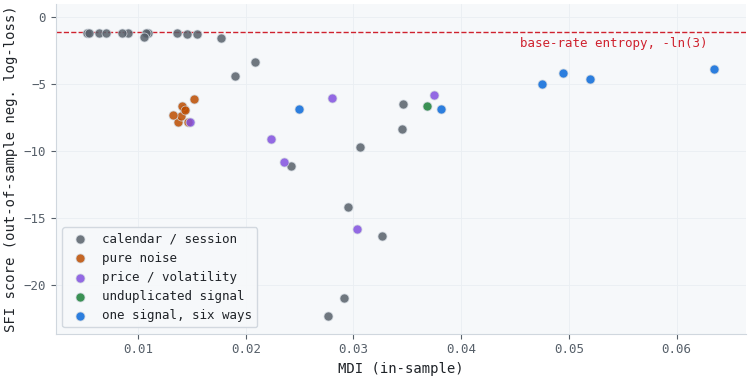
Рисунок 3. Сопоставление оценок по отдельным признакам с внутривыборочной неоднородностью и опорной линией базовой частоты
- Горизонтальная ось: MDI, поэтому информативные признаки располагаются справа.
- Пунктирная линия: оценка, которую получает неинформативный признак, — энтропия распределения базовых частот трех классов.
- Вертикальный разброс: у признаков, расположенных вплотную к опорной линии, модель на одном признаке вообще не способна различать классы, однако их оценки выше, чем у всех информативных признаков.
Лучшую оценку SFI в этом запуске получает tokyo_session: -1.172, что практически соответствует оценке на основе базовой частоты. Шесть копий скрытого сигнала получают оценки от -6.836 до -3.834. Если сортировать значения SFI как столбец важности признаков, двоичный флаг торговой сессии окажется в самом верху, а истинный предиктор — примерно на двух третях списка от начала.
Дело в калибровке, а не в информации. Двоичный флаг торговой сессии лишь делит данные на два блока, поэтому модель возвращает доли классов в каждом блоке, и ее прогнозы никогда не отклоняются далеко от базовых частот. С непрерывным информативным признаком ситуация иная: случайный лес разбивает диапазон его значений на мелкие области, находит те, где в обучающих данных преобладает один класс, и дает для них прогнозы с высокой уверенностью. Логарифмическая потеря задает неограниченно большой штраф за уверенный ошибочный прогноз и небольшой — за ошибку при низкой уверенности, поэтому модель, которая чаще оказывается права, но иногда сильно ошибается, может получить более низкую оценку, чем модель, которая никогда не делает уверенных прогнозов.
Метод SFI делает именно то, для чего он предназначен. SFI показывает, какие признаки информативны сами по себе; его оценки следует интерпретировать относительно линии базовой частоты, а не как рейтинг: удаленность от этой линии указывает на признаки, которые модель с одним входным признаком способна использовать. Если метрика оценки вероятностных прогнозов затрудняет такую интерпретацию, ее можно заменить. При работе с бинарными метаметками конвейер вместо этого использует для оценки F1 — метрику, которая учитывает решения, а не уверенность в них и не предусматривает описанного выше штрафа.
Включение анализа в процесс обучения
Анализ реализован в FeatureEngineeringPipeline, который использует те же этапы загрузки данных, разметки методом тройного барьера и поиска весов наблюдений, что и ModelDevelopmentPipeline, а затем конвейеры расходятся. Модельный конвейер определяет, какую модель следует развернуть. Конвейер признаков определяет, какие признаки стоит вычислять, и отвечает на этот вопрос на основе тех же меток и весов.
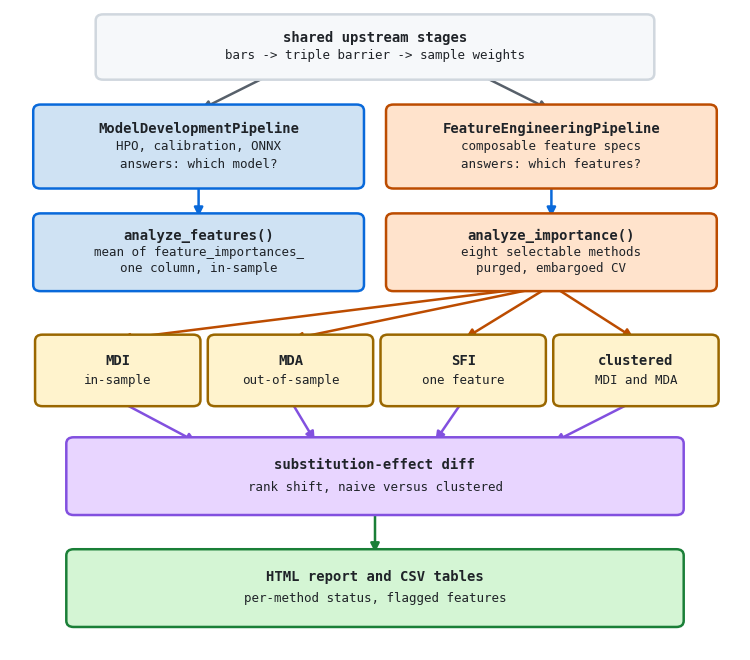
Рисунок 4. Место этапа оценки важности признаков в общей схеме с обучением модели
- Верхняя половина: оба конвейера используют одни и те же бары, события разметки методом тройного барьера и веса наблюдений, поэтому важность признаков оценивается по тем меткам, на которых модель действительно будет обучаться.
- Левая ветвь: единственный столбец внутривыборочных оценок важности признаков в модельном конвейере.
- Правая ветвь: восемь методов на выбор, диагностика по каждому кластеру и отчет, формируемый по их результатам.
Признаки задаются списком спецификаций, а не фиксированным набором; каждая спецификация содержит вызываемый объект, его параметры и имя. В конвейер можно включить любую функцию, которая принимает датафрейм с барами и возвращает датафрейм с признаками; конвейер фиксирует, какая спецификация сформировала каждый столбец, чтобы в отчете можно было связать оценки важности с их источниками.
pipe = FeatureEngineeringPipeline(
    data_config=data_config,
    feature_configs=[
        {"func": compute_all_microfeatures, "params": {}, "name": "micro"},
        {"func": get_fractal_features,      "params": {}},
        {"func": get_lagged_returns,        "params": {"n_lags": 5}},
    ],
    target_config=target_config,
    label_config=label_config,
    importance_config={
        "methods": ["mdi", "mda", "clustered_mdi", "clustered_mda", "pca"],
        "n_splits": 5,
        "pct_embargo": 0.02,
        "clustering": {
            "dependence_metric": "linear",
            "denoise": True,   # shrink noise eigenvalues before ONC (Part 20)
            "detone": False,  # the leading mode here is the signal, not a market factor
        },
    },
)
importances, catalog, config = pipe.run()
Блок clustering передается напрямую в функцию get_feature_clusters, которая теперь принимает параметры denoise, detone, market_components, kde_bwidth и use_effective_sample_size. При включенном подавлении шума очистка выполняется после построения корреляционной матрицы и до запуска ONC, а диагностические данные подгонки возвращаются вместе с разбиением на кластеры, чтобы в отчете можно было указать, на основе какого спектра оно получено. Подавление шума определено для выборочной корреляционной матрицы, поэтому при его сочетании с параметром dependence_metric, задающим меру зависимости на основе теории информации, вызов завершается исключением, а не продолжает выполнение; по той же причине исключение возникает при использовании detone без denoise.
Параметр denoise допустимо не задавать, но при этом в журнал записывается предупреждение: разбиение на кластеры, построенное по необработанной корреляционной матрице, — единственный случай, при котором результаты кластерных методов из этой статьи не воспроизводятся.
Модель для оценки важности признаков — не та модель, которая развертывается для практического использования. Это отдельный случайный лес, который конвейер создает и настраивает в соответствии с фрагментом кода 8.2. Эта конфигурация предназначена именно для оценки важности признаков и не должна служить образцом для модели, развертываемой для практического использования; кроме того, обычный случайный лес предоставляет в атрибуте estimators_ сами деревья решений, к которым MDI обращается напрямую, без извлечения из оберток.
Основная часть времени выполнения приходится на MDA и SFI, поскольку каждый из этих методов обучает модель для каждого фолда и каждого признака или кластера. Ни один из них не входит в набор методов по умолчанию. На используемой здесь матрице из 44 столбцов вычисления методом MDI заняли менее секунды, а методом SFI — примерно пятьдесят секунд.
Как читать отчет
Каждый метод выполняется внутри защитного блока, который при сбое записывает его в журнал и позволяет продолжить работу, поэтому сбой одного метода не может прервать весь запуск. У этой меры предосторожности есть недостаток, о котором стоит упомянуть: метод, выполнение которого завершилось сбоем, просто не попадает в результаты, и отчет, в котором отображаются три из восьми запрошенных методов, ничем не отличается от отчета, в котором запрашивались только три метода. Теперь отчет начинается с таблицы состояний, в которой перечислены все запрошенные методы, статус выполнения каждого из них и причины сбоев, если они произошли; эта таблица предшествует всем разделам с оценками важности.
Остальные разделы расположены таким образом, чтобы вышеупомянутые проблемы интерпретации были явными, а не скрытыми. Состав каждого кластера выводится полностью, поскольку именно он определяет, каким признакам присваивается оценка кластера, а разбиение на кластеры, при котором информативный блок включается в более крупный кластер, меняет все кластерные оценки. SFI представлен отдельно от разделов с оценками важности, а на его графике показана опорная линия, рассчитанная по базовым частотам. Таблица размывания важности следует за результатами кластерных методов, чтобы коэффициент размывания и кластерную оценку можно было рассматривать вместе.
Помимо HTML-отчета, конвейер сохраняет:
- по одному файлу CSV на каждый метод,
- каталог признаков, в котором каждому оставшемуся столбцу сопоставлены его спецификация и охват данных,
- матрицу признаков в формате Parquet.
Все результаты сохраняются в версионируемом каталоге артефактов, определяемом символом, типом бара и диапазоном дат.
Заключение
Единственный столбец усредненных оценок важности, получаемый при запуске обучения, верно отражает то, как деревья использовали признаки. Такой столбец ненадежен как ориентир при выборе признаков, которые следует сохранить, поскольку в нем приписываемый вклад одного предиктора распределяется между всеми его коррелированными представлениями. На матрице с заранее заданным ответом суммарная важность шести копий одного сигнала в 18 раз превышала важность лучшего шумового столбца, тогда как самая слабая копия занимала в рейтинге место ниже 11 признаков, которые ничего не дублируют.
Поправкой, позволившей восстановить истинную картину, стал кластерный MDA, который совместно перемешивает значения признаков целого кластера, не оставляя модели признака-заменителя. Кластерный MDI, примененный к тому же разбиению на кластеры, дал обратный порядок оценок, поскольку суммирование вкладов участников кластера в уменьшение неоднородности делает оценку кластера зависимой от его размера. Если размеры кластеров неодинаковы, это повод предпочесть вариант на основе точности, а не повод сомневаться в кластеризации.
Этот вывод сопровождается двумя оговорками. Каждая кластерная оценка зависит от разбиения на кластеры, а само разбиение — от корреляционной матрицы: при использовании исходной выборочной корреляционной матрицы одна из шести копий попадает в кластер с шумовыми признаками и сохраняет размытую оценку важности, и лишь этап очистки из части 20 позволяет это исправить. SFI при использовании логарифмической потери отчасти служит мерой калибровки, поэтому его значения лучше сопоставлять с линией базовой частоты, а не ранжировать. Поэтому разбиение на кластеры и лежащий в его основе спектр следует проверять в отчете в первую очередь, а не в последнюю.
Использование синтетического рынка здесь оправдано тем, что ответ известен заранее, а не тем, что различия велики. Реальный набор признаков не разделится столь четко, и приведенные выше числа следует рассматривать как демонстрацию того, что эффект поддается измерению, а не как оценку его величины на реальных данных.
Прикрепленные файлы
| Файл | Местоположение | Описание |
|---|---|---|
| afml.zip | afml/ | Полный набор прямых и косвенных импортируемых зависимостей feature_engineering.py: все модули, необходимые конвейеру, вместе с файлами пакетов и списком зависимостей. Поместите папку afml в один из каталогов поиска модулей Python — и конвейер запустится. |
| feature_engineering.py | afml/production/feature_engineering.py | Конструирование признаков, разметка методом тройного барьера, подбор весов наблюдений и этап оценки важности признаков. Добавляет журнал статусов по каждому методу, диагностику размывания важности по каждому кластеру и диагностику подавления шума, результаты которой включаются в отчет. |
| denoising_detoning.py | afml/denoising/denoising_detoning.py | Модуль из части 20 с добавленной функцией clean_corr: один вызов преобразует панель признаков в очищенную корреляционную матрицу и возвращает диагностические данные подгонки. Вызывает исключение EffectiveSampleSizeError, содержащее корреляционную матрицу и ее спектральное разложение, если при эффективном размере выборки на каждую переменную приходится слишком мало наблюдений. |
| feature_clusters.py | afml/clustering/feature_clusters.py | Подмножества признаков, сформированные по кластерам. Функция get_feature_clusters теперь выполняет подавление шума в корреляционной матрице перед ONC, если включен параметр denoise, а также принимает заранее вычисленную матрицу, чтобы вызывающий код мог продолжить работу после неудачной подгонки без повторного вычисления матрицы. |
| importance.py | afml/feature_importance/importance.py | MDI, MDA, кластерные варианты и SFI. Теперь при перестановке в MDA перемешанные значения записываются обратно в тот DataFrame, на котором оценивается качество модели, а все три метода возвращают столбцы типа float, а не object. |
| feature_engineering_summary.html | reports/ | Отчет, полученный в результате запуска, на котором основаны все рисунки и таблицы в этой статье: состояние методов, состав кластеров, ранжирование по каждому методу, раздел SFI и таблица размывания важности. |
Перевод с английского произведен MetaQuotes Ltd.
Оригинальная статья: https://www.mql5.com/en/articles/23564
Предупреждение: все права на данные материалы принадлежат MetaQuotes Ltd. Полная или частичная перепечатка запрещена.
Данная статья написана пользователем сайта и отражает его личную точку зрения. Компания MetaQuotes Ltd не несет ответственности за достоверность представленной информации, а также за возможные последствия использования описанных решений, стратегий или рекомендаций.


