

Архитектура машинного обучения для MetaTrader 5 (Часть 19): Режимы бэггинга
 13
 0

Содержание
- Введение
- Механизм, заявленный в AFML
- Четыре режима формирования выборки для одной базовой модели
- Показатели: сначала механизм, потом эффективность
- Смешение эффектов из-за различий базовых моделей
- Какой прирост уникальности даёт последовательный бутстрэп
- За счёт чего на самом деле снижается корреляция
- Эффективность и перестановочный тест
- Завышение OOB-оценки и калибровка вероятностных прогнозов
- Повторение эксперимента при более высокой плотности событий (бары M5)
- От Python к MQL5
- Заключение:
- Прикрепленные файлы
Введение
В части 4 этой серии было введено понятие одновременной активности меток, в части 5 был реализован последовательный бутстрэп, а в части 18 были исправлены две ошибки в классификаторе на основе бэггинга, использующем этот метод. Во всех трёх случаях одно звено в цепочке рассуждений было принято за данность, а не определено экспериментально. В §6.2 AFML неудачу бэггинга на метках с перекрывающимися временными интервалами объясняют корреляцией между базовыми моделями, а в §4.5 в качестве решения предлагается последовательный бутстрэп. Неявное утверждение состоит в том, что именно переход от стандартного бутстрэпа к последовательному бутстрэпу снижает корреляцию между деревьями. В этой статье мы экспериментально проверяем, так ли это.
Этот вопрос важен, поскольку отбор по правилу последовательного бутстрэпа требует дополнительных затрат. Для этого требуется алгоритм формирования выборки, скомпилированный с помощью Numba. Он работает с одним деревом за раз, а не с целым пакетом деревьев в векторизованном режиме. Кроме того, это усложняет последующую работу с блоками кросс-валидации: для каждого обучающего подмножества приходится заново привязывать индексы алгоритма формирования выборки. Если стандартный бутстрэп с меньшим числом извлечений обеспечивает такое же снижение корреляции, то механизм последовательного бутстрэпа лишь добавляет затраты, не принося пользы. Поэтому вместо того, чтобы сравнивать последовательный бутстрэп с наивным базовым вариантом и объявлять о победе, мы разбиваем изменение на две независимые составляющие и измеряем эффект каждой.
Эти две составляющие — число наблюдений в выборке и правило отбора. При переходе от стандартного бутстрэпа полного объёма к последовательному бутстрэпу с числом извлечений, определяемым средней уникальностью, оба параметра меняются одновременно: извлекается меньше строк, и отбираются они по другому правилу. Чтобы верно установить причину снижения корреляции, нужно изменять эти два фактора независимо друг от друга. Именно это обеспечивает схема эксперимента с четырьмя режимами формирования выборки, позволяя чётко уточнить механизм, описанный в AFML: на этих данных снижение корреляции обеспечивается числом извлечений, а правило отбора последовательного бутстрэпа почти ничего к этому не добавляет.
Механизм, заявленный в AFML
Дисперсия бэггинг-ансамбля из N базовых моделей, каждая из которых имеет дисперсию σ², при средней попарной корреляции между ними ρ задаётся формулой из §6.2 AFML: ρσ² + (1−ρ)σ²/N. По мере увеличения N второй член исчезает, а первый — нет. Дисперсия ограничена снизу величиной ρσ². Бэггинг снижает дисперсию лишь в той мере, в какой снижена корреляция между базовыми моделями, и никакое количество деревьев не спасёт ансамбль, у которого ρ остаётся высоким.
Перекрывающиеся метки метода тройного барьера повышают ρ. Событие, начавшееся на баре t, может завершиться лишь на баре t + 20, поэтому интервалы формирования исходов у последовательных событий в значительной степени перекрываются. При стандартном бутстрэпе отбор из этих почти дублирующих друг друга строк выполняется с возвращением, поэтому два дерева получают во многом одинаковую информацию, а их прогнозы согласуются сильнее, чем прогнозы независимых деревьев. Средняя уникальность из AFML §4.4 количественно характеризует избыточность: для каждого события это среднее за время его существования значение величины, обратной числу одновременно активных событий. На используемых здесь тиковых барах EURUSD этот показатель составляет 0.435, то есть эффективный объём независимой выборки значительно меньше половины номинального числа строк.
В AFML §4.5 для решения этой проблемы предлагается последовательный бутстрэп. Вместо равновероятного отбора алгоритм выбирает каждый следующий индекс с вероятностью, которая уменьшается по мере роста перекрытия соответствующего события с уже выбранными событиями, тем самым формируя выборку с меньшей одновременной активностью меток. Проверяется конкретное утверждение: именно это правило отбора, а не просто уменьшение числа извлечений, которое обычно его сопровождает, снижает ρ.
Четыре режима формирования выборки при одной и той же базовой модели
Сравниваются четыре ансамбля по 200 деревьев в каждом; все они оцениваются при одинаковой схеме кросс-валидации PurgedKFold. Во всех режимах бэггинг применяется к одной и той же базовой модели, поэтому меняется только алгоритм формирования выборки строк.
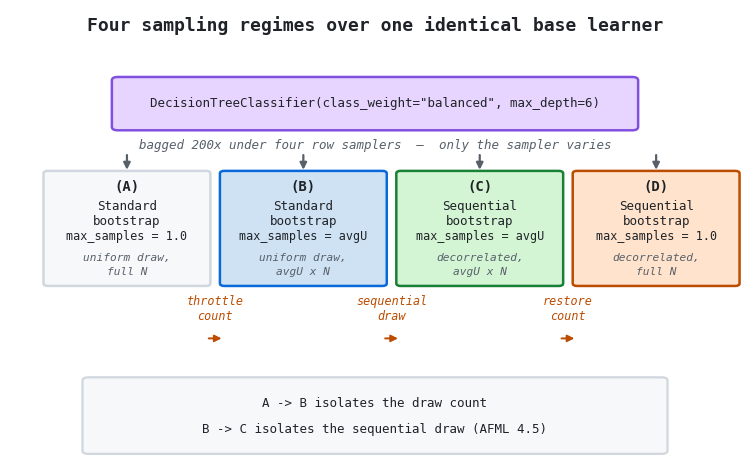
Рисунок 1. Иллюстрация разделения факторов формирования выборки на примере четырёх режимов
- Режим A: стандартный бутстрэп при max_samples = 1.0 — равновероятный отбор с полным числом извлечений, выполняемый классификатором на основе бэггинга по умолчанию.
- Режим B: стандартный бутстрэп при значении max_samples, равном средней уникальности, что уменьшает число наблюдений в выборке без изменения правила отбора.
- Режим C: последовательный бутстрэп при значении max_samples, равном средней уникальности; правило отбора, снижающее корреляцию, применяется при уменьшенном числе извлечений.
- Режим D: последовательный бутстрэп при max_samples = 1.0 — правило отбора, снижающее корреляцию, при полном числе извлечений.
Сравнения проводятся между соседними режимами. Сравнение A и B позволяет выделить эффект числа извлечений при неизменном правиле отбора. Сравнение B и C позволяет выделить эффект последовательного правила отбора при фиксированном числе извлечений, то есть проверить именно то, что описано в §4.5 AFML. Сравнение C и D позволяет проверить, сохраняется ли польза от последовательного правила отбора после снятия ограничения на число наблюдений в выборке. Поскольку во всех режимах для бэггинга используется один и тот же тип базовой модели, различия между режимами нельзя объяснить различиями базовых моделей.
Метрики: сначала механизм, затем эффективность
В центре внимания — механизм, а не итоговые показатели. Для каждого режима приводятся значения пяти показателей. Первые два показателя характеризуют сам механизм: фактическое отношение уникальности сформированной выборки к базовой, то есть среднюю уникальность строк, фактически отобранных для каждого дерева, деленную на среднюю уникальность полного набора данных. Корреляция между деревьями измеряется как средняя попарная корреляция их вероятностных прогнозов на наблюдениях вне бутстрэп-выборки (OOB). Корреляция между деревьями — это измеряемое значение ρ из выражения в §6.2, и именно эту величину должен изменять последовательный бутстрэп.
Остальные три показателя отражают последствия работы этого механизма. Показателем эффективности служит AUC на данных вне обучающей выборки при кросс-валидации с очисткой от перекрывающихся наблюдений. Мы приводим результаты перестановочного теста для основного попарного различия, поскольку сопутствующее исследование эффективности показало, что изменение числа событий менее чем на 2 % может привести к сдвигу AUC примерно на 0.10. Разница между долей правильных ответов на наблюдениях вне бутстрэп-выборки (OOB) и долей правильных ответов при кросс-валидации с очисткой от перекрывающихся наблюдений сама по себе служит диагностическим показателем избыточности, поскольку в AFML отмечается, что избыточность наблюдений приводит к завышению OOB-оценки. Оценка Брайера характеризует калибровку вероятностных прогнозов, что важно, поскольку прогнозы используемой на практике модели передаются в функцию bet_size_probability.
Смешение эффектов из-за различий базовых моделей
В первой версии этого эксперимента для режимов A и B использовался классификатор RandomForestClassifier, а для режимов C и D — классификатор на основе бэггинга с последовательным бутстрэпом. Такая схема эксперимента некорректна, и причину стоит пояснить, поскольку ее легко упустить из виду. Случайный лес не только формирует бутстрэп-выборки строк, но и при каждом разбиении узла отбирает случайное подмножество признаков. Отбор подмножества признаков сам по себе служит механизмом снижения корреляции, причем отличным от отбора строк. Если с одной стороны используется случайный лес, а с другой — бэггинг деревьев, то в любом изменении корреляции между деревьями при переходе от A к C эффект алгоритма формирования выборки строк смешивается с эффектом наличия или отсутствия отбора подмножества признаков, и разделить эти два эффекта невозможно.
Решение — использовать бэггинг с одной и той же базовой моделью DecisionTreeClassifier во всех четырёх режимах (class_weight="balanced"). Отбор подмножества признаков везде отключён, поэтому единственным изменяющимся компонентом остаётся алгоритм формирования выборки строк. Это самое важное решение при планировании данного исследования. Без этого невозможно корректное сравнение режимов B и C, которое и даёт ответ на поставленный вопрос.
Какой прирост уникальности даёт последовательный бутстрэп
На уровне отобранных строк последовательный бутстрэп даёт заявленный эффект. На панели (a) рисунка ниже показана средняя уникальность выборки каждого дерева, делённая на базовую среднюю уникальность полного набора данных.
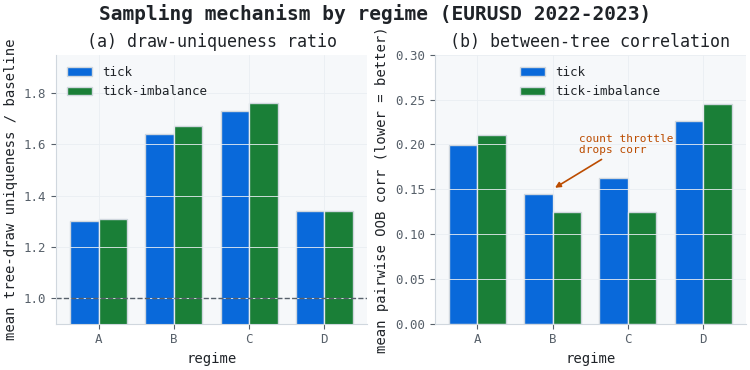
Рисунок 2. Иллюстрация механизма формирования выборки в разных режимах на двух панелях
- Панель (a): отношение уникальности сформированной выборки к базовой. Сокращение числа извлечений повышает этот показатель с 1.30 в режиме A до 1.64 в режиме B, а последовательный бутстрэп — далее до 1.73 в режиме C; в режиме D с последовательным бутстрэпом и полным числом извлечений показатель вновь снижается до 1.34.
- Панель (b): корреляция между деревьями; чем ниже значение, тем сильнее снижение корреляции. Основное снижение корреляции приходится на переход от A к B; при переходе от B к C она не меняется или немного возрастает, а в режиме D корреляция наиболее высокая из всех четырёх режимов.
Рассмотрим панель (a), следуя намеченной последовательности сравнения режимов. В режиме A используется полное число наблюдений в выборке с равными вероятностями отбора, и показатель достигает 1.30 — выше базового уровня, поскольку бутстрэп-выборка объёмом N содержит лишь около 63 % различных строк. Сокращение числа извлечений с учётом средней уникальности в режиме B повышает это отношение до 1.64. Применение правила отбора последовательного бутстрэпа при том же числе извлечений в режиме C повышает показатель до 1.73, давая дополнительный прирост на 6 % на тиковых барах и на 5 % на барах дисбаланса тиков. Последовательный бутстрэп действительно повышает уникальность отобранных строк при фиксированном числе извлечений, что и является его заявленной задачей. Режим D подтверждает, что число наблюдений в выборке — определяющий фактор: при полном числе извлечений правило отбора последовательного бутстрэпа не позволяет избежать избыточных строк, и отношение уникальности сформированной выборки к базовой вновь падает до 1.34, лишь немного превышая показатель режима A.
За счет чего на самом деле снижается корреляция
Предполагается, что более высокая уникальность сформированных выборок должна приводить к более низкой корреляции между деревьями, и именно здесь объяснение механизма расходится с фактическими данными. На графике в панели (b) изображена наблюдаемая величина ρ. На тиковых барах этот показатель снижается с 0.199 в режиме A до 0.145 в режиме B — существенное снижение, полностью обусловленное уменьшением числа извлечений при стандартном бутстрэпе. Применение последовательного бутстрэпа в режиме C не приводит к дальнейшему снижению. При этом корреляция вновь немного повышается — до 0.163. На барах дисбаланса тиков эти два режима с уменьшенным числом извлечений дают практически неразличимые значения корреляции: 0.126 для B и 0.125 для C. Ни при одном из двух представлений данных правило отбора последовательного бутстрэпа не снижает корреляцию между деревьями сильнее, чем простое уменьшение числа извлечений.
Режим D еще нагляднее подтверждает этот вывод. Последовательный бутстрэп с полным числом извлечений обеспечивает наименьшее снижение корреляции среди четырех режимов: корреляция составляет 0.227 на тиковых барах и 0.246 на барах дисбаланса тиков, что даже хуже, чем в базовом режиме равновероятного отбора с полным числом извлечений. При полном числе извлечений последовательный бутстрэп по-прежнему охватывает почти все строки, а дополнительная концентрация отбора на немногочисленных строках с высокой уникальностью, по-видимому, усиливает, а не ослабляет согласованность прогнозов деревьев. На ковариационный член из §6.2 влияет число наблюдений в выборке, а не правило отбора. Это главный эмпирический результат статьи, и он сохраняется для обоих типов баров.
Эффективность и перестановочный тест
Однако все это не приводит к улучшению итоговых показателей качества. Для каждого режима AUC вне обучающей выборки находится совсем близко к линии отсутствия прогностической способности на уровне 0.50: значения для обоих представлений данных лежат в диапазоне от 0.472 до 0.485.
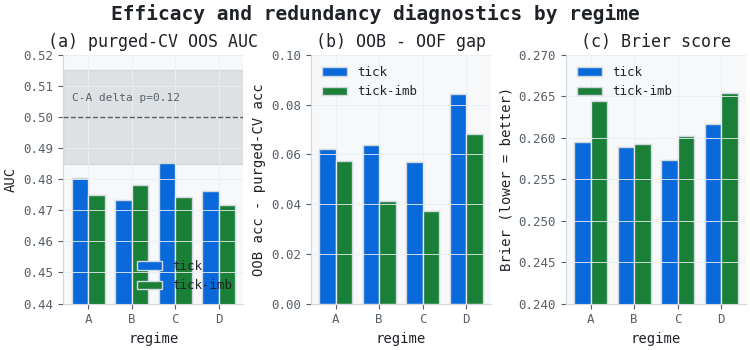
Рисунок 3. Диагностика эффективности и избыточности на трех панелях
- Панель (a): AUC вне обучающей выборки при кросс-валидации с очисткой от перекрывающихся наблюдений; область отсутствия прогностической способности выделена заливкой. Все столбцы попадают в эту область, а наибольшая попарная разность не проходит проверку перестановочным тестом.
- Панель (b): разность между долей правильных ответов на наблюдениях вне бутстрэп-выборки (OOB) и долей правильных ответов на отложенных блоках кросс-валидации (OOF). Режим D характеризуется наибольшим разрывом в обоих представлениях.
- Панель (c): оценка Брайера; калибровка вероятностных прогнозов в режимах B и C немного лучше, чем в режимах A и D с полным числом извлечений.
На тиковых барах наиболее выигрышно выглядит режим C — последовательный бутстрэп с сокращённым числом извлечений: его AUC составляет 0.485, что на 0.013 выше, чем у базового режима A. Перестановочный тест по методу Монте-Карло позволяет проверить, является ли этот разрыв статистически значимым. Метаметки перемешиваются, оба режима повторно оцениваются с использованием одной и той же кросс-валидации с очисткой от перекрывающихся наблюдений, и разность фиксируется; распределение разности C минус A при нулевой гипотезе имеет среднее 0.000 и стандартное отклонение 0.008. Наблюдаемое значение 0.013 дает двустороннее p-значение, равное 0.125. Это p-значение не ниже порога 0.05, а порог для набора режимов с поправкой Шидака оно превышает ещё сильнее. По эффективности эти четыре режима неразличимы.
Именно в этом и заключается проблема «удачи», о которой предупреждает Тимоти Мастерс в книге Testing and Tuning Market Trading Systems: результат бэктеста или кросс-валидации, который кажется прибыльным (или, как здесь, демонстрирует несколько лучшие статистические свойства), может оказаться просто удачным попаданием в хвост распределения при нулевой гипотезе с центром в нуле. Перестановочный тест обеспечивает ту статистическую защиту, на которой настаивает Мастерс: явную проверку контрфактического сценария — сохранилось бы наблюдаемое преимущество, если бы метки были случайными. Здесь это не так. Согласуясь с выводом сопутствующего исследования о том, что улучшение статистических свойств не повысило эффективность стратегии, p-значение подтверждает: небольшое преимущество режима C неотличимо от шума.
Завышение OOB-оценки и калибровка вероятностных прогнозов
Оценка на наблюдениях вне бутстрэп-выборки (OOB) — заманчивый способ упростить выбор модели, поскольку её получают при обучении без дополнительных затрат. На панели (b) показано, почему в данном случае это ловушка. Разрыв между долей правильных ответов на наблюдениях вне бутстрэп-выборки (OOB) и честной оценкой доли правильных ответов при кросс-валидации с очисткой от перекрывающихся наблюдений максимален для режима D: 0.084 на тиковых барах и 0.068 на барах дисбаланса тиков; это как раз режим последовательного бутстрэпа с полным числом извлечений, который мог бы выбрать практик, наиболее точно следующий рекомендациям книги. При выборе модели по оценке на наблюдениях вне бутстрэп-выборки (OOB) режим D получил бы высокое место, хотя его AUC при кросс-валидации с очисткой от перекрывающихся наблюдений — одна из худших, а оценка Брайера — худшая из четырёх. Оценка на наблюдениях вне бутстрэп-выборки (OOB) завышена именно там, где извлечения наиболее избыточны, а последовательный бутстрэп с полным числом извлечений избыточен по самому принципу его построения. Практический вывод категоричен: никогда не используйте оценки на наблюдениях вне бутстрэп-выборки (OOB) для выбора модели при работе с финансовыми метками с перекрывающимися временными интервалами. Это ловушка, которая напрямую ведёт к вложению капитала в переобученные модели.
Панель калибровки вероятностных прогнозов завершает оценку готовности модели к практическому применению. Режимы B и C с ограниченным числом извлечений дают самые низкие оценки Брайера — от 0.257 до 0.259, тогда как режимы A и D с полным числом извлечений показывают худшие результаты — до 0.265. Модель, вероятностный прогноз которой используется для определения размера позиции, следует выбирать с учётом калибровки вероятностных прогнозов в той же мере, что и AUC; по этому критерию режимы с ограниченным числом извлечений имеют небольшое преимущество. Практическая рекомендация по итогам всей сетки экспериментов проста: при стандартном бутстрэпе задайте параметру max_samples значение средней уникальности и рассматривайте последовательный бутстрэп как второстепенное улучшение, а не как ключевую корректировку, какой он представлен в книге.
Повторение эксперимента при более высокой плотности событий (бары M5)
При использовании описанных выше тиковых баров и баров дисбаланса тиков формируется примерно один бар в час, что за два года данных по EURUSD даёт всего от 1 269 до 1 289 событий с метаметками. Метод, сама идея которого заключается в использовании высокочастотных данных, не следует проверять на выборке, эквивалентной часовой; малое число событий — ещё и более прозаичная причина того, что описанный выше перестановочный тест не смог полностью исключить случайный характер результата. В этом разделе та же схема эксперимента с четырьмя режимами формирования выборки повторяется на временных барах M5; все остальные условия остаются неизменными. На барах M5 получается 11 833 события — примерно в девять раз больше, чем выше, — при средней уникальности 0.462, сопоставимой со значением 0.435 для тиковых баров.
Повторный эксперимент на M5 проводился с 60 деревьями и разбиением PurgedKFold на 4 блока кросс-валидации вместо 200 деревьев и 5 блоков в основной сетке экспериментов; такую облегчённую конфигурацию пришлось использовать из-за возросших вычислительных затрат в режимах последовательного бутстрэпа при десятикратном увеличении числа строк. Предварительная серия экспериментов на тиковых барах с числом деревьев от 30 до 200 во всём диапазоне воспроизвела тот же порядок режимов по результатам, поэтому число деревьев, как ожидается, не будет здесь решающим фактором. Тем не менее, прежде чем считать результаты повторного эксперимента окончательными, следует подтвердить их на M5 с полным ансамблем из 200 деревьев. Читателям с достаточными вычислительными ресурсами рекомендуется запустить прилагаемый ноутбук с 200 деревьями; представленные результаты на M5 с 60 деревьями служат предварительным подтверждением тенденции, а не окончательным выводом.
| Режим | Корреляция (тиковые бары) | Корреляция (бары дисбаланса тиков) | Корреляция (M5) |
|---|
Порядок режимов по результатам, на котором основан главный вывод статьи, полностью сохраняется: переход от A к B обеспечивает снижение корреляции, переход от B к C несколько повышает её обратно, а режим D остаётся худшим из четырёх. На M5 абсолютные значения корреляции ниже во всех режимах, а разрыв между лучшим режимом (B) и худшим (D) в относительном выражении несколько сокращается; однако соотношение A > D, C ≈ B (при небольшом преимуществе B) не меняется даже при девятикратном увеличении числа событий. Это самое убедительное свидетельство в статье того, что эффект реален, а не является артефактом малой выборки, эквивалентной данным H1.
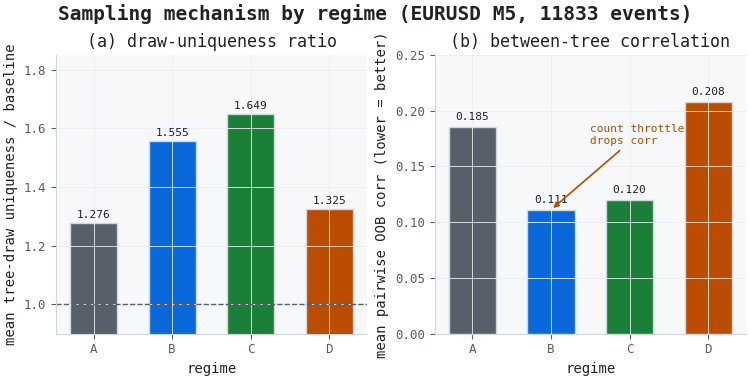
Рисунок 4. Иллюстрация из двух панелей, показывающая механизм формирования выборки на M5
- Панель (a): отношение уникальности сформированной выборки к базовой на M5. В режиме A значение составляет 1.28, в B — 1.56, в C — 1.65, в D — 1.32; соотношение значений такое же, как в основной сетке эксперимента.
- Панель (b): корреляция между деревьями на M5. В режиме B корреляция самая низкая — 0.111, в C она немного выше — 0.120, а в D самая высокая — 0.208.
В картине эффективности появляется одно действительно новое отличие. На M5 значения AUC вне обучающей выборки для всех режимов находятся выше линии отсутствия прогностической способности на уровне 0.50 — в диапазоне от 0.511 до 0.520, тогда как в основной сетке эксперимента все они находились ниже этой линии. Более мелкий временной шаг позволяет выявить слабый, но измеримый сигнал, который не удавалось обнаружить на более крупных барах. Однако выявить различия между режимами это не позволяет. Наибольшая попарная разность теперь наблюдается между B и A и составляет 0.0047; перестановочный тест при стандартном отклонении распределения при нулевой гипотезе 0.0036 дает двустороннее p-значение 0.216 — свидетельство реального различия слабее, чем на тиковых барах, хотя само распределение при нулевой гипотезе стало уже. Большее число событий повысило точность оценки и тем самым уменьшило кажущееся преимущество. По эффективности четыре режима остаются неразличимыми при таком числе событий, которое с достаточно высокой вероятностью позволило бы выявить различия, если бы они действительно существовали.
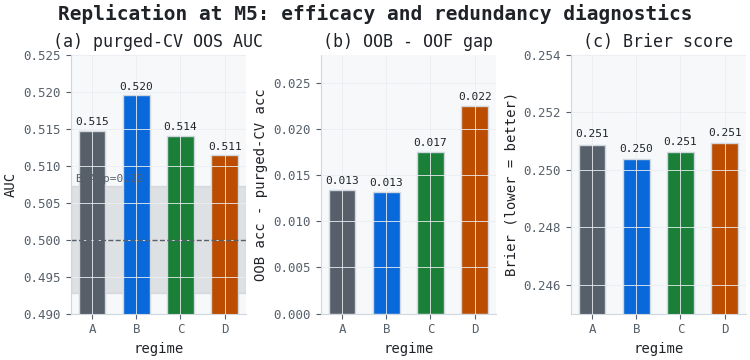
Рисунок 5. Иллюстрация из трех панелей с диагностикой эффективности и избыточности на M5
- Панель (a): AUC вне обучающей выборки при кросс-валидации с очисткой от перекрывающихся наблюдений на M5; значения для всех четырех режимов выше линии отсутствия прогностической способности, отмечена наибольшая попарная разность.
- Панель (b): разрыв между оценками OOB и OOF на M5 сократился до 0.013–0.022 по сравнению с 0.037–0.084 в основной сетке эксперимента, но порядок режимов сохранился, причем D остается худшим.
- Панель (c): оценка Брайера на M5; значения сосредоточены в узком диапазоне 0.250–0.251, при этом режим B немного превосходит остальные.
Результаты диагностики завышения OOB-оценки также подтверждаются и не усложняют, а уточняют решение о внедрении модели. В режиме D по-прежнему наблюдается наибольший разрыв между OOB- и OOF-оценками: 0.022 против 0.013 для A и B; картина та же, что и на основной сетке, но абсолютная величина разрыва примерно вчетверо меньше. При большем числе событий оценка по кросс-валидации с очисткой от перекрывающихся наблюдений сама по себе меньше расходится с OOB-оценкой, однако направление расхождения остается прежним. Калибровка вероятностных прогнозов устраняет неоднозначность, оставшуюся по результатам эксперимента на основной сетке. Там режимы B и C были настолько близки по оценке Брайера, что выбор любого из них для внедрения был обоснован. На M5 режим B однозначно лучший и по AUC, и по оценке Брайера, тогда как режим C уже неотличим от A. Единственный аргумент в пользу последовательного бутстрэпа на основной сетке — практически равная с B калибровка вероятностных прогнозов — не подтверждается при повторении эксперимента с более высокой плотностью событий.
От Python к MQL5
Вывод офлайн-анализа, подтвержденный при девятикратном числе событий, таков: стандартный бутстрэп с ограниченным числом извлечений, то есть режим B, обеспечивает наибольшее снижение корреляции и наилучшую калибровку вероятностных прогнозов, а последовательное правило отбора не дает обнаружимого выигрыша в качестве прогнозов ни при одной из двух частот формирования баров.
В части 20 я перенесу эти результаты в Тестер стратегий MetaTrader 5. В частности, я экспортирую в ONNX модели режима B (стандартный бутстрэп с ограниченным числом извлечений) и режима A (базовый вариант с полным числом извлечений), встрою их в советник с метаразметкой, представленный в части 17, и запущу обе системы на ранее не использовавшемся годе тиковых данных, отложенном для независимой проверки. Тест покажет, приводит ли выявленное в офлайн-анализе преимущество от снижения корреляции к более высокой чистой прибыли, меньшей максимальной просадке и более высокому коэффициенту Шарпа, рассчитанному по траектории капитала, после учета транзакционных издержек, смоделированных в части 14. В Тестере стратегий также будут проверены режимы C и D, чтобы прямо ответить на принципиальный вопрос: дает ли режим, обеспечивший наибольшее снижение корреляции в офлайн-анализе, и наилучшую динамику капитала в тестере или различия сглаживаются, как при кросс-валидации? Ключевой вопрос — сохраняется ли эффект статистической корректировки, подтвержденный при повторении эксперимента на M5, при потиковом исполнении сделок, имитирующем реальную торговлю.
О выборе B вместо C или D стоит сказать прямо, поскольку он противоречит предпочтению, отданному в книге другому варианту. В режимах C и D используется последовательный бутстрэп из AFML, и ни основная сетка, ни повторение эксперимента на M5 не оправдывают затраты на него: он не дает преимуществ ни в качестве прогнозов, ни в калибровке вероятностных прогнозов, но создает ощутимые издержки в виде дополнительной вычислительной сложности на этапе получения прогнозов из-за алгоритма формирования выборки, скомпилированного с помощью Numba. В тестер поступает модель, полученная с помощью обычного бутстрэпа с ограниченным числом извлечений. Тип баров, используемых для обучения и работы модели в тестере, должен соответствовать повторному эксперименту на M5, а не более грубой основной сетке: результаты на M5 обладают большей статистической мощностью, и именно такую частоту формирования баров предполагается использовать в рабочем конвейере машинного обучения.
Такой переход соответствует методологической строгости сопутствующей серии статей. Офлайн-диагностика дает гипотезу о поведении модели в реальной торговле, а не заменяет его проверку; именно в тестере эта гипотеза проверяется на барах вне обучающей выборки, которые никак не использовались при выборе модели.
Заключение:
Бэггинг при метках с перекрывающимися временными интервалами действительно требует корректировки, и в §6.2 AFML проблема диагностирована верно: избыточные извлечения сохраняют корреляцию между деревьями и задают нижний предел дисперсии ансамбля. Однако для одной высоколиквидной валютной пары, такой как EURUSD на данных за 2022–2023 годы, существенная корректировка сводится к ограничению числа извлечений в соответствии со средней уникальностью. Вполне возможно, что на широком наборе акций с иной динамикой одновременной активности меток и моментума последовательное правило отбора проявит свою силу. Однако здесь стандартный бутстрэп при таком сокращенном числе извлечений обеспечивает весь эффект снижения корреляции; последовательное правило отбора при том же числе извлечений не дает измеримого дополнительного эффекта ни для корреляции между деревьями, ни для AUC на данных вне обучающей выборки. Режим последовательного бутстрэпа с полным числом извлечений хуже по всем значимым показателям, включая завышение OOB-оценки, из-за которого при неосмотрительном выборе ему могли бы отдать предпочтение.
Это уточнение выводов книги, а не их опровержение. Последовательный бутстрэп действительно повышает уникальность отобранных строк, в точности как указано в §4.5. Однако данные не подтверждают дальнейший вывод о том, что именно последовательное правило отбора служит действенным рычагом снижения корреляции в ансамбле на данном конкретном инструменте. Здесь таким рычагом служит число наблюдений в выборке. Хотя доминирующий механизм может меняться в зависимости от класса активов, методологический вывод вполне универсален: если рекомендуемый метод объединяет два изменения, разделите их и измерьте эффект каждого, прежде чем приписывать ему полученное преимущество. Не всегда именно тот компонент, на который делается акцент, является определяющим для результата. В части 20 четыре обученные модели будут перенесены в Тестер стратегий, чтобы проверить, сохранятся ли полученные результаты на данных за год, отложенный для независимой проверки.
Прикрепленные файлы
Папка afml/ содержит минимальную часть пакета afml от Blueprint Quant: только подпакеты, которые импортирует этот ноутбук, с пустыми файлами-маркерами пакетов вместо загрузчика полной версии пакета. Для этого потребуются библиотеки numba, scipy, statsmodels и TA-Lib, а также numpy, pandas и scikit-learn.
| Файл | Местоположение | Описание | |
|---|---|---|---|
| 1. | Blueprint_Part19_Bagging_Regimes.ipynb | Notebooks\ | Ноутбук для воспроизведения результатов. Формирует размеченный набор данных из кэшированных тиковых баров, баров дисбаланса тиков и баров M5, сравнивает четыре режима формирования выборки для каждой частоты формирования баров, вычисляет пять метрик для каждого режима и воспроизводит перестановочные тесты и все рисунки. |
| 2. | tick.parquet, tick_imb.parquet, m5.parquet | bars_cache\ | Блокнот напрямую считывает готовые OHLCV-бары, поэтому для воспроизведения результатов статьи не требуется повторная обработка исходной истории тиков EURUSD за 2022–2023 годы. 12 325 тиковых баров, 13 220 баров дисбаланса тиков и 147 860 баров M5. |
| 3. | afml/ensemble/, sampling/ | afml\ | Классификатор SequentiallyBootstrappedBaggingClassifier, а также процедуры последовательного бутстрэпа, расчета средней уникальности и одновременной активности меток, определяющие режимы формирования выборки. |
| 4. | afml/strategies/, labeling/ | afml\ | Основная стратегия и разметка методом тройного барьера, с помощью которых формируются события и наборы t1 для вычисления средней уникальности. |
| 5. | afml/cross_validation/, data_structures/, filters/, util/, sample_weights/ | afml\ | PurgedKFold, средства построения баров, фильтр CUSUM, целевой показатель волатильности и вспомогательные функции для работы с весами наблюдений. |
Перевод с английского произведен MetaQuotes Ltd.
Оригинальная статья: https://www.mql5.com/en/articles/23137
Предупреждение: все права на данные материалы принадлежат MetaQuotes Ltd. Полная или частичная перепечатка запрещена.
Данная статья написана пользователем сайта и отражает его личную точку зрения. Компания MetaQuotes Ltd не несет ответственности за достоверность представленной информации, а также за возможные последствия использования описанных решений, стратегий или рекомендаций.


