

Точность вычислений под прицелом: Сравнение MQL5, ONNX Runtime и ALGLIB
 32
 1

Введение
Большинство из нас считает математические библиотеки взаимозаменяемыми. Скалярное произведение — это скалярное произведение, поэтому не должно иметь значения, выполняется ли оно с использованием матричных типов MQL5, встроенного порта ALGLIB или ONNX Runtime. В этой статье это предположение проверяется на примере одной небольшой сети и показывается, где оно подтверждается, а где — нет: результаты двух из трех вычислительных движков совпадают с эталоном float64 в пределах машинной точности, а третий демонстрирует измеримое снижение точности и увеличение времени выполнения.
Я намеренно ограничил рамки эксперимента. Я беру обученный многослойный перцептрон (8 входов, скрытые слои из 16 и 8 нейронов с функцией активации ReLU, один линейный выход) и выполняю один и тот же прямой проход средствами штатного MQL5 с типами matrix<double> и vector<double>, с использованием CMatrixDouble из ALGLIB и в ONNX Runtime через OnnxRun(). Одинаковые веса, одинаковые входные данные, три варианта выполнения. Затем измеряю два показателя, важных для советника при работе в реальном времени: насколько результат каждого движка отклоняется от эталона float64, рассчитанного в Python, и сколько микросекунд каждый из них тратит на один вызов.
Проект состоит из девяти файлов: скрипта экспорта на Python, трех общих подключаемых файлов, трех подключаемых файлов вычислительных движков, советника для тестирования и индикатора мониторинга на графике. Ниже я опишу каждый файл: для чего он нужен, как работает и почему имеет именно такую структуру. Затем вы сможете использовать этот тестовый стенд в своем проекте с другой моделью.
Область рассмотрения: речь идет о сравнительном тестировании вычислений, а не о торговой стратегии. Нигде в проекте нет логики входа в позицию или выхода из нее. Советник представляет собой диагностический тестовый стенд, который выполняет один и тот же инференс тремя способами и записывает результаты в журнал, поэтому в статье не делается никаких заявлений об эффективности какой-либо стратегии. Эти выводы применимы ко всему, что обычно рассчитывается непосредственно в коде: рекурсивным индикаторам, фильтрам рыночных режимов, инференсу моделей машинного обучения и формулам расчета размера позиции с учетом риска.
Почему точность вычислений — проблема торговли, а не математики
Погрешность отдельного инференса величиной 1e-6 обычно безвредна. Однако вблизи порога принятия решения та же погрешность может изменить результат на противоположный. В разделе "Результаты" мы вернемся к этому случаю. Рекурсивный фильтр, текущая оценка дисперсии или расчет по типу EMA — это другой случай: собственный результат подается обратно на вход, и одна и та же небольшая погрешность повторно вносится на каждом баре. В зависимости от устойчивости самого фильтра эта погрешность может накапливаться, приводя к заметному расхождению линий индикатора, стабилизироваться в виде постоянного смещения или затухать. Без проверки нельзя считать, что этим можно пренебречь: если два движка дают разные линии индикатора, то в итоге они могут привести и к разным торговым решениям.
Есть и вторая, более насущная причина: замена вычислительного движка. Часто сначала создают прототип модели на Python, экспортируют его в ONNX, а затем встраивают в советник, в котором те же вычисления ранее выполнялись средствами штатного MQL5 или ALGLIB. Если вы ни разу не измеряли расхождение результатов этих двух реализаций, то вы лишь предполагаете, что они эквивалентны. Использование в ONNX Runtime по умолчанию тензоров float32 может сделать такое предположение дорогостоящим, а это тестирование позволяет количественно оценить цену такого допущения.
Вторая сторона вопроса — время выполнения. Вопрос не только в том, какой движок самый быстрый, но и в том, какой из них стабильно показывает наименьшее время выполнения. Среднее значение скрывает поведение хвоста распределения, а именно этот хвост определяет, сохранит ли ваш советник отзывчивость при высокой частоте поступления тиков в период выхода новостей. Именно поэтому тестовый стенд сохраняет каждый исходный замер времени выполнения и выводит процентили p95 и p99 наряду со средним значением.
Архитектура системы и схема файлов
Тестовый стенд обеспечивает неизменность всех условий. Единственные намеренно заданные различия — способ выполнения вычислений и внутренняя точность каждого движка. Тензоры float32 в ONNX Runtime — часть того, что отличает этот вычислительный движок от остальных, а не отдельная переменная, введенная дополнительно. Поэтому в этом сравнительном тестировании три движка сравниваются так, как они используются на практике, — каждый с присущими ему особенностями численных вычислений. Если бы эти три движка изначально выполняли расчеты для разных моделей или разных входных данных, такое сравнение не имело бы смысла. Поэтому все остальные условия зафиксированы:
Одинаково для всех трех вычислительных движков:
1. Одни и те же веса многослойного перцептрона с архитектурой 8-16-8-1 и функциями активации ReLU/ReLU/линейная, полученные при однократном обучении в NumPy с точностью float64. Граф ONNX содержит их копии в формате float32
2. Одинаковый пакет входных данных (200 синтетических тестовых векторов, фиксированное начальное значение генератора случайных чисел)
3. Одинаковый эталонный результат (результат прямого прохода в NumPy с точностью float64, принятый за эталон)
4. Одинаковое количество итераций и одинаковый порядок прогрева (200 прогревочных проходов, затем 5 000 измеряемых проходов по набору из 200 векторов)
Различаться может именно то, что мы измеряем: точность, используемая внутри каждого вычислительного движка, и путь выполнения кода от входа до выхода.
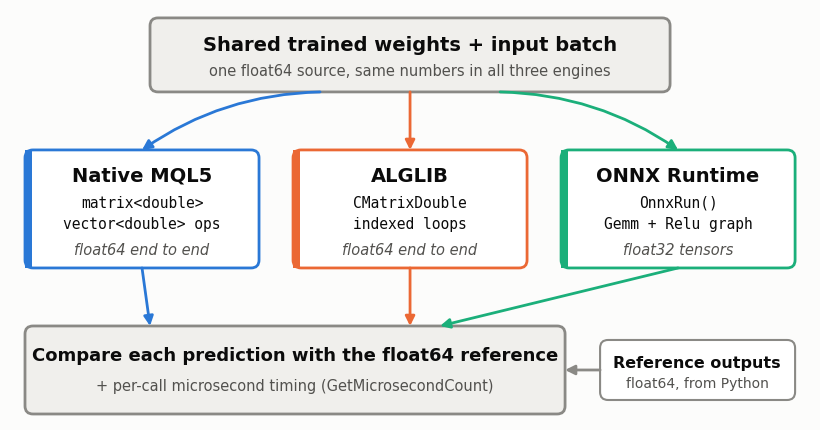
Рис. 1. Архитектура сравнительного тестирования: один набор обученных весов используется тремя независимыми движками; каждое предсказание сверяется с эталоном float64, а время его вычисления измеряется с микросекундной точностью.
Данные проходят через девять файлов в одном направлении. Следующие разделы выстроены в том же порядке, поэтому статью можно читать сверху вниз, открыв рядом исходный код:
1. Скрипт train_export_model.py обучает сеть и записывает файлы model_weights.csv, test_vectors.csv и model.onnx.
2. Файл BenchmarkConfig.mqh содержит размерности, имена файлов и количество итераций, общие для всех файлов MQL5.
3. Файл WeightLoader.mqh считывает CSV-файл с весами и проверяет размерности.
4. MathEngineNative.mqh, MathEngineAlglib.mqh и MathEngineOnnx.mqh — это три вычислительных движка, каждый из которых имеет методы Init() и Predict().
5. Файл BenchmarkStats.mqh собирает замеры времени выполнения и статистику погрешностей.
6. Файл MathFidelityBenchmark_EA.mq5 загружает все необходимое, выполняет измеряемые проходы и записывает файл benchmark_results.csv.
7. Модуль FidelityMonitor.mq5 считывает данные из этого CSV-файла и выводит на график панель со сводными данными.
Несколько деталей обеспечивают корректность сравнения. Вычислительные движки никогда не обмениваются данными друг с другом: каждый формирует собственные контейнеры весов на основе массивов загрузчика, поэтому ошибка в копии данных одного движка не может повлиять на данные другого. Эталонный результат поступает из Python и только считывается, но никогда не пересчитывается в MQL5. Кроме того, советник не обращается к графику, торговому инструменту или ценовым данным, поэтому ничто, кроме самих арифметических вычислений, не может повлиять на результат проверки точности вычислений. На время выполнения влияют планировщик ОС, динамическое изменение частоты процессора, фоновая нагрузка и сам терминал. Поэтому результаты измерения времени выполнения зависят от конкретного компьютера и конкретного запуска. Ожидается, что результаты проверки точности вычислений будут лучше воспроизводиться на разных компьютерах.
Общие константы: BenchmarkConfig.mqh
Этот файл подключается во всех файлах MQL5 проекта и не содержит никакой логики. Он служит единым местом хранения параметров, которые должны быть согласованы во всех остальных компонентах: размеров слоев, имен файлов в папке MQL5\Files и количества итераций.
BenchmarkConfig.mqh
//+------------------------------------------------------------------+
//| Network dimensions                                               |
//| Must match the Python export, the weight CSV headers and the     |
//| ONNX input/output shape. Every engine checks them at load time.  |
//+------------------------------------------------------------------+
#define BENCH_INPUT_DIM     8
#define BENCH_HIDDEN1_DIM   16
#define BENCH_HIDDEN2_DIM   8
#define BENCH_OUTPUT_DIM    1

//+------------------------------------------------------------------+
//| File names, relative to MQL5\Files                               |
//+------------------------------------------------------------------+
#define BENCH_PROJECT_NAME  "MathFidelityBenchmark"
#define BENCH_WEIGHTS_FILE  "MathFidelityBenchmark\\model_weights.csv"
#define BENCH_VECTORS_FILE  "MathFidelityBenchmark\\test_vectors.csv"
#define BENCH_ONNX_FILE     "MathFidelityBenchmark\\model.onnx"
#define BENCH_RESULTS_FILE  "MathFidelityBenchmark\\benchmark_results.csv"
#define BENCH_ERRORS_FILE   "MathFidelityBenchmark\\error_detail.csv"

//+------------------------------------------------------------------+
//| Iteration counts                                                 |
//+------------------------------------------------------------------+
#define BENCH_WARMUP_ITERS  200
#define BENCH_TIMED_ITERS   5000
Четыре константы размерности описывают сеть 8-16-8-1. Скрипт на Python, заголовки файлов весов, размеры матриц в вычислительном движке на штатном MQL5, циклы ALGLIB и формы тензоров ONNX — все они проверяются на соответствие именно этим значениям, а не друг другу. При изменении архитектуры нужно внести изменения здесь и в скрипте на Python. Загрузка любого файла, не соответствующего этим параметрам, завершится ошибкой, а не приведет к получению правдоподобного, но неверного результата.
Имена файлов хранятся здесь по той же причине. Советник, загрузчик и индикатор должны использовать один и тот же путь к файлу benchmark_results.csv, и опечатка в одной из трех копий приведет к тому, что панель мониторинга будет постоянно оставаться пустой. Количество итераций (200 проходов для прогрева и 5 000 измеряемых проходов) — это лишь значения по умолчанию для входных параметров советника, поэтому их можно изменить на вкладке "Входные параметры" без перекомпиляции.
Контракт признаков и файл WeightLoader.mqh
Главный риск при сравнительном тестировании трех реализаций — не расхождение результатов из-за точности представления чисел. Это незаметное несоответствие форм, из-за которого один движок выполняет немного иные вычисления, чем два других, но все равно возвращает правдоподобное число. Обрезанная строка весов, граф ONNX, экспортированный с неверной формой входных данных, константа размерности, переставшая соответствовать скрипту обучения, — каждый из этих случаев дает результат, который выглядит как показатель точности вычислений, но на самом деле вызван программной ошибкой.
Решение — явно проверять контракт и при его нарушении прерывать загрузку с явным сообщением об ошибке. Перед первой итерацией сравнительного тестирования выполняются три проверки:
1. Размерности данных в файле весов: в каждом разделе model_weights.csv указано свое количество строк и столбцов, и CWeightLoader отклоняет файл, если хотя бы в одном разделе эти значения не соответствуют константам #define.
2. Форма тензора ONNX: функции OnnxSetInputShape() и OnnxSetOutputShape() вызываются с теми же константами сразу после вызова OnnxCreate(), и движок не запускается, если хотя бы один из этих вызовов завершается ошибкой.
3. Размерность тестового вектора: в первой строке файла test_vectors.csv указана размерность входных данных, и советник сравнивает ее со значением BENCH_INPUT_DIM еще до чтения первой строки данных.
Первая проверка выполняется в модуле загрузки весов. Формат файла — простой CSV с разделами, помеченными тегами. Я выбрал его, поскольку функция FileReadNumber() в MQL5 поддерживает его напрямую и писать парсер не требуется: за строкой с тегом, количеством строк и количеством столбцов следует строка со значениями в построчном порядке.
//+------------------------------------------------------------------+
//| CWeightLoader                                                    |
//| Reads the tagged-section CSV written by train_export_model.py:   |
//|   #W1,8,16                                                       |
//|   v0,v1,...,v127                                                 |
//|   #b1,1,16                                                       |
//|   v0,...,v15                                                     |
//| and so on for W2/b2 and W3/b3. Each section header is checked    |
//| against the BENCH_* constants before any value is accepted, so a |
//| truncated or reshaped export fails here and not three layers on. |
//+------------------------------------------------------------------+
class CWeightLoader
  {
public:
   double            W1[]; double b1[];   // 8x16, 16
   double            W2[]; double b2[];   // 16x8, 8
   double            W3[]; double b3[];   // 8x1,  1
   bool              m_loaded;

                     CWeightLoader(void) : m_loaded(false) {}
Класс предоставляет шесть массивов как открытые члены, чтобы каждый вычислительный движок мог копировать данные непосредственно из них. Метод Load() открывает файл один раз и считывает шесть разделов в фиксированном порядке с помощью цепочки операторов &&, что автоматически обеспечивает сокращенное вычисление: первая же ошибка чтения раздела прерывает цепочку, при этом выводится причина ошибки, а m_loaded остается равным false. Метод Init() каждого движка начинается с проверки этого флага, поэтому частично загруженный набор весов никогда не попадет в тестирование.
//+------------------------------------------------------------------+
//| CWeightLoader::Load                                              |
//+------------------------------------------------------------------+
   bool              Load(const string filename)
     {
      int fh = FileOpen(filename, FILE_READ | FILE_CSV | FILE_ANSI, ',');
      if(fh == INVALID_HANDLE)
        {
         PrintFormat("[WeightLoader] failed to open %s, error %d", filename, GetLastError());
         return false;
        }

      bool ok = ReadSection(fh, "#W1", BENCH_INPUT_DIM,   BENCH_HIDDEN1_DIM, W1) &&
                ReadSection(fh, "#b1", 1,                 BENCH_HIDDEN1_DIM, b1) &&
                ReadSection(fh, "#W2", BENCH_HIDDEN1_DIM, BENCH_HIDDEN2_DIM, W2) &&
                ReadSection(fh, "#b2", 1,                 BENCH_HIDDEN2_DIM, b2) &&
                ReadSection(fh, "#W3", BENCH_HIDDEN2_DIM, BENCH_OUTPUT_DIM,  W3) &&
                ReadSection(fh, "#b3", 1,                 BENCH_OUTPUT_DIM,  b3);

      FileClose(fh);
      m_loaded = ok;
      if(ok)
         Print("[WeightLoader] all sections loaded and dimension-checked OK");
      return ok;
     }

private:
Функция ReadSection() выполняет основную работу. Сначала она считывает тег и два заявленных размера, а затем сравнивает все три значения с теми, которые ожидает вызывающий код. Только после этого она считывает значения, вызывая FileIsEnding() для проверки перед чтением каждого элемента, чтобы при усечении файла сообщить, какого именно элемента не хватает. Обратите внимание: функция никогда не полагается на указанную в самом файле форму матриц — ожидаемое количество строк и столбцов берется из BenchmarkConfig.mqh.
//+------------------------------------------------------------------+
//| CWeightLoader::ReadSection                                       |
//+------------------------------------------------------------------+
   bool              ReadSection(int fh, const string tag, const int rows, const int cols, double &dest[])
     {
      string header_tag = FileReadString(fh);
      int    header_rows = (int)FileReadNumber(fh);
      int    header_cols = (int)FileReadNumber(fh);

      if(header_tag != tag)
        {
         PrintFormat("[WeightLoader] expected tag %s, got %s", tag, header_tag);
         return false;
        }
      if(header_rows != rows || header_cols != cols)
        {
         PrintFormat("[WeightLoader] %s dimension mismatch: file says %dx%d, config expects %dx%d",
                     tag, header_rows, header_cols, rows, cols);
         return false;
        }

      int total = rows * cols;
      ArrayResize(dest, total);
      for(int i = 0; i < total; i++)
        {
         if(FileIsEnding(fh))
           {
            PrintFormat("[WeightLoader] %s truncated at element %d/%d", tag, i, total);
            return false;
           }
         dest[i] = FileReadNumber(fh);
        }
      return true;
     }
  };
Создание и экспорт общей модели: train_export_model.py
Все три вычислительных движка должны использовать одни и те же обученные веса, поэтому обучение выполняется ровно один раз — на Python, причем все вычисления проводятся в NumPy с типом float64. Здесь нет PyTorch и нет необходимости согласовывать расположение весов, специфичное для конкретного фреймворка. Сеть обучается обычным градиентным спуском по полной выборке на синтетической регрессионной задаче, где целевое значение — tanh от линейной комбинации восьми входных значений с добавлением небольшого нелинейного члена и шума. Выбор целевой зависимости не имеет значения для сравнительного тестирования. Важно, чтобы веса были реалистичными, нетривиальными числами с плавающей запятой, а прямой проход состоял из трех слоев с функцией ReLU между ними:
forward()
def forward(x, W1, b1, W2, b2, W3, b3):
    h1_pre = x @ W1 + b1
    h1 = relu(h1_pre)
    h2_pre = h1 @ W2 + b2
    h2 = relu(h2_pre)
    out = h2 @ W3 + b3
    return h1_pre, h1, h2_pre, h2, out
Веса везде хранятся в виде матриц размера (вход × выход): в CSV, в реализации на MQL5, в ALGLIB и в узлах Gemm модели ONNX. Именно единая ориентация матриц позволяет избежать типичной ошибки при переносе реализации. К этому вопросу мы вернемся в разделе "Пограничные случаи и возможные проблемы".
Экспорт дает три результата. Во-первых, веса записываются в CSV-файл с тегами, который считывает CWeightLoader. Значения записываются с 17 значащими цифрами — этого достаточно, чтобы после записи и обратного считывания точно восстановить любое число типа float64. Это также определяет предел измерений: если при экспорте веса или эталонные выходные значения округляются до десяти знаков после запятой, сравнительное тестирование не позволит различить погрешности ниже примерно 1e-10, а у реализаций на MQL5 и ALGLIB будет наблюдаться кажущийся нижний предел погрешности, обусловленный файлом, а не самими движками.
write_section()
def write_section(f, tag, arr, rows, cols):
    f.write(f"{tag},{rows},{cols}\n")
    f.write(",".join(f"{v:.17g}" for v in arr.flatten()) + "\n")

with open("model_weights.csv", "w") as f:
    write_section(f, "#W1", W1, INPUT_DIM, H1)
    write_section(f, "#b1", b1, 1, H1)
    write_section(f, "#W2", W2, H1, H2)
    write_section(f, "#b2", b2, 1, H2)
    write_section(f, "#W3", W3, H2, OUTPUT_DIM)
    write_section(f, "#b3", b3, 1, OUTPUT_DIM)
Во-вторых, скрипт генерирует 200 новых случайных входных векторов, выполняет для них прямой проход в формате float64 и записывает каждый вектор вместе с его эталонным выходным значением. Первые две строки файла задают размерность входа и количество строк — эти данные используются для третьей проверки контракта из предыдущего раздела.
тестовые векторы
X_test = rng.normal(0.0, 1.0, size=(N_TEST, INPUT_DIM))
_, _, _, _, y_test = forward(X_test, W1, b1, W2, b2, W3, b3)

with open("test_vectors.csv", "w") as f:
    f.write(f"{INPUT_DIM}\n{N_TEST}\n")
    for row, ref in zip(X_test, y_test):
        f.write(",".join(f"{v:.17g}" for v in row) + f",{ref[0]:.17g}\n")
В-третьих, те же самые веса подставляются в граф ONNX, построенный вручную из узлов Gemm и Relu, при этом все инициализаторы преобразуются в тип float32. Я строю граф вручную, а не экспортирую из фреймворка, чтобы при преобразовании весов в граф экспортер не выполнял собственных слияний операций и не менял расположение данных. Именно преобразование в float32 в const_tensor() намеренно создает разницу в точности вычислений, которую мы собираемся измерить. Скрипт также фиксирует версию промежуточного представления (IR) модели и версию набора операций (opset), поскольку модель, сохраненная с настройками по умолчанию новейшей версии onnx, может использовать версию IR, которую старые среды выполнения не поддерживают при загрузке.
Экспорт в формат ONNX
def const_tensor(name, arr):
    return helper.make_tensor(name, TensorProto.FLOAT, arr.shape, arr.astype(np.float32).flatten())

nodes = [
    helper.make_node("Gemm", ["input", "W1", "b1"], ["h1_pre"], alpha=1.0, beta=1.0),
    helper.make_node("Relu", ["h1_pre"], ["h1"]),
    helper.make_node("Gemm", ["h1", "W2", "b2"], ["h2_pre"], alpha=1.0, beta=1.0),
    helper.make_node("Relu", ["h2_pre"], ["h2"]),
    helper.make_node("Gemm", ["h2", "W3", "b3"], ["output"], alpha=1.0, beta=1.0),
]
initializers = [
    const_tensor("W1", W1), const_tensor("b1", b1),
    const_tensor("W2", W2), const_tensor("b2", b2),
    const_tensor("W3", W3), const_tensor("b3", b3),
]
graph = helper.make_graph(
    nodes, "MathFidelityBenchmarkNet",
    [helper.make_tensor_value_info("input", TensorProto.FLOAT, [1, INPUT_DIM])],
    [helper.make_tensor_value_info("output", TensorProto.FLOAT, [1, OUTPUT_DIM])],
    initializers,
)
model = helper.make_model(graph, producer_name="MathFidelityBenchmark",
                          opset_imports=[helper.make_opsetid("", 13)])
model.ir_version = 8   # newer onnx releases default to an IR version older runtimes may not support
save(model, "model.onnx")
train_export_model.py прилагается отдельным файлом наряду с архивом. Запустите скрипт с помощью команды python train_export_model.py (для этого необходимо установить numpy и onnx, больше ничего не требуется). Скрипт не принимает аргументов и записывает файлы model_weights.csv, test_vectors.csv и model.onnx непосредственно в папку, из которой его запускают. Фиксированное начальное значение генератора случайных чисел обеспечивает воспроизводимость каждого запуска. Скопируйте эти три файла в папку MQL5\Files\MathFidelityBenchmark\ вашего терминала, и советник загрузит их точно так же, как и мои файлы.
Вычислительный движок 1: MathEngineNative.mqh
Вычислительный движок на штатном MQL5 служит базой для сравнения, относительно которой оцениваются два других. Веса хранятся в полях типа matrix<double>, а смещения — в полях типа vector<double>. Все вычисления выполняются в формате float64 — от передачи данных загрузчиком до возврата предсказания из Predict(). В первой версии этого движка я использовал оператор * для непосредственного умножения вектора-строки на матрицу весов, предполагая, что в MQL5 он перегружен для этой операции так же, как для арифметических операций между векторами. Оказалось, что это не так: компилятор MetaEditor отклонил и выражение vector * matrix, и вызов MatMul(), который я попробовал следующим, поскольку в этой сборке для типа vector не предусмотрено ни то ни другое. Приведенный ниже вариант действительно компилируется: в нем используется явный цикл по элементам матрицы и вектора — такой же, как в вычислительном движке ALGLIB, но со встроенными типами вместо типов ALGLIB.
//+------------------------------------------------------------------+
//| CMathEngineNative                                                |
//| Engine 1: built-in matrix/vector types, float64 end to end.      |
//| The other two engines are judged against this one for speed.     |
//+------------------------------------------------------------------+
class CMathEngineNative
  {
private:
   matrix<double>    m_W1, m_W2, m_W3;
   vector<double>    m_b1, m_b2, m_b3;
   bool              m_ready;

//+------------------------------------------------------------------+
//| CMathEngineNative::LoadMatrix                                    |
//+------------------------------------------------------------------+
   // matrix::Assign(array) does not keep the shape set by Init() -- it
   // silently collapses the matrix to one row of rows*cols columns, so
   // every W[i][o] lookup past row 0 goes out of range. Filling each
   // element directly is the only reshape-proof way to load these.
   void              LoadMatrix(matrix<double> &dst, double &flat[], const int rows, const int cols)
     {
      dst.Init(rows, cols);
      for(int r = 0; r < rows; r++)
         for(int c = 0; c < cols; c++)
            dst[r][c] = flat[r * cols + c];
     }

public:
                     CMathEngineNative(void) : m_ready(false) {}

//+------------------------------------------------------------------+
//| CMathEngineNative::Init                                          |
//+------------------------------------------------------------------+
   bool              Init(CWeightLoader &loader)
     {
      if(!loader.m_loaded)
         return false;

      LoadMatrix(m_W1, loader.W1, BENCH_INPUT_DIM,   BENCH_HIDDEN1_DIM);
      LoadMatrix(m_W2, loader.W2, BENCH_HIDDEN1_DIM, BENCH_HIDDEN2_DIM);
      LoadMatrix(m_W3, loader.W3, BENCH_HIDDEN2_DIM, BENCH_OUTPUT_DIM);

      // vectors have no 2D shape to lose, so Assign() is safe here
      m_b1.Init(BENCH_HIDDEN1_DIM); m_b1.Assign(loader.b1);
      m_b2.Init(BENCH_HIDDEN2_DIM); m_b2.Assign(loader.b2);
      m_b3.Init(BENCH_OUTPUT_DIM);  m_b3.Assign(loader.b3);

      m_ready = true;
      return true;
     }

//+------------------------------------------------------------------+
//| CMathEngineNative::Layer                                         |
//+------------------------------------------------------------------+
   // one dense layer: out = relu(in * W + b), read straight off the
   // matrix/vector containers -- vector*matrix has no operator here
   void              Layer(const vector<double> &in, const matrix<double> &W,
                            const vector<double> &b, const bool relu, vector<double> &out)
     {
      ulong out_dim = b.Size();
      ulong in_dim  = in.Size();
      out.Init(out_dim);
      for(ulong o = 0; o < out_dim; o++)
        {
         double acc = b[o];
         for(ulong i = 0; i < in_dim; i++)
            acc += in[i] * W[i][o];
         out[o] = (relu && acc < 0.0) ? 0.0 : acc;
        }
     }

//+------------------------------------------------------------------+
//| CMathEngineNative::Predict                                       |
//+------------------------------------------------------------------+
   double            Predict(const vector<double> &in_vec)
     {
      vector<double> h1, h2, out;
      Layer(in_vec, m_W1, m_b1, true,  h1);
      Layer(h1,    m_W2, m_b2, true,  h2);
      Layer(h2,    m_W3, m_b3, false, out);
      return out[0];
     }

   bool              IsReady(void) const { return m_ready; }
  };
Функция Init() задает размеры каждой матрицы по константам конфигурации, а затем присваивает ей плоский массив, полученный от загрузчика, так что построчный порядок элементов в данных загрузчика напрямую соответствует их расположению в матрице. Функция Layer() выполняет вычисления для одного полносвязного слоя: для каждого выходного нейрона она берет смещение в качестве начального значения и суммирует по всем входам произведения in[i] * W[i][o], считывая данные непосредственно из контейнеров vector и matrix. Если установлен флаг relu, отрицательный результат заменяется нулем. Функция Predict() последовательно вызывает ее три раза, отключая ReLU при последнем вызове, и возвращает элемент итогового вектора с индексом 0.
На этом пути вычислений точность нигде не меняется. Здесь нет ни промежуточных приведений типов, ни преобразований контейнеров, и нигде не используется float32, поэтому этот вычислительный движок одновременно самый быстрый и самый близкий по результатам к эталонной реализации на Python. Одну деталь я намеренно оставил без изменений: при каждом вызове Predict() выделяется память под три временных вектора. Версия с заранее выделенными буферами работала бы еще быстрее, но именно такой код большинство разработчиков написало бы сначала. Кроме того, он обеспечивает корректное сравнение с двумя другими вычислительными движками, которые тоже выделяют память при каждом вызове.
Вычислительный движок 2: MathEngineAlglib.mqh
Вычислительный движок ALGLIB использует ту же арифметику float64, но другой контейнер. Веса хранятся в объектах CMatrixDouble, а операция умножения с накоплением реализована в виде явных индексированных циклов вместо вызова GEMM. Я намеренно выбрал такой подход вместо процедуры умножения матриц из ALGLIB, чтобы отдельно рассмотреть вопрос: каковы накладные расходы на контейнер и индексацию при одинаковой точности? Вызов GEMM позволил бы ответить на другой вопрос — насколько быстр собственный оптимизированный путь вычислений ALGLIB, — но не на тот, который рассматривается в этом сравнительном тестировании.
//+------------------------------------------------------------------+
//| CMathEngineAlglib                                                |
//| Engine 2: CMatrixDouble as the weight container, float64.        |
//| The multiply-accumulate is written as plain loops over the       |
//| container indexers, not a GEMM call. That is how most EAs use    |
//| ALGLIB for a small forward pass, and it isolates one question:   |
//| what does the container and indexing cost at equal precision?    |
//+------------------------------------------------------------------+
class CMathEngineAlglib
  {
private:
   CMatrixDouble     m_W1, m_W2, m_W3;
   double            m_b1[], m_b2[], m_b3[];
   bool              m_ready;

//+------------------------------------------------------------------+
//| CMathEngineAlglib::LoadMatrix                                    |
//+------------------------------------------------------------------+
   void              LoadMatrix(CMatrixDouble &dst, double &flat[], const int rows, const int cols)
     {
      dst.Resize(rows, cols);
      for(int r = 0; r < rows; r++)
         for(int c = 0; c < cols; c++)
            dst.Set(r, c, flat[r * cols + c]);
     }

//+------------------------------------------------------------------+
//| CMathEngineAlglib::ForwardLayer                                  |
//+------------------------------------------------------------------+
   void              ForwardLayer(const double &in[], const int in_dim,
                                   CMatrixDouble &W, const double &b[], const int out_dim,
                                   double &out[], const bool relu)
     {
      ArrayResize(out, out_dim);
      for(int o = 0; o < out_dim; o++)
        {
         double acc = b[o];
         for(int i = 0; i < in_dim; i++)
            acc += in[i] * W[i][o];
         out[o] = (relu && acc < 0.0) ? 0.0 : acc;
        }
     }

public:
                     CMathEngineAlglib(void) : m_ready(false) {}

//+------------------------------------------------------------------+
//| CMathEngineAlglib::Init                                          |
//+------------------------------------------------------------------+
   bool              Init(CWeightLoader &loader)
     {
      if(!loader.m_loaded)
         return false;

      LoadMatrix(m_W1, loader.W1, BENCH_INPUT_DIM,   BENCH_HIDDEN1_DIM);
      LoadMatrix(m_W2, loader.W2, BENCH_HIDDEN1_DIM, BENCH_HIDDEN2_DIM);
      LoadMatrix(m_W3, loader.W3, BENCH_HIDDEN2_DIM, BENCH_OUTPUT_DIM);

      ArrayCopy(m_b1, loader.b1);
      ArrayCopy(m_b2, loader.b2);
      ArrayCopy(m_b3, loader.b3);

      m_ready = true;
      return true;
     }

//+------------------------------------------------------------------+
//| CMathEngineAlglib::Predict                                       |
//+------------------------------------------------------------------+
   double            Predict(const double &in_vec[])
     {
      double h1[], h2[], out[];
      ForwardLayer(in_vec, BENCH_INPUT_DIM,   m_W1, m_b1, BENCH_HIDDEN1_DIM, h1, true);
      ForwardLayer(h1,    BENCH_HIDDEN1_DIM, m_W2, m_b2, BENCH_HIDDEN2_DIM, h2, true);
      ForwardLayer(h2,    BENCH_HIDDEN2_DIM, m_W3, m_b3, BENCH_OUTPUT_DIM,  out, false);
      return out[0];
     }

   bool              IsReady(void) const { return m_ready; }
  };
Функция LoadMatrix() изменяет размер матрицы ALGLIB и поэлементно копирует в нее плоский массив загрузчика с помощью CMatrixDouble::Set(row, col, value) — собственного метода матрицы для прямой записи элемента. Индекс r * cols + c позволяет восстановить соответствие элементов после преобразования матрицы в плоский массив в построчном порядке в Python. Чтение отдельного элемента, как в функции ForwardLayer() ниже, выполняется через оператор индексации W[i][o], но для записи нужно вызывать Set() у самой матрицы, а не у полученной из нее строки. Затем ForwardLayer() выполняет вычисления одного полносвязного слоя: для каждого выходного нейрона берет смещение в качестве начального значения, суммирует in[i] * W[i][o] по всем входам и применяет ReLU только по запросу вызывающего кода. Функция Predict() последовательно выполняет три таких вызова, причем для последнего слоя ReLU отключена.
По результатам вычислений эта реализация должна совпадать с реализацией на MQL5, и результаты проверки точности вычислений это подтверждают. Для этого движка ключевой показатель — время выполнения, поскольку каждое обращение W[i][o] проходит через вызовы индексатора контейнера, а не напрямую к массиву. Обратите внимание: при каждом вызове Predict() также объявляются три локальных динамических массива, то есть память выделяется так же, как в реализации на MQL5.
Вычислительный движок 3: MathEngineOnnx.mqh
Именно в коде вычислительного движка ONNX проявляется ключевая проблема, рассматриваемая в статье. На всех предшествующих этапах — при обучении, экспорте весов и расчете эталонных выходных значений — используется float64, но тензоры ONNX Runtime здесь имеют тип float32, и при пересечении этой границы мы неизбежно переходим к вычислениям с более низкой точностью.
//+------------------------------------------------------------------+
//| CMathEngineOnnx                                                  |
//| Engine 3: ONNX Runtime through OnnxRun.                          |
//| Same trained weights as the other two, but the tensors are       |
//| float32. Any fidelity gap here comes from that round trip.       |
//+------------------------------------------------------------------+
class CMathEngineOnnx
  {
private:
   long              m_handle;
   bool              m_ready;

public:
                     CMathEngineOnnx(void) : m_handle(INVALID_HANDLE), m_ready(false) {}

//+------------------------------------------------------------------+
//| CMathEngineOnnx::~CMathEngineOnnx                                |
//+------------------------------------------------------------------+
                    ~CMathEngineOnnx(void)
     {
      if(m_handle != INVALID_HANDLE)
         OnnxRelease(m_handle);
     }

//+------------------------------------------------------------------+
//| CMathEngineOnnx::Init                                            |
//+------------------------------------------------------------------+
   bool              Init(const string onnx_filename)
     {
      m_handle = OnnxCreate(onnx_filename, ONNX_DEFAULT);
      if(m_handle == INVALID_HANDLE)
        {
         PrintFormat("[MathEngineOnnx] OnnxCreate failed, error %d", GetLastError());
         return false;
        }

      ulong input_shape[]  = {1, BENCH_INPUT_DIM};
      ulong output_shape[] = {1, BENCH_OUTPUT_DIM};

      if(!OnnxSetInputShape(m_handle, 0, input_shape))
        {
         PrintFormat("[MathEngineOnnx] OnnxSetInputShape failed, error %d", GetLastError());
         return false;
        }
      if(!OnnxSetOutputShape(m_handle, 0, output_shape))
        {
         PrintFormat("[MathEngineOnnx] OnnxSetOutputShape failed, error %d", GetLastError());
         return false;
        }

      // same idea as the WeightLoader checks: fail at load time
      if(input_shape[1] != BENCH_INPUT_DIM || output_shape[1] != BENCH_OUTPUT_DIM)
        {
         Print("[MathEngineOnnx] declared ONNX shape does not match BenchmarkConfig.mqh");
         return false;
        }

      m_ready = true;
      return true;
     }

//+------------------------------------------------------------------+
//| CMathEngineOnnx::Predict                                         |
//+------------------------------------------------------------------+
   double            Predict(const double &in_vec[])
     {
      float in_data[BENCH_INPUT_DIM];
      for(int i = 0; i < BENCH_INPUT_DIM; i++)
         in_data[i] = (float)in_vec[i];

      float out_data[BENCH_OUTPUT_DIM];
      if(!OnnxRun(m_handle, ONNX_DEFAULT, in_data, out_data))
        {
         PrintFormat("[MathEngineOnnx] OnnxRun failed, error %d", GetLastError());
         return 0.0;
        }
      return (double)out_data[0];
     }

   bool              IsReady(void) const { return m_ready; }
  };
Функция Init() создает сеанс ONNX Runtime на основе файла .onnx, затем с помощью констант конфигурации задает формы входного и выходного тензоров 1 × 8 и 1 × 1 соответственно, а при неудаче любого вызова завершает работу с кодом ошибки. Это вторая проверка контракта признаков. Заключительное сравнение массивов форм с константами защищает от ручного изменения одного из массивов. Основная проверка, на которую я полагаюсь, состоит в том, что OnnxSetInputShape() и OnnxSetOutputShape() возвращают false, если среда выполнения отклоняет форму. Деструктор освобождает дескриптор сеанса, поэтому движок самостоятельно освобождает ресурсы, даже если советник завершается досрочно.
Функция Predict() короткая. Входной массив поэлементно приводится к типу float, при этом каждое значение округляется до 24-битной мантиссы еще до поступления в вычислительный граф. Веса уже хранятся в вычислительном графе в виде копий типа float32, все функции активации вычисляются в float32, а на выходе результат снова приводится к типу double, что не восстанавливает уже утраченную информацию. В случае сбоя метод выводит сообщение об ошибке и возвращает 0.0, поэтому неудачный вызов отражается в журнале, а не прерывает выполнение. Однако это также означает, что неудачный вызов и действительно ошибочный прогноз со значением 0.0 будут неразличимы в статистике точности вычислений. Во всех запусках, результаты которых приведены в статье, OnnxRun() ни разу не завершилась с ошибкой, поэтому это не повлияло на приведенные ниже показатели. Тем не менее, прежде чем доверять результатам оценки точности вычислений для другой модели или на другом компьютере, стоит проверить журнал на наличие ошибок.
Измерение времени выполнения и погрешности: BenchmarkStats.mqh
Файл статистики содержит два небольших класса — по одному на каждый вопрос, на который должно ответить тестирование. CLatencyStats отвечает на вопрос "сколько времени занял каждый вызов", а CFidelityStats — на вопрос "насколько каждый результат отличался от эталона".
CLatencyStats хранит все исходные замеры в массиве типа long, а не только обновляемое среднее. Это требует памяти (миллион замеров на каждый вычислительный движок занимает около 8 МБ при 8-байтовом типе long), но позволяет сохранить сведения о хвосте распределения, которые теряются при усреднении. Reset() заранее выделяет память под массив для всего запуска, поэтому Add() обычно лишь записывает значение в ячейку. Ветвь расширения массива служит только подстраховкой. Mean() накапливает сумму в 64-битной целочисленной переменной, чего достаточно для текущего количества замеров, и один раз выполняет деление в конце.
//+------------------------------------------------------------------+
//| CLatencyStats                                                    |
//| Keeps every raw sample instead of a running mean. A mean throws  |
//| away the tail, and the tail (p95/p99) is what hurts on a busy    |
//| tick.                                                            |
//+------------------------------------------------------------------+
class CLatencyStats
  {
private:
   long              m_samples[];
   int               m_count;

public:
                     CLatencyStats(void) : m_count(0) {}

//+------------------------------------------------------------------+
//| CLatencyStats::Reset                                             |
//+------------------------------------------------------------------+
   void              Reset(const int capacity)
     {
      ArrayResize(m_samples, capacity);
      m_count = 0;
     }

//+------------------------------------------------------------------+
//| CLatencyStats::Add                                               |
//+------------------------------------------------------------------+
   void              Add(const long microseconds)
     {
      if(m_count >= ArraySize(m_samples))
         ArrayResize(m_samples, ArraySize(m_samples) + 1024);
      m_samples[m_count] = microseconds;
      m_count++;
     }

   int               Count(void) const { return m_count; }

//+------------------------------------------------------------------+
//| CLatencyStats::Mean                                              |
//+------------------------------------------------------------------+
   double            Mean(void) const
     {
      if(m_count == 0)
         return 0.0;
      long sum = 0;
      for(int i = 0; i < m_count; i++)
         sum += m_samples[i];
      return (double)sum / (double)m_count;
     }
Percentile() копирует замеры, сортирует копию, сохраняя исходный порядок в оригинале, и выполняет линейную интерполяцию между значениями с двумя соседними рангами. Если ранг задается выражением p * (m_count - 1), то p = 0.5 соответствует медиане, а p = 0.99 — позиции ближе к верхнему концу отсортированного списка. Дробная часть определяет веса двух соседних значений при интерполяции, чтобы результат не менялся скачками между вызовами. Median() — лишь обертка над этой функцией. Сортировать копию при каждом вызове затратно, но советник делает это лишь несколько раз для каждого вычислительного движка после цикла измерения времени, а не внутри него.
//+------------------------------------------------------------------+
//| CLatencyStats::Percentile                                        |
//+------------------------------------------------------------------+
   double            Percentile(const double p) const
     {
      if(m_count == 0)
         return 0.0;
      long sorted[];
      ArrayResize(sorted, m_count);
      ArrayCopy(sorted, m_samples, 0, 0, m_count);
      ArraySort(sorted);
      double rank = p * (m_count - 1);
      int    lo   = (int)MathFloor(rank);
      int    hi   = (int)MathCeil(rank);
      if(lo == hi)
         return (double)sorted[lo];
      double frac = rank - lo;
      return sorted[lo] * (1.0 - frac) + sorted[hi] * frac;
     }

   double            Median(void) const { return Percentile(0.50); }
  };
CFidelityStats при каждом прогнозе обновляет четыре показателя: накопленную сумму и максимум абсолютной погрешности, а также накопленную сумму и максимум относительной погрешности. Add() принимает предсказанное значение и эталон типа float64. При расчете относительной погрешности абсолютная погрешность делится на MathMax(MathAbs(reference), 1e-8), что ограничивает знаменатель снизу. Без этого для немногочисленных тестовых векторов, у которых эталонное выходное значение близко к нулю, получались бы огромные относительные погрешности, определяющие почти все среднее значение, хотя абсолютная погрешность для этих векторов очень мала.
//+------------------------------------------------------------------+
//| CFidelityStats                                                   |
//| Accumulates absolute and relative error against the float64      |
//| reference output.                                                |
//+------------------------------------------------------------------+
class CFidelityStats
  {
private:
   double            m_abs_sum;
   double            m_abs_max;
   double            m_rel_sum;
   double            m_rel_max;
   int               m_count;

public:
                     CFidelityStats(void)
     {
      m_abs_sum = 0.0; m_abs_max = 0.0;
      m_rel_sum = 0.0; m_rel_max = 0.0;
      m_count   = 0;
     }

//+------------------------------------------------------------------+
//| CFidelityStats::Add                                              |
//+------------------------------------------------------------------+
   void              Add(const double predicted, const double reference)
     {
      double abs_err = MathAbs(predicted - reference);
      double denom   = MathMax(MathAbs(reference), 1e-8);
      double rel_err = abs_err / denom;

      m_abs_sum += abs_err;
      m_rel_sum += rel_err;
      if(abs_err > m_abs_max) m_abs_max = abs_err;
      if(rel_err > m_rel_max) m_rel_max = rel_err;
      m_count++;
     }

   int               Count(void)   const { return m_count; }
   double            AbsMean(void) const { return (m_count == 0) ? 0.0 : m_abs_sum / m_count; }
   double            AbsMax(void)  const { return m_abs_max; }
   double            RelMean(void) const { return (m_count == 0) ? 0.0 : m_rel_sum / m_count; }
   double            RelMax(void)  const { return m_rel_max; }
  };
Тестовый стенд: MathFidelityBenchmark_EA.mq5
Этот советник связывает все воедино, причем делает это практически без использования механизмов торгового советника. Он подключает шесть заголовочных файлов, предоставляет три входных параметра (число проходов прогрева, число измеряемых проходов и переключатель, позволяющий прикрепить советник к графику без запуска сравнительного тестирования), а также объявляет один загрузчик, три вычислительных движка и массивы для хранения тестовых данных.
//+------------------------------------------------------------------+
//| Includes                                                         |
//+------------------------------------------------------------------+
#include <MathFidelityBenchmark\BenchmarkConfig.mqh>
#include <MathFidelityBenchmark\BenchmarkStats.mqh>
#include <MathFidelityBenchmark\WeightLoader.mqh>
#include <MathFidelityBenchmark\MathEngineNative.mqh>
#include <MathFidelityBenchmark\MathEngineAlglib.mqh>
#include <MathFidelityBenchmark\MathEngineOnnx.mqh>

//+------------------------------------------------------------------+
//| Inputs                                                           |
//+------------------------------------------------------------------+
input int  InpWarmupIters = BENCH_WARMUP_ITERS;
input int  InpTimedIters  = BENCH_TIMED_ITERS;
input bool InpRunOnInit   = true;

//+------------------------------------------------------------------+
//| Global objects and state                                         |
//+------------------------------------------------------------------+
CWeightLoader     g_loader;
CMathEngineNative g_native;
CMathEngineAlglib g_alglib;
CMathEngineOnnx   g_onnx;

double            g_test_inputs[][BENCH_INPUT_DIM];
double            g_test_refs[];
int               g_vector_count = 0;

bool              g_benchmark_done = false;
Функция OnInit() представляет собой всю программу. Она загружает входные данные, инициализирует три движка и однократно запускает тестирование, а при любом сбое возвращает INIT_FAILED, чтобы советник не оставался на графике в частично работоспособном состоянии. И OnDeinit(), и OnTick() намеренно оставлены пустыми. Однократный запуск в OnInit() означает, что никакие другие операции в терминале не конкурируют за ресурсы с циклами измерения времени.
//+------------------------------------------------------------------+
//| OnInit                                                           |
//+------------------------------------------------------------------+
int OnInit(void)
  {
   if(!InpRunOnInit)
      return(INIT_SUCCEEDED);

   if(!LoadAllInputs())
     {
      Print("[EA] failed to load weights/test vectors -- aborting");
      return(INIT_FAILED);
     }

   if(!g_native.Init(g_loader) || !g_alglib.Init(g_loader) || !g_onnx.Init(BENCH_ONNX_FILE))
     {
      Print("[EA] one or more engines failed to initialize -- aborting");
      return(INIT_FAILED);
     }

   RunBenchmark();
   g_benchmark_done = true;
   return(INIT_SUCCEEDED);
  }

//+------------------------------------------------------------------+
//| OnDeinit                                                         |
//+------------------------------------------------------------------+
void OnDeinit(const int reason)
  {
  }

//+------------------------------------------------------------------+
//| OnTick                                                           |
//+------------------------------------------------------------------+
void OnTick(void)
  {
   // no trading logic here, the whole run happens once in OnInit
  }
LoadAllInputs() — это часть, отвечающая за загрузку. Эта функция запрашивает веса у загрузчика, затем открывает файл тестовых векторов, сверяет заявленное число входных признаков с константой (третья проверка контракта признаков), считывает количество строк, изменяет размеры массивов и заполняет их. Каждая строка содержит восемь входных значений, за которыми следует эталонное выходное значение, поэтому цикл считывает по девять чисел из каждой строки.
//+------------------------------------------------------------------+
//| LoadAllInputs                                                    |
//| Loads the weights and test vectors, validates shapes and rows.   |
//+------------------------------------------------------------------+
bool LoadAllInputs(void)
  {
   if(!g_loader.Load(BENCH_WEIGHTS_FILE))
      return false;

   int fh = FileOpen(BENCH_VECTORS_FILE, FILE_READ | FILE_CSV | FILE_ANSI, ',');
   if(fh == INVALID_HANDLE)
     {
      PrintFormat("[EA] failed to open %s, error %d", BENCH_VECTORS_FILE, GetLastError());
      return false;
     }

   int header_dim = (int)FileReadNumber(fh);
   if(header_dim != BENCH_INPUT_DIM)
     {
      PrintFormat("[EA] test vector file declares dim=%d, expected %d", header_dim, BENCH_INPUT_DIM);
      FileClose(fh);
      return false;
     }

   int row_count = (int)FileReadNumber(fh);
   ArrayResize(g_test_inputs, row_count);
   ArrayResize(g_test_refs, row_count);

   for(int r = 0; r < row_count; r++)
     {
      for(int c = 0; c < BENCH_INPUT_DIM; c++)
         g_test_inputs[r][c] = FileReadNumber(fh);
      g_test_refs[r] = FileReadNumber(fh);
     }

   FileClose(fh);
   g_vector_count = row_count;
   PrintFormat("[EA] loaded %d test vectors", g_vector_count);
   return (g_vector_count > 0);
  }
Между загрузчиком и циклами измерения времени используется еще одна вспомогательная функция. g_test_inputs — двумерный массив, и MQL5 не позволяет передать отдельную его строку в параметр типа одномерного массива или напрямую в vector::Assign(). Функция CopyRow() копирует строку r в одномерный буфер. Перед каждым приведенным ниже вызовом движка используется эта функция.
//+------------------------------------------------------------------+
//| CopyRow                                                          |
//| Copies row r of g_test_inputs into a flat dynamic array. A       |
//| row of a 2D array can't be passed directly to a function         |
//| expecting a 1D array parameter, or into vector::Assign(), so     |
//| every engine call goes through this copy first.                  |
//+------------------------------------------------------------------+
void CopyRow(const int r, double &buf[])
  {
   ArrayResize(buf, BENCH_INPUT_DIM);
   for(int c = 0; c < BENCH_INPUT_DIM; c++)
      buf[c] = g_test_inputs[r][c];
  }
RunBenchmark() — это часть, отвечающая за измерение, и ее структура играет ключевую роль. Сначала выполняется прогрев: 200 проходов по 200 векторам с вызовом всех трех вычислительных движков без записи результатов. На этом этапе выполняется настройка при первом вызове и прогреваются кеши. Затем выполняются три отдельных цикла с измерением времени — по одному для каждого вычислительного движка. Непосредственно до и после каждого измеряемого вызова вызывается GetMicrosecondCount(). Длительность в микросекундах записывается в объект CLatencyStats соответствующей реализации, а возвращенное предсказание вместе с эталоном — в его объект CFidelityStats. На самом первом измеряемом проходе (t == 0) предсказание каждого вычислительного движка также сохраняется отдельно для каждого вектора. Эти данные используются для формирования описанного ниже файла погрешностей.
//+------------------------------------------------------------------+
//| RunBenchmark                                                     |
//| Warmup, then one timed pass per engine, then Journal summary     |
//| and results CSV.                                                 |
//+------------------------------------------------------------------+
void RunBenchmark(void)
  {
   CLatencyStats  lat_native, lat_alglib, lat_onnx;
   CFidelityStats fid_native, fid_alglib, fid_onnx;

   lat_native.Reset(InpTimedIters * g_vector_count);
   lat_alglib.Reset(InpTimedIters * g_vector_count);
   lat_onnx.Reset(InpTimedIters * g_vector_count);

   double first_native[], first_alglib[], first_onnx[];
   ArrayResize(first_native, g_vector_count);
   ArrayResize(first_alglib, g_vector_count);
   ArrayResize(first_onnx,   g_vector_count);

   // warmup, not timed: first-call setup and cold caches stay out of the numbers
   for(int w = 0; w < InpWarmupIters; w++)
      for(int r = 0; r < g_vector_count; r++)
        {
         double buf[];
         CopyRow(r, buf);
         vector<double> vin;
         vin.Assign(buf);
         g_native.Predict(vin);
         g_alglib.Predict(buf);
         g_onnx.Predict(buf);
        }

   // timed passes run one engine at a time so one engine's cache
   // footprint can't leak into the next engine's numbers
   for(int t = 0; t < InpTimedIters; t++)
      for(int r = 0; r < g_vector_count; r++)
        {
         double buf[];
         CopyRow(r, buf);
         vector<double> vin;
         vin.Assign(buf);

         ulong t0 = GetMicrosecondCount();
         double pred = g_native.Predict(vin);
         lat_native.Add(GetMicrosecondCount() - t0);
         fid_native.Add(pred, g_test_refs[r]);
         if(t == 0)
            first_native[r] = pred;
        }

   for(int t = 0; t < InpTimedIters; t++)
      for(int r = 0; r < g_vector_count; r++)
        {
         double buf[];
         CopyRow(r, buf);

         ulong t0 = GetMicrosecondCount();
         double pred = g_alglib.Predict(buf);
         lat_alglib.Add(GetMicrosecondCount() - t0);
         fid_alglib.Add(pred, g_test_refs[r]);
         if(t == 0)
            first_alglib[r] = pred;
        }

   for(int t = 0; t < InpTimedIters; t++)
      for(int r = 0; r < g_vector_count; r++)
        {
         double buf[];
         CopyRow(r, buf);

         ulong t0 = GetMicrosecondCount();
         double pred = g_onnx.Predict(buf);
         lat_onnx.Add(GetMicrosecondCount() - t0);
         fid_onnx.Add(pred, g_test_refs[r]);
         if(t == 0)
            first_onnx[r] = pred;
        }

   PrintSummary("Native MQL5", lat_native, fid_native);
   PrintSummary("ALGLIB",      lat_alglib, fid_alglib);
   PrintSummary("ONNX Runtime", lat_onnx,  fid_onnx);

   WriteResultsCsv(lat_native, fid_native, lat_alglib, fid_alglib, lat_onnx, fid_onnx);
   WriteErrorDetail(first_native, first_alglib, first_onnx);
  }
Буфер заново заполняется один раз для каждой строки внутри каждого цикла и повторно используется во всех вызовах, где он необходим. В циклах с измерением времени копирование выполняется до запуска таймера, поэтому замер охватывает только сам вызов Predict() движка: для штатного MQL5 и ALGLIB это только прямой проход, а для ONNX функция Predict() сначала преобразует входные данные из double в float. Это преобразование типов намеренно оставлено внутри измеряемого вызова, а не вынесено за его пределы вместе с подготовкой буферов для двух других вычислительных движков, поскольку при реальном использовании реализации на ONNX таких затрат не избежать: любой советник, передающий ей данные float64, несет их при каждом вызове, поэтому их исключение занизило бы фактические суммарные затраты времени при использовании ONNX Runtime.
Время выполнения движков намеренно измеряется последовательно, без чередования вызовов, однако такой подход вносит собственное систематическое искажение. Чередование может исказить результаты из-за взаимного влияния на кеш: одна реализация может вытеснить из кеша рабочий набор данных другой, что нарушает корректность сравнения. При последовательном запуске этот риск заменяется другим: вычислительный движок, запускаемый последним, оказывается в условиях, сложившихся к этому моменту из-за работы процессора, планировщика ОС и терминала, а тестовый стенд не контролирует влияние этих факторов. На этапе прогрева вызовы движков действительно чередуются до начала первого блока измерений, что частично защищает от одного конкретного эффекта порядка запуска, но не исключает постепенного изменения условий в ходе всего тестирования. Учитывайте, что ранжирование по времени выполнения зависит от конкретного запуска и конкретного компьютера. Показатели точности вычислений должны воспроизводиться с меньшими отклонениями.
Последние четыре функции выводят результаты. Функция PrintSummary() записывает показатели времени выполнения и точности вычислений для одного движка в журнал. Функция WriteResultsCsv() открывает файл результатов, записывает строку заголовка и по одной строке для каждого вычислительного движка, а функция WriteRow() форматирует статистику одного вычислительного движка для записи в эту строку. Позже индикатор считывает данные из этого CSV-файла, поэтому порядок столбцов в нем должен соответствовать порядку чтения в индикаторе. Функция WriteErrorDetail() записывает второй файл: по одной строке на тестовый вектор, с эталоном и исходным предсказанием каждой реализации в экспоненциальной записи с 17 значащими цифрами. Предсказания детерминированы, поэтому за 5 000 измеряемых проходов повторяются одни и те же 200 значений, а для построения гистограммы погрешностей достаточно одного прохода.
//+------------------------------------------------------------------+
//| PrintSummary                                                     |
//+------------------------------------------------------------------+
void PrintSummary(const string name, CLatencyStats &lat, CFidelityStats &fid)
  {
   PrintFormat("--- %s ---", name);
   PrintFormat("  latency (us)  mean=%.2f  median=%.2f  p95=%.2f  p99=%.2f  n=%d",
               lat.Mean(), lat.Median(), lat.Percentile(0.95), lat.Percentile(0.99), lat.Count());
   PrintFormat("  fidelity      abs_mean=%.8f  abs_max=%.8f  rel_mean=%.6f%%  rel_max=%.6f%%",
               fid.AbsMean(), fid.AbsMax(), fid.RelMean() * 100.0, fid.RelMax() * 100.0);
  }

//+------------------------------------------------------------------+
//| WriteResultsCsv                                                  |
//+------------------------------------------------------------------+
void WriteResultsCsv(CLatencyStats &ln, CFidelityStats &fn,
                      CLatencyStats &la, CFidelityStats &fa,
                      CLatencyStats &lo, CFidelityStats &fo)
  {
   int fh = FileOpen(BENCH_RESULTS_FILE, FILE_WRITE | FILE_CSV | FILE_ANSI, ',');
   if(fh == INVALID_HANDLE)
     {
      PrintFormat("[EA] failed to open results file for writing, error %d", GetLastError());
      return;
     }

   FileWrite(fh, "engine", "mean_us", "median_us", "p95_us", "p99_us",
             "abs_err_mean", "abs_err_max", "rel_err_mean_pct");

   WriteRow(fh, "Native", ln, fn);
   WriteRow(fh, "ALGLIB", la, fa);
   WriteRow(fh, "ONNX",   lo, fo);

   FileClose(fh);
   Print("[EA] results written to ", BENCH_RESULTS_FILE);
  }

//+------------------------------------------------------------------+
//| WriteRow                                                         |
//+------------------------------------------------------------------+
void WriteRow(int fh, const string name, CLatencyStats &lat, CFidelityStats &fid)
  {
   FileWrite(fh, name,
             DoubleToString(lat.Mean(), 2),
             DoubleToString(lat.Median(), 2),
             DoubleToString(lat.Percentile(0.95), 2),
             DoubleToString(lat.Percentile(0.99), 2),
             DoubleToString(fid.AbsMean(), 8),
             DoubleToString(fid.AbsMax(), 8),
             DoubleToString(fid.RelMean() * 100.0, 6));
  }

//+------------------------------------------------------------------+
//| WriteErrorDetail                                                 |
//| One row per test vector: the reference and each engine's         |
//| prediction from the first timed pass. Predictions are            |
//| deterministic, so later passes repeat the same values.           |
//+------------------------------------------------------------------+
void WriteErrorDetail(const double &pn[], const double &pa[], const double &po[])
  {
   int fh = FileOpen(BENCH_ERRORS_FILE, FILE_WRITE | FILE_CSV | FILE_ANSI, ',');
   if(fh == INVALID_HANDLE)
     {
      PrintFormat("[EA] failed to open error file for writing, error %d", GetLastError());
      return;
     }

   FileWrite(fh, "vector", "reference", "native", "alglib", "onnx");
   for(int r = 0; r < g_vector_count; r++)
      FileWrite(fh, r,
                StringFormat("%.17e", g_test_refs[r]),
                StringFormat("%.17e", pn[r]),
                StringFormat("%.17e", pa[r]),
                StringFormat("%.17e", po[r]));

   FileClose(fh);
   Print("[EA] per-vector predictions written to ", BENCH_ERRORS_FILE);
  }
После запуска в журнале отображается по одному блоку для каждого вычислительного движка: строка заголовка, строка показателей времени выполнения со средним значением, медианой, p95, p99 и количеством замеров, а также строка показателей точности вычислений со средним и максимальным значениями как абсолютной, так и относительной погрешности. Количество замеров — самый быстрый способ проверить, все ли в порядке. При входных параметрах по умолчанию для каждой реализации должно отображаться число 1000000. Если это не так, значит, неверно заданы границы циклов или количество векторов. CSV-файл с результатами содержит те же показатели, кроме максимальной относительной погрешности, но с меньшим количеством знаков после запятой: восемь для абсолютной погрешности и шесть для относительной погрешности в процентах, тогда как в журнале значения выводятся с полной двойной точностью. Такое грубое округление существенно при выводе результатов Native и ALGLIB: их абсолютная погрешность составляет около 1e-16 — настолько мало, что DoubleToString(fid.AbsMean(), 8) выводит ее как 0.00000000.
CSV-файл и монитор подходят для сравнения вычислительных движков между собой при погрешностях порядка тех, что дает ONNX Runtime, но точное значение для Native или ALGLIB следует смотреть в журнале, а не в CSV-файле. Под строкой заголовка со столбцами engine, mean_us, median_us, p95_us, p99_us, abs_err_mean, abs_err_max и rel_err_mean_pct располагается по одной строке на каждый движок. Благодаря такому формату монитор может отображать эти данные без какого-либо разбора. Второй файл, error_detail.csv, содержит предсказания для каждого вектора с сохранением всех 17 значащих цифр. По этим данным строится гистограмма погрешностей.
Результаты сравнительного тестирования: точность вычислений
Советник выполняет 1 000 000 предсказаний для каждого вычислительного движка (5 000 измеряемых проходов по 200 тестовым векторам), но все используемые здесь вычислительные движки детерминированы, поэтому речь идет о 200 уникальных парах "вход — выход", вычисляемых по 5 000 раз, а не о миллионе независимых наблюдений. Повторения нужны для измерения времени выполнения: чтобы получить устойчивую оценку процентиля, требуется достаточно вызовов. Приведенные ниже показатели точности вычислений рассчитаны по 200 уникальным векторам и в точности воспроизводятся при каждом запуске:
| Вычислительный движок | Средняя абсолютная погрешность | Максимальная абсолютная погрешность | Средняя относительная погрешность |
|---|---|---|---|
| Штатный MQL5 | 1,47×10⁻¹⁶ | 8,88×10⁻¹⁶ | <1e-13% (ниже точности отображения) |
| ALGLIB | 1,47×10⁻¹⁶ | 8,88×10⁻¹⁶ | <1e-13% (ниже точности отображения) |
| ONNX Runtime | 7,28×10⁻⁸ | 3,69×10⁻⁷ | 0,0000337% |
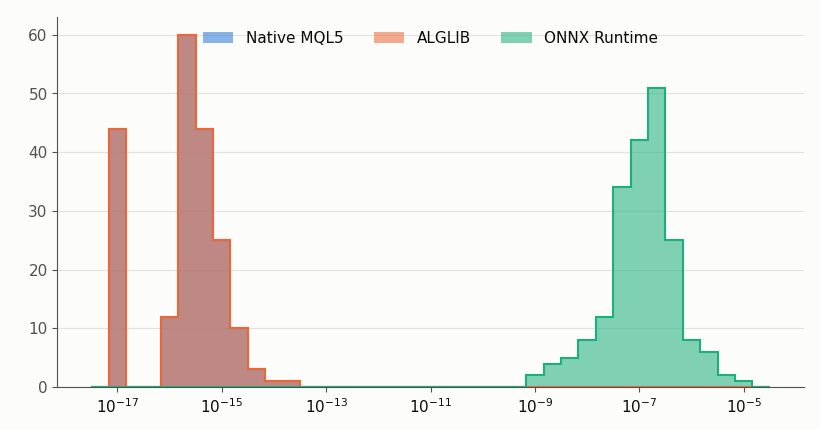
Рис. 2. Относительная погрешность для 200 тестовых векторов по сравнению с эталоном float64 в логарифмическом масштабе. Значения погрешности штатного MQL5 и ALGLIB сосредоточены вблизи машинного эпсилона; значения для ONNX Runtime при вычислениях с тензорами float32 расположены на много порядков правее. Векторы с погрешностью, равной нулю, отображаются на левом крае.
Результаты штатного MQL5 и ALGLIB побитно идентичны для всех 200 тестовых векторов — они не просто близки, а в точности равны, вплоть до последней цифры при выводе с 17 значащими цифрами. Это следствие исправления, описанного ниже в разделе о подводных камнях: когда оба вычислительных движка выполняют один и тот же цикл накопления суммы в одинаковом порядке, не остается ни одной операции, которая могла бы привести к расхождению результатов. Крошечное остаточное отклонение от эталона Python (в среднем 1,47×10⁻¹⁶, то есть меньше одного машинного эпсилона) обусловлено порядком суммирования в float64, а не программной ошибкой: эталонное суммирование в NumPy и цикл MQL5 не обязаны обрабатывать слагаемые в одинаковом порядке, чтобы оба результата были корректными. У ONNX Runtime относительная погрешность примерно на восемь порядков выше, а абсолютная — на шесть порядков. Именно такого масштаба ухудшения и следует ожидать при накоплении погрешностей в трех последовательных слоях с учетом того, что мантисса float32 обеспечивает примерно семь значащих десятичных цифр.
Это основной фактор, на который позволяет указать данный тестовый стенд, но не единственный: собственный порядок суммирования в ядре Gemm и внутренние оптимизации ONNX Runtime могут по отдельности слегка влиять на результат, а данное сравнительное тестирование не позволяет отделить вклад каждого из них от влияния самого снижения точности. Зато оно наглядно показывает совокупный эффект вычисления этого графа в ONNX Runtime с используемой по умолчанию точностью float32 по сравнению с вычислениями с теми же весами в float64 — именно это сравнение важно при решении о том, стоит ли внедрять модель ONNX в советник, работающий в реальной торговле.
Значимость этого расхождения зависит от того, как результаты используются на последующих этапах обработки. Если сигнал формируется однократным сравнением с порогом, это расхождение, скорее всего, несущественно. Для рекурсивного фильтра, который использует собственный выход в качестве следующего входа, одна и та же относительная погрешность вносится повторно на каждом баре, а отклонение от эталона float64 растет, а не остается постоянным — именно в этом заключается риск накопления погрешности, описанный во введении.
Практический способ оценить это расхождение — сравнить погрешность вычислительного движка с наименьшей разницей, которая меняет ваше решение. Если выходное значение сравнивается с порогом, который срабатывает только при изменении оценки на 0,05, то абсолютная погрешность порядка 1e-4 приведет к изменению решения для ничтожно малой доли входных данных. Если же выходное значение используется при сравнении двух почти равных оценок или вычитается из большого числа, та же погрешность может определить исход. Поэтому запустите тестовый стенд со своей моделью, обратите внимание на максимальную абсолютную погрешность, а не только на среднюю, и оцените, как часто эталонное выходное значение оказывается на расстоянии не больше этой величины от границы принятия решения.
Результаты сравнительного тестирования: время выполнения
По времени выполнения картина иная, а распределение мест не такое, какое можно было бы предсказать, исходя лишь из принципа "больше абстракции — больше накладных расходов":
| Вычислительный движок | Среднее значение (мкс) | Медиана (мкс) | p95 (мкс) | p99 (мкс) |
|---|---|---|---|---|
| Штатный MQL5 | 0,57 | 1,00 | 1,00 | 1,00 |
| ALGLIB | 13,02 | 11,00 | 24,00 | 30,00 |
| ONNX Runtime | 29,25 | 31,00 | 48,00 | 59,00 |
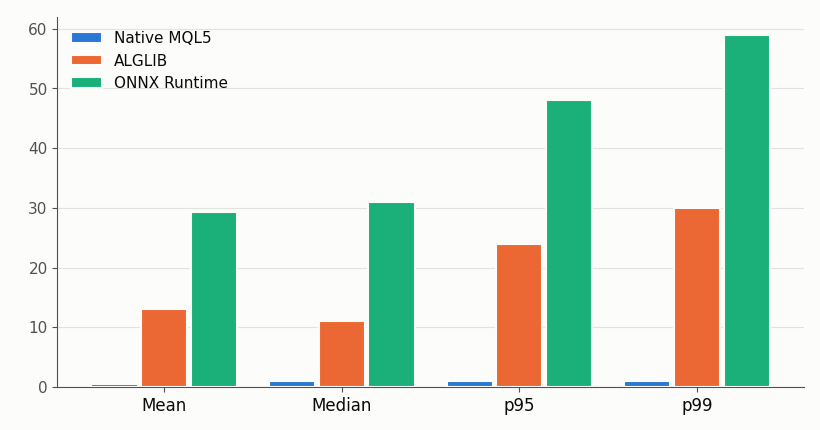
Рис. 3. Время выполнения в микросекундах на один вызов (среднее значение, медиана, p95 и p99) для каждого вычислительного движка по результатам 1 000 000 предсказаний с измерением времени в одном репрезентативном запуске. MQL5 значительно быстрее на всех процентилях; ALGLIB и ONNX Runtime требуют существенно больше времени, причем при тестировании от запуска к запуску менялось то, какой из этих двух движков медленнее (см. примечание под таблицей).
Штатный MQL5 быстрее на всех процентилях, причем со значительным отрывом: среднее время выполнения составляет 0,57 мкс против 13,02 мкс у ALGLIB и 29,25 мкс у ONNX Runtime. То, что среднее значение 0,57 мкс ниже медианы 1,00 мкс, — прямое проявление в данных эффекта разрешения таймера, описанного в примечании ниже: при измерении в целых микросекундах время значительной доли вызовов реализации на штатном MQL5 округляется вниз до нуля, поэтому среднее оказывается ниже медианы, в отличие от более типичного соотношения "среднее ≥ медиана". И ALGLIB, и ONNX Runtime дают ощутимые накладные расходы в несколько микросекунд по сравнению с реализацией на MQL5, что соответствует ожидаемому принципу "больше абстракции — больше накладных расходов". Нестабильно лишь то, какой из этих двух движков требует больше времени.
В этом запуске ONNX Runtime оказался самым медленным по полному времени выполнения. В предыдущих тестовых запусках на этапе разработки, на том же компьютере и с той же сборкой, медленнее был ALGLIB — с сопоставимым отрывом. Штатный MQL5 сохранял преимущество во всех этих неформальных запусках, но я не фиксировал их результаты в виде формальной серии измерений, поэтому воспринимайте именно это утверждение как неоднократное наблюдение, а не статистически установленный результат: в таблице выше приведен единственный запуск, подкрепленный числовыми данными.
Здесь конкурируют два разных вида затрат времени, и ни один из них не преобладает достаточно стабильно, чтобы можно было назвать победителя среди этих двух движков. В ALGLIB каждое чтение W[i][o] сопряжено с накладными расходами на вызов оператора контейнера CMatrixDouble вместо прямого доступа к массиву. На один прямой проход приходится 8 × 16 = 128 чтений в первом слое, 16 × 8 = 128 — во втором и 8 × 1 = 8 — в третьем: всего 264 чтения, причем их количество различается по слоям. Это число нужно умножить на 200 векторов и 5 200 проходов (прогрев и измеряемые проходы). Получаются фиксированные затраты, которые не должны сильно меняться от запуска к запуску.
У ONNX Runtime накладные расходы иного рода: при каждом вызове выполняется преобразование в его тензорный формат и обратно через механизм диспетчеризации среды выполнения, который тестовый стенд не контролирует и внутреннее устройство которого ему недоступно. Похоже, что накладные расходы второго типа сильнее зависят от того, какие еще задачи в этот момент выполняют терминал и ОС. Это правдоподобное объяснение того, почему именно они менялись от запуска к запуску, тогда как накладные расходы ALGLIB оставались примерно в одном диапазоне. Я не могу доказать это с помощью данного тестового стенда: он не разбивает вызов на этапы. Поэтому считайте это гипотезой, а не установленным результатом. При таком размере сети ни граф, ни контейнер, скорее всего, не являются настоящим узким местом: вычисления для MLP с 289 параметрами в обоих случаях требуют совсем немного ресурсов.
Числа достоверно показывают следующее: утверждение "больше абстракций — больше затрат" не позволяет надежно предсказать, какая именно абстракция обойдется дороже и насколько. Поэтому измеряйте производительность выбранного вычислительного движка на своей машине, а не выводите рейтинг из общих теоретических соображений. Для такой небольшой задачи штатный MQL5 явно выигрывает по времени выполнения независимо от того, какой из двух других вариантов вы бы выбрали.
Пограничные случаи и возможные проблемы
Каждая из нескольких тонкостей реализации может привести к результату, который выглядит правдоподобно, но содержит незаметную на первый взгляд ошибку. Поиск таких ошибок впоследствии обходится дорого.
Ориентация матрицы весов Gemm. Оператор Gemm в ONNX вычисляет input @ W + b при transB=0 (значение по умолчанию). При этом W должна храниться в форме (in × out) — с той же ориентацией, что и в CSV, вычислительном движке на штатном MQL5 и циклах ALGLIB. Ловушка: веса, перенесенные из фреймворка, в котором матрицы весов линейных слоев хранятся в форме out x in, и переданные в узел Gemm с настройками по умолчанию, дают граф с согласованными формами тензоров, который выполняется без ошибок, но возвращает неверное число. Ни MQL5, ни ONNX Runtime не могут это обнаружить, поскольку формы тензоров согласованы. Либо транспонируйте матрицу весов перед экспортом, либо задайте для узла transB=1. При каждом переносе весов между фреймворками проверяйте результат на известной паре "вход — выход".
Точность CSV. Файлы с весами и тестовыми векторами сохраняются с точностью до 17 значащих цифр. Если сохранять меньше цифр (например, десять знаков после запятой), округление в файле задаст нижний предел погрешности около 1e-10, который унаследуют все вычислительные движки. Тогда строки таблицы точности вычислений для штатного MQL5 и ALGLIB будут отражать точность формата экспорта, а не самих вычислительных движков.
Исключение прогрева из измерений. Первые вызовы любого движка, особенно ONNX Runtime, выполняются медленнее, чем вызовы в установившемся режиме, из-за отложенной внутренней инициализации. Исключение фиксированного периода прогрева (здесь — 200 проходов) позволяет получить показатели времени выполнения, характерные для длительной нагрузки. Если пропустить этот шаг, ONNX Runtime будет выглядеть хуже, чем на самом деле.
Относительная погрешность вблизи нуля. Относительная погрешность не определена, когда эталон в точности равен нулю, и нестабильна вблизи нуля. CFidelityStats::Add() ограничивает знаменатель снизу значением 1e-8 вместо деления непосредственно на эталон, чтобы несколько близких к нулю выходных значений не определяли среднее.
Запись через прокси-объект строки. В первоначальном варианте функция LoadMatrix() реализации ALGLIB использовала dst[r].Set(c, value) — получала строку по индексу, а затем задавала значение элемента в нужном столбце этой строки. Этот код компилируется, но у класса CMatrixDouble оператор [] возвращает временный объект строки, а MQL5 не позволяет передавать временный объект по неконстантной ссылке, поэтому запись так и не доходит до матрицы (дословное сообщение компилятора: "constant variable cannot be passed as reference"). Чтение через тот же индексатор W[i][o] не вызывает проблем, поскольку при чтении не нужна ссылка на элемент внутри контейнера — она требуется только при записи. Решение — вызывать метод Set(row, col, value) непосредственно у самой матрицы, как в приведенном выше коде, а не у предварительно извлеченной из нее строки.
Зарезервированные имена параметров. Изначально во всех трех методах Predict() параметр назывался input. Такое объявление компилируется, но input — зарезервированное ключевое слово MQL5, используемое в объявлениях параметров вида input int, поэтому любое дальнейшее использование этого параметра в коде — обращение input[i] или передача в другую функцию — приводило к ошибке синтаксического анализа. Список ошибок MetaEditor указывал на места использования, а не на объявление, из-за чего сначала было легко упустить из виду истинную причину. Исправление заключалось в переименовании параметра input в in_vec во всех трех движках.
Изменение формы матрицы при присваивании. Изначально реализация на MQL5 загружала каждую матрицу весов вызовом Init(rows, cols) с последующим вызовом Assign(flat_array). Метод Assign() не сохраняет форму, заданную методом Init(), а без предупреждения сворачивает матрицу в одну строку, содержащую все rows*cols значений, поэтому каждое обращение W[i][o] к строке с индексом больше 0 приводит к чтению за пределами допустимого диапазона. Это ошибка того же типа, что и описанная выше проблема с прокси-объектом строки в ALGLIB: вспомогательный метод контейнера, который, казалось бы, сохраняет структуру, на самом деле ее не сохраняет. Решение — вспомогательная функция LoadMatrix(), которая заполняет матрицу поэлементно с помощью dst[r][c] = flat[r * cols + c], не полагаясь на Assign(). Тот же подход уже используется в реализации ALGLIB, только здесь вместо Set() применяется штатная индексация MQL5. Для смещений по-прежнему используется Assign(), поскольку у вектора нет двумерной формы, которую можно было бы потерять.
Разрешение таймера. GetMicrosecondCount() возвращает целое число микросекунд, поэтому время вызова длительностью менее двух микросекунд измеряется с большим шагом, а затраты времени на сам вызов таймера входят в каждый замер для всех трех вычислительных движков. Интерпретируйте процентили для штатного MQL5 и ALGLIB скорее как показатели относительного ранжирования, а не как точные значения, и сравнивайте движки друг с другом, а не с абсолютным значением, полученным на другом компьютере.
Последовательное измерение времени работы вычислительных движков. Полный измеряемый проход для каждого движка завершается до запуска следующего движка. При чередовании вызовов в одном цикле характер обращений к памяти одного вычислительного движка может изменить состояние кеша, с которым будет работать следующий движок, и тем самым исказить сравнение времени выполнения по причинам, не связанным с вычислительными затратами.
Запуск тестового стенда и интерпретация результатов: FidelityMonitor.mq5
Для запуска скопируйте три файла в форматах CSV и ONNX, созданные скриптом Python, в папку MQL5\Files\MathFidelityBenchmark, скомпилируйте советник и перетащите его на любой график. При сравнительном тестировании ценовые данные не используются, поэтому торговый инструмент и таймфрейм не имеют значения. Я бы запускал советник на графике, а не в тестере стратегий: тестер работает с собственной изолированной копией папки Files, поэтому файлы данных пришлось бы объявлять для него отдельно, а запуск на графике позволяет измерять время с учетом особенностей работы таймера самого терминала.
| Настройка | Значение |
|---|---|
| Торговый инструмент / таймфрейм | Любые (тестовый стенд использует синтетические векторы, а не ценовые данные) |
| InpWarmupIters | 200 |
| InpTimedIters | 5000 |
| Тестовые векторы | 200 (сгенерированы скриптом train_export_model.py с фиксированным начальным значением генератора случайных чисел) |
| Общее количество предсказаний для каждого вычислительного движка | 1 000 000 |
Показатели точности вычислений должны воспроизводиться на других компьютерах с близкими значениями, поскольку они зависят от арифметики, а не от тактовой частоты, хотя векторизованные инструкции могут повлиять на последние разряды. Время выполнения вам предстоит измерить самостоятельно: оно будет меняться в зависимости от процессора, тактовой частоты и сборки терминала, и именно поэтому тестовый стенд реализован в таком виде.
Индикатор FidelityMonitor служит исключительно для отображения данных и сам никогда не запускает сравнительное тестирование. У индикатора нет ни буферов, ни графических построений. OnInit() запускает таймер с заданным интервалом обновления и однократно отрисовывает панель, OnTimer() перерисовывает ее, а OnDeinit() останавливает таймер и очищает комментарий. OnCalculate() присутствует лишь потому, что этого требует терминал, и только возвращает количество баров.
//+------------------------------------------------------------------+
//| Includes                                                         |
//+------------------------------------------------------------------+
#include <MathFidelityBenchmark\BenchmarkConfig.mqh>

//+------------------------------------------------------------------+
//| Inputs and globals                                               |
//+------------------------------------------------------------------+
input int InpRefreshSeconds = 5;

//+------------------------------------------------------------------+
//| OnInit                                                           |
//+------------------------------------------------------------------+
int OnInit(void)
  {
   EventSetTimer(InpRefreshSeconds);
   RefreshPanel();
   return(INIT_SUCCEEDED);
  }

//+------------------------------------------------------------------+
//| OnDeinit                                                         |
//+------------------------------------------------------------------+
void OnDeinit(const int reason)
  {
   EventKillTimer();
   Comment("");
  }

//+------------------------------------------------------------------+
//| OnTimer                                                          |
//+------------------------------------------------------------------+
void OnTimer(void)
  {
   RefreshPanel();
  }

//+------------------------------------------------------------------+
//| OnCalculate                                                      |
//+------------------------------------------------------------------+
int OnCalculate(const int rates_total, const int prev_calculated, const int begin,
                 const double &price[])
  {
   return(rates_total);
  }
Вся основная работа выполняется в функции RefreshPanel(). Она открывает CSV-файл с результатами и, если файл еще не существует, выводит причину в журнал и отображает сообщение с просьбой сначала запустить советник. В противном случае она считывает восемь полей заголовка, затем на каждой итерации цикла считывает данные одного вычислительного движка (по восемь полей, в том порядке, в котором их записал советник) и добавляет для него отформатированную строку со средним временем выполнения, 95-м процентилем времени выполнения и средней относительной погрешностью. DrawPanel() передает этот текст напрямую в Comment(), то есть во встроенную текстовую область терминала, которая всегда отображается поверх графика, вместо создания графического объекта-метки.
Графический объект, такой как OBJ_LABEL, не воспринимает \n как перевод строки: он выводит весь текст в одну строку и обрезает его у края графика, поэтому плохо подходит для многострочного текста. Comment() предназначена именно для этого: она корректно отображает многострочный текст и автоматически использует цвет переднего плана графика при любой цветовой схеме, поэтому для этой панели не нужны другие средства наложения текста.
//+------------------------------------------------------------------+
//| RefreshPanel                                                     |
//| Reads benchmark_results.csv written by the EA and rebuilds the   |
//| panel. Viewer only, it never runs the benchmark itself.          |
//+------------------------------------------------------------------+
void RefreshPanel(void)
  {
   int fh = FileOpen(BENCH_RESULTS_FILE, FILE_READ | FILE_CSV | FILE_ANSI, ',');
   if(fh == INVALID_HANDLE)
     {
      PrintFormat("[FidelityMonitor] no results file yet at %s (error %d) -- run the EA first",
                  BENCH_RESULTS_FILE, GetLastError());
      DrawPanel("MathFidelityBenchmark: no results file yet -- run the EA first.");
      return;
     }

   string text = "Numerical Fidelity & Latency Benchmark\n";
   FileReadString(fh); FileReadString(fh); FileReadString(fh); FileReadString(fh);
   FileReadString(fh); FileReadString(fh); FileReadString(fh); FileReadString(fh); // header row

   int rows = 0;
   while(!FileIsEnding(fh))
     {
      string engine   = FileReadString(fh);
      if(engine == "")
         break;
      string mean_us  = FileReadString(fh);
      string median_us= FileReadString(fh);
      string p95_us   = FileReadString(fh);
      string p99_us   = FileReadString(fh);
      string abs_mean = FileReadString(fh);
      string abs_max  = FileReadString(fh);
      string rel_mean = FileReadString(fh);

      text += StringFormat("%-8s  lat(us) mean=%s p95=%s  |  rel_err=%s%%\n",
                            engine, mean_us, p95_us, rel_mean);
      rows++;
     }
   FileClose(fh);

   PrintFormat("[FidelityMonitor] panel refreshed, %d engine rows read", rows);
   DrawPanel(text);
  }

//+------------------------------------------------------------------+
//| DrawPanel                                                        |
//| Comment() renders multi-line text correctly and already follows |
//| the chart's own foreground color across every scheme, so it's   |
//| the only overlay this panel needs.                              |
//+------------------------------------------------------------------+
void DrawPanel(const string text)
  {
   Comment(text);
   ChartRedraw(0);
  }
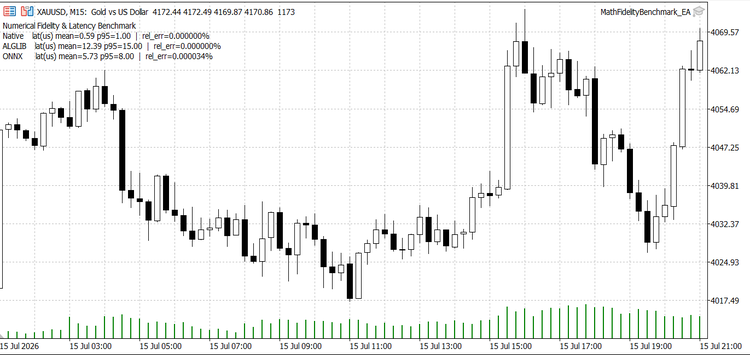
Рис. 4. Панель индикатора FidelityMonitor, отображающая время выполнения и относительную погрешность для каждого вычислительного движка по данным, считываемым в реальном времени из CSV-файла результатов после прохода тестирования.
Адаптация тестового стенда к вашей модели
Тестовый стенд достаточно компактен, чтобы перенастроить его на другую нейронную сеть всего за четыре шага. Во-первых, согласованно измените константы размерностей в файле BenchmarkConfig.mqh и размеры слоев в скрипте на Python, поскольку архитектура задается именно в этих двух местах. Во-вторых, экспортируйте свои веса в том же формате с тегами, сохранив ориентацию (вход × выход). Если в вашей сети больше или меньше слоев, добавьте соответствующие разделы в CWeightLoader::Load(), еще один вызов ForwardLayer() в вычислительном движке ALGLIB и еще одну пару строк в реализации на MQL5. Реализация ONNX не требует изменений в коде, поскольку структура заложена в самом графе.
В-третьих, заменяйте функции активации с осторожностью. ReLU обнуляет отрицательные значения и не усиливает погрешность округления, однако tanh и сигмоида используют экспоненты, которые в разных средах выполнения реализованы по-разному, поэтому расхождение между движками может оказаться больше, чем измеренное здесь. В-четвертых, заново сгенерируйте тестовые векторы из собственного распределения входных данных, а не из нормального распределения. Точность вычислений зависит от диапазона значений, проходящих через сеть, а сравнительное тестирование на входных данных, которые никогда не встречаются при реальной эксплуатации, мало что говорит о работе в реальных условиях.
Заключение
Основной результат можно разделить на две части. Что касается точности вычислений, результаты штатного MQL5 и ALGLIB совпадают с эталоном float64 в пределах машинного эпсилона и побитно идентичны друг другу. Использование тензоров float32 в ONNX Runtime увеличивает относительную погрешность примерно на восемь порядков. Такое соотношение сохранялось при каждом запуске: оно определяется арифметикой, а не компьютером. По времени выполнения штатный MQL5 также лидирует с большим отрывом при каждом запуске, однако в ходе тестирования более медленным из двух других вычислительных движков оказывался то ALGLIB, то ONNX Runtime, причем иногда разница в ту или иную сторону была весьма значительной. Точность вычислений определяется математикой и воспроизводится. Время выполнения зависит от компьютера и не воспроизводится, поэтому доверять этим двум результатам в одинаковой степени не следует.
Это не означает, что ONNX Runtime работает некорректно или что ALGLIB хуже других решений. Это позволяет количественно оценить компромиссы, хотя дополнительные затраты времени выполнения меняются от запуска к запуску. Если ваша модель невелика и вы стремитесь минимизировать время выполнения, то по результатам этого сравнительного тестирования лучше подходит MQL5. Не стоит выбирать ALGLIB в надежде выиграть по времени выполнения у ONNX Runtime или наоборот: на этом тестовом стенде даже на одном компьютере не удалось получить устойчивый порядок этих двух решений по скорости. Выбирайте ALGLIB, когда вам нужна именно его более обширная библиотека алгоритмов, а ONNX Runtime — когда ваша модель относится к тому типу, на который он рассчитан: к более крупным и сложным архитектурам, для которых писать прямой проход вручную нецелесообразно. В таком случае потеря точности вычислений и накладные расходы на вызов — разумный компромисс, если вы проверили, что возникающая погрешность достаточно мала с точки зрения решения, принимаемого на основе выхода модели.
У этого тестирования есть ограничения, которые сужают круг выводов из приведенных выше чисел. Оно охватывает одну сеть с 289 параметрами и функциями активации ReLU, один компьютер, ONNX Runtime с флагами по умолчанию и один набор замеров времени выполнения (точность вычислений воспроизводится в точности, а время выполнения меняется от запуска к запуску). 200 тестовых векторов получены из нормального распределения без попытки охватить реальные диапазоны значений признаков, выбросы или входные значения вблизи точки насыщения функции активации, поэтому показатели точности вычислений характеризуют именно это распределение входных данных и могут не характеризовать ваше. Инференс за один вызов для столь небольшой модели также близок к наихудшему случаю по доле накладных расходов ONNX Runtime: модель с большим числом параметров на вызов или пакетная обработка за один вызов, скорее всего, сократили бы разрыв во времени выполнения, а не увеличили его. Более крупные модели, другие функции активации, иные распределения входных данных и настройки выполнения могут изменить порядок вычислительных движков по результатам сравнения. Именно поэтому стоит запускать тестовый стенд на собственной модели и собственных данных, а не использовать приведенные здесь числа.
В другие проекты я перенес бы сам тестовый стенд. Всякий раз, когда вы заменяете один способ вычислений другим — переходите на новую библиотеку, новый формат модели или проводите рефакторинг собственного математического кода, — запускайте старую и новую реализации бок о бок и сравнивайте их результаты с известным эталоном, прежде чем использовать новую реализацию в рабочей среде. Весь проект состоит из девяти небольших файлов и превращает предположение "Думаю, они эквивалентны" в число, которое можно проверить.
| Файл | Тип | Описание |
|---|---|---|
| MathFidelityBenchmark_EA.mq5 | Советник | Загружает веса и тестовые векторы, выполняет прогрев и измеряемые проходы на всех трех вычислительных движках, записывает сводку в журнал, а результаты — в файлы benchmark_results.csv и error_detail.csv. |
| FidelityMonitor.mq5 | Индикатор | Панель на графике, которая по таймеру считывает данные из файла benchmark_results.csv и отображает время выполнения и относительную погрешность для каждого вычислительного движка. |
| BenchmarkConfig.mqh | Подключаемый файл | Размерности сети, имена файлов и количества итераций, общие для всех файлов MQL5. |
| BenchmarkStats.mqh | Подключаемый файл | CLatencyStats (исходные замеры, среднее значение, медиана, интерполированные процентили) и CFidelityStats (абсолютная и относительная погрешность по отношению к эталону). |
| WeightLoader.mqh | Подключаемый файл | Считывает CSV-файл весов с помеченными разделами и проверяет размерности каждого раздела до инициализации любого вычислительного движка. |
| MathEngineNative.mqh | Подключаемый файл | Прямой проход с использованием встроенных типов matrix и vector, float64 на всех этапах и явными циклами вычислений для каждого слоя. |
| MathEngineAlglib.mqh | Подключаемый файл | Прямой проход с использованием CMatrixDouble и явных циклов по индексам, float64. |
| MathEngineOnnx.mqh | Подключаемый файл | Прямой проход в ONNX Runtime через OnnxRun(), тензоры float32. |
| train_export_model.py | Скрипт на Python | Обучает общий многослойный перцептрон (MLP) в NumPy с точностью float64 и экспортирует файлы model_weights.csv, test_vectors.csv и model.onnx. |
Перевод с английского произведен MetaQuotes Ltd.
Оригинальная статья: https://www.mql5.com/en/articles/23988
Предупреждение: все права на данные материалы принадлежат MetaQuotes Ltd. Полная или частичная перепечатка запрещена.
Данная статья написана пользователем сайта и отражает его личную точку зрения. Компания MetaQuotes Ltd не несет ответственности за достоверность представленной информации, а также за возможные последствия использования описанных решений, стратегий или рекомендаций.


Для советника важнее не сама погрешность, а где она ложится рядом с порогом. Модель из PyTorch по умолчанию экспортируется в float32, у него относительная точность около 1,2e-7. Если сигнал сравнивается с порогом 0.5, то выход 0.49999997 в одном движке и 0.50000003 в другом дают разные сделки на том же баре. Я бы добавил в стенд счетчик таких расхождений по знаку относительно порога, а не только максимум отклонения: на истории сразу видно, сколько входов реально меняется.