

Архитектура машинного обучения в MetaTrader 5 (Часть 22): Аудит критерия отбора — оценка переобучения при поиске гиперпараметров
 13
 0

Содержание
- Введение
- Что исправила вложенная кросс-валидация, а что оставила без изменений
- Смещение и дисперсия при отборе моделей
- Как сделать дисперсию критерия измеримой
- Аудит критерия (criterion_variance_audit)
- Кривая оптимизма при отборе
- Каждый настраиваемый параметр — это масштаб длины ARD
- Три способа решения проблемы и ошибка в том, который мы уже применяли
- Испытания гиперпараметров — это испытания в бэктестах
- Медианный протокол и случаи, когда он действительно допустим
- Проведение аудита на собственных барах
- Заключение
- Прикрепленные файлы
- Список литературы
Введение
В части 16 мы перенесли поиск гиперпараметров внутрь каждого внешнего фолда и стали представлять полученную оценку вложенной кросс-валидации вместо наилучшего значения, найденного в ходе самого поиска. Это позволило устранить конкретную проблему: теперь публикуемое нами число оценивает качество работы конвейера на данных, которые он никогда не использовал, а не представляет собой максимум величины, на максимизацию которой поиск затратил сотни испытаний.
Это закрыло одну дыру, но оставило открытой другую, более крупную. Вложенная кросс-валидация позволяет достоверно отразить ущерб в итоговой оценке; она не уменьшает этот ущерб и — что важно — не выделяет ту его часть, которая обусловлена именно переобучением при отборе моделей. Вложенная кросс-валидация оценивает весь конвейер от начала до конца. Если полученная оценка низкая, причиной могут быть переобучение при отборе моделей, смена режима между фолдами, шум в метках, нестабильный набор признаков или любое сочетание этих факторов. Чтобы отнести ухудшение качества исключительно на счет переобучения при отборе моделей, необходим контрфактуальный эталон: «оракул», знающий лучшие гиперпараметры, конвейер с фиксированными гиперпараметрами, оцениваемый на тех же фолдах, или независимое повторное формирование выборок для процедуры отбора. В этой статье разрабатываются диагностические инструменты, однако читателю следует с самого начала понимать, что описанный ниже коэффициент разрешения измеряет локальную способность критерия различать кандидатов, а не совокупный ущерб, связанный с работой конвейера. Это связанные между собой, но различные величины. При таком поиске гиперпараметры по-прежнему настраиваются на основе конечной выборки, по-прежнему выявляются все особенности, присущие этой выборке, и по-прежнему получается модель, частично сформированная под влиянием шума. Ни на одном этапе конвейера не ставится предварительный вопрос: способен ли поиск на этой выборке и с этим критерием вообще отличить один вектор гиперпараметров от другого?
В этой статье на этот вопрос дается числовой ответ. Мы реализуем afml.cross_validation.selection_overfit. Этот инструмент измеряет разброс значений критерия при допустимых повторных разбиениях одних и тех же данных, сравнивает его с разбросом оценок кандидатов и выводит их отношение — точнее, отношение разброса оценок кандидатов к уровню шума (сигнал к шуму, а не шум к сигналу). В приведенном ниже исследовании этот коэффициент составляет 0.49. Уровень шума критерия примерно вдвое превышает разброс, который этот критерий должен позволять различать. В этих условиях поиск выбирал кандидата, лучшего в среднем по разбиениям, лишь в одном разбиении из восьми, а на этой конкретной выборке его оценку на отложенном блоке превзошли двадцать шесть из шестидесяти отклоненных кандидатов. (Как объясняется в разделе 6, само по себе последнее число не доказывает, что равномерный случайный выбор дал бы лучший результат; оно показывает лишь, что конкретный кандидат, выбранный по аргмаксимуму, не обеспечил наилучшего обобщения.)
Из этого вытекают три следствия, каждому из которых посвящен отдельный раздел. При фиксированном бюджете испытаний на этих смоделированных данных расширение пространства поиска улучшило значение критерия отбора, но ухудшило качество модели при ее применении. Это частный случай результата Коули и Тэлбота для ARD, а не универсальный закон: при достаточном бюджете, достаточно сильном сигнале или достаточной регуляризации более широкое пространство поиска может дать лучший результат. Решение состоит не в использовании более совершенного алгоритма сэмплирования, а в выборе критерия с меньшей дисперсией, что меняет подход к заданию порога ранней остановки. А поскольку байесовский алгоритм сэмплирования порождает коррелированные испытания, число испытаний, которое следует использовать при расчете дефлированного коэффициента Шарпа, не равно ни фактическому числу испытаний Optuna, ни тому значению, которое мы сейчас передаем.
На протяжении всей статьи мы опираемся на работу Гэвина Коули и Николы Тэлбот «О переобучении при отборе моделей и последующем смещении оценки качества вследствие отбора» (JMLR, 2010). В части 16 был реализован подход из раздела 5 их работы. В данной статье реализован подход из раздела 4 их работы, где объясняется, что следует делать иначе. Их эксперименты проводятся на стационарных эталонных наборах данных UCI с независимыми и одинаково распределенными фолдами. Перенос этих выводов на финансовые данные требует дополнительных допущений: достаточно стационарных признаков, функции потерь с ограниченным влиянием, явного учета зависимостей и алгоритма поиска, способ исследования которого соответствует пространству поиска; на каждом соответствующем этапе мы отмечаем эти допущения.
Что исправила вложенная кросс-валидация, а что оставила без изменений
Коули и Тэлбот разграничивают две проблемы, которые легко спутать.
Первая — смещение оценки качества вследствие отбора. Если гиперпараметры выбираются на основе данных, которые впоследствии попадают в набор для оценки, то такая оценка будет оптимистичной, поскольку гиперпараметры сохраняют частичную «память» об этих данных. Решение носит структурный характер: отбор моделей нужно выполнять заново при каждом повторном формировании выборок из данных, чтобы ни одно наблюдение не влияло на настройки, используемые при его оценке. Это и есть вложенная кросс-валидация, которой посвящена часть 16.
Вторая проблема — переобучение при отборе моделей как таковом. В ходе поиска минимизируется критерий отбора, оцениваемый по конечной выборке. После некоторого момента дальнейшая минимизация уже не улучшает обобщение, а лишь использует особенности данной конкретной выборки. Коули и Тэлбот показывают, что классическая картина переобучения при обучении воспроизводится на один уровень выше: критерий монотонно снижается, тогда как истинная ошибка примерно после тридцати–сорока шагов оптимизации перестает снижаться и начинает расти.
Вложенная кросс-валидация решает первую проблему, но почти ничего не говорит о второй. Она не позволяет отделить вторую проблему от других источников ухудшения качества на отложенных данных: дрейф режима, шум меток, нестабильность признаков и выборочная вариативность вносят свой вклад в плохую оценку при вложенной кросс-валидации, которая отражает лишь их суммарный эффект. Выполнение поиска внутри каждого внешнего фолда не делает поиск лучше: в каждом фолде поиск независимо приводит к переобучению, после чего причиненный ущерб усредняется и выражается в честной численной оценке. Если критерий отбора имеет высокую дисперсию, оценка при вложенной кросс-валидации честно отразит низкое качество, но конвейер не даст ни диагноза, ни рычага воздействия.
Это различие имеет практическое значение, поскольку эти две проблемы требуют противоположных подходов. Смещение оценки качества вследствие отбора устраняется за счет усложнения структуры процедуры и увеличения вычислительных затрат. Проблему переобучения при отборе моделей обычно решают за счет сокращения объема поиска: уменьшения числа гиперпараметров и испытаний, использования критерия с меньшей дисперсией и правила отбора, которое не проводит различий между кандидатами, неразличимыми по имеющимся данным.
Смещение и дисперсия при отборе моделей
Пусть G(θ) — истинное качество обобщения модели с гиперпараметрами θ, а g(θ;D) — его оценка, вычисленная на конечной выборке D. Ожидаемая квадратичная ошибка оценки, как обычно, разлагается на член, представляющий собой квадрат смещения, и член, представляющий собой дисперсию.
При оценке качества важно именно смещение: мы хотим, чтобы сообщаемое значение было верным в среднем. Что касается выбора модели, то это не так. При отборе никогда не используется абсолютный уровень критерия — важна лишь форма его зависимости от гиперпараметров: достаточно, чтобы точка минимума g находилась рядом с точкой минимума G. Критерий, который при всех значениях гиперпараметров пессимистичен на одну и ту же постоянную величину, — идеальный критерий отбора, поскольку добавление константы не меняет положения минимумов. Несмещенный, но шумный критерий плохо подходит для отбора, поскольку на каждой выборке его минимум оказывается в другом месте.
Именно эта смена приоритетов делает кросс-валидацию с исключением по одному наблюдению худшим критерием отбора, чем можно было бы предположить исходя из ее несмещенности; по той же причине оценка при кросс-валидации по пяти фолдам, рассчитанная на небольшом валидационном блоке, может серьезно вводить в заблуждение, как бы тщательно ни проводилась его очистка.
Смещение и дисперсия критерия отбора
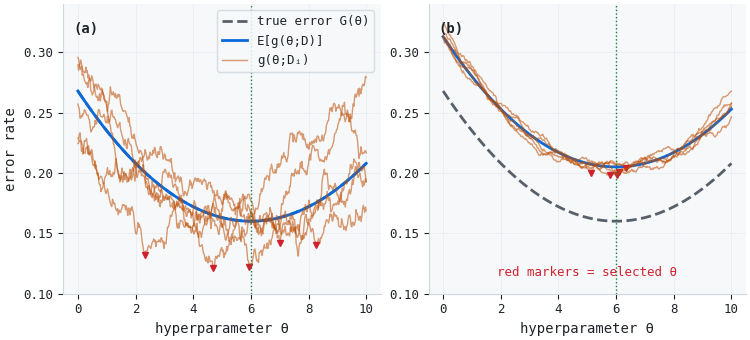
Рисунок 1. Иллюстрация из двух панелей, показывающая, почему при отборе моделей дисперсия важнее смещения
- Панель (a): несмещенный критерий, математическое ожидание которого лежит точно на кривой истинной ошибки. Реализации критерия на отдельных выборках сильно различаются, и на большинстве выборок выбранное значение θ оказывается далеко от истинного оптимума.
- Панель (b): критерий, смещенный вверх на постоянную величину. Каждая реализация дает неверный абсолютный уровень, но почти верное положение минимума, поэтому выбранные значения θ тесно группируются вокруг истинного оптимума.
Критерий на панели (b) не прошел бы ни одну проверку на несмещенность, но лучше подходит для этой задачи. В этом и заключается вся суть аргументации, а все, что следует далее, — попытка определить, какой панели рисунка соответствует данный конвейер.
Как сделать дисперсию критерия измеримой
Есть одно препятствие. PurgedKFold разбивает выборку детерминированно: тестовые блоки представляют собой непрерывные срезы по позициям наблюдений, поэтому одни и те же данные всегда дают одни и те же фолды и одну и ту же оценку. У одного числа нет разброса. Величина, которую нам нужно измерить, не наблюдаема в силу самого устройства процедуры.
Перемешивание здесь использовать нельзя. Фолды представляют собой непрерывные блоки именно потому, что метки перекрываются во времени, а эмбарго должно сохранять свой смысл. Зато нам доступен сдвиг границы. Если сдвинуть начало первого тестового блока вперед на несколько наблюдений, получится другое, столь же допустимое разбиение того же ряда: блоки остаются непрерывными, порядок сохраняется, а очистка и эмбарго применяются точно так же, как и прежде. Вычисление критерия при одном фиксированном θ для нескольких сдвигов дает несколько значений критерия, а их стандартное отклонение служит оценкой уровня шума.
Оговорка относительно предпосылки диагностики, которую сама диагностика не устраняет: сдвиги не дают независимых реализаций критерия. Близкие сдвиги дают разбиения, у которых совпадает большая часть наблюдений и фолдов; корреляция между полученными значениями критерия может быть высокой. Таким образом, стандартное отклонение по сдвигам оценивает разброс критерия в рамках конкретного семейства зависимых повторных разбиений и может быть смещено в любую сторону относительно истинной выборочной вариативности критерия при независимом получении сопоставимых данных. При сомнениях трактуйте эту величину как оценку дисперсии критерия снизу: аудит, показывающий низкий коэффициент разрешения, все равно информативен, но высокий коэффициент разрешения нельзя считать доказательством безопасности поиска.
Один фолд с очисткой при трех сдвигах границы
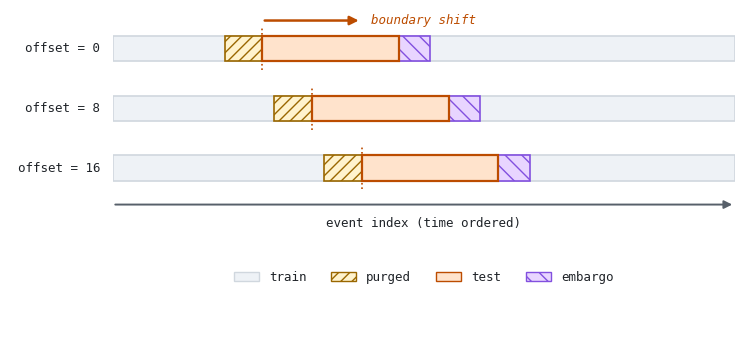
Рисунок 2. Иллюстрация в трех строках: сдвиг границы, создающий повторные разбиения
- Строка 1: стандартное разбиение, нулевой сдвиг. Тестовый блок начинается в фиксированной позиции, а перед ним расположена область очистки.
- Строка 2: тот же фолд, сдвинутый вперед на восемь событий. Области очистки и эмбарго перемещаются вместе с блоком.
- Строка 3: сдвиг вперед на шестнадцать событий. Каждая строка представляет собой допустимое разбиение одного и того же временного ряда с очисткой и эмбарго, поэтому три значения критерия — это три коррелированные реализации одной и той же величины.
Это реализовано в OffsetPurgedKFold. Это прямая замена PurgedKFold с одним дополнительным аргументом; при offset=0 воспроизводится стандартное разбиение.
class OffsetPurgedKFold(BaseCrossValidator):
    """Purged, embargoed K-fold whose test blocks start at an arbitrary offset."""

    def split(self, X, y=None, groups=None):
        if not X.index.equals(self.t1.index):
            raise ValueError("X.index and t1.index must be identical")

        n        = X.shape[0]
        indices  = np.arange(n)
        embargo  = int(n * self.pct_embargo)
        t1_vals  = self.t1.values
        t1_idx   = self.t1.index.values

        for start, stop in self._test_blocks(n):
            test_idx = indices[start:stop]
            test_t0  = t1_idx[start]
            test_t1  = t1_vals[test_idx].max()

            # Left block: events that closed strictly before the test opened.
            left = indices[t1_vals < test_t0]
            left = left[left < start]

            # Right block: events starting strictly after the last test label
            # closed, plus the embargo.
            right_start = int(np.searchsorted(t1_idx, test_t1, side="right"))
            right_start = min(right_start + embargo, n)

            train_idx = np.concatenate([left, indices[right_start:]]).astype(int)
            if train_idx.size == 0 or test_idx.size == 0:
                continue
            yield train_idx, test_idx
Здесь два граничных условия заданы строго, тогда как во фрагменте кода 7.1 из AFML они нестрогие. Метка, интервал которой заканчивается точно в первую временную отметку тестового блока, пересекается с тестовым окном согласно определению пересечения с включенными границами в самом фрагменте кода, однако исходный PurgedKFold сохраняет ее по условию t1 <= t0. Мы исключаем эту метку. Аналогично функция searchsorted вызывается с параметром side="right", чтобы событие, начинающееся точно в момент окончания интервала последней тестовой метки, исключалось, а не допускалось при нулевом эмбарго. Оба изменения затрагивают по одному наблюдению: проверка на утечку данных их выявит, а бэктест — нет. Если в принятом у вас определении события интервал метки считается полуоткрытым, [t0, t1), то строгие исключения здесь излишне консервативны на одно наблюдение. По умолчанию границы интервала включаются, поскольку именно такое определение используется в AFML; скорректируйте это поведение, если в вашем конвейере принято иное.
Примечание о вложенности фолдов с очисткой: не передавайте обучающую выборку внешнего разбиения PurgedKFold непосредственно в другой PurgedKFold. Внешний обучающий набор не является непрерывным: он состоит из левого блока, промежутка и правого блока. Внутренний алгоритм разбиения выделяет непрерывные срезы по позициям в этой конкатенированной последовательности, поэтому внутренний тестовый блок может оказаться по обе стороны разрыва, а эмбарго, рассчитываемое как доля числа строк, а не как временной интервал, незаметно исключит не те наблюдения по другую сторону разрыва. Это утверждение относится к разбиению по позиционным индексам конкатенированных данных. Если внутренний алгоритм разбиения работает с исходными временными метками и применяет логику очистки на той же временной оси, это возражение неприменимо и вложенность вполне допустима. В части 16 проблема конкатенации обходится за счет выполнения внутреннего цикла с помощью PurgedWalkForwardCV на непрерывном обучающем блоке.
Аудит критерия (criterion_variance_audit)
При наличии возможности повторного разбиения аудит проводится просто. Оцените каждого кандидата при каждом сдвиге. Разброс оценок одного кандидата при разных сдвигах границ — это шум; разброс средних оценок кандидатов — сигнал. Их соотношение определяет, служит ли поиск оцениванию или подгонке под шум.
report = criterion_variance_audit(
    estimator, X, y, t1, param_candidates=grid,
    sample_weight=sw, n_splits=5, pct_embargo=0.01,
    n_resamples=10, scorer=neg_log_loss_scorer,
)
print(report.summary())
Получаем четыре величины. noise_floor — это усредненное по кандидатам стандартное отклонение критерия по разбиениям. candidate_spread — это стандартное отклонение усредненных по разбиениям оценок между кандидатами. resolution_ratio определяется как candidate_spread / noise_floor — отношение сигнала к шуму. Значение выше единицы означает, что различия между кандидатами по критерию превышают его собственный разброс; при значении ниже единицы поиск не позволяет отличить кандидатов друг от друга на фоне выборочного шума. selection_regret — это ожидаемая потеря в единицах критерия при выборе кандидата, максимизирующего критерий на одном разбиении, по сравнению с выбором лучшего в среднем кандидата; argmax_stability показывает, как часто эти кандидаты совпадают.
Два пояснения о смысле этих показателей. Во-первых, selection_regret — это не потеря от выбора на данных вне выборки в смысле бэктеста. Он измеряет потерю на тех же повторных разбиениях, которые используются для определения условной «истины» — усредненной по разбиениям оценки. Это внутренняя величина. Для оценки действительной потери от выбора на данных вне выборки потребовалось бы оценить выбранного кандидата и лучшего в среднем кандидата на независимом будущем периоде, чего данный аудит не предусматривает. Во-вторых, argmax_stability измеряет частоту совпадения выбранного кандидата с кандидатом, лучшим по усредненной по разбиениям оценке, а не правильность выбора в каком-либо абсолютном смысле. Кандидат может быть устойчивым по этому показателю и при этом оставаться далеко от истинного оптимума G.
Еще одно уточнение: candidate_spread является свойством множества кандидатов, а не критерия. Добавление в сетку явно плохих кандидатов увеличивает разброс оценок, не улучшая способность поиска различать лидеров. Для отбора важна локальная различимость нескольких ведущих кандидатов, а не общий разброс по всей сетке. Рассматривайте коэффициент разрешения вместе с таблицей по кандидатам и при интерпретации ориентируйтесь прежде всего на верхнюю часть рейтинга, а не на крайние значения.
В приведенном ниже исследовании используется смоделированный рынок с четырьмя тысячами часовых баров и кластеризацией волатильности по модели GARCH. В модели предусмотрено скрытое состояние, которое редко переключается и меняет знак слабой моментум-компоненты. Мы используем двенадцать признаков (два сигнальных и десять шумовых) и метки доходности за будущий период с перекрывающимися временными интервалами; после прореживания остается тысяча событий (базовая частота — 0.503). Это моделирование не претендует на описание какого-либо конкретного финансового инструмента. Это контролируемый пример интересующего нас режима, в котором небольшое нестабильное преимущество скрыто в преимущественно шумовых признаках, а временные интервалы меток перекрываются. В разделе 11 рассматривается проведение того же аудита на реальных барах: именно он дает численную оценку, на которую следует опираться при принятии решений.
Дисперсия критерия и вызванная ею нестабильность
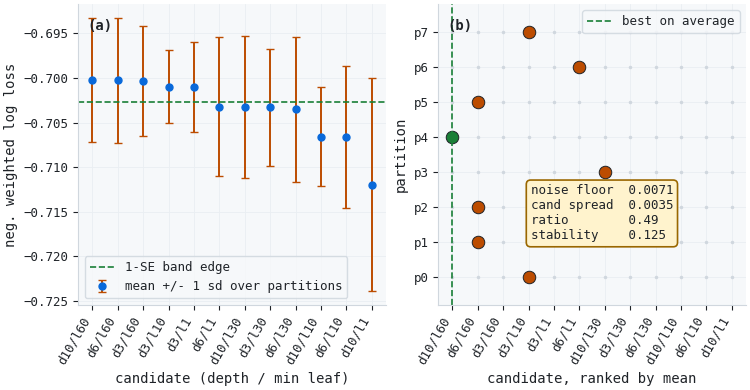
Рисунок 3. Иллюстрация из двух панелей, показывающая критерий отбора, который не позволяет различить кандидатов
- Панель (a): двенадцать кандидатов, ранжированных по средней оценке, с отрезками погрешности, соответствующими одному стандартному отклонению по восьми разбиениям. Отрезки погрешности почти полностью перекрываются; пунктирная линия обозначает границу полосы в пределах одной стандартной ошибки, и пять кандидатов попадают в эту полосу.
- Панель (b): аргмаксимум на каждом разбиении. Пунктирная линия обозначает кандидата, лучшего в среднем; он выбирается только на разбиении p4. При сдвиге границы фолда победителем поочередно становятся пять разных кандидатов.
| Величина | Значение | Интерпретация |
|---|---|---|
| Уровень шума критерия | 0.00710 | Разброс при фиксированном θ |
| Разброс оценок кандидатов | 0.00350 | Разброс по различным значениям θ |
| Коэффициент разрешения | 0.49 | Ниже единицы: преобладает шум |
| Потеря от выбора | 0.00093 | Внутренняя цена доверия к аргмаксимуму |
| Устойчивость аргмаксимума | 0.125 | Совпадает с лучшим в среднем по разбиениям кандидатом в одном случае из восьми |
Уровень шума вдвое превышает разброс оценок кандидатов. Таким образом, ранжирование на панели (a) в основном обусловлено случайным расположением границ фолдов, и панель (b) показывает именно это: стоит сдвинуть границу — и побеждает другой кандидат. Представлять кандидата, выбранного по максимуму критерия, как «настроенную модель» — значит описывать подбрасывание монеты на языке оптимизации.
Коэффициент разрешения — единственный показатель, который стоит учитывать в дальнейшем. Приведенные ниже практические пороговые значения эвристические, а не теоретически выведенные. Они не определяются на основе модели ошибок или доверительного интервала, и их потребуется перекалибровать для каждого набора данных. Рассматривайте их как отправную точку для обсуждения, а не как правило принятия решений с p-значением:
- При значении выше примерно двух поиск, скорее всего, действительно позволяет оценивать качество кандидатов, и его результат можно использовать как ориентир. Даже в этом случае предпочтительнее использовать полосу допуска, а не строго выбирать аргмаксимум.
- При значении от одного до двух считайте ранжирование приблизительным и отдавайте предпочтение правилу выбора с полосой допуска.
- При значении ниже единицы аргмаксимум несет мало информации, подкрепленной данными. Это не означает, что ранжирование бесполезно: кандидатов на противоположных концах рейтинга по-прежнему можно надежно различать, и зачастую достаточно сокращенного набора кандидатов. Однако выбор конкретного кандидата на первое место вряд ли будет воспроизводимым, и честные варианты действий — расширить базу данных для расчета критерия, сократить набор кандидатов или вовсе перестать различать лидеров.
Кривая оптимизма при отборе
В ходе аудита измеряется значение критерия отбора для фиксированного набора кандидатов. Дополняющий подход позволяет отслеживать, что происходит по мере расходования бюджета поиска. Функция selection_optimism_curve однократно разбивает выборку с сохранением временного порядка, выполняет очистку на границе разбиения, а затем в каждом испытании оценивает выбранное алгоритмом сэмплирования значение θ с помощью кросс-валидации с очисткой внутри выборки разработки, повторно обучает модель на всей выборке разработки и оценивает ее на отложенном блоке. Текущий лидер — это испытание, лидирующее по внутреннему критерию отбора.
Одно разбиение — одно наблюдение. Приведенные ниже числа — корреляция, разрыв между внутренней и отложенной оценками — разрыв оптимизма, число отклоненных кандидатов, превзошедших выбранного, — представляют собой оценки, полученные для одной временной точки привязки. На реальных данных с дрейфом режима знак корреляции может зависеть от положения точки разбиения. Отрицательная корреляция, наблюдаемая однократно, лишь наводит на предположение; отрицательная корреляция, воспроизводимая для нескольких временных точек разбиения или нескольких инструментов, уже служит свидетельством в его пользу. Не случайно в разделе 11 это сформулировано как требование воспроизводимости.
curve, fold_scores = selection_optimism_curve(
    estimator, X, y, t1, param_sampler,
    n_trials=60, sample_weight=sw,
    design_fraction=0.70, n_splits=4, n_offsets=3,
    scorer=neg_log_loss_scorer, random_state=11,
    return_fold_scores=True,
)
Сопоставление внутреннего критерия отбора с качеством на отложенном блоке в ходе поиска
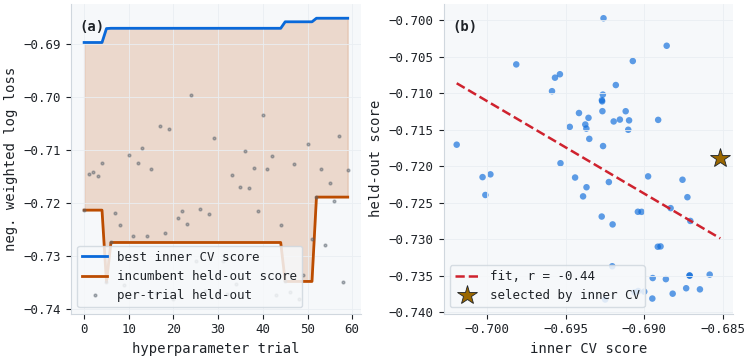
Рисунок 4. Иллюстрация из двух панелей, показывающая оптимизм при отборе в ходе поиска из шестидесяти испытаний
- Панель (a): лучшая оценка по внутреннему критерию отбора растет ступенчато по мере смены текущего лидера, тогда как его оценка на отложенном блоке изменяется независимо и преимущественно снижается. Затененная область между ними представляет собой разрыв оптимизма.
- Панель (b): каждое испытание представлено точкой, сопоставляющей оценку по внутреннему критерию отбора с оценкой на отложенном блоке; показан оцененный наклон линии регрессии, а звездочкой отмечено испытание, выбранное в ходе поиска. Связь отрицательная.
Разрыв составляет от 0.034 до 0.049 нат, то есть около пяти процентов от значения логарифмической функции потерь, и не сокращается с увеличением числа испытаний. Более интересное число приведено на панели (b): по шестидесяти испытаниям корреляция между внутренним критерием отбора и качеством на отложенном блоке составляет −0.44. На этой выборке критерий был не просто зашумленным — он был антиинформативным, и при этом разбиении модель, выбранная по аргмаксимуму критерия, получила на отложенном блоке оценку хуже, чем двадцать шесть из шестидесяти отклоненных при отборе кандидатов.
Что устанавливает это число, а чего — нет. Двадцать шесть из шестидесяти отклоненных кандидатов превзошли выбранного. Это не означает, что равновероятный случайный выбор дал бы лучший результат: 33 из 60 кандидатов не превзошли выбранного, а для такого утверждения нужно было бы сравнить среднюю оценку всех кандидатов на отложенном блоке с оценкой выбранного кандидата. Это наблюдение подтверждает более узкий вывод: на данной выборке конфигурация, максимизирующая внутренний критерий, не служит надежным ориентиром для оценки качества на отложенных данных. Этого достаточно, чтобы обосновать приведенные ниже меры, не делая чрезмерно сильных утверждений.
Механизм прост и должен быть изложен понятно. В симулятор заложен скрытый режим с редкими переключениями, а отложенный блок следует во времени за блоком данных для разработки. Модель, которая сильнее подстраивается под режим периода разработки, показывает лучшие результаты внутри этого периода и худшие — после него. Это свойство рынков, а не искусственный эффект, введенный ради эффектного графика, и именно поэтому на ценовых данных знак корреляции может меняться на противоположный, что редко происходит на стационарных эталонных наборах данных UCI, использованных Коули и Тэлботом. Однако необходимо оговорить смешение эффектов: в этой симуляции отрицательная корреляция между внутренней оценкой и качеством на отложенных данных хотя бы отчасти обусловлена сменой режима, а не только переобучением при отборе моделей. Смена режима снижает корреляцию между внутренней оценкой и качеством на отложенных данных независимо от какого-либо эффекта отбора. При такой схеме аудит не позволяет разделить эти два эффекта. Для реальных данных с неизвестной структурой режимов действует та же оговорка: отрицательная корреляция свидетельствует о чем-то, но не обязательно именно о переобучении при отборе моделей. Надежно можно утверждать, что коэффициент разрешения меньше единицы, следствием чего является неустойчивость аргмаксимума; меняется ли знак корреляции между внутренней оценкой и качеством на отложенных данных — вопрос, на который эта диагностика сама по себе ответить не может.
Каждый настраиваемый параметр — это масштаб длины ARD
Наиболее полезный эмпирический результат Коули и Тэлбота заключается в сравнении двух ядер. Ядро ARD присваивает каждому измерению входных данных свой собственный масштаб длины; изотропное ядро RBF использует один общий масштаб для всех измерений. ARD включает RBF как частный случай, поэтому минимальная ошибка на тестовых данных, достижимая с ARD, не может быть выше. В двенадцати из тринадцати тестов RBF все равно оказался победителем, причем показатель PRESS для ARD в большинстве из них был ниже. Большее число настраиваемых параметров давало лучшее значение критерия, но худшую модель.
Аналогия с Optuna показательна, но не вполне точна. Масштаб длины ARD — это параметр модели в конкретном ядре с гладким ландшафтом правдоподобия и четкой структурой градиента. Гиперпараметром в пространстве поиска Optuna может быть коэффициент регуляризации, параметр сэмплирования, вычислительный бюджет или стохастический параметр, и разные настраиваемые параметры по-разному взаимодействуют с критерием. Аналогия справедлива, поскольку каждое добавленное измерение дает поиску еще одну возможность подстроиться под шум критерия, однако конкретная динамика — то, как смещается оптимум при расширении пространства и как бюджет испытаний взаимодействует с размерностью, — различается. Приведенный ниже эмпирический результат следует рассматривать как демонстрацию того, что результат для ARD может воспроизводиться на данных, подобных финансовым, а не как доказательство того, что так будет всегда.
Есть еще одно важное замечание, которое следует учитывать, поскольку в этом вопросе легко допустить ошибку. ARD включает RBF как частный случай, поэтому при идеальном оптимизаторе и неограниченном бюджете испытаний более широкое пространство не может дать худший результат. При фиксированном бюджете эта гарантия, обусловленная вложенностью пространств, не действует. За сорок испытаний в шестимерном пространстве алгоритм может вообще не попасть в область, соответствующую двумерному подпространству. Более широкое пространство может проигрывать не только из-за переобучения, но и из-за менее плотного покрытия пространства алгоритмом сэмплирования. В данном случае оба эффекта действуют в одном направлении, и приведенная ниже диагностика не позволяет их разделить.
Мы провели этот эксперимент. Та же модель, те же данные, тот же бюджет в сорок испытаний, те же разбиения, то же начальное значение генератора случайных чисел. В узком пространстве поиск ведется по двум параметрам, напрямую определяющим компромисс между смещением и дисперсией: max_depth и min_weight_fraction_leaf, а все остальные параметры фиксированы. В широком пространстве добавляются параметры min_samples_leaf, max_features, n_estimators и max_samples, причем оно содержит узкое пространство как подмножество.
Ширина пространства поиска и обобщение
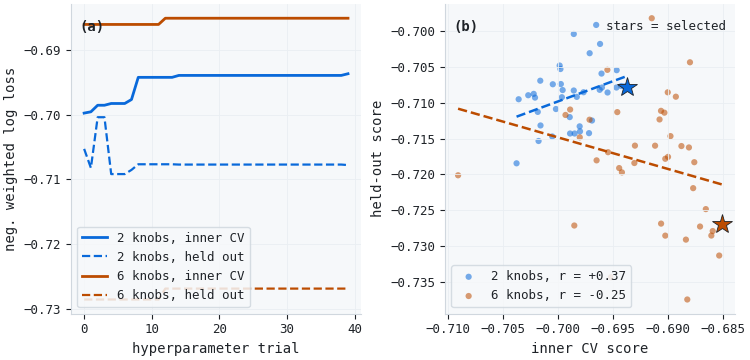
Рисунок 5. Иллюстрация из двух панелей, показывающая перенос результата для ARD на пространство гиперпараметров
- Панель (a): траектории текущего лидера в обоих пространствах. Широкое пространство одновременно дает наивысшую внутреннюю оценку и самую низкую оценку на отложенном блоке; две оранжевые линии охватывают обе синие сверху и снизу.
- Панель (b): сопоставление внутренней оценки с оценкой на отложенном блоке для всех сорока испытаний в каждом пространстве с подобранными линиями тренда. В узком пространстве сохраняется положительная связь между оценками, а в широком она становится отрицательной.
| Величина | Узкое пространство, 2 параметра | Широкое пространство, 6 параметров |
|---|---|---|
| Лучшая внутренняя оценка | −0.6937 | −0.6851 |
| Оценка на отложенном блоке | −0.7078 | −0.7269 |
| Разрыв оптимизма | 0.0141 | 0.0417 |
| corr(внутренняя оценка, оценка на отложенном блоке) | +0.37 | −0.25 |
| Испытания, превзошедшие выбранный вариант | 13 из 40 | 29 из 40 |
В этой конфигурации, при данном бюджете и на этих данных широкое пространство поиска дает выигрыш по критерию на 0.0086 нат, но проигрыш вне выборки на 0.0191. Разрыв оптимизма увеличивается втрое. Знак корреляции меняется на противоположный. Здесь воспроизведена таблица 2 из статьи на данных, подобных ценовым рядам, в условиях, благоприятных для проявления этого эффекта: небольшая выборка, фиксированный бюджет испытаний и скрытая смена режима. Утверждение, что более широкие пространства всегда проигрывают, не является общим законом. При значительно большем бюджете, более гладком критерии или пространстве поиска, дополнительные измерения которого действительно несущественны (в этом случае хороший алгоритм сэмплирования быстро научится их игнорировать), более широкое пространство может выигрывать и действительно выигрывает. Отсюда следует правило проектирования: не «никогда не расширяйте пространство поиска», а «расширяйте его осознанно и учитывайте, что при типичных бюджетах за дополнительные измерения придется чем-то заплатить».
Отсюда следует правило проектирования: подбирать только те параметры, которые напрямую управляют емкостью модели, а значения остальных фиксировать на основании обоснованных соображений. В случайном лесе параметры max_depth и min_weight_fraction_leaf управляют емкостью модели; n_estimators задает вычислительный бюджет, увеличение которого дает монотонный эффект с насыщением, и вообще не должен включаться в поиск; max_features и min_samples_leaf оказывают эффекты второго порядка, которые приведенный выше критерий все равно не способен различить. Фиксация этих параметров аналогична выбору изотропного ядра: теоретической гибкостью жертвуют ради критерия, минимум которого имеет смысл.
Три способа борьбы с переобучением и ошибка в том, который у нас уже был
Коули и Тэлбот отмечают, что методы борьбы с переобучением при отборе моделей те же, что и при обучении: регуляризация, ранняя остановка и усреднение. Здесь реализованы все три метода, причем первый уже присутствовал в кодовой базе, но с двумя дефектами.
Регуляризация: исправленное правило одной стандартной ошибки
Выбор простейшего кандидата, оценка которого отличается от лучшей не более чем на одну стандартную ошибку, — это способ снижения дисперсии: он позволяет не проводить различий между кандидатами, которых данные не позволяют различить. В реализации inner_cv_search были допущены две ошибки.
Первая ошибка — арифметическая. Допуск рассчитывался как np.std(fold_scores) — стандартное отклонение оценок по фолдам, тогда как правило требует использовать стандартную ошибку среднего по фолдам: std / sqrt(k). При девяти фолдах полоса допуска оказывается втрое шире, чем должна быть. Вместо того чтобы допускать статистически неразличимых кандидатов, правило допускает и тех, кто действительно хуже; поскольку затем выбирается самый простой из них, правило вырождается в безусловное предпочтение модели с наименьшей сложностью в сетке. Это была не регуляризация, а намеренное недообучение, которое оставалось незамеченным.
Второй момент — определение понятия «самый простой». Код брал within_1se[0], полагаясь на то, что ParameterGrid перебирает конфигурации от простых к сложным. Но это не так. ParameterGrid перебирает конфигурации в порядке отсортированных ключей, причем значения последнего ключа меняются чаще всего; такой порядок определяется ключами словаря и никак не связан с емкостью модели. Переименуйте параметр — и выбор изменится. Критерий сложности нужно задать явно.
Уточнение, отсутствующее в комментарии к коду: расчет по формуле std / sqrt(k) предполагает, что оценки по фолдам независимы или слабо зависимы. Кросс-валидация с очисткой устраняет утечку данных между обучающей и тестовой частями, но не делает оценки по фолдам независимыми друг от друга: соседние фолды имеют общую структуру перекрытий, относятся к одному и тому же базовому режиму, а их ошибки коррелируют. Истинная стандартная ошибка среднего по фолдам при положительной корреляции между оценками по фолдам превышает std / sqrt(k), а значит, скорректированное правило по-прежнему допускает слишком широкий выбор. Этот вариант гораздо ближе к правильному, чем исходный, и именно он является стандартной корректировкой. Читателям, которым нужна более строгая полоса допуска, следует увеличить делитель, умножив его на коэффициент, оцененный по матрице корреляции оценок по фолдам, или просто вручную расширить допуск.
def one_standard_error_selection(results, complexity, score_key="fold_scores",
                                 param_key="params"):
    table = []
    for r in results:
        fs = np.asarray(r[score_key], dtype=float)
        if fs.size < 2:
            raise ValueError("each candidate needs at least two fold scores")
        table.append({
            "entry":      r,
            "mean":       float(fs.mean()),
            "se":         float(fs.std(ddof=1) / np.sqrt(fs.size)),   # not fs.std()
            "complexity": float(complexity(r[param_key])),        # not grid order
        })

    best      = max(table, key=lambda d: d["mean"])
    threshold = best["mean"] - best["se"]
    within    = [d for d in table if d["mean"] >= threshold]
    chosen    = min(within, key=lambda d: d["complexity"])
    return chosen["entry"], {...}
На проверенной сетке аргмаксимум соответствует глубине 10 и минимальному числу наблюдений в листе 60; при скорректированном правиле в полосу допуска шириной 0.00247 попадают пять из двенадцати кандидатов, а выбирается модель глубины 3 с тем же ограничением на число наблюдений в листе. При устойчивости аргмаксимума 0.125 отказ от ранжирования внутри полосы допуска — не уступка. Это единственная обоснованная интерпретация полученных данных.
О функции оценки сложности: статья не может предписать, как сравнивать сложность конфигураций с условными гиперпараметрами (например, с параметром, который применяется, только если другой параметр принимает определенное значение). Выберите функцию оценки сложности, подходящую для вашей модели, задокументируйте ее и учитывайте, что неудачно выбранная функция может незаметно вызвать смещение выбора в любую сторону. Для случайного леса на практике достаточно учитывать глубину и минимальный размер листа. Для конвейеров с взаимоисключающими ветвями задавайте сложность через сравнение кортежей и учитывайте, что порядок — это решение, принятое при моделировании, а не объективный факт.
Ранняя остановка с порогом, определяемым уровнем шума
Для ранней остановки нужен порог, и произвольно выбранное значение эпсилон для этого не подходит. Содержательно обоснованный порог — это разброс самого критерия: улучшение меньше одного стандартного отклонения критерия при фиксированных гиперпараметрах не свидетельствует о том, что модель лучше. HPOEarlyStopping использует уровень шума, полученный в ходе аудита, и требует, чтобы улучшения превышали его.
Это эвристика, а не проверка гипотезы. Разность оценок текущего лидера и нового кандидата — это разность двух зашумленных оценок; ее дисперсия не обязательно равна дисперсии одной оценки при фиксированном θ. В частности, текущий лидер выбирается по максимальной оценке среди испытаний, поэтому его оценка смещена вверх относительно истинного качества; распределение разности оценок не совпадает с распределением шума, характеризуемого уровнем шума. Используемый здесь порог намеренно консервативен в пользу ранней остановки: любое улучшение меньше уровня шума считается неотличимым от шума. При многократных испытаниях вероятность ложного «улучшения», превышающего уровень шума, также накапливается, поэтому при большом бюджете испытаний оправдан более строгий порог. Если нужна полноценная статистическая проверка, используйте парное сравнение векторов оценок по фолдам или перестановочный тест для границ разбиения и внесите поправку на число испытаний.
audit = criterion_variance_audit(estimator, X, y, t1, probe_grid, n_resamples=8)

study.optimize(
    objective,
    n_trials=200,
    callbacks=[HPOEarlyStopping(
        noise_floor=audit.noise_floor,
        patience=15,
        min_trials=20,
        tolerance_multiple=1.0,
    )],
)
Стоит обратить внимание на два момента реализации, поскольку очевидный вариант не работает. Для отсеченных и завершившихся с ошибкой испытаний выполняется условие trial.value is None, поэтому любая функция обратного вызова, вычисляющая агрегат по значениям последних испытаний, вызывает TypeError при первом срабатывании механизма отсечения, а в коде уже используется MedianPruner. Функция обратного вызова проверяет значение на None и при его обнаружении завершает работу. А правило остановки без допуска сбрасывает счетчик шагов без улучшения даже при улучшении на одну миллиардную — именно такой сбой и призван предотвратить порог на уровне шума.
Усреднение по лидерам
Когда коэффициент разрешения меньше единицы, порядок лучших кандидатов определяется шумом, поэтому делать ставку на единственного кандидата, выбранного по максимуму — значит рисковать реальным капиталом по результату броска монеты. top_m_ensemble обучает модели с M векторами гиперпараметров, получившими наилучшие оценки, и усредняет предсказанные ими вероятности, сохраняя найденную поиском область, но отбрасывая порядок кандидатов, который поиск не позволяет обосновать. Разумное значение M — число кандидатов в пределах полосы шириной в одну стандартную ошибку. Это требует M проходов моделей при получении прогноза либо использования графа ONNX, усредняющего их результаты.
Испытания гиперпараметров — это испытания в бэктестах
Дефлированный коэффициент Шарпа корректирует наблюдаемый коэффициент Шарпа с учетом ожидаемого максимального значения по N испытаниям, а конвейер получает N из StrategyTrialTracker, который подсчитывает вручную зарегистрированные варианты стратегии. Сейчас исследование Optuna из двухсот испытаний учитывается в этом подсчете как одно испытание. В каждом из этих испытаний модель выбиралась на одних и тех же данных, а результат победителя — это максимум по двумстам попыткам, точно так же, как если бы мы вручную протестировали двести пар скользящих средних.
Такое сопоставление — консервативная поправка, а не теорема. Испытание конфигурации гиперпараметров не является отдельным бэктестом в том смысле, для которого был разработан дефлированный коэффициент Шарпа. DSR предполагает N испытаний, показателями качества которых служат коэффициенты Шарпа с известной дисперсией; здесь же мы имеем N испытаний, критерием отбора в которых служит логарифмическая функция потерь на фолдах кросс-валидации, а связь между вектором оценок по фолдам и распределением коэффициента Шарпа носит косвенный характер. Приравнивание испытаний при поиске гиперпараметров (HPO) к испытаниям в бэктестах — мера предосторожности против недостаточной поправки; при таком подходе возможная ошибка будет в сторону отклонения стратегий. При внедрении стратегии именно в эту сторону и следует допускать ошибку. Это не является строгим следствием определения DSR, и читателям, которым требуется формально обоснованное число испытаний, следует рассчитывать его непосредственно по распределениям прибыли и убытков (PnL) испытаний, а не по оценкам на фолдах.
Использовать фактическое число испытаний также неверно, но это ошибка в противоположную сторону. Алгоритм сэмплирования TPE сосредоточивает выбор конфигураций в определенной области пространства, поэтому последовательные испытания дают почти одинаковые ошибки на почти одних и тех же наблюдениях, а ожидаемый максимум по двумстам сильно коррелированным испытаниям значительно ниже, чем по двумстам независимым.
effective_trial_count принимает векторы оценок для каждого испытания и возвращает две стандартные оценки: оценку по собственным значениям Ли и Цзи (2005), получаемую суммированием целых и дробных частей собственных значений матрицы корреляций испытаний, и оценку на основе дизайн-эффекта Киша (1965) при равной корреляции между всеми парами испытаний.
Избыточность испытаний и обусловленный ею порог коэффициента Шарпа
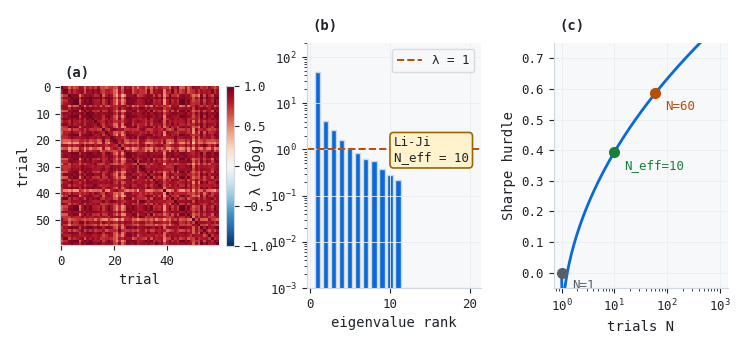
Рисунок 6. Иллюстрация из трех панелей: коррелированные испытания и необходимая для них поправка
- Панель (a): матрица корреляций векторов оценок по фолдам для шестидесяти испытаний, равномерно окрашенная в темный цвет. Средняя парная корреляция составляет 0.787.
- Панель (b): спектр собственных значений. Доминирует одна компонента величиной 47, а остальные находятся вблизи линии уровня 1, поэтому шестьдесят испытаний исследуют практически одно направление.
- Панель (c): зависимость ожидаемого максимального коэффициента Шарпа от числа испытаний с отметками при N, равном единице, эффективному числу испытаний и фактическому числу испытаний.
| Использованное число испытаний | Значение | Порог коэффициента Шарпа |
|---|---|---|
| Текущий конвейер (без учета испытаний при поиске гиперпараметров) | 1 | 0.00 |
| Эффективное число испытаний: оценка по собственным значениям | 10.0 | 0.39 |
| Эффективное число испытаний: дизайн-эффект Киша | 1.26 | 0.06 |
| Фактическое число испытаний | 60 | 0.59 |
Практический вывод дает сравнение первой строки с последней: если не учитывать испытания при поиске гиперпараметров в поправке на множественные испытания, порог коэффициента Шарпа в этом исследовании оказывается занижен примерно на 0.4–0.6. Стратегия с коэффициентом Шарпа 0.5 по результатам бэктеста преодолевает нулевой порог, но не достигает порога ни при одной из двух оценок эффективного числа испытаний.
В данном случае две оценки различаются на порядок, и функция явно сообщает причину этого расхождения, а не скрывает ее. В данном случае матрица корреляций построена из шестидесяти векторов длиной двенадцать, поэтому ее ранг составляет не более одиннадцати. В результате оценка по собственным значениям не может дать эффективное число испытаний существенно выше примерно 12, независимо от того, сколько испытаний было проведено. Результат помечается как rank_limited, и его следует трактовать как нижнюю границу. Решение — увеличить длину вектора оценок каждого испытания, рассчитывая оценки при нескольких сдвигах границ фолдов. Именно для этого предназначен аргумент n_offsets функции selection_optimism_curve; при шестидесяти испытаниях, прежде чем доверять оценке, следует добиться длины вектора более шестидесяти.
Если оценка ограничена рангом, выбор подходящего запасного варианта зависит от того, в какую сторону вы готовы допустить ошибку. Фактическое число испытаний служит консервативной верхней границей: оно дает чрезмерную поправку на множественные испытания, из-за чего можно отклонить действительно хорошую стратегию. Оценка по собственным значениям служит нижней границей: она дает недостаточную поправку на множественные испытания, из-за чего можно принять действительно плохую стратегию. При принятии решений о внедрении стратегии предпочитайте консервативный подход и используйте фактическое число испытаний. Для исследовательских решений — когда нужно понять, какую область фактически охватил поиск, — оценка эффективного числа испытаний более информативна даже при ограничении рангом, если трактовать ее как нижнюю границу, а не как точечную оценку.
Медианный протокол: когда его применение действительно допустимо
Коули и Тэлбот посвящают раздел 5.2 протоколу, в котором гиперпараметры настраиваются на первых нескольких фолдах, вычисляется медиана, а затем для каждого фолда рассчитывается оценка с использованием этих зафиксированных значений. На одиннадцати из тринадцати эталонных задач этот протокол дает оптимистическое смещение оценки; на четырех из них смещение превышает типичную разницу между конкурирующими классификаторами. При этом величина смещения различается для разных алгоритмов, поэтому протокол даже не позволяет правильно ранжировать методы. Они пришли к выводу, что его использование следует прекратить.
Три протокола оценки и их торговые аналоги
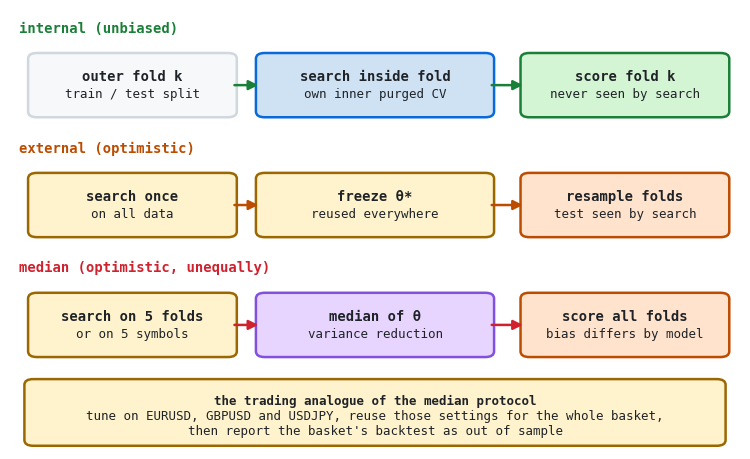
Рисунок 7. Схема из трех строк, иллюстрирующая внутренний, внешний и медианный протоколы оценки
- Строка 1: внутренний протокол. Для каждого внешнего фолда выполняется отдельный внутренний поиск с очисткой, а оценка на этом фолде получается с помощью модели, которая не использовала его данные. Это 16-я часть.
- Строка 2: внешний протокол. Один поиск по всем данным, фиксация настроек, а затем повторное формирование фолдов, тестовые данные которых уже использовались при подборе этих настроек.
- Строка 3: медианный протокол. Провести поиск на нескольких фолдах, взять медианные значения гиперпараметров и оценить качество на всех фолдах. К смещению внешнего протокола добавляется снижение дисперсии.
- Выноска: вариант, встречающийся в торговой практике, где роль фолдов играют торговые инструменты, а не временные блоки.
Этот вариант для торговли стоит упомянуть отдельно, поскольку внешне он не похож на процедуру, от которой предостерегают. Подберите настройки на EURUSD, GBPUSD и USDJPY; выберите те, что сработали на всех трех парах; протестируйте всю корзину с этими настройками; представьте результаты бэктеста корзины как вневыборочные. Здесь присутствуют все элементы медианного протокола. Три торговых инструмента, на которых подбираются настройки, коррелируют с остальной корзиной, поэтому их тестовые данные нельзя считать «чистыми», а выбор согласованных настроек по трем инструментам — это шаг по снижению дисперсии, который приукрашивает результат точно так же, как медиана по фолдам.
Именно здесь вывод научной работы требует оговорки, которой в ней нет, и это единственный пункт, по которому я в этой статье возразил бы ее авторам. Смещение, которое демонстрируют Коули и Тэлбот, — это смещение публикуемой числовой оценки. В каждом своем эксперименте они измеряют разницу между долями ошибок, оцененными по двум протоколам. Это аргумент против медианного протокола как процедуры оценки, но он ничего не говорит об агрегировании как решении для практического применения.
После того как оценка вложенной кросс-валидации честно представлена, ни один опубликованный показатель не зависит от того, как были выбраны гиперпараметры модели для внедрения. На этом этапе агрегирование гиперпараметров победителей по фолдам — это способ снижения дисперсии, применяемый к решению, а не к оценке; он обоснован по той же причине, по которой медианный протокол приукрашивает результаты: медиана нескольких наборов гиперпараметров, выбранных под влиянием шума, обычно лучше любого из них по отдельности. Однако само по себе это не подтверждает качество внедренной модели. Оценка вложенной кросс-валидации корректна для той процедуры, которую оценивал вложенный цикл, — поиска и обучения внутри каждого внешнего фолда. Модель с агрегированными параметрами получается в результате другой процедуры: берутся медианы гиперпараметров победителей по фолдам, после чего модель заново обучается на всей выборке. Ничто в этой статье не подтверждает, что качество такой модели соответствует оценке вложенной кросс-валидации; если планируется сообщить оценку качества внедренной модели, ее необходимо получить отдельно на данных, не использовавшихся при построении модели. Мы можем сделать лишь более узкое утверждение: гиперпараметры внедренной модели выбраны без искажения оценки вложенной кросс-валидации, если соблюдена приведенная ниже последовательность действий.
Это правило задает последовательность действий, а не запрет. Агрегируйте гиперпараметры только после представления оценки, никогда не раньше, и никогда не вычисляйте оценку заново с агрегированными гиперпараметрами.
Функция aggregate_fold_params реализует этот подход с корректной обработкой типов, которую упускает очевидный вариант реализации. Функция statistics.median в Python для списка целых чисел четной длины возвращает среднее двух центральных значений, поэтому median([3, 4]) равно 3.5, а max_depth=3.5 вызывает исключение в scikit-learn; при этом четное число внешних фолдов — обычный случай. Булевы значения — вторая ловушка: в Python выражение isinstance(True, int) возвращает True, поэтому при наивной реализации ветви обработки числовых значений флаги bootstrap незаметно усредняются. Значения целочисленных параметров округляются обратно до целых чисел, булевы значения выбираются большинством голосов, а для категориальных параметров и параметров, среди значений которых встречается None, берется мода.
Одно ограничение, которое обработка типов не устраняет: условные гиперпараметры. Если допустимые значения одного параметра зависят от значения другого — например, когда выбор ядра определяет, применим ли параметр gamma, — независимое вычисление медиан для каждого параметра может привести к недопустимой комбинации. Эта функция не выявляет такие случаи, и без схемы зависимостей этого не сможет сделать ни одна функция агрегирования. Перед обучением проверьте агрегированные параметры и, если пространство поиска содержит условные параметры, выполняйте агрегирование отдельно в каждой условной ветви, а не по всему набору.
nested_score = report_nested_cv(...)          # publish this, and only this

deploy_params = aggregate_fold_params(        # then choose what to ship
    [fold["best_params"] for fold in outer_results],
    numeric_agg="median",
)
final_model = clone(estimator).set_params(**deploy_params).fit(X_all, y_all, sample_weight=sw_all)
export_onnx(final_model, "EURUSD_H1.onnx")
Альтернатива агрегированию — ансамбль из M лучших моделей, описанный в предыдущем разделе: он полностью снимает проблему выбора, поскольку гиперпараметры лидеров не сводятся к одному вектору. Предпочитайте ансамбль, если затраты на получение прогнозов это позволяют, а полоса допуска широка; выбирайте агрегирование, если один граф ONNX — жесткое требование.
Проведение аудита на собственных барах
Описанное выше исследование проведено на смоделированных данных, и его следует рассматривать как демонстрацию механизма, а не как установление факта о каком-либо рынке. Это соответствует структуре исходной статьи: Коули и Талбот демонстрируют переобучение при отборе моделей на синтетическом тестовом наборе данных с известной истиной, а затем в отдельном разделе показывают, что эта проблема действительно актуальна и на реальных данных. Часть исследования на синтетических данных объясняет механизм, а часть на реальных данных позволяет решить, нужно ли принимать меры. Численные значения на рисунках 3–5 нельзя напрямую переносить на другие данные. На реальных данных при сильном сигнале, стабильном режиме или корректно специфицированной модели коэффициент разрешения может значительно превышать единицу, корреляция между внутренним критерием и качеством на отложенном блоке может быть положительной, а расширение пространства поиска — вполне оправданным. Проведите аудит, чтобы получить ответ для ваших данных.
Для аудита не требуется ничего из имитационного моделирования. Для аудита нужны матрица признаков, бинарные метки, ряд временных отметок окончания событий для очистки и, при необходимости, веса наблюдений; все они должны иметь общий индекс. Прилагаемый скрипт run_real_audit.py принимает файл с барами и выводит три ключевых показателя.
python run_real_audit.py --parquet /data/eurusd_h1.parquet --n-trials 60 --n-resamples 10
Замените в этом скрипте блок-заглушку на рабочую матрицу признаков и события, сформированные методом тройного барьера из части 2, и полученные значения будут характеризовать конвейер, который действительно внедряется, а не его приближенную модель. Перед запуском следующего поиска стоит ответить на три вопроса:
- Каков коэффициент разрешения по набору реальных событий? Если он ниже единицы, выбор текущих гиперпараметров равносилен подбрасыванию монеты, а бюджет поиска тратится впустую.
- Остается ли корреляция между внутренним критерием и качеством на отложенном блоке положительной, в том числе при нескольких разных временных точках привязки? Единственное отрицательное значение на реальных барах — предупреждение, а не доказательство; отрицательное значение, воспроизводящееся при нескольких временных точках привязки, — гораздо более весомый аргумент. Учтите также, что и смена режима, и переобучение при отборе моделей снижают эту корреляцию, а измерение на одном разбиении не позволяет отделить их влияние друг от друга.
- Каково накопленное в исследовании эффективное число испытаний и меняет ли учет этого числа при расчете дефлированного коэффициента Шарпа какие-либо из уже сделанных выводов?
Одно предостережение по поводу оценки качества. В качестве критерия следует использовать логарифмическую функцию потерь или оценку Брайера, а не F1 или долю правильных ответов. Метрика, использующая порог, разрывна по параметрам модели и имеет заметно более высокую дисперсию, чем правильное правило оценивания на тех же фолдах, а это нежелательное свойство для величины, дисперсия которой и является предметом анализа. Выбрать критерий с высокой дисперсией, а затем провести аудит его дисперсии — значит заранее предопределить ответ.
Заключение
В части 16 была обеспечена корректность сообщаемой численной оценки. В этой статье рассматривается процесс, который характеризует эта численная оценка.
Ключевой показатель, определяющий все остальное, — коэффициент разрешения: разброс оценок кандидатов, заданных конфигурациями гиперпараметров, деленный на собственный разброс критерия по допустимым повторным разбиениям тех же данных. В данном исследовании этот показатель составил 0.49, и из него вытекали все последующие симптомы. Кандидат, соответствующий аргмаксимуму, совпал с лучшим в среднем по разбиениям кандидатом лишь на одном из восьми разбиений. Внутренний критерий отрицательно коррелировал с качеством на отложенном блоке, хотя скрытая смена режима в симуляции — смешивающий фактор, влияние которого при единственном разбиении невозможно отделить от переобучения при отборе моделей. Расширение пространства поиска с двух до шести параметров улучшило значение критерия, но при данном бюджете и на этих данных привело к потере 0.019 ната на данных вне выборки.
Из этого следуют три изменения. Сократите число гиперпараметров, по которым ведется поиск, поскольку при фиксированном бюджете пространство поиска может влиять на результат сильнее, чем любой отдельный параметр в нем. Проводите отбор по скорректированному правилу одной стандартной ошибки и останавливайте поиск, когда улучшения становятся меньше уровня шума критерия: оба подхода отказываются проводить различия между кандидатами, которых данные не позволяют различить. Также учитывайте испытания гиперпараметров при расчете дефлированного коэффициента Шарпа, уменьшая их учитываемое число с поправкой на корреляцию между ними: в данном случае их исключение привело к занижению порога коэффициента Шарпа примерно на 0.4–0.6. Каждая из этих мер — эвристика, обоснованная описанным выше механизмом, а не теорема, и каждую следует повторно проверять на тех данных, к которым ее применяют.
Это исследование не устанавливает ни величину эффекта для какого-либо конкретного торгового инструмента, ни оптимальность перечисленных выше мер для какого-либо конкретного конвейера обработки данных и моделирования. Исследование проводилось на имитационной модели рынка, выбранной так, чтобы эффект ощутимо проявлялся; пороги заданы из практических соображений, а не выведены теоретически, а приравнивание испытаний при поиске гиперпараметров (HPO) к испытаниям бэктестов при расчете DSR — консервативная мера предосторожности. Демонстрируемый им механизм носит общий характер. В разделе 11 описано, как воспроизвести исследование на реальных барах, и именно такому варианту стоит доверять.
Прикрепленные файлы
| Файл | Описание |
|---|---|
| selection_overfit.py | Модуль: OffsetPurgedKFold, criterion_variance_audit, selection_optimism_curve, effective_trial_count, expected_max_sharpe, one_standard_error_selection, HPOEarlyStopping, aggregate_fold_params, top_m_ensemble |
Список литературы
- Коули, Г. К. и Тэлбот, Н. Л. С. (2010) «О переобучении при отборе моделей и последующем смещении оценки качества вследствие отбора», Journal of Machine Learning Research, т. 11, с. 2079–2107. Журнал исследований в области машинного обучения, т. 11, с. 2079–2107.
- Лопес де Прадо, М. (2018), «Достижения в области финансового машинного обучения», главы 7 и 8.
- Ли, Дж. и Цзи, Л. (2005), Корректировка множественного тестирования в многолокусном анализе с использованием собственных значений корреляционной матрицы, Heredity 95, 221–227.
- Киш, Л. (1965), «Выборочные обследования».
- Мастерс, Т. (1995), «Усовершенствованные алгоритмы для нейронных сетей».
Перевод с английского произведен MetaQuotes Ltd.
Оригинальная статья: https://www.mql5.com/en/articles/24238
Предупреждение: все права на данные материалы принадлежат MetaQuotes Ltd. Полная или частичная перепечатка запрещена.
Данная статья написана пользователем сайта и отражает его личную точку зрения. Компания MetaQuotes Ltd не несет ответственности за достоверность представленной информации, а также за возможные последствия использования описанных решений, стратегий или рекомендаций.


