

Разработка библиотеки для создания PDF-файлов на MQL5 (Часть 2): Почему PDF-файлы повреждаются
 17
 0

Содержание
- Введение
- Где мы сейчас
- Программа просмотра читает PDF-файл в обратном порядке
- Таблица представляет собой набор обещаний
- Двадцать байтов, один из них невидим
- Намеренно повреждаем файл
- Как на это реагируют реальные программы просмотра
- Четыре проверки
- Код
- О чем говорится в отчете
- Когда что-то идет не так
- Шпаргалка
- Структура проекта
- Заключение
Введение
PDF-файл может открываться без проблем, правильно отображать каждую строку текста и при этом содержать структурные ошибки, которые остаются совершенно незамеченными. Это одна из причин, по которым PDF считается форматом, с которым сложно работать. Сам по себе формат довольно прост. А вот учет служебных данных сложен, и сбои в нем могут оставаться незамеченными. В части 1 мы создали PDF-файл вручную. Его размер составлял 592 байта, он содержал пять объектов и открывался во всех программах просмотра, которые мы тестировали. Но этот небольшой файл был чувствителен к изменениям: семь чисел в нем задавали байтовые смещения, и изменение всего одного символа текста могло сделать несколько из них неверными. Документ мог по-прежнему выглядеть именно так, как и ожидалось, несмотря на то, что его внутренние ссылки больше не соответствовали его фактическому содержанию.
В этой статье мы исследуем эту чувствительность к изменениям с помощью практического эксперимента. Мы намеренно повредим один и тот же PDF-файл тремя разными способами и откроем каждый измененный файл в двух независимых реализациях формата PDF. Обе реализации примут все три файла, и каждая по-прежнему позволит получить из них правильный текст. Ни одна из реализаций не откажется обрабатывать файл, а единственным признаком повреждения станет набор предупреждений, которые одна из них выводит лишь при явно включенном выводе предупреждений. Главный вывод прост: то, что PDF-файл открывается, еще не означает, что его структура правильная. Понимание этого различия имеет решающее значение при разработке инструментов, предназначенных для создания или обработки файлов PDF.
К концу статьи мы разработаем PdfValidate.mqh — класс проверки, который считывает PDF-файл, проверяет четыре структурных свойства, на которые полагаются программы просмотра PDF, и сообщает о несоответствиях с указанием номера затронутого объекта, ожидаемого и фактического байтовых смещений. Валидатор также можно использовать для проверки PDF-файлов, созданных другими инструментами, если в них используется классическая таблица перекрестных ссылок; конструкции, которые он отказывается читать, перечислены рядом с кодом. Этот класс станет важной основой для дальнейшей работы в остальных частях серии. Начиная с части 3, наша библиотека будет автоматически вычислять эти байтовые смещения, и нам понадобится независимый способ проверки правильности этих вычислений.
Где мы сейчас
В части 1 мы вручную создали файл hello.pdf и написали скрипт Demo01_HelloPdf.mq5 для его воспроизведения средствами MQL5. В этой части мы повторно используем тот же файл без изменений, повредим его копии и добавим первый файл, который останется в библиотеке до конца серии.
Программа просмотра читает PDF-файл в обратном порядке
Прежде чем что-либо повредить, стоит узнать, что на самом деле делает программа просмотра, когда вы дважды щелкаете по PDF-файлу: порядок ее действий многих удивляет и объясняет, какие повреждения критичны, а какие не мешают обработке файла.
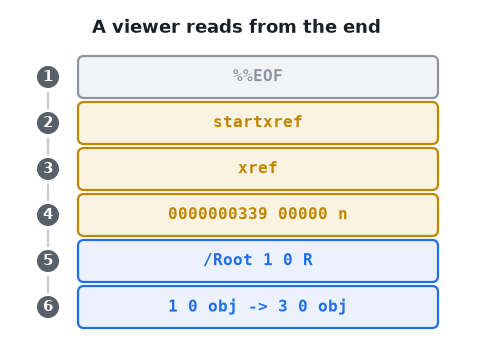
Рисунок 1. Программа просмотра начинает работу с конца файла и просматривает его в обратном порядке.
На рисунке 1 перечислены шесть элементов, которые ищет программа просмотра, в порядке их поиска. Рассмотрим их по порядку сверху вниз. Программа просмотра переходит в конец файла и читает его в обратном направлении в поисках startxref. Она берет следующее за ним число и переходит к байту с этим смещением, ожидая найти слово xref. Она читает расположенную там таблицу байтовых смещений, затем — трейлер сразу под ней, где запись /Root 1 0 R указывает на каталог. Только теперь, на шаге 6, программа просмотра обращается к объекту — и находит объект 1 по записи 1 в только что прочитанной таблице.
Шаги с 1 по 4 — это исключительно учет служебных данных. Ни содержимого, ни отрисовки, ни шрифтов. Четыре из шести операций, которые программа просмотра выполняет, прежде чем сможет отобразить хотя бы один символ, — это арифметические действия с байтовыми смещениями, и все четыре выполняются над числами, которые генератор должен был правильно вычислить.
Этим же объясняется высокая скорость работы с большими документами PDF. Программа просмотра, открывая страницу 400 в отчете на 600 страниц, не читает первые 399 страниц: она читает индекс, находит в нем нужный объект и переходит прямо к нему. Цена такой скорости заключается в том, что индекс должен быть точным.
Таблица представляет собой набор обещаний
Ниже таблица из hello.pdf показана рядом с файлом, который она описывает.
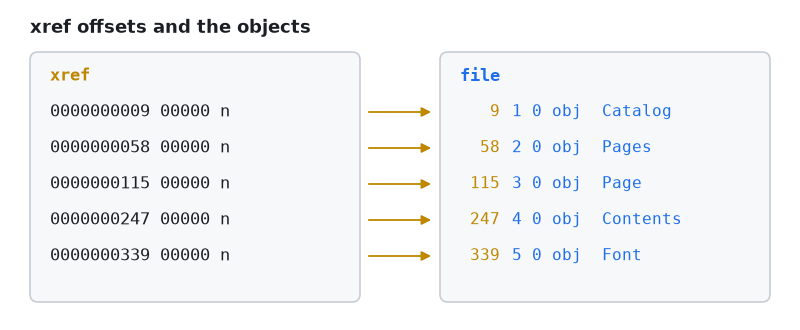
Рисунок 2. Каждая запись указывает байтовое смещение, которое может соответствовать фактическому расположению объекта в файле, а может и не соответствовать.
Обратите внимание на стрелки на рисунке 2. За каждой стрелкой — обычное целое число и утверждение: «объект 5 начинается с байта 339». А теперь посмотрите, чего не хватает. Объект 5 не содержит своего собственного адреса. Ничто внутри 5 0 obj не сообщает: «Я нахожусь по смещению 339». Указание на положение объекта и сам объект хранятся в двух разных местах, на расстоянии сотен байтов друг от друга, без контрольной суммы, поля длины или маркера, которые связывали бы их между собой.
В этом и заключается структурная слабость, которую стоит сформулировать как правило: в PDF положение — это метаданные. Большинство остальных структур формата имеют собственные разделители: словарь ограничен << и >>, строка — скобками, а объект — ключевыми словами obj и endobj. Исключением являются данные потока, поскольку их размер определяется параметром /Length, а не разделителем. Но сведения о том, где что находится, никогда не содержатся в самих структурах, и именно от этих сведений формат зависит больше всего.
Удачная аналогия: объекты — это книги на полке, а таблица перекрестных ссылок — библиотечный каталог, в котором для каждой книги указано расстояние в сантиметрах от левой стены. Вставьте на полку еще одну книгу — и все расстояния справа от нее окажутся неверными, хотя ни одну карточку каталога не трогали и все книги по-прежнему на полке.
Двадцать байтов, один из них невидим
Вторая ловушка кроется в структуре записи xref, а не в ее значении. Все, что изложено в этом разделе, относится к классической таблице перекрестных ссылок — именно ее создает код из этой серии статей; начиная с PDF 1.5 индекс может вместо этого храниться в виде сжатого потока перекрестных ссылок, который рассматривается в части 35.
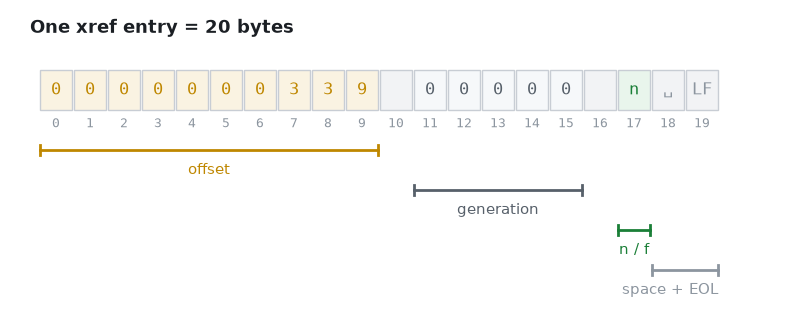
Рисунок 3. Фиксированная структура записи xref, байт за байтом.
Подсчитайте количество клеток на рисунке 3. Десять цифр байтового смещения, пробел, пять цифр номера поколения, пробел, одна буква флага и затем двухбайтовое окончание строки. Спецификация допускает три варианта такого окончания: пробел и возврат каретки, пробел и перевод строки или возврат каретки и перевод строки; поэтому наличие концевого пробела в записи зависит от того, какой вариант выбрал генератор. Неизменной остается общая длина: всегда двадцать байтов, независимо от того, насколько малы числа. Для объекта 1 с байтовым смещением 9 это смещение записывается как 0000000009 — с восемью ведущими нулями, которые не несут никакой информации.
Дополнение нулями — не украшение. Именно это позволяет переходить к нужной записи напрямую. Программа просмотра, которой нужен объект 340, не читает 339 записей, чтобы добраться до него: в таблице с одним нумерованным подразделом, начинающимся с объекта 0, — именно такие таблицы мы создаем в этой серии статей — она умножает 340 на 20, прибавляет результат к позиции первой записи и переходит по полученному смещению. Для таблицы, разбитой на несколько нумерованных подразделов, требуется еще одно сложение, но принцип вычислений тот же. Тот же прием используется при обращении к массиву по индексу, и именно поэтому формат допускает расходовать по восемь нулей на каждую запись.
Поэтому двадцатый байт имеет критическое значение. На рисунке 3 показана структура, используемая в наших файлах: байт с индексом 18 — обычный пробел, а байт с индексом 19 — перевод строки, так что запись состоит из девятнадцати видимых символов и одного перевода строки. Удалите этот пробел, который не отображается ни в одном текстовом редакторе, — казалось бы, просто наведите порядок, — и длина каждой записи сократится до девятнадцати байтов. Теперь при каждом переходе, рассчитанном программой просмотра, ошибка в позиции увеличивается на один байт с каждой следующей записью, и уже на пятой записи программа читает цифры из середины соседней строки. В файле с окончаниями строк \r\n нет концевого пробела, который можно было бы удалить, но уязвимость та же: удаление любого из двух символов окончания строки приводит к такому же нарастающему смещению.
Осталось разобраться с последним обозначением — f в первой записи. n означает, что объект используется; f — что он свободен, то есть удален. Свободные записи образуют связный список, а 0000000000 65535 f — его голова: смещение равно нулю, а номер поколения — 65535, то есть максимальному значению, которое может содержать это поле. Этот механизм позволяет повторно использовать номер объекта при редактировании файла на месте, а в файле, который мы создаем с нуля, эта запись неизменна. Скопируйте эту запись и двигайтесь дальше.
Намеренно повреждаем файл
А теперь эксперимент. Берем файл hello.pdf и создаем три его копии, в каждую из которых вносим повреждение одного определенного типа.
Первый случай встречается на практике. Никто случайно не редактирует таблицу перекрестных ссылок; люди редактируют текст и забывают, что у текста есть размер.
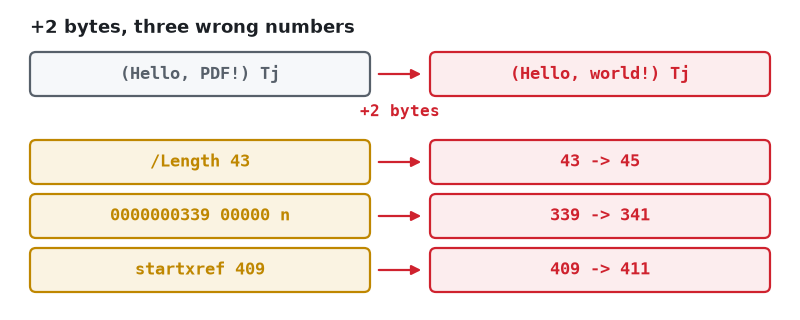
Рисунок 4. Два лишних символа искажают три числа, которые никто не редактировал.
Рассмотрите рисунок 4, начиная сверху. Мы заменяем (Hello, PDF!) Tj на (Hello, world!) Tj. Это на два символа больше. Теперь проследим последствия по левой колонке, в которой мы ничего не меняли:
- /Length 43 в объекте 4 задавало длину потока, которая теперь составляет 45 байт.
- Значение 0000000339 указывало, что объект 5 находится по байтовому смещению 339; все, что расположено после потока, сдвинулось, поэтому теперь его байтовое смещение равно 341.
- startxref 409 указывало, что таблица начинается по байтовому смещению 409; теперь она начинается по смещению 411.
Три числа — и все неверные из-за одной правки, которая ни одного из них не касалась. В этом рисунке — вся проблема, которой посвящен цикл статей, и именно ради ее решения нужна часть 3.
Во втором случае повреждение создается удалением концевого пробела из каждой записи xref, как описано выше. В третьем случае startxref указывает на байт 400 вместо 409, то есть в середину объекта 5 — такое повреждение может возникнуть у любого генератора, который изменяет файл после вычисления байтовых смещений.
Как на это реагируют реальные программы просмотра
И вот здесь статья перестает быть чисто теоретической. Мы открыли все четыре файла с помощью двух независимых реализаций: PDFium — движка рендеринга, который Chrome и Edge используют для отображения PDF, и pypdf — библиотеки Python, которую программные инструменты используют для чтения и перезаписи структуры PDF, а не для отображения документа. pypdf явно разбирает эту структуру и в режиме по умолчанию восстанавливает то, чему не может доверять, вместо того чтобы отклонять файл; в строгом режиме, который мы здесь не используем, те же несоответствия приводят к ошибкам. Две реализации и четыре небольших файла — это демонстрация, а не обзор: далее описано поведение именно этих двух реализаций, а не всех средств обработки PDF.
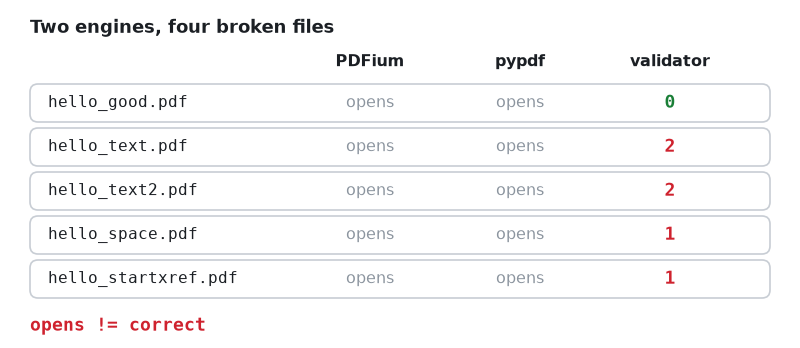
Рисунок 5. Каждый из поврежденных файлов открывается в обоих движках без видимых сообщений об ошибках.
В двух колонках рисунка 5, соответствующих движкам, значения совпадают во всех строках, а в последней колонке указано количество проблем, которые наш собственный валидатор обнаруживает в каждом файле. Каждый из файлов принимается. Из каждого файла по-прежнему получается правильный текст: PDFium отображает его, а pypdf извлекает. Файл hello_text.pdf отображает «Hello, world!» именно так, как задумано, несмотря на неверно указанную длину потока и startxref, указывающий в середину объекта.
Им это удается за счет отказа от индекса. Если программа просмотра не может разобраться в таблице, она переходит в режим восстановления: сканирует весь файл, начиная с нулевого байта, в поисках любых конструкций вида N 0 obj, строит собственную таблицу на основе найденных данных и продолжает работу. Наш валидатор использует такое же сканирование по той же причине.
pypdf делает то же самое, и если включить его предупреждения, он сообщит вам об этом:
incorrect startxref pointer(1)
Ignoring wrong pointing object 5 0 (offset 339)
Object 5 0 found
Обратите внимание на вторую строку: pypdf самостоятельно обнаружил тот же дефект, о котором сообщает наш валидатор, — неверное смещение 339 для объекта 5, — а затем обошел эту проблему и продолжил работу. Эти предупреждения — единственный признак проблемы, а при настройках предупреждений по умолчанию вызывающий код вообще не получает о ней никаких сообщений.
Такое поведение — любезность со стороны программы, а не гарантия. Спецификация не обязывает обрабатывающую PDF программу восстанавливать поврежденный файл, а ситуации, в которых на такую любезность уже нельзя рассчитывать, как раз важны для отчета, который вы кому-либо отправляете:
- Время сканирования линейно зависит от размера файла. Восстановление файла размером 400 байт происходит мгновенно. А вот восстановление отчета объемом 40 МБ, содержащего 60 000 объектов, уже не мгновенно, и некоторые инструменты ограничивают время этой операции.
- Восстановление опирается на предположения. Если номер объекта встречается дважды — такое бывает, когда генератор дописывает данные в конец файла, а не перезаписывает его, — при сканировании приходится выбирать один из двух объектов, и выбор может не совпасть с тем, на который указывает ваша таблица.
- Не все средства обработки PDF отображают содержимое. Инструменты предпечатной проверки, валидаторы PDF/A, системы архивирования и многие серверные библиотеки проверяют структуру файла, а не отображают его содержимое, и отвергают то, что программа просмотра прощает.
- Сжатый поток перекрестных ссылок невозможно восстановить с помощью такого сканирования. Начиная с PDF 1.5 сам индекс может находиться внутри сжатого объекта, и в части 35 этой серии используется именно этот формат. При сканировании по-прежнему можно найти объекты верхнего уровня с обычным заголовком N 0 obj, но у объектов, упакованных в поток объектов, такого заголовка нет, и соответствие между номером объекта и его местоположением теряется вместе с индексом.
Так что вывод не в том, что «программы просмотра прощают ошибки, можно расслабиться». Вывод в том, что программа просмотра — не средство проверки. Файл, который открывается на вашем компьютере, может незаметно для вас восстанавливаться при открытии, и вы узнаете об этом, когда система архивирования клиента его отклонит.
Четыре проверки
Нам нужна собственная проверка. Полезный валидатор не обязательно должен понимать весь формат. От четырех перечисленных ниже свойств зависят шаги 1–4 на рисунке 1; эти проверки также охватывают значения, которые вычисляет наш генератор и в которых он может ошибиться.
- Заголовок находится по байтовому смещению 0. %PDF- должны быть первыми пятью байтами файла. Маркер порядка байтов, стоящий перед ним, не отображается ни в одном из редакторов, которые его генерируют.
- startxref указывает на слово xref. Если это не так, таблицу найти невозможно, и единственный оставшийся способ найти объект — просканировать весь файл в поисках его заголовка.
- Запись i указывает на i 0 obj. Каждая запись занимает двадцать байт, поэтому к записям таблицы можно обращаться по индексу, не считывая ее последовательно. Здесь предполагается, что номер поколения равен 0: объект с большим номером поколения допустим, но эта проверка отметит его как ошибку.
- /Length задает расстояние до endstream. Если продвинуться вперед на объявленную длину, в этой позиции должно находиться ключевое слово.
Эти четыре проверки охватывают не все аспекты PDF, и их успешное прохождение — необходимое, но не достаточное условие корректности файла. Чтобы отобразить страницу, программе просмотра требуется гораздо больше: трейлер с пригодной для использования ссылкой /Root, каталог, дерево страниц, ресурсы, шрифты и потоки содержимого. Полная проверка структуры также включала бы словарь трейлера, синтаксис словарей, потоки объектов, потоки перекрестных ссылок, инкрементальные обновления, маркер %%EOF, номера поколений объектов и ссылки между объектами. Все это выходит за рамки рассматриваемой здесь проверки. Эти четыре проверки охватывают расчеты в байтах, которые генератор выполняет самостоятельно и в которых могут возникнуть наши собственные ошибки; нарушение любого из этих условий препятствует обычному открытию файла по индексу и может вынудить программу просмотра перейти в режим восстановления.
Код
PdfValidate.mqh — это первый файл, который остается в библиотеке. Это инструмент отладки, а не часть кода записи PDF, и его место в библиотеке оправданно: в каждой следующей части серии появляется новый способ получить поврежденный файл.
Файл начинается с защиты от повторного включения и двух ограничений:
//+------------------------------------------------------------------+
//|                                                  PdfValidate.mqh |
//+------------------------------------------------------------------+
#ifndef PDF5_VALIDATE_MQH
#define PDF5_VALIDATE_MQH

//--- A file with more objects than this is refused rather than risking a
//--- runaway loop on a file that is not a PDF at all.
#define PDF_MAX_OBJECTS 4096

//--- How far back from the end of the file we look for "startxref". The
//--- specification allows the trailer to be long, but in practice it is a
//--- few hundred bytes, and scanning the whole file backwards is wasteful.
#define PDF_TAIL_SCAN   2048
Оба ограничения нужны потому, что классу будут передаваться файлы, которые он сам не создавал, в том числе файлы, вообще не являющиеся PDF. Валидатор, который зависает при получении некорректных данных, хуже, чем отсутствие валидатора вообще, поэтому каждый цикл в файле имеет ограничение. Эти значения выбраны с учетом файлов, создаваемых в этой серии статей, и о них стоит знать, прежде чем передавать классу более крупные файлы: реальный отчет может содержать гораздо больше 4096 объектов, а длинный трейлер может отодвинуть startxref более чем на 2048 байт от конца файла. В обоих случаях класс отказывается от проверки или сообщает о проблеме, а не пытается угадать результат; в такой ситуации следует увеличить соответствующую константу, а не полагаться на заключение класса. Ради той же простоты размеры и смещения хранятся в переменных типа int, что ограничивает размер файлов, с которыми может работать класс, двумя гигабайтами.
Каждый результат проверки представляет собой небольшую структуру, а не строку, поэтому вызывающий код может не только выводить его, но и обрабатывать:
//+------------------------------------------------------------------+
//| One problem found in the file.                                   |
//+------------------------------------------------------------------+
struct SPdfProblem
  {
   string            message;    // what is wrong, in one sentence
   long              position;   // byte position it concerns, -1 if none
   int               object_no;  // object number it concerns, -1 if none
  };
Хранение позиции байта в отдельном поле, а не только в тексте сообщения, позволит модульным тестам из части 3 проверять, что «сбой произошел на байте 258», без сопоставления текста. Сообщение предназначено для человека, а два целых числа — для кода.
А теперь сам класс:
//+------------------------------------------------------------------+
//| CPdfValidator                                                    |
//+------------------------------------------------------------------+
class CPdfValidator
  {
private:
   uchar             m_data[];             // the whole file in memory
   int               m_size;               // its length in bytes

   //--- What the xref table claims.
   int               m_claimed[PDF_MAX_OBJECTS];
   int               m_claimed_count;

   //--- What a scan of the file actually finds.
   int               m_actual[PDF_MAX_OBJECTS];
   int               m_actual_count;

   SPdfProblem       m_problems[];
   int               m_problem_count;
Два массива, расположенные рядом: то, что обещает таблица, и то, что содержится в файле. Практически каждое полезное сообщение, генерируемое этим классом, является результатом их сравнения. Валидатор, который проверяет только то, «указывает ли запись № 5 на объект № 5», может сообщить об ошибке; а валидатор, который хранит оба числа, может подсказать способ исправления — в этом и заключается разница между инструментом на один раз и тем, которым продолжают пользоваться.
   //--- byte level helpers
   bool              Load(const string filename);
   int               Find(const string needle, const int from) const;
   int               FindLast(const string needle, const int from) const;
   bool              Match(const string needle, const int at) const;
   string            Text(const int at, const int length) const;
   int               ReadInt(const int at, int &end) const;
   int               SkipSpace(const int at) const;

   //--- the four checks
   void              CheckHeader(void);
   int               CheckStartXref(void);
   void              CheckXrefTable(const int xref_pos);
   void              CheckOffsets(void);
   void              CheckStreams(void);

   //--- a full scan, used to say what the offsets should have been
   void              ScanObjects(void);

   void              Problem(const string message, const long position = -1,
                             const int object_no = -1);

public:
                     CPdfValidator(void) { Reset(); }

   void              Reset(void);
   bool              Check(const string filename);

   int               ProblemCount(void) const { return(m_problem_count); }
   SPdfProblem       ProblemAt(const int i) const { return(m_problems[i]); }
   int               ObjectCount(void) const { return(m_actual_count); }

   //--- Named ByteCount and not FileSize: a method called FileSize would
   //--- hide the terminal's FileSize() function inside every method of
   //--- this class, and Load() needs to call it.
   int               ByteCount(void) const { return(m_size); }

   void              PrintReport(const string filename);
  };
Этот комментарий к последнему методу стоит прочитать дважды. Здесь описывается реальное поведение MQL5, а не стилистические предпочтения. Функция-член с именем FileSize скрывала бы глобальную функцию FileSize() во всех методах класса. Методу Load() нужна именно глобальная функция. Сообщение об ошибке компилятора касается количества аргументов и вообще не упоминает сокрытие имени.
Чтение файла//+------------------------------------------------------------------+ //| Reads the whole file into memory. | //+------------------------------------------------------------------+ bool CPdfValidator::Load(const string filename) { int handle = FileOpen(filename, FILE_READ | FILE_BIN); if(handle == INVALID_HANDLE) { Problem(StringFormat("cannot open %s, error %d", filename, GetLastError())); return(false); } m_size = (int)FileSize(handle); if(m_size <= 0) { FileClose(handle); Problem("the file is empty"); return(false); } ArrayResize(m_data, m_size); int read = (int)FileReadArray(handle, m_data, 0, m_size); FileClose(handle); if(read != m_size) { Problem(StringFormat("read %d bytes of %d", read, m_size)); return(false); } return(true); }
Весь файл помещается в память. Это не лень: на рисунке 1 было показано, что при чтении PDF сначала обращаются к концу файла, а затем к его началу, поэтому программе потокового чтения пришлось бы сразу же переместиться назад. Чтение в массив uchar с помощью FileReadArray также означает, что каждая указанная нами позиция — это реальная позиция в байтах, на которую читатель сможет ориентироваться при поиске в шестнадцатеричном редакторе.
Обратите внимание, что метод Load вызывает Problem() до того, как будет задано значение m_size. Это безопасно, поскольку метод Reset() уже очистил список; благодаря этому при попытке открыть несуществующий файл формируется отчет, а не просто возвращается false без каких-либо пояснений.
Поиск элементов в массиве байтов
В MQL5 есть хорошие функции для работы со строками, но мы не можем их использовать: преобразовывать 40 МБ двоичных данных в строку ради вызова StringFind было бы и медленно, и некорректно — нулевой байт внутри изображения обрезал бы строку. Таким образом, этот класс содержит четыре небольших примитива, работающих с байтами.
//+------------------------------------------------------------------+
//| True when the bytes at `at` equal `needle`.                      |
//+------------------------------------------------------------------+
bool CPdfValidator::Match(const string needle, const int at) const
  {
   int n = StringLen(needle);
   if(at < 0 || at + n > m_size)
      return(false);

   for(int i = 0; i < n; i++)
      if(m_data[at + i] != (uchar)StringGetCharacter(needle, i))
         return(false);
   return(true);
  }
Функция Match сравнивает литерал с байтами в указанной позиции. Каждое ключевое слово, которое мы ищем, — xref, obj, endstream — состоит из обычных символов ASCII, поэтому сравнение кодов символов с помощью функции StringGetCharacter дает точный результат. Именно проверка границ в первой строке позволяет безопасно вызывать эту функцию с позицией, прочитанной из поврежденного файла, что в данном случае является обычным сценарием.
//+------------------------------------------------------------------+
//| First position of `needle` at or after `from`, or -1.            |
//+------------------------------------------------------------------+
int CPdfValidator::Find(const string needle, const int from) const
  {
   int n = StringLen(needle);
   for(int i = MathMax(0, from); i + n <= m_size; i++)
      if(Match(needle, i))
         return(i);
   return(-1);
  }

//+------------------------------------------------------------------+
//| Last position of `needle` at or before `from`, or -1.            |
//+------------------------------------------------------------------+
int CPdfValidator::FindLast(const string needle, const int from) const
  {
   int n = StringLen(needle);
   for(int i = MathMin(from, m_size - n); i >= 0; i--)
      if(Match(needle, i))
         return(i);
   return(-1);
  }
Поиск в прямом и обратном направлениях: оба варианта реализованы на основе Match. Это наивный алгоритм, выполняющий сравнение в каждой позиции, и для валидатора это правильный выбор: файлы небольшие, шаблоны короткие, а реализация алгоритма Бойера — Мура добавила бы пятьдесят строк кода, которые сами могли бы содержать ошибки. Функция FindLast нужна лишь в одном месте — для поиска startxref с конца файла, что соответствует шагу 2 на рисунке 1.
Text используется исключительно для вывода фрагмента в сообщении читателю. Здесь важно экранирование. Без экранирования цитируемый 12-байтовый фрагмент может разбиться на несколько строк в журнале «Эксперты», а позиция байта — оказаться на отдельной строке.
//+------------------------------------------------------------------+
//| Skips spaces, tabs and line endings.                             |
//+------------------------------------------------------------------+
int CPdfValidator::SkipSpace(const int at) const
  {
   int i = at;
   while(i < m_size)
     {
      uchar c = m_data[i];
      if(c != ' ' && c != '\t' && c != '\r' && c != '\n')
         break;
      i++;
     }
   return(i);
  }

//+------------------------------------------------------------------+
//| Reads a decimal integer at `at`; `end` receives the position     |
//| just past the last digit. Returns -1 when there is no digit      |
//| there.                                                           |
//+------------------------------------------------------------------+
int CPdfValidator::ReadInt(const int at, int &end) const
  {
   int i = SkipSpace(at);
   int value = 0;
   bool any = false;

   while(i < m_size && m_data[i] >= '0' && m_data[i] <= '9')
     {
      value = value * 10 + (int)(m_data[i] - '0');
      any = true;
      i++;
     }

   end = i;
   return(any ? value : -1);
  }
Функция ReadInt() возвращает значение, а через параметр end — позицию после последней цифры, поскольку всякий раз, когда мы считываем число, нам сразу же нужно считать следующее: 0 6 в заголовке xref, затем смещение и номер поколения каждой записи. Возврат значения -1 вместо 0 в случае «отсутствия цифр» позволяет вызывающей стороне отличить startxref 0 от startxref, за которым следует мусор.
Проверка 1: заголовок//+------------------------------------------------------------------+ //| Check 1: the file must begin with the version marker. | //+------------------------------------------------------------------+ void CPdfValidator::CheckHeader(void) { if(Match("%PDF-", 0)) return; int found = Find("%PDF-", 0); if(found > 0) Problem(StringFormat("%%PDF- is at byte %d, not byte 0 - there are %d " "stray bytes in front of it", found, found), 0); else Problem("this file does not contain %PDF- at all", 0); }
Интерес здесь представляет средняя ветвь. Если префикс %PDF- присутствует, но не начинается с байта 0, мы указываем, сколько байтов находится перед ним, и это число служит диагнозом: 3 означает маркер порядка байтов UTF-8, 2 — маркер порядка байтов UTF-16, а любое другое значение — что файл был объединен с чем-то еще. Сообщение «неверный заголовок» привело бы к потере этой информации.
Проверка 2: startxref//+------------------------------------------------------------------+ //| Check 2: startxref, and where it points. | //+------------------------------------------------------------------+ int CPdfValidator::CheckStartXref(void) { int tail = MathMax(0, m_size - PDF_TAIL_SCAN); int at = FindLast("startxref", m_size - 1); if(at < 0 || at < tail) { Problem("no startxref keyword in the last " + IntegerToString(PDF_TAIL_SCAN) + " bytes of the file"); return(-1); }
Ключевое слово должно находиться вблизи конца файла. Поиск по всему файлу нашел бы startxref предыдущей редакции документа с инкрементальными обновлениями и выдал бы его вместо нужного; поэтому считается, что в файле, где единственный startxref находится в 30 КБ от конца, это ключевое слово отсутствует.
   int end = 0;
   int xref_pos = ReadInt(at + 9, end);      // 9 == StringLen("startxref")
   if(xref_pos < 0)
     {
      Problem("startxref is not followed by a number", at);
      return(-1);
     }

   if(xref_pos >= m_size)
     {
      Problem(StringFormat("startxref says %d but the file is only %d bytes",
                           xref_pos, m_size), at);
      return(-1);
     }

   if(!Match("xref", xref_pos))
     {
      Problem(StringFormat("startxref points at byte %d, which holds \"%s\" "
                           "and not \"xref\"", xref_pos,
                           Text(xref_pos, 12)), xref_pos);
      return(-1);
     }

   return(xref_pos);
  }
Три ошибки — три разных сообщения. В последнем сообщении приводятся двенадцать байтов, которые фактически находятся в указанной позиции, и этот фрагмент — самая полезная строка, выводимая классом: она сразу показывает, отличается ли позиция от нужной всего на несколько байтов или находится в совершенно другой области файла.
Проверка 3: таблица//+------------------------------------------------------------------+ //| Check 3a: read the table itself. | //+------------------------------------------------------------------+ void CPdfValidator::CheckXrefTable(const int xref_pos) { int end = 0; int first = ReadInt(xref_pos + 4, end); // 4 == StringLen("xref") int count = ReadInt(end, end); if(first < 0 || count < 0) { Problem("the xref table has no \"first count\" line", xref_pos); return; } if(first != 0) Problem(StringFormat("the table starts at object %d; this series only " "writes tables that start at 0", first), xref_pos); if(count > PDF_MAX_OBJECTS) { Problem(StringFormat("the table claims %d objects, which is more than " "this validator will read", count), xref_pos); return; }
Реальная таблица перекрестных ссылок может быть разбита на несколько нумерованных подразделов — 0 6, затем 12 3 — а этот валидатор обрабатывает только вариант с одним подразделом, который создается в этой серии статей. Лучше прямо указать это в сообщении, чем делать вид, что все в порядке: читатель, который проверяет этим инструментом файл, созданный другим генератором, должен знать, что инструмент отказался от проверки, а не признал файл корректным.
//--- The entries begin after the line ending that follows "first count".
   int at = end;
   while(at < m_size && (m_data[at] == '\r' || m_data[at] == '\n'))
      at++;

   m_claimed_count = 0;
   for(int i = 0; i < count; i++)
     {
      int entry = at + i * 20;
      if(entry + 20 > m_size)
        {
         Problem(StringFormat("the table is cut short after %d entries", i),
                 entry);
         return;
        }
Выражение at + i * 20 и есть суть рисунка 3, записанная в виде кода. Мы не читаем записи одну за другой, а обращаемся к ним по индексу, поскольку именно так делает программа просмотра. Валидатор, анализирующий записи построчно, без проблем принял бы записи длиной в девятнадцать байт и полностью пропустил бы вторую из трех наших ошибок.
      //--- Bytes 17 and 18 of every entry are the type flag and a space.
      //--- If they are not where they belong, the entries are not 20 bytes
      //--- long, and every entry after this one is being misread.
      uchar flag = m_data[entry + 17];
      if(flag != 'n' && flag != 'f')
        {
         Problem(StringFormat("entry %d does not have its type flag at byte "
                              "17 - the 20-byte rule is broken here, and "
                              "every entry below it is misaligned", i),
                 entry, i);
         return;
        }

      int unused = 0;
      int offset = ReadInt(entry, unused);
      m_claimed[m_claimed_count++] = (flag == 'f') ? -1 : offset;
     }
  }
Проверка байта с индексом 17 — это простой способ выявить нарушение правила двадцати байтов. Если записи имеют нужный размер, этот байт всегда равен n или f; если же нет, то уже через одну-две записи на этой позиции окажется цифра или символ окончания строки. Проверка останавливается при первом сбое и сообщает, что границы всех последующих записей смещены, поскольку пять сообщений подряд с бессмысленными смещениями заслонили бы единственный важный факт. Это проверка выравнивания, а не синтаксиса: десятизначное смещение, пятизначный номер поколения, разделители и точная последовательность окончания строки не проверяются по отдельности, поэтому запись длиной в двадцать байт, но с неверным внутренним форматом все равно проходит эту проверку.
Свободные записи хранятся со значением -1, а не 0. Для свободного объекта смещение 0 допустимо, и без этого разграничения приведенная ниже проверка выдавала бы сообщение «объект 0 не находится по байтовому смещению 0» для каждого корректного файла.
В поисках истины//+------------------------------------------------------------------+ //|Finds every "N 0 obj" in the file by reading it straight through. | //+------------------------------------------------------------------+ void CPdfValidator::ScanObjects(void) { m_actual_count = 0; ArrayInitialize(m_actual, -1); int at = 0; while(at < m_size && m_actual_count < PDF_MAX_OBJECTS) { int found = Find(" obj", at); if(found < 0) break;
Это режим восстановления — тот же резервный вариант, который использовали PDFium и pypdf на рисунке 5. Мы ищем " obj" с начальным пробелом, поэтому последовательность obj внутри endobj автоматически пропускается. Поиск выполняется побайтовым сканированием, а не синтаксическим анализом, поэтому та же последовательность внутри данных потока, строки или комментария принимается за заголовок объекта. Такой риск есть у любого инструмента, который восстанавливает таблицу этим способом; это цена резервного механизма, работающего даже тогда, когда индекс не работает.
      //--- Walk backwards over " 0" and the object number to find the
      //--- first byte of "N 0 obj", which is what the offset must name.
      int i = found;
      while(i > 0 && m_data[i - 1] == ' ')
         i--;
      while(i > 0 && m_data[i - 1] >= '0' && m_data[i - 1] <= '9')
         i--;                                    // generation number
      while(i > 0 && m_data[i - 1] == ' ')
         i--;

      int start = i;
      while(start > 0 && m_data[start - 1] >= '0' && m_data[start - 1] <= '9')
         start--;                                // object number

      int unused = 0;
      int number = ReadInt(start, unused);
      if(number > 0 && number < PDF_MAX_OBJECTS)
        {
         if(number >= m_actual_count)
            m_actual_count = number + 1;
         m_actual[number] = start;
        }

      at = found + 4;
     }
  }
Самая тонкая часть — проход назад: начиная с пробела перед obj, мы проходим номер поколения, пробел перед ним, а затем номер объекта, чтобы оказаться на первой цифре N. Первая цифра — это тот байт, на который должна указывать запись xref, поэтому ошибка в этом проходе дала бы смещения, систематически указывающие на несколько байтов раньше нужного места, и отчет, полный ложных срабатываний.
Поскольку значения в m_actual записываются по индексу, равному номеру объекта, а не добавляются в конец, при пропусках номеров в файле в массиве остаются незаполненные элементы; поэтому он инициализируется значением -1.
Сравнение двух индексов//+------------------------------------------------------------------+ //| Check 3b: does every claimed offset point at the right object? | //+------------------------------------------------------------------+ void CPdfValidator::CheckOffsets(void) { for(int i = 1; i < m_claimed_count; i++) { int offset = m_claimed[i]; if(offset < 0) continue; // a free entry, skip it string expected = IntegerToString(i) + " 0 obj"; if(offset >= m_size) { Problem(StringFormat("object %d is said to be at byte %d, past the " "end of a %d byte file", i, offset, m_size), offset, i); continue; } if(Match(expected, offset)) continue;
Проверка занимает одну строку: находится ли в указанной байтовой позиции текст "5 0 obj"? Все остальное в этом методе нужно для формирования понятного сообщения, если это не так.
      //--- Say what is there, and where the object really is.
      string found_here = Text(offset, 16);
      int real = (i < m_actual_count) ? m_actual[i] : -1;
      if(real >= 0)
         Problem(StringFormat("object %d: the table says byte %d, but \"%s\" "
                              "is there; the object is really at byte %d, a "
                              "difference of %+d", i, offset, found_here,
                              real, real - offset), offset, i);
      else
         Problem(StringFormat("object %d: the table says byte %d, but \"%s\" "
                              "is there, and the object is nowhere in the "
                              "file", i, offset, found_here), offset, i);
     }
  }
%+d выводит знак, поэтому сообщение заканчивается на +2 или -14, а не на число без знака. Когда генератор ошибается на постоянную величину — а это обычный случай, поскольку одна ошибка в начале файла одинаково сдвигает все последующие данные, — одно и то же значение +2 в каждой строке позволяет сразу выявить причину.
Проверка 4: длины потоков//+------------------------------------------------------------------+ //| Check 4: every /Length must match the bytes in its stream. | //+------------------------------------------------------------------+ void CPdfValidator::CheckStreams(void) { int at = 0; while(at < m_size) { int keyword = Find("stream", at); if(keyword < 0) break; //--- Skip the "stream" inside the word "endstream". if(keyword >= 3 && Match("endstream", keyword - 3)) { at = keyword + 6; continue; }
endstream содержит stream, поэтому при простом поиске каждый поток обнаруживается дважды. Проверка трех предшествующих байтов обходится дешевле любого более сложного подхода, а ее код легко читается. Как и при сканировании объектов, здесь выполняется побайтовый поиск, а не разбор на токены: последовательность stream внутри двоичных данных или строки может быть принята за ключевое слово, и требование наличия следующего за ней endstream снижает этот риск, но не устраняет его.
      //--- The dictionary with /Length is just above the keyword. Search
      //--- backwards for it rather than parsing the dictionary properly,
      //--- which Part 3 makes unnecessary by writing the value itself.
      int len_key = FindLast("/Length", keyword);
      if(len_key < 0)
        {
         Problem("a stream has no /Length above it", keyword);
         at = keyword + 6;
         continue;
        }

      int unused = 0;
      int claimed = ReadInt(len_key + 7, unused);   // 7 == "/Length"
Поиск /Length в обратном направлении вместо разбора словаря — это упрощение, о чем и говорится в комментарии. Такой подход дает сбой, если значение /Length потока задано косвенной ссылкой — /Length 9 0 R, что встречается в некоторых реальных файлах, — а также если словарь содержит /Length во вложенном подсловаре; если же в текущем словаре вообще нет /Length, поиск в обратном направлении может дойти до этого ключа в более раннем объекте. Все эти случаи не встречаются в файлах, создаваемых в рамках этой серии статей. Валидатор, который в такой ситуации молча выдает неверный результат, хуже того, чьи ограничения явно указаны в комментарии.
      //--- The stream data starts after the end-of-line that follows the
      //--- keyword. CR LF counts as one ending, not two.
      int data = keyword + 6;
      if(data < m_size && m_data[data] == '\r')
         data++;
      if(data < m_size && m_data[data] == '\n')
         data++;

      int stop = Find("endstream", data);
      if(stop < 0)
        {
         Problem("a stream is never closed by endstream", keyword);
         return;
        }
Именно два отдельных оператора if, а не конструкция с else if, позволяют учитывать CRLF как одно окончание строки. Ошибка в этой логике сдвигает начало данных на один байт, из-за чего проверка каждого потока в файле, созданном в Windows, сообщает о расхождении на один байт. Обратите внимание: спецификация требует окончания строки после ключевого слова stream, а этот код лишь пропускает его при наличии, не требуя его обязательного присутствия: даже если окончание строки отсутствует, длина потока все равно измеряется, и файл проходит проверку, если она совпадает с заявленной.
      //--- The test a viewer applies: step /Length bytes forward and see
      //--- whether "endstream" is sitting there. The specification allows
      //--- one optional end-of-line in front of the keyword that is not
      //--- counted in /Length, so both positions are accepted. Measuring
      //--- the distance to "endstream" and comparing it instead would call
      //--- a correct file wrong whenever that optional byte is present.
      int probe = data + claimed;
      int skip = probe;
      if(skip < m_size && m_data[skip] == '\r')
         skip++;
      if(skip < m_size && m_data[skip] == '\n')
         skip++;

      bool ok = (claimed >= 0 && probe <= m_size &&
                 (Match("endstream", probe) || Match("endstream", skip)));

      if(!ok)
        {
         int actual = stop - data;
         Problem(StringFormat("a stream declares /Length %d but endstream is "
                              "%d bytes further on, a difference of %+d",
                              claimed, actual, actual - claimed), len_key);
        }

      at = stop + 9;
     }
  }
Сначала этот блок был написан «очевидным» способом, но этот «очевидный» способ оказался неправильным. В первой версии измерялось расстояние от начала данных до endstream, из него исключалось завершающее окончание строки, а затем выполнялось сравнение. Этот код сообщал, что в hello.pdf — заведомо корректном файле, который открывается в любой программе просмотра, — длина потока на один байт больше заявленной.
Причина проста: спецификация допускает необязательное окончание строки перед endstream, которое не учитывается в /Length. В нашем файле этого необязательного байта нет; перевод строки перед endstream — последний байт самого содержимого, и /Length 43 его учитывает. Оба варианта допустимы, и с помощью измерений их не различить.
А вот переход вперед на /Length байт и проверка наличия endstream в этой позиции позволяют их различить. Именно так поступает и программа просмотра, а это более веская причина: цель этого класса — предсказать поведение программы просмотра, поэтому при наличии выбора он должен выполнять ту же проверку, что и она, а не другую, лишь внешне эквивалентную.
Выполнение проверок//+------------------------------------------------------------------+ //| Runs every check. Returns true when the file has no problems. | //+------------------------------------------------------------------+ bool CPdfValidator::Check(const string filename) { Reset(); if(!Load(filename)) return(false); ScanObjects(); CheckHeader(); int xref_pos = CheckStartXref(); if(xref_pos >= 0) { CheckXrefTable(xref_pos); CheckOffsets(); } CheckStreams(); return(m_problem_count == 0); }
Метод ScanObjects() выполняется первым, чтобы в каждом последующем сообщении можно было указать фактическое положение объекта. Проверки смещений пропускаются, если проверка startxref завершилась неудачей, поскольку без таблицы не с чем сравнивать — именно поэтому ошибки выявляются поэтапно, как показано в примере ниже. Метод CheckStreams() выполняется в любом случае, поскольку ему вообще не нужен индекс.
//+------------------------------------------------------------------+
//| Prints the findings to the Experts log.                          |
//+------------------------------------------------------------------+
void CPdfValidator::PrintReport(const string filename)
  {
   PrintFormat("--- %s: %d bytes, %d objects found by scanning",
               filename, m_size, MathMax(0, m_actual_count - 1));

   if(m_problem_count == 0)
     {
      Print("    no problems");
      return;
     }

   for(int i = 0; i < m_problem_count; i++)
     {
      string where = "";
      if(m_problems[i].position >= 0)
         where = StringFormat(" [byte %d]", m_problems[i].position);
      PrintFormat("    %d. %s%s", i + 1, m_problems[i].message, where);
     }
  }

#endif // PDF5_VALIDATE_MQH
В строке заголовка указывается количество объектов, полученное в результате сканирования, а не из таблицы, поскольку в случае повреждения таблицы именно это число является единственным, имеющим какой-либо смысл.
Воспроизведение поврежденийСкрипт Demo02_BreakIt.mq5 записывает корректный файл и четыре поврежденные копии. Он подключает HelloPdf.mqh — код создания PDF из части 1, перенесенный в заголовочный файл, чтобы его могли использовать оба демонстрационных скрипта; по сравнению с частью 1 в файл добавлена лишь защита от повторного включения, поэтому он указан в структуре проекта, но повторно здесь не приводится.
//+-------------------------------------------------------------------+
//| Break 1: make a string two characters longer.                     |
//+-------------------------------------------------------------------+
string BreakLongerText(void)
  {
   string s = BuildHelloPdf();
   StringReplace(s, "(Hello, PDF!) Tj", "(Hello, world!) Tj");
   return(s);
  }
Один вызов StringReplace, два лишних символа, три неверных числа. Больше ничего в этой функции не требуется, и в этом вся суть: чтобы создать поврежденный PDF, достаточно одной строки, причем ошибаться для этого не нужно.
//+-------------------------------------------------------------------+
//| Break 2: remove the trailing space from every xref entry.         |
//+-------------------------------------------------------------------+
string BreakLostSpace(void)
  {
   string s = BuildHelloPdf();
   StringReplace(s, "65535 f \n", "65535 f\n");
   StringReplace(s, "00000 n \n", "00000 n\n");
   return(s);
  }

//+------------------------------------------------------------------+
//| Break 3: point startxref at the wrong byte.                      |
//+------------------------------------------------------------------+
string BreakStartXref(void)
  {
   string s = BuildHelloPdf();
   StringReplace(s, "startxref\n409\n", "startxref\n400\n");
   return(s);
  }
Удаление пробелов выполняется двумя заменами, поскольку свободная запись заканчивается на f, а остальные — на n. Оба шаблона включают перевод строки, поэтому последовательность f , случайно встретившаяся внутри строки в другом месте файла, останется без изменений.
//+------------------------------------------------------------------+
//| Break 1, half repaired: the same two extra characters, with      |
//| startxref corrected to 411 and the table left alone.             |
//+------------------------------------------------------------------+
string BreakLongerTextRepaired(void)
  {
   string s = BreakLongerText();
   StringReplace(s, "startxref\n409\n", "startxref\n411\n");
   return(s);
  }
Именно этот четвертый вариант представляет интерес. В нем сначала изменяется текст, а затем startxref корректируется так, чтобы указывать на фактическую новую позицию таблицы, — вполне правдоподобное частичное исправление. Как видно из приведенного ниже отчета, устранение первой ошибки лишь выявляет следующую.
//+------------------------------------------------------------------+
//| Script entry point.                                              |
//+------------------------------------------------------------------+
void OnStart(void)
  {
   Print("Writing one good file and four broken ones:");

   WriteRawFile(path_folder + "hello_good.pdf",      BuildHelloPdf());
   WriteRawFile(path_folder + "hello_text.pdf",      BreakLongerText());
   WriteRawFile(path_folder + "hello_text2.pdf",     BreakLongerTextRepaired());
   WriteRawFile(path_folder + "hello_space.pdf",     BreakLostSpace());
   WriteRawFile(path_folder + "hello_startxref.pdf", BreakStartXref());

   Print("");
   Print("Open them all in a PDF viewer, then run Demo02_Validate.");
  }
Второй демонстрационный скрипт еще короче:
#include <MQLPDF/PdfValidate.mqh>

//--- Every article in the series writes under one shared root folder, with
//--- its own subfolder
#define PDF_ROOT_FOLDER  "MQLPDF"
#define PDF_SUB_FOLDER   "Part 02"
string path_folder = PDF_ROOT_FOLDER + "//" + PDF_SUB_FOLDER + "//";


//+------------------------------------------------------------------+
//| Checks one file and prints what it found.                        |
//+------------------------------------------------------------------+
void CheckOne(CPdfValidator &validator, const string name)
  {
   validator.Check(name);
   validator.PrintReport(name);
   Print("");
  }

//+------------------------------------------------------------------+
//| Script entry point.                                              |
//+------------------------------------------------------------------+
void OnStart(void)
  {
   CPdfValidator validator;


   CheckOne(validator, path_folder + "hello_good.pdf");
   CheckOne(validator, path_folder + "hello_text.pdf");
   CheckOne(validator, path_folder + "hello_text2.pdf");
   CheckOne(validator, path_folder + "hello_space.pdf");
   CheckOne(validator, path_folder + "hello_startxref.pdf");
  }
Один экземпляр валидатора проверяет все пять файлов, поскольку метод Check() вызывает метод Reset(). Именно эта единственная строка с вызовом CheckOne() превращает пример из демонстрации в инструмент: укажите любой другой PDF-файл в папке MQL5\Files, в том числе созданный другой программой, и отчет покажет результаты этих четырех проверок для него — но помните о перечисленных выше конструкциях, которые класс не обрабатывает.
О чем говорится в отчете
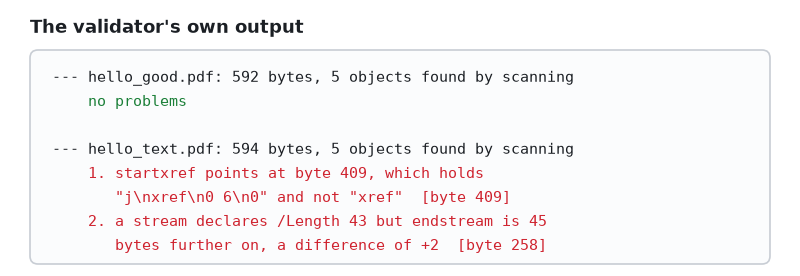
Рисунок 6. Вердикт валидатора там, где программы просмотра не вынесли своего.
Запуск Demo02_Validate для всех пяти файлов дает следующий результат:
--- hello_good.pdf: 592 bytes, 5 objects found by scanning
    no problems

--- hello_text.pdf: 594 bytes, 5 objects found by scanning
    1. startxref points at byte 409, which holds "j\nxref\n0 6\n0" and not
       "xref" [byte 409]
    2. a stream declares /Length 43 but endstream is 45 bytes further on, a
       difference of +2 [byte 258]

--- hello_text2.pdf: 594 bytes, 5 objects found by scanning
    1. object 5: the table says byte 339, but "j\n5 0 obj\n<< /Ty" is there;
       the object is really at byte 341, a difference of +2 [byte 339]
    2. a stream declares /Length 43 but endstream is 45 bytes further on, a
       difference of +2 [byte 258]

--- hello_space.pdf: 586 bytes, 5 objects found by scanning
    1. entry 1 does not have its type flag at byte 17 - the 20-byte rule is
       broken here, and every entry below it is misaligned [byte 438]

--- hello_startxref.pdf: 592 bytes, 5 objects found by scanning
    1. startxref points at byte 400, which holds ">\nendobj\nxre" and not
       "xref" [byte 400]
Рассмотрите первые два отчета вместе. В файле hello_text.pdf указано неверное значение startxref, поэтому таблица так и не была прочитана, а проверка смещений не выполнялась. Файл hello_text2.pdf — тот же файл, но с исправленным значением startxref, и теперь обнаруживается ошибка объекта 5: согласно таблице он находится на байте 339… фактически — на байте 341, разница составляет +2. Эта разница соответствует двум добавленным нами символам: вызванное ими смещение распространилось дальше по файлу именно так, как показано на рисунке 4.
Именно так, поэтапно, на практике восстанавливают поврежденный PDF-файл. Каждое исправление выявляет следующую проблему, поскольку программа просмотра, как и этот валидатор, останавливается на первой же проблеме, с которой не может справиться. Это также предостережение о тестировании: генератор, в котором исправляют лишь обнаруженную ошибку, будет создавать файлы, в которых сбой проявится на следующем, более глубоком уровне.
Третий отчет демонстрирует, как работает «правило двадцати байтов». Файл hello_space.pdf содержит пять абсолютно правильных байтовых смещений — мы ни одно из них не изменяли — и тем не менее он остается нечитаемым, поскольку записи имеют неправильный размер. Здесь нет сообщения о неправильном смещении, и его и не должно быть: смещения верны, а геометрия неверна.
Последний случай — наименее серьезный из четырех. startxref указывает внутрь объекта 5, поэтому индекс невозможно найти, но все остальные данные в файле верны. Исправьте это единственное число — и файл снова станет корректным.
Когда что-то идет не так
Три вещи удивляют людей, когда они впервые используют этот класс.
Валидатор сообщает об «отсутствии проблем» в файле, который некорректно отображается в программе просмотра. Это правильное поведение. Валидатор проверяет структуру, а не содержание. Страница, текст которой невидим из-за того, что в потоке содержимого указан шрифт, отсутствующий в /Resources, структурно безупречна; именно такая ситуация возникает в демонстрационных примерах из части 5. Ошибки структуры и ошибки отрисовки — разные виды ошибок, и этот инструмент обнаруживает только первые.
Валидатор сообщает о проблеме в PDF-файле, созданном известной программой. Обычно такой файл использует возможность, поддержку которой мы решили не реализовывать: поток перекрестных ссылок вместо таблицы, несколько нумерованных подразделов в одной таблице, /Length в виде косвенной ссылки или объект с номером поколения, отличным от 0. Большинство этих случаев прямо указано в сообщениях, и ни одно из таких сообщений не означает, что файл поврежден. Верно и обратное: класс не проверяет словарь трейлера, запись /Root, дерево страниц или маркер %%EOF, поэтому даже при отсутствии любого из этих элементов файл может пройти проверку без замечаний. Этот класс служит для проверки нашихвыходных файлов и помогает разбираться в файлах, созданных другими.
Класс не обнаруживает ошибок в файле, который не открывается. Проверьте первые четыре байта файла с помощью программы просмотра шестнадцатеричных данных. Если проверка заголовка прошла успешно, файл начинается с %PDF-, а вероятной причиной остается маркер порядка байтов или повреждение при передаче где-то дальше в файле. Число объектов, найденных при сканировании и указанное в заголовке отчета, позволяет быстро оценить правдоподобие результата: если найдено ноль объектов, файл не является PDF.
Шпаргалка
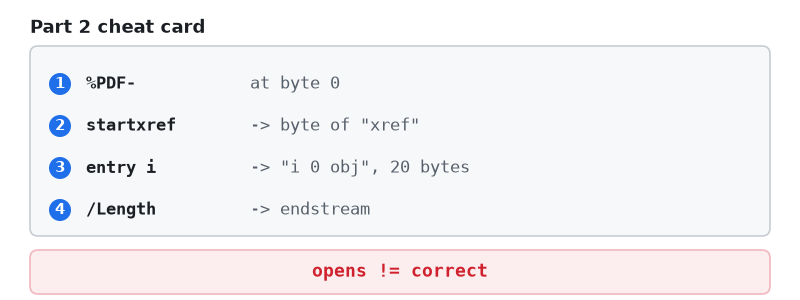
Рисунок 7. Четыре проверки и причина существования этого инструмента.
Вот эти четыре проверки; у каждой есть оговорка, о которой стоит помнить:
- %PDF- должен начинаться с байта 0 — перед ним не должно быть ни маркера порядка байтов, ни пустой строки.
- Значение startxref должно указывать байтовое смещение начала слова xref; искать его нужно с конца файла, а не с начала.
- Запись i должна указывать на i 0 obj, и каждая запись должна иметь длину ровно двадцать байт.
- Длина, заданная в /Length, должна доходить до endstream с учетом одного необязательного окончания строки между концом данных потока и этим ключевым словом.
И вот почему шпаргалка заканчивается именно так: сам факт открытия файла мало что говорит о его структуре, а проверка на уровне байтов дает гораздо больше информации. Если к документу предъявляются требования помимо этих четырех, инструменты предпечатной проверки и валидаторы PDF/A выполнят гораздо более глубокую проверку, чем когда-либо сможет этот класс.
Структура проекта
MQL5/
├── Scripts/
│    └── MQLPDF/
│        └── Part 02/
│            ├── Demo02_BreakIt.mq5     // Create multiple PDF files (valid and invalid files)
│            └── Demo02_Validate.mq5    // Check the validation of the files
│
└── Include/
│    └── MQLPDF/
│        ├── HelloPdf.mqh                // To create simple PDF file (not in final library)
│        └── PdfValidate.mqh             // To check the validation of PDF file and list the problems
└── Files/
     └── MQLPDF/
         └── Part 02/
             ├── hello_good.pdf           // good file (output file)
             ├── hello_space.pdf          // invalid file (output file)
             ├── hello_startxref.pdf      // invalid file (output file)
             ├── hello_text.pdf           // invalid file (output file)
             └── hello_text2.pdf          // invalid file (output file)
Разархивируйте файлы в папки MQL5\Scripts\ и MQL5\Include\, скомпилируйте оба скрипта, сначала запустите Demo02_BreakIt.mq5, а затем Demo02_Validate.mq5. Файлы появляются в папке MQL5\Files\MQLPDF\Part 02\.
Файл HelloPdf.mqh содержит вспомогательный код для демонстрации и не войдет в состав библиотеки; начиная с части 3, PDF-файл будет генерироваться, а не вводиться вручную. PdfValidate.mqh — первый файл, который останется в библиотеке; он будет подключаться в тестовых скриптах всех последующих частей.
| # | Файл | Каталог | Содержит |
|---|---|---|---|
| 1 | PdfValidate.mqh | MQL5/Include/MQLPDF/ | Проверка корректности PDF-файла и вывод списка проблем |
| 2 | HelloPdf.mqh | MQL5/Include/MQLPDF/ | Создание простого файла PDF (не входит в окончательную версию библиотеки) |
| 3 | Demo02_BreakIt.mq5 | MQL5/Scripts/MQLPDF/Part 02 | Создание нескольких PDF-файлов (корректных и некорректных) |
| 4 | Demo02_Validate.mq5 | MQL5/Scripts/MQLPDF/Part 02 | Проверка корректности файлов |
| 5 | MQLPDF Library - Part 02.zip | архив, содержащий все приложенные файлы и их пути относительно корневой папки терминала. |
Заключение
Структура PDF-файла держится на целых числах, задающих позиции, но в самом формате нет средств их проверки. Одно изменение в строке приводит к искажению длины потока, записи xref и startxref сразу, при этом ни в одной части файла не сохраняется достаточно информации, чтобы это заметить. Каждая запись в таблице занимает двадцать байт, поскольку программа просмотра обращается к записям по индексу, а не читает их последовательно, поэтому один удаленный пробел наносит такой же ущерб, как неверное число.
Реальные программы обработки PDF скрывают все это. Обе протестированные нами реализации принимали все поврежденные файлы и все равно выдавали правильный текст, поскольку при сбое индекса они сканируют файл и восстанавливают индекс. Проверка двух реализаций на четырех небольших файлах — это демонстрация, а не общее правило: такие же повреждения в файле большего размера или повреждения другого рода могут вообще не поддаваться восстановлению, а инструменты предпечатной проверки, архивные системы и сжатый формат индекса, используемый в больших отчетах, изначально не допускают таких послаблений.
Теперь у вас есть файл PdfValidate.mqh, который выполняет четыре проверки, на которые полагается программа просмотра, и сообщает номер объекта, позицию в байтах и величину расхождения. Укажите ему любой PDF-файл с классической таблицей перекрестных ссылок, в том числе созданный не вами. Он не подтвердит корректность документа, но сообщит, сходится ли в нем байтовая арифметика. С этого момента каждая часть этой серии тестируется с его помощью.
Чего у нас пока нет, так это способа получить эти числа. Каждое смещение в Demo01 и Demo02 задано литералом, значение которого подсчитано вручную, и мы уже посвятили целую статью тому, почему этот подход не масштабируется за пределы одного файла.
В части 3 («Ваш первый PDF из MQL5: модуль записи с точностью до байта») подсчет байтов берет на себя компьютер. Мы создаем CPdfBuffer — единственный класс в библиотеке, который понимает, что такое байт, — и CPdfWriter, который при записи фиксирует начало каждого объекта и на основе этих данных формирует таблицу перекрестных ссылок. Требования к проверке строгие: сгенерированный файл должен побайтово совпадать с тем, который мы набрали в части 1, а валидатор из части 2 не должен обнаружить в нем никаких проблем. В результате вы получите инструмент, который преобразует любой текст — журнал, дамп настроек, список открытых позиций — в PDF-файл с разбиением на страницы.
Проект поддерживается на платформе MQL5 Algo Forge. У каждой части этой серии есть свой релиз, в котором зафиксирован именно тот код, который разбирается в этой части, поэтому скачивать следует релиз, соответствующий статье, которую вы читаете.
Релиз части 2 доступен здесь: https://forge.mql5.io/SandroBegashvil/MQLPDF/releases/tag/part-02
Перевод с английского произведен MetaQuotes Ltd.
Оригинальная статья: https://www.mql5.com/en/articles/24314
Предупреждение: все права на данные материалы принадлежат MetaQuotes Ltd. Полная или частичная перепечатка запрещена.
Данная статья написана пользователем сайта и отражает его личную точку зрения. Компания MetaQuotes Ltd не несет ответственности за достоверность представленной информации, а также за возможные последствия использования описанных решений, стратегий или рекомендаций.


