

Архитектура машинного обучения для MetaTrader 5 (Часть 20): Подавление шума, удаление рыночной компоненты и кластеризация корреляционной матрицы признаков
 25
 0

Содержание
- Введение
- Почему для оценки групповой важности признаков нужна очищенная корреляционная матрица
- Теорема Марченко — Пастура
- Оценка верхней границы шумового спектра: исходное число баров или эффективный размер выборки
- Подавление шума в корреляционной матрице
- Удаление рыночной компоненты
- Репрезентативная матрица признаков
- Восстановление кластерной структуры: до и после
- Практические аспекты
- Заключение
- Прикрепленные файлы
Введение
Часть 9 завершалась явным указанием на предварительное условие: описанный в ней конвейер обработки предполагает, что набор признаков уже проверен и тщательно отобран; при этом групповая важность признаков прямо упоминалась как один из методов, которые автор еще обещал разобрать. Эта статья — первая часть выполнения этого обещания. В ней важность признаков пока не рассчитывается. В ней формируется объект, необходимый для оценки групповой важности признаков методами среднего уменьшения неоднородности (MDI) и среднего снижения точности (MDA) в следующей статье: корреляционная матрица, очищенная от шума оценивания и компоненты общей рыночной моды, которые искажают результаты кластеризации.
Это особенно важно для метаразметки. Каждая модель метаразметки в этой серии получает от первичной модели прогноз направления сделки и с помощью вторичного классификатора определяет, следует ли действовать на его основе, используя доступную на данный момент матрицу признаков. Эта матрица признаков расширялась на протяжении серии статей «Формирование признаков для машинного обучения». Теперь она включает уровни дробного дифференцирования, кодировки времени суток, оценки микроструктуры, меры энтропии, фрактальные признаки и статистики сканирования трендов — все они рассчитываются по одной и той же исходной ценовой траектории. Признаки, построенные на основе одного и того же ценового ряда, по построению не являются независимыми, а некоторые из них намеренно избыточны: один и тот же оцениватель используется с несколькими окнами ретроспективного анализа.
Непосредственное использование этой матрицы признаков для расчета среднего уменьшения неоднородности (MDI) или среднего снижения точности (MDA) приводит к эффекту замещения, описанному в главе 8 AFML. Коррелированные признаки делят между собой важность одного и того же сигнала, поэтому их важность оказывается заниженной относительно их истинного вклада. В разделе 6.5 книги «Машинное обучение для управляющих активами» (MLAM) эта проблема решается с помощью групповой важности признаков, рассчитываемой для групп схожих признаков, а не для отдельных столбцов. Кластеризация, в свою очередь, надежно работает только с корреляционной матрицей, в которой предварительно выполнены подавление шума и удаление рыночной компоненты; об этом прямо сказано в разобранном примере из MLAM, где этот этап пропущен лишь для проверки устойчивости алгоритма кластеризации в сложных условиях, а не в качестве рекомендации для практического применения.
Таким образом, последовательность действий такова: выполнить подавление шума и удаление рыночной компоненты в корреляционной матрице признаков (глава 2 MLAM), провести кластеризацию на ее основе с помощью алгоритма оптимального числа кластеров (ONC) (глава 4 MLAM), затем рассчитать по результатам групповые варианты среднего уменьшения неоднородности (MDI) и среднего снижения точности (MDA) (раздел 6.5 MLAM, следующая статья). В этой статье рассматриваются первые два звена. В ней также вновь рассматривается вопрос, который ни AFML, ни MLAM напрямую не затрагивают: какой размер выборки следует использовать при подгонке распределения Марченко — Пастура, если исходные бары обладают автокорреляцией, как часовые бары валютного рынка.
Почему для расчета групповой важности признаков нужна очищенная корреляционная матрица
Выборочная корреляционная матрица, оцененная по окну конечной длины, никогда не совпадает с истинной корреляционной матрицей. В ней присутствуют два разных источника искажений, и кластеризация чувствительна к обоим.
Первый источник — шум оценивания. При N признаках и T наблюдениях матрица, построенная на основе чисто случайных, некоррелированных данных, всё равно даёт разброс ненулевых выборочных корреляций и разброс выборочных собственных значений, отклоняющихся от 1, исключительно за счёт вариации, связанной с конечным размером выборки. Теория случайных матриц задает точную форму этого распределения при нулевой гипотезе об отсутствии корреляции; всё, что попадает в его пределы, неотличимо от шума, а всё, что выходит за них, свидетельствует о наличии реальной структуры. В разделе 7 ниже это распределение подгоняется к данным матрицы признаков, используемой в данной статье.
Второй источник — общая рыночная компонента. Признаки, полученные на основе ценовой траектории одного и того же инструмента, как правило, подвержены общему влиянию преобладающего рыночного режима: на участке с выраженным трендом и высокой волатильностью одновременно растут оценки тренда, волатильности и ряда характеристик микроструктуры независимо от того, какой специфичный для своего семейства сигнал призван выделять каждый признак. Эта общая компонента проявляется в виде необычно большого первого собственного значения с примерно одинаковыми факторными нагрузками у затронутых признаков. В разделе 2.6 MLAM прямо указано следствие этого механизма: кластеризация с трудом разделяет семейства признаков, если в корреляционной матрице присутствует сильная общая компонента, поскольку за счет нее каждый признак в некоторой степени похож на любой другой.
Подавление шума решает первую проблему. Удаление рыночной компоненты решает вторую проблему. Обе процедуры необходимы для подготовки к кластеризации; в этой статье они объединены в единый конвейер обработки, выполняемый до любых расчетов важности признаков.
Теорема Марченко — Пастура
Теорема Марченко — Пастура (MP) описывает предельное распределение собственных значений корреляционной матрицы, оцененной по N независимым одинаково распределенным случайным величинам, наблюдаемым в течение T периодов, когда N и T стремятся к бесконечности при фиксированном отношении. Если обозначить q = T/N, а через σ² — дисперсию, объясняемую чистым шумом, то при этой нулевой гипотезе собственные значения сосредоточены между следующими границами:
λmin = σ²(1 − √(1/q))² and λmax = σ²(1 + √(1/q))²
причем плотность распределения между этими двумя границами задается известной формулой в замкнутом виде. Для дальнейшего изложения важны два свойства этого отношения. Во-первых, q определяется как число наблюдений на одну переменную, T/N, а не наоборот: большое значение q (большой объем данных относительно числа признаков) сужает шумовой спектр к σ², а малое значение q расширяет его. Если перепутать это отношение с обратным, ширина шумового спектра для типичных матриц признаков незаметно увеличится на несколько порядков, поскольку тогда 1/q станет равным T/N вместо N/T. Во-вторых, σ² не задается заранее, а оценивается по данным путем минимизации квадрата расстояния между этой теоретической плотностью и ядерной оценкой плотности, построенной по эмпирической гистограмме собственных значений матрицы признаков.
Любое собственное значение выше оцененной по данным границы λmax выходит за пределы значений, которые может породить чистый шум, и рассматривается как сигнал. Все собственные значения на этой границе или ниже нее статистически неотличимы от шума независимо от того, насколько большими или малыми они кажутся.
Оценка верхней границы шумового спектра: исходное число баров или Эффективный размер выборки
Сама процедура подбора проста: вычислить теоретическую плотность MP при пробном значении σ², сравнить ее с ядерной оценкой плотности наблюдаемых собственных значений на том же носителе и минимизировать квадратичную ошибку по σ². Это соответствует фрагменту кода 2.2 из MLAM, но одну деталь реализации стоит отметить особо, поскольку здесь легко допустить незаметную ошибку: ширина окна ядерной оценки должна задаваться абсолютной величиной в единицах собственных значений (sklearn.neighbors.KernelDensity(bandwidth=...)), а не относительным масштабным коэффициентом (в scipy.stats.gaussian_kde это параметр bw_method, который задает масштабирование с учетом стандартного отклонения самих данных). Передача того же числового значения ширины окна ядерной оценки в реализацию с другой трактовкой этого параметра не вызывает ошибки; она лишь приводит к сильно смещенному результату подгонки, который оказывается на границе области поиска.
def mp_pdf(var, q, pts=1000):
    e_min = var * (1 - (1.0 / q) ** 0.5) ** 2
    e_max = var * (1 + (1.0 / q) ** 0.5) ** 2
    e_val = np.linspace(e_min, e_max, pts)
    pdf = q / (2 * np.pi * var * e_val) * ((e_max - e_val) * (e_val - e_min)) ** 0.5
    return pd.Series(pdf, index=e_val)


def fit_kde(obs, b_width=0.15, x=None):
    """Absolute-bandwidth KDE of the empirical eigenvalue distribution."""
    obs = np.asarray(obs).reshape(-1, 1)
    kde = KernelDensity(kernel="gaussian", bandwidth=b_width).fit(obs)
    x = np.unique(obs).reshape(-1, 1) if x is None else np.asarray(x).reshape(-1, 1)
    return pd.Series(np.exp(kde.score_samples(x)), index=x.flatten())


def err_pdfs(var, e_val, q, b_width, pts=1000):
    pdf0 = mp_pdf(var[0], q, pts)
    pdf1 = fit_kde(e_val, b_width, x=pdf0.index.values)
    return float(np.sum((pdf1 - pdf0) ** 2))


def find_max_eval(e_val, q, b_width=0.15):
    out = minimize(lambda v: err_pdfs(v, e_val, q, b_width),
                    x0=np.array([0.5]), bounds=((1e-5, 1 - 1e-5),))
    var = out["x"][0] if out["success"] else 1.0
    e_max = var * (1 + (1.0 / q) ** 0.5) ** 2
    return e_max, var
Обе описанные выше ошибки в трактовке параметров (инверсия q и тип ширины окна ядерной оценки) остаются незамеченными. Функция find_max_eval по-прежнему возвращает число, но оно неверно, а полученное число факторов будет выглядеть правдоподобно, не имея при этом достаточного обоснования. Для каждой из этих двух ошибок стоит предусмотреть отдельный модульный тест на синтетической ковариационной матрице с заранее известным результатом, прежде чем доверять подгонке на реальной матрице признаков.
Отдельный вопрос, который, собственно, и послужил поводом для написания этого раздела, заключается в том, какое значение T вообще следует использовать. Теорема предполагает независимость наблюдений. Часовые бары (H1) валютного рынка не являются независимыми: соседние бары связаны общим рыночным режимом, кластеризацией волатильности и устойчивостью микроструктурных эффектов, поэтому использование исходного числа баров в качестве T завышает объем независимой информации, фактически содержащейся в матрице признаков. Это та же поправка на эффективный размер выборки, которая уже применялась в других частях этой серии к последовательному бутстрапу и взвешиванию одновременно действующих меток; она уместна и здесь: поправка по типу AR(1), основанная на средней автокорреляции первого порядка рядов самой матрицы признаков, дает более обоснованное значение Teff.
def effective_sample_size(X, t_raw):
    """Average lag-1 autocorrelation across columns -> AR(1) effective T."""
    rhos = [np.corrcoef(X[:-1, j], X[1:, j])[0, 1] for j in range(X.shape[1])]
    rho_bar = float(np.mean(rhos))
    t_eff = t_raw * (1 - rho_bar) / (1 + rho_bar)
    return t_eff, rho_bar
Ни AFML, ни MLAM напрямую не рассматривают эту поправку; в обоих случаях величина T считается заданной. Использование исходного числа баров в качестве T без проверки автокорреляции рядов самой матрицы признаков — это неявное допущение о независимости, а не нейтральный выбор по умолчанию; ниже показаны численные последствия такого выбора для матрицы признаков, используемой в этой статье.
Подавление шума в корреляционной матрице
После определения верхней границы шумового спектра λmax и соответствующего числа факторов nfacts матрицу можно очистить двумя способами, описанными в разделе 2.5 MLAM. Метод выравнивания остаточных собственных значений сохраняет без изменений nfacts наибольших собственных значений и соответствующих собственных векторов, а все собственные значения ниже верхней границы шумового спектра заменяет их общим средним, сохраняя след матрицы и выравнивая всю часть спектра, отнесенную к шуму:
def cov2corr(cov):
    std = np.sqrt(np.diag(cov))
    corr = cov / np.outer(std, std)
    corr[corr < -1], corr[corr > 1] = -1, 1
    return corr


def denoised_corr(e_val, e_vec, n_facts, labels=None):
    """Constant residual eigenvalue method (MLAM eq. 2.5)."""
    e_val_ = e_val.copy()   # get_pca already returns a 1D vector
    if n_facts < e_val_.shape[0]:
        e_val_[n_facts:] = e_val_[n_facts:].sum() / (e_val_.shape[0] - n_facts)
    corr1 = cov2corr(e_vec @ np.diag(e_val_) @ e_vec.T)
    return pd.DataFrame(corr1, index=labels, columns=labels) if labels is not None else corr1
Альтернативой является целевое сжатие. Вместо того чтобы фиксировать собственные значения шума на постоянном уровне, этот метод применяет вес сжатия α к вкладу собственных векторов шума, оставляя собственные векторы сигнала без изменений (α → 0 означает полное сжатие). Сравнение методом Монте-Карло, приведенное в разделе 2.7 MLAM, показывает, что в тесте на портфеле минимальной дисперсии метод выравнивания остаточных собственных значений эффективнее целевого сжатия, которое дает лишь небольшой дополнительный выигрыш; поэтому в оставшейся части статьи используется метод выравнивания остаточных собственных значений. Оба метода уже реализованы и протестированы в аналоге RiskEstimators, используемом на других этапах этого конвейера обработки: модульные тесты подтверждают совпадение с эталонными значениями MLAM до четырех знаков после запятой. Поэтому в рабочем коде следует вызывать эту общую реализацию, а не дублировать приведенную выше процедуру; здесь представлен минимальный самодостаточный вариант для читателей, самостоятельно воспроизводящих изложенные шаги.
Удаление рыночной компоненты
Удаление рыночной компоненты — более узкая операция, чем подавление шума. Эта операция удаляет из уже очищенной от шума корреляционной матрицы вклад конкретного собственного вектора, который, как предполагается, представляет компоненту общей рыночной моды. На практике это почти всегда первый собственный вектор — тот, которому соответствует наибольшее собственное значение и примерно одинаковые факторные нагрузки по всем затронутым признакам:
def detoned_corr(corr, market_components=1):
    e_val, e_vec = get_pca(corr)
    # get_pca returns eigenvalues as a 1D vector. Slicing it in two dimensions,
    # as MLAM's snippet does, raises IndexError; build the diagonal instead.
    e_val_mkt = np.diag(e_val[:market_components])
    e_vec_mkt = e_vec[:, :market_components]
    corr_mkt = e_vec_mkt @ e_val_mkt @ e_vec_mkt.T
    corr1 = corr.values - corr_mkt
    return pd.DataFrame(cov2corr(corr1), index=corr.index, columns=corr.columns)
После вычитания рыночной компоненты процедура вновь нормирует результат до корректной корреляционной матрицы с единицами на диагонали. Здесь параметр market_components по умолчанию равен 1, поскольку в статье используется матрица признаков одного инструмента. Для матрицы признаков нескольких инструментов с более чем одним доминирующим общим фактором (например, с общей компонентой силы доллара наряду с компонентами, специфичными для отдельных инструментов) это число потребуется увеличить. Его выбирают, проверяя, скольким из наибольших собственных значений соответствуют почти однородные факторные нагрузки, характерные для общего фактора, а не для фактора отдельного семейства признаков.
Единая точка входа для всей процедуры
Описанные выше функции реализуют всю процедуру, но вызывающий код не должен вручную задавать последовательность их вызовов и каждый раз обеспечивать правильный учет эффективного размера выборки. Функция clean_corr принимает матрицу признаков и возвращает очищенную матрицу вместе с диагностическими данными, обосновывающими результат, — именно такой формат входных данных используется на этапе кластеризации в следующей статье.
corr_clean, info = clean_corr(
    X,                                    # feature panel, shape (T, N)
    detone=False,
    market_components=1,
    kde_bwidth=0.15,                     # absolute, in eigenvalue units
    use_effective_sample_size=True,      # fit against T_eff, not T
)
# info: t_raw, t_eff, rho_bar, n_features, q, noise_var, noise_ceiling, n_facts
Диагностические данные намеренно возвращаются вместе с матрицей. Сама по себе очищенная корреляционная матрица не хранит сведений о спектре, на основе которого она получена, а любое последующее распределение по кластерам зависит от этого выбора. Поэтому отчет, показывающий разбиение без результатов подгонки, лежащих в его основе, невозможно проверить.
Один граничный случай необходимо обработать, а не просто исключить из рассмотрения. При достаточно сильной временной зависимости в матрице признаков поправка на эффективный размер выборки может снизить Teff до значения меньше N. В результате q < 1, и плотность Марченко — Пастура становится неопределенной. Принудительное повышение q в этом случае приводит к возврату матрицы, очищенной с использованием верхней границы шумового спектра, которую данные не обосновывают. Причем это происходит без предупреждения, что хуже, чем завершение с ошибкой или пропуск этого этапа. Вместо этого функция clean_corr возбуждает исключение EffectiveSampleSizeError еще до попытки подгонки, поэтому ресурсоемкие вычисления не выполняются впустую. Исключение содержит корреляционную матрицу, спектральное разложение и диагностические данные, поэтому вызывающий код может продолжить работу, не вычисляя их повторно.
try:
    corr_clean, info = clean_corr(X)
except EffectiveSampleSizeError as err:
    # err.corr, err.e_val, err.e_vec and err.info are already computed.
    logger.warning(f"Denoising skipped: {err}")
    corr_clean = err.corr           # cluster on the raw matrix, nothing recomputed
Если матрица признаков вызывает это исключение, доступны три варианта: выполнить кластеризацию без подавления шума, исключить часть признаков для увеличения q или передать use_effective_sample_size=False, чтобы выполнить подгонку с использованием исходного числа баров, приняв связанное с этим допущение о независимости наблюдений.
Репрезентативная матрица признаков
Чтобы наглядно показать эффект подавления шума и удаления рыночной компоненты, в этом разделе строится синтетическая матрица признаков с заранее известным результатом. Ее структура намеренно воспроизводит рабочий набор признаков, а не типовую демонстрационную модель блочных корреляций, которую AFML и MLAM используют в своих экспериментах с синтетическими данными. Тридцать признаков сгруппированы в шесть категорий: тренд и импульс (шесть признаков, соответствующих статистическим показателям сканирования тренда), волатильность (шесть), микроструктура (пять), энтропия (четыре), календарные и сессионные кодировки (четыре), а также пять столбцов с чистым шумом в качестве контрольной группы.
В каждой группе признаков, полученных из ценовых данных, признаки связаны общим латентным фактором с выраженной временной зависимостью при умеренном целевом уровне корреляции. Группы тренда, волатильности, микроструктуры и энтропии дополнительно связаны общим фактором рыночной моды с очень сильной временной зависимостью, тогда как календарная и шумовая группы с ним не связаны. Каждый ряд генерируется как процесс AR(1), а не как последовательность независимых одинаково распределенных шумовых значений, поскольку именно эта временная зависимость придает вопросу о соотношении исходного числа баров и эффективного размера выборки из раздела 4 практический, а не только теоретический смысл.
def ar1(n, rho, seed):
    """Unit-variance AR(1) process with lag-1 autocorrelation rho."""
    rng = np.random.default_rng(seed)
    eps = rng.standard_normal(n)
    x = np.zeros(n)
    x[0] = eps[0]
    for t in range(1, n):
        x[t] = rho * x[t - 1] + np.sqrt(1 - rho ** 2) * eps[t]
    return x


def make_family(n_obs, n_features, rho_target, seed,
                 latent_rho=0.85, idio_rho=0.30,
                 market_loading=0.0, market_factor=None):
    """One family of AR(1)-persistent features sharing a latent factor at
    approximately rho_target pairwise correlation, optionally loaded onto
    a shared market-mode factor."""
    latent = ar1(n_obs, latent_rho, seed)
    a = np.sqrt(rho_target / (1 - rho_target))
    feats = np.zeros((n_obs, n_features))
    for j in range(n_features):
        idio = ar1(n_obs, idio_rho, seed * 1000 + j)
        f = a * latent + idio
        if market_factor is not None and market_loading > 0:
            f = f + market_loading * market_factor
        feats[:, j] = f
    return feats
Поскольку истинная принадлежность каждого признака к семейству известна по построению, эта матрица признаков позволяет сделать то, что невозможно для матрицы реальных рабочих данных: напрямую проверить, восстанавливает ли кластеризация правильные группы.
| Величина | Исходное число баров | Эффективный размер выборки |
|---|---|---|
| T | 1 500 | 505 |
| q = T/N | 50.0 | 16.9 |
| Оцененная верхняя граница шумового спектра λmax | 1.30 | 1.55 |
| Сохраненные сигнальные собственные значения | 5 | 5 |
Средняя автокорреляция первого порядка по всем тридцати признакам матрицы признаков составляет 0.50, что снижает Teff примерно до трети исходного числа баров. В данном случае обе аппроксимации сохраняют одни и те же пять сигнальных собственных значений, но запас невелик: пятое собственное значение (1.65) превышает верхнюю границу шумового спектра, рассчитанную с учетом эффективного размера выборки (1.55), примерно на 0.10, то есть приблизительно на шесть процентов от собственного значения. Если бы пятый фактор был чуть слабее, он был бы сохранен как сигнал при использовании исходного числа баров в качестве размера выборки, но корректно отброшен при аппроксимации с учетом временной зависимости в самой матрице признаков. Этот пограничный фактор, как выясняется, относится к группе энтропийных признаков — семейству, для которого при построении задана самая слабая внутрисемейная корреляция; его пример показывает, что происходит с таким фактором при кластеризации.
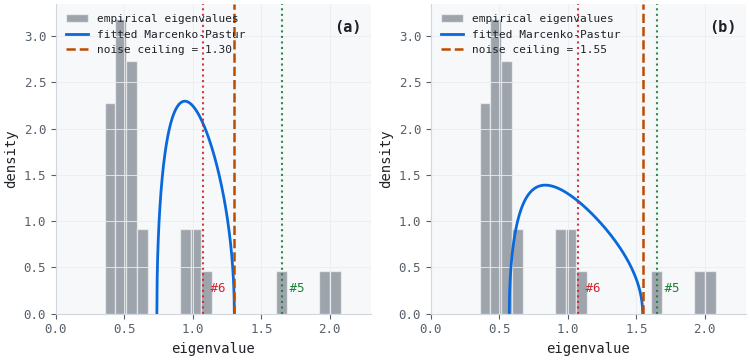
Рисунок 1. Подгонка распределения Марченко — Пастура: два графика
- Панель (a): эмпирическая гистограмма собственных значений и плотность, полученная при аппроксимации с использованием исходного числа баров; отмечены полученная верхняя граница шумового спектра, а также пятое и шестое собственные значения.
- Панель (b): та же аппроксимация с использованием эффективного размера выборки, скорректированного с учетом модели AR(1); верхняя граница шумового спектра сдвигается вправо, а отрыв пятого собственного значения от нее заметно сокращается.
Восстановление кластерной структуры: до и после
При nfacts, зафиксированном на уровне пяти (результат расчета с эффективным размером выборки), к исходной корреляционной матрице применяется подавление шума методом выравнивания остаточных собственных значений, а затем удаление рыночной компоненты, соответствующей первому собственному вектору. Затем и исходная, и очищенная матрицы кластеризуются на базовом этапе алгоритма оптимального числа кластеров (ONC): применяется метод K-средних с расстоянием √((1 − ρ)/2), вычисляемым на основе корреляции; перебираются возможные значения числа кластеров и выбирается то, которое максимизирует t-статистику коэффициента силуэта.
def cluster_kmeans_base(corr, max_clusters=10, n_init=10, seed=42):
    dist = ((1 - corr) / 2.0) ** 0.5
    best_score, best_labels, best_k = -np.inf, None, None
    for k in range(2, max_clusters + 1):
        labels = KMeans(n_clusters=k, n_init=n_init, random_state=seed).fit_predict(dist)
        silh = silhouette_samples(dist, labels)
        score = silh.mean() / silh.std() if silh.std() > 0 else silh.mean()
        if score > best_score:
            best_score, best_labels, best_k = score, labels, k
    return best_labels, best_k
Полный алгоритм ONC дополнительно выполняет повторную кластеризацию каждой группы, у которой качество по коэффициенту силуэта ниже среднего; в данной базовой версии этот повторный этап отсутствует. Именно полную версию, проверенную на соответствие эталонной реализации MLAM, уже предоставляет функция afml.clustering.onc.get_onc_clusters, которую и следует вызывать в рабочем коде. Ниже сравниваются две корреляционные матрицы, а не алгоритмы кластеризации, поэтому для выделения эффекта очистки достаточно более простого базового этапа.
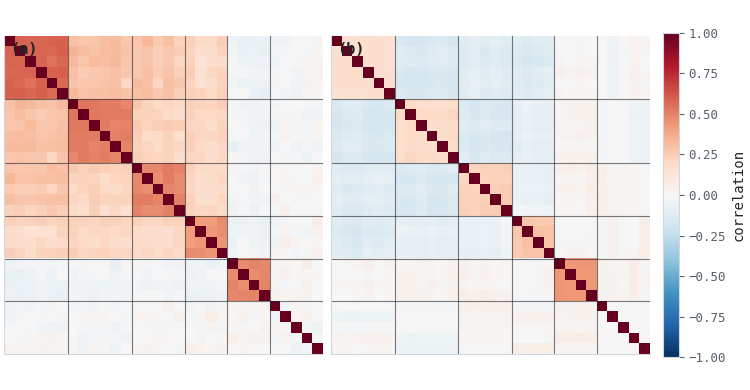
Рисунок 2. Иллюстрация из двух панелей: корреляционная матрица до и после очистки
- Панель (a): исходная выборочная корреляционная матрица, признаки упорядочены по истинным семействам; блочная структура видна, но размыта из-за общей рыночной моды, действующей на разные семейства.
- Панель (b): корреляционная матрица после подавления шума и удаления рыночной компоненты, с тем же порядком признаков; внутрисемейные блоки становятся чётче, а корреляция между семействами падает почти до нуля.
Кластеризация исходной матрицы выявляет лишь два кластера. Один кластер содержит все признаки из четырёх семейств с ненулевыми факторными нагрузками на общую рыночную моду (тренд, волатильность, микроструктура, энтропия: двадцать один признак); другой — все признаки без таких нагрузок (календарь и шум: девять признаков). При таких входных данных алгоритм не ошибается: поскольку сильная общая компонента присутствует в большей части матрицы признаков, различия, специфичные для отдельных семейств, действительно представляют собой более слабый сигнал, а метод K-средних вместо него выявляет более сильный. Именно такой случай некорректной работы описан в разделе 2.6 MLAM.
Кластеризация матрицы после подавления шума и удаления рыночной компоненты выявляет пять кластеров. Каждое из семейств тренда, волатильности, микроструктуры и календаря восстанавливается в виде отдельного однородного кластера. Семейство энтропии, напротив, не восстанавливается отдельно: оно сливается с группой шумовых признаков. Это согласуется с приведённым выше выводом о запасе собственного значения над порогом: семейство энтропии было сформировано с самой слабой внутрисемейной корреляцией, и его сигнальное собственное значение изначально лишь немного превышало верхнюю границу шумового спектра. Удаление рыночной компоненты устраняет компоненту общей рыночной моды — единственное, что вообще делало признаки энтропии отличимыми от шума; после её удаления оставшийся сигнал энтропии оказывается слишком слабым, чтобы на этом базовом этапе кластеризации отделить его от столбцов, содержащих только шум.
|
| Исходная корреляция | После подавления шума и удаления рыночной компоненты |
|---|---|---|
| Количество обнаруженных кластеров (k) | 2 | 5 |
| Скорректированный индекс Рэнда относительно истинных семейств | 0.23 | 0.83 |
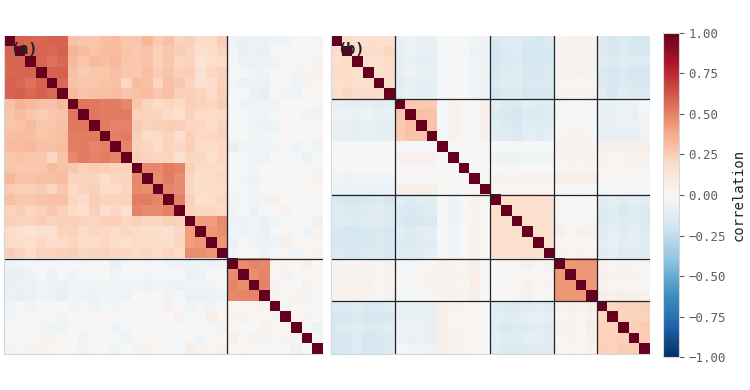
Рисунок 3. Иллюстрация из двух панелей: восстановление кластерной структуры
- Панель (a): исходная корреляционная матрица, переупорядоченная по результатам её разбиения на два кластера; семейства с ненулевыми факторными нагрузками на общую рыночную моду неотличимы друг от друга.
- Панель (b): корреляционная матрица после подавления шума и удаления рыночной компоненты, переупорядоченная в соответствии с разбиением на пять кластеров; четыре из пяти семейств сигналов восстановлены в виде чистых блоков.
Скорректированный индекс Рэнда, равный 0.83 при сравнении с шестью истинными группами, когда одно слабое семейство признаков поглощено шумовым кластером, — более честный результат, чем искусственно достигнутое идеальное восстановление кластерной структуры; именно на этом результате в следующей статье будут основаны групповые варианты методов среднего уменьшения неоднородности (MDI) и среднего снижения точности (MDA).
Практические аспекты
- Чувствительность к ширине окна ядерной оценки: во всей статье при подгонке распределения MP ширина окна была фиксированной и составляла 0.15 в единицах собственных значений. Стоит хотя бы один раз заново подобрать эту ширину с помощью перекрестной проверки на реальной матрице признаков, как предлагается в качестве упражнения в разделе 2.8 книги MLAM, а не предполагать, что выбранное значение подходит для матриц существенно разного размера.
- Эффективный размер выборки — диагностическая оценка, а не точное значение: используемое здесь приближение AR(1) представляет собой поправку первого порядка. Временную структуру признаков с более сложной зависимостью (процессы с долгой памятью, устойчивость зависимости, меняющаяся с режимом) нельзя полностью описать одним коэффициентом автокорреляции первого порядка, поэтому полученное значение Teff следует рассматривать как более обоснованную оценку, чем исходное число баров, но не как точную.
- Периодичность повторной оценки: структура корреляций между сконструированными признаками меняется при смене режимов. Результаты подавления шума и кластеризации, полученные один раз на многолетнем окне и больше не пересматриваемые, со временем утратят актуальность; этот конвейер обработки — этап исследования, который необходимо повторять на скользящем окне или по схеме walk-forward, а не однократная калибровка.
- Число рыночных компонент: для этой матрицы признаков одного инструмента оно фиксировано и равно единице. Для матриц признаков нескольких инструментов это число необходимо проверять, а не принимать без проверки.
Заключение
Исходная выборочная корреляционная матрица сконструированных признаков содержит две различные проблемные составляющие: шум оценивания, который подгонка распределения Марченко — Пастура отделяет от сигнала, и компоненту общей рыночной моды, устраняемую при удалении рыночной компоненты после того, как подавление шума определит, что следует считать сигналом. На репрезентативной матрице признаков, сформированной так, чтобы воспроизводить набор признаков рабочей системы, кластеризация по исходной корреляционной матрице объединила четыре различных семейства признаков в один блок из-за их общей подверженности влиянию рынка; кластеризация по матрице после подавления шума и удаления рыночной компоненты позволила четко восстановить четыре из пяти семейств сигналов, при этом самое слабое семейство было поглощено шумовым кластером, а не ошибочно выделено в отдельный кластер. Сама подгонка распределения Марченко — Пастура чувствительна к допущению, которое явно не сформулировано ни в AFML, ни в MLAM: размер выборки, используемый при подгонке, должен отражать число независимых наблюдений, тогда как исходное число баров для автокоррелированных валютных данных этому требованию не отвечает.
В следующей статье полученное здесь разбиение на кластеры используется как вход для групповых вариантов методов среднего уменьшения неоднородности (MDI) и среднего снижения точности (MDA); на той же матрице признаков они напрямую сравниваются с наивными методами оценки по отдельным признакам из главы 8 книги AFML: средним уменьшением неоднородности (MDI), средним снижением точности (MDA) и важностью отдельного признака (SFI), — тем самым выполняется предварительное условие, сформулированное еще в части 9.
Прикрепленные файлы
| Файл | Местоположение | Описание |
|---|---|---|
| denoising_detoning.py | afml/denoising/denoising_detoning.py | Подгонка собственных значений по распределению Марченко — Пастура, поправка на эффективный размер выборки, подавление шума методом выравнивания остаточных собственных значений и удаление рыночной компоненты для корреляционных матриц. Создан новый модуль для выделения конвейера обработки, включающего подавление шума и удаление рыночной компоненты. |
| onc.py | afml/clustering/onc.py | Алгоритм оптимального числа кластеров (ONC). Выполняет детерминированную базовую кластеризацию методом k-средних, оценивает качество кластеров по коэффициенту силуэта и рекурсивно улучшает кластеры, качество которых ниже среднего. Исправляет проблему с ленивым вычислением map и добавляет управление состоянием генератора случайных чисел для обеспечения воспроизводимости. |
| feature_clusters.py | afml/clustering/feature_clusters.py | Формирует подмножества признаков по кластерам с помощью ONC или иерархического объединения кластеров. Проверяет наличие признаков с низким коэффициентом силуэта и применяет преобразование для устранения мультиколлинеарности с помощью остаточной ортогонализации. |
| codependence_matrix.py | afml/codependence/codependence_matrix.py | Формирует матрицы зависимостей и расстояний на основе матрицы признаков с использованием вариации информации, взаимной информации, дистанционной корреляции, коэффициента корреляции Спирмена, GPR или GNPR. |
| correlation.py | afml/codependence/correlation.py | Реализует расстояния на основе корреляции: угловое, абсолютное угловое и квадратичное угловое, а также дистанционную корреляцию. |
| gnpr_distance.py | afml/codependence/gnpr_distance.py | Предоставляет коэффициент корреляции Спирмена (rho), расстояние GPR и расстояние GNPR для оценки зависимости на основе копул. |
| information.py | afml/codependence/information.py | Вычисляет взаимную информацию и вариацию информации с выбором оптимального числа интервалов. |
Перевод с английского произведен MetaQuotes Ltd.
Оригинальная статья: https://www.mql5.com/en/articles/24057
Предупреждение: все права на данные материалы принадлежат MetaQuotes Ltd. Полная или частичная перепечатка запрещена.
Данная статья написана пользователем сайта и отражает его личную точку зрения. Компания MetaQuotes Ltd не несет ответственности за достоверность представленной информации, а также за возможные последствия использования описанных решений, стратегий или рекомендаций.


